ai-powered-markdown-translatorgpt-6.1-sol की सहायता से फ़्रेंच से हिंदी में अनुवादित लेख।
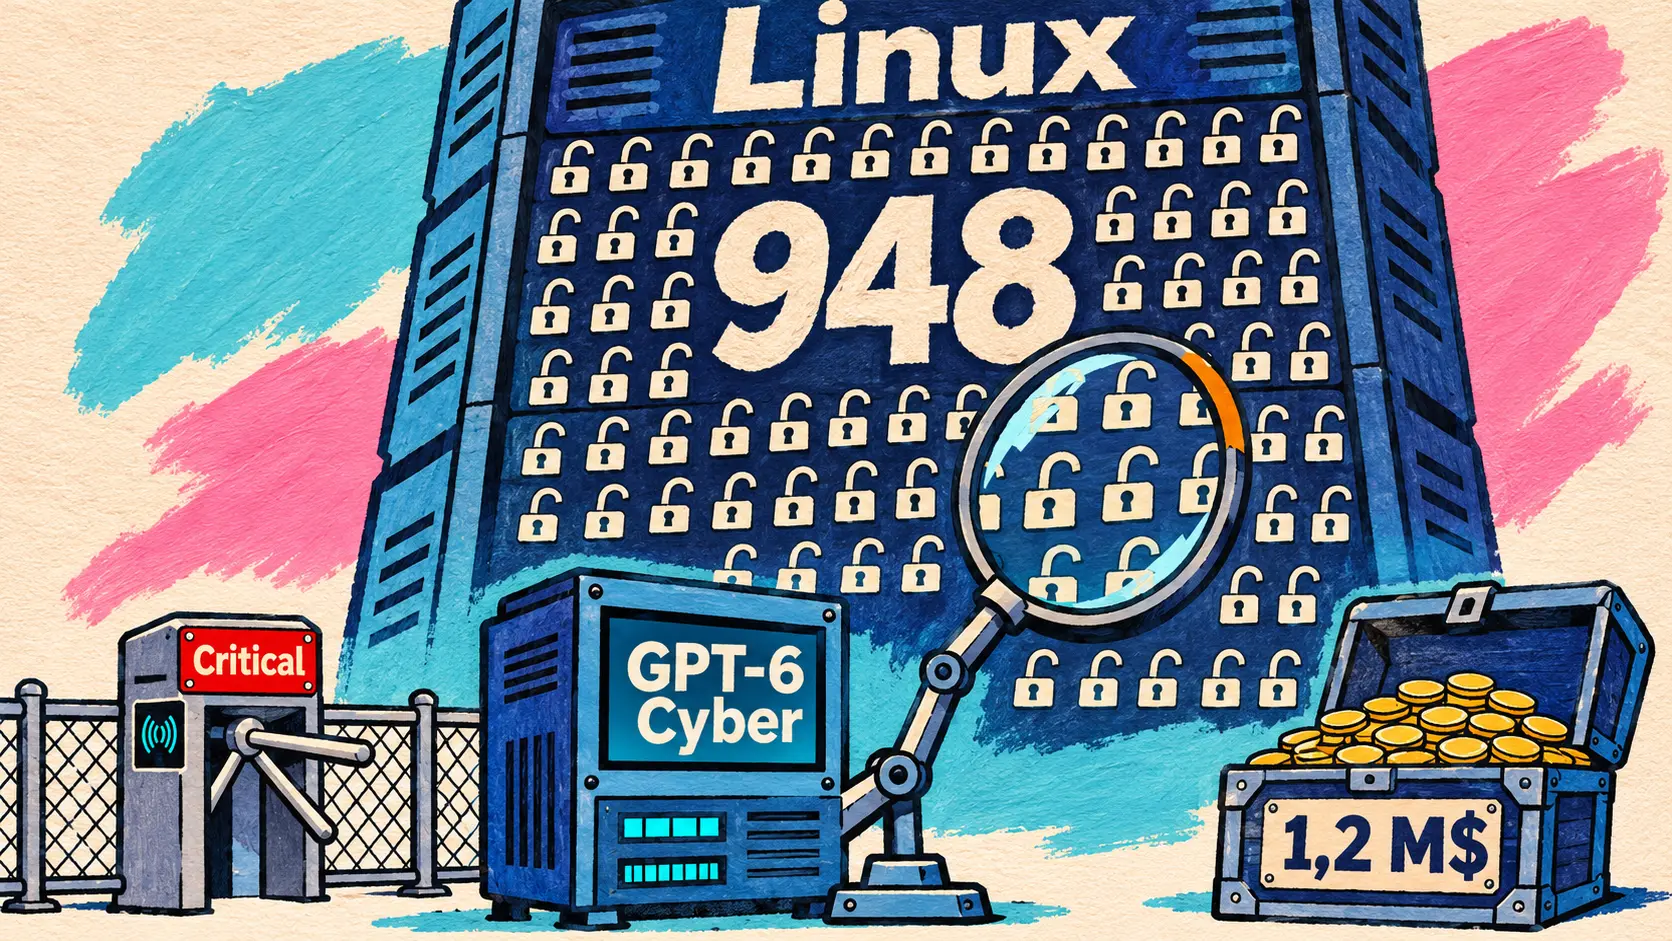
OpenAI ने GPT-6 Cyber पेश किया है, जो Critical श्रेणी का एक साइबर सुरक्षा मॉडल है और शुरुआत में केवल कुछ Daybreak Red ग्राहकों के लिए उपलब्ध है। यह घोषणा उस लेख के अगले दिन हुई है जिसमें बताया गया था कि इस मॉडल से संचालित उसकी स्वायत्त सुरक्षा कमज़ोरी खोज प्रणाली ने 1,2 मिलियन डॉलर की लागत पर Linux कर्नेल में विशेषाधिकार बढ़ाने वाली 948 कमज़ोरियों की पुष्टि की है। Anthropic ने Claude में Personal Finance उपलब्ध कराया है, जो अमेरिका में बीटा के रूप में केवल पढ़ने की अनुमति देता है, और Perplexity ने Teammates पेश किए हैं, जो लगातार काम करने वाले एजेंट हैं, जैसे वे एजेंट जिन्हें Mistral अपने Studio में जोड़ रहा है। रचनात्मक काम के क्षेत्र में OpenAI, Images 2.6 से छवियाँ बनाने की गति बढ़ा रहा है और Google ने Gemini Omni 1.2 Flash को सामान्य रूप से उपलब्ध कर दिया है, जिसमें 15 सेकंड के वीडियो और 30 % कम कीमत शामिल हैं। वहीं, Ricursive Intelligence ने Ripple-65B Preview जारी किया है, जो खुले वज़न वाला एक डेंस मॉडल है और एजेंट आधारित कोडिंग पर केंद्रित है।
OpenAI ने GPT-6 Cyber पेश किया, जो Critical श्रेणी का एक साइबर सुरक्षा मॉडल है और शुरुआत में कुछ Daybreak Red ग्राहकों के लिए उपलब्ध है
5 नवंबर — OpenAI ने GPT-6 Cyber पेश किया है, जो GPT-5.6 Cyber का उत्तराधिकारी है और जिसे शोधकर्ताओं की तय सीमा में रहते हुए ऐसी कमज़ोरियाँ खोजने और उनकी पुष्टि करने के लिए प्रशिक्षित किया गया है जिनका फायदा उठाया जा सकता है। उसका तैयारी संबंधी ढाँचा (Preparedness Framework) इसे साइबर सुरक्षा में Critical श्रेणी में रखता है, जबकि GPT-5.6 Cyber की श्रेणी High थी। OpenAI के अनुसार, यह अधिकांश साइबर कार्यों में GPT-6 Astra से बेहतर प्रदर्शन करता है, उन मामलों में भी जब Astra अनुरोध अस्वीकार नहीं करता।
Introducing GPT‑6 Cyber: a major advance in security research that pairs stronger capabilities with better model alignment. The model powered the Linux kernel research we announced yesterday, and security teams at companies like Mozilla, Palo Alto Networks, Calif, and Cisco—alongside our own at OpenAI—are already putting it to work. GPT-6 Cyber is available to select Daybreak Red customers and we are expanding access over time.
🇮🇳 पेश है GPT-6 Cyber: सुरक्षा अनुसंधान में एक बड़ी प्रगति, जो बढ़ी हुई क्षमताओं को मॉडल के बेहतर संरेखण के साथ जोड़ती है। इस मॉडल ने कल घोषित Linux कर्नेल संबंधी शोध को संचालित किया, और OpenAI की हमारी टीमों के साथ-साथ Mozilla, Palo Alto Networks, Calif और Cisco जैसी कंपनियों की सुरक्षा टीमें भी पहले से इसका उपयोग कर रही हैं। GPT-6 Cyber कुछ Daybreak Red ग्राहकों के लिए उपलब्ध है और हम समय के साथ इसकी उपलब्धता बढ़ाएँगे। — X पर @OpenAI
OpenAI के प्रकाशित आँकड़े पहले कमज़ोरियों का फायदा उठाने की क्षमता और फिर मॉडल के अपनी निर्धारित भूमिका तक सीमित रहने की क्षमता पर केंद्रित हैं: ExploitGym Honeypot लक्ष्य के पास ऐसी सहायक सेवाएँ रखता है जिन पर हमला करना जानबूझकर आसान बनाया गया है, लेकिन मॉडल को उन्हें छोड़ देना चाहिए।
| OpenAI द्वारा प्रकाशित मूल्यांकन | GPT-6 Cyber का स्कोर | तुलना का आधार |
|---|---|---|
| ExploitGym (दी गई कमज़ोरी का दूर से फायदा उठाना) | 48,5 % | GPT-5.6 Cyber के लिए 32,1 % |
| सोर्स कोड तक पहुँच के बिना वेब पैठ परीक्षण | 40,3 % कमज़ोरियाँ दोबारा खोजीं | GPT-6 Astra के लिए 32,0 % |
| RemoteExploitBench (प्रारंभिक मूल्यांकन) | 95 % कार्य सफल | GPT-6 Astra (Daybreak Blue) के लिए 100 % अस्वीकृति |
| ExploitGym Honeypot, तैनाती के प्रॉम्प्ट के बिना | 99,93 % दायरे से बाहर के हमले टाले गए | GPT-5.6 Cyber के लिए 94,49 % |
| SRE-Bench, बाइनरी रिवर्स इंजीनियरिंग (सिस्टम विवरण) | 92,84 % | GPT-6 Astra के लिए 87,98 % |
वास्तविक उपयोग में OpenAI, Linux कर्नेल में स्थानीय विशेषाधिकार बढ़ाने वाले 948 एक्सप्लॉइट (जिनका विवरण नीचे है) और Firefox की 81 नई कमज़ोरियों का उल्लेख करता है, जिन्हें Mozilla ने उच्च गंभीरता वाली श्रेणी में रखा है और जिनके सुधार जारी करने शुरू कर दिए हैं। Cisco, Calif और CodeRabbit की सुरक्षा टीमें कमज़ोरियों की खोज और कोड समीक्षा के लिए पहले से इसका उपयोग कर रही हैं।
सुरक्षा उपाय मज़बूत किए गए हैं: साइबर क्षेत्र में मॉडल के उद्देश्यों से भटकने की विशेष निगरानी, डेटा न रखने की व्यवस्था वाले API ग्राहकों के लिए सामान्यतः अनिवार्य Private Safety Processing (एन्क्रिप्ट किए गए रिकॉर्ड ग्राहक के स्टोरेज में 30 दिनों तक रखे जाते हैं), Daybreak Red के API उपयोग के लिए डिफ़ॉल्ट रूप से आवश्यक अनुमत IP पतों की सूची, और महत्वपूर्ण प्रणालियों पर हमलों में सहायता रोकने के नए नियंत्रण। एक नकली विद्युत संयंत्र पर Dragos के साथ किए गए मूल्यांकनों के बाद, Daybreak Red for Critical Infrastructure नामक समूह महत्वपूर्ण अवसंरचना की सुरक्षा करने वाले अनुमोदित पक्षों को अधिकृत परीक्षण की सुविधा देता है।
GPT-6 Cyber शुरुआत में API और Codex में अनुमोदित Daybreak Red ग्राहकों के एक सीमित समूह को दिया जा रहा है, जिसके बाद इसे धीरे-धीरे ऐसे सभी ग्राहकों तक पहुँचाया जाएगा; GPT-5.6 Cyber उनके लिए अभी से उपलब्ध है। API में gpt-6-cyber की लागत प्रति मिलियन इनपुट टोकन 20 डॉलर (कैश में 2 डॉलर) और आउटपुट के लिए 100 डॉलर है, तथा इसकी संदर्भ विंडो 1 050 000 टोकन की है। OpenAI ने 12 नवंबर को प्रशांत समय के अनुसार सुबह 10 बजे « Cyber at the Frontier » नामक सीधे प्रसारण में और घोषणाएँ करने का वादा किया है।
🔗 GPT-6 Cyber: संरेखित साइबर सुरक्षा एजेंटों की क्षमताओं की सीमा आगे बढ़ाना (OpenAI) · GPT-6 Cyber का सिस्टम विवरण
एक स्वायत्त पाइपलाइन ने 1,2 मिलियन डॉलर में Linux की विशेषाधिकार बढ़ाने वाली 948 कमज़ोरियों की पुष्टि की
4 नवंबर — लॉन्च से एक दिन पहले, OpenAI की साइबर टीम ने एक ऐसे प्रोटोटाइप का वर्णन किया जो मानवीय समीक्षा से पहले बिना हस्तक्षेप के कमज़ोरियों की खोज, एक अलग-थलग वर्चुअल मशीन में उन्हें दोहराने, उनका फायदा उठाए जा सकने का मूल्यांकन और सुधार तैयार करने के चरण पूरे करता है। यह अक्टूबर के मध्य में दस दिनों तक Linux कर्नेल की मुख्य शाखा के सबसे नए संस्करण पर चला, और इसमें वही मॉडल इस्तेमाल हुआ जिसे लॉन्च वाले ट्वीट में GPT-6 Cyber बताया गया है; स्थानीय विशेषाधिकार बढ़ाने वाली इसकी 948 कमज़ोरियों की गिनती अलग-अलग सुधारों के आधार पर की गई है।
| निष्पादन का चरण | प्राप्त परिणाम | API क्रेडिट की लागत |
|---|---|---|
| विश्लेषक एजेंटों द्वारा खोज (12 h) | 2 308 संभावित कमज़ोरियाँ | 316 549 डॉलर |
| गतिशील सत्यापन (30 h) | 1 724 कमज़ोरियाँ दोहराई गईं | 73 330 डॉलर |
| कमज़ोरियों का फायदा उठाना | 1 169 काम करने वाले एक्सप्लॉइट, 948 अलग कमज़ोरियाँ | 775 929 डॉलर |
| पहचान और छँटाई सहित पूरा निष्पादन | विशेषाधिकार बढ़ाने वाली 948 अलग कमज़ोरियाँ | 1 213 430 डॉलर, यानी प्रति कमज़ोरी 1 279 |
जुलाई के अंत में GPT-5.6 Sol ने 513 690 डॉलर में इस प्रकार की केवल 166 कमज़ोरियाँ खोजी थीं और उनका फायदा उठाया था, और दोनों अभियानों के बीच के तीन महीनों में कर्नेल की सुरक्षा और मज़बूत की गई थी। सुरक्षा मज़बूत किए गए कर्नेल वाले Google के कार्यक्रम kernelCTF पर इस प्रणाली ने लगभग 32 936 डॉलर में 112 घंटों के भीतर 21 एक्सप्लॉइट प्राप्त किए। एजेंटों ने कम-से-कम 10 ऐसी तकनीकें इस्तेमाल कीं जिनसे OpenAI और परामर्श लिए गए विशेषज्ञ, दोनों अनजान थे; इनके विवरण गोपनीय रखे गए हैं। OpenAI ने अनुमान के तौर पर कहा है कि Pwn2Own और TyphoonPWN की पुरानी इनाम दरों के अनुसार इन कमज़ोरियों का मूल्य 18,9 से 66,3 मिलियन डॉलर होता। दस दिन पूरे होने तक 61 कमज़ोरियाँ मुख्य परियोजना में पहले ही ठीक की जा चुकी थीं, 43 के सुधार तैयार किए जा रहे थे और 299 पर सार्वजनिक चर्चा चल रही थी।
🔗 रूट अधिकार पाने के एक हज़ार रास्ते कम हुए (OpenAI)
Anthropic ने Claude में Personal Finance पेश किया, Plaid के माध्यम से केवल पढ़ने की अनुमति के साथ अमेरिका में बीटा उपलब्ध
5 नवंबर — Anthropic ने Claude में Personal Finance पेश किया है, जो अमेरिका में Pro, Max और Ultra योजनाओं पर बीटा के रूप में उपलब्ध है। उपयोगकर्ता अपनी पसंद के बैंक खाते और कार्ड जोड़ता है, फिर रोज़मर्रा की भाषा में पैसे से जुड़े प्रश्न पूछता है; Claude उसके अपने शेष और लेन-देन के आधार पर उत्तर देता है।
Introducing Personal Finance in Claude, in beta in the US. Connect the accounts you choose, and Claude answers your money questions in everyday language, from your own balances and transactions. Access is read-only, and Claude can’t move, manage, or invest your money.
🇮🇳 पेश है Claude में Personal Finance, अमेरिका में बीटा के रूप में। अपनी पसंद के खाते जोड़ें और Claude आपके अपने शेष और लेन-देन के आधार पर रोज़मर्रा की भाषा में पैसे से जुड़े आपके प्रश्नों के उत्तर देगा। पहुँच केवल पढ़ने तक सीमित है, और Claude आपके पैसे को न कहीं भेज सकता है, न उसका प्रबंधन कर सकता है, न निवेश कर सकता है। — X पर @claudeai
कनेक्शन Plaid के माध्यम से होता है: उपयोगकर्ता स्वयं अपने बैंक में लॉग इन करता है और वहाँ Claude को पहुँच देने की अनुमति देता है; Claude को कभी बैंक का पासवर्ड दिखाई नहीं देता। चुने गए खातों के लिए Claude बैंक का नाम, हर खाते का नाम, प्रकार और अंतिम चार अंक, शेष राशि, क्रेडिट सीमाएँ और अधिकतम दो साल के लेन-देन पढ़ता है; निवेश, ऋण और कार्ड के लिए वह केवल शेष राशि और सीमाएँ पढ़ता है, निवेश स्थितियाँ या दरें नहीं। यह सुविधा निवेश संबंधी सलाह देने के लिए नहीं बनाई गई है और इसमें न विज्ञापन दिखते हैं, न प्रायोजित सिफ़ारिशें; Anthropic स्पष्ट करता है कि वह क्रेडिट कार्ड, ऋण या बचत खाते उपलब्ध नहीं कराता।
एक समर्पित पृष्ठ खर्चों, नकदी प्रवाह, सदस्यताओं और आगामी बिलों को एक साथ दिखाता है। लेख के उदाहरण में Claude महीने के खर्चों का कुल 4 309,37 डॉलर निकालता है, जिसमें आधे से अधिक किराये और संबंधित खर्च हैं, वेतन आने से पहले होने वाली चार आगामी स्वचालित कटौतियों की सूची देता है और बचने वाली रकम की गणना करता है: 1 393,22 डॉलर। वह दोहरी कटौतियों, अप्रत्याशित शुल्क या बढ़ते बिल की सूचना भी देता है, और चार्ट, भुगतान तिथियों का कैलेंडर या डैशबोर्ड बना सकता है।
| पेशकश का पहलू | घोषित विवरण |
|---|---|
| शामिल योजनाएँ | Pro, Max और Ultra (Free, Team और Enterprise शामिल नहीं) |
| देश और बैंक | अमेरिका, अधिकतम 16 अमेरिकी बैंक |
| लॉन्च की स्थिति | बीटा, इसी सप्ताह से चरणबद्ध उपलब्धता |
| प्लेटफ़ॉर्म | वेब, Claude Desktop, iOS और Android |
| पढ़ा जाने वाला डेटा | अधिकतम 24 महीनों के लेन-देन, केवल पढ़ने की अनुमति |
| मॉडलों का प्रशिक्षण | Personal Finance क्षेत्र की बातचीत शामिल नहीं |
इस क्षेत्र के बाहर सामान्य गोपनीयता सेटिंग लागू होती हैं; सहायता केंद्र के अनुसार, जिस बातचीत में खातों का उपयोग हुआ हो, उसका उपयोग न स्मृति में किया जाता है और न बातचीत के इतिहास में खोज के लिए। जुड़े हुए खातों का उपयोग Cowork, Claude Code या निर्धारित कार्यों में नहीं होता, और यह सुविधा Claude Duet में उपलब्ध नहीं है। Anthropic, Personal Finance को एक पहला कदम बताता है और कहता है कि वह लाइसेंस प्राप्त पेशेवरों और विनियमित संस्थानों के साथ काम करने की संभावनाएँ तलाश रहा है, लेकिन इसके लिए कोई तारीख नहीं दी गई है। Claude अब ChatGPT, Perplexity और Grok के साथ शामिल हो गया है, जो भी Plaid का उपयोग करते हैं।
🔗 Claude में Personal Finance का परिचय · Claude में Personal Finance का उपयोग करें (सहायता केंद्र)
लगातार काम करने वाले एजेंट: Perplexity Teammates और Mistral Studio के प्रबंधित एजेंट
5 नवंबर — Perplexity ने Teammates पेश किए हैं, जो लंबे समय तक चलने वाले काम के लिए व्यक्तिगत एजेंट हैं; इनकी घोषणा पहले Aravind Srinivas ने और फिर Perplexity के आधिकारिक खाते ने की। हर सहकर्मी (teammate) Computer में पहले से मौजूद चीज़ों से शुरुआत करता है: परियोजनाएँ, कौशल, स्मृति, प्लगइन और स्वचालन। उसे एक नाम, एक भूमिका, एक स्थायी निर्देश और ऐसे नियम दिए जाते हैं जो बताते हैं कि उसे कब उपयोगकर्ता से दोबारा संपर्क करना चाहिए; वह काम की योजना बनाता है, Computer सत्रों और दूसरे सहकर्मियों के बीच तालमेल बैठाता है, काम के दौरान परिणामों की जाँच करता है और पूरा काम अनुमोदन के लिए सौंपता है। वह एक निष्पादन से अगले निष्पादन तक लक्ष्यों, कार्यों के इतिहास और फ़ाइलों को एक ही स्थायी संवाद में बनाए रखता है।
Today, we’re launching Perplexity Teammates. They are personal agents for work. And change the paradigm from writing prompts in a session to giving high-level goals. Rolling out to Max users on the web today. Native apps (mobile, desktop) coming soon.
🇮🇳 आज हम Perplexity Teammates पेश कर रहे हैं। ये काम के लिए व्यक्तिगत एजेंट हैं। और ये काम करने का तरीका बदलते हैं: किसी सत्र में प्रॉम्प्ट लिखने से आगे बढ़कर व्यापक लक्ष्य तय करना। आज से वेब पर Max उपयोगकर्ताओं के लिए उपलब्ध कराया जा रहा है। मूल ऐप (मोबाइल, कंप्यूटर) जल्द आ रहे हैं। — X पर @AravSrinivas
Computer से इसका अंतर पहल करने की क्षमता में है। एक सहकर्मी चल रहे काम पर नज़र रखता है और कुछ बदलने पर नए अनुरोध के बिना कार्रवाई करता है: बिक्री का एक सहकर्मी ऐसे नियमित ग्राहक को पहचानता है जिसने खरीदारी बंद कर दी है, उसके ऑर्डर और सहायता अनुरोधों की जाँच करता है, फिर कोई प्रस्ताव तैयार करता है या समस्या की सूचना देता है। अक्सर पूछे जाने वाले प्रश्नों के अनुसार, सहकर्मी पृष्ठभूमि में चौबीसों घंटे काम करते हैं और जब कोई निर्णय ज़रूरी होता है तो सूचित करते हैं। Slack चैनल में जोड़े जाने पर सहकर्मी को दूसरे कर्मचारियों से काम मिलता है, और सहकर्मी एक-दूसरे को काम सौंपते हैं: एक वेबसाइट की त्रुटियाँ खोजता है, दूसरा उनके सुधार तैयार करता है।
| उत्पाद का पहलू | Perplexity द्वारा प्रकाशित विवरण |
|---|---|
| आवश्यक योजना | केवल Perplexity Max |
| प्लेटफ़ॉर्म | 5 नवंबर से वेब पर, मूल ऐप की घोषणा हुई है लेकिन तारीख नहीं दी गई |
| उपयोग की लागत | प्रचार अवधि के दौरान मुफ़्त, फिर Max में शामिल मासिक क्रेडिट से भुगतान |
| अलगाव | हर सहकर्मी का अपना डेस्कटॉप, ब्राउज़र, सत्र और कुकीज़ |
| अनुमतियाँ | Computer के उपकरणों और परियोजनाओं वाली अनुमतियाँ, एन्क्रिप्ट किए गए लॉगिन विवरण |
उपयोगकर्ता काम की समीक्षा कर सकता है, डेस्कटॉप का नियंत्रण अपने हाथ में ले सकता है या बीच में किसी सहकर्मी के काम की दिशा बदल सकता है। प्रचार अवधि समाप्त होने की तारीख नहीं दी गई है, और Perplexity ने आने वाले हफ़्तों में उपलब्धता और सुविधाएँ बढ़ाने का वादा किया है। Teammates, 1 अप्रैल को लॉन्च हुए Slack में Computer और 29 सितंबर को पेश किए गए स्वचालन का विस्तार है।
🔗 Teammates जटिल और लगातार चलने वाले काम के लिए एजेंट हैं (Perplexity) · Perplexity Teammates का उत्पाद पृष्ठ
Mistral ने प्रबंधित एजेंटों और ऐप्लिकेशन के साथ Studio का विस्तार किया और Workflows को सामान्य रूप से उपलब्ध कराया
5 नवंबर — उद्यमों के लिए Mistral अपने एआई प्लेटफ़ॉर्म Studio का विस्तार कर रहा है: प्रबंधित एजेंट (Managed Agents) और ऐप्लिकेशन (Apps) सार्वजनिक पूर्वावलोकन में आ रहे हैं, जबकि अप्रैल के अंत से सार्वजनिक पूर्वावलोकन में मौजूद Workflows अब सामान्य रूप से उपलब्ध हो गया है। ये तीनों घटक 5 नवंबर से Mistral Cloud पर उपलब्ध हैं और नवंबर के अंत में निजी क्लाउड तथा स्थानीय सर्वर पर किए गए परिनियोजनों में उपलब्ध होंगे। प्रबंधित एजेंट Python में mistralai-agents SDK के साथ लिखे जाते हैं: एक बार परिभाषित करने के बाद वही एजेंट अपने सर्वर (agents serve) या Mistral के यहाँ (agents deploy) चलता है, घंटों या दिनों तक पृष्ठभूमि में काम करता है, क्रैश के बाद अपने अंतिम पूरे किए गए चरण से काम फिर शुरू करता है और किसी व्यक्ति की मंज़ूरी का इंतज़ार भी कर सकता है। Studio ऐप्लिकेशन को होस्टिंग, प्रमाणीकरण और पहुँच नियंत्रण प्रदान करता है। रिलीज़ नोट्स में बारह नई सुविधाएँ सूचीबद्ध हैं, जिनमें Mistral Vibe के साथ प्राकृतिक भाषा में वर्कफ़्लो बनाने वाला उपकरण, ऑफ़लाइन और वास्तविक ट्रैफ़िक पर मूल्यांकन, एक प्रबंधित खोज इंडेक्स और वेबहुक शामिल हैं। Mistral ने ABANCA, BNP Paribas, Capgemini और CMA CGM को उन ग्राहकों और साझेदारों के उदाहरणों में गिनाया है जो पहले से Studio का उत्पादन परिवेश में उपयोग कर रहे हैं। कोई मूल्य प्रकाशित नहीं किया गया है और पूर्वावलोकन के दौरान प्रबंधित एजेंटों का API अभी बदल सकता है।
🔗 Le Chonk बुद्धिमत्ता लाता है। Studio उसे काम में लगाता है (Mistral AI)
OpenAI ने Images 2.6 लॉन्च किया: एनिमेटेड GIF, संदर्भ इमेज और 50 % अधिक तेज़ दो API मॉडल
4 नवंबर — Images 2.5 के दो महीने बाद OpenAI ने ChatGPT, Codex और API में Images 2.6 लॉन्च किया, जिसकी घोषणा 4 नवंबर की शाम को प्रकाशित हुई। यह मॉडल 50 % अधिक तेज़ी से इमेज बनाता है और एक संपादन से अगले संपादन तक बारीकियों को बेहतर ढंग से बनाए रखता है, जैसे पृष्ठभूमि बदलते समय किसी पात्र की पोशाक। यह दुनिया भर में ChatGPT और Codex के सभी सदस्यता स्तरों पर, वेब, कंप्यूटर और मोबाइल पर उपलब्ध है।
ChatGPT में दो सुविधाएँ आ रही हैं। GIF बनाने की सुविधा, जिसे अभी चरणबद्ध तरीके से उपलब्ध कराया जा रहा है, किसी प्रॉम्प्ट, इमेज या रेखाचित्र को बार-बार चलने वाले एनिमेशन में बदल देती है। इसमें प्लेबैक की गति समायोजित की जा सकती है और हर फ़्रेम को संपादित किया जा सकता है। सहेजी गई संदर्भ इमेज की मदद से नई बातचीत में किसी फ़ोटो का दोबारा उपयोग किया जा सकता है: अपने कुत्ते की फ़ोटो Pepper नाम से सहेजें, फिर उसे दोबारा भेजे बिना @Pepper का जलरंग चित्र बनाने को कहें।
| API मॉडल | बताई गई प्रमुख खूबी | आउटपुट इमेज, प्रति दस लाख टोकन |
|---|---|---|
gpt-image-2.6-flare | कम गुणवत्ता पर छह सेकंड में एक इमेज, पोस्टर और दृश्य सामग्री का सुव्यवस्थित लेआउट | 30 डॉलर |
gpt-image-2.6-sunburst | मध्यम या उच्च गुणवत्ता पर लगातार संपादनों में बेहतर गुणवत्ता और एकरूपता | 30 डॉलर |
API में दोनों मॉडल इमेज बनाने और संपादित करने, दोनों के काम आते हैं। API में जटिलता का एक पैरामीटर भी जुड़ रहा है, जो मॉडल की योजना बनाने की गहराई तय करता है (कम मान तेज़ संपादन के लिए उपयुक्त है)। इसके साथ SVG निर्यात, एनिमेटेड GIF बनाना और एनोटेशन के निर्देशों के अनुसार संपादन भी उपलब्ध हो रहा है; अंतिम सुविधा संगत GPT Image 2.5 मॉडल के लिए भी खुली है। दरें GPT-Image-2.5 Flare जैसी हैं: इनपुट टेक्स्ट के प्रति दस लाख टोकन पर 5 डॉलर और इनपुट इमेज के प्रति दस लाख टोकन पर 8 डॉलर। OpenAI के अनुसार ChatGPT, Codex और API के ज़रिए हर हफ़्ते 4 अरब इमेज बनाई जाती हैं, यानी प्रतिदिन आधे अरब से अधिक। OpenArt, Figma Weave, Picsart, fal, Sable और Higgsfield को शुरुआती पहुँच मिली थी और HeyGen ने अगले ही दिन इसे एकीकृत कर लिया (संक्षिप्त समाचार देखें)।
🔗 Images 2.6 का परिचय (OpenAI) · ChatGPT के रिलीज़ नोट्स
Google ने Gemini Omni 1.2 Flash को सामान्य रूप से उपलब्ध कराया: 15 सेकंड के वीडियो और कीमत में 30 % की कमी
5 नवंबर — Google ने वीडियो बनाने और संशोधित करने वाले अपने मॉडल का नया संस्करण Gemini Omni 1.2 Flash, Gemini API (gemini-omni-1.2-flash, केवल सशुल्क स्तर) और Gemini for business में सामान्य रूप से उपलब्ध करा दिया है। Google के अनुसार यह पहली बार है जब Gemini Omni, Provisioned Throughput समेत Google Cloud के बुनियादी ढाँचे के साथ सामान्य रूप से उपलब्ध हुआ है; हर आउटपुट पर SynthID वॉटरमार्क होता है।
मॉडल मूल रूप से 15 सेकंड के क्लिप बनाता और संशोधित करता है, जबकि Omni 1.1 की सीमा 10 सेकंड थी। अवधि 3 से 15 सेकंड के बीच एक-एक सेकंड के अंतर से तय की जा सकती है। यह अपने संदर्भों को बेहतर ढंग से बनाए रखता है (पात्र, उत्पाद या शैली की इमेज, गति के छोटे क्लिप, ऑडियो संकेत और API में अधिकतम 6 संदर्भ इमेज) और अचानक कट (जंप कट) कम करता है। कई चरणों वाली बातचीत के ज़रिए संपादन पूरे 15 सेकंड के क्लिप पर काम करता है, जिसमें संवाद अधिक स्वाभाविक हैं और होंठों का तालमेल अधिक सटीक है। API में किसी क्लिप को बढ़ाने पर हर चरण में 3 से 10 सेकंड जुड़ते हैं, कुल अधिकतम 30 सेकंड तक, और सशुल्क स्तर की अनुरोध दर सीमाएँ दोगुनी हो रही हैं।
| तुलना किया गया पैरामीटर | Omni 1.1 Flash | Omni 1.2 Flash |
|---|---|---|
| मूल रूप से समर्थित अधिकतम अवधि | 10 सेकंड | 15 सेकंड |
| वीडियो आउटपुट, प्रति दस लाख टोकन | 17,50 डॉलर | 12 डॉलर |
| 720p पर प्रभावी कीमत | लगभग 0,10 डॉलर प्रति सेकंड | लगभग 0,07 डॉलर प्रति सेकंड |
इस तरह Google ने 30 % की कमी की घोषणा की है: 720p में 15 सेकंड के क्लिप की लागत लगभग 1,04 डॉलर आती है, जबकि प्रति सेकंड लागत 360p में 0,023 डॉलर और अपसैंपल किए गए 4K में 0,209 डॉलर है। 3 दिसंबर को gemini-omni-1.1-flash पर भेजे गए सभी अनुरोध 1.2 की ओर भेजे जाएँगे और उन्हीं की दर से शुल्क लिया जाएगा। आम उपयोगकर्ताओं के लिए मॉडल Flow, Google Vids, Google Ads और सभी Google AI ग्राहकों के लिए Gemini ऐप में आ रहा है। Google Vids में Google खाते या Workspace सदस्यता के साथ 15 सेकंड के क्लिप पर कोई अतिरिक्त लागत नहीं आती, जबकि Gemini ऐप में 15 सेकंड के वीडियो केवल Google AI Ultra के लिए उपलब्ध हैं। Runway ने इसे उसी दिन जोड़ लिया (संक्षिप्त समाचार देखें)। Google मानता है कि तेज़ खेल गतिविधियों, स्क्रिप्ट में तेज़ बदलावों और जटिल भौतिकी में अभी सुधार की ज़रूरत है और उसने कोई बेंचमार्क प्रकाशित नहीं किया है।
🔗 Gemini Omni 1.2 Flash का परिचय (Google) · Gemini Omni 1.2 Flash की दरें
Luma ने MCP कनेक्टर के ज़रिए अपने रचनात्मक वर्कफ़्लो Claude और ChatGPT से जोड़े
3 नवंबर — Luma ने एक MCP कनेक्टर लॉन्च किया है, जो उसके रचनात्मक उपकरणों को Claude और ChatGPT में लाता है; 3 नवंबर को प्रकाशित और 4 नवंबर को अपडेट किए गए लेख को Luma ने 5 नवंबर को साझा किया। कनेक्टर से Luma Agent तक पहुँच मिलती है, जिसे एक ही प्रॉम्प्ट से पूरे प्रोजेक्ट का संचालन करने में सक्षम बताया गया है, और Luma के पहले से तय वर्कफ़्लो तक भी: Product Shots, Camera Angles, Background swap, Relight Studio और छोटे प्रचार क्लिप। तैयार इमेज और वीडियो बातचीत में वापस आ जाते हैं। जिस उपयोग का उदाहरण प्रमुखता से दिया गया है, वह मार्केटिंग के लिए है: असिस्टेंट से पूछें कि पिछले हफ़्ते कौन-सा विज्ञापन सबसे अच्छा चला, फिर Luma से सबसे सफल विज्ञापन के नए दृश्य, नए कोण और नई रोशनी वाले रूप बनवाएँ। Luma खाता एक बार कनेक्ट करना होता है और हर सामग्री निर्माण पर Luma सदस्यता के क्रेडिट खर्च होते हैं; कनेक्टर के लिए अलग शुल्क नहीं है। Luma ने 8 अक्टूबर को ही Claude Motion से एक MCP कनेक्टर जोड़ दिया था; नई बात ChatGPT, पहले से तय वर्कफ़्लो और Luma Agent हैं, जो अब दोनों असिस्टेंट में उपलब्ध हैं। Luma अब Runway, Synthesia, Suno और HeyGen के साथ जुड़ गया है, जिन्होंने हाल के हफ़्तों में अपने उपकरण असिस्टेंट से जोड़े हैं।
🔗 Luma को ChatGPT और Claude से जोड़ें (Luma)
Ricursive Intelligence ने Ripple-65B Preview जारी किया, एजेंट आधारित कोडिंग पर केंद्रित एक सघन ओपन वेट मॉडल
4 नवंबर — Ricursive Intelligence, एक प्रयोगशाला जिसका इस समाचार संकलन में अब तक उल्लेख नहीं हुआ था, ने Ripple-65B Preview जारी किया है: 65 अरब पैरामीटर वाला एक सघन भाषा मॉडल, जिसे शुरुआत से 12 000 अरब टोकन पर पूर्वप्रशिक्षित किया गया है। यह Apache 2.0 लाइसेंस के तहत है और अधिकतम 1 048 576 टोकन का कॉन्टेक्स्ट संभालता है। रिलीज़ में BF16 और NVFP4 में निर्देशों पर प्रशिक्षित मॉडल, केवल पूर्वप्रशिक्षण से बना एक बेस मॉडल और स्पेक्युलेटिव डिकोडिंग के लिए एक छोटा DFlash2 ड्राफ़्ट मॉडल शामिल हैं। Ricursive खुद को ऐसी प्रयोगशाला बताती है जो हार्डवेयर, सॉफ़्टवेयर और मॉडल को साथ मिलाकर अनुकूलित करती है। Ripple-65B Preview, एआई से चिप डिज़ाइन करने वाले उसके प्लेटफ़ॉर्म के मालिकाना मॉडल का सामान्य उपयोग वाला संस्करण है।
प्रमुखता से बताए गए आँकड़े एजेंट आधारित कोडिंग के हैं: Terminal-Bench 2.1 पर 80,5 %, SWE-Bench Pro v2.0-Hard पर 79,1 % और DeepSWE v1.1 पर 44,3 %। Ricursive इस क्षेत्र में अमेरिकी ओपन वेट मॉडल में सबसे आगे होने का दावा करती है, उन कहीं बड़े मॉडल से भी आगे जो विशेषज्ञों के मिश्रण (Mixture-of-Experts, MoE) पर आधारित हैं; यह दावा अमेरिकी खुले मॉडल तक सीमित है, सभी खुले मॉडल के बारे में नहीं है।
| विशेषता (Ricursive की विवरण सूची) | Ripple-65B Preview | Reflection Beam | Muse Spark Open | Inkling | Nemotron 3 Ultra |
|---|---|---|---|---|---|
| मॉडल आर्किटेक्चर | सघन | MoE | MoE | MoE | MoE |
| कुल पैरामीटर | 65B | 501B | 816B | 975B | 550B |
| सक्रिय पैरामीटर | 65B | 23B | 42B | 41B | 55B |
| Terminal-Bench 2.1 | 80,5 | 80,1 | 76,4 | 63,8 | 56,4 |
| GPQA Diamond | 85,2 | 90,6 | 89,0 | 87,2 | 87,0 |
Ricursive इसे उपलब्ध साधनों के आधार पर किया गया सर्वोत्तम प्रयास (यथासंभव तुलना) बताती है: जहाँ प्रतिस्पर्धियों के आधिकारिक स्कोर उपलब्ध हैं, वहाँ उनका उपयोग हुआ है, अन्यथा आंतरिक मूल्यांकन किया गया है। परीक्षणों के अनुसार अलग-अलग हार्नेस इस्तेमाल हुए हैं और आधिकारिक Terminus 2 हार्नेस के साथ Muse Spark Open को छोड़कर सभी के Terminal-Bench 2.1 स्कोर कम हैं। सामान्य ज्ञान (GPQA Diamond) में Ripple अपने प्रतिस्पर्धियों से पीछे रहता है।
यह प्रशिक्षण विधि एक छोटी टीम ने तैयार की, जो एक व्यक्ति से बढ़कर पाँच लोगों की हुई है। Ricursive ने Ai2 के खुले मॉडल Olmo 3 की प्रशिक्षण विधि से शुरुआत की और उसे हर स्तर पर बदला (स्केलिंग के नियम, आर्किटेक्चर, डेटा और प्रशिक्षण के बाद की प्रक्रिया): उसका कहना है कि Olmo 3 मॉडल श्रृंखला की तुलना में उसने कोडिंग के लिए गणना दक्षता 16 गुना और पूरे प्रशिक्षण के लिए 55 गुना तक बढ़ाई है। बुनियादी ढाँचे को सरल बनाने के लिए मॉडल विशेषज्ञों के मिश्रण के बजाय सघन है। इसमें Gemma 3N से प्रेरित संकीर्ण और गहरा आर्किटेक्चर (80 परतें) है तथा प्रशिक्षण BF16 में, स्वयं विकसित कंप्यूट कर्नेल के बिना किया गया है। अपेक्षाकृत हल्के प्रशिक्षणोत्तर चरण में रीइन्फ़ोर्समेंट लर्निंग के 1,4 मिलियन क्रमिक प्रयासों (रोलआउट) के साथ Terminal-Bench 2.1 पर 80,5 का स्कोर मिला, जो Ricursive के अनुसार Reflection Beam से लगभग 70 गुना कम प्रयास हैं।
मॉडल बिना क्वांटाइज़ेशन के दो B200 पर प्रति सेकंड 250 टोकन बनाता है (8 के बैच में) और NVFP4 चेकपॉइंट के साथ एक DGX Spark पर समा जाता है। Together AI इसे 5 नवंबर से अपने प्लेटफ़ॉर्म पर 128K टोकन की विंडो के साथ उपलब्ध करा रहा है, जहाँ इनपुट के प्रति दस लाख टोकन पर 0,20 डॉलर और आउटपुट पर 0,60 डॉलर की दर है। Atomic Chat ने इसे llama.cpp में पोर्ट करके पहला GGUF भी प्रकाशित कर दिया है।
🔗 X पर Ricursive की घोषणा · Hugging Face पर Ripple-65B Preview · Together AI पर Ripple-65B Preview
कोडिंग एजेंट: Devin Review 2.0, Cursor में ऑनलाइन ऐप्लिकेशन, Replit की microVM और Qwen Code v0.26.8
Cognition ने Devin Review 2.0 लॉन्च किया, PR समीक्षा सस्ती हुई और अब डिफ़ॉल्ट रूप से केवल बदलावों की समीक्षा होगी
5 नवंबर — Cognition ने Devin Review 2.0 लॉन्च किया है और Devin के साथ काम करते समय इसे पुल रिक्वेस्ट की समीक्षा का डिफ़ॉल्ट उपकरण बना दिया है। लेख के शीर्षक में अगस्त से समीक्षा पाँच गुना सस्ती होने की बात कही गई है और इसी अवधि में प्रति PR लागत में 82 % की कमी बताई गई है, जिसका श्रेय मॉडल के बेहतर मिश्रण और हार्नेस के अनुकूलन को दिया गया है; वहीं @cognition की घोषणा श्रृंखला में समीक्षा पाँच गुना तक सस्ती होने की बात है। एक सामान्य समीक्षा की लागत 0,25 से 0,75 डॉलर के बीच होती है और ग्राहकों के लिए एक बग ठीक करने की औसत लागत लगभग 2,25 डॉलर आती है। Cognition के अनुसार प्रति PR पाए गए बग की औसत संख्या 1,22 से बढ़कर 1,32 हो गई है और प्रतिक्रिया में देरी का माध्यिका मान 139 से घटकर 94 सेकंड हो गया है। समीक्षा अब डिफ़ॉल्ट रूप से क्रमिक है: नए दौर में केवल बदले हुए हिस्से दोबारा पढ़े जाते हैं, लगभग 80 % PR की लागत सभी पुश समेत एक डॉलर से कम रहती है और प्रति PR खर्च की अधिकतम सीमा लागत को अनियंत्रित होने से रोकती है। इसके साथ Devin Review Ultra भी जुड़ रहा है, जो संवेदनशील कोड (बिलिंग, सुरक्षा) के लिए अधिक गहराई से काम करने वाला और अधिक महँगा स्तर है, तथा अनुकूलित समीक्षक (Custom Reviewers) बीटा में आ रहे हैं; कोई नई दर प्रकाशित नहीं की गई है।
🔗 Devin Review 2.0 (Cognition)
Cursor ऑनलाइन ऐप्लिकेशन बनाता है, होस्ट करता है और साझा करता है
5 नवंबर — Cursor अब ऑनलाइन ऐप्लिकेशन बनाने और उन्हें एक लिंक से साझा करने की सुविधा देता है। Cursor के अनुसार शुरुआती समस्या यह है: एजेंटों ने कोड की लागत घटाई है, लेकिन बनाए गए अधिकतर उपकरण स्थानीय मशीन (localhost) से बाहर ही नहीं जाते। किसी क्लाउड एजेंट को स्पष्ट रूप से ऐप्लिकेशन बनाने का निर्देश देकर शुरू किया जाता है: Cursor उसका ढाँचा तैयार करता है, ज़रूरत पड़ने पर Postgres डेटाबेस बनाता है, प्रमाणीकरण के लिए Cursor लॉगिन लगाता है और उसे एक समर्पित खाते में होस्ट करता है, जो दूसरी टीमों के खातों से अलग होता है। चुने गए डोमेन पर ऑनलाइन किए जाने से पहले चार नियतात्मक जाँचों (फ़ाइलों में लिखे सीक्रेट, क्रेडेंशियल फ़ाइलें, .env फ़ाइलें और सोर्स मैप) और एआई द्वारा सुरक्षा समीक्षा का सफल होना ज़रूरी है, फिर उपयोगकर्ता स्पष्ट रूप से उसे प्रकाशित करता है। व्यवस्थापक सभी ऐप्लिकेशन और सभी सीक्रेट देख सकते हैं, समीक्षा के अपने नियम जोड़ सकते हैं और किसी भी ऐप्लिकेशन का प्रकाशन हटा सकते हैं। ऐप्लिकेशन व्यक्तियों, समूहों, टीम या आम जनता के साथ साझा किए जा सकते हैं; आम जनता के साथ साझा करना Teams और Enterprise में डिफ़ॉल्ट रूप से बंद है। यह सुविधा क्लाउड एजेंट वाले सभी सशुल्क प्लान पर Cursor Origin या GitHub से उपलब्ध है और GitLab के लिए जल्द आने की घोषणा की गई है; होस्टिंग की कोई कीमत नहीं बताई गई है।
🔗 Cursor में ऑनलाइन ऐप्लिकेशन बनाएँ · ऐप्लिकेशन के बारे में Cursor का दस्तावेज़ीकरण
Replit अपने सैंडबॉक्स इंजन को microVM के आधार पर दोबारा लिखता है, हर microVM का अपना Linux कर्नेल है
4 नवंबर — Replit अपने नए सैंडबॉक्स इंजन पर एक शृंखला का पहला भाग प्रकाशित करता है, जिसे 4 नवंबर की शाम ऑनलाइन डाला गया और अगले दिन साझा किया गया। अब हर सैंडबॉक्स एक microVM है, यानी अपने Linux कर्नेल वाली एक हल्की वर्चुअल मशीन; पहले कंटेनर होस्ट का कर्नेल साझा करते थे। Replit का कहना है कि उसने करोड़ों परियोजनाओं को बिना डेटा खोए स्थानांतरित किया है। Cloud Hypervisor मॉनिटर के कुछ घटक Firecracker के साथ साझा हैं, और tinyconfig से बनाया गया अतिथि कर्नेल Bluetooth, USB और डिस्प्ले ड्राइवर के बिना काम करता है।
| Linux कर्नेल की CVE का ऑडिट (1 जून से 4 नवंबर 2026) | Replit के अनुसार मान |
|---|---|
| प्रकाशित और ऑडिट की गई CVE | 6 211 |
| नए इंजन से टाली गई CVE | 5 969 (96,1 %) |
| खुलासे से पहले शामिल किए गए पैच | 4 375 (70,4 %) |
| कर्नेल के कॉन्फ़िगरेशन से बाहर हुई CVE | 676 (10,9 %) |
CVE-2026-98432, वह TCP खामी जिसका दुरुपयोग Anthropic ने करके दिखाया था, के लिए सुधारा हुआ कर्नेल 12 अक्टूबर से ही लागू था। नेटवर्क से बाहर जाने वाले ट्रैफ़िक के नियम अतिथि मशीन के बाहर, होस्ट की ओर मौजूद एक प्रॉक्सी से लागू होते हैं, और क्रेडेंशियल मध्यस्थ GitHub या Google Docs को कॉल करते हैं, लेकिन खाते की कुंजी कभी सैंडबॉक्स को नहीं देते। एक सैंडबॉक्स लगभग 500 मिलीसेकंड में मिल जाता है; दूसरा भाग Kubernetes के साथ हज़ारों की संख्या में microVM के संचालन पर होगा।
🔗 Replit के नए सैंडबॉक्स इंजन के भीतर, भाग 1
Qwen Code v0.26.8 अब Qwen की Plus और Pro सदस्यताओं से जुड़ता है
5 नवंबर — Qwen Code v0.26.8 में Qwen खाते से जुड़ने की सुविधा वापस आती है, जो अब सदस्यता से जुड़ी है। CLI, VS Code एक्सटेंशन और Desktop ऐप में « सदस्यता वाला Qwen खाता » विकल्प से chat.qwen.ai पर ली गई Plus या Pro सदस्यता को API कुंजी के बिना इस्तेमाल किया जा सकता है: क्लाइंट खाते की मॉडल सूची लोड करता है, बातचीत और अंतर्निहित वेब खोज के लिए सदस्यता का उपयोग करता है, और प्रमाणीकरण, कोटा या अनुरोध दर की सीमा से जुड़ी त्रुटि आने पर उपयोगकर्ता का मार्गदर्शन करता है। इसे जोड़ने वाले मर्ज अनुरोध के अनुसार, यह तरीका पुरानी मुफ़्त OAuth सेवा के बंद होने के जवाब में लाया गया है; न रिलीज़ नोट और न ही दस्तावेज़ बताते हैं कि वह सेवा कब बंद हुई या सदस्यता योजनाओं की कीमत क्या है, और CI तथा कंटेनर अब भी API कुंजी का उपयोग करते हैं। मौजूदा संगतता तोड़ने वाले किसी बदलाव के बिना इस स्थिर संस्करण में 83 प्रविष्टियाँ हैं, जिनमें 14 सुविधाएँ, 37 सुधार और प्रदर्शन के 13 अनुकूलन शामिल हैं: Mods अपने प्रॉम्प्ट दे सकते हैं, और किसी परियोजना से मिलने वाले हुक अब अनुमोदन वाले संवाद बॉक्स से होकर गुज़रते हैं। Desktop ऐप v0.26.8 और TypeScript SDK v0.1.28 भी उसी दिन जारी होते हैं।
तेज़ इन्फ़रेंस: NVIDIA का Vera CPU, Meta का sgl-muse-mega और वास्तविक समय में Runway Characters
NVIDIA एजेंट के लिए अपने Vera CPU की x86 पर बढ़त के आँकड़े देता है
5 नवंबर — NVIDIA एजेंट के लिए बनाए गए अपने प्रोसेसर Vera पर नए आँकड़े प्रकाशित करता है। किसी एजेंट का हर चरण—खोज करना, डेटाबेस से जानकारी माँगना, कोड लिखना और जाँचना, कार्रवाई करना—CPU पर चलता है, और चूँकि एआई फ़ैक्टरियों में ऊर्जा की सीमा होती है, NVIDIA प्रति वाट पूरे हुए काम को मापता है। अपनी तुलना में, 100 मेगावाट के डेटा सेंटर के पैमाने पर, एक Vera CPU सबसे तेज़ x86 के मुकाबले प्रति वाट 1,6 गुना अधिक एजेंट चला सकता है और सबसे कम ऊर्जा खपत करने वाले x86 के मुकाबले एजेंट को दोगुना तेज़ बना सकता है; दोनों में से किसी का नाम नहीं दिया गया है। NVIDIA छह साझेदारों के नतीजे भी बताता है:
| NVIDIA द्वारा बताया गया साझेदार | Vera के साथ बताया गया परिणाम |
|---|---|
| Perplexity | पारंपरिक CPU के मुकाबले एजेंट द्वारा कोडिंग 1,5 गुना तेज़, तैनाती की योजना है |
| DeepInfra | एजेंट संचालन में सबसे अच्छे x86 के मुकाबले 2,2 गुना तक गति |
| ClickHouse | 176 कोर पर क्षमता में लगभग रैखिक वृद्धि, ClickBench की रैंकिंग में शीर्ष पर |
| DuckLabs | TPC-H SF1000 पर Intel Xeon 6 के माध्यिका प्रदर्शन का लगभग 1,5 गुना |
| Daytona | 1 000 सैंडबॉक्स 10,8 s में चालू, जबकि x86 पर 88,4 s लगते हैं |
| Modal | तुलनीय x86 के मुकाबले प्रति कोर सैंडबॉक्स का 2 गुना तक थ्रूपुट |
लेख में न कीमत दी गई है और न समय-सारिणी; Vera को जनवरी में CES में पेश किया गया था, फिर अगस्त के अंत में AWS को दिया गया।
🔗 Vera दोनों पक्षों की बेहतरीन खूबियाँ देता है (NVIDIA)
Meta बिना घोषणा के sgl-muse-mega प्रकाशित करता है, जो GB300 पर Muse Spark Open की डिकोडिंग 2,1 गुना तक तेज़ करता है
5 नवंबर — Meta ने facebookresearch के GitHub पर MIT लाइसेंस के तहत और बिना घोषणा के sgl-muse-mega प्रकाशित किया है: यह SGLang इन्फ़रेंस इंजन का एक प्लगइन है, जो GB300 GPU पर उसके खुले वज़न वाले मॉडल Muse Spark Open को चलाता है। इस मॉडल में 816 अरब पैरामीटर हैं, जिनमें 42 अरब सक्रिय हैं। डिकोडिंग के हर चरण में सैकड़ों छोटे गणना कर्नेल (कर्नेल) चलाने के बजाय, यह डिकोडर की हर परत को एक ही बार में लॉन्च करता है, और DFlash2 ड्राफ़्ट, जाँच तथा स्पेक्युलेटिव डिकोडिंग की स्वीकृति को एक ही CUDA ग्राफ़ में जोड़ता है। README के अनुसार, आठ GB300 पर GSM8K में एक अकेला अनुरोध प्रति सेकंड 1 109 टोकन तक पहुँचता है, जबकि उसी ड्राफ़्ट के साथ SGLang 517 तक पहुँचता है, यानी 2,1 गुना अधिक; डिकोडिंग का एक चरण 12,9 ms और 1 450 कर्नेल से घटकर 5,9 ms और 97 कर्नेल रह जाता है। यह लाभ एक समय में केवल एक अनुरोध की डिकोडिंग पर लागू होता है (अन्य अनुरोध फिर SGLang पर चले जाते हैं), उपकरण को प्रायोगिक चिह्नित किया गया है और इसके लिए एक ही NVLink डोमेन में आठ GB300, या एक नोड पर चार चाहिए।
🔗 sgl-muse-mega (facebookresearch)
Runway चार H100 पर Runway Characters का 57B वीडियो मॉडल वास्तविक समय में चलाता है
5 नवंबर — Runway Research एक लेख और arXiv शोधपत्र प्रकाशित करता है, जिसमें बताया गया है कि Runway Characters वास्तविक समय में कैसे काम करता है। ये उसके वीडियो पात्र हैं, जिनसे एक ही तस्वीर के आधार पर सीधे बातचीत की जा सकती है। लगभग 57B पैरामीटर वाले एक ऑटोरेग्रेसिव वीडियो डिफ़्यूज़न ट्रांसफ़ॉर्मर को एक अकेले उपयोगकर्ता के लिए 24 फ़्रेम प्रति सेकंड की दर से, हर 166,7 ms में 704x1088 आकार के चार फ़्रेम का एक खंड बनाना होता है: कई उपयोगकर्ताओं के अनुरोधों को समूह में संसाधित करना संभव नहीं है, इसलिए हर मिलीसेकंड की बचत उसी चरण में करनी पड़ती है। बचत का पहला स्रोत कैश था: GPU का 29 % समय, अटेंशन की 240 कॉल में से हर एक में, लगभग अपरिवर्तित कैश को दोबारा संसाधित करने में लगता था। रिंग कैश में लिखते समय RoPE और FP8 क्वांटाइज़ेशन केवल एक बार लागू करके, Runway उसके रखरखाव का समय प्रति चरण 69,7 से घटाकर 6,2 ms कर देता है।
| Runway द्वारा मापा गया कॉन्फ़िगरेशन | डिफ़्यूज़न के एक चरण की अवधि |
|---|---|
| लॉन्च के समय का सॉफ़्टवेयर, चार H100 पर | 240,9 ms |
| अनुकूलन के बाद, चार H100 पर | 159,3 ms (24,5 images/s) |
| रिडक्शन और FP8 गणना को जोड़ने वाले कर्नेल के साथ | 147,4 ms |
| तीन B200 पर | 154,3 ms |
अब एक सत्र चार H100 पर चल जाता है, जबकि लॉन्च के समय आठ की ज़रूरत थी। उत्पादन में सात हफ़्तों के दौरान, 99,5 % सत्रों में औसत दर 23,5 फ़्रेम प्रति सेकंड से अधिक रही, और बातचीत के एक दौर का माध्यिका समय 2,13 s है, जिसमें वॉइस एजेंट के 1,42 s शामिल हैं।
🔗 एक के बैच आकार पर वास्तविक समय में वीडियो (Runway) · arXiv शोधपत्र 2611.05642
खुली रोबोटिक्स: Hugging Face का LeRobot v0.7.0 और Ai2 का ToyBlocks
Hugging Face ने LeRobot v0.7.0 जारी किया, जिससे काम करते रोबोट से बातचीत की जा सकती है
5 नवंबर — Hugging Face अपनी खुली रोबोटिक्स लाइब्रेरी का नया संस्करण LeRobot v0.7.0 प्रकाशित करता है, ऐसे समय में जब Hub पर LeRobot प्रारूप में भौतिक एआई का लगभग 300 टेराबाइट डेटा मौजूद है। संवादात्मक सत्रों में काम करते रोबोट से बात की जा सकती है: /subtask उसे रोके बिना निर्देश बदलता है, /vqa पॉलिसी से पूछता है कि उसे क्या दिखाई दे रहा है और /autosteer उसे एक लक्ष्य सौंपता है। अंतिम दो कमांड के लिए पाठ उत्पन्न करने वाली पॉलिसी चाहिए, जैसे FineART-VLA, जिसे Scale AI और Hugging Face के FineART डेटासेट पर प्रशिक्षित किया गया है (दो भुजाओं से की गई क्रियाओं के 1 718 घंटे, 533 000 से अधिक एनोटेट किए गए उपकार्य), या फिर कोई बाहरी VLM योजनाकार चाहिए। प्रशिक्षण के लिए डेटासेट बिना डाउनलोड किए Hub या LanceDB से स्ट्रीम के रूप में पढ़े जाते हैं, और स्टैक FSDP2 तथा HSDP पर चला जाता है: 6B वाले FastWAM मॉडल पर प्रशिक्षण फिर शुरू करते समय प्रति GPU अधिकतम मेमोरी खपत 143 से घटकर 42 गीगाबाइट रह जाती है। यह संस्करण चार वर्ल्ड ऐक्शन मॉडल (NVIDIA के Cosmos 3 और Long-WAM, Black Forest Labs का FLUX 3 Action, RLinf का LaWAM) और चार विज़न-लैंग्वेज-ऐक्शन पॉलिसियाँ जोड़ता है, जिनमें LingBot-VLA 2.0 और Wall-OSS-0.5 शामिल हैं। इससे कई मौजूदा उपयोगों की संगतता टूटती है: CUDA 13 के लिए संकलित PyTorch, असिंक्रोनस इन्फ़रेंस की जगह पॉलिसी सर्वर और Weights & Biases की जगह Trackio।
🔗 LeRobot v0.7.0 (Hugging Face ब्लॉग)
Ai2 ने बिना घोषणा के ToyBlocks ऑनलाइन डाला, यह सिमुलेशन ढाँचा रोबोट के लिए प्रदर्शन तैयार करता है
5 नवंबर — Ai2 ने 4 नवंबर की शाम से 5 नवंबर के बीच, बिना घोषणा के, ToyBlocks के घटक ऑनलाइन डाले हैं: IsaacSim और IsaacLab पर बना एक खुला सिमुलेशन ढाँचा, जिसमें एक रोबोटिक भुजा मेज़ पर ब्लॉक धकेलती है, पलटती है और एक के ऊपर एक रखती है। इसकी उपयोगिता टेलीऑपरेशन की जगह कार्यों और प्रदर्शनों को अपने आप तैयार करने में है: प्रकाशित डेटासेट में तीन ब्लॉक एक के ऊपर एक रखने के 83 496 सफल प्रदर्शन हैं, यानी 143,7 मिलियन फ़्रेम और लगभग 1 600 घंटे, कठिनाई के तीन स्तरों पर, तथा हर स्तर के लिए 1 000 एपिसोड वाले सत्यापन डेटासेट हैं। इसके साथ दो मॉडल हैं: Molmo2-4B-tb, जो फ़ाइन-ट्यून किया गया Molmo2-4B है और कैमरे की तस्वीर तथा लक्ष्य पढ़ता है, एक छोटी योजना बताता है और लगभग 6 Hz पर अगली क्रिया (उठाना, रखना, पलटना, घुमाना) तथा उसका लक्ष्य बताता है; और ManiFlow पॉलिसी, जो इन क्रियाओं को अंजाम देती है। रिपॉज़िटरी में दिए गए ब्लॉग लेख पर जाँच के समय 404 त्रुटि आ रही थी और तकनीकी रिपोर्ट जल्द आने की घोषणा की गई है।
Anthropic ने 207 049 शोध सत्रों के आधार पर मापा कि वैज्ञानिक Claude का उपयोग कैसे करते हैं
5 नवंबर — Anthropic की अर्थशास्त्र टीम Claude के वैज्ञानिक उपयोग पर एक रिपोर्ट प्रकाशित करती है। यह 2 अगस्त से 30 सितंबर 2026 के बीच आम उपभोक्ताओं की सदस्यता योजनाओं के 207 049 शोध सत्रों पर आधारित है, जिनका विश्लेषण ऐसे वर्गीकारकों ने किया जो केवल क्षेत्र और कार्य के लेबल रखते हैं। औपचारिक विज्ञानों में Claude का उपयोग वैश्विक शोध में उनकी हिस्सेदारी से कहीं अधिक है: Claude Code के सत्रों में कंप्यूटर विज्ञान का हिस्सा 32,7 % है, जबकि दुनिया के शोधकर्ताओं में इस क्षेत्र का हिस्सा 4,3 % है।
| देखा गया माप | Claude पर (Chat और Cowork) | Claude Code पर |
|---|---|---|
| विश्लेषित सत्र | 128 914 | 78 135 |
| डेटा विश्लेषण का हिस्सा | 33,7 % | 48,1 % |
| विचार विकसित करने और परिकल्पनाओं का हिस्सा | 4,2 % | 2,1 % |
वैज्ञानिक मुख्य रूप से डेटा का विश्लेषण करने और लिखने के लिए Claude का उपयोग करते हैं, परिकल्पनाएँ बनाने के लिए बहुत कम, जबकि सर्वेक्षण में शामिल 528 शोधकर्ता विचार विकसित करने और डेटा एकत्र करने को सबसे महत्त्वपूर्ण कार्यों में रखते हैं; Claude Science पर विचार विकसित करने का हिस्सा Claude के मुकाबले लगभग दोगुना है। रिपोर्ट कुछ परिदृश्य प्रस्तुत करती है जिन्हें उदाहरण के रूप में बताया गया है, पूर्वानुमान के रूप में नहीं: यदि मौजूदा क्षमताओं को व्यापक तौर पर अपनाया जाए, तो शोध उत्पादन कला में 1,35 गुना से लेकर सांख्यिकी में 2,02 गुना हो सकता है; यदि एआई सभी गैर-भौतिक काम सँभाल ले, तो प्रयोगशाला की मेज़ पर काम की ज़रूरत न पड़ने वाले क्षेत्रों में यह 15 से 16 गुना हो सकता है, जबकि जीवविज्ञान या रसायन विज्ञान में 3 से 4 गुना। सर्वेक्षण में शामिल लगभग 40 % शोधकर्ताओं को उम्मीद है कि 2030 तक एआई अकेले शोध परियोजनाएँ चला रहा होगा।
🔗 वैज्ञानिक खोज के लिए एआई: शोधकर्ता Claude का उपयोग कैसे करते हैं (Anthropic)
OpenAI अपने कंप्यूटिंग परिसरों की मेज़बानी करने वाले समुदायों के साथ समझौता प्रकाशित करता है
5 नवंबर — OpenAI समुदायों के साथ एक राष्ट्रीय समझौता (National Community Compact) और कंप्यूटिंग परिसरों के लिए एक सार्वजनिक नीति योजना (Compute Campus Policy Blueprint) प्रकाशित करता है। भविष्य में OpenAI के स्वामित्व और संचालन वाले हर परिसर का अपना स्थानीय समझौता होगा, जिसमें परियोजना को प्रभावित करने के लिए पर्याप्त शुरुआती चरण में परामर्श, एक स्थानीय संपर्क व्यक्ति और एक वार्षिक सार्वजनिक रिपोर्ट शामिल होगी। OpenAI आवश्यक बिजली और बुनियादी ढाँचे की पूरी लागत चुकाने, परियोजना में देरी होने, उसका आकार घटने या उसके रद्द होने की स्थिति में अन्य ग्राहकों की सुरक्षा के लिए वित्तीय गारंटी देने, हर स्थल की पानी और बिजली की खपत प्रकाशित करने, बंद चक्र वाली या कम पानी खर्च करने वाली शीतलन प्रणाली को प्राथमिकता देने, और सीमित सुरक्षा प्रावधानों के अलावा निर्वाचित प्रतिनिधियों तथा सार्वजनिक कर्मचारियों पर गोपनीयता समझौते न थोपने की प्रतिबद्धता जताता है। जॉर्जिया की एफिंगहैम काउंटी में निवासियों ने 4,8 मिलियन डॉलर के अनुदान को काउंटी के 14 000 विद्यार्थियों के लिए मुफ़्त स्कूली भोजन की ओर मोड़ा; ओहायो की पाइक काउंटी में OpenAI और SB Energy बच्चों की देखभाल के लिए 6 मिलियन डॉलर देने की प्रतिबद्धता जताते हैं। योजना नीति निर्माताओं से साझा नियमों की भी माँग करती है: बड़े उपभोक्ताओं से ग्रिड पर उनके कारण बढ़ने वाली लागत वसूलना, अपनी माँग घटा सकने वाले परिसरों का ग्रिड से जुड़ना आसान बनाना, जैसा कि 2 नवंबर को शुरू किए गए Grid Protectors में प्रस्तावित है, और बिजली पारेषण लाइनों के निर्माण में तेज़ी लाना।
🔗 ज़िम्मेदार एआई बुनियादी ढाँचे के लिए नया मानक तय करना (OpenAI)
संक्षिप्त समाचार
एजेंट और कोड के उपकरण
- Amp और GitLab — Amp अब GitLab के साथ जुड़ता है, चाहे gitlab.com हो या स्वयं प्रबंधित इंस्टेंस : इसके क्लाउड परिवेश, जिन्हें orbs कहा जाता है, उपयोगकर्ता की ओर से क्लोन और पुश करते हैं, मर्ज अनुरोध खोलते हैं और उन पर नज़र रखते हैं, और Orb Spawner हर नए अनुरोध या टिकट के लिए एक orb शुरू करता है ; कोई कीमत नहीं बताई गई है। 🔗 स्रोत
- Warp में एजेंटों की PR की समीक्षा — बेन होम्स समीक्षा में लगने वाली भीड़ घटाने के लिए तीन उपाय सुझाते हैं : कई चरणों में काम करने वाला अपना समीक्षा एजेंट, एजेंट द्वारा शुरू से अंत तक सत्यापन और पाँच मानदंडों पर आधारित मर्ज जोखिम का स्कोर, जिसे /merge-risk स्किल के रूप में प्रकाशित किया गया है। 🔗 स्रोत
- Copilot CLI 1.0.106-10 — npm पर रिलीज़ नोट्स के बिना एक नया पूर्वावलोकन संस्करण आया है ; इसे शामिल करने वाले Copilot SDK 1.0.29-preview.9 से इतिहास को प्रयोगात्मक रूप से संक्षिप्त करने और डिवाइस कोड से लॉगिन की सुविधाओं का पता चलता है। नवीनतम स्थिर संस्करण अभी भी 28 अक्टूबर का 1.0.105 है। 🔗 स्रोत
- Copilot Fusion — GitHub ने इस मॉडल राउटर पर 30 % की छूट समाप्त होने की तारीख 30 नवंबर तय की है, जिसे 28 अक्टूबर की घोषणा में सीमित समय के लिए भुगतान वाले Copilot प्लान तक सीमित रखा गया था ; ट्वीट में इसे GitHub Copilot ऐप, Copilot CLI और VS Code में उपलब्ध बताया गया है। 🔗 स्रोत
- Kimi Code 2.5.1 — आठ सुधार किए गए हैं, जिनमें डायनेमिक टूल स्कीमा के लिए खाली सिस्टम संदेशों के कारण बार-बार आने वाली HTTP 400 त्रुटियों का समाधान और टूल के परिणामों में चित्रों तथा वीडियो के पूर्वावलोकन की वापसी शामिल है। 🔗 स्रोत
- Kimi Work 3.2.25 — एक वैश्विक खोज परियोजनाओं, प्लगइन, स्किल और बातचीत को समेटती है, कार्य के दौरान अनुमति न मिले प्लगइन पहचाने जाते हैं और एक विंडो उनकी अनुमति देने की प्रक्रिया बताती है, तथा एक नई कार्रवाई कार्य को संग्रहित करने से पहले रोक देती है। 🔗 स्रोत
- CLI mistral 0.17.2 — Studio के विस्तार वाले दिन दो सुधार किए गए :
mistral apps deployका चेतावनी लिंक ऐप का Secrets टैब खोलता है, और शेल द्वाराUV_DEFAULT_INDEXयाUV_INDEX_URLएक्सपोर्ट किए जाने परmistral agentsकमांड अबuv.lockलॉक के कारण विफल नहीं होते। 🔗 स्रोत - iOS पर Codex — 2 नवंबर को iOS के लिए ChatGPT 1.2026.300 में Codex के पूर्ण स्क्रीन संदेश संपादक से बाहर निकले बिना संलग्नक जोड़ना और हटाना संभव हुआ, अलग-अलग डिवाइसों के बीच कार्यों के पढ़े जाने की स्थिति समन्वित होती है और आगे के संदेश डिफ़ॉल्ट रूप से मौजूदा कार्य में भेजे जाते हैं। 🔗 स्रोत
- Antigravity एक्सटेंशन — 2 नवंबर को VS Code एक्सटेंशन 1.11.0 ने बातचीत में भेजे गए टर्मिनल संदर्भ के छोटे संकेतकों को क्लिक करने योग्य बनाया, और Visual Studio एक्सटेंशन 1.0.261102.0 ने इनलाइन डिफ़ डिफ़ॉल्ट रूप से सक्रिय किए, जिन्हें ब्लॉक या फ़ाइल के स्तर पर स्वीकार या अस्वीकार किया जा सकता है। 🔗 स्रोत
- पुल रिक्वेस्ट का Overview पृष्ठ — GitHub ने स्वेच्छा से शामिल होने वालों के लिए एक पृष्ठ का सार्वजनिक पूर्वावलोकन शुरू किया है, जो मर्ज की स्थिति और अगली कार्रवाइयों को सबसे ऊपर दिखाता है, साथ ही इसमें नए डिज़ाइन वाला मर्ज क्षेत्र और बातचीत के फ़िल्टर हैं ; पुराने दृश्य पर लौटना संभव है। 🔗 स्रोत
- Rust में Discord — एआई से इतर, Discord ने अपने क्लाइंट का Rust में दोबारा बनाया गया नया संस्करण दिखाया है, जिसे Zed अपने ओपन सोर्स इंटरफ़ेस फ़्रेमवर्क GPUI पर बना हुआ बताता है। 🔗 स्रोत
कंपनियाँ और साझेदारियाँ
- DevRev और Codex — OpenAI द्वारा प्रकाशित एक केस स्टडी में DevRev बताता है कि उसने अपने Computer और Operator एजेंटों की तर्क क्षमता OpenAI के मॉडलों को सौंपी है, जिनमें GPT-6.1 Sol शामिल है, और अपने Cursor लाइसेंस छोड़कर अपनी पूरी इंजीनियरिंग को Codex पर ले आया है ; परिणामों के कोई आँकड़े नहीं दिए गए हैं। 🔗 स्रोत
- Replit और SMFL — Replit ने अपने प्लेटफ़ॉर्म को SMFL की परिसंपत्ति प्रबंधन सेवा AssetForce से जोड़ने के लिए Sumitomo Mitsui Finance and Leasing के साथ साझेदारी की है। 200 से अधिक कंपनियाँ इस सेवा का उपयोग करती हैं और यह साझेदारी SMFL के डिजिटल सेवाओं से होने वाले राजस्व को 2031 तक दस गुना करके 10 अरब येन तक पहुँचाने के लक्ष्य में मदद करेगी। 🔗 स्रोत
- Baseten और Nemotron Coalition — Baseten खुले मॉडलों के लिए NVIDIA के गठबंधन में शामिल हुआ है, जिसे मार्च में Mistral, Black Forest Labs, Cursor, Ai2 और Perplexity के साथ प्रस्तुत किया गया था, और इसमें सुदृढीकरण अधिगम के परिवेश, प्रशिक्षण के बाद का परिष्करण और अनुकूलित इन्फ़रेंस उपलब्ध कराता है। 🔗 स्रोत
प्लेटफ़ॉर्म, API और सुरक्षा
- Claude Enterprise की सुरक्षा — Anthropic बीटा में एक सुरक्षा केंद्र जोड़ता है, जो बातचीत, Cowork और Claude Code की सेटिंग की तुलना उसकी सिफ़ारिशों से करता है, साथ ही एक केंद्रीकृत प्रशासन कंसोल और macOS तथा Windows पर Cowork की स्थानीय वर्चुअल मशीन में एक EDR सेंसर जोड़ता है, जो उपकरणों पर खतरों का पता लगाता है और उन पर कार्रवाई करता है। 🔗 स्रोत
- Claude Console और Admin API — बीटा में, प्रति संगठन अधिकतम 1 000 पतों या रेंज वाली अनुमत IP पतों की सूची अन्य जगहों से आए अनुरोधों को अस्वीकार करती है, जिससे उजागर हुई API कुंजी का उपयोग सीमित होता है, और Admin API किसी Claude Enterprise सदस्य को हर जगह से लॉगआउट कर सकती है। 🔗 स्रोत
- OpenAI के SDK — openai-python 3.46.0 और openai-node 7.51.0 में ऑस्ट्रेलिया, भारत और जापान में डेटा रखने के विकल्प, GPT-6 Rosalind और Images 2.6 के नियंत्रण जोड़े गए हैं, फिर अगले संस्करणों में
gpt-6-cyberजोड़ा गया ; 29 अक्टूबर के 0.166.0 के बाद से Codex CLI का कोई स्थिर संस्करण अब भी नहीं आया है। 🔗 स्रोत - Gemini API — API अब PPT और ODP प्रस्तुतियाँ तथा ODS स्प्रेडशीट स्वीकार करती है, DOC दस्तावेज़ों को पृष्ठों की इमेज के रूप में संसाधित करती है, और टूल मॉडल को ऑडियो, वीडियो या Office तथा OpenDocument फ़ाइलें लौटा सकते हैं। 🔗 स्रोत
- Perplexity API — Agent API ने प्रयास का स्तर
ultraउपलब्ध कराया है, जो व्यापक शोध के लिए Claude Opus 5.5 पर चलता है और जिसे Computer के Effort Mode के Ultra स्तर से अलग समझना चाहिए ; एक दिन पहले Decisions API में खोजने से पहले किसी URL का पाठ पढ़ने की सुविधा आई थी, जिसकी कीमत प्रति प्राप्ति 0,001 डॉलर है। 🔗 स्रोत - एजेंटों का समन्वय — Perplexity ने एक मार्गदर्शिका प्रकाशित की है, जो समन्वय की तीन संरचनाओं की तुलना करती है : केंद्रीकृत, विकेंद्रीकृत और पदानुक्रमित। इसमें सात आम विफलताएँ गिनाई गई हैं और कार्य अनुबंधों से लेकर ऐसे पुनःप्रयासों तक सात अच्छी कार्यपद्धतियाँ सुझाई गई हैं, जिनका दोहराव परिणाम नहीं बदलता ; कोई नई उत्पाद सुविधा नहीं है। 🔗 स्रोत
- GitHub में सीक्रेट की जाँच — SpaceX साझेदार बना है : सार्वजनिक रिपॉज़िटरी में उजागर हुआ
starlink_public_api_v2_secretपहचानकर्ता रद्द करने के लिए उसे भेजा जाता है, और AWS तथा Google Cloud Storage सहित छह प्रदाताओं के डिटेक्टर अब कम गलत चेतावनियाँ देते हैं। 🔗 स्रोत
NVIDIA में बुनियादी ढाँचा और सिमुलेशन
- मेमोरी और इन्फ़रेंस — एक व्याख्यात्मक लेख दुर्लभ और महँगी HBM के संदर्भ में पूरी तकनीकी संरचना को एक साथ डिज़ाइन करने का समर्थन करता है : Blackwell Ultra से Vera Rubin तक प्रति GPU HBM में केवल लगभग 3 % की वृद्धि होती है, लेकिन SemiAnalysis AgentX पर प्रति डॉलर थ्रूपुट 30 गुना तक बढ़ता है ; NVIDIA CMX स्टोरेज के साथ नौ साझेदार जुड़े हैं। 🔗 स्रोत
- Into the Omniverse — NVIDIA ने एजेंटों द्वारा बनाए गए सिमुलेशन पर अपने लेख को अद्यतन किया है, जिसे 9 अक्टूबर को कवर किया गया था। इसमें लगभग दस परियोजनाएँ हैं, जो मुख्यतः GPT-6 Astra और कभी-कभी Claude के साथ बनाई गई हैं, जिनमें 80 कन्वेयर, 40 रोबोटिक भुजाओं और 800 बक्सों वाला एक गोदाम भी है, जो 30 फ़्रेम प्रति सेकंड पर चलता है ; कोई नया उत्पाद नहीं है। 🔗 स्रोत
खुले मॉडल, डेटा और शोध
- Slack में ML Intern — Hugging Face का ओपन सोर्स एजेंट, जो मूल्यांकन करता है, डेटा तैयार करता है और मॉडलों को फ़ाइन-ट्यून करता है, अब अपने कार्यक्षेत्र में इंस्टॉल किए जाने वाला Slack बॉट बन गया है, जो आपके डेटा, फ़ाइलों और MCP सर्वरों से जुड़ता है ; न कीमत दी गई है, न इंस्टॉलेशन लिंक। 🔗 स्रोत
- Llama और निर्णय मॉडल — llama.cpp तथा Hugging Face की टीम का स्थानीय ऐप, जो Mac और Windows पर मुफ़्त है, Liquid AI के d1-Omni और d3-flash को चलाता है। ऐप d3-flash को vLLM का मॉडल बताता है और उसे Jev Decision Index में सबसे ऊपर रखता है। 🔗 स्रोत
- Sand3D — Sandflow ने 106 094 त्रिआयामी वस्तुएँ प्रकाशित की हैं, जिनमें 10 456 जोड़युक्त हैं। हर वस्तु उसकी खुली sand3d लाइब्रेरी में छोटे Python प्रोग्राम के रूप में लिखी गई है और उसका OpenUSD निर्यात Hub के त्रिआयामी व्यूअर में देखा जा सकता है। 🔗 स्रोत
- SimReady Central — Lightwheel ने Hugging Face पर NVIDIA की त्रिआयामी वस्तुओं की लाइब्रेरी में अपनी भूमिका का विवरण दिया है, जिसमें अब 3 500 से अधिक OpenUSD वस्तुएँ हैं : कंपनी संपर्क और गति के दौरान उनके भौतिक व्यवहार को सत्यापित और समायोजित करती है। 🔗 स्रोत
- DreamTac — एक लेख पेकिंग विश्वविद्यालय के इस डेटासेट को प्रस्तुत करता है, जिसे Voxel51 ने FiftyOne के लिए रूपांतरित किया है : जेल वाली उँगलियों के सिरों से लैस Franka भुजा के 703 गति-पथ, 12 कार्यों और 7,03 घंटों में, जिनमें स्पर्श इमेज में दिखाई देता है। 🔗 स्रोत
- लेबनानी बोली में वाक् संश्लेषण — बिलाल ज़राकेत ने चार मॉडलों से बेरूत के एक परीक्षक की आवाज़ का क्लोन बनाया : पाँच मूल भाषी श्रोताओं ने पहचान जाने बिना अंक दिए, जिनमें असली आवाज़ को 5 में से 4,98 और सर्वश्रेष्ठ मॉडल VoxCPM2 को 3,89 मिले, और मॉडल की आवाज़ केवल 65 % मामलों में लेबनानी समझी गई। 🔗 स्रोत
- Guardián colombiano — ह्यूगो अलोंसो सामूहिक स्मृति की एक सार्वजनिक दीवार पर कोलंबियाई स्पेनिश में मॉडरेशन के लिए Tiny Aya Global को फ़ाइन-ट्यून करते हैं, जिसमें 3,35 अरब पैरामीटर हैं। यह तीन क्लाउड सेवाओं की शृंखला की जगह 6 जीबी के GPU पर चलता है। 🔗 स्रोत
- Anvaya-1B — एक डेवलपर PyTorch FSDP और FineWeb के साथ 16 जीबी की दो T4 कार्डों पर एक अरब से थोड़े अधिक पैरामीटर वाले मॉडल को शुरू से पूर्व-प्रशिक्षित कर रहा है और उसने पहला चेकपॉइंट तथा प्रशिक्षण विधि प्रकाशित की है। 🔗 स्रोत
- traj2envs — Hugging Face ने बिना घोषणा के एक टूल प्रकाशित किया है, जो ATIF प्रारूप वाले एजेंट गति-पथों को Harbor के सत्यापित सुदृढीकरण अधिगम कार्यों में बदलता है, जिनके परिवेश की इमेज के संस्करण निश्चित किए गए हैं। 🔗 स्रोत
चित्र, वीडियो और अवतार
- Runway और Gemini Omni 1.2 Flash — Runway ने Google का नया मॉडल जोड़ा है, जिससे 15 सेकंड तक के वीडियो बनाए और संपादित किए जा सकते हैं, किसी दृश्य को शुरू से दोबारा बनाए बिना सुधारा जा सकता है और फिर उसे 4K में बड़ा किया जा सकता है ; न लेख दिया गया है, न क्रेडिट की लागत। 🔗 स्रोत
- HeyGen और Images 2.6 — HeyGen ने अपने दृश्यों के सहायक पात्रों के लिए ChatGPT Images 2.6 को शामिल किया है, जिससे बेहतर पात्र शीट और HeyGen Video 1 में अधिक एकरूपता मिलती है ; कीमत या उपलब्ध योजनाएँ स्पष्ट नहीं की गई हैं। 🔗 स्रोत
- Luma का Photo Reframe — Expression Sheet और Character Sheet के बाद Luma ने एक टूल जोड़ा है, जो किसी चित्र के आसपास की जगह भरकर उसे Instagram पोस्ट, एल्बम के आवरण या पोस्टर के अनुकूल बनाता है ; न लेख दिया गया है, न कीमत। 🔗 स्रोत
- Manus Studio — परियोजनाएँ अब Premiere Pro, DaVinci Resolve, CapCut या Final Cut Pro में निर्यात की जा सकती हैं, ताकि एआई से बनाए गए वीडियो का संपादन किसी दूसरे टूल में पूरा किया जा सके ; निर्यात प्रारूप या योजनाएँ स्पष्ट नहीं की गई हैं। 🔗 स्रोत
- Muse Realtime Avatar — Meta Connect में प्रस्तुत यह तकनीक Muse Realtime Voice को वास्तविक समय में एनिमेटेड चेहरा देती है और अब अमेरिका में Muse ऐप में आ रही है ; अन्य देशों के लिए कोई समय-सारणी नहीं दी गई है। 🔗 स्रोत
इसके क्या मायने हैं
आक्रामक साइबर सुरक्षा सीमित पहुँच के साथ औद्योगिक पैमाने पर पहुँच रही है। Critical श्रेणी में रखे गए GPT-6 Cyber का उपयोग दस दिनों में 12 लाख डॉलर की लागत से Linux कर्नेल की विशेषाधिकार बढ़ाने वाली 948 कमज़ोरियों को सत्यापित करने के लिए किया गया, यानी प्रति कमज़ोरी 1 279 डॉलर, और Firefox में उच्च गंभीरता वाली 81 कमज़ोरियाँ खोजने के लिए भी। OpenAI इस मॉडल को स्वीकृत Daybreak Red ग्राहकों तक सीमित रखता है, डिफ़ॉल्ट रूप से अनुमत IP पतों की सूची अनिवार्य करता है और साइबर क्षेत्र से जुड़े विशिष्ट लक्ष्य-विचलन की निगरानी करता है। अब मुकाबला सुधार की गति का है : अभियान के दस दिनों के दौरान अन्य योगदानकर्ता इनमें से 61 कमज़ोरियों को मूल परियोजनाओं में पहले ही ठीक कर चुके थे और 43 अन्य के सुधार तैयार कर रहे थे, और OpenAI इस गति के साथ चलने के लिए सुधार अपने-आप तैयार करना अनिवार्य मानता है। Replit इस शृंखला का दूसरा सिरा दिखाता है : उसके अतिथि कर्नेल में खुलासा होने से पहले ही 4 375 सुधार शामिल थे, और Anthropic ने जिस TCP कमज़ोरी का लाभ उठाकर दिखाया, उसे वहाँ 12 अक्टूबर को ही ठीक कर दिया गया था।
संवेदनशील डेटा पर लंबे समय तक काम करने वाले एजेंट अलगाव और अनुमतियों को उत्पाद का केंद्र बना रहे हैं। Perplexity के सहकर्मी चौबीसों घंटे चलते हैं, हर एक का अपना डेस्कटॉप, ब्राउज़र और कुकी होती हैं ; Mistral के प्रबंधित एजेंट घंटों या दिनों तक काम करते हैं और किसी व्यक्ति की मंज़ूरी की प्रतीक्षा कर सकते हैं ; Cursor चार निर्धारक जाँचों और एआई समीक्षा के बाद हर ऐप को एक अलग खाते में होस्ट करता है। Personal Finance इस सोच को केवल पढ़ने की पहुँच तक ले जाता है : Claude, Plaid के ज़रिए शेष राशि और लेनदेन पढ़ता है, लेकिन एक डॉलर भी स्थानांतरित नहीं कर सकता, और उसके कार्यक्षेत्र की बातचीत प्रशिक्षण के लिए इस्तेमाल नहीं होती। बुनियादी ढाँचे के स्तर पर Replit हर सैंडबॉक्स को अपना Linux कर्नेल देता है और अतिथि मशीन के बाहर नेटवर्क नियम लागू करता है ; प्रशासकों के लिए Claude Enterprise अब अपनी सुरक्षा सेटिंग की तुलना Anthropic की सिफ़ारिशों से करता है।
एआई से बनाए गए चित्र और वीडियो अधिक तेज़, सस्ते होते जा रहे हैं और कुछ ही घंटों में हर जगह शामिल हो रहे हैं। Images 2.6 चित्र 50 % अधिक तेज़ी से बनाता है, Gemini Omni 1.2 Flash क्लिप की अवधि 15 सेकंड तक बढ़ाते हुए अपनी कीमत 30 % घटाकर 720p में लगभग 0,07 डॉलर प्रति सेकंड करता है, और Runway अपने 57B वीडियो पात्रों को आठ की जगह चार H100 पर वास्तविक समय में चलाता है। उपलब्धता तुरंत फैलती है : Runway ने Omni 1.2 Flash को उसके जारी होने वाले दिन ही जोड़ दिया, HeyGen ने अगले दिन Images 2.6 को शामिल किया, और Luma अपने निर्माण टूल Claude तथा ChatGPT में उपलब्ध करा रहा है। रचनाकारों के लिए अब अहम सवाल मॉडल चुनने से हटकर उस टूल पर आ रहा है जिसमें वह उपलब्ध होता है, अक्सर उसी दिन।
इन्फ़रेंस की लागत अपने आप में एक बिक्री तर्क बन रही है। NVIDIA प्रति वॉट एजेंटों की संख्या के आधार पर Vera बेचता है, Meta प्रति परत केवल एक गणना कर्नेल से Muse Spark Open की डिकोडिंग 2,1 गुना तेज़ करता है, और Cognition ने अगस्त से कोड समीक्षा की लागत 82 % घटाई है, जबकि थोड़े अधिक बग भी खोजे हैं। Ripple-65B Preview प्रशिक्षण पर यही सोच लागू करता है : Olmo 3 से निकली विधि पर शुरू से पूर्व-प्रशिक्षित और सुदृढीकरण अधिगम के 14 लाख रोलआउट से आगे प्रशिक्षित यह डेंस मॉडल एजेंट आधारित कोडिंग में अमेरिकी खुले मॉडलों में सबसे आगे होने का दावा करता है और Together AI पर प्रति दस लाख इनपुट टोकन 0,20 डॉलर में उपलब्ध है।
स्रोत
- GPT-6 Cyber: संरेखित साइबर सुरक्षा एजेंटों की सीमाओं को आगे बढ़ाना (OpenAI)
- @OpenAI : GPT-6 Cyber का शुभारंभ
- GPT-6 Cyber का सिस्टम कार्ड
- root तक पहुँचने के एक हज़ार रास्ते कम (OpenAI)
- Claude में Personal Finance का परिचय
- @claudeai : Claude में Personal Finance
- Claude में Personal Finance का उपयोग करें (सहायता केंद्र)
- Teammates जटिल और निरंतर चलने वाले कामों के लिए एजेंट हैं (Perplexity)
- @AravSrinivas : Perplexity Teammates का शुभारंभ
- Perplexity Teammates का उत्पाद पृष्ठ
- Le Chonk बुद्धिमत्ता लाता है। Studio उसे काम में लगाता है (Mistral AI)
- Images 2.6 का परिचय (OpenAI)
- ChatGPT के रिलीज़ नोट्स
- Gemini Omni 1.2 Flash का परिचय (Google)
- Gemini Omni 1.2 Flash की दरें (Google AI Studio)
- Luma को ChatGPT और Claude से जोड़ें (Luma)
- @RicursiveAI : Ripple-65B Preview
- Hugging Face पर Ripple-65B Preview
- Together AI पर Ripple-65B Preview
- Devin Review 2.0 (Cognition)
- Cursor में लाइव ऐप बनाएँ (Cursor का परिवर्तन विवरण)
- ऐप के बारे में Cursor का दस्तावेज़ीकरण
- Replit के नए सैंडबॉक्स इंजन की अंदरूनी जानकारी, भाग 1 (Replit)
- Qwen Code v0.26.8
- Vera दोनों विकल्पों की बेहतरीन खूबियाँ प्रदान करता है (NVIDIA)
- sgl-muse-mega (facebookresearch)
- एक के बैच आकार पर रीयल-टाइम वीडियो (Runway)
- arXiv शोधपत्र 2611.05642 (Runway)
- LeRobot v0.7.0 (Hugging Face ब्लॉग)
- ToyBlocks (allenai)
- वैज्ञानिक खोज के लिए AI: शोधकर्ता Claude का उपयोग कैसे करते हैं (Anthropic)
- ज़िम्मेदार AI अवसंरचना के लिए नया मानक स्थापित करना (OpenAI)
- GitLab एकीकरण (Amp)
- कोड समीक्षा की अड़चन दूर करना (Warp)
- Copilot SDK 1.0.29-preview.9
- @github : 30 नवंबर तक Copilot Fusion पर छूट
- Kimi Code 2.5.1
- Kimi Work के रिलीज़ नोट्स
- mistral CLI 0.17.2
- ChatGPT और Codex का परिवर्तन विवरण: iOS पर Codex
- Antigravity का परिवर्तन विवरण
- पुल अनुरोधों का नया अवलोकन पृष्ठ (GitHub का परिवर्तन विवरण)
- @zeddotdev : Discord और GPUI
- DevRev, GPT-6.1 Sol के साथ स्वायत्त स्व-सेवा प्रदान करता है (OpenAI)
- @Replit : SMFL के साथ साझेदारी
- @baseten : Nemotron Coalition में शामिल होना
- सुरक्षा टीमों के लिए Claude Enterprise पर अधिक दृश्यता और नियंत्रण
- Claude Platform के रिलीज़ नोट्स
- openai-python 3.46.0
- 5 नवंबर के Gemini API रिलीज़ नोट्स
- Perplexity API का परिवर्तन विवरण
- AI एजेंट ऑर्केस्ट्रेशन की सर्वोत्तम प्रथाएँ (Perplexity)
- सीक्रेट स्कैनिंग: SpaceX बना साझेदार (GitHub का परिवर्तन विवरण)
- हर बाइट से अधिक प्रदर्शन (NVIDIA)
- Omniverse में: एजेंटों द्वारा बनाए गए सिमुलेशन (NVIDIA)
- @huggingface : Slack में ML Intern
- @Llama_app : d1-Omni और d3-flash
- Sand3D (Hugging Face ब्लॉग)
- SimReady Central और Lightwheel (Hugging Face ब्लॉग)
- DreamTac और FiftyOne (Hugging Face ब्लॉग)
- क्या तैयार उपलब्ध वाक् AI लेबनानी बोली बोल सकता है? (Hugging Face ब्लॉग)
- कोलंबियाई संरक्षक (Hugging Face ब्लॉग)
- Anvaya-1B (Hugging Face ब्लॉग)
- traj2envs (Hugging Face)
- @runwayml : Runway में Gemini Omni 1.2 Flash
- @HeyGen : HeyGen में ChatGPT Images 2.6
- @LumaLabsAI : Photo Reframe
- @ManusAI : Manus Studio से निर्यात
- @AIatMeta : Muse Realtime Avatar