ai-powered-markdown-translatorgpt-5.6-sol के साथ फ़्रेंच से हिंदी में अनूदित लेख।
इस मंगलवार, Google ने Gemini 3.8 Live और Gemini 3.8 Live Extended Thinking लॉन्च किए, दो रीयल-टाइम वॉइस संवाद मॉडल जो बातचीत को रोके बिना पृष्ठभूमि में टूल कॉल कर सकते हैं। Anthropic ने Claude Code के तीन संस्करण जारी किए और Salesforce को Claude में शामिल किया, जबकि OpenAI ने ChatGPT और Codex से GPT-5.5 को हटाने की तारीख 14 अक्टूबर तय की। एजेंट मौजूदा वितरण माध्यमों में भी जगह बना रहे हैं—HP द्वारा Perplexity को पहले से इंस्टॉल करने से लेकर AWS Marketplace पर Devin की बिक्री तक—और NVIDIA ने अपने Vera Rubin प्लेटफ़ॉर्म के दो घटकों का विवरण दिया।
Gemini 3.8 Live और 3.8 Live Extended Thinking, दो वॉइस मॉडल जो बोलते हुए काम करते हैं
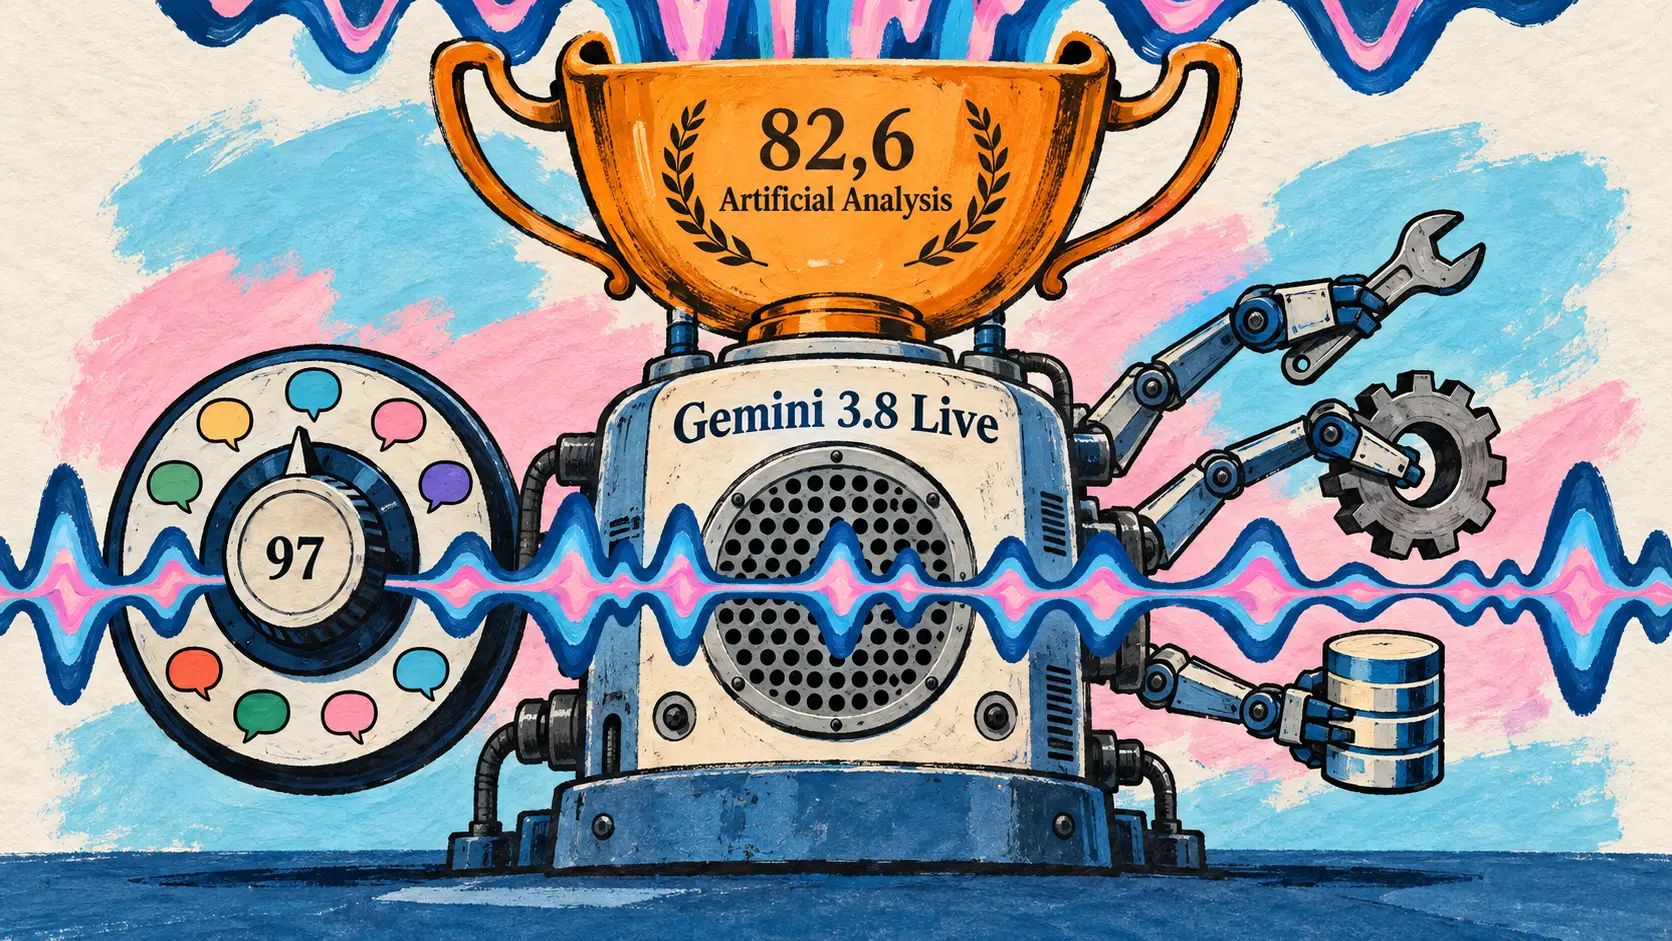
15 सितंबर — Google ने Gemini Audio टीम द्वारा प्रस्तुत दो रीयल-टाइम वॉइस संवाद मॉडल लॉन्च किए। Gemini 3.8 Live बड़े पैमाने, गति और लागत के लिए बनाया गया है: यह लगभग रीयल-टाइम में दृश्य इनपुट स्वीकार करता है और बातचीत के दौरान 97 भाषाओं के बीच स्वचालित रूप से बदलता है। Gemini 3.8 Live Extended Thinking उन कार्यों के लिए है जिनमें कई चरणों वाले तर्क की आवश्यकता होती है: यह एक साथ सोचता और बोलता है, छोटे मौखिक संकेतों से प्राप्ति की पुष्टि करता है और अपने पृष्ठभूमि कार्यों की प्रगति बताता रहता है; इसके चिंतन का स्तर API में समायोजित किया जा सकता है। दोनों मॉडल ऑडियो प्रतिक्रिया जारी रहते हुए पृष्ठभूमि में टूल और API कॉल (asynchronous function calling) निष्पादित करते हैं।
The models talk, think, and handle tasks in the background without breaking your flow.
🇮🇳 मॉडल आपकी बातचीत का प्रवाह बाधित किए बिना बोलते हैं, सोचते हैं और पृष्ठभूमि में कार्य संभालते हैं। — X पर @GoogleDeepMind
Google बोले गए अल्फ़ान्यूमेरिक डेटा—जैसे पुष्टि कोड या केस नंबर—की सटीकता पर भी ज़ोर देता है और इन मॉडलों को उन कैस्केड आर्किटेक्चर का सरल विकल्प बताता है जो ट्रांसक्रिप्शन, टेक्स्ट प्रोसेसिंग और वॉइस सिंथेसिस को क्रमिक रूप से जोड़ते हैं। Gemini 3.8 Audio की मॉडल शीट के अनुसार, ये Gemini 3 Pro पर आधारित हैं, 128K tokens के कॉन्टेक्स्ट में ऑडियो, इमेज, वीडियो और टेक्स्ट स्वीकार करते हैं, आउटपुट में 64K tokens तक उत्पन्न करते हैं और जनवरी 2025 तक के ज्ञान पर निर्भर हैं।
| रैंकिंग या बेंचमार्क | मूल्यांकित मॉडल | Google द्वारा प्रकाशित स्कोर |
|---|---|---|
| Speech to Speech Quality सूचकांक (Artificial Analysis) | 3.8 Live Extended Thinking | 82,6 (पहला स्थान) |
| τ-Voice | 3.8 Live Extended Thinking | 68,6 % |
| τ-Voice-banking (Sierra) | 3.8 Live Extended Thinking | 35,1 % |
| Big Bench Audio | 3.8 Live Extended Thinking | 97,7 % |
| Speech Agent Arena (Artificial Analysis) | 3.8 Live | दूसरा स्थान |
इन रैंकिंग का रखरखाव तृतीय पक्ष करते हैं, लेकिन उद्धृत स्कोर Google द्वारा प्रकाशित हैं। Live API में Google दोनों मॉडलों की लागत इनपुट ऑडियो के लिए 0,005 डॉलर प्रति मिनट और आउटपुट ऑडियो के लिए 0,018 डॉलर प्रति मिनट आँकता है, जो इनपुट के प्रति दस लाख tokens के लिए 3 डॉलर और आउटपुट के लिए 12 डॉलर पर आधारित है; Agora, Fishjam, LangChain, LiveKit, Pipecat, Vercel और Vision Agents को एकीकरणकर्ताओं के रूप में उद्धृत किया गया है।
| वितरण माध्यम | Gemini 3.8 Live | Gemini 3.8 Live Extended Thinking |
|---|---|---|
| Gemini API और Google AI Studio | 15 सितंबर से | 15 सितंबर से |
| Gemini Enterprise | निजी पूर्वावलोकन | निजी पूर्वावलोकन |
| आम जनता | Search Live | Gemini Live, Docs Live (Google AI Pro और Ultra सदस्य), Gmail Live और Keep Live (सभी Google AI सदस्य) |
Search Live में मॉडल रीयल-टाइम समस्या निवारण के दौरान चरण-दर-चरण मार्गदर्शन करता है। उत्पन्न किए गए सभी ऑडियो पर अदृश्य SynthID वॉटरमार्क होता है।
🔗 Gemini 3.8 Live और 3.8 Live Extended Thinking का परिचय 🔗 Live API पर डेवलपर पोस्ट 🔗 Gemini 3.8 Audio मॉडल शीट
Claude Code 2.1.271 से 2.1.273: Remote में तेज़ मोड, प्रत्येक कमांड के लिए नेटवर्क और अधिक कड़ी अनुमतियाँ
15 सितंबर — Anthropic ने Claude Code के तीन संस्करण 22 घंटे से कुछ अधिक समय में जारी किए, जिनमें पहला पेरिस समयानुसार आधी रात के तुरंत बाद आया।
| प्रकाशित संस्करण | तारीख और समय (UTC) | नोट्स की सामग्री |
|---|---|---|
| 2.1.271 | 14 सितंबर, 22 बजकर 12 मिनट | 96 पंक्तियाँ: Remote में तेज़ मोड, प्रत्येक कमांड के लिए allowed_domains, omitClaudeMd, --accept-command |
| 2.1.272 | 15 सितंबर, 0 बजकर 42 मिनट | एक पंक्ति: बग सुधार और विश्वसनीयता में सुधार |
| 2.1.273 | 15 सितंबर, 20 बजकर 23 मिनट | 64 पंक्तियाँ: LLM गेटवे के लिए हेडर, Remote Control सेशन का डुप्लिकेशन, Bedrock, Vertex और Foundry पर लोकल क्लासिफ़ायर |
2.1.271 ने Claude Code Remote सेशन में तेज़ मोड (fast mode) उपलब्ध कराया है—क्लाउड और स्वयं होस्ट किए गए निष्पादकों (self-hosted runners) दोनों पर—जहाँ संगठन इसकी अनुमति देता है। सैंडबॉक्स वाले ऑटो मोड में Bash, PowerShell और Monitor प्रत्येक कमांड के लिए allowed_domains सूची स्वीकार करते हैं: आवश्यक होस्ट की कमांड के साथ जाँच की जाती है और उन्हें केवल उसी के लिए खोला जाता है, जबकि अन्य अस्वीकार कर दिए जाते हैं। एजेंट के frontmatter का omitClaudeMd फ़ील्ड उपयोगकर्ता, प्रोजेक्ट और लोकल CLAUDE.md फ़ाइलों के बिना एक उप-एजेंट शुरू करता है, जबकि प्रबंधित नीति फ़ाइलें लोड रहती हैं, और claude plugin install --accept-command <sha256> पिछले --json के दौरान दिखाई गई केवल सटीक कमांड को स्वीकार करता है, किसी -y को नहीं। 2.1.273 Claude ऐप से claude --remote-control के साथ शुरू किए गए सेशन को डुप्लिकेट (fork) करने देता है, जिसके बाद डुप्लिकेट सेशन कंप्यूटर पर पृष्ठभूमि में चलता है। यह तब चेतावनी भी देता है जब कोई MCP सर्वर डिस्कनेक्ट हो जाता है और स्वचालित पुनः कनेक्शन प्रयास बंद हो जाता है, तथा CLAUDE_CODE_GATEWAY_HINT_HEADERS=1 से सक्रिय होने वाले LLM गेटवे के लिए अनुरोध हेडर जोड़ता है।
| संशोधित तत्व | नया व्यवहार |
|---|---|
| ऑटो मोड में उप-एजेंट की वापसी | उसके अंतिम संदेश की बाद में जाँच के बजाय सुरक्षा क्लासिफ़ायर द्वारा जाँची जाने वाली समर्पित वापसी कॉल (hand-back call) |
ऑटो मोड में skills के ! कमांड और slash कमांड | क्लासिफ़ायर के बजाय डिफ़ॉल्ट मोड के अनुमति नियम |
| Monitor निगरानियाँ | अधिकतम 30 मिनट की अनिवार्य समय-सीमा (-p निष्पादन में 10 मिनट), उन्हें फिर से सक्रिय करने के लिए Claude को सूचना |
| डायनेमिक workflows | उपयोग सीमा पर विराम और रीसेट होने पर स्वचालित बहाली, एजेंट छोड़ने के बजाय |
| Bedrock, Vertex और Foundry पर ऑटो मोड (2.1.273) | फ़िलहाल डिफ़ॉल्ट रूप से लोकल क्लासिफ़ायर, प्लेटफ़ॉर्म वाले के लिए CLAUDE_CODE_AUTO_MODE_SERVER=1 |
दोनों संस्करणों में कई अनुमति नियंत्रण भी सुधारे गए हैं। किसी subshell, दो डायरेक्टरी बदलावों या cd + git शृंखला वाली कमांड permissions.blockReadsOutsideWorkingDirectories के अंतर्गत संकेत को छोड़ देती थीं, और अनुमति-बायपास मोड (bypass) में कोई subshell खतरनाक rm को छिपा सकता था। MDM या managed-settings.json द्वारा लागू MCP सेटिंग्स को सर्वर-पक्ष की प्रबंधित सेटिंग्स मौजूद होते ही अनदेखा कर दिया जाता था। /resume और /teleport पिछली बातचीत में पढ़ी गई फ़ाइलों की ट्रैकिंग बनाए रखते थे, जिससे Claude उन फ़ाइलों को संशोधित कर सकता था जिन्हें फिर से शुरू हुई बातचीत ने कभी पढ़ा ही नहीं था। अंततः, कॉन्टेक्स्ट मीटर advisor टूल के टर्न को उनके वास्तविक आकार से लगभग दोगुना गिनता था, जिससे विंडो के लगभग आधे हिस्से पर स्वचालित compaction शुरू हो जाती थी।
तीनों में से किसी भी नोट में 14 सितंबर को घोषित Claude Mods का उल्लेख नहीं है; हालाँकि, issue #91870 पर समुदाय के परीक्षकों का मानना है कि 2.1.272 ने पहले ही उनकी सतह को प्रभावित किया है।
🔗 Claude Code 2.1.271 के रिलीज़ नोट्स 🔗 Claude Code 2.1.273 के रिलीज़ नोट्स
Salesforce in Claude, स्वीकृत संगठनों के लिए बीटा में बिक्री plugin
15 सितंबर — Anthropic ने बीटा में Salesforce in Claude लॉन्च किया, जो किसी विक्रेता के खाते, अवसर और pipeline को Claude में लाता है। पोस्ट इसे Salesforce के साथ बनाया गया plugin बताती है, जबकि सहायता केंद्र इसकी 37 बिक्री skills के निर्माण का श्रेय Salesforce को देता है: खातों की खोज, कॉल की तैयारी, pipeline समीक्षा या CRM अपडेट। इसके साथ दो connectors आते हैं—पढ़ने और लिखने के लिए Salesforce तथा व्यावसायिक चैनलों और टीम threads के लिए Slack।
Salesforce ही संदर्भ प्रणाली बना रहता है: प्रत्येक विक्रेता अपने प्रमाण-पत्रों से लॉग इन करता है, Claude केवल वही पढ़ता है जिसकी अनुमति उसकी Salesforce permissions देती हैं, और प्रत्येक लेखन को डिफ़ॉल्ट रूप से स्वीकृत करना होता है। plugin chat और Claude Cowork (web और desktop) में काम करता है। बीटा सशुल्क प्लान के लिए है, लेकिन केवल उन संगठनों के लिए जिन्हें Salesforce ने अपने बीटा पंजीकरण के माध्यम से स्वीकार किया है और जिनके पास Sales Cloud का नवीनतम enterprise edition है; उनके Salesforce administrators AgentExchange पर पहुँच का अनुरोध करते हैं। GitLab, Siemens और Legora ने इसे लागू किया है, और Salesforce के 7 000 विक्रेता इसका उपयोग करते हैं।
🔗 Salesforce को Claude में लाना 🔗 अपने संगठन के लिए Salesforce in Claude को कॉन्फ़िगर करना
GPT-5.5, 14 अक्टूबर को ChatGPT, ChatGPT Work और Codex से हटेगा, लेकिन API में रहेगा
15 सितंबर — OpenAI ने X पर अपने ऐप्स में GPT-5.5 की समाप्ति की घोषणा की, जो पहले ही 14 सितंबर की तारीख वाले ChatGPT और Codex changelog में दर्ज थी। 14 अक्टूबर को मॉडल सभी प्लान—आम उपभोक्ता, Business, Enterprise और Edu—पर ChatGPT, ChatGPT Work और Codex से हट जाएगा।
| प्रभावित सतह | 14 अक्टूबर की स्थिति |
|---|---|
| ChatGPT और ChatGPT Work | सभी प्लान से GPT-5.5 हटाया जाएगा |
| ChatGPT लॉगिन वाला Codex | GPT-5.5 हटाया जाएगा, gpt-5.6-sol पर जाने का अनुरोध |
| API कुंजी वाला Codex | GPT-5.5 उपलब्ध रहेगा |
| OpenAI API | GPT-5.5 उपलब्ध रहेगा |
ChatGPT लॉगिन वाले Codex के लिए दस्तावेज़ हर उस जगह gpt-5.5 को बदलने को कहता है जहाँ इसे स्पष्ट रूप से चुना गया है: workspace की डिफ़ॉल्ट सेटिंग्स, सहेजी गई सेटिंग्स, प्रबंधित configurations, कस्टम एजेंट, निर्धारित कार्य और scripts। @ChatGPT खाते का संदेश Codex में GPT-6 Astra को प्रतिस्थापन के रूप में भी उद्धृत करता है। administrators की मार्गदर्शिका चेतावनी देती है कि डिफ़ॉल्ट मॉडल बदलने से मॉडल की पहुँच नहीं खुलती: हर client के लिए यह जाँचना होगा कि संबंधित उपयोगकर्ताओं के लिए प्रतिस्थापन उपलब्ध है। OpenAI ने GPT-5.4 और GPT-5.4 mini पर लागू एक महीने की पूर्वसूचना अवधि को दोहराया है; 31 जुलाई की घोषणा के बाद इन्हें ChatGPT से लॉग इन करने वाले उपयोगकर्ताओं के लिए 31 अगस्त को Codex से हटा दिया गया था।
🔗 ChatGPT और Codex changelog 🔗 X पर @ChatGPT का संदेश
HP अपने Windows PC पर Autodesk Revit कनेक्शन के साथ Perplexity पहले से इंस्टॉल करता है
15 सितंबर — Perplexity और HP ने निर्माता के PC की taskbar में Windows के लिए Perplexity ऐप को पहले से इंस्टॉल करने की घोषणा की, जिसकी शुरुआत AMD Ryzen AI Max PRO 400 series processors से सुसज्जित ZBook Ultra G3a mobile workstation से होगी; अन्य मॉडल आने वाले महीनों में आएँगे, लेकिन कोई सूची, कीमत या तारीख नहीं दी गई है। पोस्ट के अनुसार, ZBook Ultra G3a की लोकल AI क्षमताएँ Portable Computer के साथ सामान्य कार्य चलाने देती हैं—यह एजेंट का लोकल संस्करण है जो cloud credits और इंटरनेट कनेक्शन के बिना काम करता है—लेकिन इसकी उपलब्धता डिवाइस configuration पर निर्भर करती है: पोस्ट संगत configurations की सूची नहीं देती, जबकि एक दिन पहले जारी Windows संस्करण के लिए कम से कम 24 GB video memory वाला NVIDIA RTX GPU आवश्यक था।
Portable Computer, Revit 2027 के MCP server के माध्यम से डिजिटल बिल्डिंग मॉडलिंग सॉफ़्टवेयर Autodesk Revit (Building Information Modeling) से भी जुड़ता है, जिसे अलग module के रूप में तकनीकी पूर्वावलोकन (Tech Preview) में पेश किया गया है। पहुँच केवल पढ़ने के लिए है: एजेंट मॉडल से जुड़े सवालों—जैसे किसी मंज़िल पर दरवाज़ों की संख्या या उनकी अग्नि-प्रतिरोध रेटिंग—का जवाब देता है और उसे बदले बिना views, PDF और schedules निर्यात करता है। Personal Computer for Windows, Windows 10 और 11 पर Pro, Max और Enterprise सदस्यों के लिए उपलब्ध है।
🔗 HP के साथ अधिक Windows PC पर आया Perplexity
Cognition ने AWS के साथ समझौता किया और Devin Cloud में macOS लॉन्च किया
15 सितंबर — Cognition ने एक ही दिन बुनियादी ढाँचे से जुड़ी दो घोषणाएँ प्रकाशित कीं: जिन Mac पर Devin अब Apple ऐप बनाता है, वे AWS EC2 Mac hosts हैं।
AWS के साथ रणनीतिक सहयोग समझौता
Cognition और Amazon Web Services ने बहुवर्षीय रणनीतिक सहयोग समझौता (Strategic Collaboration Agreement) किया है, जिसकी राशि या सटीक अवधि पोस्ट में नहीं बताई गई है। दो तत्व पहले से उपलब्ध हैं: Devin को AWS Marketplace के माध्यम से खरीदा जा सकता है और Agent Toolkit for AWS को सीधे Devin में उपयोग किया जा सकता है। ग्राहकों के AWS परिवेशों में अधिक गहन एकीकरण पर विचार किया जा रहा है, लेकिन इसके लिए कोई समय-सारणी नहीं दी गई है। Devin को ग्राहक द्वारा चुने गए AWS क्षेत्र में एकल-किरायेदार परिवेश (single-tenant) में तैनात किया जाता है, जहाँ डेटा एक समर्पित VPC में रखा जाता है और प्रत्येक सत्र के लिए एक वर्चुअल मशीन होती है, जिसे काम समाप्त होने पर हटा दिया जाता है।
| Cognition द्वारा उद्धृत ग्राहक | घोषित परिणाम |
|---|---|
| Mercedes-Benz | COBOL की 200,000 से अधिक पंक्तियों का विश्लेषण, आठ महीने अनुमानित परियोजना आठ दिनों में पूरी |
| अनाम वाहन निर्माता | COBOL की 25,000 पंक्तियों वाला प्रवाह मेनफ्रेम कंप्यूटर (mainframe) से AWS Lambda पर माइग्रेट किया गया, अनुमानित लागत 73% कम |
🔗 AWS के साथ समझौते पर Cognition की पोस्ट
Devin Cloud में macOS का आगमन
31 जुलाई को Cognition ने Xcode और iOS Simulator के साथ macOS पर चलने वाले Devin क्लाउड एजेंट पहले ही प्रदर्शित किए थे। iPhone, iPad और Mac ऐप्लिकेशन बनाने और सत्यापित करने के लिए 15 सितंबर को Devin Cloud में किया गया लॉन्च कई नई सुविधाएँ लाता है: Devin अपने परीक्षणों की स्क्रीन रिकॉर्डिंग Slack पर भेजता है, ऐप्लिकेशन इंस्टॉल करने के लिए TestFlight लिंक देता है और नया iOS Simulator पैनल चल रहे ऐप्लिकेशन को दिखाता है। एजेंट ऐप्लिकेशन को उनके अभिगम्यता-वृक्ष के माध्यम से भी नियंत्रित करता है, जिसे उसके कंप्यूटर-उपयोग टूल (computer use) के सामने उपलब्ध कराया जाता है: वह किसी नियंत्रण को उसकी भूमिका और नाम से खोजता है, उस पर कार्रवाई करता है और फिर वृक्ष को दोबारा पढ़ता है, जबकि स्क्रीनशॉट का उपयोग अब भी प्रस्तुतीकरण का आकलन करने के लिए किया जाता है। यह परत Dioxus के open source accessibility-cli पर आधारित है, जिसकी टीम 10 सितंबर को Cognition में शामिल हुई।
macOS VM, भौतिक AWS EC2 Mac पर Apple के Virtualization.framework के अंतर्गत चलते हैं। सत्र को मशीन चालू रखे बिना फिर शुरू करने के लिए snapshot प्रणाली (snapshots) में NBD (Network Block Device) इंटरफ़ेस जोड़ा गया है। प्रत्येक सत्र की नेटवर्क नीति लागू करने के लिए उपयोगकर्ता-स्थान में चलने वाला Ethernet गेटवे Apple के प्रबंधित NAT की जगह लेता है। न तो मूल्य और न ही संबंधित पेशकश स्पष्ट की गई है।
NVIDIA ने Vera Rubin के दो घटकों, Groq 3 LPX और NVLink 6 का विवरण दिया
15 सितंबर — NVIDIA के तकनीकी ब्लॉग की दो पोस्ट बताती हैं कि Vera Rubin प्लेटफ़ॉर्म inference में ऊर्जा कैसे बचाता है और अपने नेटवर्क की विफलताओं का सामना कैसे करता है। नीचे दिए गए आँकड़े NVIDIA के हैं।
Groq 3 LPX, वोल्टेज मार्जिन घटाने के लिए नियतात्मक निष्पादन
Groq 3 LPX के उत्पादन में आने की जानकारी यहाँ 24 अगस्त को दी गई थी; यह पोस्ट उसके तंत्र की व्याख्या करती है। निष्पादन से पहले LPU चिपों का compiler, rack की 256 चिपों पर प्रत्येक गणना और प्रत्येक डेटा स्थानांतरण का समय घड़ी-चक्र तक निर्धारित करता है, जिससे वह विद्युत-धारा की माँग का अनुमान लगा सकता है। दो तकनीकें इसका लाभ उठाती हैं: Preemptive Power (PEP) माँग में उछाल आने से ठीक पहले बिजली आपूर्ति नेटवर्क को वोल्टेज बढ़ाने के लिए कहता है और Clock Period Synthesis (CPS) उन घड़ी-चक्रों को लंबा करता है जिनमें विद्युत-धारा सबसे तेज़ी से बढ़ती है। इसका उद्देश्य उस वोल्टेज मार्जिन (voltage guardband) को घटाना है जिसे प्रत्येक परिपथ सुरक्षित रखता है और जो महँगा पड़ता है, क्योंकि शक्ति वोल्टेज के वर्ग के अनुपात में बढ़ती है: वोल्टेज में 10% वृद्धि का अर्थ शक्ति में 21% वृद्धि है।
आंतरिक परीक्षणों में वोल्टेज की गिरावट 60% से अधिक कम हुई। NVIDIA का अनुमान है कि समान कार्यभार के लिए आवश्यक शक्ति, तुलनीय गैर-नियतात्मक प्रणाली की तुलना में “निम्न दो-अंकीय” प्रतिशत (low-double-digit) तक कम हो सकती है। ये नियंत्रण 2026 की दूसरी छमाही में Vera Rubin पर आएँगे।
🔗 Groq 3 LPX के नियतात्मक निष्पादन पर NVIDIA की पोस्ट
NVLink 6, silicon से software तक लचीलेपन की एक पूर्ण परत-व्यवस्था
NVLink 6, Vera Rubin NVL72 rack के 72 Rubin GPU को एक ही domain में जोड़ता है; NVIDIA के दावे के अनुसार इसकी packet throughput सामान्य Ethernet विकल्पों से 10 गुना अधिक है, जिसका उल्लेख यहाँ 21 जुलाई को पहले ही किया गया था। इस बार पोस्ट परत-दर-परत विफलता-सहनशीलता का विवरण देती है।
| परत-व्यवस्था का स्तर | NVIDIA द्वारा वर्णित तंत्र |
|---|---|
| भौतिक परत | हल्का त्रुटि-सुधार, जिसके साथ भौतिक स्तर पर पुनःप्रेषण (Physical Layer Retry) |
| लिंक परत | credit-आधारित प्रवाह नियंत्रण (credit-based flow control), जिसकी बनावट में ही packet loss नहीं होता |
| लिंक प्रबंधन | NMX Controller के माध्यम से लगभग 1.5 सेकंड में software recovery |
| inference सेवा | Shadow Engine Recovery (NVIDIA Dynamo): GPU B200 पर व्यवधान 283 से घटकर 7.3 सेकंड |
| बहु-node checkpoints | prototype में NCCL द्वारा समर्थित cuda-checkpoint, वर्ष के अंत तक सामान्य उपलब्धता अपेक्षित |
credit-आधारित प्रवाह नियंत्रण कोई packet तभी भेजता है जब अगले hop के पास उसे प्राप्त करने की जगह हो, जबकि Ethernet, PFC और ECN पर निर्भर करता है। Shadow Engine Recovery inference engine की एक प्रतिकृति पहले से प्रारंभ करके रखता है, जिसके अपने NCCL communicators होते हैं।
🔗 NVLink 6 के लचीलेपन पर NVIDIA की पोस्ट
Gemini Notebook ने अपने notebooks के साथ ध्वनि वार्तालाप और audio recorder की घोषणा की
15 सितंबर — विश्वविद्यालयों में नए शैक्षणिक सत्र के लिए Gemini Notebook ने अपना स्वरूप बदला और अध्ययन टूल की एक शृंखला की घोषणा की, जिनमें से अधिकांश अभी आने बाकी हैं।
| घोषित अध्ययन टूल | बताई गई उपलब्धता |
|---|---|
| mobile पर अपने notebooks के साथ लगभग 100 भाषाओं में real-time ध्वनि वार्तालाप | इस सप्ताह वयस्क Google AI Ultra ग्राहकों के लिए, शीघ्र ही Google AI Pro और अन्य लोगों के लिए |
| mobile ऐप्लिकेशन में audio recorder | अगले सप्ताह से |
| Reports में interactive learning previews | आने वाले सप्ताहों में सभी उपयोगकर्ताओं के लिए |
| लघु-उत्तर, बहुविकल्पीय या रिक्त-स्थान वाले quiz | आने वाले सप्ताहों में सभी उपयोगकर्ताओं के लिए |
| 80 से अधिक भाषाओं में साझा किए जा सकने वाले Short Video Overviews | अब उपलब्ध, जबकि 1 सितंबर को 70 से अधिक भाषाओं में थे |
ध्वनि वार्तालाप notebook के स्रोतों के आधार पर उत्तर देगा और उसे आवाज़ से रोका जा सकेगा। recorder किसी व्याख्यान या विचार को स्रोतों के साथ सीधे notebook में रिकॉर्ड करेगा। learning previews सारांश, infographics, quiz और पुनरावृत्ति कार्ड (flashcards) को एक साथ जोड़ेंगे। अगस्त में पहले ही प्रस्तुत की गई छात्र पेशकशों के संबंध में Google ने स्पष्ट किया है कि अमेरिकी छात्रों को निःशुल्क दिया जाने वाला Google AI Pro का एक वर्ष Gemini Notebook की सीमाओं को चार गुना करता है, जबकि 140 से अधिक अन्य बाज़ारों में दिया जाने वाला Google AI Plus का एक वर्ष इन्हें दोगुना करता है।
🔗 Gemini Notebook के नए टूल से अपनी अध्ययन दिनचर्या को बेहतर बनाएँ
Antigravity 2.14.0 ने Enterprise और Business खातों के लिए integrated terminal और Git उपलब्ध कराया
15 सितंबर — 10 सुधारों और 18 सुधारात्मक बदलावों वाला Antigravity 2.14.0, Enterprise और Business खातों के लिए sidebar में integrated terminal और Git version control उपलब्ध कराता है; ये सुविधाएँ अन्य खातों के लिए 24 अगस्त के 2.10.0 संस्करण में आई थीं। बहुत लंबे इतिहास वाली बातचीत अब तेज़ी से load होती हैं और कम memory लेती हैं। skills, नियमों और customization files का वह अनावश्यक दोबारा विश्लेषण भी हटा दिया गया है, जो प्रत्येक संदेश पर फिर से शुरू होता था।
सुधारों में, अस्थायी service error अब सत्र समाप्त नहीं करती: लगभग बारह मिनट तक बढ़ते विलंब के साथ उसका पुनः प्रयास किया जाता है। पूरे हो चुके sub-agents अब सक्रिय दिखते हुए अगले संदेशों को restart होने तक अवरुद्ध नहीं करते और terminal commands के output से जुड़ी memory leak ठीक कर दी गई है। संस्करण का शीर्षक नई permissions प्रणाली का उल्लेख करता है, लेकिन इस विषय पर notes केवल सामान्य settings अनुभाग का नाम बदलकर “Global Permissions” और project settings inheritance विकल्प का नाम बदलकर “Inherit Global” करने तक सीमित हैं।
🔗 Google Antigravity का बदलाव-विवरण
IBM Research ने ALTK-Evolve की सहायता से agent का consistency gap आधा किया
15 सितंबर — Hugging Face ब्लॉग पर IBM Research ने अपनी ALTK-Evolve शृंखला का तीसरा भाग प्रकाशित किया है, जो इस बार agents के निष्पादन की निरंतरता पर केंद्रित है। AppWorld के 168 कार्यों पर तापमान 0 पर सेट GPT-4.1 के अंतर्गत चलने वाला ReAct agent पाँच प्रयासों में औसतन 77.4% निष्पादन सफलतापूर्वक पूरा करता है (Mean@5), लेकिन सभी पाँच प्रयास केवल 53.0% कार्यों के लिए सफल होते हैं (Pass^5)। IBM इन दोनों के बीच 24.4 अंकों के अंतर को consistency gap (consistency gap) कहता है।
Consistency Analyzer केवल एक दर्ज trajectory से अस्थिर निर्णय पहचानता है: वह बिना ground truth, कार्य को दोबारा चलाए बिना और logits तक पहुँच के बिना, हर चरण को offline पाँच completions का अनुरोध करके फिर से चलाता है। कमज़ोर चरण consistency guidelines (consistency guidelines) बन जाते हैं, जिन्हें inference के समय जोड़ा जाता है।
| agent configuration | Mean@5 स्कोर | Pass^5 स्कोर | consistency gap |
|---|---|---|---|
| निर्देशों के बिना ReAct GPT-4.1 | 77.4% | 53.0% | 24.4 अंक |
| consistency guidelines के साथ ReAct GPT-4.1 | 81.0% | 69.0% | 12.0 अंक |
gpt-oss-120b पर Pass^5, 10.1% से बढ़कर 16.1% हो जाता है। Analyzer और guidelines generation को ALTK-Evolve के open source repository में एकीकृत किया गया है।
🔗 Hugging Face ब्लॉग पर IBM Research की पोस्ट
Aillis ने Evidence Finder के लिए Sakana Namazu अपनाया, जापान की राष्ट्रीय चिकित्सा परीक्षा में 96.4%
14 सितंबर — machine learning पर आधारित चिकित्सा उपकरण बनाने वाली जापानी कंपनी Aillis ने अपने चिकित्सकों के लिए साक्ष्य-खोज टूल Evidence Finder में Sakana AI द्वारा अगस्त की शुरुआत में लॉन्च किए गए जापानी-विशेषज्ञ LLM Sakana Namazu को अपनाया है। Tokyo समय के अनुसार सुबह 11 बजे प्रकाशित विज्ञप्ति को Sakana AI ने उसी दिन Pacific समय के अनुसार दोपहर 3:30 बजे X पर साझा किया, जो हमारे 14 सितंबर के संकलन के बाद था। Evidence Finder चिकित्सा साहित्य के आधार पर ऐसे उत्तर तैयार करता है जो अपने संदर्भ उद्धृत करते हैं और उसकी Verify सुविधा उनके अस्तित्व की जाँच करती है; दोनों कंपनियाँ चिकित्सा उपयोगों पर संयुक्त रूप से भी काम कर रही हैं।
Sakana Namazu पर आधारित Evidence Finder के संस्करण ने फरवरी 2026 में जापान की 120वीं राष्ट्रीय चिकित्सा परीक्षा में 96.4% (500 में से 482 अंक) प्राप्त किए। 1 सितंबर को Aillis द्वारा किए गए आकलन के अनुसार, यह जापान के अर्थव्यवस्था मंत्रालय के GENIAC कार्यक्रम द्वारा नामित घरेलू foundation models में सर्वश्रेष्ठ स्कोर है। विज्ञप्ति दो सीमाएँ बताती है: इस परीक्षण के लिए product restrictions हटा दिए गए थे, जिनमें image-आधारित प्रश्नों को अस्वीकार करना भी शामिल था, जबकि commercial service केवल text-आधारित प्रश्नों को संसाधित करती है; और Evidence Finder कोई चिकित्सा उपकरण नहीं है।
🔗 PR Times पर Aillis की विज्ञप्ति 🔗 X पर Sakana AI की साझा की गई पोस्ट
Google ने AI के उपयोग और उसके सामाजिक प्रभाव को आँकड़ों में प्रस्तुत किया
15 सितंबर — Google ने उसी दिन AI के वास्तविक उपयोग और उसके सामाजिक प्रभावों पर केंद्रित पोस्ट की दो शृंखलाएँ प्रकाशित कीं।
AI & Economy ATLAS जनता के लिए उपलब्ध हुआ, साथ में वैज्ञानिकों पर एक अध्ययन
Google के मुख्य अर्थशास्त्री कार्यालय का शोध कार्यक्रम AI & Economy ATLAS, जिससे यहाँ 9 सितंबर को उद्धृत प्रशासनिक प्रक्रियाओं से जुड़े आँकड़े प्राप्त हुए थे, अब सार्वजनिक रूप से उपलब्ध interactive अनुभव बन गया है: इसमें पेशे के अनुसार, घर में और देश-दर-देश AI के उपयोग की तुलना की जा सकती है।
| प्रमुखता से प्रस्तुत ATLAS संकेतक | Google द्वारा प्रकाशित मान |
|---|---|
| भारत: AI के व्यावसायिक उपयोग में कला, design और media से जुड़े व्यवसायों की हिस्सेदारी | 19%, यानी वैश्विक औसत का 1.6 गुना |
| संयुक्त राज्य अमेरिका: computing और mathematics की हिस्सेदारी | 30%, शेष दुनिया से दोगुनी |
| ब्राज़ील और जर्मनी: उपकरण निदान जैसे manual tasks की हिस्सेदारी | 7%, जबकि जापान में 4% |
Google, Google DeepMind और MIT FutureTech के एक अध्ययन ने 2,600 विशेषीकृत AI models के विश्लेषण और 600 से अधिक अमेरिकी तथा ब्रिटिश वैज्ञानिकों के सर्वेक्षण के आधार पर बताया कि उनमें से लगभग आधे प्रतिदिन AI का उपयोग करते हैं और प्रति सप्ताह 7 घंटे से थोड़ा कम समय बचने की बात कहते हैं। लेखक इसकी कमियों को भी रेखांकित करते हैं: AI outputs को सत्यापित करने में लगने वाला समय और भौतिक प्रयोगों तथा clinical validations की प्रतीक्षा में लंबी होती अपरीक्षित परिकल्पनाओं की सूची।
🔗 Google के AI & Economy ATLAS से नई जानकारियाँ
सामाजिक प्रभाव के लिए AI: भाषाएँ, Google.org विजेता और FireSat
Google के अनुसार, समूह की तकनीकें 300 से अधिक भाषाओं में काम करती हैं, जिन्हें 7 अरब से अधिक लोग बोलते हैं, और कई डेटासेट स्थानीय साझेदारों के साथ मिलकर बनाए गए हैं। Google ने Language Explorer भी प्रस्तुत किया है, जो खुले डेटाबेस LinguaMeta को प्रदर्शित करने वाला एक इंटरैक्टिव टूल है।
| Google द्वारा उल्लिखित पहल | घोषित आँकड़ा |
|---|---|
| WAXAL, खुला वॉइस कॉर्पस | उप-सहारा अफ्रीका की 27 भाषाएँ |
| Project Vaani | 109 भाषाओं में 30,000 घंटे से अधिक का वाक् डेटा |
| Google.org Impact Challenge: AI for Government Innovation | 15 विजेता, 3 करोड़ डॉलर, 2,600 से अधिक आवेदन |
| FireSat | परिचालन उपग्रहों का पहला समूह कक्षा में, 2030 तक लगभग 50 का लक्ष्य ताकि हर 20 मिनट में एक छवि मिल सके |
| Planetary Prediction Engine, अगस्त के अंत में प्रस्तुत | Google के अनुसार, कांगो लोकतांत्रिक गणराज्य में Ebola के 83% उभरते प्रकोपों की अग्रिम पहचान |
Google.org के विजेताओं में कर रिटर्न के लिए Code for America और सड़क सुरक्षा के लिए Johns Hopkins University शामिल हैं। उन्हें Google इंजीनियरों का स्वैच्छिक सहयोग मिलता है और वे अपनी परियोजनाओं को दोबारा उपयोग किए जा सकने वाले open source मॉडल के रूप में तैयार करते हैं।
🔗 हर भाषा में सभी के लिए AI 🔗 AI की मदद से सार्वजनिक सेवाओं को रूपांतरित करने वाले 15 संगठन 🔗 विज्ञान को गति देने और जीवन बेहतर बनाने के लिए AI का निर्माण 🔗 AI की मदद से जंगल की आग का पता लगाना
संक्षिप्त समाचार
- Anthropic ने बिक्री टीमों में Claude लागू करने के लिए मार्गदर्शिका प्रकाशित की — Salesforce in Claude वाले दिन ही जारी AI-मूल राजस्व संगठन का निर्माण को एक ऐसे आलेख के माध्यम से प्रस्तुत किया गया है जिसमें दो ग्राहकों का उल्लेख है: Cox Communications का कहना है कि उसने पहले वर्ष में अपने निवेश पर 7 गुना प्रतिफल प्राप्त किया, संभावित ग्राहकों के सत्यापन और संवर्धन की लागत 86% घटाई तथा सटीकता 18% से बढ़ाकर 97% की; वहीं Cyera के लगभग 1,500 कर्मचारियों में से 88% हर सप्ताह Claude का उपयोग करते हैं। 🔗 स्रोत
- Perplexity ने छद्म AI पर मार्गदर्शिका प्रकाशित की (shadow AI) — आलेख में अपना कोई डेटा नहीं दिया गया है और वह तीसरे पक्ष के सर्वेक्षणों को संकलित करता है: लगभग आधे कर्मचारियों का कहना है कि उन्होंने AI का उपयोग करके अपने संगठन के नियमों का उल्लंघन किया है (KPMG), और Cloud Security Alliance के एक सर्वेक्षण के 82% उत्तरदाताओं ने अपने संगठन की प्रणालियों पर अज्ञात एजेंट होने की सूचना दी। इसका समापन किसी नई सुविधा के बिना Perplexity Enterprise और Comet for Enterprise के पक्ष में तर्क के साथ होता है। 🔗 स्रोत
- v0 अब मॉडल-अज्ञेय बन गया है (model-agnostic) — एक साधारण ट्वीट के अनुसार, Vercel का ऐप-निर्माण टूल Vercel AI Gateway द्वारा उपलब्ध कराए गए अग्रणी, सस्ते, खुले और तेज मॉडल प्रस्तुत करता है, जिनमें Claude, GPT, Kimi, GLM, Grok और DeepSeek शामिल हैं; न तो पूरी सूची, न मूल्य और न ही संबंधित योजनाएँ बताई गई हैं। 🔗 स्रोत
- Warp ने अपनी आंतरिक सॉफ़्टवेयर फ़ैक्टरी के आँकड़े बताए — सॉफ़्टवेयर फ़ैक्टरी (software factory) अपनाने के लिए तीन चरणों वाली कार्यपद्धति (crawl, walk, run) के आलेख में Warp के CEO Zach Lloyd बताते हैं कि कंपनी की फ़ैक्टरी उसकी मार्केटिंग साइट warp.dev के लगभग 75% बदलावों को स्वचालित करती है; Warp Factories अभी प्रारंभिक पहुँच में है और पात्र कंपनियों को 10,000 डॉलर का उपयोग निःशुल्क दिया जा रहा है। 🔗 स्रोत
- Kimi Code 0.43.1 ने अपने उप-एजेंट समूहों की समस्याएँ ठीक कीं — 0.43.0 के 19 घंटे से भी कम समय बाद Moonshot AI ने सात सुधार प्रकाशित किए, जिनमें उप-एजेंट के समाप्त होने पर मेमोरी मुक्त करना, बड़े समूहों में हल्का रेंडरिंग और इवेंट लूप, तथा ऐसा Ctrl+C शामिल है जो अब पूरी CLI बंद करने के बजाय केवल उप-एजेंटों को रोकता है। 🔗 स्रोत
- Gemini CLI v0.60.0 स्थिर संस्करण बना — यह संस्करण 8 सितंबर के preview और उसके ग्यारह सुदृढ़ीकरण बदलावों को बिना परिवर्तन अपनाता है, जबकि v0.61.0-preview.0 अगली शृंखला की शुरुआत करता है, जिसमें nightly में पहले ही प्रकाशित तीन सुधार और एजेंट लूप का एक सुधार शामिल है। 🔗 स्रोत
- Copilot ने रिपॉज़िटरी की कस्टम प्रॉपर्टी के अनुमत मान सुझाने शुरू किए — किसी कंपनी या संगठन की कस्टम प्रॉपर्टी (custom property) बनाते समय Copilot ऐसे मान सुझाता है जिन्हें एक क्लिक में स्वीकार किया जा सकता है; यह सुविधा Copilot Business और Enterprise के लिए सार्वजनिक preview में है तथा “Repository custom property suggestions” नीति के नियंत्रण में आती है। 🔗 स्रोत
- Grok Imagine बीटा में छवियों का टेक्स्ट बदलता है — SpaceXAI का छवि और वीडियो निर्माण टूल किसी भी छवि में मौजूद टेक्स्ट को संपादित कर सकता है, जैसे निमंत्रण, पोस्टर या विज्ञापन; घोषणा में न योजनाओं, न प्लेटफ़ॉर्म और न ही इस्तेमाल किए गए मॉडल का विवरण दिया गया है। 🔗 स्रोत
- MiniMax H3 ने शोर हटाने में वास्तविक समय की गति को दोगुने से अधिक पार किया — उसी दिन हमारे आँकड़े दर्ज किए जाने के बाद, 14 सितंबर को प्रशांत समयानुसार शाम 4:34 बजे प्रकाशित एक ट्वीट में MiniMax ने बताया कि SGLang-Diffusion और VDN-H3 के साथ H3, 8 B200 GPU पर 14.4 सेकंड का 768p वीडियो 9.0 सेकंड में बनाता है, और मापी गई गुणवत्ता में कोई गिरावट नहीं आती; यह 14 सितंबर को सूचीबद्ध H3 पारितंत्र का विस्तार है। 🔗 स्रोत
- Retrieve-for-Train ने reinforcement learning को एक छोटे diffusion मॉडल में डिस्टिल किया — ICML 2026 के एक शोधपत्र से लिया गया Google Research का यह काम 4B पैरामीटर वाले मॉडल को reinforcement learning (Reinforcement Learning) से केवल एक बार, ऑफ़लाइन, विविध उप-क्वेरी बनाने का प्रशिक्षण देता है; फिर इस व्यवहार को 53.9 मिलियन पैरामीटर वाले diffusion मॉडल में डिस्टिल करता है, जो पूरा समूह एक ही पास में उत्पन्न करता है और 12 से 20 गुना गति प्रदान करता है। 🔗 स्रोत
- NVIDIA ने dense मॉडल और mixture of experts के बीच चुनाव को आँकड़ों में समझाया (Mixture-of-Experts, MoE) — यह शैक्षिक आलेख 31 अगस्त को दर्ज Artificial Analysis के डेटा के आधार पर Gemma 4 31B, Qwen3.8-27B, Nemotron 3.5 Lightning और Mistral Small 4 की तुलना करता है: 30B पैरामीटर और उनमें से 3B सक्रिय पैरामीटर वाला Lightning, Qwen3.8-27B से 4 से 5 गुना तेज तथा उसकी कीमत के चौदहवें हिस्से जितना सस्ता है, लेकिन उसका क्षमता स्कोर आधे से भी कम है। 🔗 स्रोत
- NVIDIA FLARE 2.9 में Slurm जोड़ा गया — संस्करण 2.8 से Docker और Kubernetes को संभालने वाला federated learning framework (federated learning) अब एक ही federation में तीनों वातावरणों को साथ चला सकता है और प्रत्येक job के लिए संसाधनों का पोर्टेबल विवरण प्रस्तुत करता है। 🔗 स्रोत
- Sakana Marlin में इंटरैक्टिव रीडिंग और PowerPoint निर्यात जोड़े गए — इंटरैक्टिव रीडिंग (Interactive Reading) के साथ Sakana AI का स्वायत्त शोध सहायक उपयोगकर्ता को उसकी रिपोर्ट के बारे में एजेंट से प्रश्न पूछने और दावे को उचित ठहराने वाले उद्धृत स्रोत को उसी स्थान पर खोलने देता है; यह संपादन योग्य PowerPoint प्रस्तुतियाँ भी निर्यात करता है, जिनमें स्रोतों के URL मौजूद रहते हैं। 🔗 स्रोत
- ShadowPEFT को PEFT लाइब्रेरी में शामिल किया गया — सामुदायिक आलेख: स्थिर किए गए मॉडल से एक छोटा, अलग किया जा सकने वाला “छद्म” नेटवर्क जोड़ने वाली यह विधि PEFT की मुख्य शाखा में मिला दी गई है और उसके अगले संस्करण में उपलब्ध होगी; Llama-3.2-3B पर इसके लेखकों ने GSM8K में 48.1% परिणाम मापा, जबकि LoRA का परिणाम 46.9% था, लेकिन इसकी अधिकतम मेमोरी 22.3 GB के मुकाबले 28.2 GB रही। 🔗 स्रोत
- RiverRider ने फ़ाइल स्थानीयकरण की तुलना संयोग से की — व्यक्तिगत योगदान: SWE-bench Verified पर 33 मिलियन पैरामीटर वाला एक स्थानीय encoder 45.8% मामलों में सही फ़ाइल को पहले स्थान पर रखता है, लेकिन क्रम बदलकर बनाई गई क्वेरी का आधार-स्तर भी उसे 24.4% बार पहले 50 परिणामों में खोज लेता है, जिससे संकेत और संयोग का अनुपात 45.8 से घटकर 3.9 रह जाता है। 🔗 स्रोत
- EcoHash ने Qwen3.8-27B पर RTX PRO 6000 की समवर्ती क्षमता दोगुनी की — 14 सितंबर को किसी अन्य विषय के लिए पहले उद्धृत एक inference प्रदाता का यह आलेख उसकी अपनी सेवा पर किए गए मापन पर आधारित है: vLLM 0.27.1 में मॉडल के multi-token prediction head (multi-token prediction, MTP) को सक्रिय करने से प्रति token समय 22 से घटकर 13 ms हो जाता है और संभाली गई समवर्ती क्षमता 32 से बढ़कर 64 अनुरोध हो जाती है—चार में से दो परीक्षणों में यह सीमा हासिल हुई—लेकिन इसकी कीमत KV cache क्षमता के 23% के रूप में चुकानी पड़ती है। 🔗 स्रोत
- DINO-X ने यकृत की रक्त वाहिकाओं पर एक शोध मॉडल उसके विफल परिणामों सहित प्रकाशित किया — केवल शोध के लिए उपलब्ध सामुदायिक मॉडल: 86 मिलियन पैरामीटर वाला यह ViT-Base, 17,639 CT scan slices पर 0.9413 की बाहरी AUROC प्राप्त करता है; इसके लेखक ने अपने नकारात्मक परिणाम भी प्रकाशित किए हैं, जिनमें 0.6529 वाला colon specialist शामिल है जिसे जारी नहीं किया गया। 🔗 स्रोत
इसका क्या अर्थ है
आवाज़ अब अपने आप में एजेंट का पूर्ण इंटरफ़ेस बन रही है। Gemini 3.8 Live और उसका Extended Thinking संस्करण उत्तर जारी रहते हुए पृष्ठभूमि में टूल बुलाते हैं और बोलकर बताए गए कोड तथा संख्याओं की सटीकता पर विशेष ध्यान देते हैं, जबकि लागत का अनुमान प्रति मिनट ऑडियो के आधार पर लगाया जाता है। Google ने Extended Thinking संस्करण को तुरंत अपने कार्य टूल में Docs Live, Gmail Live और Keep Live के साथ शामिल कर दिया है; यह संस्करण पृष्ठभूमि के कार्यों की प्रगति पर टिप्पणी करता है। दूसरी ओर, Gemini Notebook ने प्रत्येक notebook के स्रोतों पर आधारित वॉइस वार्तालाप की घोषणा की है। अब मुद्दा आवाज़ की गुणवत्ता से हटकर इस पर केंद्रित हो रहा है कि मॉडल बोलते समय क्या पूरा करता है।
दूसरा सूत्र वितरण का है: एजेंट पहले से मौजूद रास्तों से व्यावसायिक टूल में प्रवेश कर रहे हैं। Salesforce in Claude बिक्री skills, CRM और Slack के connectors तथा प्रत्येक लेखन कार्रवाई की मंज़ूरी के साथ आता है; HP अपने PC की taskbar में Perplexity पहले से इंस्टॉल करता है और उसे Revit मॉडलों से read-only मोड में जोड़ता है; Devin को AWS Marketplace से खरीदा जाता है और एक समर्पित VPC में तैनात किया जाता है। हर मामले में एजेंट उसी टूल तक पहुँचता है जिसे कंपनी पहले से इस्तेमाल करती है और उसके सुरक्षा उपायों का पालन करता है: विक्रेता की Salesforce permissions, Revit की read-only पहुँच और AWS का समर्पित VPC।
तीसरा सूत्र विश्वसनीयता और नियंत्रण से जुड़ा है। Claude Code के संस्करण 2.1.271 और 2.1.273 उप-एजेंटों के उत्तरों की classifier से जाँच कराते हैं, प्रत्येक command के आधार पर network खोलते हैं और sub-shell अथवा अनदेखी की गई MDM settings के माध्यम से permissions को दरकिनार करने के तरीकों को ठीक करते हैं। IBM Research दिखाता है कि temperature 0 पर सेट किया गया एजेंट औसतन अपने 77.4% निष्पादन में सफल हो सकता है, लेकिन पाँचों निष्पादनों में केवल 53.0% कार्यों पर ही सफल होता है; इसलिए वह औसत के साथ Pass^k प्रकाशित करने की सलाह देता है। NVIDIA हार्डवेयर पर भी यही अपेक्षा लागू करता है: NVLink 6 लगभग 1.5 सेकंड में link को पुनर्स्थापित करता है और Shadow Engine Recovery inference बाधा को 283 सेकंड से घटाकर 7.3 सेकंड कर देता है। प्रश्न अब केवल यह नहीं है कि कोई एजेंट सफल होता है या नहीं, बल्कि यह भी है कि क्या वह सत्यापन योग्य सीमाओं के भीतर हर बार सफल होता है।
अंतिम सूत्र गति से संबंधित है। OpenAI घोषणा के एक महीने बाद अपने अनुप्रयोगों से GPT-5.5 हटा देगा, जैसा उसने पहले GPT-5.4 के साथ किया था, और जहाँ भी इसका identifier स्पष्ट रूप से चुना गया है—यहाँ तक कि scheduled tasks और scripts में भी—उसे बदलने के लिए कहता है। टूल की ओर देखें तो Claude Code ने 22 घंटों में तीन संस्करण प्रकाशित किए, Kimi Code ने पिछले संस्करण के 19 घंटे से भी कम समय में एक सुधार जारी किया और Gemini CLI ने 8 सितंबर के preview को एक सप्ताह बाद stable बनाया। इसी दौरान v0, जो अब तक अपने selector में मॉडल एक-एक करके जोड़ता था, स्वयं को model-agnostic घोषित करता है और Vercel AI Gateway पर निर्भर होता है: यहाँ मॉडल एक अदला-बदली योग्य घटक बन जाता है।
स्रोत
- Google, Gemini 3.8 Live और 3.8 Live Extended Thinking
- Google, Live API पर डेवलपर आलेख
- Google DeepMind, Gemini 3.8 Audio मॉडल विवरण
- X पर Google DeepMind, Gemini 3.8 Live की घोषणा
- Claude Code, संस्करण 2.1.271 के रिलीज़ नोट्स
- Claude Code, संस्करण 2.1.273 के रिलीज़ नोट्स
- Claude, Salesforce को Claude में लाना
- Claude सहायता केंद्र, Salesforce in Claude को कॉन्फ़िगर करना
- OpenAI, GPT-5.5 हटाने पर ChatGPT और Codex का changelog
- X पर ChatGPT, ChatGPT, ChatGPT Work और Codex में GPT-5.5 की समाप्ति
- Perplexity, HP के साथ और अधिक Windows PC पर Perplexity
- Cognition, AWS के साथ समझौता
- Devin, macOS को Devin में लाना
- NVIDIA, Groq 3 LPX का निर्धारक निष्पादन
- NVIDIA, NVLink 6 की लचीलापन क्षमता
- Google, Gemini Notebook के नए अध्ययन टूल
- Google Antigravity, changelog
- Hugging Face, IBM Research और ALTK-Evolve के साथ एजेंटों की निरंतरता
- PR Times, Aillis की प्रेस विज्ञप्ति
- X पर Sakana AI, Aillis की प्रेस विज्ञप्ति साझा की
- Google, AI & Economy ATLAS
- Google, हर भाषा में सभी के लिए AI
- Google.org, AI for Government Innovation के विजेता
- Google, विज्ञान को गति देने और जीवन बेहतर बनाने के लिए AI का निर्माण
- Google, AI की मदद से जंगल की आग का पता लगाना
- Claude, AI-मूल राजस्व संगठन का निर्माण
- Perplexity, Shadow AI
- X पर v0, Vercel AI Gateway के माध्यम से पसंद के मॉडल
- Warp, Software Factory मॉडल अपनाना
- Kimi Code, संस्करण 0.43.1 के रिलीज़ नोट्स
- Gemini CLI, संस्करण v0.60.0 के रिलीज़ नोट्स
- GitHub Changelog, Copilot द्वारा कस्टम प्रॉपर्टी के सुझाव
- X पर Grok Imagine, छवियों का टेक्स्ट बदलना
- X पर MiniMax, SGLang-Diffusion और VDN-H3 के साथ H3
- Google Research, Retrieve-for-Train
- NVIDIA, dense मॉडल या MoE
- NVIDIA, Docker, Kubernetes और Slurm के साथ FLARE
- Sakana AI, Marlin का अपडेट
- Hugging Face, PEFT में ShadowPEFT
- Hugging Face, RiverRider और फ़ाइल स्थानीयकरण
- Hugging Face, EcoHash और speculative decoding
- Hugging Face, DINO-X