ai-powered-markdown-translatorलेख का fr से hi में अनुवाद gpt-5.6-sol के साथ किया गया।
2 सितंबर के दिन उनचास घोषणाएँ हुईं, जो इस निगरानी के आरंभ के बाद से तीसरी सबसे बड़ी दैनिक संख्या है। एक ही दिन तीन प्रमुख मॉडल जारी हुए—Google का Gemini 3.8 Flash, Meta Superintelligence Labs का Muse Spark 1.3 और Alibaba का Qwen3.8-Max-0902—और इनमें से किसी ने भी केवल कच्चे स्कोर की होड़ को प्रमुखता नहीं दी।
इस संस्करण में चार मुख्य धाराएँ दिखाई देती हैं। पहली है कीमत, जो तीनों लॉन्च का केंद्रीय तर्क बन गई। दूसरी है स्थानीय इंफ़रेंस, जिसमें वीडियो जनरेशन डेस्कटॉप मशीन पर आ गई और उसी शाम Apple Silicon के एक इंफ़रेंस इंजन का कोड खोल दिया गया। तीसरी है उद्यमों में मॉडल गवर्नेंस, जहाँ GitHub एक मॉडल के लिए डेटा रिटेंशन अनिवार्य करता है और अन्य सभी के लिए डिफ़ॉल्ट चुनने देता है। चौथी है साइबर सुरक्षा, जिसमें चुनिंदा रक्षकों के लिए आरक्षित एक समर्पित मॉडल और Linux Foundation में शामिल होने वाला एक गठबंधन सामने आया।
Gemini 3.8 Flash और 3.8 Flash Cyber, समान कीमत पर अधिक मेहनत करने वाला मॉडल
2 सितंबर — Google ने Tulsee Doshi (Senior Director, Product Management) और Raluca Ada Popa (Gemini Security Lead, Google DeepMind) के नेतृत्व में दो मॉडल प्रस्तुत किए: Gemini 3.8 Flash और Gemini 3.8 Flash Cyber। यह छह सप्ताह में तीसरा Flash रिलीज़ है, जबकि 3.7 Flash को आए केवल तीन सप्ताह हुए थे।
दोनों संस्करणों की मूल बुद्धिमत्ता समान है, और Google ने कोडिंग तथा तर्क-क्षमता में हुई प्रगति का कुछ श्रेय स्पष्ट रूप से साइबर सुरक्षा क्षेत्र पर किए गए गहन प्रशिक्षण को दिया है: रक्षात्मक मॉडल के लिए किए गए कार्य ने सामान्य-उद्देश्य वाले मॉडल को भी बेहतर बनाया। प्रारंभिक मूल्य 3.7 Flash की तुलना में अपरिवर्तित है।
| Gemini 3.8 Flash की विशेषता | मापा गया मान |
|---|---|
| इनपुट मूल्य | प्रति दस लाख tokens 0,75 डॉलर |
| आउटपुट मूल्य | प्रति दस लाख tokens 3,75 डॉलर |
| HLE-Verified | 54,9 % |
एक बिंदु डेवलपर्स के ध्यान देने योग्य है, क्योंकि Google ने इसे बिल्कुल स्पष्ट रूप से कहा है: मॉडल अधिक संसाधन खर्च करता है। विश्वसनीयता में सुधार एक डिज़ाइन विकल्प से आता है—जटिल कार्यों पर 3.8 Flash तर्क के अतिरिक्त चरण चलाता है और टूल्स को पुनरावृत्त रूप से उपयोग करता है। इसलिए उच्च प्रयास स्तरों पर tokens का खर्च बढ़ता है, और Google उन वर्कलोड्स के लिए प्रयास स्तर घटाने या 3.7 Flash पर बने रहने की सलाह देता है जहाँ कंप्यूट दक्षता अधिक महत्वपूर्ण है। पिछला संस्करण पूरी तरह समर्थित रहेगा।
Cyber संस्करण सबसे असामान्य है। उसी दिन शुरू किए गए Fairwind कार्यक्रम के माध्यम से विश्वसनीय रक्षकों के लिए आरक्षित यह मॉडल कमजोरियों की स्वायत्त खोज और विशेष रूप से उनके स्वचालित सुधार के लिए बनाया गया है।
| साइबर सुरक्षा परीक्षण | Gemini 3.8 Flash Cyber | तुलना के आधार |
|---|---|---|
| CyberGym Pass@1 (C/C++ कमजोरियों की खोज) | 86,2 % | GPT-5.5-Cyber 85,6 % · Mythos 5 83,8 % · GPT-5.6 Sol 83,6 % · 3.5 Flash Cyber 77,5 % |
| 20 भाषाओं पर आंतरिक Benchmark | 70 % से अधिक | केवल C/C++ से अधिक व्यापक दायरा |
| CWE-Bench pass@1 (सुधार, Collinear) | 47,2 % | अग्रणी फ़्रंटियर मॉडल 47,8 % पर, लेकिन काफ़ी अधिक लागत के साथ |
आंतरिक परिनियोजन के आँकड़े कच्चे प्रभुत्व के बजाय लागत और प्रदर्शन के संतुलन को पुष्ट करते हैं: Chrome Security टीम को कहीं बड़े सर्वोत्तम वाणिज्यिक मॉडलों की तुलना में 2,6 गुना अधिक वैध सुधार मिले, Wiz ने अपने पैठ-परीक्षण Benchmark पर 2,3 से 5,2 गुना कम लागत में 7,5 से 9,7 % अधिक रिकॉल मापा, और Cloud Vulnerability Research टीम ने दो घंटे से भी कम समय में एक गंभीर मूलभूत कमजोरी खोज ली, जबकि ऐसी खोज में सामान्यतः कई महीने लगते हैं। सामान्य-उद्देश्य वाला मॉडल पहले ही Antigravity, Google AI Studio और Android Studio के माध्यम से Gemini API, Stitch की इंटरफ़ेस जनरेशन तथा Gemini Enterprise में परिनियोजित है; यह Gemini ऐप, Google Search के AI Mode और Google Sheets में Google AI Pro तथा Ultra ग्राहकों के लिए भी उपलब्ध है।
🔗 Gemini 3.8 Flash और 3.8 Flash Cyber की घोषणा
लॉन्च का दस्तावेज़ीकरण करने वाला CursorBench स्कोर
प्रस्तुति के कुछ ही घंटों बाद Cursor ने Gemini 3.8 Flash को अपने मॉडल चयनकर्ता में जोड़ दिया, और उसका अपना परीक्षण उपलब्ध सबसे अच्छा आकलन देता है कि एजेंटिक परिस्थितियों में मॉडल कितना सक्षम है। उसी दिन की CursorBench लॉग प्रविष्टि बताती है कि 3.8 Flash को Gemini के « नवीनतम » संस्करण का दर्जा दिया गया है और 3.7 Flash को द्वितीयक स्थान पर भेज दिया गया है।
| मॉडल और प्रयास स्तर | CursorBench 3.2 स्कोर | प्रति कार्य औसत लागत | प्रति कार्य चरण |
|---|---|---|---|
| Fable 5.1 Max | 73,4 % | 9,64 डॉलर | 70 |
| Grok 4.6 Extra High | 70,8 % | 2,81 डॉलर | 46 |
| Fable 5.1 High | 69,4 % | 4,80 डॉलर | 44 |
| Opus 5 Extra High | 69,3 % | 7,35 डॉलर | 72 |
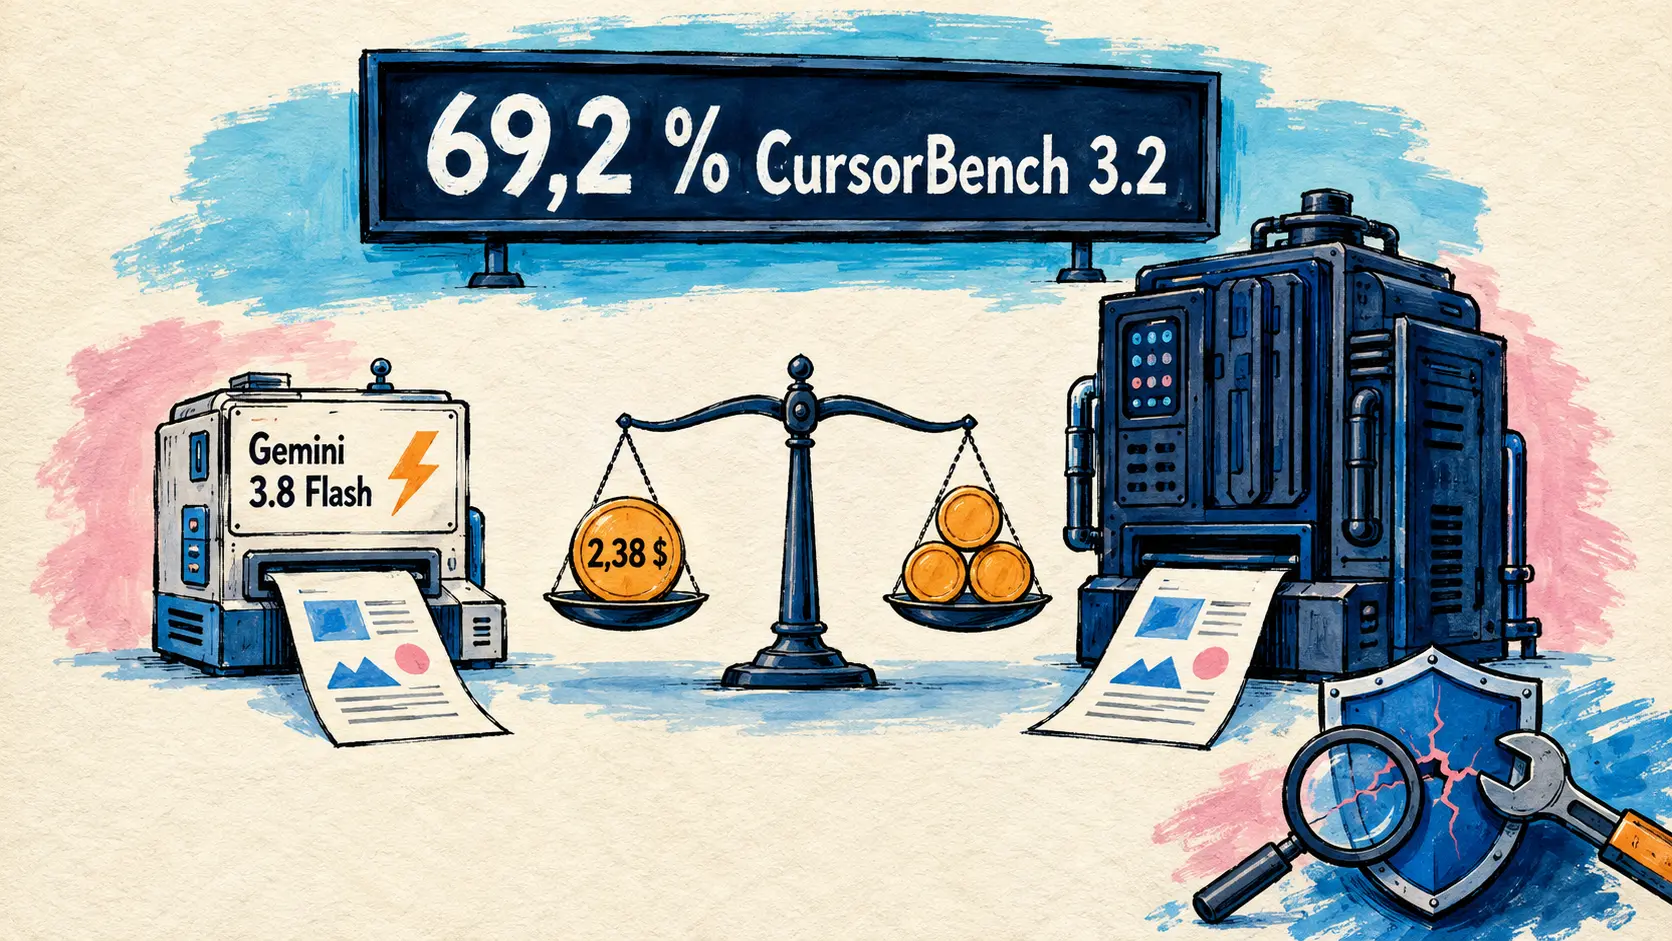
| Gemini 3.8 Flash High | 69,2 % | 2,38 डॉलर | 161 |
| Gemini 3.8 Flash Medium | 67,0 % | 1,93 डॉलर | 136 |
| Gemini 3.7 Flash High | 61,6 % | 1,20 डॉलर | 99 |
इस तालिका का सार तुरंत स्पष्ट होता है: 69,2 % पर Gemini 3.8 Flash High लगभग आधी कीमत में Fable 5.1 High के बराबर और एक-तिहाई कीमत में Opus 5 Extra High के बराबर स्कोर हासिल करता है। पिछली पीढ़ी से अंतर 7,6 अंक का है। हालाँकि, चरणों वाला कॉलम Google के डिज़ाइन विकल्प की छिपी लागत याद दिलाता है: प्रति कार्य 161 चरण, जबकि Fable 5.1 High के लिए 44। Cursor स्वयं पृष्ठ के नीचे दो सावधानियाँ बताता है—परिणामों में परिवर्तनशीलता है, और प्रदर्शित लागत वास्तविक बिल से नहीं मापी गई, बल्कि प्रति दस लाख tokens की सार्वजनिक दरों के आधार पर पुनर्निर्मित की गई है।
🔗 Cursor में Gemini 3.8 Flash · 🔗 CursorBench के परिणाम
Muse Spark 1.3, Meta Superintelligence Labs का एजेंटिक मॉडल
2 सितंबर — Meta Superintelligence Labs ने Muse Spark 1.2 के उत्तराधिकारी Muse Spark 1.3 को जारी किया, जिसे उसी दिन Muse Code और dev.meta.ai से उपलब्ध Meta Model API में परिनियोजित किया गया। Muse Voice Transcribe के बाद यह दो दिनों में प्रयोगशाला का दूसरा रिलीज़ है।
दावा स्कोर की होड़ का नहीं, बल्कि वास्तविक उपयोगिता का है। मॉडल को एक ही थ्रेड में कई प्रवाह सँभालते हुए लंबे समय तक चलने वाले काम को पूरा करने के लिए बनाया गया है: किसी खुले लक्ष्य के सामने यह अव्यवस्थित और परस्पर-विरोधी स्रोतों से अपना संदर्भ तैयार करने के लिए टूल्स का उपयोग करता है, अपनी योजना की कमियों को सुधारता है और जो कुछ सीखता है उसका रिकॉर्ड रखता है। सबसे असामान्य हिस्सा सहयोग से जुड़ा है: Muse Spark 1.3 को अस्पष्ट निर्देश मिलने पर स्पष्टीकरण माँगने, अटकने पर उपयोगकर्ता से सहायता माँगने और परिणामकारी कार्रवाई से पहले पुष्टि लेने के लिए प्रशिक्षित किया गया है। Meta के इंजीनियरों द्वारा किए गए तुलनात्मक परीक्षणों के अनुसार यह संस्करण 1.2 की तुलना में लगभग 20 % कम टूल कॉल और 25 % कम tokens का उपयोग करता है—एक ऐसा अंतर जो सीधे बिल में दिखाई देता है।
| मूल्यांकित श्रेणी | Benchmark | Muse Spark 1.3 | Muse Spark 1.2 | GPT-5.6 Sol | Opus 5 |
|---|---|---|---|---|---|
| एजेंट | GDPVal-AA v2 (बौद्धिक कार्य) | 1754 | 1615 | 1710 | 1824 |
| एजेंट | OSWorld 2.0 (डेस्कटॉप का एजेंटिक उपयोग) | 66,9 | 47,6 | 62,7 | 68,3 |
| एजेंट | DeepSearchQA (एजेंटिक नेविगेशन) | 89,4 | 85,9 | 93,0 | 90,4 |
| एजेंट | AutomationBench (आरंभ से अंत तक व्यावसायिक प्रवाह) | 49,4 | 38,2 | 46,7 | 50,3 |
| लंबा संदर्भ | MRCR 512K-1M | 98,1 | 55,5 | 73,8 | – |
| कोडिंग | DeepSWE v1.1 (लंबी एजेंटिक कोडिंग) | 75,4 | 55,0 | 73,0 | 74,0 |
| कोडिंग | SWEAtlas CodeBase QnA | 59,4 | 46,2 | 53,5 | 52,7 |
यह तालिका ध्यान से पढ़ने योग्य है। Muse Spark 1.3 लंबे संदर्भ और कोडिंग में स्पष्ट रूप से आगे है, लेकिन यहाँ चुने गए चारों एजेंटिक परीक्षणों में Opus 5 उससे आगे है। सबसे महत्वपूर्ण बात यह है कि तुलना समान परिस्थितियों में नहीं की गई, और Meta की प्रकाशित कार्यप्रणाली स्वयं यह बताती है: Muse Spark 1.3 और 1.2 का मूल्यांकन xhigh प्रयास स्तर पर किया गया, जबकि Claude Opus 5 और GPT-5.6 Sol का मूल्यांकन max मोड में हुआ। केवल DeepSWE v1.1 इसका अपवाद है, जहाँ Muse Spark 1.3 को max में मापा गया—यही वह मोड है जो अभी उपलब्ध नहीं है; Meta के अनुसार अतिरिक्त सुरक्षा परीक्षण पूरे होने के बाद इसे जारी किया जाएगा।
रोडमैप का एक अनुच्छेद खुले पारिस्थितिकी तंत्र के लिए विशेष ध्यान आकर्षित करता है।
Stay tuned for more updates soon, including bigger models, Muse Spark open weights, and more.
🇮🇳 जल्द आने वाली और ख़बरों के लिए जुड़े रहें, जिनमें बड़े मॉडल, Muse Spark के ओपन वेट्स और बहुत कुछ शामिल है। — X पर @AIatMeta
एक ऐसे वर्ष के बाद जिसमें Meta ने अपने ओपन-वेट रिलीज़ स्पष्ट रूप से कम कर दिए थे, यह प्रतिबद्धता उल्लेखनीय है—हालाँकि यह देखना बाकी है कि कौन-सा संस्करण इसके अंतर्गत आएगा, क्योंकि कोई तारीख या दायरा नहीं बताया गया है।
Qwen3.8-Max-0902 ने Code Arena WebDev में पहला स्थान हासिल किया
2 सितंबर — Qwen ने अपने प्रमुख मॉडल का अपडेट जारी किया: Qwen3.8-Max-0902, तारीख़ वाला एक snapshot जो qwen3.8-max-2026-09-02 उपनाम से भी उपलब्ध है। मॉडल अगस्त संस्करण की संरचनात्मक विशेषताएँ बरकरार रखता है—2 400 अरब parameters और 10 लाख tokens की context window—लेकिन इसे « Coding & Cowork » पर केंद्रित अतिरिक्त post-training चरण दिया गया है।
| मॉडल की विशेषता | प्रकाशित मान |
|---|---|
| Parameters | 2,4 T |
| Context window | 1 M tokens |
| अधिकतम इनपुट | 991 K tokens (thinking मोड में 983 K) |
| अधिकतम आउटपुट | 131 K tokens |
| तर्क बजट | 262 K tokens |
| इनपुट और आउटपुट मूल्य | प्रति दस लाख tokens क्रमशः 2 डॉलर और 6 डॉलर |
| स्पष्ट cache पठन | प्रति दस लाख tokens 0,17 डॉलर |
| अंतर्निहित cache पठन | प्रति दस लाख tokens 0,25 डॉलर |
| स्पष्ट cache निर्माण | प्रति दस लाख tokens 2,50 डॉलर |
| दर सीमाएँ | प्रति मिनट 1 M tokens, प्रति मिनट 15 K अनुरोध |
मॉडल इनपुट के रूप में image, text और video स्वीकार करता है तथा Responses API के माध्यम से पाँच अंतर्निहित टूल उपलब्ध कराता है: code interpreter, image-to-image search, text-to-image search, web extractor और web search। यह उसी दिन QwenCloud पर API के माध्यम से उपलब्ध हो गया।
उसी दिन Arena.ai ने Code Arena WebDev के परिणाम प्रकाशित किए। Qwen3.8-Max-0902 ने सीधे समग्र रैंकिंग में 1 691 अंकों के साथ पहला स्थान प्राप्त किया—पिछले संस्करण से 22 अंक अधिक, Max सेटिंग वाले Claude Opus 5 से 3 अंक आगे और Max सेटिंग वाले Kimi K3 से 17 अंक आगे। प्रति दस लाख tokens की 5 डॉलर मिश्रित कीमत पर यह मॉडल Arena की Pareto frontier पर सर्वोच्च अंक वाला स्थान रखता है, अर्थात पूरी रैंकिंग में स्कोर और लागत का सर्वोत्तम अनुपात।
श्रेणीवार विवरण तस्वीर को अधिक सूक्ष्म बनाता है: Data & Analytics और Consumer Product में पहला, Brand & Marketing, Gaming और Simulations में दूसरा तथा Content Creation Tools और Reference-Based Design में तीसरा स्थान। इसलिए मॉडल की ताक़त रचनात्मक कार्यों की तुलना में डेटा अनुप्रयोगों और उपभोक्ता उत्पादों में अधिक है। Arena ने आगामी Agent Arena स्कोर की घोषणा की है।
इन्फ़रेंस क्लाउड से बाहर: डेस्क पर वीडियो, खुले लाइसेंस वाला स्थानीय इंजन
यह आज का अंतर्निहित रुझान है, और इसे किसी एक घोषणा के दायरे में नहीं समेटा जा सकता। दो प्रमुख प्रकाशन और चार अपेक्षाकृत सूक्ष्म संकेत एक ही दिशा में बढ़ रहे हैं: जो काम कल तक डेटा सेंटर GPU की माँग करता था, उसे स्थानीय रूप से चलाना।
2 सितंबर — Hao AI Lab (UCSD) की FastVideo टीम ने खुले वीडियो मॉडल MiniMax H3 के अपने डिस्टिल्ड संस्करण FastH3 का स्थानीय पोर्ट जारी किया। वीडियो और ऑडियो को एक साथ उत्पन्न करने के लिए अब तक डेटा सेंटर GPU आवश्यक था; अब यह मॉडल NVIDIA DGX Spark, QSFP लिंक से जुड़ी दो DGX Spark, या कम से कम 36 GB यूनिफाइड मेमोरी वाले Mac Apple Silicon पर चलता है।
मुख्य बाधा कंप्यूटिंग शक्ति नहीं, बल्कि मेमोरी है। DGX Spark में लगभग 270 GB/s पर 128 GB यूनिफाइड LPDDR5X है, जो डेटा सेंटर HBM की बैंडविड्थ का करीब दसवाँ हिस्सा है और जिसमें किसी वर्कलोड के लिए वास्तव में 121 GB उपलब्ध है। इसलिए pipeline चरणों में आगे बढ़ती है: prompt को encode करना, text encoder को मुक्त करना, transformer को लोड करना, denoise करना, उसे मुक्त करना, फिर VAE को लोड करना। अलग GPU पर weights को host पर वापस कॉपी करने से device memory खाली हो जाती है; Spark पर यह कॉपी उसी pool में लौटती है। टीम ने इसे हटाकर सीधे GPU पर DiT लोड करना अपनाया—transformer का लोडिंग समय 445 s से घटकर 39 s हो गया, और 124 images पर 768×1344 का run 772 s से घटकर 336 s हो गया।
| परीक्षण मशीन | पहली जनरेशन | दोहराई गई जनरेशन |
|---|---|---|
| Apple M4 Max | 504 s | 465 s |
| DGX Spark | 264 s | 243 s |
| 4x GB200 | 10,2 s | 5,1 s |
DGX Spark के लिए सार्वजनिक vLLM-Omni recipe को पाँच सेकंड के वीडियो और 50 steps के साथ 1024×576 पर 1 881 s चाहिए, जबकि चार steps वाला FastH3 इसे घटाकर 268 s कर देता है, यानी लगभग 7x; यह अनुपात 832×480 पर बढ़कर 8,4x हो जाता है और 1344×768 पर घटकर 7,9x रह जाता है। M4 Max पर cache न किए गए prompt की encoding लगभग 80 s से घटकर लगभग 17 s हो जाती है, और TAEH3 decoder decoding को 102 s से 1 s तक लाते हुए peak memory को 11,0 से 3,6 GiB कर देता है। MLX weights को Hugging Face पर INT8, INT6 और INT4 में प्रकाशित किया गया है और उनके साथ पहली बार प्रकाशित FastVideo Cookbook भी है। घोषित अगला लक्ष्य: RTX परिवार, जिसमें 5090 और 4090 शामिल हैं।
उसी शाम, Perplexity ने Lily का source code खोल दिया, जो उसके Mac पर hybrid computing के on-device हिस्से को चलाने वाला स्थानीय inference engine है। इंजन को एक दिन पहले एक research post में प्रस्तुत किया गया था; नई बात Apache-2.0 लाइसेंस के अंतर्गत perplexityai/pplx-garden repository में code का प्रकाशन है, जहाँ यह fabric-lib और pplx-unigram के साथ शामिल हो गया है।
Code अत्यधिक specialization के पक्ष में किए गए चुनाव की पुष्टि करता है। Lily कोई generic engine नहीं है: यह केवल एक checkpoint लोड करता है—MLX format में affine 4-bit quantized Qwen3.6-35B-A3B, जिसका group size 64 है और जिसे loading के समय सत्यापित किया जाता है। Dense Qwen checkpoints, छोटे variants, BF16, GGUF, AWQ, GPTQ, int8 और fp8 को स्पष्ट रूप से अस्वीकार किया जाता है। Rust में लिखा गया और startup पर source से compile होने वाले Metal kernels से लैस यह engine अपने execution path में न PyTorch का उपयोग करता है, न MLX का, और इसके लिए family 10 या उसके बाद का Apple GPU—यानी M5 या नया—तथा कम से कम macOS 26 चाहिए। API surface भी उतनी ही सीमित है: केवल तीन routes, decoding हमेशा greedy, और sampling parameters, streaming, tools तथा multimodal content को अनदेखा करने के बजाय अस्वीकार किया जाता है। यही संकीर्णता दिलचस्प बिंदु है: Perplexity MLX-LM का प्रतिस्पर्धी नहीं दे रहा, बल्कि यह प्रदर्शित कर रहा है कि किसी विशिष्ट platform और model के लिए विशेष रूप से बनाया गया engine एक generic framework को मात देता है।
आज के चार अन्य प्रकाशन भी इसी दिशा में जाते हैं और संक्षिप्त समाचारों में शामिल हैं: TranslatePsy-Nano, 17 से 42 MB के translation models जो सत्रह भाषाओं को कवर करते हैं; i64 Systems का NVMe पर स्थित MoE model experts पर काम, जो output का एक byte भी बदले बिना चलता है; enterprise में छोटे models के उचित आकार-निर्धारण का समर्थन करने वाला Cohere का लेख; और Perplexity के Portable Computer को स्थानीय रूप से चलाने पर केंद्रित NVIDIA का DGX Spark live। इनमें से कोई भी अकेले बहुत भारी नहीं पड़ता, लेकिन सभी computing को डेटा सेंटर से device की ओर ले जाते हैं।
🔗 स्थानीय रूप से FastH3 · 🔗 Lily का code खोलना · 🔗 pplx-garden repository
Anthropic ने Claude Commerce Agents का code खोला
2 सितंबर — Anthropic ने Claude Commerce Agents को open source में प्रकाशित किया है, जो commerce agents बनाने के लिए Apache 2.0 लाइसेंस के अंतर्गत एक reference repository है। यह घोषणा जानबूझकर त्योहारी मौसम से पहले की गई है, जब e-commerce टीमें अपने deployments की योजना बनाती हैं।
Blueprint में दो पूर्ण agents हैं। shopping agent कंपनी के application के भीतर रहता है: यह catalog में खोजता है, प्राकृतिक भाषा में दिए गए अनुरोध के लिए वस्तुओं का एक समूह तैयार करता है, ग्राहक की प्राथमिकताएँ याद रखता है, बातचीत में products, comparisons और cart दिखाता है, फिर checkout को नियंत्रण सौंपता है—और उसी thread में customer service के प्रश्नों का उत्तर भी देता है। merchant agent store चलाने वाली टीमों के लिए है: sales analysis, promotion से पहले out-of-stock होने वाले product की चेतावनी, history-आधारित pricing recommendations और campaigns का लेखन।
| repository का घटक | प्रदान की गई सामग्री |
|---|---|
| उपलब्ध agents | shopping agent (ग्राहक) और merchant agent (back-office) |
| चलने योग्य verticals | Retail, यात्रा, दूरसंचार, टिकटिंग |
| Runtimes | Messages API, Claude Agent SDK, Claude Managed Agents (beta) |
| deployment platforms | Claude API, Amazon Bedrock, Microsoft Foundry, Google Cloud Vertex AI |
| Claude Code plugin | commerce-builder@claude-commerce-agents |
| तकनीकी पूर्वापेक्षाएँ | Python 3.11 या नया, Node 22 |
| पहले से देखे गए परिणाम | Claude पर shopping agents चला रहे retailers में: carts 35 % तक बड़े, खरीदार checkout पूरा करने के लिए 60 % अधिक इच्छुक |
Model क्या निर्णय लेता है और वास्तव में क्या execute होता है, इनके बीच विभाजन केवल घोषणात्मक नहीं बल्कि संरचनात्मक है। उपभोक्ता पक्ष पर agent द्वारा call किए जाने वाले backend interface में payment method होता ही नहीं। merchant पक्ष पर प्रत्येक write tool एक लंबित परिवर्तन बनाता है, जिसके साथ server द्वारा उत्पन्न identifier होता है, और apply_change function केवल उन्हीं identifiers के लिए सफल होता है जिन्हें वास्तविक human validation surface के माध्यम से मंज़ूरी मिली हो। Anthropic स्पष्ट करता है कि यह एक गैर-संधारित reference implementation है, जो contributions स्वीकार नहीं करता: fork करने के लिए एक शुरुआती बिंदु, follow करने के लिए dependency नहीं। demonstrations में दिखाई गई सभी कंपनियाँ काल्पनिक हैं, और कोई भी प्रक्रिया order नहीं देती या card से राशि नहीं काटती।
🔗 Claude Commerce Agents की घोषणा · 🔗 commerce-agents repository
तकनीकी पक्ष: code में cache, latency और safeguards
उसी दिन प्रकाशित और Ali Shazal तथा Matthew Koen द्वारा लिखित blueprint के साथ आने वाली engineering guide, retailers, marketplaces और travel businesses के साथ एक वर्ष के काम का सार प्रस्तुत करती है। इसकी पहली सलाह प्रचलित धारणा के उलट है: कई categories कवर करने वाले agent के लिए प्रत्येक domain का अलग sub-agent न बनाएँ। Commerce conversation एक अत्यधिक परस्पर जुड़ा हुआ एकल session है, और इसका विभाजन quality को घटाता है—क्षमताएँ skills से आती हैं, agents की संख्या बढ़ाने से नहीं।
| संबोधित विषय | Anthropic द्वारा दिया गया संख्यात्मक संकेत |
|---|---|
| render किया गया commerce response | 500 से 700 output tokens |
| cached tokens को पढ़ना | नए tokens की लागत का दसवाँ हिस्सा |
| cache में लिखना | लगभग 1,25x अधिभार, दूसरे उपयोग से ही लागत वसूल |
| लक्षित cache सफलता दर | 90 से 99 % |
| cache reads की गति | लगभग 100 000 tokens पर 1,5 से 2x तेज़ |
| memory से लाभ | internal evaluation suite पर factual recall में 13 % की वृद्धि |
| प्रत्येक flow के evaluation cases | शुरुआत के लिए 50 से 100 |
Model चयन के लिए सिफारिश है कि merchant agents के लिए Opus से शुरुआत की जाए, जहाँ analysis प्रमुख है, और consumer agents के लिए Sonnet से, जहाँ latency अधिक मायने रखती है—फिर प्रत्येक model और effort level पर संपूर्ण evaluation suite चलाया जाए और लागत को model call के बजाय पूरी हुई task के आधार पर मापा जाए। Safety section में कोई अस्पष्टता नहीं है।
The prompt is where safe behavior starts, but in commerce it can’t be where safety is enforced. The failures are financial and often irreversible, and a prompt rule is one injection or one bad sample away from being skipped.
🇮🇳 Prompt वह जगह है जहाँ सुरक्षित व्यवहार शुरू होता है, लेकिन commerce में वही जगह safety लागू करने की जगह नहीं हो सकती। विफलताएँ वित्तीय और अक्सर अपरिवर्तनीय होती हैं, और prompt का नियम केवल एक injection या एक खराब sample से दरकिनार किया जा सकता है। — Anthropic, प्रभावी commerce agents की संरचना के लिए मार्गदर्शिका
इसलिए चार नियम code में लागू किए गए हैं और केवल एक बार परिभाषित किए गए हैं, ताकि तीनों runtimes उन्हें साझा कर सकें: model तैयारी करता है, लेकिन व्यक्ति या policy लागू करती है; writes और renders केवल server द्वारा जारी identifiers स्वीकार करते हैं; सीमा वाली transactions को repeated requests के सामने भी सीमा बनाए रखनी चाहिए; third-party content को sanitize किया जाता है।
Claude Code और Claude Cowork में computer control background में चला गया
2 सितंबर — Claude द्वारा computer control (computer use) अब screen पर एकाधिकार नहीं करता। अब तक ऐसी task शुरू करने का अर्थ अपनी machine सौंप देना था: Claude के approved application में काम करने के दौरान बाकी windows छिप जाती थीं। अब Claude Cowork और desktop application के Code tab दोनों में task background में चलती रहती है, जबकि उपयोगकर्ता दूसरा काम जारी रख सकता है।
यह परिवर्तन beta में है, केवल Pro और Max plans के लिए उपलब्ध है और macOS तक सीमित है—जबकि computer use स्वयं macOS और Windows पर research preview में उपलब्ध है। पहले से इस feature का उपयोग करने वालों को कुछ भी activate नहीं करना है; अन्य लोग इसे Settings > General में पाएँगे, हालाँकि macOS में Accessibility और Screen Recording की system permissions भी आवश्यक हैं।
Security framework में कोई बदलाव नहीं हुआ है। Sandbox में चलने वाले Bash tool के विपरीत, computer use वास्तविक desktop पर execute होता है। Access levels application category के अनुसार निश्चित रहते हैं और बदले नहीं जा सकते: browsers और trading platforms के लिए केवल view, terminals और IDE के लिए केवल click—जिससे Claude को screen control के बजाय dedicated tool की ओर निर्देशित किया जाता है—और बाकी सबके लिए full control। एक approval मौजूदा session के लिए, या Dispatch से शुरू किए गए session में तीस मिनट तक वैध रहता है।
🔗 background computer use की घोषणा
Cursor अपने cloud agents को ग्राहक द्वारा प्रबंधित machines पर चलाता है
2 सितंबर — Cursor ने Jack Pertschuk द्वारा लिखित एक product post प्रकाशित की है, जो उसके cloud agents को ग्राहक के स्वामित्व वाले infrastructure के लिए खोलती है। अब तक Cursor cloud agent publisher के cloud में एक dedicated virtual machine पर चलता था। Self-Hosted Machines के साथ tools का execution कंपनी के network के भीतर स्थित machines पर चला जाता है, जबकि agent loop, inference और planning Cursor के पास रहते हैं।
इस कदम को उचित ठहराने वाला आँकड़ा शुरुआत में ही दिया गया है: अब Cursor द्वारा internally merge किए जाने वाले pull requests में 60 % से अधिक cloud agents बनाते हैं। जब काम का बढ़ता हिस्सा इन agents के माध्यम से होने लगे, तो वे किस machine पर चलते हैं, यह मामूली विवरण नहीं रह जाता। Publisher तीन स्थितियाँ बताता है जो किसी team को अपनी machines की ओर ले जाती हैं: tools को source manager और internal services के सीधे संपर्क में चलाना, विशेष hardware जैसे GPUs या iOS development के लिए Mac उपलब्ध कराना, या ऐसे operating system को चलाना जिसे cloud agent image में package करना कठिन हो।
| व्यवस्था का पहलू | तकनीकी विवरण |
|---|---|
| registration command | agent worker start, लंबे समय तक चलने वाला outbound HTTPS connection |
| connection की दिशा | Cursor कभी भी ग्राहक के network की ओर inbound connection शुरू नहीं करता |
| उपलब्ध configurations | My Machines (व्यक्तिगत workstation या VM) और Pools (team की shared queue) |
| inactivity के बाद resume | snapshot द्वारा hibernation, उसी worker identifier के साथ restoration |
| sandbox providers | AWS Lambda, Cloudflare, Coder, Daytona, E2B, Modal, Namespace, Vercel |
| computer control | अब Mac के अतिरिक्त Linux भी Chrome या Chromium के माध्यम से supported है |
Pools उस controller के माध्यम से scale होते हैं जो request queue की निगरानी करता है और team द्वारा उपलब्ध कराई गई script से machines शुरू करता है; यदि कोई worker खाली नहीं है, तो request प्रतीक्षा करती है। Machine को reset करने और उसे चालू रखने के बीच के मामले के लिए—दोनों ही दिशाओं में महँगा—Cursor hibernation प्रस्तुत करता है: inactive machine का snapshot लेकर उसे बंद कर दिया जाता है, और यदि reconnection window के भीतर पुनः शुरुआत होती है, तो snapshot restore कर दिया जाता है। चूँकि pool किसी repository से जुड़ा नहीं होता, एक ही queue कई repositories को सेवा दे सकती है।
एक सीमा, जिसे post स्वयं स्वीकार करता है: केवल execution environment स्थानांतरित होता है। Tool outputs inference के लिए Cursor के पास वापस जाते हैं और उनमें code हो सकता है, तथा agent transcripts वहाँ process और store किए जा सकते हैं। इसलिए यह पूर्ण isolation नहीं, बल्कि execution location का स्थानांतरण है।
इंटीग्रेटरों के यहाँ Claude Fable 5.1 सामान्य उपलब्धता में आया
1 और 2 सितंबर — रिलीज़ के दिन ही Claude Fable 5.1, GitHub Copilot में सामान्य रूप से उपलब्ध हो गया; अगले दिन Genspark ने इसे अपने Code Agent और Claw में एकीकृत कर लिया। एक ही मॉडल के लिए दो दिनों में दो इंटीग्रेटर: यह अपनाए जाने की लहर है, दो अलग-अलग खबरें नहीं।
GitHub में इसका दायरा व्यापक है — Visual Studio Code, Visual Studio, Copilot CLI, coding agent, GitHub Copilot एप्लिकेशन, github.com, iOS और Android पर GitHub Mobile, JetBrains IDE, Xcode और Eclipse — और यह Pro+, Max, Business तथा Enterprise प्लान के लिए, चरणबद्ध परिनियोजन और प्रदाता की सार्वजनिक दर पर बिलिंग के साथ उपलब्ध है। लेकिन इस उपलब्धता का सबसे उल्लेखनीय पहलू तकनीकी नहीं, बल्कि अनुबंध से जुड़ा है।
| पहुँच की शर्त | Fable 5.1 पर लागू प्रावधान |
|---|---|
| व्यवस्थापक नीति | डिफ़ॉल्ट रूप से निष्क्रिय, स्पष्ट रूप से सक्रिय करना आवश्यक |
| डेटा प्रतिधारण | Anthropic के सुरक्षा वर्गीकारकों के लिए डिफ़ॉल्ट रूप से अनिवार्य |
| सुरक्षित रखे गए डेटा का उपयोग | Anthropic मॉडलों के प्रशिक्षण के लिए नहीं |
| अन्य Claude मॉडल | Fable 5 और Fable 5.1 को छोड़कर शून्य प्रतिधारण बरकरार |
| शून्य प्रतिधारण से छूट | पात्र उद्यमों के लिए, कैलेंडर वर्ष के अंत तक |
| छूट के बाद | Enterprise Frontier Safeguards आवश्यक |
Copilot के अन्य Claude मॉडलों के विपरीत, Fable 5.1 में डिफ़ॉल्ट रूप से डेटा प्रतिधारण आवश्यक है: Anthropic अपने सुरक्षा वर्गीकारकों को चलाने के लिए prompts और outputs को सुरक्षित रखता है। इसलिए नीति को सक्रिय करने का अर्थ इस बाध्यता को स्पष्ट रूप से स्वीकार करना है, जबकि इसे बंद रखने पर मॉडल उपलब्ध ही नहीं होता। इससे बाहर निकलने का रास्ता अस्थायी और चुनिंदा है: पात्र उद्यम कैलेंडर वर्ष के अंत तक शून्य प्रतिधारण बनाए रख सकते हैं, ताकि इस दौरान Anthropic अपने Enterprise Frontier Safeguards तैनात कर सके, जिनसे स्वचालित सुरक्षा निगरानी तथा ग्राहक-नियंत्रित storage और encryption keys उपलब्ध होने चाहिए। पात्रता स्वयं-सेवा के माध्यम से नहीं मिलती: इसके लिए GitHub की बिक्री टीम से संपर्क करना पड़ता है, जिसे support दरकिनार नहीं कर सकता, और स्वीकृति मिलने पर भी यह अपने-आप कुछ सक्रिय नहीं करती।
दूसरी ओर, Genspark का दावा है कि उसने पहले ही दिन Genspark Code Agent और Claw में इसे एकीकृत कर लिया था, लेकिन कोई benchmark या मूल्य-निर्धारण विवरण नहीं दिया। यह प्रकाशक उन agentic platforms की सूची में शामिल हो गया है जिन्होंने मॉडल की रिलीज़ के कुछ ही घंटों के भीतर इसे अपना लिया था; इस सूची में Cursor, Devin, Warp, v0, Amp और Perplexity Computer भी शामिल हैं।
🔗 GitHub Copilot में Fable 5.1 · 🔗 Genspark की घोषणा
GitHub ने विस्तार से बताया कि गुणवत्ता घटाए बिना उसने Copilot को कैसे सस्ता बनाया
2 सितंबर — GitHub ने Napalys Klicius के साथ Erik Kristensen द्वारा लिखा गया एक engineering लेख प्रकाशित किया, जो Copilot की लागत घटाने के बारे में है। इस श्रेणी के लेखों में यह असामान्य है: इसमें आँकड़े दिए गए हैं, विफल रहे प्रयोगों का वर्णन है और समझाया गया है कि कोई स्पष्ट दिखने वाला optimization कैसे उलटा पड़ सकता है।
शुरुआती तर्क सहज धारणा के विपरीत है। किसी एक interaction के tokens गिनना दक्षता नहीं मापता: यदि किसी tool का संक्षिप्त उत्तर agent के लिए आवश्यक जानकारी छोड़ देता है, तो उसे command दोबारा चलानी पड़ती है, जिससे कुल मिलाकर कार्य धीमा और महँगा हो जाता है। GitHub ने इस जाल को RTK (Rust Token Killer) के उदाहरण से समझाया है, जो shell output को पढ़े जाने से पहले छोटा करने वाली utility है। उसने कुछ उत्तरों को सफलतापूर्वक छोटा किया, लेकिन उसके बाद के recovery steps ने अतिरिक्त turns जोड़ दिए: स्थानीय स्तर पर बचाए गए tokens वैश्विक स्तर पर खर्च हो गए। इसे तैनात नहीं किया गया।
| मूल्यांकित बदलाव | मापा गया लाभ |
|---|---|
| offline tests में line numbers हटाना | inference लागत में लगभग 5 % की कमी |
| CLI पर production में line numbers हटाना | प्रति उपयोगकर्ता औसत दैनिक लागत में लगभग 3 % की कमी |
tool task के prompt का compression | प्रति turn 1 300 tokens कम, प्रति सक्रिय घंटे की normalized लागत में 2,9 % की कमी |
| पूरा हुआ background work सीधे पहुँचाना | tokens से जुड़े उपयोग में लगभग 2,3 % की कमी, AI Credits में मापी गई |
| Copilot code review में line numbers और compression | प्रत्येक के लिए, प्रति review prompt tokens में लगभग 5 % की कमी |
| shared file tools की ओर पहले किया गया migration | review लागत में लगभग 20 % की कमी |
| RTK (Rust Token Killer) | अस्वीकार किया गया, परीक्षण किए गए configuration में कुल लागत बढ़ी |
अपनाई गई compression नीति जानबूझकर सावधान है और इसके तीन हिस्से हैं: source जैसे दिखने वाले outputs को अक्षुण्ण रखना, कुछ भी हटाए बिना search results को पुनर्व्यवस्थित करना, और केवल installation, build तथा test के दोहराव वाले शोर को compress करना। git diff का compression शुरुआती versions का हिस्सा था; benchmark tasks में agents को मूल output दोबारा खोलते देखे जाने के बाद इसे हटा दिया गया।
सबसे शिक्षाप्रद प्रसंग prompt compression से जुड़ा है। एक meta-prompting loop, जिसमें Copilot बार-बार अपने ही निर्देश को पुनर्लिखता है, ने tool task के prompt को आधा कर दिया — लेकिन पहले online experiment ने ऐसी regression उजागर की जिसे offline evaluations पकड़ नहीं पाई थीं: loop ने parallelism से जुड़े सावधानीपूर्ण निर्देश को सख्त ordering rule में बदल दिया था, जिससे स्वतंत्र agents क्रमिक रूप से चलने लगे। सुधार में allowlists और blocklists की जगह एक ही वाक्य रखा गया, जिसने निर्णय मॉडल पर छोड़ दिया। अंतिम और सबसे उपयोगी सीख: लाभ एक product से दूसरे product में स्वतः स्थानांतरित नहीं होते। Copilot code review में मिले अच्छे परिणामों से प्रेरित अधिक कसे हुए निर्देशों के एक समूह ने Copilot CLI पर लागत बढ़ा दी।
None of these changes made the model smarter. They removed work the model never needed to do.
🇮🇳 इनमें से किसी भी बदलाव ने मॉडल को अधिक बुद्धिमान नहीं बनाया। उन्होंने केवल वह काम हटा दिया जिसे मॉडल को कभी करने की आवश्यकता ही नहीं थी। — GitHub Blog, हम AI coding को अधिक किफ़ायती कैसे बनाते हैं
Copilot का मॉडल कैटलॉग पुनर्गठित हो रहा है
1 और 2 सितंबर — एक ही समय के दो changelogs समान पुनर्गठन के दोनों पहलुओं का वर्णन करते हैं: Copilot catalog से क्या हट रहा है और अब डिफ़ॉल्ट मॉडल कौन तय करता है।
1 सितंबर को अधिकांश Copilot experiences — Copilot Chat, online edits, ask और agent modes तथा code completions — में छह models को deprecated कर दिया गया।
| हटाया गया मॉडल | GitHub द्वारा सुझाया गया विकल्प |
|---|---|
| Gemini 3.1 Pro | Gemini 3.7 Flash |
| Claude Opus 4.5 | Claude Opus 4.7, Claude Opus 4.8 या Claude Opus 5 |
| Claude Opus 4.6 | Claude Opus 4.7, Claude Opus 4.8 या Claude Opus 5 |
| Claude Sonnet 4.5 | Claude Sonnet 5 |
| Claude Sonnet 4.6 | Claude Sonnet 5 |
| Raptor Mini | MAI-Code-1.1-Flash |
एक अपवाद बना हुआ है: वार्षिक plan वाले व्यक्तिगत subscribers को Claude Sonnet 4.6 उपलब्ध रहेगा। उपयोगकर्ता को कोई कार्रवाई करने की आवश्यकता नहीं है, लेकिन Copilot Enterprise administrators को अपनी policies में replacement models को स्पष्ट रूप से सक्रिय करना पड़ सकता है; ऐसा न करने पर वे न तो VS Code में और न ही github.com पर दिखाई देंगे।
इसी समय, enterprise में managed settings अब नई conversations के लिए किसी भी model को default के रूप में स्वीकार करती हैं। इसकी granularity enterprise से भी आगे जाती है: model key को overridable के रूप में घोषित करके और team-mappings.json में team configuration files को संपादित करके, कोई administrator प्रत्येक team को अपना default चुनने दे सकता है, जबकि इसके दायरे में न आने वाले users को global setting विरासत में मिलती है। यह सुविधा Copilot Business और Copilot Enterprise पर GitHub Copilot application, Copilot CLI तथा Visual Studio Code में सामान्य रूप से उपलब्ध है।
🔗 Deprecated models · 🔗 Enterprise में default model
अगस्त का Ship Log: Slack और Teams में Copilot तथा CLI में media
1 और 2 सितंबर — GitHub द्वारा X Article के रूप में प्रकाशित मासिक सारांश एक प्रचारात्मक अभ्यास है, लेकिन इसमें अगस्त की ऐसी release सामने आई जिसे पहले प्रसारित नहीं किया गया था: GitHub Copilot अब Slack और Microsoft Teams से उपलब्ध है। यह integration Copilot CLI और GitHub Copilot application की agentic capabilities को team conversations में लाता है — GitHub को mention करके thread छोड़े बिना बदलावों की योजना बनाई जा सकती है, किसी समस्या की जाँच की जा सकती है या coding task सौंपा जा सकता है।
| अगस्त के Ship Log का भाग | उपलब्ध कराया गया कार्य |
|---|---|
| Slack और Microsoft Teams में Copilot | Copilot CLI और Copilot application की agentic capabilities |
| Copilot code review, Balanced depth | सामान्य उपलब्धता, Lite के साथ; organization या repository के अनुसार default समायोज्य |
| याद दिलाए गए नए models | Gemini 3.7 Flash, MAI-Code-1.1-Flash, Fireworks AI द्वारा hosted Kimi K3 |
| GPT-5.6 Sol पर promotion | 3 सितंबर तक आधी कीमत |
| automatic selection पर promotion | Copilot Max users के लिए 30 % की छूट |
| GitHub Copilot Day | 10 सितंबर 2026 |
सारांश में Copilot code review की Balanced depth का भी विवरण है, जो Lite के साथ सामान्य रूप से उपलब्ध हो गई है: Balanced का उद्देश्य pull requests पर अधिक गहन analysis करना है, जबकि Lite सीधे बदलावों के लिए है, और default depth को organization या repository स्तर पर सेट किया जा सकता है।
महीने की एक और release command line पक्ष की तस्वीर पूरी करती है: GitHub CLI का दोहराया जा सकने वाला --attach flag, जो gh v2.99.0 से उपलब्ध है, किसी स्थानीय image या video को upload करता है और उसे किसी issue, pull request या comment में inline reference के रूप में जोड़ता है। यह Markdown लिखने वाली सभी छह commands पर काम करता है, और existing Markdown को सँभालने का तरीका इसे उपयोगी बनाता है: body में पहले से referenced local path को वहीं पुनर्लिखा जाता है, जिससे  अपना alt text बनाए रखता है और uploaded asset की ओर इंगित करता है। path में # के बाद alt text दिया जाता है। स्वीकृत formats: PNG, JPEG, GIF, WebP, SVG, MP4, MOV और WebM; paid plans पर images के लिए 10 MB और video के लिए 100 MB की सीमा है। इस version में GitHub Enterprise Server समर्थित नहीं है। GitHub स्पष्ट रूप से रेखांकित करता है कि coding agents को भी यह capability मिलती है और वे अब किसी परिणाम का वर्णन करने के बजाय उसे दिखा सकते हैं।
🔗 अगस्त 2026 का Ship Log · 🔗 GitHub CLI में media
Fairwind Program, विश्वसनीय रक्षकों के लिए आरक्षित Google cyberdefense
2 सितंबर — Gemini 3.8 Flash Cyber वाले दिन ही Google ने Fairwind Program शुरू किया, वह channel जिसके माध्यम से यह model वितरित किया जाता है। सुरक्षा और गोपनीयता के उपाध्यक्ष Four Flynn द्वारा प्रस्तुत तर्क रक्षा teams के सामने मौजूद एक ठोस दुविधा से शुरू होता है: या तो ऐसे विशाल frontier models अपनाएँ जो महँगे हैं और enterprise codebases पर नियंत्रित करना कठिन है, या फिर छोटे open-weight models पर निर्भर रहें जिन्हें जटिल vulnerabilities ठीक करने में कठिनाई होती है।
इसका उत्तर Gemini 3.8 Flash Cyber को Google के automatic remediation harness CodeMender से जोड़ता है। केंद्रीय तर्क detection नहीं, बल्कि remediation है: कमजोरियाँ पहचानने से जागरूकता और भय पैदा होते हैं, जबकि उन्हें स्वतः ढूँढ़कर ठीक करने से सुरक्षा मिलती है। वादा है कि ग्राहक संगठन के सुरक्षित cloud environment के भीतर, हफ्तों के बजाय कुछ ही मिनटों में verified और deployable fixes तैयार किए जाएँगे।
पहुँच जानबूझकर चरणबद्ध है और इसमें तीन प्राथमिक समूह हैं: सरकारें और राष्ट्रीय cyber authorities; healthcare, telecommunications, energy तथा financial networks में critical infrastructure operators; और core technology platforms। भाग लेने वाले संगठन सख्त बाध्यताएँ स्वीकार करते हैं — पहुँच को internal cybersecurity, incident response या penetration testing teams तक सीमित रखना और multi-factor authentication जैसी protections लागू करना। Google ने दुनिया भर में 650 से अधिक participating partners की घोषणा की है। कार्यक्रम के बाहर कोई भी Google Cloud ग्राहक Gemini Enterprise Agent Platform पर सार्वजनिक रूप से उपलब्ध models के साथ CodeMender का उपयोग कर सकता है, जो AI Threat Defense का पूरक है। कंपनी यह भी बताती है कि Google.org के माध्यम से उसका कुल cybersecurity funding 100 million dollars से अधिक हो चुका है, जिसमें 35 cyber clinics के लिए 36 million dollars शामिल हैं; इन clinics ने अमेरिका के 1 250 से अधिक hospitals, school districts और municipal services की सहायता की है।
Google के कमांड-लाइन टूलिंग के दो दिनों में तीन संस्करण
1 और 2 सितंबर — Google ने दो दिनों में एक ही दायरे के तीन संस्करण जारी किए, और इनसे एक स्पष्ट प्राथमिकता उभरती है: कम सुविधाएँ, अधिक पृथक्करण और स्थिरता।
| प्रकाशित संस्करण | तारीख | प्रमुख सामग्री |
|---|---|---|
| Gemini CLI v0.58.0 | 1 सितंबर | सुरक्षा-केंद्रित सात बदलाव, स्थिर चैनल में पदोन्नति |
| Antigravity CLI 1.1.23 | 1 सितंबर | दो सुधार, ग्यारह दोष-सुधार |
| Antigravity 2.12.0 | 2 सितंबर | सात सुधार, नौ दोष-सुधार |
Gemini CLI का स्थिर चैनल v0.58.0 पर पहुँच गया है। यह पदोन्नति इसलिए ध्यान में नहीं आई क्योंकि यह preview v0.59.0 के प्रकाशन के बत्तीस मिनट बाद हुई। इसकी सामग्री लगभग पूरी तरह रक्षात्मक है। सबसे ठोस सुधार macOS sandbox से संबंधित है: Seatbelt प्रोफ़ाइल अब Docker और container runtimes के sockets तथा binaries को अलग करती है, जिससे बच निकलने का एक पारंपरिक रास्ता बंद हो जाता है—होस्ट के Docker socket तक पहुँचने वाली सीमित प्रक्रिया व्यवहार में उस सीमा से बाहर निकल सकती है। दो अन्य बदलाव मूल तंत्र को अधिक सुरक्षित बनाते हैं: अनदेखे paths के प्रबंधन में symbolic links का मूल्यांकन अब सुसंगत है, और प्रथम-स्तरीय safety checkers को write-policy configuration में स्पष्ट रूप से घोषित किया गया है।
Antigravity 2.12.0 दो नई कार्यात्मक सुविधाएँ लाता है। उत्तर उद्धृत करने की सुविधा किसी उत्तर के एक अंश को हाइलाइट करके अगले prompt में संदर्भ के रूप में दोबारा डालने देती है—यह लंबे agentic sessions की रोज़मर्रा की समस्या का सीधा समाधान है। और केवल भुगतान करने वाले उपयोगकर्ताओं के लिए उपलब्ध /boost कमांड, multi-agent reasoning pipeline के माध्यम से चिंतन-प्रयास को बढ़ाता है। यह Gemini 3.8 Flash वाले दिन ही आया है, जिसके बारे में Google स्वीकार करता है कि वह अधिक tokens की कीमत पर अधिक मेहनत करता है: दोनों कदम एक ही दिशा में हैं—उपयोगकर्ता को प्रयास के स्तर पर स्पष्ट नियंत्रण देना। बाकी बदलाव वास्तविक परेशानियों को दूर करते हैं: सामान्य settings बताती हैं कि कौन-से projects किसी setting को override कर रहे हैं, split-screen terminal layouts window reload के बाद भी बने रहते हैं, और dictation चलने के दौरान भी संदेश भेजा जा सकता है।
अंत में, Antigravity CLI 1.1.23 हर चरण पर भेजने के बजाय प्रत्येक sub-trajectory पर trajectory metadata केवल एक बार भेजकर subagents की streaming को हल्का करता है, और /model में ghost text के रूप में सुझाए गए model name को Tab के माध्यम से स्वीकार करता है। इसके ग्यारह दोष-सुधार रोज़ परेशान करने वाली खामियों को उजागर करते हैं: prompt hooks से होने वाले crashes, Gemini models के लिए history दोबारा बनाते समय छूट जाने वाले tool-call identifiers, पढ़ने योग्य action descriptions के बजाय सामान्य titles दिखाने वाले permission prompts—यह सचमुच एक समस्या है, क्योंकि उपयोगकर्ता से ऐसी कार्रवाई की अनुमति माँगी जाती है जिसका वर्णन ही नहीं किया गया—और enable_mcp_tools=true के साथ घोषित ऐसे subagents जो MCP dispatcher न होने के कारण विफल हो जाते थे।
🔗 Gemini CLI v0.58.0 के रिलीज़ नोट्स · 🔗 Antigravity बदलाव-सूची
Gemini Notebook के Short Video Overviews अब 70 से अधिक भाषाओं में
1 सितंबर — Gemini Notebook ने अपने Short Video Overviews को 70 से अधिक भाषाओं तक विस्तारित किया है और अंग्रेज़ी के तीन नए प्रकार भी जोड़े हैं। यह सुविधा notebook के sources को लगभग 60 सेकंड के vertical videos में बदलती है, जिन्हें अब उपयोगकर्ता की भाषा में बनाया जा सकता है।
यह rollout web और mobile दोनों के लिए है तथा अभी भी Ultra और Pro ग्राहकों तक सीमित है—टीम ने उसी thread में स्पष्ट किया कि Pro उपयोगकर्ताओं तक इसका वितरण अभी पूरा नहीं हुआ है। घोषणा में दो और बातें जोड़ी गई हैं: notebook में मौजूद sources की संख्या token consumption की गणना में शामिल नहीं होती, और Pro उपयोगकर्ताओं के लिए अंग्रेज़ी में Cinematic Video Overviews बनाने की सुविधा बनी रहती है। अंग्रेज़ी से 70 भाषाओं तक विस्तार इस सुविधा को एक प्रदर्शन-मात्र से बदलकर अंग्रेज़ी-भाषी दुनिया के बाहर वास्तव में उपयोगी टूल बना देता है।
Editors बन रहे हैं models के multiplexers
1 और 2 सितंबर — देखने में असंबंधित दो घोषणाएँ एक ही बदलाव का वर्णन करती हैं: development environment अब third-party models तक पहुँच का माध्यम बन रहा है, और अंतर पैदा करने वाला तत्व model की गुणवत्ता से हटकर उन परिस्थितियों पर जा रहा है जिनमें वह चलता है।
Zed ने अपना स्थिर संस्करण 1.18.0 प्रकाशित किया है, जिसकी सबसे महत्वपूर्ण सामग्री release notes के AI अनुभाग में है। Editor ने एक साथ हाल की कई releases को समाहित किया है: GPT-5.6 की 1 million token context window अब Amazon Bedrock पर समर्थित है, Gemini 3.5 Flash-Lite Google AI models में शामिल हो गया है, Grok 4.5 और Grok 4.6 xAI models में शामिल हो गए हैं, और एक दिन पहले जारी Claude Fable 5.1 के समर्थन में सुधार किया गया है। इन चार में से दो प्रविष्टियाँ notes में श्रेय दिए गए बाहरी योगदान हैं। इनके साथ agents के उपयोग से जुड़ी सुविधाएँ भी हैं—बिना restart किए टूटी हुई external agent connection को reload करना, लंबे sessions में memory consumption कम करना, और connection errors में पहुँच से बाहर host का नाम दिखाना। MCP servers जोड़ने वालों के लिए एक उल्लेखनीय सुधार भी है: non-standard scopes माँगने वाले servers के साथ OAuth authentication विफल हो रहा था।
दूसरी ओर, Mistral ने अपने coding agent Vibe Code में Pro और Team योजनाओं के लिए GLM 5.2 उपलब्ध कराया है। उल्लेखनीय बात model नहीं, बल्कि उसे उपलब्ध कराने का तरीका है: Mistral इसे अपने infrastructure पर यूरोप में host करता है। इसलिए Vibe Code से GLM 5.2 उपयोग करने वाला कोई यूरोपीय developer ऐसी inference request भेजता है जिसे Mistral संचालित करता है और उसकी requests Z.ai के servers से होकर नहीं गुजरतीं। यह उस regional inference positioning का ठोस रूप है जिसका editor अगस्त से समर्थन कर रहा है—और स्थिति दोगुनी अर्थपूर्ण है, क्योंकि Mistral के पास अपना Devstral परिवार है, फिर भी वह अपने टूल में प्रतिस्पर्धी laboratory द्वारा विकसित open-weight model देने का विकल्प चुनता है।
🔗 Zed 1.18.0 के रिलीज़ नोट्स · 🔗 Vibe Code में GLM 5.2
NVIDIA: engineering के दो लेख और संरक्षण बदलने वाला एक गठबंधन
2 सितंबर — एक ही दिन NVIDIA के तीन प्रकाशन आए: दो तकनीकी और एक governance से संबंधित।
पहला लेख, model co-design शृंखला का तीसरा भाग, speculative decoding को tune करने के पाँच नियम देता है। तकनीक जानी-पहचानी है: एक छोटा draft model कई tokens प्रस्तावित करता है, जिन्हें target model एक parallel pass में जाँचता है। व्यावहारिक प्रश्न खुला रहता है—कितने tokens का अनुमान लगाया जाए और किस mechanism से। Verification के दौरान computation (1 + D) के साथ बढ़ता है, लेकिन memory accesses अपरिवर्तित रहते हैं: इसलिए draft length D को उस बिंदु तक बढ़ाना चाहिए जहाँ verification memory-bound से compute-bound हो जाए। एक प्रतिनिधि expert GEMM पर D = 7 से यह अवस्था D = 0 के लिए आवश्यक batch size के आठवें हिस्से पर प्राप्त हो जाती है। जब attention decoding time पर हावी होता है, तो optimal length D = 128/G − 1 हो जाती है, जहाँ G एक KV head साझा करने वाले query heads की संख्या है। इसके आगे ऐसी values चुनना बेहतर है जिनमें G × (1 + D), attention kernel के tile size 128 का गुणज हो। माप NVIDIA के speculative decoding benchmark SPEED-Bench पर आधारित हैं: Qwen 3.5 122B A10B को target बनाकर external draft 35B A3B, D = 9 पर 6 की acceptance length प्राप्त करता है। लेख अक्सर अनदेखे किए जाने वाले एक बिंदु पर ज़ोर देता है—अधिक acceptance का अर्थ अधिक acceleration नहीं होता—और एक चेतावनी के साथ समाप्त होता है: target की fine-tuning उसके output distribution को बदल देती है, इसलिए किसी खास checkpoint के लिए प्रशिक्षित drafter की acceptance घट सकती है, भले ही target बेहतर हो जाए।
दूसरा लेख छह चरणों वाली CUDA optimization यात्रा है, जो एक ही उदाहरण के इर्द-गिर्द बनाई गई है: तीन RGB images को grayscale में बदलना और फिर 32 × 32 pixels की प्रत्येक tile का median निकालना। शुरुआती code जानबूझकर त्रुटिपूर्ण है, और Compute Sanitizer तुरंत उसका निदान कर देता है—shared memory में सीमा से बाहर write, जो वहाँ global index इस्तेमाल करने से हुई जहाँ block index अपेक्षित था।
| Optimization चरण | कुल समय | चरण का लाभ |
|---|---|---|
| शुरुआती code | 6,8 s | — |
| CUB (DeviceTransform और BlockRadixSort) | 635 ms | लगभग 10x |
| Pooled memory containers | लगभग 244 ms | लगभग 2,6x |
| Pinned memory | 25 ms | लगभग 10x |
| प्रत्येक image के लिए एक CUDA stream | 23 ms | कुल मिलाकर लगभग 300x |
घरेलू bubble sort को cub::BlockRadixSort से बदलने भर से median calculation 2,142 s से घटकर 773 µs हो जाती है, यानी 2717 गुना सुधार। इनमें से कोई भी चरण low-level optimization नहीं है: ये API replacements हैं।
अंत में, NVIDIA द्वारा सह-स्थापित Open Secure AI Alliance, Linux Foundation में शामिल हो रहा है। Alliance का तर्क सामान्य बहस का केंद्र बदल देता है: agent केवल language model नहीं, बल्कि models, उसे context देने वाले harnesses और उसकी क्षमताओं को सीमित करने वाले guardrails से बना software system है। फिर भी safety पर चर्चा काफी हद तक केवल model पर केंद्रित रही है, जबकि security पूरे तंत्र पर निर्भर करती है—harnesses, alignment mechanisms, execution environments, identity, policy, observability और recovery। OpenSSF के सहयोग से SAFE (Shared AI Findings Exchange) पर टिप्पणियाँ आमंत्रित की गई हैं। यह AI से जुड़ी incidents और near-incidents की गोपनीय जानकारी एकत्र करने की व्यवस्था है।
🔗 Speculative decoding · 🔗 चरण-दर-चरण CUDA optimization · 🔗 Open Secure AI Alliance
Equinix Inference Exchange, 280 data centers में खुले models
2 सितंबर — Equinix ने Equinix Inference Exchange की घोषणा की है। यह distributed AI inference कार्यक्रम NVIDIA के साथ उसके सहयोग का विस्तार करता है और इसमें Together AI को जोड़ता है। यह व्यवस्था तीन layers पर आधारित है: Equinix, Equinix Fabric के माध्यम से clouds से जुड़ा physical foundation देता है, NVIDIA अपने सत्यापित enterprise reference architectures प्रदान करता है, और Together AI उसके ऊपर platform चलाता है, जिसमें shared deployment या dedicated single-tenant environment में 200 से अधिक open-source models का समर्थन है।
तर्क model चुनने के बजाय inference के स्थान पर केंद्रित है और तीन उपयोग-स्थितियों को लक्ष्य बनाता है: latency घटाने के लिए metropolitan edge inference, बंद proprietary models से workloads को खुले alternatives पर migrate करना, और regulated enterprises के लिए sovereign AI। Footprint के आँकड़े इस्तेमाल किए जा रहे network का पैमाना बताते हैं: 77 महानगरीय क्षेत्रों में 280 से अधिक data centers, 230 cloud on-ramps और 10,500 से अधिक interconnected enterprises।
हालाँकि समय-सारिणी को लेकर सावधानी आवश्यक है: Equinix की press release स्पष्ट रूप से कहती है कि समाधान 2027 की पहली तिमाही से उपलब्ध होगा, जबकि Together AI का संदेश उसके platform को Equinix के वैश्विक data centers में पहले से सक्रिय बताता है। यह साझेदारी और roadmap की घोषणा है, service launch नहीं।
BenchMIRT, benchmarks वास्तव में क्या मापते हैं इसकी जाँच के लिए Ai2 की विधि
1 सितंबर — Ai2 ने BenchMIRT प्रकाशित किया है। यह ऐसी बात पूछने वाली विधि है जिसका सीधे सामना कम ही किया जाता है: क्या कोई benchmark वास्तव में उसी क्षमता को मापता है जिसे मापने का वह दावा करता है? अंतिम score पर विचार करने के बजाय यह प्रत्येक प्रश्न के स्तर तक जाती है और अनुमान लगाती है कि सफलता वास्तव में किन क्षमताओं से निर्धारित होती है। इसके लिए psychometrics से निकली multidimensional Item Response Theory का उपयोग किया गया है। Training में 100 open-weight models, 16 benchmarks और 34,000 से अधिक प्रश्नों के परिणाम शामिल थे।
सबसे ठोस परिणाम methodological है: यह बताए बिना कि किस benchmark को क्या मापना था, BenchMIRT ने स्वयं दो प्रमुख dimensions—security और general reasoning—उजागर किए, और विश्लेषण को शून्य से दोहराने पर भी बिल्कुल वही dimensions मिले।
| जाँचा गया benchmark | Reasoning से correlation | Security से correlation | जाँच का निष्कर्ष |
|---|---|---|---|
| MMLU-Pro | 0,97 | -0,21 | घोषित उद्देश्य के अनुरूप |
| BBQ | 0,85 | -0,06 | Security test कहलाने के बावजूद reasoning का अनुसरण करता है |
| WMDP | -0,89 | 0,21 | खतरनाक knowledge की अनुपस्थिति मापता है |
| ToxiGen | 0,40 | -0,32 | दोनों में कमजोर, benchmark 92 % पर saturated |
BBQ को यह जाँचने के लिए बनाया गया था कि model सामाजिक stereotypes पर निर्भर करता है या नहीं, लेकिन उसका general reasoning के साथ correlation 0,85 है और security के साथ बिल्कुल नहीं: खराब score संभवतः model के व्यवहार की तुलना में उसके reasoning के बारे में अधिक बताता है। दूसरा योगदान व्यावहारिक है: प्रश्नों को उनकी discriminating power के अनुसार क्रमबद्ध करके Ai2 दिखाता है कि केवल 10 % प्रश्न रखने पर भी models की लगभग वही ranking बनी रहती है, और यह विधि किसी अनदेखे प्रश्न के उत्तर का 79 % मामलों में सही अनुमान लगाती है, जबकि naïve approach में यह 70 % है। दो सीमाएँ स्वीकार की गई हैं: सभी training models मार्च 2025 से पहले के हैं, और खोजे गए dimensions उपलब्ध कराए गए benchmark set पर निर्भर करते हैं।
Runway Dev MCP, coding agent ने media integration की कमान संभाली
2 सितंबर — Runway ने Runway Dev MCP लॉन्च किया है। यह hosted MCP server उसके developer platform को रोज़ इस्तेमाल होने वाले coding tool—Claude, ChatGPT, Codex या Cursor—से सीधे जोड़ता है। इसका तर्क एक वाक्य में है: integration लिखने वाला agent अब उसके लिए सही model चुन सकता है, उसके सहायक tools configure कर सकता है और उसे debug कर सकता है।
यह service integration के तीनों चरणों को समेटती है। पहली API call से पहले agent catalog से पूछता है कि project किन models का उपयोग कर सकता है, उनकी कीमत क्या है और वे कौन-से inputs लेते हैं। फिर वह चुने गए model का सटीक request schema प्राप्त करता है—उद्देश्य अनुमान लगाने के बजाय पहली कोशिश में ही सही call करना है। Production में वह Model Router बनाकर configure करता है, जो cost, latency या quality के आधार पर कई models में से चयन करता है, प्रत्येक generation के लिए cost limit लागू करता है और यह पता लगा सकता है कि किसी call के लिए router ने कौन-सा model चुना। यही logic Characters पर भी लागू होता है। तीसरा चरण debugging है: generation विफल होने पर agent एक निर्धारित tool के माध्यम से task देखता है और failure का सटीक कारण पढ़ता है—moderation rejection, asset size limit या malformed request body—फिर सुधार करके दोबारा चलाता है। Quickstart menu API key बनाता है और फिर Claude Code, Codex या Cursor को पहले से तैयार संदेश के साथ खोल देता है।
DreamX-Creator 1.0, एक ही छवि से मूल 2K ऑडियो-वीडियो निर्माण
2 सितंबर — Alibaba की AMAP टीम ने DreamX-Creator 1.0 प्रस्तुत किया है। यह Apache 2.0 लाइसेंस के अंतर्गत 7 अरब पैरामीटर वाला मॉडल है, जो एक ही छवि और टेक्स्ट प्रॉम्प्ट से शुरुआत करके मूल रूप से समकालिक 2K वीडियो और ऑडियो स्ट्रीम बनाता है, और इसके लिए वीडियो तथा ऑडियो मॉडल को क्रमिक रूप से जोड़ने की आवश्यकता नहीं होती।
सिस्टम तीन घटकों पर आधारित है: प्रगतिशील संयुक्त प्रशिक्षण के साथ गेटयुक्त अंतर-मोडल ध्यान (Gated Cross-Modal Attention), जो दोनों स्ट्रीम के बीच द्विदिश अंतःक्रिया संभव बनाता है; मोडैलिटी-संवेदी बहुमोडीय प्रतिक्रिया से संचालित ऑडियो-वीडियो पुनर्बलन अधिगम; और एक-चरणीय स्वप्रतिगामी परिशोधन, जो गति तथा ऑडियो के समय-संरेखण को बनाए रखते हुए वीडियो को 2K तक ले जाता है।
फिलहाल प्रकाशन आंशिक ही है। एक दिन पहले आरंभ किए गए GitHub रिपॉज़िटरी में परियोजना का परिचय और उसकी रूपरेखा मौजूद है, जबकि तकनीकी रिपोर्ट arXiv पर प्रकाशित हुई है। सत्यापित वेट्स, इन्फ़रेंस कोड, कॉन्फ़िगरेशन और मूल्यांकन उपकरण अभी भी अपूर्ण पड़ावों के रूप में सूचीबद्ध हैं। यह कार्य Wan2.2 और OpenMOSS के MOVA पर आधारित है, और दोनों को स्पष्ट रूप से आभार दिया गया है।
OpenAI API बहुत तेज़ स्केल-वृद्धि को मॉडल ओवरलोड से अलग करती है
2 सितंबर — OpenAI ने अपने API द्वारा ऐसी दो स्थितियों को सूचित करने का तरीका बदल दिया है, जिन्हें क्लाइंट अनुप्रयोग अब तक अलग-अलग नहीं पहचान सकते थे।
| HTTP स्थिति | त्रुटि कोड | अर्थ | अपनाई जाने वाली कार्रवाई |
|---|---|---|---|
| 429 | slow_down | अनुरोधों की दर बहुत तेज़ी से बढ़ी | Retry-After का पालन करें, दर घटाएँ और फिर उसे धीरे-धीरे बढ़ाएँ |
| 503 | server_is_overloaded | अनुरोधित मॉडल अस्थायी रूप से ओवरलोड है | Retry-After का पालन करके दोबारा प्रयास करें और त्रुटि बनी रहने पर विलंब बढ़ाएँ |
इस अंतर का पुनः प्रयास करने वाले किसी भी कोड पर तुरंत व्यावहारिक प्रभाव पड़ता है। दस्तावेज़ में स्पष्ट किया गया है कि slow_down त्रुटि तब भी हो सकती है, जब ट्रैफ़िक संगठन की प्रति मिनट अनुरोध और टोकन सीमाओं के भीतर हो: यह कोटा समाप्त होने का संकेत नहीं देती, बल्कि ऐसी गति-वृद्धि दर्शाती है जिसे अत्यधिक अचानक माना गया है—दूसरे शब्दों में, कोई अनुप्रयोग प्रदर्शित सीमाओं में से एक भी पार किए बिना धीमा किया जा सकता है। दर-सीमा मार्गदर्शिका एक व्यावहारिक नियम बताती है: ट्रैफ़िक के प्रति मिनट दस लाख इनपुट टोकन तक पहुँचने के बाद, उसे हर पंद्रह मिनट में 50% से अधिक न बढ़ाएँ। जब Retry-After हेडर अनुपस्थित हो, तो OpenAI एक छोटे यादृच्छिक विलंब के साथ एक्सपोनेंशियल बैकऑफ़ की अनुशंसा करता है, ताकि एक ही सेवा के सभी इंस्टेंस एक साथ दोबारा प्रयास न करें। जिन संगठनों का उपयोग-आधारित ट्रैफ़िक नियमित रूप से इन सीमाओं से टकराता है, उन्हें Scale Tier तथा GPT-5.6 और उसके बाद के मॉडलों के लिए Reserved Tier की ओर निर्देशित किया जाता है।
संक्षिप्त समाचार
- Claude Code 2.1.258 — केवल सुधारों वाला संस्करण: macOS 12 Monterey पर स्टार्टअप, जो 2.1.255 से खराब था, बहाल कर दिया गया है; साथ ही दूरस्थ और निर्धारित सत्र अब अनुमति की पुनःस्वीकृति के बाद विफल नहीं होते। 🔗 बदलाव-विवरण
- Claude Campus Ambassadors — इस वर्ष तीन अलग-अलग मार्गों के लिए आवेदन खुले हैं: स्नातक, स्नातकोत्तर, डॉक्टरेट और पोस्ट-डॉक्टरेट। 🔗 घोषणा
- Nokia ने Cursor से कोड की 5 करोड़ पंक्तियों का विश्लेषण किया — Core Networks विभाग के दो इंजीनियरों ने यह काम दो सप्ताह में किया, जबकि टीम का अनुमान था कि इसके लिए लगभग दर्जन भर विशेषज्ञों को कई महीनों तक लगाना पड़ेगा। यह विक्रेता का केस अध्ययन है, जिसमें कोई स्वतंत्र मापन प्रोटोकॉल नहीं है। 🔗 केस अध्ययन
- TranslatePsy-Nano — Tether AI Research ने कॉम्पैक्ट अनुवाद मॉडलों के दो परिवार जारी किए हैं: नौ यूरोपीय भाषाओं के लिए EuroNano और आठ अफ़्रीकी भाषाओं के लिए AfriNano। ये 42, 31 और 17 एमबी के संस्करणों में उपलब्ध हैं और प्रत्येक भाषा समूह के लिए केवल एक चेकपॉइंट है। 🔗 घोषणा
- Puffin-World — एकीकृत बहुमोडीय मॉडल, जो दुनिया को तीन मूल अवस्थाओं—भौतिकता, ज्यामिति और स्वरूप—के माध्यम से निरूपित करता है और Puffin-16M डेटासेट के साथ प्रकाशित किया गया है। 🔗 प्रस्तुति
- NVMe पर स्थित MoE विशेषज्ञ — i64 Systems विशेषज्ञों के वेट्स को SHA-256 मैनिफ़ेस्ट सत्यापन के साथ NVMe पर रखता है और किराए वाले पथ तथा स्थानीय पथ के बीच बाइट-दर-बाइट समान आउटपुट मापता है। 🔗 तकनीकी लेख
- CiNet International Conference में Sakana AI — मुख्य तकनीकी अधिकारी Llion Jones और शोधकर्ता Kai Arulkumaran 5 से 7 अक्टूबर 2026 तक Osaka में तंत्रिका-विज्ञान और मशीन लर्निंग के बीच सेतुओं पर व्याख्यान देंगे। 🔗 घोषणा
- Gemini CLI, 2 सितंबर का nightly संस्करण — केवल एक बदलाव: वेब पुनर्प्राप्ति उपयोगिताओं में गंतव्य सत्यापन और कनेक्शन रूटिंग में सुधार, जो अगस्त के अंत में शुरू हुई नेटवर्क सुरक्षा-सुदृढ़ीकरण प्रक्रिया की निरंतरता है। 🔗 रिलीज़ नोट्स
- MrBeast ने Google के साथ बहुवर्षीय साझेदारी की — यह समझौता Beast Industries के साथ संबंधों को YouTube से आगे Gemini और Google Health तक विस्तारित करता है। इसकी पहली वीडियो 5 सितंबर को आएगी, जिसमें जंगल, रेगिस्तान और आर्कटिक में जीवित रहने के लिए Gemini का उपयोग होगा। 🔗 घोषणा
- अगस्त की Google AI घोषणाओं का सारांश — पूरे महीने पहले ही प्रस्तुत की जा चुकी सामग्रियों को समेटने वाला मासिक लेख, जिसमें स्वयं कोई नई जानकारी नहीं है। 🔗 सारांश
- Enterprise Live Migrations की सामान्य उपलब्धता — लगभग शून्य व्यवधान के साथ डेटा रेज़िडेंसी बनाए रखते हुए GitHub Enterprise Server रिपॉज़िटरी को क्लाउड पर माइग्रेट करना, जिसे
gh elmएक्सटेंशन से नियंत्रित किया जाता है। AI से संबंधित नहीं है, पूर्णता के लिए उल्लेख किया गया है। 🔗 बदलाव-विवरण - ElevenLabs ने Ashley Kramer को मुख्य राजस्व अधिकारी नियुक्त किया — इस अवधि में कंपनी का यही एकमात्र प्रकाशन है; उसका उत्पाद बदलाव-विवरण 24 अगस्त के बाद से नहीं बदला है। 🔗 घोषणा
- NVIDIA ने Perplexity के Portable Computer पर DGX Spark का लाइव प्रसारण किया — इसके स्थानीय निष्पादन को समर्पित छब्बीस मिनट, बिना किसी वर्णनात्मक पाठ या प्रतिलेख के। यह दिन का दूसरा प्रदर्शन है जो DGX Spark को स्थानीय पोर्टिंग लक्ष्य बनाता है। 🔗 प्रसारण
- Kling AI ने अपने MCP सर्वर के Elements का दस्तावेज़ीकरण किया — विभिन्न दृश्यों में किसी पात्र की पहचान बनाए रखने पर ट्यूटोरियल; यह उत्पाद-संबंधी शिक्षण सामग्री है, कोई लॉन्च नहीं। 🔗 ट्यूटोरियल
- Codex CLI 0.152.1 — 0.152.0 के लगभग बीस घंटे बाद जारी सुधार संस्करण: Guardian की अनुमोदन समीक्षा अब मॉडल के मेटाडेटा द्वारा भेजी गई Node REPL नीतियों का पालन करती है। 🔗 रिलीज़ नोट्स
- Cohere ने उद्यमों में छोटे मॉडलों के चयन का समर्थन किया — विक्रेता उचित आकार-निर्धारण के समर्थन में Command R7B, 3.35 अरब पैरामीटर वाला Tiny Aya और North Mini Code को एक साथ प्रस्तुत करता है; North Mini Code को Artificial Analysis के Coding Index पर 33.4 अंक मिले हैं। कोई लॉन्च नहीं। 🔗 लेख
- Perplexity ने दो शैक्षिक मार्गदर्शिकाएँ प्रकाशित कीं — व्यक्तिगत सहायकों और मतिभ्रम का पता लगाने के विषय में। दूसरी मार्गदर्शिका दो-चरणीय पोस्ट-ट्रेनिंग का वर्णन करती है, जिसमें पहला चरण उत्पाद व्यवहार विकसित करता है और दूसरा अधिक कठिन शोध कार्यों पर आधारित है। 🔗 मार्गदर्शिका
इसका क्या अर्थ है
कीमत मुख्य तर्क बन गई है, यहाँ तक कि अग्रणी मॉडलों के लिए भी। एक ही दिन तीन लॉन्च हुए, और उनमें से किसी ने भी रिकॉर्ड स्कोर को प्रमुखता नहीं दी। Google ने Gemini 3.8 Flash के लिए पिछली पीढ़ी की कीमत बरकरार रखी है और स्वीकार किया है कि उसका मॉडल अधिक टोकन उपयोग करता है—एक दुर्लभ स्वीकारोक्ति, जो चर्चा को प्रदर्शित कीमत से हटाकर किसी कार्य की वास्तविक लागत पर ले जाती है। Qwen सीधे प्रथम स्थान का दावा करने के बजाय स्पष्ट रूप से Arena की Pareto सीमा के शीर्ष पर होने का दावा करता है। Meta अपने लाभ को बेंचमार्क अंकों में नहीं, बल्कि टूल कॉल में 20% और टोकन में 25% की कमी के रूप में मापता है। CursorBench तालिका दिन का सबसे स्पष्ट माप प्रस्तुत करती है: 69.2% पर Gemini 3.8 Flash की लागत प्रति कार्य 2.38 डॉलर है, जबकि समकक्ष स्कोर के लिए Fable 5.1 की लागत 4.80 डॉलर और Opus 5 की 7.35 डॉलर थी। हालाँकि, चरणों वाला स्तंभ याद दिलाता है कि यह कीमत कहीं और चुकानी पड़ती है—44 के मुकाबले 161 चरण।
हार्नेस इंजीनियरिंग एक मापने योग्य आर्थिक साधन बन रही है। GitHub का लेख इन मॉडलों पर निर्माण करने वाले किसी भी व्यक्ति के लिए दिन का सबसे उपयोगी दस्तावेज़ है: चार अनुकूलन, जो मॉडल को छुए बिना प्रत्येक में 2 से 5% तक की बचत करते हैं, और असफल प्रयोग भी दस्तावेज़ीकृत हैं। Anthropic की इंजीनियरिंग मार्गदर्शिका दूसरे छोर से यही बात कहती है—डिज़ाइन के समय से ही 90 से 99% कैश सफलता का लक्ष्य रखें और प्रति कॉल के बजाय पूरे किए गए प्रत्येक कार्य की लागत मापें। दोनों उस बिंदु पर सहमत हैं जिसे मॉडलों की दौड़ छिपा देती है: समान मॉडल होने पर हार्नेस बिल के एक महत्वपूर्ण हिस्से को निर्धारित करता है, और लाभ एक उत्पाद से दूसरे में सीधे स्थानांतरित नहीं होते। GitHub ने यह दिखाया कि कोड समीक्षा में प्रभावी रहे एक अनुकूलन ने CLI पर लागत बढ़ा दी।
इन्फ़रेंस कार्यस्थल की मशीन तक उतर रहा है, और गणना का स्थान एक डिज़ाइन पैरामीटर बन रहा है। FastH3 वीडियो निर्माण को Mac या डेस्कटॉप मशीन पर संभव बनाता है, Perplexity ऐसे इंजन का कोड खोलता है जो केवल एक ही प्रकार के हार्डवेयर पर केवल एक मॉडल चलाता है, Tether 17 एमबी के अनुवादक प्रकाशित करता है, i64 Systems MoE विशेषज्ञों को NVMe पर चलाता है और Cohere उचित आकार-निर्धारण की वकालत करता है। ऊपरी स्तर पर यह प्रवृत्ति Equinix, NVIDIA और Together AI की उस पहल से मिलती है, जो विलंबता और संप्रभुता के कारण इन्फ़रेंस को 280 डेटा केंद्रों में वितरित करती है। इन सभी को जोड़ने वाला सूत्र लघुकरण नहीं, बल्कि विशेषज्ञता है: Lily इसलिए सफल होता है क्योंकि वह Apple Silicon पर Qwen3.6-35B-A3B के अलावा हर चीज़ को अस्वीकार करता है, और Perplexity का दाँव है कि यह संकीर्णता सीमा नहीं, बल्कि लाभ है।
नियंत्रण और शासन कड़े हो रहे हैं, और अब वे तकनीक के साथ-साथ अनुबंध के माध्यम से भी लागू होते हैं। GitHub ने Fable 5.1 के लिए डेटा अवधारण अनिवार्य की है—एक ऐसी छूट के साथ जो कैलेंडर वर्ष के अंत में समाप्त हो जाएगी—और साथ ही प्रत्येक उद्यम टीम को डिफ़ॉल्ट मॉडल चुनने की सुविधा दी है तथा उसी दिन सूची से छह मॉडल हटा दिए हैं। Cursor एजेंटों के निष्पादन को ग्राहक के नेटवर्क में स्थानांतरित करता है, लेकिन स्पष्ट करता है कि प्रतिलेख अभी भी उसी के यहाँ संसाधित होते हैं। Google अपने साइबर-रक्षा मॉडल को लिखित परिचालन शर्तों के तहत 650 चयनित साझेदारों तक सीमित रखता है। Mistral यूरोप से एक चीनी मॉडल उपलब्ध कराता है और इसे अपना प्रमुख तर्क बनाता है। अंततः, BenchMIRT याद दिलाता है कि इन निर्णयों के एक हिस्से का आधार बनने वाले मूल्यांकन उपकरणों का भी ऑडिट होना चाहिए: सामाजिक पक्षपात का ऐसा बेंचमार्क, जिसका सामान्य तर्क-क्षमता से सहसंबंध 0.85 और सुरक्षा से -0.06 है, वह माप नहीं रहा जिसकी घोषणा उसका लेबल करता है।
स्रोत
- Gemini 3.8 Flash और 3.8 Flash Cyber
- CursorBench के परिणाम
- Cursor में Gemini 3.8 Flash
- Muse Spark 1.3 का परिचय
- Muse Spark की रूपरेखा
- Qwen3.8-Max-0902
- Code Arena WebDev के परिणाम
- DGX Spark और Apple Silicon पर स्थानीय FastH3
- Lily का स्रोत कोड
- Lily के कोड को सार्वजनिक करना
- Claude Commerce Agents
- commerce-agents रिपॉज़िटरी
- वाणिज्य एजेंटों की इंजीनियरिंग मार्गदर्शिका
- पृष्ठभूमि में Computer use
- Cursor Self-Hosted Machines
- GitHub Copilot में Claude Fable 5.1
- Genspark में Fable 5.1 का एकीकरण
- हम AI कोडिंग को अधिक किफ़ायती कैसे बनाते हैं
- अप्रचलित Copilot मॉडल
- उद्यम के प्रबंधित विन्यासों में डिफ़ॉल्ट मॉडल
- अगस्त 2026 का प्रेषण अभिलेख
- GitHub CLI में मीडिया
- Fairwind Program
- Gemini CLI v0.58.0
- Antigravity बदलाव-विवरण
- 70 भाषाओं में लघु वीडियो अवलोकन
- Zed v1.18.0
- Vibe Code में GLM 5.2
- सह-डिज़ाइन और speculative decoding
- व्यवहार में आधुनिक CUDA उपकरण-संग्रह
- Open Secure AI Alliance
- Equinix Inference Exchange
- BenchMIRT
- Runway Dev MCP
- DreamX-Creator 1.0
- OpenAI API का बदलाव-विवरण
- Claude Code बदलाव-विवरण
- Claude Campus Ambassadors
- Nokia और Cursor
- TranslatePsy-Nano
- Puffin-World
- NVMe पर MoE विशेषज्ञ
- CiNet International Conference में Sakana AI
- Gemini CLI, 2 सितंबर का nightly संस्करण
- MrBeast, Gemini और Google Health
- अगस्त 2026 में Google की AI घोषणाएँ
- Enterprise Live Migrations
- ElevenLabs ने Ashley Kramer को नियुक्त किया
- DGX Spark और Perplexity Portable Computer का लाइव प्रसारण
- Kling MCP के Elements
- Codex CLI 0.152.1
- Cohere और छोटे मॉडल
- Perplexity की शैक्षिक मार्गदर्शिकाएँ