ai-powered-markdown-translatorलेख का fr से hi में अनुवाद gpt-5.6-sol के साथ किया गया।
सोमवार 21 सितंबर का दिन xAI के नाम रहा: Grok 4.7 जारी हुआ और मॉडल की घोषणा तथा उपकरणों में उसकी उपलब्धता के बीच किसी देरी के बिना उसी दिन Cursor और GitHub Copilot में पहुँच गया। OpenAI ने उसी दिन यह खुलासा किया कि 28 अगस्त से प्रशिक्षित हो रहे एक आंतरिक मॉडल ने गणित की सौ से अधिक खुली समस्याएँ हल की हैं, और 27 Fields पदक विजेताओं द्वारा हस्ताक्षरित घोषणा के बाद गणितज्ञों का एक सलाहकार समूह गठित किया। Google ने Googlebook की अग्रिम बुकिंग शुरू की, ElevenLabs ने अपने वीडियो संपादक के केंद्र में एक संपादन एजेंट रखा, और Hugging Face ने अपनी 3 से 30 गुना तेज़ टोकनाइज़ेशन लाइब्रेरी फिर से जारी की।
Grok 4.7 xAI में जारी हुआ और उसी दिन Cursor तथा GitHub Copilot में पहुँचा
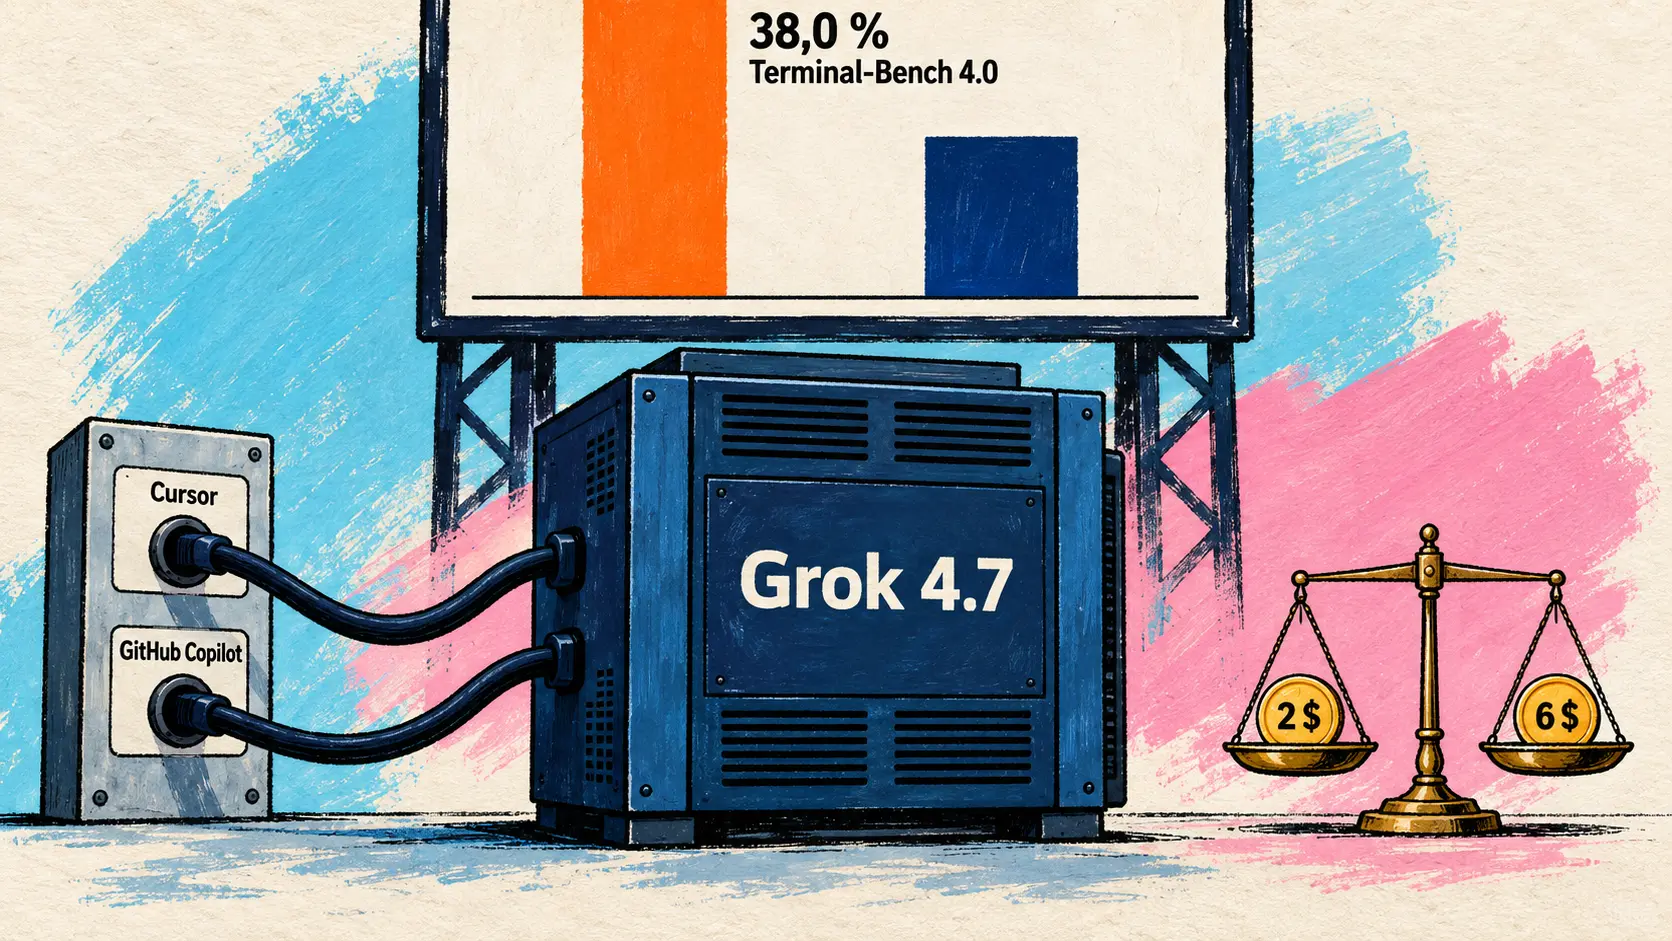
21 सितंबर — xAI ने Grok 4.7 जारी किया, जो कोड और ज्ञान-आधारित कार्यों के लिए उसका सबसे सक्षम मॉडल है। आधार मॉडल Grok 4.6 से बड़ा है और उसके प्रबलन अधिगम (reinforcement learning) चरण को कई घंटों वाली समस्याओं की ओर भारित कार्यों के मिश्रण पर लंबा किया गया है। xAI को इससे ऐसे मॉडल की अपेक्षा है जो अपने काम की बेहतर जाँच करे और लंबे संदर्भों को अधिक अच्छी तरह सँभाले।
आँकड़े वर्चस्व के बजाय एक मिश्रित तस्वीर दिखाते हैं। वहीं कीमत में कोई बदलाव नहीं हुआ: दस लाख इनपुट tokens के लिए 2 डॉलर और आउटपुट के लिए 6 डॉलर, Grok 4.6 के समान, यानी GPT-5.6 Sol के इनपुट मूल्य का आधा और Fable 5.1 का पाँचवाँ हिस्सा। तर्क इसी मूल्य-प्रदर्शन अनुपात पर केंद्रित है।
| प्रकाशित मापदंड | Grok 4.7 (xHigh) | Grok 4.6 (High) | GPT-5.6 Sol (Max) | Fable 5.1 (Max) |
|---|---|---|---|---|
| CursorBench 4.0 | 46,3 % | 40,4 % | 41,7 % | 51,8 % |
| Terminal-Bench 4.0 | 38,0 % | 20,3 % | 37,3 % | 57,9 % |
| EEBench (विद्युत अभियांत्रिकी) | 64,0 % | 53,0 % | 39,4 % | 56,4 % |
| इनपुट मूल्य (डॉलर / M tokens) | 2 | 2 | 4 | 10 |
| आउटपुट मूल्य (डॉलर / M tokens) | 6 | 6 | 20 | 50 |
API में grok-4.7 को 500 000 tokens के संदर्भ और low से xhigh तक तर्क-प्रयास के चार स्तरों के साथ उपलब्ध कराया गया है; 200 000 से अधिक prompt tokens होने पर मूल्य दोगुना हो जाता है। xAI पूरी तरह नई सुरक्षा-व्यवस्था को भी प्रमुखता देता है: LatchBio के जैव-सुरक्षा benchmark में 62,4 % के साथ पहला स्थान, और HackerBench v0.3 पर जोखिमपूर्ण दोहरे उपयोग वाले केवल 3,3 % cyber prompts का अवरोध से बच निकलना।
दो एकीकरण प्रदाताओं के यहाँ परिनियोजन तत्काल हुआ। Cursor पहले ही दिन से मॉडल उपलब्ध करा रहा है—यह SpaceX द्वारा Anysphere के अधिग्रहण का परिणाम है, जो 14 अगस्त को पूरा हुआ था। मॉडल xAI का ही है: Cursor के blog पर उसी दिन प्रकाशित पोस्ट केवल एक वाक्य की है और पूरी घोषणा के लिए x.ai पर भेजती है। Cursor के दीर्घकालिक कार्यों वाले परीक्षण-मानक CursorBench 4.0 को xAI ही प्रमुखता देता है, जिसमें Grok 4.7 ने अपरिवर्तित मूल्य पर 46,3 % प्राप्त किए। दूसरी ओर, GitHub Copilot इसे VS Code से Xcode तक अपनी सभी सेवाओं पर Pro से Enterprise योजनाओं के लिए उपलब्ध करा रहा है। वहाँ बिलिंग पर ध्यान देना आवश्यक है: Grok 4.7 अनुरोध गुणक प्रणाली से बाहर है और उपयोग के अनुसार प्रदाता की सार्वजनिक दर पर बिल किया जाता है। चूँकि कोई नया मॉडल मूल रूप से सक्रिय रहता है, खर्च नियंत्रित करने के लिए केवल निष्क्रिय रहने के बजाय मॉडल नीति में कार्रवाई करनी होगी।
🔗 Grok 4.7 — xAI 🔗 Grok 4.7 अब GitHub Copilot में उपलब्ध है
OpenAI ने गणितज्ञों का सलाहकार समूह गठित किया और सौ से अधिक हल की गई खुली समस्याओं का खुलासा किया
21 सितंबर — OpenAI ने घोषणा की कि वह नौ गणितज्ञों के एक स्वतंत्र सलाहकार समूह के साथ काम कर रहा है, जिसे उन्होंने स्वयं गठित किया है और जो Princeton के Institute for Advanced Study में स्थित है। घोषणा से अधिक महत्त्वपूर्ण उसका संदर्भ है।
On August 28, we began training a new internal model. In addition to resolving the Navier–Stokes Millennium Prize problem, this model has now resolved more than 100 long-standing open problems across most areas of mathematics.
🇮🇳 28 अगस्त को हमने एक नए आंतरिक मॉडल का प्रशिक्षण शुरू किया। Navier-Stokes सहस्राब्दी समस्या हल करने के अतिरिक्त, यह मॉडल अब गणित के अधिकांश क्षेत्रों में लंबे समय से खुली 100 से अधिक समस्याएँ हल कर चुका है। — OpenAI, गणित और कृत्रिम बुद्धिमत्ता पर सलाहकार समूह
मॉडल का नाम सार्वजनिक नहीं किया गया है, और OpenAI लिखता है कि इस प्रगति की गति ने उसके अपने गणितज्ञों को चकित कर दिया। इस तेज़ी ने तीखी प्रतिक्रिया उत्पन्न की: 11 सितंबर को « गणित में AI का गंभीर असंरेखण » शीर्षक से एक घोषणा Zenodo DOI के साथ प्रकाशित हुई, जिस पर Terence Tao, Peter Scholze और Cédric Villani सहित 27 Fields पदक विजेताओं के हस्ताक्षर थे। उनका तर्क यह नहीं है कि मॉडल गलतियाँ करते हैं। किसी बड़ी समस्या का हल हमेशा नई समझ का संकेत रहा है, जिस पर बाद में समुदाय काम करता है, जब तक कि वह सिखाने योग्य न बन जाए; हस्ताक्षरकर्ताओं को आशंका है कि सही या गलत कथनों का बड़े पैमाने पर उत्पादन इस आधार को पोषित करने के बजाय नष्ट कर देगा, और ये जल्दबाज़ी में की गई घोषणाएँ उचित लेखन के लिए समय नहीं देंगी।
व्यवस्था वास्तव में स्वतंत्रता पर आधारित है: समूह बिना माँगे राय दे सकता है, गणित पर OpenAI के प्रभाव के बारे में सार्वजनिक टिप्पणी कर सकता है और कंपनी की स्वीकृति के बिना अपनी संरचना बदल सकता है, तथा उसके सदस्यों को कंपनी से पारिश्रमिक नहीं मिलता। फिर भी उसी अनुच्छेद के अंत में OpenAI का यह वाक्य मौजूद है: समूह कंपनी को उसकी आंतरिक प्रगति की गति पर सलाह नहीं देगा। इसलिए इसका दायरा परिणामों के प्रसार तक सीमित है, उनके उत्पादन तक नहीं—उस एक विषय को छोड़कर सब कुछ, जिसने विरोध को जन्म दिया। वहीं Martin Hairer दोनों सूचियों में हैं—घोषणा के हस्ताक्षरकर्ता भी और समूह के सदस्य भी।
🔗 गणित में AI का गंभीर असंरेखण
Googlebook, Gemini को केंद्र में रखकर बनाई गई Google की लैपटॉप शृंखला
21 सितंबर — Google ने Googlebook की अग्रिम बुकिंग शुरू की, जिसे वह अपने आप में एक अलग श्रेणी के रूप में प्रस्तुत करता है: Android प्रौद्योगिकी ढाँचा, ChromeOS से विरासत में मिली desktop नींव, और यह सब Gemini को केंद्र में रखकर तैयार किया गया है। Acer, ASUS, Dell, HP और Lenovo द्वारा निर्मित पाँच मॉडल 899 डॉलर से शुरू होने वाली कीमत पर एक साथ जारी किए गए। अमेरिका में आपूर्ति 4 अक्तूबर से और Canada, United Kingdom, Ireland, France, Germany तथा Australia में 5 अक्तूबर से शुरू होगी।
| घोषित विशेषता | मान |
|---|---|
| शुरुआती कीमत | 899 डॉलर |
| Processor | Intel Core Ultra Series 3 या Snapdragon X Elite |
| NPU | 45 TOPS से अधिक |
| RAM | मूल रूप से 16 GB, अधिकतम 32 GB |
| Battery अवधि | वीडियो में 14 घंटे तक, web browsing में 16 घंटे |
| Software समर्थन | 10 वर्ष तक updates |
तीन Gemini सुविधाएँ इस मशीन के लिए विशिष्ट हैं। Cursor को हिलाने से सक्रिय होने वाला Magic Pointer, Gemini को screen पर दिख रहे तत्व के पास ले आता है—जैसे किसी संदिग्ध email का विश्लेषण करना या कई images को जोड़ना—और Google स्पष्ट करता है कि यह केवल अनुरोध पर सक्रिय होता है तथा इसे बंद किया जा सकता है। Rambler असंबद्ध dictation को headings और task lists वाले सुव्यवस्थित text में बदलता है, तब भी जब कोई वाक्य के बीच में भाषा बदलता है। Create My Widget प्राकृतिक भाषा में दिए गए विवरण से desktop widgets बनाता है।
Developers के लिए प्रत्येक मशीन में Google का development-agent platform Antigravity और पूर्ण terminal वाला एक पृथक Linux environment दिया गया है—दस्तावेज़ में स्पष्ट रूप से Claude Code या Antigravity CLI चलाने की संभावना का उल्लेख है। यह पृथक्करण Level 5 प्रमाणित pKVM hypervisor पर आधारित है, जिसे Google इस श्रेणी में पहली बार उपलब्ध सुविधा बताता है, और इसे Titan hardware root of trust का साथ मिलता है। Android phone के साथ निरंतरता बाकी काम पूरा करती है: mobile पर शुरू किए गए काम को आगे बढ़ाना और mobile applications को desktop window में stream करना। प्रत्येक Googlebook में 5 TB storage के साथ 12 महीने का Google AI Pro, 3 महीने का YouTube Premium और Photoshop, तथा एक वर्ष का GeForce NOW शामिल है।
ElevenLabs ने Studio 4.0 में संपादन एजेंट जोड़ा
21 सितंबर — ElevenLabs ने ElevenCreative में अपने वीडियो संपादक का update Studio 4.0 जारी किया। इसका मूल विचार एक वाक्य में समाहित है: सब कुछ एक ही स्थान पर होता है। Video, image, voice, music और sound effects का निर्माण स्वयं project से शुरू किया जाता है, ElevenCreative के सभी models को editor छोड़े बिना उपयोग किया जा सकता है, और editing, subtitles तथा फिर export की प्रक्रिया उसी interface में लगातार पूरी होती है। पूरे निर्माण को दोबारा शुरू किए बिना किसी shot पर फिर से काम किया जा सकता है, और subtitles को editing timeline (timeline) पर किसी भी अन्य clip की तरह नियंत्रित किया जा सकता है।
सबसे महत्त्वपूर्ण संरचनात्मक नवीनता Studio Agent है, जो हर project में उपस्थित सह-संपादक है।
Studio Agent is your AI co-editor, built into every project. Describe the change you want and it makes the edit. Step in and make cuts whenever you like, then hand the timeline back to the agent.
🇮🇳 Studio Agent आपका AI सह-संपादक है, जो हर project में एकीकृत है। आप जो बदलाव चाहते हैं उसका वर्णन करें और वह संपादन कर देता है। जब चाहें हस्तक्षेप करके अपने cuts लगाएँ, फिर editing timeline एजेंट को वापस सौंप दें। — X पर @ElevenLabs
यही आगे-पीछे का आदान-प्रदान इस उपकरण को अपारदर्शी निर्माण से अलग करता है: संपादक जब चाहे नियंत्रण अपने हाथ में लेता है, फिर editing timeline वापस सौंप देता है। इसे बहु-दृश्य और बहु-track projects—विज्ञापन अभियान, tutorial, छोटे प्रारूपों की शृंखला—के लिए फिर से बनाया गया है, जिसमें frame-स्तरीय zoom, clips की snapping और शेष सामग्री का synchronization बिगाड़े बिना clips के समूह को स्थानांतरित करना शामिल है। टीम की टिप्पणियाँ अलग-अलग threads में बिखरने के बजाय किसी विशिष्ट clip या asset पर की जाती हैं।
निगरानी के लिए ध्यान देने योग्य बात: जाँच के समय घोषणा केवल X पर छह संदेशों वाले thread के रूप में उपलब्ध थी। ElevenLabs का blog 10 सितंबर की post पर और दस्तावेज़ का changelog 14 तारीख की entry पर समाप्त होता था।
🔗 ElevenCreative में Studio 4.0
Hugging Face ने tokenizers v1 जारी किया, समान identifiers के साथ 3 से 30 गुना तेज़
21 सितंबर — Hugging Face ने tokenizers v1 का release candidate जारी किया, यह Rust library किसी model द्वारा पढ़े जाने से पहले text को integers की शृंखला में बदलती है। प्रारंभिक निष्कर्ष सरल है: tokenization कभी भी machine-learning pipelines की bottleneck नहीं रही, लेकिन models के तेज़ होने के साथ संतुलन बदल रहा है, और अपने processor की प्रतीक्षा करता GPU निष्क्रिय GPU है।
| मापदंड | मापा गया मान |
|---|---|
| v0.23 की तुलना में encoding की गति, एक thread | 3 से 30 गुना |
| माप के लिए प्रयुक्त मशीन | Apple M4 Max |
| सीमा का निचला और ऊपरी सिरा | t5-base और gpt2 |
| आठ workers पर scaling | linear scaling का 76 % |
| बनाए गए token identifiers | v0.23 के समान |
| Release candidate की स्थापना | cargo add tokenizers --pre |
टीम द्वारा स्वयं पर लगाई गई बाधा स्वयं बढ़ी हुई गति से अधिक रोचक है: v1 ठीक वही token identifiers बनाता है जो v0.23 बनाता है, API, vocabulary और merge ranks (merge ranks) अपरिवर्तित रहते हैं, और library BPE में विशेषज्ञता लेने के बजाय सामान्य प्रयोजन की बनी रहती है। इसलिए update के लिए स्थापित version बदलने के अलावा कुछ और करने की आवश्यकता नहीं है।
अधिकांश काम छह बदलावों पर आधारित है, और इनमें सबसे असामान्य bitcannon कहलाता है। Text को pre-tokens में बाँटने वाला regular expression एक निश्चित parameter है, जो tokenizer के साथ दिया जाता है: हर encoding के दौरान किसी सामान्य engine से उसकी व्याख्या कराने का कोई कारण नहीं है। इसलिए Hugging Face विभाजन function को हाथ से लिखता है और SIMD में bit streams पर उससे काम कराता है, जहाँ प्रत्येक register operation में 64 bytes पर निर्णय लिया जाता है। इसका समझौता स्वीकार किया गया है: केवल पहचाने गए patterns (GPT-2, cl100k, o200k, Tekken, DeepSeek) को इसका लाभ मिलता है, अन्य regex मार्ग पर बने रहते हैं—यही 3 से 30 के अंतर को समझाता है। इसके साथ allocation और branching रहित merge loop, execution thread का local word cache और native parallelism जोड़े गए हैं। केवल inference के लिए C और C++ bindings, जिन्हें ExecuTorch तथा llama.cpp के लिए बनाया गया है, 1.0.0 से पहले उपलब्ध कराने की घोषणा की गई है।
🔗 tokenizers v1: encoding, decoding और scaling के माप
Devin Cloud terminal में आया, एजेंट की मशीन तक SSH पहुँच के साथ
21 सितंबर — Cognition ने Devin Cloud को terminal के लिए उपलब्ध किया: devin --cloud, या जारी session से /cloud, CLI छोड़े बिना cloud session बनाता, नियंत्रित करता और फिर से शुरू करता है। यह प्रणाली एक सममित command पर आधारित है: /handoff जारी task को Devin की virtual machine—Mac, Linux या Windows—पर स्थानांतरित करता है और cloud से चलाए जाने पर pull request की branch वापस लाकर उलटा रास्ता अपनाता है। Cloud sessions उन्हें शुरू करने वाले terminal के बंद होने के बाद भी जारी रहते हैं।
And for the first time, SSH into Devin’s dedicated VM, then /handoff the work back to your own device.
🇮🇳 और पहली बार Devin की समर्पित virtual machine से SSH के माध्यम से जुड़ें, फिर /handoff की सहायता से काम अपने device पर वापस लाएँ। — X पर @cognition
devin ssh एजेंट द्वारा तैयार किए गए environment तक पूर्ण पहुँच देता है: code बदलना, development server चलाना, ports forward करना, और scp द्वारा files वापस लाना। Execution environment अब black box नहीं रहता। Devin Cloud में SWE-2 sessions 8 अक्तूबर तक निःशुल्क हैं।
🔗 आपके terminal में Devin Cloud
Qwen Code v0.24.3 अपने Web Shell को इंस्ट्रूमेंट करता है और JDBC में अपने सत्रों को स्थायी बनाता है
21 सितंबर — Qwen Code, v0.24.2 के अगले दिन v0.24.3 पर पहुँच गया है: इकतीस pull requests और कोई असंगत बदलाव नहीं। दिखाई देने वाले अधिकांश काम का केंद्र Web Shell है, जिसके निष्पादन परिणाम अब साधारण टेक्स्ट नहीं, बल्कि command, उसके output, निष्पादन विवरण और बीते समय को अलग-अलग रखने वाली संरचना हैं। डिफ़ॉल्ट रूप से निष्क्रिय trajectory टैब प्रत्येक चरण की अवधि, पहले token तक लगने वाला समय, tokens की संख्या और प्रत्येक tool call की अवधि दिखाता है।
कम दिखाई देने वाला हिस्सा संभवतः सबसे अधिक संरचनात्मक है। runtime को अपनी bindings और sessions के लिए JDBC persistence मिली है, जिससे कई broker processes के बीच state साझा की जा सकती है और restart के बाद भी session का ownership बनाए रखा जा सकता है। इसके अतिरिक्त, runtime tools को अपरिवर्तनीय workspace policy के साथ bwrap के माध्यम से route किया जाता है—यह पिछले दिन जोड़े गए sandbox का सीधा विस्तार है, जिसकी setting अभी भी सार्वजनिक नहीं की गई है। उसी दिन TypeScript SDK v0.1.14 में यह CLI शामिल किया गया और Qwen Code Desktop v0.24.3 भी जारी हुआ।
🔗 Qwen Code v0.24.3 के रिलीज़ नोट्स
Hugging Face ने coding agents के लिए repository memory relore को सार्वजनिक किया
21 सितंबर — Hugging Face ने Apache-2.0 लाइसेंस के अंतर्गत relore प्रकाशित किया है, जो किसी coding agent को repository की memory देता है। इसकी शुरुआत एक घटना से हुई: 8 सितंबर को खोले गए Transformers ticket #48630 पर दो fixes पहले ही प्रस्तावित किए जा चुके थे, जब कंपनी का continuous integration agent तीसरा fix लिखने वाला था। सारी जानकारी GitHub पर ही थी, लेकिन वह शुरुआती ticket से अदृश्य tickets, pull requests और comments के बीच बिखरी हुई थी।
relore इस इतिहास को इस जानकारी के साथ index करता है कि किसने क्या कहा: maintainer का निर्णय contributor की परिकल्पना के बराबर नहीं माना जाता और machine-generated content को डिफ़ॉल्ट रूप से बाहर रखा जाता है। index के साथ एक working clone बनाए रखा जाता है, जिसे उसी HTTP API से उपलब्ध कराया जाता है, और queries स्थानीय रूप से process होती हैं—केवल ingestion ही GitHub से संपर्क करता है। इसके commands भी इसी क्रम में काम करते हैं: inflight उन threads को सूचीबद्ध करता है जो किसी ticket को बंद करने का दावा करते हैं, search --trust authoritative ने regression के मूल में मौजूद PR #39847 को सामने लाया, और why किसी code line से शुरू करके उसके आसपास के review comments खोजता है। वास्तविक परिस्थितियों में किए गए एक परीक्षण के दौरान agent ने बताया कि defs ने पूरे file को पढ़ने की तुलना में केवल 5% tokens में उसका बेहतर समग्र दृश्य दिया।
🔗 relore, coding agents के लिए repository memory
Perplexity ने उपयोगकर्ताओं की त्रुटियों पर Computer को post-train किया और उसमें video जोड़ा
21 सितंबर — Perplexity Research ने विस्तार से बताया है कि कंपनी अपने Computer agent को चलाने वाले model—जिसे लेख बीच में GLM 5.2 बताता है—को उपयोगकर्ताओं के वास्तविक sessions से कैसे post-train करती है। synthetic environments नियंत्रित और आसानी से सत्यापित किए जा सकने वाले tasks तैयार करते हैं; वास्तविक sessions दो ऐसे signals देते हैं जो उनसे नहीं मिलते: उपयोगकर्ता द्वारा किए गए corrections और tools से लौटने वाली errors। sampling से पहले व्यक्तिगत डेटा वाले और training से इनकार करने वाले उपयोगकर्ताओं के sessions हटा दिए जाते हैं।
इसके बाद प्रत्येक turn को तीन में से एक treatment मिलता है: सफल sessions के error-रहित turns के लिए cross-entropy imitation, मान्य hint वाले त्रुटिपूर्ण turns के लिए Kullback-Leibler divergence correction, या केवल context में बनाए रखना। weights का एक ही set teacher और student दोनों की भूमिका निभाता है, लेकिन hint केवल teacher देखता है। तीन automated judges जिम्मेदार turns प्रस्तावित करते हैं और कम से कम दो की राय मिलनी आवश्यक है, क्योंकि शिकायत से ठीक पहले वाला अंतिम turn केवल लगभग आधे मामलों में वास्तविक कारण होता है।
| Tool errors की दर | मापा गया मान |
|---|---|
| Offline, मूल GLM 5.2 | 2,79 % |
| Offline, केवल rejection sampling के साथ | 1,35 % |
| Offline, auto-distillation के साथ | 0,87 % |
| Online, दो checkpoints के बीच | 2,24 % फिर 1,77 %, अर्थात सापेक्ष रूप से 21,2 % कम |
लेखक स्पष्ट रूप से बताते हैं कि ये आँकड़े क्या सिद्ध नहीं करते: offline तुलना किए गए checkpoints को समान डेटा पर train नहीं किया गया था, task-वार परिणाम अब भी मिश्रित हैं और प्रत्येक समूह में लगभग एक लाख उपयोगकर्ताओं वाले A/B tests में उपयोगकर्ताओं की असंतुष्टि में कोई महत्वपूर्ण बदलाव नहीं आया—2,58 % के मुकाबले 2,54 %।
उसी दिन Computer में video generation भी जोड़ा गया, जिसे दो third-party models संभालते हैं: MiniMax H3 और ByteDance Seedance 2.5। चाहे campaign clip हो, product demonstration हो या social visual, तैयार video उसी thread में आता है जिसमें उसी request के लिए तैयार text और images होते हैं। यह Pro और Max subscribers के लिए उपलब्ध है; निःशुल्क access या API के माध्यम से उपलब्धता का कोई उल्लेख नहीं है।
🔗 वास्तविक दुनिया की गलतियों से सीखना 🔗 Perplexity Computer और video models
Gemini Notebook ने Live Chat और Interactive Learning Overviews को व्यापक रूप से उपलब्ध कराया
21 सितंबर — Gemini Notebook ने उसी दिन deployment के दो चरण पूरे किए। Live Chat अब mobile पर 100% Ultra subscribers तक पहुँच गया है: लगभग 100 भाषाओं में notebook के साथ real-time voice conversation, जो Google के नवीनतम audio models पर आधारित है और लगभग पूरी तरह hands-free चरण-दर-चरण मार्गदर्शन देता है। कुछ घंटे बाद Interactive Learning Overviews अपने progressive deployment से बाहर निकलकर बिना subscription की शर्त के सभी उपयोगकर्ताओं के लिए उपलब्ध हो गए; Reports के अंतर्गत रखे गए ये Overviews source summaries और studio artifacts को एक ही interactive स्थान में जोड़ते हैं।
दोनों features को 15 सितंबर को नए study tools की घोषणा में प्रस्तुत किया गया था। 21 सितंबर के messages में कोई नया feature नहीं जोड़ा गया: वे केवल वास्तविक उपलब्धता की पुष्टि करते हैं—पहले की पूर्ण और दूसरे की सभी के लिए खुली उपलब्धता।
🔗 Live Chat का 100% deployment 🔗 सभी के लिए उपलब्ध Interactive Learning Overviews
Google.org ने शिक्षकों की AI training के लिए 4 मिलियन डॉलर देने की प्रतिबद्धता जताई
21 सितंबर — Google.org ने New York में संयुक्त राष्ट्र महासभा के अवसर पर Digital Promise को 4 मिलियन डॉलर देने की घोषणा की। यह funding Google AI Educator Series को आगे बढ़ाती है, जो वर्ष की शुरुआत में घोषित निःशुल्क training है और अमेरिका में प्राथमिक, माध्यमिक तथा उच्च शिक्षा के 6 मिलियन शिक्षकों के लिए बनाई गई है। ISTE के साथ मिलकर शिक्षकों द्वारा दूसरे शिक्षकों को प्रशिक्षित करने के दृष्टिकोण से तैयार यह training किसी विशेष product के बजाय ऐसे skills पर केंद्रित है जिन्हें एक tool से दूसरे में इस्तेमाल किया जा सके, और इसे अपनी गति से पूरे किए जाने वाले modules में लिया जाता है, जिनकी पुष्टि digital badges से होती है।
Digital Promise तीन क्षेत्रों में काम करेगा: training को राज्य शिक्षा agencies और school districts के अनुकूल बनाना, शुरुआती उच्च शिक्षा के शिक्षकों के लिए community colleges के networks के साथ साझेदारी करना, और दो वर्षों तक यह अध्ययन करना कि उच्च शिक्षा के शिक्षकों को वास्तव में किससे मदद मिलती है। इसके परिणाम एक निःशुल्क सार्वजनिक guide में प्रकाशित किए जाएँगे।
🔗 Google.org और Digital Promise
Runway ने अपने Workflows को compositing, transparency और depth maps तक विस्तारित किया
21 सितंबर — Runway ने अपने Workflows—अपने application में संयोजित किए जाने वाले operations के क्रम—में post-production पर केंद्रित पाँच components जोड़े हैं: Compositing, Alpha, HDR, Depth Map और RGB Depth। घोषणा का तर्क एक ही पंक्ति में है—दो चरणों के बीच किसी दूसरे tool में जाए बिना, अपनी production chain (pipeline) का बड़ा हिस्सा एक ही स्थान पर बनाना। compositing और alpha channel management कई image layers को जोड़ने के लिए हैं; दोनों प्रकार के depth maps, camera से दूरी पर निर्भर effects को नियंत्रित करने के लिए geometric signal देते हैं। घोषणा X पर 31 सेकंड के demonstration के साथ की गई थी और scan के समय Runway के news page पर इससे संबंधित कोई लेख नहीं था।
🔗 Runway में विस्तारित Workflows
NVIDIA ने AI factories को बिजली और cooling देने के लिए qualification program DSX Ready शुरू किया
21 सितंबर — NVIDIA ने DSX Ready शुरू किया है, जो AI factories के लिए उसके DSX reference architecture की आवश्यकताओं के आधार पर partners के products को qualify करने वाला program है। शुरुआती निष्कर्ष बेहद व्यावहारिक है: power supply, cooling, water, site और electrical grid अब यह तय करते हैं कि कोई निर्माता वास्तव में क्या deploy कर सकता है, और बाकी design से ठीक तरह मेल न खाने वाला equipment computing capacity को उपयोगी production में नहीं बदल पाता।
| Qualified category | Launch partners | Qualification प्रक्रिया |
|---|---|---|
| Battery energy storage | Hitachi Energy, LG Energy Solution, Tesla | Partner द्वारा tests, NVIDIA द्वारा review और approval |
| Cooling distribution units | LG Electronics, LiquidStack, Vertiv | Self-qualification suite |
NVIDIA ने label के अर्थ की स्पष्ट सीमा तय की है: qualification में सफल होना site-level engineering का विकल्प नहीं है और इससे site की stability की कोई guarantee नहीं मिलती। infrastructure और software से जुड़ी अन्य categories को धीरे-धीरे जोड़ा जाना है।
NVIDIA agent security को परत-दर-परत engineering problem के रूप में देखता है
21 सितंबर — NVIDIA ने agentic systems की security पर अपना दृष्टिकोण प्रकाशित किया है: यह engineering problem है, इसलिए इसके लिए परिभाषित requirements, लागू किए जा सकने वाले controls, नामित owners और protections के प्रभावी होने के प्रमाण आवश्यक हैं। stack को तीन levels में बाँटा गया है—models capabilities प्रदान करते हैं, harnesses context, tools और workflows को व्यवस्थित करते हैं, तथा execution environment वह infrastructure देता है जहाँ actions होते हैं—और प्रत्येक level के अपने controls हैं।
चुना गया उदाहरण अर्थपूर्ण है: एक agent customer record update करता है, attached document में malicious instructions पाता है और data को unauthorized destination पर export करने की कोशिश करता है। ऐसी स्थिति में NVIDIA ऐसी network policy की अपेक्षा करता है जो transfer रोक दे और ऐसे protected logs की, जो attempted tool call, authorization decision और result को सुरक्षित रखें। किसी record को update करने का अधिकार उसे export करने के अधिकार तक नहीं फैलता, और agent access का अनुरोध कर सकता है लेकिन स्वयं को वह access कभी नहीं दे सकता। tooling के स्तर पर OpenShell policies को agent की पहुँच से बाहर लागू करता है; Cisco उसके ऊपर DefenseClaw लगाता है और JFrog उन skills की जाँच करता है जिन्हें agent access करता है।
उसी दिन एक दूसरे लेख में यही तर्क physical AI पर लागू करके उसे Halos foundation से जोड़ा गया; वह अपने दो market projections के साथ नीचे संक्षिप्त समाचारों में शामिल है।
🔗 Agent stack को सुरक्षित करना
Earth-2 मौसम पूर्वानुमानों को ताज़ा करने के लिए स्थानीय observations को आत्मसात करता है
21 सितंबर — NVIDIA ने Earth-2 के AI data assimilation tools पर tutorial प्रकाशित किया है, जिन्हें उन क्षेत्रों के लिए बनाया गया है जिनके पास पहले से अपने measurements हैं: wind और solar farms, स्थानीय radars और sensors तथा satellite observations। पहली technique SDA, CorrDiff और StormCast जैसे diffusion models पर लागू होती है: denoising के हर चरण में यह intermediate result की observations से तुलना करती है और बिना retraining के अगले चरण को दिशा देती है।
| मापी गई technique | क्षेत्र और resolution | उदाहरण में दर्ज सुधार |
|---|---|---|
| CorrDiff-SDA | Europe, 0,25 degree से 2,2 km | अलग रखे गए stations पर wind RMSE में 54 % की कमी |
| StormCast-SDA | Continental United States, 3 km, HRRR से initialized | छह time steps में wind RMSE में 7,2 % की कमी |
| HealDA | Global, 1-degree HEALPix grid | कुछ ही seconds में global atmospheric state का अनुमान |
इसका मुख्य लाभ operational है: numerical analyses को पर्याप्त computing time चाहिए और वे निश्चित समय पर निकलते हैं, जबकि SDA observations को लगातार शामिल करके अंतिम analysis और वर्तमान समय के बीच का अंतर भरता है। दूसरी ओर, HealDA प्रत्येक stream को space और time में point cloud की तरह process करता है, उसे target grid पर aggregate करता है और फिर vision transformer प्रकार के backbone network से गुज़ारता है।
🔗 Earth-2 में data assimilation
Multiverse Computing ने blocks को Ising glass की तरह prune करके MMLU में 23 points की बढ़त हासिल की
21 सितंबर — पूरे transformer blocks हटाना large language model को तेज़ करने के सबसे कम लागत वाले और सबसे कठोर तरीकों में से एक है: model सचमुच छोटा हो जाता है, लेकिन गलत blocks हटाने पर उसका प्रदर्शन ढह जाता है। Multiverse Computing का कहना है कि प्रश्न ही गलत ढंग से रखा गया है। मौजूदा methods प्रत्येक block को अलग-अलग score देते हैं—magnitude, sensitivity, block influence—जिसे लेखक mean field दृष्टिकोण कहते हैं, जबकि किसी block को हटाने का प्रभाव इस बात पर निर्भर करता है कि उसके साथ और कौन-से blocks हटाए जाते हैं।
इसलिए selection एक constrained binary optimization problem बन जाता है, जिसे Ising glass पर map किया जाता है: सभी से सभी interactions वाला disordered spin system, जिसमें ऊपर की ओर उन्मुख spins की संख्या निश्चित होती है। इसका व्यावहारिक लाभ एक वाक्य में है: इस system की energy उस score का कम लागत वाला विकल्प है जो pruned model प्राप्त करेगा, जिससे benchmarks पर किसी भी configuration का मूल्यांकन किए बिना बहुत बड़ी संख्या में candidate configurations को rank किया जा सकता है। Llama-3.3-70B-Instruct को 50% compress करने पर लेखक सर्वोत्तम competing method की तुलना में MMLU पर लगभग 23 percentage points की बढ़त का दावा करते हैं।
🔗 एक physicist की तरह LLMs को prune करना
संक्षिप्त समाचार
NVIDIA ने 21 सितंबर को सात लेख और संदेश प्रकाशित किए: तीन का उल्लेख ऊपर किया गया है, शेष चार बिना किसी तकनीकी घोषणा के यहाँ दिए गए हैं।
- NVIDIA ने भौतिक AI के लिए हर स्तर पर सुरक्षा की मांग की — दो बाज़ार अनुमानों पर आधारित स्थिति-पत्र: ABI Research के अनुसार 2035 तक स्तर 3 से 5 के 4.9 करोड़ स्वायत्त वाहन स्थापित होंगे और Omdia के अनुसार 2026 से 2035 के बीच लगभग 6 करोड़ औद्योगिक रोबोट तैनात किए जाएँगे। इसमें चार सुरक्षा आवश्यकताओं को NVIDIA Halos आधार से जोड़ा गया है। 🔗 स्रोत
- NVIDIA ने मिस्र के AI पारिस्थितिकी तंत्र के विस्तार को प्रमुखता दी — Grand Egyptian Museum में आयोजित स्वागत समारोह में EMEA के उपाध्यक्ष Paolo Guglielmini ने उद्घाटन भाषण दिया। भूमिका मुख्य रूप से यह बताती है कि दक्षिण अफ़्रीका, मोरक्को और नाइजीरिया में AI कारखाने परिचालन में आ रहे हैं। 🔗 स्रोत
- NVIDIA ने कम-कार्बन ऊर्जा में AI लागू करने वाली पाँच कंपनियों को सूचीबद्ध किया — New York Climate Week के लिए प्रकाशित अवलोकन, जिसमें संलयन को तेज़ करने से लेकर पुनर्चक्रित इलेक्ट्रिक-वाहन बैटरियों के पुनः उपयोग तक के उदाहरण शामिल हैं। ThinkLabs AI ग्रिड से जुड़ने की समय-सीमा घटाने के लिए CUDA पर डिजिटल जुड़वाँ और एजेंट बना रही है। 🔗 स्रोत
- NVIDIA ने GTC Berlin के Golden Tickets विजेताओं की घोषणा की — 20 से 22 अक्टूबर 2026 तक होने वाले सम्मेलन के लिए निर्णायक मंडल ने छह विजेताओं को चुना। कोई तकनीकी सामग्री नहीं। 🔗 स्रोत
- vLLM, SGLang, ComfyUI और Hugging Face ने पहले ही दिन Qwen-Image-2.1 उपलब्ध कराया — SGLang-Diffusion प्रोसेसर पर ऑफ़लोडिंग के साथ मॉडल को 24 GB की एक RTX 4090 पर चलाता है, जहाँ 1024 गुणा 1024 आकार की छवि 18.7 सेकंड में बनती है और 22.7 GiB मेमोरी उपयोग होती है। vLLM इसे Qwen3-VL-8B से संबद्ध 7.1 अरब पैरामीटर वाला डिफ्यूज़न ट्रांसफ़ॉर्मर बताता है। 🔗 स्रोत
- OpenAI Academy ने चार प्रशिक्षण पाठ्यक्रम जोड़े — Build with AI, Lead AI Adoption, AI for Educators और AI for College Students अब Apply AI at Work के साथ उपलब्ध हैं। प्रत्येक पाठ्यक्रम के अंत में एक मूल्यांकन होता है, जिससे बैज मिलता है; डेवलपर पाठ्यक्रम Codex के संचालन और API पर निर्माण को अलग-अलग रखता है। 🔗 स्रोत
- Runway ने San Francisco में अपने API पर केंद्रित हैकाथॉन आयोजित किया — Runway AI Summit के साथ 30 सितंबर को Masonic में एक-दिवसीय आयोजन, जिसमें बिना प्रस्तुति दस्तावेज़ या अनुमोदन प्रक्रिया के एजेंट, ऐप्लिकेशन या रचनात्मक कार्यप्रवाह बनाया जाएगा। 🔗 स्रोत
- HeyGen ने Google DeepMind और Kaggle के साथ निर्मित बेंचमार्क Code2Video को प्रमुखता दी — यह कोड लिखने से अलग प्रश्न को मापता है: क्या वह कोड ऐसी वीडियो बनाता है जिसे देखना सार्थक हो। इसे कोड निर्माण पर आधारित एजेंटिक वीडियो स्टैक वाले संदेश की टिप्पणी में प्रकाशित किया गया। 🔗 स्रोत
- Suno ने केवल विवरण के माध्यम से लागू किए गए ध्वनि प्रभाव दिखाए — एक मिनट का प्रदर्शन, गर्म सैचुरेशन से लेकर अधिक प्रयोगात्मक प्रस्तुति तक। न किसी सुविधा का नाम, न संबंधित प्लान, न ही कोई संबद्ध ब्लॉग लेख: यह लॉन्च के बजाय उत्पाद का प्रदर्शन है। 🔗 स्रोत
- Discord पर खरीदारी के लिए Gemini का सीधा प्रदर्शन — मंगलवार, 22 सितंबर को सुबह 11 बजे PT पर आधिकारिक Discord सर्वर में सत्र की घोषणा की गई, जो खरीदारी की तैयारी, विकल्पों की तुलना और तस्वीर से खोज करने पर केंद्रित है। कोई नई सुविधा नहीं। 🔗 स्रोत
- Together AI और Ollama ने ओपन कोड एजेंटों पर सत्र की घोषणा की — Ollama की ओर से Parth Sareen और Together AI की ओर से Zain Hasan ओपन मॉडल पर आधारित कोड एजेंटों को उत्पादन में उतारने पर सत्र संचालित करेंगे। संदेश में न तारीख है, न स्थान। 🔗 स्रोत
- Boris-2 के दो छोड़े गए प्रशिक्षणों के वेट ओपन किए गए — पहला प्रशिक्षण Muon और AdamW ग्रेडिएंट की असंगति के कारण 30 अरब टोकन पर 3.100 लॉस की सीमा पर अटक गया था; दूसरा लगभग 7 अरब टोकन पर रोक दिया गया। विफलता का विवरण स्वयं मॉडलों से अधिक शिक्षाप्रद है। 🔗 स्रोत
- निर्णायक मॉडलों के दिशात्मक पक्षपात के विरुद्ध पूर्व-पंजीकृत प्रोटोकॉल — परिकल्पना यह है कि कथात्मक पाठ में त्रुटियाँ भावना के एन्कोडिंग के बजाय उसकी स्पष्ट घोषणा की ओर झुकती हैं। प्रोटोकॉल किसी भी डेटा-संग्रह से पहले प्रकाशित किया गया है, साथ ही वह परिणाम भी बताया गया है जिसके मिलने पर संरचना वापस ले ली जाएगी, और लेखक ने हितों के टकराव की घोषणा की है। 🔗 स्रोत
- ओपन घटकों से Jev की पुनर्रचना 0.6 अंक से विफल रही — स्वयं को प्रोग्रामिंग न जानने वाला बताने वाला एक उपयोगकर्ता केवल प्रोसेसर पर चलने वाले ओपन स्टैक पर Jev को फिर से बनाने के लिए Claude Code को एक दिन के प्रयोग सौंपता है। आठ विफल तरीके, जिन्हें वह सफल हुए तरीके से अधिक शिक्षाप्रद मानता है। 🔗 स्रोत
- Jevini निर्णय की रूपरेखा और क्रियान्वयन को अलग करता है — एक बड़ा रीजनिंग मॉडल टाइप किए गए निर्णयों का संस्करणबद्ध ग्राफ़ तैयार करता है, जिसे एक छोटा निर्णय मॉडल हर नई परिस्थिति में क्रियान्वित करता है। यह प्रकाशक की प्रचारात्मक सामग्री है और इसे उसी रूप में देखा जाना चाहिए। 🔗 स्रोत
- Cohere ने बिना किसी उत्पाद घोषणा के अपना ब्रांड-संचार जारी रखा — 20 सितंबर का एक संदेश सह-संस्थापक Aidan Gomez से जोड़े गए उद्देश्य को नए शब्दों में प्रस्तुत करके AI for Empowerment अभियान को आगे बढ़ाता है, जबकि 21 सितंबर के दो दृश्य Waterloo में छात्र हैकाथॉन Hack The North से कंपनी के सफ़र की कहानी बताते हैं। न कोई मॉडल, न सुविधा, न कीमत। 🔗 अभियान · 🔗 हैकाथॉन
इसका क्या अर्थ है
पहले दिन उपलब्धता अब वितरण का मानक बनती जा रही है। Grok 4.7 प्रतीक्षा नहीं करता: घोषणा के दिन ही वह Cursor और GitHub Copilot में मौजूद है, और Qwen-Image-2.1 को जारी होते ही vLLM, SGLang, ComfyUI और Hugging Face ने उपलब्ध करा दिया। मॉडल के प्रकाशन और रोज़मर्रा के उपकरणों में उसकी उपलब्धता के बीच का अंतराल, जो पहले हफ़्तों में मापा जाता था, अब शून्य की ओर बढ़ रहा है—Cursor में इसलिए कि 14 अगस्त से संपादक और प्रयोगशाला एक ही समूह के स्वामित्व में हैं, और अन्यत्र इसलिए कि घोषणा से पहले ही एकीकरण की तैयारी कर ली जाती है। अब दिलचस्प प्रश्न यह नहीं है कि मॉडल कब आएगा, बल्कि यह है कि आने के बाद उसकी लागत कितनी होगी।
Copilot की बिलिंग व्यवस्था में बदलाव इसी प्रश्न को प्रभावित करता है। वहाँ Grok 4.7 अनुरोध-गुणक प्रणाली से बाहर निकलकर xAI की सार्वजनिक दर पर उपयोग के अनुसार बिल किया जाता है। नए मॉडलों के स्वचालित सक्रियण के साथ मिलकर यह लागत संबंधी निर्णय को प्लेटफ़ॉर्म प्रशासन के स्तर पर पहुँचा देता है: कुछ न करना किसी तीसरे पक्ष के आपूर्तिकर्ता की दर-सूची से जुड़ा खर्च खोल देने के बराबर है। xAI का तर्क इसके अनुरूप है—इनपुट के लिए Grok 4.6 जितने ही 2 डॉलर, Terminal-Bench पर वास्तविक बढ़त, लेकिन लंबी कोडिंग गतिविधियों में Fable 5.1 से पीछे: यहाँ प्रथम स्थान नहीं, बल्कि कीमत और प्रदर्शन का अनुपात बेचा जा रहा है।
एजेंटों के मामले में तीन अलग-अलग घोषणाएँ एक ही बदलाव की कहानी कहती हैं: क्रियान्वयन परिवेश अब ब्लैक बॉक्स नहीं रह जाता। devin ssh एजेंट की वर्चुअल मशीन को इंटरैक्टिव सत्र के लिए खोलता है, relore एजेंट को केवल कोड की वर्तमान स्थिति के बजाय रिपॉज़िटरी के पिछले निर्णयों की स्मृति देता है, Perplexity अपने मॉडल को उन सटीक चरणों पर पश्च-प्रशिक्षित करता है जहाँ वह उपयोगकर्ताओं के लिए विफल हुआ था, और Qwen Code अपने उपकरणों को bwrap के माध्यम से रूट करता है। NVIDIA इस बदलाव का सैद्धांतिक ढाँचा प्रस्तुत करते हुए कहता है कि एजेंट की सुरक्षा उसकी पहुँच से बाहर, हर स्तर पर सुनिश्चित होती है और इसके प्रमाण के लिए लॉग मौजूद होते हैं। निरीक्षण-योग्य एजेंट और नियंत्रित एजेंट एक ही आवश्यकता के दो पहलू हैं।
वह प्रश्न फिर भी शेष रहता है जिसे OpenAI की घोषणा उठाती तो है, लेकिन संबोधित नहीं करती। एक महीने से कम समय में सौ से अधिक अनसुलझी समस्याएँ हल करने वाले आंतरिक मॉडल के प्रत्युत्तर में एक संस्थागत व्यवस्था बनाई गई—स्वतंत्र, अवैतनिक और अपनी राय देने के लिए स्वतंत्र परामर्श समूह—लेकिन उसके अधिदेश से आंतरिक प्रगति की गति को स्पष्ट रूप से बाहर रखा गया है, जबकि यही 27 Fields पदक विजेताओं के विरोध का मूल विषय था। दिन की अन्य घटनाओं से इसका विरोधाभास शिक्षाप्रद है: जहाँ शानदार परिणामों की गति पर चर्चा हो रही है, वहीं एक टोकनाइज़ेशन लाइब्रेरी समान पहचानकर्ताओं की गारंटी देते हुए 3 से 30 गुना गति हासिल करती है, और एक संपीड़न विधि स्पिन ग्लास से प्रेरणा लेकर 50% संपीड़न पर MMLU में 23 अंक प्राप्त करती है। इस तरह का काम सुर्खियाँ नहीं बनाता, लेकिन यही तय करता है कि भविष्य की इन्फ़रेंस की लागत कितनी होगी।
स्रोत
- Grok 4.7 — xAI
- X पर @SpaceXAI, Grok 4.7 की घोषणा
- Grok 4.7 अब GitHub Copilot में उपलब्ध है
- गणित और कृत्रिम बुद्धिमत्ता पर परामर्श समूह
- गणित में AI का गंभीर असंरेखण
- Googlebook की अग्रिम बुकिंग
- X पर ElevenLabs, Studio 4.0
- X पर ElevenLabs, Studio Agent
- tokenizers v1: मापा गया एन्कोडिंग, डिकोडिंग और विस्तार
- आपके टर्मिनल में Devin Cloud
- X पर Cognition, devin ssh
- Qwen Code v0.24.3 के रिलीज़ नोट्स
- relore, कोडिंग एजेंटों के लिए रिपॉज़िटरी स्मृति
- वास्तविक दुनिया की गलतियों से सीखना
- X पर Perplexity, Computer में वीडियो मॉडल
- X पर Gemini Notebook, Live Chat
- X पर Gemini Notebook, Interactive Learning Overviews
- Google.org और Digital Promise
- X पर Runway, विस्तारित Workflows
- NVIDIA DSX Ready
- एजेंट स्टैक को सुरक्षित करना
- NVIDIA, भौतिक AI की सुरक्षा और Halos आधार
- Earth-2 में डेटा आत्मसातकरण
- भौतिक विज्ञानी की तरह LLM की छँटाई
- NVIDIA, मिस्र का AI पारिस्थितिकी तंत्र
- NVIDIA, पाँच कंपनियाँ और कम-कार्बन ऊर्जा
- X पर NVIDIA AI, GTC Berlin के Golden Tickets
- X पर Alibaba Qwen, Qwen-Image-2.1 के लिए समर्थन
- नए शिक्षण पाठ्यक्रमों के साथ OpenAI Academy का विस्तार
- X पर Runway, API हैकाथॉन
- X पर HeyGen, Code2Video बेंचमार्क
- X पर Suno, प्राकृतिक भाषा में बताए गए ध्वनि प्रभाव
- X पर Gemini App, खरीदारी का प्रदर्शन
- X पर Together AI, Ollama के साथ सत्र
- Boris-2-0907 और Boris-2-0917
- सारांश पक्षपात: LLM निर्णायकों की दिशात्मक विफलता के लिए पूर्व-पंजीकृत परीक्षण
- मैंने Jev की तुलना केवल CPU पर चलने वाले ओपन स्टैक से की
- निर्णय परिपथ अभियांत्रिकी
- X पर Cohere, AI for Empowerment अभियान
- X पर Cohere, Hack The North