ai-powered-markdown-translatorArticol tradus din fr în ro cu gpt-5.6-sol.
Luni, 21 septembrie, ziua îi aparține xAI: Grok 4.7 este lansat și ajunge în aceeași zi în Cursor și GitHub Copilot, fără nicio întârziere între anunțarea modelului și apariția sa în instrumente. OpenAI alege aceeași zi pentru a dezvălui că un model intern antrenat începând cu 28 august a rezolvat peste o sută de probleme deschise de matematică și pentru a înființa un grup consultativ de matematicieni, după o declarație semnată de 27 de laureați ai Medaliei Fields. Google deschide precomenzile pentru Googlebook, ElevenLabs plasează un agent de montaj în centrul editorului său video, iar Hugging Face își relansează biblioteca de tokenizare, de 3 până la 30 de ori mai rapidă.
Grok 4.7 este lansat de xAI și ajunge în aceeași zi în Cursor și GitHub Copilot
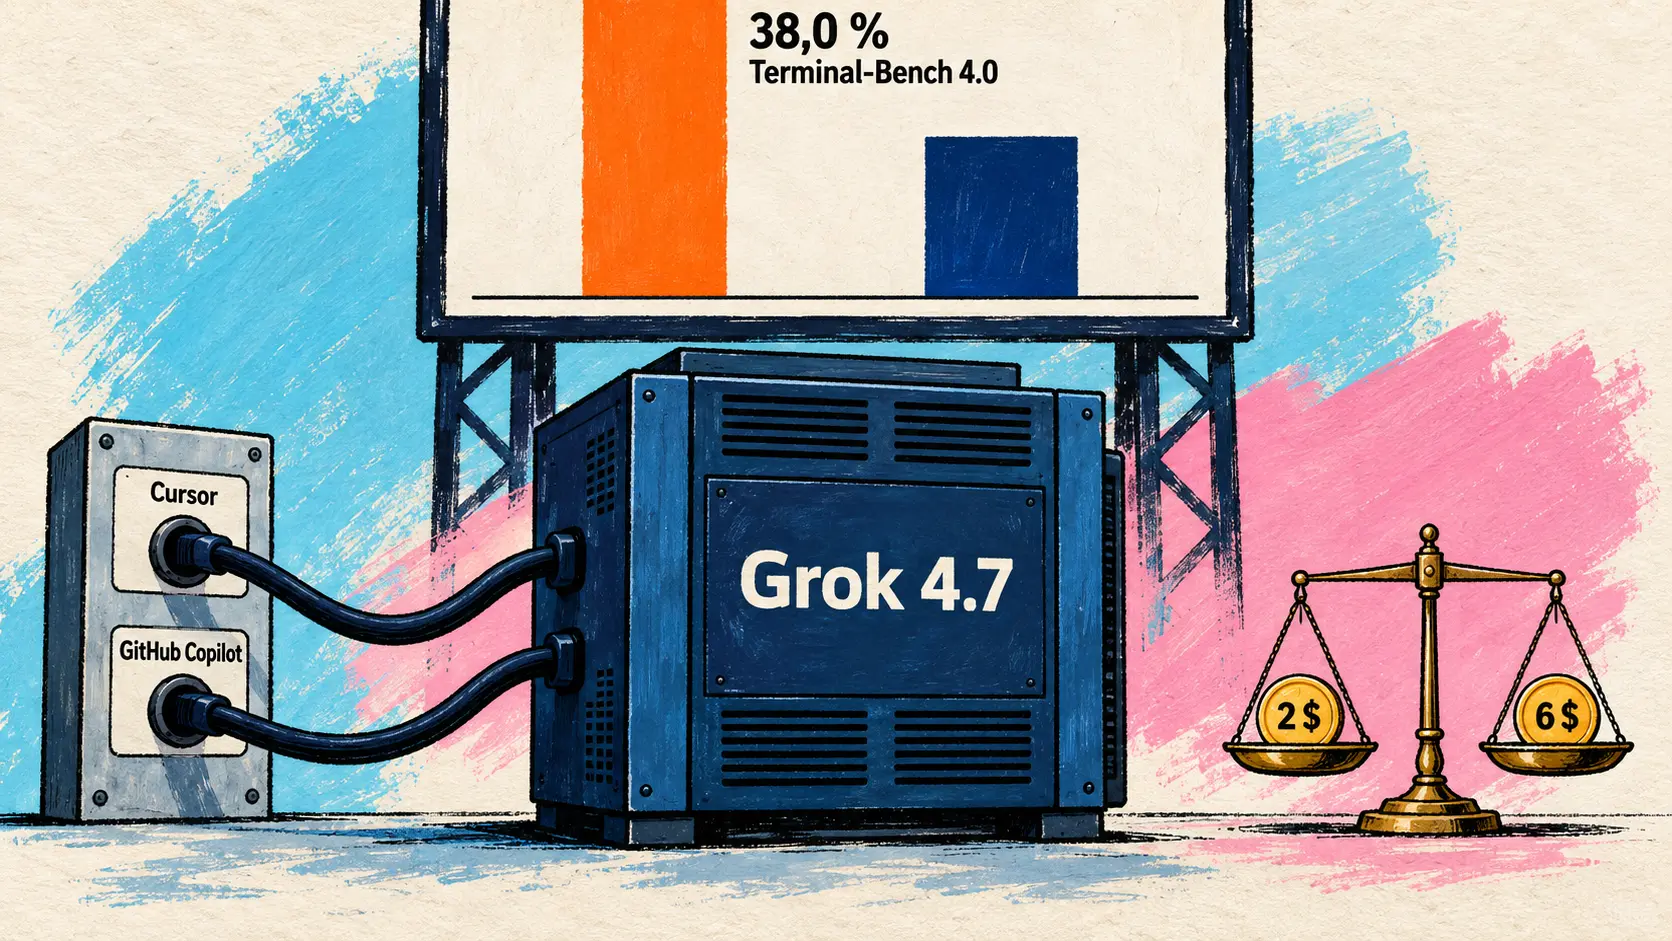
21 septembrie — xAI lansează Grok 4.7, cel mai performant model al său pentru cod și activități intelectuale. Modelul de bază este mai mare decât cel al Grok 4.6, iar etapa sa de învățare prin recompensă (reinforcement learning) a fost prelungită pe un amestec de sarcini ponderat către probleme care necesită mai multe ore. xAI se așteaptă ca modelul să-și verifice mai bine propria activitate și să gestioneze mai bine contextele lungi.
Cifrele conturează mai degrabă un profil contrastant decât o dominație. Tariful, în schimb, nu se modifică: 2 dolari pentru un milion de tokeni de intrare și 6 pentru ieșire, la fel ca Grok 4.6, adică jumătate din prețul de intrare al GPT-5.6 Sol și o cincime din cel al Fable 5.1. Argumentul se concentrează pe acest raport preț-performanță.
| Măsurătoare publicată | Grok 4.7 (xHigh) | Grok 4.6 (High) | GPT-5.6 Sol (Max) | Fable 5.1 (Max) |
|---|---|---|---|---|
| CursorBench 4.0 | 46,3 % | 40,4 % | 41,7 % | 51,8 % |
| Terminal-Bench 4.0 | 38,0 % | 20,3 % | 37,3 % | 57,9 % |
| EEBench (inginerie electrică) | 64,0 % | 53,0 % | 39,4 % | 56,4 % |
| Preț de intrare (dolari / M tokeni) | 2 | 2 | 4 | 10 |
| Preț de ieșire (dolari / M tokeni) | 6 | 6 | 20 | 50 |
API-ul oferă grok-4.7 cu un context de 500 000 de tokeni și patru niveluri de efort de raționament, de la low la xhigh; tariful se dublează pentru prompturi de peste 200 000 de tokeni. xAI evidențiază și un set complet nou de mecanisme de protecție: primul loc în benchmarkul de biosecuritate LatchBio, cu 62,4 %, și doar 3,3 % dintre prompturile cibernetice riscante, cu dublă utilizare, lăsate să treacă în HackerBench v0.3.
Implementarea este imediată la doi integratori. Cursor oferă modelul încă din prima zi — o consecință a achiziției Anysphere de către SpaceX, finalizată pe 14 august. Modelul rămâne al xAI: articolul publicat în aceeași zi pe blogul Cursor constă într-o singură propoziție și trimite la anunțul complet de pe x.ai. xAI este compania care evidențiază CursorBench 4.0, bancul de testare al Cursor pentru sarcini de lungă durată, unde Grok 4.7 obține 46,3 % la un tarif neschimbat. La rândul său, GitHub Copilot îl implementează pe toate platformele sale, de la VS Code la Xcode, pentru abonamentele Pro până la Enterprise. Facturarea merită atenție: Grok 4.7 nu intră în sistemul de multiplicatori ai solicitărilor și este facturat în funcție de utilizare, la tariful public al furnizorului. Întrucât un model nou este activat implicit, controlarea cheltuielilor necesită o acțiune în politica privind modelele, nu doar lipsa oricărei intervenții.
🔗 Grok 4.7 — xAI 🔗 Grok 4.7 este acum disponibil în GitHub Copilot
OpenAI înființează un grup consultativ de matematicieni și dezvăluie peste o sută de probleme deschise rezolvate
21 septembrie — OpenAI anunță că lucrează cu un grup consultativ independent format din nouă matematicieni, constituit de aceștia și găzduit la Institute for Advanced Study din Princeton. Contextul cântărește mai mult decât anunțul.
On August 28, we began training a new internal model. In addition to resolving the Navier–Stokes Millennium Prize problem, this model has now resolved more than 100 long-standing open problems across most areas of mathematics.
🇷🇴 Pe 28 august, am început să antrenăm un nou model intern. Pe lângă rezolvarea problemei mileniului Navier–Stokes, acest model a rezolvat până acum peste 100 de probleme deschise de lungă durată din majoritatea domeniilor matematicii. — OpenAI, Grupul consultativ pentru matematică și inteligență artificială
Modelul nu este numit public, iar OpenAI scrie că ritmul acestor progrese i-a surprins pe propriii matematicieni. Această accelerare a provocat o reacție directă: pe 11 septembrie, o declarație intitulată „O gravă nealiniere a inteligenței artificiale în matematică” a fost publicată cu un DOI Zenodo și semnătura a 27 de laureați ai Medaliei Fields, printre care Terence Tao, Peter Scholze și Cédric Villani. Argumentul lor nu este că modelele greșesc. Rezolvarea unei probleme majore a semnalat întotdeauna o înțelegere nouă, prelucrată ulterior de comunitate până când putea fi predată; semnatarii se tem că producerea în masă a unor enunțuri adevărate sau false ar putea distruge acest teren fertil, în loc să-l hrănească, și că aceste anunțuri pripite nu lasă timp pentru o redactare corectă.
Mecanismul insistă clar asupra independenței: grupul poate emite opinii nesolicitate, poate comenta public impactul OpenAI asupra matematicii și își poate modifica componența fără aprobarea companiei, iar membrii săi nu sunt remunerați de aceasta. Rămâne însă fraza pe care OpenAI o plasează la sfârșitul aceluiași paragraf: grupul nu va consilia compania cu privire la ritmul progreselor sale interne. Domeniul de aplicare acoperă, așadar, difuzarea rezultatelor, nu producerea lor — totul, mai puțin ceea ce a declanșat protestul. Martin Hairer apare pe ambele liste, atât ca semnatar al declarației, cât și ca membru al grupului.
🔗 O gravă nealiniere a inteligenței artificiale în matematică
Googlebook, gama de laptopuri Google concepută în jurul Gemini
21 septembrie — Google deschide precomenzile pentru Googlebook, pe care îl prezintă drept o categorie de sine stătătoare: stiva tehnologică Android, bazele pentru desktop moștenite de la ChromeOS, toate concepute în jurul Gemini. Cinci modele sunt lansate simultan, fabricate de Acer, ASUS, Dell, HP și Lenovo, cu prețuri începând de la 899 de dolari. Livrările încep pe 4 octombrie în Statele Unite și pe 5 octombrie în Canada, Regatul Unit, Irlanda, Franța, Germania și Australia.
| Caracteristică anunțată | Valoare |
|---|---|
| Preț de pornire | 899 de dolari |
| Procesoare | Intel Core Ultra Series 3 sau Snapdragon X Elite |
| NPU | peste 45 TOPS |
| Memorie RAM | 16 GB standard, până la 32 GB |
| Autonomie | până la 14 h de redare video, 16 h de navigare web |
| Asistență software | actualizări timp de până la 10 ani |
Trei funcții Gemini sunt specifice dispozitivului. Magic Pointer, declanșat prin scuturarea cursorului, aduce Gemini la elementul afișat pe ecran — pentru a analiza un e-mail suspect sau a combina mai multe imagini — iar Google precizează că se activează doar la cerere și poate fi dezactivat. Rambler transformă o dictare dezlânată într-un text structurat, cu titluri și liste de sarcini, inclusiv atunci când limba este schimbată în mijlocul propoziției. Create My Widget generează widgeturi pentru desktop pornind de la o descriere în limbaj natural.
Pentru dezvoltatori, fiecare dispozitiv este livrat cu Antigravity, platforma Google pentru agenți de dezvoltare, și cu un mediu Linux izolat, prevăzut cu un terminal complet — documentația menționează explicit posibilitatea de a rula Claude Code sau Antigravity CLI în acesta. Izolarea se bazează pe un hipervizor pKVM certificat Level 5, pe care Google îl prezintă drept o premieră în această categorie, completat de rădăcina hardware de încredere Titan. Continuitatea cu telefonul Android completează experiența: reluarea unei sarcini începute pe mobil și redarea în flux a aplicațiilor mobile într-o fereastră de pe desktop. Fiecare Googlebook include 12 luni de Google AI Pro, cu 5 TB de stocare, 3 luni de YouTube Premium și Photoshop și un an de GeForce NOW.
🔗 Precomenzi pentru Googlebook
ElevenLabs introduce un agent de montaj în Studio 4.0
21 septembrie — ElevenLabs lansează Studio 4.0 în ElevenCreative, actualizarea editorului său video. Ideea centrală poate fi rezumată într-o propoziție: totul se face în același loc. Generarea de videoclipuri, imagini, voci, muzică și efecte sonore este declanșată direct din proiect, toate modelele ElevenCreative pot fi apelate fără părăsirea editorului, iar montajul, subtitrarea și apoi exportul se succed în aceeași interfață. Un cadru poate fi refăcut fără relansarea întregii generări, iar subtitrările pot fi manipulate ca orice alt clip pe linia de montaj (timeline).
Cea mai importantă noutate structurală este Studio Agent, un coeditor prezent în fiecare proiect.
Studio Agent is your AI co-editor, built into every project. Describe the change you want and it makes the edit. Step in and make cuts whenever you like, then hand the timeline back to the agent.
🇷🇴 Studio Agent este coeditorul tău bazat pe inteligență artificială, integrat în fiecare proiect. Descrie modificarea dorită, iar acesta realizează montajul. Intervino și fă tăieturile când dorești, apoi redă-i agentului controlul asupra liniei de montaj. — @ElevenLabs pe X
Acest schimb de control este ceea ce diferențiază instrumentul de o generare opacă: editorul preia controlul atunci când dorește, apoi îl redă asupra liniei de montaj. De altfel, aceasta a fost reconstruită pentru proiecte cu mai multe scene și piste — campanii publicitare, tutoriale, serii de videoclipuri scurte — cu mărire la nivel de cadru, fixarea automată a clipurilor și deplasarea unui grup de clipuri fără desincronizarea celorlalte. Comentariile echipei sunt atașate unui anumit clip sau element media, în loc să fie împrăștiate în fire separate.
De reținut pentru monitorizare: la momentul verificării, anunțul exista doar pe X, într-un fir de șase mesaje. Blogul ElevenLabs se oprea la articolul din 10 septembrie, iar jurnalul de modificări al documentației, la intrarea din 14 septembrie.
🔗 Studio 4.0 în ElevenCreative
Hugging Face lansează tokenizers v1, de 3 până la 30 de ori mai rapid, cu identificatori identici
21 septembrie — Hugging Face lansează versiunea candidată a tokenizers v1, biblioteca Rust care transformă textul în secvențe de numere întregi înainte ca un model să-l citească. Premisa este simplă: tokenizarea nu a fost niciodată blocajul fluxurilor de machine learning, dar echilibrul se schimbă pe măsură ce modelele devin mai rapide, iar un GPU care își așteaptă procesorul este un GPU inactiv.
| Metrică | Valoare măsurată |
|---|---|
| Accelerarea codificării față de v0.23, un singur fir | de 3 până la 30 de ori |
| Dispozitiv de testare | Apple M4 Max |
| Limita inferioară și superioară a intervalului | t5-base și gpt2 |
| Scalare cu opt workers | 76 % din scalarea liniară |
| Identificatori de tokeni produși | identici cu cei din v0.23 |
| Instalarea versiunii candidate | cargo add tokenizers --pre |
Constrângerea impusă de echipă este mai interesantă decât câștigurile în sine: v1 produce exact aceiași identificatori de tokeni ca v0.23, API-ul, vocabularul și rangurile de îmbinare (merge ranks) rămân neschimbate, iar biblioteca rămâne generalistă în loc să se specializeze în BPE. Prin urmare, actualizarea nu necesită nimic altceva decât schimbarea versiunii instalate.
Șase modificări acoperă cea mai mare parte a efortului, iar cea mai neobișnuită se numește bitcannon. Expresia regulată care împarte textul în pre-tokeni este un parametru fix, livrat împreună cu tokenizerul: nu există niciun motiv ca aceasta să fie interpretată de un motor generic la fiecare codificare. Prin urmare, Hugging Face scrie manual funcția de segmentare și o face să opereze pe fluxuri de biți folosind SIMD, cu 64 de octeți procesați la fiecare operație de registru. Compromisul este asumat: doar modelele recunoscute (GPT-2, cl100k, o200k, Tekken, DeepSeek) beneficiază de acest lucru, iar celelalte păstrează calea regex — ceea ce explică diferența dintre 3 și 30. Se adaugă o buclă de îmbinare fără alocări sau ramificații, un cache de cuvinte local firului de execuție și paralelism nativ. Interfețele C și C++ exclusiv pentru inferență, destinate ExecuTorch și llama.cpp, sunt anunțate înainte de versiunea 1.0.0.
🔗 tokenizers v1: codificare, decodificare și scalare, măsurate
Devin Cloud ajunge în terminal, cu acces SSH la mașina agentului
21 septembrie — Cognition aduce Devin Cloud în terminal: devin --cloud sau /cloud dintr-o sesiune aflată în desfășurare creează, controlează și reia o sesiune cloud fără părăsirea CLI-ului. Mecanismul se bazează pe o comandă simetrică: /handoff transferă sarcina curentă către mașina virtuală Devin — Mac, Linux sau Windows — iar, atunci când este executată din cloud, parcurge traseul invers, recuperând ramura pull request-ului. Sesiunile cloud continuă să existe după închiderea terminalului care le-a lansat.
And for the first time, SSH into Devin’s dedicated VM, then /handoff the work back to your own device.
🇷🇴 Și, pentru prima dată, conectați-vă prin SSH la mașina virtuală dedicată a Devin, apoi transferați activitatea înapoi pe propriul dispozitiv cu /handoff. — @cognition pe X
devin ssh oferă acces complet la mediul construit de agent: modificarea codului, lansarea unui server de dezvoltare, redirecționarea porturilor și transferarea fișierelor prin scp. Mediul de execuție încetează să mai fie o cutie neagră. Sesiunile SWE-2 sunt gratuite în Devin Cloud până pe 8 octombrie.
🔗 Devin Cloud în terminalul tău
Qwen Code v0.24.3 își instrumentează Web Shell-ul și își persistă sesiunile în JDBC
21 septembrie — Qwen Code trece la v0.24.3 în ziua următoare versiunii v0.24.2: treizeci și unu de pull requests, fără nicio modificare incompatibilă. Cea mai mare parte a activității vizibile se concentrează asupra Web Shell, ale cărui rezultate de execuție nu mai sunt text brut, ci o structură care separă comanda, ieșirea acesteia, detaliile execuției și timpul scurs. O filă trajectory, dezactivată implicit, afișează duratele fiecărei ture, timpul până la primul token, numărul de tokeni și durata fiecărui apel de instrument.
Partea mai puțin vizibilă este probabil cea mai structurală. Runtime-ul primește persistență JDBC pentru legăturile și sesiunile sale, ceea ce permite partajarea stării între mai multe procese broker și păstrarea proprietății asupra unei sesiuni după o repornire. Instrumentele runtime-ului sunt, de asemenea, rutate prin bwrap cu o politică de workspace imuabil — continuarea directă a sandbox-ului introdus cu o zi înainte, a cărui configurare rămâne neexpusă. În aceeași zi, SDK-ul TypeScript v0.1.14 include această CLI, iar Qwen Code Desktop v0.24.3 îi urmează.
🔗 Notele de versiune Qwen Code v0.24.3
Hugging Face lansează relore, o memorie de repository pentru agenții de cod
21 septembrie — Hugging Face publică relore sub licența Apache-2.0, un instrument care oferă unui agent de cod memoria unui repository. Punctul de plecare este un incident: pentru ticket-ul Transformers #48630, deschis pe 8 septembrie, fuseseră deja propuse două remedieri când agentul de integrare continuă al companiei se pregătea să scrie o a treia. Informația se afla în întregime pe GitHub, dar era împrăștiată între ticket-uri, pull requests și comentarii invizibile din ticket-ul inițial.
relore indexează acest istoric înregistrând cine ce a spus: o decizie a unui maintainer nu are aceeași valoare ca ipoteza unui contributor, iar conținutul generat automat este exclus implicit. O clonă de lucru este menținută alături de index, furnizată prin aceeași API HTTP, iar interogările sunt procesate local — doar ingestia contactează GitHub. Urmează verbele: inflight enumeră firele care pretind că închid un ticket, search --trust authoritative a identificat PR-ul #39847 aflat la originea regresiei, iar why pornește de la o linie de cod pentru a regăsi comentariile de review din jurul acesteia. În timpul unui test în condiții reale, agentul a raportat că defs îi oferea o imagine de ansamblu mai bună asupra unui fișier decât citirea sa integrală, folosind 5% dintre tokeni.
🔗 relore, memorie de repository pentru agenții de cod
Perplexity post-antrenează Computer pe baza erorilor utilizatorilor săi și îi adaugă funcții video
21 septembrie — Perplexity Research detaliază modul în care compania post-antrenează modelul care stă la baza agentului său Computer — GLM 5.2, dezvăluie în treacăt articolul — folosind sesiunile reale ale utilizatorilor. Mediile sintetice produc sarcini controlate și ușor de verificat; sesiunile reale furnizează două semnale pe care acestea nu le produc: corecțiile făcute de utilizator și erorile returnate de instrumente. Sesiunile care conțin date personale și cele ale utilizatorilor care au refuzat folosirea datelor pentru antrenare sunt excluse înaintea oricărei eșantionări.
Fiecare tură primește apoi unul dintre cele trei tratamente: imitare prin entropie încrucișată pentru turele fără erori din sesiunile reușite, corectare prin divergență Kullback-Leibler pentru turele cu erori însoțite de un indiciu valid sau simpla păstrare în context. Același set de ponderi joacă rolul profesorului și al elevului, dar numai profesorul vede indiciul. Trei evaluatori automați propun turele responsabile și cel puțin doi trebuie să ajungă la aceeași concluzie, deoarece ultima tură dinaintea reclamației este cauza reală doar în aproximativ jumătate dintre cazuri.
| Rata erorilor instrumentelor | Valoare măsurată |
|---|---|
| Offline, GLM 5.2 original | 2,79 % |
| Offline, doar eșantionare cu respingere | 1,35 % |
| Offline, cu autodistilare | 0,87 % |
| Online, între două checkpoints | 2,24 % apoi 1,77 %, adică o scădere relativă de 21,2 % |
Autorii precizează explicit ce nu demonstrează aceste cifre: checkpoints comparate offline nu au fost antrenate pe aceleași date, rezultatele pe sarcini rămân mixte, iar nemulțumirea utilizatorilor nu se modifică semnificativ, 2,58% față de 2,54%, în teste A/B cu aproximativ o sută de mii de utilizatori în fiecare grup.
În aceeași zi, Computer primește funcția de generare video, încredințată la două modele terțe: MiniMax H3 și ByteDance Seedance 2.5. Fie că este vorba despre un clip de campanie, o demonstrație de produs sau un material vizual pentru rețelele sociale, videoclipul final apare în același fir cu textul și imaginile produse pentru aceeași solicitare. Funcția este disponibilă abonaților Pro și Max, fără menționarea accesului gratuit sau a disponibilității prin API.
🔗 Învățarea din greșeli din lumea reală 🔗 Perplexity Computer și modelele video
Gemini Notebook extinde Live Chat și Interactive Learning Overviews pentru toți utilizatorii eligibili
21 septembrie — Gemini Notebook a atins două praguri de implementare în aceeași zi. Live Chat ajunge la 100% dintre abonații Ultra pe dispozitive mobile: conversație vocală în timp real cu un notebook, în aproximativ 100 de limbi, bazată pe cele mai recente modele audio Google, cu îndrumare pas cu pas aproape complet hands-free. Câteva ore mai târziu, Interactive Learning Overviews ies din implementarea progresivă și devin accesibile tuturor utilizatorilor, fără condiție de abonament; amplasate în secțiunea Reports, acestea reunesc rezumatele surselor și artefactele studioului în același spațiu interactiv.
Ambele funcții fuseseră prezentate pe 15 septembrie, în anunțul noilor instrumente de studiu. Mesajele din 21 septembrie nu adaugă nicio funcționalitate: ele confirmă disponibilitatea efectivă, completă pentru prima funcție și deschisă tuturor pentru cea de-a doua.
🔗 Live Chat implementat în proporție de 100% 🔗 Interactive Learning Overviews disponibile tuturor
Google.org alocă 4 milioane de dolari pentru formarea profesorilor în domeniul AI
21 septembrie — Google.org alocă 4 milioane de dolari organizației Digital Promise, sumă anunțată la New York în marja Adunării Generale a Organizației Națiunilor Unite. Finanțarea extinde Google AI Educator Series, un program gratuit de formare anunțat la începutul anului și destinat celor 6 milioane de profesori din învățământul primar, secundar și superior din Statele Unite. Conceput împreună cu ISTE după o abordare în care profesorii formează alți profesori, acesta se concentrează asupra competențelor transferabile de la un instrument la altul, nu asupra unui anumit produs, și constă în module parcurse în ritm propriu, validate prin insigne digitale.
Digital Promise intervine în trei direcții: adaptarea programului de formare pentru agențiile educaționale ale statelor și districtele școlare, colaborarea cu rețelele de community colleges pentru profesorii din primul ciclu și desfășurarea, pe parcursul a doi ani, a unui studiu privind ceea ce îi ajută cu adevărat pe profesorii din învățământul superior, ale cărui rezultate vor fi publicate într-un ghid public gratuit.
🔗 Google.org și Digital Promise
Runway își extinde Workflows cu compositing, transparență și hărți de profunzime
21 septembrie — Runway își extinde Workflows, secvențele de operații care pot fi compuse în aplicația sa, cu cinci componente orientate spre post-producție: Compositing, Alpha, HDR, Depth Map și RGB Depth. Argumentul din anunț poate fi rezumat într-o singură propoziție — construirea unei părți mai mari a lanțului de producție (pipeline) în același loc, fără trecerea la alt instrument între două etape. Compositing și gestionarea canalului alpha vizează asamblarea mai multor straturi de imagine; hărțile de profunzime, în ambele forme, servesc drept semnal geometric pentru controlarea efectelor care depind de distanța față de cameră. Anunțul a fost făcut pe X, împreună cu o demonstrație de 31 de secunde, fără un articol corespunzător pe pagina de noutăți Runway la momentul scanării.
NVIDIA lansează DSX Ready, un program de calificare pentru alimentarea și răcirea fabricilor AI
21 septembrie — NVIDIA lansează DSX Ready, un program care califică produsele partenerilor în raport cu cerințele arhitecturii sale de referință DSX pentru fabrici AI. Premisa este una foarte concretă: alimentarea cu energie, răcirea, apa, amplasamentul și rețeaua electrică determină astăzi ceea ce un constructor poate implementa efectiv, iar un echipament care nu este armonizat cu restul proiectului nu transformă capacitatea de calcul în producție utilă.
| Categorie calificată | Parteneri la lansare | Proces de calificare |
|---|---|---|
| Stocarea energiei în baterii | Hitachi Energy, LG Energy Solution, Tesla | Testare de către partener, examinare și aprobare NVIDIA |
| Unități de distribuție a răcirii | LG Electronics, LiquidStack, Vertiv | Suită de autocalificare |
NVIDIA stabilește o limită explicită pentru semnificația etichetei: trecerea calificării nu înlocuiește ingineria la nivelul amplasamentului și nu implică nicio garanție privind stabilitatea acestuia. Alte categorii, care vizează infrastructura și software-ul, urmează să fie adăugate treptat.
NVIDIA tratează securitatea agenților ca pe o problemă de inginerie, strat cu strat
21 septembrie — NVIDIA publică o poziție privind securitatea sistemelor agentice: este o problemă de inginerie, deci presupune cerințe definite, controale aplicabile, responsabili desemnați și dovezi că protecțiile rezistă. Stiva este descompusă în trei niveluri — modelele furnizează capabilitățile, harness-urile organizează contextul, instrumentele și fluxurile de lucru, iar mediul de execuție oferă infrastructura în care se desfășoară acțiunile — fiecare având propriile controale.
Exemplul ales este elocvent: un agent actualizează fișa unui client, întâlnește instrucțiuni malițioase într-un document atașat și încearcă să exporte datele către o destinație neautorizată. NVIDIA se așteaptă atunci ca o politică de rețea să blocheze transferul și ca jurnalele protejate să păstreze apelul de instrument încercat, decizia de autorizare și rezultatul. Dreptul de a actualiza o fișă nu se extinde la dreptul de a o exporta, iar un agent poate solicita acces fără a și-l putea acorda vreodată singur. În ceea ce privește instrumentele, OpenShell aplică politicile în afara razei de acțiune a agentului; Cisco adaugă DefenseClaw deasupra, iar JFrog verifică skill-urile la care are acces un agent.
În aceeași zi, un al doilea articol aplică același raționament AI-ului fizic și îl leagă de fundația Halos; acesta apare în știrile pe scurt de mai jos, împreună cu cele două proiecții de piață ale sale.
🔗 Securizarea stivei de agenți
Earth-2 asimilează observațiile locale pentru a actualiza prognozele meteo
21 septembrie — NVIDIA publică un tutorial despre instrumentele Earth-2 de asimilare a datelor prin AI, destinate sectoarelor care dispun deja de propriile măsurători: parcuri eoliene și solare, radare și senzori locali, observații satelitare. Prima tehnică, SDA, se aplică modelelor de difuzie precum CorrDiff și StormCast: la fiecare etapă de eliminare a zgomotului, aceasta compară rezultatul intermediar cu observațiile și orientează etapa următoare, fără reantrenare.
| Tehnică măsurată | Arie și rezoluție | Câștig raportat în exemplu |
|---|---|---|
| CorrDiff-SDA | Europa, de la 0,25 grade la 2,2 km | RMSE al vântului redus cu 54% la stațiile omise |
| StormCast-SDA | Statele Unite continentale, 3 km, inițializat cu HRRR | RMSE al vântului redus cu 7,2% pe șase pași temporali |
| HealDA | Globală, grilă HEALPix de 1 grad | Starea globală a atmosferei estimată în câteva secunde |
Interesul este în primul rând operațional: analizele numerice necesită un timp de calcul substanțial și sunt produse la ore fixe, în timp ce SDA integrează continuu observațiile și acoperă decalajul față de ora curentă. HealDA, la rândul său, tratează fiecare flux ca pe un nor de puncte în spațiu și timp, agregat pe grila țintă și apoi trecut printr-o rețea dorsală (backbone) de tip vision transformer.
🔗 Asimilarea datelor în Earth-2
Multiverse Computing elaghează blocurile asemenea unei sticle de spin Ising și câștigă 23 de puncte MMLU
21 septembrie — Eliminarea unor blocuri întregi de transformer este una dintre cele mai puțin costisitoare modalități de a accelera un model lingvistic mare și una dintre cele mai brutale: modelul devine literalmente mai scurt, dar eliminarea blocurilor greșite îl face să se prăbușească. Multiverse Computing susține că întrebarea este pusă greșit. Metodele existente evaluează fiecare bloc izolat — magnitude, sensitivity, block influence — ceea ce autorii descriu drept câmp mediu, deși efectul eliminării unui bloc depinde de celelalte blocuri eliminate simultan.
Selecția devine astfel o problemă de optimizare binară cu constrângeri, care este proiectată pe o sticlă de spin Ising: un sistem de spini dezordonat, cu interacțiuni între toate perechile și cu un număr fix de spini orientați în sus. Interesul practic poate fi rezumat într-o propoziție: energia acestui sistem este un substitut cu cost redus pentru scorul pe care îl va obține modelul elaghat, ceea ce permite clasificarea unui număr foarte mare de configurații candidate fără evaluarea vreuneia dintre ele pe benchmarks. La o compresie de 50% a Llama-3.3-70B-Instruct, autorii revendică un câștig de aproape 23 de puncte procentuale pe MMLU față de cea mai bună metodă concurentă.
🔗 Elagarea LLM-urilor asemenea unui fizician
Pe scurt
NVIDIA a publicat șapte articole și mesaje pe 21 septembrie: trei sunt prezentate mai sus, iar celelalte patru se găsesc aici, fără niciun anunț tehnic.
- NVIDIA solicită securitate la fiecare nivel pentru AI-ul fizic — articol de poziție bazat pe două proiecții de piață: 49 de milioane de vehicule autonome de nivel 3 până la 5 instalate până în 2035, potrivit ABI Research, și aproximativ 60 de milioane de roboți industriali implementați între 2026 și 2035, potrivit Omdia. Patru cerințe de securitate sunt asociate platformei NVIDIA Halos. 🔗 sursă
- NVIDIA evidențiază extinderea ecosistemului AI egiptean — recepție la Grand Egyptian Museum, cu un discurs de deschidere susținut de Paolo Guglielmini, vicepreședinte EMEA. Introducerea semnalează în principal că fabrici AI devin operaționale în Africa de Sud, Maroc și Nigeria. 🔗 sursă
- NVIDIA prezintă cinci companii care aplică AI în domeniul energiei cu emisii reduse de carbon — panoramă publicată pentru New York Climate Week, de la accelerarea fuziunii până la reutilizarea bateriilor reciclate ale vehiculelor electrice. ThinkLabs AI construiește aici gemeni digitali și agenți pe CUDA pentru a scurta termenele de conectare la rețea. 🔗 sursă
- NVIDIA anunță câștigătorii Golden Tickets pentru GTC Berlin — șase câștigători desemnați de un juriu pentru conferința din 20–22 octombrie 2026. Niciun conținut tehnic. 🔗 sursă
- Qwen-Image-2.1 disponibil din prima zi prin vLLM, SGLang, ComfyUI și Hugging Face — SGLang-Diffusion rulează modelul pe o singură RTX 4090 de 24 GB, cu transfer către procesor, pentru o generare de 1024 pe 1024 în 18,7 secunde și un consum de 22,7 GiB. vLLM îl descrie drept un transformer de difuzie cu 7,1 miliarde de parametri, asociat cu Qwen3-VL-8B. 🔗 sursă
- OpenAI Academy adaugă patru trasee de formare — Build with AI, Lead AI Adoption, AI for Educators și AI for College Students se alătură programului Apply AI at Work. Fiecare curs se încheie cu o evaluare care acordă o insignă; traseul pentru dezvoltatori separă utilizarea Codex de dezvoltarea pe API. 🔗 sursă
- Runway organizează la San Francisco un hackathon axat pe API-ul său — eveniment de o singură zi, pe 30 septembrie, la Masonic, în paralel cu Runway AI Summit, pentru construirea unui agent, a unei aplicații sau a unui flux de lucru creativ, fără prezentare formală și fără circuit de validare. 🔗 sursă
- HeyGen evidențiază Code2Video, un benchmark construit împreună cu Google DeepMind și Kaggle — evaluarea urmărește o chestiune distinctă de scrierea codului: dacă acel cod produce un videoclip care merită vizionat. Publicat în comentariul unui mesaj despre stiva video agentică bazată pe generarea de cod. 🔗 sursă
- Suno prezintă efecte sonore aplicate printr-o simplă descriere — demonstrație de un minut, de la o saturație caldă până la un rezultat mai experimental. Fără nume de funcționalitate, fără abonament indicat și fără articol de blog asociat: mai degrabă o prezentare de produs decât o lansare. 🔗 sursă
- Demonstrație live a funcțiilor Gemini pentru cumpărături pe Discord — sesiune anunțată pentru marți, 22 septembrie, la ora 11 PT, pe serverul Discord oficial, dedicată pregătirii unei achiziții, comparării opțiunilor și căutării pornind de la o fotografie. Nicio funcționalitate nouă. 🔗 sursă
- Together AI și Ollama anunță o sesiune despre agenții de cod deschiși — Parth Sareen din partea Ollama și Zain Hasan din partea Together AI vor susține o sesiune despre introducerea în producție a agenților de cod bazați pe modele deschise. Mesajul nu precizează data sau locul. 🔗 sursă
- Parametrii a două antrenări abandonate ale Boris-2 devin deschiși — prima s-a plafonat la o pierdere de 3,100 după 30 de miliarde de tokeni, din cauza unei incompatibilități între gradienții Muon și AdamW; a doua a fost oprită în jurul pragului de 7 miliarde de tokeni. O relatare a eșecului mai instructivă decât modelele. 🔗 sursă
- Un protocol preînregistrat împotriva părtinirii direcționale a modelelor-evaluator — ipoteza este că, în cazul textului narativ, erorile tind spre declararea unui sentiment, mai degrabă decât spre codificarea lui. Protocolul este publicat înaintea oricărei colectări de date, împreună cu rezultatul care ar determina retragerea constructului și cu un conflict de interese declarat de autor. 🔗 sursă
- O reproducere a Jev cu componente deschise ratează cu 0,6 puncte — un utilizator care declară că nu programează îi încredințează lui Claude Code o zi de experimente pentru a reconstrui Jev pe stive deschise care rulează exclusiv pe procesor. Opt abordări eșuate, pe care le consideră mai instructive decât cea care a funcționat. 🔗 sursă
- Jevini separă proiectarea și executarea deciziei — un model mare de raționament proiectează un graf versionat de evaluări tipizate, pe care un model mic de decizie îl execută pentru fiecare situație nouă. Conținut promoțional al editorului, care trebuie tratat ca atare. 🔗 sursă
- Cohere își continuă comunicarea de brand, fără vreun anunț de produs — un mesaj din 20 septembrie prelungește campania AI for Empowerment, reformulând intenția atribuită cofondatorului Aidan Gomez, iar două materiale vizuale din 21 septembrie relatează participarea companiei la hackathonul studențesc Hack The North, din Waterloo. Nici model, nici funcționalitate, nici tarif. 🔗 campanie · 🔗 hackathon
Ce înseamnă acest lucru
Disponibilitatea din ziua zero devine norma de distribuție. Grok 4.7 nu așteaptă: este disponibil în Cursor și în GitHub Copilot chiar din ziua anunțului, iar Qwen-Image-2.1 a fost oferit încă de la lansare prin vLLM, SGLang, ComfyUI și Hugging Face. Intervalul dintre publicarea unui model și disponibilitatea sa în instrumentele de zi cu zi, care se măsura în săptămâni, tinde spre zero — în cazul Cursor, deoarece editorul și laboratorul aparțin aceluiași grup începând cu 14 august, iar în alte cazuri, deoarece integrarea este pregătită înaintea anunțului. Întrebarea interesantă nu mai este când va sosi un model, ci cât va costa odată ajuns.
Exact asta schimbă linia de facturare a Copilot. Grok 4.7 iese din sistemul multiplicatorilor de solicitări și este facturat în funcție de utilizare, la tariful public al xAI. Împreună cu activarea automată a noilor modele, acest lucru transferă o decizie privind costurile către administrarea platformei: lipsa oricărei acțiuni echivalează cu deschiderea unei categorii de cheltuieli indexate după grila unui furnizor terț. Din perspectiva xAI, argumentul este simetric — același preț de 2 dolari la intrare ca pentru Grok 4.6, îmbunătățiri reale pe Terminal-Bench, dar un loc în urma Fable 5.1 la sarcinile de cod de lungă durată: ceea ce se vinde aici este un raport preț-performanță, nu primul loc.
În privința agenților, trei anunțuri distincte descriu aceeași schimbare: mediul de execuție încetează să mai fie o cutie neagră. devin ssh deschide mașina virtuală a agentului pentru o sesiune interactivă, relore îi oferă agentului memoria deciziilor anterioare dintr-un depozit, nu doar starea actuală a codului, Perplexity își post-antrenează modelul pe exact acele interacțiuni în care a eșuat în utilizarea reală, iar Qwen Code își direcționează instrumentele prin bwrap. NVIDIA oferă cadrul teoretic al acestei evoluții, afirmând că securitatea unui agent se asigură nivel cu nivel, dincolo de controlul său, cu jurnale care servesc drept dovezi. Agentul inspectabil și agentul constrâns sunt cele două fețe ale aceleiași nevoi.
Rămâne întrebarea pe care anunțul OpenAI o ridică fără să o abordeze. Un model intern care rezolvă peste o sută de probleme deschise în mai puțin de o lună a generat un răspuns instituțional — un grup consultativ independent, neremunerat, liber să-și formuleze opiniile — al cărui mandat exclude explicit ritmul progreselor interne, adică tocmai obiectul protestului celor 27 de medaliați Fields. Contrastul cu restul zilei este instructiv: în timp ce este discutat ritmul rezultatelor spectaculoase, o bibliotecă de tokenizare devine de 3 până la 30 de ori mai rapidă, garantând identificatori identici, iar o metodă de compresie împrumută idei din sticlele de spin pentru a câștiga 23 de puncte MMLU la o compresie de 50%. Acest tip de muncă nu ajunge în titluri, dar el stabilește cât va costa inferența de mâine.
Surse
- Grok 4.7 — xAI
- @SpaceXAI pe X, anunțul Grok 4.7
- Grok 4.7 este acum disponibil în GitHub Copilot
- Grupul consultativ privind matematica și inteligența artificială
- O nealiniere gravă a AI în matematică
- Precomenzi pentru Googlebook
- ElevenLabs pe X, Studio 4.0
- ElevenLabs pe X, Studio Agent
- tokenizers v1: codificare, decodificare și scalare, măsurate
- Devin Cloud în terminalul tău
- Cognition pe X, devin ssh
- Note de lansare Qwen Code v0.24.3
- relore, memorie de depozit pentru agenții de programare
- Învățarea din greșeli din lumea reală
- Perplexity pe X, modele video în Computer
- Gemini Notebook pe X, Live Chat
- Gemini Notebook pe X, Interactive Learning Overviews
- Google.org și Digital Promise
- Runway pe X, fluxuri de lucru extinse
- NVIDIA DSX Ready
- Securizarea stivei de agenți
- NVIDIA, securitatea AI-ului fizic și platforma Halos
- Asimilarea datelor în Earth-2
- Reducerea LLM-urilor ca un fizician
- NVIDIA, ecosistemul AI egiptean
- NVIDIA, cinci companii și energiile cu emisii reduse de carbon
- NVIDIA AI pe X, Golden Tickets GTC Berlin
- Alibaba Qwen pe X, compatibilitate cu Qwen-Image-2.1
- Extinderea OpenAI Academy cu noi trasee de învățare
- Runway pe X, hackathon API
- HeyGen pe X, benchmarkul Code2Video
- Suno pe X, efecte sonore descrise în limbaj natural
- Gemini App pe X, demonstrație pentru cumpărături
- Together AI pe X, sesiune cu Ollama
- Boris-2-0907 și Boris-2-0917
- Părtinirea rezumării: un test preînregistrat pentru un eșec direcțional al modelelor-evaluator LLM
- Am evaluat Jev în raport cu stive deschise care rulează exclusiv pe procesor
- Ingineria circuitelor decizionale
- Cohere pe X, campania AI for Empowerment
- Cohere pe X, Hack The North