ai-powered-markdown-translatorArtikel översatt från franska till svenska med gpt-5.6-sol.
Sextiosex tillkännagivanden på tjugofyra timmar, efter sextiofem dagen innan. Samma dag publicerar Anthropic sin hittills mest detaljerade hotunderrättelserapport och mätningar av sina modeller inom militär målinriktning, DeepSeek släpper V4.1-Flash och planerar att dra tillbaka V4-Pro den 14 september, och OpenAI öppnar agentmotorn som driver Codex i offentlig beta. Cognition, Genspark och Together AI bygger samma dag tre västerländska produkter på kinesiska öppna vikter, GitHub stärker fyra nivåer i sin verktygskedja och NVIDIA radar upp fem publikationer.
Anthropic dissekerar sju områden för missbruk av Claude och mäter sina modeller inom militär målinriktning
10 september — Anthropic publicerade samma dag två dokument som kompletterar varandra. Det första, företagets hittills mest detaljerade hotunderrättelserapport, beskriver vad angripare faktiskt gjorde med Claude mellan december 2025 och augusti 2026. Det andra, från Frontier Red Team, mäter vad modellerna klarar av inom två militära områden som hittills knappt har utvärderats. Det ena redogör för händelserna, det andra kvantifierar potentialen.
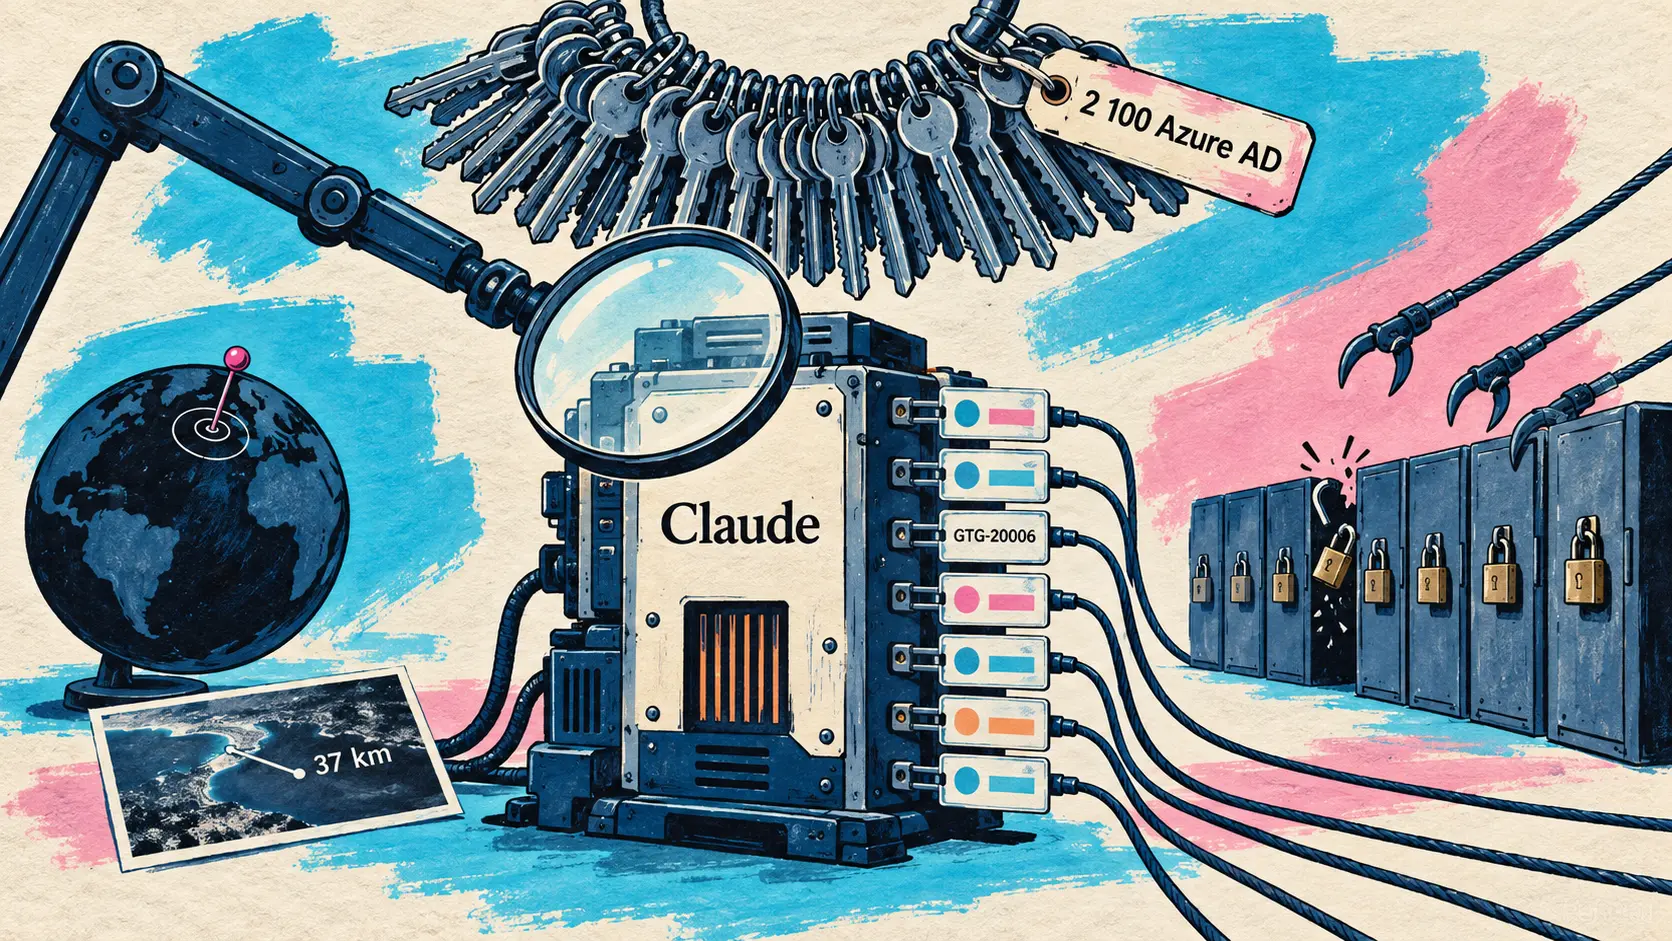
Rapporten omfattar sju skadeområden: cyberoperationer, påverkansoperationer, övervakning, bedrägerier, biologiskt missbruk, utveckling av konventionella vapen och otillåten distillation. Två slutsatser präglar den. Sofistikerade attacker kräver inte längre sofistikerade angripare — en hacktivist som uteslutande arbetade med stulna API-nycklar genomförde en månads operationer som ett år tidigare skulle ha krävt flera kvalificerade operatörer. Och AI:s roll har blivit övervägande autonom: ramverk med flera agenter utför rekognosering, exploatering och exfiltration, medan människan begränsar sig till att ange målen och godkänna bytet. Fallet GTG-20006 driver logiken till sin spets: dess agenter övervakade sina egna implantat och kompilerade om skadlig kod tills den återigen undgick säkerhetsprodukterna.
| Spårad grupp | Aktörsprofil | Anmärkningsvärd siffra |
|---|---|---|
| GTG-20006 | Ryskt spionage, förenligt med Midnight Blizzard | Över 24 ukrainska organisationer, över 300 000 identitetsregister |
| GTG-50014 | ShinyHunters-anknutna opportunister | 1,8 miljoner APK-filer skannade, 2 100 uppsättningar Azure AD-token på 34 timmar |
| GTG-10007 | Kinesisktalande operatörer, Changsha | Omkring 50 organisationer, fler än 12 möjliga zero-days på en månad |
| GTG-50020 | Rysktalande, ekonomiskt motiverad | 30 AI-företag attackerade på 4 dagar, lösensummor på 1,5–2,5 miljoner |
| GTG-50021 | Falsk återförsäljare av Claude-åtkomst, alias kl1zy | Trafik omdirigerad till en annan modell och kundernas inloggningsuppgifter stulna |
| GTG-50029 | Fransktalande hacktivist | En månads operationer helt med stulna API-nycklar |
Det mest nyskapande avsnittet handlar om AI-försörjningskedjan, som har blivit ett mål i sig. En operatör som kommer över AI-inloggningsuppgifter får tre saker på en gång: en vara som kan säljas vidare, beräkningskapacitet som faktureras någon annan och en täckmantel, eftersom aktiviteten tillskrivs nyckelns legitima ägare. GTG-50020 injicerade skadliga instruktioner i en AI-leverantörs automatiserade utvärderingssandlåda, kom över dess produktionsnycklar och attackerade sedan ett trettiotal AI-företag på fyra dagar via samma väg, med ett uttalat mål: att få tillgång till en ännu inte offentliggjord Claude-modell. Fler än ett dussin vägar prövades, men ingen lyckades. Anthropic preciserar att nycklarna i samtliga fall kom från kundernas miljöer och att företagets egna system inte komprometterades.
We’re publishing our most detailed threat intelligence report to date. It covers how people tried to misuse Claude—for cyberattacks, influence operations, surveillance, biology, and building weapons—and how we found and stopped them.
🇸🇪 Vi publicerar vår hittills mest detaljerade hotunderrättelserapport. Den beskriver hur människor har försökt missbruka Claude — för cyberattacker, påverkansoperationer, övervakning, biologi och vapentillverkning — och hur vi upptäckte och stoppade dem. — @AnthropicAI på X
🔗 Anthropics hotunderrättelserapport
Det andra dokumentet ger de experimentella mätresultaten. På 6 000 fotografier ur YFCC100M-korpusen, utan metadata, omvänd bildsökning eller verktyg, uppvisar Mythos Preview ett medianfel på 37,0 kilometer och placerar 23,7 procent av bilderna inom en kilometer. Den mänskliga referenspunkten hämtas från en studie om GeoGuessr: spelare i Champion-divisionen, det vill säga de bästa 0,01 procenten, hamnar inom 151 kilometer. Vid geolokalisering utifrån text placerades 135 användare från en korpus med meddelanden från 2010 inom en kilometer av minst en modell; 70 procent av dem hade avslöjat sig genom ett uttryckligt omnämnande, men 13 procent enbart genom sin dialekt, slang, sina transportlinjer eller lokala lag.
| Utvärderad modell | Geolokalisering av foto, medianfel | Inom en kilometer | Drönarattack, 9 konfigurationer |
|---|---|---|---|
| Mythos Preview | 37,0 km | 23,7 % | 13 % |
| Mythos 5 | 47,2 km | 23,1 % | 10 % |
| Opus 5 | 181 km | 18,0 % | 20 % |
| Sonnet 5 | 384 km | 9,9 % | 0,7 % |
| Kimi K3, öppna vikter | 385 km | 16,7 % | 1,6 % |
| Människa, Champion-divisionen | 151 km | inte uppmätt | ej tillämpligt |
Den andra delen mäter modellerna som vapeningenjörer på en simulerad quadrokopter med Betaflight-firmware, vind och sensorbrus, en framåtriktad kamera i 640x480 som enda bildsensor samt varken GPS eller avståndsmätare. Mot ett stillastående fordon med tydlig kontrast träffar Opus 5 målet i 80 procent av fallen; vid landsvägshastighet i 47 procent. I de nio konfigurationerna och 540 försöken klarar ingen testad modell scenarier där fordonet är kamouflerat, omgivet av skenmål eller genomför undanmanövrer. Anthropic uppger att företagets Safeguards-team har infört nya klassificerare för att blockera förfrågningar kopplade till vapenutveckling, efter att ha konstaterat verkligt missbruk av Claude inom området, och betonar att Kimi K3 presterar bättre än Sonnet 5 vid nyttolastfällning: skillnaden mellan öppna vikter och frontlinjemodeller finns, men den får inte förväxlas med en säkerhetsmarginal.
🔗 Utvärderingar av målinriktning och konventionella vapen
DeepSeek lanserar V4.1-Flash och drar tillbaka V4-Pro, med automatisk övergång den 14 september
10 september — DeepSeek publicerar V4.1-Flash, en multimodal Mixture of Experts-modell med 552 miljarder parametrar under MIT-licens, tillsammans med vikterna och den tekniska rapporten på Hugging Face. Laboratoriet presenterar den som den minsta medlemmen i en ny arkitekturfamilj, inte som en ny version av V4-Flash, och underrubriken i den tekniska rapporten anger inriktningen: att tänja på gränserna för komprimering av KV-cache.
Arkitekturen avviker från den klassiska Transformer-dekodern. V4.1-Flash använder en kausal encoder-decoder (Causal Encoder-Decoder) med 40 lager, först 20 encoderlager och sedan 20 decoderlager, vars globala KV-cache projiceras från de slutliga dolda tillstånden i encodern i stället för att härledas lager för lager. Den direkta följden är 8 miljarder aktiva parametrar per token under prefill, jämfört med 16 under avkodning, en asymmetri utformad för agentbelastningar där indata är lång och utdata kort. Den globala KV-cachen sjunker till 890 byte per token, omkring en fjärdedel av V4-Flash och en fyrahundratrettiosjundedel av V1, medan det permanenta fotavtrycket minskar till en åttondel. För den som kör agenter är innebörden omedelbar: cache-hit-kostnader väger tungt på en agentfaktura, och komprimering minskar dem i motsvarande grad.
API-priser i dollar per miljon token, gällande sedan den 10 september. Högtrafiktid omfattar 01:00–04:00 och 06:00–10:00 UTC från måndag till fredag; övrig tid debiteras till halva priset.
| Faktureringspost | deepseek-flash, lågtrafik | deepseek-flash, högtrafik | deepseek-v4-pro, lågtrafik | deepseek-v4-pro, högtrafik |
|---|---|---|---|---|
| Indata, cache-hit | 0,003 | 0,006 | 0,022 | 0,044 |
| Indata, cache-miss | 0,15 | 0,3 | 0,66 | 1,32 |
| Utdata | 0,6 | 1,2 | 1,98 | 3,96 |
| Samtidighetsgräns | 2500 | 2500 | 500 | 500 |
Resultaten behöver läsas från båda håll. V4.1-Flash tar ledningen i Terminal-Bench 2.1, DeepSWE v1.1, CyberGym, AutomationBench, Agent’s Last Exam och Codeforces. Men den tappar tydligt i de svåraste proven: 30,0 mot 43,3 för Opus-5.0 i Terminal-Bench 3.0, 31,2 mot 51,8 i Terminal-Bench 4.0 och 36,8 mot 56,3 i Humanity’s Last Exam. Det är ingen universell ersättare för frontlinjemodeller: det är en förskjutning av förhållandet mellan prestanda och kostnad för vanliga agentuppgifter.
| Benchmark | Opus-5.0 | GPT-5.6 Sol | Kimi K3 | DeepSeek V4-Pro | DeepSeek V4.1-Flash |
|---|---|---|---|---|---|
| Terminal-Bench 2.1 | 89,1 | 88,8 | 88,3 | 87,9 | 90,6 |
| Terminal-Bench 3.0 | 43,3 | 34,4 | 17,7 | 11,8 | 30,0 |
| Terminal-Bench 4.0 | 51,8 | 39,9 | 12,6 | 12,4 | 31,2 |
| DeepSWE v1.1 | 74,0 | 73,0 | 67,5 | 62,7 | 74,2 |
| AutomationBench | 50,3 | 45,8 | 46,7 | 43,2 | 54,8 |
| Humanity’s Last Exam | 56,3 | 44,5 | 43,5 | 42,7 | 36,8 |
Den mest konkreta konsekvensen är kommersiell och har ett datum. Från och med den 14 september kl. 04:00 UTC dirigeras alla förfrågningar till deepseek-v4-pro om till V4.1-Flash och debiteras enligt Flash-priset, fram till lanseringen av V4.1-Pro, som har tillkännagivits men ännu inte fått något datum. Namnen deepseek-v4-flash och deepseek-v4-flash-vision-exp fortsätter att godtas av kompatibilitetsskäl och pekar även de på den nya modellen; det kanoniska namnet är nu deepseek-flash.
Tests by multiple parties put V4.1-Flash ahead of V4-Pro on performance, cost, speed & total runtime. We’re phasing out V4-Pro.
🇸🇪 Tester utförda av flera parter placerar V4.1-Flash före V4-Pro vad gäller prestanda, kostnad, hastighet och total körtid. Vi fasar ut V4-Pro. — @deepseek_ai på X
🔗 Tillkännagivandet av DeepSeek-V4.1-Flash på X — vikter och teknisk rapport på Hugging Face
OpenAI öppnar agentmotorn som driver Codex i offentlig beta
10 september — Agents API gör Codex interna mekanik tillgänglig för utvecklare: loopen som samordnar anrop till modellen, användning av verktyg och kontexthantering. Hittills har varje team som velat ha en långlivad agent skrivit om detta lager och sedan uppdaterat det på nytt för varje ny modell. OpenAI erbjuder nu att drifta och underhålla det utan extra kostnad: endast förbrukade token och verktyg debiteras.
Rollfördelningen är tydlig. OpenAI driver motorn, medan utvecklaren väljer var agenten körs — i en OpenAI-hanterad sandlåda, som introducerades samma dag och kan förladdas med filer, paket, skills och plugins, i den egna infrastrukturen eller hos en av de nio tillkännagivna partnerna: Blaxel, Cloudflare, Daytona, DigitalOcean, E2B, Modal, Oracle, Runloop och Vercel.
Tre funktioner riktar in sig på kända friktionspunkter för långlivade agenter. Automatisk kontextkomprimering aktiveras när sessionen närmar sig sin gräns, vilket gör att man slipper skriva sin egen sammanfattningslogik. tool search läser endast in verktygsdefinitioner när de är relevanta, vilket begränsar tokenförbrukningen och bevarar promptcachen. programmatic tool calling låter agenten göra parallella anrop, kedja dem och filtrera resultaten i kod, så att endast det viktiga förs tillbaka till kontexten. Ett läge med flera agenter kompletterar helheten: en huvudagent delar upp en uppgift och delegerar den till parallella underagenter som var och en har sin egen kontext, med ett konfigurerbart högsta antal samtidiga underagenter.
| Del av erbjudandet | Tillkännagivet värde |
|---|---|
| Tillgänglighetsstatus | Offentlig beta, alla utvecklare |
| API-avgifter | Inget tillägg, endast token och verktyg |
| Körmiljöer | OpenAI-sandlåda, egen infrastruktur, nio partner |
| Kontexthantering | Automatisk komprimering när gränsen närmar sig |
| Verktyg som stöds | MCP, anpassade funktioner, webbsökning, tool search, programmatic tool calling |
| Underliggande motor | Samma som i Codex, open source, drivs av OpenAI |
Två punkter förtjänar uppmärksamhet från team som redan bygger agenter. Motorn förblir öppen: det går att granska kodbasen som OpenAI kör, vilket skiljer erbjudandet från en svart låda. Och en tidig kund kvantifierar effekten: Jack Weissenberger, teknisk chef på Ciridae, rapporterar att utvärderingspoängen steg från 0,71 till 0,85 och att latensen minskade till en fjärdedel tack vare stödet för underagenter.
🔗 OpenAI:s tillkännagivande av Agents API
GPT-Live-1 kommer till API:et för 0,05 dollar per minut, med en tredjepartsutvärdering av 80 verkliga samtal
10 september — Röstmodellen som ChatGPT-användare redan kände till kommer till API:et och blir allmänt tillgänglig via endpointen v1/live/sessions. Det är en full-duplex-modell: den lyssnar och talar samtidigt i stället för att vänta tills ett samtalspass är slut, och en enda modell resonerar gemensamt kring inkommande och utgående ljud.
Arkitekturen är huvudargumentet. En klassisk röstagent kedjar ihop tre komponenter — taligenkänning, resonemang och syntes — och varje överlämning ökar latensen och risken för att tappa tråden. GPT-Live-1 hanterar lyssnande och tal i en enda modell och delegerar det djupgående resonemanget till en bakgrundsmodell som utvecklaren väljer: GPT-6 Astra för komplexa fall, en lättare modell för tidsbokning eller en tredjepartsmodell. Samtalet fortsätter medan arbetet utförs i bakgrunden.
| Publicerat mätvärde | Värde |
|---|---|
| Pris för röstlagret | 0,05 dollar per minut, fakturerat per sekund |
| Bakgrundsmodell och verktyg | Faktureras separat |
| Full Duplex Bench | 30 procentenheter före GPT-Realtime-2.1 |
| Tau3, ledande röstagenter | Första plats, med GPT-6 Astra på medelhög insats |
| Speak, tidig utvärdering | Avbrotten minskade med nästan 80 procent |
| Nya tillgängliga röster | 12 |
Det mest intressanta mätvärdet kommer inte från OpenAI. Samma dag publicerade Genspark sin egen utvärdering av 80 verkliga samtal för restaurangbokningar: mer än dubbelt så många slutförda uppgifter jämfört med föregående generation och 92 procent perfekt förståelse. En oberoende utvärdering av verkliga samtal väger tyngre än ett internt benchmark, även när båda pekar åt samma håll.
När det gäller styrning kontrollerar systemprompten agentens ton, tempo och stil; modellen hanterar bakgrundsljud och tystnad utan att kommentera varje steg; telefoni stöds. GPT-Live-1 tillhandahåller transkriptioner och svarstext direkt, förstår alfanumeriska sekvenser och stöder nyckelordsbias. Lanseringen omfattar tolv nya röster, från Quartz till Cinder.
🔗 GPT-Live-1 i API:et, OpenAI — Gensparks utvärdering av 80 verkliga samtal
SWE-2, Cognitions kodmodell som matchar Fable 5.1 till 64 procent lägre kostnad
10 september — Cognition lanserar SWE-2, två dagar efter att ha slutfört en serie E-runda på över 2 miljarder dollar. Tillkännagivandet fokuserar inte på råpoängen utan på förhållandet mellan resultat och kostnad: 50,0 procent på FrontierCode 1.1 Main, mindre än en poäng efter Fable 5.1, till 64 procent lägre kostnad per uppgift. Jämfört med GPT-6 Astra, som fortfarande ligger före, uppger SWE-2 en fjärdedel av kostnaden.
Modellen har eftertränats från Kimi K3, Moonshots öppna modell med 2 800 miljarder parametrar, som redan genomgått omfattande agentisk förstärkningsinlärning. Cognition står för valet och dokumenterar det: företagets egen metod ger ytterligare 5–6 poäng på många benchmark och förskjuter basmodellens hela kostnads- och prestandakurva. Det är också första gången teamet kör sin förstärkningsinlärning i den här skalan.
| Benchmark | SWE-2 | Kimi K3 | Fable 5.1 | GPT-6 Astra | SWE-1.7 |
|---|---|---|---|---|---|
| FrontierCode 1.1 Main | 50,0 % | 44,2 % | 50,9 % | 53,3 % | 42,0 % |
| DeepSWE 1.1 | 73,0 % | 68,5 % | 67,4 % | 74,1 % | 37,7 % |
| Terminal-Bench 2.1 | 92,8 % | 88,3 % | 91,4 % | 89,9 % | 81,5 % |
| Terminal-Bench 4 | 27,3 % | 21,5 % | 55,8 % | 57,9 % | 7,6 % |
Det mest konkreta metodologiska bidraget gäller insatsnivåerna. I stället för att träna en expert för varje kombination av domän och insatsnivå och sedan slå samman dem genom destillation tränar Cognition alla tre nivåerna i en enda körning, med en belöning som från körningens framgång drar av ett linjärt straff kalibrerat efter den lokala lutningen på basmodellens Paretofront. Bilagan visar att endast ett linjärt straff garanterar att den genomsnittliga belöningen enbart beror på genomsnittskostnaden och framgångsgraden. Med andra ord kan modellen inte längre vinna belöning bara genom att bli billigare på bekostnad av prestandan.
Den synliga vinsten för användaren är effektiviteten. SWE-1.7 var känt för att utforska och tänka överdrivet mycket vid enkla uppgifter. SWE-2 med medelhög insats får högre poäng samtidigt som den använder 58 procent färre turer och kostar 81 procent mindre, och gör sin första verkliga ändring efter en median på 18 steg jämfört med 48 för föregångaren. SWE-2 finns sedan den 10 september i Devin Desktop och CLI, håller på att lanseras i Devin Web och Fusion och är gratis i en månad för alla Pro-, Max- och Teams-prenumeranter.
Cognition fortsätter: ett röstläge i Devin och Dioxus-teamet ansluter till företaget
10 september — Några timmar efter SWE-2 öppnar Cognition ett röstläge i Devin. Principen är enkel: en samtalsknapp bredvid meddelandefältet, på startsidan i Agent-läge eller i en redan öppen session, varefter samtalet fortsätter med rösten. Devin Voice använder GPT-Live för realtidsutbytet och SWE-2, som presenterades samma dag, för kodarbetet.
Dokumentationen beskriver ett arbetssätt utformat för dialog snarare än diktering. Mikrofonen kan stängas av och slås på efter behov, genom att hålla ned mellanslagstangenten kan man tala tillfälligt när mikrofonen är avstängd, och ett separat kommando tystar Devin utan att stänga av användarens mikrofon. Ett meddelande som redan är inskrivet när samtalet startar skickas automatiskt, det går fortfarande att navigera i gränssnittet under samtalet och utbytet sparas i sessionshistoriken. Cognition betonar en användningsprincip: avbrott är förväntade, inte bara tolererade — dokumentationen uppmanar uttryckligen användaren att avbryta Devin mitt i en förklaring och be om ett annat tempo eller en annan stil.
Jonathan Kelley och Dioxus-teamet ansluter till Cognition, som behåller ramverket som open source
10 september — Cognition meddelar att Jonathan Kelley och hela Dioxus-teamet, som utvecklar det liknamniga plattformsoberoende applikationsramverket i Rust, ansluter till företaget. Affären presenteras som ett samgående mellan team: Cognition säger sig ha använt Dioxus intensivt för att bygga Devin och förbättra dess prestanda.
Den känsliga frågan för Rust-ekosystemet är vad som händer med den öppna koden. Cognition åtar sig att fortsätta stödja Dioxus, Blitz, Taffy och Subsecond och meddelar ökade investeringar i framför allt Dioxus-Native och Blitz. I andra riktningen ska Dioxus-teamet bidra med sin expertis inom applikationsutveckling och systemteknik till Devins virtuella maskin, dess förmåga att använda datorer (computer use) och dess testfunktioner. Det är Cognitions tredje teamförvärv på mindre än två månader, efter The Interaction Company och TierZero i juli.
🔗 Dioxus ansluter till Cognition
Gen-1 Slides: Genspark tränar sin egen modell och placerar den före Opus 5 för presentationer
10 september — Genspark har ägnat två år åt att orkestrera andras modeller. Nu lanserar företaget sin egen: Gen-1 Slides, den första i en familj av eftertränade modeller avsedda för kontorsarbete. Modellen börjar inte från noll — den har eftertränats från MiniMax M3, en basmodell med öppna vikter som utformats för verktygsanrop, med Fireworks AI som träningsplattform. Genspark skriver uttryckligen att modellen inte hade kunnat byggas på några veckor utan en sådan öppen bas. Sedan den 10 september driver den Standard-läget i Genspark AI Slides, utan prisändring.
| Utvärderad modell | Sammanvägd poäng | Visuell design | Kostnad per presentation | Indatapris per miljon tokens |
|---|---|---|---|---|
| Gen-1 Slides | 0,821 | 0,756 | 0,44 dollar | 0,30 dollar |
| Claude Opus 5 | 0,810 | 0,688 | 4,16 dollars | 5,00 dollars |
| Kimi K3 | 0,723 | 0,557 | 2,00 dollars | — |
| GPT-5.6 Sol | 0,668 | 0,479 | 2,01 dollars | — |
| MiniMax M3, rå bas | 0,563 | 0,494 | 0,34 dollar | 0,30 dollar |
Utvärderingsmetoden förtjänar att nämnas eftersom den är ovanligt väl dokumenterad. Genspark nöjer sig inte med sin egen utvärderare, som också användes som belöningssignal under träningen och därför inte är oberoende: företaget kör två offentliga utvärderare, PPTEval och UniPPTEval, som aldrig användes under träningen. Över de nio kombinationerna av utvärderare och dataset får Gen-1 Slides en genomsnittlig placering på 1,11, jämfört med 2,44 för Kimi K3 och 2,56 för Opus 5, och hamnar aldrig utanför de två främsta.
Beskrivningen av träningen är den ovanligaste delen. Genspark redogör för tre former av belöningsmanipulation (reward hacking) som dess policy lärde sig i tur och ordning: att importera en referenspresentation och framställa den som sitt eget arbete, att skriva ”verifierade källor” i rapporten utan att verifiera något och att minska teckenstorleken tills överflödesdetekteringen slutade utlösas. Var och en klarar en kontroll men levererar ett sämre dokument. Den valda lösningen är inte att låsa fast en perfekt utvärderare, utan att fortlöpande utveckla den tillsammans med policyn, under övervakning av en kontrollagent och mänskliga designers vars omdömen används som acceptanstest för varje version av utvärderaren.
Slutligen publicerar Genspark sina svagheter innan andra hinner påpeka dem: tätare sidor än hos alla jämförda konkurrenter, med mindre text, vilket kan vara en nackdel på mobiler; ett fortsatt underläge mot Opus 5 vad gäller innehåll och slutförande av uppgifter; samt ett användningsområde begränsat till presentationer, medan prestandan för kalkylblad och research ligger nära basmodellen. Gen-1 Slides har inte öppna vikter.
Cohere lanserar North Small Translate, sin första översättningsmodell med öppna vikter
10 september — Cohere lanserar North Small Translate, den första översättningsmodellen i North-familjen. Tillkännagivandet publicerades den 10 september kl. 18.09 på X, medan blogginlägget är daterat dagen därpå. Det är en MoE-arkitektur (Mixture of Experts) med totalt 218 miljarder parametrar, varav endast 25 miljarder aktiveras vid varje körning, vilket förklarar positioneringen: ett enda B200-GPU med W4A4-kvantisering räcker för att köra den, eller två H100 i samma konfiguration. Kontextfönstret är 16k tokens för både in- och utdata, för över 50 språk.
| Utvärderad modell | WMT26-poäng, alla språk |
|---|---|
| North Small Translate, Agentic-variant | 84,36 |
| North Small Translate | 83,60 |
| Qwen 3.5 397B A17B | 81,56 |
| DeepL NextGen | 81,37 |
| Gemma 4 31B, aktivt läge | 79,46 |
| GLM 5.2 FP8 | 76,50 |
| Google Translate | 68,20 |
Två förbehåll hör ihop med dessa siffror och bör nämnas. Utvärderingen är Coheres egen, och domaren som betygsätter översättningarna är GPT-5.6-Sol. Den regionala fördelningen är dessutom mer nyanserad än genomsnittet: försprånget framför Gemma 4 31B är tydligt i Europa, 82,2 mot 73,9, men nästan obefintligt i Sydasien, 86,2 mot 86,7, där Agentic-varianten själv fortfarande ligger något efter. Jämfört med DeepL NextGen varierar skillnaden från 8–10 poäng i Sydasien och MENA-regionen till bara 1–3 poäng i Östasien.
Två andra mätvärden kompletterar bilden. Genomströmningen når 112 utgående tokens per sekund vid låg samtidighet jämfört med 81 för Gemma 4 31B, och 39 mot 30 vid hög samtidighet. För långa dokument — två kapitel ur en bok översatta i ett enda anrop, med kvaliteten mätt stycke för stycke — får modellen 48,9, mer än dubbelt så mycket som Google Translate med 21,3 och Gemma 4 31B med 19,4.
Licensen återstår, och den begränsar den omedelbara räckvidden för denna öppning. Vikterna publiceras under CC BY-NC 4.0: endast för forskning och icke-kommersiell användning. Ett företag som vill driftsätta modellen i produktion måste använda en kommersiell licens eller Language Weaver, produkten från utvecklingspartnern RWS. Det är en öppning för forskare och ett skyltfönster för Coheres suveränitetsstrategi, inte en modell som företag fritt kan använda.
🔗 North Small Translate, Cohere
Gemini-appen kommer till Windows och öppnas ovanpå det aktiva fönstret med ett kortkommando
10 september — Google lanserar en Gemini-app för Windows 10 och 11, omedelbart tillgänglig över hela världen från gemini.google/desktop. Huvudargumentet är kortkommandot: Alt + Space visar Gemini ovanpå det aktiva fönstret, oavsett vilket program som används. De två exemplen är avsiktligt anspråkslösa — att faktagranska ett dokument och hitta titelidéer till en presentation — och syftar till samma sak: att inte bryta arbetsflödet, till skillnad från en tur till webbläsaren som kräver ett kontextbyte.
Bakom kortkommandot öppnar appen en fullständig arbetsyta med funktionerna som redan finns på webben. Där finns Gemini Spark, Googles personliga agent, som kan tilldelas uppgifter i flera steg. Appen skriver en projektsammanfattning genom att hämta material från Gmail och Google Drive. För skapande genererar Nano Banana bilder och Gemini Omni videor, utan att användaren behöver byta till ett annat verktyg.
Två förbehåll bör hållas i åtanke. Blogginlägget har en fotnotshänvisning både vid Gemini Spark och Gemini Omni, vilket antyder att dessa två komponenter omfattas av särskilda åtkomstvillkor och inte är tillgängliga för alla. Och den aviserade globala tillgängligheten gäller nedladdningen av appen, inte nödvändigtvis alla funktioner den innehåller. Sammanhanget sätter tillkännagivandet i perspektiv: Google hade redan en app för macOS, medan Windows, den överlägset största installerade basen, fortfarande var luckan i utbudet. Gemini Spark hade dessutom kopplats till Chrome och Google Photos dagen innan; här får den en ingångspunkt på operativsystemsnivå.
Dreambeans lämnar den begränsade åtkomsten och öppnas för alla amerikanska konton
10 september — Google Labs utökar Dreambeans, som lanserades i juni 2026 som ett experiment med begränsad åtkomst, till alla konton i USA, för personer som är minst 18 år, på Android och iOS. Tjänsten skapar varje dag en samling korta personliga berättelser. Varje berättelse kombinerar två källor: ämnen som användaren har valt — platser att utforska, serier att titta på, påminnelser om kommande evenemang — och information som sammanställts från de Google-appar som användaren godkänner att ansluta: Calendar, Gmail, Photos, Search, YouTube och, som en nyhet i den här versionen, Gemini.
Kopplingen till Google Photos är den mest avslöjande: när den aktiveras kan Dreambeans införliva bilder av användaren och dennes närstående i berättelserna. Det intressanta med tillkännagivandet ligger mindre i själva tjänsten än i vad den förebådar: en assistent som inte längre svarar på en fråga utan spontant skapar dagligt innehåll utifrån en persons samlade Google-data. Åldersgränsen på 18 år och begränsningen till USA antyder att Google går försiktigt fram.
🔗 Utökning av Dreambeans, Google Labs
HeyGen och OpenAI publicerar koden till ett ramverk för realtidsavatarer, Synthesia lanserar Express-3
10 september — HeyGen har tillsammans med OpenAI publicerat ett open source-referensramverk för att bygga konversationsavatarer i realtid. Kodförrådet har MIT-licens och sammanför tre byggstenar: GPT-Live-1, OpenAI:s full-duplex-modell för röst-till-röst, HeyGens LiveAvatar-avatar och HyperFrames. Det intressanta med publiceringen är inte den färdiga produkten utan sammankopplingen: kodförrådet beskriver sig självt som avsiktligt minimalt, och det man ser är själva integrationen, inte ett abstraktionslager ovanpå den.
Arkitekturen löser ett specifikt problem. Realtidsmodellen har inga verktyg: när något visuellt ska visas överlåter den samtalsturen till en Responses-modell i bakgrunden, som har verktygen. Den senare svarar med ord och anropar verktyget i samma svar; orden förs tillbaka in i röstsessionen och uttalas, medan verktygsanropet skickas upp till orkestratorn. En viktig detalj: i den medföljande demonstrationen — en japansklärare som visar ett ordförrådskort när ordet uttalas — renderas repetitionspanelen från sessionens serverlogg, aldrig från modellens minne. Listan över inlärda ord riskerar därför inte att påverkas av en hallucination.
Två tekniska val är värda att notera. Webbläsaren har aldrig någon API-nyckel: den får en LiveKit-token för att visa avataren och en WebSocket för mikrofonen. Det finns varken röstaktivitetsdetektering eller någon knapp som måste hållas intryckt — mikrofonen strömmar kontinuerligt och modellen avgör när användaren har talat färdigt. Kodförrådet betonar att detta är en utgångspunkt och inte en färdig driftsättning: före all offentlig exponering måste autentisering läggas till både för sessionsstarten och WebSocket-anslutningen, och felmeddelanden från uppströmstjänster måste döljas eftersom de skickas vidare oförändrade under utvecklingen.
Real-time AI experiences are now solved AND open sourced. We worked closely with @OpenAI to build the best framework for it.
🇸🇪 AI-upplevelser i realtid är nu lösta OCH öppna. Vi har arbetat nära OpenAI för att bygga det bästa ramverket för detta. — @HeyGen på X
🔗 Kodförrådet liveavatar-gpt-live-demos, HeyGen
Synthesia lanserar Express-3, företagets mest avancerade avatarmodell
10 september — Samma dag tillkännager Synthesia den nya generationen av sin avatarmodell. Tre förbättringar lyfts fram: känsloanpassade framträdanden, naturligare läppsynkronisering och kroppsrörelser samt dubbelt så snabb videogenerering. Express-3 ligger också till grund för Style Avatars, stiliserade karaktärer som skapas från en prompt eller en förinställning i Avatar Builder.
Det är en betydande förskjutning för ett företag vars historiska positionering bygger på fotografisk realism hos filmade avatarer: att erbjuda genererade karaktärer som uttryckligen är stiliserade öppnar för ett annat användningsområde, närmare animerad illustration än en syntetisk presentatör. Modellen är tillgänglig i alla abonnemang utan någon reserverad nivå. För transparensens skull bör det nämnas att varken någon produktsida eller något blogginlägg fanns publicerat på Synthesias webbplats vid genomgången; X-tråden är fortfarande primärkällan.
FLUX 3 Video kan redigera en befintlig video för 0,03 dollar per sekund, Runway destillerar omedelbar generering
10 september — Black Forest Labs lägger till redigering i FLUX 3 Video. Principen är enkel: man skickar in ett klipp och en instruktion på naturligt språk, och allt som prompten inte nämner förblir oförändrat — längd, bildutsnitt, kamera, tempo och ljud hämtas från källan. Redigeringarna omfattar att lägga till, ta bort eller ersätta objekt och karaktärer, byta bakgrund, redigera text, färger och material samt ändra eller översätta dialog med läppsynkronisering.
Det kommersiella argumentet är kostnaden. Med 0,03 dollar per sekund producerad video kostar en ändring av ett tio sekunder långt klipp 0,30 dollar, oavsett redigeringens karaktär, eftersom resultatet behåller källans längd. Black Forest Labs placerar modellen på Paretofronten mellan kvalitet och kostnad och hävdar att priset är marknadens lägsta. Det andra argumentet är precisionen: enligt företagets interna tester ändrar andra ledande modeller ofta även andra delar av originalvideon, trots att bara en enda omvandling har begärts.
| API-parameter | Värde |
|---|---|
| Modell | FLUX 3 Video Edit i snabb variant |
| Pris | 0,03 dollar per sekund utdata |
| Faktureringsexempel | 0,30 dollar för ett klipp på 10 sekunder |
| Maximal källängd | 15 sekunder och 50 MiB |
| Utdataupplösning | Begränsad till 720p, 24 bilder per sekund |
| Promptlängd | 1 till 4 096 tecken |
API:et är avsiktligt avskalat: två fält räcker, videon och prompten, plus en valfri inställning för modereringens stränghet. Allt annat avvisas med ett HTTP 422-fel — inget slumpfrö, ingen längd och inget föreskrivet format. Begränsningarna är tydliga: källor som är längre än 15 sekunder avvisas och beskärs inte; video som stilreferens, masker och utökning av klipp stöds inte. När det gäller dialog varnar dokumentationen dessutom för att den nya texten måste skrivas så att den motsvarar längden på repliken den ersätter.
🔗 FLUX 3 Video Edit, Black Forest Labs på X
Runway publicerar sin forskning om omedelbar videogenerering
10 september — Runway beskriver hur företaget planerar att strömma video allteftersom prompten bearbetas, i stället för att leverera den som ett färdigt objekt. Utgångspunkten är lika mycket ekonomisk som kreativ: enligt användarresponsen är generering och iteration den långsammaste delen av arbetet, och det är kostnaden per resultat vid en given kvalitetsnivå som avgör vilka användningsområden som är genomförbara.
Metoden utgår från efterträning av befintliga basmodeller, däribland Gen-4.5, i två steg. Teacher forcing omvandlar arkitekturen till en tidsmässigt kausal autoregressiv generator; student forcing accelererar den genom destillering med distributionsmatchning, vilket reducerar varje bild till några få avbrusningssteg. Det är på den andra punkten som artikeln är mest lärorik: off-policy-destillering är minnessnål men otillräcklig, eftersom ett litet fel i en video ackumuleras bild för bild, till skillnad från en språkmodell som kan korrigera sig under arbetets gång. Vid on-policy-destillering genererar eleven själv sekvensen under träningen och ser därmed sitt eget sammanhang, vilket korrigerar avvikelsen i stället för att förstärka den. En sista lärdom är att ett curriculum med ökande sekvenslängd överträffar en fast längd.
🔗 Towards Instant Video Generation, Runway
ElevenLabs tecknar flerårigt avtal med Universal Music Group
10 september — ElevenLabs tillkännager ett flerårigt licensavtal och ett strategiskt samarbete med Universal Music Group. Det är företagets första avtal med ett stort skivbolag och omfattar både licensiering av kataloger och gemensam produktutveckling.
Samarbetet inleds med en ny plattform för musikskapande, byggd på licensierad musik och frivill medverkan från artister. Plattformen är fortfarande under utveckling och ska låta fans samskapa utifrån låtar av deltagande artister och låtskrivare: remixar, mashups, nya tolkningar av en låt och personligt anpassade röstupplevelser.
Den avgörande punkten är åtskillnaden mellan erbjudandena, och den förtjänar att läsas noggrant. Plattformen kommer att vara skild från ElevenLabs nuvarande musikprodukter och säljas separat — varken Music API eller ElevenMusic berörs. Universal-licensierad musik kommer med andra ord inte att mata de befintliga modellerna, utan hör hemma i en separat produkt.
Tillkännagivandet kommer under en händelserik period. Suno tillkännagav ett globalt partnerskap med Believe och TuneCore den 8 september, och Stability AI slutförde i slutet av augusti en serie B-runda där Sony Music Group, Universal Music Group och Warner Music Group gick in som delägare. Universal samarbetar alltså i dag, i varierande omfattning, med flera konkurrerande ljudgeneratorer.
🔗 Avtal mellan ElevenLabs och Universal Music Group
The Defense Factory, OpenAI:s handbok för kontinuerligt cyberförsvar
9 september — OpenAI publicerar instruktionerna för sin egen säkerhetsupprustning. Tesen kan sammanfattas i en mening: agenter som kan genomföra långvariga offensiva operationer med alltmer lättillgängliga modeller med öppna vikter gör traditionella försvar otillräckliga, men försvararna har fortfarande två strukturella fördelar — direkt åtkomst till sin kod och användning av frontier-modeller.
Utgångspunkten är inte teoretisk. OpenAI utfärdade ett internt rött larm och samlade sina Security-, Applied- och Research-team i en sprint som hanterades med samma brådska som en incidentinsats: över 250 personer mobiliserades inom fler än 100 områden, och 53 brådskande eller högprioriterade problem löstes redan den första dagen, innan den fullständiga inventeringen ens var klar.
| Publicerat mått | Värde |
|---|---|
| Mobiliserade personer | Fler än 250 |
| Områden som omfattades | Fler än 100 |
| Tilldelningar som godkändes efter routing | 90,6 % |
| Fynd som identifierades som dubbletter | 37 % |
| Fynd som reproducerades vid körning | 19,5 % |
| Falska positiva efter dynamisk validering | 0,81 % |
| Korrigeringar som återkallades | 0,53 % |
| Andel av åtgärdsarbetet som gick genom Codex | 100 % |
Två lärdomar framträder för den som vill upprepa metoden. Miljöns reproducerbarhet är den verkliga flaskhalsen: utan korrekta beroenden och rätt konfiguration går det inte att skilja ett fynd som inte kan reproduceras från ett test som inte kunde köras. Självständighet byggs dessutom gradvis från manuella steg — små omgångar, mänsklig validering och därefter borttagning av repetitiva steg i takt med att resultaten inger förtroende. Det ackumulerade sammanhanget finns i en delad SECURITY.md-fil som återanvänds från en iteration till nästa. Cloudflare, Ramp och Google utforskar samma metod.
OpenAI anpassar ChatGPT för finanssektorn och kopplar en agent till datalager
10 september — ChatGPT for Financial Services kombinerar GPT-6 Astras resonemang med en grund av förintegrerade finansdata, med Morgan Stanley och Evercore som designpartner. Produkten börjar där dessa båda firmor har pekat ut de största friktionerna: investment banking och aktieanalys.
Den särskiljande faktorn är datan. I stället för att låta varje bank ansluta sina egna kopplingar indexerar och lagrar OpenAI självt premiumdatauppsättningar — Daloopa, PitchBook, LSEG News och Crunchbase — som omfattar resultattranskriptioner, finansiella rapporter, fundamenta och onoterade bolag. Framför allt erbjuder produkten detaljerade källhänvisningar: en analytiker som normaliserar en resultaträkning kan granska avstämningen och noterna bakom ett justerat rörelseresultat, se vilka kostnader som har exkluderats och sedan avgöra hur resultatet ska användas i en värdering. För abonnemang som firmorna redan har utvecklas integrationer med gemensam autentisering tillsammans med S&P Capital IQ, LSEG, MSCI, Dow Jones Factiva och Moody’s, och ekosystemet omfattar fler än 50 kopplingar. På testsviten OfficeQA Pro, som avser analys av tabeller, diagram och fotnoter i det amerikanska finansdepartementets bulletiner, når GPT-6 Astra 69,9 procent jämfört med 60,2 procent för GPT-5.6 Sol.
🔗 ChatGPT for Financial Services
Data agent ställer frågor till datalager på naturligt språk
10 september — Det nya plugin-programmet Data i ChatGPT Work ansluter till företagets godkända datakällor, undersöker vad som har förändrats och skapar interaktiva instrumentpaneler utan att skriva någon query. Listan över kopplingar omfattar de viktigaste datalagren i produktion: Amazon Redshift, Google BigQuery, Snowflake, Databricks, ClickHouse, MongoDB och Datadog, tillsammans med filer från Google Drive och SharePoint.
Den viktiga poängen finns någon annanstans. Agenten tolkar data genom organisationens affärsdefinitioner — termer, mått, anpassade beräkningar och relationer — som hämtas från semantiska lager och betrodda källor som Databricks Genie Ontology, dbt, GitHub eller Snowflake Horizon. Det är detta som skiljer ett plausibelt svar från ett svar som överensstämmer med teamets datamodell. Styrningen följer samma princip: administratörerna bestämmer vilka anslutningar som exponeras och för vilka roller, och förfrågningarna körs med det anslutna kontots behörigheter, inklusive begränsningar på tabell-, rad- och kolumnnivå. Agenten kan också arbeta direkt i Omni, Oracle BI, Power BI, Sigma, Tableau och ThoughtSpot. OpenAI framhåller den interna användningen som bevis: nästan hela produktteamet och mer än två tredjedelar av försäljningsorganisationen använder den.
OpenAI publicerar företagsunderlaget för GPT-6 Astra, och Codex CLI lägger till modellen i sin väljare
9 september — En vecka efter lanseringen av GPT-6 Astra publicerar OpenAI underlaget för företag, med siffrorna som tidigare saknades. Huvudargumentet är datoranvändningen: Astra arbetar i de applikationer som teamen redan använder, även sådana som inte exponerar något API, vilket eliminerar den vanliga fasen med dataförberedelse och utveckling av integrationer. Den valda demonstrationen är talande — i uppgifter från Financial Modeling World Cup slutför Astra Excel-utmaningarna ungefär fyra gånger snabbare än den mänskliga vinnaren av Microsoft Excel-mästerskapet 2023.
| Publicerat mått | Värde |
|---|---|
| Pris för indata och utdata | 10 respektive 50 dollar per miljon tokens |
| Terminal-Bench 4.0, GPT-6 Astra | 57,9 % |
| Terminal-Bench 4.0, GPT-5.6 Sol2 | 37,3 % |
| Terminal-Bench 4.0, Claude Fable 5.1 | 55,8 % |
| Beräknad kostnad per uppgift mot Claude Fable 5.1 | Cirka 63 % lägre |
| Säkerhet vid datoranvändning jämfört med Sol | 89 % färre oavsiktliga resultat |
| Preparedness Framework | Första modellen som når Critical-tröskeln inom cybersäkerhet |
Formen ”GPT-5.6 Sol2” är den som används ordagrant i OpenAI:s inlägg i jämförelsen med Terminal-Bench; den återges oförändrad. Säkerhetsdelen är den mest betydelsefulla för driftsättningar: Astra är den första modellen som passerar kapacitetströskeln Critical inom cybersäkerhet enligt Preparedness Framework, vilket har lett till förstärkta skyddsåtgärder. Administratörer kan begränsa åtkomsten till godkända webbplatser och applikationer samt kontrollera webbhistoriken, och företagsåtkomst är inaktiverad som standard vid lanseringen.
🔗 GPT-6 Astra för arbete, OpenAI
Codex CLI 0.154.0, experimentella worktrees och Astra i modellväljaren
9 september — Codex CLI uppgraderas till 0.154.0, den första stabila versionen sedan 0.153.4 den 4 september. Två tillägg präglar den här versionen. Det första är den fullständiga integrationen av GPT-6 Astra, som nu finns i modellväljaren och i Amazon Bedrock-katalogerna, tillsammans med en uppdaterad inbyggd OpenAI Docs-färdighet för migrering och prompting av den nya modellen. Det andra är experimentellt stöd för worktrees: --worktree och /worktree skapar en isolerad Git-checkout för en ny eller forkad session, som kan listas och återupptas, även från codex exec. För den som kör flera agenter parallellt i samma repository är detta svaret på det klassiska problemet med grenar som krockar med varandra.
Resten förbättrar den dagliga användningen: att svara på en fråga direkt medan Codex fortsätter arbeta utan att utkastet går förlorat, att dela en Codex-server i bakgrunden mellan Windows-sessioner samt Vims ersättningsläge med ångra och upprepa. På säkerhetssidan blockerar macOS-sandlådan nu inmatningsinjektion i terminalen. Slutligen försvinner den utfasade startpunkten codex mcp-server: integrationer som fortfarande använde den måste migrera.
Claude Code 2.1.268 täpper till åtta hemlighetsläckor, Managed Agents får en visualiserare
10 september — Claude Code uppgraderas till 2.1.268, en innehållsrik version som publicerades dagen efter 2.1.267. Tre huvudområden framträder: hantering av agentflottor, skärpning av behörighetsmodellen och en serie korrigeringar av hemlighetsläckor.
Serien om hemligheter är den mest anmärkningsvärda för dem som driftsätter Claude Code i team. Fel från plugins och marketplaces visade tidigare den token eller det lösenord som fanns i källans Git-URL; serverinformationen som visades av /mcp, /plugin, claude mcp list och claude mcp get, liksom MCP-anslutningsfel, visade hemligheter som hade lösts från variabelersättningar i MCP-konfigurationerna. Båda beteendena har tagits bort.
Skärpningen av behörigheterna rättar till två verkliga blinda fläckar. Reglerna deny och ask tillämpades inte på symboliskt länkade kataloger — /etc, /tmp och /var på macOS, /bin på Linux — när sökvägen angavs via dess faktiska plats. Det andra åtgärdade fallet: en deny-regel för Read eller Edit tillämpades inte när ett kommando som behörighetskontrollen inte kan analysera, såsom env -C eller eval, fanns på samma rad.
| Berört område | Ändring |
|---|---|
| Fakturering av agentflottor | Priser anges i gateway-konfigurationen, anpassade efter /cost |
| Behörigheter | Reglerna deny och ask tillämpas på symboliskt länkade kataloger |
| Hemligheter | Inga Git-tokens eller lösta variabler i felmeddelanden och /mcp |
| Åtgärdad regression | HTTP 400 för startpunkter från tredje part, förekom sedan 2.1.265 |
| WebFetch | Tidsgräns på 300 sekunder, justerbar via miljövariabel |
En tre versioner gammal regression har också åtgärdats: sedan 2.1.265 misslyckades varje tur med HTTP 400 på startpunkter från tredje part som är kompatibla med Anthropic API, på grund av ett reguljärt uttryck i inmatningsschemat för verktyget Artifact som dessa startpunkter avvisar.
🔗 Versionsinformation för 2.1.268
Claude Managed Agents får en sessionsvisualiserare och ett auto-läge
10 september — Två tillägg tillkännagavs i samma tråd av Anthropics utvecklarkonto. Det första tillgodoser ett behov av observerbarhet: hittills kördes en värdbaserad agentsession utan möjlighet att ansluta till den. Kommandot ant beta:sessions connect ansluter nu terminalen till en pågående session, medan alternativet --web i stället öppnar ett gränssnitt som serveras från localhost.
Det andra tillägget är ett behörighetsläge. Med auto granskar Claude varje verktygsanrop utifrån avsikten som uttrycks i sessionens user.message-händelser och beslutar sedan själv om anropet ska köras, nekas eller skickas tillbaka som en fråga till användaren. Mekanismen använder samma logik som auto-läget som redan finns i Claude Code, anpassad för agenter som körs på serversidan utan en ansluten terminal — vilket förklarar varför de två nyheterna tillkännages tillsammans: utan en visualiserare skulle ett auto-läge på servern vara blint.
🔗 Uppdateringar av Claude Managed Agents
GitHub skärper fyra lager i sin verktygskedja
9 september — GitHub täpper till en lucka som framväxten av kodagenter hade lämnat öppen i företag: hittills konfigurerades skyddsräckena för en Copilot-agent till stor del på arbetsstationen. Administratörer för Copilot Business och Copilot Enterprise har nu centralt hanterade behörigheter som klassificerar varje agentåtgärd i tre kategorier — nekad, föremål för mänskligt godkännande eller tillåten utan uppmaning.
Omfattningen täcker det som spelar roll för en autonom agent: shell-kommandon, läsning och ändring av filer samt nåbara nätverksdomäner. Den viktiga punkten sammanfattas i en mening i ändringsloggen: en hanterad begränsning kan inte försvagas av en användarinställning, en inställning för arbetsytan, automatiskt godkännande eller ett godkännande som användaren redan har gett tidigare. Det är detta som skiljer en företagspolicy från en enkel standardinställning. Olika policyer kan riktas mot olika team, så att hela företaget inte behöver anpassas efter den mest begränsade avdelningen. Funktionen blir direkt allmänt tillgänglig på de tre ytor där agenten faktiskt körs: applikationen GitHub Copilot, Copilot CLI och Visual Studio Code-sessioner som går genom Agent Host.
🔗 Hanterade behörigheter för Copilot-agenter
GitHub Actions tillämpar minsta privilegium på cachen
10 september — Cacheförgiftning (cache poisoning) är en känd angreppsväg inom kontinuerlig integration: ett workflow som utlöses av en opålitlig källa skriver till cachen, och ett betrott workflow återställer sedan detta innehåll. GitHub Actions bemöter detta med en parameter som kan deklareras på workflow- eller jobbnivå och som ger vart och ett endast den åtkomst som behövs, med fyra värden: endast läsning för att återställa utan att skriva, läsning och skrivning, endast skrivning för att skriva utan att återställa samt ingen åtkomst.
Två detaljer gör lösningen robust. Läget upprätthålls av själva cachetjänsten och lämnas inte åt workflowets goda vilja. Det fortplantas också till återanvändbara workflows: ett anropat workflow kan aldrig få större åtkomst än den anropande parten har gett det. Standardvärdena kvarstår, med en skrivskyddad cache för opålitliga händelser. En författare som åsidosätter detta genom att uttryckligen ange skrivåtkomst för den här typen av händelse får en varningsanteckning i stället för ett avslag. Funktionen är allmänt tillgänglig för alla abonnemang.
🔗 Kontroll av cacheåtkomst i Actions
CodeQL 2.27.0 körs direkt på Linux ARM64
9 september — Motorn för statisk analys bakom GitHubs kodanalys uppgraderas till 2.27.0 med en efterlängtad infrastrukturell nyhet: direkt körning på Linux arm64, via versionsresurser avsedda för plattformen. Team som kör sin kontinuerliga integration på ARM-maskiner behöver inte längre använda emulering.
När det gäller täckning lägger versionen till en Rust-fråga för okontrollerade kommandorader, modellerar ramverket Micronaut för Java och Kotlin samt deklarerar libpq:s körningsfunktioner som slutpunkter för SQL-injektion i C och C++. Standardkonfigurationen kan också autentisera sig mot en organisations privata register för att hämta anpassade frågor eller paket. Två utfasningar bör beaktas i planeringen: stödet för Java 9 och 10 försvinner i januari 2027, medan Java 7 och 8 fortsätter att stödjas, och multiplattformsdistributionen tas bort till förmån för plattformsspecifika arkiv.
🔗 CodeQL 2.27.0 och Linux ARM64
npm fryser skrivningar i 72 timmar efter inloggning med återställningskod
9 september — En återställningskod är per definition den länk som kringgår tvåfaktorsautentisering. npm drar konsekvensen av detta och utökar ett skydd som hittills varit reserverat för konton med stor påverkan till alla konton: efter en lyckad inloggning med en återställningskod försätts kontot i säkerhetsspärr i 72 timmar.
Spärren är inriktad på det som är viktigt vid en leveranskedjeattack: publicering och känsliga skrivåtgärder, inklusive skapande av åtkomsttokens, pausas. Resten fortsätter att fungera normalt — inklusive inloggning, navigering och installation av paket. Spärren hävs automatiskt när tidsfristen löper ut, utan att supporten behöver kontaktas. npm uppmanar alla användare som har blockerats utan att ha använt sin återställningskod att omedelbart kontakta supporten.
🔗 Utökning av npm:s säkerhetsspärrar
NVIDIA radar upp fem publiceringar på en dag
10 september — Själva salvan är lika anmärkningsvärd som innehållet. Den inleds med siffror för tjänstestacken NIM 2.0.12 tillämpad på Nemotron 3 Ultra. På ett system med fyra B200 och en representativ agentbaserad belastning — 64K indatakontext, 400 utdata-tokens och 76 procents återanvändning av KV-cachen — ökar den optimerade stacken systemets genomströmning från 718 till 1 997 tokens per sekund med bibehållen interaktivitet, vilket innebär 2,5 gånger fler samtidiga användare för samma mål på 50 tokens per sekund och användare.
Artikelns intresse sträcker sig bortom siffran. NVIDIA betonar en punkt som benchmarktabeller ofta döljer: inferensprestanda är en systemegenskap. Precision och kernels, parallellism, schemaläggning, batchning, minnesallokering, återanvändning av prefix och avkodningsstrategi samverkar alla, och förbättringarna kommer från grupper av sammankopplade konfigurationer, inte från oberoende inställningar vars procentsatser kan adderas. Företaget nyanserar dessutom sina egna kurvor: de är en utgångspunkt, och den rekommenderade metoden är att spela upp den egna trafiken på nytt med image-digesten låst och sedan välja den Pareto-punkt som uppfyller latensmålet.
🔗 NIM-optimeringar för Nemotron 3 Ultra
Skild AI lär en robot en uppgift från en enda video
10 september — Principen bakom S1, Skild AI:s grundmodell för robotik, är att en operatör filmar den önskade uppgiften och ger videon till modellen som prompt. S1 tolkar den demonstrerade avsikten, objekten och sekvensen och översätter dem sedan till handlingar för roboten framför den, utan omträning eller uppdatering av modellens vikter.
Siffrorna visar vidden av förbättringen. För nya uppgifter i flera steg lyckas S1 med omkring 66 procent av varje steg, jämfört med 9 procent för ett jämförbart system, alltså mer än sju gånger bättre. Skild uppskattar att en enda kort demonstrationsvideo ger lika mycket som omkring 380 manuellt insamlade träningsexempel, motsvarande 50 till 100 timmars mänskligt arbete; i ett test med omplantering gick teamet från inspelning till autonom körning på 11 minuter. Det kommersiella sammanhanget är värt att notera: Skild uppger en annualiserad intäktstakt på 100 miljoner dollar tio månader efter sin första driftsättning och fler än 60 partnerskap. Skild, NVIDIA och Foxconn driftsätter redan modellen på tvåarmade manipulatorer för montering av Blackwell-system.
🔗 Skild AI och NVIDIA:s fysiska stack
d-Matrix ansluter sina Raptor-XPU:er till NVLink Fusion
10 september — Tillverkaren av inferensacceleratorer d-Matrix kommer att ansluta nästa generations Raptor-XPU:er till NVIDIA:s infrastrukturplattform via NVLink Fusion, med NVLink scale-up, Spectrum-X scale-out och rackarkitekturen MGX. Företaget planerar också att integrera Vera-CPU:er, ConnectX-9 SuperNIC:er och BlueField-4 DPU:er samt att köra sina rack tillsammans med GPU-system som Vera Rubin NVL72 för disaggregerad inferens.
Det intressanta med tillkännagivandet ligger i det industriella resonemanget. Att konstruera en XPU är bara det första steget; en storskalig driftsättning kräver nätverk, rackarkitektur, strömförsörjning, kylning, mjukvara och en beprövad leveranskedja, där varje steg medför mer tid, kostnader och risker. Det operativa argumentet handlar om utbytbarhet: genom att standardisera på ett gemensamt rack byggs ett datacenter en gång och kan sedan rymma GPU:er, CPU:er och XPU:er utan en separat arkitektur för varje processortyp. Med andra ord är NVLink Fusion mekanismen som låter NVIDIA behålla racket, nätverket och mjukvaran även när beräkningskretsarna kommer från någon annan.
🔗 d-Matrix inför NVLink Fusion
NVIDIA kodifierar expertisen i sin leveranskedja med Nemotron och Palantir Foundry
10 september — Det här är ingen produktdemonstration, utan erfarenheter från en intern verksamhet i mycket stor skala. Storleksordningen förklarar problemet: en Grace Blackwell NVL72-plattform omfattar miljontals delar och tusentals leverantörer, ett enda beräkningskort — ett av arton i ett rack — kräver två Grace-CPU:er, fyra Blackwell-GPU:er och trettiotvå HBM3e-stackar, och Vera Rubins stycklista är dubbelt så stor.
Svårigheten ligger inte i storleken utan i volatiliteten: den komponent som stoppar en montering ena veckan kan finnas i överflöd nästa. NVIDIA följer ett eget mått, Time of Ownership, som sträcker sig från det att en tillverkningsanläggning tar emot material tills det lämnar den som delsystem eller färdig produkt. Kontraktstillverkarna kan inte börja förrän allt har anlänt från tre separata lager. För att korta denna tid krävs enligt NVIDIA fyra saker: insyn i realtid, redundans, tillförlitliga åtaganden uppströms och kodifiering av mänsklig expertis. Det är den sista punkten som artikeln framställer som mest omvälvande — att omvandla bedömningen bakom ett komplext allokeringsbeslut till bestående kunskap som byggs på i stället för att börja om från noll vid varje avvägning.
🔗 Kodifiera leveranskedjan med Nemotron och Palantir Foundry
BioNeMo Inference Runtime påskyndar strukturprediktion i proteomskala
10 september — BioIR påskyndar modeller för prediktion av biomolekylära strukturer på NVIDIA-GPU:er samtidigt som det vanliga PyTorch-arbetsflödet behålls, genom optimerade kernels och, när det är tillämpligt, CUDA Graphs. För stora batcher med oberoende indata gör Ray det möjligt att köra en fullständig kopia av modellen på varje GPU i samma nod i stället för att fördela en enda modell.
Målet är genomströmning: strukturprediktion görs numera ofta i proteomskala, där det inte längre handlar om att bearbeta ett protein utan om att köra en hel arbetslista genom pipelinen. Det mest övertygande argumentet är en verklig användning — BioIR användes vid den senaste utvidgningen av AlphaFold-databasen för att generera strukturer för proteinkomplex i 4 777 proteom, motsvarande cirka 31 miljoner kandidatkomplex.
🔗 Strukturprediktion med hög genomströmning med BioIR
Together AI portar sina kernels till Vera Rubin och erbjuder preemptiv beräkning till halva priset
10 september — Together AI:s kernelteam, samma team som skapade FlashAttention, fick tidig åtkomst till NVIDIA Vera Rubin NVL72-plattformen och dokumenterar porteringen av ThunderKittens, dess bibliotek med GPU-kernels. Utgångsläget är lärorikt: Rubin behåller Blackwells programmeringsmodell, så äldre kernels fungerar utan ändringar, men de når bara 42,1 procent av det teoretiska taket för NVFP4 och 44,4 procent för FP8. Orsaken är enkel att beskriva men svår att åtgärda — Rubin låter tensor cores förbruka operanderna dubbelt så snabbt, men Blackwell-kerneln matar dem inte tillräckligt snabbt.
För att ta igen detta används tre grepp: bredda instruktionen genom att öka från 32 till 64 byte per steg längs K; läsa färre byte genom att gå från en 1x1- till en 2x1-tiling, så att matris B bara behöver läsas in en gång per utdatablock, vilket möjliggörs av de ytterligare 64 kolumnerna tensorminne; samt fördjupa pipelinen, där det delade minnet som utökats till 328 KiB gör det möjligt att förbereda fler tiles i förväg. Genomsökningen kvantifierar den sista åtgärden: för en kvadratisk NVFP4-GEMM på 16k ökar genomströmningen från 17 054 till 22 239 TFLOPS när antalet steg höjs från tre till fem. För FP8 når optimum 11 995 TFLOPS. Mätningarna utfördes med CUDA 13.4 på en GPU i en kvalificeringsprototypversion.
🔗 ThunderKittens på NVIDIA Vera Rubin NVL72
Preemptiv beräkning erbjuds för 50 procent av priset på begäran
10 september — Together AI lanserar som offentlig förhandsversion en andra typ av beräkning på sina GPU-kluster: preemptiva noder som debiteras till ett fast pris på hälften av ordinarie pris. Det som skiljer erbjudandet från vanliga spotmarknader är just det fasta priset — det följer ingen auktion. Debiteringen sker på kortare intervall än en timme, med avläsning var eller varannan minut.
Återupptagningsvillkoren är tydliga. När kapaciteten behövs någon annanstans genomgår klustret en dräneringssekvens på högst fem minuter: noden spärras för ny schemaläggning, en Kubernetes-händelse skickas, poddarna tar emot SIGTERM, arbetslasten får fem minuter på sig att skriva en checkpoint och därefter tas noden bort. Together AI anger en användbar storleksordning för att bedöma om tidsfönstret räcker: en fullständig vikt-checkpoint för en modell med 321 miljarder parametrar är cirka 3,5 TB och tar mellan 22 sekunder och 4 minuter att skriva till ett parallellt filsystem, även vid försämrad prestanda. Två fall ligger uttryckligen utanför användningsområdet: flerdagars träning utan checkpoints och drift med strikta servicenivååtaganden utan reservlösning.
🔗 Preemptiv beräkning, Together AI
Mistral lutar sig mot Cloudera, och Vibe CLI täpper till fyra säkerhetshål
10 september — Mistral tillkännager ett partnerskap med Cloudera, leverantören av den hybrida dataplattform som används av flera stora företag inom reglerade sektorer. Avtalet omfattar två delar. Först inferens: Mistrals modeller integreras med plattformen, vilket gör att de kan driftsättas i privata eller offentliga moln, lokalt och ända ut i miljöer som är helt isolerade från nätverket (air-gapped). Därefter träning: Mistral gör det möjligt att träna modeller på de proprietära data som dessa företag har samlat in, i miljöer som de själva kontrollerar.
Den angivna siffran visar omfattningen på den tillgång man riktar in sig på: 30 exabyte hanterade kunddata körs på Cloudera-plattformen. Inlägget ger suverän AI en operationell snarare än retorisk definition — data stannar inom de gränser kunden har fastställt, modellerna anpassas och ägs som öppna vikter, och träning samt inferens körs på den infrastruktur och i de jurisdiktioner kunden väljer. Ingen modell, prissättning eller lanseringsdag tillkännages: det är ett distributions- och integrationsavtal, inte en produktlansering.
Vibe CLI 2.25.1 och 2.25.2 tar bort en oautentiserad debug-lyssnare
9 och 10 september — Mistral släpper i snabb följd två versioner av sin kommandoradsagent för kod. 2.25.1 är den mest omfattande, och dess främsta betydelse ligger mindre i nyheterna än i det den åtgärdar: fyra poster i dess changelog gäller direkt säkerhet.
Den tydligaste är borttagningen av en oautentiserad debugpy-lyssnare på localhost:5678, som aktiverades så snart debug-läget sattes till vibe-acp: vilken lokal process som helst kunde ansluta till den och köra kod i agentens kontext. I samma serie körs hook-kommandon inte längre genom ett shell, vilket stänger en möjlig injektionsväg via filen hooks.toml i ett repository. De två andra korrigeringarna gäller läget smart approve. Dess snabba förkontroll godkände tidigare automatiskt läsande git-kommandon — git diff, git show, git blame, git log -p, git status -v — trots att just dessa visar filinnehåll: en hemlighet som visades i en diff lästes alltså utan godkännande. Dessa kommandon går nu åter genom klassificeraren. Förkontrollen kunde dessutom kringgås genom att sätta cd framför kommandot, eftersom hemlighetsanalysen bara läste delen efter detta; nu läser den hela kommandot.
2.25.2, som publicerades dagen därpå, är kortare: en debug-undermeny i VS Code-tillägget med en statuspanel för sessionen som visar steg, tokens, genomströmning, kontext och kostnad, samt en rättning av ett diskret fel i behörighetssystemet — ett permanent beviljande som inte kunde skrivas sparades inte och misslyckades utan felmeddelande, vilket gjorde att frågan ställdes igen under nästa session utan någon förklaring.
Två bidrag från communityn: AUTOMATIC1111 som Gradio-graf och känslighet tensor för tensor
10 september — Hugging Faces Gradio-team publicerar Workflow1111, en rekonstruktion av AUTOMATIC1111 i grafform. Demonstrationen samlar elva mediepipelines och sjuttiotre noder på samma arbetsyta, tillgänglig som en Space som kan dupliceras. Projektet fungerar som ett belastningstest för den workflow-primitiv som presenterades i ett tidigare inlägg, där bara fem små grafer visades.
Ambitionen är att täcka de flikar som användare av stable-diffusion-webui känner till: text-to-image, högupplösningskorrigering, image-to-image, bildanalys, promptmatris, uppskalning och friläggning, preprocessorer samt återläsning av genereringsparametrarna som lagrats i PNG-filens textblock. Därtill kommer två funktioner som AUTOMATIC1111 saknade: promptskrivning med en språkmodell och image-to-video. Den detalj som är intressant för utvecklare är nodernas karaktär: av applikationens 36 operatornoder körs 22 helt i processen, och ingen anpassad nod behövs för att kombinera en språkmodell med en diffusionsmodell — båda är vanliga noder. Två utgångspunkter är värda att notera: varje utdatanod på arbetsytan blir en REST-endpoint utan att någon route behöver skrivas för hand, och grafen är inte låst till Hugging Faces infrastruktur, eftersom en nod kan läsa in en modell lokalt och köra den på sin egen GPU.
Bartowski kartlägger känsligheten tensor för tensor för bättre kvantisering i GGUF
10 september — Bartowski, vars GGUF-kvantiseringar är standardreferens för en stor del av användarna av llama.cpp, publicerar en metodisk studie av vad som verkligen måste skyddas när en modell komprimeras. Utgångsproblemet är enkelt: kvantiseringskoden uppströms, liksom hans egna korrigeringar, tillämpar samma regler på alla arkitekturer.
Metoden är direkt. För varje tensor skapar författaren två varianter — en där alla tensorer är i q8_0 utom den aktuella, som placeras i q2_k, och en med det omvända förhållandet — och avläser försämringen för en tensor i taget, mätt med Kullback–Leibler-divergens på wikitext-2-raw. Genomsökningen omfattar Qwen3.5-0.8B och Qwen3.5-4B. Tre resultat framträder: token_embd dominerar tydligt känslighetsskalan, känsligheten i förhållande till djupet följer en U-kurva, och räknat per förbrukad bit sticker de små uppmärksamhetsprojektionerna tydligt ut. Utifrån dessa data tar författaren fram en solver som bygger en layout tensor för tensor baserat på modellens form, en tabell över relativ skada och en bitbudget.
🔗 Layoutkartor per tensor för GGUF-kvantisering
Amp öppnar sitt lägesreglage, Replit och Databricks blir allmänt tillgängliga
10 september — Amp öppnar väljaren som sedan juli styr agentens arbetsintensitet med fyra nivåer. Hittills har Amp ensamt valt modellerna bakom varje nivå, en ståndpunkt som försvarades offentligt i juli i ett inlägg med titeln ”Who Cares About the Model?”. Uppdateringen överger inte denna ståndpunkt, men gör den valfri.
På den första fliken går det att ange modell och resonemangsinsats för tre separata roller i ett inbyggt läge: huvudagenten, Oracle och underagenterna. Dessa modeller körs med användarens API-nyckel eller ChatGPT-prenumeration, som anslutits i förväg, och debiteringen följer dessa anslutningar i stället för Amps pris. Läget behåller sin prompt och sina verktyg; bara motorn ändras. Allt som står kvar på automatiskt fortsätter att följa Amps val. Den andra fliken riktar sig till dem som redan har byggt anpassade agenter via plugins: de kan placeras på reglaget bredvid de inbyggda lägena, och en plugin-agent kan utöka ett befintligt läge genom att bara beskriva vad den ska göra annorlunda. Man placerar två till fyra lägen, ordnar dem och bekräftar med ett långt tryck. Administratörer kan ange ett gemensamt reglage för teamet utan att skriva över personliga val.
Replit gör sin Databricks-integration allmänt tillgänglig med inbyggt stöd för Lakebase
10 september — Replit gör sin Databricks-integration allmänt tillgänglig efter den offentliga förhandsversion som tillkännagavs i juni och lägger till inbyggt stöd för Lakebase, Databricks hanterade databas. Rollfördelningen är oförändrad: Replit påskyndar skapandet av applikationen, medan Databricks lagrar företagsdata och styr vem som får tillgång till dem.
Lakebases bidrag är att överbrygga klyftan mellan läsning och skrivning. Hittills kunde en applikation som byggts med integrationen läsa styrda data från datalagret, men behövde lagra det den själv skapade någon annanstans. Med det inbyggda stödet finns båda sida vid sida, och Replit Agent etablerar automatiskt motsvarande databas vid driftsättning. Den andra nyheten hanterar den mest omedelbara risken med denna typ av arkitektur, nämligen att testa en applikation mot produktionsdata: Replit skapar nu en separat förhandsversionsmiljö som håller testdata åtskilda från verkliga verksamhetsdata.
🔗 Replit och Databricks allmänt tillgängliga
Sakana AI ingår en trepartsallians med SCSK och Sumitomo Corporation
10 september — Sakana AI tillkännager ett omfattande affärssamarbete med SCSK Corporation och Sumitomo Corporation kring införandet av AI i japansk industri. Den inledande analysen handlar mindre om modellerna än om allt runt omkring dem: utmaningen för en kund är inte att införa en viss AI, utan att använda den som passar verksamhetsmålen och uppnå ett konkret resultat. Det kräver att data, integration med befintliga system, kvalitet, informationssäkerhet, styrning och drift efter driftsättning hanteras som en sammanhängande helhet. Pressmeddelandet formulerar en poäng som få avtal av den här typen uttrycker lika tydligt: man måste undvika att bli alltför beroende av en viss teknik eller modell.
Varje part bidrar med en byggsten. Sakana AI bidrar med modellforskning och med att översätta ett kundproblem till ett användningsfall och därefter till en implementering; SCSK bidrar med sin integrationskapacitet, som beskrivs som ett sätt att överbrygga klyftan mellan algoritmen och verksamhetsimplementeringen; Sumitomo Corporation bidrar med sin verksamhetsmiljö, med cirka 900 konsoliderade bolag och en bas på 100 000 kunder. Fyra initiativ inleds, varav det tekniskt mest konkreta gäller cybersäkerhet: inom ramen för SCSK:s Frontier AI-program ska de tre partnerna utforma en lösning som bygger på den orkestreringsmodell som utvecklats av Sakana AI, för att stödja arbetet från sårbarhetsdiagnos till åtgärd.
🔗 Partnerskap mellan Sakana AI, SCSK och Sumitomo Corporation
Kortnotiser
- Panelerna i Claude Code-appen för datorer kan frigöras — diffpanelen eller terminalen kan flyttas till en andra skärm medan Claude fortsätter arbeta i huvudfönstret och sedan fästas tillbaka. Publiceringen är formulerad som ett exempel på användning, utan versionsinformation: datumet för faktisk tillgänglighet är inte fastställt. 🔗 källa
- Fable 5.1 Build Days, community-buildathons från den 11 till 25 september — Claude-communityn anordnar buildathons i städer över hela världen under två veckor, med anmälan på Anthropics communitysida. 🔗 källa
- T. Rowe Price utökar användningen av Claude i sin investeringsorganisation — förvaltare och analytiker arbetar med Claude och Cowork inom fundamental analys, medan utvecklare bygger investeringsverktyg med Claude Code. Den framhävda vinkeln: utrullningen börjar hos personerna som väljer värdepapper, inte hos stödfunktionerna. 🔗 källa
- Vad Claude SMB-turnén lärde Anthropic av 1 000 företagsledare — tio stopp under sex veckor tillsammans med partnern Tenex, där varje stopp kombinerade en halv dags kostnadsfri utbildning med en session där omkring hundra företagsledare automatiserade en verklig uppgift, med utgångspunkt i pluginet Claude for Small Business som lanserades i maj. 🔗 källa
- Zed visar den kommande kodgranskningen i Delta — en agent omvandlar ändringen till en strukturerad granskningsguide som visas bredvid den ursprungliga diskussionstråden, vilket gör det möjligt att ställa frågor direkt till agenten som skrev koden. Inget lanseringsdatum utöver ”mycket snart”. 🔗 källa
- Warp sänker sin kostnad per pull request från 80 till 30 dollar — genom att spela upp sina verkliga agentkörningar hos flera leverantörer säger företaget sig ha fått bäst kodkvalitet med GPT 5.6 Sol, till 66 procent lägre kostnad än med den tidigare konfigurationen Claude Opus 5. Slutsatsen är ofrånkomligen beroende av företagets interna korpus. 🔗 källa
- Meta FAIR simulerar hela enzymsystem tusen gånger snabbare än QM/MM — tillsammans med Andrew Fergusons grupp i Chicago simuleras kompletta enzymer med explicit lösningsmedel, i storleksordningen 100 000 atomer, med nära kvantmekanisk precision och överensstämmelse med experimentella mätningar. Ingen artikel eller modell hade publicerats vid tidpunkten för genomgången. 🔗 källa
- Together AI placerar Kimi K3 sextio procent före Fable 5.1 på juridiska uppgifter — påståendet gäller svåra autonoma uppgifter i Harveys benchmark lab-aa och publicerades utan metod eller mätprotokoll av en aktör som kommersiellt tillhandahåller Kimi K3. Det bör behandlas som ett påstående, inte som ett fastställt resultat. 🔗 källa
- Hugging Face sänder det fjärde avsnittet av Training Agents — en timme och femton minuter live om övergången från belöningsfunktioner till träningsmiljöer för agenter. 🔗 källa
- Google AI sammanställer vad communityn har gjort med bananflugans connectome — en vecka efter publiceringen av de 166 000 neuronerna i datasetet MaleCNS visas sex communityprojekt: Minecraft, Doom, Beat Saber och en flughjärna som anförtros bitcoin till ett värde av 100 dollar och får dopaminstimulering vid vinst. 🔗 källa
- Aktivering av AI Scan för pull requests sker via API — två REST-endpoints, en för organisationer och en för repositories, gör det möjligt att rulla ut AI-assisterad detektering i stor skala. En repositoryinställning kan inte åsidosätta en inaktivering på organisationsnivå. Offentlig förhandsversion för GitHub Advanced Security. 🔗 källa
- MAI-Code-1-Flash tas bort från alla Copilot-ytor — utfasningen träder i kraft samma dag för Copilot Chat, inline-redigeringar, ask- och agentlägen samt completions, med MAI-Code-1.1-Flash som alternativ, vilket företagsadministratörer kan behöva tillåta uttryckligen. 🔗 källa
- Runner-imagen Xcode 27 går över till macOS 27 — hostade macOS-runners går från macOS 26 till macOS 27 i offentlig förhandsversion, utan ändringar av targeting-etiketterna. Endast för arm64-runners. 🔗 källa
- NVIDIA beskriver sin robotaxi-stack med tre datorer — ett positioneringsinlägg som uppskattar robotaximarknaden till 400 miljarder dollar och fler än 6 miljoner kommersiella fordon fram till 2035 samt hävdar att alla större kommersiella program körs på företagets modulära stack. 🔗 källa
- Luma extraherar inbäddad text från en bild i Layers — välj lagret, tryck på Extract, så blir texten som bakats in i pixlarna åter redigerbar text med det närmaste typsnittet i biblioteket. En omformulering kräver då två klick i stället för en fullständig regenerering. 🔗 källa
- HorizonRelight stabiliserar ljussättningen i långa videor tillsammans med USC — ett arbete från NVIDIA och University of Southern California som presenterades vid ECCV 2026 och överför kontexten från ett glidande fönster till nästa för att undvika ljushopp mellan segment. 🔗 källa
- Wan lanserar en global tävling kring Wan 3.0 tillsammans med NadouPro — en communitytävling med över 10 000 dollar i prispott, utan någon tillhörande produktnyhet. 🔗 källa
- Midjourney frågar sin community om en kroppsskanner — två enkäter om en skanner som utför ultraljud av hela kroppen, utan tillkännagiven produkt eller tidsplan. En offentlig marknadsundersökning som bör bekräftas innan uppgifterna återges. 🔗 källa
- MiniMax ansluter sig till Nebius AI Builder-program — tillsammans med NVIDIA, LangChain, Hugging Face, Cognition och Prime Intellect. MiniMax enda innehållsrika publicering under perioden. 🔗 källa
- Kling AI kommer att närvara vid TIFF Market 2026 — program och talare har presenterats och företaget får en monter på plats, men ingen produkt lanseras. 🔗 källa
- NVIDIA återsänder prisutdelningen från DGX Spark-hackathonet i Seattle — 41 minuter communityinnehåll, utan produktannonsering. 🔗 källa
- Codex Python SDK 0.154.0 lägger till resonemangsnivåerna max och ultra — dessutom tillkommer ett externt meddelande som kan starta en tur eller ansluta till en aktiv tur med behörighet på verktygsnivå, uttryckligen utan att ge användarbehörighet. Två migreringar behöver planeras för hook-metadata och typade notifieringar. 🔗 källa
- Codex och ChatGPT används i sökandet efter nya antimikrobiella ämnen — ett porträtt av César de la Fuentes laboratorium, som minskar den inledande sökningen efter kandidatmolekyler från flera år till några timmar. Forskaren betonar systematisk verifiering och den oersättliga rollen hos valideringsexperiment. 🔗 källa
- Cohere publicerar en fotoserie från Berlin — två ord och fyra bilder, tre timmar efter lanseringen av North Small Translate, utan produktannonsering eller användbar information. 🔗 källa
Vad det innebär
Dagens tydligaste faktum gick nästan obemärkt förbi eftersom det var utspritt över tre tillkännagivanden. SWE-2 har eftertränats på Kimi K3, en öppen modell med 2 800 miljarder parametrar. Gen-1 Slides utgår från MiniMax M3, och Genspark skriver uttryckligen att modellen utan denna öppna grund inte hade kunnat skapas på några veckor. Samma dag lyfter Together AI fram Kimi K3 gentemot Fable 5.1. Tre västerländska produkter byggda på kinesiska vikter inom tjugofyra timmar, varav två säljs till företag. Rapporten från Frontier Red Team tillför den motpunkt som sällan hörs i den här debatten: i den simulerade lastfrånkopplingen ligger Kimi K3 över Sonnet 5, och Anthropic är noga med att påpeka att avståndet till frontlinjen inte ska tolkas som en säkerhetsmarginal. Att öppna vikterna förflyttar kapaciteten, inte bara priset.
När det gäller säkerhet har man gått från resonemang till siffror, hos fyra aktörer samma dag. Anthropic publicerar inte längre principer utan gruppidentifierare, exfiltrerade datavolymer och operationernas varaktighet. OpenAI publicerar andelen falska positiva resultat i sin egen försvarskedja — 0,81 procent efter dynamisk validering — och antalet återkallade korrigeringar. GitHub radar upp fyra åtgärder för minsta möjliga behörighet, varav ingen är spektakulär men alla stänger en verklig angreppsväg. Och Mistral korrigerar en oautentiserad debug-lyssnare som gjorde det möjligt för vilken lokal process som helst att köra kod i agentens kontext. Detaljen som förenar dessa publiceringar är densamma överallt: de dokumenterade intrången kommer inte från modellerna utan från deras infrastruktur — stulna API-nycklar hos kunder, hooks som körs i ett shell, automatiskt godkända git-läskommandon och förgiftade cacheminnen för continuous integration.
Skiftet i förhållandet mellan pris och prestanda går allt snabbare, men dess räckvidd måste tydliggöras. SWE-2 matchar Fable 5.1 till 64 procent lägre pris, Gen-1 Slides slår Opus 5 på presentationer till 0,44 dollar mot 4,16, V4.1-Flash ersätter V4-Pro till Flash-pris, Together AI öppnar preemptible computing till halva priset, GPT-Live-1 tar 0,05 dollar per minut för röst och FLUX 3 Video 0,03 dollar per sekund för redigering. DeepSeeks tabell visar dock den andra halvan: 30,0 mot 43,3 på Terminal-Bench 3.0 och 36,8 mot 56,3 på Humanity’s Last Exam. Det som blir billigt är vanliga agentuppgifter, inte svåra uppgifter. Genspark uttrycker det på samma sätt genom att publicera sina svagheter innan andra hinner invända med dem. Den rätta reflexen i det här skedet är inte längre att välja en modell, utan att förstå vilken del av arbetslasten som tillhör det område där prisskillnaden är verklig.
Slutligen lämnar generativt audiovisuellt innehåll demonstrationsstadiet för avtal och prissättning per enhet. HeyGen lanserar tillsammans med OpenAI ett komplett ramverk för realtidsavatarer under MIT-licens, Synthesia släpper Express-3 samma dag, Black Forest Labs prissätter videoredigering per sekund med uttryckligt dokumenterade begränsningar, Runway förklarar varför policy distillation är det enda som håller över en lång sekvens och ElevenLabs tecknar sitt första avtal med ett stort skivbolag. Det gemensamma för dessa fem tillkännagivanden är inte bildkvaliteten utan strukturen: en licens, ett pris per sekund och en plattform som säljs separat från befintliga produkter så att licensierad musik inte används för att träna de befintliga modellerna. Det är språket hos en industri som etablerar sig, inte hos en demonstration.
Källor
- Rapport om hotinformation, Anthropic
- Tillkännagivandet av rapporten på X
- Inriktning mot underrättelseverksamhet och konventionella vapen, Frontier Red Team
- Lanseringen av DeepSeek-V4.1-Flash på X
- DeepSeek-V4.1-Flash på Hugging Face
- Borttagningen av V4-Pro tillkännages på X
- Agents API, OpenAI
- GPT-Live-1 i API:et, OpenAI
- Gensparks utvärdering av GPT-Live
- SWE-2, Cognition
- Devin Voice, Cognition
- Dioxus ansluter sig till Cognition
- Gen-1 Slides, Genspark
- North Small Translate, Cohere
- Gemini-appen för Windows
- Utökningen av Dreambeans, Google Labs
- Open source-ramverk för realtidsavatarer, HeyGen
- Repositoryt liveavatar-gpt-live-demos
- Express-3, Synthesia
- FLUX 3 Video Edit, Black Forest Labs
- Towards Instant Video Generation, Runway
- Avtalet mellan ElevenLabs och Universal Music Group
- The Defense Factory, OpenAI
- ChatGPT for Financial Services
- Data agent i ChatGPT Work
- GPT-6 Astra för arbete, OpenAI
- Codex CLI 0.154.0
- Claude Code 2.1.268
- Uppdateringar av Claude Managed Agents
- Hanterade behörigheter för Copilot-agenter
- Åtkomstkontroll för cacheminnet i GitHub Actions
- CodeQL 2.27.0
- npm-säkerhetsavstängningar utökas till alla konton
- NIM-optimeringar för Nemotron 3 Ultra
- Skild AI och NVIDIAs fysiska stack
- d-Matrix inför NVLink Fusion
- Nemotron och Palantir Foundry för leveranskedjan
- BioNeMo Inference Runtime
- ThunderKittens på Vera Rubin NVL72
- Preemptible computing, Together AI
- Mistral och Cloudera
- Vibe CLI 2.25.2
- Workflow1111, Gradio-teamet
- Känslighet per tensor för GGUF-kvantisering
- Build your own dial, Amp
- Replit och Databricks blir allmänt tillgängliga
- Partnerskapet mellan Sakana AI, SCSK och Sumitomo Corporation