ai-powered-markdown-translatorArtikel mit gpt-6.1-sol aus dem Französischen ins Deutsche übersetzt.
Am Donnerstag, dem 1. Oktober, führt Anthropic Mods ein: kleine TypeScript-Funktionen, die sich in Ereignisse von Claude Code einklinken, um dessen Verhalten und Oberfläche umzuschreiben. Sie werden mit Version 2.1.287 ausgeliefert. GitHub stellt am selben Tag zwei Agentenfunktionen in Copilot CLI und der GitHub Copilot App als öffentliche Preview bereit: die Steuerung von Desktop-Anwendungen und dynamische Workflows, also in Code geschriebene Orchestrierungen. Black Forest Labs startet FLUX 3 Image, das mit Bounding Boxes komponiert und Bilder bis zu 4K generiert; Google führt Guided Vision in Gemini Live ein, Barclays weitet Claude auf die gesamte Bank aus und GitHub verschärft angesichts KI-generierter Meldungen die Vorgaben für das Melden von Schwachstellen.
Claude Code öffnet sich für Mods: TypeScript-Funktionen, die sein Verhalten und seine Oberfläche umschreiben
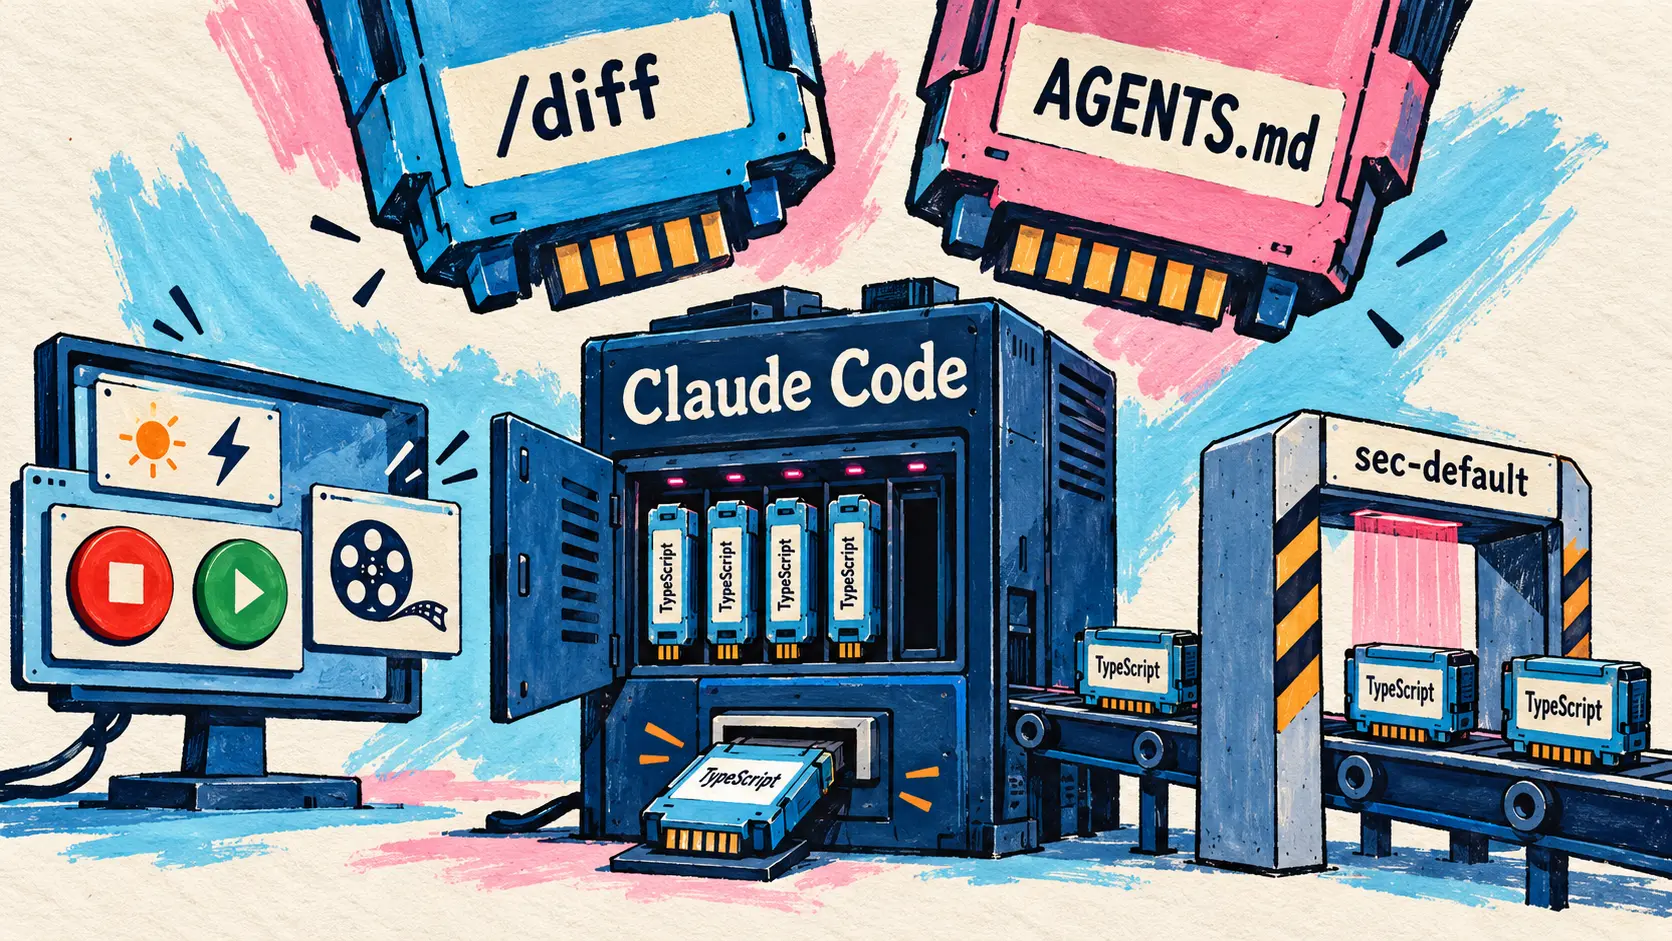
1. Oktober — Anthropic führt Mods ein, kleine TypeScript-Funktionen, die die Funktionsweise von Claude Code verändern. Jede Aktion des Tools löst ein Ereignis aus (Tool-Aufruf, Berechtigungsanfrage, eingereichter Prompt, Beginn und Ende eines Turns, Zeichnen eines Bildschirmbereichs), und ein Mod klinkt sich davor, danach, an seiner Stelle oder als umschließende Funktion ein. Er kann einen Prompt umschreiben, bevor dieser das Modell erreicht, einen Tool-Aufruf blockieren, umschreiben oder erneut starten, eine Berechtigung genehmigen oder verweigern, Geheimnisse in der Ausgabe eines Tools verbergen, bevor Claude sie liest, oder eigene Panels, Schaltflächen und Eingabefelder hinzufügen. Mods werden in Plugins ausgeliefert, mit /plugin installiert und ebenso wie diese geteilt; sie kommen mit Claude Code 2.1.287 und sind standardmäßig aktiviert. Zum Einstieg muss man die API nicht kennen: Man kann Claude Code bitten, den Mod zu schreiben, und es erzeugt den TypeScript-Code, installiert ihn und lädt ihn während der laufenden Session neu.
Der Unterschied zu den bestehenden Hooks ist deutlich. Ein Hook aus den Einstellungen (settings hook) führt bei jedem Ereignis einen Shell-Befehl aus; ein Mod wird einmal geladen und bleibt in der Session. Dadurch behält er einen Zustand, zeichnet die Oberfläche im Verlauf der Ereignisse neu und kann Slash-Befehle oder Tools registrieren, die das Modell aufruft. Anthropic nutzt dies bereits für eigene Funktionen: Das Panel /diff und die Unterstützung für AGENTS.md sind zu integrierten Mods geworden, die man deaktivieren oder ersetzen kann. Der Anbieter plant, im Laufe der Zeit weitere Funktionen umzuwandeln, damit sich Claude Code auf einen kleinen Kern reduzieren lässt. Zu den sechs integrierten Mods, die die Dokumentation auflistet, gehört You should know, das standardmäßig deaktiviert ist und in dem ein zusätzlicher Agent auf Dinge hinweist, die dem Nutzer oder Claude entgehen könnten.
| Aspekt der Mods | Offizielles Detail |
|---|---|
| Mindestversion | Claude Code 2.1.287, Mods standardmäßig aktiviert |
| Oberflächen mit Anzeige | CLI im Terminal, Code-Tab von Claude Desktop (außer WSL-Sessions) |
| Oberflächen ohne Anzeige | VS Code-Erweiterung, claude -p, Agent SDK und Cloud-Sessions, in denen die Hooks laufen |
| Integrierte Mods | 6, darunter /diff, AGENTS.md, sec-default und You should know |
| Eigene Laufzeit eines Hooks | 10 Sekunden pro Auslösung |
| Deaktivierung | /plugin für einen Mod, --safe-mode für eine Session, disableAllHooks für alle |
Die Einstiegsanleitung von Addy Osmani auf claude.dev entwickelt Token Weather, einen Mod mit rund 80 Zeilen, der oberhalb des Prompts das „Wetter“ des Kontexts mit einem Minidiagramm der letzten 12 Turns anzeigt. Sie stellt außerdem Blast Radius vor, das einen rm -rf, einen git reset --hard oder einen erzwungenen Push so lange zurückhält, bis es gezeigt hat, was davon betroffen wäre, sowie Replay Theater, das die Dateiänderungen eines Turns erneut abspielt.
Vertrauen bleibt der heikle Punkt. Der Beitrag warnt, dass Mods nicht isoliert sind: Sie haben denselben Zugriff auf den Rechner wie Claude Code. Die Dokumentation erläutert, dass ein Mod Umgebungsvariablen und Einstellungsdateien lesen, jeden Prompt sehen, einen Tool-Aufruf genehmigen oder das Nutzungskontingent des Tarifs verbrauchen kann, aber die Berechtigungsabfrage nicht verändern darf. Die Anleitung auf claude.dev beschreibt jedoch ein Modul, das in seiner eigenen Sandbox läuft, ohne DOM oder Node, wobei jede externe Aktion über die API $ erfolgt: Dadurch kann claude plugin validate vor der Installation auflisten, welche Ereignisse ein Mod abfängt und welche Aufrufe er ausführt. Bei Team und Enterprise sowie auf jedem Rechner mit verwalteten Einstellungen wird der integrierte Mod sec-default zuerst geladen und verhindert, dass vom Nutzer installierte Mods Verbotsregeln umgehen; Administratoren können ihre eigenen Mods vor ihm platzieren.
Mods are absolutely insane. You can now customize Claude to work and look the way you want by just prompting it. Each person works differently, so there’s no reason why everyone should have an identical Claude experience. Make Claude your own, and share mods as plugins so others can try your mods too.
🇩🇪 Mods sind der absolute Wahnsinn. Sie können Claude jetzt so anpassen, dass er so arbeitet und angezeigt wird, wie Sie es möchten, indem Sie ihn einfach darum bitten. Jeder arbeitet anders, deshalb gibt es keinen Grund, warum alle dieselbe Claude-Erfahrung haben sollten. Machen Sie Claude zu Ihrem eigenen Werkzeug und teilen Sie Ihre Mods als Plugins, damit andere sie ausprobieren können. — @bcherny auf X
Der Start war erwartet worden: Boris Cherny hatte ihn am 14. September angekündigt, und Anthropic hatte das Konzept auf GitHub geteilt (Issue #91870). Der Beitrag und die Anleitung auf claude.dev laden dazu ein, eigene Mods beim Claude-Verzeichnis einzureichen.
🔗 Claude Code mit Mods in TypeScript anpassen · Einstiegsanleitung auf claude.dev · Dokumentation der Mods
Claude Code 2.1.287: standardmäßig 1M Kontext bei Cloud-Anbietern und 67 Fehlerbehebungen
1. Oktober — Claude Code 2.1.287 ist die Version, die Mods ausliefert, sie umfasst aber 106 Einträge, darunter 67 Fehlerbehebungen. Für Unternehmen verwenden Opus 4.7 und spätere Versionen sowie Fable auf Bedrock, Vertex, Foundry und dem Claude apps Gateway jetzt standardmäßig ein Kontextfenster von 1M, ohne das Suffix [1m]; mit CLAUDE_CODE_DISABLE_1M_CONTEXT=1 lässt sich bei 200K bleiben. /advisor akzeptiert Sonnet 5.5 als Berater für Opus 4.7 und 4.8, bei einem automatischen Modellwechsel bleibt die aktuelle Aufwandsstufe erhalten, und MCP-Server mit dem Protokoll 2025-11-25 können URL-Abfragen öffnen. Ein gefährlicher rm behält seine Bestätigungsabfrage auch dann, wenn der Befehl seine Ausgabe nach ~ oder an eine Wildcard umleitet, ausstehende Berechtigungsabfragen werden von der ältesten bis zur neuesten angezeigt, und neun Einträge verbessern den Screenreader-Modus. In VS Code kann ein laufender Befehl oder Sub-Agent in den Hintergrund verschoben werden (Run in background).
🔗 Versionshinweise zu Claude Code 2.1.287
GitHub Copilot: Steuerung von Desktop-Anwendungen und dynamische Workflows als öffentliche Preview
1. Oktober — GitHub stellt am selben Tag zwei Agentenfunktionen in Copilot CLI und der GitHub Copilot App als öffentliche Preview bereit: die Steuerung von Desktop-Anwendungen und dynamische Workflows, die auch im GitHub Copilot SDK angeboten werden.
Copilot steuert Desktop-Anwendungen. Die Computersteuerung (computer use) kommt auf macOS und Windows. Copilot liest den zugänglichen Inhalt eines Fensters und dessen visuellen Kontext über den Accessibility Tree des Systems oder bei Bedarf über Screenshots, klickt auf Bedienelemente, gibt Text ein, drückt Tasten, scrollt, führt Drag-and-drop aus und verknüpft Schritte über mehrere Anwendungen hinweg; die Demonstration zeigt, wie es in Safari eine Spesenabrechnung ausfüllt. GitHub zielt auf ältere oder rein grafische Software ohne API, Kommandozeilenschnittstelle oder MCP-Integration. Die Dokumentation empfiehlt diese Zugangswege, sofern sie vorhanden sind, weil sie vorhersehbarere Ergebnisse liefern. Die Funktion ist standardmäßig deaktiviert: /computer on aktiviert sie in der CLI, /computer show zeigt ihren Status an und /computer off schaltet sie ab, während die App sie in ihren Einstellungen anbietet. Copilot fragt vor der Steuerung jeder Anwendung nach Erlaubnis: Man kann sie für die Session erteilen, für spätere Sessions speichern oder verweigern. Eine dauerhafte Genehmigung (Always allow) gilt für die CLI und die App auf demselben Rechner, eine Verbotsregel hat jedoch immer Vorrang. Zweimaliges Drücken von Esc in der CLI oder die Stop-Schaltfläche in der App unterbricht eine aus dem Ruder laufende Aktion. Die verwalteten Einstellungen einer Organisation können die Funktion deaktivieren, ohne dass eine lokale Aktivierung dies umgehen kann. GitHub warnt, dass eine mehrdeutige Anweisung oder unerwarteter Bildschirminhalt unbeabsichtigte Aktionen in angemeldeten Konten, einschließlich Finanzkonten, auslösen kann, und rät bei sensiblen Anwendungen von einer dauerhaften Genehmigung ab. Weder die betroffenen Tarife noch Zahlen werden genannt; der Befehl /computer stand bereits am 16. September in den Versionshinweisen zu Copilot CLI 1.0.85.
🔗 GitHub Copilot kann jetzt mit Computersteuerung mit Desktop-Anwendungen interagieren
In Code geschriebene Orchestrierungen. Dynamische Workflows (dynamic workflows), die in allen Copilot-Tarifen verfügbar sind, beschreiben in einem Programm, wie eine Aufgabe ausgeführt werden soll: Der Code legt die Schritte fest, den Zeitpunkt, an dem ein Agent eingreift, und die Verwendung seiner Ergebnisse, sequenziell, parallel oder beides. Die Agenten bearbeiten das, was Analyse oder Urteilsvermögen erfordert. Ein Workflow kann Befehle ausführen, ein Ziel in parallele Aufgaben aufteilen, strukturierte Ergebnisse von einem Schritt zum nächsten weitergeben, die Feststellungen eines Sub-Agenten von einem anderen überprüfen lassen und an einem Kontrollpunkt (checkpoint) für eine Prüfung anhalten, bevor er fortgesetzt wird. GitHub nennt die Untersuchung eines Vorfalls, die parallele Prüfung der Dateien einer Pull Request oder Review-Kommentare, die zwei Modellen vorgelegt und nur dann gemeldet werden, wenn beide übereinstimmen.
| Copilot-Modus | Wer laut Dokumentation die Arbeit organisiert |
|---|---|
| Autopilot | Copilot, das voranschreitet, ohne nach jedem Schritt eine Bestätigung anzufordern |
/fleet | Copilot, das die Aufgabe jedes Mal auf parallele Sub-Agenten aufteilt |
| Dynamischer Workflow | Der vom Autor geschriebene Code: Schritte, Bedingungen und Übergaben |
Das Programm befindet sich in einer Erweiterung von Copilot CLI und der App. Ein von Copilot geschriebener Workflow bleibt auf die Session beschränkt, lässt sich aber durch Kopieren der Erweiterung in das persönliche Verzeichnis wiederverwenden, über das Verzeichnis eines Repositorys teilen oder als Plugin verpacken. Die Sub-Agenten übernehmen die Berechtigungen der Session, während der Befehl copilot workflow run keine Abfrage anzeigt: Die Berechtigungen müssen vor dem Start erteilt werden. In der App sind Workflows ohne weitere Einstellung verfügbar, in der CLI muss man dafür die experimentellen Funktionen aktivieren (--experimental oder /experimental on). GitHub veröffentlicht weder Zahlen noch Abrechnungsregeln, und der Name erinnert, ohne dass ein Zusammenhang angekündigt wurde, an die Dynamic Workflows, die Anthropic am 28. Mai in Claude Code eingeführt hat.
🔗 Dynamische Workflows in Copilot CLI und der Copilot App
FLUX 3 Image: Black Forest Labs komponiert mit Bounding Boxes und generiert bis zu 4K
1. Oktober — Black Forest Labs (BFL) ergänzt seine FLUX 3-Familie um ein Bildmodell, unter dem Motto: jeden Pixel kontrollieren. FLUX 3 Image bearbeitet einen Bereich in mehreren aufeinanderfolgenden Durchgängen, ohne den Rest des Bildes zu verändern, und akzeptiert mehrere Änderungen in einer einzigen Anfrage.
Die sichtbarste Neuerung ist die Komposition mit Begrenzungsrahmen (bounding boxes). Unabhängig vom Format wird das Bild zu einem Koordinatensystem mit Werten von 0 bis 1000 auf jeder Achse: Man zeichnet einen Rahmen pro Element, beschreibt seinen Inhalt und fasst dann die Szene in einer Zeile zusammen. Das Modell platziert jedes Element in seinem Rahmen; ein reiner Text-Prompt bleibt möglich. FLUX 3 Image kombiniert außerdem bis zu 10 Referenzbilder, die über Tokens im Prompt angegeben werden und deren Position und Größe es selbst bestimmt. BFL stellt es als „für Agenten konzipiert“ vor: Ein LLM kann anhand einer einfachen Anfrage die Tabelle der Elemente und ihrer Rahmen erstellen, die der Nutzer vor dem Start der Generierung anpasst.
| Angekündigte Eigenschaft | Von BFL mitgeteiltes Detail |
|---|---|
| Native Auflösung | 2K und 4K (Beispiel auf der Modellseite: 5456 × 3072 Pixel, 16,8 MP) |
| Referenzbilder | Bis zu 10 |
| Komposition | Bounding Boxes auf einem Raster von 0 bis 1000 pro Achse |
| Bearbeitung | Über mehrere Turns, ohne die anderen Pixel zu verändern |
| API-Angebot | 50 % Rabatt bis zum 8. Oktober |
| Modellgewichte | Kommerzielle Gewichte unter Lizenz; offene Gewichte „in den nächsten Wochen“ |
Was den Zugang betrifft, ist FLUX 3 Image über die API bis zum 8. Oktober mit 50 % Rabatt verfügbar. BFL bietet Unternehmen, die es auf ihrer eigenen Infrastruktur feinabstimmen und bereitstellen möchten, kommerzielle Gewichte unter Lizenz an. Die Version mit offenen Gewichten ist ohne Termin angekündigt. Zum Zeitpunkt der Ankündigung waren weder ein Grundpreis noch Benchmark-Zahlen veröffentlicht. Das Modell ergänzt eine Serie, die diesen Sommer gestartet ist: FLUX 3, ein einheitliches multimodales Modell (23. Juli), FLUX 3 Video (4. August), dessen Bearbeitungsmodus (10. September) und FLUX 3 Action für Robotik (23. September).
🔗 Ankündigung von FLUX 3 Image durch @bfl_ai · Modellseite von FLUX 3 Image
Assistenten für Privatnutzer: Guided Vision in Gemini Live, virtuelle Anprobe in ChatGPT, Diagramme in Perplexity Computer, gelockerte Limits für Claude-Artefakte
Guided Vision: Gemini Live unterstützt blinde und sehbehinderte Menschen
1. Oktober — Google führt Guided Vision in Gemini Live auf Android 9 und neueren Versionen ein, in den Regionen und Sprachen, in denen Gemini Live verfügbar ist. Die gemeinsam mit blinden und sehbehinderten Menschen entwickelte Funktion beschreibt in Echtzeit, was die freigegebene Kamera aufnimmt, beantwortet Rückfragen und gibt mündliche Anweisungen zur Anpassung des Bildausschnitts: langsam nach rechts drehen, nach unten neigen, zurückgehen. Google nennt als Beispiele das Lesen einer Nährwertkennzeichnung oder einer Speisekarte in einem dunklen Restaurant, die Suche nach einem heruntergefallenen Ohrhörer oder die Beschreibung der Farben eines Kleidungsstücks. Für das Training hat Google mit Aira zusammengearbeitet, einem Dienst für visuelle Assistenz: Zehntausende Stunden an Daten, mehr als 1 000 Tester aus dessen Netzwerk und Fachleute, die an den Schutzmechanismen mitgewirkt haben. Guided Vision lässt sich im Profil der Gemini-App, über eine Android-Verknüpfung für Bedienungshilfen oder über TalkBack aktivieren. Google stellt klar, dass die Funktion weder ein Medizinprodukt noch eine Mobilitätshilfe ist: Sie ersetzt den weißen Langstock nicht.
🔗 Guided Vision in Gemini Live (Google-Blog)
ChatGPT: virtuelle Anprobe und Favoriten für Einkäufe
1. Oktober — Laut den Versionshinweisen von ChatGPT erscheint auf den Produktseiten von Kleidung und Accessoires eine Schaltfläche zur Anprobe (Try on): Man nimmt ein Selfie auf oder lädt eines hoch, und ChatGPT Images erzeugt eine virtuelle Anprobe des Artikels. Das Referenzfoto wird für weitere Anproben gespeichert; es lässt sich in den Einstellungen im Bereich für Referenzfotos ersetzen oder löschen (Settings → Personalization → Reference photos). Jedes Produkt lässt sich außerdem als Favorit speichern oder in einem Ordner der ChatGPT-Bibliothek ablegen. Beide Funktionen sind auf Mobilgeräten und im Web verfügbar, allerdings nennt der Hinweis weder die betreffenden Tarife noch die Länder. ChatGPT bot bereits seit dem 24. März visuelles Shopping an.
🔗 Versionshinweise von ChatGPT
Perplexity Computer erstellt interaktive Diagramme
1. Oktober — Perplexity Computer erstellt jetzt Diagramme und interaktive Visualisierungen direkt im Gesprächsverlauf. Bei Finanzdaten nutzt der Agent Lightweight Charts von TradingView, um Candlesticks, Volumen und gleitende Durchschnitte darzustellen. Die Ankündigung besteht aus einem Tweet mit einem Video: Sie nennt weder die unterstützten Tarife noch die Plattformen, und auch im Changelog gibt es bisher keinen Eintrag mit weiteren Einzelheiten. ChatGPT und Claude hatten diesen Schritt bereits am 10. und 12. März vollzogen, Replit Agent am 25. September.
🔗 Ankündigung von @perplexity_ai auf X
Claude halbiert nach einem Artefakt den Verbrauch des Nutzungslimits, bis zum 15. Oktober
1. Oktober — Vom 1. Oktober um 11 Uhr PT bis zum 15. Oktober um 23:59 Uhr PT verbraucht die Arbeit nach dem Erstellen oder Bearbeiten eines Artefakts (Dokument, Präsentation oder Design) in Claude oder Claude Cowork 50 % weniger vom Nutzungslimit der fünfstündigen Sitzung. Das Angebot gilt automatisch für die Tarife Pro, Max und Team; Free und die Enterprise-Tarife sind ausgeschlossen, und das wöchentliche Limit bleibt unverändert.
| Betroffener Bereich | Umfang der Ermäßigung von 50 % |
|---|---|
| Über das Menü Output gestartetes Gespräch | Ab der ersten Nachricht: 10 Nachrichten, 15 Schritte pro Antwort |
| Gewöhnliches Gespräch | Die 10 Nachrichten nach dem Erstellen des Artefakts, 15 Schritte pro Antwort |
| Über Output gestartete Cowork-Aufgabe in der Cloud | Ungefähr die ersten 45 Minuten |
| Andere Cowork-Aufgabe in der Cloud | Bis zu 80 Schritte nach dem Erstellen oder Bearbeiten eines Artefakts |
Claude Code, die API, Claude in Slack, lokale oder geplante Cowork-Aufgaben, Nutzungsguthaben und die eigenständige App Claude Design sind ausgeschlossen. Anthropic empfiehlt, das Angebot mit Sonnet 5.5 auszuprobieren, und behält sich das Recht vor, es vorzeitig zu ändern oder zu beenden.
🔗 Ankündigung von @claudeai auf X · Angebotsbedingungen (Claude-Hilfecenter)
Finanzen: Barclays weitet Claude auf die gesamte Bank aus, American Express macht Perplexity Computer für seine Business-Kunden zugänglich
Barclays strebt an, dass bis Ende 2026 die Hälfte seiner Entwickler Claude Code nutzt
1. Oktober — Barclays, die britische Universalbank, erweitert ihre Zusammenarbeit mit Anthropic und führt Claude im gesamten Unternehmen ein, um die Softwareentwicklung zu beschleunigen, Altsysteme zu modernisieren und die betriebliche Effizienz zu steigern. Die Bank plant, dass bis Ende 2026 50 % ihrer Entwickler Claude Code nutzen und 2027 die Mehrheit ihrer Softwareingenieure. Für zwei Einsatzbereiche liegen bereits Zahlen vor. Der seit 2025 eingesetzte Colleague Knowledge Assistant, der auf Claude mit einer Architektur für Retrieval-Augmented Generation (RAG) basiert, wurde von mehr als 16 000 Mitarbeitern angenommen und hat mehr als eine Million Suchanfragen verarbeitet; er unterstützt die Teams, die mehr als 20 Millionen Privatkunden im Vereinigten Königreich betreuen. Im Geschäftsbereich Global Markets klassifizieren, ergänzen und leiten die Claude-Modelle täglich etwa 120 000 E-Mails weiter. Paul Smith, Vertriebsleiter von Anthropic, sieht darin einen wichtigen Meilenstein für das Unternehmen im Vereinigten Königreich; Vertragswert und Laufzeit werden nicht genannt.
🔗 Barclays weitet Claude aus, um Abläufe zu verbessern und das Kundenerlebnis zu optimieren
Perplexity und American Express: zehn Skills für Geschäftsaufgaben in Computer für Business-Karten
1. Oktober — Perplexity veröffentlicht eine Sammlung sofort einsetzbarer Skills für Perplexity Computer, die US-Inhabern einer American Express Business-Karte mit einem Perplexity Enterprise-Abonnement vorbehalten ist. Die Unternehmensleitung wählt eine Aufgabe aus und konkretisiert sie in einem Formular, anstatt eine Anfrage zu schreiben. Die zehn Skills decken Liquiditätsprognosen, Steuervorbereitung, Lieferantenvergleiche, Budgetszenarien, Kontenabstimmung, Marketingkampagnen, Nachfrageprognosen, den Ertrag der Werbeausgaben pro Kanal (ROAS), die Überwachung von Betriebsabläufen und die Personalgewinnung ab. Die Karte wird über Plaid in Personal CFO verknüpft, und jede Ausführung verbraucht je nach Komplexität der Aufgabe Computer-Credits. Die Partnerseite bietet zusätzlich bis zum 29. März 2027 eine einmalige Gutschrift von 125 Dollar beim Kauf eines Tarifs Enterprise Pro oder Enterprise Max für mindestens 325 Dollar sowie einmalig 1 000 kostenlose Computer-Credits pro Konto. Corporate-Karten sind ausgeschlossen, und die Ergebnisse stellen keine Finanz-, Steuer-, Rechts- oder Buchhaltungsberatung dar.
🔗 Beitrag von Perplexity · Partnerseite von American Express
Generative Videos und Avatare: Wan 3.0 an der Spitze von Artificial Analysis, Project Continuum von Runway, Sessions von Synthesia
Wan 3.0 übernimmt die Spitze der neuen Video-Rangliste von Artificial Analysis
1. Oktober — Alibaba beansprucht für Wan 3.0 den ersten Platz in der neuen Text-zu-Video-Rangliste von Artificial Analysis, AA-Video-T2V v2.0, die am 30. September mit einer neuen Methodik gestartet ist: Jedes Modell wird in 1080p anhand eines regelmäßig erneuerten Satzes von Prompts bewertet, und die Tonsynchronisation fließt in die Bewertung ein. Die ersten Plätze liegen dicht beieinander, da sich die Konfidenzintervalle überschneiden.
| Bewertetes Modell | Elo-Wert | Rangintervall | Preis über die API |
|---|---|---|---|
| Wan 3.0 | 1157 (±9) | 1 bis 2 | 12,00 Dollar pro Minute |
| Utopai X (auf Basis von MiniMax H3) | 1150 (±10) | 1 bis 3 | Keine öffentliche API |
| Dreamina Seedance 2.5 | 1144 (±9) | 2 bis 4 | 34,12 Dollar pro Minute |
| MiniMax H3 (768p) | 1139 (±9) | 3 bis 5 | 4,80 Dollar pro Minute |
Die Überraschung der Rangliste ist Utopai X, das am 30. September von Utopai Studios veröffentlicht wurde, einem Film- und Fernsehstudio, das von Grund auf mit IA arbeitet. Das auf Basis von MiniMax H3 nachtrainierte Modell ist ausschließlich auf der PAI-Plattform des Studios verfügbar (93 Credits pro Sekunde Video, Abonnements ab 15 Dollar pro Monat) und liegt vor MiniMax H3 selbst.
🔗 Ankündigung von @Alibaba_Wan auf X · Rangliste AA-Video-T2V v2.0 · Utopai X laut @ArtificialAnlys
Runway Labs stellt Project Continuum vor: Benutzeroberflächen, die als Video in Echtzeit generiert werden
1. Oktober — Runway Labs, die Forschungsabteilung von Runway für neue Ansätze, zeigt Project Continuum, eine Forschungsanwendung, die ein Betriebssystem entwirft, dessen Benutzeroberfläche als Video in Echtzeit generiert würde. Sie knüpft an Solaris an, das am 31. August vorgestellte Weltmodell für Benutzeroberflächen. Dieser erste Einblick beschreibt vier Möglichkeiten, mit dem Computer zu interagieren. Bei Portals erzeugt ein Videomodell während der Navigation animierte, interaktive Overlays mit unscharfen Rändern, die auf die generierten Inhalte hinweisen. Die reaktiven Videooberflächen (Responsive Video Interfaces) ordnen sich bei Größenänderungen neu an und reagieren auf Klicks. Interactive Worlds verwandelt ein Medium in eine interaktive Simulation, sowohl für Menschen als auch für Agenten. Visual Thinking schließlich ist ein Harness für Coding-Agenten: Ein Echtzeit-Videomodell visualisiert jeden Schritt und jeden Tool-Aufruf, damit der Nutzer in den Prozess eingebunden bleibt. Runway nennt weder Zugangsmöglichkeiten noch Datum, Preis oder zugrunde liegendes Modell.
Synthesia veröffentlicht Sessions: Avatare, die trainieren und befragen
1. Oktober — Synthesia veröffentlicht Sessions, eine Produktfamilie auf Basis seiner interaktiven Avatare: ein Videoanruf, bei dem das Gegenüber ein Avatar ist, der Fragen stellt, zuhört, widerspricht und zusammenfasst. Roleplay Sessions dient dem Training: Der Avatar spielt einen Kunden, einen potenziellen Kunden oder einen Mitarbeiter, ein IA-Coach kommentiert jeden Versuch, und Führungskräfte verfolgen Bewertungen und Fortschritte in einem Dashboard. Survey Sessions verwandelt den Fragebogen in ein Gespräch: Der Avatar befragt Hunderte Menschen parallel, stellt je nach Antwort Nachfragen und liefert anschließend einen Bericht über Themen und Stimmungen; jede Antwort bleibt als Transkript, Audio oder CSV abrufbar. Eine kostenlose Testversion wird angeboten, ohne detaillierte Preisangaben. Sessions basiert auf der Interactive Avatar API, die seit dem 16. September allgemein verfügbar ist, und Synthesia kündigt weitere Varianten an.
🔗 Ankündigung von @synthesiaIO auf X · Seite zu Synthesia Sessions
IA und Wissenschaft: SynthID Bio versieht Proteine mit Wasserzeichen, Matthew Schwartz beschreibt eine „auf Claude zugeschnittene“ Wissenschaft
SynthID Bio: Google DeepMind versieht von IA entworfene Proteine mit Wasserzeichen
30. September — Google DeepMind stellt SynthID Bio vor, eine Familie von Methoden zur digitalen Kennzeichnung (watermarking) biologischer Erzeugnisse, die mit IA generiert wurden; die Vorstellung wurde am 1. Oktober auf X geteilt. Der Beitrag beschreibt sie als Machbarkeitsnachweis: Eine nicht wahrnehmbare Signatur wird in den biologischen Code eingebettet und lässt sich sowohl am digitalen Modell als auch am synthetisierten Protein überprüfen. Bei Sequenzen beeinflusst die Methode unauffällig die Auswahl der Aminosäuren; bei 3D-Strukturen wird ein kleiner Teil des Diffusionsnetzwerks von AlphaFold 3 feinabgestimmt. Im Labor erreichten die mit Wasserzeichen versehenen Binder bei drei Zielmolekülen (VEGF-A, der RBD-Domäne des Spike-Proteins von SARS-CoV-2 und PD-L1) die gleichen Erfolgsraten, Affinitäten und Sequenzvielfalt wie die herkömmlichen Varianten. Im Mittelpunkt steht die Biosicherheit: Ein automatisches Signal könnte Anbieter von DNA-Synthese dabei unterstützen, die Herkunft einer unbekannten Sequenz zu überprüfen. Google DeepMind veröffentlicht den Methodenartikel, den Code, die In-vitro-Daten und die Gewichte für die Forschung; gemeinsam mit dem Hie lab in Stanford und dem Arc Institute wird der Ansatz bereits auf das Genom eines mit Evo 2 entworfenen Bakteriophagen ausgeweitet. Die Robustheit gegenüber gezielten Veränderungen bleibt die wichtigste offene Aufgabe.
🔗 Beitrag von Google DeepMind zu SynthID Bio
Die „auf Claude zugeschnittene“ Wissenschaft: der Gastbeitrag von Matthew Schwartz
1. Oktober — Der Blog Anthropic Science veröffentlicht einen Gastbeitrag von Matthew Schwartz, einem Physiker in Harvard, der angibt, als Gastforscher bei Anthropic zu arbeiten. Darin beschreibt er eine „Impedanzfehlanpassung“ zwischen Wissenschaftlern und IA: Mit einem Modell wie mit einem menschlichen Mitarbeiter zusammenzuarbeiten, schöpft dessen Potenzial nicht aus. Besser sei es, nach „auf Claude zugeschnittenen“ Problemen zu suchen, bei denen eine bekannte Methode aus Mathematik, Physik oder Informatik auf einen Schlag eine Frage aus einem anderen Fachgebiet löst. Daraus entwickelte er BootLoops, einen Open-Source-Harness für exakte Berechnungen, der mit jedem Modell nutzbar ist; BootLoops ist kein Anthropic-Projekt, sondern wird von Schwartz gepflegt. In der Physik wurden 30 Integrale vollständig bearbeitet, darunter 15, die zuvor noch nie berechnet worden waren; in der Ökologie verändern sich die Bäume auf Barro Colorado Island 4,5-mal schneller, als es die neutrale Theorie zulässt; in der Linguistik erfasst die Datenbank AccStack den Wortakzent von 6 072 Sprachen. Die Bilanz: 36 Manuskripte in 18 Fachgebieten mit 19 Mitautoren in drei Monaten. Schwartz weist auch auf die Grenzen hin: Claude hat kein Zeitgefühl, „erklärt“ gerne „den Sieg“, und seine Ergebnisse außerhalb der Physik waren wenig interessant, bevor ein Experte sie neu ausrichtete.
🔗 Auf Claude zugeschnittene Wissenschaft (Blog Anthropic Science)
Offene Modelle und Training: Olmo-core 3 von Ai2, Clef und Clef-flash von Cloudflare, RL mit mehreren Harnesses von FineEnvs
Olmo-core 3: Ai2 veröffentlicht einen offenen MoE-Trainingsstack für mehr als eine Billion Parameter
1. Oktober — Ai2 veröffentlicht Olmo-core 3, eine neue Version des Frameworks, mit dem seine Olmo-Modelle trainiert werden. Es wurde um ein vollständig offenes Trainingssystem mit einer Mischung aus Experten (mixture-of-experts, MoE) herum neu aufgebaut. Es ist eines der Systeme für die nächste Olmo-Generation, die auf MoE umstellen und laut Ai2 die leistungsfähigste Olmo-Generation werden soll. Die alte, auf FSDP basierende Implementierung sammelte die Gewichte bei jedem Batch ein und teilte sie anschließend erneut auf; Olmo-core 3 wechselt zu DDP, belässt die Experten auf ihren GPU und sendet ihnen die Daten.
| Von Ai2 veröffentlichte Messung | Gemessener Wert |
|---|---|
| MoE mit 47 Milliarden Parametern auf acht B300, vorläufiger Test | 52 000 gegenüber 19 400 tokens/s pro GPU, etwa das 2,7-Fache |
| MXFP8 gegenüber BF16, auf vier B300 | Etwa 21 % mehr Durchsatz |
| Modell mit 1 200 Milliarden Parametern auf 512 GPU | Maximal 858 TFLOP/s pro GPU, zufälliges Routing |
Ai2 stellt klar, dass die Messung mit 1 200 Milliarden Parametern das System bewertet, nicht die Qualität eines trainierten Modells. Code (Version 3.0.0), technischer Bericht und interaktive Demonstration sind veröffentlicht.
🔗 Beitrag von Ai2 zu Olmo-core 3 · Release von Olmo-core v3.0.0
Clef und Clef-flash: Cloudflare veröffentlicht zwei mit Jev kompatible Entscheidungsmodelle
1. Oktober — Das Workers-AI-Team von Cloudflare veröffentlicht Clef und Clef-flash, seine ersten intern trainierten Modelle, auf dem von Jev, dem System-One-Modell von Typesafe AI, erschlossenen Gebiet: Sie erhalten einen Zustand (Text, JSON, Bild oder Video) und ein Schema typisierter Fragen und geben dann in einem einzigen Durchlauf eine Wahrscheinlichkeit für jede zulässige Option zurück. Clef wurde auf Basis von Qwen3.8-27B nachtrainiert, Clef-flash basiert auf Qwen3.5-9B. Sie werden auf Workers AI mit einer zur API von Jev kompatiblen API gehostet und laut dem Blogbeitrag auf Hugging Face unter der Apache-2.0-Lizenz veröffentlicht, mit einem Kontextfenster von 64k Tokens gegenüber 32k bei Jev. Die von Cloudflare ausgewählten Zahlen ergeben ein gemischtes Bild:
| Benchmark und Metrik | Clef-Score | Clef-flash-Score | Jev-Score |
|---|---|---|---|
| BFCL, exakte Fälle | 98,47 | 98,76 | 95,75 |
| BANKING77, macro-F1 | 94,20 | 90,93 | 79,74 |
| When2Call, Genauigkeit | 72,37 | 65,58 | 80,97 |
| BRIGHT, nDCG@10 | 45,91 | 39,26 | 47,52 |
| Mediane Latenz | 209,3 ms | 38,8 ms | 524,1 ms |
Cloudflare erklärt, dass Clef den Jev Decision Index anführt, einen Platz, den Liquid AI zwei Tage zuvor für d1 beansprucht hatte, und startet einen Dienst für das Fine-Tuning von Clef per Reinforcement Learning mit Kundendaten.
🔗 Cloudflares Blogbeitrag zu Clef · Clef auf Hugging Face
FineEnvs trainiert ein Modell per Reinforcement Learning gleichzeitig in vier Agenten-Harnesses
1. Oktober — Ein und dasselbe Modell verhält sich je nach Harness, der es steuert, unterschiedlich: Die Gewichte von LFM2.5-2.6B von Liquid AI lösen unter Mini-SWE-Agent 62 % der Aufgaben, unter Claude Code jedoch nur 33 %. Die Organisation FineEnvs veröffentlicht auf Hugging Face einen Leitfaden zum Trainieren eines Modells per Reinforcement Learning direkt in den Harnesses der Entwickler, ohne deren Code zu verändern. Ein zu OpenEnv hinzugefügter Capture-Proxy tritt gegenüber dem Harness als Modellanbieter auf (Formate von OpenAI, Anthropic oder Gemini) und zeichnet die exakten von vLLM erzeugten Tokens und Wahrscheinlichkeiten auf; Harbor stellt Aufgaben und Sandboxes bereit, TRL trainiert mit asynchronem GRPO. Gleichzeitig in vier Harnesses trainiert, steigt LFM2.5-2.6B im Durchschnitt von 42 % auf 54 %, und eine kleine Belohnung für sparsame Lösungen reduziert seine Tool-Aufrufe bei bereits gelösten Aufgaben um 31 %. Ein größeres Modell nachzuahmen reicht nicht aus: Ein überwachtes Fine-Tuning mit 3 189 rollouts von Qwen3.8-27B erreicht höchstens 47,5 %. Proxy, Trainer, Aufgaben, Daten und trainierte Modelle sind veröffentlicht.
🔗 Der ultimative Leitfaden für multi-harness RL
Grok 4.7 als Vorabversion auf der Agentenplattform von Google Cloud
1. Oktober — SpaceXAI kündigt an, dass Grok 4.7 auf Gemini Enterprise Agent Platform, der Agentenplattform von Google Cloud, verfügbar ist. Das auf den 30. September datierte Modelldatenblatt führt es als Vorabversion unter der Kennung grok-4.7 und beschreibt es als ein Modell von xAI für Programmier- und Wissensarbeit, das länger an schwierigen Aufgaben arbeitet und seine eigene Arbeit überprüft. Es akzeptiert Text und Bilder als Eingabe und gibt ausschließlich Text zurück; Funktionsaufrufe, strukturierte Ausgabe und Reasoning werden unterstützt, Batch-Vorhersagen hingegen nicht.
| Von Google Cloud veröffentlichte Angabe | Wert für Grok 4.7 |
|---|---|
| Kontextlänge | 524 288 tokens |
| Kontingente pro Minute | 13 Anfragen, 188 000 tokens für Eingabe und 16 000 tokens für Ausgabe |
| Nutzungsarten | Nur festes Kontingent, weder nutzungsabhängige Bezahlung noch provisionierter Durchsatz |
| Serviceregionen | US-Multiregion und globaler Endpoint |
| Preis pro Million tokens | 2 dollars für Eingabe, 6 für Ausgabe, 0,50 für Cache bei weniger als 200 000 tokens in der Eingabe, darüber das Doppelte |
Die Preistabelle entspricht derjenigen der xAI-API. Grok 4.7 wurde am 21. September veröffentlicht und kam am 28. September zu Amazon Bedrock; Grok 4.6 war bereits am 21. August auf derselben Google-Plattform verfügbar geworden.
🔗 Datenblatt zu Grok 4.7 auf Google Cloud · Ankündigung von @SpaceXAI auf X
GitHub verschärft private Schwachstellenmeldungen angesichts KI-generierter Berichte
1. Oktober — GitHub veröffentlicht in derselben Minute zwei Maßnahmen für private Schwachstellenmeldungen (private vulnerability reporting), die auf einer gemeinsamen Feststellung beruhen: Open-Source-Maintainer erhalten immer mehr minderwertige, automatisierte oder KI-generierte Berichte, in denen die relevanten Meldungen untergehen.
A single free-text box made it easy to submit low-quality or AI-generated reports and hard for you to find the signal in them.
🇩🇪 Ein einfaches Freitextfeld erleichterte das Einreichen minderwertiger oder KI-generierter Berichte und erschwerte es Ihnen, darin das Wesentliche zu erkennen. — GitHub Changelog, Strukturierte Formulare für private Schwachstellenmeldungen
Ein strukturiertes Formular. Standardmäßig muss der Melder vier Pflichtfelder ausfüllen: eine Zusammenfassung, Details, einen Proof of Concept mit mindestens 150 Zeichen und die Auswirkungen. Diese werden in der Beschreibung des Sicherheitshinweises zusammengeführt, den der Maintainer wie bisher prüft. Das Formular lässt sich für jedes Repository mit einer Datei .github/VULNERABILITY_REPORT.yml anpassen oder über das Repository .github der Organisation auf alle ihre Repositories anwenden; Maintainer können eine CWE-Kategorie verlangen, was eine Organisation oder ein Unternehmen per Richtlinie vorschreiben kann. Über ein Kontrollkästchen kann der Melder angeben, dass er beim Finden der Schwachstelle oder beim Verfassen seines Berichts KI-Unterstützung genutzt hat. Bei der REST-API gilt ebenfalls ein benutzerdefiniertes Formular, das Standardformular jedoch nicht, damit bestehende Integrationen weiterhin funktionieren.
Ein Tageslimit. Die Anzahl neuer Berichte, die dasselbe Konto täglich einreichen kann, ist nun begrenzt, sowohl für ein einzelnes Repository als auch für ganz GitHub; Kommentare zu bestehenden Sicherheitshinweisen sind davon ausgenommen. Administratoren können ein eigenes Limit festlegen und vertrauenswürdige Melder davon ausnehmen, und GitHub nennt keinen Wert für das Standardlimit. Beide Maßnahmen betreffen öffentliche Repositories mit aktivierten privaten Schwachstellenmeldungen auf GitHub Free, Pro, Team und Enterprise Cloud.
🔗 Rate Limits für private Schwachstellenmeldungen
Coding-Agenten: Codex CLI 0.160.0, Delta 0.18 und Antigravity 2.19.1
Codex CLI 0.160.0: Verlauf der Kommandozentrale und Sitzungen außerhalb von Projekten
1. Oktober — OpenAI veröffentlicht Codex CLI 0.160.0, die erste stabile Version seit der am Vortag erschienenen 0.159.3, mit 55 aufgelisteten PR seit 0.159.0. Die Agenten-Kommandozentrale (agent command center) erhält eine per Tastatur bedienbare Aktion zum Anzeigen älterer Aufgaben (Mehr anzeigen). Sitzungen können außerhalb eines Projekts mit den Standardeinstellungen des Workspace starten, wenn die Richtlinie der Organisation dies erlaubt, und gespeicherte Berechtigungen werden beim Fortsetzen wiederhergestellt. Die Genehmigungsprüfung Guardian erhält zwei optionale Fähigkeiten: zuvor erteilte Nutzeranweisungen wiederzufinden und den Kontext von Übergaben zwischen Agenten einzubeziehen. Im Vollbildmodus ermöglichen lokale Linux-X11-Terminals das Auswählen des Transkripts und das Einfügen per Mittelklick. Bei den Fehlerkorrekturen wird die Verarbeitung von Nachrichten in der Warteschlange nach einer erneuten Verbindung fortgesetzt, ohne sie doppelt zu versenden, und eine Reihe von Korrekturen betrifft die Windows-Sandbox und SQLite-Blockaden bei der Initialisierung.
🔗 Codex CLI 0.160.0 auf GitHub
Delta 0.18: Threads laufen in bestehenden Git-worktrees, und eine CLI kommt hinzu
30. September — Zed veröffentlicht Version 0.18.0 von Delta, seiner Mehrbenutzerumgebung zum Programmieren mit Agenten: 23 Neuerungen, 41 Verbesserungen, 51 Fehlerkorrekturen und eine Entfernung. Die wichtigste Neuerung war am 28. September ohne Termin angekündigt worden: Ein Thread kann jetzt in jedem bereits verknüpften bestehenden Git-worktree laufen und diese Arbeitskopie an neue Threads weitergeben, die von ihm aus erstellt werden. Delta lässt sich auch vom Terminal aus steuern: Eine CLI delta kann auf macOS, Windows und Linux installiert werden, und die Befehle delta auth verwalten das angemeldete Konto. Bei den Modellen fügt die Version die Gemini-Modelle von Google AI Studio hinzu, macht GPT-6 Sol, GPT-6 Luna und Claude Opus 5.5 mit einem API-Schlüssel zugänglich und akzeptiert in der Desktop-Anwendung jeden mit OpenAI oder Anthropic kompatiblen Anbieter. Die Arbeit in Threads erhält eine Suche über alle Unterthreads und Lesezeichen; Unterthreads veröffentlichen ihre Fortschrittsmeldungen allerdings nicht mehr im übergeordneten Thread, wo nur noch die Ergebnisse von Land Changes angezeigt werden.
🔗 Versionshinweise zu Delta 0.18.0
Antigravity 2.19.1: Direkt an Unteragenten schreiben
30. September — Antigravity 2.19.1 ermöglicht es, einem Unteragenten direkt aus dem Eingabefeld eine Nachricht zu senden, ohne den Hauptagenten einzubeziehen; die CLI bot dies mit ihrer @-Syntax bereits seit den Versionen 1.2.8 und 1.2.9 an. Die Version ergänzt den PDF-Export des in Artefakten und im Seitenpanel gerenderten Markdown, einschließlich Tabellen, Codeblöcken und Diagrammen, sowie eine auf die Unterhaltung beschränkte Option zum Rückgängigmachen; zu den fünf Fehlerkorrekturen gehört, dass benutzerdefinierte Agenten endlich die globalen Regeln und die Projektregeln beachten. Die Bereitstellung erfolgt schrittweise und kann einige Tage dauern. Die CLI hatte am 27. September die unbemerkt gebliebene Version 1.2.12 erhalten: Eine mit einem Schlüssel GEMINI_API_KEY gestartete Sitzung endet jetzt sofort, wenn die Gemini-API ein ausgeschöpftes Tageskontingent, ein erreichtes Ausgabenlimit oder aufgebrauchtes Prepaid-Guthaben meldet, statt mehrere Minuten lang weitere aussichtslose Versuche zu unternehmen.
🔗 Changelog der Antigravity-Anwendung · Changelog der Antigravity-CLI
Kurzmeldungen
- Copilot CLI 1.0.90 und 1.0.91 — Version 1.0.90 erscheint am 30. September als Stable-Version mit GPT-6.1 Sol in der Modellauswahl sowie Korrekturen für MCP und die Wiederaufnahme von Sessions; Version 1.0.91 fügt am 1. Oktober die Befehle
copilot sandbox cazur Verwaltung des Proxy-Zertifikats ihrer Sandbox hinzu. 🔗 Quelle - Codex CLI 0.159.3 — Die am 30. September um 22:57 Uhr UTC veröffentlichte Version enthält nur einen Backport: Lokale Sessions, die über ChatGPT angemeldet sind, können optionale Erinnerungen zum Abschluss der Einrichtung der Kontosicherheit anzeigen; diese Änderung wurde auch in 0.160.0 übernommen. 🔗 Quelle
- Nightly von Gemini CLI — Die v0.64.0-nightly vom 1. Oktober behebt einen Hänger bei 100 % Prozessorauslastung im Headless-Modus und macht die Schreibvorgänge der Datei-Tools atomar; Stable und Preview bleiben unverändert. 🔗 Quelle
- Zed 1.23.1 als Preview — Die am 30. September veröffentlichte Version zeigt JSONL- und NDJSON-Dateien als Tabelle an, fügt die Einstellung
agent.max_idle_retained_threadshinzu und wiederholt Anfragen automatisch, wenn ein Google-AI-Modell überlastet ist. 🔗 Quelle - Copilot in VS Code im September — Der Monatsrückblick auf die Versionen 1.136 bis 1.140 nennt einige bislang wenig beachtete Neuerungen, darunter das Fortsetzen einer in der ChatGPT-App begonnenen Codex-Unterhaltung in VS Code, ein App-Badge in der Preview und Chats ohne geöffneten Workspace. 🔗 Quelle
- Gemeinsam in Delta planen — Im Delta-Blog beschreibt Nathan Sobo, wie drei Teammitglieder in einem gemeinsamen Thread mit Fable und anschließend Astra sowie einem isolierten Subthread und Subagenten planen, statt in einer Datei
plan.md; eine neue Funktion wird nicht angekündigt. 🔗 Quelle - Innate von Cursor gefilmt — Cursor veröffentlicht ein kurzes Videoporträt von Innate, einem siebenköpfigen Team, das Alltagsroboter entwickelt und dessen Mitgründer Vignesh Anand behauptet, es leiste die Arbeit von 50 Personen, ohne zu erläutern, wie es Cursor nutzt. 🔗 Quelle
- Abrufen statt komprimieren — David Corvoysier, Entwickler von funes, ermittelt mit Claude Code, dass das Abrufen der früheren Session über sein Tool bei drei selbst ausgewählten Aufgaben die richtigen Antworten mit 8-, 4- und 3-mal weniger gewichteten Tokens findet als das Beibehalten des gesamten Kontexts. 🔗 Quelle
- Neues GitHub-Dashboard — Die Ansicht, die aktive Agenten-Sessions, Issues und Pull Requests mit höchstens 12 Einträgen pro Liste zusammenführt, wird für alle zur Standardansicht; der Nachrichtenstrom wandert in einen Feed-Tab, und die bisherige Darstellung bleibt zugänglich. 🔗 Quelle
- Asynchrone Merge-API — Sie wird allgemein verfügbar und zum empfohlenen Weg für programmatische Merges anstelle des synchronen REST-Endpunkts und der GraphQL-Mutationen; sie ist die einzige Merge-API, die gestapelte Pull Requests unterstützt. 🔗 Quelle
- npm-Dist-Tags ohne Token — Die Konfigurationen für Trusted Publishing von npm können eine optionale, standardmäßig deaktivierte Berechtigung erhalten, um Dist-Tags mit kurzlebigen OIDC-Zugangsdaten statt mit einem langlebigen Zugriffstoken zu verwalten. 🔗 Quelle
- Aufbewahrung bei GitHub Actions — Checks, Workflow-Ausführungen und Statusmeldungen, einschließlich derjenigen von Drittanbieter-Apps, richten sich nun nach der Aufbewahrungseinstellung für Artefakte und Logs und werden danach gelöscht, bei öffentlichen Repositorys spätestens nach 90 Tagen und ohne Wiederherstellungsmöglichkeit. 🔗 Quelle
- Code Scanning und ruhende Repositorys — Die geplanten wöchentlichen Analysen von Code Scanning und GitHub Code Quality starten nur noch nach einer durch einen Push oder Pull Request ausgelösten Analyse, damit ein ruhendes Repository nicht sechs weitere Monate als aktiv erscheint. 🔗 Quelle
- Codeabdeckung — Die Action
upload-code-coveragevon GitHub Code Quality lässt die CI beim Push auf einen Branch, für den noch kein Pull Request geöffnet ist, nicht mehr fehlschlagen. 🔗 Quelle - Erklärungen zur Barrierefreiheit — Eine Datei
ACCESSIBILITY.mdim Stammverzeichnis, in.github/oder indocs/wird auf der Startseite des Repositorys hervorgehoben, in allen Tarifen auf github.com, und wird auch in GitHub Enterprise Server 3.24 verfügbar sein. 🔗 Quelle - Actions Runner Controller 0.15.0 — Der Kubernetes-Controller für selbst gehostete Runner aktualisiert Ressourcen bei Patch-Updates in-place, macht die Abschaltfrist, die Limits des Kubernetes-Clients und die Parallelität der Controller konfigurierbar und verschlankt seine Anfragen. 🔗 Quelle
- Grok Bot ergreift die Initiative — Der Haupt-Bot des Nutzers erkennt nun Arbeit, die er ihm abnehmen kann, und bietet an, sie zu erledigen; der Rollout erstreckt sich über einige Stunden, und diese Vorschläge werden nicht auf die Nutzung angerechnet, ohne Angaben zu Tarifen oder Ländern. 🔗 Quelle
- Genspark und Azure Cosmos DB — Ein aus der Perspektive von Genspark verfasster Beitrag im Azure-Cosmos-DB-Blog erläutert, wie bestimmte Hintergrundprozesse globale sekundäre Indizes nutzen, um laufende Agenten-Sessions nicht mehr zu verlangsamen; Zahlen werden nicht genannt. 🔗 Quelle
- Erfahrungsbericht bei Genspark — Seulki Kang, mit fünfzehn Jahren Erfahrung im Marketing, berichtet, einen vollständigen Satz Unterrichtsmaterialien in 5 statt 30 Stunden vorzubereiten, indem sie ihre bisherigen Dokumente mit SecondBrain und anschließend mit AI Slides verknüpft; keine Produktneuheit. 🔗 Quelle
- Albertsons und OpenAI — Der Einzelhändler mit mehr als 2 200 Filialen erweitert seine Partnerschaft, von ChatGPT Enterprise für ausgewählte Teams bis zur API für seine Kundenerlebnisse und Werbeanalysen, und hebt sein am 5. August angekündigtes Safeway-Plugin in ChatGPT hervor. 🔗 Quelle
- Die ewige Ergänzung — OpenAI veröffentlicht den ersten Essay einer Reihe über die kommende Wirtschaft, verfasst von Hemanth Asirvatham und Elliott Mokski, die betonen, für sich selbst zu sprechen: Der größte Teil der maschinellen Intelligenz könnte der Ausführung statt Durchbrüchen dienen. 🔗 Quelle
- Perplexity und Berater — Ein Leitfaden vergleicht zehn IA-Tools für Berater, von AlphaSense bis Qwilr, mit im September überprüften Preisen; seine FAQ erinnert daran, dass Perplexity im kostenlosen Tarif seine Modelle mit Nutzerdaten trainiert, sofern Nutzer nicht widersprechen. 🔗 Quelle
- Luma Variants — Die am Vortag ohne Details vorgestellte Funktion wird für alle Luma-Nutzer eingeführt: Aus einer freigegebenen statischen Anzeige erzeugt sie Varianten in fünf Standardformaten, von 9:16 bis 16:9, und in mehreren Sprachen, ohne angekündigten Preis. 🔗 Quelle
- HeyGen Professional Voice Clone — Laut seinem September-Rückblick stellt HeyGen seinen originalgetreuesten Stimmklon über die API bereit, trainiert mit mindestens 20 Minuten Aufnahmen (1 bis 10 Dateien), nach einer am 9. September gestarteten privaten Preview. 🔗 Quelle
- Pika und seine Apps — Pika gibt an, mehr als 40 Apps auf seiner neuen Plattform anzubieten, und stellt zwei davon vor: Podcast Video, das zwei Figuren diskutieren lässt, und Color Grade, das ein Bild oder einen Clip farblich korrigiert, ohne Datum oder Preis. 🔗 Quelle
- ElevenLabs im Benelux — ElevenLabs eröffnet Büros in Brüssel und Amsterdam und plant, seine Teams dort zu verdreifachen; beim Betreiber KPN steigt die Erkennung von Postleitzahlen von 64 % auf 82 %, und der Verifizierungsagent bearbeitet rund 60 000 Anrufe pro Woche. 🔗 Niederlande · 🔗 Belgien
- DOCA-Skills von NVIDIA — Bei 65 echten Entwickler-Prompts erfüllen Coding-Agenten mit diesen Skills für die BlueField-DPUs 100 % der Kriterien des Bewertungsrasters, gegenüber 19 % ohne; die Skills sind auf GitHub veröffentlicht. 🔗 Quelle
- DIN Deploy — NVIDIA veröffentlicht Open-Source-Beispiele in C++, um Modelle lokal mit ONNX Runtime und TensorRT RTX unter Windows und Linux auszuführen; auf einem DGX Spark transkribiert Parakeet TDT auf der GPU 206-mal schneller als in Echtzeit, gegenüber 14-mal auf der CPU. 🔗 Quelle
- Nemotron 3.5 ASR und saudische Dialekte — Ein Tutorial von NVIDIA führt ein Fine-Tuning des Modells für die Dialekte Najdi und Hijazi durch: Die Wortfehlerrate sinkt in 12 000 Schritten auf zwei RTX PRO 6000 von 55,05 % auf 29,96 %, wobei sich die Ergebnisse für Englisch und Arabisch auf FLEURS sogar leicht verbessern. 🔗 Quelle
- HSTU-Recommender auf Dynamo-Triton — NVIDIA stellt einen generativen HSTU-Recommender mit PyTorch AOTInductor und einem KV-Cache bereit: Im besten Fall läuft er auf einer RTX PRO 6000 je nach Anzahl der Schichten bis zu 4,47- und 5,93-mal schneller, was 0,423 und 0,678 ms pro Anfrage entspricht. 🔗 Quelle
- Rentabilität von IA-Fabriken — In einem Positionsbeitrag beziffert NVIDIA die Kosten einer IA-Fabrik auf etwa 60 Millionen Dollar pro Megawatt und greift Daten von SemiAnalysis auf: Vera Rubin NVL72 ist bei DeepSeek V4 Pro pro Million Tokens bis zu 45-mal günstiger als GB300 NVL72, gegenüber 35-mal am 24. August. 🔗 Quelle
- huggingface_hub 2.1.0 — Die Bibliothek startet fehlgeschlagene Jobs automatisch neu, plant sie neu, ohne sie neu anzulegen, liest das verbleibende ZeroGPU-Kontingent aus und lädt Xet-Dateien über
hf_xetherunter: Bei einer Parquet-Datei mit 2 GB sinkt die Zeit auf HF Jobs von etwa 120 auf 7 Sekunden; drei Breaking Changes. 🔗 Quelle - ML Intern und MCP — Hugging Face bindet MCP-Datenquellen an ML Intern an, den Modus von HuggingChat, der Modelle trainiert, um offene Modelle per Fine-Tuning an eigene Geschäftsdaten anzupassen; die Ankündigung enthält keine offiziellen Zahlen. 🔗 Quelle
- Hugging Face und der Open Source for Science Fund — Die beiden Partner wollen die Bibliotheken identifizieren, von denen die Mitwirkenden an wissenschaftlichen Modellen am stärksten abhängen, und ihre Maintainer unterstützen, ohne Angaben zu Beträgen oder Zeitplan. 🔗 Quelle
- Eine Million Trainingsläufe mit TRL — Laut der von Quentin Gallouédec zitierten Telemetrie verzeichnet die Post-Training-Bibliothek von Hugging Face eine Million Trainingsläufe pro Monat, mit dem Ziel einer Million pro Woche; die Zählweise ist nicht veröffentlicht. 🔗 Quelle
- Die Million Datensätze im Hub — Drei Autoren zeigen, dass Organisationskonten etwa 19 % der Datensätze veröffentlichen, aber die Hälfte der Downloads auf sich vereinen, und dass 390 der 1 000 meistgeladenen Datensätze auf die Vereinigten Staaten entfallen. 🔗 Quelle
- Acht VLM auf einer RTX 3090 — Aakash Gupta von ThinkEvolve zeigt, dass Qwen3-VL-8B bei gleicher Genauigkeit jede Anfrage 2,2-mal schneller verarbeitet als Qwen3.8-27B, für einen Auftrag mit 7 329 Aufrufen aber 18,88 statt 7,53 Stunden benötigt, weil es den Prefix-Cache nicht wiederverwendet. 🔗 Quelle
- GLiNER2.5-Decide im Vergleich zu layax — Aravind Vijayakumar gelingt es nicht, für das Modell von Fastino einen einzigen Konfidenzschwellenwert zu zertifizieren, gegenüber 10 erfolgreichen Versuchen von 10 für layax, sein eigenes Tool, das um 20 bis 23 Punkte genauer und etwa fünfmal schneller ist. 🔗 Quelle
- David Ha und die Orchestratoren — In einem Gastbeitrag für Nikkei Asia erklärt der Mitgründer und CEO von Sakana AI, dass sich der Wert von den Gewichten eines Modells zur Intelligenz verschieben werde, die mehrere Modelle kombiniert, und definiert Souveränität als Robustheit der Lieferkette. 🔗 Quelle
- Videodiffusion auf TPU — Drei Ingenieure von Google verkürzen das Denoising eines 1440p-Videos auf acht Chips vom Typ TPU v6e von 2 471 auf 1 461 Sekunden, also um den Faktor 1,69, dank der Sparse Attention von Sparse VideoGen und eines optimierten Kernels für Splash Attention. 🔗 Quelle
Was das bedeutet
Coding-Agenten lassen sich zunehmend von ihren Nutzern programmieren. Mit Mods legt Claude Code seine internen Ereignisse für kleine TypeScript-Funktionen offen und wandelt dabei sogar seine eigenen Funktionen in austauschbare Mods um; mit dynamischen Workflows lässt GitHub die Orchestrierung der Subagenten in Code schreiben, statt Copilot die Aufteilung jedes Mal neu entscheiden zu lassen. Der Leitfaden von FineEnvs erinnert daran, warum der Harness ebenso wichtig ist wie das Modell: Dieselben Gewichte lösen 62 % der Aufgaben in einem Harness und 33 % in einem anderen. Die Kehrseite ist die Frage des Vertrauens. Ein Mod hat denselben Zugriff auf den Rechner wie Claude Code, copilot workflow run zeigt keine Rückfrage an, und die Steuerung von Desktop-Apps kann auf angemeldete Konten zugreifen. Die beiden Anbieter reagieren darauf mit einer standardmäßig deaktivierten Desktop-Steuerung, einer Prüfung vor der Installation (claude plugin validate) für Mods und Unternehmensregeln, die Vorrang haben.
IA macht auch für diejenigen, die ihre Ergebnisse erhalten, neue Filter erforderlich. GitHub strukturiert und begrenzt private Schwachstellenmeldungen, weil IA-generierte Berichte die Maintainer überfluten; Google DeepMind schlägt vor, von IA entworfene Proteine mit Wasserzeichen zu versehen, damit Anbieter von ADN-Synthese erkennen können, woher eine unbekannte Sequenz stammt. In beiden Fällen besteht das Ziel darin, die Nutzung von IA sichtbar zu machen, statt sie zu verbieten: auf der einen Seite ein Kontrollkästchen zur Angabe von IA-Unterstützung, auf der anderen eine überprüfbare Signatur.
Bei Unternehmen misst sich die Einführung inzwischen an konkreten Anwendungen. Barclays setzt sich das Ziel, dass Ende 2026 50 % der Entwickler Claude Code nutzen, und lässt 120 000 E-Mails pro Tag sortieren, American Express macht seine Business-Karte zum Zugang zu den Skills von Perplexity Computer und unterstützt dies mit kostenlosen Credits, und Anthropic nutzt seine Nutzungslimits als Hebel, indem es zwei Wochen lang den Verbrauch für die Arbeit im Anschluss an die Erstellung eines Artefakts halbiert. Für die breite Öffentlichkeit werden Assistenten Teil konkreter Handlungen: einem blinden Menschen eine Speisekarte vorlesen, ein Kleidungsstück vor dem Kauf anprobieren, im Gespräch einen Börsenchart zeichnen.
Die Zahlen zu den Modellen sind schließlich im Zusammenhang mit ihrem Messverfahren zu lesen. Ai2 stellt klar, dass seine Messung bei 1 200 Milliarden Parametern das System und kein trainiertes Modell bewertet, Cloudflare wählt seine Benchmarks aus und räumt ein, dass Jev bei When2Call und BRIGHT weiterhin vorne liegt, und das Videoranking von Artificial Analysis setzt Wan 3.0 an die Spitze, wobei sich die Konfidenzintervalle überschneiden. FLUX 3 Image folgt einem inzwischen üblichen Weg: sofort kommerzielle Gewichte unter Lizenz, später offene Gewichte, ohne Termin.
Quellen
- Claude Code mit Mods in TypeScript anpassen (claude.com)
- Einstiegsleitfaden für Mods auf claude.dev
- Dokumentation zu den Mods von Claude Code
- Reaktion von Boris Cherny auf X
- Versionshinweise zu Claude Code 2.1.287
- GitHub-Changelog zur Steuerung von Desktop-Anwendungen
- GitHub-Changelog zu dynamischen Workflows
- Ankündigung von FLUX 3 Image durch @bfl_ai
- Modellseite zu FLUX 3 Image
- Guided Vision in Gemini Live (Google-Blog)
- Versionshinweise zu ChatGPT
- Interaktive Diagramme von Perplexity Computer
- Von @claudeai angekündigtes Angebot für Artefakte
- Bedingungen des Angebots für Artefakte (Claude-Hilfecenter)
- Barclays und Claude (Anthropic)
- Beitrag von Perplexity über American Express
- American-Express-Partnerseite von Perplexity
- Ankündigung von Wan 3.0 durch @Alibaba_Wan
- AA-Video-T2V-v2.0-Rangliste von Artificial Analysis
- Utopai X in der Rangliste von Artificial Analysis
- Project Continuum von @runwayml
- Ankündigung von Sessions durch @synthesiaIO
- Seite zu Synthesia Sessions
- SynthID Bio (Google DeepMind)
- Von Claude geprägte Wissenschaft (Anthropic Science)
- Olmo-core 3 (Ai2)
- Release von Olmo-core v3.0.0
- Clef und Clef-flash (Cloudflare-Blog)
- Clef auf Hugging Face
- FineEnvs-Leitfaden zu RL mit mehreren Harnesses
- Profil von Grok 4.7 auf Google Cloud
- Ankündigung von Grok 4.7 auf Google Cloud durch @SpaceXAI
- Strukturierte Formulare für private Meldungen von Sicherheitslücken
- Tägliche Limits für private Meldungen von Sicherheitslücken
- Codex CLI 0.160.0
- Versionshinweise zu Delta 0.18.0
- Changelog der Antigravity-App
- Changelog der Antigravity CLI
- Copilot CLI 1.0.91
- Codex CLI 0.159.3
- Nightly von Gemini CLI vom 1. Oktober
- Vorschauversion von Zed 1.23.1
- September-Rückblick zu Copilot in VS Code
- Gemeinsam in Delta planen
- Porträt von Innate durch Cursor
- Benchmark zum Erinnern an Sitzungsinhalte mit funes
- Neues GitHub-Dashboard
- API für asynchrones Merging von GitHub
- Dist-tags und Trusted Publishing bei npm
- Aufbewahrung in GitHub Actions
- Code Scanning und inaktive Repositories
- Uploads der Code Coverage
- Erklärungen zur Barrierefreiheit von Repositories
- Actions Runner Controller 0.15.0
- Vorschläge von Grok Bot
- Genspark und Azure Cosmos DB
- Erfahrungsbericht von Seulki Kang (Genspark)
- Albertsons Companies und OpenAI
- Die ewige Ergänzung (OpenAI)
- Perplexity-Leitfaden zu IA-Tools für Berater
- Luma Variants
- September-Rückblick von HeyGen
- Apps von Pika
- ElevenLabs in den Niederlanden
- ElevenLabs in Belgien
- DOCA-Skills von NVIDIA
- DIN Deploy von NVIDIA
- Nemotron 3.5 ASR und saudische Dialekte
- HSTU-Recommender auf Dynamo-Triton
- Rentabilität von IA-Fabriken (NVIDIA)
- huggingface_hub 2.1.0
- ML Intern und MCP-Datenquellen
- Open Source for Science Fund und Hugging Face
- Eine Million Trainingsläufe mit TRL
- Die Million Datensätze im Hub
- Messungen von acht VLM auf einer RTX 3090
- GLiNER2.5-Decide im Vergleich zu layax
- Von Sakana AI geteilter Meinungsbeitrag von David Ha
- Beschleunigte Video-Diffusion auf TPU