ai-powered-markdown-translatorArtykuł przetłumaczony z francuskiego na polski za pomocą gpt-6.1-sol.
W czwartek 1 października Anthropic wprowadza mody, niewielkie funkcje TypeScript, które podłączają się do zdarzeń Claude Code, aby zmieniać jego zachowanie i interfejs, dostępne wraz z wersją 2.1.287. GitHub tego samego dnia udostępnia w publicznej wersji zapoznawczej dwie funkcje agentów w Copilot CLI i aplikacji GitHub Copilot: sterowanie aplikacjami desktopowymi oraz dynamiczne workflow, czyli orkiestracje zapisane w kodzie. Black Forest Labs wprowadza FLUX 3 Image, który komponuje obrazy za pomocą prostokątów ograniczających i generuje je w rozdzielczości do 4K; Google wdraża Guided Vision w Gemini Live, Barclays rozszerza dostęp do Claude na cały bank, a GitHub zaostrza zasady zgłaszania luk w zabezpieczeniach w odpowiedzi na raporty generowane przez AI.
Claude Code otwiera się na mody, funkcje TypeScript zmieniające jego zachowanie i interfejs
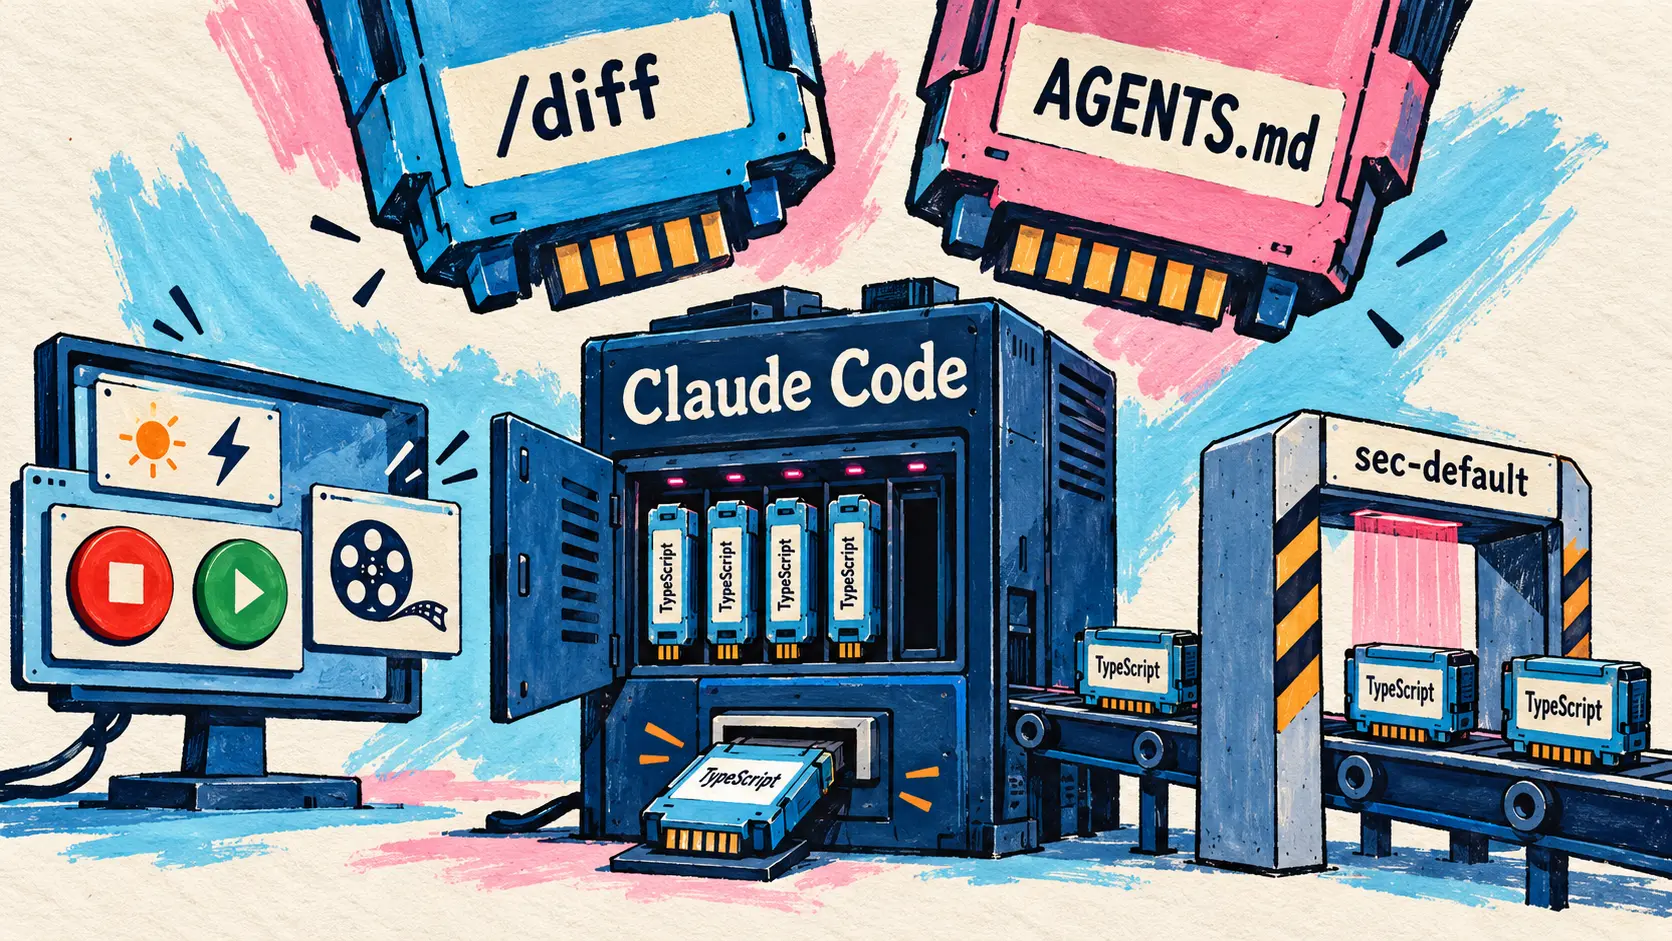
1 października — Anthropic wprowadza mody, niewielkie funkcje TypeScript, które zmieniają sposób działania Claude Code. Każda czynność narzędzia emituje zdarzenie (wywołanie narzędzia, prośba o uprawnienie, przesłanie promptu, początek i koniec tury, rysowanie części ekranu), a mod podłącza się przed jego obsługą, po niej, w jej miejsce lub opakowując ją. Może zmienić prompt, zanim trafi on do modelu, zablokować, zmodyfikować lub ponowić wywołanie narzędzia, zatwierdzić lub odrzucić prośbę o uprawnienie, ukryć sekrety w wyniku narzędzia, zanim Claude go przeczyta, albo dodać własne panele, przyciski i pola wprowadzania danych. Mody są dostarczane w pluginach, instaluje się je za pomocą /plugin i udostępnia tak jak pluginy; pojawiają się wraz z Claude Code 2.1.287 i są domyślnie włączone. Nie trzeba znać API, aby zacząć: można poprosić Claude Code o napisanie moda, a on wygeneruje kod TypeScript, zainstaluje go i przeładuje na gorąco w sesji.
Różnica w porównaniu z istniejącymi hookami jest wyraźna. Hook ustawień (settings hook) uruchamia polecenie shell przy każdym zdarzeniu; mod jest ładowany raz i pozostaje w sesji, więc zachowuje stan, przerysowuje interfejs przy kolejnych zdarzeniach i może rejestrować polecenia slash lub narzędzia wywoływane przez model. Anthropic już wykorzystuje je do własnych funkcji: panel /diff i obsługa AGENTS.md stały się wbudowanymi modami, które można wyłączyć lub zastąpić, a firma planuje z czasem przekształcić w mody kolejne funkcje, aby można było ograniczyć Claude Code do niewielkiego rdzenia. Wśród sześciu wbudowanych modów wymienionych w dokumentacji znajduje się You should know, domyślnie wyłączony, w którym agent pomocniczy sygnalizuje to, co użytkownik lub Claude mogliby przeoczyć.
| Aspekt modów | Oficjalne szczegóły |
|---|---|
| Minimalna wersja | Claude Code 2.1.287, mody domyślnie włączone |
| Środowiska z obsługą widoku | CLI w terminalu, karta Code w Claude Desktop (z wyjątkiem sesji WSL) |
| Środowiska bez obsługi widoku | Rozszerzenie VS Code, claude -p, Agent SDK i sesje w chmurze, w których działają hooki |
| Wbudowane mody | 6, w tym /diff, AGENTS.md, sec-default i You should know |
| Czas własny hooka | 10 sekund na wywołanie |
| Wyłączanie | /plugin dla jednego moda, --safe-mode dla sesji, disableAllHooks dla wszystkich |
Przewodnik wprowadzający autorstwa Addy’ego Osmaniego na claude.dev pokazuje, jak stworzyć Token Weather, mod liczący około 80 linii, który wyświetla nad promptem „pogodę” kontekstu wraz z miniwykresem 12 ostatnich tur. Przedstawia także Blast Radius, który wstrzymuje rm -rf, git reset --hard lub wymuszony push na czas pokazania, czego dotyczyłaby dana operacja, oraz Replay Theater, który odtwarza zmiany w plikach z danej tury.
Zaufanie pozostaje delikatną kwestią. Wpis ostrzega, że mody nie są izolowane: mają taki sam dostęp do komputera jak Claude Code, a dokumentacja wyjaśnia, że mod może odczytywać zmienne środowiskowe i pliki ustawień, widzieć każdy prompt, zatwierdzać wywołanie narzędzia lub zużywać limit planu, ale nie może modyfikować monitu z prośbą o uprawnienie. Przewodnik na claude.dev opisuje jednak moduł działający we własnym sandboxie, bez DOM i Node, w którym każde działanie zewnętrzne przechodzi przez API $: to właśnie pozwala claude plugin validate wyświetlać przed instalacją listę zdarzeń przechwytywanych przez mod oraz wykonywanych przez niego wywołań. W planach Team i Enterprise oraz na każdym komputerze z zarządzanymi ustawieniami wbudowany mod sec-default ładuje się jako pierwszy i uniemożliwia modom zainstalowanym przez użytkownika obchodzenie reguł odmowy; administratorzy mogą umieścić przed nim własne mody.
Mods are absolutely insane. You can now customize Claude to work and look the way you want by just prompting it. Each person works differently, so there’s no reason why everyone should have an identical Claude experience. Make Claude your own, and share mods as plugins so others can try your mods too.
🇵🇱 Mody to kompletne szaleństwo. Teraz możecie dostosować Claude tak, by pracował i wyglądał tak, jak chcecie, po prostu go o to prosząc. Każdy pracuje inaczej, więc nie ma żadnego powodu, by u wszystkich korzystanie z Claude wyglądało identycznie. Dostosujcie Claude do siebie i udostępniajcie swoje mody jako pluginy, by inni mogli je wypróbować. — @bcherny na X
Na premierę czekano: Boris Cherny zapowiedział ją 14 września, a Anthropic udostępniło projekt na GitHub (issue #91870). Wpis i przewodnik na claude.dev zachęcają do zgłaszania własnych modów do katalogu Claude.
🔗 Dostosuj Claude Code za pomocą modów w TypeScript · Przewodnik wprowadzający na claude.dev · Dokumentacja modów
Claude Code 2.1.287: domyślny kontekst 1M u dostawców usług chmurowych i 67 poprawek
1 października — Claude Code 2.1.287 to wersja wprowadzająca mody, ale zawiera 106 pozycji, w tym 67 poprawek. W przypadku firm korzystających z Bedrock, Vertex, Foundry i bramy Claude apps Opus 4.7 i nowsze wersje oraz Fable korzystają teraz domyślnie z okna kontekstowego 1M, bez sufiksu [1m]; CLAUDE_CODE_DISABLE_1M_CONTEXT=1 pozwala pozostać przy 200K. /advisor obsługuje Sonnet 5.5 jako doradcę Opus 4.7 i 4.8, automatyczna zmiana modelu zachowuje bieżący poziom wysiłku, a serwery MCP korzystające z protokołu 2025-11-25 mogą otwierać monity URL. Niebezpieczne rm nadal wymaga potwierdzenia, nawet gdy polecenie przekierowuje swój wynik do ~ lub symbolu wieloznacznego, oczekujące prośby o uprawnienia są wyświetlane od najstarszej do najnowszej, a dziewięć pozycji usprawnia tryb czytnika ekranu. W VS Code wykonywane polecenie lub działający podagent można przenieść do tła (Run in background).
🔗 Informacje o wydaniu Claude Code 2.1.287
GitHub Copilot: sterowanie aplikacjami desktopowymi i dynamiczne workflow w publicznej wersji zapoznawczej
1 października — GitHub tego samego dnia udostępnia w publicznej wersji zapoznawczej dwie funkcje agentów w Copilot CLI i aplikacji GitHub Copilot: sterowanie aplikacjami desktopowymi oraz dynamiczne workflow, dostępne również w GitHub Copilot SDK.
Copilot steruje aplikacjami desktopowymi. Sterowanie komputerem (computer use) trafia na macOS i Windows. Copilot odczytuje dostępną treść okna oraz jego kontekst wizualny, korzystając z drzewa dostępności systemu lub, gdy to konieczne, ze zrzutów ekranu, klika elementy sterujące, wpisuje tekst, naciska klawisze, przewija, przeciąga i upuszcza oraz wykonuje kolejne kroki w różnych aplikacjach; demonstracja pokazuje, jak wypełnia rozliczenie wydatków w Safari. GitHub kieruje tę funkcję do starszego oprogramowania lub programów obsługiwanych wyłącznie graficznie, bez API, interfejsu wiersza poleceń czy integracji MCP, a dokumentacja zaleca korzystanie z tych rozwiązań, gdy są dostępne, ponieważ dają bardziej przewidywalne wyniki. Funkcja jest domyślnie wyłączona: /computer on włącza ją w CLI, /computer show wyświetla jej stan, a /computer off ją wyłącza; w aplikacji jest dostępna w ustawieniach. Copilot prosi o zgodę przed sterowaniem każdą aplikacją: można jej udzielić na czas sesji, zapisać ją na kolejne sesje lub odmówić. Stała zgoda (Always allow) obejmuje CLI i aplikację na tym samym komputerze, ale reguła odmowy zawsze ma pierwszeństwo, a dwukrotne naciśnięcie Esc w CLI lub przycisk Stop w aplikacji przerywa działanie, które wymyka się spod kontroli. Zarządzane ustawienia organizacji mogą wyłączyć tę funkcję, a jej lokalne włączenie nie pozwala tego obejść. GitHub ostrzega, że niejednoznaczna instrukcja lub nieoczekiwana treść na ekranie może wywołać niezamierzone działania na zalogowanych kontach, także finansowych, i odradza udzielanie stałej zgody w przypadku aplikacji o wrażliwym charakterze. Nie podano ani objętych funkcją planów, ani żadnych danych liczbowych; polecenie /computer pojawiło się już w informacjach o wydaniu Copilot CLI 1.0.85 z 16 września.
🔗 GitHub Copilot może teraz obsługiwać aplikacje desktopowe dzięki sterowaniu komputerem
Orkiestracje zapisane w kodzie. Dynamiczne workflow (dynamic workflows), udostępnione we wszystkich planach Copilot, opisują w programie sposób wykonania zadania: kod określa etapy, moment interwencji agenta i sposób wykorzystania jego wyników, sekwencyjnie, równolegle lub na oba sposoby, a agenci zajmują się tym, co wymaga analizy lub oceny. Workflow może uruchamiać polecenia, dzielić cel na równoległe zadania, przekazywać ustrukturyzowane wyniki między etapami, zlecać jednemu podagentowi sprawdzenie ustaleń innego oraz zatrzymywać się w punkcie kontrolnym (checkpoint), aby umożliwić przegląd przed wznowieniem. GitHub wymienia analizę incydentu, równoległy przegląd plików w pull request lub komentarze z przeglądu oceniane przez dwa modele i zgłaszane tylko wtedy, gdy oba się zgadzają.
| Tryb Copilot | Kto organizuje pracę według dokumentacji |
|---|---|
| Autopilot | Copilot, który działa dalej bez proszenia o zatwierdzenie po każdym etapie |
/fleet | Copilot, który za każdym razem dzieli zadanie między podagentów pracujących równolegle |
| Dynamiczny workflow | Kod napisany przez autora: etapy, warunki i przekazywanie sterowania |
Program działa w rozszerzeniu Copilot CLI i aplikacji. Workflow napisany przez Copilot jest ograniczony do sesji, ale można go używać ponownie, kopiując rozszerzenie do katalogu domowego, udostępniać przez odpowiedni katalog repozytorium lub spakować jako plugin. Podagenci dziedziczą uprawnienia sesji, podczas gdy polecenie copilot workflow run nie wyświetla żadnych monitów: uprawnienia trzeba przyznać przed uruchomieniem. W aplikacji workflow są dostępne bez dodatkowej konfiguracji, natomiast w CLI wymagają włączenia funkcji eksperymentalnych (--experimental lub /experimental on). GitHub nie publikuje danych liczbowych ani zasad rozliczeń, a nazwa przypomina, bez ogłoszonego powiązania, Dynamic Workflows wprowadzone przez Anthropic w Claude Code 28 maja.
🔗 Dynamiczne workflow w Copilot CLI i aplikacji Copilot
FLUX 3 Image: Black Forest Labs komponuje obrazy za pomocą prostokątów ograniczających i generuje je w rozdzielczości do 4K
1 października — Black Forest Labs (BFL) dodaje model obrazu do swojej rodziny FLUX 3, z hasłem: kontrola nad każdym pikselem. FLUX 3 Image retuszuje wybrany obszar w kilku kolejnych przebiegach bez zmieniania reszty obrazu i przyjmuje wiele zmian w jednym żądaniu.
Najbardziej widoczną nowością jest komponowanie obrazu za pomocą prostokątów ograniczających (bounding boxes). Niezależnie od formatu obraz otrzymuje układ współrzędnych od 0 do 1000 na każdej osi: rysuje się prostokąt dla każdego elementu, opisuje jego zawartość, a następnie podsumowuje scenę w jednym wierszu, po czym model umieszcza każdy element w jego prostokącie; nadal można użyć wyłącznie promptu tekstowego. FLUX 3 Image łączy też do 10 obrazów referencyjnych, wskazanych za pomocą tokenów w prompcie, samodzielnie decydując o ich rozmieszczeniu i rozmiarze. BFL przedstawia go jako „zaprojektowany dla agentów”: LLM może na podstawie prostej prośby przygotować tabelę elementów i ich prostokątów, którą użytkownik dostosowuje przed uruchomieniem generowania.
| Zapowiedziana cecha | Szczegóły podane przez BFL |
|---|---|
| Natywna rozdzielczość | 2K i 4K (przykład ze strony modelu: 5456 × 3072 pikseli, 16,8 MP) |
| Obrazy referencyjne | Do 10 |
| Kompozycja | Prostokąty ograniczające na siatce od 0 do 1000 na każdej osi |
| Edycja | W wielu turach, bez zmiany pozostałych pikseli |
| Oferta API | 50 % zniżki do 8 października |
| Wagi modelu | Komercyjne na licencji; otwarte wagi „w najbliższych tygodniach” |
Jeśli chodzi o dostęp, FLUX 3 Image jest dostępny przez API z 50 % zniżki do 8 października, a BFL oferuje komercyjne wagi na licencji firmom, które chcą dostrajać model i wdrażać go na własnej infrastrukturze. Wersja z otwartymi wagami została zapowiedziana bez podania daty. W chwili ogłoszenia nie opublikowano ceny podstawowej ani żadnego benchmarku z wynikami liczbowymi. Model uzupełnia serię zapoczątkowaną tego lata: FLUX 3, zunifikowany model multimodalny (23 lipca), FLUX 3 Video (4 sierpnia), jego tryb edycji (10 września) oraz FLUX 3 Action dla robotyki (23 września).
🔗 Ogłoszenie FLUX 3 Image przez @bfl_ai · Strona modelu FLUX 3 Image
Asystenci dla użytkowników indywidualnych: Guided Vision w Gemini Live, wirtualna przymierzalnia w ChatGPT, wykresy w Perplexity Computer, złagodzone limity dla artefaktów Claude
Guided Vision: Gemini Live pomaga osobom niewidomym i słabowidzącym
1 października — Google wdraża Guided Vision w Gemini Live na Androidzie 9 i nowszych wersjach, w regionach i językach, w których Gemini Live jest dostępne. Funkcja opracowana z udziałem osób niewidomych i słabowidzących opisuje w czasie rzeczywistym obraz z udostępnionej kamery, odpowiada na dodatkowe pytania i podaje słowne wskazówki dotyczące kadrowania: powoli obróć w prawo, pochyl w dół, cofnij się. Google podaje przykłady odczytywania etykiety z wartościami odżywczymi lub menu w ciemnej restauracji, szukania upuszczonej słuchawki czy opisywania kolorów ubrania. Aby wytrenować funkcję, Google nawiązało współpracę z Aira, usługą interpretacji wizualnej: wykorzystano dziesiątki tysięcy godzin danych, ponad 1 000 testerów z jej sieci oraz specjalistów zaangażowanych w opracowanie zabezpieczeń. Guided Vision można włączyć w profilu aplikacji Gemini, za pomocą skrótu ułatwień dostępu Androida lub z poziomu TalkBack. Google zaznacza, że nie jest to urządzenie medyczne ani pomoc w poruszaniu się: funkcja nie zastępuje białej laski.
🔗 Guided Vision w Gemini Live (blog Google)
ChatGPT: wirtualne przymierzanie i ulubione produkty podczas zakupów
1 października — Według informacji o aktualizacjach ChatGPT na kartach odzieży i akcesoriów pojawia się przycisk przymierzania (Try on): użytkownik robi lub przesyła selfie, a ChatGPT Images generuje obraz przedstawiający go w wybranym produkcie. Zdjęcie referencyjne jest zachowywane do kolejnych przymiarek; można je zastąpić lub usunąć w ustawieniach, w sekcji zdjęć referencyjnych (Settings → Personalization → Reference photos). Każdy produkt można też zapisać w ulubionych lub umieścić w folderze biblioteki ChatGPT. Obie funkcje są dostępne na urządzeniach mobilnych i w przeglądarce, ale informacja nie wskazuje planów ani krajów, których dotyczą. ChatGPT oferował już zakupy z wykorzystaniem obrazów od 24 marca.
🔗 Informacje o aktualizacjach ChatGPT
Perplexity Computer tworzy interaktywne wykresy
1 października — Perplexity Computer tworzy teraz interaktywne wykresy i wizualizacje bezpośrednio w wątku rozmowy. W przypadku danych finansowych agent korzysta z Lightweight Charts firmy TradingView, aby wyświetlać świece, wolumen i średnie kroczące. Zapowiedź ogranicza się do tweeta z filmem: nie wskazuje, które plany obejmują tę funkcję ani na jakich platformach jest dostępna, a changelog nie zawiera jeszcze szczegółowego wpisu na jej temat. ChatGPT i Claude wprowadziły podobne rozwiązania 10 i 12 marca, a Replit Agent 25 września.
🔗 Zapowiedź @perplexity_ai na X
Claude zmniejsza o połowę zużycie limitów po utworzeniu artefaktu, do 15 października
1 października — Od 1 października o godz. 11 PT do 15 października o godz. 23:59 PT utworzenie lub zmodyfikowanie artefaktu (dokumentu, prezentacji lub projektu) w Claude albo Claude Cowork sprawia, że dalsza praca zużywa o 50 % mniej pięciogodzinnego limitu sesji. Oferta obowiązuje automatycznie w planach Pro, Max i Team; wyłączone są Free i plany Enterprise, a limit tygodniowy pozostaje bez zmian.
| Obszar objęty ofertą | Zakres obniżki o 50 % |
|---|---|
| Rozmowa rozpoczęta z menu Output | Od pierwszej wiadomości: 10 wiadomości, 15 kroków na odpowiedź |
| Zwykła rozmowa | 10 wiadomości po utworzeniu artefaktu, 15 kroków na odpowiedź |
| Zadanie Cowork w chmurze uruchomione z Output | Około pierwszych 45 minut |
| Inne zadanie Cowork w chmurze | Do 80 kroków po utworzeniu lub zmodyfikowaniu artefaktu |
Wyłączone są Claude Code, API, Claude w Slack, lokalne lub zaplanowane zadania Cowork, kredyty na użytkowanie oraz samodzielna aplikacja Claude Design. Anthropic sugeruje wypróbowanie oferty z Sonnet 5.5 i zastrzega sobie prawo do jej zmiany lub wcześniejszego zakończenia.
🔗 Zapowiedź @claudeai na X · Warunki oferty (centrum pomocy Claude)
Finanse: Barclays wdraża Claude w całym banku, American Express udostępnia Perplexity Computer klientom Business
Barclays chce, by połowa jego programistów korzystała z Claude Code do końca 2026 roku
1 października — Barclays, brytyjski bank uniwersalny, rozszerza współpracę z Anthropic i wdraża Claude w całej organizacji, aby przyspieszyć tworzenie oprogramowania, zmodernizować starsze systemy i zwiększyć efektywność operacyjną. Bank przewiduje, że do końca 2026 roku Claude Code będzie używać 50 % jego programistów, a w 2027 roku większość jego inżynierów oprogramowania. Dwa zastosowania mają już wyniki liczbowe. Colleague Knowledge Assistant, działający od 2025 roku i zbudowany na Claude z architekturą generowania wspomaganego wyszukiwaniem (RAG), jest używany przez ponad 16 000 pracowników i obsłużył ponad milion wyszukiwań; pomaga zespołom obsługującym ponad 20 milionów klientów indywidualnych w Wielkiej Brytanii. W działalności Global Markets modele Claude klasyfikują, wzbogacają i kierują do odpowiednich odbiorców około 120 000 e-maili dziennie. Paul Smith, dyrektor handlowy Anthropic, postrzega to jako ważny krok dla firmy w Wielkiej Brytanii; nie podano wartości ani okresu obowiązywania umowy.
🔗 Barclays rozszerza wdrożenie Claude, aby usprawnić działalność i poprawić doświadczenia klientów
Perplexity i American Express: dziesięć biznesowych Skills w Computer dla kart Business
1 października — Perplexity udostępnia kolekcję gotowych do użycia Skills dla Perplexity Computer, przeznaczoną wyłącznie dla amerykańskich posiadaczy kart American Express Business z subskrypcją Perplexity Enterprise. Osoba zarządzająca firmą wybiera zadanie i doprecyzowuje je w formularzu zamiast pisać zapytanie. Dziesięć Skills obejmuje prognozowanie przepływów pieniężnych, przygotowanie do rozliczeń podatkowych, porównywanie dostawców, scenariusze budżetowe, uzgadnianie ksiąg, kampanie marketingowe, prognozowanie popytu, zwrot z wydatków reklamowych według kanału (ROAS), monitorowanie działalności i rekrutację. Kartę łączy się przez Plaid z poziomu Personal CFO, a każde uruchomienie zużywa kredyty Computer zależnie od złożoności zadania. Strona partnerska oferuje dodatkowo, do 29 marca 2027 roku, jednorazowy zwrot 125 dolarów przy wydatku co najmniej 325 dolarów na plan Enterprise Pro lub Enterprise Max oraz 1 000 darmowych kredytów Computer przyznawanych raz na konto. Karty Corporate są wyłączone, a wyniki nie stanowią porady finansowej, podatkowej, prawnej ani księgowej.
🔗 Wpis Perplexity · Strona partnerska American Express
Generatywne wideo i awatary: Wan 3.0 na czele Artificial Analysis, Project Continuum od Runway, Sessions od Synthesia
Wan 3.0 obejmuje prowadzenie w nowym rankingu wideo Artificial Analysis
1 października — Alibaba ogłasza pierwsze miejsce Wan 3.0 w nowym rankingu generowania wideo z tekstu Artificial Analysis, AA-Video-T2V v2.0, uruchomionym 30 września z nową metodologią: każdy model jest oceniany w 1080p na zestawie regularnie aktualizowanych promptów, a synchronizacja dźwięku wpływa na wynik. Różnice na podium są niewielkie, a przedziały ufności nakładają się na siebie.
| Model w rankingu | Wynik Elo | Przedział pozycji | Cena przez API |
|---|---|---|---|
| Wan 3.0 | 1157 (±9) | 1 do 2 | 12,00 dolarów za minutę |
| Utopai X (oparty na MiniMax H3) | 1150 (±10) | 1 do 3 | Brak publicznego API |
| Dreamina Seedance 2.5 | 1144 (±9) | 2 do 4 | 34,12 dolarów za minutę |
| MiniMax H3 (768p) | 1139 (±9) | 3 do 5 | 4,80 dolarów za minutę |
Niespodzianką rankingu jest Utopai X, uruchomiony 30 września przez Utopai Studios, studio filmowe i telewizyjne zbudowane od podstaw wokół IA. Po dodatkowym treningu na bazie MiniMax H3 jest dostępny wyłącznie na platformie PAI studia (93 kredyty za sekundę wideo, subskrypcje od 15 dolarów miesięcznie) i wyprzedza sam MiniMax H3.
🔗 Zapowiedź @Alibaba_Wan na X · Ranking AA-Video-T2V v2.0 · Utopai X według @ArtificialAnlys
Runway Labs prezentuje Project Continuum, interfejsy generowane jako wideo w czasie rzeczywistym
1 października — Runway Labs, dział badawczy Runway, pokazuje Project Continuum, aplikację badawczą przedstawiającą wizję systemu operacyjnego, którego interfejs byłby generowany jako wideo w czasie rzeczywistym. Rozwija ona koncepcję Solaris, modelu świata interfejsu zaprezentowanego 31 sierpnia. Ten pierwszy pokaz opisuje cztery sposoby interakcji z komputerem. W Portals model wideo generuje podczas nawigacji animowane, interaktywne nakładki z rozmytymi krawędziami sygnalizującymi wygenerowaną treść. Responsywne interfejsy wideo (Responsive Video Interfaces) zmieniają układ po zmianie rozmiaru i reagują na kliknięcia. Interactive Worlds przekształca materiał multimedialny w interaktywną symulację, zarówno dla ludzi, jak i agentów. Visual Thinking to z kolei harness dla agentów kodujących: model wideo działający w czasie rzeczywistym wizualizuje każdy krok i każde wywołanie narzędzia, aby użytkownik mógł na bieżąco śledzić proces. Runway nie udostępnia dostępu ani nie podaje daty, ceny czy modelu stanowiącego podstawę rozwiązania.
Synthesia uruchamia Sessions, awatary prowadzące treningi i wywiady
1 października — Synthesia uruchamia Sessions, rodzinę produktów opartą na interaktywnych awatarach: rozmowę wideo, w której rozmówcą jest awatar zadający pytania, słuchający, polemizujący i podsumowujący. Roleplay Sessions służy do treningu: awatar odgrywa klienta, potencjalnego klienta lub współpracownika, trener IA komentuje każdą próbę, a menedżerowie śledzą wyniki i postępy w panelu. Survey Sessions przekształca ankietę w wywiad: awatar rozmawia z setkami osób równolegle, zadaje dodatkowe pytania zależnie od odpowiedzi, a następnie dostarcza raport o tematach i wydźwięku wypowiedzi; każdą odpowiedź można nadal przejrzeć w transkrypcji, odsłuchać lub pobrać w CSV. Dostępna jest bezpłatna wersja próbna, bez szczegółowego cennika. Sessions korzysta z Interactive Avatar API, które udostępniono ogólnie 16 września, a Synthesia zapowiada kolejne warianty.
🔗 Zapowiedź @synthesiaIO na X · Strona Synthesia Sessions
IA i nauka: SynthID Bio znakuje białka, Matthew Schwartz opisuje naukę „dopasowaną do Claude”
SynthID Bio: Google DeepMind znakuje białka zaprojektowane przez IA
30 września — Google DeepMind przedstawia SynthID Bio, rodzinę metod cyfrowego znakowania (watermarking) wytworów biologicznych generowanych przez IA, o której poinformowano na X 1 października. Wpis przedstawia ją jako potwierdzenie koncepcji: w kodzie biologicznym umieszczany jest niedostrzegalny podpis, który można zweryfikować zarówno w modelu cyfrowym, jak i w zsyntetyzowanym białku. W przypadku sekwencji metoda dyskretnie wpływa na wybór aminokwasów; w przypadku struktur 3D dostrajana jest niewielka część sieci dyfuzyjnej AlphaFold 3. W laboratorium, dla trzech celów (VEGF-A, domeny RBD białka spike SARS-CoV-2 i PD-L1), znakowane białka wiążące dorównały standardowym wersjom pod względem odsetka sukcesów, powinowactwa i różnorodności sekwencji. Chodzi o bezpieczeństwo biologiczne: automatyczny sygnał pomógłby dostawcom usług syntezy DNA sprawdzać pochodzenie nieznanej sekwencji. Google DeepMind publikuje artykuł opisujący metody, kod, dane in vitro i wagi do celów badawczych; wraz z Hie lab ze Stanford i Arc Institute podejście jest już rozszerzane na genom bakteriofaga zaprojektowanego przez Evo 2. Odporność na celowe modyfikacje pozostaje głównym obszarem dalszych prac.
🔗 Wpis Google DeepMind o SynthID Bio
Nauka „dopasowana do Claude”: gościnny wpis Matthew Schwartza
1 października — Blog Anthropic Science publikuje gościnny wpis Matthew Schwartza, fizyka z Harvardu, który zaznacza, że pracuje w Anthropic jako badacz gościnny. Opisuje w nim „niedopasowanie impedancji” między naukowcami a IA: praca z modelem tak jak z ludzkim współpracownikiem nie pozwala w pełni wykorzystać jego możliwości. Lepiej szukać problemów „dopasowanych do Claude”, w których znana technika z matematyki, fizyki lub informatyki rozwiązuje za jednym razem zagadnienie z innej dziedziny. Na tej podstawie stworzył BootLoops, harness open source do obliczeń dokładnych, który można wykorzystać z dowolnym modelem; BootLoops nie jest projektem Anthropic, utrzymuje go Schwartz. W fizyce obliczono od początku do końca 30 całek, w tym 15 nigdy wcześniej nieobliczonych; w ekologii drzewa na Barro Colorado Island zmieniają się 4,5 razy szybciej, niż dopuszcza teoria neutralna; w językoznawstwie baza AccStack obejmuje akcent wyrazowy w 6 072 językach. Bilans: 36 manuskryptów w 18 dziedzinach z 19 współautorami w ciągu trzech miesięcy. Schwartz wskazuje też ograniczenia: Claude nie ma poczucia czasu, lubi „ogłaszać zwycięstwo”, a jego wyniki poza fizyką pozostawały mało interesujące, dopóki ekspert nie nadał im nowego kierunku.
🔗 Nauka dopasowana do Claude (blog Anthropic Science)
Otwarte modele i trening: Olmo-core 3 od Ai2, Clef i Clef-flash od Cloudflare, RL z wieloma harnessami od FineEnvs
Olmo-core 3: Ai2 udostępnia otwarty stos treningowy MoE z myślą o ponad bilionie parametrów
1 października — Ai2 publikuje Olmo-core 3, nową wersję frameworka do treningu swoich modeli Olmo, przebudowaną wokół w pełni otwartego systemu treningowego z mieszaniną ekspertów (mixture-of-experts, MoE). To jeden z systemów kolejnej generacji Olmo, która przejdzie na MoE i według Ai2 ma być najsprawniejszą generacją tych modeli. Poprzednia implementacja, oparta na FSDP, zbierała wagi, a następnie ponownie je dzieliła przy każdej partii danych; Olmo-core 3 przechodzi na DDP, utrzymuje ekspertów na ich GPU i przesyła do nich dane.
| Pomiar opublikowany przez Ai2 | Zmierzona wartość |
|---|---|
| MoE z 47 miliardami parametrów na ośmiu B300, test wstępny | 52 000 wobec 19 400 tokens/s na GPU, około 2,7 razy |
| MXFP8 wobec BF16, na czterech B300 | Około 21 % większa przepustowość |
| Model z 1 200 miliardami parametrów na 512 GPU | Maksymalnie 858 TFLOP/s na GPU, losowy routing |
Ai2 zaznacza, że pomiar dla 1 200 miliardów parametrów ocenia system, a nie jakość wytrenowanego modelu. Opublikowano kod (wersja 3.0.0), raport techniczny i interaktywną demonstrację.
🔗 Wpis Ai2 o Olmo-core 3 · Wydanie Olmo-core v3.0.0
Clef i Clef-flash: Cloudflare udostępnia dwa modele decyzyjne kompatybilne z Jev
1 października — Zespół Workers AI firmy Cloudflare publikuje Clef i Clef-flash, swoje pierwsze modele wytrenowane wewnętrznie, w obszarze zapoczątkowanym przez Jev, model System One firmy Typesafe AI: otrzymują stan (tekst, JSON, obraz lub wideo) oraz schemat pytań z określonymi typami, a następnie w jednym przebiegu zwracają prawdopodobieństwo dla każdej dozwolonej opcji. Clef wytrenowano dodatkowo na bazie Qwen3.8-27B, a Clef-flash opiera się na Qwen3.5-9B. Są hostowane na Workers AI z API kompatybilnym z API Jev i według wpisu opublikowane na Hugging Face na licencji Apache 2.0, z oknem kontekstu obejmującym 64k tokenów wobec 32k w Jev. Wyniki wybrane przez Cloudflare dają mieszany obraz:
| Benchmark i metryka | Wynik Clef | Wynik Clef-flash | Wynik Jev |
|---|---|---|---|
| BFCL, dokładne dopasowania | 98,47 | 98,76 | 95,75 |
| BANKING77, macro-F1 | 94,20 | 90,93 | 79,74 |
| When2Call, dokładność | 72,37 | 65,58 | 80,97 |
| BRIGHT, nDCG@10 | 45,91 | 39,26 | 47,52 |
| Mediana opóźnienia | 209,3 ms | 38,8 ms | 524,1 ms |
Cloudflare twierdzi, że Clef prowadzi w Jev Decision Index — pozycję tę dwa dni wcześniej przypisywała d1 firma Liquid AI — i uruchamia usługę fine-tuningu Clef metodą uczenia ze wzmocnieniem na danych klienta.
🔗 Wpis Cloudflare o Clef · Clef na Hugging Face
FineEnvs trenuje model metodą uczenia ze wzmocnieniem w czterech harnessach agentów jednocześnie
1 października — Ten sam model zachowuje się różnie w zależności od sterującego nim harnessu: wagi LFM2.5-2.6B firmy Liquid AI pozwalają rozwiązać 62 % zadań w Mini-SWE-Agent, ale 33 % w Claude Code. Organizacja FineEnvs publikuje na Hugging Face przewodnik po trenowaniu modelu metodą uczenia ze wzmocnieniem bezpośrednio w harnessach deweloperów, bez modyfikowania ich kodu. Proxy rejestrujące, dodane do OpenEnv, przedstawia się harnessowi jako dostawca modelu (formaty OpenAI, Anthropic lub Gemini) i zapisuje dokładne tokeny oraz prawdopodobieństwa generowane przez vLLM; Harbor dostarcza zadania i sandboxy, a TRL prowadzi trening w asynchronicznym GRPO. Trenowany w czterech harnessach jednocześnie LFM2.5-2.6B poprawia średni wynik z 42 % do 54 %, a niewielka premia za oszczędne rozwiązania zmniejsza o 31 % liczbę wywołań narzędzi w zadaniach już rozwiązywanych przez model. Naśladowanie większego modelu nie wystarcza: nadzorowany fine-tuning na 3 189 rolloutach Qwen3.8-27B osiąga najwyżej 47,5 %. Opublikowano proxy, moduł treningowy, zadania, dane i wytrenowane modele.
🔗 Kompletny przewodnik po RL w wielu harnessach
Grok 4.7 w wersji zapoznawczej na platformie agentów Google Cloud
1 października — SpaceXAI ogłasza, że Grok 4.7 jest dostępny na Gemini Enterprise Agent Platform, platformie agentów Google Cloud. Karta modelu, datowana na 30 września, oznacza go jako wersję zapoznawczą pod identyfikatorem grok-4.7 i opisuje jako model xAI przeznaczony do programowania i pracy z wiedzą, który poświęca więcej czasu trudnym zadaniom i sprawdza własną pracę. Przyjmuje tekst i obrazy na wejściu, a zwraca wyłącznie tekst; obsługuje wywoływanie funkcji, ustrukturyzowane wyjście i rozumowanie, ale nie predykcje wsadowe.
| Dane opublikowane przez Google Cloud | Wartość dla Grok 4.7 |
|---|---|
| Długość kontekstu | 524 288 tokens |
| Limity na minutę | 13 żądań, 188 000 tokens na wejściu i 16 000 tokens na wyjściu |
| Rodzaje użycia | Wyłącznie stały limit, bez płatności za użycie ani rezerwowanej przepustowości |
| Regiony obsługi | Multiregion w Stanach Zjednoczonych i globalny endpoint |
| Cena za milion tokens | 2 dollars za wejście, 6 za wyjście, 0,50 za cache poniżej 200 000 tokens na wejściu, powyżej dwa razy więcej |
Cennik odpowiada cennikowi API xAI. Grok 4.7, wprowadzony 21 września, trafił do Amazon Bedrock 28 września, a Grok 4.6 dołączył do tej samej platformy Google 21 sierpnia.
🔗 Karta Grok 4.7 w Google Cloud · Ogłoszenie @SpaceXAI na X
GitHub zaostrza zasady prywatnego zgłaszania podatności w odpowiedzi na zgłoszenia generowane przez AI
1 października — GitHub publikuje w tej samej minucie dwa rozwiązania dotyczące prywatnego zgłaszania podatności (private vulnerability reporting), wynikające ze wspólnej obserwacji: opiekunowie projektów open source otrzymują coraz więcej zgłoszeń niskiej jakości, zautomatyzowanych lub generowanych przez AI, w których giną te istotne.
A single free-text box made it easy to submit low-quality or AI-generated reports and hard for you to find the signal in them.
🇵🇱 Zwykłe pole do wpisywania dowolnego tekstu ułatwiało przesyłanie zgłoszeń niskiej jakości lub generowanych przez AI i utrudniało wam wyłowienie z nich tego, co najważniejsze. — GitHub Changelog, Ustrukturyzowane formularze do prywatnego zgłaszania podatności
Ustrukturyzowany formularz. Domyślnie osoba zgłaszająca musi wypełnić cztery obowiązkowe pola: podsumowanie, szczegóły, proof of concept liczący co najmniej 150 znaków oraz wpływ. Są one łączone w opis biuletynu bezpieczeństwa, który opiekun przegląda tak jak dotychczas. Każde repozytorium może dostosować formularz za pomocą pliku .github/VULNERABILITY_REPORT.yml lub zastosować go we wszystkich repozytoriach organizacji z poziomu jej repozytorium .github; opiekunowie mogą wymagać kategorii CWE, co organizacja lub przedsiębiorstwo może narzucić w swoich zasadach. Pole wyboru pozwala osobie zgłaszającej zadeklarować, że korzystała z pomocy AI przy znalezieniu podatności lub napisaniu zgłoszenia. W API REST również obowiązuje formularz niestandardowy, ale nie domyślny, aby zachować działanie istniejących integracji.
Dzienny limit. Liczba nowych zgłoszeń, które jedno konto może przesłać każdego dnia, jest teraz ograniczona zarówno dla pojedynczego repozytorium, jak i dla całej platformy GitHub; komentarze do istniejących biuletynów nie są objęte limitem. Administratorzy mogą ustawić własny limit i zwolnić z niego zaufane osoby zgłaszające, a GitHub nie podaje wartości limitu domyślnego. Oba rozwiązania dotyczą publicznych repozytoriów z włączonym prywatnym zgłaszaniem podatności w GitHub Free, Pro, Team i Enterprise Cloud.
🔗 Limity częstotliwości przesyłania prywatnych zgłoszeń podatności
Agenci programistyczni: Codex CLI 0.160.0, Delta 0.18 i Antigravity 2.19.1
Codex CLI 0.160.0: historia centrum dowodzenia i sesje poza projektem
1 października — OpenAI publikuje Codex CLI 0.160.0, pierwszą stabilną wersję od wydanej dzień wcześniej 0.159.3, z 55 PR wymienionymi od wersji 0.159.0. Centrum dowodzenia agentami (agent command center) zyskuje obsługiwaną klawiaturą akcję wyświetlania starszych zadań (Pokaż więcej). Sesje mogą rozpoczynać się poza projektem, z domyślnymi ustawieniami obszaru roboczego, gdy zezwalają na to zasady organizacji, a zapisane uprawnienia są przywracane po wznowieniu. Mechanizm przeglądu zatwierdzeń Guardian otrzymuje dwie opcjonalne funkcje: odszukiwanie instrukcji podanych wcześniej przez użytkownika i uwzględnianie kontekstu przekazywania zadań między agentami. W trybie pełnoekranowym lokalne terminale Linux X11 pozwalają zaznaczać transkrypcję i wklejać środkowym przyciskiem myszy. Wśród poprawek wiadomości z kolejki są ponownie wysyłane po przywróceniu połączenia bez duplikowania, a seria zmian dotyczy sandboxu Windows i blokad SQLite podczas inicjalizacji.
Delta 0.18: wątki działają w istniejących worktree Git, pojawia się też CLI
30 września — Zed publikuje wersję 0.18.0 Delta, swojego środowiska do wspólnego programowania z agentami: 23 nowości, 41 ulepszeń, 51 poprawek i jedno usunięcie. Najważniejszą nowość zapowiedziano 28 września bez podania daty: wątek może teraz działać w dowolnym istniejącym, już powiązanym worktree Git i przekazywać tę kopię roboczą nowym wątkom utworzonym z jego poziomu. Delta można też obsługiwać z terminala: CLI delta można zainstalować na macOS, Windows i Linux, a polecenia delta auth służą do zarządzania zalogowanym kontem. W zakresie modeli wersja dodaje modele Gemini z Google AI Studio, udostępnia GPT-6 Sol, GPT-6 Luna i Claude Opus 5.5 z użyciem klucza API oraz obsługuje w aplikacji desktopowej dowolnego dostawcę kompatybilnego z OpenAI lub Anthropic. Praca w wątkach zyskuje wyszukiwanie we wszystkich podwątkach i zakładki; podwątki nie publikują już jednak komunikatów o postępach w wątku nadrzędnym, w którym pozostają widoczne tylko wyniki Land Changes.
🔗 Informacje o wydaniu Delta 0.18.0
Antigravity 2.19.1: pisanie bezpośrednio do podagentów
30 września — Antigravity 2.19.1 pozwala wysłać wiadomość bezpośrednio do podagenta z pola wpisywania, bez pośrednictwa agenta głównego; CLI oferowało już tę możliwość za pomocą składni @ od wersji 1.2.8 i 1.2.9. Wersja dodaje eksport do PDF wyrenderowanego Markdown z artefaktów i panelu bocznego, wraz z tabelami, blokami kodu i diagramami, oraz opcję cofania ograniczoną do rozmowy; wśród pięciu poprawek agenci niestandardowi wreszcie przestrzegają zasad globalnych i zasad projektu. Wdrażanie przebiega stopniowo i może potrwać kilka dni. CLI otrzymało 27 września niezauważoną wersję 1.2.12: sesja uruchomiona z kluczem GEMINI_API_KEY zatrzymuje się teraz natychmiast, gdy API Gemini zgłosi wyczerpanie dziennego limitu, osiągnięcie limitu wydatków lub wyczerpanie środków przedpłaconych, zamiast przez kilka minut ponawiać próby skazane na niepowodzenie.
🔗 Historia zmian aplikacji Antigravity · Historia zmian CLI Antigravity
Krótkie wiadomości
- Copilot CLI 1.0.90 i 1.0.91 — Wersja 1.0.90 trafia do wydania stabilnego 30 września z GPT-6.1 Sol w selektorze modeli oraz poprawkami MCP i wznawiania sesji; wersja 1.0.91, z 1 października, dodaje polecenia
copilot sandbox cado zarządzania certyfikatem proxy swojej piaskownicy. 🔗 źródło - Codex CLI 0.159.3 — Opublikowana 30 września o 22:57 UTC zawiera tylko jeden backport: lokalne sesje zalogowane przez ChatGPT mogą wyświetlać opcjonalne przypomnienia o dokończeniu konfiguracji zabezpieczeń konta; zmiana ta znalazła się również w wersji 0.160.0. 🔗 źródło
- Wydanie nightly Gemini CLI — Wersja v0.64.0-nightly z 1 października usuwa zawieszanie się przy 100 % wykorzystania procesora w trybie headless i zapewnia atomowe zapisy wykonywane przez narzędzia plikowe; wydania stabilne i przedpremierowe pozostają bez zmian. 🔗 źródło
- Zed 1.23.1 w wersji przedpremierowej — Opublikowana 30 września wyświetla pliki JSONL i NDJSON w formie tabeli, dodaje ustawienie
agent.max_idle_retained_threadsi automatycznie ponawia zapytania, gdy model Google AI jest przeciążony. 🔗 źródło - Copilot w VS Code we wrześniu — Miesięczne podsumowanie wersji od 1.136 do 1.140 wskazuje kilka mniej nagłośnionych nowości, w tym wznawianie w VS Code rozmowy z Codex rozpoczętej w aplikacji ChatGPT, oznaczenie przedpremierowej wersji aplikacji oraz czaty otwierane bez obszaru roboczego. 🔗 źródło
- Wspólne planowanie w Delta — Na blogu Delta Nathan Sobo opisuje, jak trzech członków zespołu planuje w jednym wątku z Fable, a następnie Astra, korzystając z odizolowanego podwątku i podagenta zamiast z pliku
plan.md; nie ogłoszono żadnej nowej funkcji. 🔗 źródło - Innate w filmie Cursor — Cursor publikuje krótki portret filmowy Innate, siedmioosobowego zespołu budującego roboty do codziennych zastosowań, którego współzałożyciel Vignesh Anand twierdzi, że wykonuje on pracę 50 osób, nie precyzując, jak korzysta z Cursor. 🔗 źródło
- Przywoływanie zamiast skracania kontekstu — David Corvoysier, twórca funes, mierzy za pomocą Claude Code, że przywołanie poprzedniej sesji jego narzędziem pozwala znaleźć poprawne odpowiedzi przy zużyciu odpowiednio 8, 4 i 3 razy mniejszej liczby ważonych tokenów niż zachowanie całego kontekstu, w trzech samodzielnie wybranych zadaniach. 🔗 źródło
- Nowy panel GitHub — Widok łączący aktywne sesje agentów, issues i pull requests, z maksymalnie 12 elementami w każdej liście, staje się domyślny dla wszystkich; aktualności trafiają do zakładki Feed, a poprzedni układ pozostaje dostępny. 🔗 źródło
- API asynchronicznego scalania — Staje się ogólnie dostępne i zalecane do programowego scalania, zastępując synchroniczny endpoint REST i mutacje GraphQL; to jedyne API scalania obsługujące stosy pull requests. 🔗 źródło
- Dist-tags npm bez tokena — Konfiguracje zaufanej publikacji npm mogą otrzymać opcjonalne uprawnienie, domyślnie wyłączone, do zarządzania dist-tags przy użyciu krótkotrwałych danych uwierzytelniających OIDC zamiast długoterminowego tokena dostępu. 🔗 źródło
- Retencja w GitHub Actions — Checks, uruchomienia workflow i statusy, w tym pochodzące z aplikacji zewnętrznych, podlegają teraz ustawieniom retencji artefaktów i logów i są usuwane po upływie tego okresu, wynoszącego maksymalnie 90 dni dla publicznych repozytoriów, bez możliwości przywrócenia. 🔗 źródło
- Code scanning i nieaktywne repozytoria — Zaplanowane cotygodniowe analizy code scanning i GitHub Code Quality uruchamiają się teraz dopiero po analizie wywołanej przez push lub pull request, aby nie sprawiać już wrażenia, że nieaktywne repozytorium pozostaje aktywne przez kolejne sześć miesięcy. 🔗 źródło
- Pokrycie kodu — Akcja
upload-code-coveragew GitHub Code Quality nie powoduje już niepowodzenia CI po pushu do gałęzi, dla której nie otwarto jeszcze pull requesta. 🔗 źródło - Deklaracje dostępności — Plik
ACCESSIBILITY.mdumieszczony w katalogu głównym, w.github/lub wdocs/jest wyróżniany na stronie głównej repozytorium we wszystkich planach github.com, a funkcja ta trafi również do GitHub Enterprise Server 3.24. 🔗 źródło - Actions Runner Controller 0.15.0 — Kontroler Kubernetes dla samodzielnie hostowanych runnerów aktualizuje zasoby w miejscu podczas aktualizacji do wersji poprawkowych, umożliwia konfigurowanie czasu oczekiwania na zatrzymanie, limitów klienta Kubernetes i współbieżności kontrolerów oraz zmniejsza obciążenie generowane przez swoje zapytania. 🔗 źródło
- Grok Bot wychodzi z inicjatywą — Główny Bot użytkownika wykrywa teraz zadania, które może przejąć, i proponuje, że się nimi zajmie; wdrożenie jest rozłożone na kilka godzin, a sugestie te nie wliczają się do limitów użycia, bez wskazania planów ani krajów. 🔗 źródło
- Genspark i Azure Cosmos DB — Wpis na blogu Azure Cosmos DB, napisany z perspektywy Genspark, wyjaśnia, jak część przetwarzania w tle wykorzystuje globalne indeksy wtórne, aby nie spowalniać już sesji agentów działających na żywo; nie podano żadnych liczb. 🔗 źródło
- Relacja użytkowniczki Genspark — Seulki Kang, z piętnastoletnim doświadczeniem w marketingu, mówi, że przygotowuje kompletny zestaw materiałów do kursu w 5 godzin zamiast 30, łącząc swoje wcześniejsze dokumenty z SecondBrain, a następnie z AI Slides; brak nowości produktowych. 🔗 źródło
- Albertsons i OpenAI — Sieć handlowa z ponad 2 200 sklepami rozszerza partnerstwo obejmujące ChatGPT Enterprise dla wybranych zespołów o API na potrzeby rozwiązań dla klientów i analiz promocji oraz promuje swój plugin Safeway w ChatGPT, ogłoszony 5 sierpnia. 🔗 źródło
- Wieczne uzupełnienie — OpenAI publikuje pierwszy esej z serii o przyszłej gospodarce, autorstwa Hemantha Asirvathama i Elliotta Mokskiego, którzy zaznaczają, że wypowiadają się we własnym imieniu: przeważająca część inteligencji maszyn mogłaby służyć realizacji zadań zamiast dokonywaniu przełomów. 🔗 źródło
- Perplexity i konsultanci — Przewodnik porównuje dziesięć narzędzi IA dla konsultantów, od AlphaSense po Qwilr, z cenami zweryfikowanymi we wrześniu; jego FAQ przypomina, że w bezpłatnym planie Perplexity trenuje swoje modele na danych użytkowników, chyba że wyrażą sprzeciw. 🔗 źródło
- Luma Variants — Funkcja, zapowiedziana poprzedniego dnia bez szczegółów, trafia do wszystkich użytkowników Luma: na podstawie zatwierdzonej reklamy statycznej tworzy jej warianty w pięciu standardowych formatach, od 9:16 do 16:9, oraz w wielu językach, bez ogłoszonej ceny. 🔗 źródło
- HeyGen Professional Voice Clone — Według wrześniowego podsumowania HeyGen udostępnia przez API swój najwierniejszy klon głosu, trenowany na co najmniej 20 minutach nagrań (od 1 do 10 plików), po prywatnej wersji przedpremierowej uruchomionej 9 września. 🔗 źródło
- Pika i jej aplikacje — Pika deklaruje ponad 40 aplikacji na swojej nowej platformie i prezentuje dwie z nich: Podcast Video, która tworzy debatę dwóch postaci, oraz Color Grade, która wykonuje korekcję barwną obrazu lub klipu, bez podania daty ani ceny. 🔗 źródło
- ElevenLabs w Beneluksie — ElevenLabs otwiera biura w Brukseli i Amsterdamie oraz planuje trzykrotnie powiększyć tamtejsze zespoły; u operatora KPN skuteczność rozpoznawania kodów pocztowych wzrasta z 64 % do 82 %, a agent weryfikacyjny obsługuje około 60 000 połączeń tygodniowo. 🔗 Niderlandy · 🔗 Belgia
- Skills DOCA od NVIDIA — W przypadku 65 rzeczywistych promptów deweloperów agenci kodu wyposażeni w te skills dla DPU BlueField spełniają 100 % kryteriów oceny, wobec 19 % bez nich; opublikowano je na GitHub. 🔗 źródło
- DIN Deploy — NVIDIA publikuje przykłady open source w C++ do lokalnego uruchamiania modeli z ONNX Runtime i TensorRT RTX pod Windows i Linux; na DGX Spark Parakeet TDT transkrybuje na GPU 206 razy szybciej niż w czasie rzeczywistym, wobec 14 razy na CPU. 🔗 źródło
- Nemotron 3.5 ASR i dialekty saudyjskie — Tutorial NVIDIA dostraja model na dialektach najdi i hijazi: wskaźnik błędów słownych spada z 55,05 % do 29,96 % w 12 000 kroków na dwóch RTX PRO 6000, a wyniki dla angielskiego i arabskiego w FLEURS również nieznacznie się poprawiają. 🔗 źródło
- System rekomendacji HSTU na Dynamo-Triton — NVIDIA obsługuje generatywny system rekomendacji HSTU z PyTorch AOTInductor i cache KV: w najlepszym przypadku, na RTX PRO 6000, działa do 4,47 i 5,93 razy szybciej w zależności od liczby warstw, czyli 0,423 i 0,678 ms na zapytanie. 🔗 źródło
- Rentowność fabryk IA — We wpisie przedstawiającym swoje stanowisko NVIDIA wycenia fabrykę IA na około 60 milionów dolarów za megawat i przytacza dane SemiAnalysis: Vera Rubin NVL72 kosztuje do 45 razy mniej za milion tokenów niż GB300 NVL72 w przypadku DeepSeek V4 Pro, wobec 35 razy mniej podawanych 24 sierpnia. 🔗 źródło
- huggingface_hub 2.1.0 — Biblioteka automatycznie ponawia nieudane Jobs, zmienia ich harmonogram bez ponownego tworzenia, odczytuje pozostały limit ZeroGPU i pobiera pliki Xet przez
hf_xet: pobranie pliku parquet o rozmiarze 2 Go skraca się z około 120 do 7 sekund na HF Jobs; trzy zmiany łamiące kompatybilność. 🔗 źródło - ML Intern i MCP — Hugging Face podłącza źródła danych MCP do ML Intern, trybu HuggingChat trenującego modele, aby dostrajać otwarte modele na własnych danych biznesowych; ogłoszeniu nie towarzyszą żadne oficjalne liczby. 🔗 źródło
- Hugging Face i Open Source for Science Fund — Obaj partnerzy chcą zidentyfikować biblioteki, od których najbardziej zależą twórcy modeli naukowych, i wesprzeć ich opiekunów, bez podania kwoty ani harmonogramu. 🔗 źródło
- Milion treningów z TRL — Według telemetrii przytoczonej przez Quentina Gallouèdeca biblioteka Hugging Face do post-trainingu odnotowuje milion treningów miesięcznie, z celem miliona tygodniowo; metody liczenia nie opublikowano. 🔗 źródło
- Milion zbiorów danych w Hub — Trzech autorów pokazuje, że konta organizacji publikują około 19 % zbiorów, ale odpowiadają za połowę pobrań, a Stany Zjednoczone mają 390 spośród 1 000 najczęściej pobieranych zbiorów. 🔗 źródło
- Osiem VLM na RTX 3090 — Aakash Gupta z ThinkEvolve pokazuje, że przy takiej samej dokładności Qwen3-VL-8B przetwarza każde zapytanie 2,2 razy szybciej niż Qwen3.8-27B, ale wykonanie zadania obejmującego 7 329 wywołań zajmuje mu 18,88 godziny zamiast 7,53, ponieważ nie wykorzystuje ponownie cache prefiksu. 🔗 źródło
- GLiNER2.5-Decide kontra layax — Aravindowi Vijayakumarowi nie udaje się certyfikować żadnego progu ufności dla modelu Fastino, wobec 10 udanych prób na 10 dla layax, jego własnego narzędzia, dokładniejszego o 20 do 23 punktów i około pięć razy szybszego. 🔗 źródło
- David Ha i orkiestratory — W felietonie dla Nikkei Asia współzałożyciel i PDG Sakana AI ocenia, że wartość przesunie się z wag modelu ku inteligencji łączącej wiele modeli, a suwerenność definiuje jako odporność łańcucha dostaw. 🔗 źródło
- Dyfuzja wideo na TPU — Trzech inżynierów Google skraca odszumianie wideo 1440p z 2 471 do 1 461 sekund na ośmiu układach TPU v6e, czyli przyspiesza je 1,69 razy, dzięki mechanizmowi sparse attention w Sparse VideoGen i zoptymalizowanemu kernelowi Splash Attention. 🔗 źródło
Co to oznacza
Agenci kodu stają się programowalni przez swoich użytkowników. Dzięki modom Claude Code udostępnia swoje wewnętrzne zdarzenia małym funkcjom TypeScript, posuwając się aż do przekształcania własnych funkcji w wymienne mody; dzięki dynamicznym workflow GitHub pozwala zapisać w kodzie orkiestrację podagentów, zamiast pozostawiać Copilotowi decyzję o podziale za każdym razem. Przewodnik FineEnvs przypomina, dlaczego harness jest równie ważny jak model: te same wagi rozwiązują 62 % zadań w jednym harnessie i 33 % w innym. Wymaga to jednak zaufania. Mod ma taki sam dostęp do komputera jak Claude Code, copilot workflow run nie wyświetla żadnego monitu, a sterowanie aplikacjami desktopowymi może wykonywać działania na zalogowanych kontach. Obaj dostawcy odpowiadają domyślnym wyłączeniem sterowania pulpitem, weryfikacją przed instalacją (claude plugin validate) w przypadku modów oraz regułami firmowymi, które mają pierwszeństwo.
IA wymusza też nowe filtry na tych, którzy otrzymują jej wyniki. GitHub porządkuje i ogranicza liczbę prywatnych zgłoszeń podatności, ponieważ raporty generowane przez IA zalewają opiekunów projektów; Google DeepMind proponuje oznaczać znakami wodnymi białka zaprojektowane przez IA, aby dostawcy syntezy ADN wiedzieli, skąd pochodzi nieznana sekwencja. W obu przypadkach celem nie jest zakazanie IA, lecz uwidocznienie jej wykorzystania: z jednej strony pole do zadeklarowania pomocy IA, z drugiej weryfikowalny podpis.
W firmach adopcję mierzy się już konkretnymi zastosowaniami. Barclays wyznacza cel, by pod koniec 2026 roku 50 % deweloperów korzystało z Claude Code, i zleca sortowanie 120 000 e-maili dziennie, American Express czyni swoją kartę Business przepustką do Skills w Perplexity Computer, wspierając to darmowymi kredytami, a Anthropic wykorzystuje limity użycia jako narzędzie zachęty, przez dwa tygodnie zmniejszając o połowę naliczane zużycie za pracę wykonywaną po utworzeniu artefaktu. Dla szerokiego grona użytkowników asystenci wkraczają do konkretnych codziennych czynności: odczytać menu osobie niewidomej, przymierzyć ubranie przed zakupem, narysować wykres giełdowy w rozmowie.
Wreszcie, liczby dotyczące modeli trzeba odczytywać z uwzględnieniem metod pomiaru. Ai2 zaznacza, że jego pomiar dla 1 200 miliardów parametrów ocenia system, a nie wytrenowany model, Cloudflare dobiera benchmarki i przyznaje, że Jev nadal prowadzi w When2Call i BRIGHT, a ranking wideo Artificial Analysis umieszcza Wan 3.0 na pierwszym miejscu z nakładającymi się przedziałami ufności. FLUX 3 Image podąża utartą już ścieżką: komercyjne wagi na licencji od razu, otwarte wagi później, bez podania daty.
Źródła
- Dostosuj Claude Code za pomocą modów w TypeScript (claude.com)
- Przewodnik wprowadzający do modów na claude.dev
- Dokumentacja modów Claude Code
- Reakcja Borisa Cherny’ego na X
- Informacje o wydaniu Claude Code 2.1.287
- Changelog GitHub dotyczący sterowania aplikacjami desktopowymi
- Changelog GitHub dotyczący dynamicznych workflowów
- Ogłoszenie FLUX 3 Image przez @bfl_ai
- Strona modelu FLUX 3 Image
- Guided Vision w Gemini Live (blog Google)
- Informacje o wydaniu ChatGPT
- Interaktywne wykresy Perplexity Computer
- Oferta dotycząca artefaktów ogłoszona przez @claudeai
- Warunki oferty dotyczącej artefaktów (centrum pomocy Claude)
- Barclays i Claude (Anthropic)
- Wpis Perplexity o American Express
- Strona partnerstwa Perplexity z American Express
- Ogłoszenie Wan 3.0 przez @Alibaba_Wan
- Ranking AA-Video-T2V v2.0 od Artificial Analysis
- Utopai X w rankingu Artificial Analysis
- Project Continuum od @runwayml
- Ogłoszenie Sessions przez @synthesiaIO
- Strona Synthesia Sessions
- SynthID Bio (Google DeepMind)
- Nauka ukształtowana przez Claude (Anthropic Science)
- Olmo-core 3 (Ai2)
- Wydanie Olmo-core v3.0.0
- Clef i Clef-flash (blog Cloudflare)
- Clef na Hugging Face
- Przewodnik FineEnvs po RL z wieloma harnessami
- Karta Grok 4.7 w Google Cloud
- Ogłoszenie Grok 4.7 w Google Cloud przez @SpaceXAI
- Ustrukturyzowane formularze prywatnych zgłoszeń podatności
- Dzienne limity prywatnych zgłoszeń podatności
- Codex CLI 0.160.0
- Informacje o wydaniu Delta 0.18.0
- Changelog aplikacji Antigravity
- Changelog CLI Antigravity
- Copilot CLI 1.0.91
- Codex CLI 0.159.3
- Wydanie Nightly Gemini CLI z 1 października
- Wersja zapoznawcza Zed 1.23.1
- Wrześniowe podsumowanie Copilot w VS Code
- Wspólne planowanie w Delta
- Profil Innate autorstwa Cursor
- Benchmark odtwarzania informacji z sesji za pomocą funes
- Nowy panel GitHub
- API asynchronicznego scalania GitHub
- Dist-tags i zaufane publikowanie w npm
- Retencja w GitHub Actions
- Code scanning i nieaktywne repozytoria
- Przesyłanie danych o pokryciu kodu
- Deklaracje dostępności repozytoriów
- Actions Runner Controller 0.15.0
- Sugestie Grok Bot
- Genspark i Azure Cosmos DB
- Wypowiedź Seulki Kang (Genspark)
- Albertsons Companies i OpenAI
- Wieczne dopełnienie (OpenAI)
- Przewodnik Perplexity po narzędziach IA dla konsultantów
- Luma Variants
- Wrześniowe podsumowanie HeyGen
- Aplikacje Pika
- ElevenLabs w Niderlandach
- ElevenLabs w Belgii
- Skills DOCA firmy NVIDIA
- DIN Deploy firmy NVIDIA
- Nemotron 3.5 ASR i dialekty saudyjskie
- System rekomendacji HSTU na Dynamo-Triton
- Rentowność fabryk IA (NVIDIA)
- huggingface_hub 2.1.0
- ML Intern i źródła danych MCP
- Open Source for Science Fund i Hugging Face
- Milion treningów z TRL
- Milion zbiorów danych w serwisie Hub
- Osiem VLM przetestowanych na RTX 3090
- GLiNER2.5-Decide w porównaniu z layax
- Artykuł opiniotwórczy Davida Ha udostępniony przez Sakana AI
- Przyspieszona dyfuzja wideo na TPU