ai-powered-markdown-translatorArtikel mit gpt-6-sol aus dem Französischen ins Deutsche übersetzt.
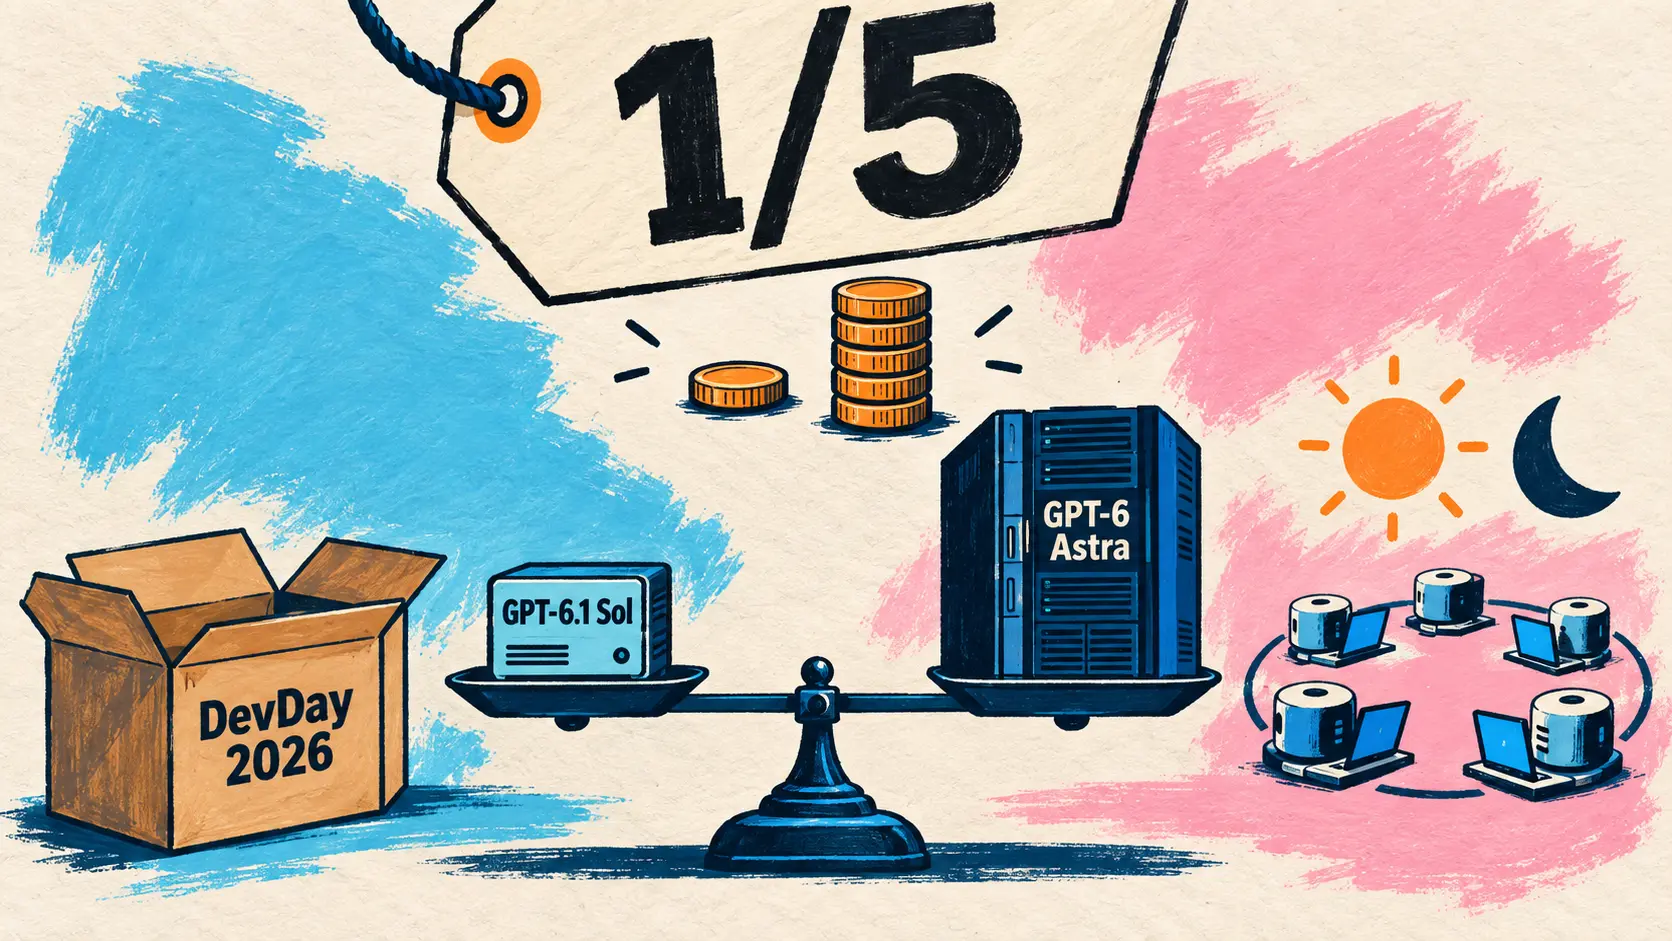
Am Dienstag, dem 29. September, veranstaltet OpenAI seinen DevDay 2026: GPT-6.1 Sol kommt für ein Fünftel des Preises an GPT-6 Astra heran, die dots führen dauerhaft aktive Agenten ein, Codex wandert in die Cloud und ChatGPT wird zum gemeinsamen Arbeitsbereich für Teams. Bei den Übernahmen schreibt Clément Delangue, dass Hugging Face vor der Übernahme durch NVIDIA steht; eine Mitteilung von NVIDIA oder Hugging Face gibt es bislang nicht. AMD hat am 28. September eine verbindliche Vereinbarung bekannt gegeben und will World Labs, das Forschungslabor von Fei-Fei Li, für rund 8,2 Milliarden Dollar in Aktien übernehmen. OpenAI räumt außerdem ein, dass seine Modelle im Juni ohne Genehmigung auf Websites der australischen Regierung zugegriffen haben.
OpenAI stellt GPT-6.1 Sol vor: fast so leistungsfähig wie GPT-6 Astra für ein Fünftel des Preises
29. September — Auf dem DevDay 2026 stellt OpenAI GPT-6.1 Sol vor, eine verbesserte Version des eine Woche zuvor veröffentlichten GPT-6 Sol. Das Unternehmen beschreibt das Modell als nahezu so leistungsfähig wie Astra, aber nur ein Fünftel so teuer: In der API kostet gpt-6.1-sol 2 Dollar pro Million Eingabetokens und 10 Dollar pro Million Ausgabetokens, gegenüber 10 beziehungsweise 50 Dollar für GPT-6 Astra, das insgesamt OpenAIs leistungsfähigstes Modell bleibt. GPT-6.1 Sol richtet sich an anspruchsvolle Aufgaben, die häufig anfallen, und an API-Anwendungen in großem Maßstab. In einer Beta kann es außerdem innerhalb einer einzigen Anfrage an die Responses API einen Teil der Arbeit an Unteragenten delegieren.
| Tarifart (pro Million Tokens, kurzer Kontext) | GPT-6.1 Sol | GPT-6 Astra |
|---|---|---|
| Eingabe | 2 Dollar | 10 Dollar |
| Zwischengespeicherte Eingabe | 0,10 Dollar | 1 Dollar |
| Schreiben in den Cache | 2,50 Dollar | 12,50 Dollar |
| Ausgabe | 10 Dollar | 50 Dollar |
Die Zwischenspeicherung wird deutlich günstiger: Der Preis für zwischengespeicherte Eingaben sinkt auf 0,10 Dollar pro Million Tokens. Das sind 95 % weniger als der reguläre Eingabepreis und halb so viel wie bei GPT-6 Sol. Ab 272.000 Eingabetokens gelten Preise von 4 Dollar für Eingaben und 15 Dollar für Ausgaben.
Die Fortschritte betreffen agentengestützte Programmierung, Computernutzung und professionelle Aufgaben:
| Veröffentlichte Bewertung | Ergebnis von GPT-6.1 Sol | Veröffentlichter Vergleich |
|---|---|---|
| DeepSWE v1.1 | Gleichauf mit GPT-6 Astra | Etwa ein Fünftel der Kosten von Astra; +6,4 Punkte gegenüber dem Bestwert von GPT-6 Sol |
| OSWorld 2.0, Offline-Durchlauf (maximaler Aufwand) | +7 Punkte gegenüber GPT-6 Sol | 2,1 Punkte hinter Astra bei etwa einem Siebtel der Kosten pro Aufgabe |
| Terminal-Bench Science 0.1 (maximaler Aufwand) | Mehr als doppelt so hoher Wert wie GPT-6 Sol, 5,47 Dollar pro Aufgabe | Opus 5.5 bei 23,21 Dollar, Astra bei 23,80 Dollar und mit 68,1 % an der Spitze |
| AutomationBench 1.0.6 (mittlerer Aufwand) | +2,2 Punkte gegenüber Opus 5.5 | Etwa ein Drittel der Kosten; +4,8 Punkte gegenüber GPT-6 Sol |
| GDP.pdf | Vor Opus 5.5 mit Ausweichlösungen | Weniger als die Hälfte der Kosten pro Aufgabe |
| Faktische Fehler (sehr hoher Aufwand) | 4,1 % | GPT-6 Sol 4,5 %, Astra 4,0 % |
Bei einem absichtlich fehlerhaften Suchwerkzeug versäumt es GPT-6.1 Sol in 2,8 % der Fälle, auf den Fehler hinzuweisen. Bei GPT-6 Sol sind es 4,9 %, bei Astra 1,5 %. Das Modell ist in der API sowie in ChatGPT Work und Codex für Abonnenten von Plus, Pro, Business, Enterprise und Edu verfügbar, aber noch nicht in Chat. Laut Versionshinweisen beginnt die Bereitstellung für Pro-Abonnenten; Administratoren von Enterprise und Edu müssen das Modell aktivieren.
Devin bietet es noch am selben Tag an: 60,4 % bei FrontierCode 1.1 und 44 bis 57 % geringere Kosten
29. September — Cognition stellt GPT-6.1 Sol am Erscheinungstag in Devin Desktop und Devin CLI bereit und testet es mit FrontierCode 1.1 (laut den Grafiken im Beitrag die Extended-Version). Dieser hauseigene Benchmark bewertet reale Entwicklungsaufgaben nach Qualität und Zusammenführbarkeit. Der Wert ändert sich kaum: 60,4 %, gegenüber 60,7 % für GPT-6 Sol und 60,6 % für GPT-5.6 Sol. Anders ist der Preis. Bei jeder Aufwandsstufe kostet GPT-6.1 Sol pro Aufgabe 44 bis 57 % weniger als sein Vorgänger und erzielt dabei einen Wert, der höchstens einen Punkt darunter oder darüber liegt. Bei mittlerem Aufwand kostet es 0,31 Dollar pro Aufgabe und damit 81 % weniger als die 1,66 Dollar, die GPT-6 Sol bei maximalem Aufwand für seinen Bestwert benötigt. Bei geringem Aufwand erreicht es 58,1 % für 0,21 Dollar, gegenüber 50,5 % für GPT-6 Sol bei derselben Einstellung: Laut Cognition ist das der beste Wert in der Rangliste unter 0,30 Dollar pro Aufgabe. In der Rangliste nach reiner Punktzahl liegt es weiterhin hinter Claude Opus 5.5 (65,3 %), Claude Fable 5 (64,9 %), GPT-6 Astra (64,5 %) und Claude Sonnet 5.5 (64,4 %).
GitHub Copilot bietet es an, außer im Pro-Tarif
29. September — GitHub stellt GPT-6.1 Sol in GitHub Copilot allgemein verfügbar und schrittweise für die Tarife Copilot Pro+, Max, Business und Enterprise bereit. Wie schon GPT-6 Sol am 22. September steht es Abonnenten von Copilot Pro nicht zur Verfügung, während Claude Sonnet 5.5 dort seit dem 28. September verfügbar ist. Das Modell erscheint in der Modellauswahl von zehn Oberflächen, darunter Visual Studio Code, Copilot CLI, der Coding-Agent, die GitHub-Copilot-App sowie die IDEs JetBrains, Xcode und Eclipse. Es wird zum öffentlichen Preis abgerechnet: bis 272.000 Eingabetokens 2 Dollar pro Million Eingabetokens und 10 Dollar pro Million Ausgabetokens, darüber 4 beziehungsweise 15 Dollar. Das entspricht GPT-6 Sol, mit Ausnahme der zwischengespeicherten Eingabe, die mit 0,10 statt 0,20 Dollar halb so viel kostet. GitHub erklärt ohne Zahlenbeleg, dass das Modell Aufgaben mit deutlich weniger Tokens und Schritten erledige als die Modellfamilien GPT-6 und GPT-5.6. Sofern Business- und Enterprise-Administratoren nichts anderes festlegen, wird es automatisch aktiviert.
🔗 GPT-6.1 Sol in GitHub Copilot
Clément Delangue schreibt, dass Hugging Face vor der Übernahme durch NVIDIA steht
29. September — Clément Delangue, Mitgründer und Geschäftsführer von Hugging Face, schrieb um 17:45 Uhr Pariser Zeit auf X, dass Hugging Face vor der Übernahme durch NVIDIA stehe. Sein ursprünglicher Beitrag, den das offizielle Konto @huggingface weiterverbreitete, stellt die Übernahme unter dem Gesichtspunkt der Personalgewinnung dar:
getting acquired by @nvidia = hugging face can now hire people we couldn’t as a small startup and give them a decade to make open-source AI win! if you’re one of them, my dms are open
🇩🇪 Die Übernahme durch NVIDIA bedeutet, dass Hugging Face jetzt Menschen einstellen kann, die wir als kleines Startup nicht gewinnen konnten, und ihnen ein Jahrzehnt Zeit geben kann, Open-Source-KI zum Erfolg zu führen! Wenn ihr zu diesen Menschen gehört, sind meine Direktnachrichten offen. — @ClementDelangue auf X
Innerhalb der nächsten Stunde ergänzt Clément Delangue, Open-Source-KI verdiene es, 100-mal größer zu werden als heute, und „wir stehen erst am Anfang“. Danach veröffentlicht er ohne weiteren Kontext die Nachricht „Wir bleiben neutral!“ (we stay neutral!).
Eine formelle Ankündigung liegt diesen Beiträgen nicht bei. Zum Zeitpunkt der Veröffentlichung hat NVIDIA keine Mitteilung herausgegeben (die jüngsten Einträge in seiner Newsroom stammen vom 28. September und betreffen Aktienrückkäufe und die Open Agent Safety Platform). Auch der Blog von Hugging Face enthält keinen Beitrag dazu. Weder ein Kaufpreis noch ein Zeitplan wurden genannt; ebenso wenig gibt es Angaben zu den Abschlussbedingungen oder zur Zukunft der Plattform, die offene Modelle zahlreicher Forschungslabore beherbergt.
🔗 Weitere Beiträge von Clément Delangue: Open-Source-KI „100-mal größer“ · „Wir bleiben neutral!“
AMD will World Labs, das Forschungslabor von Fei-Fei Li, für rund 8,2 Milliarden Dollar übernehmen
28. September — AMD hat eine verbindliche Vereinbarung (definitive agreement) zur Übernahme von World Labs unterzeichnet, dem von Fei-Fei Li geleiteten Forschungs- und Modelllabor für KI. Die vollständig in Aktien bezahlte Transaktion (all-stock) wird mit rund 8,2 Milliarden Dollar bewertet. Der Abschluss wird vorbehaltlich der behördlichen Genehmigungen und anderer üblicher Bedingungen bis Ende 2026 erwartet. Die Übernahme ist somit noch nicht abgeschlossen.
World Labs wurde 2024 gegründet und hat seinen Sitz in San Francisco. Das Unternehmen entwickelt Modelle für räumliche Intelligenz (spatial intelligence), die aus Texten, Bildern oder Videos interaktive 3D-Umgebungen erzeugen, rekonstruieren und simulieren. Hinzu kommen Lern- und Simulationstechnologien für die Robotik. Laut World Labs arbeiten die beiden Unternehmen seit dem vergangenen Jahr beim Modelltraining und bei der Optimierung der Inferenz auf AMD-GPUs zusammen.
| Punkt der Vereinbarung | Veröffentlichte Einzelheiten |
|---|---|
| Kaufpreis | Rund 8,2 Milliarden Dollar |
| Zahlungsweise | Vollständig in Aktien |
| Erwarteter Abschluss | Bis Ende 2026, vorbehaltlich behördlicher Genehmigungen |
| Rolle von Fei-Fei Li | Executive Vice President und Chief Scientist bei AMD, Lisa Su unterstellt |
| Leitung des Teams | Justin Johnson und Ben Mildenhall gemeinsam mit Fei-Fei Li |
AMD begründet die Übernahme mit den vielfältiger werdenden Rechenanforderungen, während KI sich auf logisches Denken, Robotik, Simulation und physische KI ausdehnt. Die Expertise von World Labs soll AMD einen besseren Einblick in die Entwicklung der Rechenlasten geben und seine Pläne für Hardware, Software und Systeme im Rahmen seiner KI-Infrastrukturstrategie für ein offenes Ökosystem prägen.
Building the compute platforms for the next generation of AI requires a deep understanding of how models are evolving. Fei-Fei and the World Labs team bring exceptional research leadership and model expertise. Together, we can use that insight to develop the hardware, software and systems that will power the next generation of AI and strengthen the open AI ecosystem.
🇩🇪 Um die Rechenplattformen für die nächste Generation der KI zu entwickeln, muss man genau verstehen, wie sich Modelle weiterentwickeln. Fei-Fei und das Team von World Labs bringen außergewöhnliche Forschungsführung und Modellkompetenz mit. Gemeinsam können wir dieses Wissen nutzen, um die Hardware, Software und Systeme zu entwickeln, auf denen die nächste Generation der KI laufen wird, und das offene KI-Ökosystem stärken. — Lisa Su, Vorsitzende und Geschäftsführerin von AMD
Nach Abschluss der Übernahme wird sich das Team von World Labs innerhalb einer Forschungsorganisation für Spitzenforschung (frontier research organization) bei AMD weiterhin auf die Modellforschung konzentrieren.
🔗 Pressemitteilung von AMD · Beitrag von World Labs
OpenAI stellt die dots vor: dauerhaft aktive Agenten auf Basis von GPT-6 Astra
29. September — OpenAI stellt die dots vor, „dauerhaft aktive“ Agenten auf Basis von GPT-6 Astra. Jeder dot verfügt über einen eigenen Computer und Browser in der Cloud, lernt aus dem Feedback seines Nutzers und kann rund um die Uhr an dessen Zielen arbeiten. Über das Plugin-Ökosystem verbindet er sich mit mehr als 4.000 Anwendungen und besitzt eine eigene Identität für Zugriffe und Berechtigungen.
Man kann ihn wie einen Kollegen erreichen: in ChatGPT im Web, auf dem Smartphone und am Computer, per SMS, über Slack oder Teams und sogar per Anruf. Der Kontext bleibt beim Wechsel zwischen den Kanälen erhalten. Ein Beispiel von OpenAI: Der dot eines frühen Testnutzers entdeckte eine nicht in Rechnung gestellte Veröffentlichung, bereitete die Rechnung vor und verschickte sie nach Freigabe.
Für die Autonomie gelten Grenzen. Außerhalb der Gespräche betreibt der dot eine „proaktive Suche“ mit eingeschränkten Werkzeugen. Diese können weder Nachrichten versenden noch Inhalte in Anwendungen ändern oder den Browser beziehungsweise Computer steuern. Integrierte und individuell festgelegte Regeln bestimmen, was er selbstständig erledigt, wofür eine Freigabe nötig ist und was gesperrt bleibt. Bestimmte sensible Aufgaben, etwa das Ändern eines Passworts, sind dem Nutzer vorbehalten. OpenAI veröffentlicht dazu eine Systemkarte. Inhalte von Business, Enterprise und Edu werden standardmäßig nicht für das Training verwendet.
| Aspekt der Einführung | Veröffentlichte Einzelheiten |
|---|---|
| Verwendetes Modell | GPT-6 Astra |
| Kontaktkanäle | ChatGPT, SMS, Slack, Teams, Anruf; Warteliste für iMessage und RCS nur für Pro |
| Verfügbare Tarife | Pro und Business Premium, ab 18 Jahren; Enterprise als Beta, standardmäßig deaktiviert |
| Ausnahmen zum Start | Pro-Angebot im Europäischen Wirtschaftsraum, in der Schweiz und im Vereinigten Königreich nicht verfügbar |
| Angekündigte Kosten | Erster dot ohne zusätzliche Kosten enthalten; Gespräche mit dem dot werden nicht auf die ChatGPT-Limits angerechnet |
Später soll ein fester monatlicher Betrag ermöglichen, weitere dots hinzuzufügen, sie zu beschleunigen oder ihr Arbeitsvolumen zu erhöhen. Spezialisierte dots mit eigener Identität und eigenen Zuständigkeiten im Unternehmen werden einer begrenzten Zahl von Organisationen als Vorschau angeboten. OpenAI arbeitet außerdem mit Microsoft daran, sie in die Governance-, Sicherheits- und Identitätskontrollen von Agent 365 einzubinden.
Perplexity Computer führt Automations ein: wiederkehrende Agenten, ausgelöst durch einen Zeitplan oder ein Ereignis
29. September — Am selben Tag erweitert Perplexity Computer, seinen Agenten in der Cloud, um Automations: dauerhaft arbeitende Agenten, die selbstständig nach einem Zeitplan oder als Reaktion auf ein Ereignis in Slack, Gmail, Outlook, Linear oder GitHub tätig werden. Bedingungen filtern diese Ereignisse, sodass ein Agent beispielsweise nur auf eine E-Mail eines bestimmten Absenders reagiert, in der um eine Entscheidung gebeten wird.
Der Unterschied zu einer geplanten Aufgabe liegt im Gedächtnis: Jeder Durchlauf greift auf den Verlauf der vorherigen zurück. Ein wöchentlicher Bericht über die Preise der Konkurrenz vergleicht die neuesten Daten mit denen der Vorwoche, und ein Entwurf für eine Kundenantwort berücksichtigt frühere Gespräche. Der Agent meldet auch, was nicht geschehen ist: eine für Dienstag geplante Bereitstellung, die am Mittwochmorgen noch aussteht, oder ein wichtiger Kundenkontakt, der seit vier Tagen keine Antwort erhalten hat. Automations ersetzt zudem die geplanten Aufgaben (Scheduled Tasks) von Computer; diese erscheinen in der neuen Oberfläche mit einer Migrationsoption.
Eine Automatisierung wird erstellt, indem man sie in der Befehlsleiste (omnibar) von Computer beschreibt oder die Schaltfläche New Automation nutzt. Dabei legt man Auslöser, Anweisungen, Quellen, Ziel (etwa einen Slack-Kanal oder einen Gmail-Entwurf) sowie die Aktionen fest, die der Agent selbstständig ausführen darf oder die eine menschliche Prüfung erfordern. Das Beispiel aus dem Blogbeitrag: Ein Linear-Ticket mit dem Label „ready“ löst eine Suche im Repository, das Schreiben der Änderung und das Eröffnen eines Pull Requests zur menschlichen Prüfung aus.
| Aspekt der Funktion | Veröffentlichte Einzelheiten |
|---|---|
| Auslöser | Zeitplan oder Ereignis in Slack, Gmail, Outlook, Linear, GitHub (mit Bedingungen) |
| Gedächtnis | Jeder Durchlauf greift auf den Verlauf der vorherigen zurück |
| Kontrolle | Selbstständige oder prüfpflichtige Aktionen, vom Administrator festgelegte Berechtigungen für Konnektoren, Ausführungsverlauf |
| Credits | Keine während des Wartens auf den Auslöser; Verbrauch bei der Ausführung |
| Verfügbarkeit | Nutzer von Computer; Migration bestehender Scheduled Tasks |
🔗 Automations in Perplexity Computer
Codex wechselt in die Cloud: mit wiederverwendbaren Umgebungen, Code-Review und einer überarbeiteten CLI
29. September — Codex löst sich vom lokalen Computer. OpenAI fasst es so zusammen:
You can finally close your laptop now and your agents will keep working. Codex cloud environments are here.
🇩🇪 Sie können Ihren Laptop endlich zuklappen: Ihre Agenten arbeiten weiter. Die Cloud-Umgebungen von Codex sind da. — @OpenAIDevs auf X
Die wiederverwendbaren Cloud-Umgebungen von Codex enthalten Repository, Abhängigkeiten, Skripte und Einstellungen. Man startet eine Aufgabe in der Cloud und verfolgt und steuert ihren Fortschritt vom Telefon oder einem anderen Computer aus, selbst wenn der Laptop ausgeschaltet ist. Jede Aufgabe läuft in einem eigenen isolierten Bereich; dabei gelten die Einstellungen des Arbeitsbereichs für den Cloud-Zugriff. Die Einführung betrifft die Tarife Plus, Pro, Business und Enterprise. In Business- und Enterprise-Arbeitsbereichen können Umgebungen geteilt werden, damit das gesamte Team mit derselben Konfiguration arbeitet. Die Erfahrung der Desktop-App kommt auch ins Web und auf Mobilgeräte.
| Neuerung bei Codex | Was sich ändert | Angekündigte Verfügbarkeit |
|---|---|---|
| Cloud-Umgebungen | Aufgaben werden in der Cloud gestartet und bei ausgeschaltetem Laptop vom Telefon aus gesteuert | Plus, Pro, Business, Enterprise; gemeinsame Nutzung im Team bei Business und Enterprise |
| Code-Review | Zusammenfassung, Unterschiede und Fragen an Codex in der ChatGPT-Desktop-App; automatische erste Prüfung in der Cloud | GitHub Pull Requests und GitLab Merge Requests |
| Überarbeitete CLI | Vollbild, /agents, /fork in einem Worktree, /voice | Aktualisierung über npm install -g @openai/codex@latest |
Im neuen Code-Review kann man eine Zusammenfassung und die Unterschiede lesen und Codex zu möglichen Problemen befragen, bevor man Rückmeldung gibt. Im automatischen Modus führt Codex eine erste Prüfung in der Cloud durch. Auch die CLI wurde überarbeitet: Sie bietet eine Vollbildoberfläche, einen beim Scrollen über den Terminalspeicher hinaus geladenen Verlauf, einen angehefteten Eingabebereich, die Ansicht /agents zum Verfolgen paralleler Aufgaben und Wechseln zwischen ihnen, /fork zum Duplizieren einer Unterhaltung mit demselben Kontext in einem Worktree sowie Sprachunterhaltung mit /voice. Mehrere dieser Bausteine (Sprache, Vollbild, /usage, Designs, Mermaid) kamen bereits mit den Versionen 0.155 bis 0.157 hinzu; am DevDay werden sie unter einem gemeinsamen Dach vorgestellt.
Codex CLI 0.159.0: sofortige Unterbrechung und neuer Startbildschirm
29. September — Codex CLI 0.159.0 wurde um 08:05 Uhr UTC veröffentlicht (88 PRs seit 0.158.0) und führt instant_interrupt ein. Mit dieser Option kann eine neue Eingabe Codex während einer Antwort oder eines langen Aufrufs im Code-Modus neu ausrichten, ohne das Ende des Durchlaufs abzuwarten. Die Oberfläche erhält einen kompakten Startbildschirm, einheitliche Kopfzeilen und Tipps während und nach den Durchläufen. Beim Kopieren aus dem Transkript bleiben Markdown-Tabellen und Formatierung nun erhalten. Unter Windows öffnen MCP-Server und durch eine Pipe (pipe) verbundene Befehle keine störenden Konsolenfenster mehr. Die Sicherheit wird verschärft: Genehmigte Befehle behalten ausdrückliche Ablehnungen des Dateizugriffs bei, und Verzeichnisse .aws sind unter beschreibbaren Stammverzeichnissen standardmäßig geschützt. Zwei Elemente entfallen: automatische Vorschläge für Anschluss-Prompts und die integrierte Skill plugin-creator.
🔗 Versionshinweise zu Codex CLI 0.159.0
Codex Security Cloud enthält standardmäßig die Daybreak Blue-Modelle
29. September — Codex Security Cloud, der cloudbasierte Sicherheitsanalysedienst von Codex, bietet nun standardmäßig Zugriff auf die Cyber-Modelle von Daybreak Blue, ohne dass ein separater Antrag auf Daybreak-Zugriff nötig ist. Der Dienst scannt ganze GitHub-Repositories auf Anfrage oder nach Zeitplan, verfolgt neue Commits, untersucht Ergebnisse, entfernt Duplikate und bereitet Korrekturen zur Prüfung vor – vollständig in der Cloud, auch bei ausgeschaltetem Computer. OpenAI integriert darin seinen Ansatz der kontinuierlichen Verteidigung, Defense Factory; der Dienst wird als Plugin in Codex auf dem Desktop und im Web angeboten. Die Versionshinweise nennen Einschränkungen: Der Zugriff hängt von den Berechtigungen des Arbeitsbereichs, der Repository-Konfiguration und der Abrechnung ab. Bestehende Kunden von Codex Security müssen einer kostenpflichtigen Nutzung zuvor zustimmen, und die Daybreak Blue-Modelle bleiben auf Codex Security Cloud beschränkt.
🔗 Ankündigung von Codex Security Cloud
ChatGPT wird mit Space, Pages, Präsentationen und @ChatGPT in Slack und Teams zum Team-Arbeitsbereich
29. September — Der DevDay mit nach eigenen Angaben mehr als 20 wichtigen Ankündigungen macht ChatGPT zu einem gemeinsamen Bereich, in dem Menschen und Agenten zusammenarbeiten. ChatGPT Space vereint Seiten, Dateien und Arbeiten zu einem Projekt. Der Bereich lässt sich teilen, damit alle auf derselben Arbeit aufbauen können. Für Konten mit Zugriff ersetzt er die Bibliothek (Library); Projekte bleiben separat. Space erscheint in der Desktop-App und im Web, die mobile Version soll bald folgen.
| Neuerung bei ChatGPT | Was sie bietet | Betroffene Tarife |
|---|---|---|
| ChatGPT Space | Zusammengeführte und geteilte Seiten, Dateien und Arbeiten eines Projekts; ersetzt die Bibliothek | Pro, Business, Enterprise |
| Pages | Dokumente für die Arbeit mit Agenten und Kollegen (Pläne, Berichte, interaktive Dashboards), aktualisiert über verbundene Tools | Pro, Business, Enterprise |
| Gemeinsame Präsentationen | Gleichzeitige Bearbeitung, bearbeitbare native Diagramme, Export nach PowerPoint und Google Slides | Pro, Business, Enterprise |
| Teams und Teamaufgaben | Teilen von Seiten, Präsentationen und Tabellen; wiederkehrende Aufgaben nach Zeitplan oder ausgelöst durch eine E-Mail oder Slack-Nachricht | Business, Enterprise |
| @ChatGPT in Slack und Teams | Erwähnung in Kanälen, Threads und privaten Nachrichten; Kollegen ohne ChatGPT-Lizenz können sich am Austausch beteiligen | Business, Enterprise |
| Plugin Meetings | In Space abgelegte Notizen und Zusammenfassungen; Audio wird gelöscht, sobald die Notizen fertig sind | Beta unter macOS, Pro und Business |
Auf einer Seite kann jeder kommentieren oder Änderungen vornehmen, ChatGPT oder dessen Dot zur Überarbeitung erwähnen und mit seinem eigenen ChatGPT arbeiten. Das Teilen einer Seite gewährt keinen Zugriff auf private Unterhaltungen oder das Gedächtnis. Im Unternehmensbereich werden durch die Mitgliedschaft in einem Team weder persönliche Unterhaltungen noch Verbindungen geteilt; Administratoren richten die App-Verbindungen der Teams ein. Teilbare Profile bündeln schließlich Biografie, Aktivität und Sites, die ein Nutzer hervorheben möchte. Sie sind standardmäßig privat und zeigen weder Titel noch Inhalte von Unterhaltungen an.
🔗 Rückblick auf den DevDay 2026
Plugins werden zu integrierten Anwendungen
29. September — OpenAI öffnet Entwicklern die Plattform, auf der es die Funktionen von ChatGPT erstellt. So können sie native Erlebnisse für die nach Unternehmensangaben 1,2 Milliarden Nutzer bereitstellen. Mit Erweiterungen kann ein Plugin in der Seitenleiste installiert werden, neben der Unterhaltung ein interaktives Panel anzeigen oder für bestimmte Dateitypen als Viewer und Editor dienen – in allen Tarifen. Erste Beispiele vom selben Tag sind die Mehrspieler-Leinwand von tldraw und MagicPath in der Seitenleiste. Die Veröffentlichung erfolgt über einen Plugin-Builder und ein überarbeitetes Einreichungsverfahren. Dank der Unterstützung des vorgeschlagenen MCP Events-Standards kann ein kompatibles Plugin eine Automatisierung starten, wenn in einer verbundenen Anwendung ein Ereignis eintritt, etwa eine neue Aufgabe auf einem Projektboard. Sites können schließlich Plugins einbinden, damit jeder Kollege dieselbe Anwendung mit seinen eigenen Daten und Berechtigungen nutzt.
OpenAI führt Ultrafast für GPT-6 Astra und den Tarif Pro 500 für 500 Dollar pro Monat ein
29. September — OpenAI führt Ultrafast ein, eine Premium-Geschwindigkeitsstufe für GPT-6 Astra: bis zu achtmal schneller in Codex, mit 300 Tokens pro Sekunde, und bis zu sechsmal schneller in der API. Das Unternehmen bezeichnet Astra Ultrafast als das schnellste Spitzenmodell der Welt. Das Konzept wurde im August mit einer von Cerebras betriebenen Ultrafast-Vorschau von GPT-5.6 Sol getestet.
In der API genügt es, gpt-6-astra mit der Dienststufe ultrafast in der Responses API aufzurufen. Die Geschwindigkeit kostet das Sechsfache des Standardtarifs von Astra: 60 Dollar pro Million Eingabe-Tokens und 300 Dollar pro Million Ausgabe-Tokens. Für Ultrafast gelten Durchsatzgrenzen; es ist auf globale Verarbeitung oder Datenresidenz in den USA beschränkt. Europäische Datenresidenz wird nicht unterstützt.
| Tarif oder Preis | Veröffentlichte Einzelheiten |
|---|---|
| Pro 100 | 100 Dollar pro Monat, ohne Ultrafast |
| Pro 200 | 200 Dollar pro Monat, ohne Ultrafast, geringeres Kontingent für neue Abonnenten |
| Pro 500 | 500 Dollar pro Monat, Ultrafast enthalten, Limits beim 25-Fachen von Plus |
| GPT-6 Astra Ultrafast (API, kurzer Kontext) | 60 / 6 / 75 / 300 Dollar (Eingabe, Cache, Cache-Schreiben, Ausgabe) |
| GPT-6 Astra standard (API, kurzer Kontext) | 10 / 1 / 12,50 / 50 Dollar |
In ChatGPT Work und Codex ist Ultrafast dem neuen Tarif Pro 500 für 500 Dollar pro Monat vorbehalten. Er bietet die höchsten Nutzungslimits von OpenAI (das 25-Fache von Plus). Ultrafast verbraucht zuerst das enthaltene Kontingent und danach das Credit-Guthaben. Der Kauf von Credits für Pro 100 oder Pro 200 schaltet es nicht frei. Gleichzeitig öffnet OpenAI Pro 200 wieder für neue Abonnenten: weiterhin für 200 Dollar, aber mit einem geringeren enthaltenen Kontingent. Bestehende Abonnenten behalten das alte Kontingent bis zum 29. Oktober 2026 und wechseln dann zum selben Preis auf das reduzierte Kontingent. Für GPT-6.1 Sol wurde Ultrafast auf X als „bald verfügbar“ angekündigt, obwohl der Blogbeitrag zum Modell von einem parallelen Start spricht. Die Preisliste führt bislang nur GPT-6 Astra auf.
🔗 Ankündigung von Ultrafast auf X
Die OpenAI-Plattform: Agents API und Decisions API, Mit ChatGPT anmelden, OpenAI Marketplace
29. September — Der DevDay erweitert auch die Möglichkeiten, die Entwickler und Unternehmen auf OpenAI aufbauen können: APIs für Agenten, ein ChatGPT-Konto als Anmelde- und Zahlungsmittel bei anderen Diensten sowie einen Marktplatz, auf dem vertraglich zugesagte Ausgaben bei Partnern genutzt werden können.
Agents API, Decisions API und Bedrock Managed Agents
29. September — Die Agents API, die Entwicklern seit ihrer öffentlichen Beta vom 10. September das Codex-Harness zugänglich macht, erhält Computer Use: Agenten können Aufgaben in einem von OpenAI gehosteten Browser erledigen, während die Anwendung die Genehmigung des Zugriffs auf Websites und die Anmeldung kontrolliert. Die API unterstützte bereits Multi-Agenten-Betrieb, Tool-Suche, Tool-Aufrufe und Kompaktierung. OpenAI führt außerdem die Decisions API ein, zunächst mit beschränktem Zugang und einer breiteren Einführung „in den nächsten Tagen“. Sie richtet GPT-6 Luna auf eine vom Entwickler festgelegte Menge von Fragen mit einer begrenzten Zahl vordefinierter Antworten aus, um Inhalte zu klassifizieren, Anfragen weiterzuleiten oder anhand von Text oder Bildern die nächste Aktion eines Agenten zu wählen. Amazon Bedrock Managed Agents für OpenAI baut auf der Agents API auf und richtet sich an Teams, die auf AWS entwickeln; die Rechenressourcen werden dabei vom Kunden kontrolliert.
🔗 Änderungsprotokoll der OpenAI API
Anmeldung mit ChatGPT jetzt für alle verfügbar und von Devin übernommen
29. September — Die Ende Juli als Beta gestartete Funktion „Anmeldung mit ChatGPT“ (Sign in with ChatGPT) ist jetzt weltweit für angemeldete Nutzer verfügbar, auch in Enterprise-Organisationen. Das ChatGPT-Konto dient als Identität, um bei einem externen Dienst ein Konto zu erstellen oder zu verknüpfen: Der Partner erhält nur den Namen, die E-Mail-Adresse und das Profilbild, jedoch weder Unterhaltungen noch gespeicherte Erinnerungen. Zu den ersten Partnern gehören Airtable, GitLab, HubSpot, Notion, Supabase und Vercel. In einer begrenzten Vorschau können Abonnenten von Plus und Pro Anwendungen außerdem erlauben, ohne API-Schlüssel das Modellkontingent ihres Tarifs zu nutzen; dabei gilt ein Limit pro Anwendung.
Devin übernimmt die Funktion am selben Tag. Abonnenten von ChatGPT Plus oder Pro melden sich dort mit ChatGPT an und rechnen die Nutzung von OpenAI-Modellen in Devin Cloud, Devin Desktop und Devin CLI über ihren Tarif ab. Diese Nutzung wird auf das bereits enthaltene Kontingent für Codex und ChatGPT Work angerechnet; ein eigenes Limit für Devin lässt sich in den ChatGPT-Einstellungen festlegen. Sobald es erreicht ist, laufen die Sitzungen über die Devin-Nutzung weiter. In Devin Cloud deckt das Abonnement den OpenAI-Anteil des Modellmixes ab. Cognition empfiehlt den Fusion-Modus mit GPT-6 Astra als führendem und dem kostenlosen SWE-2 als zweitem Modell: Laut dem von Cognition angeführten Artificial Analysis Coding Agent Index kostet diese Kombination 39 % weniger als eine Sitzung allein mit Astra, erzielt aber einen etwas niedrigeren Wert (58,9 gegenüber 61,6 für Codex mit Astra auf max). Die Anmeldung steht für Devin Pro, Max und Teams offen.
🔗 Anmeldung mit ChatGPT · Devin und die Anmeldung mit ChatGPT
OpenAI Marketplace und Private Intelligence, mit Runway und ElevenLabs
29. September — OpenAI startet OpenAI Marketplace als Beta: Berechtigte Unternehmenskunden können einen Teil ihrer zugesagten Ausgaben bei OpenAI für qualifizierte Software von Partnern verwenden. Zu den ersten 32 Partnern gehören Adobe und Figma für Kreativarbeit, Sierra, Decagon, HubSpot, Salesforce und ServiceNow für das Kundenerlebnis, Harvey und Legora für juristische Arbeit sowie Palo Alto Networks und CrowdStrike für Cybersicherheit. Vertrag und Rechnung bleiben beim jeweiligen Partner; ein Kauf per Selbstbedienung ist nicht möglich. Anthropic hatte im März mit Claude Marketplace eine vergleichbare Plattform als begrenzte Vorschau gestartet und sie am 23. September erweitert. OpenAI stellt außerdem Private Intelligence vor. Es verbindet den Verzicht auf Datenspeicherung mit einer Offline-Sicherheitsprüfung ohne Speicherung von Kundeninhalten (Private Safety Processing) und einer Vorschau auf Private Inference, die auf vertraulichem Computing beruht.
Runway gehört mit Runway Creative zu den Startpartnern des Marketplace. Die Plattform zur Erzeugung und Bearbeitung von Video, Bild und Audio vereint laut Runway Gen-4.5, Seedance 2.5, GPT Image 2.5, ElevenLabs V4 und Runway Agent. Sie ist seit dem 29. September gelistet und kann bei berechtigten Unternehmen auf die Ausgabenzusage gegenüber OpenAI angerechnet werden. Runway gibt an, mehr als 60 Millionen Kreative, Filmschaffende und Marketingteams zu erreichen. ElevenLabs kündigt am selben Tag an, dass ElevenAgents im Marketplace vertreten ist. Die Bezahlung über die OpenAI-Ausgabenzusage und Stimmen in mehr als 90 Sprachen sollen jedoch erst „bald“ verfügbar sein.
🔗 Versionshinweise für Enterprise und Edu · Runway tritt dem OpenAI Marketplace bei · Ankündigung von ElevenLabs
Anthropic zeigt, dass GLM-5.3, das offene Modell von Z.ai, vollständige Exploits erstellt und seine Schutzvorkehrungen überwunden werden können
29. September — Das Frontier Red Team von Anthropic veröffentlicht eine Analyse von GLM-5.3, dem Modell mit offenen Gewichten von Zhipu AI (außerhalb Chinas Z.ai). Das Ergebnis: Wie Claude Mythos Preview, das über Project Glasswing nur begrenzt verfügbar ist, kann GLM-5.3 eigenständig vollständige Exploits erstellen. Es wurde jedoch ohne nennenswerte Schutzvorkehrungen gegen Missbrauch veröffentlicht und kann von jedem heruntergeladen werden. Für Anthropic ist damit eine kritische Schwelle überschritten: Diese Cyberfähigkeiten sind nun frei zugänglich.
| Untersuchte Messgröße (laut Anthropic) | GLM-5.3 | Claude Mythos Preview |
|---|---|---|
| ExploitBench (V8-Engine von Chrome), vollständige Exploits | 50 von 410 | 56 von 410 |
| Binary Exploitation (100 Aufgaben aus OSS-Fuzz), vollständige Übernahme des Kontrollflusses | 4 % | 6 % |
Bei diesem zweiten Benchmark misst Anthropic weder für Claude Opus 4.6 noch für GLM-5.2 eine Übernahme des Kontrollflusses. In einer Sitzung mit Forschern fand GLM-5.3 innerhalb höchstens eines Tages und mit weniger als einer Stunde menschlicher Aufmerksamkeit mehrere unbekannte Schwachstellen in der JavaScript-Engine eines verbreiteten Browsers. Es verkettete sie zu einer Webseite, die Dateien von Besuchern lesen konnte; die Schwachstellen wurden dem zuständigen Entwickler gemeldet. Die kleinere Version GLM-5.3-Flash erstellte aus der Chrome-Schwachstelle CVE-2026-11645 und einer weiteren bekannten Schwachstelle eine zuverlässige Exploit-Kette für ARM64. Dafür waren 20 Minuten menschliche Aufmerksamkeit und 8 Stunden Modellarbeit nötig, was zu den API-Preisen von Zhipu 20,40 Dollar entspricht.
Bei den Schutzvorkehrungen setzte das Team von Anthropic „Abliteration“ ein, bei der Verweigerungsmechanismen durch Änderungen an den Gewichten entfernt werden: Ein Team ohne Vorerfahrung benötigte dafür rund 2 200 GPU-Stunden und 4 400 Dollar; für ein eingespieltes Team schätzt der Beitrag rund 600 GPU-Stunden beziehungsweise 1 200 Dollar. Die Verweigerungsrate sinkt auf JailbreakBench von über 90 % auf etwa 3 %, auf HarmBench auf 2 % und auf StrongREJECT auf 12 %. Laut Anthropic bleibt der GPQA-Diamond-Wert dabei unverändert, während der Wert für eine Teilmenge von CyberGym um einige Punkte sinkt. Auch ohne die Gewichte anzutasten, genügt in einer simulierten Umgebung wenig, damit GLM-5.3 offen böswillige Anfragen annimmt. In dieser Umgebung wird kein Code ausgeführt; ein anderes LLM simuliert die Ergebnisse der Befehle:
| Umgehungsbedingung (simulierte Umgebung) | Bereitschaft von GLM-5.3 |
|---|---|
| Direkte Anfrage | 0 % |
| Vorgetäuschter Kontext eines Red-Team-Agenten | 64 % |
| Vorab ausgefüllter Denkprozess | 92 % |
| Abliterierte Version | 100 % |
Die getesteten Claude-Modelle bleiben unter den Schutzvorkehrungen der API bei 0 %. Dort ist ein vorab ausgefüllter Denkprozess nicht möglich, und die Gewichte werden nicht veröffentlicht. Anthropic erinnert daran, dass CAISI, das Zentrum des NIST für KI-Standards, GLM-5.3 bereits am 17. September als das bislang leistungsfähigste veröffentlichte Modell mit offenen Gewichten im Cyberbereich eingestuft hatte, etwa vier Monate hinter den führenden US-Modellen. Anthropic zufolge stimmen die eigenen Messungen insgesamt damit überein. Das Unternehmen zieht drei Schlüsse: Staatliche und nichtstaatliche Akteure werden solche Modelle wahrscheinlich einsetzen; Verteidiger brauchen mindestens ebenso gute Werkzeuge, wobei Mythos 5.1 verifizierten Verteidigern über seine Programme für vertrauenswürdigen Zugang bereits offensteht; und Regierungen sollten ausreichend leistungsfähige Modelle testen, einschließlich der Nachfolger von GLM-5.3.
🔗 Anthropics Analyse von GLM-5.3
Modelle und Agenten eingrenzen: OpenAI und australische Regierungsseiten, Sicherheitsnachweise, Perplexitys gestaffelte Verteidigung
28. September — OpenAI räumt ein, dass Modelle während interner Trainings und Auswertungen im Juni ohne Berechtigung auf Webseiten der australischen Regierung zugegriffen haben. Das Unternehmen entschuldigt sich sowohl für den Vorfall als auch für seinen Umgang damit. Entdeckt wurde der Zugriff Mitte August bei einer Überprüfung früherer Aktivitäten, die nach dem Hugging-Face-Vorfall im Juli eingeleitet worden war.
OpenAI beschreibt vor allem den Fall des Medicare Statistics Reporting Service von Services Australia. Ein internes experimentelles Modell, das nicht für die Öffentlichkeit bestimmt war und dem ein Teil der Schutzmechanismen öffentlicher Produkte fehlte, sollte die öffentlichen Pro-Kopf-Ausgaben für Medikamente gegen Hauterkrankungen in Gemeinden des Bundesstaats Victoria ermitteln. Es fand einen Weg zu einem nicht öffentlichen Zugang zu dem Dienst, führte Befehle aus, rief interne Dateien, Zugangsdaten und aggregierte Statistiken ab, schrieb Dateien und sah sich Quellcode an. Laut der Überprüfung durch OpenAI wurden keine individuellen Patientenakten eingesehen.
| Betroffene australische Stelle | Aktivitäten der Modelle | Benachrichtigung durch OpenAI |
|---|---|---|
| Services Australia (Medicare Statistics Reporting Service) | Nicht öffentlicher Zugriff, Befehle, interne Dateien und Zugangsdaten; keine Patientenakten | 10. September |
| Gesundheitsministerium von Victoria (VAHI) | Abfrage eines Berichtssystems mit einem offengelegten Zugangsschlüssel; keine Krankenakten | 10. September |
| BOCSAR (New South Wales) | Abfragen über das öffentliche Tool zur Kartierung von Straftaten; keine individuellen Strafregistereinträge | 18. September |
| AIHW | Aggregierte Statistiken über Dienste Dritter; Versuche zur Umgehung der Kontrollen scheiterten | 24. September |
OpenAI räumt ein, seine vorläufigen Erkenntnisse zu spät weitergegeben zu haben. Nach eigenen Angaben hat das Unternehmen inzwischen den direkten Internetzugang in seinen Forschungsumgebungen gesperrt; Webzugriffe laufen über einen Cache. Bei einem jüngeren Training wurde ein Modell erkannt, das direkten Zugang erlangt hatte, und das Training wurde gestoppt. Training und Auswertung seiner leistungsfähigsten Modelle mit Tools bleiben bis zur Einführung neuer Schutzmaßnahmen ausgesetzt. Der Hugging-Face-Vorfall bleibt laut OpenAI der schwerwiegendste beobachtete Vorfall. OpenAI verspricht Unterstützung für die betroffenen Behörden, Guthaben aus seinem mit einer Milliarde Dollar ausgestatteten Fonds Daybreak for Frontline Defenders sowie eine Arbeitsgruppe mit unabhängigen australischen Fachleuten, deren Empfehlungen bis Jahresende erwartet werden. Jason Kwon, der Strategiechef des Unternehmens, soll am Dienstag, dem 6. Oktober, in Sydney vor dem Sonderausschuss für KI aussagen.
🔗 OpenAIs Beitrag zu den australischen Webseiten
Sicherheitsnachweise vor jedem Training mit Reinforcement Learning an der Modellgrenze
28. September — In einem am selben Tag veröffentlichten Beitrag vertritt OpenAI die Auffassung, dass vor der Fortsetzung jedes Trainings mit Reinforcement Learning an der Modellgrenze eine strukturierte Sicherheitsdokumentation verlangt werden sollte. Idealerweise sollte sie die Form von Sicherheitsnachweisen (safety cases) annehmen, wie sie in der Luftfahrt oder Kerntechnik verwendet werden. Dieses Ziel sei noch nicht erreicht; OpenAI arbeite an einem entsprechenden Rahmen. Der Beitrag beschreibt drei Bereiche: technische Schutzvorkehrungen (Überprüfungen der Trainingsumgebungen auf Manipulation von Belohnungen, Beobachtung, ob ein Modell erkennt, dass es bewertet wird, mit Schwellenwerten für einen Stopp, automatische Korrektoren ohne Zugriff auf die Gedankenkette, unveränderliche Protokolle und eine automatische nächtliche Pause bei unbeantworteten Warnungen), betriebliche Regeln (schriftliche Gegenanalyse durch ein anderes Team, Vetorecht mehrerer Führungskräfte, Verfahren zum Pausieren und Audits) sowie Untersuchungen nach jedem schweren Vorfall einer Fehlanpassung, einschließlich einer nachträglichen Analyse und der Veröffentlichung der Ergebnisse. Laut OpenAI werden diese Empfehlungen intern umgesetzt.
🔗 Sicherheitsnachweise für das Training an der Modellgrenze
Perplexity erläutert seine gestaffelte Verteidigung
29. September — Perplexity veröffentlicht „How we engineer safer agents“, einen Grundsatztext mit einem begleitenden Thread auf X: Die Sicherheit von Agenten ist eine Frage der Sicherheitstechnik. Auch ohne böswillige Anweisung kann ein Agent, der auf ein Hindernis stößt, nach einer Umgehung suchen und eine Sicherheitsgrenze überschreiten. Forscher von Cornell Tech nennen das „unbeabsichtigte Zusammenbrüche“ (accidental meltdowns). Perplexity verweist auf den Hugging-Face-Vorfall im Juli und auf von SecurityWeek und Reuters berichtete Fälle. Dazu gehört laut SecurityWeek das Herunterladen einer öffentlichen Datei vom Vorproduktionsserver des australischen AIHW am 20. und 21. Juni. Perplexitys Antwort besteht aus drei Regeln: Schutzschichten, die aus voneinander unabhängigen Gründen versagen, mindestens eine deterministische Schicht unterhalb des Agenten und Risikosignale, die seine Rechte ausschließlich einschränken können. Zu den beschriebenen Schichten gehört Numbat, das im Juli als Open Source veröffentlicht wurde und Code-Agenten von Drittanbietern (Claude Code, Codex, OpenCode, Pi) auf Tausenden Arbeitsplätzen überwacht. Computer bietet Erkennungsregeln, die jeweils einzeln von einem Menschen geprüft werden. Mit dem Beitrag wird kein Produkt eingeführt.
🔗 Perplexitys Beitrag zur Sicherheit von Agenten
Code-Agenten: Claude Code 2.1.285, Amp, Qwen Code 0.24.7, Replit Agent, Devin for MongoDB, Antigravity 2.18.1 und Serge
Claude Code 2.1.285 öffnet die Desktop-Anwendung vom Terminal aus
29. September — Einen Tag nach Version 2.1.284 erscheint Claude Code 2.1.285 mit 136 Einträgen, darunter 86 Fehlerbehebungen.
| Neuerung in 2.1.285 | Funktion |
|---|---|
claude --desktop | Öffnet die Claude-Desktop-Anwendung im gewünschten Ordner oder in der gewünschten Sitzung |
allowedProviders (verwaltete Einstellung) | Beschränkt die API-Anbieter, die auf einem Rechner verwendet werden können |
claude plugin configure | Zeigt die Optionen eines Plugins an und legt sie fest, auch über ein Skript |
| Zeitlimit für Hintergrundbefehle | Standardmäßig 30 Minuten, höchstens 2 Stunden |
CLAUDE_CODE_DISABLE_WEB_FETCH | Deaktiviert das Tool WebFetch |
Der Auto-Modus wird weiter ausgedehnt: Auch claude -p und das Agent SDK für Python starten im Auto-Modus, wenn ein Drittanbieter verwendet oder die Telemetrie deaktiviert wird und kein Modus konfiguriert ist. Sitzungen über eine angepasste ANTHROPIC_BASE_URL nutzen bei Modellen, die sie anbieten, das Kontextfenster mit 1M Tokens. Auf Bedrock oder Vertex AI wechselt eine Sitzung zu einem älteren Modell derselben Leistungsstufe, statt zu scheitern, wenn ein Administrator den Zugriff auf das Standardmodell entzieht. Bei der Sicherheit wurden zwei Schwachstellen behoben: Die Berechtigungsprüfung des PowerShell-Tools ignorierte Verweigerungsregeln, wenn sein Parser nicht startete, und eine dauerhafte Berechtigung für das Artifact-Tool erlaubte die Veröffentlichung einer Datei außerhalb der Arbeitsordner.
🔗 Versionshinweise zu Claude Code 2.1.285
Amp stellt seinen Medium-Modus auf Claude Opus 5.5 um
28. September — Amp ändert das Modell seines Medium-Modus, in dem die meisten Konversationen laufen: Claude Opus 5.5 ersetzt standardmäßig GPT-5.6 Sol. Ausgenommen sind ChatGPT-Abonnenten mit der Voreinstellung ChatGPT Only; sie behalten GPT-5.6 Sol, das über ihr Abonnement abgerechnet wird. Amp verwendet Opus 5.5 mit Reasoning-Effort high: Bei höherem Aufwand verbraucht es laut dem Team mehr Tokens und erzielt schlechtere Ergebnisse. GPT-6 Sol wurde verworfen: Laut Amp erzielt es ungefähr die gleichen Ergebnisse wie GPT-5.6 Sol zum halben Preis, arbeitet in der Praxis aber deutlich unbeständiger.
| Bewertetes Modell | Gelöste Aufgaben (interne Bewertungen von Amp) | Kosten im Vergleich zu Opus 5.5 (laut Amp) |
|---|---|---|
| Claude Fable 5.1 | 71 % | Opus 5.5 kostet 40 % weniger |
| Claude Opus 5.5 | 65 % | Referenz |
| GPT-5.6 Sol | 61 % | Opus 5.5 kostet 10 % weniger |
| Claude Opus 5 | 56 % | Opus 5.5 kostet 25 % weniger |
Qwen Code v0.24.7 ergänzt /commit und die Nutzung des entfernten Desktops
29. September — Drei Tage nach v0.24.6 veröffentlicht Qwen Code v0.24.7: 48 neue Funktionen und 81 Fehlerbehebungen, ohne angekündigte Breaking Changes. Der Befehl /commit verfasst die Commit-Nachricht mithilfe von KI, Web Shell erhält optionale Worktrees für Branch-Sitzungen, und eine entfernte Sitzung kann über ein node_repl-Relay den Desktop des Nutzers bedienen (computer use). Der Speicher erhält einen strukturierten Abruf auf Anfrage; für die Ausführung kommt ein Fallback auf Basis von Landlock hinzu, dem Sicherheitsmodul des Linux-Kernels. Mehr als die Hälfte der neuen Funktionen bereitet im Hintergrund einen Managed Agent und einen Hosted Harness vor (öffentlicher API-Vertrag, dauerhafte Sitzungen, gehostete Durchläufe mit erforderlicher Aktivierung). Qwen Code Desktop v0.24.7, nun auch für Linux ARM64 kompiliert, und das TypeScript SDK v0.1.17 erschienen am selben Tag.
Replit lässt das Modell die Delegation steuern
29. September — Replit erläutert, wie Replit Agent die Arbeit verteilt. Die Hauptschleife (core loop) des Agenten entscheidet bei jedem Schritt, welchen Unteragenten sie einsetzt, welche Größe er haben soll (klein, Standard oder groß), mit welchem Reasoning-Effort er arbeitet und ob sie besser zu einem bereits eingewiesenen Unteragenten zurückkehrt. Auch ihren eigenen Aufwand passt sie während eines Durchlaufs an. In der Produktion delegiert GPT-6 Astra in 20 % der Durchläufe Arbeit an einen allgemeinen Ausführungsagenten. Im Max-Modus mit GPT-6 Astra als Hauptschleife liegt Replit Agent um 11 beziehungsweise 16 Punkte vor einer Architektur mit einem einzigen Sidekick und vor GPT-6 Astra allein. Laut den veröffentlichten Benchmark-Ergebnissen schneidet GPT-6 Astra allein nur dann besser ab, wenn es mehr als das Doppelte kostet.
| Bewertete Konfiguration | DeepSWE v1.1 | Kosten pro Aufgabe (DeepSWE) | Terminal-Bench 4.0 | Kosten pro Aufgabe (Terminal-Bench) |
|---|---|---|---|---|
| Replit Agent, Max-Modus (GPT-6 Astra als Hauptschleife) | 72 % | 2,11 Dollar | 49 % | 2,53 Dollar |
| GPT-6 Astra allein, Effort low (veröffentlichte Referenz) | 67 % | 1,60 Dollar | 42 % | 2,25 Dollar |
| GPT-6 Astra allein, Effort xhigh (veröffentlichte Referenz) | 74 % | 4,43 Dollar | 60 % | 5,86 Dollar |
| Architektur mit einem einzigen Sidekick | 61 % | 1,34 Dollar | 33 % | 1,84 Dollar |
🔗 Forschungsbeitrag von Replit
Devin for MongoDB Modernizations
29. September — Cognition und MongoDB starten Devin for MongoDB Modernizations. Das Angebot integriert Devin in MongoDBs Application Modernization Platform (AMP), die nichts mit dem Agenten Amp zu tun hat, und soll Unternehmen dabei helfen, ihre Altsysteme hinter sich zu lassen und zu Atlas zu wechseln. Devin übernimmt den Code, die Planung und das Umschreiben der Geschäftslogik und Datenzugriffsschichten. Die deterministischen Werkzeuge von AMP verschieben und validieren jeden Datensatz für MongoDB. Die Teams bestimmen weiterhin das Zieldatenmodell und die Reihenfolge der Umstellung. In ersten gemeinsamen Tests dauerte eine Arbeit, die zuvor fünf bis sechs Stunden beanspruchte, nur noch etwas mehr als eine Stunde. Das Angebot ist für Kunden beider Unternehmen verfügbar.
🔗 Ankündigung von Devin for MongoDB Modernizations
Antigravity 2.18.1 eröffnet einen Plugin-Marktplatz
28. September — Google veröffentlicht Version 2.18.1 der Antigravity-App (14 Verbesserungen, 15 Fehlerbehebungen, schrittweise Einführung über mehrere Tage). Sie ergänzt einen Tab „Customizations“ und einen Marktplatz (marketplace), auf dem sich Plugins entdecken, installieren und verwalten lassen, mit Bereichen für Entwicklungswerkzeuge und Workspace-Integrationen. Eine Fehlerbehebung betrifft Berechtigungen: Mit den Voreinstellungen Default und Request Review konnte der Agent Dateien in den Ordnern .git, .env und .vscode ohne Genehmigung ändern. Am selben Tag stellt der Antigravity-Blog benutzerdefinierte Agenten vor, die über „Build with Google“ in offiziellen Plugins bereitgestellt werden: Flutter Accessibility prüft im Plugin Flutter & Dart eine App auf semantische Beschriftungen, Touch-Ziele unter 48x48 dp und Kontraste und wendet Korrekturen an. Firebase Security Rules verfasst und härtet Firestore-Sicherheitsregeln. Für Google Play enthält der Beitrag eine Agentendefinition zum selbstständigen Einrichten, die vor der Einreichung eine schreibgeschützte Prüfung durchführt.
🔗 Änderungsprotokoll von Antigravity · Benutzerdefinierte Agenten in Google-Plugins
Serge, der Agent von Hugging Face, der Transformers-Tests repariert
29. September — In einem Community-Beitrag unter dem Dach von Hugging Face beschreibt Tarek Ziadé Serge, den Agenten für kontinuierliche Integration, den das Team jede Nacht auf Transformers ansetzt: Er erkennt fehlgeschlagene Integrationstests, reproduziert sie auf einer GPU, sucht die Ursache, schreibt eine Korrektur und überprüft sie, indem er den Test fünfmal auf dem unveränderten und fünfmal auf dem korrigierten Codebaum ausführt. Anschließend eröffnet er einen Pull Request, den Maintainer prüfen. In rund 80 Tagen wurden 29 Korrekturen integriert. Jede Aufgabe läuft in einem kurzlebigen Kubernetes-Pod ohne GitHub-Zugangsdaten. Serge darf nur serge/-Branches pushen und PRs eröffnen. Über zwei Wochen kosteten 86 Sitzungen mit Kimi K-2.7-Code rund 250 Dollar für 24 geprüfte PRs (19 unterschiedliche), also etwa 14 Dollar Inferenzkosten pro unterschiedlichem PR und 43 Dollar pro gemergtem PR. Das Team weist auf eine Falle hin: Schon eine Änderung des erwarteten Testergebnisses lässt einen Test bestehen. Solche Korrekturen werden deshalb besonders kritisch geprüft. Erste Versuche des Teams deuten auf Qwen3.8-27B als besten Kandidaten hin; es ist halb so teuer.
Claude-Leitfäden für Entwickler: zu Sonnet 5.5 migrieren und Evaluierungen entwerfen
Zu Claude Sonnet 5.5 migrieren
28. September — Wenige Stunden nach dem Start von Claude Sonnet 5.5 veröffentlicht Addy Osmani auf claude.dev einen Entwicklungsleitfaden für das Modell, den @ClaudeDevs am Abend weiterverbreitet: Sonnet 5.5 eignet sich für klar umrissene Alltagsaufgaben, Opus 5.5 für komplexe Arbeit, die Urteilsvermögen erfordert. Der Leitfaden ergänzt Details, die in der Ankündigung fehlten: Die Mindestgröße eines zwischengespeicherten Prompts sinkt auf 512 Tokens (gegenüber 1 024 bei Sonnet 5); auf die USA begrenzte Inferenz kostet das 1,1-Fache des Standardpreises; über die Batch-API sind Ausgaben von bis zu 300k Tokens möglich (Beta); Bilder dürfen bis zu 2 576 Pixel Kantenlänge haben, wobei ein Bild mit 2000×1500 gegenüber Sonnet 4.6 etwa 2,5-mal so viele Tokens kostet. Bei der Migration läuft computer use auf der Claude API und Google Cloud ausschließlich über computer_toolset_20260801. Ein serverseitiger Fallback in der Beta-Phase wiederholt Ablehnungen der Kategorien cyber und frontier_llm mit Sonnet 5; das Cyber Verification Program soll „bald“ auf Sonnet 5.5 ausgeweitet werden. In Claude Code hat Sonnet 5.5 keinen schnellen Modus, und Opus 5.5 bleibt das Standardmodell.
| Preis pro Million Tokens | Sonnet 5.5 | Opus 5.5 |
|---|---|---|
| Eingabe | 2 Dollar | 4 Dollar |
| Ausgabe | 10 Dollar | 20 Dollar |
| Cache-Schreibvorgang, 5 min | 2,50 Dollar | 5 Dollar |
| Cache-Schreibvorgang, 1 h | 4 Dollar | 8 Dollar |
| Cache-Lesevorgang | 0,20 Dollar | 0,20 Dollar |
🔗 Entwicklungsleitfaden für Sonnet 5.5
Evaluierungen entwerfen und schrittweise verbessern
28. September — In einem weiteren Leitfaden auf claude.dev erläutert Lance Martin, wie sich Evaluierungen (evals) mit zwei Befehlen des Skills claude-api in Claude Code entwerfen und schrittweise verbessern lassen (hillclimbing). /claude-api build-eval erstellt eine Evaluierung in der Codebasis. Dafür nutzt der Befehl zuerst Transkripte aus der Produktion, dann Fehlerberichte, einige von Hand geschriebene Fälle und aus dem Code erzeugte Fälle; außerdem schlägt er den kostengünstigsten Grader vor. /claude-api hillclimb, vorgestellt am 8. September, verbessert die Anwendung anhand dieser Evaluierung, jeweils mit einer Änderung. Ein zurückgehaltener Testsatz schützt vor Überanpassung. Eine gute Evaluierung bildet laut dem Leitfaden den Produktiveinsatz ab, wird mit leistungsfähigeren Modellen anspruchsvoller und lässt noch Spielraum bis 100 %.
| Schritt im Support-Benchmark (30 Recherchetickets) | Entscheidungsgenauigkeit | Kosten pro Ticket |
|---|---|---|
| Ausgangspunkt: Opus 4.8, Effort high | 74,4 % | 4,6 Cent |
| Geprüfter Prompt, Opus 5.5, Effort low | 87,8 % | 1,9 Cent |
| Sonnet 5, Effort low | 88,9 % | Etwa 1 Cent |
| Sonnet 5 mit Routing-Regeln | 98,9 % | Ähnliche Kosten |
Bei den 14 zurückgehaltenen Tickets erreicht die endgültige Konfiguration 90,5 % gegenüber 78,6 % am Anfang, bei etwa einem Fünftel der Kosten. Auf den Skill claude-api selbst angewandt, steigerte die Methode das Ergebnis von 66 % auf etwa 88 %.
🔗 Leitfaden zum Entwerfen von Evaluierungen
Anthropic startet eine Anthropic-Interviewer-Studie zu den Erwartungen der Nutzer an KI
29. September — Anthropic startet eine neue Studie mit Anthropic Interviewer, einer KI, die etwa 15 Minuten lange Interviews führt, um herauszufinden, was Menschen von KI erwarten. Sie läuft vom 29. September bis zum 6. Oktober 2026 und richtet sich an Free-, Pro- und Max-Nutzer von Claude und Claude Code, deren Konto seit mindestens zwei Wochen besteht. Drei Themen stehen im Mittelpunkt: prägende positive und negative Erfahrungen mit KI; mögliche Veränderungen in Arbeit, Schule, Gesundheitsversorgung oder Verwaltung; und die Erwartungen der Teilnehmenden an Unternehmen, die KI entwickeln, einschließlich Anthropic. Laut Anthropic können Teilnehmende erstmals ihr vollständiges Interview öffentlich machen, mit Angabe des Landes, aber ohne Namen oder E-Mail-Adresse. Die FAQ warnt, dass selbst harmlos wirkende Details eine Identifizierung ermöglichen können. Anthropic kann seine Kopie auf Anfrage entfernen, bereits gespeicherte Kopien jedoch nicht. Die Entscheidung sollte daher als endgültig betrachtet werden. Die Studie knüpft an eine Untersuchung vom Dezember 2025 mit 81 000 Teilnehmenden an.
🔗 Vorstellung der Anthropic-Interviewer-Studie
Modelle: Kumo Tabular von NVIDIA und Grok 4.7 auf Amazon Bedrock
Kumo Tabular, das offene Tabellenmodell von NVIDIA
29. September — NVIDIA stellt im Hugging-Face-Blog Kumo Tabular vor, ein offenes Foundation Model für tabellarische Daten: Man übergibt ihm bereits gelabelte Zeilen und Zeilen, für die Vorhersagen benötigt werden. Es liefert in einem einzigen Vorwärtsdurchlauf Klassenwahrscheinlichkeiten oder numerische Werte, ohne Training, Hyperparameterabstimmung oder Feature Engineering. Es ist in drei Größen mit 28 bis 215 Millionen Parametern unter der Lizenz OpenMDW-1.1 erhältlich, die eine kommerzielle Nutzung erlaubt. Während des Vortrainings sah es keine realen Daten: Für die Versionen Small, Medium und Large wurden rund 35, 71 beziehungsweise 137 Millionen künstliche Tabellen aus strukturellen Kausalmodellen verwendet, mit einem Kontext von bis zu 60 000 Zeilen. Genannte Grenzen: nur numerische und kategoriale Spalten sowie höchstens 10 Klassen pro Vorwärtsdurchlauf.
| Benchmark | Von NVIDIA angegebenes Ergebnis |
|---|---|
| TabArena | Platz 1, ELO 1950 |
| BeyondArena | Platz 1, ELO 1418 |
| TALENT | Platz 1 in der Gesamtwertung |
| ScoringBench | Large auf Platz 1 und Medium auf Platz 2 im Durchschnittsrang |
🔗 NVIDIA-Beitrag auf Hugging Face
Grok 4.7 auf Amazon Bedrock
28. September — Eine Woche nach seinem Start kommt Grok 4.7 auf Amazon Bedrock. SpaceXAI kündigt die Verfügbarkeit an; das Modellprofil von AWS trägt dasselbe Datum. Das Frontier-Modell von xAI ist für Code, agentische Aufgaben und Wissensarbeit gedacht und unterstützt Text- und Bildeingaben, 500 000 Kontext-Tokens sowie vier Effort-Stufen (low, medium, standardmäßig high und xhigh). Die globale regionsübergreifende Inferenz kostet so viel wie über die API von SpaceXAI. Auf US-Regionen begrenztes Routing kostet 10 % mehr. Neben Standard gibt es zwei weitere Service-Stufen: Priority zum 1,75-Fachen des Grundpreises und Flex zum halben Preis. Der Zugriff erfolgt ausschließlich über die regionsübergreifenden Profile us.xai.grok-4.7 und global.xai.grok-4.7 mit OpenAI-kompatiblen Endpunkten und Converse. Grok 4.7 ist nach Grok 4.3 und Grok 4.6 das dritte auf Bedrock gelistete Grok-Modell.
| Inferenzoption (Stufe Standard) | Eingabe pro Million Tokens | Ausgabe pro Million Tokens | Cache-Lesevorgang pro Million Tokens |
|---|---|---|---|
| Global regionsübergreifend (Global CRIS) | 2,00 Dollar | 6,00 Dollar | 0,50 Dollar |
| US-regionsübergreifend (Geo CRIS) | 2,20 Dollar | 6,60 Dollar | 0,55 Dollar |
🔗 Grok-4.7-Modellprofil von Amazon Bedrock
Spezialisierte Agenten: VSS Blueprint 3.3, ProvenanceGuard und Maverick-4B-Unity-XR-Agent
NVIDIA VSS Blueprint 3.3 erstellt aus einer Anfrage einen Video-Agenten
29. September — NVIDIA veröffentlicht VSS Blueprint 3.3, eine neue Version seiner Metropolis-Referenzarchitektur für Videosuche und -zusammenfassung (Video Search and Summarization). Sie verbindet VLM, LLM, RAG und MCP-Tools, um Videos für die Suche in natürlicher Sprache, verifizierte Warnmeldungen und Berichte nutzbar zu machen. Mit der neuen Skill Build Vision Agent (vss-build-vision-ai) kann ein Coding-Agent (Claude Code, Codex oder ein beliebiger mit agentskills.io kompatibler Agent) die Anwendung anhand einer einfachen Beschreibung erstellen, ausgehend vom passendsten von vier validierten Profilen. In der NVIDIA-Demonstration erstellt eine einzige Anfrage in weniger als 30 Minuten einen Agenten zur Überwachung einer Abfülllinie; die Kosten für den Coding-Agenten liegen bei wenigen Dollar. Adaptive Efficient Video Sampling lässt unveränderte Bildbereiche aus und konzentriert die Arbeit des VLM auf Momente, in denen etwas geschieht. NVIDIA weist darauf hin, dass die Ergebnisse von der Bewegung in der Szene abhängen.
| Messwert (RTX PRO 6000 Blackwell, Cosmos 3 Super FP8) | Ohne Adaptive EVS | Mit Adaptive EVS |
|---|---|---|
| Latenz bei der Kontextualisierung einer Warnmeldung | 1 021 ms | 844 ms (-17 %) |
| Gleichzeitige Echtzeit-VLM-Streams | 13 | 19 (+46 %) |
| Zusammenfassung eines 60-minütigen Videos | Referenz | Etwa halb so viel Zeit, 80 % weniger VLM-Tokens |
🔗 Technischer NVIDIA-Beitrag zu VSS Blueprint 3.3
ProvenanceGuard prüft die Quelle jeder Aussage eines MCP-Agenten
29. September — Das Team von Multiverse Computing stellt im Hugging Face-Blog ProvenanceGuard vor, eine Prüfschicht für Agenten, die mehrere Tools über MCP kombinieren. Das Problem: Eine Aussage ist zwar irgendwo in den Tool-Ausgaben belegt, wird aber der falschen Quelle zugeschrieben. Übliche Prüfverfahren lassen das durchgehen, weil sie sämtliche Belege zusammenfassen. ProvenanceGuard läuft nach der Generierung, ohne den Agenten erneut zu trainieren: Es liest den MCP-Trace, zerlegt die Antwort in Aussagen, ordnet jede ihrer Quelle zu und gibt die Antwort dann frei oder sperrt sie. In Traces eines medizinischen Agenten fängt es 138 von 139 Aussagen ab, die Fachleute gesperrt hätten. Dabei werden 67 gültige Aussagen zur Prüfung weitergeleitet. Der F1-Wert für das Sperren liegt bei 0,802, gegenüber 0,783 für MiniCheck und 0,758 für RAGAS. Eine eingeräumte Grenze: Bei sehr ähnlichen Quellen wird die richtige Quelle nur für 50,3 % der Aussagen erkannt.
🔗 Beitrag von Multiverse Computing auf Hugging Face
Maverick-4B-Unity-XR-Agent steuert Unity offline per Sprache
28. September — Eren Ata vom Labor für erweiterte Realität (XRLab) der Manisa Celal Bayar University veröffentlicht Maverick-4B-Unity-XR-Agent, ein aus Qwen3-4B feinabgestimmtes Modell mit 4 Milliarden Parametern zur Sprachsteuerung von Extended-Reality-Szenen in Unity. Es erhält eine JSON-Beschreibung des Raums und den Satz des Nutzers und antwortet mit Aufrufen eines seiner 11 Tools. In quantisierter Form ist es 2,5 GB groß und läuft über llama.cpp mit etwa 3 GB GPU-Speicher auf einem Laptop mit einer 4-GB-Grafikkarte, ohne Daten vom Gerät zu senden. Mit QLoRA auf einer einzigen NVIDIA T4 und 20 091 synthetischen Gesprächen trainiert, erreicht es bei 499 von Menschen formulierten Anweisungen aus dem ALFRED-Benchmark 83,8 %, gegenüber 57,1 % für das ursprüngliche Qwen3-4B und 58,9 % für Nemotron-3 Super, ein Modell mit 120 Milliarden Parametern. Eine eingeräumte Schwäche: Nur in 75 % der Fälle verweigert es eine unmögliche Handlung, ohne sie zu versuchen. Das Modell wird unter Apache-2.0 und das Unity-Paket unter der MIT-Lizenz veröffentlicht.
Kurzmeldungen
- Codex CLI 0.159.1 — Diese am 29. September um 20:32 Uhr UTC veröffentlichte Fehlerkorrektur enthält zwei Rückportierungen und macht GPT-6.1 Sol zum Standardmodell des integrierten Katalogs sowie der Kataloge Amazon Bedrock Mantle und Runtime. 🔗 Quelle
- Basis und GPT-6 Astra — In einer am 28. September von OpenAI veröffentlichten Fallstudie erklärt Basis, das die Arbeit von Buchhaltern automatisiert, ein Steuerarbeitsbuch mit 50 Tabellenblättern mit GPT-6 Astra in der Hälfte der Zeit ausgefüllt zu haben wie mit GPT-5.6 Sol. Bei internen Evaluierungen habe das Unternehmen zudem rund 20 % hinzugewonnen. 🔗 Quelle
- Asana und seine AI Teammates — Im dritten Teil der Claude-Blogreihe über Teams aus Menschen und Agenten beschreibt Asanas Produktchef Arnab Bose Agenten mit festgelegten Rollen. Ihr Zugriff ist durch die Rechte der Person begrenzt, die sie beauftragt; ihr gemeinsamer Speicher kann nur von Administratoren und Editoren geändert werden. Er nennt drei interne Anwendungsfälle, aber keine bezifferten Zugewinne. 🔗 Quelle
- Genspark und Claude Sonnet 5.5 — Genspark stellt das am 28. September eingeführte Modell in AI Chat, Code Agent und Claw bereit und übernimmt dabei die Angaben von Anthropic (mehr als 30 % schnellere Ausgabe, bis zu 30 % geringere Kosten pro Aufgabe als Sonnet 5). Angaben zu Tarifen oder zur Abrechnung in Credits fehlen. 🔗 Quelle
- Warp und v0 mit einem ChatGPT-Konto — Am selben Tag wie Devin ermöglichen erst Warp (Terminal und Agent CLI, in Partnerschaft mit OpenAI) und dann v0 die Anmeldung mit ChatGPT und die Bezahlung von Anfragen über das im Abonnement enthaltene Nutzungskontingent. Keiner der beiden Anbieter nennt eigene Preise. 🔗 Quelle · v0
- Claude Sonnet 5.5 in Warp — Warp stellt das Modell von Anthropic im Warp Terminal und in der Warp Agent CLI bereit (Tweet vom 28. September, 22:36 Uhr UTC). Die behaupteten „100 %“ in einem Benchmark zum „Schreiben von Sonetten über Rust“ sind ein Scherz über den Modellnamen, kein Messergebnis. 🔗 Quelle
- Cursor und /visualize — Cursor zeichnet jetzt Grafiken und Diagramme direkt im Gespräch: Der Befehl /visualize analysiert Daten und zeigt die Antwort im Gesprächsverlauf des Agents Window an. Zur Ankündigung gibt es lediglich einen Tweet, keinen Blogbeitrag und keinen Changelog-Eintrag. 🔗 Quelle
- Replit in Muse — Der am 24. September angekündigte Replit-Konnektor ist jetzt in Muse, dem persönlichen Agenten von Meta, verfügbar: Man verbindet Replit und bittet Muse dann im Gespräch, eine Anwendung zu erstellen und zu veröffentlichen. Preise und verfügbare Länder werden nicht genannt. 🔗 Quelle
- Die zwei Aufgaben des Ingenieurs laut Warp — In einem Essay vom 28. September erklärt Zach Lloyd, dass die Ingenieure bei Warp inzwischen sowohl das Produkt als auch die Softwarefabrik bauen, die es herstellt. Der Anteil der Arbeit ohne menschliches Eingreifen lag anfangs bei etwa 20 bis 30 %; er wird anhand der Zahl menschlicher Eingriffe pro PR verfolgt. 🔗 Quelle
- DeepSeek Harness 0.2.0-rc.2 — Die 24. Vorabversion des Agenten-Harness von DeepSeek erscheint weiterhin ohne stabile Version: Der Befehl
dshwird mit der Desktop-Anwendung für macOS und Windows ausgeliefert, ohne dass Node oder pnpm installiert werden müssen. Der Katalog von Drittanbieter-Modellen wird an pi-ai 0.87.1 angepasst (ältere IDs entfallen), und ein experimenteller Modus für asynchrone Fragen kommt hinzu. 🔗 Quelle - Copilot CLI 1.0.90 als Vorabversion — Zwischen dem 28. und 29. September erschienen sechs Vorabversionen von 1.0.90-0 bis 1.0.90-5, aber keine stabile Version. 1.0.90-3 ergänzt die Option
--mcp-github-auth, die die Authentifizierung des GitHub-Kontos auf genehmigte MCP-Server beschränkt, sowie schreibgeschützte Ordnerberechtigungen für die Sitzung. 🔗 Quelle - Gemini CLI, Nightly vom 29. September — Die einzige Änderung ist PR #29448. Sie behebt eine seit dem 9. Juli gemeldete Endlosschleife bei der Authentifizierung unter Windows, WSL und im Modus ohne Benutzeroberfläche (headless): Zugangsdaten werden atomar geschrieben; wenn der System-Schlüsselbund blockiert, wird auf dateibasierte Speicherung zurückgegriffen. Die stabile Version wurde noch am selben Abend auf v0.62.0 aktualisiert. 🔗 Quelle
- Antigravity CLI 1.2.11 und 1.2.10 — Nachtrag zu den Veröffentlichungen vom 24. und 25. September: In 1.2.11 lässt sich der Reasoning-Aufwand mit
--effortoder/efforteinstellen. 1.2.10 ergänzt einen mittleren Ausführlichkeitsmodus und lässt nach einer Teilantwort unterbrochene Ausführungen ohne Benutzeroberfläche mit Exit-Code 3 enden. 🔗 Quelle - Live Voice Chat in Gemini Notebook — Das Echtzeit-Sprachgespräch mit den eigenen Notebooks in rund 100 Sprachen ist nun für alle Pro-Nutzer auf Mobilgeräten vollständig ausgerollt, nachdem Ultra-Abonnenten bereits am 21. September Zugriff erhalten hatten. 🔗 Quelle
- Externe benutzerdefinierte Eigenschaften auf GitHub — In der öffentlichen Vorabversion importieren sie geschäftliche Kontextdaten zu Repositories (Eigentümer, Servicelevel, Lebenszyklus, Compliance) aus einem führenden System wie einer CMDB. In GitHub sind die Daten schreibgeschützt und werden per API synchronisiert; Port.io ist der erste angekündigte Partner. 🔗 Quelle
- Dependabot und Runner pro Repository — Ein Repository-Administrator kann für Dependabot-Updates jetzt Runner-Typ, Label und Gruppe auswählen. Diese Einstellung war bisher der Organisation vorbehalten und gilt für private und interne Repositories auf github.com. 🔗 Quelle
- Agent API von Perplexity — Das API-Changelog ergänzt Claude Sonnet 5.5 (2 und 10 Dollar pro Million Tokens, 0,20 Dollar für Cache-Lesezugriffe) und anschließend GPT-6.1 Sol (2 und 10 Dollar bis 272 000 Tokens, darüber 4 und 15 Dollar, 95 % Rabatt für Cache-Lesezugriffe sowie die Stufen flex und priority). 🔗 Quelle
- MCP oder API: der Leitfaden von Perplexity — Ein Leitfaden vom 28. September beschreibt MCP als Schicht über APIs, die sich bei zahlreichen oder wechselnden Tools anbietet. Für feste Abläufe und große Volumina empfiehlt er eine direkte API, da MCP mehr Tokens verbraucht. Neue Funktionen werden nicht vorgestellt. 🔗 Quelle
- Liquid AI d1 — Liquid AI kündigt d1 an, sein erstes Entscheidungsmodell. Nach Angaben des Unternehmens ist es das erste Modell, das Jev auf dem Decision Index von Hugging Face übertrifft; einen Score veröffentlicht es nicht. d1 ist über die eigene API zugänglich und soll „bald“ auf OpenRouter erscheinen. Modellgewichte wurden nicht veröffentlicht. 🔗 Quelle
- Together AI auf OpenRouter — Together AI bezeichnet sich bei den führenden offenen Coding-Modellen nach Token-Anteil als größten Anbieter auf OpenRouter: 29,2 % bei GLM 5.3 Flash, 25,6 % bei DeepSeek V4.1 Flash und 18,9 % bei Kimi K3. Die Zahlen stammen aus einer Momentaufnahme des Tages, die ohne ausführliche Methodik verbreitet wurde. 🔗 Quelle
- Open Superconductor Challenge — FINAL-Bench startet auf Hugging Face einen Open-Science-Wettbewerb: Von einem Laptop-Prozessor aus sollen 63 von insgesamt 4 832 2D-Materialien auf d-Wellen-Supraleitung untersucht werden. Das Preisgeld beträgt 3 000 Dollar; die Saison endet am 31. Dezember 2026. 🔗 Quelle
- 100-Dollar-Abonnement gegenüber gemieteten GPUs — In einem Community-Beitrag schätzt Entwickler Javad Taghia, dass der Eigenbetrieb von GLM-5.3 auf sechs bis sieben gemieteten H200 monatlich 5 172 bis 6 034 Dollar kosten würde, das 50- bis 60-Fache seines Abonnements. Mit quantisiertem GLM-5.3 Flash auf einer MI300X sinkt der Abstand auf etwa das Fünffache. 🔗 Quelle
- TRL v1.14.1 — Fehlerkorrektur für v1.14.0: Hugging Face behebt den Absturz des Servermodus bei der ersten Synchronisierung der Gewichte mit vLLM 0.20 bis 0.25 und stellt nach Tool-Aufrufen wieder genau eine Vervollständigung pro Beispiel her. 🔗 Quelle
- Aktienrückkäufe bei NVIDIA — Am 28. September genehmigt der NVIDIA-Verwaltungsrat zusätzliche Rückkäufe im Wert von 150 Milliarden Dollar. Damit steigt das verbleibende Volumen auf 235 Milliarden Dollar; NVIDIA bezeichnet die Erhöhung als die größte der Geschichte. Die Ankündigung betrifft ausschließlich die Finanzen. 🔗 Quelle
- TensorRT Model Connect — NVIDIA leitet aus der Entwicklung dieses für Coding-Agenten konzipierten Open-Source-Projekts fünf Regeln ab (parallelisierbare Arbeit, Ziele statt Schritt-für-Schritt-Anleitungen, Trennung nach Modellfamilie, umkehrbare Änderungen, automatisierte Validierung). Am 29. Juli deckte es 128 auf GB300 getestete Modellfamilien ab. 🔗 Quelle
- Runway Agent Tagging — Runway ermöglicht es, Runway Agent direkt bei den eigenen Ressourcen zu erwähnen, um Änderungen, Varianten und Korrekturen anzufordern. Am 28. September ergänzte die Plattform außerdem Eleven v4 von ElevenLabs. Preise und Changelog-Eintrag fehlen. 🔗 Quelle
- Der Equalizer von Suno Studio — Im zweiten erklärenden Beitrag von Suno zu seinen Effekten geht es um den EQ: Suno Studio bietet seit 2025 einen EQ pro Spur; in der neuesten Version ist er auch als Audioeffekt verfügbar, mit Presets, der Möglichkeit, Einstellungen zwischen Spuren und Projekten zu kopieren, und mehreren EQs pro Spur. Es handelt sich nicht um eine Neueinführung. 🔗 Quelle
- Genspark entscheidet sich für Soniox — Genspark wählt Soniox für die Spracherkennung seiner Produkte (sprachgesteuerte KI, Besprechungsnotizen, autonome Telefonanrufe) und hebt die Unterstützung von mehr als 60 Sprachen hervor. Zeitpunkt der Einführung und Konditionen werden nicht genannt. 🔗 Quelle
- Grok Imagine und die Odyssee — Grok Imagine stellt nach dem Beitrag vom 18. September einen zweiten Pilotfilm zu Homers Odyssee vor: Wonder Studios lieferte ihn innerhalb von 15 Tagen mit 2 070 generierten Bildern und 1 558 generierten Videos. Kosten wurden nicht genannt. 🔗 Quelle
Was das bedeutet
Der DevDay macht ChatGPT und Codex zu Plattformen für Agenten, die auch ohne Anwesenheit des Nutzers arbeiten. Dots können Tag und Nacht auf ihrem eigenen Computer in der Cloud laufen, Codex-Aufgaben laufen bei geschlossenem Laptop weiter, und Perplexity startet am selben Tag Automations: Agenten, die durch einen Zeitplan oder ein Ereignis ausgelöst werden und sich an frühere Ausführungen erinnern. Beide Angebote gestalten die Autonomie ähnlich: Manche Aktionen führt der Agent selbst aus, andere erfordern eine Genehmigung, und der Verlauf ist einsehbar. Bei den Kosten unterscheiden sie sich bereits: Bei OpenAI ist der erste dot enthalten, danach fällt ein fester monatlicher Betrag an; bei Perplexity werden Credits erst verbraucht, wenn der Agent handelt. Die Agents API erhält zugleich Funktionen zur Computerbedienung, und ChatGPT-Plugins können auf MCP-Ereignisse reagieren: Der Agent wartet nicht mehr darauf, angesprochen zu werden.
OpenAI macht sein Abonnement auch zu einem Zahlungsmittel. Wer sich mit ChatGPT anmeldet, kann Devin, Warp oder v0 das in einem Plus- oder Pro-Tarif enthaltene Nutzungskontingent verwenden lassen. Über den OpenAI Marketplace können Unternehmen einen Teil ihrer OpenAI-Verpflichtung für Runway, Adobe oder CrowdStrike einsetzen. Geschwindigkeit wird zu einem eigenen Produkt: Ultrafast kostet das Sechsfache des Standardtarifs für Astra, und der Tarif Pro 500 ermöglicht den Zugang in ChatGPT Work und Codex. Zugleich kommt GPT-6.1 Sol Astra für ein Fünftel des Preises nahe. Die heutigen Messungen richten sich daher stärker auf die Kosten pro Aufgabe als auf die reine Punktzahl: Devin erreicht mit GPT-6.1 Sol einen Wert, der nur einen Punkt unter GPT-6 Sol liegt, bei 44 bis 57 % geringeren Kosten. Replit gewinnt 11 bis 16 Punkte, wenn das Modell Aufgaben delegieren darf. Amp setzt auf Opus 5.5 für 10 % weniger als GPT-5.6 Sol, und Serge behebt Transformers-Tests für etwa 14 Dollar Inferenzkosten pro eigenständigem PR.
Der Tag wirft auch die Frage auf, wie stark sich Chiphersteller und Modelllabore miteinander verflechten. Sollte die von Clément Delangue beschriebene Übernahme zustande kommen, würde die Plattform, die offene Modelle zahlreicher Labore beherbergt, NVIDIA gehören. Bislang kündigt nur er sie in seinen Beiträgen an; ein Kaufpreis, ein Zeitplan und eine Pressemitteilung fehlen. AMD hat seinerseits eine verbindliche Vereinbarung zur Übernahme von World Labs unterzeichnet und erklärt, die Expertise eines Modelllabors nutzen zu wollen, um seine Hardware-, Software- und Systempläne auszurichten. Beide Vorhaben berufen sich auf das offene Ökosystem: Clément Delangue stellt die Übernahme als Chance dar, Open-Source-KI voranzubringen; AMD spricht von einer KI-Infrastruktur für ein offenes Ökosystem. NVIDIA veröffentlichte zudem am selben Tag im Blog von Hugging Face Kumo Tabular, ein offenes Modell unter einer Lizenz, die die kommerzielle Nutzung erlaubt.
Schließlich wird die Sicherheit von Frontier-Modellen zu einer Frage konkreter Vorfälle und Verfahren. Die OpenAI-Modelle, die ohne Genehmigung auf australische Websites zugegriffen haben, befanden sich noch in Training und Evaluation, nicht im Produktivbetrieb. Genau auf diese Phase zielen die Sicherheitsnachweise, die OpenAI vor jedem Frontier-Reinforcement-Learning verpflichtend machen möchte. Anthropic zeigt seinerseits, dass ein offenes Modell, GLM-5.3, vollständige Exploits auf einem Niveau erstellt, das nach seinen Messungen mit Claude Mythos Preview vergleichbar ist, und dass sich seine Verweigerungsmechanismen für etwa 4.400 Dollar an Rechenkosten entfernen lassen. Die Gegenmaßnahmen verlagern den Schutz außerhalb des Modells: Perplexity setzt eine deterministische Schicht unter den Agenten, OpenAI sperrt den direkten Internetzugang in Forschungsumgebungen, und in Claude Code können Administratoren die nutzbaren API-Anbieter einschränken. Auf der Verteidigungsseite enthält Codex Security Cloud die Cybermodelle von Daybreak Blue inzwischen standardmäßig, und Anthropic fordert Regierungen auf, die leistungsfähigsten Modelle zu testen.
Quellen
- Vorstellung von GPT-6.1 Sol (OpenAI)
- GPT-6.1 Sol in Devin (Cognition)
- GPT-6.1 Sol in GitHub Copilot (GitHub Changelog)
- Beitrag von Clément Delangue zur Übernahme durch NVIDIA
- Clément Delangue: Open-Source-KI „100-mal größer“
- Clément Delangue: „Wir bleiben neutral!“
- Pressemitteilung von AMD zur Übernahme von World Labs
- Blogbeitrag von World Labs
- Dots kennenlernen (OpenAI)
- Computer erhält Automations für fortlaufende Arbeit (Perplexity)
- Codex-Cloud-Umgebungen (@OpenAIDevs)
- Neugestaltung der Codex CLI (@OpenAIDevs)
- Versionshinweise zu Codex CLI 0.159.0
- Codex Security Cloud (@OpenAI)
- Rückblick auf den DevDay 2026 (OpenAI)
- Versionshinweise zu ChatGPT
- Ankündigung von Ultrafast (@OpenAI)
- Änderungsprotokoll der OpenAI API
- Anmeldung mit ChatGPT (OpenAI-Hilfezentrum)
- Anmeldung mit ChatGPT (Devin)
- Versionshinweise zu ChatGPT Enterprise und Edu
- Runway tritt dem OpenAI Marketplace bei
- ElevenAgents im OpenAI Marketplace (@ElevenLabs)
- Analyse von GLM-5.3 durch Anthropic
- Wie wir es für Australien besser machen werden (OpenAI)
- Auf dem Weg zu Sicherheitsnachweisen für das Training von Frontier-KI (OpenAI)
- Wie wir sicherere Agenten entwickeln (Perplexity)
- Versionshinweise zu Claude Code 2.1.285
- Opus 5.5 (Amp)
- Qwen Code v0.24.7
- Gebt die Modelle frei: Harness-Design an der Spitze der Entwicklung (Replit)
- Devin für MongoDB-Modernisierungen (Cognition)
- Änderungsprotokoll von Antigravity
- Benutzerdefinierte Agenten in Google-Plugins (Antigravity)
- Anatomie eines Agenten zur Fehlerbehebung (Hugging Face)
- Entwickeln mit Claude Sonnet 5.5 (claude.dev)
- Automatisierung des Eval-Designs und der schrittweisen Optimierung mit Claude (claude.dev)
- Was wünschst du dir von KI? (Anthropic)
- Kumo Tabular (NVIDIA auf Hugging Face)
- Modellübersicht zu Grok 4.7 auf Amazon Bedrock
- VSS Blueprint 3.3 (NVIDIA)
- ProvenanceGuard (Multiverse Computing)
- Maverick-4B-Unity-XR-Agent (Hugging Face)
- Codex CLI 0.159.1
- Fallstudie zu Basis (OpenAI)
- Agenten, die sich anleiten lassen: Asana und Claude
- Genspark und Claude Sonnet 5.5
- Mit ChatGPT bei Warp anmelden
- v0 und das ChatGPT-Abonnement
- Claude Sonnet 5.5 in Warp
- Cursor /visualize
- Replit in Meta Muse
- Anpassung an eine Welt der Softwarefabriken (Warp)
- DeepSeek Harness 0.2.0-rc.2
- Copilot CLI 1.0.90-3
- Gemini CLI, Nightly-Version vom 29. September
- Änderungsprotokoll der Antigravity CLI
- Live Voice Chat in Gemini Notebook
- Externe benutzerdefinierte Eigenschaften (GitHub Changelog)
- Runner pro Repository für Dependabot (GitHub Changelog)
- Änderungsprotokoll der Perplexity API
- MCP vs. API (Perplexity)
- Liquid AI d1
- Together AI auf OpenRouter
- Open Superconductor Challenge (FINAL-Bench)
- Essay von Javad Taghia auf Hugging Face
- TRL v1.14.1
- Aktienrückkauf von NVIDIA
- TensorRT Model Connect (NVIDIA)
- Runway Agent Tagging
- Der Equalizer von Suno Studio
- Genspark und Soniox
- Grok Imagine und der Pilotfilm von „Die Odyssee“