ai-powered-markdown-translatorArticolo tradotto dal francese all’italiano con gpt-5.6-sol.
Sabato e domenica i laboratori tacciono: né DeepSeek, né Meta, né Ai2, né Sakana, né Mistral, né xAI hanno pubblicato nulla, e gli account ufficiali del settore dei modelli aperti sono rimasti vuoti per due giorni. Una sola vera uscita: Qwen-Image-2.1, pubblicato domenica a metà pomeriggio con pesi aperti. Il grosso del resto si riduce a cinque articoli del blog della community di Hugging Face, una versione di Antigravity che non corregge nulla e due voci del changelog di GitHub recuperate dal 18 settembre: una giornata tranquilla, che non c’è alcun motivo di gonfiare.
Qwen-Image-2.1, un solo modello per generare, modificare e offrire trasparenza
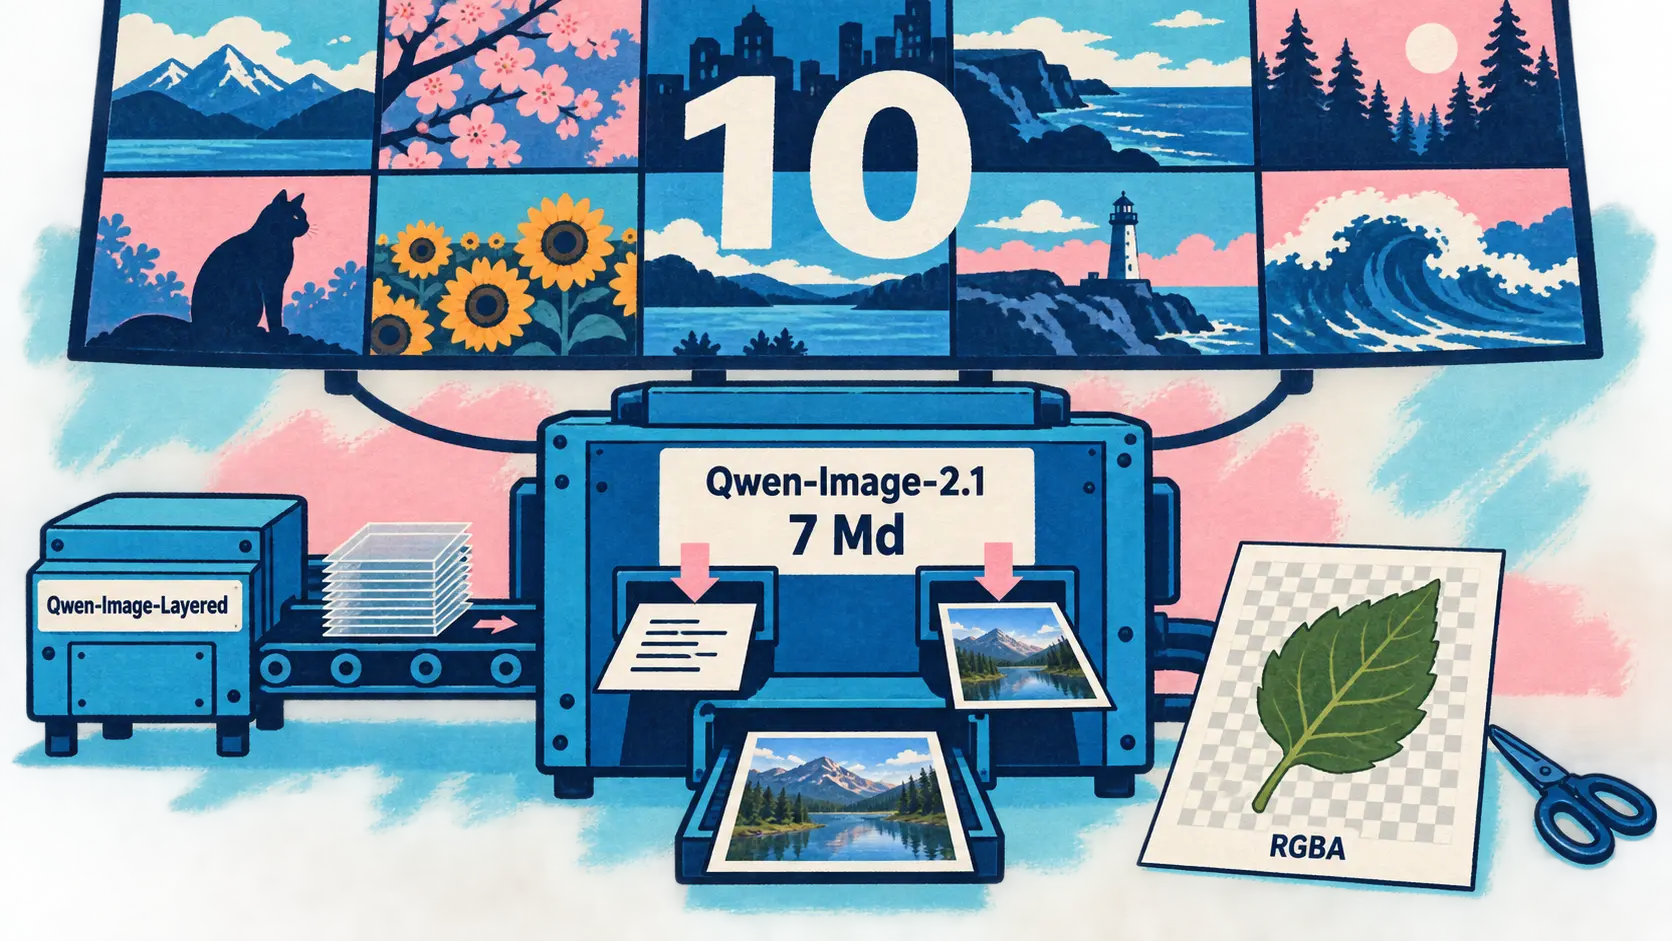
20 settembre — Qwen ha pubblicato Qwen-Image-2.1, il suo modello di generazione ed editing di immagini, con pesi aperti su Hugging Face, ModelScope e GitHub. Il punto di forza non è la dimensione, ma l’unificazione: un’unica serie di pesi copre la creazione a partire da un’istruzione testuale e il ritocco di immagini esistenti, mentre prima questi due utilizzi richiedevano due modelli.
La novità più concreta è la trasparenza nativa: il modello produce e modifica direttamente livelli RGBA, ed è l’istruzione a stabilire se l’output debba avere un canale di trasparenza. Qwen offriva questa capacità dal dicembre 2025 tramite un modello dedicato, Qwen-Image-Layered, ora incorporato. Viene eliminata una fase di scontornamento: è possibile estrarre un soggetto da una fotografia come livello riutilizzabile oppure sostituire il testo in un livello trasparente.
Sul fronte dell’editing, il modello accetta fino a 10 immagini di riferimento per una stessa composizione, mentre l’area da ritoccare può essere indicata con un cerchio colorato, un’annotazione dipinta o una maschera fornita separatamente — questa terza modalità esiste perché le prime due coprono il contenuto originale. L’efficienza si basa su un’attention a granularità mista: gli input di editing formano un contesto statico memorizzato nella cache fin dal primo passaggio.
| Elemento tecnico | Valore dichiarato |
|---|---|
| Parametri di generazione visiva | 7 miliardi, su 32 livelli Single-Stream DiT |
| Immagini di riferimento accettate | Massimo 10 |
| Trasparenza degli output | Livelli RGBA nativi, sia in generazione sia in editing |
| Modello dedicato incorporato | Qwen-Image-Layered, pubblicato nel dicembre 2025 |
| Supporto fin dal primo giorno | vLLM-Omni e ComfyUI |
Qwen pubblica un confronto su Qwen-Image-Bench, ma i valori compaiono soltanto in un’immagine dell’articolo: non vengono riportati qui.
Generate, edit, and create transparent images with one model: a 7.1B DiT paired with Qwen3-VL-8B.
🇮🇹 Generare, modificare e creare immagini trasparenti con un solo modello: un DiT da 7,1 miliardi di parametri abbinato a Qwen3-VL-8B. — @vllm_project su X
🔗 Annuncio
Qwen Code v0.24.2, la voce completa nella Web Shell e una sandbox bwrap più ricca
Stesso editore, stesso giorno, prodotto completamente diverso. 20 settembre — pubblicata poco più di ventiquattro ore dopo la v0.24.1, la v0.24.2 dell’agente di coding a riga di comando di Qwen è la prima della sua serie senza alcuna modifica incompatibile, mentre le due precedenti ne contenevano una ciascuna.
La sandbox bubblewrap riceve una base di esecuzione completa: avvio strutturato dei processi, supervisione e worker confinati. Nello stesso ambito, uno spazio di lavoro il cui livello di attendibilità non è stato ancora deciso richiede ora una scelta esplicita. La Web Shell rende invece realmente utilizzabile la funzione Live Voice: il modello e la voce possono essere scelti dalla scheda di configurazione e il livello del microfono viene visualizzato durante la chiamata. Per chi esegue più sessioni in parallelo, ogni messaggio in arrivo viene ora valutato per la sessione a cui è destinato e la cache del prompt viene conservata per gli strumenti differiti.
Verificare una risposta senza scrivere un token e una classifica in cui l’autore è giudice e parte in causa
20 settembre — Due articoli, lo stesso giorno, sullo stesso set di 2.018 elementi. Il primo presenta Zero-Token Confidence: una sonda legge l’ultimo stato nascosto del modello in un singolo forward pass e ne ricava una probabilità calibrata, senza generare alcun token. Chiedere al modello se è sicuro produce un’area sotto la curva pari a 0,5000, cioè il caso; leggerne lo stato interno produce 0,8801, in 0,0615 secondi contro gli 1,631 necessari per generare una risposta. Il secondo mette alla prova tredici verificatori: soltanto tre superano 0,70 e ZTC precede JEV di 0,0014, un divario non distinguibile.
Il dato più solido è un altro: un riferimento che considera soltanto la lunghezza e la formattazione della risposta, mai il suo contenuto, raggiunge 0,7036 e batte otto dei tredici sistemi. Una riserva: l’autore della classifica non è una terza parte neutrale — dichiara di misurare anche il proprio sistema, senza precisare quale dei tredici sia, e i due articoli escono lo stesso giorno. I numeri possono essere esatti; l’indipendenza della classifica, invece, non è dimostrata.
🔗 ZTC · classifica
Un LoRA da 54 dollari che corregge e rompe allo stesso tempo
20 settembre — ScalablyAI ha addestrato, per 53,88 dollari, due adattatori LoRA su Qwen3.8-27B a partire dai 143.145 blocchi di utilizzo degli strumenti lasciati dalla sua piattaforma di agenti, per poi valutarli rispetto a una suite congelata prima del primo passaggio di addestramento.
Il risultato è duplice. Su 73 stati di recupero dopo una chiamata a uno strumento rifiutata, l’adattatore passa da 31 a 38 successi, con sette casi che si spostano a suo favore e nessuno in senso contrario. Ma su 73 decisioni relative a traiettorie corrette, scende da 49 a 45, cinque punti e mezzo oltre una soglia fissata a due. Poiché scaricare un adattatore è un’operazione atomica, rinunciare al peggioramento imponeva di abbandonare anche il miglioramento: entrambi sono stati respinti. Da qui l’architettura scelta — 433 regole di memoria modificabili da un lato, i pesi lasciati intatti dall’altro.
If every useful experience immediately changes the weights, learning and corruption can become the same operation, and at production sample sizes you cannot tell which one you performed.
🇮🇹 Se ogni esperienza utile modifica immediatamente i pesi, apprendere e corrompere possono diventare la stessa operazione e, con le dimensioni dei campioni disponibili in produzione, non è possibile sapere quale delle due sia stata appena eseguita. — pavle-scalably sul blog di Hugging Face
🔗 Rapporto completo e registro delle prove
SeamFlow posiziona le cuciture UV dove le metterebbe un artista
20 settembre — Distendere una superficie 3D in 2D obbliga a tagliarla; una buona suddivisione posiziona queste cuciture dove saranno meno visibili. SeamFlow, presentato da Meshy AI con la City University of Hong Kong, Bambu Lab e la Nanyang Technological University, cambia la rappresentazione prima del modello: ogni spigolo della mesh diventa un token e l’etichetta binaria viene rilassata in un valore continuo, rendendo applicabile il flow matching.
I vantaggi sono strutturali: non servono più una fase di proiezione né un ordine arbitrario dei token, e ogni taglio previsto ricade su uno spigolo esistente. Addestrato su 350.000 mesh Objaverse con cuciture create da professionisti, il modello colloca i tagli nelle pieghe: l’angolo diedro medio lungo le cuciture raggiunge 67,59 gradi, contro 56,65 per xatlas e 55,97 per PartUV. Esegue l’unwrapping in 5,63 secondi, contro gli 11,46 di un riferimento autoregressivo, ed è scelto come prima opzione nel 61,0% dei casi, contro il 19,1% del concorrente successivo.
🔗 SeamFlow
Antigravity 2.15.1 porta la sandbox su Windows, senza attivarla
19 settembre — La versione 2.15.1 di Antigravity si riassume in una riga: il sandboxing dei file e della rete arriva su Windows. Un solo miglioramento e nessuna correzione, mentre la 2.15.0 del giorno precedente ne accumulava rispettivamente sette e sedici: un’aggiunta mirata, non una release di manutenzione.
Il vero tema è il divario rispetto al resto della gamma. Su Linux, la sandbox si basa sui namespace del kernel; su macOS, sui profili Seatbelt di sandbox-exec; in entrambi i casi è attiva per impostazione predefinita. Su Windows, la primitiva impiegata non è documentata, l’attivazione resta manuale tramite una casella «Enable Sandbox Mode (Preview)» e nessuno dei tre preset di sicurezza proposti — Default, Full machine, Turbo mode — la abilita: selezionando la casella, il preset passa a Custom. Google annuncia l’allineamento per una versione futura, senza fornire una tempistica.
In breve
- Cinque annotatori, la stessa istruzione, cinque risposte diverse — su 100 scene turche e con un riferimento umano di 9 positivi, cinque annotatori automatici producono da 0 a 78 positivi, mentre tutti i kappa di Cohen restano compresi tra 0,000 e 0,185 nonostante un accordo grezzo dal 74,7 all’86,3%. L’autore, che dichiara di essere il creatore dello schema valutato, ricorda che un progettista non è un giudice neutrale della trasferibilità del proprio schema. 🔗 fonte
- La nightly di Gemini CLI del 20 settembre non contiene alcuna modifica — il tag
v0.62.0-nightly.20260920.gcfbcaa8dfpunta allo stesso commit del giorno precedente, con lo stesso suffisso dell’hash, e la pagina della versione non mostra alcuna sezione «What’s Changed». Anche i canali stable (v0.60.0) e preview (v0.61.0-preview.0) restano invariati. 🔗 fonte - Eyeball, il plugin di Copilot CLI scritto da un giurista di GitHub, è open source — lo strumento inserisce screenshot del documento sorgente nel punto della clausola analizzata, affinché l’analisi e la relativa prova possano essere lette fianco a fianco. Il repository
dvelton/eyeballè pubblico con licenza MIT, scritto in Python, ha 35 stelle e non riceve commit dal 5 aprile 2026. 🔗 fonte - Token npm limitati allo staging, dal 18 settembre — l’autorizzazione «Read and write (stage only)» consente a una pipeline di integrazione continua di depositare una versione tramite
npm stage publishsenza poterla pubblicare; la messa online richiede l’approvazione 2FA di un maintainer. Il blocco viene applicato dal registro, anche per un token configurato per aggirare la 2FA; npm eliminerà questa pubblicazione diretta nel gennaio 2027. 🔗 fonte - La regola sulla code coverage è controllabile tramite API REST, sempre dal 18 settembre — l’opzione del ruleset «Restrict code coverage», che impone una soglia minima o limita il calo tollerato su una pull request, diventa generalmente disponibile nell’API e quindi nell’infrastruttura come codice. Riservata a GitHub Enterprise Cloud e GitHub Team, escluso GitHub Enterprise Server. 🔗 fonte
- Wan mette in evidenza la sua funzionalità Peel-Off Sticker — l’account Alibaba Wan mostra una funzione di wan.video che inserisce una foto personale in una scena e la anima con Wan 3.0. Non si tratta di un lancio: il messaggio non indica né una data di apertura, né un prezzo, né una misura della qualità. 🔗 fonte
- Cohere pubblica quattro foto dalla conferenza ALL IN di Montréal — il messaggio del 19 settembre segnala la presenza di Aston Martin F1 e Magnus Carlsen accanto all’azienda. Nessun annuncio di prodotto, nessun dato, nessun link. 🔗 fonte
Che cosa significa
L’unico modello uscito nel fine settimana è aperto e consolida anziché aggiungere. Qwen-Image-2.1 non si accumula accanto a Qwen-Image-Layered: lo incorpora ed elimina un modello dedicato vecchio di nove mesi, integrando la trasparenza nel modello principale. Lo stesso movimento avviene tra generazione ed editing, riuniti in un’unica serie di pesi. Per chi produce contenuti visivi, significa una pipeline più corta — un solo modello da caricare, un livello RGBA direttamente utilizzabile, nessuna fase di scontornamento — e l’ecosistema ha seguito nello stesso giorno, con vLLM-Omni e ComfyUI operativi fin dalla pubblicazione.
Tre articoli di domenica raccontano la stessa preoccupazione da tre prospettive: sapere se ci si può fidare di ciò che produce un modello e a quale costo. Zero-Token Confidence risponde in termini di costo — 0,0615 secondi contro 1,631, perché un verificatore che genera token compete con l’agente per lo stesso budget. La classifica dei tredici verificatori risponde in termini di misurazione e il suo insegnamento è spiacevole per il settore: un riferimento che considera soltanto la lunghezza e la formattazione di una risposta ne batte otto su tredici. La soglia da superare per dimostrare che un verificatore legge davvero è quindi più alta di quanto mostri la maggior parte di essi — e il fatto che l’autore ammetta di misurare anche il proprio sistema invita ad attendere una replica da parte di terzi.
Il rapporto di ScalablyAI aggiunge la dimensione che manca agli altri due: la reversibilità. Un aggiornamento dei pesi da 54 dollari ha prodotto, nello stesso artefatto, un miglioramento misurato nel recupero dopo un errore e una possibile perdita nelle decisioni corrette, con una dimensione del campione che in produzione non permette di distinguerli. Poiché non è possibile scaricare metà di un adattatore, è stato necessario scartare tutto. La conclusione operativa — la conoscenza che costa poco annullare vive nei file di testo, mentre i pesi cambiano soltanto dietro una suite congelata — costituisce un utile contrappunto alla retorica sull’IA che migliora da sola.
Sul fronte degli strumenti, l’isolamento tramite il sistema operativo diventa una base anziché un’opzione. Qwen Code trasforma bubblewrap in una base di esecuzione interna, Antigravity porta la sua sandbox su Windows, npm inventa un token che prepara una versione senza poterla pubblicare: tre editori che, in tre giorni, spostano la sicurezza dalle dichiarazioni ai valori predefiniti. Con una riserva nel caso di Windows: una sandbox da selezionare manualmente e che nessuno dei tre preset proposti abilita non è ancora una protezione predefinita, e il divario rispetto a macOS e Linux rimane intatto finché Google non fornirà una tempistica.
Fonti
- Alibaba Qwen su X, annuncio di Qwen-Image-2.1
- Qwen, articolo su Qwen-Image-2.1
- Qwen-Image-2.1 su Hugging Face
- vLLM su X, supporto fin dal primo giorno
- Qwen Code, note di rilascio della v0.24.2
- Zero-Token Confidence
- Tredici verificatori di risposte su un unico set di test
- ScalablyAI, memoria veloce e pesi lenti
- ScalablyAI, registro delle prove
- SeamFlow, unwrapping UV tramite flow matching
- SeamFlow, pagina del progetto
- Antigravity, changelog
- Antigravity, documentazione della sandbox
- Accordo tra cinque annotatori LLM
- Gemini CLI, nightly del 20 settembre
- GitHub su X, Eyeball diventa open source
- GitHub, token npm limitati allo staging
- GitHub, regola sulla code coverage tramite API REST
- Alibaba Wan su X, Peel-Off Sticker
- Cohere su X, conferenza ALL IN