Samedi et dimanche, les laboratoires se taisent : ni DeepSeek, ni Meta, ni Ai2, ni Sakana, ni Mistral, ni xAI n’ont rien publié, et les comptes officiels du domaine des modèles ouverts sont restés vides deux jours durant. Une seule vraie sortie : Qwen-Image-2.1, publié dimanche en milieu d’après-midi en poids ouverts. Le gros du reste tient en cinq billets du blog communautaire Hugging Face, une version d’Antigravity qui ne corrige rien, et deux entrées de changelog GitHub rattrapées du 18 septembre — une journée calme, qu’il n’y a aucune raison de gonfler.
Qwen-Image-2.1, un seul modèle pour générer, éditer et livrer de la transparence
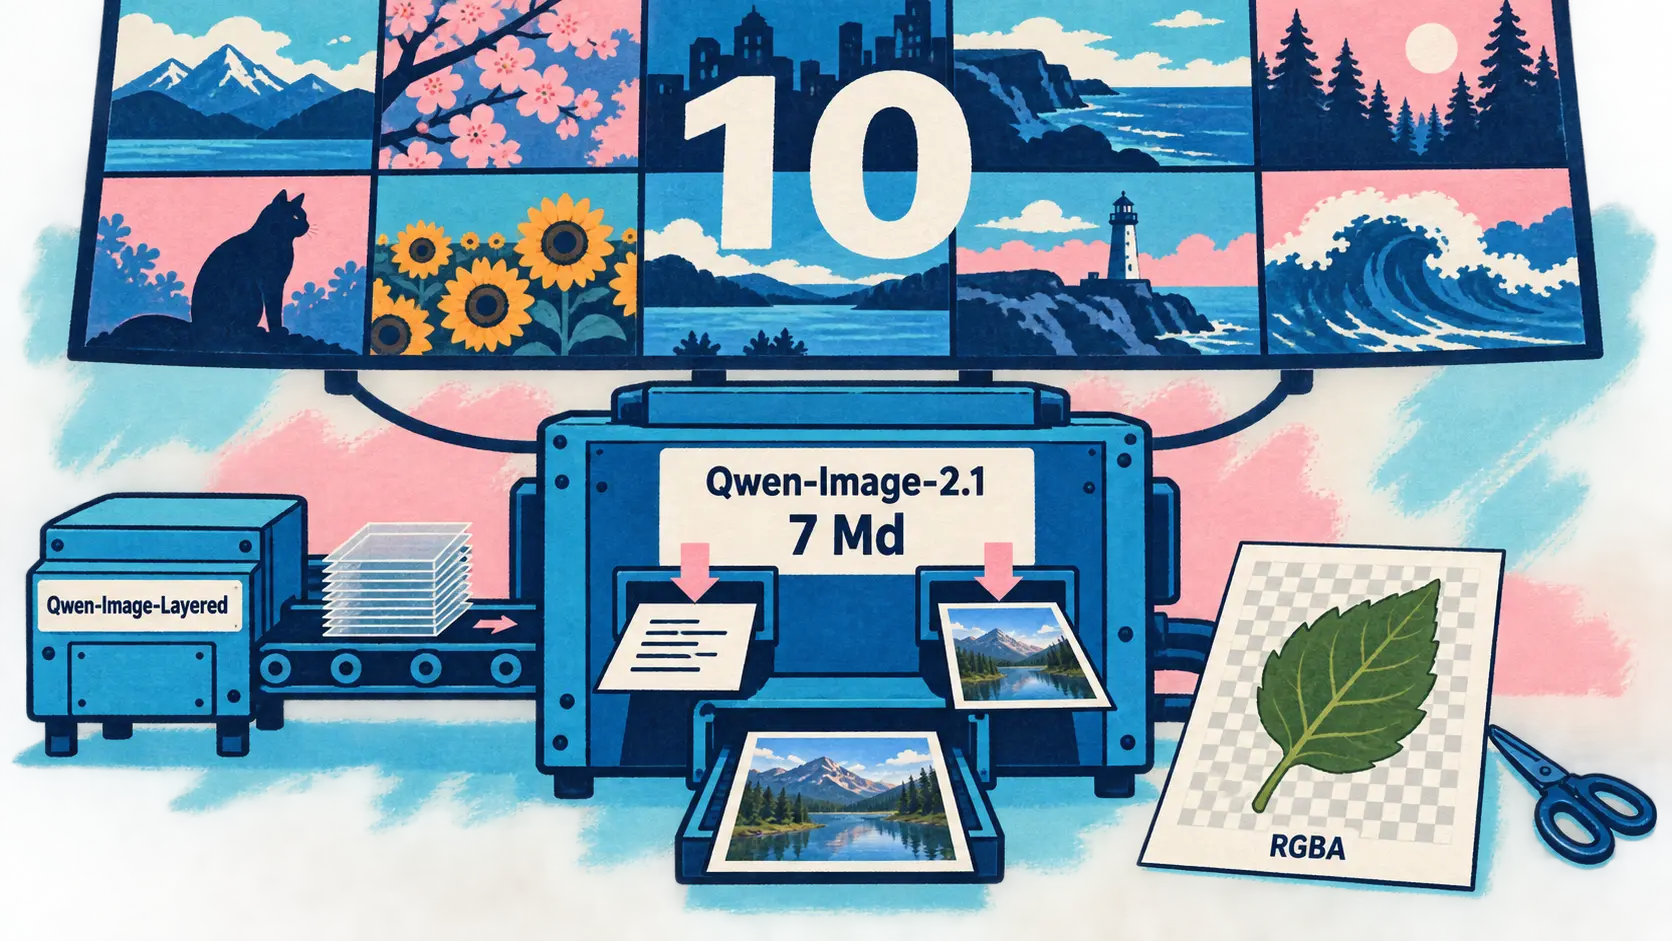
20 septembre — Qwen a publié Qwen-Image-2.1, son modèle de génération et d’édition d’images, en poids ouverts sur Hugging Face, ModelScope et GitHub. L’argument n’est pas la taille mais l’unification : une même série de poids couvre la création à partir d’une instruction textuelle et la retouche d’images existantes, là où ces deux usages demandaient deux modèles.
La nouveauté la plus concrète est la transparence native : le modèle produit et modifie directement des calques RGBA, et c’est l’instruction qui décide si la sortie porte un canal de transparence. Qwen assurait cette capacité depuis décembre 2025 par un modèle dédié, Qwen-Image-Layered, désormais absorbé. Une étape de détourage disparaît : extraire un sujet d’une photographie en calque réutilisable, ou remplacer le texte dans un calque transparent.
Côté édition, le modèle accepte jusqu’à 10 images de référence pour une même composition, et la zone à retoucher se désigne par un cercle de couleur, une annotation peinte, ou un masque fourni à part — cette troisième voie existant parce que les deux premières recouvrent le contenu d’origine. L’efficacité repose sur une attention à granularité mixte, les entrées d’édition formant un contexte statique mis en cache dès la première étape.
| Élément technique | Valeur annoncée |
|---|---|
| Paramètres de génération visuelle | 7 milliards, sur 32 couches Single-Stream DiT |
| Images de référence acceptées | 10 au maximum |
| Transparence des sorties | Calques RGBA natifs, en génération comme en édition |
| Modèle dédié absorbé | Qwen-Image-Layered, publié en décembre 2025 |
| Prise en charge dès le premier jour | vLLM-Omni et ComfyUI |
Qwen publie une comparaison sur Qwen-Image-Bench, mais ses valeurs ne figurent que dans une image du billet : elles ne sont pas reprises ici.
Generate, edit, and create transparent images with one model: a 7.1B DiT paired with Qwen3-VL-8B.
🇫🇷 Générer, éditer et créer des images transparentes avec un seul modèle : un DiT de 7,1 milliards de paramètres associé à Qwen3-VL-8B. — @vllm_project sur X
🔗 Annonce
Qwen Code v0.24.2, la voix complète dans le Web Shell et le bac à sable bwrap qui s’étoffe
Même éditeur, même journée, produit sans rapport. 20 septembre — publiée un peu plus de vingt-quatre heures après la v0.24.1, la v0.24.2 de l’agent de code en ligne de commande de Qwen est la première de sa série sans aucun changement cassant, là où les deux précédentes en comportaient chacune une.
Le bac à sable bubblewrap reçoit une fondation d’exécution complète : lancement de processus structuré, supervision, workers confinés. Dans le même registre, un espace de travail à la confiance non tranchée exige désormais une décision explicite. Le Web Shell, lui, rend la fonction Live Voice réellement utilisable : le modèle et la voix se choisissent depuis la carte de configuration, et le niveau du micro s’affiche pendant l’appel. Pour qui fait tourner plusieurs sessions en parallèle, chaque message entrant est désormais évalué pour la session à laquelle il est adressé, et le cache de prompt est préservé pour les outils différés.
Vérifier une réponse sans écrire un token, et un classement dont l’auteur est juge et partie
20 septembre — Deux billets, le même jour, sur le même jeu de 2 018 items. Le premier présente Zero-Token Confidence : une sonde lit le dernier état caché du modèle en une passe avant et en tire une probabilité calibrée, sans générer un token. Lui demander s’il est sûr donne 0,5000 d’aire sous la courbe, soit le hasard ; lire son état interne donne 0,8801, en 0,0615 seconde contre 1,631 pour générer une réponse. Le second y passe treize vérificateurs : trois seulement franchissent 0,70, et ZTC devance JEV de 0,0014, écart non séparable.
Le fait le plus solide est ailleurs : une référence qui ne regarde que la longueur et la mise en forme de la réponse, jamais son contenu, atteint 0,7036 et bat huit des treize systèmes. Réserve : l’auteur du classement n’est pas un tiers neutre — il indique mesurer aussi son propre système, sans dire lequel des treize est le sien, et les deux billets paraissent le même jour. Les chiffres peuvent être exacts ; l’indépendance du classement, elle, n’est pas établie.
🔗 ZTC · classement
Un LoRA à 54 dollars qui corrige et casse à la fois
20 septembre — ScalablyAI a entraîné, pour 53,88 dollars, deux adaptateurs LoRA sur Qwen3.8-27B à partir des 143 145 blocs d’utilisation d’outils laissés par sa plateforme d’agents, puis les a évalués contre une suite gelée avant le premier pas d’entraînement.
Le résultat est double. Sur 73 états de récupération après un appel d’outil rejeté, l’adaptateur passe de 31 à 38 réussites, sept cas basculant en sa faveur et aucun contre. Mais sur 73 décisions de trajectoire propre, il recule de 49 à 45, cinq points et demi contre une barrière fixée à deux. Décharger un adaptateur étant atomique, renoncer au recul imposait d’abandonner le gain : les deux ont été rejetés. D’où l’architecture retenue — 433 règles de mémoire éditables d’un côté, les poids laissés tranquilles de l’autre.
If every useful experience immediately changes the weights, learning and corruption can become the same operation, and at production sample sizes you cannot tell which one you performed.
🇫🇷 Si chaque expérience utile modifie immédiatement les poids, apprendre et corrompre peuvent devenir la même opération, et aux effectifs dont dispose la production vous ne pouvez pas savoir laquelle des deux vous venez d’effectuer. — pavle-scalably sur le blog Hugging Face
🔗 Rapport complet et registre de preuves
SeamFlow place les coutures UV là où un artiste les mettrait
20 septembre — Déplier une surface 3D en 2D oblige à la couper ; un bon découpage place ces coutures là où elles se verront le moins. SeamFlow, présenté par Meshy AI avec la City University of Hong Kong, Bambu Lab et la Nanyang Technological University, change la représentation avant le modèle : chaque arête du maillage devient un token, et l’étiquette binaire est relâchée en valeur continue, ce qui rend l’appariement de flots (flow matching) applicable.
Les bénéfices sont structurels : plus d’étape de projection ni d’ordre arbitraire des tokens, chaque coupe prédite tombant sur une arête existante. Entraîné sur 350 000 maillages Objaverse aux coutures créées par des professionnels, le modèle place ses coupes dans les plis : l’angle dièdre moyen le long des coutures atteint 67,59 degrés, contre 56,65 pour xatlas et 55,97 pour PartUV. Il déplie en 5,63 secondes contre 11,46 pour une référence autorégressive, et il est préféré en premier choix dans 61,0 % des cas contre 19,1 % pour le suivant.
🔗 SeamFlow
Antigravity 2.15.1 ouvre le bac à sable sur Windows, sans l’activer
19 septembre — La version 2.15.1 d’Antigravity tient en une ligne : la mise en bac à sable des fichiers et du réseau arrive sur Windows. Une seule amélioration, aucun correctif, quand la 2.15.0 de la veille en empilait sept et seize — un ajout ciblé, pas une livraison de maintenance.
L’écart avec le reste de la gamme est le vrai sujet. Sous Linux, le bac à sable repose sur les namespaces du noyau ; sous macOS, sur les profils Seatbelt de sandbox-exec ; dans les deux cas il est actif par défaut. Sur Windows, la primitive employée n’est pas documentée, l’activation reste manuelle via une case « Enable Sandbox Mode (Preview) », et aucun des trois préréglages de sécurité proposés — Default, Full machine, Turbo mode — ne l’active : cocher la case bascule le préréglage en Custom. Google annonce l’alignement pour une version ultérieure, sans calendrier.
Brèves
- Cinq annotateurs, une même consigne, cinq réponses différentes — sur 100 scènes turques et pour une référence humaine à 9 positifs, cinq annotateurs machines vont de 0 à 78 positifs, tous les kappas de Cohen restant entre 0,000 et 0,185 malgré un accord brut de 74,7 à 86,3 %. L’auteur, qui déclare être celui du schéma évalué, rappelle qu’un concepteur n’est pas juge neutre de la transférabilité de son schéma. 🔗 source
- La nightly Gemini CLI du 20 septembre ne contient aucun changement — le tag
v0.62.0-nightly.20260920.gcfbcaa8dfest posé sur le même commit que celui de la veille, même suffixe de hash, et la page de la version n’affiche aucune section « What’s Changed ». Les canaux stable (v0.60.0) et preview (v0.61.0-preview.0) sont eux aussi inchangés. 🔗 source - Eyeball, le plugin Copilot CLI écrit par un juriste de GitHub, est open source — l’outil incruste des captures d’écran du document source à l’endroit de la clause analysée, pour que l’analyse et sa preuve se lisent côte à côte. Le dépôt
dvelton/eyeballest public sous licence MIT, en Python, 35 étoiles, sans commit depuis le 5 avril 2026. 🔗 source - Des jetons npm limités à la mise en attente, depuis le 18 septembre — la permission « Read and write (stage only) » laisse une chaîne d’intégration continue déposer une version via
npm stage publishsans pouvoir la publier, la mise en ligne exigeant l’approbation 2FA d’un mainteneur. Le blocage est appliqué côté registre, y compris pour un jeton configuré pour contourner la 2FA ; npm supprimera cette publication directe en janvier 2027. 🔗 source - La règle de couverture de code se pilote par API REST, depuis le 18 septembre également — l’option de jeu de règles « Restrict code coverage », qui impose un seuil minimum ou plafonne la baisse tolérée sur une pull request, entre en disponibilité générale dans l’API, donc dans l’infrastructure en tant que code. Réservée à GitHub Enterprise Cloud et GitHub Team, hors GitHub Enterprise Server. 🔗 source
- Wan met en avant sa fonctionnalité Peel-Off Sticker — le compte Alibaba Wan montre une brique de wan.video qui incruste une photo personnelle dans une scène et l’anime avec Wan 3.0. Ce n’est pas un lancement : le message ne comporte ni date d’ouverture, ni tarif, ni mesure de qualité. 🔗 source
- Cohere publie quatre photos depuis la conférence ALL IN de Montréal — le message du 19 septembre signale la présence d’Aston Martin F1 et de Magnus Carlsen aux côtés de l’entreprise. Aucune annonce produit, aucun chiffre, aucun lien. 🔗 source
Ce que ça signifie
La seule sortie de modèle du week-end est ouverte, et elle consolide au lieu d’ajouter. Qwen-Image-2.1 ne vient pas s’empiler à côté de Qwen-Image-Layered : il l’absorbe, et fait disparaître un modèle dédié de neuf mois en intégrant la transparence dans le modèle principal. Le même mouvement joue entre génération et édition, réunies dans une série de poids unique. Pour qui produit des visuels, cela veut dire une chaîne plus courte — un modèle à charger, un calque RGBA directement exploitable, pas d’étape de détourage — et l’écosystème a suivi le jour même, avec vLLM-Omni et ComfyUI opérationnels dès la publication.
Trois billets du dimanche racontent la même préoccupation sous trois angles : savoir si on peut faire confiance à ce que produit un modèle, et à quel prix. Zero-Token Confidence répond par le coût — 0,0615 seconde contre 1,631, parce qu’un vérificateur qui génère des tokens entre en concurrence avec l’agent pour le même budget. Le classement des treize vérificateurs répond par la mesure, et son enseignement est déplaisant pour la profession : une référence qui ne lit que la longueur et la mise en forme d’une réponse en bat huit sur treize. La barre à franchir pour prouver qu’un vérificateur lit vraiment est donc plus haute que ce que la plupart affichent — et le fait que son auteur reconnaisse mesurer aussi son propre système invite à attendre une reprise par un tiers.
Le rapport de ScalablyAI ajoute la dimension qui manque aux deux autres : la réversibilité. Une mise à jour de poids à 54 dollars a produit, dans le même artefact, un gain mesuré sur la récupération après échec et une perte possible sur les décisions saines, à un effectif où la production ne peut pas les départager. Comme on ne décharge pas la moitié d’un adaptateur, il a fallu tout jeter. La conclusion opérationnelle — le savoir bon marché à défaire vit dans des fichiers texte, les poids ne bougent que derrière une suite gelée — est un contrepoint utile au discours sur l’IA qui s’améliore elle-même.
Côté outillage, l’isolation par le système d’exploitation devient un socle plutôt qu’une option. Qwen Code fait de bubblewrap une fondation d’exécution interne, Antigravity porte son bac à sable sur Windows, npm invente un jeton qui prépare une version sans pouvoir la publier : trois éditeurs qui, en trois jours, déplacent la sécurité du discours vers la valeur par défaut. Avec une réserve sur le cas Windows : un bac à sable qu’il faut cocher à la main et qu’aucun des trois préréglages proposés n’active n’est pas encore une protection par défaut, et l’écart avec macOS et Linux reste entier tant que Google n’a pas donné de calendrier.
Sources
- Alibaba Qwen sur X, annonce de Qwen-Image-2.1
- Qwen, billet Qwen-Image-2.1
- Qwen-Image-2.1 sur Hugging Face
- vLLM sur X, prise en charge dès le premier jour
- Qwen Code, notes de version v0.24.2
- Zero-Token Confidence
- Treize vérificateurs de réponses sur un seul jeu de test
- ScalablyAI, mémoire rapide et poids lents
- ScalablyAI, registre de preuves
- SeamFlow, dépliage UV par appariement de flots
- SeamFlow, page projet
- Antigravity, changelog
- Antigravity, documentation du bac à sable
- Accord entre cinq annotateurs LLM
- Gemini CLI, nightly du 20 septembre
- GitHub sur X, Eyeball passe en open source
- GitHub, jetons npm limités à la mise en attente
- GitHub, règle de couverture de code par API REST
- Alibaba Wan sur X, Peel-Off Sticker
- Cohere sur X, conférence ALL IN