ai-powered-markdown-translatorArtikel vertaald van het Frans naar het Nederlands met gpt-6.1-sol.
Anthropic stelt de message threads van de Messages API beschikbaar in publieke bèta. Ze zijn al actief in Claude Code, waar ze bij de langste verzoeken de tijd tot het eerste token met ongeveer 35 % verkorten. Sakana AI kondigt Sawara aan, zijn eerste modellen die vanaf nul zijn voorgetraind, terwijl OpenAI Grid Protectors lanceert om zijn rekencampussen hun stroomverbruik te laten verlagen wanneer het elektriciteitsnet dat nodig heeft, en LifeVal publiceert, een benchmark voor alledaagse taken. Perplexity publiceert BrowseSafe++ tegen promptinjectie, NVIDIA biedt simulatietools met Cosmos 3 Nano, en Runway, Synthesia en ElevenLabs brengen generatieve media naar assistenten en agents.
De Messages API introduceert message threads in publieke bèta, al actief in Claude Code
2 november — Anthropic stelt berichtenthreads (message threads) beschikbaar in publieke bèta op de Messages API. Tot nu toe stuurde een agent bij elke beurt het volledige gesprek opnieuw mee, inclusief de resultaten van tools. Met een thread verstuurt het eerste verzoek het volledige gesprek, met de systeemprompt en de tools; de volgende verzoeken versturen alleen de nieuwe berichten en de identificatie van het vorige antwoord, waarna de API de rest reconstrueert voordat het model wordt aangeroepen. Het volstaat om de parameter thread en de bètaheader message-threads-2026-08-12 toe te voegen, waarvoor de officiële SDK’s een speciale hulpfunctie bieden.
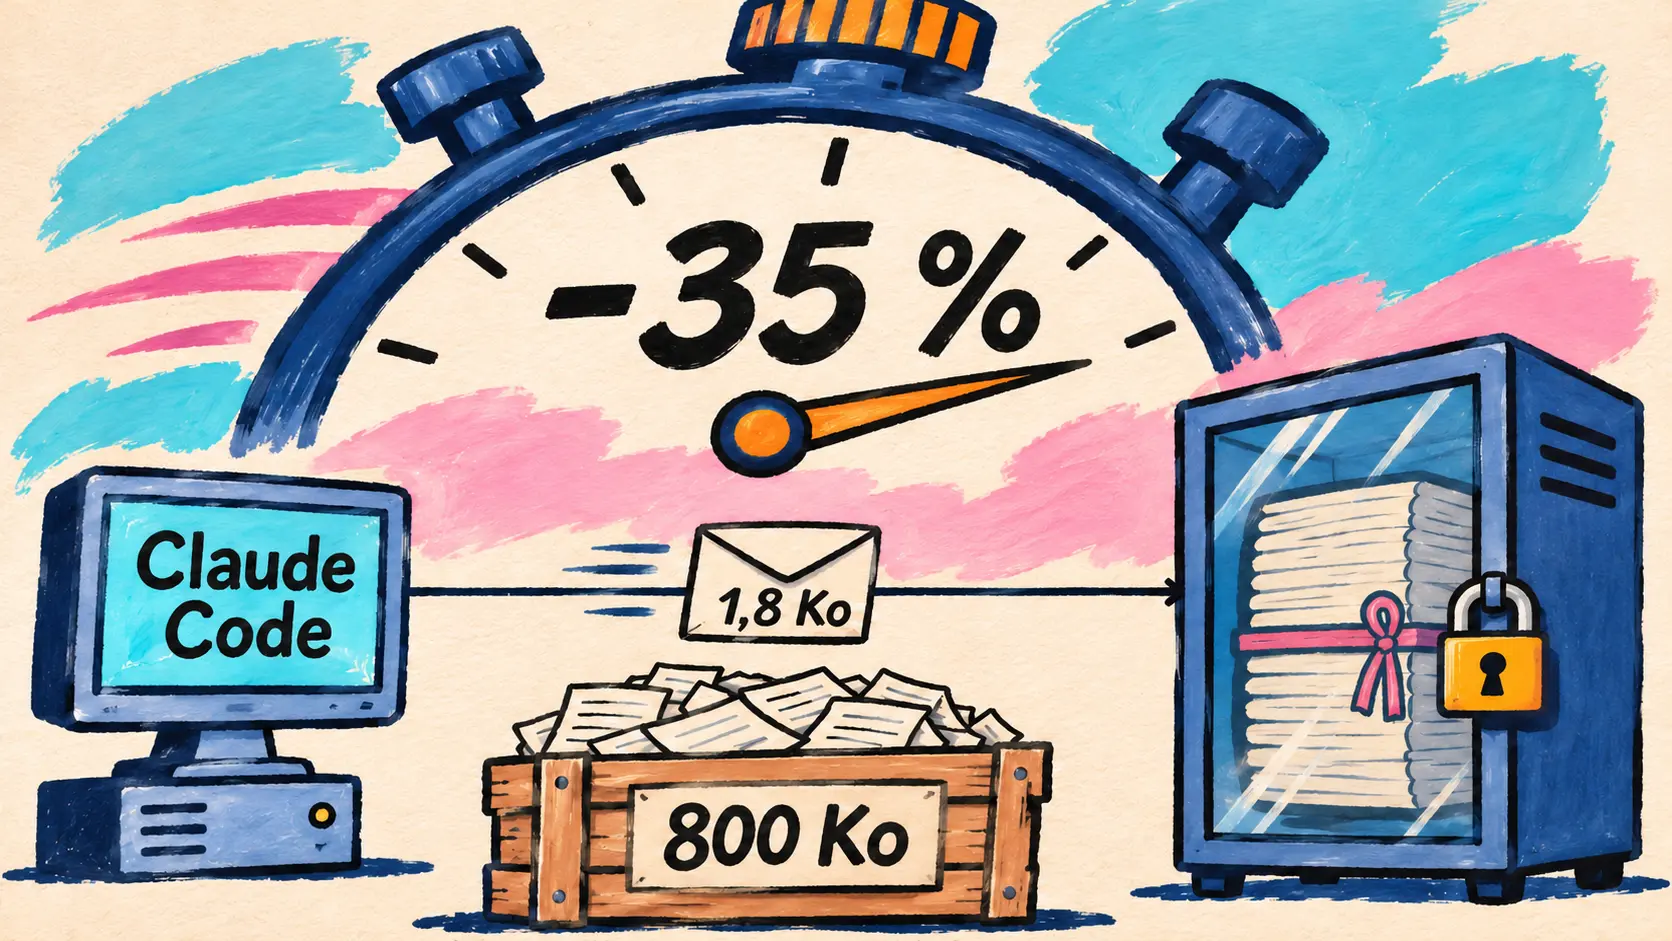
We recently integrated message threads in Claude Code. On requests with 500K to 1M tokens, median time to first token is about 35% lower. In long conversations, the median request went from about 800 KB to 1.8 KB.
🇳🇱 We hebben onlangs message threads geïntegreerd in Claude Code. Bij verzoeken van 500 000 tot 1 miljoen tokens is de mediane tijd tot het eerste token ongeveer 35 % korter. In lange gesprekken is het mediane verzoek van ongeveer 800 Ko naar 1,8 Ko gegaan. — @ClaudeDevs op X
De winst zit in de latentie, niet in de rekening: Claude leest bij elke beurt het volledige gesprek opnieuw, waardoor het aantal tokens, de tarieven en de limieten voor de verwerkingssnelheid niet veranderen. Het cachen van prompts (prompt caching) moet nog steeds zelf worden aangevraagd. De thread wordt zo goed mogelijk (best-effort) bewaard, in versleuteld geheugen en nooit op schijf: hij verloopt 5 minuten na het laatste verzoek, en de applicatie bewaart een eigen kopie om alles opnieuw te versturen als de API een 404 retourneert. De functie komt niet in aanmerking voor nul gegevensbewaring (ZDR) en werkt niet met Message Batches, compaction op aanvraag of binnen HIPAA-organisaties. Ze is beschikbaar op de Claude API, Claude Platform on AWS, Claude in Microsoft Foundry en Claude Models on Google Cloud (Anthropic managed).
🔗 Het artikel van Anthropic over message threads · De documentatie over message threads
Sakana AI kondigt Sawara aan, zijn eerste modellen die vanaf nul worden voorgetraind, met gewichten gepland voor het voorjaar van 2027
2 november — Sakana AI publiceert het verslag van zijn symposium van 26 oktober in Tokio (meer dan 400 deelnemers, lezing van Jürgen Schmidhuber), en daarin staat een heuse aankondiging: de Japanse start-up gaat eigen taalmodellen voortrainen. Tot nu toe werkte het bedrijf aan agents en aan de post-training van bestaande open modellen met Namazu. De Sawara-serie (voorlopige naam), gepresenteerd door wetenschappelijk directeur (Chief Scientist) Takuya Akiba, wordt vanaf nul opgebouwd, zonder uit te gaan van een model van derden, en is ontworpen voor gebruik door agents (agent-native): redeneren met tools, code en langdurige taken. De serie moet de basis vormen voor de producten van Sakana AI en het onderzoek van het RSI Lab naar recursieve zelfverbetering.
We are now preparing for training, and we will start pre-training Sawara Small (provisional name) this December. If everything goes smoothly, we will release the weights next spring.
🇳🇱 We bereiden nu de training voor en beginnen in december met de pretraining van Sawara Small (voorlopige naam). Als alles goed gaat, publiceren we de gewichten volgend voorjaar. — Sakana AI, verslag van het symposium van 2026
Er moet ook een Sawara Large volgen, eveneens een voorlopige naam, maar zonder datum. Sakana AI noemt geen modelgrootte, hoeveelheid data of rekenbudget.
🔗 De aankondiging van Sakana AI op X
Energie voor rekenkracht: OpenAI lanceert Grid Protectors, een TPU van Google antwoordt vanuit een baan om de aarde
OpenAI lanceert Grid Protectors, tot 1 000 MW minder stroomverbruik voor zijn campus in Effingham
2 november — OpenAI lanceert Grid Protectors, een landelijk programma waarmee zijn toekomstige rekencampussen hun stroomverbruik verlagen wanneer het elektriciteitsnet onder druk staat, tijdens een koudegolf of hittegolf. Samen met elektriciteitsleveranciers, toezichthouders en beleidsmakers wil het bedrijf per locatie overeenkomsten sluiten waarin wordt vastgelegd hoeveel het verbruik kan worden verlaagd, hoe snel dat moet gebeuren en hoelang. Afhankelijk van de lokale behoeften kunnen de campussen ook gebruikmaken van productie of opslag op locatie en hun vraag met batterijen afvlakken.
De proeflocatie is de geplande campus in Effingham County, Georgia, die in juli werd gepresenteerd onder de naam Project Camellia. OpenAI verbindt zich ertoe daar alle kosten voor infrastructuur en elektriciteitsvoorziening te betalen.
| Aangekondigd cijfer | Aangekondigde waarde | Bron van het cijfer |
|---|---|---|
| Geplande flexibele vermindering van de stroomafname in de overeenkomst met Georgia Power | tot 1 000 MW | OpenAI |
| Equivalent in gemiddelde stroomvraag van huishoudens | ongeveer 700 000 huishoudens | OpenAI |
| Jaarlijkse besparingen voor klanten van Georgia Power vanaf 2029 | ongeveer 950 miljoen dollar | Georgia Power |
| Voordeel voor een doorsnee particuliere klant die 1 000 kWh verbruikt | minstens 15 dollar per maand | Georgia Power |
De raming van Georgia Power heeft betrekking op al zijn overeenkomsten met grootverbruikers en op de verwachte groei, inclusief Project Camellia: het is geen cijfer dat specifiek op het programma van OpenAI slaat. Het bedrijf erkent dat flexibiliteit investeringen in nieuwe productie- en transportcapaciteit niet vervangt en kondigt geen andere locatie of tijdschema aan.
🔗 De blogpost van OpenAI over Grid Protectors
Project Suncatcher: een TPU in een baan om de aarde geeft zijn eerste antwoord, een haiku geschreven door Gemma 4
30 oktober — Terugblik: een maand na de lancering van zijn prototypesatelliet op 1 oktober bereikt Project Suncatcher, het onderzoeksproject van Google naar rekenkracht voor AI in de ruimte, zijn mijlpaal ‘Hello World’: het eerste AI-antwoord dat door een TPU van datacenterklasse in een baan om de aarde is geproduceerd. Tijdens een passage boven een grondstation vroeg het team het open model Gemma 4 aan boord om een haiku over het leven in de ruimte; het antwoord werd teruggestuurd toen de satelliet over Spitsbergen in Noorwegen vloog. Daarna volgden limericks en telemetrieprompts, waarop het model antwoordt door de technische toestand van de nuttige lading te beschrijven.
De volgende stap draait om betrouwbaarheid: tests van de TPU’s onder thermische belasting en straling, gevolgd door een paar onderling verbonden satellieten in 2027. De blogpost geeft geen cijfers over prestaties of verbruik.
🔗 De blogpost van Google over het eerste antwoord van de satelliet
Dagelijks leven en creativiteit van interfaces: OpenAI publiceert LifeVal, Kombai publiceert Design Creativity Bench
LifeVal: 169 alledaagse taken, van 49,3 % voor GPT-5.2 tot 80,6 % voor GPT-6 Astra
2 november — OpenAI publiceert LifeVal, een evaluatie van modellen op alledaagse taken: kinderopvang vinden, toegang krijgen tot overheidsdiensten, een budget opstellen, een recept aanpassen of een sportprogramma samenstellen. De taken zijn gebaseerd op twee grote onderzoeken naar tijdsbesteding, de American Time Use Survey en de Multinational Time Use Study, aangevuld met een representatief onderzoek onder 3 995 mensen naar de gebieden waarop ze het liefst hulp zouden krijgen. OpenAI zegt de evaluatie al een jaar te gebruiken om zijn modellen te volgen.
| Geëvalueerd model | Releasedatum | Gemiddelde beloning over 169 taken |
|---|---|---|
| GPT-5.2 | december 2025 | 49,3 % |
| GPT-5.4 | maart 2026 | 73,0 % |
| GPT-5.5 | april 2026 | 77,4 % |
| GPT-5.6 | juli 2026 | 80,0 % |
| GPT-6 Astra (xhigh) | september 2026 | 80,6 % |
Volgens de beschrijving van de grafiek gaat het om een ongewogen gemiddelde van de 169 taken, en ligt er slechts 0,6 procentpunt tussen GPT-5.6 en GPT-6 Astra. De grafiek bevat geen GPT-6.1 Sol of Terra en ook geen modellen van andere aanbieders. OpenAI vermeldt niet dat de verzameling taken wordt gepubliceerd.
🔗 De blogpost van OpenAI over LifeVal
Design Creativity Bench: modellen komen uit op dezelfde interfaces
2 november — Kombai, aanbieder van AI-tools voor front-endontwikkeling, presenteert op de blog van Hugging Face Design Creativity Bench, een benchmark die niet meet of een interface werkt, maar of die op andere interfaces lijkt. Het onderzoek omvat 15 toonaangevende modellen, 160 instructies en 2 400 HTML-interfaces, die worden vergeleken met door mensen gemaakte ontwerpen.
| Maatstaf van de benchmark | Geëvalueerde modellen | Menselijke referentie |
|---|---|---|
| Gemiddeld onderscheid bij dezelfde instructie | 0,592 tussen modellen | 0,764 tussen mensen en modellen |
| Gemiddelde creatieve bandbreedte | 0,581 | 0,902 |
| Vervulde acceptatiecriteria | meer dan 90 % voor alle modellen (Claude Opus 5.5: 99,2 %) | 98,0 % |
De modellen voldoen dus aan de eisen, maar lijken op elkaar. GPT-6 Astra heeft de meest onderscheidende stijl van de onderzochte modellen (0,646 voor originaliteit), terwijl het weinig varieert tussen contexten (0,472 voor bandbreedte). Kombai publiceert het artikel (arXiv 2610.11539), een ranglijst en een subset voor reproduceerbaarheid, en erkent de beperkingen: alleen desktopschermen en standaardinstellingen van de API’s.
🔗 De blogpost van Kombai op Hugging Face
Perplexity publiceert BrowseSafe++ en zijn BrowseSafe-Guard-detectoren tegen promptinjectie
2 november — Het Perplexity Secure Intelligence Institute publiceert BrowseSafe++, de opvolger van BrowseSafe (december 2025), een open benchmark voor indirecte promptinjectie (indirect prompt injection) gericht op agents die op het web kunnen navigeren. De benchmark omvat 38 675 paren webpagina’s, telkens een aangevallen pagina en een schone tweelingversie, waarvan 32 187 zijn opgebouwd rond daadwerkelijk waargenomen injecties: de detector van Comet signaleerde er 1,15 miljoen tussen september 2025 en september 2026. Elke pagina is beschikbaar als HTML, Markdown, toegankelijkheidsboom en screenshot. Perplexity leidt hieruit BrowseSafe-Guard af: twee detectoren van 0,8B die zijn gefinetuned op basis van Qwen3.5-0.8B, één voor tekst en één voor screenshots.
| Gepubliceerd resultaat | BrowseSafe-Guard | Vergeleken modellen |
|---|---|---|
| F1 op de tekstweergaven | ongeveer 95 %, eerste in elke weergave | 85 tot 92 % voor de beste generalistische modellen |
| F1 op screenshots | ongeveer 93 % | ongeveer 79 % voor het beste andere model |
| Ten onrechte gemarkeerde schone pagina’s | ongeveer 1 op 20 | 14,41 % voor GPT-6 Astra |
| Kosten voor 1 000 pagina’s | 0,18 dollar op een gehuurde H200 | 18,95 tot 180,61 dollar via API |
Detecteren betekent niet weerstaan: elk model volgde injecties op die het zelf had herkend, van 1,64 % van de pagina’s voor GPT-6 Astra tot 24,73 % voor Llama 3.1 8B. Ook een vasthoudende aanvaller komt er uiteindelijk doorheen: in de BrowseSafe-Adapt-omgeving, die de injectie na elke mislukking herschrijft (1 024 taken, tot 64 pogingen), stijgt het succespercentage van hoogstens 4 % bij de eerste poging naar minstens 79 % tegen vijf van de zeven geteste agents. Als Guard vóór een Gemini 3.5 Flash-Lite-agent wordt geplaatst, blokkeert het 94,5 % van de oorspronkelijke injecties, maar de aanvaller slaagt nog steeds bij 84,2 % van de taken. De dataset (met gecontroleerde toegang), een SDK onder MIT-licentie en een openbare ranglijst zijn beschikbaar; de blogpost bevat geen links naar gewichten van de detectoren.
🔗 De blogpost van Perplexity over BrowseSafe++
Generatieve media: Runway Dev komt naar Claude Code en Cursor, Synthesia naar ChatGPT en Claude, ElevenLabs kwantificeert het voordeel van spraak
Runway Dev komt naar Claude Code en Cursor
2 november — Na Codex, dat op 28 oktober werd gepresenteerd, breidt Runway zijn Runway Dev-plugins uit naar Claude Code en Cursor. Een installatie koppelt de coding agent aan het Runway Dev-account via de MCP-server van Runway en voegt de skills van Runway toe om met zijn API voor generatieve media te ontwikkelen. De agent leest eerst het account uit (projecten, beschikbare modellen met hun prijzen en limieten, creditsaldo) en gebruikt vervolgens de officiële SDK’s: hij kan een Model Router maken, die voor elk verzoek het geschikte model kiest, of een Character voor realtime avatars, en Recipes (kant-en-klare pipelines) of Workflows hergebruiken die als API-endpoints zijn gepubliceerd. Bij een fout raadpleegt hij de foutdetails. De verbinding met het account wordt bij het eerste gebruik gemaakt, zonder dat er een API-sleutel in de plugin wordt opgeslagen, en er wordt geen afzonderlijk tarief vermeld.
| Coding agent | Door Runway aangegeven installatie |
|---|---|
| Claude Code | /plugin install runway-api@claude-plugins-official |
| Cursor | /add-plugin runway-api in de Agent-chat, of via de Cursor Marketplace |
Synthesia maakt zijn video’s in ChatGPT en Claude
2 november — Synthesia kondigt aan dat zijn avatarvideo’s voortaan rechtstreeks in ChatGPT en Claude kunnen worden gemaakt: de gebruiker beschrijft de gewenste video, ziet die in het gesprek verschijnen, verfijnt die met aanvullende verzoeken en publiceert en deelt die vervolgens, zonder een andere applicatie of een ander tabblad te openen. De aankondiging bestaat uit een tweet met een demonstratievideo; op het moment van onze controle stond er geen blogpost op de blog of de homepage van Synthesia. Synthesia vermeldt daarbij niet hoe de integratie werkt, voor welke abonnementen die beschikbaar is of wat het tarief is.
🔗 De aankondiging van Synthesia op X
ElevenLabs: spraak heeft bij gesprekken langer dan twee minuten 32 % vaker succes dan chat
2 november — ElevenLabs publiceert een onderzoek waarin spraak (telefoon en WhatsApp) en chat worden vergeleken bij ElevenAgents-agents in productie, waarbij elke agent met zichzelf wordt vergeleken op basis van zijn gesprekken van mei tot juli 2026. De aankondigingstweet noemt 469 agents; het artikel spreekt van « honderden » agents.
The longer the conversation, the higher the success rate for voice agents. We analyzed 469 agents running both voice and chat in production and saw an interesting pattern. When the conversation gets complex, voice is the fastest path to resolution.
🇳🇱 Hoe langer het gesprek, hoe hoger het succespercentage van spraakagenten. We hebben 469 agents geanalyseerd die in productie zowel via spraak als via chat werken en een interessante trend waargenomen. Wanneer een gesprek complex wordt, is spraak de snelste weg naar een oplossing. — @ElevenLabs op X
| Indicator volgens ElevenLabs | Gemeten waarde |
|---|---|
| Succes van spraak bij gesprekken langer dan twee minuten | +10,9 punten, oftewel +31,7 % |
| Gesprekken van minder dan een minuut | chat ongeveer 9 punten hoger |
| Duur van succesvolle lange gesprekken | 4,6 minuten via spraak, 7 minuten via chat |
| Overstap naar een sneller LLM (315 gesprekken) | latentie 16 % lager, succes 26 % hoger |
| Voorkeur voor spraak (98 deelnemers, geannuleerde vlucht) | 85 % |
De duur dient hier als indicator voor complexiteit, een volgens het artikel onvolmaakte maat, en het onderzoek komt van de leverancier, die er zijn spraakagenten in promoot.
NVIDIA publiceert simulatierecepten met Cosmos 3 Nano voor autorijden, robotica en chirurgie
2 november — NVIDIA publiceert op zijn technische blog een tweedelige handleiding voor Cosmos, zijn platform voor foundationmodellen van de wereld (world foundation models) voor fysieke AI: simulatierecepten op basis van nieuwe Cosmos 3 Nano-checkpoints, aangekondigd op 22 oktober en nu bij naam genoemd en beschreven, gevolgd door een handleiding voor NIM-microservices. Een uitgelicht voorbeeld: alleen de prompt wijzigen volstaat om een rit overdag te veranderen in een rit tijdens een regenachtige nacht, zonder het wegverloop of de trajecten van de voertuigen aan te passen.
| Cosmos 3-checkpoint | Door NVIDIA beschreven toepassing |
|---|---|
| Cosmos3-Nano-Transfer-Auto | Multicameraclips met LiDAR voor autorijden, tot 400 beelden in 480p of 720p |
| Cosmos3-Nano-Sim-Auto | Gedistilleerde causale variant die streaming genereert om een rijstrategie in een gesloten lus te testen |
| Cosmos3-Nano-Sim-Transfer | Dieptevideo omgezet in gedetailleerde RGB-video, voor robotica |
| Cosmos3-Nano-Sim-Bimanual | Volgende waarneming van een robot met twee armen op basis van de scène en zijn acties |
| Cosmos3-H-Embodied-Nano en Cosmos3-H-Dreams | Chirurgische simulatie op basis van de acties van de robot, in realtime voor H-Dreams |
Voor deployment biedt de NIM-image cosmos3:2.0.0 profielen voor latentie of doorvoer, en speculative decoding versnelt de inferentie gemiddeld met ongeveer een factor 2 tot 3 op H200, volgens NVIDIA, dat aankondigt dat Cosmos NIM op meer dan 20 GPU’s gecertificeerd zijn. Bij generatie heeft Cosmos3-Nano 58 Gio VRAM nodig in BF16, en 31 Gio in FP8 met offloading. Cosmos Framework krijgt pipelines voor reinforcement learning (DPO, GRPO, PPO, OPD, DiffusionNFT), en op donderdag 5 november wordt er een livestream aan gewijd.
🔗 Het technische artikel van NVIDIA
Copilot CLI 1.0.106-3 in preview: optioneel sessiebeheer en 145 fixes
2 november — GitHub publiceert previewversie 1.0.106-3 van Copilot CLI, de derde in de 1.0.106-reeks. De release notes noemen slechts één toevoeging: tools voor sessiebeheer die optioneel worden ingeschakeld (opt-in), met de mogelijkheid om met @ te verwijzen naar lokale sessies waarvoor deze optie is ingeschakeld, zonder verdere details. Voor beheerde accounts geven de waarschuwingen over het vernieuwen van het beleid nu de bevindingen van de Policy Helper weer.
De overige 145 fixes betreffen vooral de robuustheid van de terminalinterface, en verschillende hebben betrekking op beveiliging:
| Beveiligingsfix | Gedrag vóór 1.0.106-3 |
|---|---|
| Gefilterde escape-sequenties | Een antwoord, bestandsnaam of titel van een MCP-tool kon de timeline anders opmaken of regels ervan verbergen |
/allow-all off | Als er een ideografische spatie (CJK-invoer) op volgde, schakelde de opdracht Allow All aan in plaats van uit |
/session delete | Een onbekende optie vóór de identifier verwijderde de huidige sessie zonder om bevestiging te vragen |
copilot -p en copilot workflow run | De tekstuitvoer toonde de waarden van --secret-env-vars, die in de JSON-uitvoer al werden verborgen |
De nieuwste stabiele versie blijft 1.0.105 van 28 oktober, en Copilot SDK 1.0.29-preview.2, die dezelfde avond verscheen, bevat geen wijzigingen aan de SDK.
🔗 De release notes van Copilot CLI 1.0.106-3
Kort nieuws
Agents en codetools
- Qwen Code v0.26.6 — Stabiele versie van 2 november, een dag na v0.26.5: de Web Shell krijgt een overzicht van de sessieactiviteit en toont per model het succespercentage, de uitvoersnelheid en de latentie tot het eerste token; de Kimi K3-modellen krijgen hun venster van 1 miljoen tokens. 🔗 bron
- Gemini CLI — Een op de avond van 2 november gemergde fix voorkomt dat een onderbroken download van het Whisper-model als een geïnstalleerd model wordt aangemerkt, waardoor de lokale spraakmodus blokkeerde totdat het bestand handmatig werd verwijderd. De fix zit nog in geen enkele versie, en de nightly van die dag gebruikt dezelfde commit als de twee voorgaande. 🔗 bron
- CLI mistral 0.16.0 —
mistral workflows initenmistral initvragen nu om de API-sleutel van een Workflow-project, controleren die bij de Mistral API en slaan die op in.envvan het project. 🔗 bron - Qodo-plugin voor Codex — In een door OpenAI gepubliceerde casestudy presenteert Qodo zijn plugin uit de Codex-marketplace: Codex ontvangt de regels van de organisatie en de geschiedenis van pull requests voordat het code schrijft, en vervolgens de review van Qodo in dezelfde sessie, vóór het openen van de pull request. Geen resultaatcijfers. 🔗 bron
- corgi, gedeeld door Zed — Op de avond van 1 november deelt Zed de website van corgi, Conrad Irwins met Cargo compatibele Rust-buildtool: één cache per machine, build.rs en macro’s in een sandbox, gecachete tests. Volgens de maker is de code bijna volledig door AI geschreven. Repository onder MIT-licentie. 🔗 bron
Ontwikkelplatforms en API’s
- pull_request_target in GitHub Actions — Het standaard blokkeren van
pull_request_targetin openbare repositories wordt uitgesteld van 2 november naar 2 december; twee geplande onderbrekingen, op 9 en 16 november van 16 h tot 18 h UTC, zullen duidelijk maken welke workflows worden getroffen. 🔗 bron - Risicobeoordelingen van GitHub — De risicobeoordelingen voor codebeveiliging en secrets geven nu voor elke bevinding aan of die zich al dan niet in een beschermde repository bevindt, op GitHub Enterprise Cloud en GitHub Team. 🔗 bron
- Analytics API van Perplexity — De antwoorden over het creditverbruik van Computer laten de uitsplitsing naar herkomst van de credits (Credit Source) voorlopig weg; het totaal en de uitsplitsing per model blijven beschikbaar, en Perplexity vraagt om een ontbrekende uitsplitsing niet als nulverbruik te interpreteren. 🔗 bron
Open modellen en communityartikelen
- kniv v7 van Dragonscale — Zes open encoders met 55M tot 538M parameters (Apache-2.0, ONNX) die entiteiten, relaties en feiten extraheren volgens een bij de aanroep beschreven schema, zonder LLM, voor het geheugen van agents; op Re-DocRED, 0,749 binnen dezelfde zin en 0,732 op twee zinnen afstand (DeBERTa-variant). 🔗 bron
- Schuifvenster en Bifocal-laag — In een communityartikel distilleert Lukas Qwen3-4B-Instruct tot vier leerlingmodellen met evenveel geheugen: het schuifvenster volstaat voor korte antwoorden, maar op AIME en HMMT lost zijn Bifocal-laag (klein venster en mLSTM-toestand) bijna twee keer zoveel problemen op als alleen het venster, dat rond 14 % blijft steken. Metingen van de auteur. 🔗 bron
- Door ViKernel geblokkeerde backdoor — VIDRAFT bouwt via fine-tuning een backdoor in Qwen3-0.6B in: het woord « payroll » in een bestandspad activeert bij niet eerder geziene paden in 98,3 % van de gevallen de kwaadaardige opdracht, zonder dat 24 controles die detecteren; op ViKernel worden alle 290 payloads vóór uitvoering geweigerd. Modelgewichten niet gepubliceerd. 🔗 bron
- Routing van Beam en valsspelen bij tests — Een vooraf geregistreerd onderzoek van Rairo Mukamuri slaagt er niet in om via de expert routing van Beam-1.0-501B-A23B testvervalsing 500 tokens vooraf te voorspellen: een AUROC van 0,580 tegenover een vastgelegde drempel van 0,75, voor 9,03 dollar aan rekenkosten. 🔗 bron
- Saturate — Daniel van Strien voert opnieuw OCR uit op 14 483 pagina’s archiefmateriaal op één GPU van Hugging Face Jobs, voor 1,47 dollar en 8,9 pagina’s per seconde, met Saturate, zijn Apache-2.0-bibliotheek voor batchinferentie via elk OpenAI-compatibel endpoint. 🔗 bron
Beeld, video, spraak en muziek
- LTX 2.5 op een RTX PRO 6000 — GPU-verhuurder EcoHash rendert een 1080p-video van 10 seconden met geluid in 90 seconden, en in 14,8 seconden in 480p, op één kaart van 96 Go; metingen van de aanbieder op zijn eigen dienst. 🔗 bron
- Mobiel AI van KPN — ElevenLabs beschrijft de belassistent van KPN voor Nederlandse kleine bedrijven (voicemailtranscriptie, gespreksamenvattingen, belmenu); fine-tuning op het Nederlands verhoogde de verificatienauwkeurigheid van ongeveer 50 % naar 90 %. Geen prijs vermeld. 🔗 bron
- Suno Studio — Nieuws van 29 oktober, alsnog gedeeld op 2 november: de clipinstellingen verhuizen naar een zijbalk, de toonhoogte is instelbaar in halve tonen en cents, geïmporteerde audio kan worden uitgerekt naar het projecttempo en tracks kunnen met Shift-H worden verborgen. 🔗 bron
- Kling en de Chroma Awards — Kling wordt partner van seizoen 2 van de wedstrijd, met meer dan 450 000 dollar aan prijzen; inzendingen tot 7 januari. 🔗 bron
Programma’s, demonstraties en artikelen van labs
- Anthropic Residency — Anthropic stelt tot 22 november de aanmelding open voor een betaald onderzoeksprogramma van zes weken tot zes maanden, voor hoogleraren, technische oprichters en engineers op staff-niveau, zonder vereiste voorkennis van machine learning; vergoeding gelijk aan 350 000 tot 500 000 dollar per jaar. 🔗 bron
- Data Bot van SpaceXSI — Interne casestudy: een Team Bot van Grok Bot die voor het hele bedrijf als data scientist werkt, op basis van skills die het datateam onderhoudt, en die volgens een schatting van SpaceXSI in één week ongeveer 70 uur werk zou hebben overgenomen. 🔗 bron
- Le Chonk en kwantumchemie — Mistral laat op X zien hoe Mistral Large 4 vanaf nul een SCF-solver en een 3D-weergave van een uiteenvallend molecuul schrijft, zonder code of cijfers te publiceren. 🔗 bron
- Oktoberoverzicht van Google — Geen nieuwe aankondigingen behalve het antwoord van de satelliet van Project Suncatcher, dat hierboven is behandeld. 🔗 bron
- Agentgeheugen bij Perplexity — Een handleiding over geheugentypen en het bouwen van een agent met persistent geheugen, die verwijst naar Brain, dat al in Computer beschikbaar is. 🔗 bron
- The Knowledge Talk — Perplexity publiceert de transcriptie van de toespraak van Aravind Srinivas van 3 oktober bij de Cambridge Union Society, zonder aankondiging. 🔗 bron
Wat dit betekent
Message threads verplaatsen een deel van de gespreksstatus naar de server zonder de rekening te veranderen: tokens en tarieven blijven gelijk, alleen de wachttijd daalt, en het effect is het duidelijkst bij agentsessies die honderdduizenden tokens verzamelen. De keuze voor een tijdelijke thread, die 5 minuten in versleuteld geheugen wordt bewaard en waarvoor geen API bestaat om hem opnieuw te lezen, geeft de applicatie controle over haar geschiedenis, ten koste van duidelijke uitsluitingen: geen ZDR, geen Batches en geen HIPAA-organisaties. Bij de terminal herinnert de preview van Copilot CLI eraan dat de interface zelf een aanvalsoppervlak is, aangezien een bestandsnaam of een modelantwoord de schermopmaak kon veranderen.
Grid Protectors en Suncatcher reageren op dezelfde beperking, de energie voor rekenwerk, op twee heel verschillende tijdshorizonten. OpenAI stelt voor om zijn campussen afschakelbaar te maken om geaccepteerd te worden door een elektriciteitsnet dat al onder druk staat, met de belofte zelf de kosten te betalen; de enige becijferde besparing voor huishoudens komt van Georgia Power en heeft betrekking op al zijn grote klanten samen. Google is in het stadium waarin het een TPU in een baan om de aarde een haiku laat schrijven: een mijlpaal voor de haalbaarheid, zonder prestatiecijfers, voorafgaand aan twee onderling verbonden satellieten in 2027.
LifeVal, Design Creativity Bench en BrowseSafe++ meten wat ranglijsten voor code en wiskunde niet zien. LifeVal laat een vertragende vooruitgang zien, 0,6 punt tussen GPT-5.6 en GPT-6 Astra, maar blijft een interne benchmark, zonder concurrenten of gepubliceerde takenset. Kombai wijst op een convergentie van interfaces die door het succespercentage wordt gemaskeerd, en BrowseSafe++ scheidt detectie van weerbaarheid: een model dat een injectie herkent, kan er toch gevolg aan geven, en een detector van 0,8B, meer dan honderd keer goedkoper dan een API-aanroep, volstaat niet tegen een aanvaller die het opnieuw probeert.
Sakana AI kiest ervoor om met Sawara de hele keten te beheersen, van pretraining tot producten, maar met een voorwaardelijke planning en zonder aangekondigde omvang. Runway en Synthesia doen het omgekeerde: ze vestigen zich waar gebruikers al werken, in de codeagent of in het gesprek met ChatGPT en Claude, in plaats van hen naar hun eigen applicatie te trekken. ElevenLabs levert het cijfermatige argument voor spraak bij lange gesprekken, met een onderzoek van de leverancier waarvan de onderzoeksbasis verschilt tussen de tweet en het artikel, terwijl NVIDIA degenen die autorijden, robotica of chirurgie simuleren van tools voorziet met Cosmos 3 Nano.
Bronnen
- Het artikel van Anthropic over message threads
- @ClaudeDevs: message threads in Claude Code
- De documentatie over message threads
- Verslag van het symposium van Sakana AI in 2026
- @SakanaAILabs: verslag van het symposium
- Introductie van het Grid Protectors Program (OpenAI)
- Eerste reactie van de prototypesatelliet van Project Suncatcher (Google)
- LifeVal (OpenAI)
- Waarom we Design Creativity Bench hebben gebouwd (Kombai)
- BrowseSafe++ (Perplexity)
- Runway Dev-plugins voor coding agents
- @synthesiaIO: Synthesia-video’s in ChatGPT en Claude
- Waarom spraak beter werkt bij complexe, stressvolle gesprekken (ElevenLabs)
- @ElevenLabs: onderzoek naar spraak tegenover chat
- Bouw world models voor interactieve simulatie met NVIDIA Cosmos
- Copilot CLI 1.0.106-3
- Qwen Code v0.26.6
- PR 30058 van Gemini CLI
- CLI mistral 0.16.0
- Casestudy over Qodo en Codex (OpenAI)
- @zeddotdev: corgi
- pull_request_target op 2 december standaard geblokkeerd (GitHub)
- Risicobeoordelingen omvatten de beschermingsstatus van repositories (GitHub)
- Changelog van de API van Perplexity
- Blogbericht van Dragonscale over kniv v7
- Blogbericht over het schuifvenster en Bifocal
- Blogbericht van VIDRAFT over de achterdeur
- Blogbericht van Rairo Mukamuri over Beam
- @vanstriendaniel: Saturate
- Blogbericht van EcoHash over LTX 2.5
- Mobiel AI van KPN (ElevenLabs)
- Release notes van Suno Studio
- @Kling_ai: Chroma Awards seizoen 2
- Anthropic Residency
- Data Bot (SpaceXSI)
- @MistralAI: Le Chonk en de SCF-solver
- De AI-aankondigingen van Google in oktober 2026
- Geheugen voor AI-agents (Perplexity)
- Het kennisgesprek (Perplexity)