ai-powered-markdown-translator本文使用 gpt-6.1-sol 从法语翻译为中文。
Anthropic 将 Messages API 的消息线程功能开放公开测试;该功能已在 Claude Code 中启用,可将最长请求的首个词元等待时间缩短约 35 %。Sakana AI 宣布推出 Sawara,这是该公司首批从零开始预训练的模型;OpenAI 则推出 Grid Protectors,让其计算园区能够根据电网需求削减用电,并发布日常生活任务评测基准 LifeVal。Perplexity 发布 BrowseSafe++,应对提示注入;NVIDIA 通过 Cosmos 3 Nano 提供仿真工具;Runway、Synthesia 和 ElevenLabs 则将生成式媒体引入助手和智能体。
Messages API 开放消息线程公开测试,该功能已在 Claude Code 中启用
11 月 2 日 — Anthropic 在 Messages API 上开放消息线程(message threads)公开测试。此前,智能体每一轮都会重新发送整个对话,包括工具返回的结果。使用线程后,首次请求发送完整对话,包括系统提示和工具;后续请求只发送新消息及上一条响应的标识符,API 会在调用模型前重建其余内容。只需添加参数 thread 和测试版请求头 message-threads-2026-08-12,官方 SDK 提供专用辅助函数来处理这些设置。
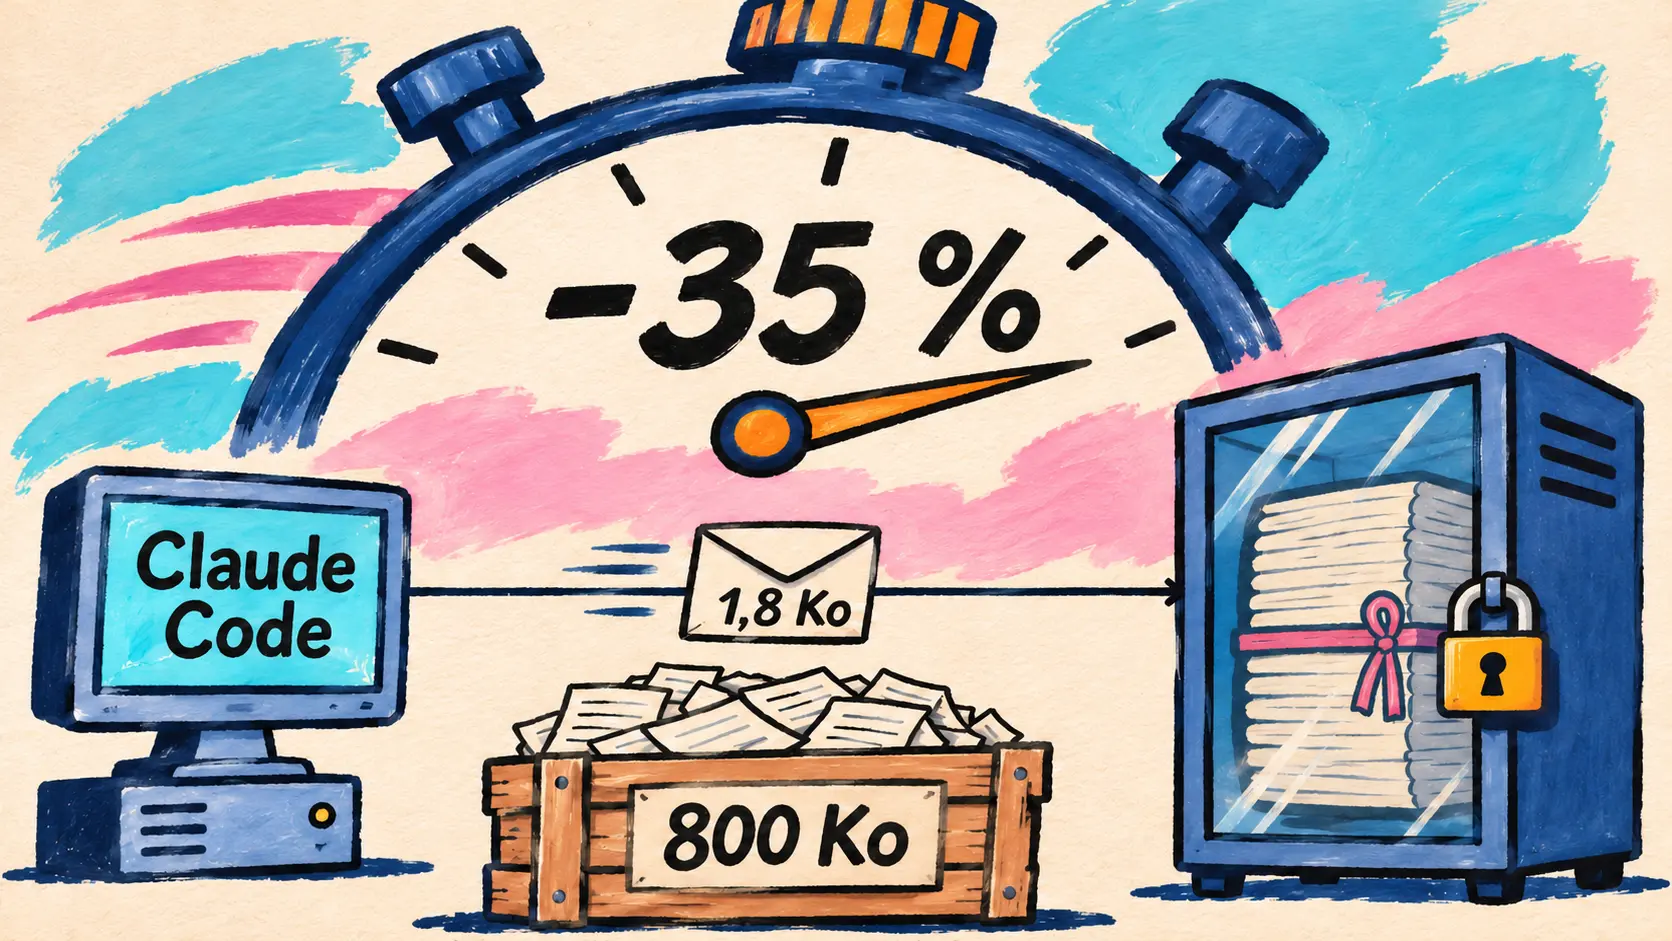
We recently integrated message threads in Claude Code. On requests with 500K to 1M tokens, median time to first token is about 35% lower. In long conversations, the median request went from about 800 KB to 1.8 KB.
🇨🇳 我们最近已将消息线程集成到 Claude Code 中。对于 50 万至 100 万词元的请求,首个词元的中位等待时间缩短了约 35 %。在长对话中,请求的中位大小从约 800 Ko 降至 1,8 Ko。 — @ClaudeDevs 在 X 上
收益体现在延迟上,费用并不会减少:Claude 每一轮仍会重新读取整个对话,因此词元数量、价格和速率限制均不变,提示缓存(prompt caching)也仍需自行请求。线程按尽力而为原则(best-effort)保留在加密内存中,绝不写入磁盘:最后一次请求后 5 分钟即过期,应用程序需保留自己的副本,以便在 API 返回 404 时重新发送全部内容。该功能不适用零数据保留(ZDR),也无法与 Message Batches、按需上下文压缩搭配使用,且不向 HIPAA 组织提供。该功能可通过 Claude API、Claude Platform on AWS、Claude in Microsoft Foundry 以及 Claude Models on Google Cloud(由 Anthropic 托管)使用。
🔗 Anthropic 关于消息线程的文章 · 消息线程文档
Sakana AI 宣布 Sawara,首批从零开始预训练的模型,计划于 2027 年春季发布权重
11 月 2 日 — Sakana AI 发布了 10 月 26 日东京研讨会的回顾文章,活动吸引了 400 多名参与者,于尔根·施密德胡贝尔发表演讲。文章还披露了一项实质性公告:这家日本初创公司将预训练自己的语言模型。此前,该公司主要研究智能体,并通过 Namazu 对现有开放模型进行后训练。由首席科学家(首席科学家)秋叶拓哉介绍的 Sawara 系列(暂定名)将从零构建,不基于第三方模型,并面向智能体用途(智能体原生)设计,涵盖工具辅助推理、代码和长时任务。该系列将作为 Sakana AI 产品以及 RSI Lab 递归自我改进研究的基础。
We are now preparing for training, and we will start pre-training Sawara Small (provisional name) this December. If everything goes smoothly, we will release the weights next spring.
🇨🇳 我们正在准备训练工作,将于 12 月开始对 Sawara Small(暂定名)进行预训练。如果一切顺利,我们将在明年春季发布权重。 — Sakana AI,2026 年研讨会回顾
同样采用暂定名称的 Sawara Large 将随后推出,但尚无日期。Sakana AI 未披露模型规模、数据量或计算预算。
算力的能源需求:OpenAI 推出 Grid Protectors,Google 的 TPU 从轨道传回响应
OpenAI 推出 Grid Protectors,为埃芬厄姆园区提供最高 1 000 MW 的用电削减能力
11 月 2 日 — OpenAI 推出全国性计划 Grid Protectors,旨在让未来的计算园区在寒潮或热浪等导致电网紧张的情况下减少用电。公司希望与电力供应商、监管机构和公共政策制定者逐个站点签订协议,明确可削减的用电量、响应时间和持续时长。根据当地需求,园区也可采用现场发电或储能设施,并利用电池平滑用电需求。
试点是计划建于佐治亚州埃芬厄姆县的园区,该项目于 7 月以 Project Camellia 的名称公布。OpenAI 承诺承担该园区全部电力基础设施和供电服务成本。
| 公布的指标 | 公布的数值 | 数据来源 |
|---|---|---|
| 与 Georgia Power 的协议中计划提供的灵活用电削减能力 | 最高 1 000 MW | OpenAI |
| 相当于家庭平均用电需求 | 约 700 000 户家庭 | OpenAI |
| 自 2029 年起为 Georgia Power 客户节省的年度费用 | 约 950 百万美元 | Georgia Power |
| 每月用电 1 000 kWh 的典型居民客户可节省的费用 | 每月至少 15 美元 | Georgia Power |
Georgia Power 的预测涵盖其与大型用电客户签订的全部协议及预期增长,其中包括 Project Camellia,并非 OpenAI 计划独有的数据。OpenAI 承认,灵活用电不能替代对新增发电和输电能力的投资,也未公布其他站点或时间表。
🔗 OpenAI 关于 Grid Protectors 的文章
Project Suncatcher:轨道上的 TPU 传回首条响应,由 Gemma 4 创作一首俳句
10 月 30 日 — 补充报道:原型卫星于 10 月 1 日发射,一个月后,Google 探索太空人工智能计算的研究项目 Project Suncatcher 达成“你好,世界”里程碑:数据中心级 TPU 首次在轨道上生成人工智能响应。卫星飞越地面站期间,团队要求搭载的开放模型 Gemma 4 创作一首关于太空生活的俳句;卫星飞越挪威斯瓦尔巴群岛时,响应传回地面。随后,团队又测试了五行打油诗和遥测提示,模型通过描述载荷的技术状态作出响应。
下一阶段将聚焦可靠性:先测试 TPU 在热应力和辐射环境下的表现,再于 2027 年部署一对互联卫星。文章没有提供任何性能或能耗数据。
日常生活与界面创意:OpenAI 发布 LifeVal,Kombai 发布 Design Creativity Bench
LifeVal:169 项日常生活任务,得分从 GPT-5.2 的 49,3 % 提升至 GPT-6 Astra 的 80,6 %
11 月 2 日 — OpenAI 发布 LifeVal,评估模型完成日常生活任务的能力,例如寻找托育服务、获取公共服务、制定预算、调整食谱或安排运动计划。任务以美国时间使用调查和跨国时间使用研究两项大型时间使用调查为基础,并补充了一项覆盖 3 995 人的代表性调查,了解受访者最希望在哪些领域获得帮助。OpenAI 表示,过去一年一直使用该评测来跟踪模型表现。
| 受评模型 | 发布日期 | 169 项任务的平均奖励 |
|---|---|---|
| GPT-5.2 | 2025 年 12 月 | 49,3 % |
| GPT-5.4 | 2026 年 3 月 | 73,0 % |
| GPT-5.5 | 2026 年 4 月 | 77,4 % |
| GPT-5.6 | 2026 年 7 月 | 80,0 % |
| GPT-6 Astra (xhigh) | 2026 年 9 月 | 80,6 % |
根据图表说明,这是 169 项任务的未加权平均值,GPT-5.6 与 GPT-6 Astra 仅相差 0,6 个百分点。图表未包含 GPT-6.1 Sol 或 Terra,也没有其他厂商的模型,OpenAI 亦未提及是否会发布任务集。
Design Creativity Bench:模型生成的界面趋于雷同
11 月 2 日 — 前端开发人工智能工具厂商 Kombai 在 Hugging Face 博客上介绍 Design Creativity Bench。该基准衡量的并非界面是否可用,而是它与其他界面是否相似。研究涵盖 15 个前沿模型、160 条指令和 2 400 个 HTML 界面,并将其与人工设计稿进行比较。
| 基准指标 | 受评模型 | 人工参考 |
|---|---|---|
| 同一指令下的平均差异度 | 模型之间为 0,592 | 人工与模型之间为 0,764 |
| 平均创意跨度 | 0,581 | 0,902 |
| 满足的验收标准 | 所有模型均超过 90 %(Claude Opus 5.5:99,2 %) | 98,0 % |
因此,模型虽然能满足需求规范,生成的界面却彼此相似。GPT-6 Astra 在受评模型中风格最独特,原创性得分为 0,646,但在不同情境下变化较小,创意跨度为 0,472。Kombai 发布了论文(arXiv 2610.11539)、排行榜以及用于复现的子集,同时承认研究存在局限:只评估桌面屏幕,且 API 均采用默认设置。
Perplexity 发布 BrowseSafe++ 及 BrowseSafe-Guard 检测器,应对提示注入
11 月 2 日 — Perplexity 安全智能研究院发布 BrowseSafe++,这是 BrowseSafe(2025 年 12 月)的后续版本。该开放基准聚焦针对网页浏览智能体的间接提示注入(indirect prompt injection)。它汇集了 38 675 对页面,每对包含一个受到攻击的页面及其干净版本,其中 32 187 对围绕真实观测到的注入构建:2025 年 9 月至 2026 年 9 月间,Comet 检测器共报告了 115 万次此类注入。每个页面均提供 HTML、Markdown、无障碍树和截图版本。Perplexity 据此开发了 BrowseSafe-Guard,包括两个基于 Qwen3.5-0.8B 微调的 0,8B 检测器,分别用于文本和截图。
| 公布的结果 | BrowseSafe-Guard | 对比模型 |
|---|---|---|
| 文本视图的 F1 | 约 95 %,在每种视图中均排名第一 | 最佳通用模型为 85 至 92 % |
| 截图的 F1 | 约 93 % | 其他模型中的最佳成绩约为 79 % |
| 干净页面的误报率 | 约每 20 个中有 1 个 | GPT-6 Astra 为 14,41 % |
| 每 1 000 个页面的成本 | 使用租用的 H200 为 0,18 美元 | 通过 API 为 18,95 至 180,61 美元 |
检测到注入并不意味着能抵御注入:每个模型都曾执行自己已经识别出的注入,比例从 GPT-6 Astra 的 1,64 % 页面到 Llama 3.1 8B 的 24,73 % 不等。持续尝试的攻击者最终也能突破防线:在每次失败后重写注入的 BrowseSafe-Adapt 环境中,测试包含 1 024 项任务、每项最多尝试 64 次,针对七个受测智能体中的五个,攻击成功率从首次尝试时最高 4 % 升至至少 79 %。将 Guard 置于 Gemini 3.5 Flash-Lite 智能体前方,可拦截 94,5 % 的初始注入,但攻击者最终仍能在 84,2 % 的任务上得手。数据集采用受控访问方式提供,此外还发布了 MIT 许可的 SDK 和公开排行榜;文章没有提供任何检测器权重的链接。
🔗 Perplexity 关于 BrowseSafe++ 的文章
生成式媒体:Runway Dev 登陆 Claude Code 和 Cursor,Synthesia 接入 ChatGPT 和 Claude,ElevenLabs 量化语音优势
Runway Dev 登陆 Claude Code 和 Cursor
11 月 2 日 — 继 10 月 28 日公布对 Codex 的支持后,Runway 将 Runway Dev 插件扩展至 Claude Code 和 Cursor。安装后,编码智能体通过 Runway 的 MCP 服务器连接 Runway Dev 账户,并获得 Runway 技能,以便使用其生成式媒体 API 进行开发。智能体会先读取账户信息,包括项目、可用模型及其价格和限制、积分余额,然后借助官方 SDK 开展工作:它可以创建为每次请求选择合适模型的 Model Router,或用于实时虚拟化身的 Character,还可复用 Recipes(开箱即用的处理流程)以及已发布为 API 端点的 Workflows。出现失败时,它会查看详细错误信息。账户连接在首次使用时完成,插件中不存储 API 密钥,公告未列出插件单独的收费标准。
| 编码智能体 | Runway 提供的安装方式 |
|---|---|
| Claude Code | /plugin install runway-api@claude-plugins-official |
| Cursor | 在 Agent 聊天中使用 /add-plugin runway-api,或通过 Cursor Marketplace 安装 |
Synthesia 可在 ChatGPT 和 Claude 中创建视频
11 月 2 日 — Synthesia 宣布,现在可以直接在 ChatGPT 和 Claude 中创建其虚拟化身视频:用户描述想要的视频,在对话中看到生成结果,通过提出要求进一步调整,然后发布和分享,全程无需打开其他应用或标签页。公告仅有一条附带演示视频的推文;截至我们查看时,Synthesia 的博客和首页均未出现相关文章。Synthesia 未说明具体集成机制、适用套餐或价格。
ElevenLabs:对话超过两分钟后,语音的成功率比聊天高 32 %
11 月 2 日 — ElevenLabs 发布一项研究,对比生产环境中 ElevenAgents 智能体通过语音(电话和 WhatsApp)与聊天进行交互的表现,每个智能体均以自身在 2026 年 5 月至 7 月的对话作为对照。公告推文提到 469 个智能体,博文则称“数百个”智能体。
The longer the conversation, the higher the success rate for voice agents. We analyzed 469 agents running both voice and chat in production and saw an interesting pattern. When the conversation gets complex, voice is the fastest path to resolution.
🇨🇳 对话越长,语音智能体的成功率就越高。我们分析了生产环境中同时支持语音和聊天的 469 个智能体,发现了一个有趣的趋势。当对话变得复杂时,语音是解决问题的最快途径。 — @ElevenLabs 在 X 上
| ElevenLabs 公布的指标 | 测得数值 |
|---|---|
| 超过两分钟后语音交互的成功率 | +10,9 个百分点,即 +31,7 % |
| 不足一分钟的对话 | 聊天领先约 9 个百分点 |
| 成功完成的长对话时长 | 语音 4,6 分钟,聊天 7 分钟 |
| 换用更快的 LLM(315 次对话) | 延迟降低 16 %,成功率提高 26 % |
| 偏好语音的比例(98 名参与者,航班取消场景) | 85 % |
这里以时长作为复杂度的指标,博文也承认这一指标并不完善,而且研究来自厂商自身,文中也在推广其语音智能体。
NVIDIA 发布适用于驾驶、机器人和手术的 Cosmos 3 Nano 仿真方案
11 月 2 日 — NVIDIA 在技术博客上发布了一份分为两部分的 Cosmos 指南。Cosmos 是其面向物理人工智能的世界基础模型平台:指南首先介绍基于全新 Cosmos 3 Nano 检查点的仿真方案,这些检查点已于 10 月 22 日公布,此次给出了名称和说明;随后介绍 NIM 微服务的使用方法。重点展示的示例是:只需更改提示词,就能将白天的行车场景变成雨夜,无需改动道路布局或车辆轨迹。
| Cosmos 3 检查点 | NVIDIA 描述的用途 |
|---|---|
| Cosmos3-Nano-Transfer-Auto | 用于驾驶的多摄像头视频片段,配合 LiDAR,最高支持 400 帧,分辨率为 480p 或 720p |
| Cosmos3-Nano-Sim-Auto | 经蒸馏的因果模型变体,以流式生成方式测试闭环驾驶策略 |
| Cosmos3-Nano-Sim-Transfer | 将深度视频转换为细节丰富的 RGB 视频,用于机器人 |
| Cosmos3-Nano-Sim-Bimanual | 根据场景和双臂机器人的动作生成其下一步观测 |
| Cosmos3-H-Embodied-Nano 和 Cosmos3-H-Dreams | 根据机器人动作进行手术仿真,其中 H-Dreams 支持实时运行 |
部署方面,NIM 镜像 cosmos3:2.0.0 提供侧重延迟或吞吐量的配置。据 NVIDIA 称,推测解码可使 H200 上的推理速度平均提升约 2 至 3 倍,Cosmos NIM 已通过超过 20 款 GPU 的认证。生成时,Cosmos3-Nano 在 BF16 下需要 58 Gio 的 VRAM,采用 FP8 并启用卸载时则需要 31 Gio。Cosmos Framework 新增了强化学习流水线(DPO、GRPO、PPO、OPD、DiffusionNFT),并将于 11 月 5 日星期四举办相关直播。
Copilot CLI 1.0.106-3 预览版:可选择启用的会话管理和 145 项修复
11 月 2 日 — GitHub 发布 Copilot CLI 1.0.106-3 预览版,这是 1.0.106 分支的第三个版本。发行说明仅列出一项新增功能:需要用户主动启用的会话管理工具,以及通过 @ 提及已启用该功能的本地会话的能力,未提供更多细节。对于托管账户,策略刷新警告现在会呈现 Policy Helper 的检查结果。
其余 145 项修复主要涉及终端界面的稳健性,其中多项与安全有关:
| 安全修复 | 1.0.106-3 之前的行为 |
|---|---|
| 过滤转义序列 | 回复、文件名或 MCP 工具标题可能改变时间线的显示样式,或隐藏其中的行 |
/allow-all off | 命令后跟表意空格(CJK 输入)时,会启用 Allow All,而非将其关闭 |
/session delete | 放在标识符前的未知选项会在未请求确认的情况下删除当前会话 |
copilot -p 和 copilot workflow run | 文本输出会显示 --secret-env-vars 的值,而 JSON 输出此前已将其隐藏 |
最新稳定版仍是 10 月 28 日发布的 1.0.105;同晚发布的 Copilot SDK 1.0.29-preview.2 则没有任何 SDK 侧的变更。
简讯
智能体与编程工具
- Qwen Code v0.26.6 — 11 月 2 日发布的稳定版,距 v0.26.5 仅一天:Web Shell 新增会话活动视图,并按模型显示成功率、输出速度和首个 token 延迟;Kimi K3 模型获得 100 万 token 的上下文窗口。🔗 来源
- Gemini CLI — 11 月 2 日晚合并的一项修复,防止将下载中断的 Whisper 模型误判为已安装;此前,这种情况会导致本地语音模式无法使用,直到手动删除文件。该修复尚未进入任何发布版本,当天的每日构建版也仍使用与前两次相同的提交。🔗 来源
- mistral CLI 0.16.0 —
mistral workflows init和mistral init现在会要求输入 Workflow 项目的 API 密钥,通过 Mistral API 验证密钥,并将其保存到项目的.env中。🔗 来源 - 面向 Codex 的 Qodo 插件 — 在 OpenAI 发布的一篇案例研究中,Qodo 介绍了其在 Codex 插件市场中的插件:Codex 在编写代码前接收组织规则和拉取请求历史,随后在同一会话内、创建拉取请求之前接收 Qodo 的审查结果。未提供效果数据。🔗 来源
- Zed 转发介绍 corgi — 11 月 1 日晚,Zed 转发了 corgi 的网站。这是康拉德·欧文开发的兼容 Cargo 的 Rust 构建工具:每台机器共用一个缓存,build.rs 和宏在沙箱中运行,测试结果也会缓存。据作者称,代码几乎全部由人工智能编写。仓库采用 MIT 许可证。🔗 来源
开发平台与 API
- GitHub Actions 中的 pull_request_target — 公共仓库中默认阻止
pull_request_target的日期从 11 月 2 日推迟至 12 月 2 日;11 月 9 日和 16 日的 16 时至 18 时 UTC 将安排两次临时停用,以暴露受影响的工作流。🔗 来源 - GitHub 风险评估 — 在 GitHub Enterprise Cloud 和 GitHub Team 上,代码安全与密钥风险评估现在会标明每项发现所在的仓库是否受到保护。🔗 来源
- Perplexity Analytics API — 关于 Computer 积分使用情况的响应目前不提供按积分来源划分的明细;总量和按模型划分的明细仍会提供。Perplexity 提醒,不应将缺失的明细解读为使用量为零。🔗 来源
开放模型与社区文章
- Dragonscale 的 kniv v7 — 六款开放编码器,参数量从 55M 到 538M(Apache-2.0、ONNX),可根据调用时描述的模式提取实体、关系和事实,无需 LLM,用于智能体记忆;在 Re-DocRED 上,同一句内的得分为 0,749,相隔两句时为 0,732(DeBERTa 变体)。🔗 来源
- 滑动窗口与 Bifocal 层 — 在一篇社区文章中,卢卡斯将 Qwen3-4B-Instruct 蒸馏为四个内存相同的学生模型:滑动窗口足以应对简短回答,但在 AIME 和 HMMT 上,他的 Bifocal 层(小窗口加 mLSTM 状态)解出的题目数量几乎是单独使用窗口的两倍,后者停留在约 14 %。数据由作者测得。🔗 来源
- ViKernel 拦截后门 — VIDRAFT 通过微调在 Qwen3-0.6B 中植入后门:文件路径中的“payroll”一词会触发恶意命令,在此前未见过的路径上触发率为 98,3 %,且未被 24 项检查发现;在 ViKernel 上,290 个攻击载荷均在执行前被拒绝。未发布权重。🔗 来源
- Beam 路由与测试作弊 — 赖罗·穆卡穆里的一项预注册研究未能通过 Beam-1.0-501B-A23B 的专家路由,提前 500 个 token 预测测试造假:AUROC 为 0,580,低于预设的 0,75 阈值,计算成本为 9,03 美元。🔗 来源
- Saturate — 丹尼尔·范·斯特林使用自己的 Saturate 库,在 Hugging Face Jobs 的单个 GPU 上对 14 483 页档案重新进行 OCR,耗资 1,47 美元,速度为每秒 8,9 页。该库采用 Apache-2.0 许可证,可向任何兼容 OpenAI 的端点批量发起推理。🔗 来源
图像、视频、语音与音乐
- 单张 RTX PRO 6000 上的 LTX 2.5 — GPU 租赁商 EcoHash 使用单张 96 Go 显卡,在 90 秒内生成一段带声音的 10 秒 1080p 视频;480p 版本耗时 14,8 秒。数据由供应商在自有服务上测得。🔗 来源
- KPN 的 Mobiel AI — ElevenLabs 详细介绍了 KPN 面向荷兰小企业的通话助手(语音留言转写、通话摘要、来电菜单);针对荷兰语进行微调后,验证准确率从约 50 % 提高到 90 %。未公布价格。🔗 来源
- Suno Studio — 补充 10 月 29 日的更新,11 月 2 日再次传播:片段设置移至侧边栏,音高可按半音和音分调整,导入的音频可拉伸以匹配项目速度,按 Shift-H 可隐藏音轨。🔗 来源
- Kling 与 Chroma Awards — Kling 成为该比赛第二季的合作伙伴,奖品总额超过 450 000 美元;作品提交截止日期为 1 月 7 日。🔗 来源
项目计划、演示与实验室文章
- Anthropic Residency — Anthropic 开放一项带薪研究计划的申请,截止日期为 11 月 22 日,时长为六周至六个月,面向教授、技术创始人及资深技术专家级工程师,无需具备机器学习背景;薪酬折合年薪为 350 000 至 500 000 美元。🔗 来源
- SpaceXSI 的 Data Bot — 一项内部案例研究:基于 Grok Bot 的 Team Bot,利用数据团队维护的技能,为全公司承担数据科学家的工作。据 SpaceXSI 估算,它在一周内完成了约 70 小时的工作。🔗 来源
- Le Chonk 与量子化学 — Mistral 在 X 上展示 Mistral Large 4 从零编写 SCF 求解器,以及一个分子断裂的三维视图,未发布代码或数据。🔗 来源
- Google 十月回顾 — 除了上文已介绍的 Project Suncatcher 卫星回复外,没有其他新公告。🔗 来源
- Perplexity 的智能体记忆 — 一份介绍记忆类型及如何构建具有持久记忆的智能体的指南,其中提到了已在 Computer 中提供的 Brain。🔗 来源
- The Knowledge Talk — Perplexity 发布了阿拉文德·斯里尼瓦斯 10 月 3 日在剑桥辩论社演讲的文字稿,没有新公告。🔗 来源
这意味着什么
消息线程将一部分对话状态移至服务器,而费用不变:token 数量和价格保持不变,只有等待时间缩短,对累积数十万 token 的智能体会话效果最明显。选择临时线程,在加密内存中保留 5 分钟且不提供重新读取的 API,让应用继续掌控自身的历史记录,代价是明确排除部分场景:不支持 ZDR、Batches 或 HIPAA 组织。终端方面,Copilot CLI 预览版提醒人们,界面本身也是攻击面,因为文件名或模型回复此前就可能改变屏幕的显示样式。
Grid Protectors 和 Suncatcher 应对的是同一个约束——计算所需的能源,但着眼于截然不同的时间尺度。OpenAI 提议让其园区可按需削减用电,以获得已经承压的电网的接纳,并承诺自行承担成本;唯一量化的家庭节省金额来自 Georgia Power,而且涵盖其全部大型客户。Google 则刚让轨道上的 TPU 写出了一首俳句:这是可行性验证的一个里程碑,没有性能数据,下一步是在 2027 年连接两颗卫星。
LifeVal、Design Creativity Bench 和 BrowseSafe++ 衡量的是编程与数学排行榜看不到的能力。LifeVal 显示进步正在放缓,GPT-5.6 与 GPT-6 Astra 之间仅相差 0,6 个百分点,但它仍是内部基准,没有竞争对手参与,也未公开任务集。Kombai 指出了成功率所掩盖的界面趋同,而 BrowseSafe++ 则将检测与抵抗区分开来:模型即使识别出注入,也可能照做;一个 0,8B 的检测器,即便成本不足一次 API 调用的百分之一,面对不断重试的攻击者也仍然不够。
Sakana AI 选择通过 Sawara 掌控从预训练到产品的整个链条,但时间安排仍有条件,也未公布模型规模。Runway 和 Synthesia 则采取相反路径:进入用户已经工作的地方,融入编程智能体或 ChatGPT 和 Claude 的对话,而不是将用户吸引到自己的应用。ElevenLabs 用数字为长对话中的语音交互提供支持,但这项厂商研究在推文和博文中所述的样本基数并不一致;与此同时,NVIDIA 通过 Cosmos 3 Nano 为驾驶、机器人或手术仿真的开发者提供工具。
来源
- Anthropic 关于消息线程的文章
- @ClaudeDevs:Claude Code 中的消息线程
- 消息线程文档
- Sakana AI 2026 年研讨会纪要
- @SakanaAILabs:研讨会纪要
- Grid Protectors Program 介绍(OpenAI)
- Project Suncatcher 原型卫星的首次响应(Google)
- LifeVal(OpenAI)
- 我们为何打造 Design Creativity Bench(Kombai)
- BrowseSafe++(Perplexity)
- 面向编程智能体的 Runway Dev 插件
- @synthesiaIO:ChatGPT 和 Claude 中的 Synthesia 视频
- 为何语音在复杂且令人紧张的对话中更具优势(ElevenLabs)
- @ElevenLabs:语音与文字聊天的对比研究
- 使用 NVIDIA Cosmos 构建用于交互式仿真的世界模型
- Copilot CLI 1.0.106-3
- Qwen Code v0.26.6
- Gemini CLI 的 PR 30058
- mistral CLI 0.16.0
- Qodo 与 Codex 案例研究(OpenAI)
- @zeddotdev:corgi
- pull_request_target 将于 12 月 2 日起默认禁用(GitHub)
- 风险评估纳入仓库保护状态(GitHub)
- Perplexity API 更新日志
- Dragonscale 关于 kniv v7 的文章
- 关于滑动窗口与 Bifocal 的文章
- VIDRAFT 关于后门的文章
- Rairo Mukamuri 关于 Beam 的文章
- @vanstriendaniel:Saturate
- EcoHash 关于 LTX 2.5 的文章
- KPN 的 Mobiel AI(ElevenLabs)
- Suno Studio 版本说明
- @Kling_ai:Chroma Awards 第 2 季
- Anthropic Residency
- Data Bot(SpaceXSI)
- @MistralAI:Le Chonk 与 SCF 求解器
- Google 在 2026 年 10 月发布的人工智能公告
- 人工智能体记忆(Perplexity)
- 知识对谈(Perplexity)