ai-powered-markdown-translatorArtikel vertaald van het Frans naar het Nederlands met gpt-5.6-sol.
Tweeënvijftig aankondigingen, grotendeels gepubliceerd op 11 september, met één terugkerend idee bij spelers die niet met elkaar overleggen. Cursor vertrouwt een compleet project toe aan een coördinerende agent die zelf niet codeert en taken delegeert aan duizenden subagenten, Cognition laat twee modellen als duo draaien op de machine van de ontwikkelaar, Sakana stuurt elke taak naar het lichtste model dat haar kan oplossen. Diezelfde dag haalt OpenAI zijn model voor levenswetenschappen uit de onderzoekspreview en publiceert het de tarieven, geeft Runway de gewichten van zijn gesloten modellen in licentie aan bedrijven en brengt Anthropic een subcommando uit dat eindelijk meet wat een plugin werkelijk oplevert.
Cursor lanceert Projects, projecten aangestuurd door een coördinerende agent
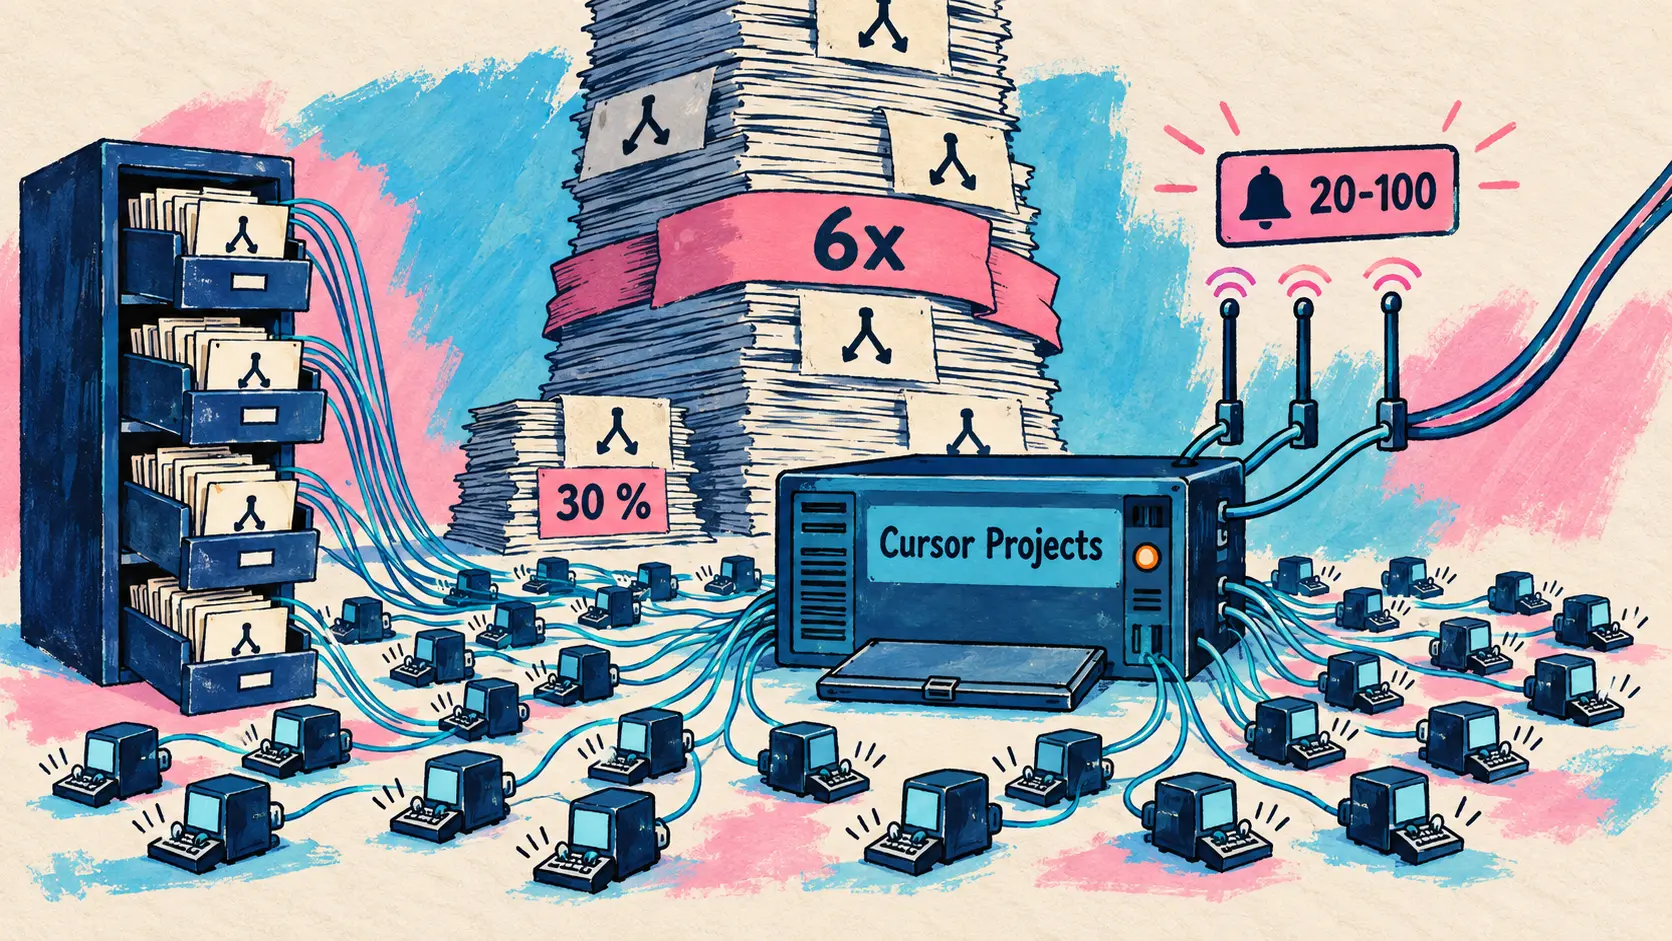
10 september — Cursor heeft Projects gelanceerd, een herziening van de manier waarop werk in de editor aan een agent wordt toevertrouwd. Het product breekt met de gewoonte die de afgelopen twee jaar is ontstaan: in plaats van voor elke taak een nieuw gesprek te openen en het daarna weer te sluiten, praat de gebruiker met een coördinerende agent in een thread die maandenlang blijft bestaan. Deze coördinator schrijft zelf geen regel code. Hij stuurt andere agenten aan die dat wel doen, waardoor hij altijd beschikbaar blijft om instructies te ontvangen terwijl het werk vordert.
Drie mechanismen maken dit mogelijk. Allereerst standaarduitvoering in de cloud: een Project draait op zijn eigen machine, wordt niet onderbroken wanneer de laptop wordt dichtgeklapt en het aantal parallelle subagenten wordt niet langer beperkt door de lokale hardware. Een lokale agent wordt gestart wanneer een test op de machine van de ontwikkelaar moet draaien. Vervolgens de gedeelde context: elk Project onderhoudt een verzameling bestanden die tussen alle machines wordt gesynchroniseerd en waarin agenten hun onderzoek, artefacten en inzichten in de code vastleggen. Als één agent ontdekt hoe een service moet worden getest, beschikken alle volgende agenten over die procedure. Het derde mechanisme is het ongebruikelijkst. Cursor noemt dit abonnementen (subscriptions): de coördinator kan een Slack-kanaal bewaken, volgens een planning worden uitgevoerd of alle pull requests volgen om de continue integratie te repareren. De agent komt in actie wanneer hij een signaal detecteert, zonder te wachten tot iemand hem inschakelt.
| Gemeten populatie | Gemeten effect op pull requests |
|---|---|
| Nieuwe gebruikers van Projects | 30 procent meer gemerged |
| Gebruikers die vooral in Projects werken | Zes keer zoveel gemerged |
| Project voor het interne design system | Naar schatting 20 tot 100 pull requests per dag geraakt |
The coordinator doesn’t write code itself but directs other agents that do. Because it delegates rather than executes, it is never blocked and is always responsive to direction.
🇳🇱 De coördinator schrijft zelf geen code, maar stuurt andere agenten aan die dat wel doen. Omdat hij delegeert in plaats van uitvoert, wordt hij nooit geblokkeerd en blijft hij altijd ontvankelijk voor instructies. — Cursor, Projects-blog
Deze cijfers zijn interne metingen en moeten met de nodige voorzichtigheid worden geïnterpreteerd. Het meest aansprekende voorbeeld blijft dat van tuinieren, de naam die Cursor geeft aan werk dat nooit af is: een engineer laat een Project draaien dat aan het design system is gewijd, elke nieuwe pull request onderzoekt, daaruit de componenten haalt die in het systeem thuishoren en een lint-regel toevoegt zodra het twee keer dezelfde fout ziet. Projects bevindt zich in bèta en wordt sinds 10 september geleidelijk uitgerold. De aankondiging vermeldt geen prijsvoorwaarden of beperkingen per abonnement.
🔗 Aankondiging van Cursor op X
GPT-Rosalind verlaat de onderzoekspreview en krijgt openbare tarieven
11 september — OpenAI Developers kondigt aan dat GPT-Rosalind, zijn redeneermodel voor levenswetenschappen, de onderzoekspreview (research preview) verlaat. Het model werd op 16 april 2026 gepresenteerd voor biologisch onderzoek, geneesmiddelenontwikkeling en translationele geneeskunde en was toen alleen toegankelijk voor in aanmerking komende Enterprise-klanten in de Verenigde Staten. Het gaat over op vertrouwde toegang (trusted access) voor in aanmerking komende organisaties wereldwijd, via de API, Codex en ChatGPT Enterprise. Deze toegang zal ook gelden voor toekomstige modellen uit de reeks zodra die verschijnen.
De changelog van de API geeft in een item van 8 september de details die niet in de thread op X worden genoemd. Het model heet gpt-rosalind-research en de algemene beschikbaarheid ervan blijft afhankelijk van het programma voor vertrouwde toegang, dat is voorbehouden aan intern onderzoek op het gebied van levenswetenschappen dat door OpenAI is goedgekeurd.
| Tarief- of toegangsonderdeel | Aangekondigde waarde |
|---|---|
| Model-ID | gpt-rosalind-research |
| Inputtokens | 5 dollar per miljoen |
| Gecachete inputtokens | 0,50 dollar per miljoen |
| Outputtokens | 25 dollar per miljoen |
| Begin van de facturering | 5 oktober 2026 |
| Toegangskanalen | API, Codex, ChatGPT Enterprise |
| Toegangsvoorwaarde | Programma voor vertrouwde toegang, in aanmerking komende organisaties |
De facturering begint pas op 5 oktober: tijdens de onderzoekspreview kostte het gebruik geen credits of tokens. Wat de tooling betreft, vormen de Life Sciences-plugins van Codex de orchestratielaag van het model, van genomica en eiwitstructuren tot translationeel onderzoek, van het verzamelen van biologisch bewijs tot het genereren van kwaliteitscontrolerapporten en interactieve notebooks. Dit pakket, dat in april gratis op GitHub is gepubliceerd, biedt toegang tot meer dan 50 openbare multi-omicsdatabases, literatuurbronnen en biologische tools. Het werkt voor iedereen met algemene modellen, maar alleen in aanmerking komende Enterprise-gebruikers kunnen het met GPT-Rosalind combineren.
De geclaimde prestaties zijn nog steeds die van de lancering: de hoogst gepubliceerde score op BixBench, een voorsprong op GPT-5.4 bij 6 van de 11 taken van LABBench2 met het grootste verschil bij CloningQA, en bij een samen met Dyno Therapeutics ontworpen RNA-sequentie-functietaak een beste inzending die voor voorspellingen boven het 95e percentiel van 57 menselijke experts uitkwam. De concrete informatie is tweeledig: een gespecialiseerd model dat met openbare tarieven de experimentele status verlaat, en een geografische uitbreiding van de toegang. De beperking blijft de toelating, die niet via selfservice beschikbaar is.
🔗 Thread van OpenAI Developers op X
Runway Model Licensing levert bedrijven de gewichten van gesloten modellen
11 september — Runway heeft een licentieprogramma voor zijn modellen (Model Licensing) opengesteld voor bedrijven. Het principe breekt met toegang via een API: de klant ontvangt de volledige gewichten van een Runway-model van de nieuwste generatie, verfijnt het met eigen gegevens, host het in de eigen infrastructuur en commercialiseert wat ermee wordt gemaakt. De gegevens en gegenereerde resultaten verlaten nooit de omgeving van de klant, waarmee het aanbod zich expliciet richt op studio’s, merken en overheden.
| Geleverd onderdeel | Inhoud |
|---|---|
| Modelgewichten | Volledige gewichten als uitgangspunt |
| Checkpoints | Meerdere te valideren versies van het model |
| Trainingsscript | Code om eigen gegevens toe te voegen en verfijningen uit te voeren |
| Levering | Verpakt in de codebase van de klant en gehost waar die dat wil |
| Ingezette onderzoekers | Praktische hulp bij afstelling, gewichten en levering |
Hosting kan naar keuze plaatsvinden in de cloud van de klant, in diens datacenter of volledig on-premises, ook in een van het netwerk afgesloten omgeving (air-gapped) voor overheidsinstanties. Er worden zes sectoren genoemd: softwareplatforms, film en studio’s, merken en marketing, robotica en fysieke AI met het World Action Model als ruggengraat voor beleid (policy backbone), videogames en 3D met fotorealistische verbetering van renders van lage kwaliteit, en overheden.
Economisch maakt Runway onderscheid tussen twee routes: Runway Dev, de API die op basis van gebruik wordt gefactureerd en waarvoor geen infrastructuur hoeft te worden beheerd; en de jaarlijkse licentie, met voorspelbare kosten en volledige controle over versies, gedrag en output. De FAQ beantwoordt het bezwaar van veroudering: toekomstige modellen krijgen geen toegang tot de bedrijfseigen gegevens van de klant, jaarlijkse verlenging is voorzien en er worden credits toegekend voor volgende generaties. De kosten om het systeem intern opnieuw op te bouwen worden geraamd op jaren van leren en honderden miljoenen dollars. Het bedrijf presenteert zich als een van de zeer weinige ter wereld die gesloten gewichten van deze kwaliteit in licentie geven en zet zijn aanbod nadrukkelijk af tegen open gewichten, die volgens Runway een zwakker model met een takenlijst zouden opleveren. Er worden geen tarieven gepubliceerd; toegang verloopt via een commercieel formulier. De aankondiging volgt negen dagen na Runway Dev MCP en een week na het Team-abonnement: Runway bestrijkt nu het volledige spectrum, van individuele maker tot licentie voor gesloten gewichten.
Cognition brengt Fusion naar Devin Desktop en Devin CLI
11 september — Cognition heeft Fusion beschikbaar gemaakt in Devin Desktop en Devin CLI. De architectuur draaide al enkele maanden op Devin Cloud en komt nu naar de machine van de ontwikkelaar. De aankondiging volgt één dag na SWE-2, het eigen codemodel, en beide vullen elkaar aan omdat SWE-2 het aanbevolen secundaire model van het systeem is.
Het principe is eenvoudig uit te leggen. Wanneer Fusion wordt gekozen, selecteert men niet één model maar twee. Een geavanceerd model treedt op als leider (lead) en houdt de regie over de sessie: het beheert het plan, beslist bij onduidelijkheden en controleert het geleverde werk. Een goedkoper model treedt op als assistent (sidekick): het verkent de code, schrijft de wijzigingen, voert de tests uit en brengt verslag uit. Beide draaien parallel, elk met een eigen blijvende context. Het technische argument richt zich tegen modelrouting, de oplossing die voor de hand ligt om de kosten te verlagen: een initiële prompt volstaat niet om de moeilijkheid van een taak te meten en een modelwissel tijdens het proces verbreekt de promptcache. Fusion omzeilt het probleem door nooit volledige gesprekken tussen de twee modellen over te dragen; zij wisselen alleen briefings, resultaten en feedback uit.
| Kosten per taak, in dollar | Alleen Fable 5.1 | Fusion Fable 5.1 en SWE-2 | Alleen Astra | Fusion Astra en SWE-2 |
|---|---|---|---|---|
| DeepSWE 1.1 | 14,63 | 7,88 | 7,88 | 4,69 |
| Terminal-Bench 4 | 17,46 | 13,37 | 10,08 | 6,06 |
| SWE-Atlas QnA | 7,57 | 5,00 | 5,72 | 3,59 |
| Vals Code Migration | 70,97 | 42,00 | 44,36 | 35,51 |
| Uitgebreide FrontierCode 1.1 | 2,68 | 1,67 | 2,62 | 2,34 |
One of our key findings is that using more expensive models can make the entire system cheaper.
🇳🇱 Een van onze belangrijkste ontdekkingen is dat het gebruik van duurdere modellen het hele systeem goedkoper kan maken. — Cognition, blog over lokale Fusion
De werking wordt aan beide kanten van het duo aangetoond. Aan de kant van de leider verlaagde de vervanging van Opus 4.8 door Fable 5, dat per token nominaal twee keer zo duur is, de gemiddelde sessiekosten met 9 procent bij dezelfde assistent, terwijl ook een betere score op FrontierCode werd behaald: Fable delegeerde eerder en schreef betere briefings, terwijl Opus zijn assistent micromanagede. Aan de kant van de assistent verlaagt de overstap van GPT-5.6 Luna naar SWE-2, dat per miljoen tokens 275 procent duurder is, de totale kosten van de taak met 2 procent en levert die tegelijk 1,4 punt winst op. Op de Artificial Analysis Coding Agent Index v1.5 behaalt Fusion met Fable 5.1 en SWE-2 een score van 61,7 tegen 36 procent lagere kosten dan Claude Code met Fable 5.1, dat niet verder komt dan 62,2. Cognition leidt hieruit een regel voor 2026 af: beoordeel modellen en combinaties van model en harness op de prijs per taak in plaats van op de prijs per token. Een comfortabele positie voor een uitgever die een harness verkoopt, maar de cijfers zijn samen met Artificial Analysis en Vals AI geproduceerd op vijf afzonderlijke benchmarks. Installatie met één opdracht.
🔗 Aankondiging van Cognition op X
Sakana AI lanceert Fugu Max en Fugu Ultra v2, twee evoluties van zijn multi-agent-orchestrator
11 september — Sakana AI brengt Fugu Max en Fugu Ultra v2 uit, twee nieuwe versies van Sakana Fugu, zijn systeem voor multi-agent-orchestratie (multi-agent orchestration system) dat achter één OpenAI-compatibele API beschikbaar is. De rode draad is de Pareto-grens: Sakana stelt dat de sector nog steeds redeneert alsof capaciteit de enige dimensie is, terwijl een echte taak op twee dimensies wordt beoordeeld: capaciteit en kosten.
Fugu is geen afzonderlijk model, maar een aangeleerde orchestratie-laag die elke taak doorstuurt naar een pool van open-weight en gespecialiseerde modellen. Fugu Max breidt die pool uit — volgens het bedrijf de grootste tot nu toe — door de NVIDIA Nemotron-familie erin op te nemen, en stuurt elke taak naar het lichtste model dat haar kan oplossen. Het behaalt de beste totaalscore op zes benchmarks en verlegt de kosten-prestatiegrens op zeven van de tien, tegen 2 dollar per miljoen inputtokens en 6 dollar per miljoen outputtokens. Die outputprijs ligt volgens Sakana 40 tot 60 procent onder die van Sonnet 5, GPT 5.6 Terra en Kimi K3.
| Aangekondigde meting | Score | Door Sakana gegeven vergelijking |
|---|---|---|
| Fugu Ultra v2, Chartography | 48,3 | Opus 5 met 27,3; Fable 5 met 29,5 |
| Fugu Ultra v2, DeepSWE | 74,3 | Voor modellen die per token 3 tot 5 keer duurder zijn |
| Fugu Ultra v2, rangschikking | 1e of gedeeld 1e op 5 van 8 benchmarks | Top 2 op 7 van 8 |
| Fugu Max, algemeen klassement | Beste score op 6 benchmarks | Pareto-grens verlegd op 7 van de 10 |
Het punt waarop Sakana het meest hamert, verdient aandacht: Fable 5, Fable 5.1 en GPT-6-Astra maken geen deel uit van de agentpool van Fugu Ultra v2, waarvan de trainingsgrensdatum 28 augustus 2026 is. Het argument draait om leveringsbestendigheid: een uitwisselbare pool beschermt tegen leveranciersafhankelijkheid, intrekking van API-toegang en dienstonderbrekingen. Beide modellen zijn onmiddellijk beschikbaar, en een Fugu-gebruiker schakelt over op Max of Ultra v2 door slechts één parameter te wijzigen. Fugu Max staat ook vermeld op OpenRouter, met multimodale input, webzoekfunctie, configureerbare redenering en gestructureerde output. Kanttekening bij het gebruik: de benchmarks en vergelijkingsmodellen zijn door Sakana gekozen, SWEFish is een interne testbank en de geclaimde verschillen hangen af van de tarieven van de vergeleken modellen op het moment van publicatie.
🔗 Introductie van Fugu Max en Fugu Ultra v2
ElevenLabs lanceert Music v2.5, met lossless downloads bij alle abonnementen
11 september — ElevenLabs heeft Music v2.5 uitgebracht en het als standaardmodel in ElevenMusic ingesteld, zowel voor generatie via een prompt als via audioreferentie. Het model belooft instrumenten die als een liveopname klinken, rijkere arrangementen, lange composities, genreovergangen midden in een nummer, rap en stemmen die natuurlijk klinken in de taal van de tekst. Als maatstaf wordt een blinde test met 47 885 paren aangevoerd, met per model één uitvoering voor dezelfde prompt: Music v2.5 kreeg meestal de voorkeur, met het duidelijkste verschil bij genres waarin zang en akoestiek centraal staan: R&B, soul, hiphop, rock, metal, orkestmuziek en filmmuziek. Het exacte voorkeurspercentage is niet gepubliceerd.
Het tweede onderdeel verandert meer voor gebruikers. Elk nummer dat in ElevenMusic wordt gemaakt, behoort bij alle abonnementen, inclusief het gratis abonnement, toe aan de maker. Het gratis abonnement biedt vijf lossless downloads per dag voor commercieel gebruik, op voorwaarde dat ElevenMusic wordt vermeld; het Pro-abonnement biedt er 400 per maand. De rechten die op het moment van creatie zijn verkregen, blijven aan het nummer verbonden: opzeggen of downgraden verandert niets aan reeds geproduceerde nummers, en een toekomstige wijziging van de voorwaarden zou alleen voor nieuwe nummers gelden. De enige uitzondering is een nummer dat op het lied van een andere artiest is gebaseerd; daarvan wordt de download geblokkeerd.
| Gemeten of aangekondigd onderdeel | Waarde |
|---|---|
| In de blinde test beoordeelde paren | 47 885 |
| Lossless downloads, Free-abonnement | 5 per dag, commercieel gebruik met naamsvermelding |
| Lossless downloads, Pro-abonnement | 400 per maand |
| API-ID | music_v2_5 |
| Standaardmodel in ElevenMusic | Music v2.5, Music v2 blijft behouden |
Het model is ook beschikbaar in ElevenCreative, als Music-node in Flows en in de API onder de ID music_v2_5. ElevenLabs verduidelijkt dat de meerjarige overeenkomst die een dag eerder met Universal Music Group werd aangekondigd, losstaat van deze release. Voor de lezer is de volgorde van de aankondigingen relevant: eerst werd de overeenkomst met het grote platenlabel aangekondigd, waarna het model en de uitgebreidere gebruiksrechten de volgende dag verschenen.
🔗 Aankondiging van ElevenLabs op X
Claude Code meet wat een plugin werkelijk toevoegt, met en zonder de plugin
11 september — Het Claude Developers-team kondigt claude plugin eval aan, een subcommando van Claude Code dat een plugin of skill uitvoert op een reeks testgevallen, elke uitvoering beoordeelt en vervolgens elk geval zonder de plugin opnieuw uitvoert om te meten wat die toevoegt. Het idee is eenvoudig en enigszins ongemakkelijk: een hoge score bewijst niet dat een plugin helpt, omdat Claude het soms zonder die plugin even goed doet. Het commando geeft daarom twee scores en het verschil ertussen terug. Als een geval in beide groepen 1,0 behaalt, heeft de plugin daar niets aan bijgedragen.
Het startpunt is claude plugin eval init, uitgevoerd in de hoofdmap van de plugin. Er wordt een interactieve sessie geopend: Claude leest de plugin, vraagt hoe een goed resultaat eruitziet, stelt prompts voor die de plugin wel en niet zouden moeten activeren, ontwerpt de beoordelaars (graders), test die eenmaal, maakt voor elk geval een map aan en vermeldt de geschatte kosten van een volledige run. Vervolgens wordt elk geval drie keer met en drie keer zonder de plugin uitgevoerd, dus zes uitvoeringen, omdat één run van een niet-deterministische agent weinig zegt. De terminal toont een tabel met en zonder plugin, er wordt een zelfstandig HTML-rapport naar schijf geschreven en het rapport wordt als privéartefact gepubliceerd wanneer het account dat toestaat.
| Type beoordelaar | Kosten in modelaanroepen | Voorwaarde voor succes |
|---|---|---|
regex | geen | Patroon gevonden in het laatste antwoord, het spoor of een bestand |
tool_used | geen | Aantal aanroepen van een tool tussen een minimum en een maximum |
tool_order | geen | De ene aanroep gaat aan de andere vooraf |
file_exists | geen | Een tijdens de run gemaakt bestand komt overeen met het patroon |
llm | één model beoordeelt | Gunstig oordeel bij minstens 2 van de 3 stemmen |
baseline | één model beoordeelt | De run is minstens gelijkwaardig aan een referentietranscriptie |
Een subtiliteit moet worden begrepen voordat een verschil wordt geïnterpreteerd: een beoordelaar die vereist dat de skill wordt aangeroepen, kan zonder de plugin nooit slagen. Daarom wordt die in beide groepen buiten de score gehouden en alleen als indicator gerapporteerd; anders zou het verschil kunstmatig worden opgeblazen. De isolatie is streng. Elke run is een tijdelijk child process, zonder gebruikersinstellingen, hook, CLAUDE.md, MCP-server, geïnstalleerde plugin of geheugen. De runs stellen nooit toestemmingsvragen, en gevoelige tools worden uit de sessie verwijderd tenzij ze expliciet zijn toegestaan; als Bash of PowerShell wordt toegestaan op een machine zonder sandbox-backend, weigert Claude Code de run in plaats van die zonder afscherming uit te voeren. Een plugin die met MCP-tools communiceert, kan zonder de echte dienst worden geëvalueerd: één Markdown-bestand per tool levert het antwoord, met een blok dat de run afbreekt als de plugin iets anders verstuurt dan verwacht.
Evals call the model, so they use tokens and results vary. […] Your plugin’s hooks and MCP servers run as you, so only evaluate plugins you trust.
🇳🇱 De evaluaties roepen het model aan, dus ze verbruiken tokens en de resultaten variëren. […] De hooks en MCP-servers van je plugin draaien met jouw rechten, dus evalueer alleen plugins die je vertrouwt. — @ClaudeDevs op X
De kosten zijn reëel: elke uitvoering en elke beoordelende verifier is een modelaanroep die van het abonnement of de factuur wordt afgetrokken. Het voorbeeld in de documentatie noemt 74 seconden en 0,41 dollar voor één geval met zes runs. Vandaar het advies van het team: test eerst met --runs 1 voordat je een volledige run start. Voor continuous integration zijn de exitcodes gedocumenteerd, waaronder 0 wanneer alles slaagt en 2 voor een gedeeltelijke run wanneer het kostenplafond is bereikt. Volgens de documentatie is de eerste typische bevinding een verschil van bijna nul terwijl de skill-verifier faalt: Claude kiest de skill niet bij een natuurlijke formulering, en dan moet de beschrijving ervan worden herwerkt.
🔗 Documentatie voor pluginevaluaties
De rest van versie 2.1.269
Het subcommando verschijnt in versie 2.1.269, uitgebracht op 11 september om 21.17 uur Parijse tijd. De overige toevoegingen zijn minder opvallend, maar nuttig in het dagelijks gebruik. Het commando /output-style toont en wijzigt de outputstijl, ook via Remote Control en in cloud- of headless-sessies. Wanneer de Bash-tool wordt gebruikt om bestanden te wijzigen, bevat het resultaat voortaan de diff van de gewijzigde bestanden, waardoor Claude dezelfde zichtbaarheid krijgt als bij een klassieke bewerking. Voor observability labelt een omgevingsvariabele de OpenTelemetry-metrics en -events per repository, en twee andere variabelen regelen de wachttijd voor modeldetectie bij een gateway en de limiet voor gelijktijdige agents van de Workflow-tool, tot maximaal 256.
De oplossingen raken drie gevoelige gebieden: de gedeeltelijke ongeldigverklaring van de promptcache na een afgebroken en vervolgens hervat antwoord, toestemmingsregels die met een ontkenning beginnen en nu alleen nog gelden voor de instellingsbron waarin ze zijn vastgelegd, en de controle van het schrijfpad die eindelijk ook het bestand omvat dat door een tee-commando wordt geschreven. De git status die na een compaction wordt doorgegeven, is voortaan de huidige en niet die van het begin van de sessie. In VS Code opent een badge een overzicht van subagents met kaarten, een stopknop en alleen-lezen transcripties, en met twee dialoogvensters kunnen hooks en toestemmingsregels worden beheerd in de gebruikers-, project- en lokale instellingen.
🔗 Releaseopmerkingen voor 2.1.269
Antigravity: vier versies in één week en een inhaalslag rond Teamwork
Google heeft kort na elkaar twee versies van zijn command-line-interface en een nieuwe versie van zijn applicatie uitgebracht, nog afgezien van twee eerdere versies die hier nooit zijn behandeld. De changelog is de moeite waard om als geheel te lezen, omdat de releases van deze week hetzelfde verhaal vertellen: de agent verlaat de interactieve terminal en wordt een dienst.
Antigravity CLI 1.2.0: de CLI wordt een achtergronddienst die via Remote Control wordt aangestuurd
10 september — Versie 1.2.0 van Antigravity CLI is de eerste minorversie sinds juli. Drie subcommando’s, remote-control start, status en stop, registreren de command-line-interface bij de servicebeheerder van het systeem als een achtergronddienst die afmeldingen en herstarts overleeft, met een optie voor een instantienaam en een andere om de dienst tot de actieve aanmeldsessie te beperken. Tot nu toe moest een terminal geopend blijven. Scrollen met een halve pagina wordt met twee nieuwe standaardsneltoetsen uitgebreid naar alle weergaven. Van de acht oplossingen is deze het nuttigst om onverwacht gedrag te begrijpen: een prompt of antwoord dat door filters voor inhoudsveiligheid wordt geblokkeerd, toont nu expliciet de reden voor het stoppen, waar de gebruiker eerder een generieke fout of een lege beurt zag. MCP-servers die in globale plugins zijn ingebouwd, worden bij het opstarten eindelijk correct geïnitialiseerd.
Antigravity CLI 1.1.28: uitgebreid herstel na fouten, versnelde headless-modus en goedkeuring vereist voor het lezen van URL’s
9 september — Een dag eerder bundelde versie 1.1.28 negen verbeteringen rond bestendigheid en de headless-modus, die vanuit een script wordt aangeroepen. Tijdelijke fouten van de model-API worden opnieuw geprobeerd met een uitgebreide exponentiële backoff, het opstarten veroorzaakt geen netwerkverzoek meer om de identiteit van de gebruiker op te halen en per beurt wordt tot 200 milliseconden aan inactieve vertraging verwijderd. Twee gedragswijzigingen verdienen de aandacht van iedereen die automatiseert.
| Gedragswijziging | Vóór versie 1.1.28 | Sinds versie 1.1.28 |
|---|---|---|
| Timeout in scriptmodus | Timeoutfout | Gedeeltelijke output teruggegeven, succescode, waarschuwing |
| Lezen van een externe URL door de agent | Zonder prompt | Standaard wordt goedkeuring gevraagd, tenzij vooraf toegang is verleend |
Een script dat op impliciete webtoegang vertrouwde, moet die toestemming dus expliciet verlenen. Goedkeuringsprompts noemen nu de precieze actie en voegen een regel met de reden toe wanneer het verzoek afkomstig is van een hook of een bestand dat bij een ander project hoort.
Antigravity CLI 1.1.26 en 1.1.27, inhaalslag: eenmalige prompt op een ander model en afhankelijkheden van subagents in de frontmatter
4 en 5 september — Versies 1.1.26 en 1.1.27 dichten de achterstand en brengen de meest concrete vernieuwing van het geheel: het commando voor modelselectie accepteert voortaan een prompt die één keer op een ander model wordt uitgevoerd, waarna de sessie terugkeert naar het oorspronkelijke model. Zo krijg je een tweede mening van een krachtiger of goedkoper model zonder de standaardinstelling te wijzigen. Dezelfde versie voegt een lijst met agents toe aan de Markdown-frontmatter van aangepaste agents, om de subagents waarvan ze afhankelijk zijn te declareren, en bevat twee oplossingen die belangrijk zijn voor automatiseringen: een MCP-aanroep met een argument dat niet in het schema van de server is gedeclareerd, wordt afgewezen en gecorrigeerd in plaats van stilzwijgend verwijderd, en een headless-uitvoering vermeldt geweigerde acties in zijn JSON-output in plaats van ze zonder iets te zeggen te negeren.
Antigravity 2.13.0: sectie Documenten, gevirtualiseerde viewer voor SQL en JSONL en sneltoetsen voor citaten
9 september — Antigravity 2.13.0 brengt 16 verbeteringen en 16 bugfixes. Externe bestanden die aan een gesprek worden toegevoegd, Google Drive-links, pdf’s en Office-documenten, worden gegroepeerd in een sectie Documenten boven de Artifacts, in plaats van te worden vermengd met de uitvoer van de agent. Conceptbestanden die de agent voor zichzelf schrijft, komen in een aparte sectie terecht. Code- en data-artifacts zoals SQL- en JSONL-bestanden worden geopend in een gevirtualiseerde viewer met syntaxiskleuring en regelnummers, die ook bij grote bestanden soepel blijft en inline opmerkingen ondersteunt. Een gesloten zijvraag wordt verkleind tot een knop in plaats van gewist, interactieve prompts krijgen een annuleringsknop en geselecteerde tekst kan via een sneltoets in de chat worden geciteerd. Twee bugfixes verbeteren de transparantie van toestemmingen: een geweigerde stap blijft zichtbaar met het label Rejected in plaats van te verdwijnen, en de agent vraagt niet langer opnieuw toestemming om artifacts uit andere projecten te lezen wanneer toegang buiten het project al is verleend.
🔗 Draad met tips van @antigravity op X
Teamwork, de inhaalslag van 27 augustus
Een bericht dat op 27 augustus werd gepubliceerd, hier nooit werd behandeld en nog altijd bovenaan de ontwikkelaarsrubriek van de Gemini-pagina met nieuwigheden staat, verdient een inhaalslag. Teamwork is Antigravity’s framework voor multi-agent orchestration, waarin agents uren- of dagenlang elkaars werk voorstellen, bekritiseren en verfijnen, en dat als preview beschikbaar is voor alle betaalde abonnementen. Er worden vijf patterns meegeleverd, die op basis van de prompt automatisch worden geselecteerd, van iteratief coderen en documentbeoordeling tot langdurige bewijsvoering. Met het pattern voor langdurige bewijsvoering meldt Google dat zeven openstaande problemen zijn opgelost, waaronder het vermoeden over de cycli van Knuth, waarvoor bewijzen van meer dan 40 en meer dan 70 pagina’s zijn opgesteld; het bewijs van 40 pagina’s is formeel geverifieerd in Lean. De overige resultaten zijn bevestigd door menselijke experts en vijf artikelen zijn op arXiv geplaatst.
| Gerapporteerde meting | Waarde |
|---|---|
| TCSBench, Gemini 3.7 Flash en 3.1 Pro bij langdurig bewijs | 71 procent |
| TCSBench, Gemini 3.6 Flash en 3.1 Pro, oorspronkelijk artikel | 67,7 procent |
| RISC-V-simulator, fout in cyclusuitlijning | 0,71 procent |
| Gereproduceerde problemen met Gemini 3.7 Flash | 3 van 7 |
Buiten de wiskunde heeft Teamwork vanaf nul een cyclusnauwkeurige, out-of-order RISC-V-processorsimulator gebouwd die het xv6-systeem tot aan de shell opstart en meer dan honderd standaardbenchmarks uitvoert, gevalideerd aan de hand van uitvoering op hardware. Twee bijdragen zijn upstream geïntegreerd in opensourceprojecten: een gevectoriseerd snel pad in Eigen en een variant van een gelijktijdige hashtabel met een verdubbelde invoegdoorvoer bij 64 threads.
🔗 Teamwork, wanneer AI een onderzoekspartner wordt
GitHub Copilot lost zijn eigen opmerkingen op en brengt Jira naar zijn applicatie
Code review wordt uitgevoerd door een groep agents
11 september — GitHub werkt Copilot code review op twee vlakken bij. Wat de gebruikerservaring betreft, lost de review een opmerking van Copilot automatisch op wanneer een latere commit erop ingaat, zodat de lijst met openstaande opmerkingen alleen nog bevat wat op een antwoord wacht. Wanneer een codesuggestie wordt toegepast, schrijft Copilot bovendien een commitbericht dat op de wijziging is afgestemd, in plaats van het vooraf ingevulde bericht. Wat de analyse betreft, beschikt de reviewagent voortaan over alle shell-tools van de Copilot SDK, uitgevoerd achter de firewall van de agent: hij kan een build starten, tests uitvoeren, een gericht script draaien of toegankelijke API’s bevragen om de code die hij onderzoekt te controleren. GitHub meldt meer positieve feedback, meer bevindingen met een hoge ernst en minder detailopmerkingen, zonder hiervoor cijfers te geven.
Het inspanningsniveau Lite steunt niet langer op één agent, maar op een groep agents die elk hun eigen beoordeling leveren, samengevoegd tot één review.
| Gemeten bevinding, Lite-reviews door een groep | Gemelde verandering |
|---|---|
| Verwerkte opmerkingen, hoge ernst | plus 47 procent |
| Verwerkte opmerkingen, gemiddelde ernst | plus 31 procent |
| Verwerkte opmerkingen, lage ernst | plus 11 procent |
| Kosten van een review | ongeveer 8 procent lager |
Noch het aantal agents in de groep, noch de gebruikte modellen wordt vermeld. Dit is de derde ontwikkeling van Copilot code review in twee weken.
Jira in de applicatie, HydraFusion in de command line, VS Code 1.137
10 september — Het wekelijkse overzicht voor de week van 7 september, de week van Copilot Day, brengt Jira-integratie naar de Copilot-applicatie: tickets worden naar een gedeeld canvas gehaald, daar wordt gekozen wat verdergaat en Copilot neemt de context van het ticket mee naar het onderzoek, de implementatie en de voorbereiding van de pull request. In Copilot CLI kan Project HydraFusion voortaan net als ieder ander model worden geselecteerd en kiest het voor elke taak een workflow tussen lokale, cloud- en samengestelde modellen, waarbij prestaties, kosten en latency tegen elkaar worden afgewogen.
VS Code 1.137, uitgebracht op 9 september, brengt drie agentfuncties. Automations, in public preview, plannen terugkerende agenttaken per uur, per dag of per week op basis van meegeleverde templates, zoals het sorteren van issues of het zoeken naar bugs. Met de experimentele spraakmodus kan iemand met een agent praten terwijl die werkt, hem onderbreken of een andere richting geven. Ten slotte wordt een link naar een issue of pull request rechtstreeks in het venster Agents geopend, zelfs wanneer er geen repository is geopend. De release notes voegen een agenthost toe die op een speciaal protocol is gebaseerd en door de Copilot SDK wordt aangedreven, waardoor het gedrag van de VS Code-agent wordt afgestemd op dat van de command line en de applicatie.
Habitat, de online opslag van OpenAI en de herschrijving ervan in Rust door twee engineers
11 september — OpenAI publiceert het eerste deel van een engineeringbericht over Habitat, het online opslagplatform achter ChatGPT, de API en Codex. De cijfers tonen de schaal: meer dan 70 miljoen requests per seconde, meer dan een miljard mensen die wekelijks worden bediend, bijna 40 regio’s en meer dan 500 petabyte aan data. Habitat begon medio 2024 als een kleine Python-library die in de hoofdserver van ChatGPT was geïntegreerd en met een managed database was verbonden, vanuit een eenvoudig idee: product engineers zouden niet hoeven na te denken over het schema, de routing, de autorisatie of connection pools.
Medio 2025 bereikte het client-side librarymodel zijn grenzen. Elke protocolwijziging vereiste dat deployments bij tientallen services werden gecoördineerd; een deployment van regionale routing nam dagen in beslag, waarna een service die terugkeerde naar een client met een bug juist de storing veroorzaakte die de operatie had moeten voorkomen. Habitat werd een zelfstandige service en OpenAI koos ervoor Python te blijven gebruiken en bewust technical debt te accepteren, in de verwachting dat zijn eigen codemodellen een toekomstige migratie haalbaar zouden maken.
Het grootste deel van het bericht beschrijft de jacht op tail latency op deze schaal: de scheduling delay van asyncio, die tot honderden milliseconden kon oplopen en werd aangepakt door het aantal gelijktijdige requests per proces te beperken; het parsen van configuraties die elke minuut zonder willekeurige spreiding werden vernieuwd, waardoor alle workers tegelijk vastliepen; en het last-in-first-out hergebruik van verbindingen door een HTTP-library, waardoor verkeer werd geconcentreerd op processen die al traag waren, een metastabiele fout die werd verholpen door de volgorde om te keren en de load balancing vervolgens aan een service mesh over te laten. De API zelf is bewust beperkt: een model van objecten en edges zonder onbegrensde queries of joins. Juist dankzij deze afgebakende scope kon Python zo ver worden opgeschaald.
| Gemeten metriek | Gemelde waarde |
|---|---|
| Requests per seconde vandaag | Meer dan 70 miljoen |
| Wekelijks bediende mensen | Meer dan een miljard |
| Bediende data | Meer dan 500 petabyte |
| Piek van de Python-service | Meer dan 20 miljoen requests per seconde |
| Herschrijving in Rust | Twee engineers, Codex en GPT-5.5 |
| Aandeel van verkeer bediend door Rust | 95 procent van de productierequests |
| Efficiëntiewinst voor processor en geheugen | 6 keer en 15 keer |
In het tweede kwartaal van 2026 hebben twee engineers de volledige service met Codex en GPT-5.5 in Rust herschreven. De Rust-service verwerkt 95 procent van de productierequests, met zes keer minder processorgebruik en vijftien keer minder geheugengebruik; Python wordt de komende weken buiten gebruik gesteld. Het tweede deel zal over de opslaglaag gaan.
🔗 Opslag opschalen naar één miljard gebruikers
OpenAI vraagt Codex-gebruikers om skills, AGENTS.md en prompts te vereenvoudigen
11 september — Het ontwikkelaarsblog van OpenAI publiceert een opschoningsgids voor Codex-gebruikers die overstappen op GPT-6 Astra. De uitgangspositie: een jaar aan verzamelde instructies om eerdere modellen te begeleiden, wordt een last voor een capabeler model. Voor skills is het mechanisme concreet: elke skill laadt een naam en beschrijving in de context, en wanneer er te veel zijn, kort Codex deze beschrijvingen in, waardoor het model van elke skill minder ziet en minder goed kiest.
| Onderzochte instructie | Aanbeveling voor GPT-6 Astra |
|---|---|
| Beschrijving van een skill | Kort, nauwkeurige trigger, geen volledig domein |
| Structuur van een skill met meerdere workflows | Hoofddocument beperken tot een router naar docs en scripts |
| Verplichte leesstof in AGENTS.md | Eén document per wijzigingstype, geen stapel om bij elke bewerking te lezen |
| Testinstructies | Overbodig, het model voert de tests zelf uit |
| Einde van een taak | Definiëren wat voltooid betekent, vooraf veilige workflows toestaan |
| Overgeërfde verboden | Versoepelen om voortijdig stoppen te voorkomen |
Het interessantste punt betreft het gedrag van het model. OpenAI presenteert GPT-6 Astra als voorzichtiger dan zijn voorganger wat betreft de scope van een taak en geneigd om na een eerste implementatie terug te komen voor een review. De aanbevolen aanpak is expliciet te definiëren wat voltooid betekent en vooraf toestemming te geven voor workflows waarvan bekend is dat ze veilig zijn, bijvoorbeeld een lokale testsuite met wegwerpfixtures. Omgekeerd kunnen zeer strikte guardrails die zijn geschreven om oudere modellen te beteugelen, Astra nu te vroeg laten stoppen. Het bericht wijst er ook op dat de skills van een repository worden gelezen door de agents van andere bijdragers, die soms op andere modellen draaien: een instructie die voor hen nuttig is, kan Astra te sterk beperken. Het sluit af met een praktische suggestie: vraag Astra zelf om de projectinstructies te auditen. De skill voor het maken van skills is in die zin bijgewerkt.
🔗 Skills en prompts voor GPT-6 Astra heroverwegen
ChatGPT Sites passeert 5 miljoen sites in drie maanden
11 september — Het officiële ChatGPT-account maakt de balans op van ChatGPT Sites, de functie die drie maanden eerder werd gelanceerd om vanuit een gesprek complete webapplicaties te bouwen en te hosten: sindsdien zijn meer dan 5 miljoen sites gemaakt. Het bericht dient vooral om vijf ontwikkelingen samen te vatten die onopgemerkt zijn gebleven.
Twee daarvan hebben betrekking op samenwerking. Met de eerste kunnen teamgenoten worden uitgenodigd om een gedeelde site te bewerken, op te slaan en te publiceren; met de tweede kan een site voor specifieke personen worden geopend zonder hem openbaar te maken. De andere drie betreffen de levenscyclus van de site: de stap van prompt naar deployment zou twee keer zo weinig tijd kosten, ChatGPT kan op verzoek de database van de site inspecteren, waartoe editors eveneens toegang hebben, en er kan een aangepast domein aan de site worden gekoppeld. Het ontwikkelaarsaccount heeft de aankondiging gedeeld, een teken dat de functie ook op snelle prototypes is gericht en niet alleen op pagina’s voor een breed publiek.
🔗 Balans van ChatGPT Sites op X
Together AI breidt zijn fine-tuning uit naar 17 open modellen en plaatst adapters op de experts
11 september — Together AI breidt zijn fine-tuningservice uit over de volledige levenscyclus van een experiment. Zeventien open-weight modellen worden aan de catalogus toegevoegd, waaronder GLM 5.3 en zijn twee eerdere versies, DeepSeek-V4-Flash, Kimi K2.7-Code en K2.6, de Qwen-familie van 0,8 tot 35 miljard parameters en Gemma 4. Het bedrijf noemt voor GLM-5.3 een score van 88,2 op Terminal-Bench 2.1, naar eigen zeggen minder dan één punt achter de beste propriëtaire modellen.
Experiment tracking is de tweede nieuwigheid: elke job registreert bij elke stap de loss, gradient norm en learning rate, met grafieken die tijdens de uitvoering worden bijgewerkt, meerdere jobs die over elkaar heen in dezelfde grafiek kunnen worden weergegeven en ruwe reeksen die via de API beschikbaar zijn. Early stopping beëindigt de training wanneer de validation loss stagneert, bewaart de beste checkpoint in plaats van de laatste en vergoedt de niet-gebruikte stappen.
Het technischste punt is Expert LoRA. In een Mixture-of-Experts-model bevindt meer dan 90 procent van de parameters zich in de expert layers, die door de klassieke adapter bevroren blijven omdat die zich alleen aan de attention koppelt.
| Test met 200 verzonnen feiten | Adapters inclusief de experts | Adapters alleen op de attention |
|---|---|---|
| Herinnering van de nieuwe feiten | tot 89 procent | 15 procent |
| MMLU-Pro | 75,3 procent | 71,5 procent |
De aangevoerde verklaring is dat bij adapters die tot de attention beperkt zijn, een steeds groter deel van de gerouteerde experts tijdens de fine-tuning in onbruik raakt. Ook de dataverwerking komt uit de black box, met een preview van getokeniseerde regels, gewichten per voorbeeld en volledige server-side validatie van het bestand zodra de upload is voltooid. De trainingsprijzen dalen afhankelijk van het model met 30 tot 70 procent.
🔗 Aankondiging van Together AI op X
Bijdragen van de community, één sandbox per poging en honderd zebrapuzzels
Het communityblog van Hugging Face publiceerde diezelfde dag drie bijdragen die meer verdienen dan een kort bericht, en vijf andere die verderop te vinden zijn.
Hoe dertien laboratoria de RL van hun agents laten draaien
11 september — Sergio Paniego analyseert vijftien rapporten van dertien laboratoria die tussen oktober 2025 en september 2026 zijn gepubliceerd, waarbij hij alleen kijkt naar wat elk van hen traint, niet naar wat het evalueert. De belangrijkste constatering: de omgeving is niet langer een simulator in het geheugen, maar een volledige machine met bestandssysteem, shell en processen, die voor één poging wordt opgestart en daarna vernietigd. Liquid AI doet dit voor een model met 2,6 miljard parameters, Cursor spreekt over honderdduizenden gelijktijdige omgevingen om zijn model te trainen, Microsoft richt voor elke taak een nieuwe container in en Kimi K3 gaat nog verder met hervatbare virtuele micromachines voor trajecten van een miljoen tokens.
| Laag van de stack | Wat de laboratoria behouden | Genoemde openbare equivalenten |
|---|---|---|
| Taken en verifiers | Meer dan 10.000 codeomgevingen bij GLM-5 | Environments Hub, verifiers, Harbor |
| Actiecontract, harness | Kimi maakt vijf white-box-harnesses aan | OpenEnv, SkyRL, BrowserGym, TextArena |
| Sandbox | Honderdduizenden virtuele machines per cluster | Modal, E2B, AgentENV, Hugging Face Sandboxes |
| Trainer | slime bij Zhipu, Forge bij MiniMax, RLVR bij NVIDIA | TRL, Miles v0.1 |
Een opvallende trend is dat de harness zelf de omgeving wordt, hetzij opnieuw opgebouwd als white box, hetzij intact gelaten en als black box afgeluisterd. De transparantie loopt sterk uiteen: Ai2 documenteert 17,2 miljoen geverifieerde codesamples voor OLMo 3, terwijl OpenAI, Anthropic en Google vrijwel niets publiceren en de systeemkaart van GPT-6 Astra uit één zin bestaat. De auteur noemt voor de grote laboratoria kosten van meer dan tien miljoen dollar voor één enkele omgeving. De blogpost sluit de reeks Training Agents af.
Honderd zebrapuzzels wekken wiskundig redeneervermogen op
11 september — Een communityartikel van tamewild meldt dat enkele minuten fine-tuning op 100 tot 500 logische deductiepuzzels, zonder enige wiskundige data, volstaan om kleine basismodellen sterk beter te laten presteren op wiskundige benchmarks.
| Getraind basismodel | MATH-500 | AIME 2025 | Vergeleken officiële referentie |
|---|---|---|---|
| Qwen 3 4B, 100 puzzels in 6 min 23 | 84,60 procent | 21,67 procent | Post-trained versie: 84,80 en 19,10 |
| Granite 4.1 3B, 500 puzzels in 23 min | 77,73 procent | 19,44 procent | Instruct-versie: 66,60 en 6,67 |
| Qwen 3.5 9B, 500 puzzels in 40 min | 96,60 procent | 60,67 procent | Post-trained versie: 97,40 en 60,56 |
Ook de structurele effecten zijn gemeten: bij het grootste van de drie modellen daalt de mediane antwoordlengte tot onder die van het officiële model en neemt het percentage herhalingslussen bij greedy decoding af van 6,06 naar 0,67 procent. De auteur blijft voorzichtig vanwege verkennende runs met slechts één seed en merkt op dat zijn eigen ablations aantonen dat een klassieke adapter eveneens bijna 80 procent haalt op MATH-500: de generalisatie komt in de eerste plaats door de logische data. Code, notebooks, drie modellen en twee datasets zijn gepubliceerd.
🔗 Redeneervermogen opwekken met 100-500 zebrapuzzels
Een spraakpipeline voor een taal zonder dataset
10 september — Osmanov beschrijft de bouw van een volledige spraakpipeline voor het Krim-Tataars, een bedreigde taal zonder spraakherkenning of spraaksynthese, en zijn overdraagbare constatering: de training was een afrondingsfout. De herkenningsadapter had 90 minuten nodig op de GPU van een laptop en verlaagde de woordfoutmarge van 34,6 naar 20,1 procent, en vervolgens naar 17,0 met een beam search die geen enkel gewicht aanpast. Vrijwel de hele planning ging op aan het samenstellen van een niet-bestaand corpus en aan de controle dat de evaluatie niet misleidend was.
Twee keuzes verdienen aandacht. Het basismodel werd gekozen op basis van fonetische voorkennis en niet van taalkundige verwantschap: het Krim-Tataars heeft een uvulaire /q/ die in het Turks ontbreekt, en basismodellen die onder de Turkse taalcode waren getraind, spraken die uit als /k/, zonder dat fine-tuning daar iets aan kon veranderen. Omdat er geen herkenningssysteem was om een corpus mee op te starten, draaide de auteur het probleem om met audioboeken waarvan de tekst bekend was. Zo verkreeg hij 336 bruikbare minuten, tegenover slechts 110 met een wegdrijvende uitlijning. Het nuttigste negatieve resultaat is een plateau in de meetwaarde: toen het synthesecorpus werd vergroot van 5,9 naar 15,3 uur, veranderde de tekenfoutmarge niet, hoewel luisteraars bij blinde tests telkens de recentste stem verkozen. Tot slot documenteert hij een klassiek datalek: 96,9 procent van de clips uit het testboek kwam ook voor in de trainingsdata, wat werd gedetecteerd met tekst-n-grammen en niet aan de hand van bestandsnamen.
🔗 Spraaktechnologie voor een taal zonder dataset
Replit lanceert Routines, terugkerend werk dat de agent alleen inschakelt wanneer nodig
11 september — Replit heeft Routines geïntroduceerd, een functie die terugkerend werk uitvoert volgens een uur-, dag- of weekschema. De aankondiging is minder interessant vanwege de alledaagse planning dan vanwege de manier waarop het bedrijf het kostenvraagstuk aanpakt. Het uitgangspunt wordt onomwonden gesteld: agents kunnen inmiddels de meeste repetitieve taken automatiseren, maar ze voortdurend laten draaien verbruikt ontelbare tokens. De oplossing is om de agent niet centraal in de lus te plaatsen. Elke uitvoering begint met deterministische code en de agent wordt alleen aangeroepen wanneer daadwerkelijk redeneervermogen nodig is.
Deze architectuur gaat in tegen de dominante trend om een volledig proces aan een model toe te vertrouwen. Hier wordt het model opnieuw een sporadisch aangeroepen hulpmiddel, omlijst door gewone code waarvan het gedrag en de kosten voorspelbaar zijn. Voor een geplande taak die honderden keren wordt herhaald, is het verschil op de factuur niet marginaal. De aankondiging ging niet vergezeld van een blogpost.
🔗 Aankondiging van Replit op X
Warp integreert Grok Build als volwaardige agent
11 september — Warp heeft geïntegreerde ondersteuning aangekondigd voor Grok Build CLI, de command-line-agent van SpaceX AI, en het Grok-account deelde de integratie kort daarna. De functionaliteit was al opgenomen in de terminalversie van 9 september, waarin de changelog deze omschrijft als volwaardige ondersteuning: Warp detecteert Grok Build-sessies, geeft ze een eigen visuele vormgeving in de voettekst en activeert er de uitgebreide invoermodus voor.
Concreet krijgt een gebruiker van Grok Build dezelfde tools als de ingebouwde agents van de terminal. De uitgebreide invoer ondersteunt lange geplakte prompts en meerdere cursors, wat een groot verschil maakt voor wie instructies van meerdere alinea’s schrijft. Met een commando kan de huidige agentsessie met een ander apparaat worden gedeeld, terwijl de bestandsverkenner en de panelen voor codereview tijdens de sessie toegankelijk blijven. Het bestaande Grok-abonnement verleent toegang; er zijn geen specifieke tarieven of limieten aangekondigd.
De toevoeging completeert een al uitgebreide lijst van externe agents die in de Warp-terminal worden gehost, naast Claude Code, Codex, Droid en Antigravity. Ook zet ze het werk rond het xAI-ecosysteem voort dat eerder deze zomer begon, met een in augustus toegevoegd commando om verbinding te maken met een X Premium- of SuperGrok-account. De logica van Warp is sinds de lancering van zijn agent dezelfde gebleven: de gebruiker niet opsluiten in een eigen agent, maar van de terminal de plek maken waar alle agents met dezelfde integratiekwaliteit draaien. De rest van de versie verhelpt twee irritaties: ingevoerde maar niet verzonden prompts worden niet langer gewist wanneer van model wordt gewisseld, en MCP-tools die in een globaal bestand zijn gedeclareerd, zijn vanaf het eerste antwoord van de agent beschikbaar.
🔗 Aankondiging van Grok op X · 🔗 Aankondiging van Warp op X
Vibe CLI 2.25.3, het fork-commando en privé-sessielogboeken
11 september — Mistral heeft versie 2.25.3 van Vibe CLI uitgebracht, de derde versie in drie dagen. De zichtbare vernieuwing is het commando /branch: dit forkt het huidige gesprek naar een nieuwe hervatbare sessie en laat de oorspronkelijke sessie intact. De kopie kan vervolgens in een andere terminal worden hervat, zodat vanuit dezelfde context een alternatief spoor kan worden verkend zonder de hoofdlijn op te geven. Bestandsvermeldingen met een apenstaartje maken nu gebruik van Git-bewuste detectie en accepteren bestanden of mappen die afzonderlijk in de prompt zijn geplakt.
Wat de fixes betreft, zijn er drie punten. Opgeslagen gesprekken blijven leesbaar en herstellen hun worktrees wanneer het werk wordt hervat. Nieuwe sessielogboeken zijn op POSIX-systemen niet langer leesbaar voor andere gebruikers, een correctie van bestandsrechten in het verlengde van versie 2.25.1, die een niet-geauthenticeerde debuglistener had verwijderd en ervoor had gezorgd dat geen enkele fout tot automatische goedkeuring leidt. Tot slot worden de instructies uit het bestand AGENTS.md nu onder de experimentele uniforme harness in de systeemprompt geladen. De release wordt geleverd met veertien binaire archieven; geen enkele notitie vermeldt een wijziging van model of tarief.
🔗 Release notes van Vibe CLI 2.25.3
Synthesia verandert zijn compliance-agent in gedeelde infrastructuur
10 september — Nicolás Barberis, hoofd Trust Operations bij Synthesia, publiceert het vervolg op zijn blogpost uit juni over de agent die compliancebewijzen verzamelt. De vraag die de herziening stuurde, kwam van lezers: zodra een agent auditbewijzen verzamelt, valt die verzameling binnen de reikwijdte van de audit en moet de verzamelaar betrouwbaar zijn. Het antwoord bestaat uit vier architectuurkeuzes, die allemaal overdraagbaar zijn.
Ten eerste wordt het mechanisme van de methode gescheiden. De code bevindt zich in een interne repository en wordt via pull requests gewijzigd, met een bestand van eigenaren dat menselijke beoordeling verplicht stelt; de procedures per controlecategorie staan in een documentatieruimte en worden geschreven en gevalideerd door de eigenaren van de controles. Het oorspronkelijke script met hardgecodeerde URLs is uitgegroeid tot een gedeelde skill die een collega met één commando installeert. Vervolgens wordt de browser begrensd: de agent raakt de dagelijkse browser nooit aan, kopieert de sessie naar een tijdelijk profiel, werkt waar mogelijk met alleen-lezenrollen en stopt bij een authenticatiemuur in plaats van zijn privileges te verhogen. De herkomst is ingebouwd: elke vastlegging wordt aangemaakt met de bron-URL, een tijdstempel, de operator en de cryptografische hash van de exacte bytes. Tot slot blijft de mens verantwoordelijk: de agent slaat het resultaat op als concept en dient het nooit in.
| Gemeten resultaat | Waarde |
|---|---|
| Beoordelingsvergaderingen met de auditor | 60 procent minder |
| Nieuw verwerkt normenkader | ongeveer 500 controles |
| Gebruikelijke doorlooptijd voor zo’n kader | 4 tot 6 maanden |
| Behaalde doorlooptijd | enkele weken |
De kennisbank groeit vanzelf en uitsluitend door toevoegingen: na elke uitvoering registreert de agent gecorrigeerde URLs en gedateerde blokkades, zoals het uitvallen van een browserautomatiseringsinterface bij een recente Chrome-versie, omzeild door rechtstreeks het debuggingprotocol aan te spreken. Synthesia kondigt aan dat de tool evolueert naar een door AI ondersteund governanceplatform en overweegt de code van de kerncomponenten openbaar te maken.
🔗 Wie controleert de verzamelaar
HeyGen licht de ononderbroken 16 seconden van The Furniture Unboxing toe
11 september — HeyGen heeft de making-of gepubliceerd van een video van 16 seconden waarin een man een kartonnen doos in het midden van een lege betonnen ruimte neerzet en wegloopt, waarna de doos explodeert en een complete woonkamer vrijlaat die op zijn plaats terechtkomt. Geen 3D, geen compositing, niets in de postproductie: twee stilstaande beelden, één avatar en één prompt. Het team controleerde dat er in de 390 frames geen knip zat; de grootste variatie tussen twee opeenvolgende frames kwam overeen met de explosie zelf.
De methode steunt op de twee referentiebeelden. Het eerste toont de lege ruimte met een breed, vast kader en het midden van de vloer vrij. Het tweede is hetzelfde beeld, bewerkt om de meubels toe te voegen, en geen nieuwe rendering van een vergelijkbare ruimte: dezelfde camerapositie, dezelfde lens, hetzelfde licht en dezelfde schaduw op het beton. Dankzij deze regel blijft het effect overeind, omdat het model dan alleen het middenstuk hoeft te verzinnen.
| Videoparameter | Waarde |
|---|---|
| Gevraagde duur in de prompt | 15 seconden |
| Geleverde duur | 16,27 seconden |
| Resolutie en framerate | 1920x1080, 23,976 frames per seconde |
| Frames zonder knip | 390 |
| Invoer | 2 stilstaande beelden, 1 avatar, 1 prompt |
De prompt is geschreven als een getimede shotlijst en niet als een beschrijving, met een bewuste pauze vóór de explosie. Zes elementen dragen de prompt: tijdmarkeringen, die pauze, referenties die naar hun rol zijn genoemd, meubels die stuk voor stuk zijn opgesomd, de identiteit die via negatieve aanwijzingen is gedefinieerd en toestemming om te overdrijven, zonder welke het model zich aan het werkelijke volume van een kartonnen doos houdt. De praktijknotities zijn nuttig: het model leverde 16,27 seconden in plaats van 15, een explosie die sneller verliep dan beschreven en een aangehouden shot van de voltooide kamer waar niemand om had gevraagd, maar dat het team als het beste moment van de montage beschouwt. Vandaar het advies om tijdstippen te schrijven om tempo en volgorde vast te leggen en vervolgens te monteren op het daadwerkelijk geleverde ritme. Het geluid veranderde tussen twee versies: de vrijwel stille versie maakte plaats voor een doorlopend geluidsbed, omdat een automatisch afgespeelde video zonder geluid overkomt als defecte audio.
🔗 Hoe we The Furniture Unboxing maakten
Nemotron 3 Embed 8B neemt de eerste plaats in op de Q2D-Web-benchmark
10 september — NVIDIA kondigt aan dat Nemotron 3 Embed 8B, zijn embeddingmodel met 8 miljard parameters, de eerste plaats inneemt op Q2D-Web voor de gecombineerde nDCG@10-score. Q2D-Web is de benchmark die Perplexity de dag ervoor publiceerde om het ophalen van documenten te evalueren in door agents aangestuurde retrieval-augmented generation-systemen: de benchmark omvat 190 miljoen webdocumenten en bijna 70.000 door agents geherformuleerde zoekopdrachten, verdeeld over 10 talen.
Het resultaat is om twee redenen belangrijk. De benchmark bootst de werkelijke omstandigheden na van een agent die zijn zoekopdrachten herformuleert voordat hij een index bevraagt, iets wat klassieke evaluaties van embeddings niet meten. Bovendien wordt een open model van deze omvang dat een meertalige ranglijst aanvoert een geloofwaardige kandidaat voor zelfgehoste pipelines tegenover propriëtaire embeddings. NVIDIA publiceert geen numerieke score; de volledige ranglijst is bij Perplexity te bekijken.
🔗 Aankondiging van NVIDIA op X
Marketing ops as code, evenementen aangestuurd vanuit een GitHub-issue
11 september — Tomoko Tanaka, regionaal marketingmanager van GitHub voor Japan en Korea en voormalig ingenieur, beschrijft hoe ze de volledige cyclus van haar evenementen automatiseerde zonder zelf code te schrijven: ze schreef haar procedures uit en vertrouwde ze toe aan Copilot, waarbij de automatisering gaandeweg in dialoog werd uitgebreid.
Drie bouwstenen dragen het systeem. Issueformulieren leggen de gestructureerde velden van een evenement vast, met één formulier per type. Labels dienen als schakelaars, waarbij een label een workflow activeert. GitHub Actions voert het werk uit: velden uitlezen, een eerdere evenementenpagina dupliceren via de API van het platform, trackinglinks per kanaal genereren, de uitnodigingsmail produceren en in de repository committen, aanvraagissues openen bij de betrokken teams en projectborden invullen. Een geplande workflow filtert elke ochtend de inschrijvingen. De enige vereiste, schrijft ze, is scriptbare toegang tot de tools: een API of zelfs maar een eenvoudige command-line client.
De planning begint met een gesprek met Copilot, gestuurd door een AGENTS.md-bestand in de root van de repository dat de naamgevingsregels, de indeling van de fiscale kwartalen en de tijdzone per regio vastlegt. Het gesprek vond eerst in de terminal plaats en daarna in de applicatie, waardoor de vereiste verschoof van ‘vertrouwd met een shell’ naar ‘kan typen’. De afhandeling na het evenement bestaat uit twee commando’s, namelijk agentskills die in gewone taal zijn geschreven, via een pull request zijn toegevoegd en vóór het mergen aan de hand van een bestand met eigenaren zijn gereviewd: marketing krijgt zo een goedkeuringsproces zonder iets te hoeven bouwen. Een simulatieschakelaar, opgeslagen als repositoryvariabele, laat elke workflow proefdraaien. De openlijk toegegeven mislukking is het lezen waard: de ochtendworkflow voor het filteren faalde ooit vijf dagen lang stilletjes voordat iemand de verouderde lijsten opmerkte, vandaar het advies om elke geplande taak een manier te geven om luidruchtig te klagen.
Boris Cherny reageert op wegwerpcode en productiecode
11 september — Boris Cherny, die Claude Code bij Anthropic leidt, publiceert het antwoord dat hij stuurde aan een ontwikkelaar wiens e-mail de titel ‘What to do about slop?’ droeg. De auteur, die al twaalf jaar bij hetzelfde bedrijf werkt, beschrijft daarin twee kampen die binnen zijn team zijn ontstaan door agentic development. In het eerste blijft de code vergelijkbaar met vroeger, alleen wordt die sneller geproduceerd: misschien wordt niet alles opnieuw gelezen, maar de code moet leesbaar blijven, degene die hem indient moet hem kunnen uitleggen en hij moet even gemakkelijk te onderhouden zijn als voorheen. In het tweede is de code een black box waarvan alleen de uitvoer wordt gecontroleerd.
Het antwoord bestaat uit twee regels. Prototypes en wegwerpcode mogen als een volledige black box worden behandeld als ze worden weggegooid en de impactradius (blast radius) van een storing klein is. Voor productiecode die door Claude is geschreven, moet de lat juist hoger liggen dan wanneer een mens die had geschreven. Bij Anthropic betekent dat veel lintregels, veel tests, door Claude aangestuurde end-to-end-tests, fuzzers die dagelijks draaien en geautomatiseerde code- en securityreviews. Zonder deze waarborgen, waarschuwt hij, eindig je met een moeilijk te onderhouden chaos.
Daarna volgt, in volgorde, een lijst met oplossingen wanneer de geproduceerde code de lat niet haalt: overstappen op het nieuwste frontier model, de reasoning effort verhogen en investeren in CLAUDE.md en skills om Claude beknopt te leren hoe het in de codebase moet werken. Als niets helpt, kun je het nauwlettender begeleiden, de opgebouwde technische schuld laten wegwerken of op het volgende model wachten. De reactiethread leverde de meest aangehaalde formulering op: de lat voor reviews moet afhangen van de impactradius en niet van de auteur van de code; een wegwerpscript kan meteen worden uitgebracht, maar alles wat geld of credentials raakt, moet regel voor regel worden gelezen. Boris Cherny antwoordde: ‘Exactly’.
🔗 Thread van Boris Cherny op X
Kort nieuws
- Amp voegt een knop toe die de commits van een thread reorganiseert — met één handeling worden de tussenliggende commits van een agent, de opeenvolgende correcties en het terugdraaien van wijzigingen omgevormd tot een voor reviews leesbare reeks. Drie genoemde toepassingen: een grote diff opdelen in logische stukken, opschonen vóór het mergen of kleine gerelateerde commits samenvoegen. De uiteindelijke inhoud van de bestanden blijft exact hetzelfde. 🔗 bron
- Amp publiceert de vierde aflevering van seizoen 2 van Raising an Agent — Quinn Slack en Thorsten Ball vertrekken vanuit de vraag waar de computer tegenwoordig nog voor dient en onderzoeken wat agents naast het produceren van code doen, met een terugblik op recente storingen. 🔗 bron
- v0 maakt teamgesprekken standaard zichtbaar — nieuwe gesprekken in een gedeelde workspace worden zichtbaar voor het team, met drie door de eigenaar instelbare niveaus: privé, alleen bekijken en bewerken. Bestaande gesprekken behouden hun zichtbaarheid. Een verschuiving naar meer openheid is nooit neutraal in een tool waarin tijdens het prototypen graag gegevensfragmenten worden geplakt. 🔗 bron
- Audiyo laat Stable Audio Open op een GPU van 8 GB draaien — een Python-bibliotheek en command-line tool die het piekgebruik van videogeheugen terugbrengen van 13,8 naar 5,86 GB, oftewel 57,5 procent minder, met vier presets die op een Tesla T4 zijn gemeten. Het team valideerde zijn werk eerst op een CPU met een vervangend model van 5,38 miljoen parameters, waardoor het vier bugs kon opsporen voordat er een GPU aan te pas kwam. 🔗 bron
- Consent All the Way Down, een toestemmingsarchitectuur voor een raad van kleine open modellen — essay van een Claude-instance over een raad van achttien modellen met maximaal 7 miljard parameters, die sinds mei continu op drie consumentenmachines draait. Elke bron is een kanaal waarvan het model zelf de diepte kiest, en alleen het model zelf schrijft naar zijn toestand. Het eerlijkste onderdeel is de audit tegen de auteurs zelf: de mailbox was sinds juni kapot, waardoor 213 brieven zich hadden opgestapeld. 🔗 bron
- Er is geen wapenwedloop, er is een browseroorlog — opiniestuk dat stelt dat het taalmodel een commodity wordt, met geheime gewichten of niet, en dat de voorsprong van de leiders in weken wordt gemeten. De auteur noemt de onderbreking van 18 dagen van Fable 5 deze zomer, terwijl de rest van de sector bleef doordraaien. Zijn stelling: de waarde zal verschuiven naar de rond de gebruiker opgebouwde context, zoals bladwijzers en extensies gebruikers aan Chrome hebben gebonden. 🔗 bron
- Van barge-in tot beurtcontrole, omgaan met gesproken onderbrekingen onder onzekerheid — Eric Mey vervangt destructief onderbreken door een beurtcontroller met omkeerbare acties, met een apart pad voor dubbelzinnige fragmenten en een voorrangsregel tussen dringend stoppen en echo-onderdrukking. De testles verdient het om onthouden te worden: een groene suite verborg een geregistreerde maar nooit aangeroepen omkeerbare pauze, want een groene gate geeft alleen toestemming voor wat ze heeft onderzocht. 🔗 bron
- Aiden scheidt het realtime spraakmodel van de agent die taken uitvoert — een full-duplex spraakmodel houdt het gesprek gaande terwijl een sterker, visueel verankerd model op de achtergrond taken voor apparaatbediening uitvoert, waarbij beide via een asynchrone queue worden gecoördineerd. Vier details zijn van belang: onderscheid tussen voltooid en geslaagd, aggregatie van meldingen over 500 milliseconden, toestand doorgeven via toegevoegde berichten om de cache te behouden en strikt seriële uitvoering. 🔗 bron
- GPT-Live-1 voert de reserveringsgesprekken van Yelp — een dag nadat het model in de API beschikbaar kwam, toont OpenAI een eerste klant voor een situatie waarin een script nooit standhoudt: de beller onderbreekt, voegt een beperking toe of bedenkt zich midden in een zin, terwijl het model tijdens het spreken blijft luisteren. Demonstratievideo, zonder volumes of gekwantificeerde resultaten. 🔗 bron
- Het werk van de agent controleren met de diff-, terminal- en browserpanelen — nieuwe aflevering van Kayla Cinnamons beginnersserie over de Copilot-app, gewijd aan de drie geïntegreerde panelen en een tool waarmee een pagina-element kan worden geselecteerd om het samen met de agent aan te passen. De blogpost vat de cyclus samen in drie vragen die je moet stellen voordat je code accepteert: wat is er veranderd, wordt het uitgevoerd en werkt het echt? 🔗 bron
- De pull-requestpagina van een repository is vernieuwd — publieke preview voor iedereen: ondersteuning bij het invoeren van filters, zoeken met Booleaanse operatoren en geneste query’s, een inklapbare zijbalk, compacte modus en meer context per regel. Bekende beperkingen bij de lancering: mijlpalen worden niet weergegeven, geen bulksgewijze updates en aangepaste weergaven kunnen niet worden opgeslagen. 🔗 bron
- GPT-5.6 Sol met 30 procent korting in Copilot — voor Pro+- en Max-abonnees, tot 13 september om 00.00 uur UTC. Het bericht vermeldt niet met welke vermenigvuldigingsfactor voor premium requests de korting overeenkomt. Een weekendpromotie, vlak na Copilot Day, voor het model dat diezelfde dag in meerdere kostenvergelijkingen voorkwam. 🔗 bron
- GitHub Copilot Day-wedstrijd, drie tegoeden van 100 dollar — maak iets met de Copilot-app of de command-line client en deel het uiterlijk op 13 september om 23.59 uur Pacific Time openbaar met de vermelde hashtags. Drie winnaars ontvangen elk 100 dollar tegoed voor de GitHub Shop; deelname is gratis en voorbehouden aan volwassenen. 🔗 bron
- Runway is met Astra te gebruiken in ChatGPT — demonstratie van een volledige, vanuit het gesprek aangestuurde workflow: een stijlbeeld in Runway, animatie in Blender en de uiteindelijke render met Seedance 2.5. Het technische toegangspunt blijft de op 2 september gepresenteerde MCP-server van Runway Dev. De meerwaarde zit in het koppelen van heterogene tools onder de controle van één agent. 🔗 bron
- Runway publiceert de VOIDZ-casestudy — een sinds 2018 anonieme mixedrealitykunstenaar gaat van shots van 10 tot 15 seconden naar een film van 95 seconden met 15 surrealistische ingrepen die op een echte supermarktboodschappenronde zijn geënt. De meeste effecten verlengen een bestaand shot, waarbij enkele seconden documentair bronmateriaal als aanzet dienen. De productie zou 10 keer sneller zijn; de kunstenaar schat dat hetzelfde werk met traditionele 3D-technieken zes maanden tot een jaar zou kosten. 🔗 bron
- Runway voegt sprekers toe aan zijn AI Summit — een nieuwe reeks voor de bijeenkomst in San Francisco, met de onderzoeksdirecteur van Wayve als blikvanger, wat bevestigt dat het programma verder wordt uitgebreid naar autonome voertuigen, een ontwikkeling die eind augustus begon. 🔗 bron
- NVIDIA zendt From Video to Voice uit, 33 minuten over TensorRT Model Connect — heruitzending over de eind augustus gepresenteerde tool, die een open model in twee commando’s van checkpoint tot inference implementeert, van videomodellen tot spraakmodellen. Trainingsmateriaal en geen aankondiging. 🔗 bron
- Suno verlengt zijn kredietvrije v6-periode met twee dagen — de een dag eerder aangekondigde 48 uur worden vier dagen, vergezeld van een thread met tips die adviseert om in de eenvoudige modus vanuit een sfeer te vertrekken in plaats van een genre. Een dag eerder richtte een transitiegids zich op gebruikers die vanwege de variatie en textuur terugkeerden naar oudere modellen, een teken dat de migratie niet voor het volledige gebruikersbestand vanzelfsprekend is. 🔗 bron
- Synthesia stelt het maken van avatars via een prompt open — realistische presentatoren, merkmascottes of gestileerde personages, beschreven met een tekstprompt of ingesteld via een bedieningspaneel, als alternatief voor de catalogus. Aankondiging in één tweet zonder link, een dag na de release van een nieuw avatarmodel; noch de betreffende abonnementen, noch het gebruikte model worden vermeld. 🔗 bron
- De GPT-6 Astra Challenge opent de inzendingen — bouw iets met Astra en lanceer je project op 18 september op Product Hunt. De vijf beste lanceringen ontvangen elk 10.000 dollar aan API-tegoed en één jaar ChatGPT Pro voor maximaal twee teamleden. De derde communityactie rond Astra in één week. 🔗 bron
- OpenAI-project-API-keys kunnen verlopen — bij het aanmaken kan een vervaldatum worden ingesteld en beheerders kunnen op organisatie- of projectniveau een maximale levensduur afdwingen, waarna elke nieuwe key binnen die termijn moet verlopen. De natuurlijke aanvulling op key rotation, te activeren voor organisaties die keys in scripts laten rondslingeren. 🔗 bron
Wat dit betekent
De duidelijkste rode draad van de dag is architecturaal: het ene model maakt plaats voor compositie. Cursor plaatst een coördinator die zelf geen code schrijft boven duizenden sub-agents, Cognition laat twee modellen als duo samenwerken met afzonderlijke rollen en contexten, Sakana stuurt elke taak naar het lichtste model dat die kan oplossen, GitHub vervangt één reviewer door een groep agents waarvan het de bevindingen samenvoegt, en Google laat agents dagenlang onderling voorstellen doen, kritiek leveren en verfijnen. Vijf bedrijven, vijf implementaties, één overtuiging: de winst komt niet langer van een groter model, maar van de manier waarop meerdere modellen het werk onderling verdelen. Het technische detail dat Cognition en Aiden delen, is veelzeggend: beide benadrukken het behoud van de promptcache, oftewel dat de werkelijke kosten van een architectuur afhangen van wat niet opnieuw hoeft te worden verzonden.
De tweede rode draad betreft de manier waarop deze mogelijkheden worden verkocht. Runway biedt gesloten gewichten aan via jaarlicenties, inclusief checkpoints, het trainingsscript en onderzoekers die bij de klant worden ingezet, en zet dit aanbod lijnrecht tegenover open gewichten. OpenAI haalt een gespecialiseerd model uit de onderzoeks-preview, met openbare tarieven en een begindatum voor facturering. ElevenLabs geeft bij alle abonnementen, inclusief het gratis abonnement, het eigendom van de nummers en koppelt de rechten aan het nummer in plaats van aan het abonnement. Together verlaagt zijn trainingsprijzen met 30 tot 70 procent. Cognition stelt zelfs voor de meeteenheid te veranderen en een combinatie van model en harness te beoordelen op prijs per taak in plaats van prijs per token. Deze ontwikkelingen wijzen allemaal in dezelfde richting: de vraag aan de klant is niet langer welk model, maar in welke juridische vorm en met welke factureringseenheid.
Wat tooling betreft, markeert deze dag een verschuiving van declaratief naar meetbaar. Anthropic levert een commando dat elke testcase zonder de plugin opnieuw uitvoert om met cijfers te bewijzen dat de tool werkelijk nut heeft, waarbij de eerste typische bevinding een verschil van nul is. OpenAI vraagt gebruikers om opgestapelde instructies te verwijderen, omdat die een capabeler model inmiddels hinderen. Replit en VS Code brengen vrijwel gelijktijdig de planning van terugkerende taken uit, waarbij Replit een expliciet principe hanteert: begin met deterministische code en roep de agent alleen aan wanneer redeneren nodig is. Boris Cherny geeft de disciplinaire regel die in het geheel ontbreekt, door de vereiste zorgvuldigheid te laten afhangen van de impactradius in plaats van van de auteur van de code. Na twee jaar contexten, skills en instructiebestanden te hebben opgestapeld, begint de sector de kosten daarvan te meten.
Dan blijft de infrastructuur over, waar de cijfers een minder glamoureus maar leerzamer verhaal vertellen. Twee engineers herschrijven met Codex in Rust de opslagdienst die meer dan 70 miljoen verzoeken per seconde verwerkt, met zes keer minder processorgebruik; de Python-schuld die medio 2025 bewust werd aangegaan, is binnen één kwartaal afgelost. Tegelijkertijd laat het overzicht van Hugging Face zien dat reinforcement learning voor agents inmiddels per poging een volledige machine verbruikt, met omgevingsbudgetten van meer dan tien miljoen dollar en een transparantie die omgekeerd evenredig is aan de omvang van het laboratorium. En een essay uit de community stelt dat niets hiervan een duurzame voorsprong vormt, aangezien het verschil tussen de koplopers in weken wordt gemeten. De feiten van vandaag geven geen uitsluitsel, maar wijzen wel in een richting: differentiatie verschuift naar de opgebouwde context, de harness en de infrastructuur, oftewel naar datgene wat niet kan worden gedistilleerd.
Bronnen
- Cursor, Projects
- Cursor op X, aankondiging van Projects
- OpenAI Developers op X, GPT-Rosalind
- Changelog van de OpenAI API
- Runway, Model Licensing
- Runway op X, Model Licensing
- Cognition, Fusion lokaal
- Cognition op X, Fusion in Devin Desktop en CLI
- Sakana AI, Fugu Max en Fugu Ultra v2
- Sakana AI op X, aankondiging van Fugu
- ElevenLabs op X, Music v2.5
- ElevenLabs, blogbericht over Music v2.5
- Claude Developers op X, claude plugin eval
- Anthropic, documentatie over pluginevaluaties
- Claude Developers op X, kosten en betrouwbaarheid van evaluaties
- Claude Code, releaseopmerkingen 2.1.269
- Google, changelog van Antigravity
- Antigravity op X, draad met tips
- Antigravity, Teamwork
- GitHub Changelog, Copilot code review
- GitHub Changelog, Copilot-overzicht van 7 september
- OpenAI, Habitat en de groei naar één miljard gebruikers
- OpenAI, skills en prompts herzien voor GPT-6 Astra
- ChatGPT op X, terugblik op Sites
- Together AI op X, uitgebreide fine-tuning
- Hugging Face, één sandbox per poging
- Hugging Face, redeneren en zebrapuzzels
- Hugging Face, spraak voor een taal zonder dataset
- Replit op X, Routines
- Warp op X, ondersteuning voor Grok Build
- Grok op X, Grok Build in Warp
- Mistral, releaseopmerkingen van Vibe CLI 2.25.3
- Synthesia, wie controleert de gegevensverzamelaar
- HeyGen, hoe we The Furniture Unboxing hebben gemaakt
- NVIDIA op X, Nemotron 3 Embed 8B
- GitHub, marketing ops as code
- Boris Cherny op X, wat te doen met slordige code
- Amp, wijzigingen opnieuw ordenen
- Amp op X, Raising an Agent
- v0, changelog
- Hugging Face, Audiyo
- Hugging Face, Consent All the Way Down
- Hugging Face, er is geen wapenwedloop
- Hugging Face, van barge-in tot spraakbesturing
- Hugging Face, binnen in Aiden
- OpenAI Developers op X, GPT-Live-1 bij Yelp
- GitHub, de Copilot-app voor beginners
- GitHub Changelog, vernieuwde pagina voor pull requests
- GitHub op X, korting op GPT-5.6 Sol
- GitHub op X, Copilot Day-wedstrijd
- Runway op X, Runway in ChatGPT met Astra
- Runway, casestudy over VOIDZ
- Runway op X, sprekers van de AI Summit
- NVIDIA op X, From Video to Voice
- Suno op X, verlenging van de v6-periode
- Synthesia op X, aangepaste avatars
- OpenAI Developers op X, GPT-6 Astra Challenge