ai-powered-markdown-translator使用 gpt-5.6-sol 将文章从法语翻译成中文。
共计五十二项公告,其中大多数发布于 9 月 11 日,而彼此并无沟通的多家公司却不约而同地围绕着同一个思路展开。Cursor 将整个项目交给一个自身不编写代码、而是向数千个子代理委派任务的协调代理;Cognition 让两个模型在开发者的机器上结对运行;Sakana 则将每项任务路由给能够解决它的最轻量模型。同一天,OpenAI 结束其生命科学模型的研究预览并公布价格表,Runway 向企业授权其闭源模型权重,而 Anthropic 则发布了一条子命令,终于能够衡量一个插件真正带来了什么。
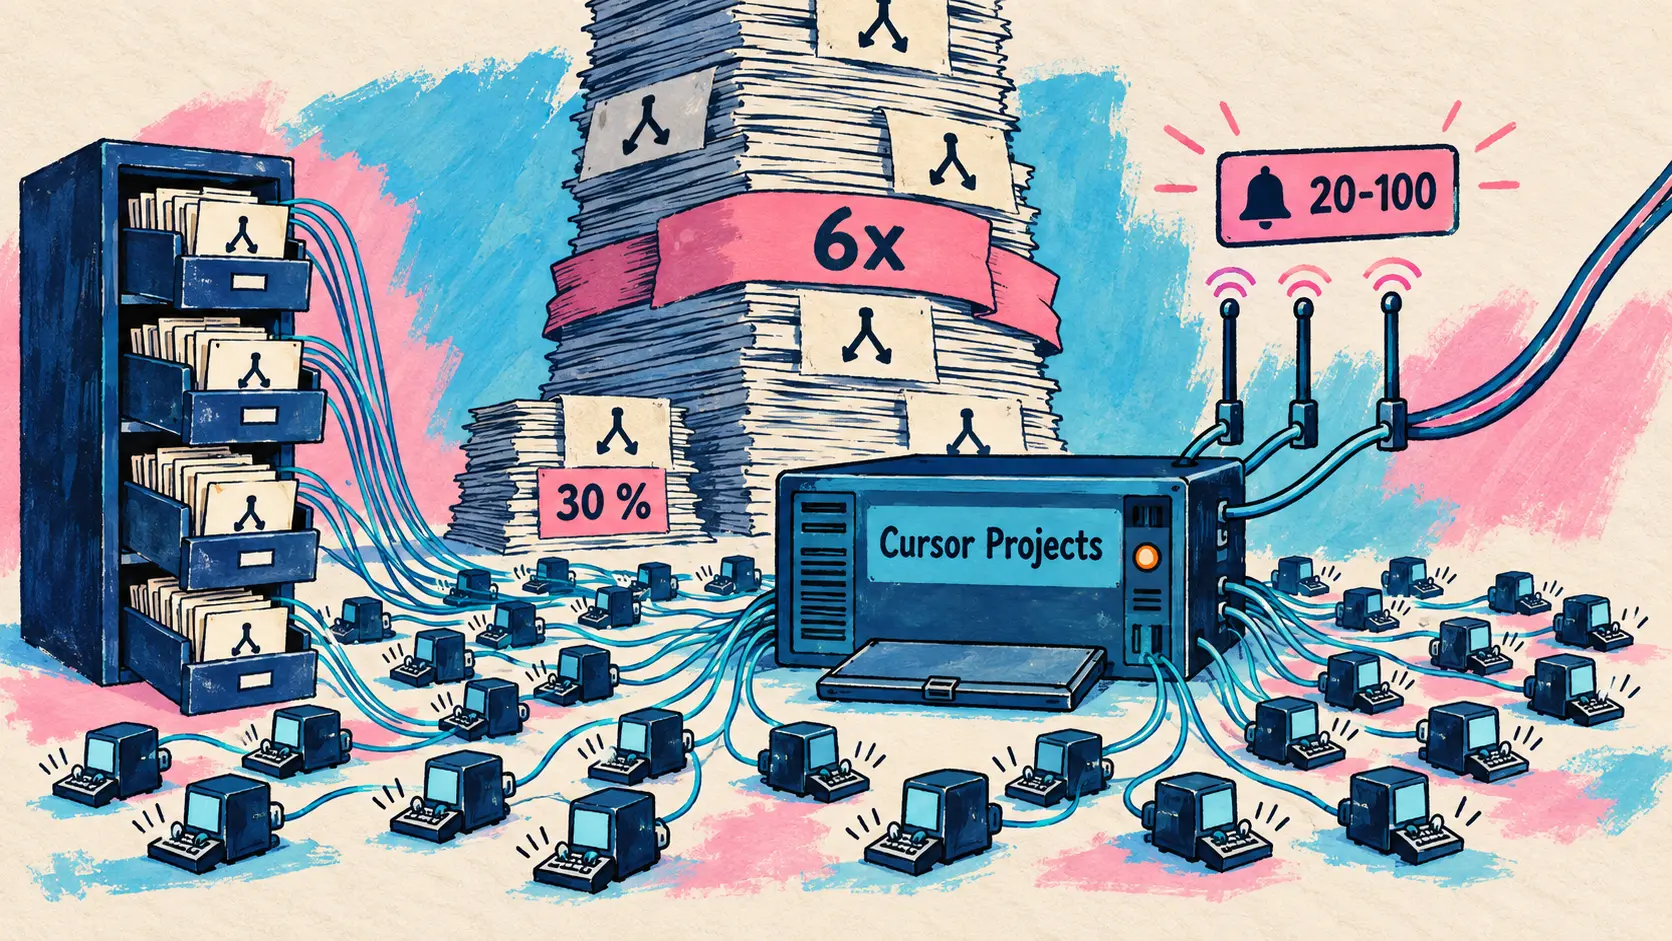
Cursor 推出 Projects:由协调代理主导的项目
9 月 10 日 — Cursor 推出了 Projects,重新设计了用户在编辑器中向代理委派工作的方式。这款产品打破了过去两年形成的习惯:用户不再为每项任务开启一次新对话并在完成后将其关闭,而是在一个可持续数月的对话线程中与协调代理交流。这个协调代理一行代码也不写。它指挥其他代理编写代码,因此即使工作正在推进,它也始终可以接收新的指令。
这一机制由三个部分支撑。首先是默认在云端执行:每个 Project 都在自己的机器上运行,关闭笔记本电脑不会中断它,并行子代理的数量也不再受本地硬件限制。只有当测试必须在开发者的机器上运行时,才会启动本地代理。其次是共享上下文:每个 Project 都维护着一组在所有机器间同步的文件,代理会在其中保存研究结果、产物以及它们对代码的理解。如果其中一个代理找到了测试某项服务的方法,之后的所有代理都能使用这套流程。第三个机制最为特别。Cursor 将其称为订阅(subscriptions):协调代理可以监控 Slack 频道、按照日程运行,或者跟踪所有 pull request 以修复持续集成问题。代理会在检测到信号后采取行动,无需等待有人向其发出请求。
| 衡量群体 | 对 pull request 的衡量结果 |
|---|---|
| Projects 新用户 | 合并数量增加 30% |
| 主要使用 Projects 工作的用户 | 合并数量达到六倍 |
| 内部 design system Project | 据预测每天涉及 20 至 100 个 pull request |
The coordinator doesn’t write code itself but directs other agents that do. Because it delegates rather than executes, it is never blocked and is always responsive to direction.
🇨🇳 协调代理本身不编写代码,而是指挥其他代理完成代码工作。因为它负责委派而非执行,所以永远不会受阻,并始终能够接收指令。 — Cursor 的 Projects 博客
这些都是内部测量数据,解读时理应保持谨慎。最能说明问题的例子仍是“园艺”,这是 Cursor 对永无止境的工作的称呼:一名工程师运行一个专注于 design system 的 Project,由它检查每个新的 pull request,从中提取适合纳入该系统的组件,并在第二次发现同一错误时添加一条 lint 规则。Projects 目前处于测试阶段,自 9 月 10 日起逐步推出。公告并未提及任何定价条件或套餐限制。
GPT-Rosalind 结束研究预览,并公布价格表
9 月 11 日 — OpenAI Developers 宣布,其专用于生命科学推理的模型 GPT-Rosalind 已结束研究预览(research preview)。该模型于 2026 年 4 月 16 日发布,面向生物学研究、药物发现和转化医学,当时仅向美国符合条件的 Enterprise 客户开放。如今,它通过 API、Codex 和 ChatGPT Enterprise,以可信访问(trusted access)方式向全球符合条件的组织开放;随着该系列后续模型陆续发布,这一访问权限也将覆盖它们。
API 更新日志中一则日期为 9 月 8 日的条目提供了 X 帖子中未提及的详细信息。该模型名为 gpt-rosalind-research,其正式可用性仍取决于可信访问计划;该计划仅面向经 OpenAI 批准的生命科学内部研究。
| 定价或访问项目 | 公布的内容 |
|---|---|
| 模型标识符 | gpt-rosalind-research |
| 输入 token | 每百万个 5 美元 |
| 缓存输入 token | 每百万个 0.50 美元 |
| 输出 token | 每百万个 25 美元 |
| 开始计费 | 2026 年 10 月 5 日 |
| 访问渠道 | API、Codex、ChatGPT Enterprise |
| 访问条件 | 可信访问计划,符合条件的组织 |
计费要到 10 月 5 日才开始:在研究预览期间,使用该模型既不消耗额度,也不消耗 token。在工具方面,Codex 的 Life Sciences 插件构成了该模型的编排层,覆盖从基因组学、蛋白质结构到转化研究的各个领域,并贯穿从收集生物学证据到生成质量控制报告和交互式 notebook 的全过程。这个软件包于 4 月在 GitHub 上免费发布,可访问 50 多个公共多组学数据库、文献来源和生物学工具;所有人都可以将其与通用模型配合使用,但只有符合条件的 Enterprise 用户才能将其与 GPT-Rosalind 结合使用。
其宣称的性能仍与发布时相同:在 BixBench 上取得已公布的最高分;在 LABBench2 的 11 项任务中,有 6 项优于 GPT-5.4,其中在 CloningQA 上的差距最大;在一项与 Dyno Therapeutics 共同设计的 RNA 序列—功能任务中,其最佳提交结果在预测表现上超过了 57 名人类专家的第 95 百分位。具体信息有两点:一个专业模型结束实验状态并公布价格,以及访问范围扩展至更多地区。限制依然是资格要求,用户无法自行开通。
Runway Model Licensing:向企业交付闭源模型权重
9 月 11 日 — Runway 推出了一项面向企业的模型许可计划(Model Licensing)。其原则与通过 API 访问不同:客户会收到 Runway 最新一代模型的完整权重,可使用自己的数据进行微调,将其托管在自己的基础设施中,并将由此开发的成果商业化。数据和生成内容绝不会离开客户的环境,该计划明确面向工作室、品牌和政府机构。
| 交付项目 | 内容 |
|---|---|
| 模型权重 | 作为起点的完整权重 |
| Checkpoint | 多个可供验证的模型版本 |
| 训练脚本 | 用于添加自有数据并启动微调的代码 |
| 交付方式 | 打包到客户的代码库中,并托管在客户希望的位置 |
| 派驻研究人员 | 在调优、权重和交付方面提供实际协助 |
客户可以选择将其托管在自己的云端、数据中心或完全本地的环境中;政府机构还可以在与网络隔离(air-gapped)的环境中使用。公告点名了六个行业:软件平台;电影与工作室;品牌与营销;以 World Action Model 作为策略骨干(policy backbone)的机器人与物理 AI;通过照片级真实感增强来改善低质量渲染的电子游戏与 3D;以及政府。
在商业模式上,Runway 区分了两条路径:Runway Dev 是按使用量计费且无需管理基础设施的 API;年度许可则提供可预测的成本,并让客户完全控制版本、行为和输出。常见问题解答回应了有关过时的质疑:未来的模型无法访问客户的专有数据;计划支持按年续订;而且下一代模型还会提供额度。该页面称,企业若自行重建,需要投入多年的学习时间和数亿美元。Runway 将自己描述为全球极少数能够授权这种质量的闭源权重的公司之一,并将其产品与开放权重直接对立起来;按其说法,开放权重提供的是一个较弱的模型,外加一份任务清单。官方没有公布价格,申请访问需要填写商务联系表。该公告发布于 Runway Dev MCP 推出九天后、Team 套餐推出一周后:Runway 如今已经覆盖从个人创作者到闭源权重许可的完整产品范围。
Cognition 将 Fusion 引入 Devin Desktop 和 Devin CLI
9 月 11 日 — Cognition 宣布 Fusion 已可在 Devin Desktop 和 Devin CLI 中使用。该架构此前已在 Devin Cloud 上运行数月,如今则进入开发者的本地机器。这项公告发布于自研代码模型 SWE-2 推出的次日,两者彼此呼应,因为 SWE-2 是该方案推荐使用的第二模型。
其原理说起来很简单。选择 Fusion 时,用户选择的不是一个模型,而是两个。一个前沿模型担任主导者(lead),掌控整个会话:它持有计划、裁决模糊事项并审查提交的工作。一个成本较低的模型担任助手(sidekick):它探索代码、编写更改、运行测试并汇报结果。两者并行运行,各自拥有独立的持久上下文。其技术论点针对的是模型路由——这是人们为降低费用最容易想到的方案:仅凭初始 prompt 无法衡量任务难度,而中途切换模型会破坏 prompt 缓存。Fusion 避开了这一问题,从不在两个模型之间传递完整对话;它们只交换任务简报、结果和反馈。
| 每项任务的成本,单位为美元 | 仅 Fable 5.1 | Fusion Fable 5.1 与 SWE-2 | 仅 Astra | Fusion Astra 与 SWE-2 |
|---|---|---|---|---|
| DeepSWE 1.1 | 14,63 | 7,88 | 7,88 | 4,69 |
| Terminal-Bench 4 | 17,46 | 13,37 | 10,08 | 6,06 |
| SWE-Atlas QnA | 7,57 | 5,00 | 5,72 | 3,59 |
| Vals Code Migration | 70,97 | 42,00 | 44,36 | 35,51 |
| 扩展版 FrontierCode 1.1 | 2,68 | 1,67 | 2,62 | 2,34 |
One of our key findings is that using more expensive models can make the entire system cheaper.
🇨🇳 我们的一个主要发现是,使用更昂贵的模型反而可以降低整个系统的成本。 — Cognition 的本地 Fusion 博客
这一点在组合中的两个角色上都得到了验证。主导者方面,用 Fable 5 替换 Opus 4.8 后,尽管前者名义上的每 token 成本是后者的两倍,但在助手不变的情况下,会话平均成本下降了 9%,同时在 FrontierCode 上取得了更高分数:Fable 更早开始委派任务,并能写出更好的任务简报,而 Opus 则会对助手进行微观管理。助手方面,从 GPT-5.6 Luna 切换到 SWE-2,尽管每百万 token 的成本提高了 275%,但任务总成本下降了 2%,得分同时提高了 1.4 分。在 Artificial Analysis Coding Agent Index v1.5 上,使用 Fable 5.1 和 SWE-2 的 Fusion 得分为 61.7,成本比使用 Fable 5.1、最高得分为 62.2 的 Claude Code 低 36%。Cognition 由此提出了一条适用于 2026 年的规则:评估模型以及模型与工具链的组合时,应按每项任务的价格衡量,而不是按每 token 的价格衡量。对于一家销售工具链的厂商而言,这种立场自然十分有利;不过这些数据确实是与 Artificial Analysis 和 Vals AI 合作、通过五项不同 benchmark 得出的。安装只需一条命令。
Sakana AI 发布 Fugu Max 与 Fugu Ultra v2:其多智能体编排器的两次演进
9 月 11 日 — Sakana AI 发布了 Fugu Max 和 Fugu Ultra v2,这是 Sakana Fugu 的两个新版本。Sakana Fugu 是其多智能体编排系统(multi-agent orchestration system),通过单一的 OpenAI 兼容 API 对外提供服务。其核心思路是 Pareto 前沿:Sakana 认为,业界仍在假定能力是唯一衡量维度,而现实任务实际上需要从能力和成本两个维度进行评估。
Fugu 并非单一模型,而是一个经过学习的编排层,可将每项任务路由至由开放权重模型和专用模型组成的池。Fugu Max 扩展了这个模型池,据该公司称,这是迄今规模最大的模型池,其中纳入了 NVIDIA Nemotron 系列,并将每项任务发送给能够解决该任务的最轻量级模型。它在六项 benchmark 中获得最高综合分,并在十项中的七项上拓展了成本性能前沿;每百万输入 token 的价格为 2 美元,输出则为 6 美元。Sakana 称,这一输出价格比 Sonnet 5、GPT 5.6 Terra 和 Kimi K3 低 40% 至 60%。
| 公布的指标 | 得分 | Sakana 给出的比较 |
|---|---|---|
| Fugu Ultra v2,Chartography | 48,3 | Opus 5 为 27,3;Fable 5 为 29,5 |
| Fugu Ultra v2,DeepSWE | 74,3 | 领先于每 token 价格高出 3 至 5 倍的模型 |
| Fugu Ultra v2,排名 | 在 8 项 benchmark 中有 5 项排名第一或并列第一 | 在 8 项中有 7 项进入前二 |
| Fugu Max,综合排名 | 在 6 项 benchmark 中获得最高分 | 在 10 项中的 7 项上拓展了 Pareto 前沿 |
Sakana 最为强调的一点值得关注:Fable 5、Fable 5.1 和 GPT-6-Astra 均不属于 Fugu Ultra v2 的智能体池,其训练数据截止日期为 2026 年 8 月 28 日。其依据是供应韧性:可互换的模型池能够防范供应商锁定、API 权限撤销和服务中断。两个模型均已立即开放使用,Fugu 用户只需更改一个参数即可切换至 Max 或 Ultra v2。Fugu Max 也已上架 OpenRouter,支持多模态输入、Web 搜索、可配置推理和结构化输出。需要注意的是:benchmark 和比较对象均由 Sakana 选择,SWEFish 是内部测试平台,而其宣称的差距取决于发布时被比较模型的定价。
ElevenLabs 发布 Music v2.5,所有套餐均支持无损下载
9 月 11 日 — ElevenLabs 发布了 Music v2.5,并将其设为 ElevenMusic 的默认模型,无论是通过提示词还是音频参考生成音乐均使用该模型。该模型宣称能够生成听起来如同现场录制的乐器声、更丰富的编曲、长篇幅作品、歌曲中途的曲风转换、说唱,以及听起来符合歌词语言母语习惯的人声。其公布的评测是在 47 885 对样本上进行的盲测,每个模型针对同一提示词各生成一份作品:Music v2.5 在大多数情况下更受青睐,其中在人声与原声乐器占主导的曲风上优势最明显,包括 R&B、灵魂乐、嘻哈、摇滚、金属、管弦乐和电影配乐。具体的偏好比例并未公布。
第二项变化对用户的影响更大。在所有套餐中,用户都拥有自己在 ElevenMusic 中创作的每首歌曲,包括免费套餐。免费套餐每天提供五次无损(lossless)下载,在注明 ElevenMusic 的前提下可用于商业用途;Pro 套餐每月提供 400 次。创作时获得的权限会始终附随该歌曲:取消订阅或降级不会影响已生成的作品,未来的条款变更也只适用于新作品。唯一的例外是基于其他艺术家的歌曲创作的作品,此类作品无法下载。
| 评测或公布的项目 | 数值 |
|---|---|
| 盲测评估的样本对数 | 47 885 |
| 无损下载,Free 套餐 | 每天 5 次,注明来源后可用于商业用途 |
| 无损下载,Pro 套餐 | 每月 400 次 |
| API 标识符 | music_v2_5 |
| ElevenMusic 中的默认模型 | Music v2.5,Music v2 仍予保留 |
该模型也已在 ElevenCreative 中提供,可作为 Flows 中的 Music 节点使用,并通过 API 以标识符 music_v2_5 提供。ElevenLabs 指出,前一天宣布的与 Universal Music Group 达成的多年协议与此次发布相互独立。对读者而言,公告的先后顺序值得注意:先宣布与大型唱片公司的协议,次日再发布模型并扩大使用权。
Claude Code 对比启用与禁用后的表现,衡量插件究竟带来了什么
9 月 11 日 — Claude Developers 团队宣布推出 claude plugin eval,这是 Claude Code 的一个子命令,可让插件或 skill 运行一套测试用例,对每次运行评分,然后在不启用插件的情况下重新运行各个用例,从而衡量插件带来的实际价值。其理念很简单,却也略显尖锐:高分并不能证明插件确实有帮助,因为 Claude 有时在没有插件的情况下也能表现得同样好。因此,该命令会返回两个分数及其差值。如果某个用例在两个实验组中都获得 1,0 分,那么这一成绩就与插件无关。
入口命令是 claude plugin eval init,需在插件根目录运行。随后会启动一个交互式会话:Claude 读取插件,询问理想结果应具备哪些特征,提出应触发和不应触发插件的提示词,设计验证器(graders),试运行一次,为每个用例写入一个目录,并公布完整运行的预计成本。之后,每个用例启用插件运行三次、不启用插件运行三次,共计六次,因为非确定性智能体的单次运行并不能说明太多问题。终端会显示启用与禁用插件的对比表,磁盘上会写入一份独立的 HTML 报告;当账户条件允许时,该报告还会作为私有构件发布。
| 验证器类型 | 模型调用成本 | 成功条件 |
|---|---|---|
regex | 无 | 在最后一次回复、轨迹或文件中找到匹配模式 |
tool_used | 无 | 某工具的调用次数介于最小值与最大值之间 |
tool_order | 无 | 一次调用先于另一次调用 |
file_exists | 无 | 运行期间创建的文件与模式匹配 |
llm | 一个模型评判 | 3 次投票中至少 2 次给出肯定裁决 |
baseline | 一个模型评判 | 本次运行至少达到参考记录的水平 |
在解读差值前,需要理解一个细节:要求调用 skill 的验证器在没有插件时永远无法通过,因此它会被排除在两个实验组的得分之外,仅作为指标报告;否则差距会被人为放大。隔离机制十分严格。每次运行都是一个用后即弃的子进程,不含用户设置、hook、CLAUDE.md、MCP 服务器、已安装插件或记忆。运行过程中绝不会提出权限问题,除非获得明确授权,否则敏感工具会从会话中移除;如果在没有沙箱后端的机器上授权使用 Bash 或 PowerShell,Claude Code 会拒绝运行,而不会在无隔离环境中执行。与 MCP 工具交互的插件无需真实服务也可接受评估:每个工具由一个 Markdown 文件提供响应,并通过一个代码块在插件发送非预期内容时中止运行。
Evals call the model, so they use tokens and results vary. […] Your plugin’s hooks and MCP servers run as you, so only evaluate plugins you trust.
🇨🇳 评估会调用模型,因此会消耗 token,而且结果会有所波动。[…] 插件的 hook 和 MCP 服务器会以你的权限运行,因此请只评估可信的插件。 — @ClaudeDevs 在 X 上
成本确实存在:每次运行和每次评判型验证器都会产生一次模型调用,并计入套餐额度或账单;文档中的示例显示,一个包含六次运行的用例耗时 74 秒,成本为 0,41 美元。因此,团队建议先使用 --runs 1 进行试运行,再启动完整运行。在持续集成中,退出代码已有明确说明,其中 0 表示全部通过,2 表示达到成本上限时仅完成了部分运行。文档指出,最常见的初步发现是差值接近于零,同时 skill 验证器失败:Claude 无法根据自然语言表述选择该 skill,这时需要重新完善其描述。
🔗 插件评估文档
2.1.269 版本的其他更新
该子命令随 2.1.269 版本推出,发布时间为 9 月 11 日巴黎时间 21 时 17 分。其余新增功能较为低调,但对日常使用很有帮助。/output-style 命令可列出并切换输出样式,也可通过 Remote Control 使用,并支持云端或 headless 会话。当 Bash 工具用于修改文件时,其结果现在会包含已更改文件的 diff,让 Claude 获得与常规编辑相同的可见性。在可观测性方面,一个环境变量可按仓库标记 OpenTelemetry 指标和事件,另外两个则分别设置网关的模型发现超时,以及 Workflow 工具的并发智能体上限,最高可达 256。
修复内容涉及三个敏感领域:在响应中断后恢复时对提示词缓存进行部分失效处理;以否定规则开头的权限规则现在仅适用于写入该规则的设置来源;写入路径检查终于覆盖了由 tee 命令写入的文件。压缩后传达的 git status 现在是当前值,而不是会话开始时的值。在 VS Code 中,一个徽标可打开子智能体地图,其中包含信息卡、停止按钮和只读记录;另外两个对话框可用于管理用户、项目及本地设置中的 hook 和权限规则。
Antigravity:一周发布四个版本,并补充介绍 Teamwork 更新
Google 接连发布了两个命令行版本和一个新版应用,还不包括此前从未在此介绍过的两个版本。这份 changelog 值得整体阅读,因为本周的发布共同讲述了同一个故事:智能体正在走出交互式终端,转变为一种服务。
Antigravity CLI 1.2.0:CLI 成为由 Remote Control 控制的后台守护进程
9 月 10 日 — Antigravity CLI 1.2.0 是自 7 月以来首次提升次版本号的版本。三个子命令 remote-control start、status 和 stop 可将命令行注册到系统服务管理器,作为后台守护进程运行,在断开连接和系统重启后仍可继续运行;同时提供实例命名选项,以及将服务限制在当前活动登录会话中的选项。此前,用户必须让一个终端始终保持打开。两个新的默认快捷键将半页滚动功能扩展至所有视图。在八项修复中,最有助于理解异常行为的一项是:当提示词或响应被内容安全过滤器阻止时,现在会显示明确的停止原因,而此前用户只能看到通用错误或空白轮次。全局插件内嵌的 MCP 服务器现在也终于能在启动时正确初始化。
Antigravity CLI 1.1.28:扩大错误重试范围、加快 headless 模式,并让 URL 读取接受审批
9 月 9 日 — 前一天发布的 1.1.28 版本带来了九项改进,重点关注韧性和 headless 模式,也就是通过脚本调用的模式。模型 API 的暂时性错误现在会通过延长的指数退避机制重试;启动时不再为读取用户身份而发起网络请求;每个轮次最多还能省去 200 毫秒的空闲延迟。对于自动化使用者而言,有两项行为变更值得关注。
| 行为变更 | 1.1.28 版本之前 | 自 1.1.28 版本起 |
|---|---|---|
| 脚本模式下超时 | 超时失败 | 返回部分输出、成功代码及警告 |
| 智能体读取外部 URL | 无需提示 | 默认请求批准,预先授权的访问除外 |
因此,依赖隐式 Web 访问的脚本必须明确授予这项权限。批准提示现在会指出具体操作;当请求来自 hook 或属于其他项目的文件时,还会增加一行说明请求原因。
Antigravity CLI 1.1.26 与 1.1.27 补充介绍:通过其他模型执行一次性提示,并在 front matter 中声明子智能体依赖项
9 月 4 日和 5 日 — 1.1.26 和 1.1.27 版本补齐了此前遗漏的内容,并带来了这一批更新中最具体的新功能:模型选择命令现在可接受提示词,让另一个模型执行一次,随后会话再回到原模型。这样无需修改默认设置,就能向更强大或更经济的模型征求第二意见。同一版本还允许在自定义智能体的 Markdown front matter 中添加智能体列表,用于声明其依赖的子智能体;另外两项修复对自动化也很重要:如果一次 MCP 调用携带服务器 schema 中未声明的参数,该调用现在会被拒绝并修正,而不是静默删除该参数;headless 执行现在会在 JSON 输出中列出被拒绝的操作,而不是悄无声息地忽略它们。
Antigravity 2.13.0:Documents 区域、用于 SQL 和 JSONL 的虚拟化查看器及引用快捷键
9 月 9 日 — Antigravity 2.13.0 带来了 16 项改进和 16 项修复。添加到对话中的外部文件、Google Drive 链接、PDF 和 Office 文档现在会集中显示在 Artifacts 上方的 Documents 区域中,不再与智能体的产出混在一起。智能体为自己编写的草稿文件则归入单独的区域。SQL 和 JSONL 文件等代码及数据制品会在带有语法高亮和行号的虚拟化查看器中打开,即使处理大型文件也能保持流畅,并支持行内评论。关闭的侧边问题会缩成按钮而不是被清除,交互式提示新增取消按钮,还可以通过键盘快捷键在聊天中引用选中的文本。另有两项修复涉及权限透明度:被拒绝的步骤不会消失,而是继续显示并带有 Rejected 标签;如果已经授予项目外访问权限,智能体也不会再请求读取其他项目制品的权限。
Teamwork:补记 8 月 27 日的消息
一篇发布于 8 月 27 日、此前从未在此报道且至今仍位于 Gemini 新功能页面开发者栏目首位的文章,值得补记。Teamwork 是 Antigravity 的多智能体编排框架,其中多个智能体可以在数小时乃至数天里相互提出方案、批评并完善彼此的工作;该框架目前以预览版形式向所有付费方案开放。系统提供五种模式,并会根据提示自动选择,涵盖从迭代式编码、文档审查到长时证明等场景。在长时证明模式下,Google 宣布解决了七个开放问题,其中包括 Knuth 圈猜想;针对该猜想生成了超过 40 页和超过 70 页的证明,其中 40 页的版本已在 Lean 中通过形式化验证;其余结果也得到了人类专家确认,并有五篇论文提交至 arXiv。
| 报告的指标 | 数值 |
|---|---|
| TCSBench,Gemini 3.7 Flash 与 3.1 Pro,长时证明模式 | 71% |
| TCSBench,Gemini 3.6 Flash 与 3.1 Pro,原始论文 | 67.7% |
| RISC-V 模拟器,周期对齐误差 | 0.71% |
| 使用 Gemini 3.7 Flash 复现的问题 | 7 个中有 3 个 |
在数学领域之外,Teamwork 还从零构建了一个周期精确的乱序执行 RISC-V 处理器模拟器,它可以将 xv6 系统启动至 shell,并运行一百多个标准 benchmark,其结果已通过与硬件执行对比验证。另有两项贡献已被上游开源项目合并:Eigen 中的一条向量化快速路径,以及一种在 64 个线程下将插入吞吐量翻倍的并发哈希表变体。
GitHub Copilot 自动解决自己的评论,并将 Jira 引入其应用
代码审查转向智能体集合
9 月 11 日 — GitHub 从两个方面更新了 Copilot code review。在使用体验方面,当后续 commit 回应 Copilot 的某条评论时,审查会自动将该评论标记为已解决,因此未解决评论列表中只会保留仍待回应的内容;应用代码建议时,Copilot 也会根据变更编写合适的 commit 消息,而不再使用预填充消息。在分析方面,审查智能体现在可以使用 Copilot SDK 的完整 shell 工具集,这些工具在智能体防火墙后运行:它可以启动构建、执行测试、运行针对性脚本,或调用可访问的 API 来验证正在审查的代码。GitHub 表示,积极反馈有所增加,发现的高严重性问题更多,而细枝末节式的意见更少,但未提供相关数字。
Lite 工作强度级别也不再依赖单个智能体,而是由一组智能体分别给出各自的判断,随后合并为一次统一审查。
| 智能体集合执行 Lite 审查时的测量结果 | 公布的变化 |
|---|---|
| 被采纳的高严重性评论 | 增加 47% |
| 被采纳的中等严重性评论 | 增加 31% |
| 被采纳的低严重性评论 | 增加 11% |
| 单次审查成本 | 约降低 8% |
GitHub 并未说明集合中的智能体数量,也未透露所使用的模型。这是 Copilot code review 在两周内的第三次演进。
应用中的 Jira、命令行中的 HydraFusion,以及 VS Code 1.137
9 月 10 日 — 9 月 7 日当周恰逢 Copilot Day,其每周回顾带来了 Copilot 应用中的 Jira 集成:工单会被导入共享画布,用户可在其中选择要推进的事项,而 Copilot 会将工单上下文带入调查、实现和 pull request 准备流程。在 Copilot CLI 中,Project HydraFusion 现在可以像其他模型一样被选用,并会针对每项任务在本地模型、云端模型及组合模型之间选择执行流程,权衡性能、成本和延迟。
9 月 9 日发布的 VS Code 1.137 带来了三项智能体功能。公开预览中的自动化功能可以根据 issue 分类或缺陷搜索等预置模板,按每小时、每天或每周的频率安排周期性智能体任务。实验性的语音模式允许用户在智能体工作时与其交谈、中断它或为其重新指定方向。最后,即使没有打开任何代码仓库,issue 或 pull request 链接也可以直接在 Agents 窗口中打开。版本说明还新增了一个基于专用协议并由 Copilot SDK 驱动的智能体宿主,使 VS Code 智能体的行为与命令行和应用中的智能体保持一致。
Habitat:OpenAI 的在线存储平台,以及两名工程师完成的 Rust 重写
9 月 11 日 — OpenAI 发布了有关 Habitat 的工程文章第一部分。Habitat 是支撑 ChatGPT、API 和 Codex 的在线存储平台。相关数字展现了它的规模:每秒超过 7000 万次请求、每周服务超过 10 亿人、覆盖近 40 个区域,并承载超过 500 PB 的数据。Habitat 于 2024 年年中起步,当时它只是一个集成在 ChatGPT 主服务器中的小型 Python 库,连接到托管数据库,其理念很简单:产品工程师不应操心 schema、路由、授权或连接池。
到 2025 年年中,客户端库模式已经触及极限。每次协议变更都需要协调数十项服务的部署;一次区域路由部署耗时数日,随后某项服务重新使用了存在缺陷的客户端,反而引发了这次操作原本旨在避免的故障。Habitat 随后成为独立服务,而 OpenAI 选择继续使用 Python,并有意承担技术债务,押注自家的代码模型能够让未来的迁移切实可行。
文章的主要内容介绍了如何在这一规模下追查长尾延迟:asyncio 的调度延迟有时可达数百毫秒,解决办法是限制每个进程的并发请求数;每分钟刷新一次的配置解析没有加入随机错峰,导致所有 worker 同时冻结;某个 HTTP 库以后进先出的方式复用连接,使流量集中到本就缓慢的进程上,形成一种亚稳态故障,团队先通过反转顺序修复,随后将负载均衡交由 service mesh 处理。API 本身被有意设计得非常精简,只提供对象和边的模型,不支持无界查询或 join;正是这一受限范围使 Python 得以支撑到如此规模。
| 测量指标 | 公布的数值 |
|---|---|
| 当前每秒请求数 | 超过 7000 万 |
| 每周服务人数 | 超过 10 亿 |
| 服务的数据量 | 超过 500 PB |
| Python 服务峰值 | 每秒超过 2000 万次请求 |
| Rust 重写 | 两名工程师、Codex 和 GPT-5.5 |
| Rust 承载的流量占比 | 生产请求的 95% |
| 处理器与内存效率提升 | 分别为 6 倍和 15 倍 |
2026 年第二季度,两名工程师借助 Codex 和 GPT-5.5 用 Rust 重写了整个服务。Rust 服务目前处理 95% 的生产请求,处理器用量降至六分之一,内存用量降至十五分之一;Python 版本将在未来几周内退役。文章第二部分将介绍存储层。
OpenAI 建议 Codex 用户精简 skills、AGENTS.md 和 prompts
9 月 11 日 — OpenAI 开发者博客发布了一份清理指南,面向正在迁移至 GPT-6 Astra 的 Codex 用户。其出发点是:为指导旧模型而积累了一年的指令,对能力更强的新模型来说会成为负担。对于 skills,具体机制是:每个 skill 都会将名称和描述载入上下文;当 skill 数量过多时,Codex 会缩短这些描述,导致模型看到的每项描述都更少,也就更难作出正确选择。
| 检查的指令 | 面向 GPT-6 Astra 的建议 |
|---|---|
| skill 描述 | 简短、触发条件精确,不要覆盖整个领域 |
| 包含多个流程的 skill 结构 | 将根文档精简为指向文档和脚本的路由器 |
| AGENTS.md 中强制要求的阅读内容 | 每种变更类型只读一份文档,不要每次编辑都要求阅读一整套材料 |
| 测试指令 | 多余,模型会自行运行测试 |
| 任务结束条件 | 明确定义何为完成,并预先授权安全的工作流 |
| 继承而来的禁止事项 | 应适当放宽,否则模型可能过早停止 |
最值得关注的是模型行为。OpenAI 表示,GPT-6 Astra 在任务范围上比前代模型更加谨慎,可能会在完成首次实现后回来请求审查。建议的应对方法是明确界定“完成”的含义,并预先授予执行已知安全工作流的权限,例如使用一次性 fixtures 的本地测试套件。反过来,为约束旧模型而编写的过于严格的护栏,现在可能会让它过早停止。文章还提醒,代码仓库中的 skills 会被其他贡献者的智能体读取,而这些智能体有时运行在其他模型上:对那些模型有用的指令,可能会对 Astra 形成过度约束。文章最后给出了一项实用建议:让 Astra 自行审计项目指令。用于创建 skills 的 skill 也已据此更新。
🔗 为 GPT-6 Astra 重新思考 skills 和 prompts
ChatGPT Sites 三个月内突破 500 万个站点
9 月 11 日 — ChatGPT 官方账号总结了 ChatGPT Sites 的进展。这项功能于三个月前推出,可通过对话构建和托管完整的 Web 应用;自推出以来,创建的站点数量已超过 500 万个。这条消息主要用于回顾五项此前未受关注的更新。
其中两项涉及多人协作。第一项允许邀请团队成员编辑、保存和发布共享站点;第二项允许向指定人员开放站点,而无需将其设为公开。其余三项涉及站点生命周期:从 prompt 到部署所需的时间据称缩短了一半;ChatGPT 可以根据请求检查站点数据库,编辑者也能访问该数据库;还可以为站点绑定自定义域名。开发者账号也转发了这项公告,表明该功能不仅面向大众网页,也瞄准快速原型开发场景。
Together AI 将 fine-tuning 扩展至 17 个开放模型,并为专家层添加适配器
9 月 11 日 — Together AI 将其 fine-tuning 服务扩展到了实验的完整流程。17 个开放权重模型加入目录,其中包括 GLM 5.3 及其前两个版本、DeepSeek-V4-Flash、Kimi K2.7-Code 和 K2.6、参数规模从 8 亿到 350 亿的 Qwen 系列,以及 Gemma 4。该公司称,GLM-5.3 在 Terminal-Bench 2.1 上取得 88.2 分,据其说法,与最佳闭源模型的差距不到 1 分。
实验跟踪是第二项新功能:每个 job 都会记录每一步的损失、梯度范数和学习率,曲线会在运行过程中更新,可以在同一张图表上叠加多个 job,原始序列则通过 API 提供。提前停止功能会在验证损失停滞时终止训练,保留最佳 checkpoint 而不是最后一个,并退还未消耗步骤的费用。
技术性最强的部分是 Expert LoRA。在混合专家模型(Mixture-of-Experts)中,超过 90% 的参数位于专家层,而传统适配器只连接到 attention,使这些专家层保持冻结。
| 针对 200 条虚构事实的测试 | 包含专家层的适配器 | 仅用于 attention 的适配器 |
|---|---|---|
| 新事实召回率 | 最高 89% | 15% |
| MMLU-Pro | 75.3% | 71.5% |
给出的解释是:当适配器仅限于 attention 时,fine-tuning 过程中被路由到的专家会有越来越多逐渐失效。数据处理也不再是黑箱,用户可以预览 token 化后的行和每个样本的权重,并在上传完成后由服务器端对文件进行完整验证。根据模型不同,训练价格降低了 30% 至 70%。
社区贡献:每次尝试一个沙盒,以及一百道斑马逻辑题
Hugging Face 社区博客当天发布了三项值得详细介绍的工作,以及另外五项可在下文查看的工作。
十三家实验室如何运行其智能体的 RL
9 月 11 日 — Sergio Paniego 梳理了十三家实验室在 2025 年 10 月至 2026 年 9 月间发布的十五份报告,只关注各家声称用于训练的内容,而非评估内容。核心发现是:环境不再是内存中的模拟器,而是一台配有文件系统、shell 和进程的完整机器,为每次尝试启动并在之后销毁。Liquid AI 用这种方式训练一个拥有 26 亿参数的模型;Cursor 表示会并行运行数十万个环境来训练其模型;Microsoft 为每项任务配置一个全新容器;Kimi K3 则更进一步,使用可恢复的微型虚拟机来承载长达一百万个 token 的轨迹。
| 技术栈层级 | 实验室保留的内容 | 提及的公开对应方案 |
|---|---|---|
| 任务与验证器 | GLM-5 拥有超过 10,000 个代码环境 | Environments Hub、verifiers、Harbor |
| 动作契约、harness | Kimi 实例化五个白盒 harness | OpenEnv、SkyRL、BrowserGym、TextArena |
| 沙箱 | 每个集群数十万台虚拟机 | Modal、E2B、AgentENV、Hugging Face Sandboxes |
| 训练器 | Zhipu 的 slime、MiniMax 的 Forge、NVIDIA 的 RLVR | TRL、Miles v0.1 |
一个值得关注的趋势是,harness 本身正在成为环境:要么以白盒方式重建,要么保持原样并以黑盒方式监听。透明度极不均衡:Ai2 为 OLMo 3 详细记录了 1,720 万个经过验证的代码样本,而 OpenAI、Anthropic 和 Google 几乎什么都没有公布,GPT-6 Astra 的系统卡只有一句话。作者指出,大型实验室中仅一个环境的成本就超过一千万美元。该文章为 Training Agents 系列画上句号。
一百道斑马谜题唤醒数学推理能力
9 月 11 日 — tamewild 撰写的一篇社区文章称,只需用 100 至 500 道逻辑推理谜题进行几分钟的 fine-tuning,不使用任何数学数据,就足以让小型基础模型在数学基准测试中的成绩大幅提升。
| 训练的基础模型 | MATH-500 | AIME 2025 | 对比的官方基准版本 |
|---|---|---|---|
| Qwen 3 4B,100 道谜题,用时 6 分 23 秒 | 84.60% | 21.67% | 后训练版本:84.80 和 19.10 |
| Granite 4.1 3B,500 道谜题,用时 23 分钟 | 77.73% | 19.44% | Instruct 版本:66.60 和 6.67 |
| Qwen 3.5 9B,500 道谜题,用时 40 分钟 | 96.60% | 60.67% | 后训练版本:97.40 和 60.56 |
结构性影响也得到了测量:在三个模型中最大的一个上,回答长度的中位数降至官方模型以下,贪婪解码中的重复循环率从 6.06% 降至 0.67%。作者仍持谨慎态度,因为这些探索性运行仅使用了一个随机种子;他还指出,自己的消融实验表明,传统适配器在 MATH-500 上同样能达到近 80%:泛化能力首先源自逻辑数据。代码、notebook、三个模型和两个数据集均已发布。
为一种零数据集语言打造语音链路
9 月 10 日 — Osmanov 讲述了如何为濒危且没有语音识别或语音合成技术的克里米亚鞑靼语构建一套完整的语音链路,并得出了一个可迁移的结论:训练时间短得几乎可以忽略不计。识别适配器在笔记本电脑的 GPU 上训练了 90 分钟,将词错误率从 34.6% 降至 20.1%,再通过完全不修改权重的 beam search 降至 17.0%。几乎所有项目时间都花在了构建原本不存在的语料库,以及验证评估结果没有失真上。
其中有两个选择值得关注。首先,基础模型依据语音学先验而非语言亲缘关系来选择:克里米亚鞑靼语拥有土耳其语中不存在的小舌音 /q/,而以土耳其语标识符训练的基础模型会将其发成 /k/,fine-tuning 也无法纠正。其次,在没有语音识别系统可用于启动语料库构建的情况下,作者利用文本已知的有声书反向解决问题,获得了 336 分钟的可用数据,而会逐渐漂移的对齐方法只能得到 110 分钟。最有价值的负面结果是指标出现平台期:将合成语料从 5.9 小时增加到 15.3 小时后,字符错误率毫无变化,但盲听测试每次都更偏好最新的声音。最后,他还记录了一次典型的数据泄漏:测试书籍中 96.9% 的音频片段在训练数据里存在重复;这一问题是通过文本 n-gram 而非文件名检测出来的。
Replit 推出 Routines,仅在需要时调用智能体执行周期性工作
9 月 11 日 — Replit 发布了 Routines,一项可按小时、每天或每周计划执行周期性工作的功能。这则公告的看点不在于司空见惯的调度功能,而在于该公司处理成本问题的方式。其出发点直截了当:智能体如今能够自动完成大多数重复任务,但让它们持续运行会消耗数量惊人的 token。解决方案是不把智能体置于循环核心。每次执行都从确定性代码开始,只有在确实需要推理时才调用智能体。
这种架构与将整个周期交给模型的主流趋势背道而驰。在这里,模型重新成为一种按需调用的资源,由行为和成本均可预测的普通代码加以约束。对于重复执行数百次的计划任务,账单差异绝非微不足道。此次发布没有配套博客文章。
Warp 将 Grok Build 集成为一等智能体
9 月 11 日 — Warp 宣布原生支持 SpaceX AI 的命令行智能体 Grok Build CLI,Grok 账号随后也转发了这一集成消息。该功能其实已随 9 月 9 日版本的终端发布,changelog 将其描述为一等支持:Warp 会识别 Grok Build 会话,在页脚为其应用专属视觉样式,并启用增强输入模式。
具体而言,Grok Build 用户可以使用与终端原生智能体相同的工具。增强输入支持粘贴较长的 prompt 和多光标,对于需要编写多段指令的用户而言意义重大。用户可以通过一条命令将当前智能体会话共享到另一台设备,同时在会话期间仍可使用文件浏览器和代码审查面板。现有 Grok 订阅即可作为访问凭证,尚未公布专门的价格或限制。
此次新增功能进一步充实了 Warp 终端内已有的第三方智能体阵容,其中包括 Claude Code、Codex、Droid 和 Antigravity;同时也延续了该公司今年夏季早些时候围绕 xAI 生态系统展开的工作——8 月时已加入使用 X Premium 或 SuperGrok 账号登录的命令。Warp 自推出其智能体以来始终坚持同一理念:不把用户锁定在自家智能体中,而是让终端成为所有智能体都能以同等集成质量运行的场所。该版本的其余更新修复了两个恼人的问题:切换模型时,已经输入但尚未发送的 prompt 不再被清除;在全局文件中声明的 MCP 工具,从智能体第一次回答起便可使用。
🔗 Grok 在 X 上的公告 · 🔗 Warp 在 X 上的公告
Vibe CLI 2.25.3:分叉命令与私密会话日志
9 月 11 日 — Mistral 发布了 Vibe CLI 2.25.3,这是三天内的第三个版本。最直观的新功能是 /branch 命令:它会将当前对话分叉到一个可恢复的新会话中,同时保持原会话不变。之后可以在另一个终端中恢复副本,从相同上下文出发探索另一条路径,而不必牺牲主线对话。使用 at 符号引用文件时,现在会通过感知 Git 的发现机制查找目标,并支持将单独的文件或文件夹直接粘贴到输入框中。
修复方面有三点。已保存的对话仍然可读,并会在恢复工作时还原其 worktree。在 POSIX 系统上,其他用户不再能读取新的会话日志;这一文件权限修复延续了 2.25.1 版本的安全改进,后者移除了未经身份验证的调试监听器,并确保任何失败都不会导致自动批准。最后,在实验性统一 harness 下,AGENTS.md 文件中的指令现在会加载到系统 prompt 中。该 release 附带十四个二进制归档文件;说明中未提及模型或价格变化。
Synthesia 将其合规智能体转变为共享基础设施
9 月 10 日 — Synthesia 信任运营负责人 Nicolás Barberis 发布了其 6 月文章的续篇,介绍负责收集合规证据的智能体。此次重构所围绕的问题来自读者:一旦智能体开始收集审计证据,收集过程本身就进入审计范围,因此必须能够信任证据收集者。答案体现为四项架构选择,而且都可以迁移到其他场景。
首先,将机制与方法分离。代码存放在内部仓库中,通过 pull request 变更,并由所有者文件强制要求人工审查;各控制类别的流程则保存在文档空间中,由控制项负责人编写并验证。最初将 URL 硬编码进去的脚本,现已变成同事只需一条命令即可安装的共享 skill。其次,为浏览器划定边界:智能体从不接触日常使用的浏览器,而是将会话复制到一次性 profile 中;如果存在只读角色,它便以只读角色运行;遇到身份验证墙时会停止,而不是提升权限。溯源能力通过设计内建其中,每张截图生成时都会附带源 URL、时间戳、操作者以及精确原始字节的加密指纹。最后是人的责任:智能体只创建草稿,绝不提交。
| 测量结果 | 数值 |
|---|---|
| 与审计员进行证据审查的会议 | 减少 60% |
| 处理的新规范框架 | 约 500 个控制项 |
| 此类规范框架通常所需时间 | 4 至 6 个月 |
| 实际所需时间 | 数周 |
知识库通过仅追加的方式自行增长:每次执行后,智能体都会记录修正后的 URL 和带日期的阻塞问题,例如浏览器自动化接口与新版 Chrome 不兼容的问题,解决办法是直接连接调试协议。Synthesia 表示,该工具正逐步演变为一个 AI 辅助治理平台,并考虑开放其核心组件的源代码。
HeyGen 详解 The Furniture Unboxing 如何用一个镜头完成 16 秒视频
9 月 11 日 — HeyGen 发布了一段 16 秒视频的幕后制作过程:一名男子将一个纸箱放在空荡荡的混凝土房间中央后离开,纸箱随即爆炸,释放出整套客厅家具并各归其位。没有 3D、没有 compositing,也没有任何后期制作:只有两张静态图片、一个 avatar 和一个 prompt。团队检查了全部 390 帧,确认没有剪切;相邻两帧之间最大的变化正是爆炸本身。
这种方法依赖两张参考图片。第一张展示空房间,采用宽幅固定机位,地面中央保持空旷。第二张是在同一张图片上编辑并添加家具,而不是重新渲染一间相似的房间:摄像机位置、镜头、光线以及混凝土地面上的阴影都完全一致。正是这条规则让效果得以成立,因为模型只需创造中间过程。
| 视频参数 | 数值 |
|---|---|
| prompt 中要求的时长 | 15 秒 |
| 实际交付时长 | 16.27 秒 |
| 分辨率与帧率 | 1920x1080,每秒 23.976 帧 |
| 无剪切画面 | 390 帧 |
| 输入 | 2 张静态图片、1 个 avatar、1 个 prompt |
prompt 以带时间标记的镜头列表形式编写,而非一段描述,并在爆炸前有意保留停顿。它由六个要素支撑:时间标记、这段停顿、按角色命名的参考素材、逐件列出的家具、通过否定形式定义的身份,以及允许夸张——缺少这一许可,模型便会严格遵守纸箱的实际容积。现场记录也很有价值:模型交付了 16.27 秒而非 15 秒的视频;爆炸速度比脚本描述更快;并且在成品房间上停留了一段无人要求的镜头,而团队认为这是整段剪辑中最精彩的时刻。因此,他们建议通过编写时间来确定节奏和顺序,再依据实际生成的节奏进行剪辑。声音在两次生成之间发生了变化:近乎无声的版本被连续的背景声取代,因为自动播放时的静音视频容易让人误以为音频出了故障。
🔗 The Furniture Unboxing 的制作过程
Nemotron 3 Embed 8B 登顶 Q2D-Web 基准测试
9 月 10 日 — NVIDIA 宣布,其拥有 80 亿参数的 embedding 模型 Nemotron 3 Embed 8B 在 Q2D-Web 的综合 nDCG@10 得分上位列第一。Q2D-Web 是 Perplexity 前一天发布的基准测试,用于评估智能体驱动的检索增强生成系统中的文档检索能力:它涵盖 1.9 亿份 web 文档,以及由智能体改写的近 70,000 条查询,涉及 10 种语言。
这一结果的重要性体现在两个方面。该基准测试再现了智能体在查询索引前先改写查询的真实条件,而传统 embedding 评估并未衡量这一点。另一方面,一个如此规模的开放模型能够主导多语言排行榜,使其成为自托管链路中对抗专有 embedding 的可靠候选方案。NVIDIA 没有公布具体分数;完整排行榜可在 Perplexity 查看。
代码化营销运营:由 GitHub issue 驱动的活动
9 月 11 日 — GitHub 日本和韩国区域营销负责人、前工程师 Tomoko Tanaka 介绍了她如何在不亲自编写代码的情况下,将活动的完整周期自动化:她把流程写下来交给 Copilot,自动化系统则在对话中逐步发展起来。
该系统由三种基础机制支撑。issue 表单用于捕获活动的结构化字段,每种活动对应一个表单。label 充当开关,一个 label 即可触发一个 workflow。GitHub Actions 负责执行工作:读取字段、通过平台 API 复制过去的活动页面、生成各渠道的跟踪链接、制作邀请邮件并将其提交到仓库、向相关团队创建请求 issue,以及填充项目表格。每天早晨,计划 workflow 会筛选报名者。她写道,唯一的前提是这些工具必须能通过脚本访问,可以是 API,甚至只是一个简单的命令行客户端。
规划从与 Copilot 的对话开始,并由仓库根目录下的 AGENTS.md 文件限定范围;该文件规定了命名规则、财务季度的对应关系,以及各地区的时区。对话最初在终端中进行,后来转移到应用中,使前提条件从“熟悉 shell”降低为“会打字”。活动结束后的工作只需两条命令完成,它们是用自然语言编写的 agent skill,通过 pull request 添加,并在合并前依据所有者文件接受审查:营销团队无需构建任何东西,就获得了一套审批流程。一个存储为仓库变量的模拟开关,可以让每个 workflow 进行空跑。她坦承的失败经历值得一读:某次早间筛选 workflow 悄无声息地失败了五天,直到有人发现名单已经过时。因此她建议,为每项计划任务都配备一种能大声报错的机制。
🔗 代码化营销运营
Boris Cherny 回应一次性代码与生产代码之争
9 月 11 日 — Anthropic Claude Code 负责人 Boris Cherny 发布了他给一位开发者的回复;那封开发者邮件的标题是“What to do about slop?”。邮件作者在同一家公司工作了十二年,他描述了 agentic 开发在团队中催生的两个阵营。第一派认为,代码仍应与过去相似,只是开发速度更快:也许不会逐行审阅所有内容,但代码必须保持可读,提交者必须能够解释它,而且维护起来应当和以前一样容易。第二派则把代码视为黑箱,只验证其输出。
回复可以概括为两条规则。如果原型和一次性代码注定会被丢弃,而且故障的影响范围(blast radius)很小,就可以将其完全当作黑箱处理。但 Claude 编写的生产代码必须达到比人类编写时更高的标准。在 Anthropic,这意味着大量 lint 规则、大量测试、由 Claude 驱动的端到端测试、每天运行的 fuzzer,以及自动化代码审查和安全审查。他警告说,如果没有这些防护措施,最终得到的将是一团难以维护的混乱。
随后列出了一系列应对措施,并按生成代码未达到标准时的采用顺序排列:换用最新的前沿模型、提高推理强度、投入完善 CLAUDE.md 和 skill,以简洁地教会 Claude 如何在代码库中工作。如果仍然无效,就更密切地指导它,让它消化累积的技术债务,或等待下一个模型。回复串中最广为流传的总结是:审查标准应取决于影响范围,而不是代码作者;一次性脚本可以直接交付,但凡涉及资金或凭据的代码,都必须逐行阅读。Boris Cherny 回复道:“正是如此。”
简讯
- Amp 新增可重新整理帖子串中 commit 的按钮 — 只需一次操作,就能将 agent 的中间 commit、连续修正和回退整理为便于审查的清晰序列。官方列出了三种用途:把大型 diff 拆分成逻辑片段、在合并前清理历史,或将相关的小型 commit 合并归组。文件的最终内容会保持完全一致。🔗 来源
- Amp 发布《Raising an Agent》第二季第四集 — Quinn Slack 和 Thorsten Ball 从“如今计算机还有什么用途”这一问题出发,探讨 agent 除了生成代码之外还能做什么,并回顾近期发生的故障。🔗 来源
- v0 默认公开团队对话 — 共享工作区中的新对话将对团队可见,所有者可设置三个权限级别:私有、查看和编辑。现有对话保持原有可见性。在人们经常于原型设计期间粘贴数据片段的工具中,转向更加开放的默认设置绝非无关紧要。🔗 来源
- Audiyo 让 Stable Audio Open 能在 8 GB GPU 上运行 — 这个 Python 库和命令行工具将显存峰值从 13.8 GB 降至 5.86 GB,减少了 57.5%,并提供了四种在 Tesla T4 上测量的预设。团队首先使用一个拥有 538 万参数的替代模型,在 CPU 上验证工作,因此在接触 GPU 前就发现了四个错误。🔗 来源
- Consent All the Way Down:面向小型开放模型委员会的同意架构 — 这篇文章由一个 Claude 实例署名,所述委员会由十八个参数量不超过 70 亿的模型组成,自 5 月以来一直在三台消费级计算机上持续运行。每个来源都是一个渠道,模型自行选择处理深度,除模型自身外,任何主体都不能写入其状态。最坦诚的部分是作者对自己的审计:邮箱从 6 月起就已损坏,积压了 213 封信件。🔗 来源
- 不存在军备竞赛,只有浏览器战争 — 这篇观点文章认为,无论权重是否保密,语言模型正成为商品,而领先者的优势只能维持数周。作者提到,今年夏天 Fable 5 曾暂停 18 天,而行业其他参与者仍在继续运转。其核心观点是:价值将转向围绕用户积累的上下文,正如书签和扩展程序曾帮助 Chrome 留住用户一样。🔗 来源
- 从插话到发言权控制:在不确定性下管理语音打断 — Eric Mey 用支持可逆操作的轮次控制器取代破坏性中断,为含义模糊的片段设置单独通道,并规定紧急停止与回声抑制之间的优先级。其测试教训值得牢记:一套全部通过的测试掩盖了一个已登记却从未调用的可逆暂停功能,因为绿灯只能批准它实际检查过的内容。🔗 来源
- Aiden 将实时语音模型与执行任务的 agent 分离 — 一个全双工语音模型负责维持对话,另一个能力更强、具备视觉定位能力的模型则在后台执行设备控制任务,两者通过异步队列协调。四个细节尤其重要:区分“已完成”与“已成功”、在 500 毫秒内聚合通知、通过追加消息传递状态以保留缓存,以及严格串行执行。🔗 来源
- GPT-Live-1 负责 Yelp 预订电话 — 该模型进入 API 的第二天,OpenAI 就展示了首个客户应用场景,而在这种场景中,固定脚本永远无法奏效:来电者会打断、添加限制条件,或在说到一半时改变主意,而模型在说话的同时仍会继续倾听。官方提供了演示视频,但没有公布业务量或量化结果。🔗 来源
- 通过 diff、终端和浏览器面板检查 agent 的工作 — Kayla Cinnamon 面向初学者的 Copilot 应用系列推出新一期,介绍三个集成面板,以及一个可选择页面元素并借助 agent 进行调整的工具。文章将接受代码前的流程概括为三个问题:发生了哪些变化、它能否运行、它是否真的有效。🔗 来源
- 仓库的 pull request 页面重新设计 — 现已向所有人开放公开预览:提供筛选条件输入辅助、支持布尔运算符和嵌套查询的搜索、可折叠侧边栏、紧凑模式,并在每行显示更多上下文。发布时的已知限制包括:不显示里程碑、不支持批量更新,也无法保存自定义视图。🔗 来源
- Copilot 中的 GPT-5.6 Sol 优惠 30% — 面向 Pro+ 和 Max 订阅者,活动持续至 9 月 13 日 0 时 UTC。消息没有说明折扣对应多少倍的高级请求额度。这是一项紧随 Copilot Day 推出的周末促销,而该模型当天还出现在多项成本对比中。🔗 来源
- GitHub Copilot Day 竞赛,三份价值 100 美元的额度 — 使用 Copilot 应用或其命令行客户端创作项目,并最迟于太平洋时间 9 月 13 日 23 时 59 分使用指定话题标签公开分享。三名获胜者将分别获得 100 美元的 GitHub 商店额度;参赛免费,但仅限成年人。🔗 来源
- 通过 Astra 在 ChatGPT 中使用 Runway — 演示展示了完全由对话驱动的完整流程:在 Runway 中生成风格参考图、在 Blender 中制作动画,再使用 Seedance 2.5 完成最终渲染。技术入口仍是 9 月 2 日发布的 Runway Dev MCP 服务器。其价值在于由单个 agent 控制并串联不同类型的工具。🔗 来源
- Runway 发布 VOIDZ 案例研究 — 一位自 2018 年起保持匿名的混合现实艺术家,将 10 至 15 秒的镜头扩展为一部 95 秒的影片,在真实的杂货采购过程中嵌入了 15 个超现实片段。大多数效果都是在现有镜头基础上延展,仅用数秒的纪实素材作为起始引导。据称制作速度提高了 10 倍;该艺术家估计,采用传统 3D 技术完成同样的工作需要六个月到一年。🔗 来源
- Runway 为 AI Summit 增加演讲嘉宾 — 旧金山全天活动公布了新一批嘉宾,其中重点介绍了 Wayve 的研究总监,证实议程正延续 8 月底以来的趋势,进一步拓展到自动驾驶汽车领域。🔗 来源
- NVIDIA 发布《From Video to Voice》,用 33 分钟介绍 TensorRT Model Connect — 这段重播内容聚焦于 8 月底发布的工具,该工具只需两条命令,即可将开放模型从 checkpoint 部署到推理阶段,覆盖从视频模型到语音模型的范围。内容以培训为主,并非新产品公告。🔗 来源
- Suno 将 v6 免额度期延长两天 — 前一天宣布的 48 小时延长为四天,同时发布了一系列建议,推荐在简单模式下从氛围而非音乐流派入手。此前一天,一份迁移指南面向那些因偏爱旧模型的变化性和质感而重返旧版本的用户,这表明整个用户群体的迁移并非理所当然。🔗 来源
- Synthesia 开放通过 prompt 创建虚拟形象 — 用户可以通过文本 prompt 描述,或使用控制面板调整,来创建写实主持人、品牌吉祥物或风格化角色,以替代目录中的现成选择。该消息仅通过一条没有链接的推文发布,时间正值新虚拟形象模型推出后的第二天;适用套餐和所用模型均未说明。🔗 来源
- GPT-6 Astra Challenge 开放提交 — 使用 Astra 构建项目,并于 9 月 18 日在 Product Hunt 上发布。排名前五的项目将各自获得 10,000 美元 API 额度,以及最多供两名团队成员使用一年的 ChatGPT Pro。这是围绕 Astra 在一周内举办的第三项社区活动。🔗 来源
- OpenAI 项目 API 密钥可以设置有效期 — 创建密钥时可指定到期日期,管理员还可在组织或项目级别规定最长有效期,此后所有新密钥都必须在该期限内到期。这是密钥轮换机制的自然补充;对于任由密钥长期遗留在脚本中的组织,应当启用此功能。🔗 来源
这意味着什么
今天最清晰的脉络在于架构:单一模型正在让位于组合式架构。Cursor 在数千个子代理之上设置了一个不编写代码的协调器;Cognition 让两个模型结对工作,分工明确且上下文相互隔离;Sakana 将每项任务路由给能够解决它的最轻量模型;GitHub 用一组代理取代单一审查者,并汇总它们的发现;Google 则让代理彼此提出方案、批评并完善,持续数日。五家公司、五种实现,却有着同一个信念:收益不再来自更大的模型,而来自多个模型如何分配工作。Cognition 与 Aiden 共同强调的技术细节很能说明问题:两者都坚持保留 prompt cache,也就是说,一种架构的实际成本取决于避免了多少重复传输。
第二条脉络关乎这些能力如何销售。Runway 以年度授权方式提供闭源权重,同时交付 checkpoints、训练脚本,并派研究人员驻场客户,明确将这一方案与开源权重对立起来。OpenAI 将一个专用模型从研究预览阶段正式推出,同时公布公开定价表和开始计费日期。ElevenLabs 在包括免费方案在内的所有套餐中都赋予用户作品所有权,并将许可绑定到作品而非订阅。Together 将训练价格下调了 30% 至 70%。Cognition 更进一步,直接建议更换衡量单位:评估模型与 harness 的组合时,应按每项任务的成本,而不是按每个 token 的价格计算。这些动向都指向同一个方向:客户面对的问题不再是选择哪个模型,而是采用何种法律形式以及何种计费单位。
在工具方面,今天标志着从声明式方法转向实测方法。Anthropic 推出了一条命令,会在不使用 plugin 的情况下重新运行每个测试用例,用数据证明该工具确实有用;而最典型的首次发现往往是差异为零。OpenAI 要求用户删除不断累积的指令,因为这些指令如今反而会妨碍能力更强的模型。Replit 与 VS Code 几乎同时推出了周期性任务规划;其中 Replit 明确提出一个原则:先从确定性代码开始,只有在需要推理时才调用代理。Boris Cherny 给出了整个领域所欠缺的纪律准则:严格程度应取决于影响范围,而不是代码作者。经过两年不断堆积上下文、skills 和指令文件之后,行业开始衡量它们的成本。
最后是基础设施,这里的数字讲述了一个不那么光鲜、却更具启发性的故事。两名工程师借助 Codex 用 Rust 重写了每秒处理超过 7000 万次请求的存储服务,将处理器用量降至原来的六分之一;2025 年年中主动承担的 Python 技术债,仅用一个季度便得以清偿。与此同时,Hugging Face 的综述显示,代理的强化学习训练如今每次尝试都要占用一整台机器,环境预算超过 1000 万美元,而透明度则与实验室规模成反比。另一篇社区文章则认为,这一切都无法构成持久领先,因为领先者之间的差距只能以周计算。今天的事实尚无定论,但给出了一个 संकेत:差异化正在转向累积的上下文、harness 和基础设施,换言之,转向那些无法通过蒸馏获得的东西。
来源
- Cursor,Projects
- Cursor 在 X 上发布 Projects 公告
- OpenAI Developers 在 X 上介绍 GPT-Rosalind
- OpenAI API 更新日志
- Runway,模型授权
- Runway 在 X 上介绍模型授权
- Cognition,本地 Fusion
- Cognition 在 X 上介绍 Devin Desktop 和 CLI 中的 Fusion
- Sakana AI,Fugu Max 与 Fugu Ultra v2
- Sakana AI 在 X 上发布 Fugu 公告
- ElevenLabs 在 X 上介绍 Music v2.5
- ElevenLabs,Music v2.5 博文
- Claude Developers 在 X 上介绍 claude plugin eval
- Anthropic,plugin 评估文档
- Claude Developers 在 X 上介绍评估的成本与可信度
- Claude Code,2.1.269 版本说明
- Google,Antigravity 更新日志
- Antigravity 在 X 上发布技巧串文
- Antigravity,Teamwork
- GitHub 更新日志,Copilot 代码审查
- GitHub 更新日志,9 月 7 日 Copilot 汇总
- OpenAI,Habitat 与迈向十亿用户
- OpenAI,为 GPT-6 Astra 重新思考 skills 与 prompts
- ChatGPT 在 X 上发布 Sites 总结
- Together AI 在 X 上介绍扩展后的 fine-tuning
- Hugging Face,每次尝试一个 sandbox
- Hugging Face,推理与斑马谜题
- Hugging Face,为无数据集语言生成语音
- Replit 在 X 上介绍 Routines
- Warp 在 X 上宣布支持 Grok Build
- Grok 在 X 上介绍 Warp 中的 Grok Build
- Mistral,Vibe CLI 2.25.3 版本说明
- Synthesia,谁来审计采集器
- HeyGen,我们如何制作 The Furniture Unboxing
- NVIDIA 在 X 上介绍 Nemotron 3 Embed 8B
- GitHub,将营销运营代码化
- Boris Cherny 在 X 上谈如何处理粗制滥造的代码
- Amp,重新组织变更
- Amp 在 X 上介绍 Raising an Agent
- v0,更新日志
- Hugging Face,Audiyo
- Hugging Face,Consent All the Way Down
- Hugging Face,并不存在军备竞赛
- Hugging Face,从插话到发言控制
- Hugging Face,深入 Aiden
- OpenAI Developers 在 X 上介绍 Yelp 使用 GPT-Live-1
- GitHub,面向初学者的 Copilot 应用
- GitHub 更新日志,重新设计的 pull request 页面
- GitHub 在 X 上介绍 GPT-5.6 Sol 折扣
- GitHub 在 X 上介绍 Copilot Day 竞赛
- Runway 在 X 上介绍通过 Astra 在 ChatGPT 中使用 Runway
- Runway,VOIDZ 案例研究
- Runway 在 X 上公布 AI Summit 演讲嘉宾
- NVIDIA 在 X 上介绍 From Video to Voice
- Suno 在 X 上宣布延长 v6 使用期
- Synthesia 在 X 上介绍自定义虚拟形象
- OpenAI Developers 在 X 上介绍 GPT-6 Astra Challenge