ai-powered-markdown-translatorArtykuł przetłumaczony z fr na pl za pomocą gpt-5.6-sol.
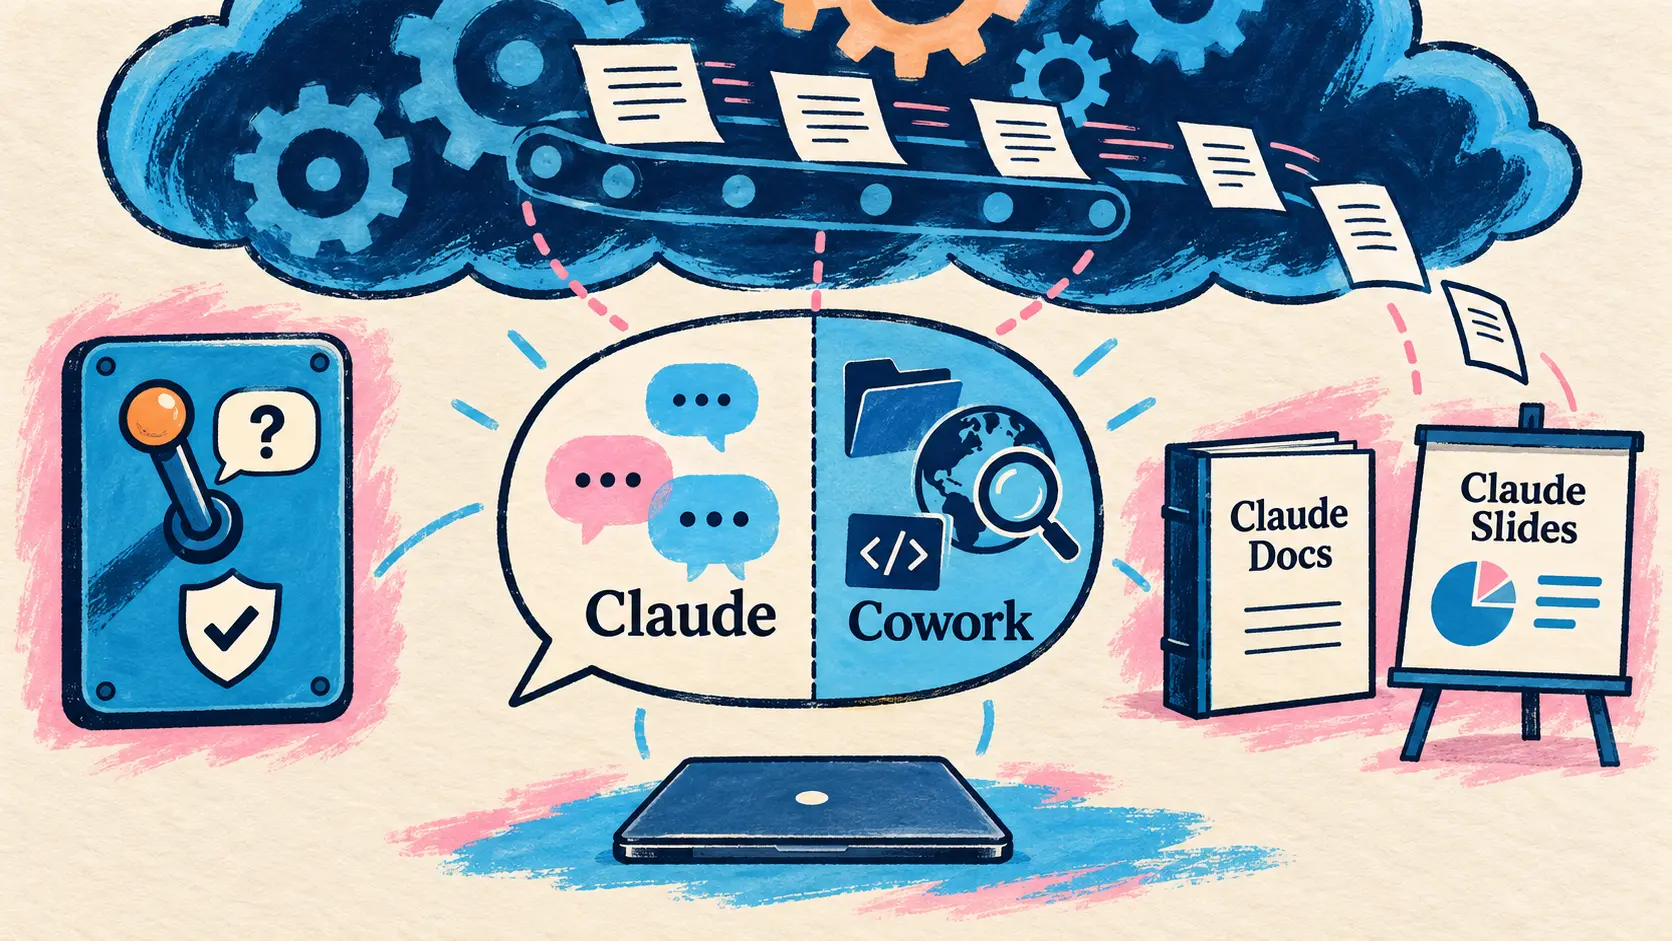
W tę środę Anthropic łączy czat i Cowork w jednego Claude’a, który sam wybiera swoje narzędzia, oraz uruchamia Claude Docs i Claude Slides w wersji beta. Zed udostępnia Delta wszystkim, zastępując pull request przeglądem w wątku, a NVIDIA wprowadza Vera Rubin NVL72 do MLPerf Inference v6.1 w chwili, gdy energia elektryczna staje się głównym ograniczeniem fabryk AI. Agenci marek wkraczają również do reklamy — zarówno w ChatGPT, jak i na YouTube — podczas gdy Cohere podpisuje ostateczną umowę z Aleph Alpha, a Mistral trafia do Firefox.
Jeden Claude: czat i Cowork łączą się, a Claude Docs i Claude Slides trafiają do wersji beta
16 września — Anthropic łączy czat i Claude Cowork: nie trzeba już wybierać trybu, Claude sam decyduje, czy należy przeszukać internet, odczytać pliki lub wykonać kod, i dostarcza gotowe pliki. Długotrwałe zadania są kontynuowane w chmurze nawet po wyłączeniu komputera, ale lokalne pliki, wbudowana przeglądarka i sterowanie komputerem (computer use, w wersji beta w planach Pro i Max) wymagają otwartego Claude Desktop.
Today, chat and Cowork start merging into one Claude. The direction: one Claude that carries context across everything you’re working on, wherever you are.
🇵🇱 Dzisiaj czat i Cowork zaczynają łączyć się w jednego Claude’a. Kierunek: jeden Claude, który zachowuje kontekst wszystkiego, nad czym pracujesz, gdziekolwiek jesteś. — Boris Cherny (Anthropic) na X
Nowe Claude Docs i Claude Slides tworzą dokumenty i prezentacje, a Claude Design, uruchomiony w kwietniu, działa teraz również w rozmowach. Wszystkie trzy są dostępne w wersji beta w płatnych planach, według uznania administratorów Enterprise. Każdy utworzony materiał można udostępnić za pomocą linku, a prezentacje można eksportować do PowerPoint lub PDF. W trybie Manual, będącym ustawieniem domyślnym, Claude pyta o zgodę przed każdą czynnością; w trybie Auto każdą czynność poprzedzają zautomatyzowane kontrole bezpieczeństwa.
| Plan lub grupa użytkowników | Zapowiedziany termin |
|---|---|
| Pro i Max (web, desktop, mobile) | „W ciągu najbliższych tygodni”, bez potrzeby aktywacji |
| Team i Free | „Wkrótce”, bez podanej daty |
| Enterprise | Co najmniej 30 dni wyprzedzenia przed każdą zmianą |
Zmiana jest nieodwracalna, ale zadania, projekty, konektory, skills i artefakty Cowork zostają zachowane. W chwili premiery centrum pomocy wskazuje następujące ograniczenia: brak możliwości dodawania z GitHub ani tworzenia odgałęzień rozmowy, rozmowy incognito otwierane w starym interfejsie, wcześniejsze zadania Cowork niewidoczne w wyszukiwarce oraz Dispatch niedostępny dla nowych użytkowników. Czat i Cowork współdzieliły już projekty i artefakty od 7 lipca, a pamięć od 25 sierpnia.
🔗 Wpis Anthropic 🔗 Centrum pomocy
Design, Slides i Docs działają również w Claude Code
Tego samego dnia @ClaudeDevs informuje, że Claude Design, Claude Slides i Claude Docs działają również w Claude Code: można poprosić o prezentację do przeglądu projektu (design review deck) lub makietę interfejsu, wskazując Claude’owi rzeczywiste pliki i RFC z repozytorium, samodzielnie albo w rozmowie zmienić rezultat, a następnie udostępnić link. W przypadku Design nie jest to nowość, ponieważ polecenie /design znajduje się w fazie wstępnych badań od 17 sierpnia: nowością są Slides i Docs. Tweet nie podaje minimalnej wersji, planów ani dokumentacji, a informacje o najnowszym wydaniu o tym nie wspominają.
Zed udostępnia Delta w publicznej wersji beta i zastępuje pull request przeglądem w wątku
16 września — Zed udostępnia Delta wszystkim. Narzędzie, uruchomione 12 sierpnia dla zapisanych użytkowników, a następnie 4 września w systemie Windows dla osób z listy, można teraz swobodnie pobrać na macOS, Linux i Windows, używać w internecie bez instalacji oraz śledzić jego wątki (threads) z urządzenia mobilnego.
Główną ideą jest współpraca bez commit ani push. Członek zespołu zaproszony do rozmowy z agentem widzi te same kopie robocze (worktrees), może przejąć je na swoim komputerze, zapytać agenta o jego decyzje lub kontynuować pracę, jeśli autor się rozłączy. Przegląd kodu, pokazany w wersji zapoznawczej 10 września, zastępuje pull request: podwątek prowadzi recenzenta przez zmiany w gałęzi, wraz z kontekstem pierwotnego agenta, na odizolowanej kopii worktrees. Polecenie /land powierza następnie agentowi zebranie zmian w jednym commit, przeprowadzenie CI, scalenie po zatwierdzeniu przez zespół i usunięcie gałęzi.
W repozytorium Delta pull requests są wyłączone od tygodnia poprzedzającego ogłoszenie, a od tego czasu 33 osoby scaliły w nim 570 zmian; repozytorium edytora Zed pozostaje na GitHub „na razie”. Pod maską DeltaDB uzupełnia wersjonowanie Git przyrostowymi deltami, które między dwoma commit zachowują zmiany i wiadomości zarówno ludzi, jak i agentów; commit pozostaje punktem kontrolnym, dzięki czemu członek zespołu, który nigdy nie otwiera Delta, widzi zwykłe repozytorium Git.
Zed deklaruje zamiar zastąpienia GitHub.com i nazywa ten sposób pracy inżynierią ciągłą (continuous engineering); jego plan rozwoju, bez podanej daty, przewiduje przechowywanie Git w DeltaDB, a w dalszej perspektywie rozważa weryfikację typu CI bezpośrednio w wątku. Delta jest bezpłatna podczas wersji beta, płatne plany zapowiedziano „wkrótce”, bez ceny ani daty, a Zed obiecuje zachować wersję bezpłatną.
🔗 Wpis Zed o publicznej wersji beta Delta 🔗 Wątek Zed o poleceniu /land
Vera Rubin NVL72 debiutuje w MLPerf Inference v6.1 z przepustowością nawet 3,7 razy większą niż GB300 NVL72
16 września — NVIDIA wprowadza Vera Rubin NVL72, swoją platformę rack następnej generacji, do MLPerf Inference v6.1, którego wyniki publikuje MLCommons, ze zgłoszeniami w wersji przedpremierowej (preview). Według porównań NVIDIA między własnymi zgłoszeniami rack osiąga nawet 3,7 razy większą przepustowość niż GB300 NVL72 w Qwen3-VL, w scenariuszach offline, serwerowym i interaktywnym, z vLLM i NVIDIA Dynamo, oraz nawet 2,5 razy większą w DeepSeek-R1 z TensorRT-LLM. Nebius również zgłosił przedpremierowe wyniki Vera Rubin NVL72.
NVIDIA przypisuje te wzrosty wspólnemu projektowaniu sprzętu i oprogramowania: precyzji NVFP4 dla wag, mechanizmu attention i pamięci podręcznej KV, rozdzielonej obsłudze oddzielającej wstępne wypełnianie (prefill) od dekodowania, równoległości ekspertów na dużą skalę oraz domenie NVLink szóstej generacji, której przepustowość pakietów według NVIDIA jest dziesięciokrotnie większa niż w standardowym Ethernet. Obecna generacja również publikuje swoje wyniki:
| Test MLPerf Inference v6.1 | Zgłoszony system | Wynik opublikowany przez NVIDIA |
|---|---|---|
| DeepSeek-R1 offline, od 72 do 288 GPU | GB300 NVL72, od 1 do 4 racków | 99% efektywności skalowania |
| WAN 2.2, tekst na wideo | GB300 NVL72 | 0,65 wideo 720p na sekundę, 5,7 s na wideo |
| Qwen3-VL, v6.1 w porównaniu z v6.0 | GB300 NVL72 | Do 1,6 raza dzięki oprogramowaniu |
| Edge-Agentic, nowy test (Qwen3.6-27B) | Jetson AGX Thor, TensorRT Edge-LLM | Zgłoszenie bez wyniku liczbowego we wpisie |
NVIDIA informuje również o wzrostach osiągniętych po terminie zgłoszeń w GPT-OSS-120B i DLRMv3, których MLCommons jeszcze nie zweryfikowało. Firma wymienia 19 partnerów, w tym ośmiu korzystających z wielowęzłowych systemów Blackwell NVL72, oraz wspomina o przyszłym teście MLPerf Endpoints organizacji MLCommons, który ma ustandaryzować pomiar wnioskowania agentowego.
🔗 Vera Rubin NVL72 firmy NVIDIA zapewnia czołową wydajność podczas debiutu w MLPerf Inference v6.1
Energia elektryczna w centrum fabryk AI: DSX MaxLPS w Lambda i sojusz AEMA
15 i 16 września — Dwa ogłoszenia NVIDIA stawiają sieć elektroenergetyczną w centrum wdrażania AI, a w obu pojawia się Emerald AI: fabryka AI sterowana jego oprogramowaniem ograniczyła pobór energii na żądanie dostawcy energii elektrycznej, po czym Emerald AI, Google i NVIDIA uruchomiły sojusz na rzecz elastycznych data centers.
AI Infra Summit: Lambda zatwierdza DSX MaxLPS, a fabryka AI ogranicza pobór na żądanie sieci
15 września — Podczas AI Infra Summit keynote Iana Bucka (NVIDIA) dotyczył liczby tokenów wytwarzanych na megawat w fabrykach AI (AI factories). Lambda zatwierdziła DSX MaxLPS, oprogramowanie NVIDIA, które monitoruje zużycie energii przez GPU i racki oraz rozdziela moc zależnie od obciążenia: 19 węzłów HGX B200 pracowało w ramach budżetu energetycznego odpowiadającego 16 węzłom działającym z pełną mocą, zwiększając przepustowość z około 4 do 5 milionów tokenów na sekundę (+24%) i wydajność na wat o 23%. NVIDIA prognozuje do 40% większą pojemność GPU dla Vera Rubin NVL72 przy tym samym budżecie, „w odpowiednich środowiskach”. Pewnego sierpniowego wieczoru sygnał od Silicon Valley Power automatycznie zmniejszył z 4 do 3 MW pobór fabryki AI w Santa Clara sterowanej przez Emerald AI Conductor, bez przerywania priorytetowego wnioskowania; od tego czasu obsłużono ponad 200 sygnałów, z czasem reakcji poniżej minuty. DSX Flex, który przetwarza tego rodzaju sygnały, doczeka się pierwszego dedykowanego wdrożenia komercyjnego w fabryce Vera Rubin o mocy 96 MW w Manassas w stanie Wirginia.
AEMA, sojusz na rzecz data centers dostosowujących się do sieci
16 września — Emerald AI, Google i NVIDIA uruchamiają AI Energy Management Alliance (AEMA), koalicję na rzecz data centers zdolnych do modulowania zużycia energii w zależności od stanu sieci: przenoszenia obciążeń, korzystania z magazynów energii, wykorzystywania powiązanej produkcji lub reagowania na incydenty. Jej zasady obejmują: ustalenie przed przyłączeniem wymogów dotyczących utrzymania pracy (ride-through), ograniczania poboru (curtailment) i reagowania na incydenty, standaryzację metryk, otwieranie szybszych ścieżek przyłączenia w zamian za weryfikowalne zobowiązania do elastyczności oraz rozdzielanie kosztów zgodnie z rzeczywistym wpływem. Sojusz koncentruje się na Stanach Zjednoczonych, a jego partnerzy założycielscy nie zostali wymienieni. Na swojej stronie wskazuje dwa potencjalne efekty: możliwość uwolnienia 100 GW w istniejącej sieci dzięki umiarkowanie elastycznym data centers oraz uniknięcie kosztów w wysokości 733 milionów dolarów na każdy GW nowych elastycznych data centers. NVIDIA i Emerald AI prezentowały już elastyczne fabryki AI podczas CERAWeek 31 marca.
🔗 Wpis NVIDIA o AEMA 🔗 Strona AEMA
Agenci marek wkraczają do reklamy w ChatGPT i na YouTube
16 września — Tego samego dnia OpenAI i Google umieszczają konwersacyjnego agenta marki w formacie reklamowym w Stanach Zjednoczonych: OpenAI prowadzi testy z wybranymi reklamodawcami, a Google udostępnia wersję beta sprzedawcom po rejestracji.
ChatGPT Ads testuje Sponsored Agents i integruje się z HubSpot oraz Shopify
OpenAI dodaje AI po obu stronach swojej platformy reklamowej ChatGPT Ads. Dzięki Sponsored Agents kliknięcie reklamy w ChatGPT może otworzyć wyraźnie oznaczoną rozmowę z agentem sponsorowanym przez markę, zanim pojawi się link do jej strony. OpenAI wyjaśnia, że ta wymiana jest odrębna od niezależnych odpowiedzi ChatGPT i oddzielona od pierwotnej rozmowy.
| Nowość w ChatGPT Ads | Stan na 16 września |
|---|---|
| Sponsored Agents | Testy z wybranymi reklamodawcami w Stanach Zjednoczonych |
| Plugin Ads Manager, kampanie sterowane promptami | Wdrażanie |
| Sugerowane teksty i materiały wizualne w Ads Manager | Wdrażanie |
| Personalizacja i tłumaczenie tekstu | Uruchomione, dostępne po wyrażeniu zgody (opt-in) |
| Integracja z HubSpot | Dostępna |
| Aplikacja ChatGPT Ads dla Shopify | Sprzedawcy z USA, inne rynki ChatGPT Ads od 23 września |
Wpis nie podaje ani cen, ani liczby reklamodawców. Reklamy, testowane w ChatGPT w lutym, otrzymały w maju Ads Manager w wersji beta i w modelu samoobsługowym (self-service), a 31 sierpnia OpenAI poinformowało o miliardzie dolarów rocznych przychodów w ujęciu annualizowanym po rozszerzeniu tej samoobsługi.
🔗 Nowe podejście do reklamy dzięki AI
Google umieszcza Business Agent w reklamach YouTube i rozwija handel agentowy
Google publikuje swoje świąteczne aktualizacje handlu agentowego (agentic commerce). Business Agent, który według Google trafił do Search „wcześniej w tym roku”, wchodzi do wersji beta w reklamach YouTube w Stanach Zjednoczonych, dostępnej dla sprzedawców po rejestracji: widz może pytać agenta o produkty bez opuszczania YouTube. AI performance insights, porównujące udział marki w dyskusji (share of voice) w AI Mode i AI Overviews, staje się dostępne w Merchant Center w Australii, Kanadzie, Indiach, Nowej Zelandii i Stanach Zjednoczonych. W Merchant Center centrum integracji UCP (Universal Commerce Protocol), protokołu zaprezentowanego przez Google 11 stycznia, dodaje możliwość przeniesienia koszyka na stronę sprzedawcy i testowania procesu płatności, a analizy pojawią się „wkrótce”; funkcje te są stopniowo wdrażane w Stanach Zjednoczonych, a następnie w Australii i Kanadzie „na początku przyszłego roku”. Tapestry (Coach, Kate Spade) prowadzi już sprzedaż za pośrednictwem UCP w Search i aplikacji Gemini. Według Google dobre praktyki dotyczące feedów produktowych przynoszą średnio o 5% więcej konwersji w następnym miesiącu, a podczas testów z lululemon atrybuty konwersacyjne marki pojawiały się w 50% odpowiednich rekomendacji AI Mode.
🔗 Wpis Google o handlu agentowym
Cohere podpisuje umowę z Aleph Alpha i uruchamia Confidential Computing w Model Vault
16 września — Cohere mnoży ogłoszenia, w tym dwa skierowane do klientów, którzy chcą zachować kontrolę nad swoimi danymi i technologią.
Aleph Alpha: ostateczna umowa i dwie siedziby w Berlinie i Toronto
Cohere i Aleph Alpha podpisały ostateczną umowę o połączeniu przedsiębiorstw (definitive business combination agreement), którego plan ogłoszono 24 kwietnia. Całość będzie działać pod nazwą Cohere, zatrudniając ponad 1000 pracowników, z planowanymi dwiema siedzibami w Berlinie i Toronto oraz centrum badawczym w Heidelbergu, w placówce Aleph Alpha. Transakcja, której wartości nie ujawniono, nadal wymaga ostatnich zgód organów regulacyjnych; jej finalizacja jest oczekiwana „jeszcze w tym roku”. Ilhan Scheer, współdyrektor generalny Aleph Alpha, zostanie wówczas dyrektorem operacyjnym Cohere, a współzałożyciel Samuel Weinbach — dyrektorem ds. badań. Współpraca z grupą Schwarz jest kontynuowana w ramach STACKIT, jej suwerennej chmury.
No government or enterprise should have to choose between capable AI and control over their tech. That belief is exactly why we’re joining forces with Aleph Alpha. Together, we’ll meet the rising global demand for frontier AI that’s both powerful and secure.
🇵🇱 Żaden rząd ani żadna firma nie powinny być zmuszone wybierać między wydajną AI a kontrolą nad swoją technologią. To właśnie to przekonanie skłania nas do połączenia sił z Aleph Alpha. Wspólnie odpowiemy na rosnący globalny popyt na potężną i bezpieczną frontier AI. — Aidan Gomez (Cohere), cytowany przez @cohere na X
Confidential Computing w Model Vault we wczesnym dostępie
Cohere uruchamia Confidential Computing w Model Vault, swojej dedykowanej i w pełni zarządzanej platformie inferencyjnej, aby chronić dane podczas ich przetwarzania, a nie tylko w spoczynku i podczas przesyłania. Opisano trzy mechanizmy: szyfrowaną inferencję end-to-end, wymuszaną sprzętowo izolację obejmującą również GPU dzięki NVIDIA Confidential Computing oraz podpisany token atestacyjny, dostępny na żądanie i możliwy do zweryfikowania za pomocą kluczy publicznych producenta sprzętu. Cohere twierdzi, że nikt, „nawet my”, nie może uzyskać dostępu do obciążeń klienta, nie wspominając jednak o audycie zewnętrznym. Wczesny dostęp jest zarezerwowany dla ograniczonej grupy klientów beta; nie podano ceny, daty powszechnej dostępności ani listy modeli, a ogłoszenie ogranicza się do tweetów i strony produktu. Funkcję zapowiedziano jako nadchodzącą już 9 września.
🔗 Ogłoszenie Cohere na X 🔗 Strona produktu Model Vault
Mistral napędza Smart Window, asystenta AI w Firefox
16 września — We wspólnym wpisie Mistral AI i Mozilla ogłaszają, że Smart Window, wciąż dostępny w wersji beta asystent przeglądania w Firefox, działa teraz z modelami Mistral, choć nie sprecyzowano z którymi. Asystent pomaga rozplątywać złożone wyszukiwania i zbierać źródła z otwartych kart. Mistral początkowo zasila go dla użytkowników we Francji i Ameryce Północnej, a Wielka Brytania i Niemcy mają dołączyć „jeszcze w tym roku”. Domyślnie rozmowy nie są przechowywane na serwerach Mozilla, a partnerzy tacy jak Mistral zobowiązują się do zerowej retencji danych (zero data retention). Dla Mistral, który twierdzi, że „tradycyjnie” obsługuje przedsiębiorstwa, umowa otwiera dostęp do szerokiego grona odbiorców. Arthur Mensch, współzałożyciel i CEO Mistral, mówi o dwóch zwolennikach open source współpracujących ze sobą, a Anthony Enzor-DeMeo, CEO Mozilla Corporation, uważa, że przeglądarka nie powinna być jednokierunkowym lejkiem.
🔗 Wspólny wpis Mistral i Mozilla
Grok Build zapamiętuje konwencje i decyzje projektu między sesjami
16 września — SpaceXAI wyposaża Grok Build, swojego agenta kodującego, w pamięć. Po zakończeniu każdej tury Grok ponownie analizuje ją w tle, bez blokowania sesji, i zapisuje w notatce Markdown trwałe informacje: konwencje zespołu, decyzje wraz z ich uzasadnieniem oraz fakty dotyczące projektu, takie jak polecenie uruchamiające testy. Wykluczone są stan zadań, tymczasowe wnioski, dane poufne oraz informacje już zawarte w repozytorium lub jego dokumentacji. Notatki są uporządkowane według projektów, a preferencje obowiązujące wszędzie trafiają do zbioru globalnego. Polecenie /dream grupuje je w pliki tematyczne i jest również okresowo uruchamiane automatycznie, natomiast /memory otwiera przeglądarkę w trybie tylko do odczytu. Po powrocie do projektu Grok odczytuje tematy dotyczące obszaru, nad którym będzie pracować, ale bieżąca rozmowa ma pierwszeństwo przed notatkami. Pamięć działa wyłącznie w nowych sesjach. Wersja beta z 25 maja wymieniała już zachowywanie decyzji między sesjami; wpis szczegółowo opisuje ten mechanizm.
Qwen Code v0.24.0 izoluje agenta na poziomie jądra w Linux i zmienia hooki bash
16 września — Dwa dni po wersji v0.23.4 Qwen Code v0.24.0 dodaje w Linux oparty na jądrze sandbox wykorzystujący bubblewrap (bwrap), bez kontenera, uprawnień root, demona ani obrazu. Po włączeniu tej opcji ponownie uruchamia CLI za widokiem systemu plików tylko do odczytu, w którym zapisywalne pozostają jedynie przestrzeń robocza i kilka katalogów (tymczasowe, cache, Qwen, Git); qwen sandbox wyświetla konfigurację, a --verify testuje izolację. Autor PR wymienia jej ograniczenia: brak osobnej przestrzeni nazw PID, dostępność gniazd Unix hosta oraz możliwość modyfikowania ustawień Git i Qwen. Zmiana niezgodna wstecznie (breaking change): w hookach wykonywanych przez bash zmienna $QWEN_PROJECT_DIR oraz jej odpowiedniki Claude i Gemini, odczytywane ze środowiska zamiast zastępowane, muszą znajdować się w podwójnych cudzysłowach. web_search ma limit na sesję (domyślnie 200, maksymalnie 10 000), budżet taki jak +500k w wiadomości określa rozmiar całej tury, a komunikacja między sesjami jest domyślnie włączona.
Devin uruchamia Code Scans, audyty całej bazy kodu ukierunkowane na cel
16 września — Cognition uruchamia Code Scans w Devin: punktem wyjścia jest szeroki cel, a nie konkretna modyfikacja, w razie potrzeby z własnymi kryteriami (standardami zespołu, listą kontrolną dostępności, wymaganiami migracji), po czym Devin bada bazę kodu, ustala priorytety swoich ustaleń, omawia je, a następnie otwiera wskazane pull requests. Scan uruchamiany za pomocą /scan w aplikacji webowej, wspomniany już w informacjach o wydaniu z 2 września, wykorzystuje architekturę agentowego MapReduce (Agentic MapReduce) z Devin Security Swarm, zaprezentowaną w lipcu, w czterech fazach: planowanie, podział na partie, równoległa eksploracja i synteza. Cognition publikuje dwa testy: w Dioxus pełna kompilacja debug 22 crates skraca się z 58,6 do 21,0 sekundy, czyli o 64%; scan SEO stron devin.ai i cognition.com wykrywa 44 problemy, po czym wynik Ahrefs dla devin.ai wzrasta z 87 do 92, a liczba wolnych stron spada o 73%. Nie podano żadnych cen.
Claude for Small Business rozszerza się do 43 przepływów pracy i 27 nowych integracji
15 września — We wpisie, którego nie uwzględniliśmy w naszym zestawieniu z 15 września, Anthropic rozszerza Claude for Small Business, swój plugin dla małych firm uruchomiony w maju z 15 przepływami pracy (workflows). Obejmuje on teraz 43 przepływy pracy oraz 27 nowych integracji, w tym Shopify, Salesforce, TikTok, Atlassian, Zoom, Xero, Gusto, Square, Stripe i Zapier, a liczba instalacji przekroczyła 900 000. Każdy przepływ rozpoczyna się w trybie zatwierdzania, a poziom autonomii można ustawiać osobno dla każdego przepływu i odwracalnie zmieniać. Anthropic ponownie uruchamia również szkolenia: jesienną trasę z Tenex w 10 miastach w USA, ponad 150 akredytowanych organizacji szkoleniowych prowadzących przeszło 750 warsztatów oraz 14 webinarów partnerskich. Oferta jest dostępna we wszystkich płatnych planach; podsumowanie wiosennej trasy opublikowano 10 września.
🔗 Wpis Anthropic o Claude for Small Business
ElevenLabs uruchamia Reception, recepcjonistę AI dla małych firm
16 września — ElevenLabs uruchamia Reception, recepcjonistę AI dla małych firm zbudowanego na platformie ElevenAgents. Przez całą dobę odpowiada on w języku rozmówcy na pytania o usługi, godziny otwarcia lub adres, a następnie rezerwuje termin w kalendarzu — jako wsparcie, gdy zespół nie odbiera, albo po zamknięciu firmy. Usługa ma własną witrynę reception.ai i można ją bezpłatnie wypróbować przez 14 dni, korzystając z 30 minut rozmów.
| Plan Reception | Cena miesięczna bez podatku | Minuty rozmów w cenie |
|---|---|---|
| Basic | 29 dolarów | 75 |
| Plus | 79 dolarów | 275 |
| Premium | 199 dolarów | 1 000 |
| Enterprise | Wycena indywidualna | Indywidualnie |
Wszystkie plany obejmują ponad 70 języków, Google Calendar, Calendly, Zapier, webhooki i serwer MCP.
🔗 Przedstawiamy Reception od ElevenAgents 🔗 Cennik Reception
Synthesia udostępnia Interactive Avatar API, awatary czasu rzeczywistego za 0,10 euro za minutę
16 września — Synthesia udostępnia powszechnie Interactive Avatar API, które pozwala integrować z produktami awatary zdolne słuchać, mówić i odpowiadać w czasie rzeczywistym. Klient zapewnia własny LLM, bazę wiedzy i logikę; Synthesia odpowiada za twarz, głos i synchronizację ruchu ust. Awatar dołącza do pokoju LiveKit jako uczestnik wideo dzięki pluginowi, który według FAQ obsługuje obecnie wyłącznie agentów LiveKit napisanych w Python. API jest rozliczane według użycia — 0,10 euro za minutę, bez zobowiązań, z 500 darmowymi minutami. Plugin Pipecat oraz kompleksowa oferta z zarządzanymi LLM, wiedzą i głosem są zapowiadane „wkrótce”, bez podania daty. W lipcu Synthesia opublikowała ramy badawcze swoich modeli interaktywnych awatarów.
🔗 Ogłoszenie Synthesia na X 🔗 Strona Interactive Avatars firmy Synthesia
Koa, model CRM Salesforce zbudowany na Nemotron 3 Super
15 września — Podczas Dreamforce Salesforce zaprezentował Koa, swój pierwszy model rozumowania przeznaczony do zarządzania relacjami z klientami (CRM), uzyskany przez post-training NVIDIA Nemotron 3 Super z użyciem NeMo RL, NeMo Gym i NeMo AutoModel na syntetycznym zbiorze danych. Salesforce kontroluje wagi i uruchamia model we własnej infrastrukturze; według Salesforce żadne dane klientów nie zostały wykorzystane do treningu ani nie są używane podczas inferencji. W CRM Bench, własnym benchmarku firmy (aktualizacja szansy sprzedażowej, przekierowanie zgłoszenia, zaplanowanie ponownego kontaktu), Koa dorównuje czołowym modelom lub je przewyższa, popełniając trzykrotnie mniej błędów, przy czym nie podano nazw porównywanych modeli. Model jest już używany wewnętrznie w Slack, a w październiku wejdzie do programu pilotażowego jako model dostępny do wyboru w Agentforce, między innymi w Formula 1 i Xero, przed oczekiwaną zimą 2026 roku powszechną dostępnością w regionach USA.
🔗 Wpis NVIDIA o Jensenie Huangu na Dreamforce
Runway szczegółowo opisuje moderację swoich przyszłych modeli wideo w czasie rzeczywistym
16 września — Runway planuje uruchomić modele generowania wideo w czasie rzeczywistym „w ciągu najbliższych miesięcy” i wyjaśnia, jak będzie je moderować. Podczas ciągłego przesyłania (streaming) użytkownik widzi wideo przed ostateczną kontrolą. Runway opracował więc i przetestował szybszy system: przyspieszoną weryfikację danych wejściowych, moderację synchroniczną, która będzie analizować klatki strumienia i przerywać transmisję natychmiast po pojawieniu się problematycznych treści, a następnie kontrolę całego wideo przed jego pobraniem lub udostępnieniem. Klasyfikator CoPE-B firmy Zentropi jest adapterem LoRA dla Gemma-4-26B-A4B-it, mieszanki ekspertów z 25,2 miliarda parametrów, z których 3,8 miliarda jest aktywnych; weryfikacja zajmuje średnio mniej niż 0,5 sekundy. W testach graniczne dane wejściowe sprawiały, że zabronione treści były przez krótki czas widoczne przed przerwaniem transmisji. System uzupełni istniejące zabezpieczenia Runway, a filmy generowane w czasie rzeczywistym będą, podobnie jak inne dzieła platformy, zawierać sygnały pochodzenia C2PA.
🔗 Moderacja w czasie rzeczywistym
Aktualności
- Zed 1.20.1 dodaje Gemini 3.8 Flash — cotygodniowa stabilna wersja edytora wprowadza również opcjonalną animację kursora, otwieranie plików Markdown w renderowanym podglądzie oraz pliki binarne dla macOS i Linux mniejsze o około 25%; naprawia też błąd, który mógł ujawniać współpracownikom prywatne pliki za pośrednictwem wyszukiwania w projekcie. 🔗 źródło
- Replit udostępnia w wersji beta niestandardowe konektory (Custom Connectors) — administratorzy przestrzeni roboczej mogą zdefiniować API REST przez HTTPS, uwierzytelniane kluczem API, aby Agent korzystał z niego poza oficjalnymi konektorami; dokumentacja wymienia klientów Pro i Enterprise, ale informacja w ramce zastrzega wersję beta dla Enterprise. 🔗 źródło
- NVIDIA powierza agentom przeniesienie TileGym do cuTile Rust — osiem dni po premierze CUDA Rust wieloagentowa skill dostarczona w TileGym przeniosła wszystkie 24 publiczne operatory biblioteki, które zachowują średnio 99,5% wydajności cuTile Python w 347 konfiguracjach zmierzonych na DGX B200. 🔗 źródło
- OpenAI publikuje przewodnik po analizach w Admin Console — widoki Usage, Insights i Outcomes, z których ostatni mierzy udział scalonych commitów utworzonych przy udziale Codex, mają łączyć wykorzystanie ChatGPT Work i Codex z wynikami; przytoczony zwrot z inwestycji na poziomie 245% jest wyraźnie hipotetyczny, a powiązanej dokumentacji nie udało się znaleźć podczas naszego przeglądu. 🔗 źródło
- API OpenAI wprowadza zasady tworzenia kluczy — dodana do changelogu 15 września, pięć dni po wprowadzeniu dat wygaśnięcia, sekcja API Key Governance pozwala administratorom zezwolić wyłącznie na klucze kont usługowych albo wyłącznie na klucze projektów należące do użytkownika, bądź zablokować tworzenie wszelkich nowych kluczy; istniejące klucze pozostają bez zmian. 🔗 źródło
- Copilot: wnioski o zwiększenie budżetu stają się ogólnie dostępne — w Copilot Business i Enterprise z rozliczeniem według użycia członek, który wyczerpał kredyty AI, może poprosić o dodatkowy budżet; właściciele i menedżerowie rozliczeń ustalają kwotę i zatwierdzają wniosek, co natychmiast przywraca dostęp. 🔗 źródło
- AI Scan pull requestów nie wymaga już domyślnej konfiguracji CodeQL — wykrywanie podatności przez AI w pull requestach obejmuje kwalifikujące się repozytoria bez tej konfiguracji i jest dostępne w publicznej wersji zapoznawczej dla klientów GitHub Advanced Security w serwisie github.com; GitHub Enterprise Server nie jest obsługiwany. 🔗 źródło
- Konfiguracje GitHub Advanced Security stają się obowiązkowe dla organizacji — od 15 września administratorzy przedsiębiorstw mogą uniemożliwić administratorom organizacji, a nie tylko właścicielom repozytoriów, modyfikowanie konfiguracji zabezpieczeń ustalonych na poziomie przedsiębiorstwa. 🔗 źródło
- GitHub wyłącza SHA-1 w HTTPS — zgodnie z zapowiedzią z 20 kwietnia changelog z 15 września potwierdza wycofanie SHA-1 z połączeń HTTPS z github.com i partnerskimi sieciami CDN, w tym GitHub Enterprise Cloud; dotyczy to przeglądarek, klientów API i Git przez HTTPS, ale nie GitHub Enterprise Server. 🔗 źródło
- MiniMax H3 trafia do Together AI w wersji bezserwerowej (serverless) — zgodnie z postem opublikowanym 15 września o 16:58 czasu pacyficznego otwarty model wideo z 33 miliardami parametrów, generujący klipy o długości od 4 do 15 sekund w rozdzielczości do 2K z natywnym dźwiękiem stereo, kosztuje tam 0,1391 dolara za film. 🔗 źródło
- MiniMax prezentuje H3 IP Edition — podsumowując swoją konferencję w Tokio z KAGAMI AI, MiniMax informuje o zaprezentowaniu edycji H3 powiązanej z oficjalnie licencjonowanymi japońskimi własnościami intelektualnymi, bez podania katalogu licencji, daty ani ceny. 🔗 źródło
- Runway dodaje pięć modeli zewnętrznych w kolekcji Fall 2026 — Fish Audio S2.1 Pro, Cartesia Sonic 3.6, MiniMax H3 Max, FLUX Video Upscale i FLUX Video Edit dołączają do platformy bez ogłoszonego cennika; kilka z nich było już dostępnych gdzie indziej, między innymi FLUX Video Upscale w Black Forest Labs od 20 sierpnia i H3 Max od 27 sierpnia. 🔗 źródło
- Luma wprowadza Camera Angles — opublikowana 15 września o 16:26 czasu pacyficznego funkcja Luma Agents ponownie generuje obiekt z pojedynczego zdjęcia pod wybranymi kątami, zachowując szczegóły; nie podano nazwy modelu ani żadnych danych liczbowych. 🔗 źródło
- Grok Voice trafia na fal — platforma inferencyjna oferuje model głosowy SpaceXAI w trybach Speech to Speech i czasu rzeczywistego; według fal odpowiada on w 0,70 sekundy i kosztuje 0,00083 dolara za sekundę, a warsztaty na żywo ze SpaceXAI zaplanowano na 22 września. 🔗 źródło
- OpenText i Cohere łączą siły z myślą o sektorach regulowanych — ogłoszone podczas konferencji ALL IN AI w Montrealu partnerstwo zintegruje North i modele Cohere z agentami OpenText Aviator, które można wdrażać lokalnie albo w chmurze prywatnej, publicznej lub suwerennej; wspólna oferta ma trafić do klientów na początku 2027 roku. 🔗 źródło
- Manus nawiązuje partnerstwa edukacyjne w Singapurze — agent jest dostępny w SkillsFuture AI Subscription, które oferuje sześć miesięcy bezpłatnego dostępu kwalifikującym się Singapurczykom zapisanym na wybrane kursy AI, a także w Singtel AI Pass; w międzyuczelnianym wyzwaniu zarejestrowało się ponad 1100 osób, a Manus rozpoczyna globalny nabór partnerów edukacyjnych. 🔗 źródło
- Uniwersytet w Manchesterze prognozuje zanieczyszczenie powietrza za pomocą Earth-2 — ponownie wytrenowany w ciągu dwóch dni na węźle z 8 GPU superkomputera Isambard-AI model Earth-2 CorrDiff obejmuje całe Zjednoczone Królestwo z rozdzielczością od 2 do 3 km², a zespół zapowiada udostępnienie danych i przepływów pracy jako open source. 🔗 źródło
- Szpital Dziecięcy w Filadelfii modeluje serca w kilka sekund — oparta na frameworku open source MONAI usługa CHOP tworzy modele serca, których przygotowanie wymagało wcześniej około czterech godzin pracy; na ten rok zaplanowano około 200 przypadków, a integrowane obecnie narzędzia zbudowane na Newton mogą skrócić symulacje wszczepiania urządzeń do czasu zbliżonego do rzeczywistego. 🔗 źródło
- Google publikuje badanie dotyczące amerykańskich nastolatków i AI — przeprowadzone wspólnie z RXN wśród ponad 1000 osób w wieku od 13 do 17 lat badanie U.S. Future Report wskazuje, że 94% z nich korzystało z AI w ciągu ostatniego roku, a 55% porównuje odpowiedzi z innymi źródłami; nie zapowiedziano żadnego produktu. 🔗 źródło
- Perplexity publikuje przewodnik po detektorach tekstu generowanego przez AI — przedstawiony jako hipotetyczny przykład pokazuje, że detektor błędnie klasyfikujący 2% tekstów napisanych przez ludzi może oznaczyć 64 artykuły na 1000, z czego 19 napisanych przez ludzi, co daje niemal 30% błędnych wskazań; przewodnik zaleca traktowanie wykrycia jako początku weryfikacji. 🔗 źródło
- GiniGEN AI klasyfikuje 425 modeli z OpenRouter — wpis społeczności opublikowany na blogu Hugging Face: ranking dodaje opóźnienie do pierwszego tokena zmierzone w 329 modelach oraz ocenę jakości języka koreańskiego; tylko 8,5% ocenionych modeli otrzymuje ocenę A za formy grzecznościowe, a 9,4% za wiedzę o koreańskich instytucjach. 🔗 źródło
Co to oznacza
Agent staje się interfejsem, a wybór trybu znika. W nowym Claude nie wybiera się już między rozmową a przestrzenią roboczą: Claude wybiera między wyszukiwaniem w sieci, plikami i kodem, a następnie tworzy dokument lub prezentację. Delta stosuje tę samą logikę do dostarczania kodu, oferując przegląd w wątku i polecenie /land, które kolejno wykonuje commit, CI i scalenie zamiast pull requesta. Devin Code Scans zaczyna od celu, a nie od modyfikacji, natomiast Grok Build zapamiętuje między sesjami konwencje i decyzje dotyczące projektu. Kontrola człowieka zmienia miejsce, ale nie znika: domyślny tryb Manual w Claude, zatwierdzenie przez zespół przed scaleniem w Zed oraz omówienie ustaleń przed utworzeniem pull requesta w Devin.
Agenci wchodzą również do procesów handlowych. OpenAI testuje Sponsored Agents, które przejmują kontakt po reklamie, Google umieszcza Business Agent w reklamach YouTube i zapewnia obsługę płatności za pomocą UCP, a obie firmy oddzielają agenta marki od pozostałych treści: z jednej strony rozmowa jest oznaczona i oddzielona od niezależnych odpowiedzi ChatGPT, z drugiej wersja beta jest dostępna dla sprzedawców po rejestracji. Claude for Small Business deklaruje 43 przepływy pracy i ponad 900 000 instalacji dla małych firm, a ElevenLabs sprzedaje za 29 dolarów miesięcznie wirtualnego recepcjonistę, który umawia spotkania. Synthesia pobiera 0,10 euro za minutę działania awatara przemawiającego w produkcie klienta, a Salesforce udostępnia Koa jako model do wyboru w Agentforce: agent nie tylko pomaga już firmie, ale również zwraca się w jej imieniu do klientów.
Zaufanie staje się argumentem sprzedażowym, a dostawcy starają się uczynić je weryfikowalnym. Cohere i Aleph Alpha podkreślają suwerenność, mając dwie siedziby — w Berlinie i Toronto — natomiast Model Vault wydaje token atestacyjny kontrolowany przez klienta za pomocą kluczy publicznych producenta sprzętu. Mistral zapewnia Firefoxowi brak retencji danych, Salesforce przechowuje wagi Koa we własnej infrastrukturze, Runway zamierza przerywać transmisję wideo natychmiast po wykryciu problematycznej treści, OpenAI pozwala administratorom ograniczać tworzenie kluczy API, a Qwen Code izoluje swojego agenta na poziomie jądra i publikuje listę jego ograniczeń. Najsolidniejsze gwarancje to te, które klient może samodzielnie zweryfikować; własny benchmark, taki jak CRM Bench, lub deklaracja „nawet my nie możemy” bez wzmianki o audycie zewnętrznym pozostają jedynie twierdzeniami.
Wreszcie moc obliczeniowa napotyka ograniczenia energetyczne. Według NVIDIA Vera Rubin NVL72 zapewnia nawet 3,7 raza większą przepustowość niż GB300 NVL72, lecz najbardziej konkretne ogłoszenia z tych dwóch dni dotyczą megawatów: Lambda mieści 19 węzłów w budżecie energetycznym przewidzianym dla 16, fabryka AI w Santa Clara zmniejsza zużycie z 4 do 3 MW na żądanie swojego dostawcy, a AEMA domaga się szybszych przyłączeń w zamian za weryfikowalną elastyczność. Przepustowość na szafę pozostaje argumentem technicznym, ale dostęp do sieci energetycznej warunkuje tempo uruchamiania tych szaf.
Źródła
- Claude, Claude Cowork i czat są teraz jednym Claude
- Centrum pomocy Claude, połączenie czatu i Cowork
- Boris Cherny na X, czat i Cowork zaczynają się łączyć
- Claude Devs na X, Design, Slides i Docs w Claude Code
- Zed, publiczna wersja beta Delta
- Zed na X, polecenie /land
- NVIDIA, Vera Rubin NVL72 w MLPerf Inference v6.1
- NVIDIA, relacja na żywo z AI Infra Summit
- NVIDIA, uruchomienie AI Energy Management Alliance
- AI Energy Management Alliance, oficjalna strona
- OpenAI, nowe podejście do reklamy dzięki AI
- Google, aktualizacje handlu agentowego na okres świąteczny
- Cohere, ostateczna umowa z Aleph Alpha
- Cohere na X, wypowiedź Aidana Gomeza
- Cohere na X, Confidential Computing w Model Vault
- Cohere, strona produktu Model Vault
- Mistral AI, partnerstwo z Mozilla
- SpaceXAI, Memory w Grok Build
- Qwen Code, informacje o wersji v0.24.0
- Cognition, prezentacja Code Scans
- Claude, nowe przepływy pracy Claude for Small Business
- ElevenLabs, prezentacja Reception
- Reception, cennik
- Synthesia na X, Interactive Avatar API
- Synthesia, strona Interactive Avatars
- NVIDIA, Jensen Huang na Dreamforce
- Runway, moderowanie w czasie rzeczywistym
- Zed, informacje o wersji 1.20.1
- Replit na X, Custom Connectors w wersji beta
- NVIDIA, przeniesienie TileGym do cuTile Rust
- OpenAI, powiązanie wykorzystania AI z wartością biznesową
- OpenAI, changelog API
- GitHub Changelog, wnioski o zwiększenie budżetu Copilot
- GitHub Changelog, AI Scan bez domyślnej konfiguracji CodeQL
- GitHub Changelog, obowiązkowe konfiguracje GitHub Advanced Security
- GitHub Changelog, wycofanie SHA-1 w HTTPS
- Together AI na X, bezserwerowy MiniMax H3
- MiniMax na X, H3 IP Edition
- Runway na X, kolekcja Fall 2026
- Luma na X, Camera Angles
- fal na X, Grok Voice
- OpenText, partnerstwo z Cohere
- Manus na X, nauka AI z Manus
- NVIDIA, Earth-2 i zanieczyszczenie powietrza w Zjednoczonym Królestwie
- NVIDIA, CHOP i modelowanie serca
- Google, U.S. Future Report o nastolatkach i AI
- Perplexity, przewodnik po detektorach tekstu generowanego przez AI
- Hugging Face, ranking modeli OpenRouter przygotowany przez GiniGEN AI