ai-powered-markdown-translator使用 gpt-5.6-sol 将文章从法语翻译成中文。
本周三,Anthropic 将聊天与 Cowork 合并为统一的 Claude,由它自行选择工具,并推出 Claude Docs 和 Claude Slides 测试版。Zed 向所有人开放 Delta,以讨论串中的审查取代 pull request;与此同时,在电力成为 AI 工厂关键约束之际,NVIDIA 让 Vera Rubin NVL72 首次亮相 MLPerf Inference v6.1。品牌智能体也开始进入广告领域,ChatGPT 和 YouTube 均有布局;Cohere 则与 Aleph Alpha 签署最终协议,Mistral 也进入 Firefox。
统一的 Claude:聊天与 Cowork 合并,Claude Docs 和 Claude Slides 推出测试版
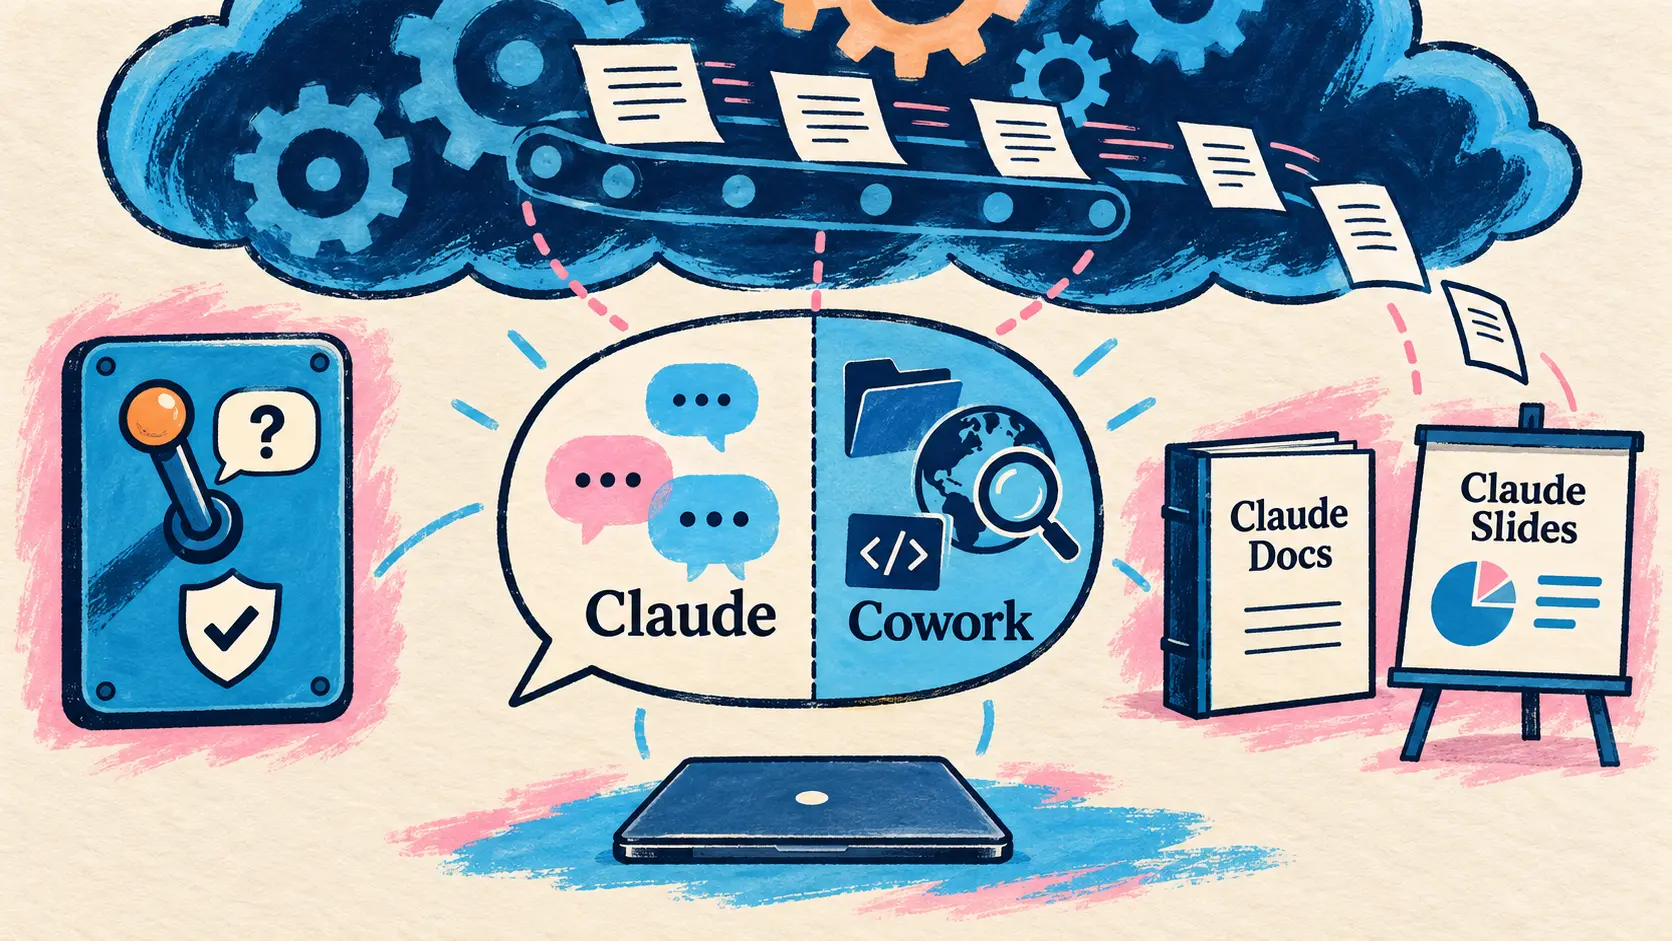
9 月 16 日 — Anthropic 合并聊天与 Claude Cowork:用户无需再选择模式,Claude 会自行判断是否需要搜索网络、读取文件或执行代码,并交付成品文件。即使电脑关闭,耗时较长的任务仍会在云端继续运行;但本地文件、集成浏览器和电脑控制功能(computer use,在 Pro 和 Max 方案中处于测试阶段)要求 Claude Desktop 保持开启。
Today, chat and Cowork start merging into one Claude. The direction: one Claude that carries context across everything you’re working on, wherever you are.
🇨🇳 今天,聊天与 Cowork 开始合并为统一的 Claude。发展方向是:打造一个统一的 Claude,无论你身在何处,它都能保留你所有工作内容的上下文。 — Boris Cherny(Anthropic)在 X 上
新推出的 Claude Docs 和 Claude Slides 可制作文档与演示文稿,而于 4 月上线的 Claude Design 现也能在对话中使用。这三项功能均在付费方案中提供测试版,Enterprise 管理员可自行决定是否启用。每项作品均可通过链接分享,演示文稿还可导出为 PowerPoint 或 PDF。默认设置的手动模式下,Claude 会在每次操作前请求确认;自动模式下,每次操作前都会先执行自动安全检查。
| 方案或适用用户 | 公布的时间安排 |
|---|---|
| Pro 和 Max(网页端、桌面端、移动端) | “未来几周内”,无需启用任何设置 |
| Team 和 Free | “即将推出”,未公布日期 |
| Enterprise | 任何变更前至少提前 30 天通知 |
切换不可逆,但 Cowork 中的任务、项目、连接器、skills 和 artifacts 都会保留。上线时,帮助中心列出了若干限制:无法从 GitHub 添加内容,也无法创建对话分支;隐身对话仍会在旧版体验中打开;部分旧 Cowork 任务不会出现在搜索结果中;Dispatch 不再向新用户开放。自 7 月 7 日起,聊天与 Cowork 已共享项目和 artifacts,并自 8 月 25 日起共享记忆。
🔗 Anthropic 博文 🔗 帮助中心
Design、Slides 和 Docs 也可在 Claude Code 中使用
同一天,@ClaudeDevs 表示 Claude Design、Claude Slides 和 Claude Docs 也可在 Claude Code 中使用:用户可以要求它制作设计审查演示文稿(design review deck)或界面模型,同时让 Claude 参考代码仓库中的真实文件和 RFC;随后既可自行修改结果,也可在对话中修改,最后分享链接。对 Design 而言,这并非首次亮相,因为命令 /design 自 8 月 17 日起便已处于初步研究阶段;真正的新功能是 Slides 和 Docs。该推文既未说明最低版本和适用方案,也未提供文档,最新已发布版本的发行说明中同样没有提及。
Zed 开放 Delta 公开测试版,以讨论串中的审查取代 pull request
9 月 16 日 — Zed 向所有人开放 Delta。该工具于 8 月 12 日以注册制推出,随后在 9 月 4 日向已注册用户开放 Windows 版本;如今可在 macOS、Linux 和 Windows 上自由下载,也可直接在网页端使用而无需安装,其讨论串(threads)还可通过移动设备跟进。
核心理念是在无需 commit 或 push 的情况下协作。被邀请加入智能体对话的队友可以看到相同的工作树副本(worktrees),在自己的设备上接手工作,向智能体询问其决策依据,或在原作者断开连接后继续推进。9 月 10 日预览的代码审查功能取代了 pull request:子讨论串会在隔离的 worktrees 副本上,结合原智能体的上下文,引导审查者查看分支变更。随后,命令 /land 会交由智能体将变更整理为单个 commit、通过 CI、在团队批准后完成合并,并删除分支。
自公告发布前一周起,Delta 代码仓库已关闭 pull request,此后共有 33 人在其中合并了 570 项变更;Zed 编辑器的代码仓库“目前”仍保留在 GitHub 上。在底层,DeltaDB 以增量 delta 补充 Git 的版本管理,在两次 commit 之间保留人类和智能体的修改及消息;commit 仍然是检查点,因此从不打开 Delta 的队友看到的仍是普通 Git 代码仓库。
Zed 表示希望取代 GitHub.com,并将这种工作方式称为持续工程(continuous engineering);其未注明日期的路线图计划在 DeltaDB 中存储 Git,并考虑最终在讨论串内加入类似 CI 的验证。Delta 在测试期间免费,付费方案将“很快”公布,但尚无价格或日期;Zed 承诺会保留免费版本。
🔗 Zed 关于 Delta 公开测试版的博文 🔗 Zed 关于 /land 命令的讨论串
Vera Rubin NVL72 首次亮相 MLPerf Inference v6.1,吞吐量最高达到 GB300 NVL72 的 3.7 倍
9 月 16 日 — NVIDIA 让下一代机架级平台 Vera Rubin NVL72 首次亮相 MLPerf Inference v6.1;MLCommons 公布了测试结果,其中包括预览版(preview)提交。根据 NVIDIA 对其自身提交结果的比较,该机架在离线、服务器和交互场景中使用 vLLM 与 NVIDIA Dynamo 运行 Qwen3-VL 时,吞吐量最高达到 GB300 NVL72 的 3.7 倍;使用 TensorRT-LLM 运行 DeepSeek-R1 时,最高达到 2.5 倍。Nebius 也提交了 Vera Rubin NVL72 的预览版结果。
NVIDIA 将这些提升归功于软硬件协同设计:权重、注意力和 KV cache 均采用 NVFP4 精度;通过解耦服务分离预填充(prefill)与解码;采用大规模专家并行;并使用第六代 NVLink 域,NVIDIA 声称其数据包吞吐量是标准 Ethernet 的 10 倍。当前一代平台也公布了数据:
| MLPerf Inference v6.1 测试 | 提交的系统 | NVIDIA 公布的结果 |
|---|---|---|
| DeepSeek-R1 离线,72 至 288 个 GPU | GB300 NVL72,1 至 4 个机架 | 99% 扩展效率 |
| WAN 2.2,文本生成视频 | GB300 NVL72 | 每秒 0.65 个 720p 视频,每个视频耗时 5.7 秒 |
| Qwen3-VL,v6.1 对比 v6.0 | GB300 NVL72 | 得益于软件,最高达到 1.6 倍 |
| Edge-Agentic,新测试(Qwen3.6-27B) | Jetson AGX Thor、TensorRT Edge-LLM | 博文中提交结果未提供具体数字 |
NVIDIA 还报告了在截止日期后于 GPT-OSS-120B 和 DLRMv3 上取得的提升,但 MLCommons 尚未进行验证。该公司称共有 19 家合作伙伴,其中 8 家采用多节点 Blackwell NVL72 系统;同时还提到 MLCommons 未来推出的 MLPerf Endpoints 测试,该测试旨在统一智能体推理的测量标准。
🔗 NVIDIA Vera Rubin NVL72 在 MLPerf Inference v6.1 首秀中展现领先性能
电力成为 AI 工厂核心:Lambda 的 DSX MaxLPS 与 AEMA 联盟
9 月 15 日和 16 日 — NVIDIA 的两项公告均将电网置于 AI 部署的核心位置,而且两者都涉及 Emerald AI:一座由其软件控制的 AI 工厂应电力供应商要求降低了用电量;随后 Emerald AI、Google 和 NVIDIA 又成立了一个面向灵活数据中心的联盟。
AI Infra Summit:Lambda 验证 DSX MaxLPS,一座 AI 工厂响应电网要求降低用电量
9 月 15 日 — 在 AI Infra Summit 上,Ian Buck(NVIDIA)的主题演讲聚焦 AI 工厂(AI factories)每兆瓦可生成的 token 数量。Lambda 验证了 NVIDIA 的 DSX MaxLPS 软件,该软件会监控 GPU 和机架的用电量,并根据负载重新分配功率:19 个 HGX B200 节点在 16 个节点满功率运行所需的电力预算内运转,使吞吐量从每秒约 400 万提升至 500 万个 token(增长 24%),每瓦性能提高 23%。NVIDIA 预计,在“适宜环境”中,同等电力预算下 Vera Rubin NVL72 可增加最高 40% 的 GPU 容量。8 月的一个夜晚,Silicon Valley Power 发出的信号使 Emerald AI Conductor 控制的圣克拉拉 AI 工厂自动从 4 MW 降至 3 MW,同时未中断高优先级推理;此后已响应超过 200 次信号,响应时间均不到一分钟。用于处理此类信号的 DSX Flex 将在弗吉尼亚州马纳萨斯一座 96 MW 的 Vera Rubin 工厂中完成首次专用商业部署。
AEMA:推动数据中心适应电网的联盟
9 月 16 日 — Emerald AI、Google 和 NVIDIA 成立 AI Energy Management Alliance(AEMA),这是一个致力于让数据中心根据电网状态调节用电量的联盟:迁移负载、调用储能、利用配套发电设施或响应事故。其原则包括:在并网前明确持续运行(ride-through)、负荷削减(curtailment)和事故响应义务;统一指标;为可验证的灵活性承诺开辟更快捷的并网通道;并依据实际影响分摊成本。该联盟面向美国,但未公布创始合作伙伴名单。其网站提出两项潜力数据:具备适度灵活性的数据中心可在现有电网上释放 100 GW 容量;每新增 1 GW 灵活数据中心,可避免 7.33 亿美元成本。早在 3 月 31 日的 CERAWeek 上,NVIDIA 与 Emerald AI 就已展示灵活 AI 工厂。
🔗 NVIDIA 关于 AEMA 的博文 🔗 AEMA 网站
品牌智能体进入 ChatGPT 与 YouTube 广告
9 月 16 日 — 同一天,OpenAI 和 Google 在美国将品牌对话智能体引入广告形式:OpenAI 正与选定广告主开展测试,Google 则向注册商家开放测试版。
ChatGPT Ads 测试 Sponsored Agents,并接入 HubSpot 和 Shopify
OpenAI 在 ChatGPT Ads 广告平台的两端加入 AI。借助 Sponsored Agents,用户点击 ChatGPT 中的广告后,可以先进入一个明确标注、由品牌赞助的智能体对话,之后再通过链接前往品牌网站。OpenAI 强调,这类互动有别于 ChatGPT 的独立回答,并与原始对话相互分离。
| ChatGPT Ads 新功能 | 截至 9 月 16 日的状态 |
|---|---|
| Sponsored Agents | 正与美国选定广告主进行测试 |
| Plugin Ads Manager,由 prompts 驱动广告活动 | 正在推出 |
| Ads Manager 中建议的文案与视觉素材 | 正在推出 |
| 文案个性化与翻译 | 已推出,可选择启用(opt-in) |
| HubSpot 集成 | 已可用 |
| 面向 Shopify 的 ChatGPT Ads 应用 | 面向美国商家;其他 ChatGPT Ads 市场自 9 月 23 日起开放 |
该博文既未提供价格,也未公布广告主数量。广告于 2 月在 ChatGPT 中测试,5 月新增测试版自助式(self-service)Ads Manager;随后 OpenAI 于 8 月 31 日表示,在扩大自助服务后,其年化收入已达到 10 亿美元。
Google 将 Business Agent 引入 YouTube 广告,并扩展智能体商务
Google 发布了面向节日季的智能体商务(agentic commerce)更新。据 Google 称,Business Agent 于“今年早些时候”进入 Search,如今开始在美国 YouTube 广告中提供测试版,商家注册后即可使用:观众无需离开 YouTube,便可向智能体咨询产品信息。AI performance insights 可比较品牌在 AI Mode 和 AI Overviews 中的声量份额(share of voice),现已在澳大利亚、加拿大、印度、新西兰和美国的 Merchant Center 中提供。Merchant Center 内的 UCP(Universal Commerce Protocol)集成中心也获得更新;这一协议由 Google 于 1 月 11 日发布,如今新增将购物车转移至商家网站以及测试结账流程的功能,分析功能则将“很快”推出。这些功能正逐步在美国上线,随后将于“明年年初”进入澳大利亚和加拿大。Tapestry(Coach、Kate Spade)已通过 UCP 在 Search 和 Gemini 应用中销售商品。据 Google 称,采用产品信息流最佳实践后,次月转化量平均增加 5%;在与 lululemon 的测试中,该品牌的对话式属性出现在 AI Mode 相关建议中的比例达到 50%。
Cohere 与 Aleph Alpha 签约,并在 Model Vault 中推出 Confidential Computing
9 月 16 日 — Cohere 接连发布多项公告,其中两项面向希望掌控自身数据和技术的客户。
Aleph Alpha:最终协议敲定,并在柏林和多伦多设立双总部
Cohere 与 Aleph Alpha 已签署最终业务合并协议(definitive business combination agreement),该计划于 4 月 24 日公布。合并后的公司将以 Cohere 为名运营,员工超过 1,000 人,计划在柏林和多伦多设立双总部,并在 Aleph Alpha 所在的海德堡设立研究中心。交易金额尚未披露,仍需获得最后的监管批准;预计将于“今年晚些时候”完成。届时,Aleph Alpha 联席 CEO Ilhan Scheer 将出任 Cohere 首席运营官,联合创始人 Samuel Weinbach 将出任研究主管。公司还将继续与 Schwarz 集团就其主权云 STACKIT 展开合作。
No government or enterprise should have to choose between capable AI and control over their tech. That belief is exactly why we’re joining forces with Aleph Alpha. Together, we’ll meet the rising global demand for frontier AI that’s both powerful and secure.
🇨🇳 任何政府或企业都不应被迫在高性能 AI 与对自身技术的控制权之间作出选择。正是这一信念促使我们与 Aleph Alpha 携手合作。我们将共同满足全球对强大且安全的前沿 AI 日益增长的需求。 — Aidan Gomez(Cohere),引自 @cohere 在 X 上的发言
Model Vault 推出早期访问版 Confidential Computing
Cohere 在其专用、完全托管的推理平台 Model Vault 中推出 Confidential Computing,不再只保护静态和传输中的数据,也保护处理过程中的数据。官方介绍了三项机制:端到端加密推理;由硬件强制实施并通过 NVIDIA Confidential Computing 延伸至 GPU 的隔离;以及可按需获取、由硬件制造商公钥验证的签名证明令牌。Cohere 声称,没有任何人——“甚至包括我们”——能够访问客户的工作负载,但未提及第三方审计。早期访问仅面向一小部分测试客户,尚未公布价格、正式可用日期或模型列表,相关公告也仅见于推文和产品页面。该功能曾于 9 月 9 日预告即将推出。
🔗 Cohere 在 X 上的公告 🔗 Model Vault 产品页面
Mistral 为 Firefox 的 AI 助手 Smart Window 提供支持
9 月 16 日——Mistral AI 与 Mozilla 在一篇联合文章中宣布,仍处于测试阶段的 Firefox AI 浏览助手 Smart Window 现已采用 Mistral 模型,但未说明具体型号。该助手可帮助理清复杂的搜索任务,并从已打开的标签页中汇集来源。Mistral 将首先为法国和北美用户提供支持,英国和德国预计将于“今年晚些时候”上线。默认情况下,对话不会保存在 Mozilla 的服务器上,而 Mistral 等合作伙伴承诺实行零数据保留(zero data retention)。Mistral 表示,该公司“历来”服务于企业,而这项协议使其得以触达普通大众。Mistral 联合创始人兼 CEO Arthur Mensch 称,这是两位开源拥护者携手合作;Mozilla Corporation CEO Anthony Enzor-DeMeo 则认为,浏览器不应成为单向漏斗。
Grok Build 可跨会话记住项目约定和决策
9 月 16 日——SpaceXAI 为其代码智能体 Grok Build 增加了记忆功能。每轮交互结束后,Grok 会在后台重新审阅内容,不阻塞当前会话,并在 Markdown 笔记中记录长期有效的信息:团队约定、决策及其理由,以及启动测试所用命令等项目事实。任务状态、暂定结论、机密信息,以及仓库或其文档中已有的内容均不会记录。笔记按项目整理,同时设有一套全局笔记,用于保存适用于所有项目的偏好。命令 /dream 会将笔记归并为主题文件,也会定期自动运行;/memory 则会打开只读浏览器。重新进入某个项目时,Grok 会读取与即将处理区域相关的主题,但当前对话的优先级高于笔记。记忆功能仅适用于新会话。5 月 25 日的测试版已将跨会话保留决策列为功能之一;此次文章进一步详述了其机制。
Qwen Code v0.24.0 在 Linux 上通过内核级机制隔离智能体,并更改 bash hooks
9 月 16 日——继 v0.23.4 发布两天后,Qwen Code v0.24.0 在 Linux 上新增了基于 bubblewrap(bwrap)的内核级沙箱,无需容器、root 权限、守护进程或镜像。启用该选项后,它会在文件系统只读视图中重新启动 CLI,仅允许写入工作区和少数目录(临时目录、缓存目录、Qwen 目录和 Git 目录);qwen sandbox 用于显示配置,--verify 用于测试隔离效果。PR 作者也列出了其限制:没有独立的 PID 命名空间、仍可连接主机的 Unix sockets,且 Git 和 Qwen 设置可被修改。存在一项不兼容变更(breaking change):在 bash 执行的 hooks 中,$QWEN_PROJECT_DIR 及其 Claude 和 Gemini 对应变量改为从环境中读取,而非进行替换,因此必须置于双引号内。web_search 设有单会话上限(默认 200,最高 10,000),消息中类似 +500k 的预算会决定整个交互轮次的规模,且跨会话消息功能默认启用。
🔗 版本说明
Devin 推出 Code Scans:以目标为导向审计整个代码库
9 月 16 日——Cognition 在 Devin 中推出 Code Scans:用户从宽泛目标而非具体修改入手,必要时还可提供自定义标准(团队规范、无障碍评估表、迁移要求),Devin 随后会调查代码库、确定发现项的优先级、与用户讨论,并创建所要求的 pull requests。扫描通过 Web 应用中的 /scan 启动,此功能已在 9 月 2 日的版本说明中提及。它沿用了 7 月发布的 Devin Security Swarm 所采用的智能体 MapReduce(Agentic MapReduce)架构,分为四个阶段:规划、分批、并行探索和综合。Cognition 公布了两项测试:在 Dioxus 上,22 个 crates 的完整 debug 编译时间从 58.6 秒降至 21.0 秒,减少 64%;对 devin.ai 和 cognition.com 的 SEO 扫描发现了 44 个问题,修复后 devin.ai 的 Ahrefs 评分从 87 升至 92,慢速页面数量减少 73%。官方未说明价格。
Claude for Small Business 增至 43 个工作流和 27 项新集成
9 月 15 日——Anthropic 在一篇未被我们 9 月 15 日汇总发现的文章中,扩展了 Claude for Small Business。这款面向小型企业的插件于 5 月推出,当时提供 15 个工作流(workflows)。目前工作流数量已增至 43 个,并新增 27 项集成,包括 Shopify、Salesforce、TikTok、Atlassian、Zoom、Xero、Gusto、Square、Stripe 和 Zapier;其安装量据称已超过 900,000 次。每个工作流默认以审批模式启动,其自主程度可逐个工作流调整,并可随时撤销。Anthropic 还重启了培训计划:与 Tenex 合作,在美国 10 个城市开展秋季巡回活动;超过 150 家获批培训机构将举办 750 多场研讨会;另有 14 场合作伙伴网络研讨会。该产品适用于所有付费套餐;春季巡回活动总结已于 9 月 10 日发布。
🔗 Anthropic 关于 Claude for Small Business 的文章
ElevenLabs 推出面向小型企业的 AI 接待员 Reception
9 月 16 日——ElevenLabs 推出 Reception,这是一款基于 ElevenAgents 平台、面向小型企业的 AI 接待员。它可全天候以呼叫者所用语言回答有关服务、营业时间或地址的问题,随后在日历中预约时间;既可在团队未接听时作为溢出接听方案,也可在下班后接听。该服务拥有独立网站 reception.ai,并提供 14 天免费试用,包含 30 分钟通话时长。
| Reception 套餐 | 每月未税价格 | 包含的通话分钟数 |
|---|---|---|
| Basic | 29 美元 | 75 |
| Plus | 79 美元 | 275 |
| Premium | 199 美元 | 1 000 |
| Enterprise | 询价 | 定制 |
所有套餐均支持 70 多种语言,并包含 Google Calendar、Calendly、Zapier、webhooks 和 MCP server。
🔗 ElevenAgents 推出 Reception 🔗 Reception 定价
Synthesia 开放 Interactive Avatar API,实时虚拟形象每分钟 0.10 欧元
9 月 16 日——Synthesia 正式全面开放 Interactive Avatar API,可将能够实时聆听、说话和回应的虚拟形象集成到产品中。客户提供自己的 LLM、知识库和逻辑;Synthesia 负责面部、语音和唇形同步。虚拟形象通过一个插件以视频参与者身份加入 LiveKit 房间;FAQ 显示,该插件目前仅支持使用 Python 编写的 LiveKit agents。API 按使用量收费,每分钟 0.10 欧元,无需承诺使用量,并赠送 500 分钟。官方还宣布将“很快”推出 Pipecat 插件,以及由平台统一管理 LLM、知识和语音的端到端服务,但未给出日期。Synthesia 曾于 7 月发布其交互式虚拟形象模型的研究框架。
🔗 Synthesia 在 X 上的公告 🔗 Synthesia 的 Interactive Avatars 页面
Koa:Salesforce 基于 Nemotron 3 Super 构建的 CRM 模型
9 月 15 日——Salesforce 在 Dreamforce 大会上发布了 Koa,这是其首个专用于客户关系管理(CRM)的推理模型。该模型通过 NeMo RL、NeMo Gym 和 NeMo AutoModel,使用合成数据集对 NVIDIA Nemotron 3 Super 进行后训练而成。Salesforce 掌控模型权重,并在自有基础设施上运行该模型;Salesforce 表示,没有任何客户数据用于训练或推理。在其自建的 CRM Bench 基准测试中(包括更新销售机会、路由工单和安排跟进),Koa 的表现达到或超过尖端模型,错误数量少三倍,但官方未公布对比模型的名称。Koa 已在 Slack 内部使用,并将于 10 月作为 Agentforce 中的可选模型进入试点阶段,参与企业包括 Formula 1 和 Xero;预计于 2026 年冬季在美国各地区正式推出。
🔗 NVIDIA 关于 Jensen Huang 亮相 Dreamforce 的文章
Runway 详解其未来视频模型的实时内容审核机制
9 月 16 日——Runway 计划在“未来几个月”推出实时视频生成模型,并解释了将如何对其进行内容审核。在连续流式传输(streaming)中,用户会在任何最终检查完成前看到视频。因此,Runway 设计并测试了一套更快速的机制:加速检查输入;进行同步审核,分析视频流中的画面,一旦出现问题内容便立即中断传输;最后在视频下载或分享前检查完整视频。其分类器 CoPE-B 由 Zentropi 开发,是 Gemma-4-26B-A4B-it 上的 LoRA adapter;后者是一个拥有 252 亿参数、其中 38 亿为活跃参数的 mixture of experts。检查平均耗时不到 0.5 秒。测试中,某些边界输入会导致禁止内容短暂出现,随后传输才被切断。这套机制将加入 Runway 的现有保护措施,实时视频也将像其其他创作内容一样带有 C2PA 来源信号。
🔗 实时审核
简讯
- Zed 1.20.1 新增 Gemini 3.8 Flash — 该编辑器每周发布的稳定版本还带来了可选的光标动画、以渲染预览方式打开 Markdown 文件,以及体积缩小约 25% 的 macOS 和 Linux 二进制文件;同时修复了一个可能通过项目搜索向协作者暴露私有文件的缺陷。🔗 来源
- Replit 开放自定义连接器(Custom Connectors)测试版 — 工作区管理员可以在其中声明一个使用 API 密钥认证的 HTTPS REST API,使 Agent 能够调用官方连接器之外的服务;文档提及 Pro 和 Enterprise 客户,但其中一个提示框注明该测试版仅面向 Enterprise。🔗 来源
- NVIDIA 让智能体负责将 TileGym 移植到 cuTile Rust — CUDA Rust 发布八天后,TileGym 中提供的一项多智能体 skill 已完成该库全部 24 个公共算子的移植;在 DGX B200 上测量的 347 种配置中,其性能平均保持在 cuTile Python 的 99.5%。🔗 来源
- OpenAI 发布 Admin Console 分析指南 — Usage、Insights 和 Outcomes 视图旨在将 ChatGPT Work 与 Codex 的使用情况同实际成果关联起来,其中 Outcomes 用于衡量有 Codex 贡献的已合并 commit 占比;文中提到的 245% 投资回报率被明确标注为假设值,而截至我们调查时,关联文档仍无法找到。🔗 来源
- OpenAI API 对密钥创建实施管控 — API Key Governance 部分于 9 月 15 日写入 changelog,距密钥到期日期功能上线五天;管理员可以仅允许服务账户密钥、仅允许由用户持有的项目密钥,或阻止创建任何新密钥;现有密钥不受影响。🔗 来源
- Copilot:追加预算申请正式全面开放 — 对于采用按使用量计费的 Copilot Business 和 Enterprise,耗尽 AI 点数的成员可以申请额外预算;所有者和账单管理员可设定金额并予以批准,访问权限将立即恢复。🔗 来源
- pull request 的 AI Scan 不再要求采用 CodeQL 默认配置 — 面向 pull request 的 AI 漏洞检测扩展至未采用该配置的合资格仓库,目前以公开预览形式向 github.com 上的 GitHub Advanced Security 客户提供;GitHub Enterprise Server 暂不支持。🔗 来源
- GitHub Advanced Security 配置可强制应用于组织 — 自 9 月 15 日起,企业管理员可以阻止组织管理员修改在企业级别设定的安全配置,此前只能阻止仓库所有者进行修改。🔗 来源
- GitHub 在 HTTPS 中禁用 SHA-1 — 正如 4 月 20 日所宣布的那样,9 月 15 日的 changelog 确认,连接 github.com 及其合作伙伴 CDN 的 HTTPS 连接将不再使用 SHA-1,GitHub Enterprise Cloud 也包括在内;浏览器、API 客户端和使用 HTTPS 的 Git 均受影响,GitHub Enterprise Server 则不受影响。🔗 来源
- MiniMax H3 以无服务器(serverless)形式登陆 Together AI — 这款拥有 330 亿参数的开放视频模型于太平洋时间 9 月 15 日 16 时 58 分通过一条推文宣布上线,可生成 4 至 15 秒、最高 2K 分辨率且带原生立体声的短片,平台标价为每段视频 0.1391 美元。🔗 来源
- MiniMax 发布 H3 IP Edition — MiniMax 在回顾与 KAGAMI AI 共同举办的东京会议时表示,会上展示了一个与日本官方授权知识产权联动的 H3 版本,但未提供授权内容清单、发布日期或价格。🔗 来源
- Runway 在 Fall 2026 系列中新增五款第三方模型 — Fish Audio S2.1 Pro、Cartesia Sonic 3.6、MiniMax H3 Max、FLUX Video Upscale 和 FLUX Video Edit 加入该平台,但尚未公布价格;其中多款此前已在其他平台上线,例如 FLUX Video Upscale 自 8 月 20 日起已在 Black Forest Labs 提供,而 H3 Max 自 8 月 27 日起已经可用。🔗 来源
- Luma 推出 Camera Angles — 该 Luma Agents 功能于太平洋时间 9 月 15 日 16 时 26 分发布,可以根据一张照片从选定角度重新生成其中的主体,同时保留细节;官方未说明所用模型,也未公布任何数据指标。🔗 来源
- Grok Voice 登陆 fal — 该推理平台以 Speech to Speech 和实时模式提供 SpaceXAI 的语音模型;据 fal 称,该模型可在 0.70 秒内响应,费用为每秒 0.00083 美元,平台还计划于 9 月 22 日与 SpaceXAI 举办一场直播研讨会。🔗 来源
- OpenText 与 Cohere 携手服务受监管行业 — 这项合作在蒙特利尔举行的 ALL IN AI 大会上宣布,将把 North 和 Cohere 模型集成到 OpenText Aviator 智能体中,并可部署在本地、私有云、公有云或主权云上;联合产品预计于 2027 年初向客户提供。🔗 来源
- Manus 在新加坡建立培训合作关系 — 该智能体已加入 SkillsFuture AI Subscription,为参加特定 AI 课程且符合条件的新加坡人提供六个月免费使用权,同时也已加入 Singtel AI Pass;一项校际挑战赛吸引了超过 1,100 人报名,Manus 还面向全球招募学习合作伙伴。🔗 来源
- 曼彻斯特大学使用 Earth-2 预测空气污染 — Earth-2 CorrDiff 在 Isambard-AI 超级计算机的一个 8 GPU 节点上用两天时间完成重新训练,能够以 2 至 3 平方公里的分辨率覆盖整个英国;团队承诺以开源方式发布数据和工作流。🔗 来源
- 费城儿童医院可在数秒内完成心脏建模 — CHOP 的这项服务基于开源框架 MONAI 构建,能够生成原本需要约四小时人工处理的心脏模型,今年预计处理约 200 个病例;目前正在集成的 Newton 工具可将器械植入模拟缩短至接近实时的水平。🔗 来源
- Google 发布关于美国青少年与 AI 的研究 — 这项 U.S. Future Report 研究与 RXN 合作开展,调查了 1,000 多名 13 至 17 岁的青少年;报告显示,94% 的受访者在过去一年使用过 AI,55% 会通过其他来源交叉核实回答;此次未发布任何产品。🔗 来源
- Perplexity 发布 AI 文本检测器指南 — 其中一个被说明为假设情形的示例显示,如果检测器将 2% 的人类文本误判为 AI 文本,那么在 1,000 篇文章中,它可能会标记 64 篇,其中 19 篇实际由人类撰写,即误报比例接近 30%;该指南建议将检测结果视为启动审查的依据。🔗 来源
- GiniGEN AI 对 425 个 OpenRouter 模型进行排名 — 这篇社区文章发布在 Hugging Face 博客上:榜单新增了针对 329 个模型测得的首 token 延迟,以及韩语质量评分;在获得评分的模型中,仅 8.5% 在敬语形式上取得 A,9.4% 在韩国机构相关内容上取得 A。🔗 来源
这意味着什么
智能体正在成为界面,而模式选择正在消失。在新版 Claude 中,用户不再需要在对话和工作区之间进行选择:Claude 会自行选择网页搜索、文件或代码,然后输出文档或演示文稿。Delta 将同一逻辑应用于代码交付,通过对话串中的审查和一条 /land 命令,连续完成 commit、CI 与合并,以此取代 pull request。Devin Code Scans 从目标而非代码修改出发,Grok Build 则能跨会话记住项目的约定和决策。人工控制并未消失,只是转移了位置:Claude 默认采用 Manuel 模式,Zed 在合并前要求团队批准,Devin 则要求先讨论发现的问题,之后才能创建 pull request。
智能体也开始进入商业环节。OpenAI 正在测试 Sponsored Agents,让其接替广告继续与用户互动;Google 将 Business Agent 放入 YouTube 广告,并使用 UCP 支持支付;两家公司都将品牌智能体与其他内容区分开来:一边是带有明确标识的对话,并与 ChatGPT 的独立回答分开;另一边则是商家需报名参与的测试版。面向小型企业,Claude for Small Business 宣称已提供 43 种工作流,并获得超过 900,000 次安装;ElevenLabs 则以每月 29 美元起的价格出售能够安排预约的接待员。Synthesia 以每分钟 0.10 欧元的价格,提供可在客户产品中说话的虚拟形象;Salesforce 则将 Koa 变成 Agentforce 中可选择的模型:智能体不再只是协助企业,也开始代表企业直接面对客户。
信任正在成为卖点,而厂商试图使其能够得到验证。Cohere 与 Aleph Alpha 强调主权性,在柏林和多伦多设立双总部;Model Vault 则提供由客户控制的证明 token,并使用硬件制造商的公钥。Mistral 为 Firefox 作出零保留承诺,Salesforce 将 Koa 的权重保留在自身基础设施上,Runway 计划在问题内容出现时立即切断视频流,OpenAI 允许管理员限制 API 密钥的创建,Qwen Code 则通过公开限制清单,在内核层面对其智能体实施隔离。最有力的保障,是客户能够亲自验证的保障;像 CRM Bench 这样的内部 benchmark,或在未提及第三方审计的情况下声称“连我们也无法访问”,仍然只是主张。
最后,算力正受制于电力。根据 NVIDIA 的数据,Vera Rubin NVL72 的吞吐量最高可达 GB300 NVL72 的 3.7 倍,但这两天最具体的公告都围绕兆瓦展开:Lambda 在原本只能容纳 16 个节点的电力预算内安置了 19 个节点;圣克拉拉的一座 AI 工厂应电力供应商要求将功率从 4 MW 降至 3 MW;AEMA 则以可验证的灵活调度能力为交换条件,要求加快电网接入。每个机架的吞吐量仍是技术卖点,但能否接入电网,决定了这些机架投入使用的速度。
来源
- Claude:Claude Cowork 与聊天现已合并为统一的 Claude
- Claude 帮助中心:聊天与 Cowork 的合并
- Boris Cherny 在 X 上表示,聊天与 Cowork 开始合并
- Claude Devs 在 X 上介绍 Claude Code 中的 Design、Slides 和 Docs
- Zed:Delta 公开测试版
- Zed 在 X 上介绍 /land 命令
- NVIDIA:Vera Rubin NVL72 在 MLPerf Inference v6.1 中的表现
- NVIDIA:AI Infra Summit 直播博客
- NVIDIA:成立 AI Energy Management Alliance
- AI Energy Management Alliance 官方网站
- OpenAI:利用 AI 重新构想广告
- Google:面向节日季的智能体商务更新
- Cohere:与 Aleph Alpha 达成最终协议
- Cohere 在 X 上发布 Aidan Gomez 的引述
- Cohere 在 X 上介绍 Model Vault 中的 Confidential Computing
- Cohere:Model Vault 产品页面
- Mistral AI:与 Mozilla 建立合作关系
- SpaceXAI:Grok Build 中的 Memory
- Qwen Code:v0.24.0 版本说明
- Cognition:Code Scans 简介
- Claude:Claude for Small Business 的新工作流
- ElevenLabs:Reception 简介
- Reception:价格
- Synthesia 在 X 上介绍 Interactive Avatar API
- Synthesia:Interactive Avatars 页面
- NVIDIA:Jensen Huang 出席 Dreamforce
- Runway:实时审核
- Zed:1.20.1 版本说明
- Replit 在 X 上介绍 Custom Connectors 测试版
- NVIDIA:将 TileGym 移植到 cuTile Rust
- OpenAI:将 AI 使用情况与商业价值关联起来
- OpenAI:API changelog
- GitHub Changelog:Copilot 追加预算申请
- GitHub Changelog:无需 CodeQL 默认配置的 AI Scan
- GitHub Changelog:强制实施 GitHub Advanced Security 配置
- GitHub Changelog:在 HTTPS 中停用 SHA-1
- Together AI 在 X 上介绍无服务器版 MiniMax H3
- MiniMax 在 X 上介绍 H3 IP Edition
- Runway 在 X 上介绍 Fall 2026 系列
- Luma 在 X 上介绍 Camera Angles
- fal 在 X 上介绍 Grok Voice
- OpenText:与 Cohere 建立合作关系
- Manus 在 X 上介绍使用 Manus 学习 AI
- NVIDIA:Earth-2 与英国空气污染
- NVIDIA:CHOP 与心脏建模
- Google:关于青少年与 AI 的 U.S. Future Report
- Perplexity:AI 文本检测器指南
- Hugging Face:GiniGEN AI 的 OpenRouter 模型排名