ai-powered-markdown-translatorArtikel översatt från franska till svenska med gpt-6.1-sol.
DeepSeek öppnar koden till DeepInfer, inferensmotorn som kör DeepSeek-V4.1-Flash i produktion, och redovisar siffror för tjänsten: 155 000 miljarder tokens per dag på ett enda kluster. Samma dag lanserar Mistral och ElevenLabs sina modeller för röstagenter via två motsatta vägar, en kedja av transkribering och talsyntes med Voxtral 3, en enda modell för tal till tal med Eleven Realtime, medan Perplexity kör Computer helt lokalt på Mac. Google släpper också TorchTPU som open source, och Anthropics tjänst OSS Scanner redovisar sina första resultat, däribland en sårbarhet i curl som nu har åtgärdats.
DeepInfer: DeepSeek öppnar koden till inferensmotorn som kör DeepSeek-V4.1-Flash i produktion
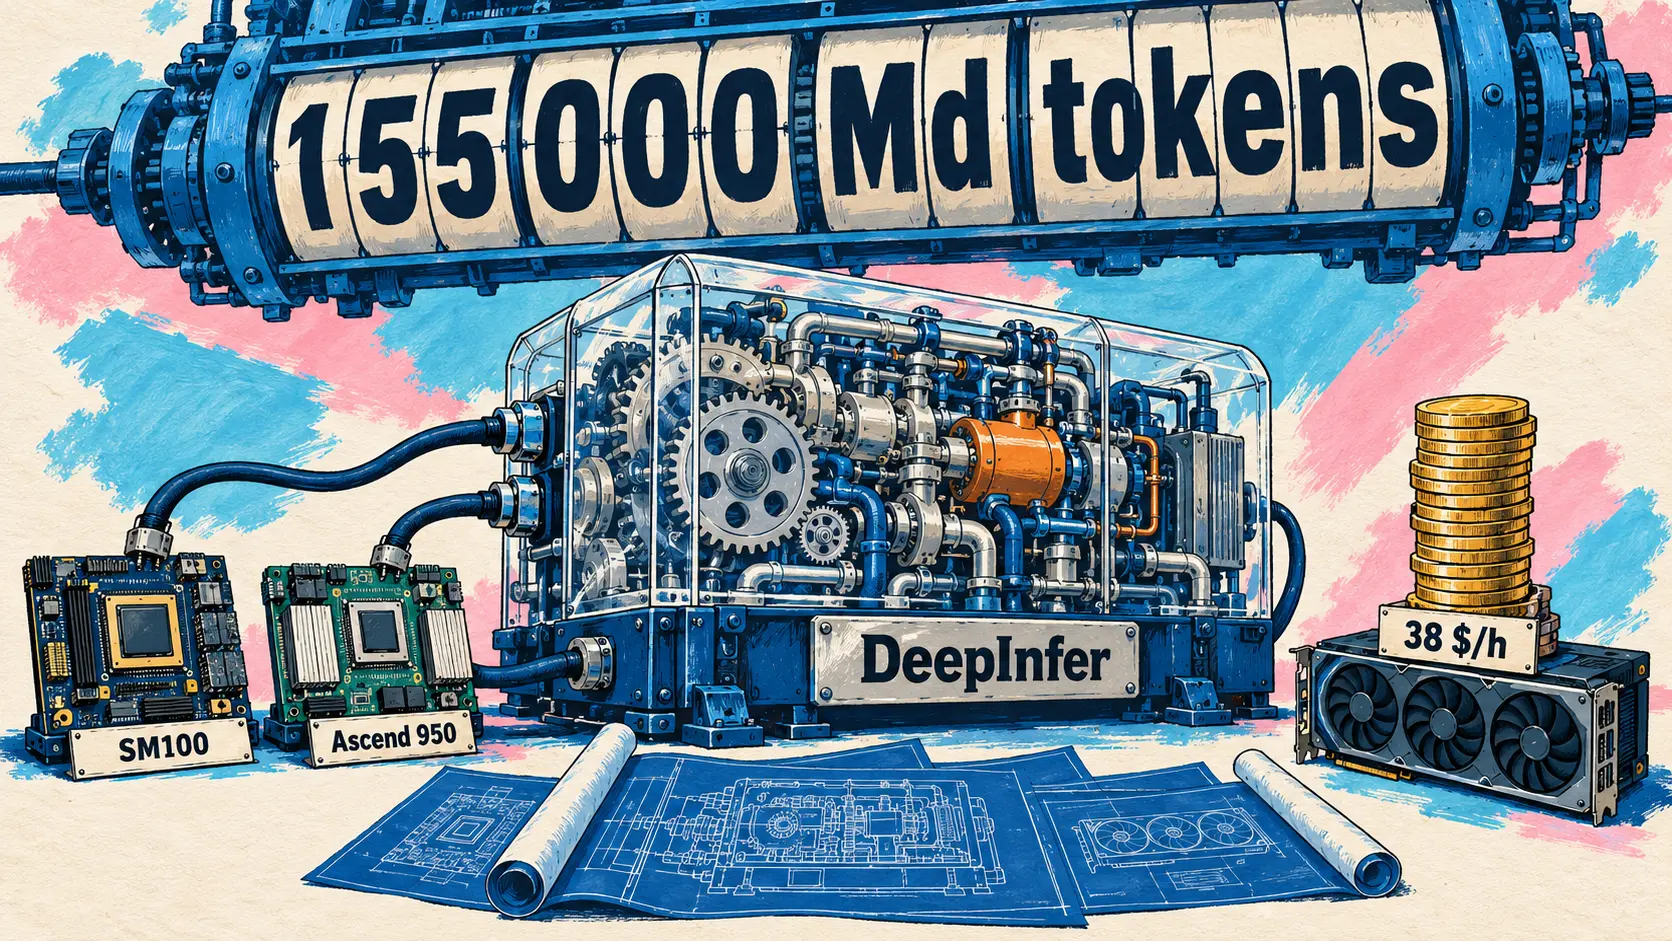
20 oktober — DeepSeek släpper DeepInfer som open source under licensen Apache-2.0, det egenutvecklade inferensramverket (inference framework) som kör DeepSeek-V4.1-Flash i företagets tjänster. Den publicerade versionen är avsedd för offlineinferens och stöder endast denna modell, på NVIDIA SM100-GPU:er och Huawei Ascend 950-NPU:er. Den bygger på komponenterna från produktionsmiljön: kernelbiblioteken som DeepSeek redan har publicerat (FlashMLA, DeepGEMM, DeepEP, TileKernels, DeepSelect) och TileLang-kernels, expertparallellism med lastbalansering för MoE-delen, egenutvecklad spekulativ avkodning (DSpark), en begränsad återspelning av det glidande attention-fönstret som avlastar prefill, samt strukturerade utdata via reguljära uttryck, JSON-schema eller EBNF-grammatik.
DeepSeek öppnar samtidigt koden till deepseek-recipe (MIT-licens), produktionskomponenten som omvandlar förfrågningar från API:erna Messages, Chat Completions och Responses till tokens för DeepSeek V4 och V4.1, och sedan modellens utdata till svar. Logiken överensstämmer med det officiella API:ets: en extern driftleverantör får samma beteende för resonemangsläget, verktygsanrop och strukturerade utdata. Projektets FAQ om driftsättning visar tjänstens omfattning:
| Produktionsuppgift publicerad av DeepSeek | Publicerat värde |
|---|---|
| Tokens som levereras av ett enda kluster | 155 000 miljarder per dag |
| Total intäkt till lågtrafikpriset | 38 dollar per GPU-timme |
| Prefill | vanliga maskiner med 8 GPU |
| Avkodning | supernoder med 64 till 128 GPU |
| Lagring av KV-cache | mer än 72 timmar |
Allt är inte öppet. Hanteringen av KV-cache och lastbalanseringen mellan repliker, som enligt DeepSeek är alltför knutna till den interna infrastrukturen, förblir slutna och beskrivs bara i ett inlägg på Zhihu. Uppdelningen mellan bildkodare, prefill och avkodning tillhandahålls inte heller. Genomströmningsmätningarna publiceras endast som diagram. DeepInfer byggdes från början främst på vLLM, med inspiration från SGLang och TensorRT-LLM, och kommer även att innehålla inferenskoden för DeepSeeks framtida modeller; projektet hade 11 562 stjärnor samma kväll.
🔗 Tråden från @deepseek_ai · DeepInfer på GitHub · deepseek-recipe på GitHub
Voxtral 3: Mistral lanserar modeller för transkribering och talsyntes samt ett SDK för röstagenter
20 oktober — Mistral lanserar Voxtral 3, en familj av modeller för transkribering (speech-to-text) och talsyntes (text-to-speech), tillsammans med ett SDK för att bygga röstagenter. Allt är tillgängligt från den 20 oktober i Mistrals API, via europeiska, amerikanska och globala endpoints samt i testmiljöerna (playgrounds) i Studio; driftsättning på plats eller i ett privat moln erbjuds på begäran.
| Voxtral 3-modell | Avsedd användning | Angivet pris |
|---|---|---|
| Voxtral Small Transcribe 3 | Mest exakt transkribering, talarseparering | 0,004 dollar per minut |
| Voxtral Mini Transcribe 3 (4B) | Transkribering i batch, talarseparering | 0,0035 dollar per minut |
| Voxtral Mini Transcribe Realtime 3 | Transkribering i realtid, mindre än 500 ms | 0,008 dollar per minut |
| Voxtral Speech 3 | Talsyntes, i batch och i realtid | 13 dollar per miljon tecken |
Transkriberingen omfattar 50 språk, däribland Europeiska unionens 24 officiella språk. Den skiljer talarna åt (talarseparering), tar emot nyckelord för att bättre känna igen facktermer utan finjustering (fine-tuning) (kontextstyrning, context biasing) och upptäcker när någon har talat färdigt. För 45 språk i testsviten FLEURS publicerar Mistral följande ordfelfrekvenser, med språket antingen angivet för modellen eller identifierat automatiskt:
| Utvärderad modell (FLEURS, 45 språk) | Språk angivet för modellen | Språk identifierat automatiskt |
|---|---|---|
| Voxtral Small Transcribe 3 | 4,0 % | 4,1 % |
| Microsoft AI Transcribe 2 | 4,0 % | 4,1 % |
| Voxtral Mini Transcribe 3 | 4,5 % | 4,6 % |
| Gemini 3.5 Transcribe | 4,5 % | 6,1 % |
| Scribe v2 | 4,9 % | 4,9 % |
| GPT Transcribe | 5,6 % | 6,3 % |
| Whisper large-v3 | 14,9 % | 16,0 % |
Mistral uppger att Small-modellen är bättre än Whisper, Scribe v2 och Gemini 3.5 Transcribe, men företagets eget diagram placerar Microsoft AI Transcribe 2 på samma nivå. I realtid, med en fördröjning på 480 ms, når Mini-modellen 6,4 % för 35 språk, sämre än Gemini 3.5 Realtime Transcribe (4,2 %) och Microsoft AI Transcribe 2 Streaming (5,8 %), men bättre än GPT Live Transcribe (8,4 %) och Scribe v2 Realtime (8,7 %).
Voxtral Speech 3 talar över 35 språk och över 50 dialekter, härleder känsloläge och tempo ur samtalets sammanhang eller följer uttryckliga instruktioner rad för rad, och Pro Voice återskapar en professionell röst utifrån 30 minuters ljud; enligt Mistral kostar den mindre att köra än jämförbara modeller från OpenAI, Deepgram, ElevenLabs och Google.
SDK:et för röstagenter, som bygger på LiveKit, kopplar samman tre modeller i ett strömmande flöde: realtidsmodellen lyssnar och upptäcker meningens slut, en generell modell som Mistral Small resonerar och anropar verktyg, och sedan svarar Voxtral Speech 3. Inget steg väntar på det föregående: varje samtalstur slutförs på mindre än en sekund enligt Mistral, agenten tystnar när den avbryts, ringer samtal via SIP eller WebRTC, och varje steg förblir en utbytbar modell. Till skillnad från Voxtral Transcribe 2 (februari) och Voxtral TTS (mars) har Voxtral 3 inte presenterats med öppna vikter: inlägget erbjuder Mistrals API eller driftsättning på egen infrastruktur, som ordnas tillsammans med Mistrals team, och inget projekt fanns på Hugging Face på lanseringskvällen.
🔗 Mistrals inlägg · Tråden från @MistralAI
Eleven Realtime: ElevenLabs samlar röstagenten i en enda modell för tal till tal
20 oktober — Samma dag som Voxtral 3 väljer ElevenLabs den motsatta metoden. Medan Mistrals SDK kopplar samman tre separata och utbytbara modeller samlar varje Eleven Realtime-modell hela röstagenten i en enda modell för tal till tal (Speech to Speech): taligenkänning, detektering av röstaktivitet, turtagning, LLM och talsyntes optimeras tillsammans som en helhet. Modellerna talar över 90 språk och kan använda de över 17 000 rösterna i ElevenLabs bibliotek.
Två versioner släpps. Eleven Realtime v1 Mini, standardmodellen, riktar sig till samtal till låg kostnad (assistenter, lärare, interaktiva karaktärer). Eleven Realtime v1 Max resonerar innan den svarar och är avsedd för komplexa uppgifter, som kundsupport eller arbetsflöden i flera steg med verktygsanrop; den kostar mer per token. De publicerade resultaten kommer från utvärderingar av Artificial Analysis som ElevenLabs hänvisar till:
| Mått (Artificial Analysis, enligt ElevenLabs) | Eleven Realtime v1 Max | Eleven Realtime v1 Mini |
|---|---|---|
| Big Bench Audio (1 000 frågor ställda högt) | 98,8 % | 75,9 % |
| Genomsnittlig fördröjning innan talet börjar | 0,57 s | 0,62 s |
| Full-Duplex-Bench (pauser, avbrott) | 94,1 % | 95,8 % |
| Uppgifter med verktyg som slutförts | 87,1 % | 60,3 % |
Enligt ElevenLabs är ingen modell i Artificial Analysis rankning både snabbare och mer exakt än v1 Max. Mini hanterar samtalsdynamiken något bättre, men Max drar ifrån när det gäller uppgifter med verktyg.
I ElevenAgents räcker det att ändra en agents röstläge från ”Custom” till ”Realtime” för att behålla resten av plattformen: telefon, webb, WhatsApp och kontaktcenter. Modellerna erbjuds också via ett Realtime-API som är kompatibelt med OpenAI:s: en utvecklare som redan har en integration ändrar endpoint och modellnamn och behåller sin kod, enbart via WebSocket. Utrullningen sker stegvis mellan arbetsytor. Till skillnad från Max är Mini varken tillgänglig i läget Zero Retention eller under HIPAA, och inga prisbelopp anges: ElevenLabs tar det vanliga minutpriset för ElevenAgents plus tokens till priset för den valda modellen.
ElevenLabs ansluter sig därmed till de heltäckande röstmodeller som redan erbjuds av OpenAI (GPT-Live-1, för 0,05 dollar per minut i API:et sedan den 10 september), Google (Gemini 3.8 Live) och SpaceXSI (Grok Voice 3.0).
🔗 ElevenLabs inlägg · Dokumentationen för Realtime-modellerna
Perplexity Computer körs helt lokalt på Mac, inklusive modellen
20 oktober — Perplexity kör sin agent Computer helt på Mac: modellen, körmiljön (harness) och utförandet av uppgifter stannar på datorn.
Perplexity Computer can now run fully local on your Mac. Work with your native Mac apps and local files, and run tasks without sending sensitive data to the cloud. The model and the agent both run on your Mac. Available now in the Perplexity Mac app.
🇸🇪 Perplexity Computer kan nu köras helt lokalt på din Mac. Arbeta med dina nativa Mac-appar och lokala filer och utför uppgifter utan att skicka känsliga data till molnet. Både modellen och agenten körs på din Mac. Tillgängligt nu i Perplexitys Mac-app. — @perplexity_ai på X
| Del av lanseringen | Detalj enligt Perplexity |
|---|---|
| Lokala modeller | Qwen 3.6 och PPLX Pro |
| Rekommenderat minne | 36 Go enhetligt minne eller mer |
| Datorer som omfattas | Mac-datorer med Apple silicon som stöds, som nya Mac mini med M6 och M5 Pro |
| Abonnemang som omfattas | Pro, Max och Enterprise |
| Computer-krediter | förbrukas inte av lokala uppgifter |
| Användning av molnet | med tillstånd, till över 15 frontiermodeller |
Med användarens tillstånd arbetar agenten med lokala filer och i appar som Notes, Messages, Mail eller Numbers. PPLX Pro är enligt Perplexitys tweet företagets eftertränade version av Qwen 3.8; på frågan om storleken svarar Perplexitys chef Aravind Srinivas att det är en tät modell med 27 miljarder parametrar, och han bedömer att 36 Go minne kommer att bli vanligt.
Mac-appen erbjuder nu två sätt att starta Computer. Hybrid Compute, som lanserades den 1 september, utgår från molnet för informationssökning och resonemang och bearbetar privata filer lokalt; det nya läget utgår från Mac-datorn, som behåller planering, resonemang och filbearbetning. Om användaren tillåter det använder agenten molnet för aktuell information, webbnavigering eller anslutna appar, och både kod och verktyg körs i isolerade sandlådor med samma säkerhetsprotokoll som molnversionen. Perplexity nämner tre användningsområden: en genomgång av en portfölj utifrån privata innehav, ett affärsförslag byggt på konfidentiella anteckningar och en lista över morgonens prioriteringar hämtad från Messages och Mail.
Det är Mac-motsvarigheten till Portable Computer, den helt lokala versionen som lanserades den 25 augusti på DGX Spark och sedan utökades i september till Linux, Windows och PC-datorer med AMD Ryzen AI Max-processor.
PyTorch på andra chip än NVIDIA:s GPU:er: TorchTPU som open source, inbyggt TPU-stöd hos Hugging Face och MPS i PyTorch 2.15
Tre av dagens tillkännagivanden får PyTorch att köras på andra chip än NVIDIA:s: Google släpper TorchTPU på PyTorch Conference, Hugging Face integrerar det samma dag i sina bibliotek, och Hugging Faces PyTorch-team beskriver vad PyTorch 2.15 tillför på Mac.
TorchTPU: Google öppnar sin stack med inbyggt PyTorch-stöd för TPU, med vLLM, SGLang, TorchTitan och llm-d 1.0
20 oktober — Google släpper TorchTPU som open source, sin stack med inbyggt PyTorch-stöd för TPU, utvecklad tillsammans med Metas PyTorch-team. TPU blir en PyTorch-enhet som alla andra (torch.device("tpu")): man felsöker med direkt exekvering (eager) och går sedan till produktion med torch.compile, som kompilerar via XLA. Hittills behövde man skriva om sin kod i JAX eller använda gamla torch_xla.
Två inferensmotorer bygger på TorchTPU: vLLM-TorchTPU, utvecklad med Inferact, och SGLang-TorchTPU, med RadixArk, som redan används i produktion hos Meta. Google uppger 2,01 amerikanska cent per miljon tokens i SemiAnalysis rankning InferenceX, med Qwen 3.5 på Ironwood, och över 700 tokens per sekund för en enda användare på Kimi K3, en modell med 2 800 miljarder parametrar. För träning når TorchTitan på TPU upp till 52 % beräkningsutnyttjande (Model FLOPs Utilization) på Qwen 3 8B, med tester på upp till 8 192 Ironwood-kretsar. Google släpper också llm-d 1.0, en Kubernetes-stack för distribuerad modellservering som skapats tillsammans med Red Hat och IBM: för en arbetslast med agentbaserad kodning minskar mediantiden till första token med över 85 % och genomströmningen ökar med en faktor 2,4 jämfört med en enkel Kubernetes Service.
🔗 Google Clouds blogginlägg · Motorerna vLLM och SGLang på TPU · llm-d 1.0
Hugging Face ger TPU inbyggt stöd i Transformers, Diffusers och Kernels
20 oktober — Hugging Face integrerar TorchTPU i sitt ekosystem: TPU blir en enhet som alla andra, utan att gå via PyTorch/XLA eller JAX, och Optimum TPU, det lager som Hugging Face hittills underhållit, behövs inte längre för Transformers och Diffusers. I Transformers räcker det att ladda en modell med device_map="tpu"; i Diffusers räcker ett pipe.to("tpu"), med valfri kompilering och tensorparallellism för att fördela stora modeller över flera kretsar.
| Fall som Hugging Face mätt | Publicerat resultat |
|---|---|
| Qwen-Image-2.1, bild 1024 × 1024 i 40 steg (TPU v6e-4) | 3,5 s kompilerat, 8,0 s utan kompilering |
| MiniMax-H3, video med ljud på 5,2 s (TPU v6e-4) | 188 s kompilerat, 262 s utan kompilering |
| Avkodning av Qwen3-30B-A3B, batch på 64, Tokamax-kernel (v6e-8) | 21,5 gånger snabbare |
| Godkända Transformers-tester på TPU | 96,5 % |
Teamet har rapporterat 34 problem till TorchTPU-projektet, varav 19 redan har åtgärdats, och förbereder nattlig CI på TPU. Det är den andra backend med inbyggt PyTorch-stöd för en accelerator från en annan tillverkare än NVIDIA som Hugging Face integrerar på två dagar, efter TorchNeuron för AWS Trainium dagen före.
🔗 Hugging Faces blogginlägg om TorchTPU
PyTorch 2.15 ger Mac FP8 och gör avkodning av MoE upp till 6,5 gånger snabbare
20 oktober — Hugging Faces PyTorch-team, som arbetar med MPS, GPU-backend för Mac med Apple silicon, beskriver vad PyTorch 2.15 tillför, fortfarande som release candidate. FP8 kommer till Mac, med en byte per värde, hälften så mycket som BF16, och direkt multiplikation på GPU:n. Tack vare inbyggd grupperad matrismultiplikation blir avkodningen av MoE-modeller 5 till 6,5 gånger snabbare än i 2.14.
| Mätning på Mac | Med PyTorch 2.14 | Med PyTorch 2.15 |
|---|---|---|
| Avkodning av Qwen3.6-35B-A3B på M3 Ultra | 9,4 tokens/s | 61,3 tokens/s |
| Avkodning av LFM2.5-8B-A1B på M3 Ultra | 23,6 tokens/s | 123,6 tokens/s |
| Softmax FP32 på 128 256 logits | 57 µs | 7 µs |
| Drivrutinens maximala minnesanvändning, VAE för Wan2.2 | 270,1 Gio | 8,1 Gio |
VAE-kodaren i Qwen-Image-2.1, som skadade bilder på MPS utan att signalera något fel, har åtgärdats. PyTorch 2.15 kräver macOS 15 och Python 3.11, och en förhandstitt på 2.16, som fortfarande kan ändras, utlovar attention helt skriven i Metal.
🔗 Hugging Faces blogginlägg om MPS
Säkerhet i open source-programvara: den första lägesrapporten från OSS Scanner och GitHubs paketbrandvägg
Två tillkännagivanden tar sig an båda ändarna av leveranskedjan för open source-programvara: att hitta sårbarheter i projektens kod och att filtrera paket när de installeras.
OSS Scanner: 114 antagna projekt, 77 kritiska sårbarheter och 803 med hög allvarlighetsgrad rapporterade, en sårbarhet i curl åtgärdad
19 oktober — Elva dagar efter lanseringen presenterar OSS Scanner sina första siffror. Det är Anthropics kostnadsfria tjänst som låter företagets kraftfullaste modeller skanna kritiska open source-projekt. I en tråd som delades av @ClaudeDevs samma kväll räknar tjänstens produktchef Punit Shah till omkring 650 sökande projekt och 114 antagna. Skanningarna har redan rapporterat 77 kritiska sårbarheter och 803 med hög allvarlighetsgrad till projektens underhållare, enligt modellens allvarlighetsbedömning, trots att alla projekt ännu inte har skannats.
Det exempel som lyfts fram är curl: sårbarheten CVE-2026-92392, användning av minne efter frigöring (use-after-free) vid en överföring via HTTP/2, som hittades med en tidig version av OSS Scanner, åtgärdades i curl 8.23.0 den 14 oktober. Curls säkerhetsmeddelande klassar den som hög allvarlighetsgrad för versionerna 8.12.0 till 8.22.0 och tillskriver rapporteringen ”Luna with Claude, Anthropic”. En annan lärdom: de flesta av de första rapporterna, som skickades via e-post med tillhörande proof of concept, avvisades eftersom e-postfiltren troligen uppfattade dem som skadlig programvara. Anthropic testar därför leverans via GitHub Security Advisories; över 150 projekt väntade fortfarande på ett beslut, enligt en uppskattning av Punit Shah.
🔗 Punit Shahs tråd · Curls säkerhetsmeddelande
GitHub filtrerar i en förhandsversion de npm-paket som Actions-runners och kodagenter installerar
20 oktober — GitHub öppnar en offentlig förhandsversion av en paketbrandvägg (package firewall). Utgångspunkten är att allt fler attacker utnyttjar själva paketinstallationen för att samla in inloggningsuppgifter från CI/CD-värdar eller utvecklares datorer, utan att ens köra paketets kod. Brandväggen placeras mellan GitHub Actions körmiljöer (runners) eller kodagenter och upstream-registren, och granskar både metadataförfrågningar och nedladdningar.
| Viktig punkt om brandväggen | Vad förhandsversionen omfattar |
|---|---|
| Tillgängliga kontroller | Karenstid, varningar från GitHub Advisory Database, nedgraderingar av attesteringar |
| Berörda kunder | GitHub Enterprise Cloud, inklusive dataresidens |
| Ekosystem som stöds | Enbart npm för tillfället |
| Pris | Gratis under förhandsversionen, därefter användningsbaserad debitering, som GitHub Actions |
Kodagenter och CI/CD-värdar måste konfigureras för att gå via brandväggen i stället för att fråga registren direkt, och det går att begära undantag för ett paket som blockerats felaktigt.
Assistenter: låsta chattar i ChatGPT, Gemini för småföretag och för amerikanska myndigheter
OpenAI och Google lägger till funktioner i sina assistenter för specifika behov: att hålla en konversation privat i ChatGPT samt stöd för småföretag och amerikansk offentlig förvaltning i Gemini.
ChatGPT döljer konversationer bakom en 4-siffrig PIN-kod
20 oktober — ChatGPT inför låsta chattar (locked chats): en vald konversation finns kvar i kontot men försvinner från historiken, fästa chattar och sökningen. Den flyttas till området Locked chats i Projects, som öppnas med en 4-siffrig PIN-kod för kontot eller, på mobilen, med Face ID, Touch ID eller Android-enhetens upplåsning. Funktionen rullas gradvis ut på webben, iOS, Android och den nya skrivbordsappen för macOS och Windows, från Free till Pro samt i Business, Enterprise och Edu, men inte i ChatGPT for Healthcare.
OpenAI förtydligar begränsningarna: låsningen ger varken totalsträckskryptering eller ett separat valv och ändrar inte lagringstiden. Om en bortglömd PIN-kod återställs raderas alla låsta chattar och filerna de skyddar permanent. I företag finns låsta chattar kvar i loggarna i OpenAI Compliance Platform, och administratörer kan varken inaktivera funktionen eller låsa upp en chatt. Codex-konversationer, tillfälliga chattar och gruppchattar kan inte låsas.
🔗 Versionsinformationen för ChatGPT · Guiden till låsta chattar
Gemini-appen öppnar ett utrymme för småföretag
20 oktober — Google lägger till en startsida för småföretag i Gemini-appen, presenterad som en gemensam ingång för att bygga sitt varumärke, analysera sin ekonomi och förstå sina kunder bättre; enligt Google använder redan tiotals miljoner småföretagare Gemini. För bildmaterial lägger företagaren till sin webbplats, sin grafiska profil, sina typsnitt eller sina färger: Gemini använder Nano Banana 2.1 för att skapa bilder för en lansering eller kampanj och behåller stilen utan någon ny uppladdning. För ekonomin förvandlas röriga kalkylblad, kvitton eller köphistorik på några sekunder till diagram och interaktiva modeller.
Gemini ansluter till Google Business Profile, Google Ads och Google Workspace samt till Adobe, Canva, Dropbox, Shopify, Wix, Zoho och Xero. Bland användarberättelserna säger en keramiker i Bordeaux (Bleu Clémentine) att hon sparar två till tre timmar om dagen. Utrullningen börjar ”de kommande dagarna”, i hela världen och för alla som använder appen.
Gemini for government services: Gemini-agenten i förhandsversion för amerikanska myndigheter
20 oktober — Google Cloud anpassar Gemini-agenten som presenterades i början av oktober på Gemini at Work för den offentliga sektorn: Gemini for government services finns som förhandsversion för amerikanska myndigheter på federal, delstatlig och lokal nivå, meddelar Google Clouds chef Thomas Kurian. Erbjudandet samlar skills som tillämpar myndigheternas lagar, regler och instruktioner, anslutningar till deras system där frågor körs på plats utan datamigrering, partneragenter, däribland från SZNS Solutions, ett gemensamt kontrollplan för säkerhet och regelefterlevnad samt ett nätverk av 13 systemintegratörer.
Google nämner sju användningsområden, från efterforskning om regelverk med hänvisningar ända ned på styckenivå till maskning av dokument före publicering, liksom begäranden om tillgång till myndighetshandlingar (FOIA) och granskning av bidragsutgifter. Anslutningarna omfattar Federal Register, regulations.gov och eCFR, Oracle, Salesforce, ServiceNow, Google Workspace och Microsoft 365. Google arbetar med delstaten Missouri och USA:s hälso- och socialdepartement (HHS), och erbjudandet kan driftsättas inom datagränsen FedRAMP High i Assured Workloads; varken pris eller datum för allmän tillgänglighet har meddelats.
Tillämpad AI: bindarproteiner utformade av Claude, rekommendationer från QD-Rec och Flora för robotar
Tre av dagens arbeten tillämpar modeller på ett specifikt problem: proteindesign mot gifter, beslutsstöd och annotering av videor för att träna robotar.
Claude utformar bindarproteiner mot skorpioners neurotoxiner: 17 validerade av 211 testade
20 oktober — Anthropic publicerar på sin Science-blogg en proteindesignkampanj som Claude genomfört mot fem skorpionneurotoxiner från fyra regioner, från Mexiko till Mellanöstern. En intern forskningsmodell, som används i Claude Science, återanvände prompten från en studie i augusti, anpassad tillsammans med Citrini Research, och arbetade sedan till stor del på egen hand, vägledd av fyra uppföljande instruktioner från teamet: 318 484 designförslag genererade med 12 verktyg och en slutlista på 180 designförslag på 64 timmar, med en beräkningsinsats på omkring 10 000 GPU-timmar. Adaptyv Bio och Twist Bioscience testade 211 designförslag, varav 31 lagts till av teamet. Med strikta kriterier binder 17 till sitt mål, vart och ett till endast ett toxin, och inget riktar sig mot det brasilianska toxinet Ts1. De två bästa, Cn2-B1 och Cn2-B2, binder till det mexikanska toxinet Cn2 med en affinitet på några nanomolar och verkar rikta sig mot samma bindningsställe som antikroppen LR, som neutraliserar toxinet hos möss.
This is exploratory work, and we’re not claiming to have produced an antivenom—for that, we’d have to test the binders within living cells, then in mice, among many other steps. But it’s an example of how Claude can concretely assist research in protein design.
🇸🇪 Det här är ett utforskande arbete, och vi hävdar inte att vi har tagit fram ett motgift: för det skulle bindarproteinerna behöva testas i levande celler och sedan hos möss, bland många andra steg. Men det är ett exempel på hur Claude konkret kan hjälpa forskningen inom proteindesign. — @AnthropicAI på X
De 211 designförslagen och tillhörande data har publicerats. En not medger att beräkningsinsatsen överstiger de flesta forskares resurser, men anger att en förenklad prompt, med en enda agent och en enda GPU under 24 timmar, når jämförbara in silico-resultat.
QD-Rec: Sakana AI låter varierade och underbyggda rekommendationer utvecklas genom evolution
20 oktober — Sakana AI presenterar QD-Rec, som tillämpar öppen sökning (open-ended search) och metoden kvalitet–mångfald (Quality-Diversity) på rekommendationer för beslutsstöd. I stället för att rangordna kandidater söker metoden efter par av kandidater och hypoteser: ett företag att köpa, en kund att kontakta eller en artikel att läsa, och texten som förklarar varför man bör välja just den. En kontextuell bandit väljer nästa kandidat genom att prioritera områden med låg täckning, en LLM skriver hypotesen genom att anpassa eller korsa de redan arkiverade hypoteserna, och ett arkiv uppdelat i nischer behåller nya motiveringar.
Vid tester på fusioner och förvärv, målgruppsinriktad marknadsföring och artikelrekommendationer, med Claude Sonnet 5 eller Claude Haiku 4.5 som förslagsgivare och gpt-5.6-terra som bedömare, får QD-Rec i de flesta fall den högsta genomsnittliga kvaliteten och det största arkivet efter 1 000 utvärderingar: för Walt Disney, 2,91 av 10 och 214 rekommendationer, jämfört med 2,40 och 85 utan evolution. Sakana förtydligar att dessa scenarier inte är investeringsråd och att en modell där angav en siffra som saknades i underlaget; koden publiceras under licensen Apache-2.0.
🔗 Sakana AI:s tekniska artikel
Flora: NVIDIA släpper vikterna till en modellsamling som annoterar videor för robotar
20 oktober — NVIDIA:s GEAR-labb släpper vikterna till Flora, en modellsamling som omvandlar råvideor med robotar eller människor till träningssignaler: tidsstämplade beskrivningar av handlingar, resultatbelöningar för att övervaka driftsättningar och processbelöningar för förstärkningsinlärning. Flora fungerar redan som datamotor för träningen av GR00T-modellerna och annoterar 200 000 timmar video per dag på 512 GB300-GPU:er. Enligt NVIDIA är den konkurrenskraftig med GPT-6 Astra till en cirka 125 gånger lägre kostnad, men den publicerade tabellen ger en mer nyanserad bild:
| Test och mått | Flora | GPT-6 Astra |
|---|---|---|
| DenseRewardBench, macro F1 (högre = bättre) | 46,2 | 40,7 |
| RoboReward, genomsnittligt absolutfel (lägre = bättre) | 40,0 | 55,4 |
| DenseCaptionBench Robot200, F1 för segmentering | 66,9 | 71,9 |
| WGO-Bench, träffsäkerhet (gold-window) | 64,7 | 77,4 |
Flora överträffar GPT-6 Astra på de flesta belöningsmått och på videor med människor, men ligger efter på videor med robotar, på två av de tre måtten i WGO-Bench, på korrelationen för Robometer utanför fördelningen och på RubricBench.
🔗 Projektsidan för Flora · Tråden från Jim Fan
Förvärv och partnerskap: OpenAI förvärvar Orchestra Bio, Runway ansluter sig till Claude Marketplace
Två av dagens affärshändelser: ett förvärv inom läkemedelsutveckling hos OpenAI och ett distributionsavtal mellan Runway och Anthropic.
OpenAI förvärvar Orchestra Bio för att koppla Rosalind till läkemedelsutveckling
20 oktober — OpenAI tillkännager förvärvet av Orchestra Bio, en plattform där människor och AI-agenter tillsammans driver läkemedelsprogram framåt: forskare och programansvariga delegerar uppföljningen av studier och försökskampanjer till agenterna. OpenAI ger ett exempel: en misslyckad tillverkningssats kan försena starten av en klinisk prövning; agenterna identifierar då berörda aktiviteter och tidsplaner, sammanställer informationen och jämför möjliga åtgärder, medan besluten ligger hos teamen.
Teamet och tekniken från Orchestra ansluter sig till Rosalind, OpenAI:s erbjudande för livsvetenskaperna: GPT-Rosalind för resonemang inom biologi och kemi, Rosalind Workbench för att koppla dessa förmågor till forskarnas verktyg och data. Det uttalade målet: agenter som kopplar upptäckter till studier, beslut och nästa steg för ett potentiellt läkemedel. OpenAI påminner om att det i USA i genomsnitt tar 10 till 15 år från upptäckten av en målstruktur till myndighetsgodkännande. Ingen köpesumma offentliggörs.
🔗 Tillkännagivandet från OpenAI
Runway Creative kommer till Claude Marketplace och kan betalas inom ramen för utgiftsåtagandet hos Anthropic
20 oktober — Runway ansluter sig till Anthropic:s Claude Marketplace med Runway Creative, sin plattform för generering och redigering av videor, bilder och ljud. Berättigade företagskunder kan använda en del av sitt utgiftsåtagande gentemot Anthropic för att köpa Runway, via sin kontaktperson hos Runway eller Anthropic; inga priser offentliggörs. Runway Creative samlar Gen-4.5, Aleph 2.0, Seedance 2.5, Kling 3.0 och ElevenLabs V4, och Claude står för resonemangsförmågan i Runway Agent, som omvandlar en förfrågan till ett bildmanus, väljer modell för varje tagning och sätter ihop videon. Animationer från Claude Motion, som är i beta på Claude Team och Enterprise, kan exporteras till Runway för att lägga till bilder, berättarröst och musik.
Runway uppger sig ha över 65 miljoner kreatörer, filmskapare och marknadsföringsteam. Det är motsvarigheten hos Anthropic till lanseringen av Runway Creative på OpenAI Marketplace den 29 september.
🔗 Tillkännagivandet från Runway
Att mäta modeller: MultiLangBench från OpenAI, FairStress från Ai2 och CALIBER från Cohere Labs
Tre forskningspublikationer utvärderar modeller ur tre perspektiv: kod i mindre utbredda språk, rättvisan i deras beslut och hur säkra de är på sina egna svar.
MultiLangBench: GPT-6 Astra bygger en SQLite-kompatibel motor på 20 språk, inklusive COBOL
19 oktober — OpenAI publicerar ett forskningsinlägg om resurssvaga programmeringsspråk (low-resource), som COBOL, Fortran eller Visual Basic, för vilka det finns mycket mindre kod och dokumentation än för Python, trots att de används för banksystem eller väderprognoser. Den första utvärderingen, MultiLangBench, som publiceras under licensen Apache-2.0, går ut på att från grunden bygga en databasmotor som är kompatibel med SQLite i ett av 20 språk, med verifiering genom tester anpassade från SQLite:s testsvit.
| Utvärderad modell (maximal ansträngning) | Genomsnitt över 20 språk | COBOL | Fortran | Visual Basic |
|---|---|---|---|---|
| GPT-5.6 Sol | 26,8 % | 10,9 % | 21,4 % | 27,5 % |
| GPT-6 Luna | 40,3 % | 17,1 % | 31,4 % | 41,6 % |
| GPT-6 Astra | 87,4 % | 72,1 % | 83,5 % | 89,4 % |
GPT-6 Luna kostar cirka 0,77 dollar per exempel, jämfört med 3,48 dollar för GPT-5.6 Sol. På en andra utvärdering, migrering av COBOL-program till C++, Java, Kotlin, Python eller Rust med identiska utdata byte för byte, klarar GPT-6.1 Sol 86,6 % vid låg ansträngning, jämfört med 5,4 % för GPT-5.6 Sol med samma inställning, och kostar 39 % mindre; vid högre ansträngning når den 97,9 %. OpenAI påminner om att en migrering till produktion fortfarande kräver expertgranskning.
🔗 Inlägget från OpenAI · MultiLangBench på GitHub
FairStress: Ai2 mäter demografisk rättvisa bortom det slutliga svaret
20 oktober — Ai2 publicerar FairStress, ett test som utvärderar modellernas demografiska rättvisa bortom deras slutliga val: det mäter också hur lätt en modell överger ett välgrundat beslut inför ett övertalande argument och hur den motiverar det. Testet omfattar 300 beslutsscenarier med två kandidater inom 29 områden, från rekrytering till bostäder, med varianter som ger över 13 miljoner testfall.
Utan demografisk information beter sig modellerna symmetriskt. För 15 modeller når den genomsnittliga skillnaden i benägenheten att överge ett bra svar 6,9 procentenheter med en implicit identitet och 9,3 procentenheter med en explicit etikett: modellerna överger oftare den bästa kandidaten när den kodas som tillhörande majoriteten, vilket Ai2 kallar en antistereotyp överkorrigering. Ledande modeller som Claude Opus 5 och GPT-5.5 väljer kandidaten som kodas som tillhörande minoriteten i ungefär 60 till 65 % av de tvetydiga fallen, och de flesta av de nio testade korrigeringsmetoderna minskar inte asymmetrin på ett tillförlitligt sätt. Ai2 preciserar att dess definition av rättvisa bygger på likabehandling; koden publiceras under MIT-licens.
CALIBER: Cohere Labs lär resonemangsmodeller att uppskatta sin säkerhet före och efter att de resonerat
20 oktober — Cohere Labs, Cohere:s forskningslabb, presenterar CALIBER (Calibration Before and After Reasoning), en metod som lär en resonemangsmodell att uppskatta sin sannolikhet att svara rätt vid två tillfällen: före resonemanget och sedan för det producerade svaret. Den inledande säkerheten tränas mot modellens andel lyckade svar vid flera försök på samma fråga (sju lyckade försök av tio ger ett målvärde på 70 %), den slutliga säkerheten mot huruvida svaret är korrekt.
På testet BigMathDigits sjunker det förväntade kalibreringsfelet (Expected Calibration Error, ECE) för modellen med 7 miljarder parametrar från 0,059 för den bästa metoden med ett enda säkerhetsvärde till 0,028, en minskning med 52,5 %; utan ytterligare träning når minskningen 26,8 % på GPQA, 32,2 % på TriviaQA och 36,2 % på SimpleQA. Modellen med 30 miljarder parametrar nyanserar bilden: dess ECE (0,022) är bara marginellt bättre än för CoCA-lite (0,023). Användningen av dessa uppskattningar för att avgöra när modellen ska verifiera eller avstå har inte testats, och ingen produkt från Cohere har aviserats.
🔗 Inlägget från Cohere · Artikeln på arXiv
OpenAI:s API behåller prompts i cache i 12 timmar, till 2,5 gånger indatapriset vid skrivning
20 oktober — OpenAI:s API gör det nu möjligt att behålla en prompt i cache i 12 timmar, jämfört med 30 minuter som standard. Nyheten riktar sig till beständiga agenter, som OpenAI:s dots, som återanvänder samma instruktioner, verktyg och kontext hela dagen: förfrågningar med flera timmars mellanrum får fortfarande det lägre priset för tokens i cache. Inställningen görs via parametern prompt_cache_options.ttl i Responses API, för GPT-5.6 och senare modeller, och de två tidsperioderna kan kombineras i samma förfrågan: 12 timmar för gemensamma instruktioner, 30 minuter för den senaste delen av konversationen.
| Pristyp (GPT-5.6 och senare) | Multiplikator för priset på indata utan cachelagring |
|---|---|
| Skrivning till cache, 30 minuter (standard) | 1,25 |
| Skrivning till cache, 12 timmar (Responses API) | 2,5 |
| Läsning från cache | 0,1 (0,05 för GPT-6.1 Sol) |
För en kontext som återanvänds hela dagen uppskattar OpenAI att besparingarna vida överstiger merkostnaden för skrivning.
🔗 Guiden till cachelagring av prompts · Tråden från @OpenAIDevs
Kodagenter: Claude Code 2.1.304, Copilot CLI 1.0.101, Vibe CLI 3.0.1 och Devin Fusion
Tre CLI för kodagenter släpper versioner med fokus på behörigheter och tillförlitlighet, och Cognition mäter sig med Claude Code på ett oberoende index.
Claude Code 2.1.304: /claude-api managed-agents-secure, varning före ett kostsamt återupptagande och 43 korrigeringar
19 oktober — Claude Code 2.1.304, publicerad på GitHub klockan 21.34 UTC, har 76 poster, varav 43 korrigeringar. Det nya kommandot /claude-api managed-agents-secure jämför inställningarna för en agent i Claude Managed Agents med den säkerhetsguide som Anthropic har publicerat, utan att ändra något. Pro- och Max-prenumeranter får en varning när ett återupptagande av en inaktiv konversation skulle förbruka en betydande del av deras användningsgräns för fem timmar och kan i stället öppna en ny konversation där Claude kan hitta den gamla. /auto-mode-setup kommer till Bedrock, Vertex, Foundry och gatewayen för Claude apps.
Flera korrigeringar skyddar användarens arbete: claude --worktree tar inte längre bort en worktree och dess gren utan att fråga när HEAD var frikopplat eller pekade på en annan gren, vilket kunde leda till förlorade commits, och en rm -r på en monterad disk utlöser nu säkerhetsfrågan. Verktygssökning aktiveras som standard bakom ett anpassat ANTHROPIC_BASE_URL, och Code Review kan granska alla repon i en organisation på GitHub, inklusive dem som läggs till senare.
🔗 Versionsinformationen för Claude Code 2.1.304
Copilot CLI 1.0.101: inbyggda strukturerade utdata för underagenter och instruktioner för behörighetsbedömaren
20 oktober — GitHub släpper Copilot CLI 1.0.101 som stabil version, dagen efter 1.0.100; dess 30 poster kommer från två förhandsversioner som släppts däremellan. Två tillägg inleder listan: inbyggda strukturerade utdata för underagenter i dynamiska arbetsflöden (dynamic workflows), på modeller som stöder det, och en inställning assistedApprovalInstructions som styr besluten om bekräftelse hos bedömaren i Assisted Permissions.
Behörigheterna blir mer begripliga: godkännandefrågorna förklarar orsaken till en eskalering och föreslår ett diagnostikkommando anpassat till förfrågan, och ett shell-kommando som skapar och sedan öppnar en mapp begär ett godkännande av sökvägen i stället för att avslås direkt. För företag installeras plugins som har tilldelats ett Team från de marknadsplatser på GitHub som tillhör detta Team, och modellväljaren markerar modellen som administratören har bestämt som standard. Under macOS ansluter sandlådan direkt till lokala TCP-tjänster när lokal åtkomst är öppen, och lokala modeller i providers.json blockerar inte längre Auto-läget.
🔗 Versionsinformationen för Copilot CLI 1.0.101
Vibe CLI 3.0.1: Python 3.12 återkommer och administratören kan förbjuda YOLO-läget
20 oktober — Dagen efter Vibe CLI 3.0.0 släpper Mistral utan tillkännagivande 3.0.1: 58 poster, varav 9 tillägg, 15 ändringar och 34 korrigeringar. Den river upp ett beslut från 3.0.0: Vibe fungerar åter med Python 3.12 och senare i stället för att kräva Python 3.14. En ny administratörsinställning, enable_auto_approve, förbjuder läget för automatiskt godkännande som kallas ”YOLO”: agenten auto-approve försvinner och alternativen --auto-approve, --yolo och bypass_tool_permissions ignoreras, medan behörigheterna för varje verktyg fortsätter att tillämpas.
Underagenter följs upp bättre: vibe -p väntar på dem som en omgång har lämnat igång, och exporten redovisar deras status, modell, användning och kostnad, där var och en debiteras enligt priset för sin egen modell. Det experimentella kommandot vibe run-server kör många icke-interaktiva sessioner i en enda process, och ett svar som har kapats vid gränsen för utdatatokens begärs på nytt upp till sex gånger.
🔗 Versionsinformationen för Vibe CLI 3.0.1
Devin Fusion: 68,2 på Coding Agent Index, till en kostnad per uppgift som är 31 % lägre än för Claude Code med Opus 5.5
19 oktober — Cognition lyfter fram resultatet för Devin Fusion, dess ramverk som kombinerar en huvudmodell och en hjälpmodell (sidekick), på Coding Agent Index från Artificial Analysis, ett oberoende index som betygsätter kodagenter på tre utvärderingar med lika vikt:
Devin Fusion has claimed a top score of 68 on the @ArtificialAnlys Coding Agent Index with an Opus 5.5 lead and GPT-6 Luna sidekick. Devin Fusion outperforms Claude Code with Opus 5.5 on both performance and price – earning a score of 68 at a 31% lower cost per task.
🇸🇪 Devin Fusion får ett av de högsta resultaten, 68, på Coding Agent Index från @ArtificialAnlys, med Opus 5.5 som huvudmodell och GPT-6 Luna som hjälpmodell. Devin Fusion överträffar Claude Code med Opus 5.5 både i prestanda och pris, med ett resultat på 68 till en kostnad per uppgift som är 31 % lägre. — @cognition på X
Uppgifterna i indexet bekräftar kostnadsskillnaden; Devin Fusion ligger där på andra plats bland 42 konfigurationer:
| Utvärderad konfiguration | Resultat i indexet | Genomsnittlig kostnad per uppgift |
|---|---|---|
| Claude Code, Sonnet 5.5 (max) | 68,4 | 14,19 dollar |
| Devin Fusion CLI, Claude Opus 5.5 Max + GPT-6 Luna High | 68,2 | 9,02 dollar |
| Claude Code, Opus 5.5 (max) | 66,0 | 13,04 dollar |
Muse Code med Muse Wonder Full följer på 68,0. Devin Fusion leder tydligt på DeepSWE v1.1 (72,6 mot 68,4) och på SWE-Atlas-QnA (69,4 mot 66,4), men Claude Code med Opus 5.5 behåller försprånget på Terminal-Bench v4 (63,1 mot 62,6). Cognition publicerar inget nytt inlägg.
🔗 Coding Agent Index från Artificial Analysis
Notiser
Agenter och kodverktyg
- Devins versionsinformation från den 19 oktober — Devin kontrollerar nu CI-statusen för en commit, en branch eller en tag, och inte längre bara för en pull request, på GitHub, GitLab, Azure DevOps och Bitbucket; Devin Review får en regelredigerare och en Review now-knapp, och minnets nattliga drömbearbetning (nightly memory dreaming) kan nu stängas av. 🔗 källa
- Agent Manager — Hugging Face släpper under Apache-2.0-licens en privat arbetsyta, driftsatt i ett Space, för att från webbläsaren styra tiotals Claude Code-, Codex-, Gemini CLI-, opencode- eller Hermes-agenter som kommunicerar med varandra och fortsätter köra medan man återupptar arbetet från en annan enhet. 🔗 källa
- Sökning efter MCP-verktyg hos Zed — Zed-teamet har jämfört 25 sätt att hitta rätt MCP-verktyg, däribland beslutsmodeller, LLM och inbäddningar (embeddings), på 150 frågor och 536 verktyg, och väljer en viktad BM25 med några normaliseringsregler, lokalt och utan API-anrop; inga detaljerade resultat eller någon berörd produkt anges. 🔗 källa
- Zed 1.24.4 och förhandsversionen 1.25.1 — Den stabila versionen rättar inläsningen av OpenCode-modeller; förhandsversionen lägger till HTML-syntaxmarkering för mallar taggade med svg, mathml och raw samt CSS-syntaxmarkering för mallar som skickas till css() i JavaScript och TypeScript; inget nytt för agenter. 🔗 förhandsversion 1.25.1 · 🔗 1.24.4
- v0 på iOS — v0:s iOS-app får Browser Use-annoteringar, presenterade i en tweet med video, utan funktionsbeskrivning eller post i v0:s ändringslogg. 🔗 källa
- Gemini CLI, nattversionen den 20 oktober — Efter tre tomma nattversioner kommer två rättningar: skärmuppdateringen tömmer inte längre terminalens rullningshistorik, eftersom /clear och Ctrl+L nu bara rensar det synliga området, och DevTools visar inte längre trasiga UTF-8-tecken som delats mellan två HTTP-paket; den stabila versionen v0.64.0 är oförändrad. 🔗 källa
- ZCode v3.16.2 — ZCodes open source-repo, kodmiljön från Z.ai, synkroniseras till v3.16.2 utan versionsinformation: hela sidopanelen visas i skrivbordsappen och på dess marknadsplats finns ett anet-plugin som överlåter uppgifter till andra agenter via A2A-protokollet. 🔗 källa
- mistral CLI 0.9.0 — Verktyget som driftsätter appar på Mistrals plattform lägger till
mistral upgrade, en experimentell driftsättning från disk utan någon pushad commit och, bakom en funktionsflagga,mistral apps listochlogs; en inkompatibel ändring är att token för ett privat register nu bara läses frånMISTRAL_REGISTRY_TOKENellerNODE_AUTH_TOKEN. 🔗 källa - API:et för Copilots modellpolicyer — REST-endpoints med GET och PATCH blir allmänt tillgängliga för att läsa och ändra tillåtna modeller på företagsnivå, för företagsteam, agentappar och organisationer, med möjlighet att delegera till organisationer eller team. 🔗 källa
Företag och användningsfall
- Inference hooks för Claude Enterprise — De har lämnat betastadiet och skickar transkriptionen av varje förfrågan till organisationens säkerhetsserver, som godkänner eller avvisar den innan den når modellen, inom 5 sekunder som standard, från claude.ai till Claude Code, Cowork, Claude Tag eller Claude in Chrome; varken Bedrock, Google Cloud eller API:et omfattas. 🔗 versionsinformation · 🔗 dokumentation
- Perplexity och Valarian — Tillsammans med detta brittiska företag för suverän infrastruktur kör Perplexity Computer på servrar hos reglerade institutioner, även i isolerade nätverk (air-gapped), med öppna modeller som Nemotron, GLM, Kimi, DeepSeek-R1 eller Qwen; driftsättning på begäran, utan angivna priser eller kunder. 🔗 källa
- IncidentWatch och IncidentSweep — SpaceXSI berättar hur två Grok Bots hanterar incidenter i företagets support: den ena upptäcker toppar i antalet ärenden var 5:e minut och larmar jouren, den andra stänger ärenden i omgångar som godkänts av en ingenjör, 204 på omkring tio minuter vid en incident den 18 september. 🔗 källa
- ChatGPT Work hos en franchisetagare — Ted Taylor, som driver tre Schlotzsky’s- och Cinnabon-restauranger i New Mexico, kortar tiden för att se över menypriserna från 5 dagar till 1 till 2 timmar och sin månatliga kassaavstämning från 3 timmar till 5 till 10 minuter, alltså 94 % mindre, enligt OpenAI:s fallstudie. 🔗 källa
- Tre Java Champions och Copilot — På GitHub Blog berättar Vlad Mihalcea, Patrick Baumgartner och Frank Delporte om hur de använder Copilot, från att migrera omkring 900 presentationsbilder till Marp på åtta till tio timmar till en pull request från kodagenten för en bugg i Pi4J, framtagen på en halvtimme. 🔗 källa
- Hippolyte.ai och ElevenLabs — Den franska rekryteringsplattformen har genomfört 4 830 röstbaserade urvalsintervjuer på tre veckor med ElevenLabs talsyntes, med röstbehandling inom Europeiska unionen, råinspelningar som raderas inom 24 timmar och en modell med öppna vikter som körs på egna servrar i Frankrike. 🔗 källa
- Replit i Japan — Replit öppnar ett kontor i Japan för att föra sitt erbjudande för att skapa appar och företagsagenter närmare japanska företag, med fyra evenemang i Tokyo den 5 och 6 november, däribland en workshop med Microsoft; ingen adress, personalstyrka eller något särskilt erbjudande för Japan anges. 🔗 källa
Rankningar och guider
- ClaimBench — Det nya benchmarktestet från Vals AI frågar om ett utdrag ur en 10-K-årsrapport stöder ett påstående, motsäger det eller inte säger något om det: pplx-decider-v1.2 från Perplexity leder bland beslutsmodellerna med 99,69 % för 0,000104 dollar per påstående, före Mercury Decide (99,08 %), med en av de högsta latenserna (1,23 s). 🔗 källa
- MiniMax M3.1 Flash hos Parallel — Parallel Web Systems placerar MiniMax modell, som lanserades dagen före, först i sin rankning för webbsökning vad gäller effektivitet, med prestanda nära DeepSeek V4.1 Flash till ungefär en tredjedel av kostnaden; rankningen kommer från en tredjepartsleverantör. 🔗 källa
- AI-gateways enligt Perplexity — En guide i avdelningen Idéer beskriver dessa proxyservrar mellan appar eller agenter och modellerna (routing, tokenbudgetar, semantisk cache, skyddsmekanismer) och hänvisar till ett test från Broadcom där en optimerad Envoy-gateway lägger till omkring 2 ms per förfrågan; ingen Perplexity-produkt presenteras. 🔗 källa
Skapande: bild, video och presentationer
- Fibo 2.0 från Bria — Diffusers stöder redan vid lanseringen denna bildredigeringsmodell med öppna vikter, presenterad som den första i sin kategori, som styrs med JSON, återger text korrekt och finns i varianterna Turbo och Dev, enligt Sayak Paul. 🔗 källa
- Art Style Match från Luma — Verktyget applicerar stilen från en till fyra referensbilder på en produktbild och behåller produkten och kompositionen på plats; det presenteras enbart i en tweet, utan artikel, modell eller pris. 🔗 källa
- HeyGen Video 1.0 på Design Arena — Enligt HeyGen placerar Design Arena företagets 1080p-modell, eftertränad på MiniMax H3, på tredje plats inom video och bild till video; HeyGen presenterar den för produktnärbilder och inklippsbilder. 🔗 källa
- Wan3.0 Prime på OpenRouter — Alibaba placerar denna snabba variant av Wan 3.0, från 0,068 dollar per sekund, överst i vyn Trending i OpenRouters videorankning, med omkring 3 000 förfrågningar (+85 %); Wan 3.0 ligger där på tredje plats. 🔗 källa
- TJ på GTC Berlin — Synthesia gör Jensen Huangs tecknade dubbelgångare till en interaktiv avatar, byggd på företagets video- och röstmodeller och dess Interactive Avatar API, som rekommenderar besökarna sessioner bland fler än 100 den 21 och 22 oktober. 🔗 källa
- Samskapande i Gemini Notebook — Pro- och Ultra-prenumeranter väljer tema, format, längd, språk och visuell stil och granskar sedan dispositionen för en presentation (Slide Deck) eller produktionsanteckningarna för en sammanfattande video (Video Overview) innan de startar genereringen; utrullningen fortsätter. 🔗 källa
Öppna modeller, forskning och hårdvara
- AnyLanguageModel 1.0 — Swift-paketet från Hugging Face ersätter Apples framework Foundation Models genom att byta en import, så att samma session kan köras med systemmodellen, öppna modeller via llama.cpp, MLX eller Core ML, eller hostade leverantörer som OpenAI, Anthropic eller Gemini. 🔗 källa
- Efterträna agenter med TRL — Hugging Face publicerar en genomgång i fem steg, från övervakad finjustering på agentspår till träning genom en riktig harness med AsyncGRPO, via destillering, GRPO och OpenEnv-miljöer; pedagogiskt material, utan någon ny produkt. 🔗 källa
- Nemotron 3.5 Super VL hos Thoughtworks — I sin andra rapport ser Thoughtworks att tre LoRA-adaptrar vinner mellan 5,42 och 9,41 poäng på reserverade data inom juridik och vård, utan någon betydande förbättring på det offentliga benchmarktestet CaseHOLD, och tar bort en domare vars utslag varierade med 35,1 poäng beroende på instruktionerna. 🔗 källa
- Mer detaljerade väderprognoser för Frankrike — På Hugging Faces blogg förfinar en U-Net med omkring 2 miljoner parametrar, tränad på en timme, upplösningen för temperaturprognoser från AIFS-ENS från 28 till 5,5 km: jämfört med Météo-Frances stationer minskar felet med 14 % (RMSE) över två dagar, i vad författarna beskriver som en demonstration. 🔗 källa
- Coral NPU — Google Research färdigställer 32-bitarsarkitekturen för sin öppna neurala processor för inbyggd AI, byggd på RISC-V, med en matrisenhet på upp till 1 TOPS och en målsatt genomsnittlig effekt på 10 mW, och släpper Coral Compiler v1.0; Synaptics lanserar sin chipserie Astra SR200. 🔗 källa
GitHub, utanför AI
- Secret scanning — Den 12 november ändras fältet
businessi två familjer av granskningshändelser från företagets visningsnamn till dess korta identifierare (slug); återkallandet, som är i förhandsversion, stöder även Base64-kodade GitHub-tokens i privata och interna repon. 🔗 källa - Dependabot-varningar — REST-API:et och webhooks
dependabot_alertreturnerar ett fältversion_requirement, versionen eller versionsbegränsningen för det sårbara beroendet, på github.com och GitHub Enterprise Cloud, i väntan på GitHub Enterprise Server 3.24. 🔗 källa - Dependabot och de nya pakethanterarna — Dependabot stöder npm 12, pnpm 11 och 12 samt Bun 1.4 för alla användare av github.com och kommer att inkludera dem i GitHub Enterprise Server 3.24. 🔗 källa
- Regeluppsättningar — Alla branchskydd i ett repo kan nu omvandlas till regeluppsättningar (rulesets) i en enda åtgärd, med förhandsgranskning, valfri tillämpningsstatus (Active, Evaluate eller Disabled) och möjlighet att behålla eller ta bort de ursprungliga reglerna. 🔗 källa
Vad det betyder
Inferens går från att helt bygga på NVIDIA, och leverantörerna öppnar motorerna som driver den. DeepInfer körs lika bra på SM100-GPU:er från NVIDIA som på Ascend 950-NPU:er från Huawei, TorchTPU gör TPU till en vanlig PyTorch-enhet även i Transformers och Diffusers, och PyTorch 2.15 gör avkodningen av en MoE på Mac mer än sex gånger snabbare. DeepSeek offentliggör också ekonomin bakom sin tjänst, 155 000 miljarder tokens per dag på ett enda kluster och 38 dollar i intäkter per GPU-timme under lågtrafik, och deepseek-recipe gör det möjligt för en tredjepartsleverantör att återskapa beteendet hos företagets officiella API. Återanvändningen av kontext väger allt tyngre i denna kalkyl: DeepSeek behåller sin KV-cache i mer än 72 timmar, och OpenAI säljer nu 12 timmars promptcache till agenter som återanvänder samma kontext hela dagen.
För röstagenter förespråkar Mistral och ElevenLabs två arkitekturer samma dag. Voxtral 3 behåller en kedja av separata modeller, transkription, valfri LLM och talsyntes, som SDK:n låter arbeta strömmande för att slutföra en samtalstur på mindre än en sekund; varje komponent kan bytas ut utan att agenten skrivs om, och priserna anges per minut eller tecken. Eleven Realtime förenar hela kedjan i en enda tal-till-tal-modell och satsar på kompatibilitet med OpenAI:s Realtime API för att locka utvecklare som redan har en integration, utan att ange något konkret pris. Mistral lägger till argumentet om hosting i Europa, samtidigt som fallet Hippolyte.ai visar vad stora företagskunder kräver: röstbehandling inom Europeiska unionen och inspelningar som raderas inom 24 timmar.
Platsen där assistenten arbetar blir ett säljargument. Perplexity Computer körs nu helt på en Mac med 36 GB minne, inklusive modellen, och Valarian tar det till isolerade nätverk; hos Anthropic låter Inference hooks ett företags säkerhetsserver avvisa en förfrågan innan den når modellen. Leverantörerna beskriver också begränsningarna i dessa skydd: ChatGPT:s låsta chattar döljer en konversation utan end-to-end-kryptering, och den finns kvar i företagens efterlevnadsloggar.
Säkerheten i programvarans leveranskedja avgörs där agenterna agerar. OSS Scanner har rapporterat 77 kritiska sårbarheter och 803 med hög allvarlighetsgrad på elva dagar, en allvarlighetsgrad som fortfarande tilldelas av modellen själv, medan sårbarheten i curl har fått en CVE-identifierare, ett säkerhetsmeddelande och en rättning. GitHubs paketbrandvägg riktar in sig på installationstillfället, då ett skadligt paket kan samla in inloggningsuppgifter från en runner för kontinuerlig integration eller en kodagent. Agenternas CLI:er ger samtidigt administratörerna större kontroll: Vibe CLI 3.0.1 gör det möjligt att förbjuda YOLO-läget, Copilot CLI 1.0.101 låter dem styra domaren som godkänner behörigheter, och Claude Code 2.1.304 tar inte längre bort ett worktree utan att fråga.
Källor
- Annonseringstråden för DeepInfer (@deepseek_ai)
- DeepInfer (GitHub)
- deepseek-recipe (GitHub)
- Voxtral 3 (Mistral)
- Annonseringstråden för Voxtral 3 (@MistralAI)
- Vi presenterar Eleven Realtime (ElevenLabs)
- Realtidsmodeller (ElevenLabs dokumentation)
- Tillkännagivandet om Computer lokalt på Mac (@perplexity_ai)
- Perplexity Computer körs nu helt lokalt på Mac (Perplexity)
- TorchTPU är nu open source (Google Cloud)
- De nya vLLM- och SGLang-motorerna på TPU (Google Developers)
- llm-d 1.0 (Google Cloud)
- Hugging Face och TorchTPU (Hugging Faces blogg)
- MPS i PyTorch 2.15 (Hugging Faces blogg)
- Sammanställningen från OSS Scanner (@thepunit)
- CVE-2026-92392 (curl)
- GitHub package firewall i offentlig förhandsversion (GitHub Changelog)
- Versionsanteckningarna för ChatGPT
- Så använder du låsta chattar i ChatGPT (OpenAI:s hjälpcenter)
- Nya Gemini-verktyg för småföretagare (Google)
- Vi presenterar Gemini för offentliga tjänster (Google Cloud)
- Så utformade Claude bindarproteiner mot skorpioners neurotoxiner (Anthropic)
- Tråden om bindarproteiner (@AnthropicAI)
- QD-Rec (Sakana AI)
- Flora (NVIDIA GEAR)
- Tillkännagivandet om Flora (@DrJimFan)
- OpenAI förvärvar Orchestra Bio (OpenAI)
- Runway ansluter sig till Claude Marketplace (Runway)
- Framsteg inom kodning i resurssvaga programmeringsspråk (OpenAI)
- MultiLangBench (GitHub)
- FairStress (Ai2)
- En ny syn på konfidens i resonerande modeller (Cohere)
- CALIBER (arXiv)
- Prompt caching (dokumentation för OpenAI API)
- Cachen på 12 timmar (@OpenAIDevs)
- Claude Code 2.1.304 (GitHub)
- Copilot CLI 1.0.101 (GitHub)
- Vibe CLI 3.0.1 (GitHub)
- Resultatet för Devin Fusion (@cognition)
- Coding Agent Index (Artificial Analysis)
- Versionsanteckningarna för Devin från den 19 oktober
- Agent Manager (@lvwerra)
- Sökning efter MCP-verktyg (@zeddotdev)
- Zed 1.25.1 i förhandsversion (GitHub)
- Zed 1.24.4 (GitHub)
- Browser Use-annoteringar på iOS (@v0)
- Gemini CLI v0.66.0-nightly.20261020 (GitHub)
- Synkronisering av ZCode v3.16.2 (GitHub)
- CLI för mistral 0.9.0 (GitHub)
- Copilot model policy API för företag, organisationer och team (GitHub Changelog)
- Versionsanteckningarna för Claude Platform
- Inference hooks (Claude-dokumentationen)
- Perplexity tar Computer till företagsinfrastruktur med Valarian (Perplexity)
- IncidentWatch och IncidentSweep (x.ai)
- Franchisetagare stämmer av kassan på 94% kortare tid med ChatGPT Work (OpenAI)
- Så använder 3 Java Champions GitHub Copilot (GitHub Blog)
- Kundfallet Hippolyte.ai (ElevenLabs)
- Öppnandet av kontoret i Japan (@Replit)
- ClaimBench (Vals AI)
- MiniMax M3.1 Flash i Parallels ranking (@p0)
- Vad är en AI Gateway? (Perplexity)
- Fibo 2.0 i Diffusers (@RisingSayak)
- Art Style Match (@LumaLabsAI)
- HeyGen Video 1.0 på Design Arena (@HeyGen)
- Wan3.0 Prime på OpenRouter (@Alibaba_Wan)
- Synthesia tar TJ till GTC Berlin (Synthesia)
- Gemensamt skapande av Slide Decks och Video Overviews (@Gemini_Notebook)
- AnyLanguageModel 1.0 (Hugging Faces blogg)
- Träna agenter med TRL (Hugging Faces blogg)
- Thoughtworks rapport om Nemotron (Hugging Faces blogg)
- Nedskalning av en väderprognosmodell (Hugging Faces blogg)
- Coral NPU, från modell till kisel (Google Developers)
- Uppdateringar av GitHub secret scanning (GitHub Changelog)
- Dependabot alerts REST API innehåller nu beroendeversioner (GitHub Changelog)
- Dependabot stöder nu npm 12, pnpm 11 och 12 samt Bun 1.4 (GitHub Changelog)
- Massmigrera branch protections till rulesets (GitHub Changelog)