ai-powered-markdown-translatorArtikel mit gpt-6.1-sol aus dem Französischen ins Deutsche übersetzt.
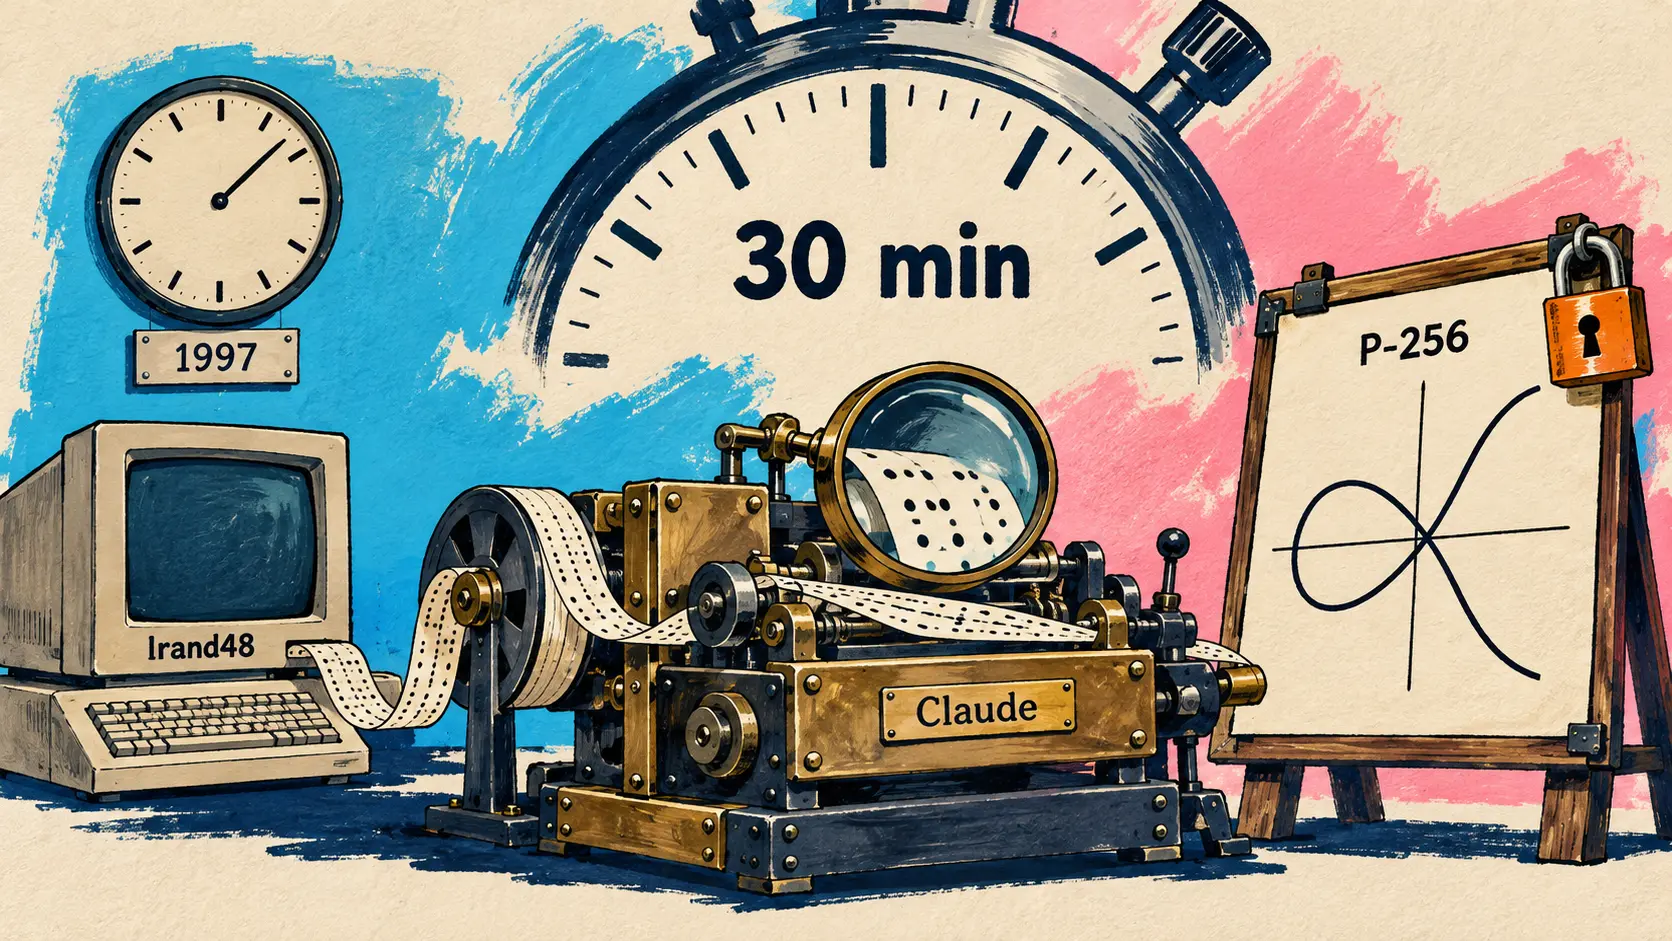
Ein internes Forschungsmodell von Anthropic hat in weniger als einer halben Stunde ermittelt, woher die Seeds der ECDSA-Kurven des NIST stammen, die von der NSA ohne Erklärung bereitgestellt wurden: Sie stammen aus einem gewöhnlichen Pseudozufallszahlengenerator, der 1997 und 1998 mit der Systemzeit initialisiert wurde, was eine Backdoor laut Anthropic deutlich weniger plausibel macht. Reflection veröffentlicht die Gewichte von Beam, einem Mixture-of-Experts-Modell mit 501 Milliarden Parametern unter der Apache 2.0-Lizenz, das ab dem ersten Tag von mehr als 40 Partnern unterstützt wird, während vier Gemini 4 Argon-Agenten Minecraft in 27 Stunden bezwingen und Claude Mythos 5 die besten veröffentlichten Quantenschaltkreise für acht Aufgaben verbessert. Bei den Produkten verteilt GPT-6 Astra Pro eine Aufgabe in ChatGPT nun auf mehrere Agenten, und Grok Bot erledigt seine Aufgaben am Computer dreimal so schnell.
ECDSA-Kurven des NIST: Claude ermittelt die Herkunft ihrer Seeds aus einem 1997 und 1998 mit der Systemzeit initialisierten Generator
16. Oktober — Das Frontier Red Team von Anthropic berichtet, wie Claude ein altes Rätsel der Kryptografie gelöst hat. Als das NIST im Jahr 2000 mit dem Standard FIPS 186-2 den Signaturalgorithmus ECDSA einführte, wurden seine standardisierten elliptischen Kurven mit „Seeds“ (seeds) geliefert, deren Hashwert den Koeffizienten b jeder Kurve festlegt. Diese von der NSA ohne Erklärung bereitgestellten Werte nährten seit Jahren den Verdacht auf eine Backdoor. Eine von Filippo Valsorda ausgelobte öffentliche Prämie wartete auf denjenigen, der ihre Herkunft ermitteln würde. Die bekannteste Spur, ein durch eine Hashfunktion geschickter humorvoller Satz, den Jerry Solinas (NSA) 2015 vor seinem Tod im Jahr 2023 erwähnt hatte, hatte zu keinem Ergebnis geführt.
Ein Mitarbeiter von Anthropic legte die Frage einem nicht namentlich genannten internen Forschungsmodell vor, ohne ihm diese Spur zu verraten. In weniger als einer halben Stunde fand Claude den Ursprung der Seeds von P-192, P-224, P-256, P-384 und P-521: Keiner ist ein Hashwert, alle stammen aus lrand48, dem Pseudozufallszahlengenerator der C-Bibliothek, initialisiert mit einem Unix-Zeitstempel. Nachdem Claude 34 Kombinationen von Generatoren und Ausgabeausschnitten durchgeprüft hatte, erkannte es die Signatur von lrand48 in den höchstwertigen Bits, rekonstruierte dessen internen Zustand durch Gitterreduktion (LLL-Algorithmus) und verfolgte anschließend die Initialisierungen der zehn betroffenen Seeds zurück: fünf des NIST und fünf des Standards ANSI X9.62, alle zwischen Mai 1997 und April 1998.
| Von Claude untersuchter Punkt | Von Anthropic veröffentlichtes Ergebnis |
|---|---|
| Zeit bis zur Entdeckung | weniger als 30 Minuten |
| Beispiel P-256 | Kandidat Nr. 1842 einer Ziehung vom 16. August 1997 (Nr. 876 derselben Ziehung war ebenfalls geeignet) |
| Ermittelte Seeds der binären Kurven | B-233, B-283, B-409 und B-571, die sich als Februar 1984 lesen lassen, beziehungsweise als 17. April 1998, wenn man den Zeitstempel verdoppelt |
| Erklärte Basispunkte | sechs im Mai 1997 erzeugte Kurven (P-192 und fünf Beispielkurven aus ANSI X9.62), über den Generator von FreeLIP |
| Weiterhin ungeklärt | der Seed von B-163; die Basispunkte von P-224, P-256, P-384, P-521 und den binären Kurven |
Diese Basispunkte stammen aus FreeLIP, der Bibliothek von Arjen Lenstra: Laut Anthropic war die Herkunft bislang keines einzigen Basispunkts des NIST geklärt. Unbekannt bleibt auch das Kriterium, nach dem bestimmte gültige Kandidaten verworfen wurden. Der Beitrag gibt schließlich die Überlegungen des Modells wieder, das seiner eigenen Entdeckung zunächst misstraut, bevor es sie durch Berechnungen bestätigt:
This is astonishing: it solves the 25-year-old mystery. Hmm wait. Let me be skeptical: am I in some sort of simulated/test environment?
🇩🇪 Das ist verblüffend: Damit ist das 25 Jahre alte Rätsel gelöst. Hmm, Moment. Ich muss skeptisch bleiben: Befinde ich mich in einer Art Simulations- oder Testumgebung? — Claude, im Beitrag des Frontier Red Teams von Anthropic zitierte Überlegung
Anthropic betont die Tragweite: kein Knacken der Verschlüsselung, kein neuer Angriff, keine Schwachstelle und „keine Maßnahmen erforderlich“. Ein mit einem gewöhnlichen Generator aus der Systemzeit gewonnener Seed, dessen Erzeugung nun jeder nachvollziehen kann, macht eine Backdoor vielmehr „deutlich weniger plausibel“. Der Code zur Reproduktion der Seeds und der sechs Basispunkte wird unter der CC0-Lizenz veröffentlicht, und die Prämie von 36 864 Dollar wird an die Internet Security Research Group (ISRG) gespendet.
🔗 Der Beitrag des Frontier Red Teams von Anthropic · Die Prämie von Filippo Valsorda
Offene Modelle: Reflection veröffentlicht die Gewichte von Beam, dazu pplx-decider-v1.2, Granite Switch 4.1, Bonsai 2 und ein Korpus von NVIDIA in 22 indischen Sprachen
16. Oktober — Elf Tage nach der Vorstellung veröffentlicht Reflection die Gewichte von Beam, seinem ersten Modell mit offenen Gewichten, unter der Apache 2.0-Lizenz. Dieses Modell mit einer Mischung aus Experten (Mixture-of-Experts, MoE) und 501 Milliarden Parametern, davon 23 Milliarden pro Token aktiv, zielt auf Code, Reasoning und lang andauernde Agentenaufgaben ab, mit einem Kontext von einer Million Tokens und ausschließlich Text. Am 5. Oktober hatte Reflection lediglich einen Vorabzugang geöffnet und die Gewichte für „später im Oktober“ angekündigt.
Die Veröffentlichung umfasst die Gewichte in BF16, FP8 und NVFP4, den Tokenizer, die Referenzimplementierung, ein Draft-Modell DFlash2 für spekulatives Decoding und Mirror CLI, den Open-Source-Harness, mit dem Beam trainiert wurde (Schnittstelle in Python, Agentenkern in Rust, parallele Agenten in getrennten Git-Worktrees, Skills und MCP-Verbindungen). Mehr als 40 Partner unterstützen das Modell ab dem ersten Tag: Transformers (v5.20.1), vLLM, SGLang, Unsloth, Axolotl und Dynamo auf der Softwareseite; AWS, Google Cloud, Azure, Together AI, Fireworks AI, OpenRouter oder Ollama beim Hosting; Dell und HPE für den Betrieb vor Ort. Die API von Reflection befindet sich in der öffentlichen Beta.
Der Beitrag von Hugging Face erläutert die Architektur: Von 52 Schichten verwenden 43 eine Sliding-Window-Attention mit 512 Tokens und 9 eine globale Attention. Dadurch sinkt der KV-Cache von 208 Kio auf 36 Kio pro Token, also von 208 Gio auf 36,08 Gio pro Sequenz mit einer Million Tokens. Die Gewichte belegen etwa 1 To in BF16 und 280 Go in NVFP4, und Hugging Face empfiehlt vier B200 für die Bereitstellung des Modells.
| Benchmark (Zahlen von Reflection) | Beam in BF16 | Beam in FP8 | Beam in NVFP4 |
|---|---|---|---|
| SWE-bench Verified | 81,6 % | 80,2 % | 80,7 % |
| Terminal Bench v2.1 | 80,1 % | 78,9 % | 78,4 % |
| SWE Bench Pro v1 | 66,1 % | 65,9 % | 65,6 % |
| AIME 2026 | 97,7 % | 98,0 % | 97,5 % |
| GPQA Diamond | 90,6 % | 90,3 % | 89,3 % |
| MCP Atlas | 80,8 % | 81,5 % | 80,5 % |
Laut NVIDIA wurde Beam auf GB300 NVL72-Racks trainiert und liefert auf Blackwell Ultra ab dem ersten Tag ohne besondere Anpassungen (out of the box) mehr als 70 000 Tokens pro Sekunde und GPU. Einige Stunden später meldete NVIDIA etwa 90 000, ohne die Messbedingungen anzugeben (Batchgröße, Kontext, Anzahl der GPUs). Der NVFP4-Checkpoint wird auf Hugging Face veröffentlicht, ebenfalls unter Apache 2.0.
🔗 Der Beitrag von Reflection · Der Beitrag von Hugging Face · Die Model Card · Der Beitrag von NVIDIA · Durchsatz auf 90 000 Tokens pro Sekunde gesteigert
pplx-decider-v1.2 und seine Flash-Version: Perplexity veröffentlicht zwei Entscheidungsmodelle mit offenen Gewichten für seine Decisions API
16. Oktober — Perplexity aktualisiert die Modelle seiner am 1. Oktober gestarteten Decisions API. Das Modell pplx-decider-v1.2 ersetzt v1.1 als Entscheidungsmodell mit 27 Milliarden Parametern zum gleichen Preis. Hinzu kommt pplx-decider-flash-v1.2, ein neues Modell mit 4 Milliarden Parametern, das aus den 27B-Modellen destilliert wurde und die Hälfte kostet. Beide verarbeiten Text und Bilder, die Ausgabe bleibt kostenlos, und die Gewichte stehen auf Hugging Face unter der Apache 2.0-Lizenz bereit. Aufrufe, die weiterhin v1.1 oder v1 angeben, werden automatisch auf v1.2 umgestellt.
| Entscheidungsmodell | Basismodell | Eingabepreis (pro Million Tokens) | Wert im Decision Index 0.3 | Wert im Vision Decision Index 0.3 |
|---|---|---|---|---|
| pplx-decider-v1.1-27b | Qwen3.8-27B | 0,02 Dollar | 62,30 | 73,22 |
| pplx-decider-v1.2 | Qwen3.8-27B | 0,02 Dollar | 68,09 | 77,43 |
| pplx-decider-flash-v1.2 | Qwen3.5-4B | 0,01 Dollar | 58,88 | 72,53 |
v1.2 ändert das Anfrageformat: Das Modell liest den Zustand und anschließend alle Fragen in einer einzigen Sequenz, sodass mehrere Fragen zu demselben Zustand ungefähr so viel kosten wie eine einzige. Die Bündelung hilft, wenn die Fragen verschiedene Aspekte derselben Entscheidung beschreiben (+11,3 Punkte auf SATA-Bench), und schadet, wenn sie unabhängige Kandidaten gegeneinander abwägen (−4,8 auf ToolRet). Perplexity hat außerdem die offiziellen Trainingsdatensätze einiger Benchmarks des Decision Index in das Training aufgenommen, bereinigt um Überschneidungen mit deren Testdatensätzen. Auf einem GB200 beantwortet v1.2 eine einzelne Anfrage im Median in 96 ms.
🔗 pplx-decider-v1.2 auf Hugging Face · pplx-decider-flash-v1.2 auf Hugging Face · Der Changelog der Perplexity-API
Granite Switch 4.1: IBM vereint Konversation, Entscheidungen und Sprachtranskription in einem einzigen offenen Modell
15. Oktober — IBM stellt im Blog von Hugging Face Granite Switch 4.1 in 8B und 30B unter der Apache 2.0-Lizenz vor. Jedes Modell vereint ein Konversationsmodell, zwei Entscheidungsadapter und ein Spracherkennungsmodell, die über einen einzigen Endpunkt bereitgestellt werden.
| Komponente von Granite Switch 4.1 | Von IBM angegebene Funktion |
|---|---|
| Decision-Adapter (aLoRA) | allgemeine Entscheidungen im Format /v1/systemone |
| Guardian-Adapter (aLoRA) | sicherheitsbezogene Entscheidungen, laut IBM im Durchschnitt vor Jev 1.13, Microsoft-Decision-1, GPT-Luna-Decisions und Clef-Flash |
| Granite-Speech-5.0-Turbo-CTC | Transkription, als schnellstes Modell des Open ASR Leaderboard vorgestellt |
Die Adapter sind Activated LoRA: Sie verwenden den vom Basismodell erzeugten KV-Cache wieder, sodass bei einer Entscheidung nach einer Antwort der Kontext nicht erneut berechnet wird und das Gesamtpaket ungefähr so viel Speicher belegt wie das Basismodell allein. Die Modelle laufen in vLLM mit einem Plugin und nativ in llama.cpp, als direkter Ersatz für Aufrufe von /v1/systemone. IBM zeigt außerdem ein Granite Switch mit 3B, das für Doom trainiert wurde und 60 bis 100 Entscheidungen pro Sekunde trifft, gegenüber den für Jev angegebenen 10. Zudem plant IBM ein SDK, um eigene Adapter in Mellea zu trainieren. Die Vergleiche mit den anderen Entscheidungsmodellen werden nur in Diagrammen gezeigt.
🔗 Der Beitrag von IBM · Granite Switch 4.1 30B auf Hugging Face
Bonsai 2: PrismML veröffentlicht ternäre Vision-Modelle von 2B bis 9B, die 0,43 bis 2 Go belegen
15. Oktober — PrismML veröffentlicht Bonsai 2 in 2B, 4B und 9B: von Qwen3.5 abgeleitete Modelle mit ternären Gewichten (−1, 0 oder +1), die auch Bilder verstehen, unter der Apache 2.0-Lizenz. Sie behalten den Kontext von 262 144 Tokens des Basismodells bei, und die Bonsai 2-Familie umfasst nun vier Größen von 2B bis 27B.
| Bonsai 2-Modell | Größe der ternären Gewichte |
|---|---|
| 2B | 0,43 Go |
| 4B | 0,95 Go |
| 9B | 2,0 Go, gegenüber etwa 17,9 Go in FP16 |
PrismML hat nach eigenen Angaben an der Nutzung als lokaler Assistent gearbeitet: Befolgen von Anweisungen, Vermeiden von Wiederholungsschleifen, Tool-Aufrufe auf dem Smartphone und Antworten ohne überflüssigen Text. Das 9B soll bei gängigen Aufgaben zum Befolgen von Anweisungen und in Mathematik etwa 40 % weniger Tokens verbrauchen, ohne dass eine Vergleichsbasis genannt wird. Auf einem iPhone 18 Pro Max erreicht es bis zu 34 Tokens pro Sekunde, gegenüber 120 beim 2B. Die kompaktesten Formate erfordern den llama.cpp-Fork von PrismML, da das offizielle llama.cpp nur das Format Q2_0 lesen kann; für Macs gibt es eine MLX-Version.
🔗 Der Thread von PrismML · Die Model Card des 9B im GGUF-Format
Nemotron-pretraining-Indic-v1: NVIDIA und AI4Bharat beschreiben ein Korpus mit rund 2 800 Milliarden Tokens in 22 indischen Sprachen
16. Oktober — NVIDIA und AI4Bharat, das auf indische Sprachen spezialisierte Labor des IIT Madras, beschreiben Nemotron-pretraining-Indic-v1 im Detail, das am Vortag unter den Daten für Nemotron 3.5 Super VL genannte Pretraining-Korpus: rund 2 800 Milliarden Tokens, davon 2 601 Milliarden in der jeweiligen Originalschrift und 224,6 Milliarden in lateinischer Umschrift, in den 22 in der indischen Verfassung aufgeführten Sprachen, die laut der Volkszählung von 2011 die Muttersprachen von 97 % der indischen Bevölkerung sind. Das Korpus ist noch nicht online: Es soll „bald“ zusammen mit der GPU-beschleunigten Generierungs-Pipeline veröffentlicht werden, die es erzeugt hat.
Die Texte sind Übersetzungen englischer Dokumente aus 15 Teilmengen von Nemotron-CC-v2. Für 12 Sprachen übersetzt Gemma-4-31B-it ganze Dokumente, bewertet jede Übersetzung anhand eines von MQM inspirierten Bewertungsrasters (Schwellenwert 75 von 100) und korrigiert zu schwache Ausgaben, wodurch 438,4 Milliarden Tokens nutzbar gemacht werden konnten; die 10 übrigen Sprachen werden mit Indic Translate von Bodhan AI verarbeitet. Zehn Milliarden dieser Tokens brachten Nemotron 3.5 Super VL im Rahmen eines fortgesetzten Pretrainings mit 100 Milliarden Tokens auf fünf indischen Benchmarks Zugewinne von 4,98 bis 9,82 Punkten, wobei diese Messung den Beitrag des Korpus allein nicht gesondert erfasst. NVIDIA räumt ein, dass diese Übersetzungen keine direkt in diesen Sprachen verfassten Texte ersetzen und die Qualitätskontrolle weiterhin überwiegend automatisch erfolgt.
🔗 Der Beitrag von NVIDIA und AI4Bharat
KI im Labor: Claude Mythos 5 verbessert acht Quantenschaltungen, Google DeepMind sucht mit Antigravity nach antimikrobiellen Peptiden
16. Oktober — Anthropic veröffentlicht die Arbeiten, die Andi Gu, Mitglied seines Programms STEM Fellows, unter der Betreuung von Alek Kemeny, Spezialist für Quantenphysik bei Anthropic, gemeinsam mit Susanne Yelin (Harvard) und Mikhail Lukin (Harvard und QuEra Computing) durchgeführt hat. Der Versuchsaufbau: alltagssprachliche Spezifikationen für acht Schaltungen und ein automatischer Evaluator, der jeden Vorschlag prüft und anhand der Zahl der Qubits multipliziert mit der Zahl der Gatter bewertet. Claude Mythos 5 arbeitet dabei in einem geschlossenen Regelkreis, ohne menschliches Eingreifen zwischen den Durchläufen, und findet für die acht Primitive Entwürfe, die sowohl weniger Qubits als auch weniger Gatter benötigen als die besten veröffentlichten, mitunter um eine Größenordnung oder mehr.
| Aufgabe für Claude Mythos 5 | Veröffentlichtes Ergebnis | Vergleichsmaßstab |
|---|---|---|
| Punktaddition auf elliptischen Kurven | 17-mal weniger Gatter bei 12 % mehr Qubits | kleinster veröffentlichter Entwurf |
| Reed-Solomon-Decoder des DQI-Algorithmus | 12-mal weniger Gatter; 19 reservierte Qubits statt 665 | frühere Konstruktion von Google |
Das erste Ergebnis betrifft den zentralen Schritt der Quantenalgorithmen für den diskreten Logarithmus auf elliptischen Kurven. Claude arbeitete daran 53 Stunden bei minimalem menschlichem Eingreifen und entwickelte die erste reversible Implementierung der divsteps-Methode ohne gespeicherten Verzweigungsverlauf, die zunächst durch Simulation überprüft und anschließend in Lean formalisiert wurde. Der Beitrag stellt diese Zahl einer anderen gegenüber: Es brauchte acht Jahre und zahlreiche Gruppen, um die geschätzten Kosten der Simulation von FeMoco um einen Faktor von etwa 150 000 zu senken. Für Anthropic verringern solche Fortschritte die für nützliche Anwendungen nötigen Quantenressourcen, sodass praxistaugliche Quantencomputer früher als erwartet verfügbar werden könnten. Das Team musste mit einem vorsichtigen Claude umgehen, der seine Verbesserungen erneut überprüfte und bekannte Methoden bevorzugte, indem es ihm mehrere parallele Lösungswege vorgab.
🔗 Der Beitrag von Anthropic · Der Artikel auf arXiv
Google DeepMind sucht mit Antigravity nach neuen antimikrobiellen Peptiden und fügt einen 3D-Viewer hinzu
15. Oktober — Google DeepMind zeigt, wie Antigravity, seine Plattform für agentische Entwicklung, als wissenschaftliche Arbeitsumgebung (agentic science workbench) dienen kann. In der beschriebenen Sitzung gibt ein Biologe das Ziel vor, neue antimikrobielle Peptide bei Streptococcus pseudopneumoniae zu finden und rechnerisch zu validieren, und der Agent orchestriert Datenbanken, Strukturanalyse und die Aufarbeitung der Fachliteratur. Er stützt sich auf ProtNLM, ein Google-Modell, das die Funktion eines Proteins anhand seiner Sequenz vorhersagt und Millionen nicht charakterisierter UniProt-Einträge annotiert.
Der Agent wählt ein Bakteriozin mit 97 Aminosäuren (UniProt A0A0U0D591) aus, für das es unter den kuratierten Proteinen von Swiss-Prot kein signifikantes Homolog gibt und dessen AlphaFold-Modell sich wie ein Bakteriozin mit bekannter Struktur faltet. Anschließend schlägt er einen aus der Literatur abgeleiteten Wirkmechanismus vor und verfasst ein Laborprotokoll. Dieser Kandidat und mehrere weitere aus derselben Pipeline werden derzeit im Labor validiert: Der Beitrag spricht von einem plausiblen Ansatz, nicht von einem Ergebnis. Er erinnert daran, dass antimikrobielle Resistenzen einer Schätzung zufolge bis 2050 jährlich rund 10 Millionen Todesfälle verursachen könnten.
Der Beitrag stellt außerdem den Biomolecular Structure Viewer vor, einen in Antigravity integrierten 3D-Viewer, den Agent und Forscher gemeinsam nutzen: Der Agent hebt darin Bereiche hervor, um seine Hypothesen zu veranschaulichen, und erhält die Anmerkungen des Forschers zurück, etwa eine an einer Bindungstasche angeheftete Notiz. Weder ein Datum noch Zugangsbedingungen werden genannt.
🔗 Der Beitrag von Google DeepMind · Antigravity für die Wissenschaft
Werkzeuge für Forschende: Google macht Deep Review für alle zugänglich, SAIR startet Open Math OS, OpenAI bietet US-Laboren den Rosalind Academic Plan an
14. Oktober — Anlässlich von Research@ 2026 macht Google Research Deep Review öffentlich zugänglich, ein agentisches KI-System, das komplexe technische Dokumente gegenliest und ihren Inhalt prüft: logische Konsistenz, mathematische Aussagen, durch Quellen belegte Fakten, Vergleich mit bestehenden Arbeiten und Verbesserungsvorschläge, wobei die fachlichen Urteile den Menschen vorbehalten bleiben. Es folgt auf das Paper Assistant Tool, das bei STOC 2026, ICML 2026, NeurIPS 2026 und ICLR 2027 getestet wurde: Die Autoren von mehr als 16 000 freiwillig eingereichten Manuskripten erhielten damit vor Ablauf der Frist privates Feedback, unabhängig von der offiziellen Begutachtung der Konferenzen.
Der Zugang ist weltweit verfügbar, mit zwei kostenlosen Begutachtungen pro Woche; ein Gemini-API-Schlüssel ermöglicht höhere Limits und den Zugriff auf die Deep Review API. Der Dienst akzeptiert derzeit PDF und reinen Text, soll auch Google Docs, Präsentationen sowie Recht und Finanzen abdecken, und Google verpflichtet sich, die Dokumente nicht zum Training seiner Modelle zu verwenden (für die Anzeige werden sie ein Jahr lang gespeichert). Google begründet das Tool mit der Flut an Einreichungen:
| Einreichungsjahr | Bei ICLR, NeurIPS und ICML eingereichte Artikel |
|---|---|
| 2023 | rund 23 000 |
| 2024 | rund 32 000 |
| 2025 | rund 45 000 |
| 2026 | mehr als 74 000 |
Am selben Tag wurden für den Agenten Geospatial Reasoning von Google Earth AI ein technischer Bericht und zwei neue Benchmarks für Forschende (GeoKTools und GeoExpertQueries) veröffentlicht und der experimentelle Zugang über Ask Google Earth und einen Agent-to-Agent-Dienst (A2A) erweitert.
🔗 Der Beitrag von Google Research · Research@ 2026 im Google-Blog · Der Beitrag zum Agenten Geospatial Reasoning
Open Math OS: Die SAIR-Stiftung startet eine Plattform für mathematische Forschung auf Basis offener Modelle
16. Oktober — Die SAIR-Stiftung startet Open Math OS, das sie als Infrastruktur der „Mathematik 2.0“ vorstellt, einen Monat nach der Ankündigung der Initiative Open Math Model. Hugging Face, Lean, die EPFL und @cscsch sind Partner zum Start, und Thomas Wolf, Mitgründer von Hugging Face, hat die Ankündigung geteilt. Jedes Projekt erhält eine 24 Stunden am Tag verfügbare Cloud-Maschine mit mehr als 100 vorinstallierten mathematischen und wissenschaftlichen Tools; für auf Bewerbung aufgenommene Teams ist die Rechenleistung kostenlos.
Der Mathematiker wählt darin ein offenes Modell (in der gezeigten Oberfläche Kimi K3, DeepSeek V4.1 Flash, GLM 5.3 oder Nemotron 3) und kann den Modus Ultramath starten, in dem mehrere Agenten parallel unterschiedliche Ansätze für dasselbe Problem verfolgen; die Demonstration auf der Website zeigt einen in Lean verifizierten Beweis, der anschließend in einen LaTeX-Artikel integriert wird. Die Projekte sind standardmäßig privat, das Training anhand der Arbeiten erfordert die ausdrückliche Zustimmung der Autoren, und diese behalten das Eigentum an ihren Ideen und die Anerkennung dafür.
🔗 Der Thread von SAIR · Die Website von Open Math Model
Rosalind Academic Plan: bis zu 30 kostenlose ChatGPT-Lizenzen für 12 Monate für universitäre Labore in den USA
15. Oktober — OpenAI startet den Rosalind Academic Plan, ein Angebot für universitäre Labore der Lebenswissenschaften, das vorerst US-amerikanischen Universitäten vorbehalten ist.
| Vorteil des Angebots | Zugehörige Bedingung |
|---|---|
| Bis zu 30 Lizenzen für ChatGPT Business Standard | 0 Dollar pro Nutzer und Monat, höchstens 12 Monate |
| Kommerziell verfügbare Spitzenmodelle | innerhalb der Nutzungslimits des Angebots |
| GPT-Rosalind und Rosalind Workbench | nach Genehmigung des vertrauensbasierten Zugangs (trusted access) |
| Geteilte Forschungsdaten | standardmäßig nicht für das Training verwendet |
Rosalind Workbench orchestriert Tools für Medizinalchemie, Genomik und die Unterstützung von Experimenten. Der leitende Forscher oder der Laborleiter reicht den Antrag im Namen seines Teams ein; eine Bewerbung gewährt keinen sofortigen Zugang, und Universitäten, die bereits über einen Vertrag für OpenAI Enterprise verfügen, durchlaufen ihren eigenen Prozess. OpenAI zielt auf sieben Bereiche ab, von der Entwicklung von Medikamenten und Proteinen bis hin zu antimikrobiellen Resistenzen, und verweist auf die Arbeiten des Zhao-Labors (UCSF), des Bourdenx-Labors und des Teams von Brian Hie (Stanford und Arc Institute). GPT-Rosalind, am 16. April eingeführt, ist seit dem 11. September über einen vertrauensbasierten Zugang via API, Codex und ChatGPT Enterprise verfügbar.
🔗 Der Beitrag von OpenAI · Der Thread von OpenAI
Gemini 4 Argon: Vier Agenten spielen Minecraft in 27 Stunden durch, Perplexity stellt es seinen Pro- und Max-Abonnenten und in seiner Agent API bereit
16. Oktober — Vier Agenten von Gemini 4 Argon haben Minecraft von Grund auf durchgespielt: In einer zufälligen Überlebenswelt, im Modus Easy und mit feindlichen Monstern besiegten sie nach 27 Stunden und 2 783 Programmen den Ender Dragon. Maxence Faldor schildert das Experiment in einem von @GoogleDeepMind geteilten X Article und beschreibt es gemeinsam mit Satinder Singh und Roberta Raileanu in einem technischen Bericht auf arXiv im Detail. Es handelt sich um Argons allgemein einsetzbare Coding-Agenten, die auch Ingenieure täglich verwenden: keine Minecraft-spezifischen Tools, keine zugewiesenen Rollen.
Die Agenten sehen keine Bilder und drücken keine Tasten: Jeder steuert einen Spieler, indem er kurze Programme für die Open-Source-Bibliothek Mineflayer schreibt, deren Ausgabe liest und sich über den Spielchat sowie einen gemeinsamen Speicher mit den anderen abstimmt. Zehn Minuten nach dem Start hatten sie die Arbeit untereinander aufgeteilt (Werkzeuge, Nahrung, Diamanten, Portal). Um die Festung zu finden, warf einer von ihnen von zwei Orten aus zwei Gegenstände und berechnete den Schnittpunkt ihrer Flugbahnen, auf 43 Meter genau bei einer 1,3 Kilometer entfernten Festung. Der Endkampf kostete sie 69 Respawns: Nach rund 21 Spielstunden erkannte ein Agent, dass die Kristalle den Drachen heilten und ein Stapel Erdblöcke genügte, um sie zu erreichen.
| Messgröße des Experiments | Ermittelter Wert |
|---|---|
| Dauer bis zum Sieg | 27 h 14 min |
| Geschriebene Programme | 2 783, davon 22 % mit Fehler beendet |
| Chatnachrichten | 229 |
| Respawns insgesamt | 605, davon 69 im Kampf gegen den Drachen |
Ein fünfter Agent, der Observer, überwachte die Partie, um jeglichen Betrug oder jede Ausnutzung der Spezifikation (specification gaming) zu erkennen: Weder er noch die manuelle Prüfung einer Stichprobe der Logs fanden derartige Fälle. Die Autoren erkennen die Grenzen des Experiments an: Die Welt wird über eine API ausgelesen, die die exakten Positionen der Blöcke und Kreaturen liefert, und ein Plugin berechnet die Wege. Es handelt sich um ein unabhängiges Forschungsexperiment, das weder ein offizieller Minecraft-Meilenstein noch von Mojang oder Microsoft genehmigt ist.
🔗 Der Artikel von Maxence Faldor · Der geteilte Beitrag von Google DeepMind · Der technische Bericht auf arXiv
Perplexity macht Gemini 4 Argon seinen Pro- und Max-Abonnenten zugänglich, mit einem Rekordwert von 0,802 auf WANDR
16. Oktober — Perplexity nimmt Gemini 4 Argon, das bei Google seit dem 13. Oktober allgemein verfügbar ist, in das Angebot für seine Pro- und Max-Abonnenten auf. Die Ankündigung besteht aus einem Tweet und einer Grafik: Auf WANDR, seinem hauseigenen Benchmark für quellengestützte Recherche, erreicht Argon 0,802 bei 7,88 Dollar pro Aufgabe, den besten Wert der Grafik.
| Bewertetes Modell | WANDR-Score | Kosten pro Aufgabe |
|---|---|---|
| Gemini 4 Argon | 0,802 | 7,88 Dollar |
| GPT-6 Astra | 0,735 | 13,34 Dollar |
| GPT-6.1 Sol | 0,654 | 3,70 Dollar |
| Claude Opus 5.5 | 0,647 | 3,69 Dollar |
| Claude Fable 5.1 | 0,601 | 12,76 Dollar |
| GPT-6 Sol | 0,566 | 2,23 Dollar |
| Claude Sonnet 5.5 | 0,550 | 2,73 Dollar |
| Grok 4.7 | 0,528 | 9,30 Dollar |
| DeepSeek V4 Pro 0813 | 0,359 | 0,75 Dollar |
Für Entwickler weist der API-Changelog seit dem Abend des 15. Oktober darauf hin, dass die Agent API google/gemini-4-argon unterstützt, zum bis zum 30. November 2026 geltenden Einführungspreis: 2 Dollar pro Million Eingabe-Tokens, 0,10 Dollar für gecachte Tokens und 10 Dollar für Ausgabe-Tokens, einschließlich Reasoning-Tokens.
🔗 Die Ankündigung von Perplexity · Die Modelle der Agent API
Agenten für Endnutzer: GPT-6 Astra Pro verteilt in ChatGPT eine Aufgabe auf mehrere Agenten, Grok Bot arbeitet dreimal so schnell und verbindet sich mit Robinhood, Coinbase und eToro
16. Oktober — OpenAI aktualisiert GPT-6 Astra Pro in ChatGPT: schnellere Antworten, eine bessere Nutzung von Plugins und Tools und vor allem mehrere Agenten, die parallel verschiedene Teile derselben Aufgabe bearbeiten. Der Nutzer verfolgt den Fortschritt jedes einzelnen und öffnet abgeschlossene Aufgaben, um ihre Arbeit durchzusehen. Die Funktion ist für Pro-Abonnenten im Tab Chat verfügbar.
OpenAI nennt weder einen bezifferten Geschwindigkeitsgewinn noch einen Benchmark, und weder die Release Notes von ChatGPT noch die der Modelle erwähnten das Update bereits am Abend des 16. Oktober. Der um 20:00 UTC unter dem Namen „GPT-6 Pro“ veröffentlichte Tweet wurde 27 Minuten später zu „GPT-6 Astra Pro“ korrigiert; seit GPT-6 am 7. Oktober für alle Nutzer eingeführt wurde, basiert die Pro-Reasoning-Stufe von ChatGPT auf GPT-6 Pro (Astra). Bislang war die Arbeit mit mehreren Agenten seit dem 29. September für GPT-6.1 Sol als Beta ausgewiesen.
Grok Bot erledigt Aufgaben am Computer dreimal schneller, liest X Chat und verbindet sich mit Robinhood, Coinbase und eToro
16. Oktober — Grok Bot, der Agent von SpaceXSI, der sich mit den Tools seiner Nutzer verbindet, stellt seine Neuerungen in einem Thread mit zehn Beiträgen vor, ohne einen Blogbeitrag auf x.ai. Die wichtigste betrifft die Geschwindigkeit: Laut dem Account @bot werden Aufgaben am Computer im Durchschnitt dreimal schneller abgeschlossen, und Antworten auf alles andere kommen in weniger als der Hälfte der Zeit.
| Bereich | Angekündigte Neuerung |
|---|---|
| Geschwindigkeit | Aufgaben am Computer im Durchschnitt dreimal schneller, andere Antworten in weniger als der Hälfte der Zeit |
| Sprache | Schnellere, zuverlässigere Anrufe, bessere Erinnerung an frühere Gespräche |
| Oberfläche | Neu gestaltete Chat-Karten, neue Schriftart, Themes, Benachrichtigungen nur auf dem gerade genutzten Gerät |
| „Plus“-Aliasse, um eine Routine auf E-Mails an eine bestimmte Adresse zu beschränken | |
| X | Eine Erwähnung von @bot in einem Post startet eine Aufgabe; Lesen von X Chat nach Verknüpfung des X-Kontos |
| Konnektoren | Unter anderem Robinhood, Coinbase, Trello, PostHog, beehiiv und eToro |
Teams können auch eigene Konnektoren einreichen: Über ein Formular auf x.ai lassen sich Plugins oder MCP-Server nach einer Prüfung für den Marketplace an Nutzer von Grok Bot und Cursor und bald auch von Grok verteilen.
🔗 Der Thread von Grok Bot · Das Formular zum Einreichen von Plugins
Generative Medien: Stimmen aus Beschreibungen für GPT-Live, Pika in ChatGPT, Ideogram 4.5 von 0,8 bis 22 Cent pro Bild, Mirelo SFX 2.0 in Runway
16. Oktober — Die GPT-Live API ermöglicht allen Kunden, Stimmen anhand einer Beschreibung zu erstellen (prompt-to-voice): Eine eigene Stimme wird über die API oder den Sprach-Playground als Text beschrieben und kann anschließend in GPT-Live-Sitzungen wiederverwendet werden. Die Erstellung ist kostenlos, die erzeugte Sprache wird zum üblichen Sitzungstarif abgerechnet, und diese Stimmen funktionieren ausschließlich mit GPT-Live, nicht mit der Text to Speech API, der Realtime API oder Chat Completions. Weder eine Referenzaufnahme noch eine Einwilligungsaufnahme wird verlangt, doch OpenAI schreibt Erwachsenenstimmen vor, verbietet Identitätsmissbrauch und verlangt einen Hinweis darauf, dass die Sprache KI-generiert ist; zwei Kunden können ähnliche Stimmen erhalten.
Außerdem erhält GPT-Live neun vordefinierte Stimmen, die laut @OpenAIDevs mit muttersprachlichen Sprechern aufgenommen wurden:
| Gesprochene Sprache | Hinzugefügte Stimmen |
|---|---|
| Deutsch | Nuri, Juni und Flitz |
| Französisch | Brise und Sillage |
| Hindi | Nira |
| Japanisch | Harema und Shida |
| Koreanisch | Noeul |
Am Vortag wurde im Changelog eine native Integration der Decisions API in GPT-Live ergänzt: Die Anwendung handelt, während der Nutzer spricht, entweder weil Live Decisions direkt aufruft (native Delegation) oder weil Live die Anwendung benachrichtigt, die daraufhin Decisions abfragt (benutzerdefinierte Delegation). Entscheidungen können dabei durch Transkriptionsfragmente ausgelöst werden. Der Leitfaden nennt als Beispiel einen Sprachassistenten im Auto, der die Temperatur oder die Scheibenentfeuchtung regelt. Diese Neuerungen betreffen gpt-live-1: GPT-Live-1.1, das am 15. Oktober in ChatGPT eingeführt wurde, erscheint noch nicht im Changelog der API.
🔗 Der Thread von OpenAI Developers · Der Leitfaden für benutzerdefinierte Stimmen · Der Leitfaden zur Decisions API mit Sprache
Pika bringt seine Kreativtools mit einem gemeinsam mit OpenAI entwickelten Plugin in ChatGPT
16. Oktober — Pika kündigt in Partnerschaft mit OpenAI eine Plugin-Erweiterung für Pika × ChatGPT (Pika X ChatGPT plugin extension) an, die seine Kreativtools in die Unterhaltung und die Seitenleiste von ChatGPT integriert. Dort lassen sich Tool-Optionen, visuelle Voreinstellungen und Generierungen steuern, ohne die Unterhaltung zu verlassen. Alternativ öffnet man ein immersiveres Pika-Fenster, in dem ChatGPT mit dem Nutzer zusammenarbeitet. Laut seinem Thread bringt Pika mehr als 40 Anwendungen für Bild, Ton und Video sowie mehr als 100 Generierungsmodelle mit; die Plugin-Seite listet 13 Skills von Produktwerbung bis Podcast sowie einen Einführungsablauf auf, der festlegt, wie Pika nachfragt, bevor Credits ausgegeben werden.
Pika schreibt jedem Konto nach der ersten Generierung über das Plugin 250 Credits gut und veröffentlicht keinen eigenen Preis für das Plugin. OpenAI hatte die Plugin-Erweiterungen von ChatGPT am 7. Oktober vorgestellt, mit Adobe, Canva, Figma und Shopify unter den ersten Anbietern.
🔗 Der Thread von Pika · Die Seite des Pika-Plugins in ChatGPT
Ideogram 4.5 bietet vier Qualitätsmodi von 0,8 bis 22 Cent pro Bild
15. Oktober — Ideogram erläutert die Preisstaffel von Ideogram 4.5, seinem am 30. September eingeführten Bildbearbeitungsmodell: vier Qualitätsmodi von 0,8 bis 22 Cent pro Bild, alle mit nativer 2K-Auflösung. Der günstigste Modus, Very Low, bearbeitet ein Bild in 8 Sekunden für 0,8 Cent, ohne dass sich von Bearbeitung zu Bearbeitung Artefakte ansammeln. Laut Ideogram, das sich auf Design Arena stützt, verschiebt dieser Modus die Pareto-Grenze der Bildbearbeitung sowohl beim Preis als auch bei der Geschwindigkeit: Jedes höher bewertete Modell kostet mehr und arbeitet langsamer. Design Arena führt ihn mit einem Elo-Wert von 1189 auf Platz 23 seiner Image Editing Arena.
Ideogram nennt keine genauen Preise für die beiden mittleren Modi. Auf die bei der Einführung versprochenen offenen Modellgewichte angesprochen, antwortet der Ideogram-Account, dass daran gearbeitet werde, ohne einen Termin zu nennen.
Runway integriert Mirelo SFX 2.0, das Videos vertont und dabei Dialoge erhält
16. Oktober — Runway erweitert seine Plattform um Mirelo SFX 2.0, ein Modell, das automatisch die Klanggestaltung eines Videos übernimmt (sound design): Es erzeugt aus den Bildern vollständige Klangwelten, synchronisiert mit jedem Einzelbild, und lässt die Dialoge dabei unverändert. Auf die Frage nach einer Längenbegrenzung antwortet Runway, dass dies mit Clips beliebiger Länge funktioniert. Weder Preise noch Kosten in Credits werden veröffentlicht, der Changelog von Runway erwähnt das Modell noch nicht, und Mirelo hat seinerseits keine Ankündigung veröffentlicht. Nach Eleven v4 von ElevenLabs Ende September ergänzt Runway seine Videomodelle damit weiter um Audiomodelle von Drittanbietern.
🔗 Die Ankündigung von Runway · Die Antwort zur Länge der Clips
Code-Agenten: Das Claude Code-Team erläutert seine Code-Reviews, Codex CLI 0.163.0, Arbeitsflächen und Muse Wonder in Cursor, Gemini CLI verweist auf Antigravity CLI
16. Oktober — Das Claude Code-Team erklärt auf claude.dev, wie es seinen eigenen Code prüft, obwohl Claude rund 90 % davon schreibt. Der Beitrag von Addy Osmani, Morgan Westlee Lunt und Qing Wang nennt zwei Zahlen: Von Juni bis September hat sich die Zahl der zusammengeführten Pull Requests mehr als verdoppelt, während der Anteil derjenigen, die rückgängig gemacht werden mussten, um mehr als 40 % sank. Das Ziel ist, dass die meisten Pull Requests mit höchstens einem beteiligten Menschen zusammengeführt werden, der auch ihr Autor sein kann.
Jede Änderung durchläuft mehrere Stufen: Prüfung durch Claude vor der Pull Request (Tests, Kompilierung, statische Analyse, anschließend Prüfung des Diffs durch einen zweiten Agenten mit neuem Kontext), CI, Code Review, eine blockierende Sicherheitsprüfung, eine Merge-Warteschlange (merge queue) und eine schrittweise Veröffentlichung. Ein Klassifikator legt das Risiko anhand der Änderung fest, nicht anhand des Autors: keine menschliche Freigabe für Dokumentation oder eine Ergänzung hinter einem Feature Flag, eine Person für eine gewöhnliche Produktänderung oder einen sensiblen Bereich wie den Cache oder System-Prompts, zwei für die riskantesten Änderungen. Die Freigabe eines Agenten zählt niemals als die einer Person. Während der Research Preview von Code Review war der Anteil interner Pull Requests mit inhaltlichen Kommentaren bereits von 16 % auf 54 % gestiegen.
Der Beitrag beziffert auch ein agentenspezifisches Problem: Reviews, die zu keinem Abschluss kommen. Eine Pull Request für die CLI hatte in einer Nacht mehr als fünfzig Runden durchlaufen. Mit einer Begrenzung auf drei Runden, einer auf den neuen Diff beschränkten Prüfung und Meldungen nach Fehlerklasse kommen die Reviews schneller zum Abschluss:
| Kennzahl (interne Pull Requests von Claude Code) | Vor den Änderungen | Nach den Änderungen |
|---|---|---|
| Nach einer einzigen Review- und Korrekturrunde freigegeben | 65 % | 78 % |
| Fünf oder mehr Runden erforderlich | 8,9 % | 1,5 % |
| Durchschnittliche Anzahl von Reviews bis zur Freigabe | 2,08 | 1,32 |
Der Beitrag endet mit einer Umsetzungsliste: eine kurze CLAUDE.md, /code-review und /security-review lokal, eine von den Code-Verantwortlichen geschriebene REVIEW.md, schriftlich festgehaltene Risikostufen, eine Merge-Warteschlange und vergangene Vorfälle, die täglich als Evaluierungsdatensatz erneut durchgespielt werden.
🔗 Der Beitrag des Claude Code-Teams · Der Hinweis von @ClaudeDevs
Codex CLI 0.163.0: Steuerung während der Antwort, Suche in /config und Daybreak standardmäßig aktiviert
15. Oktober — OpenAI veröffentlicht Codex CLI 0.163.0 um 21:30 Uhr UTC, die erste stabile Version seit 0.162.1 vom 9. Oktober, mit 227 Einträgen seit 0.162.0. Daybreak, das mit Version 0.161.0 vom 7. Oktober an die Option cli_daybreak gebunden war, ist nun für berechtigte Konten standardmäßig aktiviert, und codex exec kann es mit einem OpenAI API-Schlüssel auswählen, sobald der Server den Zugriff freigibt.
| Bereich | Änderung in 0.163.0 |
|---|---|
| Steuerung | Eine während der Antwort gesendete Folgenachricht lenkt Codex sofort; das Unterbrechen eines Durchgangs stoppt auch aktive Code Mode-Zellen |
Befehl /config | Suche nach Einstellungen über alle Kategorien hinweg, kompatible Einstellungen werden sofort angewendet |
Befehl /keymap | Konfigurierbare Leader-Taste (standardmäßig Ctrl+X); die Stummschaltung der Sprachfunktion erfolgt nun über F9 |
Befehl /daemon | Neustart des verwalteten Hintergrundservers, anschließend automatische Wiederverbindung |
| Tools | Unabhängige Tools mit reinem Lesezugriff werden parallel ausgeführt |
| Netzwerk-Proxy | Berechtigung wird vor der DNS-Auflösung geprüft, doppelte Host-Header werden abgewiesen |
Beim Fortsetzen eines Threads werden auch dessen Berechtigungen und Netzwerkfreigaben wiederhergestellt, und Codex liefert keine modifizierte Version von zsh mehr mit: Es verwendet seinen Standard-Shell-Executor.
🔗 Die Versionshinweise zu Codex CLI 0.163.0
Cursor: Cloud-Agenten erstellen teilbare Arbeitsflächen, die Environments API geht in die Beta, Metas Muse Wonder erreicht 46,1 % auf CursorBench
16. Oktober — Die Cloud-Agenten von Cursor können nun interaktive Arbeitsflächen (canvases) erstellen: Während sie arbeiten, bittet man sie um ein Dashboard oder einen Bericht und teilt die fertige Arbeitsfläche anschließend per Link mit dem Team. Die Environments API geht in die Beta: Sie erstellt und verwaltet die Umgebungen dieser Agenten programmatisch, einschließlich geklonter Repositorys und der Konfiguration environment.json. Eine Umgebung unterstützt nun bis zu 500 Repositorys, und große Umgebungen mit mehreren Repositorys starten laut Cursor 5-mal schneller. Der im Thread verlinkte Changelog-Eintrag war am Abend des 16. noch nicht online, sodass weder die betroffenen Tarife noch der Preis oder der Termin für das Ende der Beta bekannt sind.
15. Oktober — Drei Tage nach seiner Einführung durch Meta kommt Muse Wonder in Cursor, zu 4 Dollar pro Million Eingabe-Tokens und 20 Dollar pro Million Ausgabe-Tokens, wie bei der API von Meta. Cursor hebt 46,1 % auf CursorBench bei der standardmäßigen Aufwandsstufe hervor, das beste Ergebnis eines Muse-Modells; die öffentliche Rangliste von CursorBench 4.0 führt die anderen Aufwandsstufen im Detail auf.
| Modell und Aufwandsstufe | Ergebnis CursorBench 4.0 | Kosten pro Aufgabe | Rang in der Rangliste |
|---|---|---|---|
| Claude Opus 5.5 Max | 57,8 % | 13,43 dollars | 1. |
| Muse Wonder Max | 50,4 % | 5,25 dollars | 12. |
| Muse Wonder Extra High | 48,2 % | 4,24 dollars | 15. |
| Muse Wonder High | 46,1 % | 3,51 dollars | 21. |
| Muse Wonder Medium | 45,2 % | 2,82 dollars | 22. |
| Muse Wonder Low | 41,7 % | 1,91 dollar | 32. |
| Muse Spark 1.3 Max | 41,6 % | 2,64 dollars | 34. |
🔗 Der Thread von Cursor zu Cloud-Agenten · Muse Wonder in Cursor · Die CursorBench-Rangliste
Gemini CLI erklärt, nicht für Gemini 4 Argon optimiert zu sein, und verweist auf Antigravity CLI
16. Oktober — Google hat in der Nacht einen Warnhinweis am Anfang des README von Gemini CLI hinzugefügt. Der Kasten erinnert daran, dass Gemini CLI für Nutzer des kostenlosen Tarifs und von Google One am 18. Juni 2026 durch Antigravity CLI ersetzt wurde, und stellt anschließend in Fettdruck klar, bevor er für die Nutzung von Argon auf Antigravity verweist:
Gemini CLI has not been optimized for Gemini 4 Argon.
🇩🇪 Gemini CLI wurde nicht für Gemini 4 Argon optimiert. — README von Gemini CLI, Pull Request 29774
Eine zweite Änderung, die etwas mehr als eine Stunde später zusammengeführt wurde, weitet den Hinweis auf alle neuesten Gemini-Modelle aus und verweist für die beste Programmiererfahrung auf Antigravity CLI. Dabei verliert das README seine bisherigen Argumente: den Abschnitt „Warum Gemini CLI?“ und dessen kostenlosen Tarif mit 60 Anfragen pro Minute und 1 000 pro Tag, die erweiterten Funktionen und die GitHub-Integration; die Anmeldung mit einem Google-Konto richtet sich nur noch an kostenpflichtige Code Assist-Lizenzen für Organisationen.
Diese Hinweiskästen setzen den am 19. Mai angekündigten Übergang fort: Seit dem 18. Juni bleibt Gemini CLI für Code Assist Standard- und Enterprise-Lizenzen sowie kostenpflichtige API-Schlüssel verfügbar, mit dem Versprechen, Zugang zu den neuesten Gemini-Modellen zu bieten. Drei Tage nach der allgemeinen Verfügbarkeit von Argon ist der Community-Vorschlag, der es zur Modellauswahl von Gemini CLI hinzufügt (Pull Request 29737), noch immer nicht zusammengeführt.
🔗 Pull Request 29775 zur Bereinigung des README · Der Beitrag vom 19. Mai zum Übergang zu Antigravity CLI
Kurzmeldungen
Agenten und Coding-Tools
- Amp zeigt den Desktop seiner Runner — Direkt aus einem Thread lässt sich jetzt der Desktop eines macOS- oder Linux-Runners anzeigen und steuern, etwa um eine mit Amp erstellte iOS-Anwendung auszuprobieren, über einen Browser oder die iPhone- und iPad-Apps; wer in einem Thread des Runners schreiben kann, kann auch dessen Desktop steuern. 🔗 Quelle
- v0 — Dateien, die für die Vorschau zu groß sind, lassen sich über den Tab Code herunterladen, die iOS-App erhält Auswahlmöglichkeiten für Skills und Design-Systeme sowie Videoanhänge, und Anfragen an Gemini 4 schlagen bei hohen Effort-Stufen nicht mehr fehl. 🔗 Quelle
- Copilot CLI als Preview — Drei Previews an einem Tag (1.0.99-2, 1.0.99-3 und 1.0.100-0), ohne stabile Version: Die semantische Codesuche wird zur Standardeinstellung für Online-Sitzungen, die Option
--disable-client-telemetrydeaktiviert die Client-Telemetrie, und ein festgefahrener MCP-Server blockiert die Sitzung nicht mehr. 🔗 Quelle - Copilot in Slack und Teams — @GitHub arbeitet jetzt innerhalb einer Unterhaltung an mehreren Repositories: offene oder zusammengeführte Pull Requests, Untersuchungen, die sowohl Frontend als auch Backend betreffen, Aktivitätszusammenfassungen; geteilte Slack-Nachrichten und -Threads dienen als Kontext. 🔗 Quelle
- Qwen Code v0.25.3-preview.0 — Einen Tag nach der stabilen v0.25.2 setzt eine Preview mit 64 Einträgen QwenCloud an die erste Stelle in /auth, gewährt dem Managed Agent vollständigen Shell-Zugriff mit umschaltbaren Genehmigungen und zeigt die Abläufe live in der Web Shell an. 🔗 Quelle
- Gemini CLI, Nightly 0.66.0 — Erste Nightly der Reihe mit neun Fehlerbehebungen: synchronisierte Ausgabe gegen Flackern unter tmux, Git-Prompts, die die Benutzeroberfläche einfrieren ließen, endlich aufgelöste .env-Variablen in den MCP-Einstellungen und SKILL.md-Dateien mit einzeiliger Beschreibung; Stable und Preview bleiben unverändert. 🔗 Quelle
- DeepSeek Harness 0.2.1-alpha.5 — 29. Preview ohne stabile Version: vier Fehlerbehebungen (Skills-Menü nach der Aktivierung eines Plugins, überflüssige Terminals, Anweisungen im PTC-Modus, Page-Up-Taste unter Windows und Linux) und eine Erweiterungsmöglichkeit, über die Plugins Modelle je Anbieter umbenennen können. 🔗 Quelle
ChatGPT, Claude und KI im Unternehmen
- ChatGPT Sites für Enterprise — @OpenAIDevs kündigt die allgemeine Verfügbarkeit für Enterprise an, mit Datenresidenz in den USA oder der EU für neue Sites, verifizierten Domains und privaten Tunneln zu internen APIs; die Enterprise-Versionshinweise sprechen von einer Administrator-Preview, die gerade ausgerollt wird, und bei Plus und Pro entfällt die feste Begrenzung der Anzahl an Sites. 🔗 Quelle
- ChatGPT Slides wird ausgerollt — Die am DevDay vom 29. September angekündigten kollaborativen Präsentationen kommen für berechtigte Pro-, Business- und Enterprise-Abonnenten in Space an, mit gemeinsamer Bearbeitung in Echtzeit, Präsentation direkt aus ChatGPT und Export nach PowerPoint, PDF oder Google Slides. 🔗 Quelle
- Stack Overflow for Agents — Laut einer Fallstudie von OpenAI haben zwei Entwickler das Produkt innerhalb weniger Wochen mit Codex fertiggestellt; sein ChatGPT-Plugin verdreifachte die Anmeldungen über Nacht, und ein Connector für Stack Internal lässt sich in 4 Tagen statt in 3 bis 6 Wochen erstellen. 🔗 Quelle
- Sullivan & Cromwell — Die Anwaltskanzlei hat gemeinsam mit OpenAI Agreement Analyzer entwickelt, dessen Prototyp John Savva innerhalb der Kanzlei mit Codex erstellte und das zu einem Vertragsentwurf ein Memorandum sowie Änderungsvorschläge liefert, die der Anwalt prüft; die Studie nennt keine Zahlen zum Effizienzgewinn. 🔗 Quelle
- Die Agenten eines Vertriebsmitarbeiters von Anthropic — Shahboz Ibragimov aus dem Japan-Team beschreibt sechs Agenten auf Claude Managed Agents (Sortierung von Interessenten, Salesforce, Antworten auf Japanisch oder Englisch, Gesprächsprotokolle), Claude Tag für die Nachverfolgung sowie Sonnet oder Opus je nach erforderlichem Urteilsvermögen; laut seinem wöchentlichen Arbeitsprotokoll wurden rund 60 Arbeitsstunden eingespart. 🔗 Quelle
- American Forge — Cognition und das National Design Studio starten ein sechsmonatiges Residenzprogramm, das Ingenieure in die US-Regierung einbindet; der Beitrag beziffert die Zahl alter oder veralteter Websites der US-Bundesbehörden auf über 29 000; Bewerbungen sind möglich, Angaben zur Vergütung oder zur Anzahl der Plätze fehlen. 🔗 Quelle
Generierte Stimmen und Videos
- HeyGen Video 1 im MCP von HeyGen — Man beschreibt seinem Agenten (ChatGPT, Claude, Claude Code oder Cursor) das gewünschte Video und erhält es fertig zur Veröffentlichung zurück, laut HeyGen innerhalb weniger Sekunden; die Renderings werden vom Guthaben des Tarifs abgezogen. 🔗 Quelle
- NTT Docomo Business und ElevenAgents — Der Betreiber testet in Aizuwakamatsu (Fukushima) seinen auf ElevenAgents basierenden Sprachassistenten CONN, um ältere Einwohner, die wegen des Schnees nicht hinausgehen können, zu informieren und mit ihnen Gespräche zu führen; die Rückmeldungen werden als positiv bewertet, Zahlen fehlen. 🔗 Quelle
- Zertifizierungen von ElevenLabs — ElevenLabs erneuert seine Zertifizierungen ISO/IEC 27001, 27701, 42001, 27017 und 27018, SOC 2 Type II und PCI DSS Level 1 und ergänzt SOC 2 Type I für ElevenProductions. 🔗 Quelle
Modelle, Benchmarks und Forschung
- Mistral Large 4 auf STEMBench — Mistral hebt den wissenschaftlichen Benchmark von Ulam hervor, bei dem sein Modell ohne Tools 2,501 von 4 erreicht (2,602 im Ingenieurwesen, 2,597 in Astronomie): Platz 6 unter 10 Konfigurationen und Platz 4 ohne Tools, hinter Muse Wonder, Claude Opus 5.5 und Hy4 Preview; die beiden Erstplatzierten, GPT-6 Astra xhigh und GPT-6.1 Sol, liefen mit Tools in Codex. 🔗 Quelle
- Jebadiah v2.1 — Zwei offene Entscheidungsmodelle mit 27B und 9B, veröffentlicht am 10. Oktober unter Apache-2.0, erreichen im Decision Index unter 168 Teilnehmern 55,94 (35.) und 44,91 (74.), hinter Jev 1.13 (60,11). 🔗 Quelle
- Nemotron 3.5 Super VL und Diagramme — Laut Thoughtworks steigert ein LoRA, das 3,3 Stunden auf 24 000 generierten Diagrammen trainiert wurde, die Leistung eines vorläufigen Checkpoints des Modells bei 224 Fragen aus CharXiv von 16,96 % auf 78,13 %, auf Kosten eines Nettoverlusts von 104 korrekt beantworteten Fragen in anderen Bereichen. 🔗 Quelle
- Intels Arc Pro B65 — Ein Community-Benchmark unter llama.cpp misst bei drei Modellen mit etwa 30B in 4 Bit einen um 31,2 % schnelleren Prefill mit SYCL und flash attention als mit Vulkan: Bei zwei davon erscheint der erste Token eines Prompts mit etwa 16 000 Tokens nach 20,5 Sekunden statt nach 42. 🔗 Quelle
- TB-Lite Verified — Hugging Face stellt ohne Ankündigung eine korrigierte Version des Benchmarks OpenThoughts-TBLite für Terminal-Agenten online: fünf fehlerhafte Aufgaben von 100 entfernt, eine auf 0,997 gedeckelte Bewertung korrigiert, keine Ergebnisse veröffentlicht. 🔗 Quelle
- AutoIllustrate von Sakana AI — Als Nachtrag zum 14. Oktober: Ein Kommandozeilentool unter Apache-2.0 verwandelt den Abschnitt „Methoden“ eines Artikels in eine bearbeitbare draw.io-Abbildung und anschließend in eine stilistisch überarbeitete PNG-Datei; es wurde für die Abbildungen von The Agentic Scientist eingesetzt. 🔗 Quelle
- Übermäßige Zustimmung von LLM laut Meta — facebookresearch veröffentlicht ohne Ankündigung die Prompts und Bewertungsraster des Artikels „From Preference Data to Personalization“, der Antworten in sieben Typen einteilt, vom offenen Widerspruch bis zur ausdrücklichen Bestätigung; weder Modell noch Zahlen. 🔗 Quelle
- Anthropic und die Simons Foundation — Anthropic stellt 5 Millionen Dollar in Form von Finanzierung, Rechenleistung und Zugang zu Claude für Mathematiker bereit, verwaltet von der Simons Foundation; zusammen mit der Stiftung und OpenAI, das ebenfalls 5 Millionen Dollar beisteuert, erreicht das Gesamtvolumen laut Simons Foundation 15 Millionen Dollar, die unter anderem über Ausschreibungen vergeben werden. 🔗 Quelle
Leitfäden und Auszeichnungen
- Die Sicherheit von LLM laut Perplexity — Ein Leitfaden behandelt die zehn Risiken der OWASP Top 10 for LLM Applications 2026 mit jeweils einem Vorfall und Schutzmaßnahmen und erinnert an die Schutzmechanismen von Perplexity (Sandbox von Computer, BrowseSafe für Comet, keine Datenspeicherung bei Drittanbietern); keine neue Funktion. 🔗 Quelle
- Mit KI lernen — Perplexity veröffentlicht fünf wissenschaftlich gestützte Methoden (sich abfragen lassen, Lerneinheiten zeitlich verteilen, Inhalte erneut erklären, abwechseln, eigene Fortschritte verfolgen) und zitiert Gallup und die Lumina Foundation: 57 % der US-amerikanischen Studierenden nutzen jede Woche KI für ihr Studium. 🔗 Quelle
- Zwei Erfindungen des Jahres bei TIME — Das Magazin zählt Omnilingual ASR von Meta, eine Spracherkennung für mehr als 1 600 Sprachen, und NemoClaw von NVIDIA, einen in einer Sandbox abgeschotteten autonomen Agenten, zu seinen besten Erfindungen des Jahres 2026. 🔗 Meta · 🔗 NVIDIA
GitHub: Lizenzen, Runner und Zugriff
- Einhaltung von Open-Source-Lizenzen — Allgemeine Verfügbarkeit für GitHub Enterprise Cloud mit Code Security: Eine unternehmensweite Lizenzrichtlinie wird über einen Regelsatz bei Pull Requests durchgesetzt, und ein neuer Endpoint ermöglicht Coding-Agenten zu prüfen, ob ein Paket diese Richtlinie einhält. 🔗 Quelle
- Xcode-27-Image — Abseits der KI wird das Runner-Image Xcode 27 von GitHub Actions (macOS 27, nur Apple Silicon) allgemein verfügbar, mit den unveränderten Labels xcode-27 und xcode-27-xlarge. 🔗 Quelle
- Evergreen — Abseits der KI stellt GitHub die GitHub App vor, die jedes Quartal unbestätigte Zugriffsrechte externer Mitwirkender widerruft und inaktive Repositories einer gemeinsam genutzten Organisation mit über 1 400 Beschäftigten archiviert, ohne sie jemals zu löschen. 🔗 Quelle
Was das bedeutet
Elliptische Kurven waren am selben Tag Thema zweier Beiträge von Anthropic, die das Thema von zwei Seiten beleuchteten. Beim Blick in die Vergangenheit rekonstruiert Claude den Generator und die Zeitstempel hinter den Seeds des NIST: Nichts wurde geknackt, wie Anthropic wiederholt betont, aber eine Manipulation wird deutlich weniger plausibel, und jeder kann das Ergebnis mit dem unter CC0 veröffentlichten Code reproduzieren. Beim Blick in die Zukunft findet Claude Mythos 5 eine Schaltung zur Punktaddition auf elliptischen Kurven, die bei 12 % mehr Qubits 17-mal weniger Gatter benötigt, ein zentraler Baustein der Quantenalgorithmen, die den diskreten Logarithmus auf elliptischen Kurven berechnen könnten, das Problem, von dem die Sicherheit von ECDSA abhängt. Anthropic leitet daraus ab, dass nützliche Quantencomputer früher als erwartet kommen könnten: Das Vertrauen in die Erzeugung dieser Kurven wächst zu einem Zeitpunkt, an dem die geschätzten Kosten für Quantenschaltungen sinken, die sie eines Tages gefährden könnten.
In den Laboren arbeiten Agenten länger allein, und die Überprüfung wird zur Voraussetzung für ihre Glaubwürdigkeit. Claude Mythos 5 lief 53 Stunden lang unter Bewertung durch einen automatischen Evaluator, mit einem in Lean formalisierten Beweis; die Argon-Agenten spielten mehr als 27 Stunden unter Aufsicht eines Observer, der Betrugsversuche erkennen sollte; der Agent von Antigravity verfasst ein Protokoll, doch sein Bakteriozin wartet noch auf die Validierung im Labor. Die Tools für Forschende folgen derselben Logik: Deep Review prüft Aussagen und Konsistenz vor der Einreichung, Open Math OS stützt sich auf Lean und hält Projekte standardmäßig privat, und der Rosalind Academic Plan gewährt erst nach Genehmigung eines vertrauenswürdigen Zugangs Zugriff auf GPT-Rosalind.
Bei offenen Modellen wird die Lizenz wieder zu einem Argument. Einen Tag nach Muse Spark Open, das unter der Muse Model License mit eingeschränkten kommerziellen Nutzungsrechten veröffentlicht wurde, erscheint Beam unter Apache 2.0, mit mehr als 40 Partnern am ersten Tag, einem NVFP4-Checkpoint und dem Harness, mit dem es trainiert wurde. Kleinere Formate nutzen dieselbe Lizenz und zielen auf Effizienz: Das kleinste Bonsai 2 passt in 0,43 Go und läuft auf einem Telefon, und Entscheidungsmodelle etablieren sich als eigene Kategorie, mit pplx-decider-v1.2 und seiner Flash-Version für 0,02 beziehungsweise 0,01 Dollar je Million Tokens, den Adaptern von Granite Switch 4.1, die den Cache des Basismodells wiederverwenden, und einer gemeinsamen Rangliste, dem Decision Index.
Das Harness zählt inzwischen genauso viel wie das Modell. Reflection liefert Beam mit Mirror CLI aus, Google verweist Argon-Nutzer auf Antigravity CLI statt auf Gemini CLI, und das Team von Claude Code bringt die Verdoppelung seiner Merges mit der Überarbeitung seiner Review-Pipeline in Verbindung, in der ein Klassifikator entscheidet, wie viele Menschen erforderlich sind. Im Endkundenbereich wächst die Reichweite der Agenten: GPT-6 Astra Pro verteilt eine Aufgabe auf mehrere Agenten, Grok Bot verbindet sich mit Robinhood, Coinbase und eToro, und die Plugins von ChatGPT werden zu einem Vertriebskanal, von den Tools von Pika bis zur Verdreifachung der Anmeldungen bei Stack Overflow for Agents.
Quellen
- Der Beitrag des Frontier Red Team von Anthropic zu ECDSA-Kurven
- Filippo Valsordas Prämie für die Seeds des NIST
- Beam ist jetzt verfügbar (Reflection)
- Beam (Blog von Hugging Face)
- Modellkarte von Beam-1.0-501B-A23B (Hugging Face)
- Beam auf Blackwell Ultra (@NVIDIAAI)
- Der Durchsatz von Beam auf 90 000 tokens pro Sekunde gesteigert (@NVIDIAAI)
- pplx-decider-v1.2 (Hugging Face)
- pplx-decider-flash-v1.2 (Hugging Face)
- Changelog der Perplexity API
- Granite Switch 4.1 (Blog von IBM auf Hugging Face)
- Granite Switch 4.1 30B (Hugging Face)
- Bonsai 2 (@PrismML)
- Ternary-Bonsai-2-9B-gguf (Hugging Face)
- Nemotron-pretraining-Indic-v1 (Blog von NVIDIA auf Hugging Face)
- Effiziente Quantenschaltungen entwerfen (Anthropic)
- Die Quantenschaltungen von Claude Mythos 5 (arXiv)
- Die Suche nach antimikrobiellen Peptiden beschleunigen (Google DeepMind)
- Antigravity für die Wissenschaft
- Technische Dokumente mit Deep Review analysieren (Google Research)
- Research@ 2026 (Blog von Google)
- Earth AI zum Einsatz bringen (Google Research)
- Open Math OS (@SAIRfoundation)
- Open Math Model
- Vorstellung des Rosalind Academic Plan (OpenAI)
- Der Rosalind Academic Plan (@OpenAI)
- Ein Team von Gemini 4 Argon-Agenten spielt Minecraft durch (@maxencefaldor)
- Der geteilte Beitrag von Google DeepMind (@GoogleDeepMind)
- Der technische Bericht zu Minecraft (arXiv)
- Gemini 4 Argon in Perplexity (@perplexity_ai)
- Modelle der Agent API (Perplexity)
- GPT-6 Astra Pro in ChatGPT (@OpenAI)
- Die Neuerungen von Grok Bot (@bot)
- Plugins für Grok Bot einreichen (x.ai)
- Die Stimmen von GPT-Live (@OpenAIDevs)
- Leitfaden für benutzerdefinierte Stimmen (OpenAI)
- GPT-Live und die Decisions API (OpenAI)
- Pika × ChatGPT (@pika_labs)
- Eintrag zum Pika-Plugin (ChatGPT)
- Die Qualitätsmodi von Ideogram 4.5 (@ideogram_ai)
- Mirelo SFX 2.0 auf Runway (@runwayml)
- Die Dauer der Clips laut Runway (@runwayml)
- Das Problem der Code Reviews bei Anthropic lösen (claude.dev)
- Der geteilte Beitrag von @ClaudeDevs
- Codex CLI 0.163.0 (GitHub)
- Canvas und Environments API (@cursor_ai)
- Muse Wonder in Cursor (@cursor_ai)
- CursorBench-Rangliste
- Pull request 29774 von Gemini CLI (GitHub)
- Pull request 29775 von Gemini CLI (GitHub)
- Der Übergang von Gemini CLI zu Antigravity CLI (Google Developers)
- Amp und das Büro der Runner
- Changelog von v0 vom 16. Oktober
- Copilot CLI 1.0.99-2 (GitHub)
- Copilot in Slack und Teams (Changelog von GitHub)
- Qwen Code v0.25.3-preview.0 (GitHub)
- Gemini CLI v0.66.0-nightly.20261016 (GitHub)
- DeepSeek Harness 0.2.1-alpha.5 (GitHub)
- ChatGPT Sites für Enterprise (@OpenAIDevs)
- Versionshinweise zu ChatGPT
- Stack Overflow und sein ChatGPT-Plugin (OpenAI)
- Sullivan & Cromwell (OpenAI)
- Der Arbeitstag eines Vertriebsmitarbeiters von Anthropic in Japan (Claude)
- American Forge (Blog von Cognition)
- HeyGen Video 1 im MCP von HeyGen (@HeyGenDev)
- NTT Docomo Business und ElevenAgents (ElevenLabs)
- Erneuerung der Zertifizierungen (ElevenLabs)
- Mistral Large 4 auf STEMBench (@MistralAI)
- Jebadiah v2.1 (Blog von Hugging Face)
- Nemotron 3.5 Super VL und CharXiv (Blog von Hugging Face)
- Intel Arc Pro B65 (Blog von Hugging Face)
- TB-Lite Verified (GitHub)
- AutoIllustrate (GitHub)
- Sycophancy in Large Language Models nachverfolgen (GitHub)
- Anthropic und die Simons Foundation (@AnthropicAI)
- Was ist LLM-Sicherheit? (Perplexity)
- So nutzt man AI zum Lernen (Perplexity)
- Omnilingual ASR unter den Erfindungen von TIME (@AIatMeta)
- NemoClaw unter den Erfindungen von TIME (@NVIDIAAI)
- Einhaltung von Open-Source-Lizenzen (Changelog von GitHub)
- Image für Xcode 27 (Changelog von GitHub)
- Dauerhaft aktuell bleiben (GitHub Blog)