ai-powered-markdown-translatorمقال مترجم من الفرنسية إلى العربية باستخدام gpt-6.1-sol.
اكتشف نموذج بحثي داخلي لدى Anthropic، في أقل من نصف ساعة، مصدر بذور منحنيات ECDSA لدى NIST، التي قدّمتها NSA دون تفسير: فهي ناتجة عن مولّد عادي للأعداد شبه العشوائية، جرت تهيئته باستخدام الساعة في عامَي 1997 و1998، مما يجعل احتمال وجود باب خلفي أقل بكثير، وفقًا لـAnthropic. وتنشر Reflection أوزان Beam، وهو نموذج مزيج خبراء يضم 501 مليار معلمة بموجب ترخيص Apache 2.0، ويدعمه أكثر من 40 شريكًا منذ اليوم الأول، بينما يهزم أربعة وكلاء Gemini 4 Argon لعبة Minecraft في 27 ساعة، ويحسّن Claude Mythos 5 أفضل الدارات الكمومية المنشورة في ثماني مهام. وعلى صعيد المنتجات، بات GPT-6 Astra Pro يوزّع المهمة بين عدة وكلاء في ChatGPT، وأصبح Grok Bot ينجز مهامه على الحاسوب بسرعة أكبر بثلاث مرات.
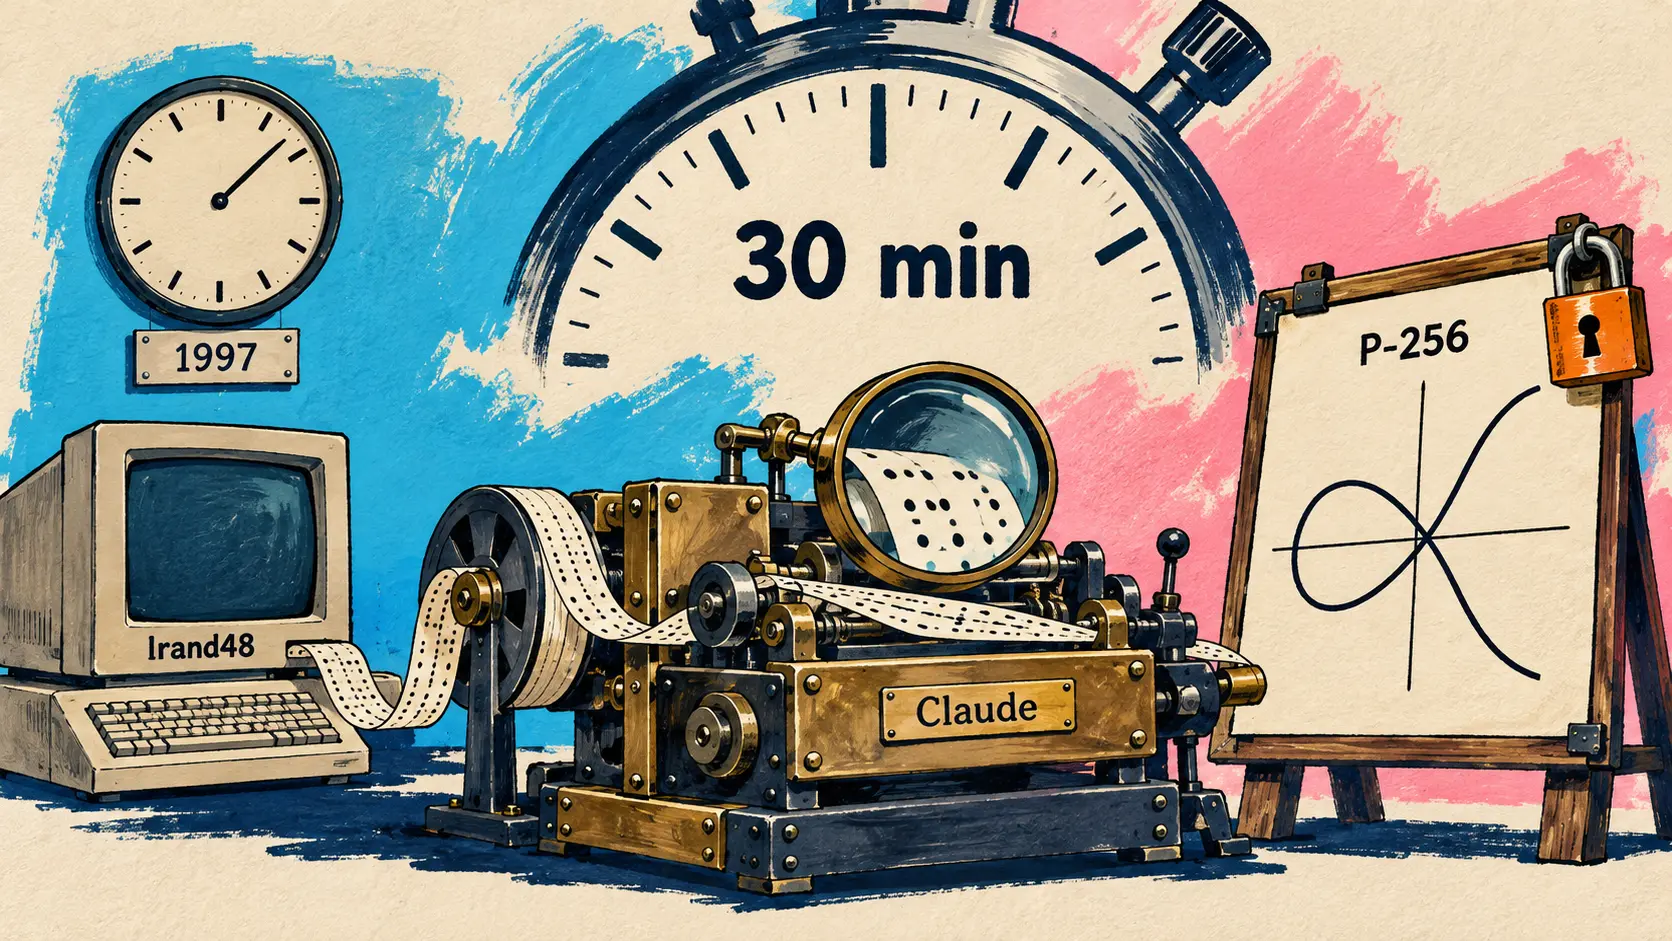
منحنيات ECDSA لدى NIST: يكشف Claude مصدر بذورها، المستخرجة من مولّد جرت تهيئته باستخدام الساعة في عامَي 1997 و1998
16 أكتوبر — يروي فريق الاختبار الهجومي المتقدم في Anthropic كيف حلّ Claude لغزًا قديمًا في علم التشفير. عندما اعتمد NIST خوارزمية التوقيع ECDSA عام 2000 ضمن المعيار FIPS 186-2، جاءت منحنياته الإهليلجية القياسية مع «بذور» (seeds) تحدد تجزئتها المعامل b لكل منحنى. وكانت هذه القيم، التي قدّمتها NSA دون تفسير، تغذّي منذ سنوات الشكوك حول وجود باب خلفي، فيما كانت مكافأة عامة أطلقها فيليبو فالسوردا تنتظر من يكشف مصدرها. ولم يؤدِّ أشهر خيط بحث، وهو عبارة فكاهية أُدخلت في دالة تجزئة، كان جيري سوليناس من NSA قد ذكرها عام 2015 قبل وفاته عام 2023، إلى أي نتيجة.
طرح أحد موظفي Anthropic السؤال على نموذج بحثي داخلي لم يُذكر اسمه، دون أن يلمّح له إلى هذا الخيط. وفي أقل من نصف ساعة، اكتشف Claude أصل بذور P-192 وP-224 وP-256 وP-384 وP-521: لا تمثّل أيٌّ منها ناتج تجزئة، بل تخرج جميعها من lrand48، مولّد الأعداد شبه العشوائية في مكتبة C، بعد تهيئته بطابع زمني من Unix. وبعد تمحيص 34 توليفة من المولّدات ومقاطع مخرجاتها، رصد Claude بصمة lrand48 في البتات الأعلى قيمة، وأعاد بناء حالته الداخلية عبر اختزال الشبكات بخوارزمية LLL، ثم تتبّع تهيئة البذور العشر المعنية، خمس منها لدى NIST وخمس ضمن المعيار ANSI X9.62، وتقع جميعها بين مايو 1997 وأبريل 1998.
| النقطة التي فحصها Claude | النتيجة التي نشرتها Anthropic |
|---|---|
| مدة التوصل إلى الاكتشاف | أقل من 30 دقيقة |
| مثال P-256 | المرشح رقم 1842 من توليد أُجري في 16 أغسطس 1997 (وكان المرشح رقم 876 من التوليد نفسه صالحًا أيضًا) |
| بذور المنحنيات الثنائية التي كُشف مصدرها | B-233 وB-283 وB-409 وB-571، التي تُقرأ بوصفها فبراير 1984، أي 17 أبريل 1998 عند مضاعفة الطابع الزمني |
| نقاط الأساس التي فُسّر مصدرها | ستة منحنيات وُلّدت في مايو 1997 (P-192 وخمسة منحنيات نموذجية من ANSI X9.62)، باستخدام مولّد FreeLIP |
| ما يزال غير مفسّر | بذرة B-163؛ ونقاط الأساس لكل من P-224 وP-256 وP-384 وP-521 والمنحنيات الثنائية |
تأتي نقاط الأساس هذه من FreeLIP، مكتبة آرين لينسترا: ووفقًا لـAnthropic، لم يكن مصدر أي نقطة أساس لدى NIST قد فُسّر حتى الآن. كما يظل المعيار الذي استُخدم لاستبعاد بعض المرشحين الصالحين مجهولًا. وتورد التدوينة أخيرًا تأمل النموذج، الذي يشكّك في اكتشافه قبل تأكيده بالحساب:
This is astonishing: it solves the 25-year-old mystery. Hmm wait. Let me be skeptical: am I in some sort of simulated/test environment?
🇸🇦 هذا مذهل: إنه يحل اللغز الذي مضى عليه 25 عامًا. همم، انتظر. يجب أن أبقى متشككًا: هل أنا داخل نوع من بيئات المحاكاة أو الاختبار؟ — Claude، تأمل نقلته تدوينة فريق الاختبار الهجومي المتقدم في Anthropic
تشدّد Anthropic على حدود هذا الاكتشاف: لا كسر للتشفير، ولا هجوم جديد، ولا نقطة ضعف، و«لا إجراء مطلوبًا». فالبذرة المستخرجة من الساعة باستخدام مولّد عادي، والتي يستطيع الجميع الآن إعادة إنتاجها، تجعل احتمال وجود باب خلفي «أقل بكثير». ونُشرت الشيفرة التي تعيد إنتاج البذور ونقاط الأساس الست بموجب ترخيص CC0، وستُحوّل المكافأة البالغة 36 864 دولارًا إلى مجموعة أبحاث أمن الإنترنت (ISRG).
🔗 تدوينة فريق الاختبار الهجومي المتقدم في Anthropic · مكافأة فيليبو فالسوردا
النماذج المفتوحة: تنشر Reflection أوزان Beam، إلى جانب pplx-decider-v1.2 وGranite Switch 4.1 وBonsai 2 ومجموعة بيانات من NVIDIA بـ22 لغة هندية
16 أكتوبر — بعد أحد عشر يومًا من تقديمه، تنشر Reflection أوزان Beam، أول نموذج لها بأوزان مفتوحة، بموجب ترخيص Apache 2.0. ويستهدف نموذج مزيج الخبراء هذا (Mixture-of-Experts، أو MoE)، الذي يضم 501 مليار معلمة، منها 23 مليارًا نشطة لكل رمز، البرمجة والاستدلال ومهام الوكلاء طويلة المدة، مع سياق يبلغ مليون رمز، ويقتصر على النص. وفي 5 أكتوبر، لم تكن Reflection قد أتاحت سوى وصول مبكر، مع وعد بنشر الأوزان «لاحقًا في أكتوبر».
يشمل الإصدار الأوزان بصيغ BF16 وFP8 وNVFP4، وأداة تقسيم النص إلى رموز، والتنفيذ المرجعي، ونموذج المسودة DFlash2 لفك الترميز التخميني، وMirror CLI، إطار التشغيل المفتوح المصدر الذي دُرّب Beam باستخدامه (واجهة بلغة Python، ونواة وكيل بلغة Rust، ووكلاء يعملون بالتوازي في أشجار عمل Git منفصلة، ومهارات واتصالات MCP). ويدعمه أكثر من 40 شريكًا منذ اليوم الأول: Transformers (v5.20.1) وvLLM وSGLang وUnsloth وAxolotl وDynamo على صعيد البرمجيات؛ وAWS وGoogle Cloud وAzure وTogether AI وFireworks AI وOpenRouter وOllama على صعيد الاستضافة؛ وDell وHPE للنشر داخل المؤسسات. وأصبحت واجهة API لدى Reflection في مرحلة تجريبية عامة.
تفصّل تدوينة Hugging Face البنية: من بين 52 طبقة، تستخدم 43 طبقة آلية انتباه بنافذة منزلقة من 512 رمزًا، وتستخدم 9 طبقات آلية انتباه شاملة، مما يخفض ذاكرة KV المؤقتة إلى 36 Kio لكل رمز بدلًا من 208 Kio، أي 36,08 Gio لكل تسلسل من مليون رمز بدلًا من 208 Gio. ويبلغ حجم الأوزان نحو 1 To بصيغة BF16 و280 Go بصيغة NVFP4، وتوصي Hugging Face باستخدام أربع وحدات B200 لتشغيل النموذج وتقديمه.
| اختبار الأداء (أرقام Reflection) | Beam بصيغة BF16 | Beam بصيغة FP8 | Beam بصيغة NVFP4 |
|---|---|---|---|
| SWE-bench Verified | 81,6 % | 80,2 % | 80,7 % |
| Terminal Bench v2.1 | 80,1 % | 78,9 % | 78,4 % |
| SWE Bench Pro v1 | 66,1 % | 65,9 % | 65,6 % |
| AIME 2026 | 97,7 % | 98,0 % | 97,5 % |
| GPQA Diamond | 90,6 % | 90,3 % | 89,3 % |
| MCP Atlas | 80,8 % | 81,5 % | 80,5 % |
وفقًا لـNVIDIA، دُرّب Beam على منظومات GB300 NVL72، ويقدّم أكثر من 70 000 رمز في الثانية لكل GPU على Blackwell Ultra منذ اليوم الأول، دون ضبط خاص (جاهزًا للاستخدام)؛ وبعد ساعات قليلة، أعلنت NVIDIA بلوغ نحو 90 000، دون تحديد ظروف القياس (حجم الدفعة، وطول السياق، وعدد وحدات GPU). ونُشرت نقطة التحقق بصيغة NVFP4 على Hugging Face، هي أيضًا بموجب ترخيص Apache 2.0.
🔗 تدوينة Reflection · تدوينة Hugging Face · بطاقة النموذج · منشور NVIDIA · رفع معدل التوليد إلى 90 000 رمز في الثانية
pplx-decider-v1.2 وإصداره Flash: تنشر Perplexity نموذجَي قرار بأوزان مفتوحة لواجهة Decisions API
16 أكتوبر — تحدّث Perplexity نماذج واجهة Decisions API، التي أطلقتها في 1 أكتوبر. ويحلّ pplx-decider-v1.2 محل v1.1 بوصفه نموذج قرار يضم 27 مليار معلمة، بالسعر نفسه، فيما يصل pplx-decider-flash-v1.2، وهو نموذج جديد يضم 4 مليارات معلمة جرى تقطيره من نماذج 27B، بنصف السعر. ويقرأ كلاهما النصوص والصور، وتظل المخرجات مجانية، وتتوفر الأوزان على Hugging Face بموجب ترخيص Apache 2.0؛ أما الاستدعاءات التي ما تزال تحدّد v1.1 أو v1 فتنتقل تلقائيًا إلى v1.2.
| نموذج القرار | النموذج الأساسي | سعر الإدخال (لكل مليون رمز) | النتيجة في Decision Index 0.3 | النتيجة في Vision Decision Index 0.3 |
|---|---|---|---|---|
| pplx-decider-v1.1-27b | Qwen3.8-27B | 0,02 دولار | 62,30 | 73,22 |
| pplx-decider-v1.2 | Qwen3.8-27B | 0,02 دولار | 68,09 | 77,43 |
| pplx-decider-flash-v1.2 | Qwen3.5-4B | 0,01 دولار | 58,88 | 72,53 |
يغيّر v1.2 تنسيق الطلب: يقرأ النموذج الحالة ثم جميع الأسئلة ضمن تسلسل واحد، بحيث تصبح تكلفة عدة أسئلة عن الحالة نفسها مقاربة لتكلفة سؤال واحد. ويساعد التجميع عندما تصف الأسئلة جوانب القرار نفسه (+11,3 نقطة على SATA-Bench)، لكنه يضرّ بالأداء عندما تُستخدم الأسئلة للمفاضلة بين مرشحين مستقلين (−4,8 على ToolRet). وأضافت Perplexity أيضًا إلى التدريب مجموعات التدريب الرسمية لبعض اختبارات Decision Index، بعد تنقيتها من بيانات مجموعات اختبارها. وعلى وحدة GB200، يجيب v1.2 عن طلب منفرد بزمن وسيط يبلغ 96 ms.
🔗 pplx-decider-v1.2 على Hugging Face · pplx-decider-flash-v1.2 على Hugging Face · سجل تغييرات واجهة API لدى Perplexity
Granite Switch 4.1: تجمع IBM المحادثة والقرارات والتفريغ الصوتي في نموذج مفتوح واحد
15 أكتوبر — تنشر IBM على مدونة Hugging Face نموذج Granite Switch 4.1 بحجمَي 8B و30B بموجب ترخيص Apache 2.0. ويجمع كل نموذج بين نموذج للمحادثة ومحوّلَي قرار ونموذج للتعرف على الكلام، وتُقدّم جميعها عبر نقطة وصول واحدة.
| مكوّن Granite Switch 4.1 | الدور المعلن من IBM |
|---|---|
| محوّل Decision (aLoRA) | قرارات عامة، بتنسيق /v1/systemone |
| محوّل Guardian (aLoRA) | قرارات متعلقة بالأمان، متقدمًا في المتوسط على Jev 1.13 وMicrosoft-Decision-1 وGPT-Luna-Decisions وClef-Flash، وفقًا لـIBM |
| Granite-Speech-5.0-Turbo-CTC | التفريغ الصوتي، ويُقدَّم بوصفه أسرع نموذج في Open ASR Leaderboard |
تستخدم المحوّلات تقنية Activated LoRA: فهي تعيد استخدام ذاكرة KV المؤقتة التي ينتجها النموذج الأساسي، بحيث لا يستلزم اتخاذ قرار بعد إجابة إعادة حساب السياق، وتشغل المنظومة كاملةً ذاكرة تقارب ما يشغله النموذج الأساسي وحده. وتعمل النماذج في vLLM باستخدام إضافة، وبصورة أصلية في llama.cpp، بوصفها بديلًا مباشرًا لاستدعاءات /v1/systemone. وتعرض IBM أيضًا نموذج Granite Switch بحجم 3B دُرّب للعب Doom، ويتخذ من 60 إلى 100 قرار في الثانية، مقابل 10 قرارات مُعلنة لـJev، وتخطط لإتاحة SDK لتدريب محوّلات مخصصة في Mellea. ولا تُقدَّم المقارنات مع نماذج القرار الأخرى إلا في رسوم بيانية.
🔗 تدوينة IBM · Granite Switch 4.1 30B على Hugging Face
Bonsai 2: تنشر PrismML نماذج رؤية بأوزان ثلاثية القيم من 2B إلى 9B، بحجم يتراوح بين 0,43 و2 Go
15 أكتوبر — تنشر PrismML نماذج Bonsai 2 بأحجام 2B و4B و9B، وهي نماذج بأوزان ثلاثية القيم (−1 أو 0 أو +1)، مشتقة من Qwen3.5 وتفهم الصور أيضًا، بموجب ترخيص Apache 2.0. وتحتفظ هذه النماذج بسياق النموذج الأساسي البالغ 262 144 رمزًا، وأصبحت عائلة Bonsai 2 تضم أربعة أحجام، من 2B إلى 27B.
| نموذج Bonsai 2 | حجم الأوزان ثلاثية القيم |
|---|---|
| 2B | 0,43 Go |
| 4B | 0,95 Go |
| 9B | 2,0 Go، مقابل نحو 17,9 Go بصيغة FP16 |
تقول PrismML إنها ركّزت على الاستخدام بوصفه مساعدًا محليًا: اتباع التعليمات، وتجنّب الحلقات التكرارية، واستدعاء الأدوات على الهاتف، وتقديم إجابات دون نص زائد. وبحسب الشركة، يستهلك 9B رموزًا أقل بنحو 40 % في مهام شائعة تتعلق باتباع التعليمات والرياضيات، دون تحديد أساس المقارنة، ويعمل بسرعة تصل إلى 34 رمزًا في الثانية على iPhone 18 Pro Max، مقابل 120 للنموذج 2B. وتتطلب الصيغ الأكثر ضغطًا النسخة المتفرعة من llama.cpp لدى PrismML، إذ لا يقرأ الإصدار الرسمي من llama.cpp سوى صيغة Q2_0؛ وتتوفر نسخة MLX لأجهزة Mac.
🔗 سلسلة منشورات PrismML · بطاقة نموذج 9B بصيغة GGUF
Nemotron-pretraining-Indic-v1: تفصّل NVIDIA وAI4Bharat مجموعة بيانات تضم نحو 2 800 مليار رمز بـ22 لغة هندية
16 أكتوبر — تفصّل NVIDIA وAI4Bharat، المختبر التابع للمعهد الهندي للتكنولوجيا في مدراس والمتخصص في اللغات الهندية، مجموعة Nemotron-pretraining-Indic-v1، وهي مجموعة بيانات التدريب المسبق التي ورد ذكرها في اليوم السابق ضمن بيانات Nemotron 3.5 Super VL: نحو 2 800 مليار رمز، منها 2 601 مليار بالكتابات الأصلية و224,6 مليار منقولة إلى الحروف اللاتينية، باللغات الـ22 المعترف بها في الدستور الهندي، والتي كانت اللغات الأم لـ97 % من الهنود وفق تعداد عام 2011. لم تُتح المجموعة على الإنترنت بعد: ستُنشر «قريبًا»، إلى جانب مسار التوليد المسرَّع بوحدات GPU الذي أنتجها.
النصوص ترجمات لوثائق إنجليزية مأخوذة من 15 مجموعة فرعية من Nemotron-CC-v2. في 12 لغة، يترجم Gemma-4-31B-it وثائق كاملة، ويقيّم كل ترجمة وفق شبكة مستوحاة من MQM بحد أدنى قدره 75 من 100، ويصلح المخرجات ذات الجودة المنخفضة، مما أتاح استعادة 438,4 مليار رمز؛ أما اللغات الـ10 الأخرى فتُترجم باستخدام Indic Translate من Bodhan AI. وأدت عشرة مليارات من هذه الرموز، ضمن تدريب مسبق متواصل على 100 مليار رمز، إلى تحسين نتائج Nemotron 3.5 Super VL بما يتراوح بين 4,98 و9,82 نقطة في خمسة اختبارات معيارية هندية، وهو قياس لا يعزل مساهمة هذه المجموعة وحدها. وتقرّ NVIDIA بأن هذه الترجمات لا تحل محل نصوص كُتبت مباشرة بهذه اللغات، وأن مراقبة الجودة لا تزال آلية في معظمها.
الذكاء الاصطناعي في المختبر: يحسّن Claude Mythos 5 ثماني دوائر كمومية، وتبحث Google DeepMind عن ببتيدات مضادة للميكروبات باستخدام Antigravity
16 أكتوبر — تنشر Anthropic الأعمال التي أنجزها آندي غو، العضو في برنامج STEM Fellows لديها، بإشراف أليك كيميني، المتخصص في الفيزياء الكمومية لدى Anthropic، وبمشاركة سوزان يلين من هارفارد وميخائيل لوكين من هارفارد وQuEra Computing. يقوم الإعداد على مواصفات بلغة عادية لثماني دوائر، ومقيّم آلي يتحقق من كل مقترح ويقيّمه وفق حاصل ضرب عدد الكيوبتات في عدد البوابات. يعمل Claude Mythos 5 ضمن حلقة مغلقة، من دون تدخل بشري بين الجولات، ويجد للعمليات الأساسية الثماني تصاميم تستخدم عددًا أقل من الكيوبتات والبوابات معًا مقارنة بأفضل التصاميم المنشورة، أحيانًا بفارق رتبة مقدار أو أكثر.
| المهمة المسندة إلى Claude Mythos 5 | النتيجة المنشورة | مرجع المقارنة |
|---|---|---|
| جمع النقاط على منحنى إهليلجي | عدد بوابات أقل بـ17 مرة، مقابل زيادة 12 % في عدد الكيوبتات | أصغر تصميم منشور |
| مفكّك ترميز Reed-Solomon في خوارزمية DQI | عدد بوابات أقل بـ12 مرة؛ 19 كيوبتًا محجوزًا بدلًا من 665 | التصميم السابق من Google |
تتعلق النتيجة الأولى بالخطوة المحورية في الخوارزميات الكمومية للوغاريتم المتقطع على المنحنيات الإهليلجية. عمل Claude عليها مدة 53 ساعة بتدخل بشري محدود للغاية، ليصل إلى أول تنفيذ قابل للعكس لطريقة divsteps من دون تخزين سجل للفروع، وقد جرى التحقق منه بالمحاكاة ثم صياغته رسميًا في Lean. وتقارن التدوينة هذا الرقم بآخر: فقد استغرق خفض تقدير تكلفة محاكاة FeMoco بنحو 150 000 مرة ثماني سنوات وعمل مجموعات عديدة. وترى Anthropic أن مثل هذه المكاسب تقلل الموارد الكمومية اللازمة للتطبيقات المفيدة، بحيث قد تظهر حواسيب كمومية عملية في وقت أبكر من المتوقع. واضطر الفريق إلى التعامل مع حذر Claude، الذي كان يعيد التحقق من مكاسبه ويفضّل الأساليب المعروفة، عبر إلزامه باستكشاف عدة مسارات بالتوازي.
🔗 تدوينة Anthropic · الورقة على arXiv
تبحث Google DeepMind عن ببتيدات جديدة مضادة للميكروبات باستخدام Antigravity وتضيف إليه عارضًا ثلاثي الأبعاد
15 أكتوبر — تعرض Google DeepMind كيف يمكن استخدام Antigravity، منصتها للتطوير القائم على الوكلاء، بوصفها منصة عمل علمية (منصة عمل علمية قائمة على الوكلاء). في الجلسة الموصوفة، يحدد عالم أحياء الهدف، وهو العثور على ببتيدات جديدة مضادة للميكروبات لدى Streptococcus pseudopneumoniae والتحقق منها حاسوبيًا، ويتولى الوكيل تنسيق استخدام قواعد البيانات والتحليل البنيوي وتلخيص الأدبيات العلمية. ويعتمد على ProtNLM، وهو نموذج من Google يتنبأ بوظيفة البروتين انطلاقًا من تسلسله، ويضيف توصيفات إلى ملايين المدخلات غير الموصوفة في UniProt.
يختار الوكيل بكتريوسينًا من 97 حمضًا أمينيًا يحمل المعرّف UniProt A0A0U0D591، ولا يوجد له نظير ذو دلالة بين البروتينات التي خضعت للمراجعة في Swiss-Prot، ويُظهر نموذج AlphaFold الخاص به طيًّا يشبه بكتريوسينًا معروف البنية. ثم يقترح آلية عمل مستمدة من الأدبيات العلمية ويكتب بروتوكولًا مختبريًا. ويخضع هذا المرشح وعدة مرشحين آخرين ناتجين عن المسار نفسه للتحقق في المختبر: تتحدث التدوينة عن مسار بحثي محتمل، وليس عن نتيجة مثبتة. وتذكّر بأن مقاومة مضادات الميكروبات قد تتسبب في نحو 10 ملايين وفاة سنويًا بحلول 2050، وفق أحد التقديرات.
وتقدّم التدوينة أيضًا Biomolecular Structure Viewer، وهو عارض ثلاثي الأبعاد مدمج في Antigravity يشترك في استخدامه الوكيل والباحث: يبرز الوكيل فيه مناطق لتوضيح فرضياته، وتصل إليه تعليقات الباحث التوضيحية، مثل ملاحظة مثبّتة على جيب ارتباط. ولم يُحدَّد موعد الإتاحة أو شروط الوصول.
🔗 تدوينة Google DeepMind · Antigravity للعلوم
أدوات للباحثين: تتيح Google نظام Deep Review للجميع، وتطلق SAIR منصة Open Math OS، وتقدّم OpenAI خطة Rosalind Academic Plan للمختبرات الأمريكية
14 أكتوبر — بمناسبة Research@ 2026، تتيح Google Research للجمهور نظام Deep Review، وهو نظام ذكاء اصطناعي قائم على الوكلاء يراجع الوثائق التقنية المعقدة ويتحقق من محتواها: الاتساق المنطقي، والعبارات الرياضية، واستناد الوقائع إلى المصادر، والمقارنة بالأعمال القائمة، واقتراح التحسينات، مع إبقاء الأحكام الجوهرية للبشر. ويأتي خلفًا لأداة Paper Assistant Tool، التي اختُبرت مع STOC 2026 وICML 2026 وNeurIPS 2026 وICLR 2027: تلقّى مؤلفو أكثر من 16 000 مخطوطة مشاركة طوعًا ملاحظات خاصة قبل الموعد النهائي، من دون صلة بالمراجعة الرسمية للمؤتمرات.
الإتاحة عالمية، مع مراجعتين مجانيتين أسبوعيًا؛ ويتيح مفتاح Gemini API حدود استخدام أعلى والوصول إلى Deep Review API. تقبل الخدمة حاليًا ملفات PDF والنصوص العادية، وتستهدف أيضًا Google Docs والعروض التقديمية والقانون والتمويل، وتتعهد Google بعدم استخدام الوثائق لتدريب نماذجها، مع الاحتفاظ بها عامًا واحدًا لإتاحة عرضها. وتبرر Google الأداة بتزايد الأبحاث المقدمة:
| سنة التقديم | الأبحاث المقدمة إلى ICLR وNeurIPS وICML |
|---|---|
| 2023 | نحو 23 000 |
| 2024 | نحو 32 000 |
| 2025 | نحو 45 000 |
| 2026 | أكثر من 74 000 |
وفي اليوم نفسه، صدر تقرير تقني عن وكيل Geospatial Reasoning في Google Earth AI، ونُشر اختباران معياريان جديدان للباحثين، هما GeoKTools وGeoExpertQueries، ووُسّع الوصول التجريبي عبر Ask Google Earth وخدمة Agent-to-Agent (A2A).
🔗 تدوينة Google Research · Research@ 2026 على مدونة Google · تدوينة وكيل Geospatial Reasoning
Open Math OS: تطلق مؤسسة SAIR منصة للبحث الرياضي تعتمد على نماذج مفتوحة
16 أكتوبر — تطلق مؤسسة SAIR منصة Open Math OS، التي تقدّمها بوصفها البنية التحتية لـ«الرياضيات 2.0»، بعد شهر من إعلان مبادرة Open Math Model. وتشمل قائمة شركاء الإطلاق Hugging Face وLean والمعهد الفدرالي السويسري للتكنولوجيا في لوزان و@cscsch، وقد شارك الإعلان توماس وولف، الشريك المؤسس لـHugging Face. يحصل كل مشروع على جهاز سحابي متاح على مدار 24 ساعة، مع أكثر من 100 أداة رياضية وعلمية مثبتة مسبقًا؛ وتُتاح موارد الحوسبة مجانًا للفرق المقبولة بعد تقديم طلب.
يختار عالم الرياضيات نموذجًا مفتوحًا، مثل Kimi K3 أو DeepSeek V4.1 Flash أو GLM 5.3 أو Nemotron 3 في الواجهة المعروضة، ويمكنه تشغيل وضع Ultramath، حيث يستكشف عدة وكلاء بالتوازي مسارات مختلفة للمسألة نفسها؛ ويعرض المثال التوضيحي على الموقع برهانًا جرى التحقق منه في Lean ثم أُدرج في ورقة بصيغة LaTeX. تكون المشاريع خاصة افتراضيًا، ويتطلب التدريب على الأعمال موافقة صريحة من مؤلفيها، ويحتفظ هؤلاء بملكية أفكارهم ونسبتها إليهم.
🔗 سلسلة منشورات SAIR · موقع Open Math Model
Rosalind Academic Plan: ما يصل إلى 30 ترخيصًا مجانيًا لـChatGPT لمدة 12 شهرًا للمختبرات الجامعية الأمريكية
15 أكتوبر — تطلق OpenAI خطة Rosalind Academic Plan، وهي عرض مخصص للمختبرات الجامعية في علوم الحياة، يقتصر حاليًا على الجامعات الأمريكية.
| ميزة العرض | الشرط المرتبط بها |
|---|---|
| ما يصل إلى 30 ترخيصًا من ChatGPT Business Standard | 0 دولار لكل مستخدم شهريًا، لمدة أقصاها 12 شهرًا |
| نماذج متقدمة متاحة تجاريًا | ضمن حدود استخدام العرض |
| GPT-Rosalind وRosalind Workbench | بعد الموافقة على الوصول الموثوق (الوصول الموثوق) |
| بيانات البحث المشتركة | لا تُستخدم افتراضيًا في التدريب |
ينسّق Rosalind Workbench استخدام أدوات الكيمياء الدوائية وعلم الجينوم والمساعدة في التجارب. يقدّم الباحث الرئيسي أو مدير المختبر الطلب نيابة عن فريقه؛ ولا يمنح تقديم الطلب وصولًا فوريًا، فيما تتبع الجامعات المرتبطة أصلًا بعقد OpenAI Enterprise إجراءاتها الخاصة. تستهدف OpenAI سبعة مجالات، من تصميم الأدوية والبروتينات إلى مقاومة مضادات الميكروبات، وتستشهد بأعمال مختبر تشاو في جامعة كاليفورنيا بسان فرانسيسكو، ومختبر بوردنكس، وفريق براين هاي في ستانفورد وArc Institute. وأصبح GPT-Rosalind، الذي أُطلق في 16 أبريل، متاحًا ضمن الوصول الموثوق عبر API وCodex وChatGPT Enterprise منذ 11 سبتمبر.
🔗 تدوينة OpenAI · سلسلة منشورات OpenAI
Gemini 4 Argon: أربعة وكلاء ينهون Minecraft في 27 ساعة، وPerplexity تتيحه لمشتركي Pro وMax وفي Agent API
16 أكتوبر — أنهى أربعة وكلاء من Gemini 4 Argon لعبة Minecraft بدءًا من الصفر: في عالم بقاء عشوائي، على مستوى الصعوبة Easy ومع وحوش معادية، هزموا Ender Dragon بعد 27 ساعة و2 783 برنامجًا. يروي ماكسنس فالدور التجربة في مقال على X شاركه @GoogleDeepMind، ويفصّلها مع ساتيندر سينغ وروبرتا رايليانو في تقرير تقني على arXiv. وهؤلاء هم وكلاء البرمجة العامون في Argon، الذين يستخدمهم المهندسون يوميًا: من دون أي أداة خاصة بـMinecraft أو أدوار مسندة مسبقًا.
لا يرى الوكلاء أي صور ولا يضغطون أي مفاتيح: يتحكم كل منهم في لاعب بكتابة برامج قصيرة لمكتبة Mineflayer المفتوحة المصدر، ويقرأ مخرجاتها وينسق مع الآخرين عبر دردشة اللعبة وذاكرة مشتركة. بعد عشر دقائق من البداية، كانوا قد تقاسموا العمل: الأدوات والطعام والألماس والبوابة. وللعثور على الحصن، رمى أحدهم عنصرين من موقعين وحسب تقاطع مساريهما، بهامش خطأ يبلغ 43 مترًا لحصن يقع على بُعد 1,3 كيلومتر. وكلّفهم القتال الأخير 69 عودة إلى اللعب بعد الموت: فبعد نحو 21 ساعة من اللعب، أدرك أحد الوكلاء أن البلورات تعالج التنين، وأن تكديس كتل من التراب يكفي للوصول إليها.
| مقياس التجربة | القيمة المسجلة |
|---|---|
| المدة حتى الفوز | 27 h 14 min |
| البرامج المكتوبة | 2 783، منها 22 % انتهت بخطأ |
| رسائل الدردشة | 229 |
| إجمالي مرات العودة بعد الموت | 605، منها 69 في مواجهة التنين |
وكان وكيل خامس، يُدعى Observer، يراقب اللعب لرصد أي غش أو تحايل على المواصفات (التحايل على المواصفات): ولم يعثر هو أو المراجعون يدويًا لعينة من السجلات على أي حالة من ذلك. ويقرّ المؤلفون بحدود التجربة: إذ تُقرأ بيانات العالم عبر API يوفّر المواقع الدقيقة للكتل والمخلوقات، وتتولى إضافة برمجية حساب المسارات. وهذه تجربة بحثية مستقلة، وليست إنجازًا رسميًا معتمدًا في Minecraft، ولم تعتمدها Mojang أو Microsoft.
🔗 مقال ماكسنس فالدور · مشاركة Google DeepMind · التقرير التقني على arXiv
تتيح Perplexity نموذج Gemini 4 Argon لمشتركي Pro وMax، مع نتيجة قياسية تبلغ 0,802 على WANDR
16 أكتوبر — تضيف Perplexity نموذج Gemini 4 Argon، المتاح عمومًا لدى Google منذ 13 أكتوبر، لمشتركي Pro وMax. ويقتصر الإعلان على منشور ورسم بياني: على WANDR، اختبارها الداخلي للبحث المدعوم بالمصادر، يحقق Argon نتيجة 0,802 بتكلفة 7,88 دولارات لكل مهمة، وهي أعلى نتيجة في الرسم البياني.
| النموذج المقيَّم | نتيجة WANDR | التكلفة لكل مهمة |
|---|---|---|
| Gemini 4 Argon | 0,802 | 7,88 دولارات |
| GPT-6 Astra | 0,735 | 13,34 دولارًا |
| GPT-6.1 Sol | 0,654 | 3,70 دولارات |
| Claude Opus 5.5 | 0,647 | 3,69 دولارات |
| Claude Fable 5.1 | 0,601 | 12,76 دولارًا |
| GPT-6 Sol | 0,566 | 2,23 دولار |
| Claude Sonnet 5.5 | 0,550 | 2,73 دولار |
| Grok 4.7 | 0,528 | 9,30 دولارات |
| DeepSeek V4 Pro 0813 | 0,359 | 0,75 دولار |
أما للمطورين، فيشير سجل تغييرات API منذ مساء 15 أكتوبر إلى أن Agent API تقبل google/gemini-4-argon، بسعر الإطلاق الساري حتى 30 نوفمبر 2026: 2 دولار لكل مليون رمز إدخال، و0,10 دولار للرموز المخزنة مؤقتًا، و10 دولارات لرموز الإخراج، بما يشمل رموز الاستدلال.
🔗 إعلان Perplexity · نماذج Agent API
وكلاء للجمهور: يوزّع GPT-6 Astra Pro المهمة بين عدة وكلاء في ChatGPT، ويعمل Grok Bot أسرع بثلاث مرات ويتصل بـRobinhood وCoinbase وeToro
16 أكتوبر — تحدّث OpenAI نموذج GPT-6 Astra Pro في ChatGPT: إجابات أسرع، واستخدام أفضل للإضافات والأدوات، والأهم، عدة وكلاء يعالجون بالتوازي أجزاء مختلفة من المهمة نفسها. يتابع المستخدم تقدم كل منهم ويفتح المهام المكتملة لمراجعة عملهم. وتتوفر الميزة لمشتركي Pro في علامة التبويب Chat.
لا تقدّم OpenAI أرقامًا لزيادة السرعة أو اختبارًا معياريًا، ولم تكن ملاحظات إصدار ChatGPT أو النماذج قد ذكرت التحديث بعد بحلول مساء 16 أكتوبر. ونُشر المنشور عند الساعة 20:00 بتوقيت UTC تحت اسم «GPT-6 Pro»، ثم صُحّح بعد 27 دقيقة إلى «GPT-6 Astra Pro»؛ ومنذ إتاحة GPT-6 لجميع المستخدمين في 7 أكتوبر، يعتمد مستوى الاستدلال Pro في ChatGPT على GPT-6 Pro (Astra). وكان العمل بعدة وكلاء يُقدَّم حتى الآن في إصدار تجريبي لـGPT-6.1 Sol، منذ 29 سبتمبر.
يُنجز Grok Bot مهامه على الحاسوب بسرعة أكبر بثلاث مرات، ويقرأ X Chat ويتصل بـRobinhood وCoinbase وeToro
16 أكتوبر — يعرض Grok Bot، وكيل SpaceXSI الذي يتصل بأدوات مستخدميه، مستجداته في سلسلة من عشرة منشورات، من دون تدوينة على x.ai. ويتعلق أبرزها بالسرعة: فبحسب حساب @bot، تُنجز المهام على الحاسوب بسرعة أكبر بثلاث مرات في المتوسط، وتصل الردود على كل ما عدا ذلك في أقل من نصف الوقت.
| المجال المعني | الميزة الجديدة المُعلنة |
|---|---|
| السرعة | مهام الحاسوب أسرع بثلاث مرات في المتوسط، والردود الأخرى في أقل من نصف الوقت |
| الصوت | مكالمات أسرع وأكثر موثوقية، وذاكرة أفضل للمحادثات السابقة |
| الواجهة | بطاقات محادثة أُعيد تصميمها، وخط جديد، وسمات، وإشعارات على الجهاز المستخدم وحده |
| البريد الإلكتروني | أسماء مستعارة بعلامة «زائد» لتخصيص إجراء روتيني للبريد المُرسل إلى عنوان محدد |
| X | تؤدي الإشارة إلى @bot في منشور إلى بدء مهمة؛ وقراءة X Chat بعد ربط حساب X |
| الموصلات | Robinhood وCoinbase وTrello وPostHog وbeehiiv وeToro، وغيرها |
يمكن للفرق أيضًا تقديم موصلاتها الخاصة: يتيح نموذج على x.ai توزيع إضافة أو خادم MCP على مستخدمي Grok Bot وCursor، وقريبًا Grok، بعد مراجعته لإدراجه في سوق الإضافات.
🔗 سلسلة منشورات Grok Bot · نموذج تقديم الإضافات
الوسائط التوليدية: أصوات تُنشأ من وصف لـGPT-Live، وPika داخل ChatGPT، وIdeogram 4.5 بسعر من 0,8 إلى 22 سنتًا للصورة، وMirelo SFX 2.0 داخل Runway
16 أكتوبر — تتيح API الخاصة بـGPT-Live لجميع عملائها إنشاء أصوات انطلاقًا من وصف (prompt-to-voice): يُوصف الصوت المخصص نصيًا، عبر API أو Playground الصوتي، ثم يُعاد استخدامه في جلسات GPT-Live. إنشاء الصوت مجاني، ويُحاسَب الكلام المُولَّد بالتعرفة المعتادة للجلسات، ولا تعمل هذه الأصوات إلا مع GPT-Live، دون API الخاصة بـText to Speech أو Realtime API أو Chat Completions. لا يُطلب أي تسجيل مرجعي أو تسجيل لإثبات الموافقة، لكن OpenAI تشترط أصوات بالغين، وتحظر انتحال الهوية، وتطلب الإفصاح عن أن الكلام مُولَّد بالذكاء الاصطناعي؛ وقد يحصل عميلان على صوتين متشابهين.
وتنضم إلى GPT-Live أيضًا تسعة أصوات جاهزة، سُجّلت بحسب @OpenAIDevs بمشاركة ممثلين يتحدثون اللغات المعنية بوصفها لغاتهم الأم:
| اللغة المنطوقة | الأصوات المضافة |
|---|---|
| الألمانية | Nuri وJuni وFlitz |
| الفرنسية | Brise وSillage |
| الهندية | Nira |
| اليابانية | Harema وShida |
| الكورية | Noeul |
وفي اليوم السابق، أضاف سجل التغييرات تكاملًا أصليًا لـAPI الخاصة بـDecisions داخل GPT-Live: ينفّذ التطبيق الإجراءات أثناء حديث المستخدم، إما لأن Live يستدعي Decisions مباشرةً (تفويض أصلي)، أو لأن Live يُنبّه التطبيق، الذي يستعلم عندئذٍ من Decisions (تفويض مخصص)، ويمكن تفعيل القرارات استنادًا إلى أجزاء النص المنسوخ من الكلام. ويعرض الدليل مثال مساعد صوتي في سيارة يضبط درجة الحرارة أو إزالة الضباب. تتعلق هذه المستجدات بـgpt-live-1: أما GPT-Live-1.1، الذي أُتيح في ChatGPT في 15 أكتوبر، فلا يظهر بعد في سجل تغييرات API.
🔗 سلسلة منشورات OpenAI Developers · دليل الأصوات المخصصة · دليل استخدام API الخاصة بـDecisions مع الصوت
تُثبّت Pika أدوات الإنشاء الخاصة بها داخل ChatGPT، بإضافة صُممت بالشراكة مع OpenAI
16 أكتوبر — تعلن Pika، بالشراكة مع OpenAI، عن ملحق إضافة Pika × ChatGPT (Pika X ChatGPT plugin extension) يُثبّت أدوات الإنشاء الخاصة بها داخل المحادثة واللوحة الجانبية في ChatGPT. ويمكن من خلاله ضبط خيارات الأدوات والإعدادات البصرية المسبقة وعمليات التوليد دون مغادرة المحادثة، أو فتح نافذة Pika أكثر غمرًا يعمل فيها ChatGPT مع المستخدم. وتُقدّم Pika من خلاله، وفقًا لسلسلة منشوراتها، أكثر من 40 تطبيقًا للصور والصوت والفيديو وأكثر من 100 نموذج توليدي؛ وتسرد صفحة الإضافة 13 مهارة، من إعلانات المنتجات إلى البودكاست، ومسار تهيئة يحدد كيفية طلب Pika الإذن قبل إنفاق الأرصدة.
تضيف Pika رصيدًا قدره 250 إلى كل حساب بعد أول عملية توليد عبر الإضافة، ولا تنشر أي تسعيرة خاصة بها. وكانت OpenAI قد عرضت ملحقات إضافات ChatGPT في 7 أكتوبر، وكانت Adobe وCanva وFigma وShopify من أوائل المشاركين.
🔗 سلسلة منشورات Pika · صفحة إضافة Pika في ChatGPT
يتوفر Ideogram 4.5 بأربعة أوضاع للجودة، بأسعار من 0,8 إلى 22 سنتًا للصورة
15 أكتوبر — تعرض Ideogram تفاصيل تسعير Ideogram 4.5، نموذجها لتعديل الصور الذي أُطلق في 30 سبتمبر: أربعة أوضاع للجودة، بأسعار من 0,8 إلى 22 سنتًا للصورة، جميعها بدقة 2K أصلية. ويُعدّ Very Low الأقل تكلفة، إذ يعدّل صورة في 8 ثوانٍ مقابل 0,8 سنت، دون تراكم الشوائب من تعديل إلى آخر. وبحسب Ideogram، استنادًا إلى Design Arena، يدفع هذا الوضع حد باريتو لتعديل الصور إلى مستوى جديد من حيث السعر والسرعة: فكل نموذج أعلى تقييمًا أغلى تكلفة وأبطأ تنفيذًا. وتضعه Design Arena في المرتبة 23 ضمن Image Editing Arena، بتقييم Elo يبلغ 1189.
لا تفصّل Ideogram أسعار الوضعين المتوسطين. وردًا على سؤال عن الأوزان المفتوحة التي وُعد بها عند الإطلاق، يجيب حساب Ideogram بأنه يعمل عليها، دون تحديد موعد.
تدمج Runway نموذج Mirelo SFX 2.0، الذي يضيف الصوت إلى الفيديو مع الحفاظ على الحوارات
16 أكتوبر — تضيف Runway إلى منصتها Mirelo SFX 2.0، وهو نموذج يصمم تلقائيًا المشهد الصوتي للفيديو (sound design): فيولّد أجواء صوتية كاملة انطلاقًا من الصور، متزامنة مع كل صورة منها، مع إبقاء الحوارات سليمة. وردًا على سؤال عن حد المدة، تجيب Runway بأنه يعمل مع مقاطع بأي طول. لم تُنشر تسعيرة أو تكلفة بالأرصدة، ولا يذكر سجل تغييرات Runway النموذج بعد، كما لم تنشر Mirelo إعلانًا من جهتها. وبعد إضافة Eleven v4 من ElevenLabs في أواخر سبتمبر، تواصل Runway إضافة نماذج صوتية من جهات خارجية إلى جانب نماذج الفيديو الخاصة بها.
🔗 إعلان Runway · الرد بشأن مدة المقاطع
وكلاء البرمجة: فريق Claude Code يفصّل مراجعة الكود، وCodex CLI 0.163.0، ولوحات عمل وMuse Wonder في Cursor، وGemini CLI يحيل إلى Antigravity CLI
16 أكتوبر — يشرح فريق Claude Code على claude.dev كيف يراجع الكود الخاص به، بينما يكتب Claude نحو 90 % منه. وتورد تدوينة آدي عثماني ومورغان ويستلي لونت وتشينغ وانغ رقمين: من يونيو إلى سبتمبر، تضاعف عدد pull requests المدمجة أكثر من مرة، وانخفضت نسبة ما استلزم التراجع عنه بأكثر من 40 %. والهدف أن تُدمج معظم pull requests بمشاركة شخص واحد على الأكثر، قد يكون صاحبها.
يمر كل تغيير عبر طبقات عدة: تحقق يجريه Claude قبل pull request (اختبارات، وبناء، وتحليل ساكن، ثم مراجعة diff بواسطة وكيل ثانٍ ضمن سياق جديد)، ثم CI، وCode Review، ومراجعة أمنية تمنع المتابعة عند عدم اجتيازها، وطابور دمج (merge queue)، ونشر تدريجي. ويحدد مُصنِّف مستوى المخاطر بناءً على التغيير، لا صاحبه: لا موافقة بشرية للتوثيق أو لإضافة خلف علامة تفعيل، وشخص واحد لتغيير اعتيادي في المنتج أو في منطقة حساسة مثل التخزين المؤقت أو تعليمات النظام، وشخصان للتغييرات الأعلى خطورة. ولا تُعادل موافقة وكيل موافقة شخص أبدًا. وخلال المعاينة البحثية لـCode Review، كانت نسبة pull requests الداخلية التي تتلقى تعليقات جوهرية قد ارتفعت بالفعل من 16 % إلى 54 %.
وتعرض التدوينة أيضًا أرقامًا لمشكلة خاصة بالوكلاء، وهي المراجعة التي لا تصل إلى نتيجة نهائية: فقد شهدت إحدى pull requests الخاصة بـCLI أكثر من خمسين جولة في ليلة واحدة. ومع سقف من ثلاث جولات، ومراجعة تقتصر على diff الجديد، وبلاغات بحسب فئة الخطأ، تصل المراجعة إلى نتيجة نهائية أسرع:
| المؤشر (pull requests الداخلية لـClaude Code) | قبل التغييرات | بعد التغييرات |
|---|---|---|
| المعتمدة بعد جولة واحدة من المراجعة والتصحيح | 65 % | 78 % |
| التي تتطلب خمس جولات أو أكثر | 8,9 % | 1,5 % |
| متوسط عدد المراجعات قبل الاعتماد | 2,08 | 1,32 |
وتختتم التدوينة بقائمة للتنفيذ: ملف CLAUDE.md قصير، و/code-review و/security-review محليًا، وملف REVIEW.md يكتبه المسؤولون عن الكود، ومستويات مخاطر موثقة، وطابور دمج، وإعادة تشغيل الحوادث السابقة يوميًا بوصفها مجموعة تقييم.
🔗 تدوينة فريق Claude Code · إعادة النشر من @ClaudeDevs
Codex CLI 0.163.0: توجيه أثناء الرد، وبحث داخل /config، وتفعيل Daybreak افتراضيًا
15 أكتوبر — تنشر OpenAI إصدار Codex CLI 0.163.0 في الساعة 21:30 UTC، وهو أول إصدار مستقر منذ 0.162.1 الصادر في 9 أكتوبر، مع 227 بندًا منذ 0.162.0. وأصبح Daybreak، الذي وُضع خلف الخيار cli_daybreak في الإصدار 0.161.0 بتاريخ 7 أكتوبر، مُفعّلًا افتراضيًا للحسابات المؤهلة، ويمكن لـcodex exec اختياره باستخدام مفتاح API من OpenAI عندما يتيح الخادم الوصول إليه.
| المجال المعني | التغيير الذي يقدمه الإصدار 0.163.0 |
|---|---|
| التوجيه | رسالة متابعة تُرسل أثناء الرد توجّه Codex فورًا؛ وإيقاف جولة يوقف أيضًا خلايا Code Mode النشطة |
الأمر /config | البحث عن التفضيلات في جميع الفئات، وتطبيق الإعدادات المتوافقة فورًا |
الأمر /keymap | مفتاح leader قابل للتخصيص (Ctrl+X افتراضيًا)؛ ونقل كتم الصوت إلى F9 |
الأمر /daemon | إعادة تشغيل خادم الخلفية المُدار، ثم إعادة الاتصال تلقائيًا |
| الأدوات | تنفيذ الأدوات المستقلة المخصصة للقراءة فقط بالتوازي |
| وكيل الشبكة | التحقق من الإذن قبل حل أسماء DNS، ورفض ترويسات Host المكررة |
وتؤدي استعادة سلسلة محادثة أيضًا إلى استعادة أذوناتها وموافقات الشبكة الخاصة بها، ولم يعد Codex يتضمن نسخة معدّلة من zsh: بل يستخدم منفّذ shell القياسي الخاص به.
🔗 ملاحظات إصدار Codex CLI 0.163.0
Cursor: الوكلاء السحابيون ينشئون لوحات عمل قابلة للمشاركة، وAPI الخاصة بـEnvironments تدخل المرحلة التجريبية، وMuse Wonder من Meta يحقق 46,1 % على CursorBench
16 أكتوبر — أصبح وكلاء Cursor السحابيون قادرين على إنشاء لوحات عمل (canvases) تفاعلية: يُطلب منهم إنشاء لوحة معلومات أو تقرير أثناء عملهم، ثم تُشارك لوحة العمل المكتملة مع الفريق عبر رابط. وتدخل API الخاصة بـEnvironments المرحلة التجريبية: إذ تنشئ بيئات هؤلاء الوكلاء وتديرها برمجيًا، بما في ذلك المستودعات المستنسخة وإعدادات environment.json. وتدعم البيئة الآن ما يصل إلى 500 مستودع، وتبدأ البيئات الكبيرة متعددة المستودعات بسرعة أكبر بمقدار 5 مرات، بحسب Cursor. ولم يكن بند سجل التغييرات الذي أشارت إليه سلسلة المنشورات منشورًا حتى مساء 16 أكتوبر، لذلك لا تُعرف الخطط المشمولة ولا التسعيرة ولا موعد انتهاء المرحلة التجريبية.
15 أكتوبر — بعد ثلاثة أيام من إطلاق Meta له، يصل Muse Wonder إلى Cursor، بسعر 4 دولارات لكل مليون من tokens الإدخال و20 دولارًا للإخراج، كما في API الخاصة بـMeta. وتبرز Cursor نتيجة 46,1 % على CursorBench عند مستوى الجهد الافتراضي، وهي أفضل نتيجة لنموذج Muse؛ ويعرض تصنيف CursorBench 4.0 العام تفاصيل مستويات الجهد الأخرى.
| النموذج ومستوى الجهد | نتيجة CursorBench 4.0 | التكلفة لكل مهمة | المرتبة في التصنيف |
|---|---|---|---|
| Claude Opus 5.5 Max | 57,8 % | 13,43 دولارًا | 1 |
| Muse Wonder Max | 50,4 % | 5,25 دولارات | 12 |
| Muse Wonder Extra High | 48,2 % | 4,24 دولارات | 15 |
| Muse Wonder High | 46,1 % | 3,51 دولارات | 21 |
| Muse Wonder Medium | 45,2 % | 2,82 دولار | 22 |
| Muse Wonder Low | 41,7 % | 1,91 دولار | 32 |
| Muse Spark 1.3 Max | 41,6 % | 2,64 دولار | 34 |
🔗 سلسلة منشورات Cursor عن الوكلاء السحابيين · Muse Wonder في Cursor · تصنيف CursorBench
يعلن Gemini CLI أنه غير مُحسَّن لـGemini 4 Argon ويحيل إلى Antigravity CLI
16 أكتوبر — أضافت Google خلال الليل تحذيرًا في أعلى README الخاص بـGemini CLI. ويذكّر المربع بأنه، بالنسبة إلى مستخدمي الفئة المجانية وGoogle One، حلّ Antigravity CLI محل Gemini CLI في 18 يونيو 2026، ثم يوضح بخط عريض، قبل الدعوة إلى استخدام Antigravity للوصول إلى Argon:
Gemini CLI has not been optimized for Gemini 4 Argon.
🇸🇦 لم يُحسَّن Gemini CLI للعمل مع Gemini 4 Argon. — README الخاص بـGemini CLI، pull request 29774
ويوسّع تعديل ثانٍ، دُمج بعد أكثر بقليل من ساعة، نطاق الرسالة ليشمل جميع أحدث نماذج Gemini، ويحيل إلى Antigravity CLI للحصول على أفضل تجربة برمجة. ويفقد README في الوقت نفسه مزاياه الترويجية السابقة: قسم «لماذا Gemini CLI؟» وفئته المجانية التي تتيح 60 طلبًا في الدقيقة و1 000 طلب يوميًا، والقدرات المتقدمة، والتكامل مع GitHub؛ ولم يعد تسجيل الدخول بحساب Google مخصصًا إلا لتراخيص Code Assist المدفوعة للمؤسسات.
وتمتد هذه المربعات بالانتقال المُعلن في 19 مايو: فمنذ 18 يونيو، يظل Gemini CLI متاحًا لتراخيص Code Assist Standard وEnterprise ولمفاتيح API المدفوعة، مع وعد بالوصول إلى أحدث نماذج Gemini. وبعد ثلاثة أيام من الإتاحة العامة لـArgon، لم يُدمج بعد اقتراح المجتمع الذي يضيفه إلى محدد النماذج في Gemini CLI (pull request 29737).
🔗 pull request 29775 الذي ينقّح README · تدوينة 19 مايو عن الانتقال إلى Antigravity CLI
موجز الأخبار
وكلاء البرمجة وأدواتها
- Amp يعرض سطح مكتب مشغّلاته — أصبح من الممكن من داخل سلسلة محادثة رؤية سطح مكتب مشغّل يعمل بنظام macOS أو Linux والتحكم فيه، مثلًا لتجربة تطبيق iOS أنشأه Amp، وذلك من متصفح أو من تطبيقي iPhone وiPad؛ وكل من يستطيع الكتابة في سلسلة محادثة تخص المشغّل يستطيع أيضًا التحكم في سطح مكتبه. 🔗 المصدر
- v0 — يمكن تنزيل الملفات التي يتعذر عرضها في المعاينة بسبب حجمها من علامة التبويب Code، ويحصل تطبيق iOS على أدوات لاختيار المهارات ونظام التصميم، إلى جانب مرفقات الفيديو، ولم تعد طلبات Gemini 4 تفشل عند مستويات الجهد المرتفعة. 🔗 المصدر
- Copilot CLI في نسخة تجريبية — ثلاث نسخ تجريبية خلال اليوم (1.0.99-2 و1.0.99-3 و1.0.100-0)، دون إصدار مستقر: يصبح البحث الدلالي في الشيفرة الإعداد الافتراضي للجلسات المتصلة بالإنترنت، ويعطّل الخيار
--disable-client-telemetryبيانات القياس عن بُعد لدى العميل، ولم يعد تجمّد خادم MCP يعطّل الجلسة. 🔗 المصدر - Copilot في Slack وTeams — يعمل @GitHub الآن على عدة مستودعات في المحادثة نفسها: طلبات سحب مفتوحة أو مدمجة، وتحقيق يشمل الواجهتين الأمامية والخلفية، وملخص للنشاط؛ وتُستخدم رسائل Slack وسلاسل محادثاته التي تتم مشاركتها سياقًا للعمل. 🔗 المصدر
- Qwen Code v0.25.3-preview.0 — في اليوم التالي لصدور النسخة المستقرة v0.25.2، تضع نسخة تجريبية تضم 64 بندًا QwenCloud في صدارة /auth، وتمنح Managed Agent وصولًا كاملًا إلى Shell مع إمكانية تبديل حالة الموافقات، وتعرض مسارات التنفيذ مباشرةً في Web Shell. 🔗 المصدر
- Gemini CLI، النسخة الليلية 0.66.0 — أول نسخة ليلية في السلسلة، مع تسعة إصلاحات: إخراج متزامن لمنع الوميض تحت tmux، وإصلاح مطالبات Git التي كانت تجمّد الواجهة، وحلّ متغيرات .env أخيرًا في إعدادات MCP، ودعم ملفات SKILL.md التي يأتي وصفها في سطر واحد؛ دون تغيير في النسختين المستقرة والتجريبية. 🔗 المصدر
- DeepSeek Harness 0.2.1-alpha.5 — النسخة التجريبية التاسعة والعشرون دون إصدار مستقر: أربعة إصلاحات (قائمة المهارات بعد تفعيل إضافة، والنوافذ الطرفية المكررة، وتعليمات وضع PTC، ومفتاح Page Up تحت Windows وLinux)، وموضع يتيح للإضافات إعادة تسمية النماذج بحسب المزوّد. 🔗 المصدر
ChatGPT وClaude والذكاء الاصطناعي في المؤسسات
- ChatGPT Sites لخطة Enterprise — يعلن @OpenAIDevs الإتاحة العامة لخطة Enterprise، مع إقامة البيانات في الولايات المتحدة أو الاتحاد الأوروبي لمواقع Sites الجديدة، ونطاقات موثّقة وأنفاق خاصة إلى واجهات API الداخلية؛ وتشير ملاحظات Enterprise إلى نسخة تجريبية للمسؤولين يجري طرحها، كما يُلغى الحد الثابت لعدد Sites في خطتي Plus وPro. 🔗 المصدر
- بدء طرح ChatGPT Slides — العروض التقديمية التعاونية التي أُعلن عنها في DevDay يوم 29 سبتمبر تصل إلى Space للمشتركين المؤهلين في Pro وBusiness وEnterprise، مع تحرير مشترك في الوقت الفعلي، وتقديم العروض من ChatGPT، والتصدير إلى PowerPoint أو PDF أو Google Slides. 🔗 المصدر
- Stack Overflow for Agents — وفقًا لدراسة حالة من OpenAI، أنجز مهندسان المنتج خلال بضعة أسابيع باستخدام Codex؛ ورفعت إضافته لـ ChatGPT عدد التسجيلات إلى ثلاثة أمثاله بين عشية وضحاها، ويُبنى موصّل لـ Stack Internal خلال 4 أيام بدلًا من 3 إلى 6 أسابيع. 🔗 المصدر
- Sullivan & Cromwell — أنشأ مكتب المحاماة بالتعاون مع OpenAI أداة Agreement Analyzer، التي طوّر جون سافا نموذجها الأولي داخل المكتب باستخدام Codex، وتُنتج مذكرة وتعديلات مقترحة على مشروع عقد ليراجعها المحامي؛ ولا تتضمن الدراسة أي أرقام عن المكاسب. 🔗 المصدر
- وكلاء أحد مندوبي المبيعات في Anthropic — يصف شاهبوز إبراغيموف، من فريق اليابان، ستة وكلاء على Claude Managed Agents (فرز العملاء المحتملين، وSalesforce، والردود باليابانية أو الإنجليزية، والتقارير)، واستخدام Claude Tag للمتابعة، وSonnet أو Opus بحسب ما يتطلبه الأمر من تقدير؛ مع توفير نحو 60 ساعة عمل وفقًا لسجله الأسبوعي. 🔗 المصدر
- American Forge — تطلق Cognition وNational Design Studio برنامج إقامة مدته ستة أشهر يدمج مهندسين في الحكومة الأمريكية، ويُقدّر المنشور عدد المواقع الفيدرالية القديمة أو المتقادمة بأكثر من 29 000 موقع؛ باب التقديم مفتوح، دون تحديد الأجر أو عدد المقاعد. 🔗 المصدر
أصوات ومقاطع فيديو مولَّدة
- HeyGen Video 1 ضمن MCP الخاص بـ HeyGen — تصف الفيديو الذي تريده لوكيلك (ChatGPT أو Claude أو Claude Code أو Cursor)، فيعود جاهزًا للنشر خلال ثوانٍ بحسب HeyGen؛ وتُخصم عمليات التصيير من رصيد الخطة. 🔗 المصدر
- NTT Docomo Business وElevenAgents — تختبر شركة الاتصالات في أيزوواكاماتسو (فوكوشيما) مساعدها الصوتي CONN، المبني على ElevenAgents، لإطلاع السكان المسنّين الذين تمنعهم الثلوج من الخروج على المعلومات وإتاحة المحادثة لهم؛ وتُعدّ ردود الفعل إيجابية، دون أرقام. 🔗 المصدر
- شهادات ElevenLabs — تجدّد ElevenLabs شهاداتها ISO/IEC 27001 و27701 و42001 و27017 و27018، وSOC 2 Type II، وPCI DSS من المستوى 1، وتضيف شهادة SOC 2 Type I لـ ElevenProductions. 🔗 المصدر
النماذج واختبارات الأداء والأبحاث
- Mistral Large 4 على STEMBench — تسلّط Mistral الضوء على اختبار Ulam العلمي، حيث يحقق نموذجها 2,501 من 4 دون أدوات (2,602 في الهندسة، و2,597 في علم الفلك): السادس بين 10 إعدادات والرابع دون أدوات، خلف Muse Wonder وClaude Opus 5.5 وHy4 Preview؛ أما صاحبا المركزين الأولين، GPT-6 Astra xhigh وGPT-6.1 Sol، فكانا يعملان مع أدوات داخل Codex. 🔗 المصدر
- Jebadiah v2.1 — نموذجان مفتوحان لاتخاذ القرار بحجم 27B و9B، نُشرا في 10 أكتوبر بترخيص Apache-2.0، يحققان 55,94 (المرتبة 35) و44,91 (المرتبة 74) بين 168 نموذجًا على Decision Index، خلف Jev 1.13 (60,11). 🔗 المصدر
- Nemotron 3.5 Super VL والمخططات البيانية — وفقًا لـ Thoughtworks، رفع LoRA دُرّب لمدة 3,3 ساعات على 24 000 مخطط مولَّد نتيجة نقطة حفظ أولية للنموذج من 16,96 % إلى 78,13 % على 224 سؤالًا من CharXiv، مقابل خسارة صافية قدرها 104 أسئلة في مواضع أخرى. 🔗 المصدر
- Arc Pro B65 من Intel — يُظهر اختبار مجتمعي باستخدام llama.cpp أن SYCL مع flash attention أسرع من Vulkan بنسبة 31,2 % في مرحلة الملء المسبق على ثلاثة نماذج بحجم نحو 30B وبدقة 4 بتات: إنتاج الرمز الأول من مطالبة يبلغ طولها نحو 16 000 رمز في 20,5 ثانية بدلًا من 42 لاثنين منها. 🔗 المصدر
- TB-Lite Verified — تطرح Hugging Face، دون إعلان، نسخة مصححة من اختبار OpenThoughts-TBLite لوكلاء الطرفية: إزالة خمس مهام معيبة من أصل 100، وإصلاح احتساب درجات كان سقفه 0,997، دون نشر أي نتائج. 🔗 المصدر
- AutoIllustrate من Sakana AI — استدراكًا لخبر 14 أكتوبر، أداة لسطر الأوامر بترخيص Apache-2.0 تحوّل قسم «الأساليب» في مقالة علمية إلى رسم قابل للتحرير بصيغة draw.io، ثم إلى صورة PNG بنمط بصري جديد؛ وقد استُخدمت في رسوم «العالِم الوكيل». 🔗 المصدر
- تملّق LLM وفقًا لـ Meta — ينشر facebookresearch، دون إعلان، المطالبات وجداول التقييم الخاصة بمقالة «من بيانات التفضيلات إلى التخصيص»، التي تصنّف الإجابات إلى سبعة أنواع، من الاعتراض الصريح إلى التأييد الواضح؛ دون نموذج أو أرقام. 🔗 المصدر
- Anthropic وSimons Foundation — تلتزم Anthropic بتقديم 5 ملايين دولار على هيئة تمويل وموارد حوسبة وإتاحة الوصول إلى Claude للرياضيين، بإدارة Simons Foundation؛ وباحتساب مساهمة المؤسسة وOpenAI، التي تخصص بدورها 5 ملايين دولار، يصل إجمالي المبلغ إلى 15 مليون دولار وفقًا لـ Simons Foundation، وتُخصَّص الأموال عبر آليات تشمل الدعوة إلى تقديم مقترحات. 🔗 المصدر
أدلة وتكريمات
- أمن LLM وفقًا لـ Perplexity — يستعرض دليل المخاطر العشرة الواردة في قائمة OWASP لأبرز 10 مخاطر لتطبيقات LLM لعام 2026، مع حادثة ووسائل دفاع لكل خطر، ويذكّر بوسائل حماية Perplexity (بيئة العزل في Computer، وBrowseSafe لـ Comet، وعدم الاحتفاظ بالبيانات لدى المزوّدين الخارجيين)؛ دون أي ميزة جديدة. 🔗 المصدر
- الدراسة بمساعدة الذكاء الاصطناعي — تنشر Perplexity خمس طرق مدعومة بالأبحاث (الخضوع لاختبارات، والمباعدة بين جلسات الدراسة، وإعادة الشرح، والتناوب، وتتبع التقدم)، وتستشهد بـ Gallup وLumina Foundation: يستخدم 57 % من الطلاب الأمريكيين الذكاء الاصطناعي أسبوعيًا في دراستهم. 🔗 المصدر
- اختراعان ضمن اختراعات العام لدى TIME — تدرج المجلة ضمن أفضل اختراعاتها لعام 2026 تقنية Omnilingual ASR من Meta، وهي نظام للتعرف على الكلام لأكثر من 1 600 لغة، وNemoClaw من NVIDIA، وهو وكيل مستقل محصور في بيئة عزل. 🔗 Meta · 🔗 NVIDIA
GitHub: التراخيص والمشغّلات والوصول
- الامتثال لتراخيص المصادر المفتوحة — إتاحة عامة لـ GitHub Enterprise Cloud مع Code Security: تُفرَض سياسة تراخيص على مستوى المؤسسة على طلبات السحب عبر مجموعة قواعد، وتتيح نقطة نهاية جديدة لوكلاء البرمجة التحقق من امتثال حزمة لها. 🔗 المصدر
- صورة Xcode 27 — بعيدًا عن الذكاء الاصطناعي، تصبح صورة المشغّل Xcode 27 في GitHub Actions متاحة عمومًا (macOS 27، وعلى Apple Silicon فقط)، مع بقاء التسميتين xcode-27 وxcode-27-xlarge دون تغيير. 🔗 المصدر
- Evergreen — بعيدًا عن الذكاء الاصطناعي، تقدّم GitHub تطبيق GitHub App الذي يسحب كل ثلاثة أشهر صلاحيات الوصول من المتعاونين الخارجيين الذين لم يُؤكَّدوا، ويؤرشف المستودعات غير النشطة، دون حذفها أبدًا، في مؤسسة مشتركة تضم أكثر من 1 400 موظف. 🔗 المصدر
ما الذي يعنيه ذلك
شغلت المنحنيات الإهليلجية منشورين لـ Anthropic في اليوم نفسه، من طرفي المسألة. من جهة الماضي، يستعيد Claude المولّد والطوابع الزمنية الكامنة وراء بذور NIST: لم تُكسر أي حماية، وهذا ما تكرره Anthropic، لكن احتمال التلاعب يصبح أقل بكثير، ويمكن لأي شخص إعادة إنتاج النتيجة باستخدام الشيفرة المنشورة بترخيص CC0. ومن جهة المستقبل، يجد Claude Mythos 5 دائرة لجمع النقاط على منحنى إهليلجي تستخدم بوابات أقل بـ 17 مرة مقابل زيادة قدرها 12 % في الكيوبتات، وهي لبنة أساسية للخوارزميات الكمومية التي قد تحسب اللوغاريتم المتقطع على المنحنيات الإهليلجية، أي المسألة التي يعتمد عليها أمن ECDSA. وتستنتج Anthropic من ذلك أن الحواسيب الكمومية المفيدة قد تظهر أبكر مما كان متوقعًا: تزداد الثقة في كيفية إنشاء هذه المنحنيات في الوقت الذي تنخفض فيه التكلفة المقدّرة للدوائر الكمومية التي قد تهددها يومًا ما.
في المختبرات، يعمل الوكلاء وحدهم لفترات أطول، ويصبح التحقق شرطًا لمصداقيتهم. عمل Claude Mythos 5 لمدة 53 ساعة أمام مقيّم آلي، مع برهان مصاغ رسميًا بلغة Lean؛ ولعب وكلاء Argon أكثر من 27 ساعة تحت مراقبة Observer المكلّف برصد الغش؛ ويكتب وكيل Antigravity بروتوكولًا، لكن البكتريوسين الخاص به لا يزال ينتظر التحقق المخبري. وتتبع أدوات الباحثين المنطق نفسه: يتحقق Deep Review من العبارات والاتساق قبل تقديم البحث، ويعتمد Open Math OS على Lean ويُبقي المشاريع خاصة افتراضيًا، ولا تتيح خطة Rosalind Academic Plan استخدام GPT-Rosalind إلا بعد الموافقة على الوصول الموثوق.
في جانب النماذج المفتوحة، يعود الترخيص ليصبح حجة بارزة. في اليوم التالي لصدور Muse Spark Open بترخيص Muse Model License ذي الشروط التجارية المقيّدة، يصل Beam بترخيص Apache 2.0، مع أكثر من 40 شريكًا منذ اليوم الأول، ونقطة حفظ NVFP4، وإطار التشغيل الذي استُخدم في تدريبه. وتتبنّى النماذج الأصغر الترخيص نفسه وتستهدف الكفاءة: يشغل أصغر نماذج Bonsai 2 مساحة 0,43 غيغابايت ويعمل على هاتف، وتتبلور نماذج اتخاذ القرار بوصفها فئة مستقلة، مع pplx-decider-v1.2 ونسخته Flash بسعرَي 0,02 و0,01 دولار لكل مليون رمز، ومهايئات Granite Switch 4.1 التي تعيد استخدام ذاكرة التخزين المؤقت للنموذج الأساسي، وتصنيف مشترك هو Decision Index.
بات إطار التشغيل بأهمية النموذج نفسه. تطرح Reflection نموذج Beam مع Mirror CLI، وتوجّه Google مستخدمي Argon إلى Antigravity CLI بدلًا من Gemini CLI، ويربط فريق Claude Code تضاعف عمليات الدمج بإعادة تصميم سلسلة المراجعة لديه، حيث يحدد مُصنِّف عدد المراجعين البشريين المطلوبين. وعلى مستوى الجمهور العام، يتّسع نطاق عمل الوكلاء: يوزّع GPT-6 Astra Pro المهمة بين عدة وكلاء، ويتصل Grok Bot بـ Robinhood وCoinbase وeToro، وتصبح إضافات ChatGPT قناة توزيع، من أدوات Pika إلى ارتفاع التسجيلات في Stack Overflow for Agents إلى ثلاثة أمثالها.
المصادر
- تدوينة فريق الاختبار الهجومي المتقدم في Anthropic حول منحنيات ECDSA
- مكافأة فيليبو فالسوردا بشأن بذور NIST
- أصبح Beam متاحًا الآن (Reflection)
- Beam (مدونة Hugging Face)
- بطاقة Beam-1.0-501B-A23B (Hugging Face)
- Beam على Blackwell Ultra (@NVIDIAAI)
- رفع معدل معالجة Beam إلى 90 000 رمز في الثانية (@NVIDIAAI)
- pplx-decider-v1.2 (Hugging Face)
- pplx-decider-flash-v1.2 (Hugging Face)
- سجل تغييرات واجهة API في Perplexity
- Granite Switch 4.1 (مدونة IBM على Hugging Face)
- Granite Switch 4.1 30B (Hugging Face)
- Bonsai 2 (@PrismML)
- Ternary-Bonsai-2-9B-gguf (Hugging Face)
- Nemotron-pretraining-Indic-v1 (مدونة NVIDIA على Hugging Face)
- تصميم دوائر كمومية فعالة (Anthropic)
- الدوائر الكمومية في Claude Mythos 5 (arXiv)
- تسريع البحث عن الببتيدات المضادة للميكروبات (Google DeepMind)
- Antigravity للعلوم
- تحليل الوثائق التقنية باستخدام Deep Review (Google Research)
- Research@ 2026 (مدونة Google)
- تسخير Earth AI للعمل (Google Research)
- Open Math OS (@SAIRfoundation)
- Open Math Model
- تقديم Rosalind Academic Plan (OpenAI)
- Rosalind Academic Plan (@OpenAI)
- فريق من وكلاء Gemini 4 Argon يُنهي Minecraft (@maxencefaldor)
- إعادة النشر من Google DeepMind (@GoogleDeepMind)
- التقرير التقني عن Minecraft (arXiv)
- Gemini 4 Argon في Perplexity (@perplexity_ai)
- نماذج Agent API (Perplexity)
- GPT-6 Astra Pro في ChatGPT (@OpenAI)
- مستجدات Grok Bot (@bot)
- تقديم إضافات إلى Grok Bot (x.ai)
- أصوات GPT-Live (@OpenAIDevs)
- دليل الأصوات المخصصة (OpenAI)
- GPT-Live وواجهة API Decisions (OpenAI)
- Pika × ChatGPT (@pika_labs)
- بطاقة إضافة Pika (ChatGPT)
- أوضاع الجودة في Ideogram 4.5 (@ideogram_ai)
- Mirelo SFX 2.0 على Runway (@runwayml)
- مدة المقاطع بحسب Runway (@runwayml)
- حل تحديات مراجعة الشيفرة في Anthropic (claude.dev)
- إعادة النشر من @ClaudeDevs
- Codex CLI 0.163.0 (GitHub)
- اللوحات وواجهة API Environments (@cursor_ai)
- Muse Wonder في Cursor (@cursor_ai)
- ترتيب CursorBench
- طلب السحب 29774 في Gemini CLI (GitHub)
- طلب السحب 29775 في Gemini CLI (GitHub)
- الانتقال من Gemini CLI إلى Antigravity CLI (Google Developers)
- Amp ومكتب منفّذات المهام
- سجل تغييرات v0 بتاريخ 16 أكتوبر
- Copilot CLI 1.0.99-2 (GitHub)
- Copilot في Slack وTeams (سجل تغييرات GitHub)
- Qwen Code v0.25.3-preview.0 (GitHub)
- Gemini CLI v0.66.0-nightly.20261016 (GitHub)
- DeepSeek Harness 0.2.1-alpha.5 (GitHub)
- ChatGPT Sites لخطة Enterprise (@OpenAIDevs)
- ملاحظات إصدار ChatGPT
- Stack Overflow وإضافته في ChatGPT (OpenAI)
- Sullivan & Cromwell (OpenAI)
- يوم في حياة مندوب مبيعات لدى Anthropic في اليابان (Claude)
- American Forge (مدونة Cognition)
- HeyGen Video 1 ضمن MCP الخاص بـ HeyGen (@HeyGenDev)
- NTT Docomo Business وElevenAgents (ElevenLabs)
- تجديد الشهادات (ElevenLabs)
- Mistral Large 4 على STEMBench (@MistralAI)
- Jebadiah v2.1 (مدونة Hugging Face)
- Nemotron 3.5 Super VL وCharXiv (مدونة Hugging Face)
- Intel Arc Pro B65 (مدونة Hugging Face)
- TB-Lite Verified (GitHub)
- AutoIllustrate (GitHub)
- تتبّع التملّق في النماذج اللغوية الكبيرة (GitHub)
- Anthropic وSimons Foundation (@AnthropicAI)
- ما هو أمن LLM؟ (Perplexity)
- كيفية استخدام الذكاء الاصطناعي للدراسة (Perplexity)
- Omnilingual ASR ضمن اختراعات TIME (@AIatMeta)
- NemoClaw ضمن اختراعات TIME (@NVIDIAAI)
- الامتثال لتراخيص المصادر المفتوحة (سجل تغييرات GitHub)
- صورة Xcode 27 (سجل تغييرات GitHub)
- الحفاظ على التحديث المستمر (مدونة GitHub)