ai-powered-markdown-translatorArtículo traducido del francés al español con gpt-5.6-sol.
Este viernes, las herramientas de agentes convergen hacia formatos compartidos: Claude Code ahora lee AGENTS.md cuando un proyecto no tiene CLAUDE.md, Antigravity inyecta el catálogo de subagentes en el prompt del sistema de sus agentes Markdown, Codex detalla su consumo por subagente y MiniMax abre el código de su agente de terminal. El resto de la jornada se resume en dos lanzamientos de modelos —Qwen3.8-Omni-Flash y Grok Voice Transcribe 2.0— y una colaboración inusual: Anthropic instala evaluadores de Accenture dentro de su propia empresa.
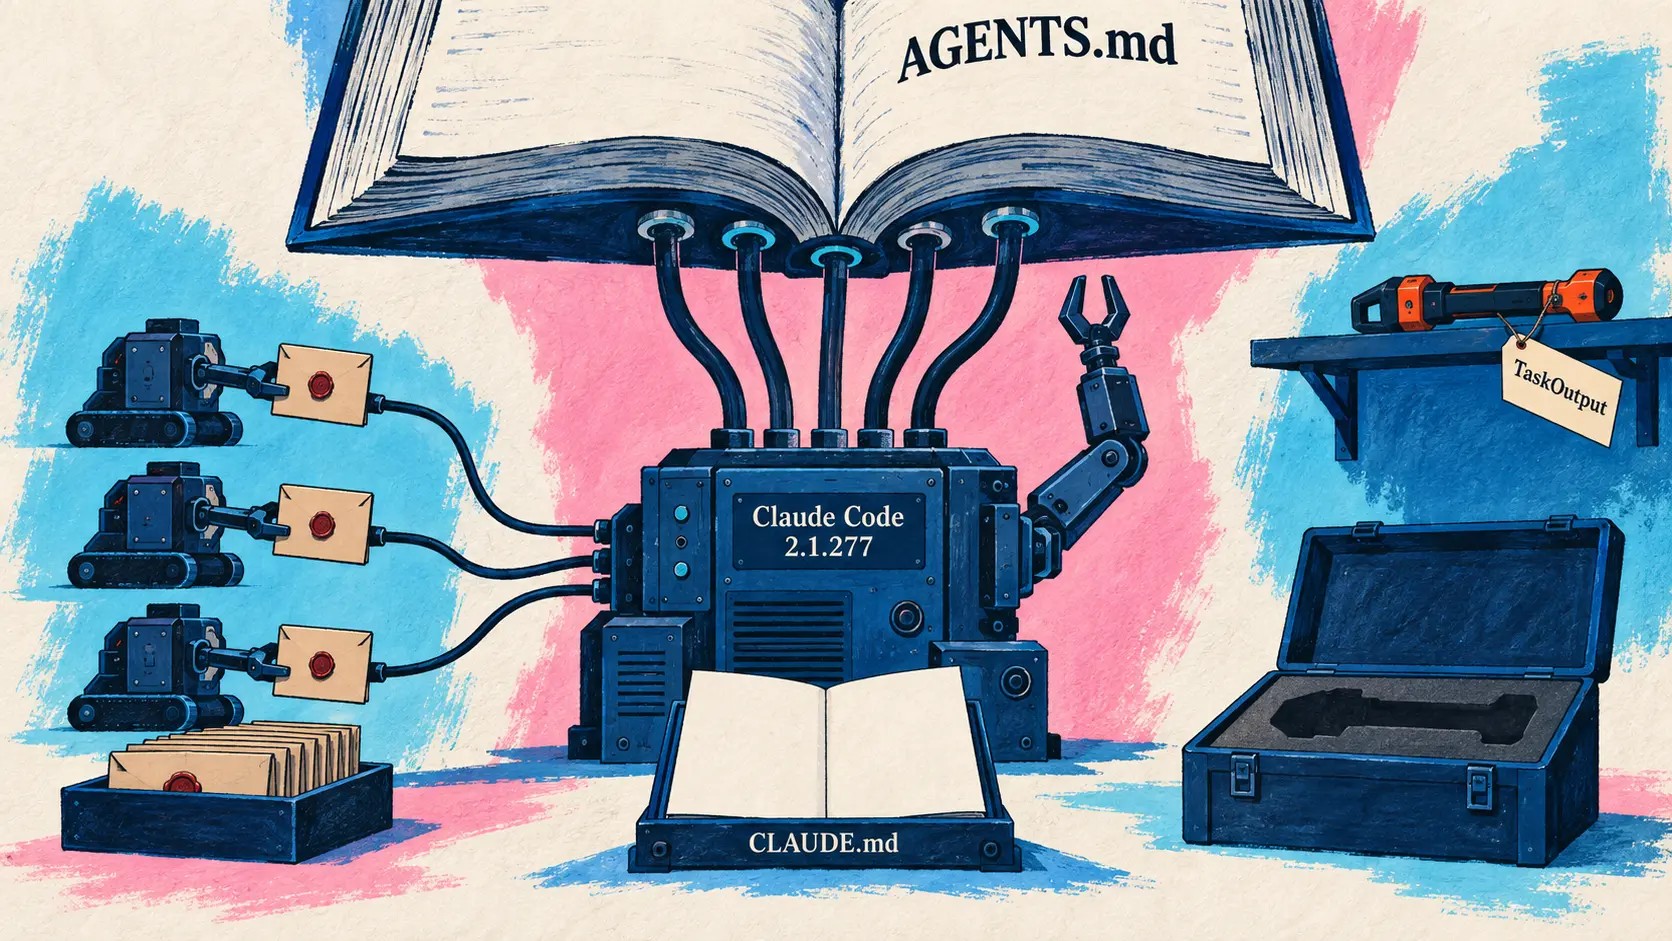
Claude Code lee AGENTS.md, aísla los subagentes y elimina TaskOutput
18 de septiembre — Tres versiones de Claude Code se sucedieron en veinte horas: la 2.1.275 el 17 de septiembre a las 22:33 UTC, la 2.1.276 el 18 a las 02:12 UTC y la 2.1.277 el 18 a las 18:06 UTC.
La novedad más estructural se resume en una línea de la versión 2.1.277. En un proyecto que carezca de CLAUDE.md, Claude Code lee AGENTS.md, el archivo de instrucciones convertido en una convención compartida por varios agentes de código del mercado. La opción se configura en /config, dentro de «Project instructions». La función aún no está disponible en Bedrock, Vertex ni Foundry.
Added AGENTS.md support: in a project with no CLAUDE.md, Claude Code reads AGENTS.md instead; change it under “Project instructions” in /config (not yet on Bedrock, Vertex or Foundry)
🇪🇸 Se añadió compatibilidad con AGENTS.md: en un proyecto sin CLAUDE.md, Claude Code lee AGENTS.md en su lugar; la opción se cambia en «Project instructions» dentro de /config (aún no disponible en Bedrock, Vertex ni Foundry). — CHANGELOG de Claude Code, anthropics/claude-code
Otros dos cambios de la misma versión afectan a la seguridad del contexto. Los resultados de los subagentes llegan al agente principal bajo un encabezado que los identifica como tales, para evitar que un texto devuelto por un subagente pueda hacerse pasar por una instrucción de la sesión; además, los caracteres Unicode invisibles de formato se eliminan de los prompts y la versión depurada se muestra antes del envío. La versión 2.1.277 también elimina la herramienta obsoleta TaskOutput: Claude ahora lee el archivo de salida de una tarea en segundo plano mediante Read.
La versión 2.1.275 añade una tecla de envío inmediato (ctrl+enter) que interrumpe el turno en curso y envía de una sola vez todos los mensajes en cola, así como la sincronización con el terminal de las skills y los plugins activados en la cuenta de claude.ai. En cuanto a la cadena de suministro, los plugins procedentes de npm se obtienen mediante npm pack --ignore-scripts con verificación de integridad, lo que impide que se ejecuten los scripts de instalación de un paquete. La versión 2.1.276, publicada menos de cuatro horas después, solo corrige una regresión de esta versión: un error 400 que hacía fallar todas las solicitudes detrás de un proxy.
| Número de versión | Publicación (UTC) | Contenido destacado |
|---|---|---|
| 2.1.275 | 17/09 a las 22:33 | Envío inmediato, sincronización de las skills de claude.ai, npm --ignore-scripts |
| 2.1.276 | 18/09 a las 02:12 | Corrección única: error 400 detrás de un proxy |
| 2.1.277 | 18/09 a las 18:06 | Compatibilidad con AGENTS.md, aislamiento de subagentes, retirada de TaskOutput |
Qwen3.8-Omni-Flash, el primer modelo ómnimo-modal agéntico de Qwen
18 de septiembre — Qwen publica Qwen3.8-Omni-Flash, presentado como su primer modelo ómnimo-modal diseñado en torno a capacidades agénticas. El cambio anunciado ya no consiste en comprender contenidos multimodales, sino en utilizarlos: comprender el contenido, planificar la tarea, ejecutarla con herramientas y entregar el resultado. El modelo admite texto, imagen, audio y vídeo en una ventana de contexto de un millón de tokens.
Meet Qwen3.8-Omni-Flash, Qwen’s first omni-modal model built around agentic capabilities!
🇪🇸 Presentamos Qwen3.8-Omni-Flash, el primer modelo ómnimo-modal de Qwen creado en torno a capacidades agénticas. — @Alibaba_Qwen en X
En las 29 evaluaciones seleccionadas por Qwen, la puntuación media mejora más de un 25 % frente a Qwen3.5-Omni-Plus, con las mayores mejoras concentradas en los agentes de audio y vídeo. El reconocimiento de múltiples hablantes es el aspecto que más avanza.
| Evaluación seleccionada | Qwen3.8-Omni-Flash | Qwen3.5-Omni-Plus | Gemini 3.8 Flash |
|---|---|---|---|
| WildClawBench-MM | 71,0 | 34,5 | 58,9 |
| UniClawBench | 69,6 | 67,1 | 69,0 |
| AgenticVBench | 36,8 | 14,5 | 45,0 |
| OmniVideoBench | 63,4 | 53,8 | 65,2 |
| StreamingBench | 80,8 | 57,1 | 79,9 |
| AliMeeting DER / cpWER (cuanto más bajo, mejor) | 3,4 / 17,2 | 88,1 / 89,6 | 72,6 / 53,1 |
El aspecto más original es la percepción agéntica aplicada a vídeos largos. En lugar de procesar una grabación de principio a fin, el modelo parte de la pregunta planteada, decide por sí mismo qué mirar y escuchar, y localiza la información mediante pasadas sucesivas de lo general a lo preciso. En OmniVideoBench, este modo eleva la precisión de 63,4 a 67,8 y reduce el consumo de 145 736 a 79 117 tokens por solicitud, aproximadamente un 45,7 % menos, cifra que indica la propia publicación oficial.
El componente tarifario sigue la misma línea: según la metodología de Qwen, el precio por hora de entrada de audio baja más de un 98 % respecto a Qwen3.5-Omni-Plus. Al mismo tiempo se abren dos componentes: Qwen-MM-Plugins, compatible con los harnesses Codex, Claude Code, Qwen Code y Gemini CLI, y Qwen-Live Harness para la interacción en tiempo real. Una variante Realtime está dedicada a la interacción continua de baja latencia, con un primer token entre 591 y 981 milisegundos.
🔗 Publicación de Qwen sobre Qwen3.8-Omni-Flash
Codex CLI 0.155.0 introduce las conversaciones de voz como función experimental
17 de septiembre — OpenAI publica Codex CLI 0.155.0, la primera versión estable desde la 0.154.0 del 10 de septiembre, instalable mediante npm install -g @openai/codex@0.155.0. Es la entrada del changelog que faltaba para el agente de voz anunciado el día anterior en X: la función se denomina /voice, ofrece transcripción en directo y controles del micrófono, y sigue siendo experimental —solo está disponible en las compilaciones compatibles (supported builds) y debe activarse mediante /experimental.
El resto de la versión es más discreto, pero resulta más útil de inmediato. La interfaz de terminal incorpora resúmenes del razonamiento en directo en la línea de estado, además de una marca de tiempo de finalización tras cada turno completado correctamente. La vista general de agentes permite ocultar, archivar y eliminar tareas, con detalles sobre la propiedad de los worktrees y una confirmación antes de eliminar los worktrees gestionados que estén limpios. En los Mac compatibles, las solicitudes MCP de las sesiones TUI locales pueden validarse mediante Touch ID. Amazon Bedrock puede obtener sus credenciales de AWS a partir de comandos configurados, con almacenamiento en caché, renovación al caducar y reanudación tras un fallo de autenticación.
Varias correcciones están relacionadas con la seguridad: se bloquean los escapes de procesos de Windows desde sandboxes WSL restringidos, se refuerzan las instantáneas de shell intermediadas contra la exposición de credenciales y un cambio de cuenta invalida las sesiones de control remoto, el estado WebSocket almacenado en caché y los catálogos de modelos pertenecientes a la identidad anterior.
| Novedad de la versión | Detalle |
|---|---|
/voice | Transcripción en directo y controles del micrófono, experimental mediante /experimental |
| Interfaz de terminal | Resúmenes del razonamiento en la línea de estado, marca de tiempo al final del turno |
| Vista de agentes | Ocultación, archivado y eliminación de tareas, propiedad de los worktrees |
| Touch ID | Validación de solicitudes MCP en sesiones locales, en Mac compatibles |
| Amazon Bedrock | Credenciales de AWS obtenidas mediante comandos, con caché y renovación |
🔗 Notas de la versión Codex CLI 0.155.0
Codex detalla su consumo por tarea, subagente y conversación
18 de septiembre — OpenAI Developers anuncia un seguimiento detallado del consumo en Codex: la herramienta muestra cómo contribuyen las tareas, los subagentes y las conversaciones individuales al uso total. La información se encuentra en la aplicación de escritorio, en Ajustes y después Usage & billing para las cuentas personales y Business, o en Usage para las cuentas Enterprise que cumplan los requisitos; es necesario tener la aplicación actualizada para disponer de ella. El anuncio no viene acompañado de ninguna publicación de blog ni entrada de changelog.
La granularidad es el verdadero asunto. Hasta ahora, agotar una cuota no indicaba de dónde procedía el gasto; un desglose por subagente permite saber qué delegación consume recursos y reescribirla. Es la contrapartida contable de la generalización de los subagentes en los harnesses de código.
🔗 Anuncio de OpenAI Developers en X
Grok Voice Transcribe 2.0, el reconocimiento de voz de SpaceXAI al mismo precio
18 de septiembre — SpaceXAI anuncia Grok Voice Transcribe 2.0, su nuevo modelo de reconocimiento de voz (speech-to-text), descrito como dos veces más preciso que la versión 1.0 al mismo precio. El modelo se basa en la arquitectura de audio que ya impulsa Grok Voice, que, según la empresa, gestiona decenas de miles de llamadas de atención al cliente al día y transcribe millones de horas de narración de vídeo.
El argumento central se refiere al audio real y no al de laboratorio: líneas telefónicas inestables, voces superpuestas, acentos locales, números de teléfono y direcciones de correo electrónico dictados en voz alta. SpaceXAI reivindica el primer puesto en precisión entre 32 modelos de streaming en la clasificación pública Artificial Analysis y se apoya en cuatro conjuntos internos extraídos del tráfico de producción: telefonía de 8 kHz, conversaciones con Grok, identificadores dictados y comandos de voz breves en 19 idiomas.
La mejora más clara se produce en el ámbito multilingüe. En el conjunto de frases cortas, que son las que ofrecen menos contexto para identificar el idioma, la tasa de error por palabra baja del 20,6 % al 6,8 %. El modelo detecta automáticamente el idioma y sigue sus cambios durante la grabación en una sola pasada.
| Métrica medida | Valor anunciado |
|---|---|
| Precisión declarada frente a Transcribe 1.0 | dos veces superior |
| Clasificación Artificial Analysis (streaming) | 1.º de 32 modelos |
| Tasa de error en frases cortas (1.0 → 2.0) | 20,6 % → 6,8 % |
| Tarifa por lotes | 0,10 dólares por hora de audio |
| Tarifa de streaming | 0,20 dólares por hora de audio |
| Canales transcritos de forma independiente | hasta 8 |
| Términos de negocio por solicitud | hasta 100 |
El modelo admite procesamiento por lotes y streaming, marcas de tiempo por palabra con puntuación de confianza, separación de hablantes (diarization) sin coste adicional y detección del final del turno de habla. Las integraciones existentes de la API reciben la mejora de precisión sin cambios en el código. Grok Voice Transcribe 2.0 se convertirá próximamente en el modelo predeterminado de la API y la versión 1.0 quedará obsoleta en las próximas semanas: será necesario fijar grok-voice-transcribe-1.0 para seguir utilizándola.
🔗 Anuncio de Grok Voice Transcribe 2.0
Anthropic instala evaluadores de Accenture dentro de la empresa
18 de septiembre — Anthropic anuncia una colaboración con Accenture para la evaluación independiente de modelos de frontera, presentada como un paso importante hacia el compromiso asumido por su director general de acoger evaluadores integrados (embedded). El trabajo correrá a cargo de Faculty, la filial de Accenture especializada en IA, y abarcará la evaluación y el red-teaming de los modelos, las evaluaciones de alineamiento y las pruebas de las salvaguardas.
La distinción respecto a los evaluadores externos es explícita: un evaluador integrado trabaja dentro de la empresa de IA con un acceso comparable al de un empleado. Puede observar los modelos durante su entrenamiento, seguir las decisiones que rigen su creación y despliegue, hablar directamente con los empleados, verificar que se cumplen los compromisos de seguridad, comunicar incidentes y publicar una descripción mejor fundamentada de los beneficios y riesgos. Anthropic precisa que el mecanismo no reduce su responsabilidad, sino que la hace más verificable.
El anuncio es inusualmente franco sobre lo que aún no existe. No hay ninguna norma sobre la información a la que debería tener acceso un evaluador integrado, ni sobre cómo debería publicar sus conclusiones, ni tampoco un sistema establecido para financiar la evaluación independiente. Anthropic considera que, a largo plazo, esta financiación debería proceder de fondos comunes o públicos; al no existir hoy tal mecanismo, financia directamente el trabajo de Accenture, lo que constituye la limitación más visible del acuerdo.
| Elemento de la colaboración | Valor anunciado |
|---|---|
| Entidad operadora | Faculty, filial de IA de Accenture |
| Inversión | Al menos 1 000 millones de dólares por parte, durante cinco años |
| Ámbito cubierto | Evaluación, red-teaming, alineamiento, salvaguardas |
| Nivel de acceso | Comparable al de un empleado |
| Financiación | Directa por Anthropic, ante la falta de fondos comunes |
| Exclusividad | Ninguna, por ninguna de las partes |
Anthropic también indica que mantiene conversaciones con METR y otros evaluadores sin ánimo de lucro para experimentar con elementos de evaluación integrada mediante su propia financiación, y anuncia más colaboradores para las próximas semanas.
🔗 Anuncio de Anthropic sobre la evaluación integrada
Antigravity: tres versiones en dos días en torno a los agentes personalizados
Google publicó de forma consecutiva dos versiones de su CLI y una versión de la aplicación Antigravity. Las tres abordan el mismo tema desde tres ángulos: qué sabe un agente personalizado, qué puede rechazar y hasta qué punto puede funcionar sin supervisión. Prolongan una intensa serie iniciada el 11 de septiembre, cuyas versiones 1.2.1 a 1.2.4 no se incluyen aquí.
La CLI 1.2.6 abre un Remote Control vinculado a la sesión y elimina el límite de cinco minutos
18 de septiembre — Ocho días después de la 1.2.0, que convertía la CLI en un servicio persistente del sistema, Google toma la dirección opuesta con una segunda modalidad de Remote Control, mucho más ligera: una conexión limitada a la sesión (session-scoped), abierta mediante el flag --remote-control al iniciar o mediante el comando /remote-control durante la ejecución. Escribir /remote-control off o cerrar la sesión desmonta el túnel y elimina el dispositivo de la lista. Mientras que la 1.2.0 buscaba un daemon que sobreviviera a la sesión, la 1.2.6 busca lo contrario.
El segundo cambio afecta al modo sin interfaz (headless): el tiempo de expiración predeterminado de las ejecuciones -p / --prompt pasa de cinco minutos a ilimitado, salvo que se especifique --print-timeout. El tercero estructura los informes de errores: si falla el agente o la API, la CLI escribe en la salida de error una línea JSON AGY_ERROR: {...} que contiene el estado canónico, el código HTTP o gRPC, si se puede reintentar y un identificador de error, con un código de salida que pasa de 1 a 3. De este modo, un script de orquestación puede distinguir un fallo temporal de red de un error definitivo sin analizar texto libre.
La CLI 1.2.5 proporciona por fin a los agentes Markdown el directorio de sus subagentes
17 de septiembre — Hasta ahora, un agente personalizado definido en Markdown podía declarar invoke_subagent entre sus herramientas sin llegar a saber nunca qué subagentes existían: disponía de la herramienta, pero no del directorio. La CLI añade ahora automáticamente a su prompt del sistema el catálogo de subagentes disponibles y sus instrucciones de uso, lo que hace efectiva la delegación.
El vocabulario del changelog exige una precaución: se trata de contexto añadido por el propio producto, no de una vulnerabilidad de seguridad ni de una corrección. La segunda mejora conserva el nombre explícito de una tarea enviada a segundo plano, que se perdía entre las notificaciones y las listas de tareas. Las cinco correcciones abordan la depuración de identificadores invalidados, los códigos de salida de los comandos interrumpidos y los paneles de razonamiento que permanecían bloqueados.
Antigravity 2.15.0 permite a los agentes personalizados desactivar los prompts y las herramientas predeterminados
18 de septiembre — Tres días después de la 2.14.0, la aplicación publica 7 mejoras y 16 correcciones. El principal cambio permite a los agentes personalizados controlar su propio contexto: pueden desactivar las secciones predeterminadas del prompt y las herramientas predeterminadas, y después reintroducir únicamente las que necesitan. Para un agente especializado, esto reduce en la misma medida el prompt del sistema impuesto.
El resto se centra en la navegación y la persistencia: Page Up, Page Down, Home y End desplazan una conversación, Esc permite salir del área de entrada y el agente personalizado seleccionado se recuerda tras una recarga. Dos correcciones afectan a la integridad de los datos: los ajustes guardados y la lista de proyectos podían sobrescribirse cuando la aplicación no conseguía leer su archivo de estado, y los ajustes de permisos acumulaban duplicados que hacían crecer los archivos de conversación.
GitHub Copilot: un canvas de Sentry, seis modelos retirados y métricas por personalización
Tres entradas del changelog en dos días reflejan la misma preocupación: medir qué hacen realmente los equipos con Copilot y eliminar lo que ya no utilizan.
El resumen del 14 de septiembre identifica dos componentes nuevos
18 de septiembre — GitHub publica su resumen semanal de Copilot correspondiente a la semana del 14 de septiembre. La mayor parte del sumario retoma entradas ya publicadas a lo largo del changelog; solo dos elementos no se habían anunciado antes por separado. El primero es el canvas de Sentry en la aplicación Copilot, que vincula un informe de fallo en producción con una corrección sin salir de la aplicación: muestra los errores, las trazas de pila (stack traces) y el contexto, y después permite investigar la causa, validar una corrección y preparar una pull request. Es la primera integración de una herramienta de supervisión de errores en los canvases, después de Jira a principios de septiembre.
El segundo es la oleada de agentes de VS Code 1.138. La ventana Agents puede ejecutar un agente en un Dev Container local, con las herramientas y dependencias del proyecto; el despliegue es progresivo y requiere Docker. Las sesiones inactivas pueden marcarse automáticamente como finalizadas una vez fusionadas todas sus pull requests, con eliminación opcional tras un periodo de gracia, en versión preliminar y con activación explícita. Por último, se puede crear una pull request directamente desde una sesión de Agent Host.
Seis modelos abandonarán todas las superficies de Copilot el 19 de octubre
18 de septiembre — GitHub anuncia la retirada de seis modelos de todas las superficies de Copilot —Copilot Chat, ediciones en línea, modos ask y agent y completado de código— el 19 de octubre de 2026. Es la segunda oleada de obsolescencia anunciada en septiembre.
| Modelo retirado | Fecha de retirada | Alternativa sugerida |
|---|---|---|
| Gemini 3.7 Flash | 19/10/2026 | Gemini 3.8 Flash |
| GPT-5.5 | 19/10/2026 | GPT-5.6 Sol |
| GPT-5.4 | 19/10/2026 | GPT-5.6 Sol |
| GPT-5.4 mini | 19/10/2026 | GPT-5.6 Luna |
| GPT-5 mini | 19/10/2026 | GPT-5.6 Luna |
| Grok 4.5 | 19/10/2026 | Grok 4.6 |
Con la activación predeterminada de los modelos, las alternativas se activan automáticamente para los clientes de Copilot Enterprise y Business, salvo que un administrador haya desactivado el valor predeterminado global o bloqueado explícitamente el modelo en cuestión; en ese caso, el acceso se vuelve a habilitar mediante las políticas de modelos en los ajustes. No se requiere ninguna acción para retirar los modelos.
🔗 Anuncio de la obsolescencia de los modelos de Copilot
La API de métricas contabiliza los skills, agentes, servidores MCP y plugins de la CLI
17 de septiembre — La API de métricas de uso de Copilot abarca ahora cinco familias de personalizaciones agénticas de la CLI: skills, agentes personalizados, servidores MCP, slash commands y plugins. Las tablas totals_by_skill, totals_by_custom_agent, totals_by_mcp, totals_by_slash_cmd y totals_by_plugin enumeran los cinco elementos más activos con su interaction_count, mientras que los campos distinct_*_use_count contabilizan la variedad de elementos utilizados más allá de esos cinco primeros.
Dos matices evitan interpretaciones erróneas. Para los servidores MCP, el contador solo aumenta cuando la CLI intenta conectarse o volver a conectarse —tanto si tiene éxito como si fracasa—, no con cada llamada a una herramienta a través de una conexión establecida. Las métricas de plugins solo contabilizan las invocaciones de skills vinculadas a un plugin: constituyen un subconjunto de los totales de skills y no deben sumarse a estos. Por motivos de privacidad, solo se muestran los nombres proporcionados por GitHub; los nombres definidos por los clientes se agrupan bajo other.
🔗 Personalizaciones agénticas de la CLI en la API de métricas
Los agentes de código en el terminal: MiniMax abre el suyo y Mistral estabiliza su arnés
Dos anuncios de dos actores sin relación entre sí, el mismo día y en el mismo mercado: el agente de programación que funciona en un terminal se está generalizando y la diferenciación se desplaza hacia la licencia y la estabilidad del arnés.
MiniMax publica el código de MiniMax Code CLI bajo licencia MIT
18 de septiembre — MiniMax abre el código fuente de su agente de programación para terminal en la versión 0.4.12. La herramienta se instala con el nombre mcode y ofrece tres puntos de entrada: una interfaz interactiva de terminal, un modo sin interfaz (mcode exec) destinado a scripts de shell, integración continua y evaluaciones, y un modo ACP para editores compatibles con Agent Client Protocol. Lee los archivos de un proyecto, inspecciona las diferencias, ejecuta comandos de shell y pruebas, bajo un régimen de permisos y sandbox.
La elección del modelo sigue abierta: por un lado, una cuenta de MiniMax y su Token Plan; por otro, un proveedor externo, siempre que exponga un formato de API compatible con OpenAI o Anthropic. A esto se suman una función de búsqueda integrada, herramientas multimodales, el protocolo MCP, subagentes y un sistema de plugins. El código de primera mano se publica de forma predeterminada bajo licencia MIT. El repositorio abarca la TUI, la CLI sin interfaz y el modo ACP, pero no la aplicación de escritorio, aunque sí alberga el seguimiento de sus incidencias; por ahora, solo se aceptan propuestas de código de los colaboradores del repositorio.
El Unified Harness de Vibe CLI abandona el estado experimental
18 de septiembre — Mistral publica Vibe CLI 2.25.5, seis días después de la 2.25.4. El cambio estructural se resume en una línea de las notas de la versión: el Unified Harness ya no lleva la etiqueta «experimental», y ahora --legacy-harness sirve como vía de escape documentada hacia el antiguo arnés de Python. Tras una serie de versiones correctivas centradas en la seguridad de las aprobaciones del shell, el nuevo arnés se convierte oficialmente en el predeterminado: esa es la noticia, no el número de versión.
El cambio viene acompañado de una recuperación de la paridad: Unified Harness ahora incorpora la rama actual de Git, el estado del repositorio y los commits recientes a las instrucciones del sistema; los hooks se ejecutan por fin dentro de los subagentes en lugar de ignorarse silenciosamente; y vuelven a funcionar los proveedores configurados sin una variable de entorno para la clave de API, como los servidores locales o autoalojados. El refuerzo de los permisos continúa: las aprobaciones del shell ya no se amplían a otro programa o entorno, las llamadas a herramientas MCP ahora respetan el sistema de permisos en lugar de eludirlo, y smart approve deja de saltarse las reglas del usuario.
🔗 Notas de la versión Vibe CLI 2.25.5
Los plugins de ChatGPT admiten varias cuentas a la vez
18 de septiembre — La compatibilidad con varias cuentas llega a la mayoría de los plugins de ChatGPT. Ahora es posible vincular la cuenta personal, la profesional y las de proyectos paralelos, y después incorporar el contexto de cada una a una misma conversación. Las cuentas se conectan desde el directorio de plugins, en chatgpt.com/plugins.
El anuncio de la cuenta OpenAI Developers retoma un mensaje de Max Stoiber publicado una hora antes. Por parte de los desarrolladores de plugins, no hay nada que hacer: la función se activa automáticamente, sin modificaciones. Quienes quieran ir más lejos pueden añadir una herramienta profile a su servidor MCP para que ChatGPT pueda etiquetar las cuentas conectadas; es la única acción concreta que se espera de ellos. El anuncio, publicado a las 18:10, hora de París, no viene acompañado de ninguna entrada de blog ni del changelog.
El caso de uso previsto es el de un desarrollador que mantiene separadas sus identidades por empleador o proyecto y que, hasta ahora, tenía que cambiar de conexión para cambiar de contexto.
🔗 Anuncio de las cuentas múltiples en X
🔗 Mensaje original de Max Stoiber
Genspark añade un saldo semanal de créditos a los planes Plus y Pro
18 de septiembre — Genspark modifica las ventajas de sus suscripciones Plus y Pro al añadir un saldo semanal de créditos, sin cambiar el precio de los planes. Este saldo se recibe cada semana de forma adicional al plan ya contratado y cubre el uso en modo Standard de todos los agentes y herramientas de la plataforma: Super Agent, AI Chat, AI Image, AI Slides, AI Sheets, AI Docs y Deep Research.
Un segundo mensaje del mismo hilo detalla el funcionamiento para AI Chat y AI Image. Para los suscriptores actuales, el saldo se añade a lo que ya tienen y, hasta el 31 de diciembre de 2026, todos los modelos de AI Chat y AI Image pueden utilizarse sin coste en créditos, incluidos los modelos insignia como Opus; para quienes se suscriban a partir del 18 de septiembre, los modelos básicos (core models) de AI Chat y AI Image son gratuitos. Genspark aclara que estos cambios no se aplican ni a los planes Team ni a los planes Enterprise, y remite a su centro de ayuda para consultar las condiciones detalladas.
Google Research: lo que ha producido AlphaGenome Atlas y simulaciones que se ponen a prueba a sí mismas
Dos publicaciones de investigación el mismo día, con un punto en común: en ambos casos, lo que se muestra no es el modelo, sino lo que terceros han obtenido de él o lo que el ciclo de validación verifica en su lugar.
AlphaGenome Atlas presenta los primeros resultados de sus socios
17 de septiembre — Nueve días después de la publicación de AlphaGenome Atlas, el mapa predictivo de las 9.000 millones de sustituciones posibles del ADN humano, Google DeepMind destaca un hilo que detalla tres colaboraciones.
| Socio científico | Resultado comunicado |
|---|---|
| Stowers Institute | Más de 2.500 motivos reguladores cartografiados |
| Universidad de Exeter / UK Biobank | Más de 54.000 participantes analizados, más de un 22 % de detección adicional de señales genéticas raras |
| Broad Institute | Mutación crítica del gen DNM1 identificada y posteriormente confirmada y validada en laboratorio |
Los motivos reguladores son las secuencias de ADN que actúan como interruptores y reguladores sobre la actividad de los genes. El trabajo realizado en Exeter también identificó nuevas variantes que influyen en la abundancia de PLA2G7, una proteína relacionada con la salud metabólica. El caso del Broad Institute es el más concreto de los tres: ante una lista inmensa de posibles mutaciones en enfermedades raras sin explicación, Atlas ayuda a señalar la correcta, que después se confirma experimentalmente. Sin embargo, toda la información se limita a un hilo en X, sin una entrada detallada ni una publicación asociada.
🔗 Hilo de AlphaGenome Atlas en X
Simulaciones educativas generadas y luego probadas por un agente en Chrome
17 de septiembre — Gal Elidan y Yael Haramaty publican un experimento que aplica la interfaz generativa (generative UI) a la creación de simulaciones educativas. El docente mantiene la iniciativa: propone el tema, Google genera un conjunto de objetivos de aprendizaje modificables y sujetos a su aprobación, que sirven como base para la generación. Cada recurso interactivo se divide en niveles de dificultad creciente, con caja de herramientas, pistas progresivas y soluciones detalladas.
El elemento más interesante es el bucle de autocorrección. La generación se controla mediante criterios pedagógicos, mecánicos y de presentación, y algunas evaluaciones son agénticas: la prueba de resolubilidad abre una instancia de Chrome y manipula la simulación como lo haría un usuario, intentando también acciones adversas, como llevar los controles deslizantes a sus valores extremos. El bucle se repite hasta que se cumplen todos los criterios, a costa de un tiempo de generación más largo. Google publica más de 30 recursos interactivos STEM en inglés; docentes británicos evaluaron una colección de 40, y un estudio con 12 docentes estadounidenses arroja una puntuación media de 8 sobre 10.
🔗 Publicación de Google Research sobre los recursos educativos interactivos
Claude acelera más de 30 modelos de biología y financia una competición de proteínas
17 de septiembre — Anthropic publica una entrada que describe cómo Claude optimizó la inferencia de más de 30 modelos open source utilizados por biólogos —predicción de estructuras, diseño de proteínas, modelos de lenguaje de proteínas y genómica— en poco menos de cuatro semanas, con una mejora media de aproximadamente 4x. Todo el código se publica como open source.
El núcleo técnico se centra en la atención triangular y la multiplicación triangular, cúbicas tanto en tiempo como en memoria. Claude produjo FlashPairformer, un conjunto de kernels que supera el estándar del sector entre 2,7 y 2,9x en atención. Un modo de baja memoria denominado «Big» permite plegar con precisión sistemas de más de 10 000 tokens en un solo nodo GPU, mientras que el ribosoma 40S predicho por AlphaFold3 tenía 7 663 tokens. El aspecto metodológico es igual de importante: el trabajo fue supervisado por dos miembros del personal técnico sin experiencia previa en optimización de inferencia.
Por último, Anthropic copatrocina con Adaptyv Bio una competición de diseño de proteínas sobre cinco problemas difíciles, con más de 5 000 diseños de la comunidad validados experimentalmente, hasta 1 millón de dólares en créditos de Claude y 250 000 dólares en recursos de computación aportados por Modal.
🔗 Publicación de investigación de Anthropic
Modelos abiertos y laboratorios: Muse llega a Mac, Sakana revela su grupo de frontera
Meta lleva su agente Muse a macOS
18 de septiembre — Meta lanza Muse en Mac, anunciado durante la noche del 17 al 18 de septiembre. La cuenta @AIatMeta comparte una publicación que describe un agente personal capaz de actuar directamente en el ordenador del usuario, con su permiso explícito en cada ocasión. Se citan tres usos: ordenar la carpeta de descargas, encontrar un archivo perdido y resumir mensajes y notas.
El anuncio amplía el lanzamiento de Muse del 8 de septiembre, un agente impulsado por Muse Spark 1.3 y disponible hasta ahora en iOS, Android, la web y WhatsApp. La llegada a Mac hace que este tipo de producto dé un paso adelante: el agente ya no trabaja en su propio sandbox, sino con los archivos personales del usuario. Meta no comunica el precio, los países donde estará disponible ni la configuración requerida, y la puesta a disposición no viene acompañada de ningún documento de seguridad específico para Mac; el blog ai.meta.com no ha publicado nada desde el 27 de julio.
Sakana AI revela el Frontier Intelligence Group y su postura sobre el paradigma
18 de septiembre — Sakana AI anuncia la existencia del Frontier Intelligence Group (FIG), un colectivo interno que ha ido creciendo desde los inicios de la empresa. El punto de partida es una pregunta planteada por Llion Jones, director técnico de Sakana AI y uno de los inventores del Transformer: ¿basta con ampliar la arquitectura Transformer con cada vez más datos y capacidad de computación para llegar hasta la AGI? La respuesta del laboratorio es no.
Ahí es donde reside la información, más que en el catálogo de trabajos que la acompaña. La publicación enumera los defectos que el paradigma actual no ha resuelto —modelos que producen con seguridad información falsa, colapsan ante situaciones realmente nuevas y consumen mucha energía— y los contrapone a la inteligencia biológica, que aprende continuamente y generaliza a partir de muchos menos datos. El grupo adopta cinco principios, entre ellos la libertad de fracasar sin presión sobre las puntuaciones de los benchmarks. Entre los trabajos presentados, los Transformer dispersos desarrollados con NVIDIA parten de una observación cuantificada —más del 95 % de las neuronas de una capa feed-forward permanecen inactivas durante el procesamiento de una palabra— y han dado lugar a un formato de datos denominado TwELL, aceptado en ICML 2026.
🔗 Publicación de Sakana AI sobre el Frontier Intelligence Group
Vídeo generativo: Runway unifica sus créditos, Pika lanza su primera aplicación
Runway hace que sus créditos sean intercambiables entre la aplicación web y Runway Dev
18 de septiembre — Runway elimina la barrera entre sus dos productos: los créditos adquiridos pasan a poder utilizarse indistintamente en la aplicación web y en Runway Dev, la oferta destinada a desarrolladores. Hasta ahora, ambos entornos funcionaban con reservas separadas, contratos distintos y sin un lugar único desde el que seguir el consumo de un proyecto a otro.
El cambio viene acompañado de cuatro elementos: una reserva única adquirida de forma centralizada en una sola factura, un flujo continuo entre la creación de una secuencia en la aplicación web y su exposición mediante API, un soporte reforzado para Runway Dev con acceso a Applied AI Architects y una vista de análisis del espacio de trabajo rediseñada que permite a los administradores transferir créditos entre los espacios web y Dev. Dos ofertas comerciales son válidas hasta el 31 de diciembre de 2026: un 10 % de créditos adicionales al firmar para las nuevas empresas, equivalente como mínimo a 130 minutos de vídeo o 12 000 imágenes según la conversión anunciada por Runway; y, para los clientes existentes, 5 000 créditos más una jornada de Applied AI Architect a cambio de una recomendación al responsable de producto de aplicaciones de IA.
🔗 Publicación de Runway sobre la tarificación unificada
Pika lanza Product Ad, de la foto de producto al anuncio en vídeo
18 de septiembre — Al día siguiente de presentar su nueva plataforma creativa, Pika lanza su primera aplicación: Product Ad. La aplicación toma una o varias imágenes de producto, las combina con un briefing escrito y genera un vídeo presentado como listo para el mercado.
| Parámetro de generación | Valor propuesto |
|---|---|
| Duraciones disponibles | 6 s, 15 s, 30 s, 60 s, 2 min |
| Formato de salida | 16:9 |
| Entrada esperada | imágenes del producto y briefing escrito |
| Acceso | se requiere crear una cuenta |
Pika publica el anuncio citando su propio mensaje del día anterior sobre el rediseño de la plataforma, lo que sitúa Product Ad dentro de una serie de aplicaciones previstas y no como una función aislada. No se menciona ningún modelo ni se comunica ningún precio.
NVIDIA publica AIPerf, sucesor de GenAI-Perf para medir la inferencia a gran escala
18 de septiembre — NVIDIA presenta AIPerf, su herramienta de medición del rendimiento de la inferencia generativa, descrita como la sucesora de GenAI-Perf y reescrita desde cero. El punto de partida resulta familiar: una vez desplegado un modelo, la pregunta «¿es rápido?» suele resolverse con comandos curl o un generador de carga improvisado, que producen cifras poco fiables.
La ruptura es arquitectónica. Mientras que la mayoría de las herramientas se ejecutan en un solo proceso y chocan con el bloqueo global del intérprete de Python en cuanto aumenta la concurrencia, AIPerf distribuye el trabajo: los procesos worker generan la carga, servicios independientes procesan los resultados y todo el conjunto se coordina mediante ZMQ. El objetivo es explícito: que el cliente de medición nunca se convierta en el cuello de botella.
| Indicador informado | Qué mide |
|---|---|
| Time to First Token | Tiempo entre el envío de la solicitud y el primer token |
| Inter-Token Latency | Tiempo entre dos tokens sucesivos durante la generación |
| Latencia de la solicitud | Tiempo de extremo a extremo de la respuesta completa |
| Rendimiento de tokens de salida | Tokens producidos por segundo en todas las solicitudes |
| Percentiles informados | p25, p50, p75, p90, p95, p99 |
| Tipos de endpoints | más de 15 |
La herramienta también puede reproducir trazas de tráfico real en los formatos Mooncake, Baseten y WEKA. El artículo insiste especialmente en la utilidad de las distribuciones: un servidor cuyo tiempo medio hasta el primer token parece saludable, pero cuyo p99 se dispara, pasa inadvertido en los datos agregados y falla en producción.
🔗 Publicación de NVIDIA sobre AIPerf
Mistral desmiente una afirmación de acceso no autorizado a sus sistemas
18 de septiembre — Mistral publica a las 05:48 UTC un breve comunicado en su cuenta de X en respuesta a una afirmación de acceso no autorizado a sus sistemas. La empresa indica que ha realizado una investigación exhaustiva, que no ha encontrado ningún elemento que respalde dicha afirmación y confirma que sus sistemas no han sido comprometidos.
We are aware of a claim alleging unauthorized access to our systems. Following a thorough investigation, we have found no evidence to support this claim and can confirm that our systems have not been compromised.
🇪🇸 Tenemos conocimiento de una afirmación que señala un acceso no autorizado a nuestros sistemas. Tras una investigación exhaustiva, no hemos encontrado ningún elemento que respalde dicha afirmación y podemos confirmar que nuestros sistemas no han sido comprometidos. — @MistralAI en X
El mensaje no identifica al autor de la afirmación, no especifica ni su fecha ni su naturaleza y no ofrece ningún detalle sobre el alcance de la investigación. Lo que aquí se recoge es la postura de Mistral, y solo la suya: no fue posible consultar la afirmación original. El comunicado es el mensaje más visto de la cuenta durante el periodo, y no se encontró ninguna publicación adicional en el sitio web de la empresa.
Breves
- Balyasny Asset Management explica cómo supervisa Claude Fable 5 — la empresa, que gestiona unos 38.000 millones de dólares, reduce el análisis inicial de un arbitraje de fusiones de entre tres y cinco días a menos de un día, con un agente que funciona durante unos 30 minutos y una revisión humana. 🔗 fuente
- Codex CLI 0.155.1 vuelve a desactivar de forma predeterminada los resúmenes de razonamiento — corrección única al día siguiente de la versión 0.155.0: activarlos de oficio provocaba que los proveedores que no los admiten rechazaran las solicitudes. 🔗 fuente
- Gemini CLI retoma su serie nightly tras un día en blanco — cuatro cambios el 18 de septiembre, entre ellos la conservación del refresh token OAuth durante una renovación y una eliminación de credenciales que ahora es idempotente; los canales stable y preview permanecen sin cambios. 🔗 fuente
- Kimi Code 2.0.1 acelera el inicio y la reanudación de sesiones — versión de correcciones 32 horas después de la 2.0.0: compactación del índice de sesiones, reanudación más rápida con historiales largos, clave de API legible desde una variable de entorno con nombre y observadores de archivos limitados. 🔗 fuente
- Qwen Code pasa a la versión preliminar v0.24.1 con un SDK de navegador Playwright — no es una versión estable; incorpora control integrado del navegador con un puente de mensajería nativa de Chrome y ejecución de los subagentes en contenedores. 🔗 fuente
- Zed publica la versión estable 1.20.2, con solo dos correcciones — los errores de pago de proveedores de modelos externos ya no muestran una invitación para pasarse a Zed Pro en lugar del mensaje original, y dos extensiones de snippets para el mismo lenguaje ya no se anulan mutuamente. 🔗 fuente
- Replit afirma que su Free Mode es «30 veces más» generoso, sin publicar ninguna referencia — un único tuit, sin enlace ni changelog, que no precisa con qué se compara ese factor: debe considerarse una afirmación de Replit, no una medición. 🔗 fuente
- El panel de impacto de Copilot desglosa la interacción por funcionalidad — siete superficies durante 28 días, con distinción entre revisión de código activa y pasiva, y una población de la fase de adopción calculada ahora mediante una ventana móvil. 🔗 fuente
- GitHub programa una retransmisión en directo de introducción al SDK de Copilot en seis idiomas — sesiones, herramientas, servidores MCP y eventos en streaming, con sesiones dedicadas a .NET y Java, sin requisitos previos. 🔗 fuente
- Runway Ruby conserva el canal alfa durante la conversión a HDR — la conversión de una toma a HDR mantiene intacta la transparencia en un solo paso; no se especifican ni el precio ni el nivel de suscripción. 🔗 fuente
- MiniMax se incorpora al Singtel AI Pass para el programa singapurense SkillsFuture — MiniMax H3, MiniMax Agent y MiniMax Audio entran en la oferta, dirigida a estudiantes que cumplan los requisitos en más de 200 cursos de IA respaldados por la SWDA; no se indica importe ni calendario alguno. 🔗 fuente
- VC-Attention acelera la atención de MiniMax-H3 sin reentrenamiento — MiniMax difunde el trabajo de Nunchux AI sobre atención de baja precisión aplicable al modelo existente; Nunchux AI anuncia una aceleración de 1,6x en B200 y de 1,5x en B300 frente a FlashAttention-4. 🔗 fuente
- Wan3.0 ocupa el segundo puesto en la categoría de vídeo de OpenArt Arena — Alibaba destaca los planos de 30 segundos, el audio nativo y la compatibilidad con cualquier referencia; posicionamiento en una clasificación externa, sin novedades de producto. 🔗 fuente
- Synthesia abre su sede estadounidense en Nueva York — noticia empresarial sin producto, plantilla ni calendario de inversión, dos días después de la disponibilidad general de su Interactive Avatar API. 🔗 fuente
- Grok Imagine detalla el coste de un episodio piloto producido íntegramente con IA — el estudio de PJaccetturo anuncia nueve días de trabajo, 3.627 imágenes y 3.043 vídeos generados, con un coste de 2.677 dólares en generaciones para el episodio piloto del concurso Odyssée. 🔗 fuente
- BananaMind 2 Pro se acerca a SmolLM2 con veinte veces menos tokens — un modelo de 139 millones de parámetros entrenado con 100.000 millones de tokens y una RTX 5070 Ti alcanza un 42,78 % en HellaSwag, frente al 43,22 de SmolLM2-135M, entrenado con 2 billones de tokens. 🔗 fuente
- Optimum-Intel v2.2.0 y OpenVINO GenAI 2026.4.0 amplían la exportación al hardware de Intel — Hugging Face e Intel publican versiones conjuntas compatibles con procesadores, tarjetas gráficas y NPU de Intel, y Mistral 3 ya puede exportarse. 🔗 fuente
- AmberTrace Labs mide la fidelidad del razonamiento de Olmo 3 bajo RL con recompensa verificable — en las sondas excluidas del entrenamiento, la fidelidad aumenta de 0,238 a 0,262: una deriva positiva, no una erosión, con checkpoints publicados. 🔗 fuente
- Together AI afirma tener el mejor tiempo hasta el primer token en DeepSeek V4.1 Flash — la empresa difunde la medición de un tercero para solicitudes precalentadas, sin publicar ni el método ni el valor: una afirmación, no un resultado verificable. 🔗 fuente
- Google Flow acompaña a dos creadores en la Semana de la Moda de Nueva York — herramientas a medida diseñadas con Jane Wade y Sergio Hudson; escaparate de uso, sin ningún modelo nuevo ni funcionalidad desplegada. 🔗 fuente
- La Google AI Educator Series permite obtener créditos universitarios — los cursos de la formación ahora permiten obtener créditos universitarios o de formación continua. 🔗 fuente
Qué significa
La jornada deja clara ante todo una cosa: los agentes de código dejan de ser productos cerrados y empiezan a compartir sus formatos. Claude Code lee AGENTS.md cuando un proyecto no tiene CLAUDE.md; es decir, Anthropic acepta un archivo de instrucciones definido en otro lugar para que un mismo repositorio pueda servir a varias herramientas. Ese mismo día, Antigravity incorpora al prompt del sistema de sus agentes Markdown el catálogo de subagentes disponibles, Vibe CLI consigue por fin que los hooks se ejecuten dentro de los subagentes, Codex desglosa su factura por subagente y Qwen Code coloca los suyos en contenedores. La delegación entre agentes era una promesa de configuración; se está convirtiendo en un mecanismo que hay que documentar, aislar y facturar. Claude Code lleva incluso hasta el final esta lógica de desconfianza al marcar los resultados de los subagentes con un encabezado específico, para que un texto devuelto no pueda hacerse pasar por una instrucción.
Por su parte, el mercado de los agentes de terminal se está normalizando a ojos vista. MiniMax publica el suyo con licencia MIT, TUI, modo sin interfaz, ACP y libre elección del modelo; Mistral retira la etiqueta «experimental» de su Unified Harness y documenta --legacy-harness como vía de escape; Kimi Code publica una corrección de rendimiento 32 horas después de su versión principal. Cuando cuatro empresas ofrecen el mismo objeto con los mismos puntos de entrada, la diferenciación se desplaza: depende de la licencia, de la estabilidad del harness y del régimen de permisos, y precisamente ahí se concentran los cambios del día, tanto en Mistral como en Anthropic.
En cuanto a los modelos, el movimiento apunta hacia un audio y un vídeo que se vuelven agénticos en lugar de descriptivos. Qwen3.8-Omni-Flash ya no intenta describir un vídeo, sino encontrar en él una respuesta: partiendo de la pregunta, gana 4,4 puntos en OmniVideoBench y consume un 45,7 % menos de tokens; el rendimiento y el ahorro avanzan en la misma dirección, algo poco habitual. En el otro extremo, Grok Voice Transcribe 2.0 no apuesta por una demostración de laboratorio, sino por el tráfico real, con una tasa de error en frases cortas que baja del 20,6 % al 6,8 % y un precio sin cambios. Ambos anuncios convergen: el valor ya no procede de la modalidad compatible, sino de lo que el modelo decide procesar.
Queda la cuestión de qué están dispuestos a someter a verificación los laboratorios. Anthropic paga a Accenture para instalar evaluadores dentro de su propia empresa, con acceso de empleado, y reconoce en el mismo anuncio que no existe ninguna norma sobre a qué debería acceder un evaluador de este tipo, cómo deberían publicarse sus conclusiones ni quién debería financiarlo. Es tanto una confesión como un mecanismo. A su lado, las pruebas más sólidas del día son las que un tercero puede reproducir: los resultados de Exeter y del Stowers Institute sobre AlphaGenome Atlas, el código de optimización biomolecular publicado como open source y los checkpoints de AmberTrace Labs. Y lo contrario resulta igual de visible: Replit presenta un factor de 30 sin referencias, Together AI difunde una clasificación sin método y Mistral desmiente una acusación que nadie ha podido leer. En este panorama, AIPerf llega en el momento oportuno: una herramienta de medición que empieza por admitir que quien mide suele ser el problema.
Fuentes
- Claude Code, notas de la versión 2.1.277
- CHANGELOG de Claude Code
- Qwen, publicación sobre Qwen3.8-Omni-Flash
- Alibaba Qwen en X, anuncio del modelo
- Codex CLI, notas de la versión 0.155.0
- OpenAI Developers en X, el consumo detallado en Codex
- SpaceXAI, Grok Voice Transcribe 2.0
- Anthropic, evaluación integrada con Accenture
- Changelog de Antigravity
- GitHub, resumen semanal de Copilot del 14 de septiembre
- GitHub, retirada de seis modelos de Copilot
- GitHub, personalizaciones agénticas de CLI en la API de métricas
- MiniMax en X, publicación del código de MiniMax Code CLI
- Vibe CLI, notas de la versión 2.25.5
- OpenAI Developers en X, los plugins multicuenta
- Max Stoiber en X, el mensaje original sobre las cuentas múltiples
- Genspark en X, el saldo semanal Plus y Pro
- Google DeepMind en X, los resultados de los socios de AlphaGenome Atlas
- Google Research, contenidos interactivos educativos mediante una interfaz generativa
- Anthropic Research, Claude y el modelado biomolecular
- Meta AI en X, Muse para Mac
- Sakana AI, el Frontier Intelligence Group
- Runway, los precios unificados
- Pika en X, lanzamiento de Product Ad
- NVIDIA, medición de la inferencia a gran escala con AIPerf
- Mistral AI en X, desmentido del 18 de septiembre