ai-powered-markdown-translatorArticolo tradotto dal francese all’italiano con gpt-5.6-sol.
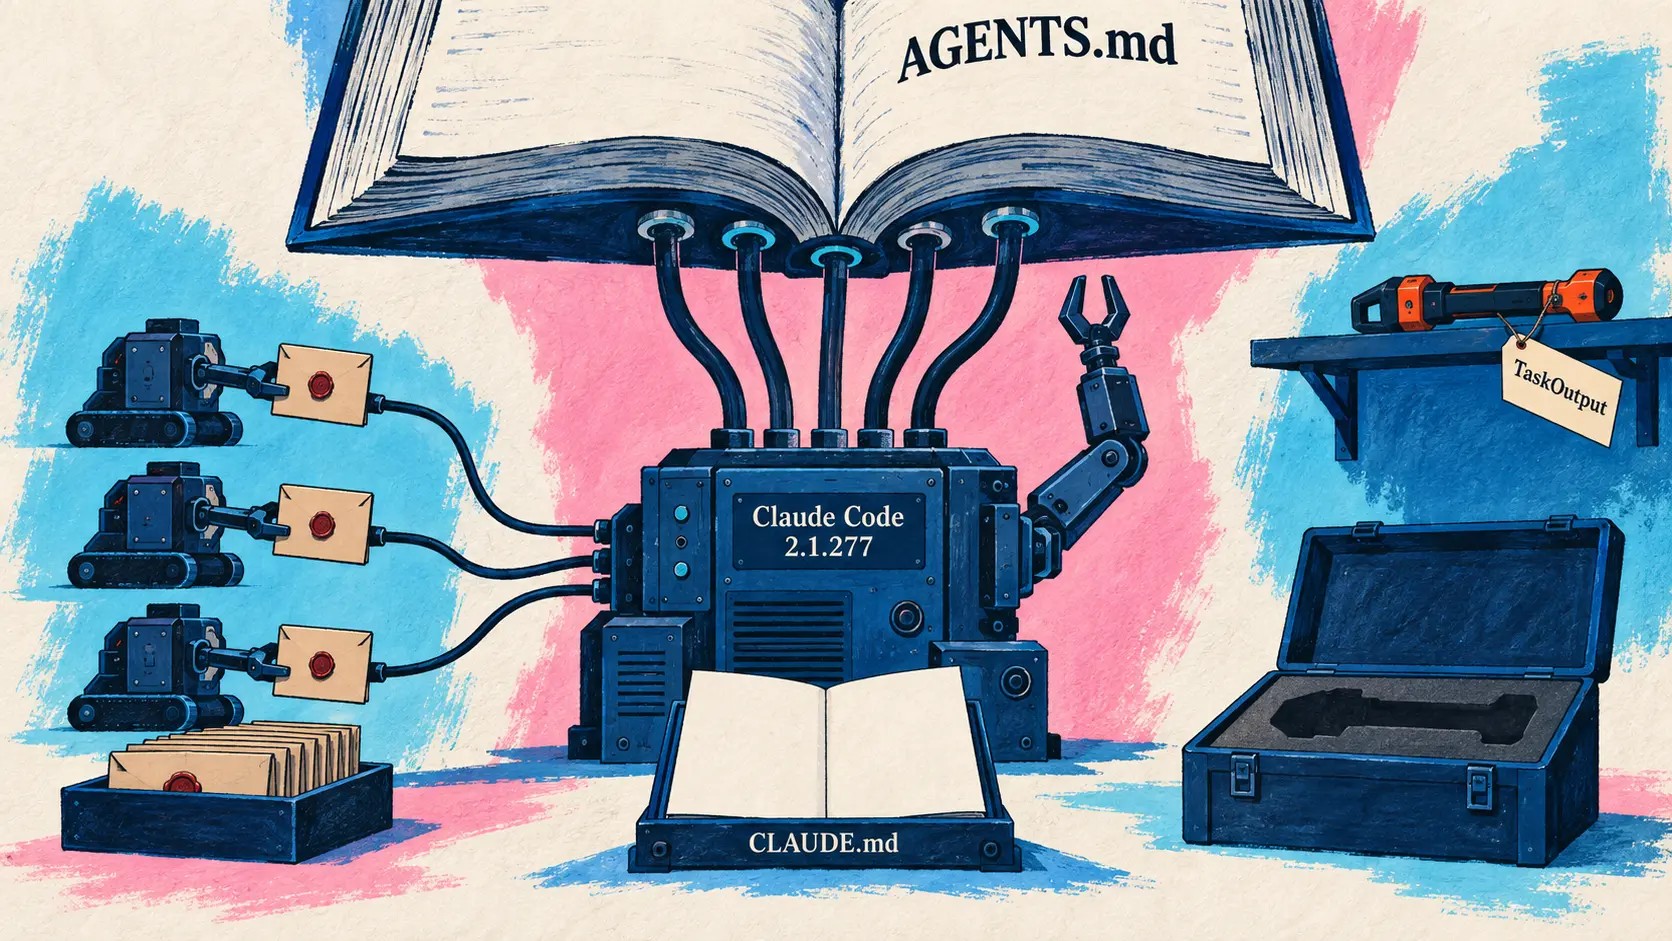
Questo venerdì, gli strumenti per agenti convergono verso formati condivisi: Claude Code ora legge AGENTS.md quando un progetto non contiene CLAUDE.md, Antigravity inserisce il catalogo dei sotto-agenti nel prompt di sistema dei propri agenti Markdown, Codex descrive nel dettaglio il consumo per sotto-agente e MiniMax rende open source il codice del proprio agente da terminale. Il resto della giornata si concentra su due modelli appena presentati — Qwen3.8-Omni-Flash e Grok Voice Transcribe 2.0 — e su una partnership insolita: Anthropic integra valutatori di Accenture all’interno della propria azienda.
Claude Code legge AGENTS.md, isola i sotto-agenti e rimuove TaskOutput
18 settembre — In venti ore si sono succedute tre versioni di Claude Code: la 2.1.275 il 17 settembre alle 22:33 UTC, la 2.1.276 il 18 alle 02:12 UTC e la 2.1.277 il 18 alle 18:06 UTC.
La novità più strutturale è racchiusa in una riga della versione 2.1.277. In un progetto privo di CLAUDE.md, Claude Code legge AGENTS.md, il file di istruzioni diventato una convenzione condivisa da diversi agenti di coding sul mercato. L’impostazione può essere modificata in /config, alla voce «Project instructions». La funzionalità non è ancora disponibile su Bedrock, Vertex o Foundry.
Added AGENTS.md support: in a project with no CLAUDE.md, Claude Code reads AGENTS.md instead; change it under “Project instructions” in /config (not yet on Bedrock, Vertex or Foundry)
🇮🇹 Aggiunto il supporto per AGENTS.md: in un progetto senza CLAUDE.md, Claude Code legge AGENTS.md al suo posto; l’impostazione può essere modificata alla voce «Project instructions» in /config (non ancora disponibile su Bedrock, Vertex o Foundry). — CHANGELOG di Claude Code, anthropics/claude-code
Altri due cambiamenti della stessa versione riguardano la sicurezza del contesto. I risultati dei sotto-agenti vengono restituiti all’agente principale sotto un’intestazione che li identifica come tali, affinché un testo restituito da un sotto-agente non possa essere scambiato per un’istruzione della sessione; inoltre, i caratteri Unicode invisibili di formattazione vengono rimossi dai prompt e la versione ripulita viene mostrata prima dell’invio. La versione 2.1.277 elimina anche lo strumento deprecato TaskOutput: Claude ora legge il file di output di un’attività in background tramite Read.
La versione 2.1.275 aggiunge un tasto per l’invio immediato (ctrl+enter), che interrompe il turno in corso e invia in una volta sola tutti i messaggi in coda, nonché la sincronizzazione con il terminale delle skill e dei plugin attivati sull’account claude.ai. Sul fronte della supply chain, i plugin provenienti da npm vengono recuperati tramite npm pack --ignore-scripts con verifica dell’integrità, impedendo l’esecuzione degli script di installazione di un pacchetto. La versione 2.1.276, pubblicata meno di quattro ore dopo, corregge soltanto una regressione di questa versione: un errore 400 che faceva fallire tutte le richieste dietro un proxy.
| Numero di versione | Pubblicazione (UTC) | Contenuto principale |
|---|---|---|
| 2.1.275 | 17/09 alle 22:33 | Invio immediato, sincronizzazione delle skill claude.ai, npm --ignore-scripts |
| 2.1.276 | 18/09 alle 02:12 | Unica correzione: errore 400 dietro un proxy |
| 2.1.277 | 18/09 alle 18:06 | Supporto per AGENTS.md, isolamento dei sotto-agenti, rimozione di TaskOutput |
🔗 Note di rilascio della versione 2.1.277
Qwen3.8-Omni-Flash, il primo modello omni-modale agentico di Qwen
18 settembre — Qwen pubblica Qwen3.8-Omni-Flash, presentato come il suo primo modello omni-modale progettato attorno alle capacità agentiche. Il cambiamento annunciato non riguarda più la comprensione dei contenuti multimodali, bensì il loro utilizzo: comprendere il contenuto, pianificare l’attività, eseguirla con degli strumenti e consegnare il risultato. Il modello accetta testo, immagini, audio e video in una finestra di contesto da un milione di token.
Meet Qwen3.8-Omni-Flash, Qwen’s first omni-modal model built around agentic capabilities!
🇮🇹 Ecco Qwen3.8-Omni-Flash, il primo modello omni-modale di Qwen costruito attorno alle capacità agentiche. — @Alibaba_Qwen su X
Nelle 29 valutazioni selezionate da Qwen, il punteggio medio aumenta di oltre il 25% rispetto a Qwen3.5-Omni-Plus, con miglioramenti concentrati sugli agenti audio-video. Il riconoscimento multi-speaker è l’ambito che registra il cambiamento maggiore.
| Valutazione selezionata | Qwen3.8-Omni-Flash | Qwen3.5-Omni-Plus | Gemini 3.8 Flash |
|---|---|---|---|
| WildClawBench-MM | 71,0 | 34,5 | 58,9 |
| UniClawBench | 69,6 | 67,1 | 69,0 |
| AgenticVBench | 36,8 | 14,5 | 45,0 |
| OmniVideoBench | 63,4 | 53,8 | 65,2 |
| StreamingBench | 80,8 | 57,1 | 79,9 |
| AliMeeting DER / cpWER (più basso è migliore) | 3,4 / 17,2 | 88,1 / 89,6 | 72,6 / 53,1 |
L’aspetto più originale è la percezione agentica applicata ai video lunghi. Anziché elaborare una registrazione dall’inizio alla fine, il modello parte dalla domanda posta, decide autonomamente che cosa guardare e ascoltare e individua l’informazione attraverso passaggi successivi dal generale al particolare. Su OmniVideoBench, questa modalità porta l’accuratezza dal 63,4 al 67,8, riducendo al contempo il consumo da 145 736 a 79 117 token per richiesta, ossia circa il 45,7% in meno — una cifra riportata direttamente nel post ufficiale.
Segue l’aspetto tariffario: secondo la metodologia di Qwen, il prezzo per ora di input audio diminuisce di oltre il 98% rispetto a Qwen3.5-Omni-Plus. Contestualmente vengono rese disponibili due componenti open source: Qwen-MM-Plugins, compatibile con gli harness Codex, Claude Code, Qwen Code e Gemini CLI, e Qwen-Live Harness per l’interazione in tempo reale. Una variante Realtime è dedicata all’interazione continua a bassa latenza, con un primo token generato tra 591 e 981 millisecondi.
🔗 Post di Qwen su Qwen3.8-Omni-Flash
Codex CLI 0.155.0 introduce in via sperimentale le conversazioni vocali
17 settembre — OpenAI pubblica Codex CLI 0.155.0, la prima versione stabile dalla 0.154.0 del 10 settembre, installabile tramite npm install -g @openai/codex@0.155.0. È la voce del changelog che mancava all’agente vocale annunciato il giorno precedente su X: la funzionalità si chiama /voice, offre la trascrizione in diretta e i controlli del microfono e rimane sperimentale — disponibile soltanto sulle build supportate (supported builds) e da attivare tramite /experimental.
Il resto della versione è più discreto, ma di utilità più immediata. L’interfaccia nel terminale ottiene riepiloghi del ragionamento in tempo reale nella riga di stato e un timestamp di completamento dopo ogni turno concluso correttamente. La panoramica degli agenti consente di nascondere, archiviare ed eliminare attività, mostrando i dettagli sulla proprietà dei worktree e richiedendo una conferma prima di eliminare i worktree gestiti e puliti. Sui Mac compatibili, le richieste MCP delle sessioni TUI locali possono essere autorizzate tramite Touch ID. Amazon Bedrock può ottenere le proprie credenziali AWS da comandi configurati, con memorizzazione nella cache, rinnovo alla scadenza e ripristino dopo un errore di autenticazione.
Diverse correzioni riguardano la sicurezza: vengono bloccate le evasioni dei processi Windows dalle sandbox WSL limitate, gli snapshot della shell intermediati vengono rafforzati contro l’esposizione delle credenziali e un cambio di account invalida le sessioni di controllo remoto, lo stato WebSocket memorizzato nella cache e i cataloghi dei modelli appartenenti all’identità precedente.
| Novità della versione | Dettaglio |
|---|---|
/voice | Trascrizione in diretta e controlli del microfono, sperimentale tramite /experimental |
| Interfaccia nel terminale | Riepiloghi del ragionamento nella riga di stato, timestamp di fine turno |
| Panoramica degli agenti | Occultamento, archiviazione ed eliminazione delle attività, proprietà dei worktree |
| Touch ID | Autorizzazione delle richieste MCP nelle sessioni locali, sui Mac compatibili |
| Amazon Bedrock | Credenziali AWS ottenute tramite comando, con cache e rinnovo |
🔗 Note di rilascio di Codex CLI 0.155.0
Codex descrive nel dettaglio il consumo per attività, sotto-agente e conversazione
18 settembre — OpenAI Developers annuncia un monitoraggio dettagliato del consumo in Codex: lo strumento mostra come le attività, i sotto-agenti e le singole conversazioni contribuiscano all’utilizzo totale. Le informazioni si trovano nell’applicazione desktop, in Impostazioni e poi in Usage & billing per gli account personali e Business, oppure in Usage per gli account Enterprise idonei; per accedervi è necessario utilizzare la versione più recente. L’annuncio non è accompagnato da alcun post sul blog né da una voce nel changelog.
La granularità è il vero punto centrale. Finora, l’esaurimento di una quota non indicava da dove provenisse il consumo; una ripartizione per sotto-agente consente di sapere quale delega ha un costo maggiore e di riscriverla. È il corrispettivo contabile della diffusione dei sotto-agenti negli harness di coding.
🔗 Annuncio di OpenAI Developers su X
Grok Voice Transcribe 2.0, il riconoscimento vocale di SpaceXAI allo stesso prezzo
18 settembre — SpaceXAI annuncia Grok Voice Transcribe 2.0, il suo nuovo modello di riconoscimento vocale (speech-to-text), descritto come due volte più preciso rispetto alla versione 1.0 allo stesso prezzo. Il modello si basa sull’infrastruttura audio che già alimenta Grok Voice, il quale, secondo l’azienda, gestisce decine di migliaia di chiamate di assistenza clienti al giorno e trascrive milioni di ore di narrazione video.
L’argomento centrale riguarda l’audio reale anziché quello di laboratorio: linee telefoniche instabili, voci sovrapposte, accenti locali, numeri di telefono e indirizzi e-mail pronunciati ad alta voce. SpaceXAI rivendica il primo posto per accuratezza tra 32 modelli in streaming nella classifica pubblica di Artificial Analysis e si basa su quattro dataset interni ricavati dal traffico di produzione — telefonia a 8 kHz, conversazioni con Grok, identificativi dettati e brevi comandi vocali in 19 lingue.
Il miglioramento più evidente riguarda il multilinguismo. Nel dataset di frasi brevi, quelle che offrono meno contesto per identificare la lingua, il tasso di errore per parola scende dal 20,6% al 6,8%. Il modello rileva automaticamente la lingua e segue i cambiamenti durante la registrazione in un unico passaggio.
| Metrica misurata | Valore annunciato |
|---|---|
| Accuratezza dichiarata rispetto a Transcribe 1.0 | due volte superiore |
| Classifica Artificial Analysis (streaming) | 1° su 32 modelli |
| Tasso di errore sulle frasi brevi (1.0 → 2.0) | 20,6% → 6,8% |
| Tariffa per l’elaborazione in batch | 0,10 dollari per ora di audio |
| Tariffa in streaming | 0,20 dollari per ora di audio |
| Canali trascritti separatamente | fino a 8 |
| Termini specialistici per richiesta | fino a 100 |
Il modello gestisce l’elaborazione in batch e lo streaming, i timestamp a livello di parola con punteggio di affidabilità, la separazione degli interlocutori (diarization) senza costi aggiuntivi e il rilevamento della fine del turno di parola. Le integrazioni API esistenti beneficiano del miglioramento dell’accuratezza senza modifiche al codice. Grok Voice Transcribe 2.0 diventerà presto il modello predefinito dell’API e la versione 1.0 verrà deprecata nelle prossime settimane: sarà necessario fissare grok-voice-transcribe-1.0 per continuare a utilizzarla.
🔗 Annuncio di Grok Voice Transcribe 2.0
Anthropic integra valutatori di Accenture all’interno dell’azienda
18 settembre — Anthropic annuncia una partnership con Accenture per la valutazione indipendente dei modelli di frontiera, presentata come un passo importante verso l’impegno assunto dal suo amministratore delegato di accogliere valutatori integrati (embedded). Il lavoro sarà svolto da Faculty, la controllata di Accenture specializzata in IA, e comprenderà la valutazione e il red-teaming dei modelli, le valutazioni di allineamento e i test dei guardrail.
La distinzione rispetto ai valutatori esterni è esplicita: un valutatore integrato lavora all’interno dell’azienda di IA con un livello di accesso paragonabile a quello di un dipendente. Può osservare i modelli durante l’addestramento, seguire le decisioni che ne governano la costruzione e l’implementazione, parlare direttamente con i dipendenti, verificare il rispetto degli impegni di sicurezza, segnalare incidenti e pubblicare una descrizione più informata dei benefici e dei rischi. Anthropic precisa che il sistema non riduce la propria responsabilità, ma la rende più verificabile.
L’annuncio è insolitamente franco su ciò che ancora non esiste. Non vi è alcuno standard sulle informazioni a cui un valutatore integrato dovrebbe avere accesso, né sul modo in cui dovrebbe pubblicare le proprie conclusioni, né esiste un sistema consolidato per finanziare la valutazione indipendente. Anthropic ritiene che in futuro tali finanziamenti dovrebbero provenire da fondi comuni o pubblici; in assenza oggi di un simile meccanismo, finanzia direttamente il lavoro di Accenture — il limite più evidente dell’accordo.
| Elemento della partnership | Valore annunciato |
|---|---|
| Entità operativa | Faculty, controllata IA di Accenture |
| Investimento | Almeno 1 miliardo di dollari per parte, nell’arco di cinque anni |
| Ambito coperto | Valutazione, red-teaming, allineamento, guardrail |
| Livello di accesso | Paragonabile a quello di un dipendente |
| Finanziamento | Diretto da parte di Anthropic, in assenza di fondi comuni |
| Esclusività | Nessuna, da entrambe le parti |
Anthropic riferisce inoltre di essere in trattativa con METR e altri valutatori non profit per sperimentare alcuni elementi della valutazione integrata con finanziamenti propri e annuncia altri partner nelle prossime settimane.
🔗 Annuncio di Anthropic sulla valutazione integrata
Antigravity: tre versioni in due giorni sugli agenti personalizzati
Google ha pubblicato in rapida successione due versioni della sua CLI e una versione dell’applicazione Antigravity. Tutte e tre affrontano lo stesso argomento da tre prospettive: ciò che un agente personalizzato sa, ciò che può rifiutare e fino a che punto può funzionare senza supervisione. Proseguono una fitta serie iniziata l’11 settembre, le cui versioni dalla 1.2.1 alla 1.2.4 non sono riportate qui.
La CLI 1.2.6 introduce un Remote Control legato alla sessione ed elimina il limite di cinque minuti
18 settembre — Otto giorni dopo la 1.2.0, che trasformava la CLI in un servizio di sistema persistente, Google prende la direzione opposta con una seconda forma di Remote Control, molto più leggera: una connessione limitata alla sessione (session-scoped), aperta tramite il flag --remote-control all’avvio o con il comando /remote-control durante l’esecuzione. Digitare /remote-control off o chiudere la sessione smantella il tunnel e rimuove il dispositivo dall’elenco. Mentre la 1.2.0 puntava a un daemon che sopravvive alla sessione, la 1.2.6 mira all’opposto.
La seconda modifica riguarda la modalità senza interfaccia (headless): il timeout predefinito delle esecuzioni -p / --prompt passa da cinque minuti a illimitato, salvo un --print-timeout esplicito. La terza struttura la segnalazione degli errori: in caso di errore dell’agente o dell’API, la CLI scrive sullo standard error una riga JSON AGY_ERROR: {...} contenente lo stato canonico, il codice HTTP o gRPC, l’indicazione se l’operazione può essere ritentata e un identificatore di errore, con un codice di uscita che passa da 1 a 3. Uno script di orchestrazione può quindi distinguere un’interruzione temporanea della rete da un errore definitivo senza analizzare testo libero.
La CLI 1.2.5 fornisce finalmente agli agenti Markdown l’elenco dei loro sottoagenti
17 settembre — Finora, un agente personalizzato definito in Markdown poteva dichiarare invoke_subagent tra i propri strumenti senza sapere quali sottoagenti esistessero: disponeva dello strumento, ma non dell’elenco. La CLI ora aggiunge automaticamente al suo prompt di sistema il catalogo dei sottoagenti disponibili e le relative istruzioni per l’uso, rendendo effettiva la delega.
Il vocabolario del changelog richiede una precisazione: si tratta di un’aggiunta di contesto da parte del prodotto stesso, non di una vulnerabilità di sicurezza né di una correzione. Il secondo miglioramento conserva il nome esplicito di un’attività inviata in background, che andava perso tra le notifiche e gli elenchi delle attività. Le cinque correzioni riguardano l’eliminazione degli identificatori invalidati, i codici di uscita dei comandi interrotti e i riquadri di ragionamento che rimanevano bloccati.
Antigravity 2.15.0 consente agli agenti personalizzati di disattivare prompt e strumenti predefiniti
18 settembre — Tre giorni dopo la 2.14.0, l’applicazione pubblica 7 miglioramenti e 16 correzioni. La modifica principale offre agli agenti personalizzati il controllo sul proprio contesto: possono disattivare le sezioni predefinite del prompt e gli strumenti predefiniti, per poi reintrodurre soltanto quelli di cui hanno bisogno. Per un agente specializzato, ciò riduce in misura corrispondente il prompt di sistema imposto.
Il resto riguarda la navigazione e la persistenza: Page Up, Page Down, Home ed End fanno scorrere una conversazione, Esc sposta il focus fuori dall’area di immissione e l’agente personalizzato selezionato viene memorizzato dopo un ricaricamento. Due correzioni interessano l’integrità dei dati: le impostazioni salvate e l’elenco dei progetti potevano essere sovrascritti quando l’applicazione non riusciva a leggere il proprio file di stato, mentre nelle impostazioni dei permessi si accumulavano duplicati che facevano aumentare le dimensioni dei file delle conversazioni.
GitHub Copilot: un canvas Sentry, sei modelli ritirati e metriche per personalizzazione
Tre voci del changelog in due giorni delineano la stessa preoccupazione: misurare ciò che i team fanno realmente con Copilot ed eliminare ciò che non usano più.
Il riepilogo del 14 settembre mette in evidenza due nuovi elementi
18 settembre — GitHub pubblica il suo riepilogo settimanale di Copilot per la settimana del 14 settembre. Gran parte del sommario riprende voci già apparse nel changelog; soltanto due elementi non erano mai stati annunciati separatamente. Il primo è il canvas Sentry nell’applicazione Copilot, che collega una segnalazione di arresto anomalo in produzione a una correzione senza uscire dall’applicazione: mostra gli errori, gli stack trace (stack traces) e il contesto, quindi permette di indagare sulla causa, convalidare una correzione e preparare una pull request. È la prima integrazione di uno strumento di monitoraggio degli errori nei canvas, dopo Jira all’inizio di settembre.
Il secondo è l’ondata di funzionalità per gli agenti di VS Code 1.138. La finestra Agents può eseguire un agente in un Dev Container locale, con gli strumenti e le dipendenze del progetto: distribuzione progressiva, Docker obbligatorio. Le sessioni inattive possono essere contrassegnate automaticamente come completate dopo l’unione di tutte le loro pull request, con eliminazione facoltativa dopo un periodo di tolleranza; la funzione è in anteprima e deve essere attivata esplicitamente. Infine, è possibile creare una pull request direttamente da una sessione Agent Host.
🔗 Riepilogo settimanale di Copilot
Sei modelli lasceranno tutte le superfici di Copilot il 19 ottobre
18 settembre — GitHub annuncia il ritiro di sei modelli da tutte le superfici di Copilot — Copilot Chat, modifiche inline, modalità ask e agent, completamenti del codice — il 19 ottobre 2026. È la seconda ondata di deprecazioni annunciata a settembre.
| Modello ritirato | Data del ritiro | Alternativa suggerita |
|---|---|---|
| Gemini 3.7 Flash | 19/10/2026 | Gemini 3.8 Flash |
| GPT-5.5 | 19/10/2026 | GPT-5.6 Sol |
| GPT-5.4 | 19/10/2026 | GPT-5.6 Sol |
| GPT-5.4 mini | 19/10/2026 | GPT-5.6 Luna |
| GPT-5 mini | 19/10/2026 | GPT-5.6 Luna |
| Grok 4.5 | 19/10/2026 | Grok 4.6 |
Con l’attivazione predefinita dei modelli, le alternative vengono attivate automaticamente per i clienti Copilot Enterprise e Business, a meno che un amministratore non abbia disattivato l’impostazione predefinita globale o bloccato esplicitamente il modello interessato; in tal caso, l’accesso può essere riabilitato tramite i criteri dei modelli nelle impostazioni. Non è richiesta alcuna azione per rimuovere i modelli.
🔗 Annuncio della deprecazione dei modelli Copilot
L’API delle metriche conta skills, agenti, server MCP e plugin della CLI
17 settembre — L’API delle metriche di utilizzo di Copilot ora copre cinque famiglie di personalizzazioni agentiche della CLI: skills, agenti personalizzati, server MCP, slash commands e plugin. Le tabelle totals_by_skill, totals_by_custom_agent, totals_by_mcp, totals_by_slash_cmd e totals_by_plugin elencano i cinque elementi più attivi con il relativo interaction_count, mentre i campi distinct_*_use_count conteggiano la varietà degli elementi utilizzati oltre questi primi cinque.
Due sottigliezze evitano interpretazioni errate. Per i server MCP, il contatore aumenta soltanto quando la CLI tenta di connettersi o riconnettersi — con successo o meno — e non a ogni chiamata a uno strumento su una connessione stabilita. Le metriche dei plugin conteggiano soltanto le invocazioni di skills associate a un plugin: costituiscono un sottoinsieme dei totali delle skills e non devono essere sommate a questi ultimi. Per motivi di riservatezza, vengono visualizzati soltanto i nomi forniti da GitHub, mentre quelli definiti dai clienti sono raggruppati sotto other.
🔗 Personalizzazioni agentiche della CLI nell’API delle metriche
Gli agenti di codice nel terminale: MiniMax apre il proprio, Mistral stabilizza il suo harness
Due annunci provenienti da due soggetti indipendenti, nello stesso giorno e sullo stesso mercato: l’agente di coding che vive in un terminale diventa sempre più comune e la differenziazione si sposta verso la licenza e la stabilità dell’harness.
MiniMax pubblica il codice di MiniMax Code CLI con licenza MIT
18 settembre — MiniMax rende open source il proprio agente di coding nel terminale con la versione 0.4.12. Lo strumento si installa con il nome mcode e offre tre punti di accesso: un’interfaccia terminale interattiva, una modalità senza interfaccia (mcode exec) destinata agli script shell, all’integrazione continua e alle valutazioni, e una modalità ACP per gli editor compatibili con l’Agent Client Protocol. Legge i file di un progetto, esamina le differenze, esegue comandi shell e test, nell’ambito di un sistema di permessi e sandboxing.
La scelta del modello rimane aperta: da un lato l’account MiniMax e il relativo Token Plan, dall’altro un fornitore terzo, purché esponga un formato API compatibile con OpenAI o Anthropic. Si aggiungono una ricerca integrata, strumenti multimodali, il protocollo MCP, sottoagenti e un sistema di plugin. Il codice originale è pubblicato per impostazione predefinita con licenza MIT. Il repository comprende la TUI, la CLI senza interfaccia e la modalità ACP, ma non l’applicazione desktop, della quale ospita comunque il tracciamento dei problemi; per il momento, le proposte di codice sono accettate soltanto dai collaboratori del repository.
Lo Unified Harness di Vibe CLI abbandona lo stato sperimentale
18 settembre — Mistral pubblica Vibe CLI 2.25.5, sei giorni dopo la 2.25.4. La modifica strutturale è riassunta in una riga delle note di rilascio: lo Unified Harness non è più etichettato come «experimental» e ora è --legacy-harness a fungere da via di ripiego documentata verso il vecchio harness Python. Dopo una serie di versioni correttive incentrate sulla sicurezza delle approvazioni shell, il nuovo harness diventa ufficialmente quello predefinito: è questa la notizia, non il numero di versione.
Il passaggio è accompagnato da un recupero della parità funzionale: lo Unified Harness ora inserisce nelle istruzioni di sistema il branch Git corrente, lo stato del repository e i commit recenti; gli hook vengono finalmente eseguiti all’interno dei sottoagenti anziché essere ignorati silenziosamente; inoltre, i fornitori configurati senza una variabile d’ambiente per la chiave API — server locali o self-hosted — funzionano di nuovo. Prosegue l’irrobustimento dei permessi: le approvazioni shell non si estendono più a un altro programma o ambiente, le chiamate agli strumenti MCP ora rispettano il sistema dei permessi anziché aggirarlo e lo smart approve smette di eludere le regole dell’utente.
🔗 Note di rilascio di Vibe CLI 2.25.5
I plugin di ChatGPT accettano più account contemporaneamente
18 settembre — Il supporto per più account arriva sulla maggior parte dei plugin di ChatGPT. Diventa possibile collegare il proprio account personale, quello professionale e quelli dei progetti secondari, per poi importare il contesto di ciascuno nella stessa conversazione. Gli account si collegano dalla directory dei plugin, su chatgpt.com/plugins.
L’annuncio dell’account OpenAI Developers riprende un messaggio di Max Stoiber pubblicato un’ora prima. Per gli sviluppatori di plugin non c’è nulla da fare: la funzionalità si attiva automaticamente, senza modifiche. Chi vuole andare oltre può aggiungere uno strumento profile al proprio server MCP, affinché ChatGPT sappia etichettare gli account collegati: è l’unica azione concreta richiesta. Nessun articolo di blog né voce del changelog accompagna l’annuncio, pubblicato alle 18:10, ora di Parigi.
Il caso d’uso previsto è quello di uno sviluppatore che separa le proprie identità per datore di lavoro o progetto e che finora doveva cambiare accesso per cambiare contesto.
🔗 Annuncio degli account multipli su X
🔗 Il messaggio originale di Max Stoiber
Genspark aggiunge un saldo settimanale di crediti ai piani Plus e Pro
18 settembre — Genspark modifica i vantaggi dei propri abbonamenti Plus e Pro aggiungendo un saldo settimanale di crediti, senza cambiare il prezzo dei piani. Questo saldo viene erogato ogni settimana in aggiunta al piano già sottoscritto e copre l’utilizzo in modalità Standard di tutti gli agenti e strumenti della piattaforma: Super Agent, AI Chat, AI Image, AI Slides, AI Sheets, AI Docs e Deep Research.
Un secondo messaggio dello stesso thread descrive in dettaglio il funzionamento per AI Chat e AI Image. Per gli abbonati esistenti, il saldo si aggiunge a quanto già disponibile e, fino al 31 dicembre 2026, tutti i modelli di AI Chat e AI Image possono essere utilizzati senza costi in crediti, compresi i modelli di punta come Opus; per chi si abbona a partire dal 18 settembre, i modelli di base (core models) di AI Chat e AI Image sono gratuiti. Genspark precisa che queste modifiche non si applicano né ai piani Team né ai piani Enterprise e rimanda al proprio centro assistenza per i dettagli delle condizioni.
Google Research: ciò che ha prodotto AlphaGenome Atlas e simulazioni che si mettono alla prova da sole
Due pubblicazioni di ricerca nello stesso giorno, con un punto in comune: in entrambi i casi, ciò che viene mostrato non è il modello, ma ciò che ne hanno ricavato soggetti terzi o ciò che il ciclo di convalida verifica al suo posto.
AlphaGenome Atlas presenta i primi risultati dei suoi partner
17 settembre — Nove giorni dopo la pubblicazione di AlphaGenome Atlas, la mappa predittiva dei 9 miliardi di possibili sostituzioni del DNA umano, Google DeepMind mette in evidenza un thread che descrive in dettaglio tre collaborazioni.
| Partner scientifico | Risultato riportato |
|---|---|
| Stowers Institute | Oltre 2.500 motivi regolatori mappati |
| Università di Exeter / UK Biobank | Oltre 54.000 partecipanti analizzati, oltre il 22% in più di rilevamento dei segnali genetici rari |
| Broad Institute | Mutazione critica del gene DNM1 identificata, quindi confermata e convalidata in laboratorio |
I motivi regolatori sono sequenze di DNA che agiscono come interruttori e potenziometri sull’attività dei geni. Il lavoro condotto a Exeter ha inoltre identificato nuove varianti che influenzano l’abbondanza di PLA2G7, una proteina associata alla salute metabolica. Il caso del Broad Institute è il più concreto dei tre: di fronte a un elenco immenso di possibili mutazioni nelle malattie rare non diagnosticate, Atlas serve a individuare quella corretta, che viene poi confermata in laboratorio. Il tutto è tuttavia contenuto in un thread su X, senza un articolo dettagliato né una pubblicazione associata.
🔗 Thread su AlphaGenome Atlas su X
Simulazioni didattiche generate, poi testate da un agente in Chrome
17 settembre — Gal Elidan e Yael Haramaty pubblicano un esperimento che applica l’interfaccia generativa (generative UI) alla creazione di simulazioni didattiche. L’insegnante mantiene l’iniziativa: propone l’argomento, Google genera una serie di obiettivi di apprendimento modificabili e sottoposti alla sua approvazione, che fungono da base per la generazione. Ogni esperienza interattiva è suddivisa in livelli di difficoltà crescente, con strumenti, suggerimenti progressivi e soluzioni dettagliate.
L’elemento più interessante è il ciclo di autocorrezione. La generazione è controllata in base a criteri didattici, meccanici e di presentazione, e alcune valutazioni sono agentiche: il test di risolvibilità apre un’istanza di Chrome e manipola la simulazione come farebbe un utente, tentando anche azioni avversarie come spingere i cursori ai loro valori estremi. Il ciclo si ripete finché tutti i criteri non sono soddisfatti, al prezzo di un tempo di generazione più lungo. Google pubblica più di 30 esperienze interattive STEM in inglese; una raccolta di 40 è stata valutata da insegnanti britannici e uno studio condotto su 12 insegnanti statunitensi ha ottenuto un punteggio medio di 8 su 10.
🔗 Articolo di Google Research sulle esperienze didattiche interattive
Claude accelera più di 30 modelli biologici e finanzia una competizione sulle proteine
17 settembre — Anthropic pubblica un articolo che descrive come Claude abbia ottimizzato l’inferenza di più di 30 modelli open source utilizzati dai biologi — previsione della struttura, design di proteine, modelli linguistici proteici e genomici — in poco meno di quattro settimane, con un miglioramento medio di circa 4x. Tutto il codice è pubblicato in open source.
Il nucleo tecnico riguarda l’attenzione triangolare e la moltiplicazione triangolare, cubiche sia nel tempo sia nella memoria. Claude ha prodotto FlashPairformer, una serie di kernel che supera lo standard del settore da 2,7 a 2,9x nell’attenzione. Una modalità a memoria ridotta denominata «Big» consente di ripiegare con precisione sistemi di oltre 10.000 token su un singolo nodo GPU, mentre il ribosoma 40S previsto da AlphaFold3 contava 7.663 token. L’aspetto metodologico è altrettanto importante: il lavoro è stato supervisionato da due membri dello staff tecnico privi di precedente esperienza nell’ottimizzazione dell’inferenza.
Anthropic, infine, co-sponsorizza con Adaptyv Bio una competizione di design di proteine su cinque problemi difficili, con oltre 5.000 design della comunità convalidati sperimentalmente, fino a 1 milione di dollari in crediti Claude e 250.000 dollari di capacità di calcolo fornita da Modal.
🔗 Articolo di ricerca di Anthropic
Modelli aperti e laboratori: Muse arriva su Mac, Sakana presenta il suo gruppo di frontiera
Meta porta il suo agente Muse su macOS
18 settembre — Meta distribuisce Muse su Mac, annunciato nella notte tra il 17 e il 18 settembre. L’account @AIatMeta rilancia una pubblicazione che descrive un agente personale capace di agire direttamente sul computer dell’utente, ogni volta con il suo consenso esplicito. Vengono citati tre utilizzi: riordinare la cartella dei download, ritrovare un file smarrito, riassumere messaggi e note.
L’annuncio amplia il lancio di Muse dell’8 settembre, agente basato su Muse Spark 1.3 e fino a quel momento disponibile su iOS, Android, web e WhatsApp. Il passaggio al Mac segna un nuovo traguardo per questo tipo di prodotto: l’agente non lavora più nel proprio ambiente isolato, ma sui file personali dell’utente. Meta non comunica né il prezzo, né i Paesi in cui sarà disponibile, né la configurazione richiesta, e la distribuzione non è accompagnata da alcun documento di sicurezza specifico per Mac — il blog ai.meta.com non pubblica nulla dal 27 luglio.
Sakana AI presenta il Frontier Intelligence Group e la sua posizione sul paradigma
18 settembre — Sakana AI annuncia l’esistenza del Frontier Intelligence Group (FIG), un collettivo interno cresciuto fin dagli esordi dell’azienda. Il punto di partenza è una domanda posta da Llion Jones, direttore tecnico di Sakana AI e uno degli inventori del Transformer: ampliare l’architettura Transformer con quantità sempre maggiori di dati e capacità di calcolo è sufficiente per arrivare fino all’AGI? La risposta del laboratorio è no.
È qui che risiede l’informazione, più che nel catalogo di lavori che l’accompagna. L’articolo elenca i problemi che il paradigma attuale non ha risolto — modelli che producono con sicurezza informazioni false, crollano di fronte a situazioni realmente nuove e consumano molta energia — e vi contrappone l’intelligenza biologica, che apprende continuamente e generalizza a partire da una quantità di dati molto inferiore. Il gruppo si dà cinque principi, tra cui la libertà di fallire senza pressioni sui punteggi dei benchmark. Tra i lavori presentati, i Transformer sparsi sviluppati con NVIDIA partono da un dato misurato — oltre il 95% dei neuroni di un livello feed-forward rimane inattivo durante l’elaborazione di una parola — e hanno prodotto un formato di dati denominato TwELL, accettato all’ICML 2026.
🔗 Articolo di Sakana AI sul Frontier Intelligence Group
Video generativi: Runway rende intercambiabili i suoi crediti, Pika lancia la sua prima applicazione
Runway rende i suoi crediti fungibili tra l’applicazione web e Runway Dev
18 settembre — Runway abbatte la barriera tra i suoi due prodotti: i crediti acquistati possono essere utilizzati indistintamente nell’applicazione web e in Runway Dev, l’offerta destinata agli sviluppatori. Finora i due ambienti disponevano di riserve separate, contratti distinti e nessun luogo unico in cui monitorare i consumi da un progetto all’altro.
Il cambiamento è accompagnato da quattro elementi: una riserva unica acquistata centralmente con una sola fattura, un percorso continuo tra la creazione di una sequenza nell’applicazione web e la sua esposizione tramite API, un supporto potenziato per Runway Dev con accesso agli Applied AI Architects e una visualizzazione analitica dell’area di lavoro riprogettata, che consente agli amministratori di trasferire i crediti tra gli spazi web e Dev. Due offerte commerciali sono valide fino al 31 dicembre 2026: il 10% di crediti aggiuntivi alla firma per le nuove aziende, equivalenti ad almeno 130 minuti di video o 12.000 immagini secondo la conversione comunicata da Runway, e, per i clienti esistenti, 5.000 crediti più una giornata con un Applied AI Architect in cambio di una presentazione al responsabile di prodotto delle applicazioni IA.
🔗 Articolo di Runway sulla tariffazione unificata
Pika lancia Product Ad, dalla foto del prodotto alla pubblicità video
18 settembre — Il giorno dopo la presentazione della sua nuova piattaforma creativa, Pika ne distribuisce la prima applicazione: Product Ad. L’applicazione acquisisce una o più immagini del prodotto, le combina con un brief scritto e ne ricava un video presentato come pronto per il mercato.
| Parametro di generazione | Valore proposto |
|---|---|
| Durate disponibili | 6 s, 15 s, 30 s, 60 s, 2 min |
| Formato di output | 16:9 |
| Input richiesto | immagini del prodotto e brief scritto |
| Accesso | creazione di un account obbligatoria |
Pika pubblica l’annuncio citando il proprio messaggio del giorno precedente sulla riprogettazione della piattaforma, collocando così Product Ad in una serie di applicazioni previste anziché presentarlo come una funzionalità isolata. Non viene indicato alcun modello né comunicato alcun prezzo.
NVIDIA pubblica AIPerf, successore di GenAI-Perf per misurare l’inferenza su larga scala
18 settembre — NVIDIA presenta AIPerf, il suo strumento di misurazione delle prestazioni per l’inferenza generativa, definito come il successore di GenAI-Perf e riscritto da zero. Il punto di partenza è noto: una volta distribuito un modello, alla domanda «è veloce?» si risponde spesso con comandi curl o con un generatore di carico improvvisato, che producono numeri inaffidabili.
La svolta è architetturale. Mentre la maggior parte degli strumenti viene eseguita in un singolo processo e si scontra con il global interpreter lock di Python quando aumenta la concorrenza, AIPerf distribuisce il lavoro: processi worker generano il carico, servizi distinti elaborano i risultati e il tutto è coordinato tramite ZMQ. L’obiettivo è esplicito: impedire che il client di misurazione diventi esso stesso il collo di bottiglia.
| Indicatore riportato | Che cosa misura |
|---|---|
| Time to First Token | Ritardo tra l’invio della richiesta e il primo token |
| Inter-Token Latency | Ritardo tra due token consecutivi durante la generazione |
| Latenza della richiesta | Tempo end-to-end della risposta completa |
| Throughput dei token in output | Token prodotti al secondo su tutte le richieste |
| Percentili riportati | p25, p50, p75, p90, p95, p99 |
| Tipi di endpoint | più di 15 |
Lo strumento è inoltre in grado di riprodurre tracce di traffico reale nei formati Mooncake, Baseten e WEKA. L’articolo insiste soprattutto sull’utilità delle distribuzioni: un server il cui tempo medio fino al primo token sembra adeguato, ma il cui p99 aumenta vertiginosamente, passa inosservato nei dati aggregati e fallisce in produzione.
🔗 Articolo di NVIDIA su AIPerf
Mistral smentisce una rivendicazione di accesso non autorizzato ai suoi sistemi
18 settembre — Mistral pubblica alle 05:48 UTC un breve comunicato sul proprio account X, in risposta a una rivendicazione di accesso non autorizzato ai suoi sistemi. L’azienda afferma di aver condotto un’indagine approfondita, di non aver trovato alcun elemento a sostegno della rivendicazione e conferma che i suoi sistemi non sono stati compromessi.
We are aware of a claim alleging unauthorized access to our systems. Following a thorough investigation, we have found no evidence to support this claim and can confirm that our systems have not been compromised.
🇮🇹 Siamo a conoscenza di un’affermazione secondo cui sarebbe avvenuto un accesso non autorizzato ai nostri sistemi. A seguito di un’indagine approfondita, non abbiamo trovato alcun elemento a sostegno di tale affermazione e possiamo confermare che i nostri sistemi non sono stati compromessi. — @MistralAI su X
Il messaggio non nomina l’autore della rivendicazione, non ne precisa né la data né la natura e non fornisce alcun dettaglio sull’ambito dell’indagine. Qui viene riportata la posizione di Mistral, e soltanto quella: non è stato possibile consultare l’affermazione originale. Il comunicato è il messaggio più visualizzato dell’account nel periodo considerato e sul sito dell’azienda non è stata trovata alcuna pubblicazione aggiuntiva.
In breve
- Balyasny Asset Management racconta come supervisiona Claude Fable 5 — la società, che gestisce circa 38 miliardi di dollari, riduce l’analisi iniziale di un arbitraggio su fusioni da tre-cinque giorni a meno di un giorno, con un agente che opera per circa 30 minuti e una revisione umana. 🔗 fonte
- Codex CLI 0.155.1 disattiva nuovamente per impostazione predefinita i riepiloghi del ragionamento — unica correzione il giorno dopo la 0.155.0: abilitarli automaticamente faceva rifiutare le richieste dai provider che non li supportano. 🔗 fonte
- Gemini CLI riprende la sua serie nightly dopo una giornata senza release — quattro modifiche il 18 settembre, tra cui la conservazione del refresh token OAuth durante un rinnovo e la rimozione degli identificativi resa idempotente; i canali stable e preview restano invariati. 🔗 fonte
- Kimi Code 2.0.1 accelera l’avvio e la ripresa delle sessioni — versione correttiva 32 ore dopo la 2.0.0: compattazione dell’indice delle sessioni, ripresa più rapida per le cronologie lunghe, chiave API leggibile da una variabile d’ambiente denominata e osservatori dei file con limiti definiti. 🔗 fonte
- Qwen Code passa alla preview v0.24.1 con un SDK per browser Playwright — non è una versione stable; introduce il controllo integrato del browser con relay di messaggistica nativa Chrome e l’esecuzione dei sotto-agenti in container. 🔗 fonte
- Zed pubblica la versione stable 1.20.2, con appena due correzioni — gli errori di pagamento dei provider di modelli di terze parti non mostrano più un invito a passare a Zed Pro al posto del messaggio originale e due estensioni di snippet per lo stesso linguaggio non si annullano più a vicenda. 🔗 fonte
- Replit afferma che il Free Mode è «30 volte più» generoso, senza pubblicare riferimenti — un singolo tweet, senza link né changelog, che non specifica rispetto a cosa sia calcolato questo fattore: va considerato un’affermazione di Replit, non una misurazione. 🔗 fonte
- La dashboard sull’impatto di Copilot suddivide il coinvolgimento per funzionalità — sette aree nell’arco di 28 giorni, distinguendo tra revisione del codice attiva e passiva, e una popolazione nella fase di adozione ora calcolata su una finestra mobile. 🔗 fonte
- GitHub programma una diretta introduttiva sull’SDK Copilot, in sei lingue — sessioni, strumenti, server MCP ed eventi in streaming, con sessioni dedicate a .NET e Java, senza prerequisiti. 🔗 fonte
- Runway Ruby preserva il canale alpha durante la conversione in HDR — la conversione di una ripresa in HDR mantiene intatta la trasparenza, in un solo passaggio; non vengono specificati né il prezzo né il piano di abbonamento. 🔗 fonte
- MiniMax entra nel Singtel AI Pass per il programma SkillsFuture di Singapore — MiniMax H3, MiniMax Agent e MiniMax Audio entrano nell’offerta, rivolta agli studenti idonei di oltre 200 corsi di IA sostenuti dalla SWDA; nessun importo né calendario. 🔗 fonte
- VC-Attention accelera l’attention di MiniMax-H3 senza nuovo addestramento — MiniMax rilancia il lavoro di Nunchux AI su un’attention a bassa precisione applicabile al modello esistente; Nunchux AI dichiara prestazioni 1,6 volte superiori su B200 e 1,5 volte superiori su B300 rispetto a FlashAttention-4. 🔗 fonte
- Wan3.0 si classifica secondo nella categoria video dell’OpenArt Arena — Alibaba mette in evidenza le sequenze di 30 secondi, l’audio nativo e il supporto per qualsiasi riferimento; si tratta del posizionamento in una classifica di terze parti, senza novità di prodotto. 🔗 fonte
- Synthesia apre la sua sede statunitense a New York — notizia aziendale senza indicazioni su prodotti, organico o calendario degli investimenti, due giorni dopo la disponibilità generale della sua Interactive Avatar API. 🔗 fonte
- Grok Imagine descrive nel dettaglio il costo di un episodio pilota prodotto interamente con l’IA — lo studio di PJaccetturo dichiara nove giorni di lavoro, 3.627 immagini e 3.043 video generati, per un costo di generazione di 2.677 dollari, per l’episodio pilota del concorso Odissea. 🔗 fonte
- BananaMind 2 Pro si avvicina a SmolLM2 usando venti volte meno token — un modello da 139 milioni di parametri addestrato su 100 miliardi di token e una RTX 5070 Ti raggiunge il 42,78% su HellaSwag, contro il 43,22 di SmolLM2-135M, addestrato su 2.000 miliardi di token. 🔗 fonte
- Optimum-Intel v2.2.0 e OpenVINO GenAI 2026.4.0 ampliano l’esportazione verso l’hardware Intel — Hugging Face e Intel pubblicano versioni congiunte che coprono processori, schede grafiche e NPU Intel, con Mistral 3 ora esportabile. 🔗 fonte
- AmberTrace Labs misura la fedeltà del ragionamento di Olmo 3 sottoposto a RL con ricompensa verificabile — sui probe esclusi dall’addestramento, la fedeltà passa da 0,238 a 0,262: una deriva positiva e non un’erosione, con checkpoint pubblicati. 🔗 fonte
- Together AI rivendica il miglior tempo al primo token su DeepSeek V4.1 Flash — l’azienda rilancia la misurazione di una terza parte per le richieste preriscaldate, senza pubblicare né il metodo né il valore: un’affermazione, non un risultato verificabile. 🔗 fonte
- Google Flow affianca due stilisti alla Fashion Week di New York — strumenti su misura progettati con Jane Wade e Sergio Hudson; una vetrina d’uso, senza nuovi modelli né funzionalità distribuite. 🔗 fonte
- La Google AI Educator Series dà diritto a crediti universitari — i corsi del programma di formazione danno ora diritto a crediti universitari o di formazione continua. 🔗 fonte
Che cosa significa
La giornata dice soprattutto una cosa: gli agenti di coding smettono di essere prodotti chiusi e iniziano a condividere i propri formati. Claude Code legge AGENTS.md quando un progetto non dispone di CLAUDE.md — vale a dire che Anthropic accetta un file di istruzioni definito altrove, affinché lo stesso repository possa servire più strumenti. Nello stesso giorno, Antigravity inserisce nel prompt di sistema dei suoi agenti Markdown il catalogo dei sotto-agenti disponibili, Vibe CLI fa finalmente eseguire gli hook all’interno dei sotto-agenti, Codex suddivide i costi per sotto-agente e Qwen Code esegue i propri in container. La delega tra agenti era una promessa di configurazione; sta diventando un meccanismo che occorre documentare, isolare e fatturare. Claude Code porta inoltre fino in fondo la logica della diffidenza contrassegnando i risultati dei sotto-agenti con un’intestazione dedicata, affinché un testo restituito non possa spacciarsi per un’istruzione.
Il mercato degli agenti da terminale, nel frattempo, si standardizza a vista d’occhio. MiniMax pubblica il proprio con licenza MIT, TUI, modalità headless, ACP e libera scelta del modello; Mistral rimuove l’etichetta «sperimentale» dal suo Unified Harness e documenta --legacy-harness come via d’uscita; Kimi Code pubblica una correzione delle prestazioni 32 ore dopo la sua versione principale. Quando quattro sviluppatori propongono lo stesso oggetto con gli stessi punti di ingresso, la differenziazione si sposta: dipende dalla licenza, dalla stabilità dell’harness e dal regime dei permessi — ed è proprio su questi aspetti che si concentrano le modifiche del giorno, tanto da Mistral quanto da Anthropic.
Sul fronte dei modelli, il movimento è quello dell’audio-video che diventa agentico anziché descrittivo. Qwen3.8-Omni-Flash non cerca più di descrivere un video, bensì di trovarvi una risposta: partendo dalla domanda, guadagna 4,4 punti su OmniVideoBench consumando al contempo il 45,7% di token in meno — prestazioni e risparmio procedono nella stessa direzione, cosa rara. Dall’altra parte, Grok Voice Transcribe 2.0 non punta sulla dimostrazione di laboratorio, ma sul traffico reale, con un tasso di errore sulle frasi brevi che scende dal 20,6% al 6,8% e un prezzo invariato. I due annunci convergono: il valore non deriva più dalla modalità supportata, ma da ciò che il modello decide di elaborare.
Resta la questione di ciò che i laboratori accettano di sottoporre a verifica. Anthropic paga Accenture per inserire valutatori all’interno della propria azienda, con accesso da dipendenti — e nello stesso annuncio riconosce che non esiste alcuno standard su ciò a cui un simile valutatore dovrebbe avere accesso, né su come pubblicarne le conclusioni, né su chi dovrebbe finanziarlo. È un’ammissione quanto un dispositivo. Accanto a ciò, le prove più solide del giorno sono quelle che una terza parte può riprodurre: i risultati di Exeter e dello Stowers Institute su AlphaGenome Atlas, il codice di ottimizzazione biomolecolare pubblicato in open source, i checkpoint di AmberTrace Labs. E anche il contrario è altrettanto evidente: Replit avanza un fattore 30 senza riferimenti, Together AI rilancia una classifica priva di metodo, Mistral smentisce un’affermazione che nessuno ha potuto leggere. In questo scenario, AIPerf arriva al momento giusto — uno strumento di misurazione che comincia ammettendo che spesso il problema è chi misura.
Fonti
- Claude Code, note di rilascio 2.1.277
- CHANGELOG di Claude Code
- Qwen, articolo su Qwen3.8-Omni-Flash
- Alibaba Qwen su X, annuncio del modello
- Codex CLI, note di rilascio 0.155.0
- OpenAI Developers su X, il consumo dettagliato in Codex
- SpaceXAI, Grok Voice Transcribe 2.0
- Anthropic, valutazione integrata con Accenture
- Changelog di Antigravity
- GitHub, riepilogo settimanale di Copilot del 14 settembre
- GitHub, deprecazione di sei modelli Copilot
- GitHub, personalizzazioni agentiche della CLI nell’API delle metriche
- MiniMax su X, pubblicazione del codice di MiniMax Code CLI
- Vibe CLI, note di rilascio 2.25.5
- OpenAI Developers su X, i plugin multi-account
- Max Stoiber su X, il messaggio originale sugli account multipli
- Genspark su X, il saldo settimanale Plus e Pro
- Google DeepMind su X, i risultati dei partner di AlphaGenome Atlas
- Google Research, contenuti interattivi didattici tramite interfaccia generativa
- Anthropic Research, Claude e la modellazione biomolecolare
- Meta AI su X, Muse per Mac
- Sakana AI, il Frontier Intelligence Group
- Runway, i prezzi unificati
- Pika su X, lancio di Product Ad
- NVIDIA, misurare l’inferenza su larga scala con AIPerf
- Mistral AI su X, smentita del 18 settembre