ai-powered-markdown-translatorgpt-6.1-sol का उपयोग करके फ़्रेंच से हिंदी में अनुवादित लेख।
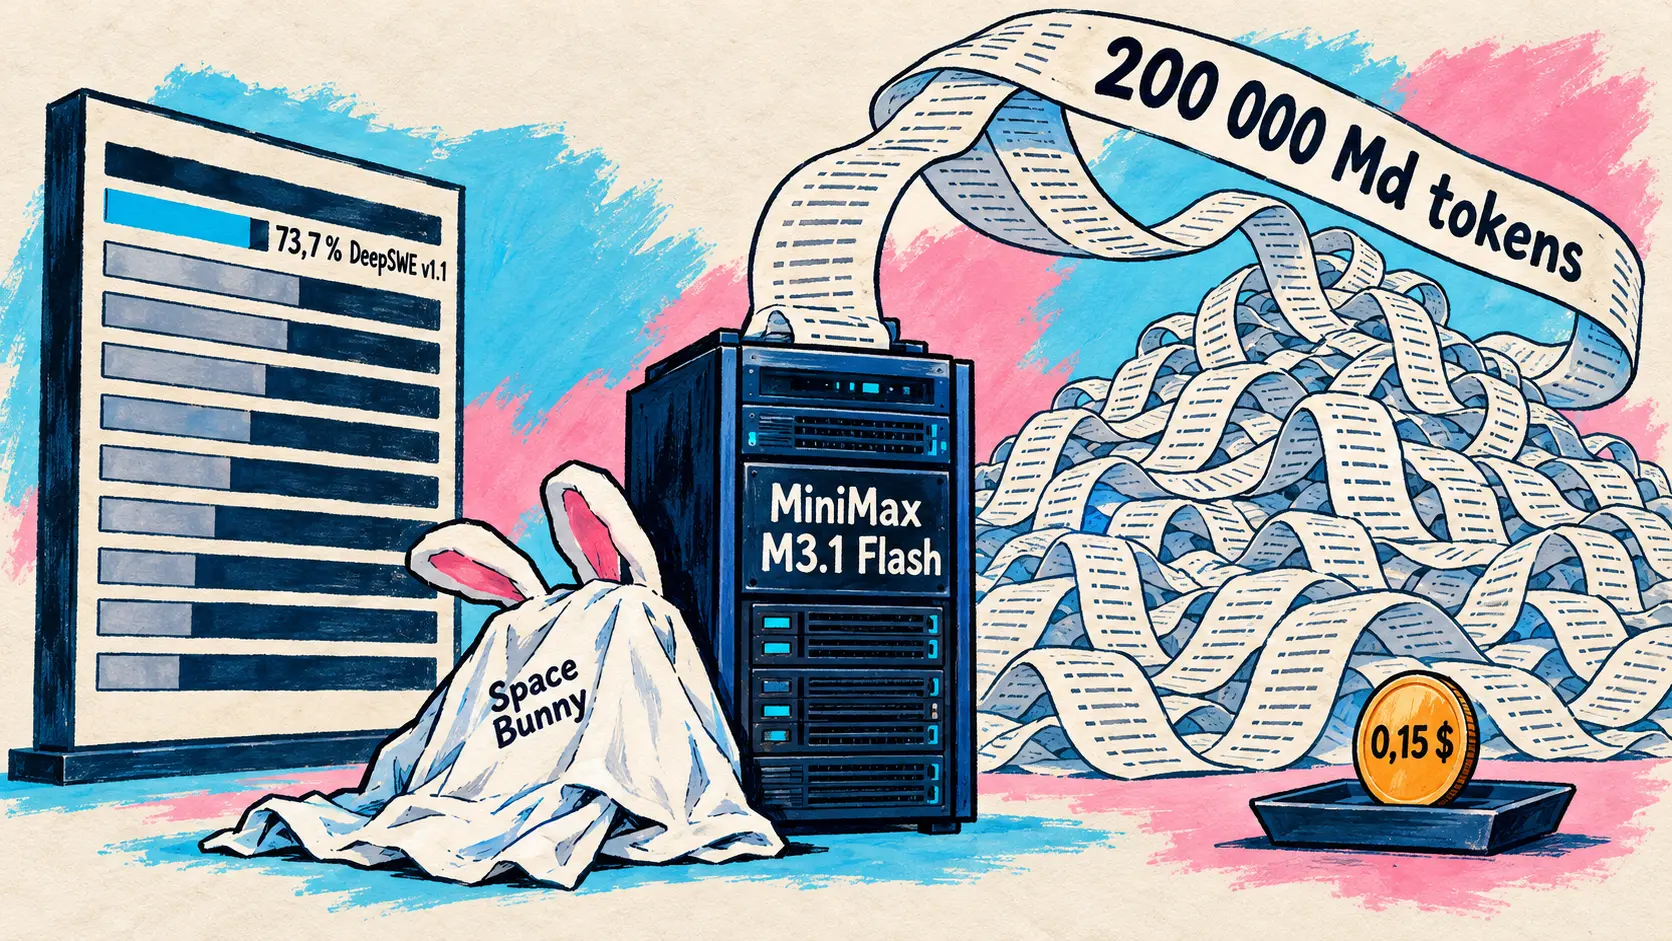
MiniMax ने M3.1 Flash उपलब्ध कराया है। एजेंट और कोड संबंधी कार्यों के लिए बने इस मॉडल की कीमत प्रति दस लाख इनपुट tokens पर 0,15 डॉलर है। कंपनी ने यह भी बताया कि 200 000 अरब से अधिक tokens संसाधित करने वाला अनाम मॉडल Space Bunny इसका एक प्रारंभिक संस्करण था। Black Forest Labs और fal ने FLUX 3 Max पेश किया है, जो 12,45 सेकंड में 10 सेकंड का वीडियो बनाता है। यह Seedance 2.5 से लगभग 22 गुना तेज़ है और चित्र से वीडियो बनाने की अभी प्रारंभिक अवस्था वाली एक प्रतिस्पर्धा में संयुक्त रूप से पहले स्थान पर है। OpenAI ने अपने API से GPT-4o और GPT-4.1 को हटाने की तारीख 14 जनवरी 2027 तय की है, Meta ने Muse Wonder को प्रशिक्षित करने वाले सुपरकंप्यूटर Prometheus का विवरण दिया है, और Devin अब प्रत्येक इंजीनियर की कार्यकुशलता को 0 से 100 तक अंक देता है।
MiniMax ने M3.1 Flash पेश किया: Space Bunny इसका प्रारंभिक संस्करण था, कीमत प्रति दस लाख इनपुट tokens पर 0,15 डॉलर
19 अक्टूबर — MiniMax ने अपनी Flash श्रेणी का नया मॉडल M3.1 Flash आधिकारिक रूप से उपलब्ध कराया है और एक अनाम मॉडल का रहस्य खोला है:
Space Bunny 🐰, which processed more than 200 trillion tokens while operating anonymously, was an early version of MiniMax M3.1 Flash.
🇮🇳 Space Bunny 🐰, जिसने अनाम रूप से काम करते हुए 200 000 अरब से अधिक tokens संसाधित किए, MiniMax M3.1 Flash का एक शुरुआती संस्करण था। — MiniMax का लॉन्च लेख
M3.1 Flash, M3.1-Flash-Preview का उत्तराधिकारी है, जो 27 सितंबर को MiniMax Code में और फिर Token Plan में बिना किसी benchmark या कीमत के सामने आया था। यह Space Bunny Alpha का भी उत्तराधिकारी है, जिसे OpenRouter ने 23 सितंबर को निर्माता का नाम बताए बिना एक गुप्त मॉडल के रूप में सूचीबद्ध किया था और जिसका उल्लेख यहाँ 27 सितंबर को किया गया था। MiniMax इसे एजेंट संबंधी कार्यों, कोड, कंप्यूटर उपयोग (Computer Use) और साइबर सुरक्षा के लिए नई पीढ़ी की छलाँग बताता है। नीचे दिए गए सभी अंक MiniMax के हैं:
| परीक्षण | MiniMax द्वारा घोषित अंक |
|---|---|
| DeepSWE v1.1 | 73,7 % |
| OSWorld V2 | 61,7 |
| Agents’ Last Exam (ALE) | 29,6 |
| BankerToolBench | 76,2 |
| CyberGym | 82 % |
| Automation-Bench | 62 % (पिन किया गया ट्वीट) |
OSWorld V2 और Agents’ Last Exam पर M3.1 Flash चीनी मॉडलों में पहले स्थान पर है; AutomationBench-AA पर लेख इसे केवल « सर्वश्रेष्ठ मॉडलों में से एक » बताता है, लेकिन पिन किया गया ट्वीट Automation-Bench पर 62 % अंक देता है।
दूसरा तर्क लागत है। अधिक विरलता (sparsity) आउटपुट की गति को 200 tokens प्रति सेकंड से ऊपर ले जाती है, जिसकी माध्यिका 170 से अधिक है, और इससे ऑनलाइन inference लगभग तीन गुना तेज़ होने का दावा है। लेख के अनुसार, एजेंट संबंधी कार्यों में उपयोग की लागत पिछले मॉडल की तुलना में 70 % घटती है, और पिन किया गया ट्वीट M3 की लागत के एक तिहाई पर तीन गुना गति की बात करता है। दरें निश्चित हैं:
| दर का प्रकार | प्रति दस लाख tokens की कीमत |
|---|---|
| इनपुट | 0,15 डॉलर |
| आउटपुट | 0,60 डॉलर |
| कैश किया गया इनपुट | 0,015 डॉलर |
M3.1 Flash अभी से MiniMax API, M Plan सदस्यता और MiniMax Code ऐप के माध्यम से उपलब्ध है। पिन किए गए ट्वीट के अनुसार, मॉडल के वज़न 23 अक्टूबर को उपलब्ध होंगे, जबकि लेख में केवल « बाद में » कहा गया है। इसके बाद एक Pro संस्करण भी आएगा, जिसकी तारीख घोषित नहीं की गई है। शाम को MiniMax ने पहले दिन से ही Ollama द्वारा इसके समर्थन की खबर साझा की, जिसमें अमेरिका में होस्टिंग और डेटा सहेजे बिना संचालन की सुविधा है। कंपनी ने यह भी दावा किया कि प्रारंभिक संस्करण बारह दिनों से OpenCode में शीर्ष पर था।
🔗 @MiniMax_AI की पिन की गई घोषणा
FLUX 3 Max: Black Forest Labs और fal 12 सेकंड में 10 सेकंड का वीडियो बनाते हैं, Seedance 2.5 से 22 गुना तेज़
19 अक्टूबर — Black Forest Labs (BFL) ने एक पिन किए गए ट्वीट में FLUX 3 Max पेश किया है। fal का पृष्ठ इसे fal Research द्वारा post-training से तैयार नया वीडियो मॉडल बताता है, जिसे BFL के साथ FLUX 3 के आधार पर बनाया गया है और जो 720p में टेक्स्ट से वीडियो तथा चित्र से वीडियो बनाता है।
Generate a 10-second video in 12 seconds. Tied for #1 in image-to-video. 22× faster than Seedance 2.5 at the same quality. FLUX 3 is a model designed for customization. @fal adapted and optimized it to create FLUX 3 Max.
🇮🇳 12 सेकंड में 10 सेकंड का वीडियो बनाएँ। चित्र से वीडियो बनाने में संयुक्त रूप से पहले स्थान पर। समान गुणवत्ता के साथ Seedance 2.5 से 22 गुना तेज़। FLUX 3 एक ऐसा मॉडल है जिसे अनुकूलन के लिए बनाया गया है। @fal ने इसे अनुकूलित और बेहतर बनाकर FLUX 3 Max तैयार किया है। — X पर @bfl_ai
| fal द्वारा प्रकाशित मापदंड | FLUX 3 Max | fal द्वारा दी गई तुलना |
|---|---|---|
| 10 सेकंड का वीडियो बनाने में लगने वाला समय | 12,45 s | Seedance 2.5 के लिए 277,80 s, FLUX 3 के लिए 126,44 s |
| Artificial Analysis की चित्र से वीडियो प्रतिस्पर्धा में Elo | 1 139, संयुक्त रूप से पहला स्थान | Seedance 2.5 भी 1 139 पर; MiniMax H3 (768p) अनिश्चितता के दायरे के भीतर 1 141 पर शीर्ष पर; FLUX 3 का स्कोर 1 089 |
| fal पर 720p की कीमत, 7 नवंबर तक | प्रति सेकंड 0,0425 डॉलर | सूचीबद्ध दर पर 0,17 डॉलर |
मूल FLUX 3 की तुलना में, inference पर fal का काम वीडियो निर्माण को लगभग 10 गुना तेज़ बनाता है, और post-training से इसे 50 Elo अंकों का लाभ मिलता है। मनुष्यों के बिना मॉडल की पहचान जाने दिए गए मतों पर आधारित Artificial Analysis की रैंकिंग अभी केवल एक प्रारंभिक झलक है: MiniMax H3 इसमें 1 141 पर शीर्ष पर है, और FLUX 3 Max को संयुक्त रूप से पहले स्थान पर बताया गया है, क्योंकि उसकी अनिश्चितता का दायरा अग्रणी मॉडलों के दायरे से मिलता है। यह Gemini Omni Flash 1.1, Wan 3.0 और H3 Max से आगे है। BFL आवाज़ों, भौतिक यथार्थता, ध्वनि प्रभावों और असामान्य अनुरोधों पर अच्छे प्रदर्शन को भी प्रमुखता देता है।
लॉन्च की कीमत BFL द्वारा घोषित दो सप्ताह की 75 % छूट के अनुरूप है। यह टेक्स्ट से वीडियो और चित्र से वीडियो, दोनों पर लागू है, और इसके लिए कोई न्यूनतम खर्च या सदस्यता आवश्यक नहीं है। fal यहाँ H3 Max की पद्धति दोहराता है, जो MiniMax H3 का उसका post-training से तैयार संस्करण है और उसी API से उपलब्ध है: केवल पहचानकर्ता बदलकर एक से दूसरे पर जाया जा सकता है। एक सप्ताह में FLUX 3 परिवार की यह तीसरी घोषणा है; इससे पहले 14 अक्टूबर को FLUX 3 Video की कीमतों में कमी और 15 अक्टूबर को FLUX 3 Image Klein की घोषणा हुई थी।
OpenAI अपने API से GPT-4o, GPT-4o mini, GPT-4.1 और GPT-4.1 mini को 14 जनवरी 2027 को हटाएगा
14 अक्टूबर — पिछली खबर: अपने API के अप्रचलन संबंधी पृष्ठ के अनुसार, OpenAI ने 14 अक्टूबर को संबंधित डेवलपर्स को बताया कि GPT-4 श्रृंखला के चार मॉडल, उनके परिष्कृत (fine-tuned) संस्करणों सहित, 14 जनवरी 2027 को हटा दिए जाएँगे। उसी पृष्ठ पर 1 अक्टूबर को घोषित मॉडल हटाने की दो अन्य श्रृंखलाएँ भी सूचीबद्ध हैं:
| API से हटाया जाने वाला मॉडल | हटाने की तारीख | सुझाया गया विकल्प |
|---|---|---|
GPT-4o (gpt-4o-2024-08-06, gpt-4o-2024-11-20) | 14 जनवरी 2027 | gpt-6-luna |
GPT-4o mini (gpt-4o-mini-2024-07-18) | 14 जनवरी 2027 | gpt-6-luna |
| GPT-4.1 और GPT-4.1 mini (14 अप्रैल 2025 के स्नैपशॉट) | 14 जनवरी 2027 | gpt-6-luna |
gpt-5.3-codex और gpt-5.1, घोषणा 1 अक्टूबर को हुई | 1 अप्रैल 2027 | gpt-6-sol |
gpt-5.4-nano, घोषणा 1 अक्टूबर को हुई | 1 अप्रैल 2027 | gpt-6-luna |
tts-1, tts-1-hd और gpt-4o-mini-tts, घोषणा 1 अक्टूबर को हुई | 6 जनवरी 2027 | gpt-realtime-2.1-mini |
ये तारीखें केवल अप्रचलन संबंधी पृष्ठ पर हैं, API के changelog में इनकी कोई प्रविष्टि नहीं है; 17 अक्टूबर के Node SDK 7.37.0 में GPT-4 मॉडल के उपनामों के लिए सेवा बंद होने की सूचनाएँ जोड़ी गई हैं।
🔗 OpenAI API का अप्रचलन संबंधी पृष्ठ
मॉडल प्रशिक्षण: Meta का Prometheus, Luma का MARBLE, Together Post-Training और Trainium पर TorchNeuron
आज की चार घोषणाएँ चार स्तरों पर प्रशिक्षण से जुड़ी हैं: Meta का कंप्यूटिंग केंद्र, Luma का GPU के बीच समानांतर संचालन, Together AI की post-training सेवा और AWS की चिपों के लिए PyTorch backend।
Prometheus: Muse Wonder को प्रशिक्षित करने वाले Meta के सुपरकंप्यूटर का लक्ष्य दस लाख GPU
19 अक्टूबर — Meta ने न्यू अल्बानी (ओहायो) स्थित अपने गीगावाट स्तर के सुपरकंप्यूटर Prometheus का विवरण दिया है, जिसने Muse Wonder सहित उसके Muse मॉडलों को प्रशिक्षित किया है; 12 अक्टूबर की हमारी खबरों में केवल इसका नाम दिया गया था। पहले चरण में कई इमारतों में फैले लाखों GPU शामिल हैं।
| Prometheus का मापदंड | Meta द्वारा प्रकाशित मान |
|---|---|
| उपयोगी कार्य-दर (goodput), Muse Wonder | पूर्व-प्रशिक्षण में 85 % से अधिक, RL में 90 % से अधिक |
| व्यवधानों के बीच औसत समय | लगभग 47 000 GPU-घंटे, उसके बाद से 54 000 से अधिक |
| 8 000 GPU पर व्यवधान | 2025 के मध्य में प्रतिदिन लगभग 1 000, अब 99 % की कमी |
| NVIDIA प्लेटफ़ॉर्म | GB200 और GB300 NVL72, फिर Vera Rubin NVL72 |
NVL72 में एक खराबी 72 GPU के पूरे समूह को प्रभावित करती है: Meta प्रति रैक केवल 64 GPU इस्तेमाल करता है और शेष 8 को बैकअप में रखता है। इसके अलावा लगभग 2 % रैक आरक्षित हैं, यानी 32 768 सक्रिय GPU के लिए 523 रैक (37 656 GPU)। लुइज़ियाना में उसका अगला सुपरकंप्यूटर Hyperion इन अनुभवों का उपयोग करेगा।
🔗 Prometheus के भीतर (Meta की इंजीनियरिंग)
MARBLE: Luma लाखों बहु-माध्यमीय tokens पर अनुक्रम समानांतरता को सटीक बनाता है
19 अक्टूबर — Luma ने MARBLE (Mask-Aware Ring with Balanced, Lossless Execution) प्रकाशित किया है। यह 1 से 8 मिलियन tokens के संकुचित अनुक्रमों पर बहु-माध्यमीय मॉडल प्रशिक्षित करने के लिए अनुक्रम समानांतरता की एक विधि है, जहाँ कारणात्मक टेक्स्ट के साथ द्विदिश चित्र और वीडियो शामिल होते हैं। MARBLE इस मास्क को प्रति token चार पूर्णांकों से निरूपित करता है और प्रत्येक परत के लिए ring attention, विरल all-to-all तथा Ulysses में से चुनाव करता है।
| Luma द्वारा परीक्षण की गई संरचना | MARBLE का परिणाम |
|---|---|
| FlashMask + Ulysses के मिश्रित समाधान की तुलना में | 48 में से 47 मामलों में तेज़ |
| 32, फिर 128 H100 GPU पर गति-वृद्धि की माध्यिका | 1,28 गुना, फिर 2,63 गुना |
| Gemma 3 27B का प्रशिक्षण चरण, 1 मिलियन tokens, 32 GPU | 13,2 s, जबकि FlashMask के साथ 32,5 s |
एक संशोधित FlashAttention-4 कर्नेल softmax की स्थिति fp32 में रखता है: आउटपुट और gradients एकल GPU के समान होते हैं। Luma स्वीकार करता है कि कर्नेल केवल Hopper GPU के लिए है और तुलना में इस्तेमाल किया गया मिश्रित समाधान उसने स्वयं बनाया है; कोड उपलब्ध कराने का वादा किया गया है, लेकिन कोई तारीख नहीं दी गई है।
Together Post-Training: ग्राहक अपना SFT या RL चक्र लिखता है, Together AI GPU चलाता है
19 अक्टूबर — प्रशिक्षण विधियों का अपना संग्रह (post-training-cookbook) जारी करने के एक सप्ताह बाद Together AI ने आधिकारिक रूप से सेवा शुरू की है। यह संग्रह 12 अक्टूबर को बिना घोषणा के ऑनलाइन आया था और यहाँ 13 अक्टूबर को प्रस्तुत किया गया था। ग्राहक पर्यवेक्षित परिष्करण (SFT) या पुनर्बलन अधिगम (RL) के माध्यम से प्रशिक्षण चक्र स्वयं लिखता है; इसके नीचे Together AI समर्पित GPU पर प्रशिक्षक और जनरेटर चलाता है।
| सेवा की विशेषता | Together AI द्वारा घोषित विवरण |
|---|---|
| वज़न का अनुकूलन | LoRA, एक ही GPU पर कई अडैप्टर, या कुछ मॉडलों पर पूरे वज़न |
| अंतर्निहित हानि फलन | GRPO, CISPO, DPPO, cross-entropy, या अनुकूलित हानि फलन |
| लॉन्च के समय उपलब्ध मॉडल | Muse Spark Open, GLM 5.3, Kimi K3, Qwen 3.8-27B |
| लॉन्च की कीमत | आठ सप्ताह तक B200 GPU के प्रति घंटे 9 डॉलर |
शुल्क GPU के प्रति मिनट के हिसाब से लगता है, और Tinker API से स्थानांतरण के लिए केवल एक पंक्ति बदलनी पड़ती है।
🔗 Together Post-Training (Together AI का ब्लॉग)
TorchNeuron: Transformers, Diffusers और Kernels सीधे AWS Trainium पर चलते हैं
19 अक्टूबर — Hugging Face ने Transformers, Diffusers और Kernels में AWS की Trainium चिपों के नए PyTorch backend TorchNeuron के लिए सीधा समर्थन जोड़ा है; सार्वजनिक बीटा 20 अक्टूबर को खुलेगा। अब तक PyTorch XLA पर बने Optimum Neuron का उपयोग करना पड़ता था, जिसमें स्थिर आकार और ग्राफ़ टूटने पर हर बार पुनः संकलन आवश्यक था। TorchNeuron चिप को एक सामान्य PyTorch उपकरण बनाता है, जिसमें तत्काल निष्पादन (eager), torch.compile और FSDP2 उपलब्ध हैं।
Inference में टेक्स्ट निर्माण की 100 सबसे अधिक इस्तेमाल होने वाली आर्किटेक्चर में से 89 % सीधे काम करती हैं, जबकि Optimum Neuron v0.4.5 में यह आँकड़ा 46 % था। Hugging Face अब Optimum Neuron की जगह Transformers, Diffusers, Accelerate, PEFT और TRL के उपयोग की सलाह देता है। TRL की एक मानक SFT स्क्रिप्ट 8 Trainium2 चिपों पर चलती है, और Hub पर साझा किया गया एक Neuron कर्नेल vision transformers को 2,4 गुना तक तेज़ करता है।
🔗 TorchNeuron (Hugging Face का ब्लॉग)
OpenAI के Python और Node SDK computer use और browser use के टूल संचालन चक्र को सँभालते हैं
16 अक्टूबर — पिछली खबर: @OpenAIDevs द्वारा दोबारा साझा किए गए एक थ्रेड में OpenAI की डेवलपर अनुभव टीम के केविन व्हिनरी ने Python और Node.js SDK के नए सहायक फ़ंक्शन (helpers) प्रस्तुत किए हैं, जो Responses API के टूल संचालन चक्र (tool loop) को सँभालते हैं। यह कोड 14 अक्टूबर को openai-python 3.31.0 और openai-node 7.33.0 में आया था। यह चार भागों वाली श्रृंखला का पहला भाग है।
| SDK का घटक | यह मॉडल को क्या उपलब्ध कराता है |
|---|---|
ComputerToolset | computer टूल के माध्यम से स्क्रीनशॉट, माउस और कीबोर्ड की क्रियाएँ |
BrowserToolset | फ़ंक्शन टूल के रूप में पृष्ठ का टेक्स्ट, नियंत्रण और टैब |
| Responses का Tool runner | स्ट्रीम के रूप में प्रगति और फिर से शुरू करने के बिंदु (checkpoints) |
डेवलपर द्वारा लिखा या आयात किया गया एक चालक (driver) क्रियाएँ निष्पादित करता है, और नियंत्रण ऐप के पास रहता है: उपलब्ध कराए गए संचालन, बदलावों की पुष्टि, सुरक्षा जाँच और चरणों की सीमाएँ। मार्गदर्शिका Browserbase, Browser Use, Daytona और E2B के साथ एकीकरण सूचीबद्ध करती है। Claude के SDK को 7 अक्टूबर को बीटा में इसी तरह के toolsets मिल चुके थे।
🔗 केविन व्हिनरी का थ्रेड · Computer use की मार्गदर्शिका
Perplexity : भूमिका के अनुसार कनेक्टर का ऐक्सेस, Projects में स्थानीय फ़ोल्डर, Nano Banana 2.1 और Reverse Engineer स्किल
19 अक्टूबर — Perplexity ने 5 अक्टूबर के बाद अपना पहला उत्पाद चेंजलॉग प्रकाशित किया है: इसकी तेरह श्रेणियों में से सात नई हैं।
| चेंजलॉग में नई सुविधा | क्या बदलता है | किन उपयोगकर्ताओं के लिए |
|---|---|---|
| भूमिका के अनुसार कनेक्टर का ऐक्सेस | हर कनेक्टर सभी के लिए, एडमिन के लिए या कुछ भूमिकाओं के लिए खोला जा सकता है | समर्पित सहायता वाली Enterprise योजनाओं के एडमिन |
| Projects में स्थानीय फ़ोल्डर | Computer डिफ़ॉल्ट रूप से Mac के एक फ़ोल्डर में पढ़ता और सहेजता है | Mac ऐप 26.38 या बाद का संस्करण |
| Computer में Nano Banana 2.1 | चित्र बनाना और संपादित करना, उसी थ्रेड में दोबारा अनुरोध करना | वे सभी जिन्हें Computer का ऐक्सेस है |
| Reverse Engineer स्किल | ऐसे सॉफ़्टवेयर की जाँच करना जिसका विश्लेषण करने का अधिकार हो, फिर उसे दोबारा बनाना और परखना | 31 अक्टूबर तक निःशुल्क, प्रति खाते 10 000 क्रेडिट की सीमा तक |
जुलाई के अंत में आया भूमिका आधारित ऐक्सेस नियंत्रण अब हर कनेक्टर के स्तर पर लागू होता है, साथ में ऑडिट लॉग भी हैं। इसके अलावा Computer में थंबनेल की एक पट्टी, अपना फ़ॉन्ट (PPLX) और इनपुट क्षेत्र में Ask या Computer मोड दर्शाने वाला फ़्रेम जोड़ा गया है। पहले से कवर किए गए विषयों में, Gemini 4 Argon अब Computer में Pro और Max ग्राहकों को उपलब्ध है, जबकि खोज में यह केवल Max ग्राहकों को मिलता है।
LiteRT Tensor API : Google ने C++ में CPU, GPU और NPU पर चलने वाले एम्बेडेड मॉडल लिखना संभव किया
19 अक्टूबर — Google AI Edge ने LiteRT Tensor API प्रकाशित की है। यह उसके एम्बेडेड इन्फ़रेंस स्टैक की एक परत है, जिससे C++ में एक-एक ऑपरेशन जोड़कर मॉडल हाथ से लिखा जा सकता है। एक ही ग्राफ़ LiteRT के साथ CPU पर, 8 अक्टूबर को ओपन सोर्स किए गए ML Drift इंजन की मदद से GPU पर, या NPU पर चलता है। इसे XNNPACK के ज़रिए सीधे CPU पर भी चलाया जा सकता है। वेट बिना किसी रूपांतरण के Hugging Face की .safetensors फ़ाइलों से लोड होते हैं, और टेंसर एक्सेलरेटर की मेमोरी में बिना कॉपी किए आगे बढ़ते हैं।
| SAM 2 पर Google का माप | घोषित परिणाम |
|---|---|
| WebGPU पर 512x512 में प्रति सेकंड चित्र | 10 से कम से बढ़कर 30 से अधिक |
| Apple MLX की तुलना में गति (MacBook Pro, fp16) | लगभग 1,5 गुना अधिक तेज़ |
प्रदर्शन में Meta का सेगमेंटेशन मॉडल SAM 2 ब्राउज़र में चलता है और उसके प्रॉम्प्ट Gemma 4 E2B समझता है; लेख के अनुसार, कोड एजेंट Antigravity ने इसे Tensor API से लिखा और फिर इसकी गति बढ़ाई। अधिकांश परियोजनाओं के लिए रूपांतरण अब भी सुझाया गया तरीका है।
कोड एजेंट : Devin अपने उपयोगकर्ताओं की दक्षता को अंक देता है, Amp अब Linear में एजेंट है, Mistral ने Vibe CLI 3.0.0 जारी किया, Antigravity में Gemini 4 Argon अब Google AI Pro ग्राहकों के लिए भी उपलब्ध
Cognition और Amp टीमों के लिए सुविधाएँ जोड़ रहे हैं, Mistral ने अपनी CLI का एक प्रमुख संस्करण जारी किया है, और Google ने Gemini 4 Argon को सदस्यता के एक और स्तर के लिए खोल दिया है।
Devin हर इंजीनियर की दक्षता को 0 से 100 तक अंक देता है और अच्छे अंक पाने वालों की सीमाएँ अपने आप बढ़ाता है
19 अक्टूबर — Cognition ने Devin की Enterprise योजना में खर्च नियंत्रित करने की तीन सुविधाएँ जोड़ी हैं। Efficiency Score हर इंजीनियर के हाल के उपयोग को अंक देता है। इसमें दक्षता E, यानी प्रति ACU (Devin की बिलिंग इकाई) उत्पादक घंटे, और उपयोग की मात्रा V, यानी प्रतिदिन उत्पादक घंटे, को मिलाया जाता है: Score = 100 × (E + 0,2 × V × (1 − E))। उपयोग की मात्रा का असर कम है: एक औसत इंजीनियर को 55, उतनी ही दक्षता वाले भारी उपयोगकर्ता को 60, कम दक्षता के साथ अधिक संसाधन खर्च करने वाले को 41 और सावधानी से उपयोग करने वाले अत्यंत दक्ष उपयोगकर्ता को 76 अंक मिलते हैं।
Devin Coach किसी प्रॉम्प्ट को चलाने से पहले उस पर टिप्पणी करता है और कभी चुपचाप उसे दोबारा नहीं लिखता। दक्षता के आधार पर स्वीकृति देने के विकल्प में एडमिन एक अधिकतम सीमा तय करता है: जब “स्वस्थ” या “संतोषजनक” श्रेणी का इंजीनियर अपनी सीमा के करीब पहुँचता है, तो Devin बिना अनुरोध किए उसे बढ़ा देता है, उस अधिकतम सीमा तक और संगठन की सीमाओं के भीतर। इससे अधिक के अनुरोध, तथा “सुधार की आवश्यकता” या “अज्ञात” श्रेणी के इंजीनियरों के अनुरोध, एडमिन के पास जाते हैं और कोई भी अनुरोध अपने आप अस्वीकार नहीं होता। सभी Devin Enterprise ग्राहकों के लिए अभी उपलब्ध इन स्वीकृति सुविधाओं की कीमत प्रकाशित नहीं की गई है।
Amp अब Linear में एजेंट है : इश्यू सौंपने या @Amp का उल्लेख करने से एक orb शुरू होता है
19 अक्टूबर — अब Linear का कोई इश्यू Amp को सौंपने या टिप्पणी में @Amp का उल्लेख करने से Linear में एक एजेंट सेशन (Agent Session) खुलता है और एक orb शुरू होता है, यानी उस व्यक्ति की ओर से काम करने वाला एजेंट थ्रेड। Amp इसी सेशन में जवाब देता है, काम के दौरान भेजे गए संदेशों पर प्रतिक्रिया करता है और बताता है कि वह किसी त्रुटि के कारण रुक गया है या किसी टूल की स्वीकृति की प्रतीक्षा कर रहा है। दस्तावेज़ों के अनुसार, सब्सक्रिप्शन हर नए इश्यू के लिए भी एक orb शुरू कर सकते हैं। Amp वर्कस्पेस का एडमिन ऐप इंस्टॉल करता है, Linear का एडमिन उसे स्वीकृति देता है, फिर हर व्यक्ति अपना खाता जोड़ता है और Linear उसके MCP सर्वरों में शामिल हो जाता है। कोई कीमत नहीं बताई गई है; Amp 23 जुलाई से ही Linear वेबहुक पर प्रतिक्रिया दे सकता था।
Vibe CLI 3.0.0 : Mistral ने केवल Rust CLI और Unified Harness को रखा
19 अक्टूबर — Mistral ने बिना घोषणा के Vibe CLI 3.0.0 जारी किया है, जो उसका पहला 3.x संस्करण है: इसमें 95 प्रविष्टियाँ हैं, जिनमें 54 सुधार और 5 हटाव शामिल हैं। पुराना Python इंटरफ़ेस, पुराना रनटाइम और Plan मोड हटा दिए गए हैं, vibe अब भी Rust TUI शुरू करता है, और CLI से लेकर Desktop तक सभी इंटरफ़ेस Unified Harness से चलते हैं।
कई बदलाव किसी मौजूदा इंस्टॉलेशन को काम करने से रोक सकते हैं: न्यूनतम Python संस्करण 3.12 से बढ़कर 3.14 हो गया है, प्रमाणपत्रों की जाँच RFC 5280 के अधिक सख्त नियमों से होती है, Vibe 1.x सेशन का समर्थन समाप्त हो गया है और उप-एजेंट टूल का नाम बदलकर agents.* कर दिया गया है। नई सुविधाओं में, /branch बातचीत की एक शाखा नए सेशन में खोलता है, Vibe Desktop किसी दूसरे कोड एजेंट के सेशन आयात करता है और enable_mcp फ़्लैग से एडमिन MCP सर्वरों को ब्लॉक कर सकते हैं। Windows पर अब कोई कमांड अपना एक हिस्सा छिपाकर स्वीकृति की जाँच से नहीं बच सकती।
🔗 Vibe CLI 3.0.0 के रिलीज़ नोट्स
Antigravity में Gemini 4 Argon अब Google AI Pro ग्राहकों के लिए भी उपलब्ध, अलग साप्ताहिक कोटे के साथ
15 अक्टूबर — छूटी हुई खबर: Google Antigravity में Gemini 4 Argon अब केवल Ultra ग्राहकों तक सीमित नहीं है। @antigravity खाते ने डेस्कटॉप ऐप और CLI में भुगतान करने वाले Google AI Pro ग्राहकों के लिए इसकी उपलब्धता की घोषणा की है, जबकि 13 अक्टूबर को सामान्य उपलब्धता शुरू होने पर केवल Google AI Ultra और पात्र Gemini Enterprise ग्राहकों को इसका ऐक्सेस था। Pro के लिए Gemini 3.8 Flash कोटे के अलावा Argon का एक अलग कोटा मिलता है, जो केवल साप्ताहिक है और जिसकी मात्रा नहीं बताई गई है।
| सदस्यता का स्तर | Antigravity में Gemini 4 Argon |
|---|---|
| निःशुल्क और Google AI Plus | नहीं |
| Google AI Pro | हाँ, परीक्षण अवधि के बाहर |
| Google AI Ultra | हाँ |
| एंटरप्राइज़ | हाँ |
Argon, Antigravity App, Antigravity CLI और IDE एक्सटेंशन में काम करता है, Antigravity IDE में नहीं। 19 अक्टूबर को Zed 1.24.3 ने भी इसे अपने स्थिर संस्करण में शामिल किया।
🔗 @antigravity की घोषणा · Antigravity का मॉडल पृष्ठ
संक्षिप्त खबरें
कोड एजेंट और टूल
- Claude Code 2.1.303 — 18 अक्टूबर को जारी इस संस्करण के नोट्स केवल एक पंक्ति के हैं: बग सुधार और विश्वसनीयता में सुधार, लेकिन ठीक की गई समस्याओं की सूची नहीं है; TypeScript Agent SDK भी 0.3.303 पर पहुँच गया है। 🔗 स्रोत
- Qwen Code v0.25.3 — स्थिर संस्करण 16 अक्टूबर को कवर किए गए पूर्वावलोकन संस्करण के बाद आया है और इसमें संगतता तोड़ने वाला कोई ज्ञात बदलाव नहीं है: v0.25.2 के बाद से 41 सुविधाएँ और 81 सुधार, मुख्य रूप से Managed Agent के लिए, जो अपने टूल SSH के ज़रिए या नेटिव macOS वर्कस्पेस में चलाता है और अब Plan मोड भी पाता है। 🔗 स्रोत
- Copilot CLI 1.0.100 — 14 अक्टूबर के 1.0.98 के बाद पहला स्थिर संस्करण कोई नई चीज़ नहीं लाता: इसकी 49 प्रविष्टियाँ 1.0.99-0 से 1.0.100-1 तक के पूर्वावलोकन संस्करणों की हैं, जिन्हें यहाँ 15 से 17 अक्टूबर के बीच पेश किया गया था। 🔗 स्रोत
- ZCode v3.16.1 — Z.ai ने ZCode के ओपन सोर्स रिपॉज़िटरी को संस्करण 3.16.1 के साथ सिंक किया है, लेकिन कोई रिलीज़ या रिलीज़ नोट्स नहीं दिए हैं; दस्तावेज़ों में एकमात्र नई चीज़ चीनी भाषा में CLI उपयोग की मार्गदर्शिका है। 🔗 स्रोत
- Gemini CLI, 19 अक्टूबर का नाइटली बिल्ड — कोई बदलाव नहीं: यह लगातार तीसरा नाइटली बिल्ड है जो उसी कमिट पर है, क्योंकि 16 अक्टूबर की शाम से कुछ भी मर्ज नहीं हुआ है। स्थिर v0.64.0 और पूर्वावलोकन v0.65.0-preview.0 भी अपरिवर्तित हैं। 🔗 स्रोत
- Zed 1.24.3 — इस स्थिर संस्करण का एकमात्र नोट Google AI मॉडल में Gemini 4 Argon को जोड़ता है, जो 14 अक्टूबर से पूर्वावलोकन संस्करण 1.25.0 में मौजूद था। 🔗 स्रोत
- Figma के MCP साझेदार — 15 अक्टूबर की छूटी हुई खबर में, Figma ने Config India में 20 नए MCP साझेदारों की घोषणा की, जिनमें Amp, JetBrains का Junie, OpenCode, Cline, Delta और Zed शामिल हैं। लेकिन उसकी सूची में 21 नाम हैं और यह नहीं बताया गया है कि कौन-सी सुविधाएँ खुलेंगी या वे कब उपलब्ध होंगी; Zed ने 19 अक्टूबर को यह घोषणा साझा की। 🔗 स्रोत · 🔗 Zed
- Navan और Cursor के क्लाउड एजेंट — 16 अक्टूबर की छूटी हुई खबर में, Cursor बताता है कि Navan ने अपनी मशीनों पर चलने वाले क्लाउड एजेंटों की मदद से लगभग एक सप्ताह में Spring Boot 4 पर माइग्रेशन किया (8 ऐप्लिकेशन, 15 लाइब्रेरी), जबकि दो साल पहले इसमें एक महीने से अधिक लगा था; 30 दिनों में उसके मुख्य रिपॉज़िटरी में मर्ज हुई PR में से 36 % Cursor के साथ लिखी गई थीं। 🔗 स्रोत
- GitHub Copilot ऐप का सेशन VS Code में फिर शुरू करना — GitHub Blog का एक ट्यूटोरियल दिखाता है कि “VS Code में खोलें” कार्रवाई कैसे किसी सेशन को उसके वर्कट्री में टास्क, योजना, बातचीत और डिफ़ के साथ दोबारा खोलती है, जिसके बाद समीक्षा, संशोधन, स्थानीय परीक्षण और सेशन की पुल रिक्वेस्ट में पुश किया जा सकता है। 🔗 स्रोत
- COOKED — OpenAI Developers ने एक वीडियो कार्यक्रम शुरू किया है, जिसमें दिखाया जाता है कि टीम और समुदाय Codex से क्या बना रहे हैं; पहला एपिसोड (13 मिनट 20 सेकंड) पहले से उपलब्ध सुविधाएँ दिखाता है, Codex के क्लाउड वातावरण से लेकर Ultrafast से बनाए गए 8 बिट के रामेन गेम तक। 🔗 स्रोत
API, हार्नेस और इंटीग्रेशन
- Perplexity की Agent API —
require_approvalसेटिंग MCP टूल और कनेक्टर कॉल चलाने से पहले ऐप्लिकेशन की सहमति अनिवार्य करती है, और xhigh प्रीसेट की आउटपुट सीमा 128 000 से बढ़कर 512 000 टोकन हो गई है; Perplexity ने 5 अक्टूबर की अपनी उस प्रविष्टि को भी सुधारा है, जिसे यहाँ दोहराया गया था: xhigh भी Fast Search का उपयोग करता है। 🔗 स्रोत - हार्नेस इंजीनियरिंग — Perplexity ने हार्नेस (harness) पर एक मार्गदर्शिका प्रकाशित की है, यानी AI टूल में मॉडल के आसपास मौजूद पूरी व्यवस्था पर। इसे एजेंट लूप से लेकर सत्यापन तक छह घटकों में बाँटा गया है; इसमें एक अनाम स्वतंत्र परीक्षण का हवाला दिया गया है, जहाँ केवल हार्नेस बदलने से एक ही मॉडल के कोड परीक्षण के स्कोर में 11 % तक अंतर आया। 🔗 स्रोत
- Crusoe में SPACE — Crusoe ने Perplexity के ओपन सोर्स सैंडबॉक्स SPACE को Crusoe Cloud की Managed AI सेवा में शामिल करने के लिए Perplexity के साथ साझेदारी की घोषणा की है, लेकिन कोई तारीख या कीमत नहीं बताई है; 15 अक्टूबर को SPACE का कोड सार्वजनिक करते समय बताए गए साझेदारों में Crusoe पहले से शामिल था। 🔗 स्रोत
- Lovable में Perplexity — 15 अक्टूबर की छूटी हुई खबर में, Perplexity अब Claude, Firecrawl, Gemini, OpenAI, p0 और TypeSafe के साथ उन AI सुविधाओं के प्रदाताओं में शामिल है जिन्हें Lovable ऐप्लिकेशन में जोड़ता है। इससे स्रोत संदर्भों के साथ रीयल-टाइम वेब उत्तर मिलेंगे; कीमत या तकनीकी विवरण नहीं दिया गया है। 🔗 स्रोत
- एक वॉइस एजेंट जो चुप नहीं होता — Google Developers की एक मार्गदर्शिका दिखाती है कि ADK के स्ट्रीमिंग और नॉन-ब्लॉकिंग टूल gemini-3.8-live पर वॉइस एजेंट की चुप्पी कैसे दूर करते हैं: बिक्री रिपोर्ट के वर्कफ़्लो में उसके पहले शब्दों तक की देरी 14,4 सेकंड से घटकर 1,2 सेकंड हो जाती है, बिना किसी नई सुविधा के। 🔗 स्रोत
- Together AI पर DeepSeek-V4.1-Flash-1017 — 17 अक्टूबर को यहाँ पेश किया गया DeepSeek का मॉडल Together AI पर उपलब्ध है, होस्टिंग प्रदाता के अनुसार “उसी कीमत पर”। 🔗 स्रोत
खुले मॉडल और शोध
- Muse Glimmer — Meta ने अगस्त में लॉन्च किए गए अपने 30B ओपन मॉडल की तकनीकी रिपोर्ट प्रकाशित की है। यह आम उपभोक्ता हार्डवेयर पर एजेंट कार्यों के लिए है: टेक्स्ट और चित्र, सौ से अधिक भाषाएँ, एक GPU पर लगभग 4 बिट और Apache 2.0 लाइसेंस; Meta का कहना है कि यह Gemma4-31B और Qwen3.6-27B के मुकाबले अपनी श्रेणी में आगे है, लेकिन सारांश में कोई आँकड़ा नहीं दिया गया है। 🔗 स्रोत
- SlideOn और mSlideOn — LightOn ने DenseOn और mLateOn से बने विरल खोज (sparse retrieval) के दो मॉडल प्रकाशित किए हैं, जिनमें क्रमशः 174M (अंग्रेज़ी) और 339M पैरामीटर (बहुभाषी) हैं: SlideOn को BEIR-15 पर DenseOn के 56,20 के मुकाबले 56,68 अंक मिलते हैं, और mSlideOn, MLDR पर mDenseOn से 10,19 अंक आगे है। 🔗 स्रोत
- tokenizers v1.0.0-rc.3 — tokenizers v1 का तीसरा रिलीज़ कैंडिडेट लाइब्रेरी को ब्राउज़र में लाता है। इसके लिए npm पर
tokenizers-wasmनाम से WebAssembly बाइंडिंग प्रकाशित की गई हैं; इससे ModernBERT, NLLB और SentencePiece से रूपांतरित मॉडलों को लोड करना भी संभव होता है। 🔗 स्रोत - Transformers v5.20.2 — सुधार वाला संस्करण: जनरेशन के दौरान इनपुट अब अपना टाइप नहीं खोते, जिससे मल्टीमोडल मॉडलों को परेशानी होती थी, और एक्सपर्ट पैरेललिज़्म के साथ bfloat16 में एक्सपर्ट ग्रेडिएंट अब शून्य नहीं होते। 🔗 स्रोत
- अपने प्रॉम्प्ट क्रमबद्ध करना — समुदाय के एक लेख में अब्देनासेर बदावी बैच इन्फ़रेंस से पहले प्रॉम्प्ट को विषय क्षेत्र के अनुसार क्रमबद्ध करके, vLLM में कोई बदलाव किए बिना, उसे Qwen3-30B-A3B पर 12 से 17 % और gpt-oss-120b पर 7 से 12 % तेज़ बनाते हैं, क्योंकि समान अनुरोध उन्हीं एक्सपर्ट का उपयोग करते हैं; विलंब के प्रति संवेदनशील ऑनलाइन सेवा में यह लाभ खत्म हो जाता है। 🔗 स्रोत
- Nesso3-0.4B-Agentic — mii-llm ने टूल कॉलिंग के लिए 0,4 अरब पैरामीटर वाला इतालवी-अंग्रेज़ी द्विभाषी मॉडल Apache-2.0 लाइसेंस के तहत प्रकाशित किया है: इसके लेखकों के द्विभाषी परीक्षण सूट में Qwen3-0.6B के 67 के मुकाबले इसे 74/100 मिलते हैं, लेकिन अंग्रेज़ी के सामान्य टूल पर 84 % के मुकाबले केवल 48 %। 🔗 स्रोत
- S²-MAS और Fin-Laya — यांग ली ने 500 मिलियन घरेलू व्यक्तित्व-प्रोफ़ाइलों से लिए गए 12 मिलियन एजेंटों का सिमुलेशन 14 GPU पर 3 घंटे 59 मिनट में किया और वित्तीय निर्णय मॉडल Fin-Laya पेश किया। उनके अपने माप के अनुसार, इसकी सटीकता 74,5544 % और औसत विलंब 9,10 ms है, जबकि Jev 1.13 का विलंब 206,77 ms है। 🔗 स्रोत
- BlenderWorld — 15 अक्टूबर की छूटी हुई खबर में, Qwen ने Blender में 3D निर्माण का एक बेंचमार्क प्रकाशित किया है (223 टास्क, 2 651 द्विआधारी मानदंड): 13 मॉडलों में GPT-6-Astra, 100 में से 79,9 अंकों के साथ Opus-5 (73,0) और GPT-5.6-Sol (67,7) से आगे है, Qwen3.8-Max पाँचवें स्थान पर है (60,6), और पहले स्थान वाला मॉडल भी केवल 42,2 % टास्क में सभी मानदंड पूरे करता है। 🔗 स्रोत
हार्डवेयर, आम उपभोक्ता और सृजन
- RTX Spark लैपटॉप की कीमत — 16 अक्टूबर की खबर पर लौटें तो NVIDIA की लॉन्च प्रेस विज्ञप्ति में ASUS, Dell, HP, Lenovo, Microsoft और MSI के RTX Spark लैपटॉप दुनिया भर में 2 599 डॉलर से उपलब्ध होने की घोषणा की गई है; वहीं, NVIDIA की 17 अक्टूबर की ब्लॉग पोस्ट उन्हीं निर्माताओं के लैपटॉप की शुरुआती कीमत 2 399 डॉलर बताती है। 🔗 प्रेस विज्ञप्ति · 🔗 ब्लॉग पोस्ट
- Action बटन पर Grok Bot — Grok Bot का खाता @bot एक वीडियो में दिखाता है कि सहायक को iPhone के Action बटन से जोड़ा जा सकता है, जैसे यहाँ 18 अक्टूबर को प्रस्तुत OpenAI के dots को; न iOS का संस्करण बताया गया है, न सदस्यता योजना, और न ही x.ai पर कोई ब्लॉग पोस्ट या @SpaceXSI की ओर से साझा की गई कोई पोस्ट है। 🔗 स्रोत
- Chroma Awards, सीज़न 2 — ElevenLabs ने एआई से रचना करने की उस प्रतियोगिता का दूसरा सीज़न शुरू किया है, जिसे अपने संरक्षण में विकसित करने का वह दावा करता है: पाँच श्रेणियाँ, 1 मिलियन डॉलर के ट्रायल और 450 000 डॉलर से अधिक के पुरस्कार; पोस्ट में अंतिम तिथि 1 जनवरी 2027 दी गई है, जबकि उसकी शर्तों में 7 जनवरी है, जिसके बाद 11 फ़रवरी 2027 को समारोह होगा। 🔗 स्रोत
GitHub, एआई के अलावा
- प्रमाणीकरण वाले HTTPS क्लोन — असामान्य ट्रैफ़िक के दौरान GitHub सार्वजनिक रिपॉज़िटरी पर HTTPS के ज़रिए किए जाने वाले कुछ
git cloneऔरgit fetchके लिए अस्थायी रूप से प्रमाणीकरण अनिवार्य कर सकता है; SSH, पुश और प्रमाणीकृत कार्रवाइयाँ प्रभावित नहीं होतीं, और GitHub निरंतर एकीकरण के लिएGITHUB_TOKENया GitHub App टोकन की सलाह देता है। 🔗 स्रोत - CodeQL, Xcode 27 और Swift 6.4 — Apple की कुछ सिस्टम बाइनरी में
x86_64कोड न होने के कारण CodeQL अब Xcode 27 से होने वाले बिल्ड को ट्रेस नहीं करता और किसी भी प्लेटफ़ॉर्म पर Swift 6.4 का समर्थन नहीं करता; Intel वाले Mac का समर्थन दिसंबर के मध्य में अप्रचलित घोषित किया जाएगा, और GitHub macOS 26 तथा Xcode 26 के संस्करण पिन करने की सलाह देता है। 🔗 स्रोत
इसका क्या मतलब है
MiniMax और Black Forest Labs एक ही मोर्चे पर प्रतिस्पर्धा कर रहे हैं: मूल गुणवत्ता से अधिक, किसी कार्य की गति और लागत पर। M3.1 Flash आउटपुट में प्रति सेकंड 200 टोकन से आगे निकलता है, एजेंट कार्यों के उपयोग की लागत 70 % घटाता है और इनपुट में प्रति मिलियन टोकन के लिए 0,15 डॉलर लेता है; FLUX 3 Max 10 सेकंड का वीडियो 12,45 सेकंड में तैयार करता है, जिसकी दर 7 नवंबर तक 0,0425 डॉलर प्रति सेकंड है। बताई गई गुणवत्ता सर्वश्रेष्ठ मॉडलों की बराबरी करती है, उनसे आगे नहीं निकलती: FLUX 3 Max ऐसी रैंकिंग में संयुक्त रूप से पहले स्थान पर है जिसमें MiniMax H3 उससे दो अंक आगे है, जो अनिश्चितता की सीमा के भीतर है, और M3.1 Flash एजेंटों के दो बेंचमार्क पर चीनी मॉडलों में पहले स्थान पर होने का दावा करता है। MiniMax का मॉडल वास्तविक परिस्थितियों में भी परखा गया है: Space Bunny ने यह बताए बिना कि वह कहाँ से आया था, 200 000 अरब से अधिक टोकन संसाधित किए, और MiniMax के अनुसार उसका प्रारंभिक संस्करण बारह दिनों तक OpenCode में शीर्ष पर रहा। ये सभी आँकड़े अभी भी निर्माताओं के अपने हैं, और Artificial Analysis की रैंकिंग अभी प्रारंभिक है।
पोस्ट-ट्रेनिंग अपने आप में एक संपूर्ण उत्पाद बनती जा रही है। fal ने FLUX 3 Max को शून्य से नहीं बनाया: उसने Black Forest Labs के FLUX 3 को अनुकूलित और बेहतर किया, जैसे उसने MiniMax H3 को अपना H3 Max बनाया था; fal के अनुसार पोस्ट-ट्रेनिंग से मॉडल को 50 Elo अंकों की बढ़त मिली, और इनफ़रेंस पर किए गए काम से जनरेशन लगभग दस गुना तेज़ हुआ। Together AI अब यह क्षमता अपने ग्राहकों को बेचता है, जो खुले मॉडलों पर अपना ट्रेनिंग लूप, SFT या RL, लिखते हैं, और TorchNeuron, Transformers तथा TRL की सामान्य PyTorch स्क्रिप्ट के लिए AWS की Trainium चिपों तक पहुँच खोलता है। इस शृंखला के दूसरे सिरे पर प्रीट्रेनिंग का केंद्रीकरण हो रहा है: Prometheus का लक्ष्य दस लाख GPU है, और Meta की पोस्ट का अधिकांश हिस्सा विश्वसनीयता पर केंद्रित है, जिसमें हर रैक में 8 अतिरिक्त GPU और व्यवधानों में 99 % की कमी शामिल है। MARBLE सॉफ़्टवेयर के स्तर पर पैमाने की इसी समस्या से निपटता है, कई मिलियन टोकन वाले अनुक्रमों के लिए।
एजेंटों को प्रशासकों के नियंत्रण भी मिल रहे हैं: कौन क्या चला सकता है, किस बजट में और किस स्वीकृति के बाद। Devin जिन इंजीनियरों को कुशल मानता है, उनकी सीमाएँ अपने आप बढ़ा देता है और बाकी को प्रशासक के पास भेज देता है; Perplexity हर कनेक्टर का उपयोग कुछ भूमिकाओं के लिए खोलता है, और उसका Agent API एप्लिकेशन की मंज़ूरी मिलने तक MCP कॉल रोक सकता है; OpenAI के टूलसेट एप्लिकेशन को बदलावों की पुष्टि करने और चरणों की संख्या सीमित रखने देते हैं; Vibe CLI 3.0.0 प्रशासकों को ऐसा फ़्लैग देता है जो MCP सर्वर बंद कर देता है। वहीं, Amp उस व्यक्ति की ओर से Linear में काम करता है जो उसे कोई इश्यू सौंपता है: एजेंट टीम के टूल में स्थापित हो जाता है और हर व्यक्ति के Linear कनेक्शन से कार्य करता है।
अंत में, डेवलपरों के लिए यह पतझड़ कई माइग्रेशन भी लेकर आया है। GPT-4o और GPT-4.1 14 जनवरी 2027 को OpenAI के API से हट जाएँगे, वाणी संश्लेषण मॉडल tts-1 और gpt-4o-mini-tts 6 जनवरी को ही हट जाएँगे, और ये तारीखें केवल अप्रचलन वाले पृष्ठ पर दी गई हैं: केवल API के परिवर्तन विवरण पर नज़र रखने से ये छूट जाती हैं। Trainium पर Hugging Face, Optimum Neuron छोड़कर TorchNeuron पर Transformers और TRL अपनाने की सलाह देता है। और Vibe CLI 3.0.0 के लिए Python 3.14 अनिवार्य है, वह प्रमाणपत्रों की जाँच अधिक कड़ाई से करता है और Vibe 1.x के सत्रों को फिर से नहीं खोलता, जिससे रिलीज़ नोट पढ़े बिना अपडेट करने वालों को आश्चर्य हो सकता है।
स्रोत
- MiniMax M3.1 Flash (MiniMax की ब्लॉग पोस्ट)
- M3.1 Flash की पिन की गई घोषणा (@MiniMax_AI)
- FLUX 3 Max की घोषणा (@bfl_ai)
- FLUX 3 Max (fal)
- अप्रचलन सूचनाएँ (OpenAI API के दस्तावेज़)
- Prometheus के भीतर: गीगावाट स्तर के सुपरक्लस्टर तक Meta की यात्रा (Meta में इंजीनियरिंग)
- MARBLE, पैक्ड मल्टीमोडल अटेंशन (Luma)
- Together Post-Training (Together AI)
- TorchNeuron: AWS Trainium पर HF मॉडल चलाना अब पहले से भी आसान है (Hugging Face ब्लॉग)
- SDK के computer use और browser use टूलसेट (@kevinwhinnery)
- Computer use मार्गदर्शिका (OpenAI API के दस्तावेज़)
- 19 अक्टूबर का उत्पाद परिवर्तन विवरण (Perplexity)
- LiteRT Tensor API से एज के लिए नेटिव मॉडल तैयार करना (Google Developers)
- दक्षता के आधार पर लागत नियंत्रण (Devin)
- इसे Amp को सौंपें (Amp)
- Vibe CLI 3.0.0 (GitHub)
- Google AI Pro के लिए Gemini 4 Argon (@antigravity)
- Antigravity के मॉडल (दस्तावेज़)
- Claude Code 2.1.303 (GitHub)
- Qwen Code v0.25.3 (GitHub)
- Copilot CLI 1.0.100 (GitHub)
- ZCode v3.16.1 का सिंक्रनाइज़ेशन (GitHub)
- Gemini CLI v0.66.0-nightly.20261019 (GitHub)
- Zed 1.24.3 (GitHub)
- Figma के नए MCP साझेदार (@figma)
- Zed द्वारा साझा की गई पोस्ट (@zeddotdev)
- Navan की केस स्टडी (Cursor)
- GitHub Copilot ऐप का सत्र VS Code में फिर से शुरू करना (GitHub ब्लॉग)
- COOKED, कड़ी 1 (@OpenAIDevs)
- Perplexity API का परिवर्तन विवरण
- हार्नेस इंजीनियरिंग (Perplexity)
- Managed AI में SPACE (@CrusoeAI)
- Lovable में Perplexity (@perplexitydevs)
- आवाज़ से संवाद करने वाला एक ADK एजेंट जो कभी चुप नहीं होता (Google Developers)
- Together AI पर DeepSeek-V4.1-Flash-1017 (@togethercompute)
- Muse Glimmer 30B: डिवाइस पर चलने वाला एक एजेंटिक मॉडल (Meta)
- SlideOn और mSlideOn (Hugging Face ब्लॉग)
- tokenizers v1.0.0-rc.3 (GitHub)
- Transformers v5.20.2 (GitHub)
- अपने प्रॉम्प्ट क्रमबद्ध करें (Hugging Face ब्लॉग)
- Nesso3-0.4B-Agentic (Hugging Face ब्लॉग)
- S²-MAS (Hugging Face ब्लॉग)
- BlenderWorld (GitHub)
- RTX Spark पीसी का लॉन्च (NVIDIA की प्रेस विज्ञप्ति)
- RTX Spark के लॉन्च समारोह (NVIDIA ब्लॉग)
- Action बटन पर Grok Bot (@bot)
- Chroma Awards, सीज़न 2 (ElevenLabs)
- HTTPS पर कुछ Git कार्यों के लिए अस्थायी रूप से प्रमाणीकरण आवश्यक हो सकता है (GitHub का परिवर्तन विवरण)
- macOS 27, Xcode 27 और Swift 6.4 के लिए CodeQL में बदलाव (GitHub का परिवर्तन विवरण)