ai-powered-markdown-translatorArtykuł przetłumaczony z francuskiego na polski za pomocą gpt-6.1-sol.
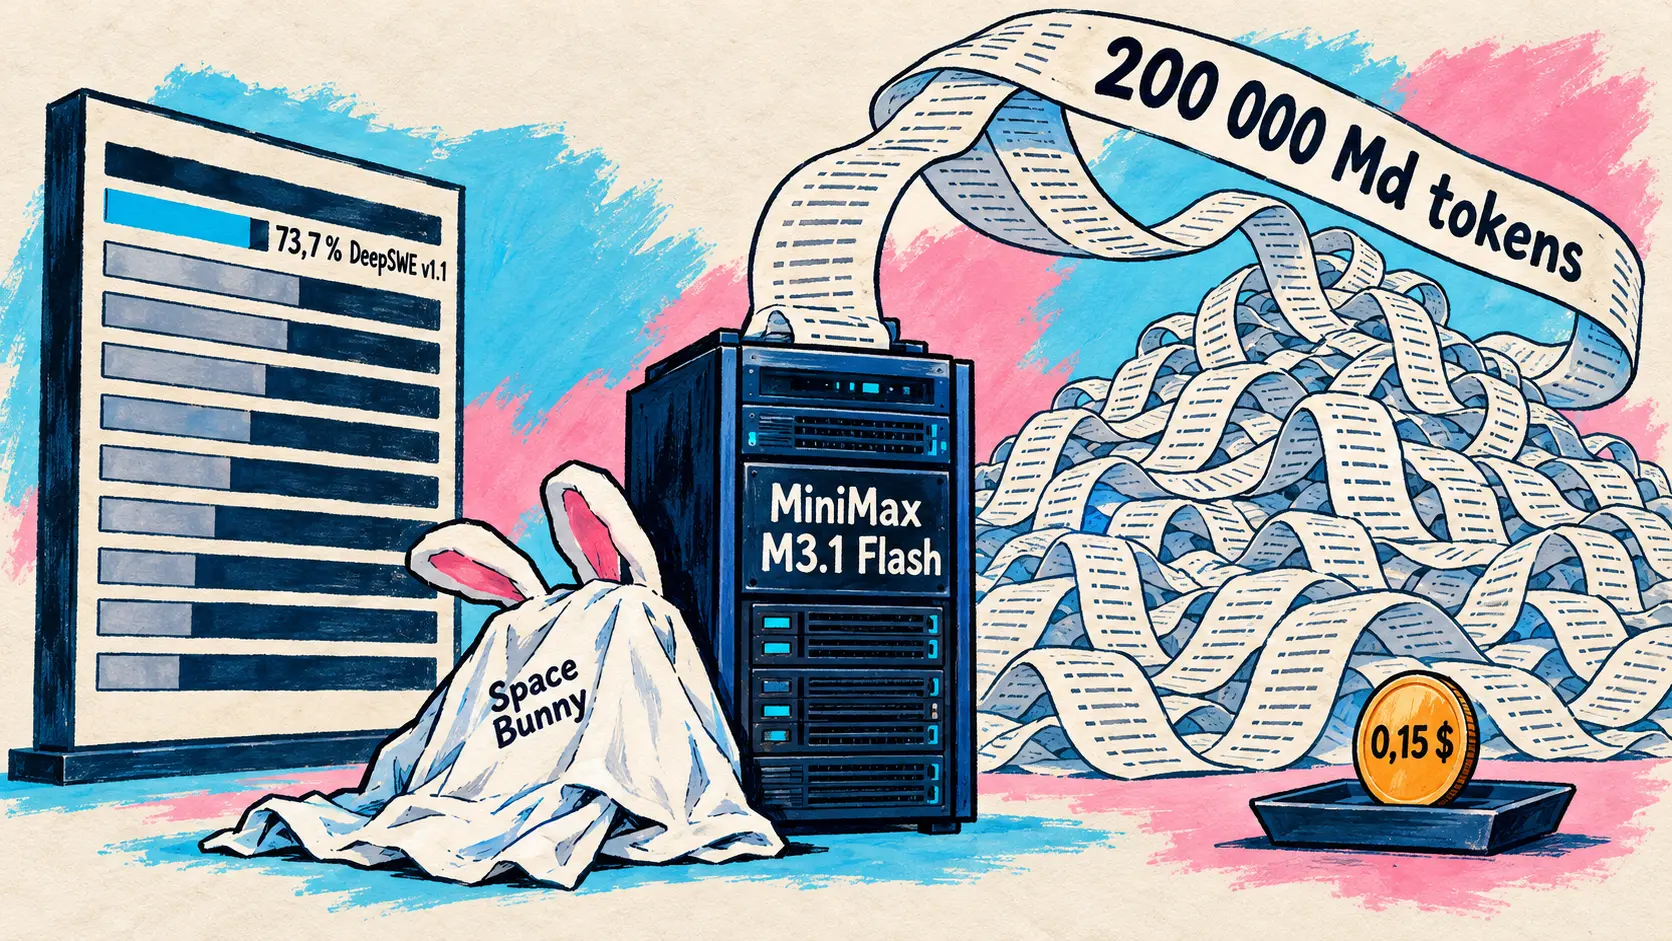
MiniMax udostępnia M3.1 Flash, model do zadań agentowych i programowania w cenie 0,15 dolara za milion tokenów wejściowych, i ujawnia, że Space Bunny, anonimowy model, który przetworzył ponad 200 000 miliardów tokenów, był jego wersją wstępną. Black Forest Labs i fal wprowadzają FLUX 3 Max, który generuje wideo o długości 10 sekund w 12,45 sekundy, około 22 razy szybciej niż Seedance 2.5, i zajmuje pierwsze miejsce ex aequo we wstępnym jeszcze rankingu areny generowania wideo z obrazu. OpenAI wyznacza 14 stycznia 2027 jako datę wycofania GPT-4o i GPT-4.1 ze swojego API, Meta przedstawia szczegóły dotyczące Prometheus, superkomputera, na którym wytrenowano Muse Wonder, a Devin ocenia teraz efektywność każdego inżyniera w skali od 0 do 100.
MiniMax wprowadza M3.1 Flash: Space Bunny był jego wersją wstępną, cena wynosi 0,15 dolara za milion tokenów wejściowych
19 października — MiniMax oficjalnie udostępnia M3.1 Flash, swój nowy model z serii Flash, i wyjaśnia tajemnicę anonimowego modelu:
Space Bunny 🐰, which processed more than 200 trillion tokens while operating anonymously, was an early version of MiniMax M3.1 Flash.
🇵🇱 Space Bunny 🐰, który przetworzył ponad 200 000 miliardów tokenów, działając anonimowo, był pierwszą wersją MiniMax M3.1 Flash. — MiniMax, wpis premierowy
M3.1 Flash jest następcą M3.1-Flash-Preview, który pojawił się 27 września w MiniMax Code, a następnie w Token Plan, bez benchmarków ani cennika, oraz Space Bunny Alpha, modelu udostępnionego po cichu 23 września przez OpenRouter bez wskazania twórcy i przedstawionego tutaj 27 września. MiniMax opisuje go jako skok generacyjny w zadaniach agentowych, programowaniu, obsłudze komputera (Computer Use) i cyberbezpieczeństwie. Wszystkie poniższe wyniki pochodzą od MiniMax:
| Benchmark | Wynik podany przez MiniMax |
|---|---|
| DeepSWE v1.1 | 73,7 % |
| OSWorld V2 | 61,7 |
| Agents’ Last Exam (ALE) | 29,6 |
| BankerToolBench | 76,2 |
| CyberGym | 82 % |
| Automation-Bench | 62 % (przypięty tweet) |
W OSWorld V2 i Agents’ Last Exam M3.1 Flash zajmuje pierwsze miejsce wśród chińskich modeli; w przypadku AutomationBench-AA wpis mówi jedynie, że jest „wśród najlepszych”, ale przypięty tweet podaje 62 % w Automation-Bench.
Drugim argumentem jest koszt. Większa rzadkość (sparsity) podnosi szybkość generowania do ponad 200 tokenów na sekundę (mediana ponad 170) i ma niemal trzykrotnie przyspieszać inferencję online. Według wpisu koszt korzystania z modelu w zadaniach agentowych spada o 70 % względem poprzedniego modelu, a przypięty tweet mówi o jednej trzeciej kosztu M3 przy trzykrotnie większej szybkości. Cennik jest stały:
| Rodzaj opłaty | Cena za milion tokenów |
|---|---|
| Dane wejściowe | 0,15 dolara |
| Dane wyjściowe | 0,60 dolara |
| Dane wejściowe w pamięci podręcznej | 0,015 dolara |
M3.1 Flash jest już dostępny przez API MiniMax, abonament M Plan i aplikację MiniMax Code. Według przypiętego tweeta wagi zostaną udostępnione 23 października, podczas gdy wpis mówi jedynie o „późniejszym terminie”; później pojawi się też wersja Pro, bez zapowiedzianej daty. Wieczorem MiniMax przekazał informację o obsłudze modelu przez Ollama już od pierwszego dnia, z hostingiem w USA bez przechowywania danych, i podał, że wersja wstępna przez dwanaście dni zajmowała pierwsze miejsce w OpenCode.
🔗 Przypięte ogłoszenie @MiniMax_AI
FLUX 3 Max: Black Forest Labs i fal generują 10 sekund wideo w 12 sekund, 22 razy szybciej niż Seedance 2.5
19 października — Black Forest Labs (BFL) przedstawia FLUX 3 Max w przypiętym tweecie. Strona fal opisuje go jako nowy model wideo po dodatkowym treningu przeprowadzonym przez fal Research, zbudowany wspólnie z BFL na bazie FLUX 3, służący zarówno do generowania wideo z tekstu, jak i z obrazu, w 720p.
Generate a 10-second video in 12 seconds. Tied for #1 in image-to-video. 22× faster than Seedance 2.5 at the same quality. FLUX 3 is a model designed for customization. @fal adapted and optimized it to create FLUX 3 Max.
🇵🇱 Wygeneruj wideo o długości 10 sekund w 12 sekund. Ex aequo na pierwszym miejscu w generowaniu wideo z obrazu. 22 razy szybciej niż Seedance 2.5 przy tej samej jakości. FLUX 3 to model zaprojektowany z myślą o personalizacji. @fal dostosował go i zoptymalizował, aby stworzyć FLUX 3 Max. — @bfl_ai na X
| Wskaźnik opublikowany przez fal | FLUX 3 Max | Porównanie podane przez fal |
|---|---|---|
| Czas generowania wideo o długości 10 sekund | 12,45 s | 277,80 s dla Seedance 2.5, 126,44 s dla FLUX 3 |
| Elo, arena generowania wideo z obrazu Artificial Analysis | 1 139, pierwsze miejsce ex aequo | Seedance 2.5 również 1 139; MiniMax H3 (768p) na prowadzeniu z 1 141, w granicach niepewności; FLUX 3 z 1 089 |
| Cena 720p w fal, do 7 listopada | 0,0425 dolara za sekundę | 0,17 dolara według ceny katalogowej |
W porównaniu z pierwotnym FLUX 3 prace fal nad inferencją sprawiają, że generowanie jest około 10 razy szybsze, a dodatkowy trening przynosi wzrost o 50 punktów Elo. Ranking Artificial Analysis, oparty na głosach ludzi w ślepych testach, jest zaledwie wstępnym obrazem sytuacji: na czele znajduje się MiniMax H3 z 1 141 punktami, a FLUX 3 Max, którego przedział niepewności pokrywa się z przedziałami liderów, jest określany jako pierwszy ex aequo, przed Gemini Omni Flash 1.1, Wan 3.0 i H3 Max. BFL podkreśla również głosy, realizm fizyczny, efekty dźwiękowe i radzenie sobie z nietypowymi poleceniami.
Premierowa cena odpowiada ogłoszonej przez BFL zniżce 75 % przez dwa tygodnie, zarówno przy generowaniu wideo z tekstu, jak i z obrazu, bez minimalnego progu ani abonamentu. fal stosuje ten sam sposób co przy H3 Max, swojej wersji MiniMax H3 po dodatkowym treningu, udostępnianej przez to samo API: między modelami można się przełączać, zmieniając identyfikator. To trzecie ogłoszenie dotyczące rodziny FLUX 3 w ciągu tygodnia, po obniżce cen FLUX 3 Video 14 października i ogłoszeniu FLUX 3 Image Klein 15 października.
OpenAI wyznacza 14 stycznia 2027 jako datę wycofania GPT-4o, GPT-4o mini, GPT-4.1 i GPT-4.1 mini ze swojego API
14 października — Uzupełnienie wcześniejszych wiadomości: według strony dotyczącej deprecjacji API OpenAI powiadomiło 14 października odpowiednich deweloperów o wycofaniu czterech modeli z serii GPT-4 14 stycznia 2027, w tym wersji dostrojonych (fine-tuned). Ta sama strona wymienia dwie grupy wycofań zapowiedzianych 1 października:
| Model wycofywany z API | Data wycofania | Zalecany zamiennik |
|---|---|---|
GPT-4o (gpt-4o-2024-08-06, gpt-4o-2024-11-20) | 14 stycznia 2027 | gpt-6-luna |
GPT-4o mini (gpt-4o-mini-2024-07-18) | 14 stycznia 2027 | gpt-6-luna |
| GPT-4.1 i GPT-4.1 mini (wersje z 14 kwietnia 2025) | 14 stycznia 2027 | gpt-6-luna |
gpt-5.3-codex i gpt-5.1, ogłoszone 1 października | 1 kwietnia 2027 | gpt-6-sol |
gpt-5.4-nano, ogłoszony 1 października | 1 kwietnia 2027 | gpt-6-luna |
tts-1, tts-1-hd i gpt-4o-mini-tts, ogłoszone 1 października | 6 stycznia 2027 | gpt-realtime-2.1-mini |
Daty te widnieją tylko na stronie dotyczącej deprecjacji, bez wpisu w changelogu API; SDK Node 7.37.0 z 17 października dodaje powiadomienia o wycofaniu aliasów modeli GPT-4.
🔗 Strona deprecjacji API OpenAI
Trenowanie modeli: Prometheus firmy Meta, MARBLE firmy Luma, Together Post-Training i TorchNeuron na Trainium
Cztery dzisiejsze ogłoszenia dotyczą trenowania na czterech poziomach: centrum obliczeniowego Meta, zrównoleglenia pracy GPU w Luma, usługi dodatkowego treningu Together AI i backendu PyTorch dla układów AWS.
Prometheus: superkomputer Meta, na którym wytrenowano Muse Wonder, ma docelowo obejmować milion GPU
19 października — Meta opisuje Prometheus, swój superkomputer o mocy rzędu gigawata w New Albany (Ohio), na którym wytrenowano jej modele Muse, w tym Muse Wonder; nasz przegląd wiadomości z 12 października wymieniał jedynie jego nazwę. Pierwsza faza obejmuje setki tysięcy GPU rozmieszczonych w kilku budynkach.
| Wskaźnik Prometheus | Wartość opublikowana przez Meta |
|---|---|
| Użyteczna przepustowość (goodput), Muse Wonder | ponad 85 % podczas treningu wstępnego, ponad 90 % w RL |
| Średni czas między przerwami | około 47 000 godzin-GPU, od tego czasu ponad 54 000 |
| Przerwy przy 8 000 GPU | prawie 1 000 dziennie w połowie 2025, spadek o 99 % |
| Platformy NVIDIA | GB200 i GB300 NVL72, następnie Vera Rubin NVL72 |
W NVL72 awaria dotyka domeny liczącej 72 GPU: Meta wykorzystuje tylko 64 w każdej szafie i pozostawia pozostałe 8 w rezerwie, a dodatkowo utrzymuje około 2 % zapasowych szaf, co daje 523 szafy (37 656 GPU) na 32 768 aktywnych GPU. Hyperion, jej następny superkomputer w Luizjanie, wykorzysta te doświadczenia.
🔗 Prometheus od środka (Engineering at Meta)
MARBLE: Luma zapewnia dokładność równoległego przetwarzania sekwencji milionów tokenów multimodalnych
19 października — Luma publikuje MARBLE (Mask-Aware Ring with Balanced, Lossless Execution), metodę równoległego przetwarzania sekwencji do trenowania modeli multimodalnych na spakowanych sekwencjach od 1 do 8 milionów tokenów, łączących tekst przetwarzany przyczynowo z obrazami i wideo przetwarzanymi dwukierunkowo. MARBLE opisuje tę maskę za pomocą czterech liczb całkowitych na token i dla każdej warstwy wybiera między ring attention, rzadkim all-to-all i Ulysses.
| Konfiguracja testowana przez Luma | Wynik MARBLE |
|---|---|
| W porównaniu z hybrydą FlashMask + Ulysses | szybszy w 47 przypadkach na 48 |
| Mediana przyspieszenia przy 32, a następnie 128 GPU H100 | 1,28 raza, a następnie 2,63 raza |
| Krok Gemma 3 27B, 1 milion tokenów, 32 GPU | 13,2 s, wobec 32,5 s z FlashMask |
Zmodyfikowany kernel FlashAttention-4 przechowuje stan softmax w fp32: wyjścia i gradienty są identyczne z tymi z pojedynczego GPU. Luma przyznaje, że kernel działa wyłącznie na GPU Hopper, a porównywaną hybrydę zbudowała sama; udostępnienie kodu jest zapowiedziane, bez podanej daty.
Together Post-Training: klient pisze własną pętlę SFT lub RL, Together AI obsługuje GPU
19 października — Tydzień po udostępnieniu repozytorium przepisów (post-training-cookbook), opublikowanego bez zapowiedzi 12 października i przedstawionego tutaj 13 października, Together AI oficjalnie uruchamia usługę. Klient sam pisze pętlę treningową, wykorzystując nadzorowane dostrajanie (SFT) lub uczenie ze wzmocnieniem (RL); Together AI uruchamia w tle komponent trenujący i generatory na dedykowanych GPU.
| Cecha usługi | Szczegóły podane przez Together AI |
|---|---|
| Adaptacja wag | LoRA, wiele adapterów na tych samych GPU lub pełne wagi w wybranych modelach |
| Zintegrowane funkcje straty | GRPO, CISPO, DPPO, entropia krzyżowa lub własna funkcja straty |
| Modele w dniu premiery | Muse Spark Open, GLM 5.3, Kimi K3, Qwen 3.8-27B |
| Cena premierowa | 9 dolarów za godzinę GPU B200 przez osiem tygodni |
Opłaty są naliczane za minutę pracy GPU, a migracja z API Tinker mieści się w jednej linii kodu.
🔗 Together Post-Training (blog Together AI)
TorchNeuron: Transformers, Diffusers i Kernels działają natywnie na AWS Trainium
19 października — Hugging Face dodaje natywną obsługę TorchNeuron, nowego backendu PyTorch od AWS dla układów Trainium, w Transformers, Diffusers i Kernels; publiczna beta rusza 20 października. Do tej pory trzeba było korzystać z Optimum Neuron, opartego na PyTorch XLA, ze statycznymi kształtami i ponowną kompilacją przy każdym przerwaniu grafu. TorchNeuron sprawia, że układ staje się zwykłym urządzeniem PyTorch, z natychmiastowym wykonywaniem (eager), torch.compile i FSDP2.
W inferencji 89 % ze 100 najczęściej używanych architektur generowania tekstu działa od razu, w porównaniu z 46 % dla Optimum Neuron v0.4.5, a Hugging Face zaleca teraz korzystanie z Transformers, Diffusers, Accelerate, PEFT i TRL zamiast Optimum Neuron. Standardowy skrypt SFT z TRL działa na 8 układach Trainium2, a kernel Neuron udostępniony na Hub przyspiesza działanie vision transformers nawet 2,4 raza.
🔗 TorchNeuron (blog Hugging Face)
SDK Python i Node od OpenAI obsługują pętlę narzędzi computer use i browser use
16 października — Uzupełnienie wcześniejszych wiadomości: w wątku udostępnionym ponownie przez @OpenAIDevs Kevin Whinnery z zespołu OpenAI odpowiedzialnego za doświadczenia deweloperów przedstawia nowe funkcje pomocnicze (helpers) SDK Python i Node.js, które obsługują pętlę narzędzi (tool loop) Responses API. Kod pojawił się 14 października w openai-python 3.31.0 i openai-node 7.33.0, w ramach pierwszej z czterech części serii.
| Komponent SDK | Co udostępnia modelowi |
|---|---|
ComputerToolset | zrzuty ekranu, działania myszy i klawiatury, przez narzędzie computer |
BrowserToolset | tekst strony, kontrolki i karty, w postaci narzędzi opartych na funkcjach |
| Tool runner Responses | strumieniowe przesyłanie postępu i punkty wznowienia (checkpoints) |
Sterownik (driver) napisany lub zaimportowany przez dewelopera wykonuje działania, a aplikacja zachowuje kontrolę nad udostępnianymi operacjami, potwierdzaniem zmian, kontrolami bezpieczeństwa i limitami kroków. Przewodnik wymienia integracje z Browserbase, Browser Use, Daytona i E2B. SDK Claude otrzymały porównywalne toolsets w wersji beta 7 października.
🔗 Wątek Kevina Whinnery’ego · Przewodnik po Computer use
Perplexity: dostęp do konektorów według ról, folder lokalny w Projects, Nano Banana 2.1 i skill Reverse Engineer
19 października — Perplexity publikuje pierwszy changelog produktu od 5 października: siedem z trzynastu sekcji pojawia się po raz pierwszy.
| Nowość w changelogu | Co się zmienia | Dla kogo |
|---|---|---|
| Dostęp do konektorów według ról | każdy konektor dostępny dla wszystkich, administratorów lub wybranych ról | administratorzy planów Enterprise z opieką |
| Folder lokalny w Projects | Computer domyślnie odczytuje i zapisuje dane w folderze na Macu | aplikacja na Maca w wersji 26.38 lub nowszej |
| Nano Banana 2.1 w Computer | generowanie i edycja obrazów, ponowienia w tym samym wątku | wszyscy, którzy mają dostęp do Computer |
| Skill Reverse Engineer | analizowanie oprogramowania, do którego analizy ma się prawo, a następnie jego odtworzenie i testowanie | bezpłatnie do 31 października, z limitem 10 000 kredytów na konto |
Kontrola dostępu według ról, wprowadzona pod koniec lipca, obejmuje teraz poszczególne konektory i dzienniki audytu. Do tego dochodzą pasek miniatur w Computer, własny font (PPLX) oraz ramka wskazująca w polu wprowadzania tryb Ask lub Computer. Wśród wcześniej opisywanych tematów: Gemini 4 Argon jest dostępny w Computer dla subskrybentów Pro i Max, ale w wyszukiwaniu wyłącznie dla subskrybentów Max.
LiteRT Tensor API: Google umożliwia pisanie w C++ modeli dla systemów wbudowanych działających na CPU, GPU i NPU
19 października — Google AI Edge publikuje LiteRT Tensor API, warstwę swojego stosu inferencji na urządzeniach, która pozwala ręcznie napisać model w C++, operacja po operacji. Ten sam graf działa z LiteRT na CPU, na GPU dzięki silnikowi ML Drift, udostępnionemu jako open source 8 października, lub na NPU, a także może być wykonywany bezpośrednio na CPU przez XNNPACK. Wagi są ładowane z plików .safetensors z Hugging Face, bez konwersji, a tensory są przekazywane bez kopiowania w pamięci akceleratora.
| Pomiar Google na SAM 2 | Ogłoszony wynik |
|---|---|
| Obrazy na sekundę w 512x512 na WebGPU | od poniżej 10 do ponad 30 |
| Szybkość względem Apple MLX (MacBook Pro, fp16) | około 1,5 raza szybciej |
W demonstracji SAM 2, model segmentacji firmy Meta, działa w przeglądarce z promptami interpretowanymi przez Gemma 4 E2B; według wpisu kod napisał agent programistyczny Antigravity, korzystając z Tensor API, a następnie go przyspieszył. Konwersja pozostaje zalecaną ścieżką dla większości projektów.
Agenci programistyczni: Devin ocenia efektywność użytkowników, Amp staje się agentem w Linear, Mistral publikuje Vibe CLI 3.0.0, Gemini 4 Argon trafia do subskrybentów Google AI Pro w Antigravity
Cognition i Amp dodają funkcje dla zespołów, Mistral publikuje nową główną wersję swojego CLI, a Google udostępnia Gemini 4 Argon na kolejnym poziomie subskrypcji.
Devin ocenia efektywność każdego inżyniera w skali od 0 do 100 i sam podnosi limity najwyżej ocenianych
19 października — Cognition dodaje trzy funkcje zarządzania wydatkami do planu Enterprise w Devin. Efficiency Score ocenia niedawne korzystanie z narzędzia przez każdego inżyniera, łącząc efektywność E, wyrażoną w produktywnych godzinach na ACU (jednostkę rozliczeniową Devin), z wolumenem V, wyrażonym w produktywnych godzinach dziennie: Score = 100 × (E + 0,2 × V × (1 − E)). Wolumen ma niewielki wpływ: przeciętny inżynier otrzymuje 55, równie efektywny intensywny użytkownik 60, użytkownik zużywający dużo zasobów przy niskiej efektywności 41, a ostrożny, lecz bardzo efektywny użytkownik 76.
Devin Coach komentuje prompt przed jego wykonaniem, nigdy nie przerabiając go po cichu. Dzięki opcji Approve based on efficiency administrator ustala górny pułap: gdy inżynier z oceną Healthy lub Satisfactory zbliża się do swojego limitu, Devin podnosi go bez konieczności składania prośby, do tego pułapu i w granicach limitów organizacji. Kwoty powyżej pułapu, podobnie jak wnioski inżynierów z oceną Needs Improvement lub Unknown, trafiają do administratora, a żaden wniosek nie jest automatycznie odrzucany. Funkcje zatwierdzania są już dostępne dla wszystkich klientów Devin Enterprise; nie opublikowano ich cennika.
Amp staje się agentem w Linear: przypisanie issue lub wzmianka @Amp uruchamia orb
19 października — Przypisanie issue w Linear do Amp lub wspomnienie go przez @Amp w komentarzu otwiera teraz sesję agenta (Agent Session) w Linear i uruchamia orb, czyli wątek agenta pracującego w imieniu danej osoby. Amp odpowiada w tej sesji, reaguje na wiadomości wysyłane w trakcie pracy i sygnalizuje zatrzymanie z powodu błędu lub oczekiwanie na zatwierdzenie użycia narzędzia. Według dokumentacji subskrypcje mogą również uruchamiać orb dla każdego nowego issue. Administrator przestrzeni Amp instaluje aplikację, administrator Linear ją zatwierdza, następnie każdy łączy swoje konto, a Linear dołącza do jego serwerów MCP. Nie podano ceny; Amp potrafił już reagować na webhooki Linear od 23 lipca.
Vibe CLI 3.0.0: Mistral pozostawia tylko Rust CLI i Unified Harness
19 października — Mistral publikuje bez zapowiedzi Vibe CLI 3.0.0, swoją pierwszą wersję 3.x: 95 wpisów, w tym 54 poprawki i 5 usuniętych elementów. Znikają stary interfejs Python, stary silnik wykonawczy i tryb Plan, vibe nadal uruchamia Rust TUI, a wszystkie interfejsy, od CLI po Desktop, korzystają z Unified Harness.
Kilka zmian może sprawić, że dotychczasowa instalacja przestanie działać: wymagany jest co najmniej Python 3.14 zamiast 3.12, certyfikaty są sprawdzane według bardziej rygorystycznych reguł RFC 5280, porzucono obsługę sesji Vibe 1.x, a narzędzia subagentów przemianowano na agents.*. Wśród nowości: /branch tworzy odgałęzienie rozmowy w nowej sesji, Vibe Desktop importuje sesje innego agenta programistycznego, a flaga enable_mcp pozwala administratorom blokować serwery MCP. W Windows polecenie nie może już omijać kontroli zatwierdzania przez ukrywanie części swojej treści.
🔗 Informacje o wydaniu Vibe CLI 3.0.0
Gemini 4 Argon trafia do subskrybentów Google AI Pro w Antigravity, z osobnym limitem tygodniowym
15 października — Uzupełnienie wcześniejszych wiadomości: Gemini 4 Argon nie jest już zarezerwowany dla subskrybentów Ultra w Google Antigravity. Konto @antigravity ogłosiło udostępnienie go płatnym subskrybentom Google AI Pro w aplikacji desktopowej i CLI, podczas gdy w chwili ogólnego udostępnienia 13 października dostęp mieli tylko subskrybenci Google AI Ultra i uprawnieni klienci Gemini Enterprise. W Pro do limitu Gemini 3.8 Flash dochodzi osobny limit Argon, wyłącznie tygodniowy i bez podanej wartości.
| Poziom subskrypcji | Gemini 4 Argon w Antigravity |
|---|---|
| Bezpłatny i Google AI Plus | nie |
| Google AI Pro | tak, poza okresem próbnym |
| Google AI Ultra | tak |
| Dla firm | tak |
Argon działa w Antigravity App, Antigravity CLI i rozszerzeniach IDE, ale nie w Antigravity IDE. 19 października Zed 1.24.3 udostępnił go także w swojej wersji stabilnej.
🔗 Ogłoszenie @antigravity · Strona modeli Antigravity
W skrócie
Agenci i narzędzia programistyczne
- Claude Code 2.1.303 — Opublikowana 18 października wersja ma jednowierszowe informacje o wydaniu: poprawki błędów i ulepszenia niezawodności, bez listy naprawionych problemów; SDK Agent dla TypeScript otrzymuje wersję 0.3.303. 🔗 źródło
- Qwen Code v0.25.3 — Wersja stabilna następuje po wersji wstępnej opisanej 16 października, bez znanych zmian naruszających kompatybilność: 41 funkcji i 81 poprawek od v0.25.2, głównie dla Managed Agent, który wykonuje swoje narzędzia przez SSH lub w natywnym obszarze roboczym macOS i zyskuje tryb Plan. 🔗 źródło
- Copilot CLI 1.0.100 — Pierwsza wersja stabilna od 1.0.98 z 14 października nie wnosi niczego nowego: jej 49 wpisów powtarza zmiany z wersji wstępnych od 1.0.99-0 do 1.0.100-1, przedstawionych tutaj od 15 do 17 października. 🔗 źródło
- ZCode v3.16.1 — Z.ai synchronizuje repozytorium open source ZCode z wersją 3.16.1, bez wydania ani informacji o wersji; jedyną udokumentowaną nowością jest przewodnik korzystania z CLI po chińsku. 🔗 źródło
- Gemini CLI, nightly z 19 października — Bez zmian: to trzecie z rzędu wydanie nightly z tego samego commita, ponieważ od wieczora 16 października niczego nie scalono, a wersja stabilna v0.64.0 i preview v0.65.0-preview.0 pozostają bez zmian. 🔗 źródło
- Zed 1.24.3 — Jedyna informacja o tej wersji stabilnej dotyczy dodania Gemini 4 Argon do modeli Google AI, obecnego już od 14 października w wersji wstępnej 1.25.0. 🔗 źródło
- Partnerzy MCP firmy Figma — Uzupełnienie z 15 października: Figma ogłasza na Config India 20 nowych partnerów MCP, w tym Amp, Junie od JetBrains, OpenCode, Cline, Delta i Zed, ale jej lista zawiera 21 nazw i nie precyzuje ani udostępnianych funkcji, ani ich dostępności; Zed przekazał ogłoszenie 19 października. 🔗 źródło · 🔗 Zed
- Navan i agenci chmurowi Cursor — Uzupełnienie z 16 października: Cursor opisuje, jak Navan przeprowadził migrację do Spring Boot 4 (8 aplikacji, 15 bibliotek) w około tydzień, wobec ponad miesiąca dwa lata wcześniej, z pomocą agentów chmurowych działających na własnych maszynach firmy; w ciągu 30 dni 36 % PR scalonych w jej głównym repozytorium napisano z użyciem Cursor. 🔗 źródło
- Wznowienie sesji aplikacji GitHub Copilot w VS Code — Poradnik na GitHub Blog pokazuje, jak akcja Open in VS Code ponownie otwiera sesję w jej worktree, wraz z zadaniem, planem, rozmową i diffem, przed przeglądem, poprawkami, lokalnymi testami i pushem do pull requesta tej sesji. 🔗 źródło
- COOKED — OpenAI Developers uruchamia program wideo o tym, co zespół i społeczność tworzą z Codex; pierwszy odcinek (13 min 20 s) pokazuje już dostępne funkcje, od środowisk chmurowych Codex po grę o ramenie w 8 bitach zbudowaną z Ultrafast. 🔗 źródło
API, harnessy i integracje
- Agent API od Perplexity — Ustawienie
require_approvalwymaga zgody aplikacji na wywołania narzędzi MCP i konektorów przed ich wykonaniem, a preset xhigh przechodzi na 512 000 tokenów wyjściowych zamiast 128 000; Perplexity poprawia też swój wpis z 5 października, przytoczony tutaj: xhigh również używa Fast Search. 🔗 źródło - Inżynieria harnessu — Perplexity publikuje przewodnik po harnessie (harness), czyli wszystkim, co otacza model w narzędziu AI, podzielony na sześć komponentów, od pętli agenta po weryfikację; przywołuje niezależny, nienazwany test, w którym sama zmiana harnessu powodowała różnicę wyniku tego samego modelu w teście programistycznym sięgającą 11 %. 🔗 źródło
- SPACE w Crusoe — Crusoe ogłasza partnerstwo z Perplexity w celu zintegrowania SPACE, sandboxa open source firmy Perplexity, z ofertą Managed AI w Crusoe Cloud, bez daty ani ceny; Crusoe było już wśród partnerów wymienionych przy udostępnieniu kodu SPACE 15 października. 🔗 źródło
- Perplexity w Lovable — Uzupełnienie z 15 października: Perplexity dołącza, obok Claude, Firecrawl, Gemini, OpenAI, p0 i TypeSafe, do dostawców funkcji AI, które Lovable integruje z aplikacjami, oferując odpowiedzi z internetu w czasie rzeczywistym z odnośnikami do źródeł; brak ceny i szczegółów technicznych. 🔗 źródło
- Agent głosowy, który nie milknie — Przewodnik Google Developers pokazuje, jak narzędzia ADK obsługujące streaming i działanie nieblokujące zapobiegają ciszy u agenta głosowego korzystającego z gemini-3.8-live: w workflow raportowania sprzedaży czas do wypowiedzenia pierwszych słów spada z 14,4 sekundy do 1,2 sekundy, bez nowej funkcji. 🔗 źródło
- DeepSeek-V4.1-Flash-1017 w Together AI — Opisany tutaj 17 października model DeepSeek jest dostępny w Together AI „w tej samej cenie”, według dostawcy hostingu. 🔗 źródło
Otwarte modele i badania
- Muse Glimmer — Meta publikuje raport techniczny swojego otwartego modelu 30B do zadań agentowych na sprzęcie konsumenckim, wprowadzonego w sierpniu: tekst i obrazy, ponad sto języków, około 4 bitów na pojedynczym GPU, licencja Apache 2.0; według Meta model prowadzi w swojej kategorii w porównaniu z Gemma4-31B i Qwen3.6-27B, bez liczb w podsumowaniu. 🔗 źródło
- SlideOn i mSlideOn — LightOn publikuje dwa modele wyszukiwania rzadkiego (sparse retrieval) wywodzące się z DenseOn i mLateOn, o 174M (angielski) i 339M parametrów (wielojęzyczny): SlideOn uzyskuje 56,68 na BEIR-15 wobec 56,20 dla DenseOn, a mSlideOn zyskuje 10,19 punktu na MLDR względem mDenseOn. 🔗 źródło
- tokenizers v1.0.0-rc.3 — Trzeci kandydat do wydania tokenizers v1 wprowadza bibliotekę do przeglądarki dzięki bindingom WebAssembly opublikowanym na npm pod nazwą
tokenizers-wasmi umożliwia ładowanie ModernBERT, NLLB oraz modeli przekonwertowanych z SentencePiece. 🔗 źródło - Transformers v5.20.2 — Wydanie z poprawkami: dane wejściowe nie tracą już swojego typu podczas generowania, co utrudniało działanie modeli multimodalnych, a gradienty ekspertów nie są już zerowe w bfloat16 przy równoległości ekspertów. 🔗 źródło
- Sortowanie promptów — We wpisie społecznościowym Abdennacer Badaoui przyspiesza vLLM, bez jego modyfikowania, o 12 do 17 % na Qwen3-30B-A3B i o 7 do 12 % na gpt-oss-120b, sortując prompty według dziedziny przed inferencją wsadową, ponieważ podobne zapytania angażują tych samych ekspertów; korzyść znika przy obsłudze online wrażliwej na opóźnienia. 🔗 źródło
- Nesso3-0.4B-Agentic — mii-llm publikuje dwujęzyczny model włosko-angielski o 0,4 miliarda parametrów do wywoływania narzędzi, na licencji Apache-2.0: 74/100 w dwujęzycznym zestawie testów autorów wobec 67 dla Qwen3-0.6B, ale 48 % wobec 84 % dla narzędzi ogólnego zastosowania w języku angielskim. 🔗 źródło
- S²-MAS i Fin-Laya — Yang Li symuluje 12 milionów agentów wybranych z 500 milionów person gospodarstw domowych, w 3 h 59 na 14 GPU, i przedstawia Fin-Laya, model podejmowania decyzji finansowych o dokładności 74,5544 % i średnim opóźnieniu 9,10 ms, wobec 206,77 ms dla Jev 1.13, według własnych pomiarów. 🔗 źródło
- BlenderWorld — Uzupełnienie z 15 października: Qwen publikuje benchmark tworzenia 3D w Blender (223 zadania, 2 651 kryteriów binarnych): wśród 13 modeli GPT-6-Astra prowadzi z wynikiem 79,9 na 100 przed Opus-5 (73,0) i GPT-5.6-Sol (67,7), Qwen3.8-Max zajmuje piąte miejsce (60,6), a lider spełnia wszystkie kryteria tylko w 42,2 % zadań. 🔗 źródło
Sprzęt, produkty konsumenckie i twórczość
- Ceny laptopów RTX Spark — Uzupełnienie informacji z 16 października: komunikat premierowy NVIDIA zapowiada dostępność laptopów RTX Spark od ASUS, Dell, HP, Lenovo, Microsoft i MSI na całym świecie od 2 599 dolarów; z kolei wpis na blogu NVIDIA z 17 października podaje cenę od 2 399 dolarów dla tych samych producentów. 🔗 komunikat · 🔗 wpis
- Grok Bot na przycisku Action — Konto @bot, należące do Grok Bot, pokazuje na filmie, że asystenta można przypisać do przycisku Action w iPhonie, podobnie jak dots OpenAI przedstawione tutaj 18 października; nie podano wersji iOS ani planu subskrypcji, nie ma też wpisu na x.ai ani udostępnienia przez @SpaceXSI. 🔗 źródło
- Chroma Awards, sezon 2 — ElevenLabs otwiera drugi sezon konkursu twórczości z użyciem sztucznej inteligencji, który, jak podaje, objął inkubacją: pięć kategorii, 1 milion dolarów na testy i ponad 450 000 dolarów w nagrodach; wpis podaje termin zakończenia na 1 stycznia 2027, a następnie na 7 stycznia w warunkach udziału, przed ceremonią 11 lutego 2027. 🔗 źródło
GitHub, poza sztuczną inteligencją
- Klonowanie przez HTTPS z uwierzytelnieniem — W okresach nietypowego natężenia ruchu GitHub może tymczasowo wymagać uwierzytelnienia przy niektórych operacjach
git cloneigit fetchprzez HTTPS na publicznych repozytoriach; nie dotyczy to SSH, operacji push ani operacji z uwierzytelnieniem, a do ciągłej integracji GitHub zalecaGITHUB_TOKENlub token GitHub App. 🔗 źródło - CodeQL, Xcode 27 i Swift 6.4 — Z powodu braku kodu
x86_64w niektórych systemowych plikach binarnych Apple CodeQL nie śledzi już buildów z Xcode 27 i nie obsługuje Swift 6.4 na żadnej platformie; obsługa komputerów Mac z procesorami Intel zostanie oznaczona jako przestarzała w połowie grudnia, a GitHub zaleca przypięcie wersji macOS 26 i Xcode 26. 🔗 źródło
Co to oznacza
MiniMax i Black Forest Labs rywalizują na tym samym polu: przede wszystkim szybkości i kosztu zadania, a w mniejszym stopniu samej jakości. M3.1 Flash przekracza 200 tokenów na sekundę na wyjściu, obniża koszt wykonywania zadań agentowych o 70 % i kosztuje 0,15 dolara za milion tokenów wejściowych; FLUX 3 Max renderuje wideo o długości 10 sekund w 12,45 sekundy, za 0,0425 dolara za sekundę do 7 listopada. Deklarowana jakość dorównuje najlepszym modelom, ale ich nie przewyższa: FLUX 3 Max zajmuje ex aequo pierwsze miejsce w rankingu, w którym MiniMax H3 wyprzedza go o dwa punkty, co mieści się w marginesie niepewności, a M3.1 Flash według deklaracji twórców zajmuje pierwsze miejsce wśród chińskich modeli w dwóch benchmarkach agentów. Model MiniMax sprawdzono też w rzeczywistych warunkach: Space Bunny przetworzył ponad 200 000 miliardów tokenów bez ujawniania swojego pochodzenia, a jego wstępna wersja przez dwanaście dni pozostawała na czele rankingu OpenCode według MiniMax. Wszystkie te liczby nadal pochodzą od dostawców, a ranking Artificial Analysis jest wciąż wstępny.
Dotrenowywanie staje się pełnoprawnym produktem. fal nie stworzył FLUX 3 Max od zera: zaadaptował i zoptymalizował FLUX 3 firmy Black Forest Labs, tak jak wcześniej przekształcił MiniMax H3 w swój H3 Max; według fal dotrenowywanie poprawiło wynik modelu o 50 punktów Elo, a prace nad inferencją przyspieszyły generowanie około dziesięciokrotnie. Together AI sprzedaje teraz tę możliwość swoim klientom, którzy piszą własną pętlę treningową, SFT lub RL, dla otwartych modeli, a TorchNeuron udostępnia układy Trainium od AWS zwykłym skryptom PyTorch korzystającym z Transformers i TRL. Na drugim końcu łańcucha następuje koncentracja treningu wstępnego: Prometheus stawia sobie za cel milion GPU, a większość wpisu Meta dotyczy niezawodności, z 8 zapasowymi GPU na szafę i ograniczeniem przerw o 99 %. MARBLE mierzy się z tym samym problemem skali po stronie oprogramowania, dla sekwencji liczących wiele milionów tokenów.
Agenci zyskują też zabezpieczenia administracyjne: kto może co uruchomić, z jakim budżetem i po uzyskaniu jakiej zgody. Devin samodzielnie podnosi limity inżynierom, których uzna za efektywnych, a pozostałych odsyła do administratora; Perplexity udostępnia każdy konektor wybranym rolom, a jego Agent API może wstrzymać wywołanie MCP do czasu uzyskania zgody aplikacji; toolsets OpenAI pozwalają aplikacji potwierdzać zmiany i ograniczać liczbę kroków; Vibe CLI 3.0.0 daje administratorom flagę wyłączającą serwery MCP. Amp z kolei pracuje w Linear w imieniu osoby, która przypisuje mu issue: agent zadomawia się w narzędziach zespołu i działa przy użyciu połączenia z Linear poszczególnych użytkowników.
Wreszcie jesień przynosi deweloperom kolejną porcję migracji. GPT-4o i GPT-4.1 znikną z API OpenAI 14 stycznia 2027, a modele syntezy mowy tts-1 i gpt-4o-mini-tts już 6 stycznia; daty te widnieją wyłącznie na stronie dotyczącej wycofywanych funkcji: śledzenie tylko changelogu API nie pozwala ich zauważyć. W przypadku Trainium Hugging Face zaleca przejście z Optimum Neuron na Transformers i TRL na TorchNeuron. Z kolei Vibe CLI 3.0.0 wymaga Python 3.14, bardziej rygorystycznie weryfikuje certyfikaty i nie otwiera już ponownie sesji Vibe 1.x, co może zaskoczyć osoby aktualizujące bez czytania informacji o wydaniu.
Źródła
- MiniMax M3.1 Flash (wpis MiniMax)
- Przypięta zapowiedź M3.1 Flash (@MiniMax_AI)
- Zapowiedź FLUX 3 Max (@bfl_ai)
- FLUX 3 Max (fal)
- Wycofywane funkcje (dokumentacja API OpenAI)
- Wewnątrz Prometheus: droga Meta do superklastra o mocy gigawata (Engineering at Meta)
- MARBLE, pakowany multimodalny mechanizm uwagi (Luma)
- Together Post-Training (Together AI)
- TorchNeuron: uruchamianie modeli HF na AWS Trainium jest łatwiejsze niż kiedykolwiek (blog Hugging Face)
- Toolsets computer use i browser use w SDK (@kevinwhinnery)
- Przewodnik po Computer use (dokumentacja API OpenAI)
- Changelog produktu z 19 października (Perplexity)
- Natywne tworzenie modeli dla urządzeń brzegowych z LiteRT Tensor API (Google Developers)
- Kontrola kosztów oparta na efektywności (Devin)
- Przypisz to Amp (Amp)
- Vibe CLI 3.0.0 (GitHub)
- Gemini 4 Argon w Google AI Pro (@antigravity)
- Modele Antigravity (dokumentacja)
- Claude Code 2.1.303 (GitHub)
- Qwen Code v0.25.3 (GitHub)
- Copilot CLI 1.0.100 (GitHub)
- Synchronizacja ZCode v3.16.1 (GitHub)
- Gemini CLI v0.66.0-nightly.20261019 (GitHub)
- Zed 1.24.3 (GitHub)
- Nowi partnerzy MCP Figma (@figma)
- Udostępnienie przez Zed (@zeddotdev)
- Studium przypadku Navan (Cursor)
- Wznawianie sesji aplikacji GitHub Copilot w VS Code (GitHub Blog)
- COOKED, odcinek 1 (@OpenAIDevs)
- Changelog API Perplexity
- Harness engineering (Perplexity)
- SPACE w Managed AI (@CrusoeAI)
- Perplexity w Lovable (@perplexitydevs)
- Agent głosowy ADK, który nigdy nie milknie (Google Developers)
- DeepSeek-V4.1-Flash-1017 na Together AI (@togethercompute)
- Muse Glimmer 30B: model agentowy działający na urządzeniu (Meta)
- SlideOn i mSlideOn (blog Hugging Face)
- tokenizers v1.0.0-rc.3 (GitHub)
- Transformers v5.20.2 (GitHub)
- Sortuj swoje prompty (blog Hugging Face)
- Nesso3-0.4B-Agentic (blog Hugging Face)
- S²-MAS (blog Hugging Face)
- BlenderWorld (GitHub)
- Premiera komputerów PC RTX Spark (komunikat NVIDIA)
- Imprezy z okazji premiery RTX Spark (blog NVIDIA)
- Grok Bot na przycisku Action (@bot)
- Chroma Awards, sezon 2 (ElevenLabs)
- Niektóre operacje Git przez HTTPS mogą tymczasowo wymagać uwierzytelnienia (GitHub Changelog)
- Zmiany w CodeQL dotyczące macOS 27, Xcode 27 i Swift 6.4 (GitHub Changelog)