ai-powered-markdown-translatorgpt-6.1-solでフランス語から日本語に翻訳された記事。
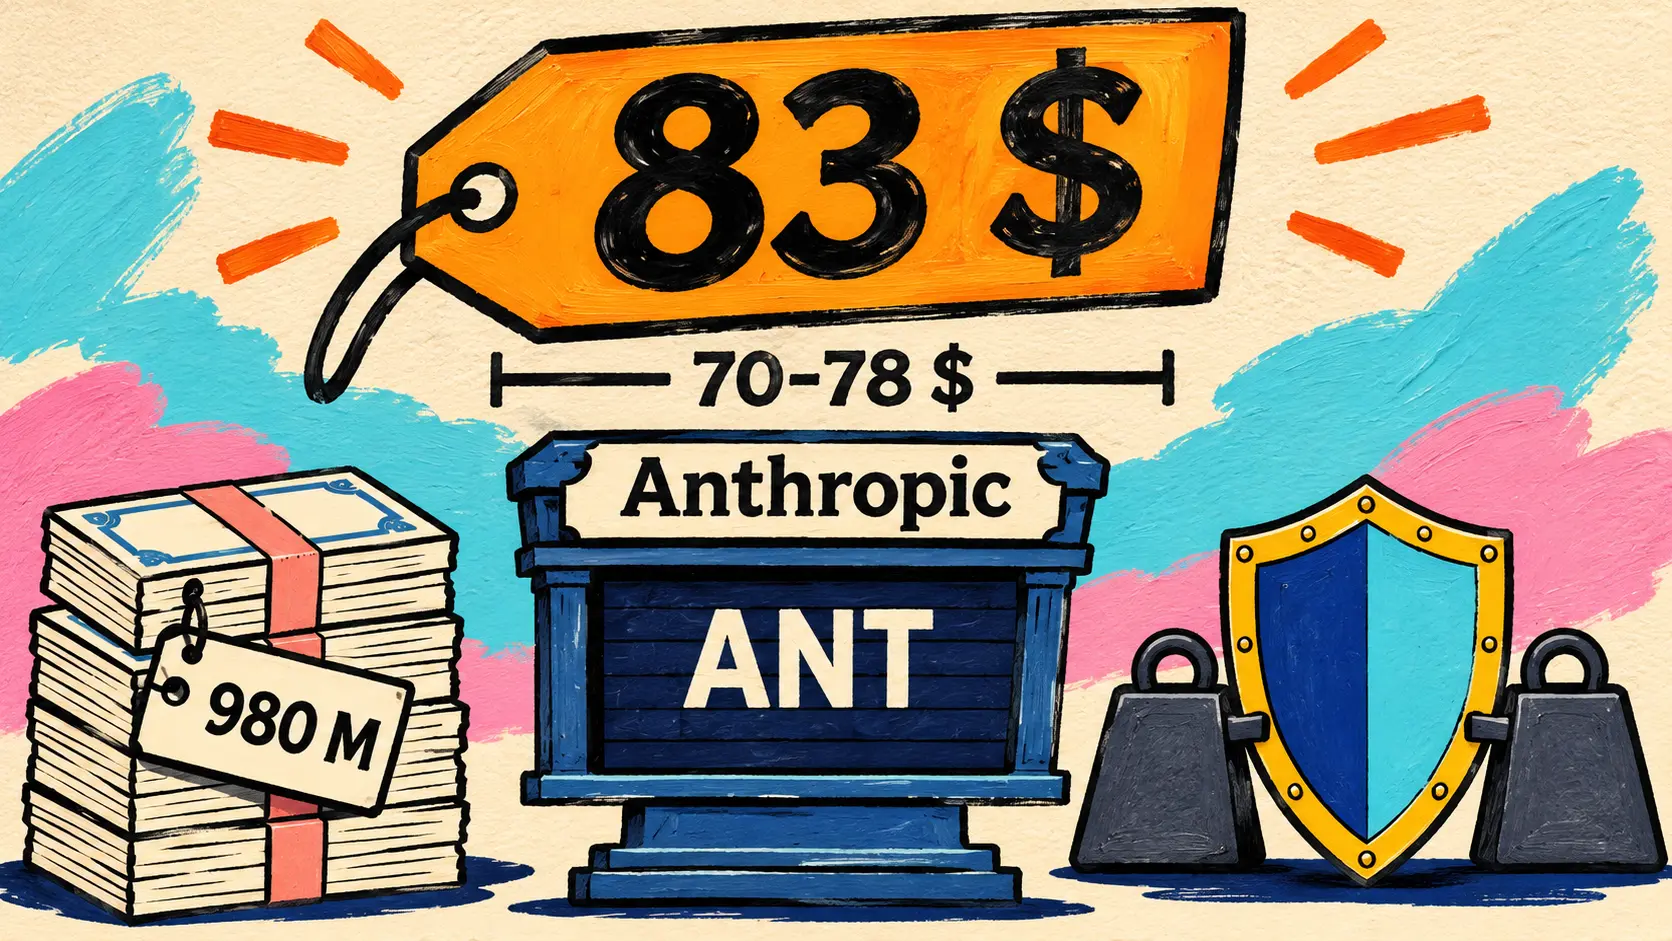
Anthropicは新規株式公開価格を1株83ドルに設定した。当初の想定価格帯である70~78ドルを上回り、公開株数は9億8,000万株に拡大した。Nasdaqに銘柄コードANTで上場する予定だ。OpenAIはエージェントによる研究加速について新たな測定結果を公表し、2~4時間かかるタスクの46 %をエージェントが単独で完了できるようになったと報告した。また、CodexエージェントがChatGPTの速度低下を調査する仕組みも紹介している。Ideogram 4.6はネイティブ4Kで画像を生成し、Gemini 4 NeonはCursorBench 4.1で首位に立ち、GitHub Copilotにも登場した。Genie 4は1秒当たり約0,10ドルで開発者向けに提供され、Mac版Geminiアプリにはコンピューターを操作する機能が加わった。
金融:Anthropicが新規株式公開価格を1株83ドルに設定
11月18日 — AnthropicはクラスA株の新規株式公開価格を1株83ドルに設定した。11月10日の投資家向け説明会(ロードショー)開始時に示した70~78ドルの想定価格帯を上回った。公開規模も拡大し、予定していた8億2,500万株から9億8,000万株となった。このうちAnthropicが956 351 354株、既存株主が23 648 646株を売却する。既存株主の売却代金は同社には入らない。引受銀行には、さらに1億4,700万株を対象とする30日間の追加購入オプションが付与されている。
| 公開条件 | 11月10日の発表 | 11月18日に決定した価格・株数 |
|---|---|---|
| 1株当たりの価格 | 70~78ドル | 83ドル |
| 公開株数 | 825 000 000 | 980 000 000 |
| うちAnthropicによる売却 | 801 351 354 | 956 351 354 |
| うち既存株主による売却 | 23 648 646 | 23 648 646 |
| 引受銀行のオプション(30日間) | 123 750 000 | 147 000 000 |
SECは11月18日に登録届出書の効力発生を認めた。Nasdaq Global Select Marketでの取引開始は11月19日、銘柄コードはANT、取引の完了は11月20日の予定だった。Anthropicは調達額も評価額も公表していない。決定した価格に基づくと、同社が売却する956 351 354株の総額は費用控除前で約794億ドルとなる。これは発表資料の数値から算出したものだ。フランスを含む欧州経済領域の個人投資家については、欧州向け目論見書で米国の公開価格と同一の最終価格が予定されていた。
11月19日、@AnthropicAIは短い動画を公開し、続いてDario Amodeiの文章を掲載した。Amodeiは、自身とDaniela Amodeiの父親が、数年後には治療可能になった病気で亡くなったことを振り返っている。十分に強力なAIが人間と協働すれば、科学と医療の1世紀分の進歩を10年に圧縮できる可能性があるという。ただし、現時点での成果はまだ予備的な段階にあるとも述べた。個人や国家による悪用、経済の激変、システムの制御喪失というリスクも挙げている。モデルの安全性を確保し、人間の管理下に置き続けるため、必要な限り訓練と展開のペースを調整すると約束した。
We will not bend to either business or political pressure.
🇯🇵 私たちは商業的な圧力にも政治的な圧力にも屈しません。 — Xの@AnthropicAI
Dario Amodeiは、この上場によって同社の財務基盤が強化され、それとともに決意も強まると述べ、「高みを目指す競争」(頂点への競争)という考えを改めて示した。
🔗 新規株式公開価格の発表(Anthropic) · Xの@AnthropicAI:公開価格の決定
OpenAIで働くエージェント:研究加速の報告書とPerformance Factory
11月18日 — 最初の報告書から2カ月後、OpenAIは自社のエージェントが研究をどのように加速しているかについて、新たな測定結果を公表した。題名が結論を要約している。能力の最前線は不均一だ(でこぼこの最前線)。人間なら2~4時間かかると見積もられたタスクを、エージェントが介入なしで完了できた割合は、3月から10月にかけて23 %から46 %に上昇した。4~8時間のタスクでは13 %から35 %となった。結果は作業内容によって大きく異なる。訓練の監視では成功率79 %、技術的な質問への回答では72 %だが、推論とサービングのコード作成では25 %にとどまる。OpenAIは、モデルの変化と同時に、割り当てられるタスクも変化した可能性があると指摘している。
| OpenAIの内部指標 | 公表値 |
|---|---|
| 支援なしでの成功率、2~4時間のタスク | 3月は23 %、10月は46 % |
| 支援なしでの成功率、4~8時間のタスク | 3月は13 %、10月は35 % |
| 研究者1人・1日当たりのエージェント費用の中央値 | 10月は2 400ドル(+62 %) |
| 費用の90パーセンタイル値 | 10月は23 000ドル(+105 %) |
| 研究者1人・1日当たりのエージェント稼働日数 | 0,5から5,7 |
| 安全性とアラインメントに費やした記録上の時間 | 1月から9月にかけて+77 % |
| OECI指数におけるOpenAIの最先端モデル | 年間+16,4ポイント、Epochの観測値は14 |
費用はAPIの定価で計算されており、研究者に利用枠の制限はない。研究者1人当たりのエージェント稼働時間は11倍になった。10月中旬には、追跡対象の研究者の3分の2以上が、1日の利用のピーク時に少なくとも4つのエージェントを同時に動かしていた。9月には、この利用額が研究組織の株式報酬を除く報酬総額の約2倍に相当した一方、社内での運用が占める計算資源は、研究向け全体のわずか2 %だった。
報告書はアイデアの出所も追跡している。GPT-6.2 Astraでは、事前学習の研究者がCodexとの対話を通じて一部のアイデアを発展させ、そのうち1人は重要な着想をCodexから得たと評価した。一方、GPT-6 Astraのアイデアはすべて人間によるものだった。GPT-5.2より優れたコーディングエージェントを3カ月間利用できるなら、調査対象の研究者は中央値で、チームの人員の40 %または計算資源の30 %を手放してもよいと回答した。聞き取りでは限界も挙げられている。研究アイデアを見極める力が弱い、コードの品質が低い、不要な手順を経由して遠回りするといった問題があり、人間による綿密な監督が必要になる。
安全性とアラインメントに費やす時間は、すべての分野の中で絶対量の増加が最も大きく、7月のHugging Faceの事案後に増加傾向が強まった。OpenAIはまた、Epoch Capabilities Indexから派生した指数であるOECIも導入した。この指数では同社のモデルがEpochの指数よりも高く評価されるが、同社によれば、おそらくベンチマークの構成の違いが原因だという。さらに、AIが将来のシステムの開発を加速する過程である再帰的自己改善(再帰的自己改善、RSI)の指標を、研究機関に追跡・公開させるべきだとの見解を示した。ただし、この公表を完全なRSIを目指す意図の表明と受け取るべきではないとしている。報告書は、これらの数値を一部が自己申告に基づく、限定的な実態の把握として位置づけている。
🔗 研究の加速:不均一な最前線(OpenAI) · Xの@OpenAI
OpenAIがPerformance Factoryの詳細を公開、CodexエージェントがChatGPTの速度低下を調査
11月19日 — OpenAIのエンジニアリングブログは、エージェントに任せる作業の具体例としてPerformance Factoryを紹介した。これはCodexエージェントがChatGPTの性能低下を追跡する、クラウド上の自律システムだ。アラートによってタスクが作成され、あるエージェントが原因を突き止め、別のエージェントが修正案をプルリクエストとして提出する。エンジニアがマージを判断し、展開後にはエージェントが指標の正常化を確認する。この最初のワークフローは3カ月余りで1 700件以上の調査を追跡し、600件以上で原因を特定した。1日当たり17件の調査を自動化したことになる。
チームのノウハウは共有スキルperf-forensicsにまとめられ、30以上の性能分析ツールの中からどれを使うかをCodexに指示する。エージェントが最初のもっともらしい説明で調査を止めないよう、別のCodexセッションが各診断の反証を試みる。人手で見直した100件の原因分析のうち、70 %が正確と判断された。OpenAIは、修正が依然として最も難しい段階だと認めている。また、性能低下の事前検出や、リスクの低い修正を人間の介入なしで展開する仕組みを検討しているが、時期は示していない。
🔗 OpenAIのPerformance FactoryがChatGPTの速さを維持する仕組み · @OpenAIDevsのスレッド
画像・動画生成:Ideogram 4.6はネイティブ4K、Kling 4.0は4Kと10ビットHDRに対応
11月19日 — Ideogramは、拡大処理(アップスケーリング)なしで直接4K画像を生成する新モデルIdeogram 4.6を公開した。肌から布地まで、すべての細部をフル解像度で生成する。Ideogramによれば、画像の「AIらしさ」やろうのような肌の質感を取り除くことに取り組み、毛穴や小じわ、自然な質感を表現できるようにしたという。電子商取引や商品写真を想定し、色や素材の再現性も大幅に向上したとしている。
編集機能は引き続きモデルの中核だ。変更領域の外で生じるピクセルのずれ(ピクセルドリフト)が大幅に減り、スケッチからの生成も元の絵により忠実になった。Ideogramは、4.6がRapidataの複数段階の画像編集(Multi-step Image Edit)ランキングで、Seedream 5.5やFLUX 3 Imageを含むすべてのモデルを上回って首位になったと述べているが、スコアは示していない。4.5もすでに11月10日、Rapidataの連続画像編集ランキングで首位を獲得したと発表していた。
| Ideogram 4.6の利用方法 | 発表内容 |
|---|---|
| IdeogramのアプリとAPI | 11月19日から利用可能 |
| 提携プラットフォーム(12) | Leonardo、Runway、fal、Comfy、Runware、Scenario、Invideo、MyDesigns、Sociaro、Moda、HeyGen、Luma |
| 料金 | 発表に料金の記載なし |
| オープンウェイト | 4.6のオープン版を提供予定、時期は未定 |
オープンウェイトについては、Ideogramが方針を変更した。9月30日から「近日公開」としていた4.5のウェイトについて問われると、4.5を飛ばして4.6のオープン版に直接進むと回答したが、日程は示していない。Ideogram 4.0のウェイトは6月3日に公開されていた。
We’ll skip 4.5 open and go directly to 4.6 open.
🇯🇵 4.5のオープン版は見送り、4.6のオープン版に直接進みます。 — Xの@ideogram_ai
Kling 4.0がネイティブ4Kと10ビットHDR出力に対応
11月19日 — 動画でも同様の動きがあった。Klingは、Kling 4.0がネイティブ4K解像度に加え、4Kと1080pの両方で10ビットHDR出力に対応し、より細かな描写と豊かな色彩を実現すると発表した。このHDR出力は、10月15日にKling 4.0が全面提供となった際、日程を示さず「近日対応」と予告されていた。Kling 3.0はすでに4月23日からネイティブ4K生成に対応していた。今回の発表は1件の投稿のみで、ブログ記事、リリースノート、クレジット料金、最大生成時間、APIの詳細はいずれも示されていない。
CursorとGitHub CopilotにGemini 4 Neonが登場:CursorBench 4.1で首位、Pro+、Max、Business、Enterpriseで利用可能
ここで11月18日に取り上げたGoogleによる公開から数時間後、Gemini 4 Neonがサードパーティーのコーディングツールにも登場した。CursorとGitHub Copilotは11月18日夜から提供を開始し、GensparkとAntigravity CLIも19日に続いた(短報を参照)。
CursorがGemini 4 Neonを提供開始、Extra High設定でCursorBench 4.1の首位となる65,4 %を記録
11月18日 — Cursorによれば、Gemini 4 Neonはデフォルトの推論努力設定で、CursorBench 4.1におけるコストと性能の最前線を更新した。スコアはGemini 4 Hydrogenの57,3 %に対して63,7 %となり、日常的なエージェントによるコーディングではHydrogenに代わるモデルとなる。最も難しいタスクには引き続きGemini 4 Carbonが推奨される。CursorBench 4.1は同日付の新しいベンチマークで、指示追従に関する問題が変更され、エージェントに与える時間も延長された。このため、11月初旬にCarbonとHydrogenについて公表されたCursorBench 4.0のスコアとは比較できない。
| モデルと推論努力設定(CursorBench 4.1) | スコア | タスク当たりの平均費用 |
|---|---|---|
| Gemini 4 Neon Extra High | 65,4 % | 10,67ドル |
| Gemini 4 Neon High | 63,7 % | 6,54ドル |
| Gemini 4 Carbon High | 61,5 % | 8,52ドル |
| Gemini 4 Hydrogen Extra High | 61,4 % | 8,09ドル |
| Claude Fable 5.2 Max | 61,3 % | 48,11ドル |
| Gemini 4 Carbon Medium | 60,4 % | 7,22ドル |
| Claude Fable 5.2 Extra High | 58,8 % | 17,84ドル |
| Claude Opus 5.5 Max | 58,1 % | 11,88ドル |
| Gemini 4 Neon Medium | 57,7 % | 3,07ドル |
| Gemini 4 Hydrogen High | 57,3 % | 4,57ドル |
Cursorでは、Neon(gemini-4-neon、コンテキストは200Kトークン、最大1M)の料金は100万トークン当たり入力3ドル、キャッシュ読み取り0,15ドル、出力15ドルとなる。他のサードパーティーモデルと同様、プランに含まれる利用枠の対象にはならず、The X Subscriptionの前払いクレジット、または旧Cursorプランの「Other Models」枠から差し引かれる。
🔗 XでのCursorの発表 · CursorBenchの比較表(Cursor)
GitHub CopilotでGemini 4 Neonの提供開始、Pro+、Max、Business、Enterpriseが対象
11月18日 — GitHubはCopilotでGemini 4 Neonの一般提供を開始し、エージェントによるコーディング、複数の手順にわたるツールの使用、知的作業向けに設計されたモデルとして紹介した。変更履歴ではGoogleの説明を踏襲している。タスク当たりのトークンコストを抑えながらGemini 4 Carbonに近い品質を実現し、応答の開始が速く、要求されていないコード変更や、ツールやテスト結果についての根拠のない断言が少ないという。ただし、裏付けとなる数値は示されていない。
NeonはCopilot Pro+、Max、Business、Enterpriseの加入者が利用できる。Proプランへの言及はないが、Gemini 4 Hydrogenは11月13日の時点で同プランに導入されていた。VS Code、Visual Studio、Copilot CLI、コーディングエージェント、GitHub Copilotアプリ、github.com、GitHub Mobile、JetBrainsの統合開発環境、Xcode、Eclipseの10の環境で動作する。提供元の標準価格による従量課金で、段階的に展開される。企業では、新しいモデルを既定で有効にする設定が維持されている限り、管理者がこのモデルを無効にしないかぎり自動的に有効になる。
🔗 GitHub CopilotのGemini 4 Neon(変更履歴) · Xの@github
コーディングエージェント:Claude Code 2.1.328、Kimi Code 2.7.0、Devin Security Threats、Devin for Databricks Migrations、ReplitのAmuseとOptimization-Bench
Claude Code 2.1.328、外部プロバイダーのOpus 4.6とSonnet 4.6に自動モードを開放、/code-reviewをバグ中心に変更
11月19日 — Claude Code 2.1.328の変更項目は144件で、うち91件が不具合修正。Amazon Bedrock、Google CloudのAgent Platform、Microsoft Foundry、Claude appsゲートウェイでClaude Opus 4.6とSonnet 4.6の自動モードが利用可能になった。これらの環境で権限モードを指定せずに対話セッションを開始すると、直接、自動モードで起動し、設定disableAutoModeで無効にできる。11月19日時点では、権限モードのドキュメントには、これらのプロバイダーで自動モードを利用できるのはSonnet 5以降、Opus 4.7以降、Haiku 5.5、Fableの各モデルに限られると、まだ記載されていた。
コマンド/code-reviewは、ほとんどのモデルでバグとCLAUDE.mdからの逸脱だけを報告するようになった。コードの整理(再利用、簡素化、効率化)は/simplifyで行い、各指摘には「重要」「既存」「軽微」のいずれかが付く。10月8日にコマンドフックとHTTPフックへ追加された失敗時のブロック機能("onFailure": "block")が、mcp_toolフックにも拡張された。Anthropic APIを使うターミナル環境では、小型高速モデルがサブエージェントの進捗要約を作成するようになった。Code Modeの変更は22件で、自動モードとバイパスモードで大半のスクリプト実行後に入っていた0,75秒の待機を削除したことなどが含まれる。セルフホスト型ランナーの変更は26件。Bedrock、Agent Platform、Foundryでサブエージェントの推論強度を無効にしていた2.1.327の回帰不具合も修正された。安定版チャンネルは2.1.311のまま。
Kimi Code 2.7.0がAmazon Bedrockに対応、Kimi Code Desktop 1.4.0はClaude Code、Codex、Cursorと連携
11月19日 — Moonshot AIは、11月12日の2.6.0以来となるマイナーバージョン、Kimi Code 2.7.0(変更24件)を公開し、その13分後にKimi Code Desktop 1.4.0(変更34件)を公開した。CLIはAmazon Bedrockのプロバイダーに対応し、各ターンの後に次のプロンプトの予測を試験的に表示する。また、「フォローアップの動作」設定が追加され、Steerモードでは、メッセージをキューに入れる代わりに、Enterキーで進行中のターンの方向を修正できる。自動化向けには、kimi serverでブラウザーを開かずにローカルサーバーを起動でき、新たに3つのHTTPエンドポイントでセッションを操作できる。プロジェクトごとに接続先のSSHホストを指定できるようになった。従来の/api/v2エンドポイントは廃止され、/api/v1に置き換えられたが、このAPI変更は単なる不具合修正に分類されている。
デスクトップアプリはClaude Code、Codex、Cursorなどの外部エージェントと接続し、セッションの引き渡し、履歴の確認、ターンをまたいだ連携を行える。また、プロバイダーにQwen Coding Planが追加された。
🔗 Kimi Code 2.7.0 · Kimi Code Desktop 1.4.0
CognitionがDevin Security Threatsを公開、公開直後の脆弱性をワンクリックでスキャンできる管理型インデックス
11月19日 — CognitionはDevin Securityに、公開直後の脆弱性を集めた管理型インデックスを追加した。同社が取り上げたのは、今週発表された2件の脆弱性。Javaの実行環境に影響するJava4Shell(11月17日)と、nginxの5件のメモリ破損バグからなるNGINX2Root(11月18日)で、いずれもリモートコード実行につながる可能性がある。各脅威には、影響を受ける対象、攻撃者が悪用する方法、修正方法が記載される。Cognitionは主要な脆弱性公開に関する脅威情報を掲載し、各チームもバグ報奨金制度の報告、ベンダーの勧告、インシデントの振り返りから独自の脅威情報を作成できる。
「Devinでスキャン」ボタンを押すと、選択したリポジトリでその脅威に絞ったスキャンを実行し、Devinがレビュー用のプルリクエストを作成する。自動トリアージモードでは、指定した重大度以上の新しい脅威が公開されるたびに、選択したリポジトリをDevinが再スキャンする。Markdownで記述されたオープンソースの2つのスキル、fix-nginx-vulnとfix-java-vulnがDevin MarketplaceのVulnerability Fixesプラグインに追加され、ほかのコーディングエージェントでも利用できる。料金は発表されていない。
🔗 Devin Security Threats(Cognition) · Xの@cognition
CognitionがDevin for Databricks Migrationsを公開、従来のデータウェアハウスをDatabricksへ移行
11月19日 — CognitionはDatabricksと共同で、移行専用のサービスを開始した。Devinは従来のデータウェアハウス(Teradata、Oracle、SQL Server、Informatica、Redshift、Snowflake)のコードを変換し、顧客のワークスペースでテストし、失敗を修正する。切り替え前には、各移行元とDatabricks上のコピーを、スキーマ、行数、集計値、最後に行単位で照合する。Cognitionによると、Fortune 500に入るエネルギー企業は142オブジェクトのプラットフォームを8日でUnity Catalogへ移行し、コンサルティング会社のZebは4週間を予定していたNetSuiteの移行を2週間半で完了した。
このサービスはDatabricks Marketplaceで提供され、Databricksとすでに契約済みの利用額コミットメント(Universal Commit)に充当できる。Cognitionはまた、Databricksを戦略的な推論プロバイダーとして利用し、単一のエンドポイントからオープンソースモデルと最先端モデルを提供しているという。価格は公表されていない。
🔗 Devin for Databricks Migrations(Cognition)
ReplitがAmuseを公開、Missionsが3日で再構築したオープンソースの個人用アシスタント
11月19日 — ReplitはTernSignに続き、エージェント群の実行基盤であるMissionsによる新たな成果を紹介した。Amuseは、ユーザーのコンピューターで動作するオープンソースの個人用AIアシスタント(Apache 2.0)。Replitによると、エージェント群には、名前を明かしていない「定番のAIアシスタント」を再現する課題が与えられ、3日で達成した。その後、プラットフォームのSecurity Scannerを使い、検出された脆弱性を修正した。
Amuseは出典付きのウェブ検索を行い、動作を観察して手動操作に切り替えられるブラウザーを操作し、リマインダーやバックグラウンドタスクを管理し、小規模なアプリを作成する。記憶は読める形式のファイルに保存され、認証情報は暗号化された保管庫に格納され、モデルには代理トークンだけが見える。送信、フォームの送信、支払い、新たなスケジュール設定の前には承認を求める。「無料」はモデルの利用費を除いた意味で、OpenAIのAPIキー(エージェントにはGPT-6.2 Sol、短時間の処理にはGPT-6 Luna)とPostgreSQLデータベースが必要になる。利用は1台のコンピューター上の1人に限られ、MCPサーバーには対応していない。
🔗 XでのReplitの発表 · replit/amuseリポジトリ
ReplitがOptimization-Benchを公開:単独で最も優秀なエージェントが、最も優秀なエージェント群になるとは限らない
11月19日 — Replitの研究チームは、バージョンを固定したオープンソースライブラリを対象とする性能最適化ベンチマーク、Optimization-Benchを公開した。14件のうち、NumPy、SQLite、SQLGlot、Gitの4件を分析している。6つのモデルが単独で、その後は8、16、32エージェントの群で、それぞれ2時間作業した。評価はエージェントがアクセスできないマシンで実行された。
| Optimization-Benchの指標 | Replitが公表した結果 |
|---|---|
| NumPyでのGPT-6.2 Astra単独実行 | Opus 5.5単独の3倍超の速度 |
| 32エージェントのGPT-6.2 Astra群 | 4タスク中3タスクで単独時のスコアを下回る |
| OpusとSonnet 5.5のエージェント群による向上の中央値 | 16、32エージェントで単独時のスコアの1,30倍 |
| Opus 5.5が共有ボードに送ったメッセージの割合 | 82 % |
GPT-6.2 Astraは単独では圧倒的だが、エージェント群の性能は8エージェントで頭打ちになる。一方、Claude Opus 5.5とClaude Sonnet 5.5のエージェント群は、毎回、単独実行を上回った。NumPyでは、Opusは単独の3,7倍から32エージェント群の18,9倍へ伸びた。この数値はMissionsの公開時にも示されていた。Replitは、この差を組織運営に帰している。効率的なチームは共有ボードに書き込み、調整役に作業の配分と統合を任せる(32エージェントによるOpusのNumPy群では、調整役は作業担当のエージェントに一度も直接メッセージを送らなかった)。一方、ほかのチームは調整役を中継窓口にしてしまい、エージェントが増えるたびにその受信箱が膨らむ。
🔗 問題解決に人数を投入する(Replit) · Xの@Replit
一般向けアシスタント:Mac版Geminiのcomputer use、Android、デスクトップ、dots、サイトへのChatGPT Health展開
Mac版Geminiアプリ、computer useでアプリとウェブをバックグラウンド操作
11月19日 — Mac版Geminiアプリが、ユーザーに代わってコンピューターを操作する機能(computer use)に対応した。Geminiはローカルファイル、デスクトップアプリ、ウェブをまたいで、クリック、入力、メニュー操作、フォーム入力など、複数の手順からなるタスクを続けて実行する。バックグラウンドの隔離されたウィンドウで作業し、会話内にリアルタイムのプレビューを表示するため、メイン画面とカーソルは自由に使える。ユーザーはアクセスを許可するアプリを選び、各手順を確認し、すべての操作を一時停止できる。重要な操作は実行前に承認する。
Googleが挙げる例は、写真の一括編集、ローカルのPDFからの配送見積もりフォーム入力、ダッシュボードを基にしたGoogle Slidesのプレゼンテーション作成など。Xで公開された動画では、スケッチからBlenderでアニメーション可能な3Dモデルを作成している。この機能は米国のGoogle AI Plus、Pro、Ultra加入者向けに英語で順次展開され、macOS Sequoia 15.0以降を搭載したApple SiliconのMacと、18歳以上の個人用Googleアカウントが必要になる。開発者向けには、Gemini APIのComputer Useツールが10月末から一般提供されている。今回、一般向けアプリでもユーザーのMacを操作できるようになった。
🔗 Mac版Geminiのcomputer use(Google) · Xの@GeminiApp
ChatGPT、HealthをHealth Connect連携のAndroid、デスクトップアプリ、dots、サイトへ拡大
11月19日 — ChatGPTのHealthスペースが、デスクトップアプリ、dots、サイト、Androidに対応する。AndroidではHealth Connectに接続し、睡眠や活動の傾向を読み取る。ChatGPTの個人用エージェントであるdotsは、会議がトレーニングと重なったときに別の時間帯を自発的に提案したり、接続した医療記録を基に予防の選択肢を知らせたりできる。コンピューター向けには、OpenAIはマラソンの準備状況を追跡するサイトの作成例を紹介している。展開は段階的で、米国のFree、Go、Plus、Proプランが対象。dotsは引き続きProプラン限定となる。Healthはサイドバー、または「探索」メニューから利用できる。
Gemini API:Genie 4を開発者に開放、Tool Retrievalはプレビュー提供
Genie 4がGemini APIとGoogle AI Studioに登場、生成する世界の1秒当たり約0,10ドル
11月19日 — Google AI Ultra加入者向けのProject Genieに登場した翌日、Genie 4が開発者向けに、Interactions API経由のGemini APIとGoogle AI Studioで利用可能になった。対話型キャンバスと開発の出発点となるアプリも用意される。このワールドモデルは、テキスト、参照画像、またはその両方から、環境音から会話まで同期した音声を伴う、連続的に展開する環境を生成する。キーボードで移動でき、途中で天候、照明、物体、出来事をテキストで変更できる。
| APIでのGenie 4の仕様 | ドキュメント記載値 |
|---|---|
| モデル識別子 | models/genie-4 (Interactions API) |
| 映像と音声の出力 | 1280x720, 16:9, 24 images/s, ステレオ音声48 kHz |
| アクセス | 有料枠のAPIキー |
| 課金 | 1フレーム当たり240動画トークン、1秒当たり約0,10ドル |
| セッションの長さ | 60〜90 s後に品質低下の可能性、上限120 s |
| 提供地域 | 米国、西欧、日本 |
ドキュメントでは、タブを閉じても生成はすぐには止まらず、明示的にセッションを終了する操作(complete())だけが課金を停止すると注意している。Genie 4は3Dシーンを記憶として保持しない。物体が8秒以上視界から消えたり、その場で一周回ったりすると、目印が移動したり初期化されたりする可能性がある。すべての出力にSynthIDの電子透かしが付く。
🔗 Gemini APIのGenie 4(Google) · Genieのドキュメント(AI Studio)
Gemini APIがTool Retrievalをプレビュー公開、必要に応じてツールのスキーマを読み込み
11月19日 — GoogleはGemini APIに、OpenAIとAnthropicがすでに提供していたツール検索を追加した。Interactions APIでプレビュー提供されるTool Retrievalにより、数十から数百のツールに接続するエージェントは、リクエストのたびにすべてのツールのパラメータースキーマを送る必要がなくなる。tool_searchツールを追加し、必要になるまで待機させるツールにdefer_loading: trueを指定するだけでよい。モデルには各ツールの名前と説明だけが見え、必要になったときに名前でツールを要求する。APIは同じリクエスト内でサーバー側のスキーマ読み込みを行うため、インデックスを構築する必要はない。
この仕組みはリモートMCPサーバーにも対応する。読み込まれたスキーマは会話の後方に追加されるため、プレフィックスキャッシュも維持される。独自のツールレジストリを管理するチームは、追加の1往復が必要になるものの、自分たちの環境で検索を実行できる。Tool Retrievalに個別の料金はない。tool_searchによって少量の固定入力トークンが追加され、読み込まれた各スキーマは、その後の会話全体で入力として課金される。Googleは削減効果の数値を公表しておらず、自社のトラフィックで効果を測定するよう勧めている。この機能はGemini 3.6以降のモデルで動作し、Gemini 4の全モデルも含まれる。
🔗 Gemini APIのTool Retrieval(Google)
音声:GPT-Live-1.1がAPIに登場、待機中の料金は1分0,02ドル
11月19日 — 10月15日にChatGPT PlusとProの音声機能に導入されてから1か月余りを経て、GPT-Live-1.1がOpenAIのAPIに登場した(v1/live/sessions上のgpt-live-1.1)。このモデルは多言語の音声会話における発音、アクセントの一貫性、文字起こしを改善し、既存のLiveセッション設定に組み込める。
最も具体的な新機能は待機機能(standby)で、WebRTCセッションのGPT-Live-1とGPT-Live-1.1の両方で利用できる。5〜60秒の範囲で設定した無音時間が続くと、通話を切らずにモデルが一時停止し、誰かが再び話し始めるまで、1分当たりの料金が0,05ドルから0,02ドルに下がる。
| GPT-Liveのセッション種別 | 1分当たりの料金 |
|---|---|
| アクティブなセッション | 0,05 dollar |
| 待機中(WebRTC、推論を一時停止) | 0,02 dollar |
バックエンドのモデルとツールの利用料金は引き続き別途請求され、両バージョンの同時セッション数の上限もそれぞれ異なる。Python SDK 3.56.0とNode SDK 7.61.0でこのモデルが追加され、OpenAIは公開に合わせて言語と地域別アクセントに関するガイドも提供している。
🔗 @OpenAIDevsの発表 · GPT-Live-1.1の仕様 · 言語と地域別アクセントのためのGPT-Liveのプロンプト設計
ハードウェアとクラウド:NVIDIAとMicrosoftがIgniteで発表、RTX SparkのミニPCが発売
NVIDIAとMicrosoftがIgniteで協業を拡大、AzureのVera RubinからFoundryのNemotron 3.5まで
11月19日 — Microsoft Igniteに合わせ、NVIDIAはデイブ・サルバトール名義の記事でMicrosoftとの協業拡大を詳しく説明した。Vera Rubin NVL72システムはAzureのデータセンターで稼働しており、それを利用する仮想マシンへのアクセスが拡大している。記事ではAzure上のVera Rubinをプレビューとして紹介しており、一般提供の開始日は示されていない。
| NVIDIAとMicrosoftの発表 | 記事に記載された状況 |
|---|---|
| Vera Rubin NVL72搭載のAzure VM | アクセス拡大、プレビュー |
| Nemotron 3.5 Super、Lightning、Embed、Rerank、Parse、Content Safety | Foundry Managed Computeでラインナップ拡大 |
| Nemotron 3.5 BoltとTranscribe | 近日提供 |
| Foundry LocalのNemotron 3.5とCosmosモデル | Azure Local環境を含め、対応範囲を拡大 |
| Azure Local | RTX PRO 6000 Blackwell GPUを今後提供、Jetson ThorとJetson Orinへ拡大 |
| Windows 365のDirect Stream | 4K・60 images/sのストリームを2本、2027年初めにパブリックプレビュー |
| Microsoft DiscoveryのBioNeMoとALCHEMI | カタログに追加、RFD4-Proteinaを初めて統合 |
紹介された事例では、EYが購買記録を分類するため、Foundryのサーバーレス事後学習サービスProgrammed Trainingを使ってNemotronのオープンモデルを調整した。記事によると、同社の評価用データセットで精度が55 %向上し、費用は最先端のプロプライエタリモデルの15分の1になったという。Microsoft AIも、事後学習の強化学習におけるロールアウト(rollouts)の推論にNVIDIA Dynamoを使用している。記事は最後にAzureのMLPerfの結果にも触れている。Training v6.1ではGB200 NVL72システム上で最大10 240基のNVIDIA GPUを使用し、同ラウンドで最大規模となった。また、Signal65によると、Inference v6.1では、AzureのGB300 NVL72がDeepSeek-R1の対話型スループットで他のクラウドからの提出結果を10 %以上上回った。価格は公表されていない。
🔗 IgniteでのNVIDIAとMicrosoftの発表(NVIDIA)
ASUS、Dell、MSIのRTX SparkミニPCが発売、NVIDIAが発表
11月18日 — NVIDIAは、ASUS ProArt GR1XやMSI EdgeMesa N AI+シリーズなど、ASUS、Dell、MSIのデスクトップ型RTX SparkミニPCの販売開始を発表した。Acer、GIGABYTE、HPの製品やMicrosoft Surface RTX Spark Dev Boxも近日登場する。これらは10月発売のノートPCと同じプラットフォームを採用し、20コアのNVIDIA Graceプロセッサー、6 144 CUDAコアのBlackwell RTX GPU、最大128 Goのユニファイドメモリ、最大1ペタフロップのAI性能を備える。NVIDIAによると、1,200億パラメータのモデルをローカルで実行できるという。価格は示されていない。
ソフトウェア面では、エージェントのタスクをローカルモデルとクラウドモデルに振り分けるSwitchyardがHermesで利用可能になった。AdobeはPremiereで一般的なH.264の納品物を作成する時間を50 %以上短縮し、Windows on Armにネイティブ対応したIllustratorは、エミュレーション版より最大30 %高速になった。Blender 5.3にはDLSS 4.5 Ray Reconstructionが組み込まれる。Igniteでは、DGX Station for WindowsへのWindows Server 2028の導入と、Windows MLでllama.cppを介してHugging FaceのあらゆるGGUFモデルを実行できることも発表された。
オープンモデル:DaisyRose-27BとHermesアダプターがQwen3.8-27Bを強化、OVHcloudがOlala miniを公開、PEFT v0.22.0
RadixArkがDaisyRose-27Bを公開、RLで調整したQwen3.8-27BがTerminal-Bench 4.1のスコアを倍増
11月18日 — RadixArkは、同社初のモデルとしてDaisyRose-27Bを公開した。独自のオープンソースフレームワークMilesを使い、長時間に及ぶ約1 200件のエージェントタスクでQwen3.8-27Bを強化学習により再学習したモデルだ。各タスクは1回の試行が最長1,5時間、ツール呼び出しが100回を超えるもので、元モデルの誤りを重点的に扱うためEigent AIと共同で設計された。重みはApache 2.0ライセンスの下、BF16、FP8、NVFP4形式で公開され、ベースモデルの256Kトークンのコンテキスト長と画像理解能力を維持している。学習には144基のH200で18日間を要した。
| ベンチマーク(スコア、%) | Qwen3.8-27B | DaisyRose-27B |
|---|---|---|
| Terminal-Bench 4.1 (pass@1) | 5,6 | 12,0 |
| Terminal-Bench 2.1 | 73,0 | 75,5 |
| DeepSWE v1.1 | 42,2 | 46,2 |
| SWE Bench Pro v2 | 91,3 | 94,7 |
| GPQA Diamond | 89,2 | 90,7 |
RadixArkは、GPUの実効利用率(MFU)が37 %で、Megatronベースのオープンソース学習器の16 %を上回り、GPU時間を57 %削減したとも発表している。これらはいずれも開発元の公表値だ。
🔗 DaisyRose-27B(RadixArkの記事) · DaisyRose-27B-NVFP4(Hugging Face)
harness-hubがQwen3.8-27BのHermesアダプターを公開、思考なしでSWE-Bench Proを29,4 %から43,1 %に改善
11月19日 — harness-hubプロジェクトは、piとOpenCodeに続く3つ目のQwen3.8-27B用LoRAアダプターを公開した。今回はNous ResearchのエージェントハーネスHermes向けで、GGUF版も用意されている。
| ベンチマーク(pass@1) | Qwen3.8-27B | Hermesアダプター使用時 |
|---|---|---|
| SWE-Bench Pro(難しい51タスク)、思考なし | 29,4 % | 43,1 % |
| SWE-Bench Pro(難しい51タスク)、思考強度xhigh | 45,1 % | 51,0 % |
| Terminal-Bench 2.1、思考なし | 44,7 % | 58,8 % |
| Terminal-Bench 2.1、思考強度xhigh | 58,8 % | 57,6 % |
主な利点はトークン消費の少なさにある。思考なしのアダプターは、トークン数を3,5分の1〜4,4分の1に抑えながら、思考強度xhighのベースモデルに匹敵する。1タスク当たり10 000トークンの予算では、Terminal-Bench 2.1の51 %、SWE-Bench Proの39 %を解決する一方、xhighのベースモデルはそれぞれ28 %と0 %だった。学習手法(TRLのAsyncGRPOTrainer、OpenEnv、safeagents)の詳細は、金曜日に公開予定の記事で説明される見込みだ。
🔗 @yb2698のXでの発表 · Qwen3.8-27B-hermes-adapted(Hugging Face)
OVHcloudがOlala mini 7A1Bの重みをHugging Faceで公開、12種のベンチマークで平均スコア68,0
11月19日 — 11月17日に発表されたOlala mini 7A1Bが、Apache 2.0ライセンスの下、base、SFT、GGUF、MLXの各版でHugging Faceからダウンロード可能になった。OVHcloud初の言語モデル群の第1弾となるモデルだ。
| Olala mini 7A1Bの特徴 | 公表値 |
|---|---|
| パラメータ数 | 6,8十億個、うちトークン当たり約1十億個が稼働 |
| アーキテクチャ | Mamba-3とアテンションを組み合わせた混合エキスパート構成、全36層中7層にKVキャッシュ |
| コンテキスト長 | 32K tokens、128K版も近日登場予定 |
| 学習 | 12,8T tokens、英語とその他36言語 |
| 推定環境負荷 | 約40 tのCO2と1,16 GWh |
| 12種のベンチマーク平均 | 68,0、SFTチェックポイントより15,2ポイント高い |
このモデルは欧州の3つの公共スーパーコンピューター、JUPITER(GH200 GPU 1 024基を含む)、Jean Zay、MeluXinaで学習された。回答前に思考し、その強度は4段階から選べるほか、ツールを呼び出すための強化学習も受けている。強みは指示への追従で、弱みは数学コンテストの問題だ。
🔗 @OVHcloudのX投稿 · Olala-v1.0-mini-7A1B(Hugging Face)
Hugging FaceがPEFT v0.22.0を公開、PEFT 1.0に先立ちPaCA、Astra、NoRAを追加
11月19日 — Hugging Faceの省資源ファインチューニングライブラリがv0.22.0になった。今回追加されたPaCA(Partial Connection Adaptation)は、アダプター層を追加せず、事前学習済みの重みからランダムに選んだ入力列を直接調整する。原論文によると、同等の精度でLoRAより学習時間を22 %、メモリ使用量を16 %削減できるという。LoRAの新しい初期化手法AstraとNoRAも加わり、テンソル並列とFSDP2への対応を強化するとともに、モデルの健全性を確認する機能も追加された。PEFTは今回からPython 3.11を必須とする。リリースノートによると、次回はAPIの整理といくつかの軽微な破壊的変更を伴う1.0となり、その前にリリース候補版(release candidate)が公開される予定だ。
科学:Ai2がAstaでTheorizerを公開、論文に裏付けられた理論を提案するエージェント
11月19日 — Ai2は、科学研究向けエージェントプラットフォームAstaでTheorizerを提供開始し、Apache-2.0ライセンスの下でコードも公開した。このエージェントは文献を調べ、各論文から抽出すべき内容を定め、結果を比較して理論を組み立てる。各主張には、それを裏付ける論文への参照が付く。新規性があると判断した理論にはその旨を示す一方、検索で先行研究を見落とす可能性があるとも注意を促す。Ai2は実例として、既知のドライバー変異がない肺腺がん(症例の約20〜30 %)について、CDK2タンパク質への依存性という予備的な仮説を紹介しているが、実験室での検証が必要だ。また、1〜2件を期待していたAllen Instituteの神経科学者に対し、VIP介在ニューロンに関する理論候補を50件提示した。Astaでの利用費用は一定のトークン数までAi2が負担する。技術論文はACL 2026で発表され、12月10日にはウェビナーが予定されている。
🔗 AstaのTheorizer(Ai2) · allenai/asta-theorizerのリポジトリ
企業向けAI:Sakana AIとSalesforceが日本の公共部門向けに覚書を締結
11月19日 — Sakana AIは、日本の行政機関や地方自治体向けに、同社のAIモデルを米国企業Salesforceのソフトウェアに統合することを目指し、同社と覚書を締結したと発表した。これらの組織の行政効率化とデジタル変革に貢献することを目標に掲げ、Sakana AIは日本の公共部門のニーズに適した技術の開発を引き続き進めるとしている。日本語の投稿は時事通信の配信記事を紹介したもので、発表には日程、具体的な製品名、金額はいずれも示されていない。
短報
他のサービスにも広がるGemini 4 Neon
- Antigravity CLI 1.5.12 — Gemini APIキー(
GEMINI_API_KEY)だけで、Gemini 4 Neonの4段階すべての思考レベルを利用できるようになった。Remote Controlのブラウザー画面では複数の会話を横に並べて表示でき、従来は最大1時間かかっていた/forkも数秒で完了する。 🔗 出典 - Genspark — AI ChatとCode AgentにGemini 4 Neonが登場。Googleの説明として、思考量xhighでArtificial Analysisの総合ランキング3位、同機関のコーディングエージェント指数で1位、タスク当たりのコストは最上位モデルより50〜80 %低いと紹介している。対象プランやクレジットについての説明はない。 🔗 出典
コーディングエージェントと開発ツール
- Codex CLI 0.172.0-alpha.2 — このプレビュー版のリリースノートは空欄。62件のコミットのタイトルによると、スラッシュコマンドの引数補完、ローカルMCPサーバーのオンデマンド起動の標準化、
/experimentalでのステータス行のカスタマイズを準備している。安定版までに内容が変わる可能性がある。 🔗 出典 - iOS版Codex — iOS版ChatGPTのバージョン1.2026.314では、サイド会話をペアリング済みのコンピューターに保存する。クラウド、または特定のコンピューターとプロジェクトを選んでタスクを開始する選択機能も追加され、サブエージェント数には稼働中のものだけを数えるようになった。 🔗 出典
- Copilot CLI 1.0.115とCopilot SDK 2.0.2 — CLIの2つのプレビュー版では、リフレッシュトークンのスコープを省略するMCPサーバーへの接続などを修正。SDKのプレビュー版2.0.2-preview.0では、macOSとLinuxのトラストアンカーから、認証局eMudhraの報告対象となった16個の鍵を削除した。安定版は引き続き1.0.114。 🔗 出典 · 🔗 Copilot SDK
- GitHub CLI 2.105.0 — プレビュー版では、
gh event listenがプルリクエストのイベント(レビュー、競合、新しいコミット、チェックスイートの完了)を繰り返し問い合わせる代わりに待機するようになり、gh prとgh runもエージェントにこの方法を提案するようになった。Event Streamsの利用には引き続き待機リストへの登録が必要。 🔗 出典 - CopilotのMCPコネクター — 既存の25以上のサービスに、GitHubが検証した8サービスが加わった。Box、Buildkite、Calendly、ClickUp、Mixpanel、Supabase、Webflow、Wixが、全プランでパブリックプレビューとして利用できる。 🔗 出典
- Gemini CLI v0.69.0とv0.70.0 — 9日間リリースがなかった後、同じ日に2つの安定版が公開された。v0.70.0には、11月10日以降にマージされたルールエンジンのセキュリティ修正が含まれる。プレビュー版v0.71.0-preview.0では、PowerShellコマンドの解析が非同期になった。 🔗 出典 · 🔗 v0.71.0-preview.0
- mistral CLI 0.19.0と0.20.0 —
mistral ocr processで文書や画像をMarkdownまたは構造化データに変換できる。mistral evals judgeはmistral evals scorerに置き換わり、mistral agents initはAPIキーなしでAgents SDKの独立したプロジェクトを作成するようになった。 🔗 出典 · 🔗 0.20.0 - Delta 0.28 — エージェントとコーディングするためのZedの環境が、組織全体のスレッドを検索できるようになった。モデルを呼び出さずに古いツール実行結果を間引くソフトコンパクションも、標準で有効になった。 🔗 出典
- Windows版Amp — 実験版の公開から10日後の11月17日、AmpがWindowsアプリを発表した。x64とArmにネイティブ対応し、ランナーを内蔵。Intuneで展開できるMSIXパッケージと、グループポリシーによる設定にも対応する。 🔗 出典
- Warp Learn — Warpが、Ben Holmesによる無料講座「自己改善するソフトウェア工場を構築する」を公開した。全3単元のうち2単元が公開済みで、エージェントによる開発ループから、エラー監視をきっかけに行う修正までを扱う。 🔗 出典
- DevinDash — CognitionがDevin Botsを応用し、DoorDashのMCPサーバー経由で食事を注文するテンプレートを提供する。Devin for Startupsに参加し、サンフランシスコまたはニューヨークの相談会(オフィスアワー)に来たスタートアップは、1,000ドル分のDoorDashクレジットを受け取れる。 🔗 出典
APIとプラットフォーム
- PerplexityのAgent API — 思考量xhighのモデルがClaude Opus 5.5からGPT-6.2 Solに切り替わり、フォールバックモデルはなくなった。バージョンを
xhigh@2026-11-11.0に固定すると、以前の構成を維持できる。 🔗 出典 - Together AIとNous PortalのQwen4-Max — Together AIがAlibabaの主力モデル(総パラメータ数2.4T、アクティブパラメータ数71BのMoE、コンテキスト長1M)を30 %割引で提供する。Nous ResearchはInferactとともに、Nous Portalで5日間無料にする。終了日や利用上限は明示されていない。 🔗 Together AI · 🔗 Nous Research
アシスタントと企業
- ChatGPTがデスクトップアプリに照合と月次決算向けのAccountingプラグインを追加 — このプラグインは、取引の照合、請求に関する仕訳の作成、月末報告書の準備を支援する。macOSまたはWindowsでのコンピューター操作を利用し、Enterpriseでは管理者の承認が必要となる(11月18日付のChatGPTリリースノート。リンクは上記)。
- Perplexity Brain — PerplexityはXで、Brainが作成した個人用スキルを紹介し、米国の個人向け・企業向けの全契約者がこの機能を利用できると発表した。一方、ブログ記事ではMax契約者を対象としている。無作為化試験では、自動改善を有効にしたユーザーの72.9 %が新しい個人用スキルを獲得したのに対し、対照群では6.5 %だった。 🔗 出典 · 🔗 記事
- サービスとしてのRAG — Perplexityが、サービスとして提供されるRAGのガイドを公開し、7社の提供元を順位付けした。Perplexity Enterpriseを首位とし、AWS Bedrock、OpenAI、Azure AI Search、Pinecone、LlamaIndex、Vectaraが続く。この順位はPerplexity自身によるもの。 🔗 出典
- Sumitomo Life — 2026年6月にChatGPT Enterpriseへ移行した日本の生命保険会社が、週次利用率は80 %超と発表した。申告された時間削減効果に基づく推定投資収益率は、全体で203 %、月101回以上利用する従業員では平均524 %となった。 🔗 出典
- 外部メンバーのSSO — ChatGPT Enterprise、Edu、Healthcareのワークスペース所有者は、ドメインが未検証の外部メンバーをSSOの適用対象から除外できる。この免除は1つのワークスペースに限って有効で、退会すると失効する。 🔗 出典
- Candid HealthとElevenAgents — 米国の収益サイクル管理プラットフォームが、保険金の支払い拒否に関する保険会社への電話をElevenLabsの音声エージェントに任せている。通話件数は12,860件、月間の削減時間は850時間超で、試験運用では通話の59 %で用件を解決した。導入には48時間を要した。 🔗 出典
- Enterprise Live Migrations — AI以外の話題:Azure DevOps Servicesからデータレジデンシー対応のGitHub Enterprise Cloudへの継続的な移行が一般提供となった。切り替えまで、Gitの履歴、ブランチ、タグ、プルリクエストの同期を維持する。 🔗 出典
- GitHub ActionsのRHELランナー — AI以外の話題:ホスト型larger runners向けのRed Hat Enterprise Linux 9と10のイメージが、TeamおよびEnterprise Cloudプランで一般提供となった。 🔗 出典
オープンモデル、研究、シミュレーション
- GensparkのDeep Research — Gensparkが、Basetenが11月10日に公開した研究成果を紹介した。深掘り調査向けに事後学習したQwen3.5-397Bは、Gensparkの内部評価で0.759を記録し、ベースモデルの0.612とOpus 5.5の0.738を上回った。このモデルがエージェントの標準モデルとなり、重みはGensparkが保持する。 🔗 出典 · 🔗 Basetenの記事
- BARベンチマークのMuse Wonder — Metaが、法律向けAIプラットフォームLegoraの11月のランキングを紹介した。Muse Wonderは総合品質で最高スコアを獲得し、分析と抽出を含む4種類のタスクで首位となった。 🔗 出典
- Clairic — CloudflareがHugging Faceで公開した、型付き構造化抽出を行う270億パラメータのモデルClairicのデモが、Hubで利用できる。モデルの公開日は10月16日、Flash版は11月12日。 🔗 出典
- AirbnbのGemma 4 E2B — GoogleのGemmaアカウントによると、AirbnbはRTX Pro 6000 GPUを1基使い、Gemma 4 E2Bでルール分類を行った。F1の最高値は0.563から0.902に向上し、レイテンシーの中央値は35 msで、最先端モデルの約900 msを下回った。大量処理時のコストは、これらのモデルの約1 %だった。 🔗 出典
- Atto — NeuMLが、840パラメータから2,800万パラメータまでの超小型文書検索モデル群を公開した。9万パラメータの密モデルは、BEIRの一部でnDCG@10が0.4257となった。約256倍大きいall-MiniLM-L6-v2は0.4802だった。 🔗 出典
- ja-NCM — ある開発者が、トークンごとではなく概念ごとにテキストを生成する、重みを公開した小型日本語モデルを公開した。開発者によると、同程度の品質で、自己回帰モデルの約6倍、拡散モデルの2.4倍の速度を実現するという。 🔗 出典
- Into the Omniverse — NVIDIAが、エージェントによって構築されたシミュレーションに関する記事を、新たな事例を加えて3度目の再掲載を行った。追加されたのは、GPT-6 Astraを使ったFalkor(KONGSBERG)の産業施設のデジタルツインと、Claude Codeで組み立てた集中治療室で、後者では768台中766台のMicroduckロボットが立ったままだった。 🔗 出典
これが意味すること
最先端の研究所では、資金調達と技術の節目に、安全性への約束が伴うようになっている。Anthropicは価格を想定レンジより高く設定し、募集株式数を8億2,500万株から9億8,000万株に増やした。その翌日、Dario Amodeiは、商業的・政治的圧力に屈することなく、モデルの安全性と人間による管理を確保できるまで、学習と展開のペースを調整すると約束した。研究のうちエージェントに任せる割合の増加を測定しているOpenAIは、研究所に再帰的自己改善の指標公開を義務付けるよう求めている。両者の発言が答えようとしている問いは同じだ。資源と能力がこれほど急速に増える中で、安全性もそれに追いついていると示せるかということだ。
エージェントは今や、研究所自体の仕事のうち、測定可能な割合を担っている。OpenAIでは、2〜4時間かかるタスクの半分近くを単独で成功させており、研究者1人・1日当たりの利用額は、定価換算の中央値で2,400ドルに上る。Performance Factoryは、ChatGPTの処理遅延に関する調査を1日17件、エージェントに任せている。Replitは、連携の仕組みがモデルと同じくらい重要であることを示した。単独では最も優れたエージェントでも、スウォームを組むと、共有ボードで連携するClaude Opus 5.5より成績が低い。いずれの場合も、決定権は人間にある。Performance Factoryの修正はエンジニアがマージし、OpenAIの研究者は綿密に監督し、Devinは人間がレビューするためのプルリクエストを作成する。
課金はますます実際の利用量に合わせられるようになっている。Gemini 4 NeonはCursorで、思考量Mediumの3.07ドルからExtra Highの10.67ドルまで、タスク当たりのコストを売りにしている。Genie 4は生成した世界の時間に応じて1秒当たり約0.10ドルが課金され、GPT-Liveは誰も話していないときには1分当たり0.02ドルまで下がる。Tool Retrievalも、OpenAIやAnthropicの同等機能と同じく、開発者向けに同じ目的を追求している。実際に使うツールのスキーマだけにトークン料金を支払えるようにすることだ。
オープンモデルでは、既存の基盤から何を引き出せるかに力が注がれている。DaisyRose-27BとHermesアダプターは、どちらもQwen3.8-27Bを出発点とする。前者は強化学習でTerminal-Bench 4.1のスコアを2倍にし、後者はトークン数を3.5分の1〜4.4分の1に抑えながら、最大思考モードと同等の性能を達成した。PEFTはこうした調整を支援するためにバージョン1.0を準備し、OVHcloudは公共のスーパーコンピューターで学習した欧州のモデルを、そのカーボンフットプリントとともに公開した。Ideogramはバージョン4.6の重みの公開を約束している。これらの数値は、いずれも提供元が公表したものだ。
出典
- 新規株式公開の公開価格に関する発表(Anthropic)
- @AnthropicAIのX投稿:公開価格の決定
- @AnthropicAIのX投稿:ダリオ・アモデイの文章
- 研究の加速:進展にばらつきのある最前線(OpenAI)
- @OpenAIのX投稿:研究の加速
- OpenAIのPerformance FactoryがChatGPTの高速性を維持する仕組み(OpenAI)
- @OpenAIDevsのX投稿:Performance Factory
- @ideogram_aiのX投稿:Ideogram 4.6
- @ideogram_aiのX投稿:4.6の重み公開
- @Kling_aiのX投稿:4Kと10ビットHDR
- @cursor_aiのX投稿:CursorでのGemini 4 Neon
- CursorBench(Cursor)
- GitHub CopilotでのGemini 4 Neon(GitHubの更新履歴)
- @githubのX投稿:Gemini 4 Neon
- Claude Code v2.1.328
- Kimi Code 2.7.0
- Kimi Code Desktop 1.4.0
- Devin Security Threats(Cognition)
- @cognitionのX投稿:Devin Security Threats
- Databricks移行向けDevin(Cognition)
- @ReplitのX投稿:Amuse
- replit/amuseリポジトリ(GitHub)
- 問題解決のために人員を投入する(Replit)
- @ReplitのX投稿:Optimization-Bench
- Mac版Geminiでのコンピューター操作(Google)
- @GeminiAppのX投稿:コンピューター操作
- ChatGPTのリリースノート
- Gemini APIでのGenie 4(Google)
- Genieのドキュメント(AI Studio)
- Gemini APIでのTool Retrieval(Google)
- @OpenAIDevsのX投稿:GPT-Live-1.1
- GPT-Live-1.1の概要(OpenAI)
- GPT-Liveで言語や地域ごとのアクセントを指定するプロンプトの作成(OpenAI)
- IgniteでのNVIDIAとMicrosoft(NVIDIA)
- RTX Sparkのミニパソコンが販売開始(NVIDIA)
- DaisyRose-27B(RadixArkの記事)
- DaisyRose-27B-NVFP4(Hugging Face)
- @yb2698のX投稿:Hermesアダプター
- Qwen3.8-27B-hermes-adapted(Hugging Face)
- @OVHcloudのX投稿:Olala mini 7A1B
- Olala-v1.0-mini-7A1B(Hugging Face)
- PEFT v0.22.0
- AstaでのTheorizer(Ai2)
- allenai/asta-theorizerリポジトリ(GitHub)
- @SakanaAILabsのX投稿:Salesforceとの覚書
- Antigravityの更新履歴
- @genspark_aiのX投稿:Gemini 4 Neon
- Codex CLI 0.172.0-alpha.2
- Codexの更新履歴、iOS版ChatGPT 1.2026.314
- Copilot CLI 1.0.115-1
- Copilot SDK 2.0.2-preview.0
- GitHub CLIでプルリクエストのイベントを待機する(GitHubの更新履歴)
- Copilot向けのSupabase、Box、Calendlyなどのコネクター(GitHubの更新履歴)
- Gemini CLI v0.70.0
- Gemini CLI v0.71.0-preview.0
- mistral CLI 0.19.0
- mistral CLI 0.20.0
- Delta 0.28.0のリリースノート
- Windows版Amp(Amp)
- Warp Learn(Warp)
- @cognitionのX投稿:DevinDash
- Perplexity APIの更新履歴
- @togethercomputeのX投稿:Qwen4-Max
- @NousResearchのX投稿:Nous PortalでのQwen4-Max
- @perplexity_aiのX投稿:Brainの個人用スキル
- 自己改善するスキル(Perplexity)
- サービスとしてのRAG(Perplexity)
- Sumitomo Lifeの導入事例(OpenAI)
- ChatGPT EnterpriseとEduのリリースノート(OpenAI)
- Candid Health(ElevenLabs)
- Azure DevOpsからのEnterprise Live Migrations(GitHubの更新履歴)
- RHELランナーイメージの一般提供開始(GitHubの更新履歴)
- @genspark_aiのX投稿:Basetenと開発したDeep Researchモデル
- BasetenとGensparkが検索モデルを学習(Baseten)
- @AIatMetaのX投稿:BARベンチマークでのMuse Wonder
- @HuggingAppsのX投稿:Clairic
- @googlegemmaのX投稿:AirbnbでのGemma 4 E2B
- Atto(NeuML、Hugging Face)
- ja-NCM(Hugging Face)
- Omniverseの世界へ(NVIDIA)