ai-powered-markdown-translatorArticolo tradotto dal fr all’it con gpt-6.1-sol.
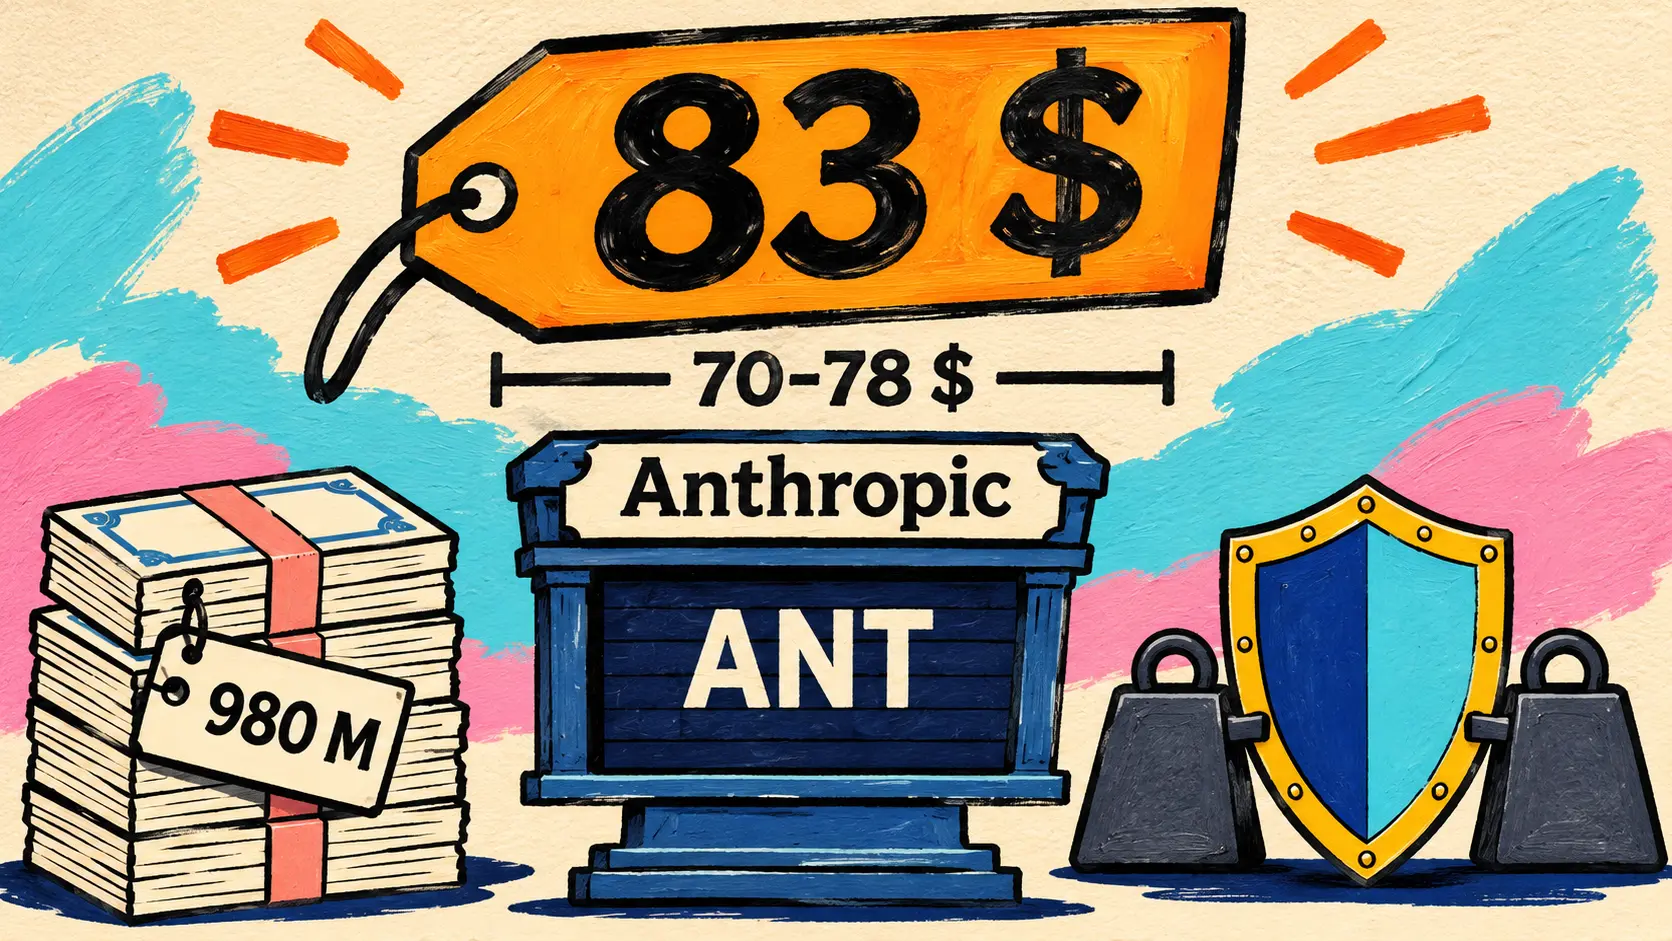
Anthropic fissa il prezzo del debutto in borsa a 83 dollari per azione, al di sopra della forchetta di 70–78 dollari, per un’offerta portata a 980 milioni di azioni e una quotazione attesa al Nasdaq con il simbolo ANT. OpenAI pubblica nuove misurazioni della propria ricerca accelerata dagli agenti, che ora completano autonomamente il 46 % delle attività da due a quattro ore, e mostra come gli agenti Codex individuano i rallentamenti di ChatGPT. Ideogram 4.6 genera in 4K nativo, Gemini 4 Neon conquista la vetta di CursorBench 4.1 e arriva in GitHub Copilot, Genie 4 si apre agli sviluppatori a circa 0,10 dollari al secondo e l’applicazione Gemini per Mac impara a usare il computer.
Finanza: Anthropic fissa il prezzo del debutto in borsa a 83 dollari per azione
18 novembre — Anthropic ha fissato il prezzo del debutto in borsa a 83 dollari per azione di classe A, al di sopra della forchetta di 70–78 dollari annunciata all’avvio del giro di incontri con gli investitori (roadshow), il 10 novembre. Anche l’offerta è aumentata: riguarda 980 milioni di azioni, contro gli 825 milioni previsti. Anthropic ne vende 956 351 354 e gli azionisti esistenti 23 648 646, i cui proventi non spettano all’azienda. Le banche dispongono inoltre di un’opzione di 30 giorni su 147 milioni di azioni.
| Elemento dell’offerta | Annuncio del 10 novembre | Prezzo fissato il 18 novembre |
|---|---|---|
| Prezzo per azione | Da 70 a 78 dollari | 83 dollari |
| Azioni offerte | 825 000 000 | 980 000 000 |
| di cui vendute da Anthropic | 801 351 354 | 956 351 354 |
| di cui azionisti esistenti | 23 648 646 | 23 648 646 |
| Opzione delle banche (30 giorni) | 123 750 000 | 147 000 000 |
La SEC ha dichiarato efficace la dichiarazione di registrazione il 18 novembre. L’inizio delle negoziazioni era previsto per il 19 novembre sul Nasdaq Global Select Market, con il simbolo ANT, e la chiusura dell’operazione per il 20 novembre. Anthropic non pubblica né l’importo raccolto né la propria valutazione. Al prezzo fissato, le 956 351 354 azioni vendute dall’azienda rappresentano circa 79,4 miliardi di dollari lordi, un calcolo effettuato a partire dai dati del comunicato. Per gli investitori privati dello Spazio economico europeo, inclusa la Francia, il prospetto europeo prevedeva un prezzo finale identico a quello dell’offerta statunitense.
Il 19 novembre, @AnthropicAI ha pubblicato un breve video, seguito da un testo di Dario Amodei. Il dirigente ricorda che lui e Daniela Amodei hanno perso il padre a causa di una malattia diventata curabile pochi anni dopo. Secondo lui, un’IA sufficientemente potente, lavorando con gli esseri umani, potrebbe concentrare un secolo di progressi scientifici e medici in un decennio, anche se per il momento i risultati restano preliminari. Elenca i rischi: uso malevolo da parte di individui o Stati, sconvolgimento economico, perdita di controllo dei sistemi. Si impegna a regolare il ritmo dell’addestramento e del rilascio dei modelli per tutto il tempo necessario a garantire che siano sicuri e rimangano sotto il controllo umano.
We will not bend to either business or political pressure.
🇮🇹 Non cederemo né alle pressioni commerciali né a quelle politiche. — @AnthropicAI su X
Per Dario Amodei, l’operazione rafforza la situazione finanziaria dell’azienda e, con essa, la sua determinazione; riprende l’idea di una «corsa al rialzo» (race to the top).
🔗 Annuncio del prezzo del debutto in borsa (Anthropic) · @AnthropicAI su X: il prezzo fissato
Agenti al lavoro in OpenAI: il rapporto sull’accelerazione della ricerca e la Performance Factory
18 novembre — Due mesi dopo un primo rapporto, OpenAI pubblica nuove misurazioni del modo in cui i propri agenti accelerano la ricerca. Il titolo riassume la conclusione: la frontiera è irregolare (jagged frontier). Tra marzo e ottobre, la quota di attività stimate in due–quattro ore di lavoro umano che gli agenti completano senza intervento passa dal 23 % al 46 %, e dal 13 % al 35 % per le attività da quattro a otto ore. Tutto dipende dal lavoro: il 79 % di successo nel monitoraggio di un addestramento, il 72 % nel rispondere a una domanda tecnica, appena il 25 % nella scrittura di codice di inferenza e serving. OpenAI osserva che le attività assegnate potrebbero essere cambiate insieme ai modelli.
| Indicatore interno di OpenAI | Valore pubblicato |
|---|---|
| Successo senza aiuto, attività da 2 a 4 ore | 23 % a marzo, 46 % a ottobre |
| Successo senza aiuto, attività da 4 a 8 ore | 13 % a marzo, 35 % a ottobre |
| Spesa mediana per gli agenti per ricercatore al giorno | 2 400 dollari a ottobre (+62 %) |
| Spesa al 90º percentile | 23 000 dollari a ottobre (+105 %) |
| Giorni-agente per ricercatore al giorno | Da 0,5 a 5,7 |
| Tempo documentato per sicurezza e allineamento | +77 % da gennaio a settembre |
| Frontiera dei modelli OpenAI nell’indice OECI | +16,4 punti all’anno, contro i 14 osservati da Epoch |
Le spese sono calcolate ai prezzi di listino dell’API e i ricercatori non hanno quote di utilizzo. Il tempo degli agenti per ricercatore è aumentato di undici volte; a metà ottobre, oltre due terzi dei ricercatori monitorati facevano funzionare almeno quattro agenti contemporaneamente nel momento di massima attività della giornata. A settembre, il valore di questo utilizzo rappresentava circa il doppio della retribuzione, esclusa la componente azionaria, dell’organizzazione di ricerca, mentre l’impiego interno incide solo per il 2 % sulle risorse di calcolo dedicate alla ricerca.
Il rapporto segue anche l’origine delle idee. Per GPT-6.2 Astra, alcuni ricercatori del pre-training hanno sviluppato determinate idee dialogando con Codex, e uno di loro gli attribuisce intuizioni chiave; quelle di GPT-6 Astra erano interamente umane. Per disporre per tre mesi di agenti di programmazione migliori di GPT-5.2, i ricercatori intervistati rinuncerebbero, in mediana, al 40 % del personale del proprio team o al 30 % delle sue risorse di calcolo. Le interviste ricordano i limiti: scarso discernimento nella scelta delle idee di ricerca, codice di bassa qualità, deviazioni attraverso passaggi inutili, da cui la necessità di una stretta supervisione umana.
Il tempo dedicato alla sicurezza e all’allineamento registra il maggiore aumento assoluto tra tutti gli ambiti, con un cambio di tendenza dopo l’incidente Hugging Face di luglio. OpenAI introduce anche l’OECI, un indice derivato dall’Epoch Capabilities Index, sul quale i suoi modelli ottengono risultati migliori rispetto all’indice di Epoch, probabilmente a causa della combinazione di benchmark, secondo l’azienda. Ritiene infine che i laboratori dovrebbero essere obbligati a monitorare e pubblicare indicatori di automiglioramento ricorsivo (recursive self-improvement, RSI), il processo attraverso il quale l’IA accelera lo sviluppo dei sistemi futuri, precisando però che questa pubblicazione non va interpretata come un’intenzione di puntare a una RSI completa. Il rapporto presenta i propri dati come una visione parziale, basata in parte su dichiarazioni.
🔗 Accelerazione della ricerca: la frontiera irregolare (OpenAI) · @OpenAI su X
OpenAI illustra la Performance Factory, dove gli agenti Codex indagano sui rallentamenti di ChatGPT
19 novembre — Il blog Engineering di OpenAI offre un esempio concreto di questo lavoro affidato agli agenti: la Performance Factory, un sistema autonomo nel cloud in cui gli agenti Codex individuano le regressioni delle prestazioni di ChatGPT. Un avviso apre un’attività, un agente risale alla causa, un altro propone una correzione sotto forma di pull request, un ingegnere decide se integrarla, poi un agente verifica dopo il rilascio che le metriche siano tornate alla normalità. In poco più di tre mesi, questo primo flusso ha seguito oltre 1 700 indagini e individuato la causa di oltre 600 casi, pari a 17 indagini automatizzate al giorno.
Il know-how del team è racchiuso in uno skill condiviso, perf-forensics, che indica a Codex quali strumenti usare tra oltre 30 strumenti per le prestazioni. Per evitare che un agente si fermi alla prima spiegazione plausibile, una seconda sessione Codex tenta di confutare ogni diagnosi: su 100 cause riesaminate manualmente, il 70 % è stato giudicato corretto. OpenAI riconosce che la correzione rimane la fase più difficile e studia il rilevamento proattivo delle regressioni e il rilascio senza intervento umano di correzioni a basso rischio, senza indicare una tempistica.
🔗 Come la Performance Factory di OpenAI mantiene ChatGPT veloce · Thread di @OpenAIDevs
Immagini e video generativi: Ideogram 4.6 in 4K nativo, Kling 4.0 in 4K e HDR a 10 bit
19 novembre — Ideogram lancia Ideogram 4.6, un nuovo modello per le immagini che genera direttamente in 4K, senza ingrandimento (upscaling): ogni dettaglio, dalla pelle al tessuto, è prodotto alla piena risoluzione. Ideogram afferma di aver lavorato per eliminare l’aspetto «da IA» e la pelle cerosa delle immagini, con pori visibili, piccole rughe e texture naturali, e annuncia una fedeltà molto maggiore dei colori e dei materiali, puntando al commercio online e alla fotografia di prodotto.
Il ritocco resta il cuore del modello: una deriva dei pixel (pixel drift) molto minore al di fuori dell’area modificata e una generazione a partire da schizzi più fedele al disegno iniziale. Ideogram afferma che la versione 4.6 è prima nella classifica di ritocco in più passaggi (Multi-step Image Edit) di Rapidata, davanti a tutti gli altri modelli, inclusi Seedream 5.5 e FLUX 3 Image, senza citare un punteggio; la 4.5 rivendicava già, il 10 novembre, la vetta di una classifica Rapidata di ritocco successivo.
| Accesso a Ideogram 4.6 | Cosa viene annunciato |
|---|---|
| Applicazione e API di Ideogram | Disponibili dal 19 novembre |
| Piattaforme partner (12) | Leonardo, Runway, fal, Comfy, Runware, Scenario, Invideo, MyDesigns, Sociaro, Moda, HeyGen e Luma |
| Prezzo | Nessun prezzo nell’annuncio |
| Pesi aperti | Promessa una versione aperta della 4.6, senza data |
Sul fronte dei pesi aperti, Ideogram cambia piano. Interpellata su quelli della versione 4.5, annunciati «a breve» dal 30 settembre, risponde che salterà la 4.5 per passare direttamente a una versione aperta della 4.6, senza fornire una data. Ideogram 4.0 era stato pubblicato con pesi aperti il 3 giugno.
We’ll skip 4.5 open and go directly to 4.6 open.
🇮🇹 Salteremo la versione aperta della 4.5 e passeremo direttamente a una versione aperta della 4.6. — @ideogram_ai su X
🔗 Annuncio di Ideogram 4.6 su X
Kling 4.0 passa al 4K nativo con un output HDR a 10 bit
19 novembre — Stesso movimento sul fronte video: Kling annuncia che Kling 4.0 supporta ora la risoluzione 4K nativa e un output HDR a 10 bit, sia in 4K sia in 1080p, per maggiori dettagli e colori più ricchi. Questo output HDR era stato promesso «a breve», senza data, quando Kling 4.0 era diventato pienamente disponibile, il 15 ottobre; Kling 3.0 generava già in 4K nativo dal 23 aprile. L’annuncio si esaurisce in un solo tweet: nessun articolo, nota di rilascio, prezzo in crediti, durata massima o dettaglio sull’API.
Gemini 4 Neon in Cursor e GitHub Copilot: in testa a CursorBench 4.1, disponibile per Pro+, Max, Business ed Enterprise
Poche ore dopo il lancio da parte di Google, trattato qui il 18 novembre, Gemini 4 Neon arriva negli strumenti di programmazione di terze parti. Cursor e GitHub Copilot lo rendono disponibile già dalla sera del 18 novembre; Genspark e Antigravity CLI seguono il 19 (vedi le Notizie in breve).
Cursor rende disponibile Gemini 4 Neon, in testa a CursorBench 4.1 al 65,4 % con effort Extra High
18 novembre — Secondo Cursor, Gemini 4 Neon stabilisce, con il livello di effort predefinito, una nuova frontiera costo-prestazioni su CursorBench 4.1: 63,7 % contro il 57,3 % di Gemini 4 Hydrogen, che sostituisce per la programmazione agentica quotidiana, mentre Gemini 4 Carbon resta consigliato per le attività più difficili. CursorBench 4.1 è una nuova versione del benchmark, datata lo stesso giorno (problemi di rispetto delle istruzioni modificati, tempo concesso all’agente aumentato): i suoi punteggi non sono confrontabili con quelli di CursorBench 4.0 pubblicati per Carbon e Hydrogen all’inizio di novembre.
| Modello ed effort (CursorBench 4.1) | Punteggio | Costo medio per attività |
|---|---|---|
| Gemini 4 Neon Extra High | 65,4 % | 10,67 dollari |
| Gemini 4 Neon High | 63,7 % | 6,54 dollari |
| Gemini 4 Carbon High | 61,5 % | 8,52 dollari |
| Gemini 4 Hydrogen Extra High | 61,4 % | 8,09 dollari |
| Claude Fable 5.2 Max | 61,3 % | 48,11 dollari |
| Gemini 4 Carbon Medium | 60,4 % | 7,22 dollari |
| Claude Fable 5.2 Extra High | 58,8 % | 17,84 dollari |
| Claude Opus 5.5 Max | 58,1 % | 11,88 dollari |
| Gemini 4 Neon Medium | 57,7 % | 3,07 dollari |
| Gemini 4 Hydrogen High | 57,3 % | 4,57 dollari |
In Cursor, Neon (gemini-4-neon, contesto di 200K token, fino a 1M) costa 3 dollari per milione di token in ingresso, 0,15 dollari per la lettura dalla cache e 15 dollari in uscita. Come gli altri modelli di terze parti, non rientra nell’utilizzo incluso: viene addebitato sul credito prepagato di The X Subscription oppure sulla riserva «Other Models» dei precedenti piani Cursor.
🔗 Annuncio di Cursor su X · Tabella CursorBench (Cursor)
Gemini 4 Neon arriva in GitHub Copilot per Pro+, Max, Business ed Enterprise
18 novembre — GitHub rende Gemini 4 Neon disponibile in versione generale in Copilot, presentandolo come un modello progettato per la programmazione agentica, l’uso di strumenti in più passaggi e il lavoro intellettuale. Il changelog riprende le argomentazioni di Google: una qualità vicina a Gemini 4 Carbon con un costo in tokens per attività inferiore, un avvio della risposta più rapido, meno modifiche non richieste al codice e meno affermazioni non supportate sugli strumenti o sui risultati dei test, senza fornire dati a sostegno.
Neon è disponibile per gli abbonati Copilot Pro+, Max, Business ed Enterprise; il piano Pro non viene citato, mentre Gemini 4 Hydrogen vi era arrivato già il 13 novembre. Funziona su dieci interfacce: VS Code, Visual Studio, Copilot CLI, l’agente di programmazione, l’app GitHub Copilot, github.com, GitHub Mobile, gli IDE JetBrains, Xcode ed Eclipse. Viene fatturato a consumo, al prezzo di listino del fornitore, con un rilascio progressivo. Nelle aziende viene attivato automaticamente finché rimane attiva l’abilitazione predefinita dei nuovi modelli, salvo che l’amministratore disattivi questo modello.
🔗 Gemini 4 Neon in GitHub Copilot (changelog) · @github su X
Agenti di programmazione: Claude Code 2.1.328, Kimi Code 2.7.0, Devin Security Threats, Devin for Databricks Migrations, Amuse e Optimization-Bench di Replit
Claude Code 2.1.328 apre la modalità auto a Opus 4.6 e Sonnet 4.6 presso i fornitori terzi e concentra /code-review sui bug
19 novembre — Claude Code 2.1.328 conta 144 voci, di cui 91 correzioni. La modalità auto si apre a Claude Opus 4.6 e Sonnet 4.6 su Amazon Bedrock, Google Cloud’s Agent Platform, Microsoft Foundry e il gateway Claude apps: una sessione interattiva avviata senza modalità di autorizzazione parte direttamente in modalità auto, e l’impostazione disableAutoMode permette di disattivarla. Il 19 novembre, la pagina della documentazione sulle modalità di autorizzazione riservava ancora la modalità auto, presso questi fornitori, a Sonnet 5 e versioni successive, Opus 4.7 e versioni successive, Haiku 5.5 e ai modelli Fable.
Il comando /code-review segnala ormai, sulla maggior parte dei modelli, soltanto i bug e le difformità rispetto a CLAUDE.md; gli interventi di pulizia (riutilizzo, semplificazione, efficienza) passano da /simplify, e ogni rilievo viene contrassegnato come Important, Pre-existing o Nit. Il blocco in caso di errore ("onFailure": "block"), aggiunto l’8 ottobre agli hook command e HTTP, si estende agli hook mcp_tool. Nel terminale, tramite l’API Anthropic, il modello piccolo e veloce redige ora i riepiloghi di avanzamento dei sottoagenti. Code Mode riceve 22 voci, tra cui la rimozione di una pausa di 0,75 secondi dopo la maggior parte degli script in modalità auto e bypass, e il runner self-hosted ne riceve 26. Viene corretta una regressione della 2.1.327 che interrompeva l’effort dei sottoagenti su Bedrock, Agent Platform e Foundry; il canale stabile rimane alla 2.1.311.
Kimi Code 2.7.0 supporta Amazon Bedrock, Kimi Code Desktop 1.4.0 si collega a Claude Code, Codex e Cursor
19 novembre — Moonshot AI pubblica Kimi Code 2.7.0 (24 voci), prima versione minore dalla 2.6.0 del 12 novembre, e poi l’applicazione Kimi Code Desktop 1.4.0 (34 voci) tredici minuti dopo. La CLI supporta i fornitori Amazon Bedrock, mostra in via sperimentale una previsione del prompt successivo dopo ogni turno e aggiunge un’impostazione «Follow-up behavior» la cui modalità Steer fa sì che il tasto Invio riorienti il turno in corso, invece di mettere il messaggio in coda. Per l’automazione, kimi server avvia il server locale senza aprire un browser, e tre nuovi endpoint HTTP permettono di gestire le sessioni. Ogni progetto può puntare ai propri host SSH; i vecchi endpoint /api/v2 scompaiono a favore di /api/v1, una modifica dell’API classificata comunque come semplice correzione.
L’applicazione desktop si collega ad agenti esterni, come Claude Code, Codex e Cursor, per passare loro sessioni, rivedere la cronologia e collaborare da un turno all’altro. Aggiunge anche Qwen Coding Plan tra i fornitori.
🔗 Kimi Code 2.7.0 · Kimi Code Desktop 1.4.0
Cognition lancia Devin Security Threats, un indice gestito delle vulnerabilità recenti da analizzare con un clic
19 novembre — Cognition aggiunge a Devin Security un indice gestito delle vulnerabilità appena divulgate. L’azienda parte da due annunci della settimana: Java4Shell (17 novembre), che interessa l’ambiente di esecuzione Java, e NGINX2Root (18 novembre), cinque bug di corruzione della memoria in nginx; entrambi possono portare all’esecuzione di codice da remoto. Ogni minaccia descrive cosa è interessato, come un attaccante potrebbe sfruttarla e cosa la risolve. Cognition pubblica quelle relative alle principali divulgazioni, e ogni team può scrivere le proprie a partire da un rapporto di bug bounty, da un avviso di un fornitore o dall’analisi di un incidente.
Il pulsante Scan with Devin avvia una scansione incentrata sulla minaccia nei repository scelti, poi Devin apre delle pull request da esaminare. In modalità Auto-triage, Devin ripete la scansione dei repository selezionati a ogni nuova minaccia che supera una soglia minima di gravità. Due skill open source scritte in Markdown, fix-nginx-vuln e fix-java-vuln, si aggiungono al plugin Vulnerability Fixes del Devin Marketplace e possono essere utilizzate da un altro agente di programmazione. Non viene annunciato alcun prezzo.
🔗 Devin Security Threats (Cognition) · @cognition su X
Cognition lancia Devin for Databricks Migrations per trasferire i data warehouse legacy su Databricks
19 novembre — Insieme a Databricks, Cognition lancia un’offerta dedicata alla migrazione. Devin converte il codice dei data warehouse legacy (Teradata, Oracle, SQL Server, Informatica, Redshift, Snowflake), lo testa nell’area di lavoro del cliente, corregge gli errori e confronta ogni sorgente con la relativa copia su Databricks prima del passaggio: schema, numero di righe, aggregati, poi confronto riga per riga. Secondo Cognition, un’azienda energetica del Fortune 500 ha migrato una piattaforma di 142 oggetti verso Unity Catalog in otto giorni, e la società Zeb ha completato in due settimane e mezza una migrazione NetSuite prevista in quattro.
L’offerta è disponibile sul Databricks Marketplace e viene conteggiata nell’impegno di spesa già sottoscritto con Databricks (Universal Commit). Cognition dichiara inoltre di utilizzare Databricks come fornitore strategico di inferenza, per modelli open source e di frontiera serviti tramite un unico endpoint. Non viene comunicato alcun prezzo.
🔗 Devin for Databricks Migrations (Cognition)
Replit pubblica Amuse, un assistente personale open source che Missions ha ricostruito in tre giorni
19 novembre — Dopo TernSign, Replit mostra una nuova realizzazione di Missions, il suo harness per sciami di agenti: Amuse, un assistente IA personale open source (Apache 2.0) che gira sul computer dell’utente. Secondo Replit, lo sciame aveva la sfida di riprodurre «l’assistente IA di riferimento», senza nominarlo, e ci è riuscito in tre giorni; il Security Scanner della piattaforma è poi servito a correggere le vulnerabilità individuate.
Amuse effettua ricerche sul web con fonti, controlla un browser che si può osservare e di cui si può riprendere il controllo, gestisce promemoria e attività in background e costruisce piccole applicazioni. La sua memoria è conservata in file leggibili, le sue credenziali in una cassaforte cifrata di cui il modello vede soltanto token sostitutivi, e richiede un’approvazione prima di qualsiasi invio, compilazione di moduli, pagamento o nuova pianificazione. «Gratuito» si intende escluso il modello: richiede una chiave API OpenAI (GPT-6.2 Sol per l’agente, GPT-6 Luna per i passaggi rapidi) e un database PostgreSQL, e rimane limitato a una persona su un computer, senza server MCP.
🔗 Annuncio di Replit su X · Repository replit/amuse
Replit pubblica Optimization-Bench: il miglior agente da solo non produce il miglior sciame
19 novembre — Il team di ricerca di Replit pubblica Optimization-Bench, un benchmark di ottimizzazione delle prestazioni su versioni congelate di librerie open source, di cui ne vengono analizzate quattro su quattordici: NumPy, SQLite, SQLGlot e Git. Sei modelli hanno lavorato da soli, poi in sciami di 8, 16 e 32 agenti, per due ore, mentre la valutazione veniva eseguita su una macchina a cui gli agenti non potevano accedere.
| Misura di Optimization-Bench | Risultato pubblicato da Replit |
|---|---|
| GPT-6.2 Astra da solo, su NumPy | oltre 3 volte più veloce di Opus 5.5 da solo |
| Sciami di 32 agenti GPT-6.2 Astra | sotto il proprio punteggio individuale in 3 attività su 4 |
| Miglioramento mediano degli sciami di Opus e Sonnet 5.5 | 1,30 volte il loro punteggio individuale, con 16 e 32 agenti |
| Messaggi di Opus 5.5 inviati alla bacheca condivisa | 82 % |
GPT-6.2 Astra domina da solo, ma i suoi sciami raggiungono il massimo a 8 agenti. Al contrario, gli sciami di Claude Opus 5.5 e Claude Sonnet 5.5 superano ogni volta le rispettive esecuzioni individuali; su NumPy, Opus passa da 3,7 volte da solo a 18,9 volte in uno sciame di 32, un dato già fornito al lancio di Missions. Replit attribuisce la differenza all’organizzazione: i team efficaci scrivono su una bacheca condivisa e lasciano al coordinatore la distribuzione e poi l’integrazione del lavoro (nello sciame NumPy di 32 agenti Opus, non ha mai scritto a un singolo worker), mentre gli altri trasformano il coordinatore in un centralino la cui casella di posta in arrivo cresce a ogni agente aggiunto.
🔗 Aumentare gli organici per risolvere il problema (Replit) · @Replit su X
Assistenti per il grande pubblico: computer use in Gemini per Mac, ChatGPT Health su Android, desktop, dots e siti
L’applicazione Gemini per Mac controlla le applicazioni e il web in background con computer use
19 novembre — L’applicazione Gemini per Mac sa ora utilizzare il computer (computer use) al posto dell’utente. Gemini esegue in sequenza attività in più passaggi tra file locali, applicazioni desktop e web: clic, digitazione, menu, moduli. Lavora in una finestra isolata in background, con un’anteprima in diretta nella conversazione, così lo schermo principale e il cursore rimangono liberi. L’utente sceglie le applicazioni accessibili, segue ogni passaggio, può mettere tutto in pausa e approva le azioni importanti prima che vengano eseguite.
Gli esempi di Google vanno dal ritocco di foto in batch alla compilazione di preventivi di spedizione a partire da PDF locali, passando per una presentazione Google Slides costruita a partire da dashboard; il video pubblicato su X trasforma uno schizzo in un modello 3D animabile in Blender. La funzione viene distribuita in inglese negli Stati Uniti agli abbonati Google AI Plus, Pro e Ultra, sui Mac con chip Apple Silicon e macOS Sequoia 15.0 o successivo, con un account Google personale di un utente di almeno 18 anni. Per gli sviluppatori, lo strumento Computer Use dell’API Gemini è disponibile in versione generale dalla fine di ottobre; l’applicazione per il grande pubblico porta ora questa capacità di controllo sul Mac dell’utente.
🔗 Computer use in Gemini per Mac (Google) · @GeminiApp su X
ChatGPT estende Health ad Android con Health Connect, all’applicazione desktop, ai dots e ai siti
19 novembre — Lo spazio Health di ChatGPT arriva nell’applicazione desktop, nei dots, nei siti e su Android. Su Android si collega a Health Connect per individuare tendenze del sonno e dell’attività fisica. I dots, gli agenti personali di ChatGPT, possono proporre autonomamente un altro orario per l’allenamento quando una riunione interferisce, oppure ricordare opzioni di prevenzione sulla base delle cartelle cliniche collegate. Sul computer, OpenAI propone l’esempio di un sito costruito per seguire la preparazione a una maratona. Il rilascio è progressivo e limitato agli Stati Uniti, per i piani Free, Go, Plus e Pro; i dots rimangono riservati al piano Pro. Health si trova nella barra laterale o nel menu Explore.
API Gemini: Genie 4 aperto agli sviluppatori, Tool Retrieval in anteprima
Genie 4 arriva nell’API Gemini e in Google AI Studio, a circa 0,10 dollari per secondo di mondo generato
19 novembre — Il giorno dopo il suo arrivo in Project Genie per gli abbonati Google AI Ultra, Genie 4 si apre agli sviluppatori nell’API Gemini, tramite l’Interactions API, e in Google AI Studio, con un canvas interattivo e applicazioni di partenza. A partire da un testo, da un’immagine di riferimento o da entrambi, il modello di mondo genera un ambiente continuo con audio sincronizzato, dai suoni ambientali ai dialoghi; ci si muove con la tastiera e si possono modificare tramite testo, durante il percorso, il meteo, l’illuminazione, gli oggetti o gli eventi.
| Caratteristica di Genie 4 nell’API | Valore documentato |
|---|---|
| Identificativo del modello | models/genie-4 (Interactions API) |
| Output video e audio | 1280x720, 16:9, 24 images/s, audio stereo 48 kHz |
| Accesso | chiave API del livello a pagamento |
| Fatturazione | 240 tokens video per fotogramma, pari a circa 0,10 dollari al secondo |
| Durata di una sessione | possibile degrado dopo 60–90 s, limite di 120 s |
| Regioni di servizio | Stati Uniti, Europa occidentale, Giappone |
La documentazione avverte che chiudere la scheda non interrompe immediatamente la generazione: soltanto la chiusura esplicita della sessione (complete()) interrompe la fatturazione. Genie 4 non conserva in memoria una scena 3D: un oggetto perso di vista per 8 secondi o più, oppure un giro completo su sé stessi, può far spostare o reimpostare i punti di riferimento. Ogni output presenta una filigrana SynthID.
🔗 Genie 4 nell’API Gemini (Google) · Documentazione di Genie (AI Studio)
L’API Gemini lancia Tool Retrieval in anteprima, che carica gli schemi degli strumenti su richiesta
19 novembre — Google aggiunge all’API Gemini la ricerca di strumenti già proposta da OpenAI e Anthropic. Con Tool Retrieval, in anteprima nell’Interactions API, un agente collegato a decine o centinaia di strumenti non invia più tutti i loro schemi dei parametri a ogni richiesta: basta aggiungere uno strumento tool_search e contrassegnare con defer_loading: true gli strumenti da tenere in riserva. Il modello vede soltanto il loro nome e la loro descrizione, richiede uno strumento per nome quando ne ha bisogno, e l’API carica lo schema nella stessa richiesta, lato server, senza dover costruire un indice.
Il meccanismo si estende ai server MCP remoti e rispetta la cache del prefisso, poiché gli schemi caricati vengono aggiunti più avanti nella conversazione. I team che gestiscono il proprio registro di strumenti possono eseguire la ricerca nella propria infrastruttura, al costo di un round trip aggiuntivo. Tool Retrieval non viene fatturato separatamente: tool_search aggiunge un piccolo blocco fisso di tokens di input, ogni schema caricato viene fatturato in input per il resto della conversazione e Google, che non pubblica alcun dato sul risparmio, consiglia di misurare il vantaggio sul proprio traffico. La funzione è compatibile con Gemini 3.6 e i modelli successivi, compresa tutta la famiglia Gemini 4.
🔗 Tool Retrieval nell’API Gemini (Google)
Voce: GPT-Live-1.1 arriva nell’API, con una modalità standby a 0,02 dollari al minuto
19 novembre — Poco più di un mese dopo il suo arrivo nella modalità vocale di ChatGPT Plus e Pro, il 15 ottobre, GPT-Live-1.1 entra nell’API di OpenAI (gpt-live-1.1 su v1/live/sessions). Il modello migliora la pronuncia, la coerenza dell’accento e la trascrizione nelle conversazioni vocali multilingue e si integra in una configurazione di sessione Live esistente.
La novità più concreta è la modalità standby (standby), disponibile sia per GPT-Live-1 sia per GPT-Live-1.1 nelle sessioni WebRTC. Dopo un silenzio regolabile da 5 a 60 secondi, il modello si mette in pausa senza interrompere la chiamata e il costo al minuto passa da 0,05 a 0,02 dollari finché qualcuno non riprende a parlare.
| Tipo di sessione GPT-Live | Tariffa al minuto |
|---|---|
| Sessione attiva | 0,05 dollari |
| Standby (WebRTC, inferenza in pausa) | 0,02 dollari |
L’utilizzo del modello backend e degli strumenti resta fatturato separatamente e le due versioni hanno limiti distinti per le sessioni simultanee. Gli SDK Python 3.56.0 e Node 7.61.0 aggiungono il modello e OpenAI accompagna il rilascio con una guida sulle lingue e sugli accenti regionali.
🔗 Annuncio @OpenAIDevs · Scheda GPT-Live-1.1 · Prompting di GPT-Live per lingue e accenti regionali
Hardware e cloud: NVIDIA e Microsoft a Ignite, disponibili i mini-PC RTX Spark
NVIDIA e Microsoft ampliano la collaborazione a Ignite, da Vera Rubin in Azure a Nemotron 3.5 in Foundry
19 novembre — In occasione di Microsoft Ignite, NVIDIA descrive in un articolo firmato da Dave Salvator l’ampliamento della collaborazione con Microsoft. I sistemi Vera Rubin NVL72 sono operativi nei data center Azure e si amplia l’accesso alle macchine virtuali che li utilizzano; l’articolo parla di un’anteprima di Vera Rubin su Azure, senza una data di disponibilità generale.
| Annuncio di NVIDIA e Microsoft | Stato secondo l’articolo |
|---|---|
| VM Azure su Vera Rubin NVL72 | accesso ampliato, anteprima |
| Nemotron 3.5 Super, Lightning, Embed, Rerank, Parse e Content Safety | gamma ampliata su Foundry Managed Compute |
| Nemotron 3.5 Bolt e Transcribe | in arrivo |
| Nemotron 3.5 e modelli Cosmos in Foundry Local | supporto ampliato, inclusi gli ambienti Azure Local |
| Azure Local | GPU RTX PRO 6000 Blackwell in arrivo, estensione a Jetson Thor e Jetson Orin |
| Direct Stream su Windows 365 | due flussi 4K a 60 fotogrammi/s, anteprima pubblica a inizio 2027 |
| BioNeMo e ALCHEMI in Microsoft Discovery | ingresso nel catalogo, prima integrazione di RFD4-Proteina |
Esempio citato: EY ha adattato modelli aperti Nemotron con Programmed Training, il servizio serverless di post-training di Foundry, per classificare registri di acquisto; secondo l’articolo, la precisione aumenta del 55 % sul suo set di valutazione, con un costo 15 volte inferiore rispetto ai modelli proprietari di punta. Microsoft AI utilizza anche NVIDIA Dynamo per l’inferenza dei rollout (rollouts) di apprendimento per rinforzo del suo post-training. L’articolo ricorda infine i risultati MLPerf di Azure: fino a 10 240 GPU NVIDIA su sistemi GB200 NVL72 in Training v6.1, la scala più ampia della sessione, e, in Inference v6.1, un vantaggio superiore al 10 % dei GB300 NVL72 di Azure rispetto alle altre proposte cloud in termini di throughput interattivo su DeepSeek-R1, secondo Signal65. Non viene comunicato alcun prezzo.
🔗 NVIDIA e Microsoft a Ignite (NVIDIA)
Sono disponibili i mini-PC RTX Spark di ASUS, Dell e MSI, annuncia NVIDIA
18 novembre — NVIDIA annuncia la disponibilità dei mini-PC desktop RTX Spark di ASUS, Dell e MSI, come ASUS ProArt GR1X o la serie MSI EdgeMesa N AI+; quelli di Acer, GIGABYTE e HP arriveranno presto, così come Microsoft Surface RTX Spark Dev Box. Riprendono la piattaforma dei portatili lanciati a ottobre: processore NVIDIA Grace a 20 core, GPU Blackwell RTX con 6 144 core CUDA, fino a 128 Go di memoria unificata e fino a 1 petaflop di prestazioni IA. NVIDIA afferma che sono in grado di eseguire localmente modelli da 120 miliardi di parametri. Non viene indicato alcun prezzo.
Sul fronte software, Switchyard, che distribuisce le attività degli agenti tra modelli locali e cloud, è disponibile in Hermes. Adobe riduce di oltre il 50 % i tempi di produzione degli output H.264 comuni in Premiere e Illustrator, ora nativo su Windows on Arm, è fino al 30 % più veloce della sua versione emulata; Blender 5.3 integra DLSS 4.5 Ray Reconstruction. Tra gli annunci di Ignite, Windows Server 2028 arriva su DGX Station for Windows e Windows ML esegue qualsiasi modello GGUF di Hugging Face tramite llama.cpp.
🔗 Mini-PC RTX Spark disponibili (NVIDIA)
Modelli aperti: DaisyRose-27B e l’adattatore Hermes potenziano Qwen3.8-27B, OVHcloud pubblica Olala mini, PEFT v0.22.0
RadixArk pubblica DaisyRose-27B, un Qwen3.8-27B affinato con RL che raddoppia il proprio punteggio su Terminal-Bench 4.1
18 novembre — RadixArk pubblica DaisyRose-27B, presentato come il suo primo modello: un Qwen3.8-27B riaddestrato tramite apprendimento per rinforzo con Miles, il suo framework open source, su circa 1 200 attività lunghe per agenti (fino a 1,5 ore e oltre 100 chiamate a strumenti per tentativo), progettate con Eigent AI per intervenire sugli errori del modello originale. I pesi sono pubblicati con licenza Apache 2.0 in BF16, FP8 e NVFP4, con il contesto di 256K tokens e la comprensione delle immagini del modello di base. L’addestramento ha richiesto 18 giorni su 144 H200.
| Benchmark (punteggio in %) | Qwen3.8-27B | DaisyRose-27B |
|---|---|---|
| Terminal-Bench 4.1 (pass@1) | 5,6 | 12,0 |
| Terminal-Bench 2.1 | 73,0 | 75,5 |
| DeepSWE v1.1 | 42,2 | 46,2 |
| SWE Bench Pro v2 | 91,3 | 94,7 |
| GPQA Diamond | 89,2 | 90,7 |
RadixArk annuncia anche un utilizzo utile delle GPU (MFU) del 37 % contro il 16 % del trainer open source basato su Megatron, pari al 57 % di tempo GPU in meno; si tratta dei dati forniti dallo sviluppatore.
🔗 DaisyRose-27B (articolo di RadixArk) · DaisyRose-27B-NVFP4 (Hugging Face)
Il progetto harness-hub pubblica l’adattatore Hermes di Qwen3.8-27B, che porta SWE-Bench Pro dal 29,4 al 43,1 % senza ragionamento
19 novembre — Dopo pi e OpenCode, il progetto harness-hub pubblica un terzo adattatore LoRA di Qwen3.8-27B, questa volta per Hermes, l’harness per agenti di Nous Research, con una versione GGUF.
| Benchmark (pass@1) | Qwen3.8-27B | Con l’adattatore Hermes |
|---|---|---|
| SWE-Bench Pro (51 attività difficili), senza ragionamento | 29,4 % | 43,1 % |
| SWE-Bench Pro (51 attività difficili), ragionamento xhigh | 45,1 % | 51,0 % |
| Terminal-Bench 2.1, senza ragionamento | 44,7 % | 58,8 % |
| Terminal-Bench 2.1, ragionamento xhigh | 58,8 % | 57,6 % |
L’interesse risiede soprattutto nell’efficienza: senza ragionamento, l’adattatore eguaglia il modello di base con ragionamento xhigh usando da 3,5 a 4,4 volte meno tokens. Con un budget di 10 000 tokens per attività, risolve il 51 % di Terminal-Bench 2.1 e il 39 % di SWE-Bench Pro, contro il 28 % e lo 0 % del modello di base in xhigh. La ricetta (AsyncGRPOTrainer di TRL, OpenEnv, safeagents) sarà descritta in dettaglio in un articolo annunciato per venerdì.
🔗 Annuncio di @yb2698 su X · Qwen3.8-27B-hermes-adapted (Hugging Face)
OVHcloud pubblica i pesi di Olala mini 7A1B su Hugging Face, con un punteggio medio di 68,0 su dodici benchmark
19 novembre — Annunciato il 17 novembre, Olala mini 7A1B, il modello che inaugura la prima famiglia di modelli linguistici di OVHcloud, è ora scaricabile da Hugging Face con licenza Apache 2.0, nelle versioni base, SFT, GGUF e MLX.
| Caratteristica di Olala mini 7A1B | Valore pubblicato |
|---|---|
| Parametri | 6,8 miliardi, di cui circa 1 miliardo attivo per token |
| Architettura | ibrida Mamba-3 e attenzione in una miscela di esperti, cache KV su 7 strati su 36 |
| Contesto | 32K tokens, versione 128K annunciata in arrivo |
| Addestramento | 12,8T tokens, in inglese e altre 36 lingue |
| Impronta stimata | circa 40 t di CO2 e 1,16 GWh |
| Media su dodici benchmark | 68,0, ossia 15,2 punti in più rispetto al checkpoint SFT |
Il modello è stato addestrato su tre supercomputer pubblici europei, JUPITER (con 1 024 GPU GH200), Jean Zay e MeluXina. Ragiona prima di rispondere, con quattro livelli di impegno, ed è stato addestrato tramite apprendimento per rinforzo a chiamare strumenti; il suo punto di forza è il rispetto delle istruzioni, il suo punto debole la matematica da competizione.
🔗 @OVHcloud su X · Olala-v1.0-mini-7A1B (Hugging Face)
Hugging Face pubblica PEFT v0.22.0, con i metodi PaCA, Astra e NoRA, prima di PEFT 1.0
19 novembre — La libreria di Hugging Face per il fine-tuning a basso consumo di risorse passa alla v0.22.0. Aggiunge PaCA (Partial Connection Adaptation), che non aggiunge strati di adattamento ma affina direttamente colonne di input scelte casualmente nei pesi preaddestrati: secondo l’articolo originale, richiede il 22 % di tempo di addestramento e il 16 % di memoria in meno rispetto a LoRA, a parità di precisione. Due nuove inizializzazioni di LoRA, Astra e NoRA, completano la versione, che potenzia anche il parallelismo tensoriale e FSDP2 e aggiunge un controllo dello stato di salute del modello. PEFT richiede ora Python 3.11 e le note annunciano che la prossima versione sarà la 1.0, con una pulizia dell’API e alcune piccole modifiche che interrompono la compatibilità, preceduta da una versione candidata (release candidate).
Scienza: Ai2 lancia Theorizer in Asta, un agente che propone teorie collegate alle pubblicazioni
19 novembre — Ai2 rende disponibile Theorizer in Asta, la sua piattaforma di agenti per la ricerca scientifica, e ne pubblica il codice con licenza Apache-2.0. L’agente esamina la letteratura, definisce cosa estrarre da ogni articolo, confronta i risultati e formula teorie in cui ogni affermazione rimanda agli articoli che la sostengono; segnala quelle che ritiene nuove, avvertendo che una ricerca può non individuare lavori precedenti. Ai2 lo illustra con casi reali: negli adenocarcinomi polmonari senza mutazione driver nota (circa il 20–30 % dei casi), un’ipotesi preliminare di dipendenza dalla proteina CDK2, ancora da convalidare in laboratorio; 50 teorie candidate sugli interneuroni VIP per un neuroscienziato dell’Allen Institute che ne aspettava una o due. L’utilizzo in Asta è finanziato da Ai2 fino a un limite di tokens, l’articolo tecnico è stato pubblicato ad ACL 2026 e un webinar è previsto per il 10 dicembre.
🔗 Theorizer in Asta (Ai2) · Repository allenai/asta-theorizer
IA in azienda: Sakana AI e Salesforce firmano un protocollo d’intesa per il settore pubblico giapponese
19 novembre — Sakana AI annuncia un protocollo d’intesa con Salesforce per integrare i propri modelli di IA nei software dell’azienda americana, destinati alle amministrazioni pubbliche e agli enti locali giapponesi. L’obiettivo dichiarato è contribuire all’efficienza amministrativa e alla trasformazione digitale di questi enti e Sakana AI afferma di voler continuare a sviluppare tecnologie adatte alle esigenze del settore pubblico giapponese. Il tweet, in giapponese, riprende un dispaccio dell’agenzia di stampa Jiji; l’annuncio non indica né tempistiche, né un prodotto specifico, né un importo.
Brevi
Gemini 4 Neon altrove
- Antigravity CLI 1.5.12 — Gemini 4 Neon diventa accessibile con una semplice chiave API Gemini (
GEMINI_API_KEY), su tutti e quattro i suoi livelli di ragionamento; la vista browser di Remote Control mostra più conversazioni affiancate, e/forkrichiede pochi secondi anziché fino a un’ora. 🔗 fonte - Genspark — Gemini 4 Neon arriva in AI Chat e nel Code Agent, con gli argomenti promozionali di Google (3° nella classifica generale di Artificial Analysis con effort xhigh, 1° nel suo indice degli agenti di codice, costo per attività inferiore dal 50 all’80 % rispetto ai migliori modelli), senza indicazioni su piani o crediti. 🔗 fonte
Agenti di codice e strumenti di sviluppo
- Codex CLI 0.172.0-alpha.2 — Le note di questa versione di anteprima sono vuote; stando ai titoli dei suoi 62 commit, prepara il completamento degli argomenti dei comandi slash, l’avvio su richiesta come impostazione predefinita dei server MCP locali e righe di stato personalizzate in
/experimental. Il contenuto può cambiare prima della versione stabile. 🔗 fonte - Codex su iOS — La versione 1.2026.314 di ChatGPT per iOS salva le conversazioni laterali sul computer abbinato, aggiunge un selettore per avviare un’attività nel cloud oppure su un computer e in un progetto specifici, e conta soltanto i sottoagenti ancora attivi. 🔗 fonte
- Copilot CLI 1.0.115 e Copilot SDK 2.0.2 — Due versioni di anteprima della CLI correggono in particolare la connessione ai server MCP che omettono uno scope del token di refresh; la versione di anteprima 2.0.2-preview.0 dell’SDK rimuove dalle ancore di fiducia, su macOS e Linux, le 16 chiavi segnalate dell’autorità di certificazione eMudhra. La versione stabile resta la 1.0.114. 🔗 fonte · 🔗 Copilot SDK
- GitHub CLI 2.105.0 — In anteprima,
gh event listenattende un evento di pull request (revisione, conflitto, nuovo commit, check suite completata) anziché interrogarne ripetutamente lo stato, e siagh prsiagh runora lo suggeriscono agli agenti; l’accesso a Event Streams passa ancora da una lista d’attesa. 🔗 fonte - Connettori MCP di Copilot — Otto servizi verificati da GitHub si aggiungono agli oltre 25 esistenti, in anteprima pubblica su tutti i piani: Box, Buildkite, Calendly, ClickUp, Mixpanel, Supabase, Webflow e Wix. 🔗 fonte
- Gemini CLI v0.69.0 e v0.70.0 — Dopo nove giorni senza nuove versioni, due versioni stabili escono nello stesso giorno, e la v0.70.0 include le correzioni di sicurezza del motore di regole integrate dal 10 novembre; la versione di anteprima v0.71.0-preview.0 rende asincrona l’analisi dei comandi PowerShell. 🔗 fonte · 🔗 v0.71.0-preview.0
- CLI mistral 0.19.0 e 0.20.0 —
mistral ocr processconverte un documento o un’immagine in Markdown o in dati strutturati,mistral evals judgelascia il posto amistral evals scorer, emistral agents initora crea un progetto autonomo dell’SDK Agents, senza chiave API. 🔗 fonte · 🔗 0.20.0 - Delta 0.28 — L’ambiente di Zed per programmare con gli agenti cerca nei thread dell’intera organizzazione e attiva per impostazione predefinita la compattazione leggera, che elimina i vecchi risultati degli strumenti senza chiamare un modello. 🔗 fonte
- Amp per Windows — Il 17 novembre, dieci giorni dopo una versione sperimentale, Amp annuncia la sua applicazione Windows, nativa su x64 e Arm, con un runner integrato, pacchetti MSIX distribuibili tramite Intune e impostazioni tramite criteri di gruppo. 🔗 fonte
- Warp Learn — Warp lancia un corso gratuito, Build a Self-Improving Software Factory, tenuto da Ben Holmes: due unità su tre sono online, dal ciclo di sviluppo tramite agenti alle correzioni attivate dal monitoraggio degli errori. 🔗 fonte
- DevinDash — Cognition propone una variante dei suoi Devin Bots sotto forma di un modello che ordina pasti tramite il server MCP di DoorDash; le startup di Devin for Startups che hanno partecipato agli incontri (office hours) di San Francisco o New York possono ricevere 1 000 dollari di credito DoorDash. 🔗 fonte
API e piattaforme
- Agent API di Perplexity — Il livello di effort xhigh passa a GPT-6.2 Sol, senza modello di fallback, al posto di Claude Opus 5.5; fissare la versione
xhigh@2026-11-11.0mantiene la vecchia configurazione. 🔗 fonte - Qwen4-Max su Together AI e Nous Portal — Together AI offre il modello di punta di Alibaba (MoE da 2,4T parametri di cui 71B attivi, contesto di 1M) con il 30 % di sconto, e Nous Research lo rende gratuito per cinque giorni su Nous Portal con Inferact, senza precisare la data di fine né i limiti di utilizzo. 🔗 Together AI · 🔗 Nous Research
Assistenti e aziende
- ChatGPT aggiunge un plugin Accounting per le riconciliazioni e le chiusure mensili nell’applicazione desktop — Il plugin aiuta a riconciliare transazioni, a redigere registrazioni di fatturazione e a preparare i rapporti di fine mese; utilizza il controllo del computer su macOS o Windows, con l’approvazione di un amministratore in Enterprise (note di rilascio di ChatGPT del 18 novembre, nel link più sopra).
- Perplexity Brain — Perplexity condivide su X gli skill personali scritti da Brain e vi annuncia la funzione per tutti gli abbonati privati e aziendali negli Stati Uniti, mentre il suo articolo parla degli abbonati Max; nel test randomizzato, il 72,9 % degli utenti con il miglioramento automatico ha ottenuto un nuovo skill personale, contro il 6,5 % del gruppo di controllo. 🔗 fonte · 🔗 articolo
- RAG as a service — Perplexity pubblica una guida sul RAG offerto come servizio e classifica sette fornitori, con Perplexity Enterprise in testa davanti ad AWS Bedrock, OpenAI, Azure AI Search, Pinecone, LlamaIndex e Vectara; la classifica è stilata da Perplexity. 🔗 fonte
- Sumitomo Life — La compagnia giapponese di assicurazioni sulla vita, passata a ChatGPT Enterprise nel giugno 2026, annuncia un utilizzo settimanale superiore all’80 % e un ritorno sull’investimento stimato, sulla base dei risparmi di tempo dichiarati, al 203 % complessivo e al 524 % in media tra i dipendenti che lo usano almeno 101 volte al mese. 🔗 fonte
- SSO dei membri esterni — I proprietari degli spazi ChatGPT Enterprise, Edu e Healthcare possono esentare dall’SSO i membri esterni il cui dominio non è verificato; l’esenzione vale per un solo spazio e decade quando il membro lo lascia. 🔗 fonte
- Candid Health ed ElevenAgents — La piattaforma statunitense di gestione del ciclo dei ricavi affida agli agenti vocali di ElevenLabs le sue chiamate alle compagnie assicurative sui rifiuti di rimborso: 12 860 chiamate, oltre 850 ore risparmiate al mese e il 59 % delle chiamate pilota risolte, con un’integrazione in 48 ore. 🔗 fonte
- Enterprise Live Migrations — Al di fuori dell’IA: le migrazioni continue da Azure DevOps Services a GitHub Enterprise Cloud con residenza dei dati diventano generalmente disponibili, con cronologia Git, branch, tag e pull request che restano sincronizzati fino al passaggio definitivo. 🔗 fonte
- Runners RHEL di GitHub Actions — Al di fuori dell’IA: le immagini Red Hat Enterprise Linux 9 e 10 dei larger runners ospitati diventano generalmente disponibili per i piani Team ed Enterprise Cloud. 🔗 fonte
Modelli aperti, ricerca e simulazione
- Deep Research di Genspark — Genspark condivide un lavoro pubblicato da Baseten il 10 novembre: un Qwen3.5-397B sottoposto a post-training per la ricerca approfondita raggiunge 0,759 sul grader interno di Genspark, contro 0,612 per il modello di base e 0,738 per Opus 5.5; diventa il modello predefinito dell’agente, e Genspark conserva i pesi. 🔗 fonte · 🔗 articolo di Baseten
- Muse Wonder sul benchmark BAR — Meta condivide la classifica di novembre di Legora, piattaforma di IA giuridica, in cui Muse Wonder ottiene il miglior punteggio di qualità complessiva e primeggia in quattro tipi di attività, tra cui analisi ed estrazione. 🔗 fonte
- Clairic — Una demo di Clairic, il modello di estrazione strutturata tipizzata da 27 miliardi di parametri pubblicato da Cloudflare su Hugging Face, è disponibile sull’Hub; il modello risale al 16 ottobre e la sua versione Flash al 12 novembre. 🔗 fonte
- Gemma 4 E2B presso Airbnb — Secondo l’account Gemma di Google, Airbnb ha utilizzato Gemma 4 E2B per la classificazione di regole su una sola GPU RTX Pro 6000: F1 massimo da 0,563 a 0,902, latenza mediana di 35 ms contro circa 900 ms per i modelli di frontiera, a circa l’1 % del loro costo su grandi volumi. 🔗 fonte
- Atto — NeuML pubblica una famiglia di minuscoli modelli di ricerca documentale, da 840 parametri a 28 milioni: il modello denso da 90 000 parametri raggiunge 0,4257 in nDCG@10 su un sottoinsieme di BEIR, contro 0,4802 per all-MiniLM-L6-v2, circa 256 volte più grande. 🔗 fonte
- ja-NCM — Uno sviluppatore pubblica un piccolo modello giapponese a pesi aperti che genera il testo per concetti anziché token per token: secondo lui, circa 6 volte più velocemente di un modello autoregressivo e 2,4 volte più velocemente di un modello di diffusione, a qualità comparabile. 🔗 fonte
- Into the Omniverse — NVIDIA ripubblica per la terza volta il suo articolo sulle simulazioni costruite da agenti, con nuovi esempi: i gemelli digitali di siti industriali di Falkor (KONGSBERG) con GPT-6 Astra, e un’unità di terapia intensiva assemblata da Claude Code in cui 766 robot Microduck su 768 rimanevano in piedi. 🔗 fonte
Che cosa significa
Le tappe finanziarie e tecniche dei laboratori di punta sono ormai accompagnate da impegni sulla sicurezza. Anthropic fissa il proprio prezzo al di sopra della forchetta e porta la sua offerta da 825 a 980 milioni di azioni; il giorno dopo, Dario Amodei promette di regolare il ritmo dell’addestramento e del rilascio fino ad assicurarsi che i modelli siano sicuri e restino sotto controllo umano, senza cedere alle pressioni commerciali o politiche. OpenAI, che misura la quota crescente della propria ricerca affidata agli agenti, chiede che i laboratori siano obbligati a pubblicare indicatori di auto-miglioramento ricorsivo. Le due dichiarazioni rispondono alla stessa domanda: dimostrare che la sicurezza tiene il passo quando risorse e capacità aumentano così rapidamente.
Gli agenti svolgono ormai una quota misurabile del lavoro dei laboratori stessi. In OpenAI, portano a termine autonomamente quasi la metà delle attività da due a quattro ore e comportano, in mediana, un costo di 2 400 dollari per ricercatore al giorno al prezzo di listino; la Performance Factory affida loro 17 indagini al giorno sui rallentamenti di ChatGPT. Replit mostra che l’organizzazione conta quanto il modello: il miglior agente singolo crea sciami meno efficaci di quelli di Claude Opus 5.5, che si coordina tramite una bacheca condivisa. Ovunque, la decisione resta all’essere umano: un ingegnere esegue il merge delle correzioni della Performance Factory, i ricercatori di OpenAI supervisionano da vicino e Devin apre pull request da rivedere.
La fatturazione si adegua sempre più all’utilizzo effettivo. Gemini 4 Neon viene venduto in Cursor in base al costo per attività, da 3,07 dollari con effort Medium a 10,67 dollari con Extra High; Genie 4 viene fatturato al secondo di mondo generato, circa 0,10 dollari, e GPT-Live scende a 0,02 dollari al minuto quando nessuno parla. Tool Retrieval, come i suoi equivalenti di OpenAI e Anthropic, persegue lo stesso obiettivo per gli sviluppatori: pagare in token soltanto gli schemi degli strumenti effettivamente utilizzati.
Per i modelli aperti, lo sforzo si concentra su ciò che si può ricavare da una base esistente. DaisyRose-27B e l’adattatore Hermes partono entrambi da Qwen3.8-27B: il primo raddoppia il proprio punteggio su Terminal-Bench 4.1 tramite apprendimento per rinforzo, il secondo eguaglia la modalità di ragionamento massima con un numero di token da 3,5 a 4,4 volte inferiore. PEFT prepara la sua versione 1.0 per fornire strumenti per questi fine-tuning, OVHcloud pubblica un modello europeo addestrato su supercomputer pubblici con la relativa impronta di carbonio, e Ideogram promette i pesi della sua versione 4.6. Questi dati restano quelli dichiarati dai produttori.
Fonti
- Annuncio del prezzo dell’offerta pubblica iniziale (Anthropic)
- @AnthropicAI su X: il prezzo fissato
- @AnthropicAI su X: testo di Dario Amodei
- Accelerazione della ricerca: la frontiera irregolare (OpenAI)
- @OpenAI su X: accelerazione della ricerca
- Come la Performance Factory di OpenAI mantiene ChatGPT veloce (OpenAI)
- @OpenAIDevs su X: Performance Factory
- @ideogram_ai su X: Ideogram 4.6
- @ideogram_ai su X: pesi aperti della 4.6
- @Kling_ai su X: 4K e HDR a 10 bit
- @cursor_ai su X: Gemini 4 Neon in Cursor
- CursorBench (Cursor)
- Gemini 4 Neon in GitHub Copilot (changelog di GitHub)
- @github su X: Gemini 4 Neon
- Claude Code v2.1.328
- Kimi Code 2.7.0
- Kimi Code Desktop 1.4.0
- Devin Security Threats (Cognition)
- @cognition su X: Devin Security Threats
- Devin per le migrazioni Databricks (Cognition)
- @Replit su X: Amuse
- Repository replit/amuse (GitHub)
- Aumentare il personale per risolvere il problema (Replit)
- @Replit su X: Optimization-Bench
- Computer use in Gemini per Mac (Google)
- @GeminiApp su X: computer use
- Note di rilascio di ChatGPT
- Genie 4 nell’API Gemini (Google)
- Documentazione di Genie (AI Studio)
- Tool Retrieval nell’API Gemini (Google)
- @OpenAIDevs su X: GPT-Live-1.1
- Scheda GPT-Live-1.1 (OpenAI)
- Prompting di GPT-Live per lingue e accenti regionali (OpenAI)
- NVIDIA e Microsoft a Ignite (NVIDIA)
- Mini PC RTX Spark disponibili (NVIDIA)
- DaisyRose-27B (articolo di RadixArk)
- DaisyRose-27B-NVFP4 (Hugging Face)
- @yb2698 su X: adattatore Hermes
- Qwen3.8-27B-hermes-adapted (Hugging Face)
- @OVHcloud su X: Olala mini 7A1B
- Olala-v1.0-mini-7A1B (Hugging Face)
- PEFT v0.22.0
- Theorizer in Asta (Ai2)
- Repository allenai/asta-theorizer (GitHub)
- @SakanaAILabs su X: protocollo d’intesa con Salesforce
- Changelog di Antigravity
- @genspark_ai su X: Gemini 4 Neon
- Codex CLI 0.172.0-alpha.2
- Changelog di Codex, ChatGPT per iOS 1.2026.314
- Copilot CLI 1.0.115-1
- Copilot SDK 2.0.2-preview.0
- Attendere gli eventi di una pull request con GitHub CLI (changelog di GitHub)
- Connettori Supabase, Box, Calendly e altri per Copilot (changelog di GitHub)
- Gemini CLI v0.70.0
- Gemini CLI v0.71.0-preview.0
- CLI mistral 0.19.0
- CLI mistral 0.20.0
- Note di rilascio di Delta 0.28.0
- Amp per Windows (Amp)
- Warp Learn (Warp)
- @cognition su X: DevinDash
- Changelog dell’API Perplexity
- @togethercompute su X: Qwen4-Max
- @NousResearch su X: Qwen4-Max in Nous Portal
- @perplexity_ai su X: skills personali di Brain
- Skills che si migliorano autonomamente (Perplexity)
- RAG come servizio (Perplexity)
- Caso di studio Sumitomo Life (OpenAI)
- Note di ChatGPT Enterprise ed Edu (OpenAI)
- Candid Health (ElevenLabs)
- Enterprise Live Migrations da Azure DevOps (changelog di GitHub)
- Immagini dei runner RHEL in disponibilità generale (changelog di GitHub)
- @genspark_ai su X: modello di Deep Research con Baseten
- Baseten e Genspark addestrano un modello di ricerca (Baseten)
- @AIatMeta su X: Muse Wonder sul benchmark BAR
- @HuggingApps su X: Clairic
- @googlegemma su X: Gemma 4 E2B presso Airbnb
- Atto (NeuML, Hugging Face)
- ja-NCM (Hugging Face)
- Dentro Omniverse (NVIDIA)