ai-powered-markdown-translatorArtigo traduzido do francês para o português com gpt-6.1-sol.
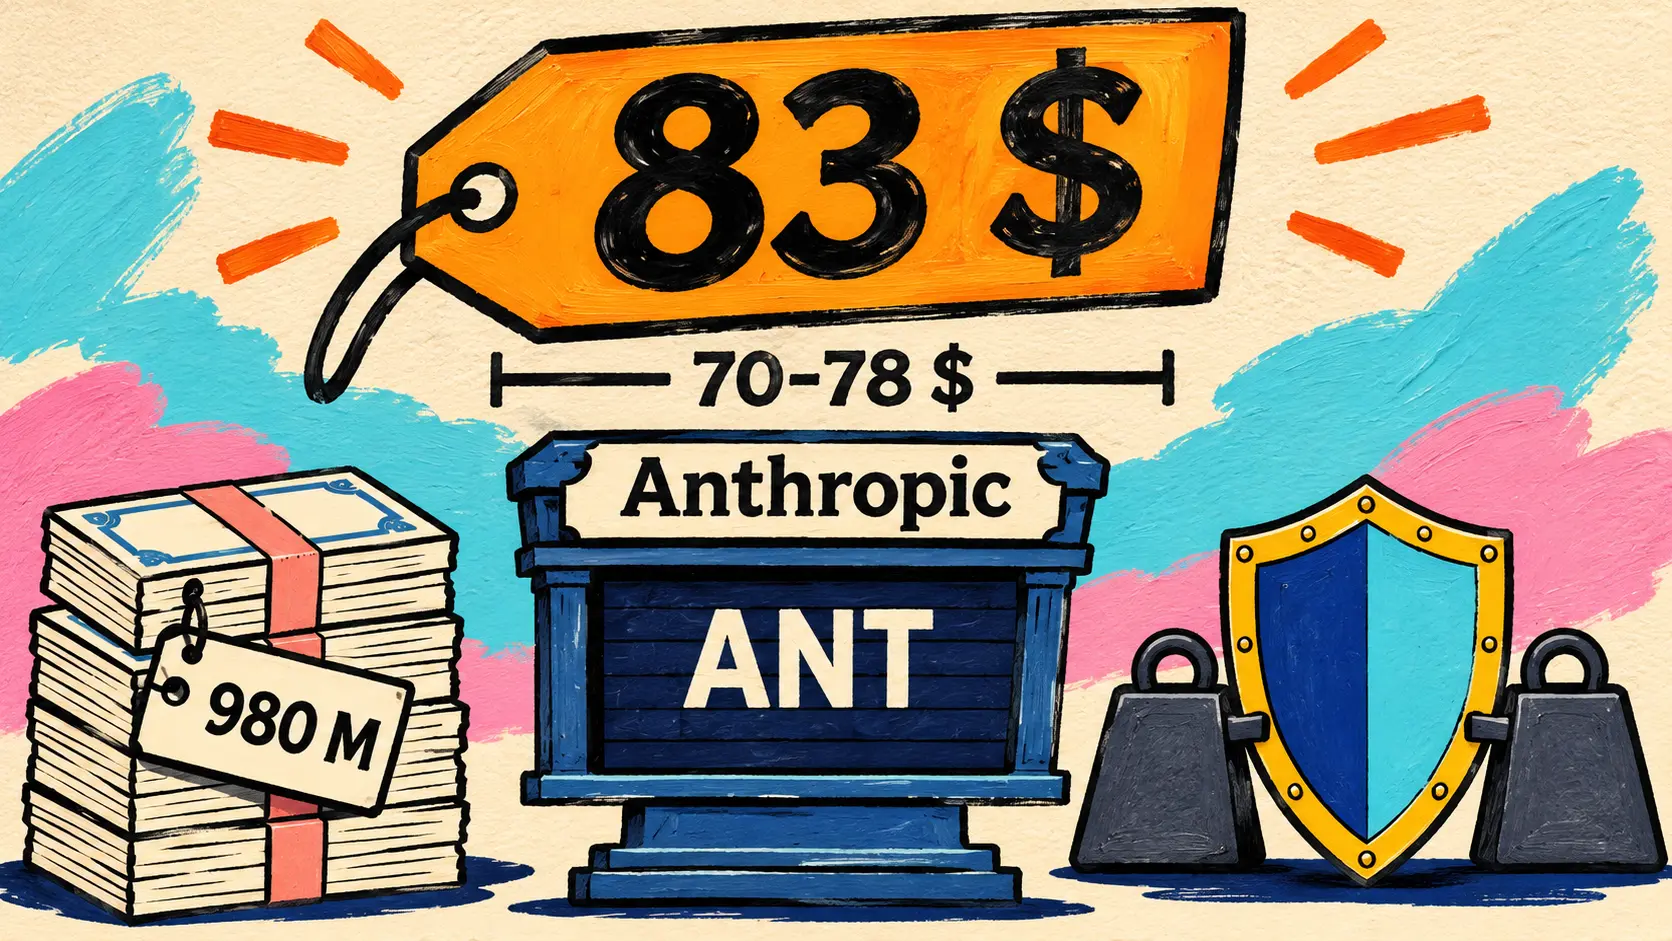
A Anthropic fixa o preço da sua oferta pública inicial em 83 dólares por ação, acima do intervalo de 70 a 78 dólares, com uma oferta aumentada para 980 milhões de ações e cotação prevista no Nasdaq sob o símbolo ANT. A OpenAI publica novas medições da sua investigação acelerada por agentes, que agora concluem sozinhos 46 % das tarefas de duas a quatro horas, e mostra como agentes Codex detetam os abrandamentos do ChatGPT. O Ideogram 4.6 gera imagens em 4K nativo, o Gemini 4 Neon assume a liderança do CursorBench 4.1 e chega ao GitHub Copilot, o Genie 4 abre-se aos programadores por cerca de 0,10 dólar por segundo, e a aplicação Gemini para Mac aprende a utilizar o computador.
Finanças: Anthropic fixa o preço da sua oferta pública inicial em 83 dólares por ação
18 de novembro — A Anthropic fixou o preço da sua oferta pública inicial em 83 dólares por ação de classe A, acima do intervalo de 70 a 78 dólares anunciado no início da ronda junto dos investidores (roadshow), em 10 de novembro. A oferta também aumentou: abrange 980 milhões de ações, contra os 825 milhões previstos. A Anthropic vende 956 351 354 e os acionistas existentes 23 648 646, sem que a empresa receba o produto destas últimas. Os bancos dispõem ainda de uma opção de 30 dias sobre 147 milhões de ações.
| Elemento da oferta | Anúncio de 10 de novembro | Preço fixado em 18 de novembro |
|---|---|---|
| Preço por ação | 70 a 78 dólares | 83 dólares |
| Ações oferecidas | 825 000 000 | 980 000 000 |
| das quais vendidas pela Anthropic | 801 351 354 | 956 351 354 |
| das quais de acionistas existentes | 23 648 646 | 23 648 646 |
| Opção dos bancos (30 dias) | 123 750 000 | 147 000 000 |
A declaração de registo foi declarada efetiva pela SEC em 18 de novembro. As primeiras cotações estavam previstas para 19 de novembro no Nasdaq Global Select Market, sob o símbolo ANT, e a conclusão da operação para 20 de novembro. A Anthropic não publica o montante angariado nem a sua avaliação. Ao preço fixado, as 956 351 354 ações vendidas pela empresa representam cerca de 79,4 mil milhões de dólares brutos, um cálculo feito a partir dos números do comunicado. Para os investidores particulares do Espaço Económico Europeu, incluindo França, o prospeto europeu previa um preço final idêntico ao da oferta americana.
Em 19 de novembro, @AnthropicAI publicou um pequeno vídeo, seguido de um texto de Dario Amodei. Nele, o dirigente recorda que ele e Daniela Amodei perderam o pai devido a uma doença que se tornou curável alguns anos depois. Segundo ele, uma IA suficientemente poderosa, a trabalhar com os humanos, poderia condensar um século de progresso científico e médico numa década, embora os resultados sejam, por enquanto, preliminares. Enumera os riscos: utilização maliciosa por indivíduos ou Estados, perturbação económica, perda de controlo dos sistemas. Compromete-se a ajustar o ritmo do treino e da disponibilização dos modelos durante o tempo necessário para garantir que são seguros e permanecem sob controlo humano.
We will not bend to either business or political pressure.
🇵🇹 Não cederemos nem a pressões comerciais nem a pressões políticas. — @AnthropicAI no X
Para Dario Amodei, a operação reforça a situação financeira da empresa e, com ela, a sua determinação; retoma a ideia de uma «corrida para o topo» (race to the top).
🔗 Anúncio do preço da oferta pública inicial (Anthropic) · @AnthropicAI no X: o preço fixado
Agentes a trabalhar na OpenAI: o relatório sobre a aceleração da investigação e a Performance Factory
18 de novembro — Dois meses após um primeiro relatório, a OpenAI publica novas medições da forma como os seus próprios agentes aceleram a sua investigação. O título resume a conclusão: a fronteira é irregular (jagged frontier). Entre março e outubro, a percentagem de tarefas estimadas em duas a quatro horas de trabalho humano que os agentes concluem sem intervenção passa de 23 % para 46 %, e de 13 % para 35 % nas tarefas de quatro a oito horas. Tudo depende do trabalho: 79 % de sucesso na monitorização de um treino, 72 % na resposta a uma questão técnica, apenas 25 % na escrita de código de inferência e de serviço. A OpenAI assinala que as tarefas atribuídas podem ter mudado ao mesmo tempo que os modelos.
| Indicador interno da OpenAI | Valor publicado |
|---|---|
| Sucesso sem ajuda, tarefas de 2 a 4 horas | 23 % em março, 46 % em outubro |
| Sucesso sem ajuda, tarefas de 4 a 8 horas | 13 % em março, 35 % em outubro |
| Despesa mediana com agentes por investigador e por dia | 2 400 dólares em outubro (+62 %) |
| Despesa no percentil 90 | 23 000 dólares em outubro (+105 %) |
| Dias-agente por investigador e por dia | de 0,5 a 5,7 |
| Tempo documentado em segurança e alinhamento | +77 % de janeiro a setembro |
| Fronteira dos modelos OpenAI no índice OECI | +16,4 pontos por ano, contra 14 observados pela Epoch |
As despesas são calculadas aos preços de tabela da API, e os investigadores não têm quota. O tempo de agente por investigador foi multiplicado por onze; em meados de outubro, mais de dois terços dos investigadores acompanhados executavam pelo menos quatro agentes em simultâneo no pico do seu dia. Em setembro, o valor desta utilização representava cerca de duas vezes a remuneração, excluindo ações, da organização de investigação, enquanto a disponibilização interna representa apenas 2 % da capacidade de computação dedicada à investigação.
O relatório acompanha também a origem das ideias. Para o GPT-6.2 Astra, investigadores do pré-treino desenvolveram algumas ideias em diálogo com o Codex, tendo um deles atribuído ao agente intuições essenciais; as do GPT-6 Astra eram inteiramente humanas. Para disporem durante três meses de agentes de código melhores do que o GPT-5.2, os investigadores inquiridos abdicariam, em mediana, de 40 % dos efetivos da sua equipa ou de 30 % da sua capacidade de computação. As entrevistas recordam as limitações: fraco discernimento quanto às ideias de investigação, código de baixa qualidade, desvios por etapas desnecessárias, o que exige uma supervisão humana rigorosa.
O tempo dedicado à segurança e ao alinhamento regista o maior aumento absoluto de todas as áreas, com uma inflexão após o incidente da Hugging Face em julho. A OpenAI introduz também o OECI, um índice derivado do Epoch Capabilities Index, no qual os seus modelos obtêm melhores resultados do que no índice da Epoch, provavelmente devido à combinação de benchmarks, segundo a empresa. Considera, por fim, que os laboratórios deveriam ser obrigados a acompanhar e a publicar indicadores de autoaperfeiçoamento recursivo (recursive self-improvement, RSI), o processo pelo qual a IA acelera o desenvolvimento dos sistemas futuros, esclarecendo que esta publicação não deve ser interpretada como uma intenção de procurar uma RSI completa. O relatório apresenta os seus números como uma visão parcial, em parte baseada em declarações.
🔗 Aceleração da investigação: a fronteira irregular (OpenAI) · @OpenAI no X
OpenAI detalha a Performance Factory, onde agentes Codex investigam os abrandamentos do ChatGPT
19 de novembro — O blogue de Engenharia da OpenAI dá um exemplo concreto deste trabalho confiado aos agentes: a Performance Factory, um sistema autónomo na cloud onde agentes Codex detetam regressões de desempenho do ChatGPT. Um alerta abre uma tarefa, um agente identifica a causa, outro propõe uma correção sob a forma de pull request, um engenheiro decide integrá-la, e depois um agente verifica, após a disponibilização, se as métricas regressaram ao normal. Em pouco mais de três meses, este primeiro fluxo de trabalho acompanhou mais de 1 700 investigações e encontrou a causa de mais de 600 casos, ou seja, 17 investigações automatizadas por dia.
O conhecimento da equipa está reunido num skill partilhado, perf-forensics, que indica ao Codex quais as ferramentas a utilizar entre mais de 30 ferramentas de desempenho. Para evitar que um agente se fique pela primeira explicação plausível, uma segunda sessão do Codex tenta refutar cada diagnóstico: de 100 causas revistas manualmente, 70 % foram consideradas corretas. A OpenAI reconhece que a correção continua a ser a etapa mais difícil e estuda a deteção proativa de regressões, bem como a entrega sem intervenção humana de correções de baixo risco, sem calendário definido.
🔗 Como a Performance Factory da OpenAI mantém o ChatGPT rápido · Fio de @OpenAIDevs
Imagens e vídeo generativos: Ideogram 4.6 em 4K nativo, Kling 4.0 em 4K e HDR de 10 bits
19 de novembro — A Ideogram lança o Ideogram 4.6, um novo modelo de imagem que gera diretamente em 4K, sem ampliação (upscaling): cada detalhe, da pele ao tecido, é produzido à resolução máxima. A Ideogram afirma ter trabalhado para eliminar o aspeto de «IA» e a pele cerosa das imagens, com poros visíveis, pequenas rugas e texturas naturais, e anuncia uma fidelidade muito superior das cores e dos materiais, tendo em vista o comércio eletrónico e a fotografia de produto.
O retoque continua a ser o núcleo do modelo: muito menos desvio de píxeis (pixel drift) fora da zona modificada, e uma geração a partir de esboços mais fiel ao desenho inicial. A Ideogram afirma que a versão 4.6 ocupa o primeiro lugar da classificação de retoque em várias etapas (Multi-step Image Edit) da Rapidata, à frente de todos os outros modelos, incluindo Seedream 5.5 e FLUX 3 Image, sem indicar uma pontuação; a versão 4.5 já reivindicava, em 10 de novembro, a liderança de uma classificação da Rapidata de retoque sucessivo.
| Acesso ao Ideogram 4.6 | O que é anunciado |
|---|---|
| Aplicação e API da Ideogram | disponíveis a partir de 19 de novembro |
| Plataformas parceiras (12) | Leonardo, Runway, fal, Comfy, Runware, Scenario, Invideo, MyDesigns, Sociaro, Moda, HeyGen e Luma |
| Preço | nenhum preço no anúncio |
| Pesos abertos | versão aberta da 4.6 prometida, sem data |
Quanto aos pesos abertos, a Ideogram muda de planos. Questionada sobre os da versão 4.5, anunciados como estando «para breve» desde 30 de setembro, responde que saltará a 4.5 para passar diretamente a uma versão aberta da 4.6, sem indicar uma data. O Ideogram 4.0 tinha sido publicado com pesos abertos em 3 de junho.
We’ll skip 4.5 open and go directly to 4.6 open.
🇵🇹 Vamos saltar a versão aberta da 4.5 e passar diretamente a uma versão aberta da 4.6. — @ideogram_ai no X
🔗 Anúncio do Ideogram 4.6 no X
Kling 4.0 passa para 4K nativo com saída HDR de 10 bits
19 de novembro — O mesmo movimento no vídeo: a Kling anuncia que o Kling 4.0 passa a suportar resolução 4K nativa e saída HDR de 10 bits, tanto em 4K como em 1080p, para mais detalhes e cores mais ricas. Esta saída HDR tinha sido prometida «para breve», sem data, quando o Kling 4.0 passou à disponibilidade plena, em 15 de outubro; o Kling 3.0 já gerava em 4K nativo desde 23 de abril. O anúncio resume-se a um único tweet: sem artigo, notas de versão, preço em créditos, duração máxima ou esclarecimentos sobre a API.
Gemini 4 Neon no Cursor e no GitHub Copilot: na liderança do CursorBench 4.1, disponível para Pro+, Max, Business e Enterprise
Poucas horas após o seu lançamento pela Google, aqui abordado em 18 de novembro, o Gemini 4 Neon chega às ferramentas de código de terceiros. O Cursor e o GitHub Copilot disponibilizam-no logo na noite de 18 de novembro; o Genspark e o Antigravity CLI seguem-se no dia 19 (ver as Breves).
Cursor disponibiliza o Gemini 4 Neon, na liderança do CursorBench 4.1 com 65,4 % em esforço Extra High
18 de novembro — Segundo o Cursor, o Gemini 4 Neon estabelece, no seu esforço predefinido, uma nova fronteira de custo-desempenho no CursorBench 4.1: 63,7 % contra 57,3 % do Gemini 4 Hydrogen, que substitui na programação agêntica do dia a dia, continuando o Gemini 4 Carbon a ser recomendado para as tarefas mais difíceis. O CursorBench 4.1 é uma nova versão do benchmark, datada do mesmo dia (problemas de cumprimento de instruções alterados, tempo concedido ao agente aumentado): as suas pontuações não são comparáveis às do CursorBench 4.0 publicadas para o Carbon e o Hydrogen no início de novembro.
| Modelo e esforço (CursorBench 4.1) | Pontuação | Custo médio por tarefa |
|---|---|---|
| Gemini 4 Neon Extra High | 65,4 % | 10,67 dólares |
| Gemini 4 Neon High | 63,7 % | 6,54 dólares |
| Gemini 4 Carbon High | 61,5 % | 8,52 dólares |
| Gemini 4 Hydrogen Extra High | 61,4 % | 8,09 dólares |
| Claude Fable 5.2 Max | 61,3 % | 48,11 dólares |
| Gemini 4 Carbon Medium | 60,4 % | 7,22 dólares |
| Claude Fable 5.2 Extra High | 58,8 % | 17,84 dólares |
| Claude Opus 5.5 Max | 58,1 % | 11,88 dólares |
| Gemini 4 Neon Medium | 57,7 % | 3,07 dólares |
| Gemini 4 Hydrogen High | 57,3 % | 4,57 dólares |
No Cursor, o Neon (gemini-4-neon, contexto de 200K tokens, até 1M) é faturado a 3 dólares por milhão de tokens de entrada, 0,15 dólar na leitura de cache e 15 dólares na saída. Tal como os outros modelos de terceiros, não faz parte da utilização incluída: é descontado do crédito pré-pago da The X Subscription ou da reserva «Other Models» dos antigos planos do Cursor.
🔗 Anúncio do Cursor no X · Tabela CursorBench (Cursor)
Gemini 4 Neon chega ao GitHub Copilot para Pro+, Max, Business e Enterprise
18 de novembro — O GitHub disponibiliza o Gemini 4 Neon de forma geral no Copilot, apresentando-o como um modelo concebido para programação agêntica, utilização de ferramentas em várias etapas e trabalho intelectual. O changelog retoma os argumentos da Google: uma qualidade próxima da do Gemini 4 Carbon com um custo em tokens por tarefa mais baixo, respostas que começam mais depressa, menos alterações não solicitadas no código e menos afirmações sem fundamento sobre ferramentas ou resultados de testes, sem apresentar números que sustentem essas afirmações.
O Neon está disponível para os subscritores Copilot Pro+, Max, Business e Enterprise; o plano Pro não é mencionado, embora o Gemini 4 Hydrogen tenha chegado a esse plano logo a 13 de novembro. Funciona em dez interfaces: VS Code, Visual Studio, Copilot CLI, o agente de código, a aplicação GitHub Copilot, github.com, GitHub Mobile, os IDE JetBrains, Xcode e Eclipse. É faturado ao preço de tabela do fornecedor, conforme a utilização, com uma disponibilização gradual. Nas empresas, é ativado automaticamente enquanto a ativação por predefinição dos novos modelos se mantiver, exceto se o administrador desativar este modelo.
🔗 Gemini 4 Neon no GitHub Copilot (changelog) · @github no X
Agentes de código: Claude Code 2.1.328, Kimi Code 2.7.0, Devin Security Threats, Devin for Databricks Migrations, Amuse e Optimization-Bench da Replit
Claude Code 2.1.328 disponibiliza o modo auto para Opus 4.6 e Sonnet 4.6 em fornecedores terceiros e centra /code-review nos bugs
19 de novembro — O Claude Code 2.1.328 conta com 144 entradas, incluindo 91 correções. O modo auto passa a estar disponível para Claude Opus 4.6 e Sonnet 4.6 no Amazon Bedrock, Google Cloud’s Agent Platform, Microsoft Foundry e no gateway Claude apps: uma sessão interativa iniciada sem modo de autorização arranca diretamente em modo auto nesses fornecedores, e a definição disableAutoMode permite desativá-lo. A 19 de novembro, a página de documentação dos modos de autorização ainda reservava o modo auto, nesses fornecedores, ao Sonnet 5 e posteriores, Opus 4.7 e posteriores, Haiku 5.5 e aos modelos Fable.
Na maioria dos modelos, o comando /code-review passa a assinalar apenas bugs e desvios ao CLAUDE.md; as limpezas de código (reutilização, simplificação, eficiência) passam pelo /simplify, e cada problema identificado recebe a classificação Important, Pre-existing ou Nit. O bloqueio em caso de falha ("onFailure": "block"), acrescentado a 8 de outubro aos hooks command e HTTP, estende-se aos hooks mcp_tool. No terminal, através da API Anthropic, o modelo pequeno e rápido passa a redigir os resumos de progresso dos subagentes. O Code Mode recebe 22 entradas, incluindo a eliminação de uma pausa de 0,75 segundo após a maioria dos scripts em modo auto e bypass, e o runner autoalojado recebe 26. Foi corrigida uma regressão da versão 2.1.327 que interrompia o esforço dos subagentes no Bedrock, Agent Platform e Foundry; o canal estável mantém-se na versão 2.1.311.
Kimi Code 2.7.0 passa a suportar Amazon Bedrock, Kimi Code Desktop 1.4.0 liga-se a Claude Code, Codex e Cursor
19 de novembro — A Moonshot AI publica o Kimi Code 2.7.0 (24 entradas), a primeira versão menor desde a 2.6.0 de 12 de novembro, seguida da aplicação Kimi Code Desktop 1.4.0 (34 entradas), treze minutos depois. A CLI passa a suportar fornecedores Amazon Bedrock, apresenta experimentalmente uma previsão do próximo prompt após cada turno e acrescenta uma definição «Follow-up behavior», cujo modo Steer faz com que a tecla Enter reoriente o turno em curso, em vez de colocar a mensagem em fila. Para a automatização, kimi server inicia o servidor local sem abrir um navegador, e três novos pontos de acesso HTTP permitem controlar as sessões. Cada projeto pode apontar para os seus próprios hosts SSH; os antigos pontos de acesso /api/v2 desaparecem em favor de /api/v1, uma alteração da API que, ainda assim, é classificada como uma simples correção.
A aplicação de desktop liga-se a agentes externos, como Claude Code, Codex e Cursor, para lhes passar sessões, rever o histórico e colaborar entre turnos. Acrescenta também o Qwen Coding Plan entre os fornecedores.
🔗 Kimi Code 2.7.0 · Kimi Code Desktop 1.4.0
Cognition lança Devin Security Threats, um índice gerido de vulnerabilidades recentes para analisar com um clique
19 de novembro — A Cognition acrescenta ao Devin Security um índice gerido de vulnerabilidades acabadas de divulgar. A empresa parte de dois anúncios da semana: Java4Shell (17 de novembro), que afeta o ambiente de execução Java, e NGINX2Root (18 de novembro), cinco bugs de corrupção de memória no nginx; ambos podem levar à execução remota de código. Cada ameaça descreve o que é afetado, como um atacante a exploraria e o que a corrige. A Cognition publica as ameaças relativas às grandes divulgações, e cada equipa pode escrever as suas a partir de um relatório de bug bounty, de um aviso de fornecedor ou de uma análise de incidente.
O botão Scan with Devin inicia uma análise centrada na ameaça nos repositórios escolhidos, e depois o Devin abre pull requests para revisão. No modo Auto-triage, o Devin volta a analisar os repositórios selecionados sempre que surge uma nova ameaça acima de uma gravidade mínima. Duas skills open source escritas em Markdown, fix-nginx-vuln e fix-java-vuln, juntam-se ao plugin Vulnerability Fixes do Devin Marketplace e podem ser utilizadas por outro agente de código. Não foi anunciado qualquer preço.
🔗 Devin Security Threats (Cognition) · @cognition no X
Cognition lança Devin for Databricks Migrations para migrar armazéns de dados legados para Databricks
19 de novembro — Em conjunto com a Databricks, a Cognition lança uma oferta dedicada à migração. O Devin converte o código dos armazéns de dados legados (Teradata, Oracle, SQL Server, Informatica, Redshift, Snowflake), testa-o no espaço de trabalho do cliente, corrige as falhas e compara cada origem com a respetiva cópia no Databricks antes da transição: esquema, número de linhas, agregados e, por fim, comparação linha a linha. Segundo a Cognition, uma empresa de energia da Fortune 500 migrou uma plataforma de 142 objetos para o Unity Catalog em oito dias, e a consultora Zeb concluiu em duas semanas e meia uma migração NetSuite prevista para quatro.
A oferta está disponível no Databricks Marketplace e é contabilizada no compromisso de despesa já celebrado com a Databricks (Universal Commit). A Cognition indica também que utiliza a Databricks como fornecedor estratégico de inferência, para modelos open source e de fronteira disponibilizados através de um único ponto de acesso. Não foi comunicado qualquer preço.
🔗 Devin for Databricks Migrations (Cognition)
Replit publica Amuse, um assistente pessoal open source que o Missions reconstruiu em três dias
19 de novembro — Depois do TernSign, a Replit apresenta uma nova realização do Missions, o seu harness de enxames de agentes: Amuse, um assistente pessoal de IA open source (Apache 2.0) que corre no computador do utilizador. Segundo a Replit, o enxame tinha o desafio de reproduzir «o assistente de IA de referência», sem o nomear, e conseguiu-o em três dias, tendo o Security Scanner da plataforma servido depois para corrigir as vulnerabilidades encontradas.
O Amuse faz pesquisas na web com fontes, controla um navegador que se pode observar e cujo controlo se pode retomar, gere lembretes e tarefas em segundo plano e constrói pequenas aplicações. A sua memória é guardada em ficheiros legíveis, as suas credenciais num cofre encriptado do qual o modelo apenas vê tokens de substituição, e pede aprovação antes de qualquer envio, submissão de formulário, pagamento ou novo agendamento. «Gratuito» exclui o modelo: exige uma chave de API OpenAI (GPT-6.2 Sol para o agente, GPT-6 Luna para as etapas rápidas) e uma base de dados PostgreSQL, e continua limitado a uma pessoa num computador, sem servidores MCP.
🔗 Anúncio da Replit no X · Repositório replit/amuse
Replit publica Optimization-Bench: o melhor agente a solo não faz o melhor enxame
19 de novembro — A equipa de investigação da Replit publica o Optimization-Bench, um banco de testes de otimização de desempenho sobre versões fixas de bibliotecas open source, das quais quatro em catorze são analisadas: NumPy, SQLite, SQLGlot e Git. Seis modelos trabalharam a solo e depois em enxames de 8, 16 e 32 agentes, durante duas horas, com a avaliação a decorrer numa máquina a que os agentes não tinham acesso.
| Métrica do Optimization-Bench | Resultado publicado pela Replit |
|---|---|
| GPT-6.2 Astra a solo, no NumPy | mais de 3 vezes mais rápido do que Opus 5.5 a solo |
| Enxames de 32 agentes GPT-6.2 Astra | abaixo da sua pontuação a solo em 3 de 4 tarefas |
| Ganho mediano dos enxames de Opus e Sonnet 5.5 | 1,30 vezes a sua pontuação a solo, com 16 e 32 agentes |
| Mensagens do Opus 5.5 enviadas para o quadro partilhado | 82 % |
O GPT-6.2 Astra domina a solo, mas os seus enxames deixam de melhorar a partir de 8 agentes. Pelo contrário, os enxames de Claude Opus 5.5 e Claude Sonnet 5.5 superam sempre as suas execuções a solo; no NumPy, o Opus passa de 3,7 vezes a solo para 18,9 vezes num enxame de 32, um número já apresentado no lançamento do Missions. A Replit atribui a diferença à organização: as equipas eficazes escrevem num quadro partilhado e deixam o coordenador distribuir e depois integrar o trabalho (no enxame NumPy de 32 agentes Opus, nunca escreveu a um único agente executor), enquanto as outras transformam o coordenador numa central telefónica cuja caixa de entrada cresce a cada agente acrescentado.
🔗 Resolver o problema aumentando a equipa (Replit) · @Replit no X
Assistentes para o público em geral: computer use no Gemini para Mac, ChatGPT Health no Android, no desktop, nos dots e nos sites
A aplicação Gemini para Mac controla as aplicações e a web em segundo plano com computer use
19 de novembro — A aplicação Gemini para Mac já consegue utilizar o computador (computer use) em vez do utilizador. O Gemini encadeia tarefas com várias etapas entre ficheiros locais, aplicações de desktop e a web: cliques, introdução de texto, menus, formulários. Trabalha numa janela isolada em segundo plano, com uma pré-visualização em direto na conversa, pelo que o ecrã principal e o cursor continuam livres. O utilizador escolhe as aplicações acessíveis, acompanha cada etapa, pode colocar tudo em pausa e aprova as ações importantes antes da sua execução.
Os exemplos da Google vão da edição de fotografias em lote ao preenchimento de orçamentos de envio a partir de PDF locais, passando por uma apresentação Google Slides criada a partir de painéis de controlo; o vídeo publicado no X transforma um esboço num modelo 3D que pode ser animado no Blender. A funcionalidade está a ser disponibilizada em inglês nos Estados Unidos para os subscritores Google AI Plus, Pro e Ultra, em Macs com processador Apple Silicon e macOS Sequoia 15.0 ou superior, com uma conta Google pessoal e idade igual ou superior a 18 anos. Para os programadores, a ferramenta Computer Use da API Gemini está em disponibilidade geral desde o final de outubro; a aplicação para o público em geral traz agora este controlo ao Mac do utilizador.
🔗 Computer use no Gemini para Mac (Google) · @GeminiApp no X
ChatGPT alarga o Health ao Android com Health Connect, à aplicação de desktop, aos dots e aos sites
19 de novembro — O espaço Health do ChatGPT chega à aplicação de desktop, aos dots, aos sites e ao Android. No Android, liga-se ao Health Connect para identificar tendências de sono e atividade. Os dots, os agentes pessoais do ChatGPT, podem sugerir por iniciativa própria outro horário de treino quando uma reunião se sobrepõe, ou relembrar opções de prevenção com base nos registos médicos ligados. No computador, a OpenAI dá o exemplo de um site criado para acompanhar a preparação para uma maratona. A disponibilização é gradual e limitada aos Estados Unidos, para os planos Free, Go, Plus e Pro; os dots continuam reservados ao plano Pro. O Health encontra-se na barra lateral ou no menu Explore.
API Gemini: Genie 4 disponível para programadores, Tool Retrieval em versão preliminar
Genie 4 chega à API Gemini e ao Google AI Studio, por cerca de 0,10 dólar por segundo de mundo gerado
19 de novembro — No dia seguinte à sua chegada ao Project Genie para os subscritores Google AI Ultra, o Genie 4 fica disponível para programadores na API Gemini, através da Interactions API, e no Google AI Studio, com um canvas interativo e aplicações de exemplo. A partir de um texto, de uma imagem de referência ou de ambos, o modelo de mundo gera um ambiente contínuo com som sincronizado, dos sons ambiente aos diálogos; é possível deslocar-se nele com o teclado e, durante o percurso, alterar por texto as condições meteorológicas, a iluminação, os objetos ou os eventos.
| Característica do Genie 4 na API | Valor documentado |
|---|---|
| Identificador do modelo | models/genie-4 (Interactions API) |
| Saída de vídeo e áudio | 1280x720, 16:9, 24 imagens/s, áudio estéreo 48 kHz |
| Acesso | chave de API do nível pago |
| Faturação | 240 tokens de vídeo por imagem, ou seja, cerca de 0,10 dólar por segundo |
| Duração de uma sessão | possível degradação após 60 a 90 s, limite de 120 s |
| Regiões de serviço | Estados Unidos, Europa Ocidental, Japão |
A documentação avisa que fechar o separador não interrompe imediatamente a geração: só o encerramento explícito da sessão (complete()) interrompe a faturação. O Genie 4 não mantém uma cena 3D em memória: um objeto que fique fora de vista durante 8 segundos ou mais, ou uma volta completa sobre si próprio, pode fazer com que os pontos de referência se desloquem ou sejam repostos. Cada saída inclui uma marca de água SynthID.
🔗 Genie 4 na API Gemini (Google) · Documentação do Genie (AI Studio)
A API Gemini lança Tool Retrieval em versão preliminar, que carrega os esquemas das ferramentas a pedido
19 de novembro — A Google acrescenta à API Gemini a pesquisa de ferramentas que a OpenAI e a Anthropic já disponibilizavam. Com o Tool Retrieval, em versão preliminar na Interactions API, um agente ligado a dezenas ou centenas de ferramentas deixa de enviar todos os seus esquemas de parâmetros em cada pedido: basta acrescentar uma ferramenta tool_search e marcar com defer_loading: true as ferramentas a manter em reserva. O modelo vê apenas o nome e a descrição de cada uma, pede uma ferramenta pelo nome quando precisa dela, e a API carrega o esquema no mesmo pedido, do lado do servidor, sem ser necessário criar um índice.
O mecanismo estende-se aos servidores MCP remotos e respeita a cache de prefixos, já que os esquemas carregados são acrescentados mais adiante na conversa. As equipas que gerem o seu próprio registo de ferramentas podem executar a pesquisa na sua infraestrutura, à custa de uma ida e volta adicional. O Tool Retrieval não é faturado à parte: tool_search acrescenta um pequeno bloco fixo de tokens de entrada, cada esquema carregado é faturado como entrada durante o resto da conversa, e a Google, que não publica qualquer número sobre a poupança, aconselha a medir o ganho no próprio tráfego. A funcionalidade funciona com o Gemini 3.6 e os modelos posteriores, incluindo toda a família Gemini 4.
🔗 Tool Retrieval na API Gemini (Google)
Voz: GPT-Live-1.1 chega à API, com standby a 0,02 dólares por minuto
19 de novembro — Pouco mais de um mês após a sua chegada à voz do ChatGPT Plus e Pro, a 15 de outubro, o GPT-Live-1.1 entra na API da OpenAI (gpt-live-1.1 em v1/live/sessions). O modelo melhora a pronúncia, a consistência do sotaque e a transcrição nas conversas de voz multilingues, e integra-se numa configuração de sessão Live existente.
A novidade mais concreta é o modo de espera (standby), disponível tanto para GPT-Live-1 como para GPT-Live-1.1 nas sessões WebRTC. Após um silêncio ajustável de 5 a 60 segundos, o modelo entra em pausa sem desligar a chamada, e o preço por minuto passa de 0,05 para 0,02 dólares até alguém voltar a falar.
| Tipo de sessão GPT-Live | Preço por minuto |
|---|---|
| Sessão ativa | 0,05 dólares |
| Standby (WebRTC, inferência em pausa) | 0,02 dólares |
A utilização do modelo backend e das ferramentas continua a ser faturada separadamente, e as duas versões têm limites distintos de sessões simultâneas. Os SDK Python 3.56.0 e Node 7.61.0 acrescentam o modelo, e a OpenAI acompanha o lançamento com um guia sobre idiomas e sotaques regionais.
🔗 Anúncio de @OpenAIDevs · Ficha do GPT-Live-1.1 · Prompting do GPT-Live para idiomas e sotaques regionais
Hardware e cloud: NVIDIA e Microsoft no Ignite, mini-PC RTX Spark disponíveis
NVIDIA e Microsoft alargam a colaboração no Ignite, de Vera Rubin no Azure a Nemotron 3.5 no Foundry
19 de novembro — Por ocasião do Microsoft Ignite, a NVIDIA detalha, num artigo assinado por Dave Salvator, o alargamento da sua colaboração com a Microsoft. Os sistemas Vera Rubin NVL72 estão em funcionamento nos centros de dados do Azure e o acesso às máquinas virtuais que os utilizam está a ser alargado; o artigo fala de uma pré-visualização de Vera Rubin no Azure, sem data de disponibilidade geral.
| Anúncio da NVIDIA e da Microsoft | Estado segundo o artigo |
|---|---|
| VM Azure em Vera Rubin NVL72 | acesso alargado, pré-visualização |
| Nemotron 3.5 Super, Lightning, Embed, Rerank, Parse e Content Safety | gama alargada no Foundry Managed Compute |
| Nemotron 3.5 Bolt e Transcribe | em breve |
| Nemotron 3.5 e modelos Cosmos no Foundry Local | suporte alargado, incluindo os ambientes Azure Local |
| Azure Local | GPU RTX PRO 6000 Blackwell em breve, extensão a Jetson Thor e Jetson Orin |
| Direct Stream no Windows 365 | dois fluxos 4K a 60 imagens/s, pré-visualização pública no início de 2027 |
| BioNeMo e ALCHEMI no Microsoft Discovery | entrada no catálogo, primeira integração de RFD4-Proteina |
Exemplo citado: a EY adaptou modelos abertos Nemotron com Programmed Training, o serviço serverless de pós-treino do Foundry, para classificar registos de compras; a precisão aumenta 55 % no seu conjunto de avaliação, com um custo 15 vezes inferior ao de modelos proprietários de ponta, segundo o artigo. A Microsoft AI também utiliza NVIDIA Dynamo para a inferência das execuções (rollouts) de aprendizagem por reforço do seu pós-treino. O artigo recorda, por fim, os resultados MLPerf do Azure: até 10 240 GPU NVIDIA em sistemas GB200 NVL72 em Training v6.1, a maior escala da sessão, e, em Inference v6.1, uma vantagem superior a 10 % dos GB300 NVL72 do Azure sobre as restantes submissões cloud em débito interativo no DeepSeek-R1, segundo a Signal65. Não foi divulgado qualquer preço.
🔗 NVIDIA e Microsoft no Ignite (NVIDIA)
Os mini-PC RTX Spark da ASUS, Dell e MSI estão disponíveis, anuncia a NVIDIA
18 de novembro — A NVIDIA anuncia a disponibilidade dos mini-PC de secretária RTX Spark da ASUS, Dell e MSI, como o ASUS ProArt GR1X ou a série MSI EdgeMesa N AI+; os da Acer, GIGABYTE e HP chegam em breve, tal como a Microsoft Surface RTX Spark Dev Box. Utilizam a mesma plataforma dos portáteis lançados em outubro: processador NVIDIA Grace com 20 núcleos, GPU Blackwell RTX com 6 144 núcleos CUDA, até 128 Go de memória unificada e até 1 petaflop de desempenho de IA. A NVIDIA afirma que conseguem executar localmente modelos de 120 mil milhões de parâmetros. Não foi indicado qualquer preço.
No software, o Switchyard, que distribui as tarefas dos agentes entre modelos locais e cloud, está disponível no Hermes. A Adobe reduz em mais de 50 % o tempo de produção dos ficheiros finais H.264 mais comuns no Premiere, e o Illustrator, agora nativo no Windows on Arm, é até 30 % mais rápido do que a sua versão emulada; o Blender 5.3 integra DLSS 4.5 Ray Reconstruction. Entre os anúncios do Ignite, o Windows Server 2028 chega ao DGX Station for Windows e o Windows ML executa qualquer modelo GGUF do Hugging Face através de llama.cpp.
🔗 Mini-PC RTX Spark disponíveis (NVIDIA)
Modelos abertos: DaisyRose-27B e o adaptador Hermes impulsionam Qwen3.8-27B, OVHcloud publica Olala mini, PEFT v0.22.0
RadixArk publica DaisyRose-27B, um Qwen3.8-27B ajustado por RL que duplica a sua pontuação no Terminal-Bench 4.1
18 de novembro — A RadixArk publica DaisyRose-27B, apresentado como o seu primeiro modelo: um Qwen3.8-27B retreinado por aprendizagem por reforço com Miles, o seu framework open source, em cerca de 1 200 tarefas longas de agentes (até 1,5 hora e mais de 100 chamadas de ferramentas por tentativa), concebidas com a Eigent AI para corrigir os erros do modelo original. Os pesos são publicados sob Apache 2.0 em BF16, FP8 e NVFP4, com o contexto de 256K tokens e a compreensão de imagens do modelo de base. O treino demorou 18 dias em 144 H200.
| Benchmark (pontuação em %) | Qwen3.8-27B | DaisyRose-27B |
|---|---|---|
| Terminal-Bench 4.1 (pass@1) | 5,6 | 12,0 |
| Terminal-Bench 2.1 | 73,0 | 75,5 |
| DeepSWE v1.1 | 42,2 | 46,2 |
| SWE Bench Pro v2 | 91,3 | 94,7 |
| GPQA Diamond | 89,2 | 90,7 |
A RadixArk anuncia também 37 % de utilização útil dos GPU (MFU), contra 16 % para o treinador open source baseado em Megatron, o que representa menos 57 % de tempo de GPU; estes são os números do fornecedor.
🔗 DaisyRose-27B (artigo da RadixArk) · DaisyRose-27B-NVFP4 (Hugging Face)
O projeto harness-hub publica o adaptador Hermes de Qwen3.8-27B, que eleva SWE-Bench Pro de 29,4 para 43,1 % sem raciocínio
19 de novembro — Depois de pi e OpenCode, o projeto harness-hub publica um terceiro adaptador LoRA de Qwen3.8-27B, desta vez para Hermes, o harness de agentes da Nous Research, com uma versão GGUF.
| Benchmark (pass@1) | Qwen3.8-27B | Com o adaptador Hermes |
|---|---|---|
| SWE-Bench Pro (51 tarefas difíceis), sem raciocínio | 29,4 % | 43,1 % |
| SWE-Bench Pro (51 tarefas difíceis), raciocínio xhigh | 45,1 % | 51,0 % |
| Terminal-Bench 2.1, sem raciocínio | 44,7 % | 58,8 % |
| Terminal-Bench 2.1, raciocínio xhigh | 58,8 % | 57,6 % |
O interesse está sobretudo na eficiência: sem raciocínio, o adaptador iguala o modelo de base com raciocínio xhigh, utilizando 3,5 a 4,4 vezes menos tokens. Com um orçamento de 10 000 tokens por tarefa, resolve 51 % de Terminal-Bench 2.1 e 39 % de SWE-Bench Pro, contra 28 % e 0 % para o modelo de base em xhigh. A receita (AsyncGRPOTrainer do TRL, OpenEnv, safeagents) deverá ser detalhada num artigo anunciado para sexta-feira.
🔗 Anúncio de @yb2698 no X · Qwen3.8-27B-hermes-adapted (Hugging Face)
OVHcloud disponibiliza os pesos de Olala mini 7A1B no Hugging Face, com uma pontuação média de 68,0 em doze benchmarks
19 de novembro — Anunciado a 17 de novembro, Olala mini 7A1B, o modelo que inaugura a primeira família de modelos de linguagem da OVHcloud, já está disponível para descarregar no Hugging Face sob licença Apache 2.0, nas versões base, SFT, GGUF e MLX.
| Característica de Olala mini 7A1B | Valor publicado |
|---|---|
| Parâmetros | 6,8 mil milhões, dos quais cerca de 1 mil milhão ativo por token |
| Arquitetura | híbrida de Mamba-3 e atenção numa mistura de especialistas, cache KV em 7 camadas de um total de 36 |
| Contexto | 32K tokens, versão 128K anunciada para breve |
| Treino | 12,8T tokens, em inglês e 36 outros idiomas |
| Pegada estimada | cerca de 40 t de CO2 e 1,16 GWh |
| Média em doze benchmarks | 68,0, ou seja, 15,2 pontos acima do checkpoint SFT |
O modelo foi treinado em três supercomputadores públicos europeus, JUPITER (incluindo 1 024 GPU GH200), Jean Zay e MeluXina. Raciocina antes de responder, com quatro níveis de esforço, e foi treinado por reforço para chamar ferramentas; o seu ponto forte é seguir instruções, e o seu ponto fraco é a matemática de competição.
🔗 @OVHcloud no X · Olala-v1.0-mini-7A1B (Hugging Face)
Hugging Face publica PEFT v0.22.0, com os métodos PaCA, Astra e NoRA, antes de PEFT 1.0
19 de novembro — A biblioteca de fine-tuning eficiente da Hugging Face passa à v0.22.0. Acrescenta PaCA (Partial Connection Adaptation), que não adiciona camadas de adaptadores, mas ajusta diretamente colunas de entrada escolhidas aleatoriamente nos pesos pré-treinados: segundo o artigo original, exige menos 22 % de tempo de treino e menos 16 % de memória do que LoRA, com precisão comparável. Duas novas inicializações de LoRA, Astra e NoRA, completam a versão, que também reforça o paralelismo tensorial e FSDP2 e acrescenta uma verificação do estado do modelo. PEFT exige agora Python 3.11, e as notas anunciam que a próxima versão será a 1.0, com uma limpeza da API e algumas pequenas alterações incompatíveis, precedida de uma versão candidata (release candidate).
Ciência: Ai2 lança Theorizer no Asta, um agente que propõe teorias ligadas às publicações
19 de novembro — A Ai2 disponibiliza Theorizer no Asta, a sua plataforma de agentes para investigação científica, e publica o seu código sob licença Apache-2.0. O agente percorre a literatura, define o que deve extrair de cada artigo, compara os resultados e formula teorias em que cada afirmação remete para os artigos que a sustentam; assinala as que considera novas, avisando que uma pesquisa pode deixar escapar trabalhos anteriores. A Ai2 ilustra-o com casos reais: em adenocarcinomas pulmonares sem mutação condutora conhecida (cerca de 20 a 30 % dos casos), uma hipótese preliminar de dependência da proteína CDK2, que ainda precisa de ser validada em laboratório; 50 teorias candidatas sobre os interneurónios VIP para um neurocientista do Allen Institute que esperava uma ou duas. A utilização no Asta é suportada pela Ai2 até um limite de tokens, o artigo técnico foi publicado na ACL 2026, e está previsto um webinar para 10 de dezembro.
🔗 Theorizer no Asta (Ai2) · Repositório allenai/asta-theorizer
IA nas empresas: Sakana AI e Salesforce assinam um memorando de entendimento para o setor público japonês
19 de novembro — A Sakana AI anuncia um memorando de entendimento com a Salesforce para integrar os seus modelos de IA no software do fornecedor americano, destinado às administrações públicas e às autarquias locais japonesas. O objetivo declarado é contribuir para a eficiência administrativa e para a transformação digital destes organismos, e a Sakana AI afirma querer continuar a desenvolver tecnologias adaptadas às necessidades do setor público japonês. O tweet, em japonês, retoma uma notícia da agência noticiosa Jiji; o anúncio não indica calendário, produto específico ou montante.
Breves
Gemini 4 Neon noutras plataformas
- Antigravity CLI 1.5.12 — O Gemini 4 Neon fica acessível com uma simples chave de API Gemini (
GEMINI_API_KEY), nos seus quatro níveis de raciocínio; a vista do navegador do Remote Control apresenta várias conversas lado a lado, e/forkdemora alguns segundos em vez de até uma hora. 🔗 fonte - Genspark — O Gemini 4 Neon chega ao AI Chat e ao Code Agent, com os argumentos da Google (3.º na classificação geral da Artificial Analysis com esforço xhigh, 1.º no seu índice de agentes de código, custo por tarefa 50 a 80 % inferior ao dos melhores modelos), sem indicação de plano ou créditos. 🔗 fonte
Agentes de código e ferramentas de desenvolvimento
- Codex CLI 0.172.0-alpha.2 — As notas desta versão de pré-lançamento estão vazias; pelos títulos dos seus 62 commits, prepara o preenchimento automático dos argumentos dos comandos slash, o arranque a pedido por predefinição dos servidores MCP locais e linhas de estado personalizadas em
/experimental. O conteúdo pode mudar antes da versão estável. 🔗 fonte - Codex no iOS — A versão 1.2026.314 do ChatGPT para iOS guarda as conversas laterais no computador emparelhado, acrescenta um seletor para iniciar uma tarefa na cloud ou num computador e num projeto específicos, e passa a contabilizar apenas os subagentes ainda ativos. 🔗 fonte
- Copilot CLI 1.0.115 e Copilot SDK 2.0.2 — Duas versões de pré-lançamento da CLI corrigem, entre outros problemas, a ligação aos servidores MCP que omitem um scope de token de atualização; a versão de pré-lançamento 2.0.2-preview.0 do SDK retira das âncoras de confiança, em macOS e Linux, as 16 chaves sinalizadas da autoridade de certificação eMudhra. A versão estável continua na 1.0.114. 🔗 fonte · 🔗 Copilot SDK
- GitHub CLI 2.105.0 — Em versão de pré-lançamento,
gh event listenaguarda um evento de pull request (revisão, conflito, novo commit, check suite concluída) em vez de o consultar em ciclo, e tantogh prcomogh runpassam a sugeri-lo aos agentes; o acesso ao Event Streams continua sujeito a uma lista de espera. 🔗 fonte - Conectores MCP do Copilot — Oito serviços verificados pelo GitHub juntam-se aos mais de 25 existentes, em versão de pré-lançamento pública em todos os planos: Box, Buildkite, Calendly, ClickUp, Mixpanel, Supabase, Webflow e Wix. 🔗 fonte
- Gemini CLI v0.69.0 e v0.70.0 — Após nove dias sem uma nova versão, são lançadas duas versões estáveis no mesmo dia, e a v0.70.0 inclui as correções de segurança do motor de regras integradas desde 10 de novembro; a versão de pré-lançamento v0.71.0-preview.0 torna assíncrona a análise dos comandos PowerShell. 🔗 fonte · 🔗 v0.71.0-preview.0
- CLI mistral 0.19.0 e 0.20.0 —
mistral ocr processconverte um documento ou uma imagem em Markdown ou em dados estruturados,mistral evals judgedá lugar amistral evals scorer, emistral agents initpassa a criar um projeto autónomo do SDK Agents, sem chave de API. 🔗 fonte · 🔗 0.20.0 - Delta 0.28 — O ambiente da Zed para programar com agentes pesquisa nas conversas de toda a organização e ativa por predefinição a compactação suave, que elimina os resultados antigos das ferramentas sem recorrer a um modelo. 🔗 fonte
- Amp para Windows — A 17 de novembro, dez dias após uma versão experimental, a Amp anuncia a sua aplicação Windows, nativa em x64 e Arm, com um runner integrado, pacotes MSIX implementáveis pelo Intune e definições por política de grupo. 🔗 fonte
- Warp Learn — A Warp lança um curso gratuito, Build a Self-Improving Software Factory, lecionado por Ben Holmes: duas das três unidades estão disponíveis online, desde o ciclo de desenvolvimento com agentes até às correções desencadeadas pela monitorização de erros. 🔗 fonte
- DevinDash — A Cognition cria uma variante dos seus Devin Bots num modelo que encomenda refeições através do servidor MCP da DoorDash; as startups do Devin for Startups que participaram nas sessões de apoio (office hours) de São Francisco ou de Nova Iorque podem receber 1 000 dólares de crédito DoorDash. 🔗 fonte
API e plataformas
- Agent API da Perplexity — O nível de esforço xhigh passa a usar GPT-6.2 Sol, sem modelo alternativo, em substituição do Claude Opus 5.5; fixar a versão
xhigh@2026-11-11.0mantém a configuração anterior. 🔗 fonte - Qwen4-Max na Together AI e no Nous Portal — A Together AI disponibiliza o principal modelo da Alibaba (MoE de 2,4T parâmetros, dos quais 71B ativos, contexto de 1M) com 30 % de desconto, e a Nous Research torna-o gratuito durante cinco dias no Nous Portal com a Inferact, sem indicação de data de fim ou de limite de utilização. 🔗 Together AI · 🔗 Nous Research
Assistentes e empresas
- O ChatGPT acrescenta um plugin Accounting para reconciliações e fechos mensais na aplicação de desktop — O plugin ajuda a reconciliar transações, a redigir lançamentos de faturação e a preparar os relatórios de fim de mês; recorre à utilização do computador em macOS ou Windows, com aprovação de um administrador no Enterprise (notas de versão do ChatGPT de 18 de novembro, com ligação acima).
- Perplexity Brain — A Perplexity divulga no X os skills pessoais escritos pelo Brain e anuncia aí a funcionalidade para todos os subscritores particulares e empresariais nos Estados Unidos, embora o seu artigo fale dos subscritores Max; no teste aleatorizado, 72,9 % dos utilizadores com melhoria automática obtiveram um novo skill pessoal, contra 6,5 % do grupo de controlo. 🔗 fonte · 🔗 artigo
- RAG as a service — A Perplexity publica um guia sobre RAG disponibilizado como serviço e classifica sete fornecedores, com o Perplexity Enterprise à frente de AWS Bedrock, OpenAI, Azure AI Search, Pinecone, LlamaIndex e Vectara; a classificação é da própria Perplexity. 🔗 fonte
- Sumitomo Life — A seguradora de vida japonesa, que adotou o ChatGPT Enterprise em junho de 2026, anuncia uma utilização semanal superior a 80 % e um retorno do investimento estimado, com base nos ganhos de tempo declarados, de 203 % no total e de 524 % em média entre os funcionários que o utilizam pelo menos 101 vezes por mês. 🔗 fonte
- SSO dos membros externos — Os proprietários de espaços ChatGPT Enterprise, Edu e Healthcare podem dispensar de SSO os membros externos cujo domínio não esteja verificado; a isenção aplica-se a um único espaço e desaparece quando o membro sai. 🔗 fonte
- Candid Health e ElevenAgents — A plataforma americana de gestão do ciclo de receitas entrega aos agentes de voz da ElevenLabs as suas chamadas às seguradoras sobre recusas de reembolso: 12 860 chamadas, mais de 850 horas poupadas por mês e 59 % das chamadas do projeto-piloto resolvidas, com uma integração em 48 horas. 🔗 fonte
- Enterprise Live Migrations — Fora da IA: as migrações contínuas do Azure DevOps Services para o GitHub Enterprise Cloud com residência de dados passam a disponibilidade geral, mantendo o histórico Git, os branches, as tags e os pull requests sincronizados até à transição. 🔗 fonte
- Runners RHEL do GitHub Actions — Fora da IA: as imagens Red Hat Enterprise Linux 9 e 10 dos larger runners alojados passam a disponibilidade geral nos planos Team e Enterprise Cloud. 🔗 fonte
Modelos abertos, investigação e simulação
- Deep Research da Genspark — A Genspark divulga um trabalho publicado pela Baseten a 10 de novembro: um Qwen3.5-397B pós-treinado para investigação aprofundada atinge 0,759 no grader interno da Genspark, contra 0,612 do modelo base e 0,738 do Opus 5.5; torna-se o modelo predefinido do agente, e a Genspark mantém os pesos. 🔗 fonte · 🔗 artigo da Baseten
- Muse Wonder no benchmark BAR — A Meta divulga a classificação de novembro da Legora, plataforma de IA jurídica, na qual o Muse Wonder obtém a melhor pontuação de qualidade global e lidera em quatro tipos de tarefas, incluindo análise e extração. 🔗 fonte
- Clairic — Está disponível no Hub uma demonstração do Clairic, o modelo de extração estruturada tipada de 27 mil milhões de parâmetros publicado pela Cloudflare no Hugging Face; o modelo data de 16 de outubro e a sua versão Flash de 12 de novembro. 🔗 fonte
- Gemma 4 E2B na Airbnb — Segundo a conta Gemma da Google, a Airbnb utilizou o Gemma 4 E2B para classificação de regras numa única GPU RTX Pro 6000: F1 máximo de 0,563 para 0,902, latência mediana de 35 ms contra cerca de 900 ms dos modelos de fronteira, por cerca de 1 % do seu custo em grandes volumes. 🔗 fonte
- Atto — A NeuML publica uma família de modelos de pesquisa documental minúsculos, de 840 parâmetros a 28 milhões: o modelo denso de 90 000 parâmetros atinge 0,4257 em nDCG@10 num subconjunto do BEIR, contra 0,4802 do all-MiniLM-L6-v2, cerca de 256 vezes maior. 🔗 fonte
- ja-NCM — Um programador publica um pequeno modelo japonês de pesos abertos que gera texto por conceitos em vez de token a token: segundo o próprio, cerca de 6 vezes mais depressa do que um modelo autorregressivo e 2,4 vezes mais depressa do que um modelo de difusão, com qualidade comparável. 🔗 fonte
- Into the Omniverse — A NVIDIA republica pela terceira vez o seu artigo sobre simulações construídas por agentes, com novos exemplos: os gémeos digitais de instalações industriais da Falkor (KONGSBERG) com GPT-6 Astra, e uma unidade de cuidados intensivos montada pelo Claude Code, na qual 766 dos 768 robôs Microduck se mantinham de pé. 🔗 fonte
O que isto significa
Os marcos financeiros e técnicos dos laboratórios de ponta são agora acompanhados por compromissos de segurança. A Anthropic fixa o seu preço acima do intervalo e aumenta a sua oferta de 825 para 980 milhões de ações; no dia seguinte, Dario Amodei promete ajustar o ritmo do treino e da disponibilização até garantir que os modelos são seguros e permanecem sob controlo humano, sem ceder a pressões comerciais ou políticas. A OpenAI, que mede a parcela crescente da sua investigação confiada a agentes, pede que os laboratórios sejam obrigados a publicar indicadores de autoaperfeiçoamento recursivo. Os dois discursos respondem à mesma questão: mostrar que a segurança acompanha o aumento tão rápido dos recursos e das capacidades.
Os agentes fazem agora uma parte mensurável do trabalho dos próprios laboratórios. Na OpenAI, concluem sozinhos quase metade das tarefas de duas a quatro horas e representam, em mediana, 2 400 dólares por investigador e por dia a preços de tabela; a Performance Factory confia-lhes 17 investigações por dia sobre a lentidão do ChatGPT. A Replit mostra que a organização conta tanto como o modelo: o melhor agente individual forma enxames menos eficazes do que o Claude Opus 5.5, que se coordena através de um quadro partilhado. Em todos os casos, a decisão continua nas mãos de uma pessoa: um engenheiro integra as correções da Performance Factory, os investigadores da OpenAI supervisionam de perto, e o Devin abre pull requests para revisão.
A faturação ajusta-se cada vez mais à utilização real. O Gemini 4 Neon é vendido no Cursor com base no custo por tarefa, de 3,07 dólares com esforço Medium a 10,67 dólares com Extra High; o Genie 4 é faturado ao segundo de mundo gerado, cerca de 0,10 dólar, e o GPT-Live desce para 0,02 dólar por minuto quando ninguém fala. O Tool Retrieval, tal como os seus equivalentes na OpenAI e na Anthropic, procura o mesmo objetivo para os programadores: pagar em tokens apenas pelos esquemas das ferramentas efetivamente utilizadas.
Nos modelos abertos, o esforço concentra-se no que se consegue extrair de uma base existente. O DaisyRose-27B e o adaptador Hermes partem ambos do Qwen3.8-27B: o primeiro duplica a sua pontuação no Terminal-Bench 4.1 através de aprendizagem por reforço, e o segundo iguala o modo de raciocínio máximo com 3,5 a 4,4 vezes menos tokens. O PEFT prepara a sua versão 1.0 para fornecer ferramentas para estes ajustes, a OVHcloud publica um modelo europeu treinado em supercomputadores públicos acompanhado da sua pegada de carbono, e a Ideogram promete os pesos da sua versão 4.6. Estes números continuam a ser os divulgados pelos fornecedores.
Fontes
- Anúncio do preço da oferta pública inicial (Anthropic)
- @AnthropicAI no X: o preço fixado
- @AnthropicAI no X: texto de Dario Amodei
- Aceleração da investigação: a fronteira irregular (OpenAI)
- @OpenAI no X: aceleração da investigação
- Como a Performance Factory da OpenAI mantém o ChatGPT rápido (OpenAI)
- @OpenAIDevs no X: Performance Factory
- @ideogram_ai no X: Ideogram 4.6
- @ideogram_ai no X: pesos abertos da 4.6
- @Kling_ai no X: 4K e HDR de 10 bits
- @cursor_ai no X: Gemini 4 Neon no Cursor
- CursorBench (Cursor)
- Gemini 4 Neon no GitHub Copilot (changelog do GitHub)
- @github no X: Gemini 4 Neon
- Claude Code v2.1.328
- Kimi Code 2.7.0
- Kimi Code Desktop 1.4.0
- Devin Security Threats (Cognition)
- @cognition no X: Devin Security Threats
- Devin para migrações do Databricks (Cognition)
- @Replit no X: Amuse
- Repositório replit/amuse (GitHub)
- Aumentar a equipa para resolver o problema (Replit)
- @Replit no X: Optimization-Bench
- Computer use no Gemini para Mac (Google)
- @GeminiApp no X: computer use
- Notas de versão do ChatGPT
- Genie 4 na API Gemini (Google)
- Documentação do Genie (AI Studio)
- Tool Retrieval na API Gemini (Google)
- @OpenAIDevs no X: GPT-Live-1.1
- Ficha do GPT-Live-1.1 (OpenAI)
- Prompting do GPT-Live para idiomas e sotaques regionais (OpenAI)
- NVIDIA e Microsoft no Ignite (NVIDIA)
- Mini-PC RTX Spark disponíveis (NVIDIA)
- DaisyRose-27B (artigo da RadixArk)
- DaisyRose-27B-NVFP4 (Hugging Face)
- @yb2698 no X: adaptador Hermes
- Qwen3.8-27B-hermes-adapted (Hugging Face)
- @OVHcloud no X: Olala mini 7A1B
- Olala-v1.0-mini-7A1B (Hugging Face)
- PEFT v0.22.0
- Theorizer no Asta (Ai2)
- Repositório allenai/asta-theorizer (GitHub)
- @SakanaAILabs no X: memorando de entendimento com a Salesforce
- Changelog do Antigravity
- @genspark_ai no X: Gemini 4 Neon
- Codex CLI 0.172.0-alpha.2
- Changelog do Codex, ChatGPT para iOS 1.2026.314
- Copilot CLI 1.0.115-1
- Copilot SDK 2.0.2-preview.0
- Aguardar os eventos de uma pull request com o GitHub CLI (changelog do GitHub)
- Conectores Supabase, Box, Calendly e outros para o Copilot (changelog do GitHub)
- Gemini CLI v0.70.0
- Gemini CLI v0.71.0-preview.0
- CLI mistral 0.19.0
- CLI mistral 0.20.0
- Notas de versão do Delta 0.28.0
- Amp para Windows (Amp)
- Warp Learn (Warp)
- @cognition no X: DevinDash
- Changelog da API Perplexity
- @togethercompute no X: Qwen4-Max
- @NousResearch no X: Qwen4-Max no Nous Portal
- @perplexity_ai no X: skills pessoais do Brain
- Skills que se aperfeiçoam autonomamente (Perplexity)
- RAG como serviço (Perplexity)
- Estudo de caso da Sumitomo Life (OpenAI)
- Notas do ChatGPT Enterprise e Edu (OpenAI)
- Candid Health (ElevenLabs)
- Enterprise Live Migrations a partir do Azure DevOps (changelog do GitHub)
- Imagens de runners RHEL em disponibilidade geral (changelog do GitHub)
- @genspark_ai no X: modelo de Deep Research com a Baseten
- Baseten e Genspark treinam um modelo de pesquisa (Baseten)
- @AIatMeta no X: Muse Wonder no benchmark BAR
- @HuggingApps no X: Clairic
- @googlegemma no X: Gemma 4 E2B na Airbnb
- Atto (NeuML, Hugging Face)
- ja-NCM (Hugging Face)
- Entrar no Omniverse (NVIDIA)