ai-powered-markdown-translatorArticol tradus din fr în ro cu gpt-6.1-sol.
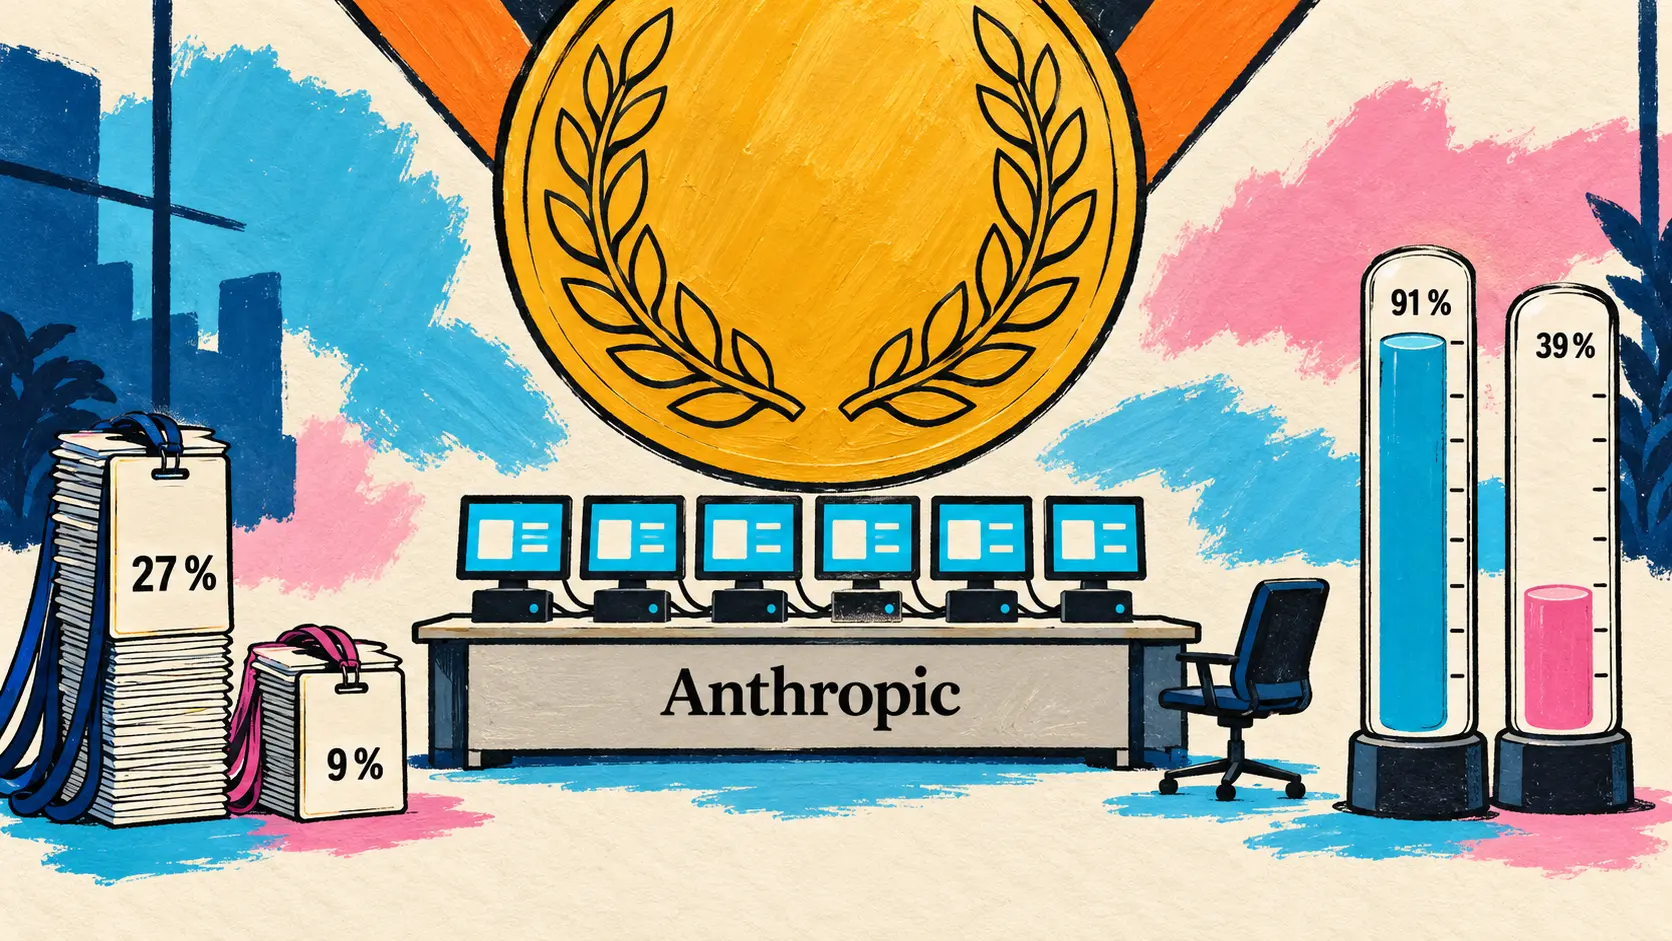
Anthropic își folosește propriile echipe ca teren de studiu: juniorii au scăzut de la 27 % la 9 % din angajările tehnice, agenții lansați de angajați lucrau în august de șase ori mai multe ore decât aceștia, iar 91 % dintre angajați consideră că IA este capabilă de o descoperire demnă de un premiu Nobel până în 2030, față de 39 % dintre americani. DeepSeek publică V4.1-Flash-1017 sub licență MIT, înaintea GPT-5.6 Sol și Claude Opus 5 pe DeepSWE v1.1, la același tarif, și deschide tuturor accesul la API-urile sale de căutare web Search și Fetch. Agenții Google Research controlează roboți de laborator și contribuie la obținerea unor lianți proteici nanomolari pentru o țintă tumorală, Claude Code începe să răspundă de trei ori mai repede decât în august, iar NVIDIA își prezintă în detaliu PC-urile RTX Spark pentru dezvoltatori.
Anthropic își studiază propriile locuri de muncă: juniorii scad la 9 % din angajările tehnice, iar angajații săi au așteptări mult mai mari de la IA decât americanii
16 octombrie — Echipa Economics a Anthropic publică două rapoarte ale The Anthropic Institute care folosesc însăși compania ca teren de studiu. Primul, „Cum se schimbă ocuparea forței de muncă la Anthropic” (How employment is changing at Anthropic), corelează date interne (numărul de angajați, utilizarea IA, producția, calendarele, deciziile de angajare) cu 17 interviuri cu angajați. Al doilea, „Decalajul dintre așteptările privind IA” (The AI expectations gap), compară un sondaj Morning Consult realizat în august în rândul a 10 980 de adulți americani cu un sondaj intern în rândul a 1 334 de angajați; un al doilea val, în septembrie, oferă rezultate similare.
| Indicator urmărit la Anthropic | Evoluție măsurată |
|---|---|
| Ponderea juniorilor în angajările tehnice | de la 27 % la 9 % |
| Ponderea juniorilor în departamentele tehnice | de la 21 % la 14 % de la începutul lui 2025 |
| Ore ale agenților interactivi pentru o oră de angajat | 6 în august 2026 |
| Commit-uri per inginer | de 5 ori ritmul de acum șase luni |
| Sesiuni de programare ale personalului netehnic, pe lună | de la 2 (august 2025) la 90 (mai 2026) |
Scăderea ponderii începătorilor este cea mai clară constatare, iar IA joacă un rol declarat în acest sens: în aprilie 2026, aproximativ o treime dintre managerii din machine learning și o cincime dintre managerii din ingineria software spuneau că angajează mai puțin din cauza ei. Agenții, la rândul lor, au ocupat un loc tot mai mare: în martie 2026, numărul lor cumulat de ore l-a depășit pentru prima dată pe cel al angajaților. În cazul a 192 de ingineri care au trecut la agenți de programare, comparați cu 74 care nu au făcut-o, volumul de cod adăugat crește puternic, fără ca cel generat de agenți să fie șters sau anulat mai frecvent ulterior.
Reversul este atenția umană, devenită factorul limitativ: sesiunile interactive rămân inactive aproximativ 80 % din timp, în așteptarea unui răspuns, iar citirea a tot ce produc ar ocupa mai mult de jumătate din săptămâna de lucru. Meta-munca (meta-work), care constă în redactarea de specificații pentru agenți, verificarea muncii unui agent de către altul sau supravegherea unor fluxuri de procesare, a crescut de la 10 % la 22 % din sesiuni între toamna lui 2025 și primăvara lui 2026, iar angajatul median petrece cu 20 % mai mult timp în ședințe decât acum un an. La angajare, evaluările pun mai mult accent pe autonomie și discernământ; Anthropic afirmă că implementează un sistem de avertizare timpurie (early warning system) privind posturile expuse și că acordă prioritate redistribuirilor interne.
Al doilea raport arată că angajații și publicul larg sunt de acord asupra a ceea ce poate face IA astăzi, dar nu și asupra vitezei progreselor sale:
| Răspuns măsurat, orizont 2030 | Americani intervievați | Angajați Anthropic |
|---|---|---|
| O descoperire demnă de un premiu Nobel este considerată posibilă | 39 % | 91 % |
| Ponderea propriei munci pe care o poate face IA (medie) | 28 % (persoane active) | 75 % |
| Creșterea PIB implicată de răspunsuri (mediană) | 5,4 % | 17,1 % |
Cele două grupuri raționează totuși în același fel: cu cât cineva crede că IA va face o parte mai mare din munca sa, cu atât anticipează mai mult șomaj, iar lucrătorii americani care o consideră capabilă să le facă cel puțin 80 % din muncă prevăd un șomaj de 12,2 % în 2030, față de 4,2 % astăzi. Creșterea PIB este dedusă din modelul de scenarii economice prezentat de Anthropic în septembrie. În fine, angajatul median estimează că IA face deja 51 % din munca necesară construirii unui model de vârf și prevede o pondere de 95 % la sfârșitul lui 2030: raportul precizează că acestea sunt opinii personale culese prin sondaj, nu previziuni ale companiei.
🔗 Cum se schimbă ocuparea forței de muncă la Anthropic · Decalajul dintre așteptările privind IA · Articolul de prezentare
Modele deschise: DeepSeek publică V4.1-Flash-1017 și deschide accesul la API-urile Search și Fetch, partenerii NVIDIA realizează post-antrenarea Nemotron 3.5 Super VL
17 octombrie — DeepSeek publică DeepSeek-V4.1-Flash-1017, o nouă versiune a V4.1-Flash, modelul său multimodal de tip MoE cu 552 de miliarde de parametri, lansat pe 10 septembrie. Fișa modelului vorbește despre o actualizare minoră (minor update), dar diferențele sunt clare la sarcinile agenților: 77,0 % pe DeepSWE v1.1 față de 74,2 % pentru versiunea precedentă, 42,3 față de 31,2 pe Terminal-Bench 4.0. Ponderile sunt publicate sub licență MIT pe Hugging Face și ModelScope, iar modelul este disponibil pe site, în aplicație și prin API.
Stronger benchmark performance, faster task completion, and shorter outputs than the previous version—a Pareto improvement in performance and cost.
🇷🇴 Scoruri mai mari, sarcini finalizate mai repede și răspunsuri mai scurte decât în versiunea precedentă: o îmbunătățire Pareto în privința performanței și a costului. — @deepseek_ai pe X
Prețul rămâne neschimbat. Numele deepseek-flash oferă acum această versiune, cu un context de un milion de tokens și până la 384K tokens la ieșire; vechile nume deepseek-v4-flash și deepseek-v4-flash-vision-exp sunt în continuare acceptate, dar cererile lor sunt procesate tot de V4.1-Flash-1017. Pagina de tarife afișează în continuare 0,30 dolari per milion de tokens la intrare (în afara cache-ului) și 1,20 dolari la ieșire în orele de vârf, jumătate în orele cu trafic redus, ca pe 13 septembrie. Scăderea costului provine, așadar, din răspunsurile mai scurte: graficul din notele de versiune, disponibil doar ca imagine, plasează setarea max la 77,0 % pe DeepSWE v1.1 pentru aproximativ 0,2 dolari per sarcină, deasupra tuturor celorlalte puncte. Cel mai apropiat, GPT-6.1 Sol, atinge cel mult aproximativ 75 % pentru circa 0,65 dolari, în timp ce cele mai bune puncte ale GPT-6 Astra, Gemini 3.8 Flash, Claude Opus 5 și Claude Fable 5, între aproximativ 70 % și 74 %, costă între circa 2 și 15 dolari per sarcină.
| Benchmark | V4.1-Flash-1017 | V4.1-Flash | K3 | GLM-5.3 | GPT-5.6 Sol | Opus 5 |
|---|---|---|---|---|---|---|
| HLE fără instrumente | 42,6 | 36,8 | 43,5 | 42,0† | 44,5 | 56,3 |
| Terminal-Bench 4.0 | 42,3 | 31,2 | 12,6 | 37,9 | 39,9 | 51,8 |
| DeepSWE v1.1 | 77,0 | 74,2 | 67,5 | 66,9 | 73,0 | 74,0 |
| ProgramBench | 29,1 | 20,3 | 17,5 | 19,0 | 23,0 | 37,0 |
| NL2Repo-Bench | 68,2 | 65,4 | 58,0 | 58,0 | 56,8 | 75,3 |
| Automation-Bench v1.0.6 | 60,5 | 54,8 | 46,7 | 48,8 | 45,8 | 50,3 |
| Agents’ Last Exam | 35,4 | 31,8 | 27,6 | 28,5 | 26,7 | 28,6 |
| Apex Bench v1.1 | 72,1 | 64,6 | 47,8 | 56,6 | 54,3 | 65,8 |
† : subsetul text al HLE, singurul scor oferit pentru GLM-5.3 (V4.1-Flash-1017 obține aici 44,0). Sursă: fișa modelului de pe Hugging Face.
În privința modelelor închise, tabelul include doar GPT-5.6 Sol și Claude Opus 5, nu și succesorii lor. V4.1-Flash-1017 le depășește pe DeepSWE v1.1, Automation-Bench, Agents’ Last Exam și Apex Bench, dar rămâne în urma Opus 5 pe HLE fără instrumente (unde și GPT-5.6 Sol îl depășește, 44,5 față de 42,6), Terminal-Bench 4.0, ProgramBench, NL2Repo-Bench și cele trei benchmark-uri vizuale cu instrumente din fișă (Chartography, BabyVision și ZeroBench-main); în comparație cu modelele deschise K3 și GLM-5.3, pierde doar în fața K3, pe HLE fără instrumente (43,5 față de 42,6). DeepSeek atribuie aceste progrese învățării prin întărire cu autoevaluare (reinforcement learning with self-feedback) pe proiecte complete și optimizează modelul pentru DeepSeek Harness, Tencent CodeBuddy și WorkBuddy. Pentru rularea locală, pachetul publicat nu oferă un șablon de conversație în format Jinja, ci o implementare Python de referință a formatului de prompt, și recomandă cel puțin 256K tokens la ieșire; niciun nou raport tehnic nu însoțește această versiune.
🔗 Notele de versiune DeepSeek · Fișa modelului pe Hugging Face
Search și Fetch: DeepSeek deschide tuturor accesul la API-urile sale de căutare web, la 0,75 dolari pentru 1 000 de cereri reușite
17 octombrie — În același fir, DeepSeek deschide tuturor utilizatorilor API-ului său accesul la două servicii de căutare web. Search interoghează motorul de căutare propriu al DeepSeek, care, potrivit companiei, procesează sute de milioane de cereri pe zi, și returnează rezultate structurate: fiecare are un scor de relevanță de la 0 la 3, un rezumat de 600 până la 800 de caractere destinat modelului, data publicării și un nivel de autoritate de la 0 la 4. Fetch preia o pagină și o convertește în Markdown, cu respectarea regulilor de acces ale site-ului vizat.
| Element al ofertei | Valoare indicată de DeepSeek |
|---|---|
| Prețul fiecărui API | 0,75 dolari pentru 1 000 de cereri reușite |
| Limită per cont | 5 cereri pe secundă pe fiecare API |
| Rezultate per căutare | de la 1 la 50 (10 implicit) |
| Apeluri din Harness, Claude Code, Codex | gratuite până pe 31 octombrie la 16 h UTC |
Sunt facturate doar răspunsurile care conțin rezultate: eșecurile, căutările fără rezultate și depășirile timpului de așteptare sunt gratuite, iar numărul de rezultate solicitate nu schimbă prețul. Instrumentele de pe server ale API-ului DeepSeek, apelate din DeepSeek Harness, Claude Code sau Codex, se bazau deja pe aceste API-uri, iar aceste apeluri rămân gratuite până pe 31 octombrie; Harness v0.2.1-rc.2 integrează Search și Fetch în setările sale de căutare web.
🔗 Ghidul Search și Fetch · Anunțul @deepseek_ai
Nemotron 3.5 Super VL: post-antrenat de partenerii NVIDIA, ajunge pe sarcinile lor la nivelul unor modele închise mai scumpe
16 octombrie — La o zi după lansarea Nemotron 3.5 Super VL, modelul său deschis cu 120 de miliarde de parametri (12 miliarde activi), prezentat aici pe 15 octombrie, NVIDIA publică un fir care citează 21 de mesaje ale partenerilor, aproape toate apărute în ziua lansării. O bună parte dintre ele arată ce rezultate oferă modelul după post-antrenarea pe o sarcină precisă, fiecare fiind măsurat pe propriile evaluări: NVIDIA le redistribuie fără o metodologie comună.
| Partener citat | Utilizare după post-antrenare | Rezultat anunțat de partener |
|---|---|---|
| AfterQuery (cu Hebbia) | Sarcini de creditare de nivel expert | de la 47 % la 74 % de sarcini rezolvate perfect, la aproximativ 1/7 din costul modelelor închise comparate |
| Trajectory | Legal Agent Bench de la Harvey | la nivelul Opus 4.7, la 1,34 dolari per milion de tokens față de 15 |
| Alex Dimakis | Cercetător ML autonom | de la 28 % la 35 % pe AutoResearchExam, la nivelul Qwen 3.8 Max, de 20 de ori mai mare |
| Handshake | Documente din științele vieții | precizie dublată cu peste 2 000 de date furnizate de experți |
| Multiverse Computing | Comprimarea modelului | Comet 60B, jumătate din numărul de parametri, cu o abatere de mai puțin de 5 % față de precizia inițială |
Firul arată și instrumentele care se dezvoltă în jurul modelului: disponibilitate pe Tinker, API-ul River, AC2 de la Applied Compute și ModelScope (ponderi BF16 și NVFP4), lansarea Fastino Training API pentru buclele SFT și RL și servire la 962 tokens pe secundă și per utilizator pe două GPU H200, cu motorul Litespark de la Mindbeam.
Agenți în laborator: Google Research le încredințează roboți de pipetare și obține liganzi cu afinitate nanomolară pentru o țintă tumorală
16 octombrie — Google Research prezintă trei lucrări care aduc agenții IA până la masa de lucru din laboratorul umed (wet lab): aceștia nu se mai limitează la proiectarea moleculelor, ci pornesc experimentele, citesc rezultatele și își corectează metoda, sub îndrumarea cercetătorilor.
Prima componentă, VERID (VERified Infrastructure for Discovery Laboratories), este un geamăn digital al stației robotizate de pipetare, construit pe framework-ul open source PyLabRobot. Acesta urmărește în timp real brațul, volumul din fiecare godeu, reactivii și vârfurile de pipetă disponibile, simulează fiecare protocol în câteva secunde și blochează comenzile imposibile fizic. Într-un caz raportat, simulatorul refuză o aspirare cu opt canale într-o tăviță prea îngustă: agentul reface planul, apoi concepe un plan factorial care izolează o abatere cauzată de contaminarea provenită de la vârfurile de pipetă.
| Experiment realizat cu agenții | Rezultat raportat de Google Research |
|---|---|
| Aptameri pentru α-trombină, trei cicluri | 0 %, apoi 26,0 %, apoi 42,1 % liganzi confirmați, cu o specificitate de 98,5 % |
| Aptameri pentru mioglobină | specificitate scăzută de la 75,0 % la 19,1 %, revenită la 72,4 %; 33,5 % liganzi în ciclul 3 |
| Liganzi proteici de novo pentru FAP | afinitate nanomolară cu o singură cifră, predicția structurii de 8,6 ori mai rapidă |
| Colaborare om-agent, cu aceleași resurse de calcul | rată de succes in silico aproape dublă față de un cercetător care lucrează singur |
Cazul mioglobinei ilustrează învățarea în buclă închisă: în al doilea ciclu, agenții mizează pe motive G-quadruplex care se leagă de orice, observă prăbușirea specificității în datele de laborator și își rescriu singuri regulile de proiectare. Pentru FAP, un receptor supraexprimat în tumorile solide, pipeline-ul păstrează doar situsul de legare în timpul predicției structurii. Google își detaliază măsurile de protecție (sisteme biologice neinfecțioase, screening de biosecuritate pentru fiecare secvență, simulare obligatorie înainte de execuție, supraveghere umană), dar nu precizează ce model stă la baza agenților.
🔗 Articolul Google Research · VERID (PDF) · Mediul de testare pentru aptameri (PDF) · Excizia epitopului (PDF)
Agenți de cod: Claude Code începe să răspundă de trei ori mai repede, versiunea 2.1.302 extinde utilizarea subagenților fork, Replit se instalează în cloud-ul clienților săi
16 octombrie — Claude începe să răspundă mai devreme, anunță @ClaudeDevs. În Claude Code, conversația trimisă modelului la fiecare schimb este acum comprimată cu gzip pentru a ajunge mai repede la acesta, iar sesiunile cloud pornesc imediat ce utilizatorul începe să tasteze cererea. Tabelul anexat anunțului măsoară timpul de așteptare până la primul token între august și octombrie:
| Interfață măsurată | August 2026 | Octombrie 2026 | Câștig anunțat |
|---|---|---|---|
| Claude Code, sesiuni locale | 4,07 s | 1,33 s | de 3 ori |
| Claude Code, sesiuni cloud | 16,99 s | 6,00 s | de 2,8 ori |
| Claude, chat și Cowork | 3,36 s | 2,17 s | de 1,5 ori |
| API Claude, inclusiv timpul modelului (mediană) | 1,53 s | 1,01 s | de 1,5 ori |
Primele trei rânduri exclud timpul de calcul al modelului și se referă la percentila 90. Comprimarea nu este chiar nouă: Claude Code 2.1.300 o aplica deja, pe 14 octombrie, cererilor mari către api.anthropic.com, cu variabila CLAUDE_CODE_GZIP_REQUEST_BODIES=0 pentru dezactivare. Nu este indicat niciun număr de versiune pentru pornirea anticipată a sesiunilor cloud.
Claude Code 2.1.302: subagenți fork activați implicit în afara terminalului, model selectabil pentru clasificatorul modului auto, 43 de corecții
16 octombrie — La o zi după versiunea 2.1.301, Claude Code 2.1.302 (63 de intrări, dintre care 43 de corecții) extinde la celelalte interfețe un comportament specific terminalului: subagenții fork sunt acum activați implicit în claude -p, Agent SDK, aplicația desktop și VS Code (CLAUDE_CODE_FORK_SUBAGENT=0 pentru dezactivare), iar aplicația desktop și VS Code lansează întotdeauna în fundal subagenții conversației principale.
| Domeniu vizat | Modificare adusă de versiunea 2.1.302 |
|---|---|
| Modul auto | CLAUDE_CODE_AUTO_MODE_MODEL selectează modelul clasificatorului executat pe partea clientului |
Comanda /config | rândul Idle compaction permite dezactivarea sau reactivarea compactării în perioadele de inactivitate |
| Furnizori terți | dacă nu este specificat un mod, claude -p și Agent SDK pornesc în modul default dacă telemetria este dezactivată sau instalarea este nouă |
| Hooks prompt și agent | cel mult 12 execuții simultane per eveniment |
| Instrumentul Read | imaginile de peste 128 Mo sunt refuzate în loc să fie încărcate în memorie |
Printre celelalte corecții, o rutină programată care a eșuat parțial nu mai este reluată de la început, ceea ce putea publica de două ori același raport, iar discurile exFAT sau FAT32 nu mai blochează scrierile în Windows.
🔗 Notele de versiune Claude Code 2.1.302
Replit Bring Your Own Cloud: platforma în spațiul Azure, Google Cloud sau AWS al clientului și Claude Haiku 5.5 în modul Power
16 octombrie — Replit lansează Bring Your Own Cloud (BYOC), care rulează întreaga platformă Replit sau o parte din aceasta în spațiul cloud (tenant) al unei companii, pe Microsoft Azure, Google Cloud sau Amazon Web Services. Pentru dezvoltatori, nimic nu se schimbă: publicarea se face în continuare cu același buton Publish.
| Opțiune de implementare | Ce rulează în infrastructura clientului | Stadiul disponibilității |
|---|---|---|
| Full BYOC | întreaga platformă, inclusiv harness-ul Agent, și aplicațiile publicate | versiune preliminară privată |
| BYOC for Published Apps | doar aplicațiile publicate, dezvoltarea rămânând la Replit | acces anticipat |
| Image Exports | o imagine Docker, un fișier Terraform și un SBOM, implementate de echipa clientului | acces anticipat |
Tunelurile sunt exclusiv de ieșire, cu criptare mTLS dublă, iar cheile gestionate de client (CMEK) sunt rezervate contractelor cu izolare fizică completă. Documentația stabilește limitele: planul de control rămâne la Replit, Full BYOC nu este nici o instalare izolată (air-gapped), nici o versiune Replit găzduită integral pe infrastructură proprie, iar inferența modelelor este asigurată în continuare de Replit. Nu este publicat niciun preț. Changelog-ul din aceeași zi adaugă Claude Haiku 5.5 în selectorul modului Power pentru planurile Core și Pro, unde Claude Sonnet 5.5 fusese introdus pe 2 octombrie.
🔗 Articolul Replit · Documentația BYOC · Changelog-ul din 16 octombrie
RTX Spark: NVIDIA își detaliază PC-urile pentru dezvoltatori, cu Junie Local de la JetBrains și câștiguri anunțate față de Core Ultra X9 388H
16 octombrie — În ziua lansării laptopurilor RTX Spark, pentru care prezentase pe 13 octombrie software-ul disponibil la lansare, NVIDIA explică pe blogul său tehnic ce le oferă această mașină dezvoltatorilor: să scrie cod, să testeze și să implementeze pe un singur PC, cu agenți de cod care rulează local pe până la 128 Go de memorie unificată. Laptopurile sunt disponibile, iar în noiembrie vor urma calculatoare desktop compacte, prezentate ca fiind potrivite pentru agenții care rulează continuu.
| Sarcină de lucru | Test folosit de NVIDIA | Câștig anunțat față de Core Ultra X9 388H |
|---|---|---|
| Agenți de cod | AA-AgentPerf-local cu Qwen3.8-27B | de 4,6 ori |
| Ajustare fină (LoRA) | Unsloth pe Llama-3.1-8B | de 2,7 ori |
| Compilare | kernel Linux, Phoronix Test Suite | de 1,8 ori |
Aceste măsurători sunt realizate de NVIDIA, în comparație cu cipul Panther Lake 12Xe de la Intel. Pe partea de software, Windows Developer Config, conceput împreună cu Microsoft, instalează principalele framework-uri de dezvoltare, dezactivează notificările și îmbunătățește terminalul; pe Windows on Arm, peste 2 000 de pachete Conda sunt gata de utilizare, iar peste 97 % dintre cele mai folosite 15 000 de pachete Python au o versiune Arm. JetBrains lansează suportul nativ pentru Junie Local, care își ajustează fereastra de context în funcție de memoria GPU-ului, GitHub Copilot rulează local prin Windows ML cu llama.cpp, iar SDK-urile AI for Media (super-rezoluție video, generare de cadre intermediare, TrueHDR) devin disponibile ca pachet Python pe PyPI.
🔗 Articolul de pe blogul tehnic NVIDIA
Pe scurt
Agenți și instrumente pentru cod
- Notele de lansare Devin din 16 octombrie — După cele din 14, prezentate pe 15, Cognition publică 19 rubrici: comenzi /devin în merge requests GitLab, starea îmbinării din Bitbucket Cloud în Devin Review, căutarea de pull requests pe cinci platforme de găzduire a codului, instrumente integrate pentru issues și labels și o setare Enterprise care ascunde vechiul marketplace MCP fără a deconecta serverele deja instalate. 🔗 sursă
- Copilot CLI 1.0.100-1 — La două ore și jumătate după 1.0.100-0, prezentată cu o zi înainte, această a doua versiune preliminară face din navigatorul unificat de sesiuni afișarea implicită pentru
/sessions,/sessionși/resumeși elimină marcajele de limbă din dictarea vocală; încă nu există nicio versiune stabilă după 1.0.98 din 14 octombrie. 🔗 sursă - Gemini CLI, nightly din 17 octombrie — Patru remedieri care închid tichete din martie și aprilie: actualizarea automată verifică în sfârșit binarul lansat efectiv, în loc să anunțe în buclă un succes fals atunci când coexistă mai multe instalări în PATH,
keybindings.jsonacceptă un arraykeys, iar semnalele de oprire ajung la procesul copil sub ACP, systemd sau într-un container. 🔗 sursă - Antigravity CLI 1.4.0 și aplicația Antigravity 2.24.0 — Revenind la noutățile din 15 și 14 octombrie: CLI își afișează starea în fila terminalului (secvența OSC 7501) și reface
agy plugin validatefolosind regulile reale de încărcare; aplicația, după 2.23.0 prezentată pe 13 octombrie, își reorganizează panoul lateral, adaugă /compact și permite alegerea între Flash Lite, Flash sau Pro pentru fiecare automatizare. 🔗 sursă - DeepSeek Harness 0.2.1-rc.1 și rc.2 — Primele două versiuni candidate din seria 0.2.1: rc.1 reunește modificările din versiunile preliminare alpha.1 până la alpha.5, rc.2 acceptă V4.1-Flash-1017 și API-urile Search și Fetch; depozitul numără 31 de lansări din 17 august, toate în versiune preliminară. 🔗 sursă
- bun lint — Revenind la 15 octombrie, Bun, achiziționat de Anthropic la sfârșitul lui 2025, anunță pentru următoarea versiune un linter compatibil cu ESLint, cu peste 1 000 de reguli integrate, care citește configurațiile eslint și oxlint; anunțat ca fiind de 26 de ori mai rapid decât ESLint, de 11 până la 43 de ori în cele cinci depozite măsurate, acesta nu are încă o dată de lansare. 🔗 sursă
OpenAI în companii și în rândul dezvoltatorilor
- Itaú și ia.i — Potrivit unui studiu de caz OpenAI, banca braziliană pune ia.i, interfața sa conversațională prin text sau voce, la dispoziția a aproximativ 300 000 de clienți și vizează întreaga clientelă până la sfârșitul lui 2026; modele GPT-5.x alimentează Customer DNA (aproximativ 70 de milioane de clienți), iar platforma sa cu mai mulți furnizori, IARA, susține o soluție juridică bazată pe peste 90 de milioane de documente. 🔗 sursă
- Benefit Street Partners și Codex — La această firmă de administrare a investițiilor specializată în credit, administratorul Anant Kumar a construit într-o zi prima versiune a unui instrument de urmărire a evaluărilor împrumuturilor (10 până la 12 ore de dezvoltare în total) și un analizor de contracte de credit refactorizat cu GPT-6 Astra; întrebările comitetului de investiții, care necesitau zile sau săptămâni, se rezolvă într-o zi. 🔗 sursă
- ChatGPT Enterprise și Edu — Conectorii sincronizați gestionați de administrator sunt eliminați în favoarea aplicațiilor în timp real Google Drive, SharePoint și Microsoft Teams, cu noi controale pentru conținut, iar pagina External access din Admin Console centralizează accesul prin Sign in with ChatGPT, accesul aplicațiilor conectate și accesul la datele Ads. 🔗 sursă
- Comutarea între furnizori — Revenind la 14 octombrie, blogul OpenAI Developers explică modul de comutare între API-ul direct OpenAI și modelele sale de pe Amazon Bedrock sau Azure OpenAI: numai în cazul unei erori tranzitorii sau al unei limitări care amenință termenul-limită, niciodată în cazul unei cereri invalide, al unui refuz sau al epuizării cotei; un prompt Codex adaugă un mecanism de comutare dezactivat implicit. 🔗 sursă
- Proiecte hardware construite cu Codex — OpenAI Developers prezintă o galerie comunitară de 20 de proiecte ordonate după voturi, deschisă contribuțiilor, de la un Kindle vechi transformat într-un tablou de bord pentru utilizarea IA până la un ecuson DEFCON al cărui circuit a fost proiectat de Astra, de la rutarea în KiCad până la comanda la JLCPCB, potrivit autorului său. 🔗 sursă
API-uri, modele și căutare web
- Agent API de la Perplexity — Șaisprezece modele mai vechi (șapte Claude 4.x, cinci Gemini 3.x, patru Grok 4.x) dispar din documentație, calculator și exemple, fără ca anunțul să precizeze că identificatorii lor nu mai răspund; GPT-6 Astra (10 dolari per milion de tokens de intrare, 50 la ieșire) și DeepSeek V4 Pro (1,32 și 3,96 dolari) sunt adăugate. 🔗 sursă
- pplx-decider-v1.2 pe OpenRouter — Publicate pe 16 octombrie împreună cu ponderile lor, cele două modele de decizie Perplexity ajung în aceeași zi pe OpenRouter, la 0,02 dolari (27B) și 0,01 dolari (4B) per milion de tokens de intrare, cu ieșire gratuită și un context de 262K, la fel ca v1.1 pe 7 octombrie. 🔗 sursă
- Embed 5 Fast comparat cu EmbeddingGemma 2 — Cohere afirmă că depășește modelul Google pe peste 95 % din 163 de seturi de date, dar folosind RCP-nDCG@10, propria metodă de evaluare; cu nDCG@10 standard, graficul său ViDoRe v3 indică 59,3 față de 47,6, fără o listă a seturilor de date, comparând un model disponibil printr-un API cu plată cu un model deschis de 740M de parametri. 🔗 sursă
- SDK TypeScript de la SpaceXSI 0.2.4 — Fără un anunț, acesta adaugă parametrul
guidelinesdinresponses.create(), instrucțiuni pe categorii pentru ieșirea modelului (refuzarea unei categorii, oferirea de sprijin în caz de automutilare), formatele video 21:9 și 5:2 și identificatorii grok-voice-3.0 și grok-voice-2.0 și marchează Live Search ca deprecated în favoareaweb_searchșix_search. 🔗 sursă - AI Mode și AI Overviews — Revenind la 15 octombrie, Google adaugă mai multe linkuri integrate, plasate mai sus, în răspunsurile sale generate, extinde în alte țări și limbi caruselele de știri care evidențiază sursele preferate (Preferred Sources), a căror utilizare a crescut de peste șapte ori de la începutul anului, și testează o secțiune dedicată paginilor oficiale. 🔗 sursă
Modele deschise și cercetare comunitară
- FLUX 3 Image Klein — La două zile după lansarea modelului, Black Forest Labs își corectează workflow-urile (ComfyUI v0.41.3, Space Hugging Face actualizat), recomandă supraeșantionarea promptului în 2K și publică pe GitHub promptul de sistem recomandat pentru a renunța la aceasta. 🔗 sursă
- Filtrare după autor pe Hub — Paginile Models și Datasets de pe Hugging Face pot fi filtrate după utilizator sau organizație, printr-un buton nou de pe fiecare profil; un card reamintește contul consultat atunci când se adaugă filtrele după sarcină, dimensiune, bibliotecă sau licență. 🔗 sursă
- Ammu-1.0-OffOnTopic-Guardrail — Kalyan KS publică sub licență MIT patru clasificatoare de la 150M la 17M de parametri, care evaluează dacă o cerere depășește domeniul stabilit prin promptul de sistem; potrivit autorului, cel mai mare obține 91,56 la Macro-F1, față de 81,95 pentru DeepSeek V4 Flash 0731 și 79,12 pentru GPT-6 Luna. 🔗 sursă
- Un clasificator de memorie care nu a fost pus în producție — Javad Taghia explică de ce encoderul ajustat fin pentru a decide scrierile în memoria AtMem nu a fost pus în producție: de la 18,4 % la 73,8 % pe un test sigilat, dar numai 16 decizii corecte din 100 de observații fictive rulate din nou în condiții similare producției, față de 30 pentru regulile deterministe, și de 15 până la 230 de ori mai lent. 🔗 sursă
- SPICY-KV — Potrivit lui Yuge Y (ElithiaTechnologies), această metodă care grupează cheile înainte de RoPE comprimă de 28,6 ori cache-ul KV al DeepSeek-R1-Distill-Qwen, păstrând 100,0 % (1.5B) și 91,7 % (7B) din recall pe RULER, în timp ce îmbinarea după RoPE scade la 0,0 %; acestea sunt măsurătorile autorului, fără evaluare inter pares. 🔗 sursă
Ce înseamnă acest lucru
Raportul Anthropic mută discuția despre ocuparea forței de muncă. Într-un laborator de vârf, agenții interactivi lansați de angajați lucrează deja de șase ori mai multe ore decât aceștia, iar ceea ce devine rar este atenția umană: recitirea, specificarea, supravegherea. Începătorii sunt primii care suportă consecințele, cu 9 % din angajările tehnice față de 27 %, în timp ce interviurile pun mai mult accent pe autonomie și discernământ. Google Research descrie aceeași împărțire în laborator: omul de știință stabilește strategia, agentul o execută, iar cei doi găsesc împreună aproape de două ori mai mulți candidați in silico decât un om de știință singur. Rămâne decalajul așteptărilor: 91 % dintre angajații Anthropic consideră că IA este capabilă de o descoperire demnă de un Nobel până în 2030, față de 39 % dintre americani, iar răspunsurile lor implică o creștere a PIB-ului de trei ori mai mare (17,1 % față de 5,4 %).
Câștigurile de viteză se lovesc de aceeași limită. Claude Code reduce așteptarea până la primul token de la 4,07 la 1,33 secunde la nivel local și activează implicit subagenții fork în afara terminalului, dar studiul Anthropic arată că mașina nu mai este principalul blocaj: sesiunile interactive rămân inactive aproximativ 80 % din timp, așteptând un răspuns, iar citirea a tot ceea ce produc ar ocupa mai mult de jumătate dintr-o săptămână de lucru. Reducerea latenței scurtează așteptarea utilizatorului în fața mașinii, nu și pe cea a sesiunilor care așteaptă intervenția umană.
În cazul modelelor deschise, costul per sarcină contează acum mai mult decât prețul per token. DeepSeek nu își modifică tariful, dar V4.1-Flash-1017 produce ieșiri mai scurte și declară 77,0 % pe DeepSWE v1.1 pentru aproximativ 0,2 dolari per sarcină, în timp ce cel mai bun model închis din graficul său, GPT-6.1 Sol, se oprește la aproximativ 75 % pentru un cost de circa trei ori mai mare; tabelul său de scoruri compară însă doar GPT-5.6 Sol și Opus 5, fără succesorii acestora. Partenerii NVIDIA transmit același mesaj pentru sarcini specifice, cu un Nemotron 3.5 Super VL antrenat suplimentar până la nivelul Opus 4.7 pe Legal Agent Bench de la Harvey, la 1,34 dolari per milion de tokens față de 15. Iar DeepSeek vinde acum și căutarea web pentru agenții săi, la 0,75 dolari pentru 1 000 de cereri: modelul, instrumentele și harness-ul provin de la același furnizor.
În cele din urmă, agenții se apropie de mediul real, iar fiecare își stabilește măsurile de protecție. Google Research repetă fiecare protocol într-un geamăn digital înainte de a atinge un reactiv, cu verificări de biosecuritate și supraveghere umană. Replit își instalează platforma și harness-ul Agentului său în cloud-ul clientului, dar păstrează la sine planul de control și inferența. NVIDIA, cu RTX Spark, mizează pe agenți de cod care rulează pe calculatorul dezvoltatorului, de la Junie Local la Copilot, în așteptarea unor calculatoare desktop concepute pentru agenți care nu se opresc.
Surse
- Cum se schimbă ocuparea forței de muncă la Anthropic (Anthropic)
- Decalajul așteptărilor privind IA (Anthropic)
- Munca la frontiera cercetării modelează așteptările pentru viitor (Anthropic)
- DeepSeek-V4.1-Flash-1017 (note de lansare DeepSeek)
- Fișa DeepSeek-V4.1-Flash-1017 (Hugging Face)
- Anunțul V4.1-Flash-1017 (@deepseek_ai)
- Ghidul Search și Fetch (DeepSeek)
- Punerea la dispoziție a Search și Fetch (@deepseek_ai)
- Partenerii Nemotron 3.5 Super VL (@NVIDIAAI)
- Ancorarea agenților IA în realitatea biologică (Google Research)
- VERID (PDF, Google)
- Sandbox-ul pentru aptameri (PDF, Google)
- Excizia epitopului (PDF, Google)
- Claude răspunde mai repede (@ClaudeDevs)
- Claude Code 2.1.302 (GitHub)
- Bring Your Own Cloud în Replit (Replit)
- Documentația Bring Your Own Cloud (Replit)
- Changelog-ul Replit din 16 octombrie
- Scrie cod, testează și implementează pe o singură mașină cu NVIDIA RTX Spark (NVIDIA)
- Notele de lansare Devin din 16 octombrie
- Copilot CLI 1.0.100-1 (GitHub)
- Gemini CLI v0.66.0-nightly.20261017 (GitHub)
- Changelog-ul Antigravity
- DeepSeek Harness 0.2.1-rc.2 (GitHub)
- bun lint (@bunjavascript)
- Itaú și IA generativă (OpenAI)
- Benefit Street Partners (OpenAI)
- Notele de lansare ChatGPT Enterprise și Edu
- Proiectarea mecanismului de failover între furnizorii de modele OpenAI (OpenAI Developers)
- Proiecte hardware construite cu Codex (@OpenAIDevs)
- Changelog-ul API-ului Perplexity
- pplx-decider-v1.2 pe OpenRouter (@perplexitydevs)
- Embed 5 Fast comparat cu EmbeddingGemma 2 (@cohere)
- SDK TypeScript de la SpaceXSI 0.2.4 (GitHub)
- Noutățile AI Mode și AI Overviews (Google)
- Workflow-urile FLUX 3 Image Klein (@bfl_ai)
- Filtrarea modelelor și a seturilor de date după autor (Hugging Face)
- Ammu-1.0-OffOnTopic-Guardrail (blogul Hugging Face)
- Clasificatorul de memorie AtMem (blogul Hugging Face)
- SPICY-KV (blogul Hugging Face)