ai-powered-markdown-translatorمقال مترجم من الفرنسية إلى العربية باستخدام gpt-6.1-sol.
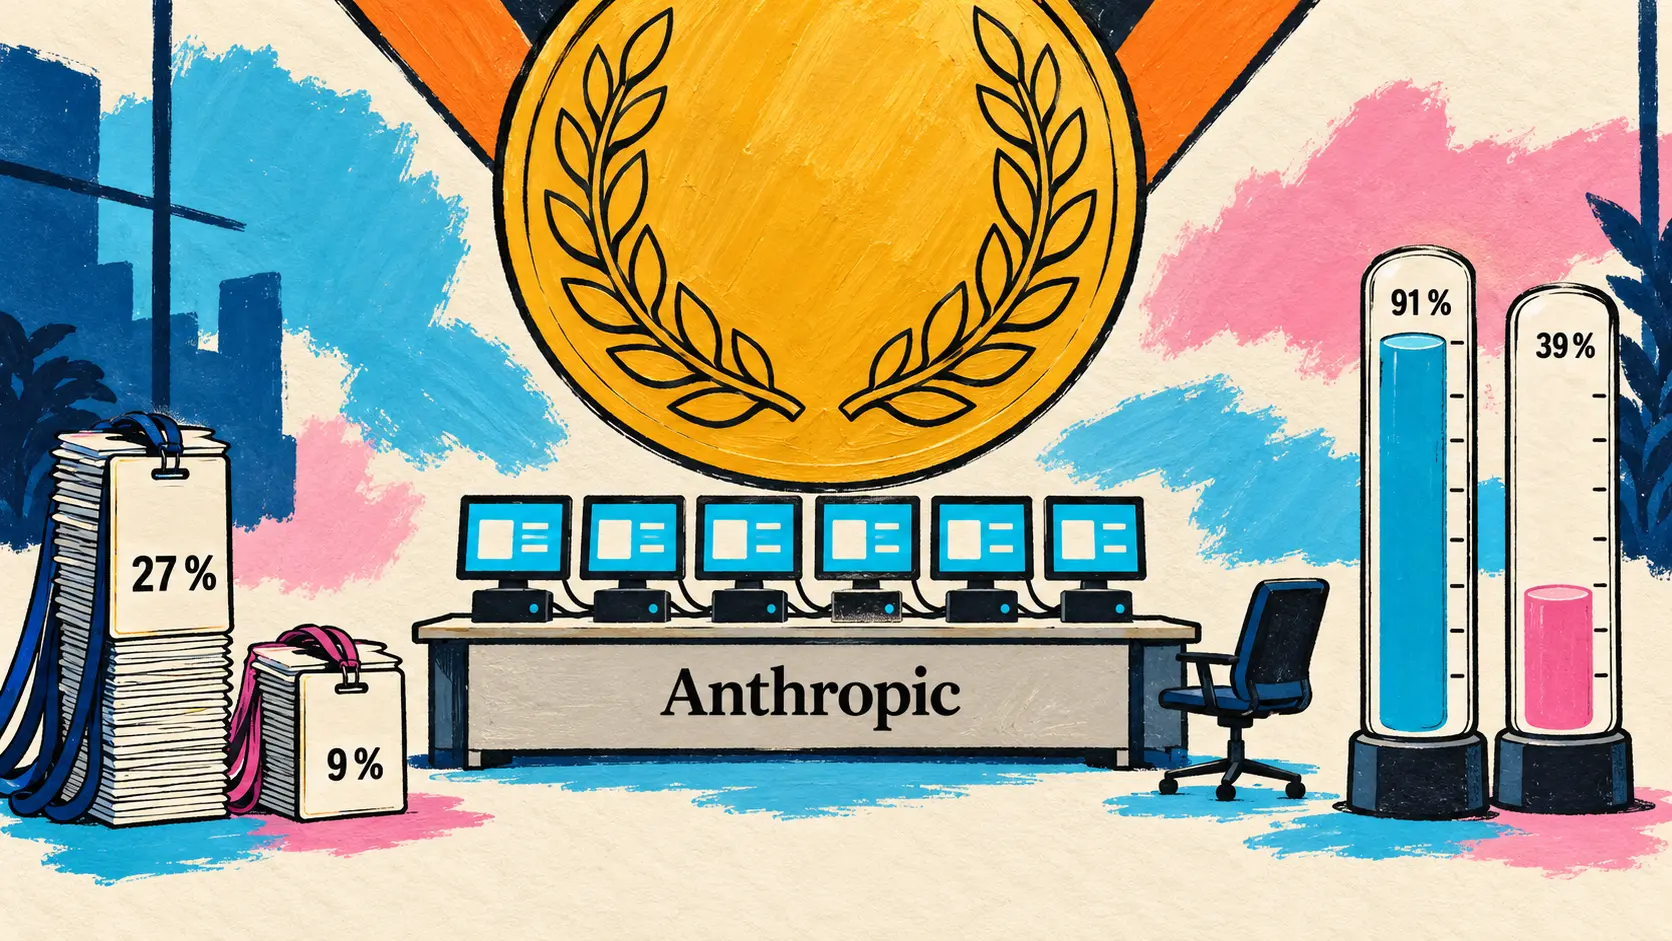
تتخذ Anthropic فرقها ميدانًا للدراسة: تراجعت حصة المبتدئين فيها من 27 % إلى 9 % من التعيينات التقنية، وبلغت ساعات عمل الوكلاء الذين شغّلهم الموظفون في أغسطس ستة أضعاف ساعات عمل هؤلاء، ويرى 91 % من هؤلاء الموظفين أن الذكاء الاصطناعي قادر على تحقيق اكتشاف يستحق جائزة نوبل بحلول 2030، مقابل 39 % من الأمريكيين. وتطرح DeepSeek نموذج V4.1-Flash-1017 بترخيص MIT، متقدمًا على GPT-5.6 Sol وClaude Opus 5 في DeepSWE v1.1 مع بقاء السعر على حاله، وتتيح للجميع واجهتَي API للبحث على الويب Search وFetch. ويوجّه وكلاء من Google Research روبوتات مختبرية ويسهمون في الحصول على جزيئات رابطة بروتينية ذات ألفة نانومولارية تجاه هدف ورمي، ويبدأ Claude Code بالرد بسرعة تعادل ثلاثة أضعاف سرعته في أغسطس، وتفصّل NVIDIA حواسيب RTX Spark الشخصية المخصصة للمطورين.
Anthropic تدرس وظائفها: تنخفض حصة المبتدئين إلى 9 % من التعيينات التقنية، وموظفوها يتوقعون من الذكاء الاصطناعي أكثر بكثير مما يتوقعه الأمريكيون
16 أكتوبر — ينشر فريق الاقتصاد في Anthropic تقريرين من معهد Anthropic يتخذان الشركة نفسها ميدانًا للدراسة. يجمع الأول، «كيف يتغير التوظيف في Anthropic» (كيف يتغير التوظيف في Anthropic)، بين بيانات داخلية (أعداد الموظفين، واستخدام الذكاء الاصطناعي، والإنتاج، والجداول الزمنية، وقرارات التوظيف) و17 مقابلة مع موظفين. ويقارن الثاني، «فجوة التوقعات بشأن الذكاء الاصطناعي» (فجوة التوقعات بشأن الذكاء الاصطناعي)، استطلاعًا أجرته Morning Consult في أغسطس وشمل 10 980 بالغًا أمريكيًا باستطلاع داخلي شمل 1 334 موظفًا؛ وأظهرت موجة ثانية في سبتمبر نتائج متقاربة.
| المؤشر المتابَع في Anthropic | التغير المقاس |
|---|---|
| حصة المبتدئين من التعيينات التقنية | من 27 % إلى 9 % |
| حصة المبتدئين في الأقسام التقنية | من 21 % إلى 14 % منذ بداية 2025 |
| ساعات الوكلاء التفاعليين مقابل كل ساعة عمل لموظف | 6 في أغسطس 2026 |
| عمليات Commit لكل مهندس | 5 أضعاف الوتيرة قبل ستة أشهر |
| جلسات البرمجة لغير التقنيين شهريًا | من 2 (أغسطس 2025) إلى 90 (مايو 2026) |
يمثل تراجع المبتدئين أبرز النتائج، وللذكاء الاصطناعي دور معلَن فيه: ففي أبريل 2026، صرّح نحو ثلث المديرين في التعلم الآلي وخُمس المديرين في هندسة البرمجيات بأنهم يقلّلون التوظيف بسببه. أما الوكلاء، فقد اتسع حضورهم: في مارس 2026، تجاوز مجموع ساعات عملهم ساعات عمل الموظفين للمرة الأولى. ولدى 192 مهندسًا انتقلوا إلى استخدام وكلاء البرمجة، مقارنة بـ74 لم يفعلوا ذلك، قفز حجم الشيفرة المضافة، من دون أن تكون شيفرة الوكلاء أكثر عرضة للحذف أو التراجع عنها لاحقًا.
أما الجانب الآخر فهو الانتباه البشري، الذي أصبح عنق الزجاجة: تبقى الجلسات التفاعلية خاملة نحو 80 % من الوقت، في انتظار رد، وستستغرق قراءة كل ما تنتجه أكثر من نصف أسبوع العمل. وارتفعت حصة العمل الفوقي (العمل الفوقي)، الذي يتمثل في كتابة مواصفات للوكلاء، أو تكليف وكيل بمراجعة عمل آخر، أو مراقبة سلاسل المعالجة، من 10 % إلى 22 % من الجلسات بين خريف 2025 وربيع 2026، ويقضي الموظف الوسيط وقتًا في الاجتماعات يزيد بنسبة 20 % عما كان عليه قبل عام. وعند التوظيف، تركز التقييمات أكثر على الاستقلالية وحسن التقدير؛ وتقول Anthropic إنها تنشئ نظام إنذار مبكر (نظام إنذار مبكر) للوظائف المعرضة للتأثر، وتعطي الأولوية لإعادة توزيع الموظفين داخليًا.
يُظهر التقرير الثاني أن الموظفين والجمهور يتفقون بشأن ما يستطيع الذكاء الاصطناعي فعله اليوم، لكنهم يختلفون بشأن سرعة تقدمه:
| الإجابة المقاسة، بأفق 2030 | الأمريكيون المشاركون في الاستطلاع | موظفو Anthropic |
|---|---|---|
| اعتبار اكتشاف يستحق جائزة نوبل أمرًا ممكنًا | 39 % | 91 % |
| حصة العمل الشخصي التي يستطيع الذكاء الاصطناعي أداءها (المتوسط) | 28 % (العاملون) | 75 % |
| نمو الناتج المحلي الإجمالي الذي تستلزمه الإجابات (الوسيط) | 5,4 % | 17,1 % |
ومع ذلك، تستند المجموعتان إلى المنطق نفسه: كلما زاد اعتقاد الفرد بأن الذكاء الاصطناعي سيؤدي جزءًا كبيرًا من عمله، ارتفعت توقعاته للبطالة، ويتوقع العاملون الأمريكيون الذين يرونه قادرًا على أداء 80 % على الأقل من عملهم بلوغ البطالة 12,2 % في 2030، مقابل 4,2 % اليوم. ويُستمد نمو الناتج المحلي الإجمالي من نموذج السيناريوهات الاقتصادية الذي عرضته Anthropic في سبتمبر. وأخيرًا، يقدّر الموظف الوسيط أن الذكاء الاصطناعي يؤدي بالفعل 51 % من العمل اللازم لبناء نموذج متقدم، ويتوقع بلوغ هذه النسبة 95 % بنهاية 2030: ويوضح التقرير أن هذه آراء شخصية جُمعت باستطلاع، وليست توقعات الشركة.
🔗 كيف يتغير التوظيف في Anthropic · فجوة التوقعات بشأن الذكاء الاصطناعي · التدوينة التعريفية
النماذج المفتوحة: DeepSeek تطرح V4.1-Flash-1017 وتتيح واجهتَي API Search وFetch، وشركاء NVIDIA يجرون تدريبًا لاحقًا لنموذج Nemotron 3.5 Super VL
17 أكتوبر — تطرح DeepSeek نموذج DeepSeek-V4.1-Flash-1017، وهو إصدار جديد من V4.1-Flash، نموذجها متعدد الوسائط من نوع MoE الذي يضم 552 مليار معلمة وأُطلق في 10 سبتمبر. تصفه بطاقة النموذج بأنه تحديث طفيف (تحديث طفيف)، لكن الفوارق واضحة في مهام الوكلاء: 77,0 % في DeepSWE v1.1 مقابل 74,2 % للإصدار السابق، و42,3 مقابل 31,2 في Terminal-Bench 4.0. ونُشرت الأوزان بترخيص MIT على Hugging Face وModelScope، وأصبح النموذج متاحًا على الموقع والتطبيق وواجهة API.
Stronger benchmark performance, faster task completion, and shorter outputs than the previous version—a Pareto improvement in performance and cost.
🇸🇦 درجات أعلى، ومهام تُنجز أسرع، ومخرجات أقصر من الإصدار السابق: تحسّن باريتو في الأداء والتكلفة. — @deepseek_ai على X
أما السعر، فلم يتغير. أصبح الاسم deepseek-flash يشغّل هذا الإصدار، بسياق يبلغ مليون رمز وما يصل إلى 384K رمز في المخرجات؛ ويظل الاسمان القديمان deepseek-v4-flash وdeepseek-v4-flash-vision-exp مقبولين، لكن طلباتهما تُوجَّه أيضًا إلى V4.1-Flash-1017. ولا تزال صفحة الأسعار تعرض 0,30 دولار لكل مليون رمز إدخال (خارج ذاكرة التخزين المؤقت) و1,20 دولار للمخرجات في ساعات الذروة، ونصف ذلك خارج ساعات الذروة، كما في 13 سبتمبر. إذن، يأتي انخفاض التكلفة من الإجابات الأقصر: يضع الرسم البياني في ملاحظات الإصدار، الذي لا يمكن الاطلاع عليه إلا كصورة، الإعداد max عند 77,0 % في DeepSWE v1.1 بتكلفة نحو 0,2 دولار لكل مهمة، متقدمًا على جميع النقاط الأخرى. ويبلغ أقربها، GPT-6.1 Sol، حدًا أقصى يقارب 75 % بتكلفة نحو 0,65 دولار، بينما تتراوح أفضل نقاط GPT-6 Astra وGemini 3.8 Flash وClaude Opus 5 وClaude Fable 5 بين نحو 70 % و74 %، بتكلفة تقارب 2 إلى 15 دولارًا لكل مهمة.
| معيار التقييم | V4.1-Flash-1017 | V4.1-Flash | K3 | GLM-5.3 | GPT-5.6 Sol | Opus 5 |
|---|---|---|---|---|---|---|
| HLE من دون أدوات | 42,6 | 36,8 | 43,5 | 42,0† | 44,5 | 56,3 |
| Terminal-Bench 4.0 | 42,3 | 31,2 | 12,6 | 37,9 | 39,9 | 51,8 |
| DeepSWE v1.1 | 77,0 | 74,2 | 67,5 | 66,9 | 73,0 | 74,0 |
| ProgramBench | 29,1 | 20,3 | 17,5 | 19,0 | 23,0 | 37,0 |
| NL2Repo-Bench | 68,2 | 65,4 | 58,0 | 58,0 | 56,8 | 75,3 |
| Automation-Bench v1.0.6 | 60,5 | 54,8 | 46,7 | 48,8 | 45,8 | 50,3 |
| Agents’ Last Exam | 35,4 | 31,8 | 27,6 | 28,5 | 26,7 | 28,6 |
| Apex Bench v1.1 | 72,1 | 64,6 | 47,8 | 56,6 | 54,3 | 65,8 |
† : المجموعة النصية الفرعية من HLE، وهي النتيجة الوحيدة المذكورة لـGLM-5.3 (ويحقق V4.1-Flash-1017 فيها 44,0). المصدر: بطاقة النموذج على Hugging Face.
بالنسبة إلى النماذج المغلقة، يقتصر الجدول على GPT-5.6 Sol وClaude Opus 5، ولا يشمل النماذج اللاحقة لهما. يتفوق V4.1-Flash-1017 عليهما في DeepSWE v1.1 وAutomation-Bench وAgents’ Last Exam وApex Bench، لكنه يظل خلف Opus 5 في HLE من دون أدوات (حيث يتقدمه GPT-5.6 Sol أيضًا، بـ44,5 مقابل 42,6)، وفي Terminal-Bench 4.0 وProgramBench وNL2Repo-Bench ومعايير التقييم البصرية الثلاثة التي تستخدم أدوات والواردة في البطاقة (Chartography وBabyVision وZeroBench-main)؛ وأمام النموذجين المفتوحين K3 وGLM-5.3، لا يخسر إلا أمام K3 في HLE من دون أدوات (43,5 مقابل 42,6). وتعزو DeepSeek هذا التقدم إلى التعلم المعزز بالتقييم الذاتي (التعلم المعزز مع التغذية الراجعة الذاتية) على مشاريع كاملة، وتحسّن النموذج للعمل مع DeepSeek Harness وTencent CodeBuddy وWorkBuddy. وللتشغيل المحلي، لا يتضمن الإصدار قالب محادثة بصيغة Jinja، بل تنفيذًا مرجعيًا بلغة Python لتنسيق الموجّه، ويوصي بما لا يقل عن 256K رمز في المخرجات؛ ولا يرافق هذا الإصدار أي تقرير تقني جديد.
🔗 ملاحظات إصدار DeepSeek · بطاقة النموذج على Hugging Face
Search وFetch: تتيح DeepSeek للجميع واجهتَي API للبحث على الويب بسعر 0,75 دولار لكل 1 000 طلب ناجح
17 أكتوبر — في سلسلة المنشورات نفسها، تتيح DeepSeek خدمتين للبحث على الويب لجميع مستخدمي واجهة API الخاصة بها. تستعلم Search من محرك البحث الداخلي لدى DeepSeek، الذي يعالج، بحسب الشركة، مئات الملايين من الطلبات يوميًا، وتعيد نتائج منظَّمة: تحمل كل نتيجة درجة صلة من 0 إلى 3، وملخصًا من 600 إلى 800 محرف مخصصًا للنموذج، وتاريخ النشر، ومستوى موثوقية من 0 إلى 4. وتجلب Fetch صفحة وتحوّلها إلى Markdown، مع مراعاة قواعد الوصول الخاصة بالموقع المستهدَف.
| عنصر العرض | القيمة التي تذكرها DeepSeek |
|---|---|
| سعر كل واجهة API | 0,75 دولار لكل 1 000 طلب ناجح |
| الحد لكل حساب | 5 طلبات في الثانية لكل واجهة API |
| النتائج لكل بحث | من 1 إلى 50 (10 افتراضيًا) |
| الاستدعاءات من Harness وClaude Code وCodex | مجانية حتى 31 أكتوبر عند 16 h UTC |
تُحتسب الرسوم فقط على الاستجابات التي تتضمن نتيجة: حالات الفشل وعمليات البحث الخالية من النتائج وانتهاء المهلة مجانية، ولا يغيّر عدد النتائج المطلوبة السعر. وكانت الأدوات التي تعمل على الخادم ضمن واجهة API لدى DeepSeek، والمستدعاة من DeepSeek Harness أوClaude Code أوCodex، تعتمد بالفعل على هاتين الواجهتين، وتظل هذه الاستدعاءات مجانية حتى 31 أكتوبر؛ ويدمج Harness v0.2.1-rc.2 خدمتي Search وFetch في إعداداته للبحث على الويب.
🔗 دليل Search وFetch · إعلان @deepseek_ai
Nemotron 3.5 Super VL: بعد تدريب لاحق يجريه شركاء NVIDIA، يضاهي في مهامهم نماذج مغلقة أعلى تكلفة
16 أكتوبر — في اليوم التالي لإطلاق Nemotron 3.5 Super VL، نموذجها المفتوح الذي يضم 120 مليار معلمة (12 مليارًا نشطة) والذي عُرض هنا في 15 أكتوبر، تنشر NVIDIA سلسلة تشير إلى 21 منشورًا لشركاء، نُشر معظمها تقريبًا يوم الإطلاق. ويعرض قسم كبير منها أداء النموذج بعد تدريبه لاحقًا على مهمة محددة، ويُقاس كل منها بتقييماته الخاصة: تعيد NVIDIA نشرها من دون منهجية مشتركة.
| الشريك المذكور | الاستخدام بعد التدريب اللاحق | النتيجة التي يعلنها الشريك |
|---|---|---|
| AfterQuery (مع Hebbia) | مهام ائتمانية للخبراء | من 47 % إلى 74 % من المهام المحلولة بالكامل، بتكلفة تقارب 1/7 تكلفة النماذج المغلقة محل المقارنة |
| Trajectory | Legal Agent Bench من Harvey | بمستوى Opus 4.7، بسعر 1,34 دولار لكل مليون رمز مقابل 15 |
| أليكس ديماكيس | باحث مستقل في ML | من 28 % إلى 35 % في AutoResearchExam، بمستوى Qwen 3.8 Max الأكبر حجمًا بـ20 ضعفًا |
| Handshake | وثائق علوم الحياة | مضاعفة الدقة باستخدام أكثر من 2 000 عنصر بيانات من خبراء |
| Multiverse Computing | ضغط النموذج | Comet 60B، بنصف عدد المعلمات، وبفارق يقل عن 5 % عن الدقة الأصلية |
وتعرض السلسلة أيضًا الأدوات التي تتشكل حول النموذج: إتاحته على Tinker وواجهة API من River وAC2 من Applied Compute وModelScope (بأوزان BF16 وNVFP4)، وإطلاق Fastino Training API لدورات SFT وRL، وتقديمه بمعدل 962 رمزًا في الثانية لكل مستخدم على 2 من وحدات GPU من طراز H200 باستخدام محرك Litespark من Mindbeam.
الوكلاء في المختبر: Google Research تسند إليهم روبوتات لنقل السوائل بالماصّات وتحصل على جزيئات رابطة بألفة نانومولية لهدف ورمي
16 أكتوبر — تعرض Google Research ثلاثة أعمال تنقل وكلاء الذكاء الاصطناعي إلى طاولة المختبر الرطب (wet lab): فلم يعودوا يكتفون بتصميم الجزيئات، بل يطلقون التجارب ويقرؤون النتائج ويصححون منهجهم، تحت إشراف العلماء.
اللبنة الأولى هي VERID (VERified Infrastructure for Discovery Laboratories)، وهو توأم رقمي لمحطة نقل السوائل بالماصّات الروبوتية، مبني على إطار العمل المفتوح المصدر PyLabRobot. يتتبع مباشرةً الذراع وحجم السائل في كل بئر والكواشف ورؤوس الماصّات المتاحة، ويتيح التدرّب على كل بروتوكول بالمحاكاة خلال ثوانٍ، ويمنع الأوامر المستحيلة ماديًا. وفي إحدى الحالات الموثقة، يرفض المحاكي سحب السوائل بثماني قنوات من حوض ضيق جدًا: فيعيد الوكيل التخطيط، ثم يصمم تجربة عاملية تعزل انحيازًا ناتجًا عن تلوث خلّفته رؤوس الماصّات.
| التجربة التي أُجريت بمشاركة الوكلاء | النتيجة التي أبلغت عنها Google Research |
|---|---|
| أبتامرات ضد الثرومبين α، ثلاث دورات | 0 %، ثم 26,0 %، ثم 42,1 % من الجزيئات الرابطة المؤكدة، بنوعية تبلغ 98,5 % |
| أبتامرات ضد الميوغلوبين | انخفضت النوعية من 75,0 % إلى 19,1 %، ثم ارتفعت إلى 72,4 %؛ وبلغت الجزيئات الرابطة 33,5 % في الدورة 3 |
| جزيئات بروتينية رابطة مصممة من الصفر ضد FAP | ألفة نانومولية برقم أحادي، وتنبؤ بالبنية أسرع بمقدار 8,6 مرات |
| تعاون الإنسان والوكيل، عند تساوي الموارد الحسابية | معدل نجاح في المحاكاة الحاسوبية يقارب ضعف ما يحققه عالم بمفرده |
تُظهر حالة الميوغلوبين التعلم ضمن حلقة مغلقة: ففي الدورة الثانية، يراهن الوكلاء على أنماط G-quadruplex التي ترتبط بكل شيء، ويرصدون انهيار النوعية في بيانات المختبر، ثم يعيدون كتابة قواعد التصميم بأنفسهم. وفي مواجهة FAP، وهو مستقبل يزداد التعبير عنه في الأورام الصلبة، لا يحتفظ مسار المعالجة إلا بموقع الارتباط أثناء التنبؤ بالبنية. وتفصّل Google ضوابطها الوقائية (أنظمة بيولوجية غير مُعدية، وفحص السلامة البيولوجية لكل تسلسل، ومحاكاة إلزامية قبل التنفيذ، وإشراف بشري)، لكنها لا تذكر النموذج الذي يشغّل الوكلاء.
🔗 تدوينة Google Research · VERID (PDF) · بيئة التجارب المعزولة للأبتامرات (PDF) · استئصال الحاتمة (PDF)
وكلاء البرمجة: Claude Code يبدأ الرد أسرع بثلاث مرات، والإصدار 2.1.302 يعمّم الوكلاء الفرعيين من نوع fork، وReplit تنتقل إلى سحابة عملائها
16 أكتوبر — يبدأ Claude الرد في وقت أبكر، بحسب إعلان @ClaudeDevs. ففي Claude Code، أصبحت المحادثة المُرسلة إلى النموذج في كل جولة تُضغط باستخدام gzip لتصل إليه أسرع، وتبدأ الجلسات السحابية بمجرد البدء بكتابة الطلب. ويقيس الجدول المرفق بالإعلان زمن الانتظار قبل أول token بين أغسطس وأكتوبر:
| الواجهة التي شملها القياس | أغسطس 2026 | أكتوبر 2026 | التحسن المعلن |
|---|---|---|---|
| Claude Code، الجلسات المحلية | 4,07 s | 1,33 s | 3 مرات |
| Claude Code، الجلسات السحابية | 16,99 s | 6,00 s | 2,8 مرة |
| Claude، الدردشة وCowork | 3,36 s | 2,17 s | 1,5 مرة |
| واجهة API الخاصة بـ Claude، مع احتساب زمن النموذج (الوسيط) | 1,53 s | 1,01 s | 1,5 مرة |
تستثني الصفوف الثلاثة الأولى زمن حساب النموذج، وتعتمد المئين التسعين. والضغط ليس جديدًا تمامًا: فقد كان Claude Code 2.1.300 يطبقه بالفعل، في 14 أكتوبر، على الطلبات الكبيرة المرسلة إلى api.anthropic.com، مع المتغير CLAUDE_CODE_GZIP_REQUEST_BODIES=0 لتعطيله. ولم يُذكر أي رقم إصدار لبدء الجلسات السحابية مسبقًا.
Claude Code 2.1.302: وكلاء فرعيون من نوع fork افتراضيًا خارج الطرفية، وإمكانية اختيار نموذج مصنّف الوضع التلقائي، و43 إصلاحًا
16 أكتوبر — بعد يوم من الإصدار 2.1.301، يوسّع Claude Code 2.1.302 (63 بندًا، منها 43 إصلاحًا) نطاق سلوك كان مقتصرًا على الطرفية ليشمل الواجهات الأخرى: أصبح الوكلاء الفرعيون من نوع fork مفعّلين افتراضيًا في claude -p وAgent SDK وتطبيق سطح المكتب وVS Code (مع CLAUDE_CODE_FORK_SUBAGENT=0 لتعطيلهم)، كما يشغّل تطبيق سطح المكتب وVS Code دائمًا الوكلاء الفرعيين للمحادثة الرئيسية في الخلفية.
| المجال المعني | التغيير الذي يقدمه الإصدار 2.1.302 |
|---|---|
| الوضع التلقائي | يختار CLAUDE_CODE_AUTO_MODE_MODEL نموذج المصنّف الذي يعمل على جانب العميل |
الأمر /config | سطر Idle compaction لتعطيل ضغط السياق عند الخمول أو إعادة تفعيله |
| المزوّدون الخارجيون | عند عدم تحديد الوضع، يبدأ claude -p وAgent SDK في وضع default إذا كانت بيانات القياس عن بُعد معطّلة أو كان التثبيت جديدًا |
| Hooks من نوعَي prompt وagent | 12 عملية تنفيذ متزامنة كحد أقصى لكل حدث |
| أداة Read | رفض الصور التي يتجاوز حجمها 128 Mo بدلًا من تحميلها في الذاكرة |
ومن بين الإصلاحات الأخرى، لم يعد الروتين المجدول الذي يفشل جزئيًا يُعاد تشغيله من البداية، وهو ما كان قد يؤدي إلى نشر التقرير نفسه مرتين، كما لم تعد أقراص exFAT أو FAT32 تعيق عمليات الكتابة على Windows.
🔗 ملاحظات إصدار Claude Code 2.1.302
Replit Bring Your Own Cloud: المنصة داخل بيئة العميل على Azure أو Google Cloud أو AWS، وClaude Haiku 5.5 في وضع Power
16 أكتوبر — تطلق Replit خدمة Bring Your Own Cloud (BYOC)، التي تشغّل Replit كليًا أو جزئيًا داخل البيئة السحابية (tenant) للشركة، على Microsoft Azure أو Google Cloud أو Amazon Web Services. وبالنسبة للمطورين، لا يتغير شيء: يظل النشر متاحًا بزر Publish نفسه.
| خيار النشر | ما يعمل لدى العميل | مرحلة الإتاحة |
|---|---|---|
| Full BYOC | المنصة بأكملها، بما فيها إطار تشغيل Agent، والتطبيقات المنشورة | معاينة خاصة |
| BYOC for Published Apps | التطبيقات المنشورة وحدها، مع بقاء التطوير لدى Replit | وصول مبكر |
| Image Exports | صورة Docker وملف Terraform وSBOM، ينشرها فريق العميل | وصول مبكر |
تعمل الأنفاق في الاتجاه الصادر فقط، مع تشفير مزدوج باستخدام mTLS، وتقتصر المفاتيح التي يديرها العميل (CMEK) على عقود العزل المادي الكامل. وتحدد الوثائق القيود: يظل مستوى التحكم لدى Replit، ولا تمثل Full BYOC تثبيتًا معزولًا عن الشبكات (air-gapped) أو نسخة من Replit مستضافة ذاتيًا بالكامل، كما تظل Replit مسؤولة عن استدلال النماذج. ولم تُنشر أي أسعار. ويضيف سجل التغييرات في اليوم نفسه Claude Haiku 5.5 إلى أداة اختيار النماذج في وضع Power لباقتَي Core وPro، اللتين أُتيح فيهما Claude Sonnet 5.5 في 2 أكتوبر.
🔗 تدوينة Replit · وثائق BYOC · سجل تغييرات 16 أكتوبر
RTX Spark: NVIDIA تفصّل مزايا حواسيبها للمطورين، مع Junie Local من JetBrains ومكاسب أداء معلنة مقارنةً بـ Core Ultra X9 388H
16 أكتوبر — في يوم طرح حواسيب RTX Spark المحمولة، التي عرضت برمجيات إطلاقها في 13 أكتوبر، تشرح NVIDIA في مدونتها التقنية ما تقدمه هذه الأجهزة للمطورين: كتابة الشيفرة واختبارها ونشرها على حاسوب واحد، مع وكلاء برمجة يعملون محليًا على ذاكرة موحّدة تصل إلى 128 Go. أصبحت الحواسيب المحمولة متاحة، وستتبعها حواسيب مكتبية صغيرة في نوفمبر، تُقدَّم على أنها مناسبة للوكلاء الذين يعملون باستمرار.
| عبء العمل | الاختبار الذي استخدمته NVIDIA | التحسن المعلن مقارنةً بـ Core Ultra X9 388H |
|---|---|---|
| وكلاء البرمجة | AA-AgentPerf-local مع Qwen3.8-27B | 4,6 مرة |
| الضبط الدقيق (LoRA) | Unsloth على Llama-3.1-8B | 2,7 مرة |
| ترجمة الشيفرة | نواة Linux، وPhoronix Test Suite | 1,8 مرة |
هذه القياسات صادرة عن NVIDIA، بالمقارنة مع شريحة Panther Lake 12Xe من Intel. وعلى صعيد البرمجيات، يثبّت Windows Developer Config، المصمم بالتعاون مع Microsoft، أطر عمل التطوير الرئيسية، ويعطّل الإشعارات ويحسّن الطرفية؛ وعلى Windows on Arm، تتوفر أكثر من 2 000 حزمة Conda جاهزة للاستخدام، ولأكثر من 97 % من حزم Python البالغ عددها 15 000 والأكثر استخدامًا نسخة مخصصة لـ Arm. وتطلق JetBrains دعمًا أصليًا لـ Junie Local، الذي يكيّف نافذة سياقه مع ذاكرة GPU، ويعمل GitHub Copilot محليًا عبر Windows ML باستخدام llama.cpp، وتصل حزم SDK الخاصة بـ AI for Media (رفع دقة الفيديو، وتوليد الإطارات الوسيطة، وTrueHDR) في حزمة Python على PyPI.
أخبار موجزة
وكلاء وأدوات البرمجة
- ملاحظات إصدار Devin ليوم 16 أكتوبر — بعد ملاحظات 14 أكتوبر التي تناولناها في 15 أكتوبر، تنشر Cognition 19 بندًا: أوامر /devin في طلبات الدمج على GitLab، وحالة الدمج في Bitbucket Cloud داخل Devin Review، والبحث عن طلبات السحب عبر خمس منصات لاستضافة الشيفرة، وأدوات مدمجة للمشكلات والتسميات، وإعداد في Enterprise يخفي سوق MCP القديم دون إيقاف الخوادم المثبتة بالفعل. 🔗 المصدر
- Copilot CLI 1.0.100-1 — بعد ساعتين ونصف من الإصدار 1.0.100-0، الذي تناولناه في اليوم السابق، يجعل هذا الإصدار التجريبي الثاني مستعرض الجلسات الموحد العرض الافتراضي لكل من
/sessionsو/sessionو/resume، ويزيل وسوم اللغة من الإملاء الصوتي؛ ولم يصدر بعد أي إصدار مستقر منذ 1.0.98 في 14 أكتوبر. 🔗 المصدر - Gemini CLI، الإصدار الليلي ليوم 17 أكتوبر — أربعة إصلاحات تغلق تذاكر تعود إلى مارس وأبريل: يتحقق التحديث التلقائي أخيرًا من الملف التنفيذي الذي شُغّل فعليًا، بدلًا من تكرار الإعلان عن نجاح زائف عند وجود عدة تثبيتات ضمن PATH، ويقبل
keybindings.jsonمصفوفةkeys، وتصل إشارات الإنهاء إلى العملية الفرعية تحت ACP أو systemd أو داخل حاوية. 🔗 المصدر - Antigravity CLI 1.4.0 وتطبيق Antigravity 2.24.0 — استدراكًا لإصداري 15 و14 أكتوبر: تعرض CLI حالتها في علامة تبويب الطرفية (تسلسل OSC 7501) وتعيد تصميم
agy plugin validateوفق قواعد التحميل الفعلية؛ ويعيد التطبيق، بعد الإصدار 2.23.0 الذي تناولناه في 13 أكتوبر، تنظيم لوحته الجانبية، ويضيف /compact ويتيح اختيار Flash Lite أو Flash أو Pro لكل عملية مؤتمتة. 🔗 المصدر - DeepSeek Harness 0.2.1-rc.1 وrc.2 — أول إصدارين مرشحين ضمن سلسلة 0.2.1: يجمع rc.1 التغييرات من الإصدارات التجريبية alpha.1 إلى alpha.5، ويدعم rc.2 نموذج V4.1-Flash-1017 وواجهتي API لكل من Search وFetch؛ ويضم المستودع 31 إصدارًا منذ 17 أغسطس، جميعها تجريبية. 🔗 المصدر
- bun lint — استدراكًا لأخبار 15 أكتوبر، تعلن Bun، التي استحوذت عليها Anthropic في أواخر 2025، عن أداة لتدقيق الشيفرة متوافقة مع ESLint في إصدارها المقبل، تتضمن أكثر من 1 000 قاعدة مدمجة وتقرأ إعدادات eslint وoxlint؛ وبحسب الإعلان، فهي أسرع من ESLint بـ26 مرة، وبما يتراوح بين 11 و43 مرة بحسب المستودعات الخمسة التي قيس عليها الأداء، ولم يُحدد موعد لإصدارها بعد. 🔗 المصدر
OpenAI في المؤسسات ولدى المطورين
- Itaú وia.i — وفقًا لدراسة حالة من OpenAI، يتيح البنك البرازيلي ia.i، واجهة المحادثة النصية أو الصوتية الخاصة به، لنحو 300 000 عميل، ويستهدف إتاحتها لجميع عملائه بحلول نهاية 2026؛ وتُشغّل نماذج GPT-5.x منظومة Customer DNA (نحو 70 مليون عميل)، وتستضيف منصته متعددة المزوّدين IARA حلًا قانونيًا يعمل على أكثر من 90 مليون وثيقة. 🔗 المصدر
- Benefit Street Partners وCodex — لدى مدير الأصول هذا المتخصص في الائتمان، أنشأ مدير الصندوق أنانت كومار في يوم واحد النسخة الأولى من أداة لمتابعة تقييمات القروض (10 إلى 12 ساعة من التطوير إجمالًا)، ومحللًا لاتفاقيات الائتمان أُعيدت هيكلة شيفرته باستخدام GPT-6 Astra؛ وأصبحت أسئلة لجنة الاستثمار، التي كانت تستغرق أيامًا أو أسابيع، تُعالج في يوم واحد. 🔗 المصدر
- ChatGPT Enterprise وEdu — يجري الاستغناء عن الموصلات المتزامنة التي يديرها المسؤول لصالح تطبيقات Google Drive وSharePoint وMicrosoft Teams التي تعمل في الوقت الفعلي، مع ضوابط جديدة للمحتوى، وتجمع صفحة الوصول الخارجي في وحدة تحكم الإدارة صلاحيات الوصول الخاصة بتسجيل الدخول باستخدام ChatGPT والتطبيقات المتصلة وبيانات Ads. 🔗 المصدر
- التبديل بين المزوّدين — استدراكًا لأخبار 14 أكتوبر، تشرح مدونة OpenAI Developers كيفية التبديل بين API المباشرة من OpenAI ونماذجها على Amazon Bedrock أو Azure OpenAI: فقط عند حدوث خطأ عابر أو تقييد لمعدل الطلبات يهدد الموعد النهائي، ولا يحدث أبدًا عند وجود طلب غير صالح أو رفض أو نفاد الحصة؛ وتضيف تعليمة موجّهة إلى Codex آلية تبديل معطّلة افتراضيًا. 🔗 المصدر
- مشاريع أجهزة بُنيت باستخدام Codex — تسلّط OpenAI Developers الضوء على معرض مجتمعي يضم 20 مشروعًا مرتبة حسب الأصوات ويقبل المشاركات، من جهاز Kindle قديم تحوّل إلى لوحة لمتابعة استخدام الذكاء الاصطناعي، إلى شارة DEFCON صمّم Astra دائرتها، من رسم مساراتها في KiCad إلى طلب تصنيعها من JLCPCB، بحسب صاحبها. 🔗 المصدر
واجهات API والنماذج والبحث على الويب
- Agent API من Perplexity — تُزال ستة عشر نموذجًا قديمًا (سبعة من Claude 4.x، وخمسة من Gemini 3.x، وأربعة من Grok 4.x) من الوثائق والحاسبة والأمثلة، دون أن يذكر بند التحديث أن معرّفاتها تتوقف عن الاستجابة؛ ويُضاف إليها GPT-6 Astra (10 دولارات لكل مليون رمز إدخال، و50 للإخراج) وDeepSeek V4 Pro (1,32 و3,96 دولار). 🔗 المصدر
- pplx-decider-v1.2 على OpenRouter — نُشر نموذجا اتخاذ القرار من Perplexity مع أوزانهما في 16 أكتوبر، ووصلا في اليوم نفسه إلى OpenRouter، بسعر 0,02 دولار (27B) و0,01 دولار (4B) لكل مليون رمز إدخال، مع إخراج مجاني وسياق يبلغ 262K، كما حدث مع v1.1 في 7 أكتوبر. 🔗 المصدر
- Embed 5 Fast مقابل EmbeddingGemma 2 — تقول Cohere إنها تتفوق على نموذج Google في أكثر من 95 % من 163 مجموعة بيانات، لكنها تستخدم RCP-nDCG@10، وهي طريقتها الخاصة في التقييم؛ وبمقياس nDCG@10 القياسي، يُظهر مخططها لـViDoRe v3 نتيجة 59,3 مقابل 47,6، دون قائمة بمجموعات البيانات، ويقارن نموذجًا مدفوعًا عبر API بنموذج مفتوح ذي 740M معلمة. 🔗 المصدر
- حزمة SDK بلغة TypeScript من SpaceXSI 0.2.4 — دون إعلان، تضيف المَعلمة
guidelinesالخاصة بـresponses.create()، وتعليمات بحسب الفئة لمخرجات النموذج (رفض فئة، وتقديم الدعم في حالات إيذاء النفس)، ونسبتي أبعاد الفيديو 21:9 و5:2 والمعرّفين grok-voice-3.0 وgrok-voice-2.0، وتضع علامة على Live Search تفيد بأنه لم يعد موصى باستخدامه لصالحweb_searchوx_search. 🔗 المصدر - AI Mode وAI Overviews — استدراكًا لأخبار 15 أكتوبر، تضيف Google مزيدًا من الروابط المدمجة في مواضع أعلى داخل إجاباتها المُولّدة، وتوسّع إتاحة شرائط الأخبار الدوارة التي تبرز المصادر المفضلة (Preferred Sources) لتشمل بلدانًا ولغات أخرى، وقد زاد استخدامها إلى أكثر من سبعة أضعاف منذ بداية العام، وتختبر قسمًا مخصصًا للصفحات الرسمية. 🔗 المصدر
النماذج المفتوحة والأبحاث المجتمعية
- FLUX 3 Image Klein — بعد يومين من إصدار النموذج، تُصحّح Black Forest Labs مسارات عمله (ComfyUI v0.41.3، وتحديث Space على Hugging Face)، وتوصي بتوسيع النص التوجيهي عند دقة 2K، وتنشر على GitHub النص التوجيهي للنظام الموصى به للاستغناء عن ذلك. 🔗 المصدر
- التصفية حسب صاحب المحتوى على Hub — يمكن تصفية صفحتي النماذج ومجموعات البيانات في Hugging Face بحسب المستخدم أو المؤسسة، من خلال زر جديد في كل ملف شخصي؛ وتذكّر بطاقة بالحساب الذي يجري تصفحه عند إضافة مرشحات المهمة أو الحجم أو المكتبة أو الترخيص. 🔗 المصدر
- Ammu-1.0-OffOnTopic-Guardrail — ينشر كاليان كي إس، بموجب ترخيص MIT، أربعة مُصنّفات تتراوح أحجامها من 150M إلى 17M معلمة، تحكم على ما إذا كان الطلب يتجاوز النطاق المحدد في النص التوجيهي للنظام؛ وبحسب صاحبها، يحقق أكبرها 91,56 على مقياس Macro-F1، مقابل 81,95 لنموذج DeepSeek V4 Flash 0731 و79,12 لنموذج GPT-6 Luna. 🔗 المصدر
- مُصنّف للذاكرة لم يُستخدم في بيئة الإنتاج — يوضح جواد تاغيا سبب عدم تشغيل المُرمّز المضبوط بدقة لاتخاذ قرارات الكتابة في ذاكرة AtMem في بيئة الإنتاج: ارتفع أداؤه من 18,4 % إلى 73,8 % في اختبار مغلق، لكنه اتخذ 16 قرارًا صحيحًا فقط من أصل 100 ملاحظة افتراضية أُعيد تمريرها لمحاكاة بيئة الإنتاج، مقابل 30 للقواعد الحتمية، وكان أبطأ بما يتراوح بين 15 و230 مرة. 🔗 المصدر
- SPICY-KV — بحسب يوغي واي (ElithiaTechnologies)، تضغط هذه الطريقة، التي تجمّع المفاتيح قبل RoPE، ذاكرة التخزين المؤقت KV لنموذج DeepSeek-R1-Distill-Qwen بمقدار 28,6 مرة، مع الحفاظ على استرجاع قدره 100,0 % (1.5B) و91,7 % (7B) على RULER، بينما يؤدي الدمج بعد RoPE إلى انخفاضه إلى 0,0 %؛ وهذه قياسات صاحب الطريقة، ولم تخضع لمراجعة الأقران. 🔗 المصدر
ما الذي يعنيه ذلك
يغيّر تقرير Anthropic زاوية النظر إلى مسألة التوظيف. في مختبر رائد، يعمل الوكلاء التفاعليون الذين يطلقهم الموظفون بالفعل لساعات تعادل ستة أضعاف ساعات عملهم، وما بات نادرًا هو الانتباه البشري: المراجعة وتحديد المتطلبات والمراقبة. ويتحمل المبتدئون الأثر أولًا، إذ يشكلون 9 % من التعيينات التقنية مقابل 27 %، فيما تقيّم المقابلات الاستقلالية وحسن التقدير بدرجة أكبر. ويصف Google Research توزيع الأدوار نفسه داخل المختبر: يحدد العالِم الاستراتيجية وينفذها الوكيل، ويعثر الثنائي بالمحاكاة الحاسوبية على مرشحين يقارب عددهم ضعف ما يعثر عليه عالِم بمفرده. وتبقى فجوة التوقعات: يرى 91 % من موظفي Anthropic أن الذكاء الاصطناعي قادر على تحقيق اكتشاف يستحق جائزة نوبل بحلول 2030، مقابل 39 % من الأمريكيين، وتشير إجاباتهم ضمنًا إلى نمو في الناتج المحلي الإجمالي يبلغ ثلاثة أضعاف (17,1 % مقابل 5,4 %).
تصطدم مكاسب السرعة بالحد نفسه. يقلّص Claude Code زمن الانتظار قبل الرمز الأول من 4,07 إلى 1,33 ثانية محليًا، ويفعّل افتراضيًا الوكلاء الفرعيين من نوع fork خارج الطرفية، لكن دراسة Anthropic تُظهر أن الآلة لم تعد عنق الزجاجة الرئيسي: تظل الجلسات التفاعلية خاملة نحو 80 % من الوقت بانتظار رد، وستستغرق قراءة كل ما تنتجه أكثر من نصف أسبوع عمل. تقليل زمن الاستجابة يقلّص الوقت الذي ينتظره المستخدم أمام الآلة، لا الوقت الذي تنتظر فيه الجلسات استجابة الإنسان.
أما في النماذج المفتوحة، فأصبحت تكلفة المهمة أهم من السعر لكل رمز. لا تغيّر DeepSeek أسعارها، لكن V4.1-Flash-1017 يُنتج مخرجات أقصر ويعلن تحقيق 77,0 % على DeepSWE v1.1 مقابل نحو 0,2 دولار للمهمة، بينما يصل أفضل نموذج مغلق في مخططه، GPT-6.1 Sol، إلى سقف يقارب 75 % مقابل نحو ثلاثة أضعاف التكلفة؛ ومع ذلك، لا يقارن جدول نتائجه إلا GPT-5.6 Sol وOpus 5، دون الإصدارات اللاحقة لهما. ويردد شركاء NVIDIA الفكرة نفسها في مهام محددة، إذ يصل Nemotron 3.5 Super VL بعد تدريب لاحق إلى مستوى Opus 4.7 على معيار Legal Agent Bench من Harvey، بسعر 1,34 دولار لكل مليون رمز مقابل 15. وتبيع DeepSeek الآن أيضًا البحث على الويب لوكلائها، بسعر 0,75 دولار لكل 1 000 طلب: النموذج والأدوات وإطار تشغيل الوكلاء تأتي جميعًا من المزوّد نفسه.
وأخيرًا، يقترب الوكلاء من البيئة الواقعية، ويضع كل طرف ضوابطه. يجعل Google Research كل بروتوكول يُجرَّب في توأم رقمي قبل استخدام أي كاشف كيميائي، مع فحص للسلامة الحيوية وإشراف بشري. تثبّت Replit منصتها وإطار تشغيل وكيلها Agent في سحابة العميل، لكنها تحتفظ لديها بطبقة التحكم والاستدلال. وتراهن NVIDIA، عبر RTX Spark، على وكلاء للبرمجة يعملون على جهاز المطور، من Junie Local إلى Copilot، في انتظار حواسيب مكتبية مصممة لوكلاء لا يتوقفون عن العمل.
المصادر
- كيف يتغير التوظيف لدى Anthropic (Anthropic)
- فجوة التوقعات بشأن الذكاء الاصطناعي (Anthropic)
- العمل في طليعة التطور يشكّل التوقعات للمستقبل (Anthropic)
- DeepSeek-V4.1-Flash-1017 (ملاحظات إصدار DeepSeek)
- بطاقة نموذج DeepSeek-V4.1-Flash-1017 (Hugging Face)
- الإعلان عن V4.1-Flash-1017 (@deepseek_ai)
- دليل Search وFetch (DeepSeek)
- إتاحة Search وFetch (@deepseek_ai)
- شركاء Nemotron 3.5 Super VL (@NVIDIAAI)
- ربط وكلاء الذكاء الاصطناعي بالواقع البيولوجي (Google Research)
- VERID (PDF، Google)
- بيئة تجريب الأبتامرات (PDF، Google)
- استئصال الحاتمة (PDF، Google)
- Claude يستجيب أسرع (@ClaudeDevs)
- Claude Code 2.1.302 (GitHub)
- استخدام سحابتك الخاصة مع Replit (Replit)
- وثائق استخدام سحابتك الخاصة (Replit)
- سجل تغييرات Replit ليوم 16 أكتوبر
- اكتب الشيفرة واختبرها وانشرها على جهاز واحد باستخدام NVIDIA RTX Spark (NVIDIA)
- ملاحظات إصدار Devin ليوم 16 أكتوبر
- Copilot CLI 1.0.100-1 (GitHub)
- Gemini CLI v0.66.0-nightly.20261017 (GitHub)
- سجل تغييرات Antigravity
- DeepSeek Harness 0.2.1-rc.2 (GitHub)
- bun lint (@bunjavascript)
- Itaú والذكاء الاصطناعي التوليدي (OpenAI)
- Benefit Street Partners (OpenAI)
- ملاحظات إصدار ChatGPT Enterprise وEdu
- تصميم آلية تبديل عند التعطل بين مزوّدي نماذج OpenAI (OpenAI Developers)
- مشاريع أجهزة بُنيت باستخدام Codex (@OpenAIDevs)
- سجل تغييرات API من Perplexity
- pplx-decider-v1.2 على OpenRouter (@perplexitydevs)
- Embed 5 Fast مقابل EmbeddingGemma 2 (@cohere)
- حزمة SDK بلغة TypeScript من SpaceXSI 0.2.4 (GitHub)
- جديد AI Mode وAI Overviews (Google)
- مسارات عمل FLUX 3 Image Klein (@bfl_ai)
- تصفية النماذج ومجموعات البيانات حسب صاحب المحتوى (Hugging Face)
- Ammu-1.0-OffOnTopic-Guardrail (مدونة Hugging Face)
- مُصنّف الذاكرة في AtMem (مدونة Hugging Face)
- SPICY-KV (مدونة Hugging Face)