ai-powered-markdown-translatorمقال مترجم من الفرنسية إلى العربية باستخدام gpt-5.6-sol.
تنشر NVIDIA Research منصة الاستدلال Sol-H3، التي تخفّض زمن توليد خمس ثوانٍ من الفيديو إلى ما دون مدة تشغيل المقطع، وذلك بترخيص Apache 2.0. وفي اليوم نفسه، ينشر مطوّر على Hugging Face خطَّين من النماذج المصممة للمعالج، مصحوبين بوعود لا تدعمها أي قياسات، بينما يتيح فريق هندي مجموعة بيانات للكلام المشوش يخضع فيها كل طابع زمني لسلسلة تحقق موثقة. كذلك توسّع Google Research إلى آسيا تجاربها على المسارات الجوية التي تتجنب خطوط التكاثف.
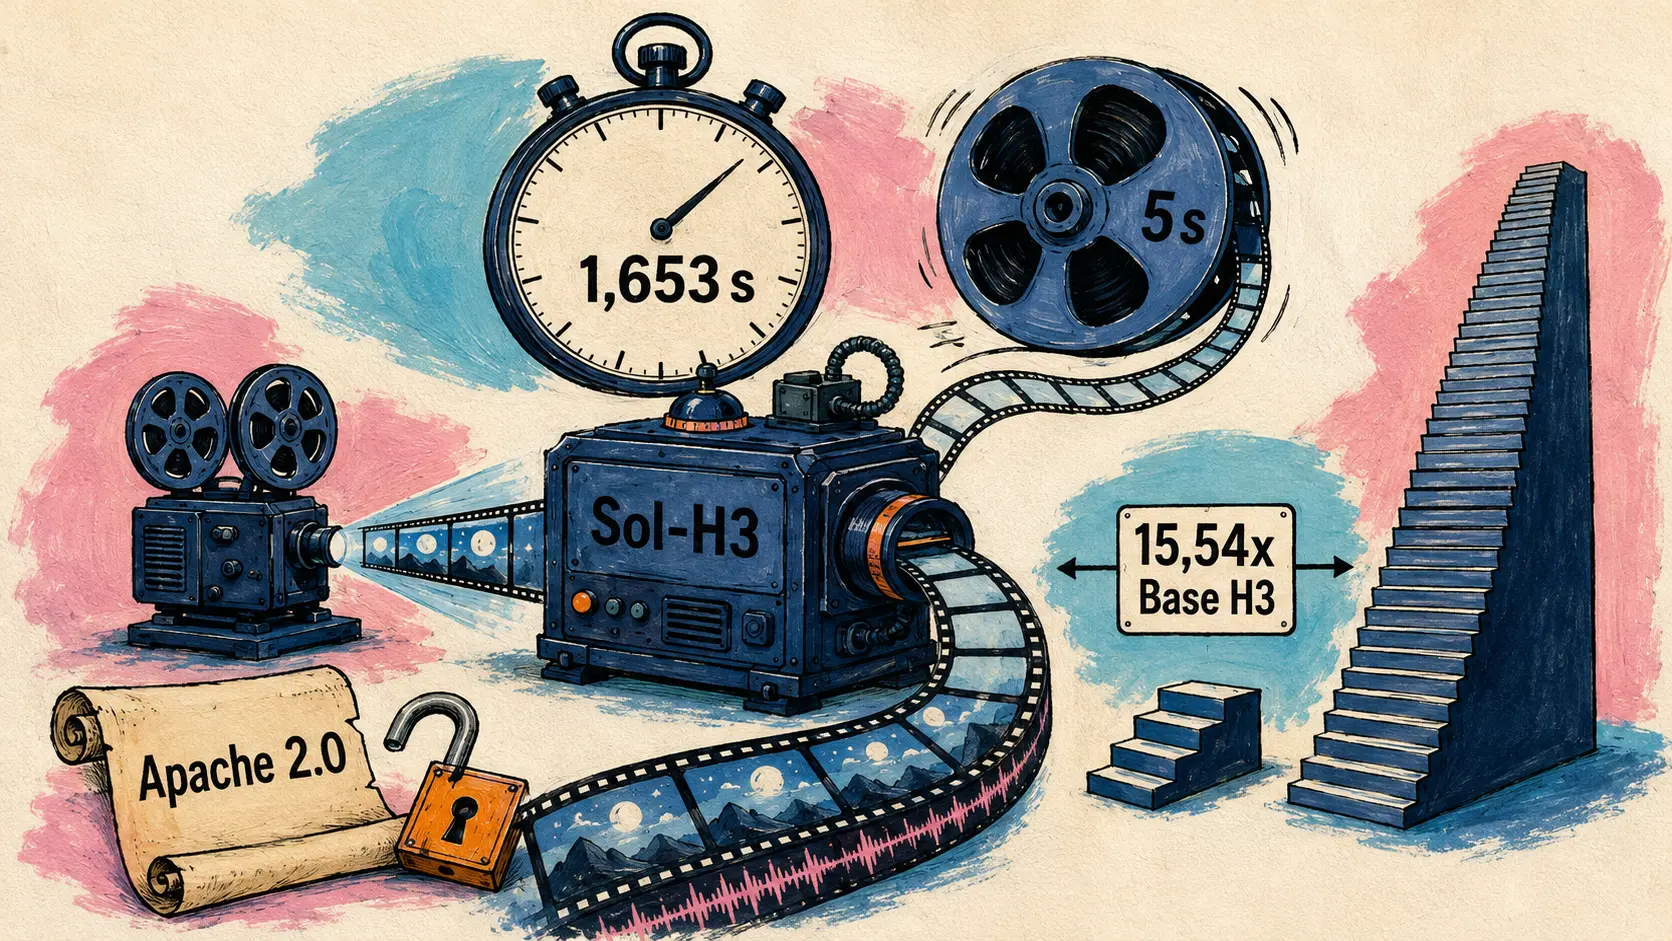
يولّد Sol-H3 خمس ثوانٍ من الفيديو في 1,653 ثانية، أسرع من مدة تشغيلها
7 سبتمبر — ينشر فريق Efficient AI في NVIDIA Research، بالتعاون مع مختبره في سنغافورة، Sol-H3، وهي منصة استدلال متكاملة لنموذج الفيديو MiniMax-H3. ويمكن تلخيص النتيجة في جملة واحدة: إنتاج خمس ثوانٍ من الفيديو بدقة 1344×768 وبمعدل 24 إطارًا في الثانية، مع توليد صوت ستيريو في التمريرة نفسها، خلال 1,653 ثانية على نظام يضم ثمانية مسرّعات B300 Blackwell. وهكذا يصنع النموذج المقطع أسرع مما يستطيع المشاهد مشاهدته.
تتناول المقارنة إعدادات متكاملة، لا مجرد تغيير في نواة الانتباه. يستهلك الإعداد المرجعي، Base H3 Dense، عدد 50 خطوة من المجدوِل، أي 49 تمريرة أمامية عبر شبكة DiT؛ أما Sol-H3 فلا يستخدم سوى أربع خطوات.
| تهيئة العتاد | المدة المولّدة | Base H3، 50 خطوة | Sol-H3، 4 خطوات | التسريع |
|---|---|---|---|---|
| 8× B300 | 5 s | 18,250 s | 1,653 s | 11,04× |
| 8× B300 | 10 s | 50,660 s | 3,732 s | 13,57× |
| 8× B300 | 15 s | 99,513 s | 6,612 s | 15,05× |
| 4× B300 | 5 s | 35,328 s | 2,918 s | 12,11× |
| 4× B300 | 15 s | 194,930 s | 12,542 s | 15,54× |
| 1× B300 | 5 s | 129,898 s | 13,745 s | 9,45× |
يبلغ التسريع ذروته عند 15,54×، وهي قيمة قصوى تحققت باستخدام أربع وحدات B300 لفيديو مدته خمس عشرة ثانية. والبروتوكول واضح على نحو غير معتاد: القيم الوسيطة لثلاث عمليات تشغيل بعد الإحماء، باستخدام الموجّه والبذرة نفسيهما؛ ويشمل القياس الزمني ترميز النص وإزالة الضوضاء عبر DiT وفك الترميز بواسطة VAE، لكنه يستثني تحميل النموذج وترميز MP4 النهائي.
تجمع المنصة مكوّنين طُوّرا بصورة منفصلة: Sol-Engine لبيئة تشغيل استدلال الفيديو، وSol-Attn للانتباه المتناثر (sparse attention) المطبّق آنيًا من دون إعادة تدريب. ويضاف إليهما استخدام أنوية مدمجة، واتصال بين وحدات GPU بصيغة INT8 لإسقاطات QKV وبصيغة FP8 للمخرجات، وفك ترميز VAE على نحو متوازٍ وعلى دفعات، وتخزين مؤقت لمعاملات AdaLN. ينخفض تحضير الانتباه المتناثر من 1,206 إلى 0,285 مللي ثانية، وفك ترميز VAE من 7,55 إلى 0,602 ثانية، مع تحرير نحو 24 GB من الذاكرة لكل GPU.
يجعل قراران هذا الإصدار قابلًا للاستخدام فيما يتجاوز العرض التجريبي: إصدار الشفرة بترخيص Apache 2.0، وإمكانية توصيل أي LoRA مدرّب مسبقًا بعدد قليل من الخطوات (few-step) لـ MiniMax-H3 ببيئة التشغيل نفسها. كما يتيح الوصول المفتوح إلى API عبر Reactor منذ اليوم الأول تجربة النظام من دون حجز ثماني وحدات B300.
For us, the bigger milestone is crossing from “fast generation” into “faster than playback.” That opens the path toward continuous 24 FPS generation and truly interactive video systems.
🇸🇦 بالنسبة إلينا، يتمثل الإنجاز الحقيقي في الانتقال من «التوليد السريع» إلى «أسرع من مدة التشغيل». وهذا يمهّد الطريق نحو التوليد المستمر بمعدل 24 FPS وأنظمة فيديو تفاعلية بحق. — @xieenze_jr على X
🔗 صفحة مشروع Sol-H3 لدى NVIDIA Research
🔗 الوصول إلى API منذ اليوم الأول عبر Reactor
مجموعة بيانات مفتوحة تؤرشف زمنيًا 106 892 ضوضاء حقيقية في 58 لغة هندية
7 سبتمبر — ينشر فريق ARTPARK التابع لـ Indian Institute of Science مجموعة Vaani Noise Event Timestamp Dataset، وهي طبقة من التعليقات التوضيحية البشرية أضيفت إلى مجموعة الكلام العفوي Project Vaani. وتحمل كل ضوضاء خلفية فيها نوعها ولحظتي بدايتها ونهايتها بدقة المللي ثانية.
| خاصية مجموعة البيانات | القيمة |
|---|---|
| إجمالي الصوت المشروح | أكثر من 122 ساعة |
| أحداث الضوضاء المؤرشفة زمنيًا | 106 892، ضمن 7 فئات |
| مقاطع الكلام والمتحدثون | 72 756 مقطعًا، و38 541 صوتًا |
| التغطية اللغوية والجغرافية | 58 لغة، و30 ولاية |
| المجموعة المتحقق منها والمجموعة الخام | نحو 22 h ونحو 100 h |
تكمن النقطة المنهجية هنا: جرى التقاط الكلام والضوضاء معًا، باستخدام هواتف عادية، من دون إدراج ضوضاء اصطناعية أو مزج لاحق. وتظهر الأصوات البشرية غير الكلامية، مثل السعال والضحك، في نحو 38 بالمئة من المقاطع، لكنها تدوم أقل من نصف ثانية؛ أما أصوات الحيوانات وحركة المرور فهي أندر وأطول بكثير، وتشكل معًا الحصة الأكبر من زمن الضوضاء. ويخضع كل طابع زمني لعملية شرح، ثم للتحقق من الاتساق، ثم لإعادة تحقق داخلية، وأخيرًا لتدقيق مستقل على عُشر مجموعة البيانات مختار عشوائيًا: إذا فشل عنصر واحد فقط، تُعاد معالجة الدفعة بأكملها.
🔗 منشور ARTPARK-IISc على Hugging Face
ينشر CMS Manhattan خطَّين من النماذج للمعالج من دون معيار أداء داعم
6 سبتمبر — يتيح مطوّر CMS Manhattan على Hugging Face إصدارين بأوزان مفتوحة موجّهين إلى الاستدلال على المعالج بدلًا من بطاقة الرسوميات. وقد نشر مطوّر النماذج المنشورين بنفسه، وكل ما يلي معروض بهذه الصفة.
يجمع الإصدار الأول، سلسلة JiRack Ultra، أربعة نماذج بأوزان ثلاثية ذات 1,58 bit على غرار BitNet، ويقول المطوّر إنها مشتقة من معمارية DeepSeek-R1-Distill-Qwen-32B. وليس التكميم العنصر الأكثر إثارة للاهتمام، بل الـ tokenizer، الذي وُسّع بإضافة رموز مخصصة للتوجيه واستدعاء الأدوات ووسوم التحكم الروبوتي والوسائط، ما يستهدف الأنظمة الوكيلة والروبوتات المضمنة. أما الإصدار الثاني، JiRackDeltaNet_27b، فيستخدم نموذج Qwen 3.8 ذا 27 مليار معامل بعد نقله إلى معمارية DeltaNet، التي تتناوب فيها طبقات الانتباه الكامل وطبقات Gated DeltaNet المرتبطة بنماذج فضاء الحالات، مع سياق معلن يبلغ 262 144 tokens.
| خط النماذج | الأساس الذي أعلنه المطوّر | تنسيق الأوزان المنشورة | الترخيص والتغليف |
|---|---|---|---|
| JiRack Ultra، أربعة أحجام | DeepSeek-R1-Distill-Qwen-32B | أوزان ثلاثية 1,58 bit، وGGUF من Q2_K إلى Q4_K_M | أوزان على Hub، وصور Docker، وواجهة باشتراك |
| JiRack DeltaNet 27B | نقل Qwen 3.8 27B إلى DeltaNet | ملفات GGUF اعتيادية لـ llama.cpp منتجة من FP16 | أوزان بترخيص MIT، وصورة Docker، وواجهة بسعر 12 دولارًا لكل مستخدم سنويًا |
هناك تحفظان مهمان للقارئ. فعلى الرغم من وسمي ternary وbitnet في مستودع DeltaNet، يتوافق خط GGUF المنشور مع عمليات تكميم اعتيادية من llama.cpp، لا مع نقطة تحقق ثلاثية منفصلة، وهو ما يقر به المنشور نفسه. كذلك فإن وعد الجودة القريبة من Opus 4.6 Max، المستخدم عنوانًا للمنشور الثاني، لا يدعمه أي ناتج لمعيار أداء: وهذا بالضبط ما ينقص، أي قياس مقارن منشور يتيح تقييم هذه النماذج بما يتجاوز وثائقها.
🔗 سلسلة JiRack Ultra على Hugging Face
🔗 JiRack DeltaNet 27B على Hugging Face
لماذا تعمل بيئات RL اليوم ولم تكن تعمل في 2016
7 سبتمبر — ينشر Sergio Paniego على مدونة Hugging Face مراجعةً استعادية تنطلق من ملاحظة محيّرة: كان من الممكن أن يظهر وصف OpenAI Universe، المنشور في ديسمبر 2016، كما هو في تدوينة لأحد المختبرات الرائدة اليوم. ومع ذلك، فقد أُرشف المستودع.
يمتد التسلسل الزمني من Arcade Learning Environment في 2012 إلى OpenAI Gym في 2016 ومفرداته الدنيا، reset() وstep()، التي انتقلت منذ ذلك الحين إلى Gymnasium تحت مظلة Farama Foundation. ثم جاءت موجة التخصص حسب المجال، من World of Bits إلى WebArena، ثم SWE-bench وTerminal-Bench: فكثيرًا ما تبدأ المهمة كمعيار أداء قبل أن تصبح ساحة تدريب.
يتلخص جوهر التحليل في خمسة عناصر كانت مفقودة في 2016: لم يكن هناك نموذج مدرّب مسبقًا يصلح نقطة انطلاق، وكانت المهمة بعيدة المنال، والواجهة مصممة على نمط البشر بدلًا من الآلات، ولم تكن هناك أي وصفة للمكافآت المتناثرة، كما كان من المتعذر تنسيق آلاف البيئات المعزولة القابلة للتخلص منها. ويوفّر GRPO والمكافآت القابلة للتحقق العنصر الرابع اليوم. ويُختتم المقال بـ OpenEnv، وهي واجهة معيارية أعلنها فريق PyTorch في Meta وHugging Face في أكتوبر 2025، وبسوق لبيئات تضم Prime Intellect وMechanize.
تجعل Google أكثر من 80 رحلة لـ Cathay Pacific تتبع مسارًا يتجنب خطوط التكاثف
7 سبتمبر — توسّع Google Research إلى منطقة آسيا والمحيط الهادئ تجاربها لتجنب خطوط التكاثف، مع Cathay Pacific بوصفها أول شريك طيران تجاري لها في المنطقة. والحل بسيط نظريًا: تعديل الارتفاع قليلًا لتفادي المناطق الباردة والرطبة التي تستمر فيها خطوط التكاثف على هيئة طبقات تحتجز الحرارة.
| مقياس المرحلة الأولى | القيمة |
|---|---|
| الرحلات المستهدفة ضمن شبكة Cathay Pacific | أكثر من 100 |
| الرحلات التي اتبعت بالفعل مسارًا للتجنب | أكثر من 80 |
| الانخفاض المقدّر في أثر الاحترار الناجم عن خطوط التكاثف | نحو 40 % |
| حصة ممر Hong Kong-Singapour من المكاسب | أكثر من 50 % |
| حصة خطوط التكاثف من الأثر المناخي للطيران | نحو الثلث |
يجمع النظام بين التنبؤات التي تنتجها نماذج Google وصور الأقمار الاصطناعية وبيانات الأرصاد الجوية المتقدمة. وتصل التوقعات إلى قمرة القيادة عبر شبكة Wi-Fi على متن الطائرة ومن خلال سجل الرحلة الإلكتروني للشركة (Electronic Flight Folder)، من دون تعطيل الإجراءات المعتادة، وتظل التعديلات ضمن معايير السلامة المعتمدة. وقد بدأت مرحلة ثانية موسّعة، بمشاركة Contrails.org.
Contrail mitigation remains one of the most immediately available, scalable, and cost-effective ways to reduce aviation’s climate footprint, and it can get started now, with today’s aircrafts and fuel.
🇸🇦 يظل الحد من خطوط التكاثف أحد أكثر الوسائل المتاحة فورًا، والقابلة للتعميم، والأقل تكلفةً لتقليص البصمة المناخية للطيران، ويمكن البدء به حالًا باستخدام طائرات اليوم ووقوده. — Kemal Armada وMax Vogler، Google Research
تضيف Genspark نموذج Muse Spark 1.3 إلى ثلاثة من منتجاتها
7 سبتمبر — تدمج Genspark نموذج Meta، Muse Spark 1.3، في AI Chat وCode Agent وClaw، بعد خمسة أيام من الإعلان عنه. وتكرر المنصة الرقمين اللذين طرحتهما Meta لتبرير الاختيار: خفض استدعاءات الأدوات بنسبة 20 بالمئة، واستهلاك tokens بنسبة أقل بـ25 بالمئة؛ وهما مقياسان يؤثران مباشرةً في تكلفة وكيل يعمل بصورة متكررة على مهام طويلة.
الوتيرة هي الإشارة الحقيقية. ففي ستة أيام، دمجت Genspark أربعة نماذج من مزوّدين مختلفين: Claude Fable 5.1 في 2 سبتمبر، وGemini 3.8 Flash في 3 سبتمبر، وGPT-6 Astra في 5 سبتمبر، وMuse Spark 1.3 في 7 سبتمبر. ولا تتموضع المنصة بوصفها نموذجًا بقدر ما تتموضع كطبقة تنسيق تستوعب إصدارات جميع المختبرات خلال الأيام التالية لنشرها.
موجز الأخبار
- Replit تفتتح أول مكتب دولي لها في لندن — تتخذه الشركة مركزًا لعملياتها الأوروبية، بالتعاون مع عمدة لندن Sadiq Khan والحكومة البريطانية وLondon & Partners، وتعلن عن برنامج تجريبي لتنمية المهارات مع TLMA لصالح شباب لندن العاطلين عن العمل وغير الملتحقين بالتعليم أو التدريب. 🔗 المنشور
- Tolquane، مكتبة Python للتوازي القابل للتركيب — يمكن تشغيل الرسم البياني نفسه، من دون تغيير الشيفرة، باستخدام الخيوط أو العمليات أو async أو بصورة موزعة أو تسلسلية، بسرعة تبلغ 5.6 أضعاف الأداء المرجعي على Python 3.14t من دون قفل عمومي، مقابل 0.9 ضعف باستخدام الخيوط مع GIL. ويُعتمد فيها عدم الحظر قاعدةً تصميمية، مع خطأ يسمّي العُقد المحظورة. 🔗 التدوينة
- إجراء مخصص لتثبيت مهارة وكيل — يوجّه برنامج Aiden الثابت الآن عنوان URL للمهارة إلى إجراء واحد يتولى الإعداد والتحقق ثم النشر بصورة ذرّية. وأدى تكرار العملية على وكيل حقيقي إلى اختزال تتبّع متعدد الأدوات إلى استدعاء واحد. 🔗 التدوينة
- Together AI تقارن GLM-5.3 Flash بـ GPT-5.6 Terra من حيث التكلفة لكل مهمة — حقق النموذجان النتيجة نفسها على مؤشر الذكاء من Artificial Analysis، لكن الأول أقل تكلفة لكل مهمة بنسبة 82 في المئة وفقًا لمضيفه، الذي لم ينشر طريقة الحساب ولا تدوينة مفصلة، وهو نفسه من يقدّم النموذج موضع المقارنة. 🔗 المنشور
- بيان من أجل منظومة برازيلية للذكاء الاصطناعي — نص بالبرتغالية يواصل استعارة المنظومة الطبيعية لوصف مجتمع الذكاء الاصطناعي في البلاد، من دون نموذج أو مجموعة بيانات أو قياس. أُدرج لاستكمال التغطية. 🔗 التدوينة
- Google DeepMind تختار 16 منظمة لمسرّعة AI for the Planet في منطقة آسيا والمحيط الهادئ — الدفعة الأولى، التي انطلقت بمعسكر تدريبي مكثف (bootcamp) في سنغافورة، تليه ثلاثة أشهر من الوصول إلى نماذج AnthroKrishi وForestCast وAlphaEarth Foundations وSpeciesNet وPerch، موزعة على مجالات حماية الطبيعة والزراعة المستدامة وحلول الكربون. 🔗 التدوينة
- GitHub تعيد تسليط الضوء على مساحات الرسم في تطبيق Copilot — إعادة نشر لمقال مؤرخ في 17 أغسطس يعرض مساحة الرسم بوصفها سطحًا مشتركًا ودائمًا تظل عليه حالة العمل مرئية، مع رقم نادر النشر: من 2,000 إلى 3,000 من AI Credits لبناء كل واحد من المثالين المذكورين. 🔗 المنشور
- GitHub تطلق مولّد أسماء مستعارة لـ GitHub Universe — نشاط مجتمعي ترويجي قبل نسخة أكتوبر 2026، لا صلة له بالذكاء الاصطناعي ولا بأي ميزة في المنتج. 🔗 المنشور
- Synthesia تعرض بالتفصيل محاور أبحاثها الثلاثة لـ ECCV 2026 — شخصيات رمزية توليدية موجّهة بالصوت، وأبحاث صوتية مطبقة على التعرّف إلى الكلام، وشخصيات رمزية تفاعلية، تحت مظلة نموذج العالم المتمحور حول الإنسان. 🔗 المنشور
- Mati Staniszewski يقدّر أن اختبار Turing الحواري سيُجتاز خلال ستة أشهر أو اثني عشر شهرًا — صرّح المؤسس المشارك والرئيس التنفيذي لـ ElevenLabs بذلك في بودكاست GDIY، الذي تتيح خدمة الصوت التابعة للشركة مقابلته مدبلجة بالفرنسية. 🔗 المنشور
- QwenCloud تنشر تقرير Qwen Conference Thailand 2026 — شارك نحو 400 عميل ومطوّر في بانكوك يوم 4 سبتمبر، وشهد الحدث عرضًا توضيحيًا متكاملًا يكون فيه الوكيل نفسه هو العميل، بدءًا من التسجيل ووصولًا إلى الدفع وإصدار الفواتير من دون تدخل بشري. 🔗 المنشور
- Cohere تعيد نشر تقرير CNN عن Toronto بوصفها مركزًا عالميًا للذكاء الاصطناعي — مادة تواصلية بلا إعلان عن منتج، تشير إلى احتلال المدينة المرتبة الثالثة عالميًا في المواهب التقنية وفقًا لـ CBRE، وإلى التزام الاستراتيجية الوطنية الكندية بأكثر من ملياري دولار، وإلى تدفق طلبات العملاء الذي أعلنت عنه Cohere عقب ضوابط التصدير المفروضة على نماذج Anthropic. 🔗 المنشور
ما الذي يعنيه ذلك
العتبة التي تجاوزها Sol-H3 ليست مجرد رقم قياسي آخر في قائمة. فما دام إنتاج مقطع يستغرق وقتًا أطول من مشاهدته، يظل توليد الفيديو عملًا على دفعات: نبدأ العملية، ثم ننتظر، ثم نشاهد. أما النزول تحت هذه العتبة فيفتح فئة أخرى من الاستخدام، حيث تُنتج الصورة في أثناء مشاهدتها. والتفصيل المهم للممارس هو أن المكسب لا يأتي من نموذج جديد: فالنموذج هو نفسه، وما تغيّر هو مكدس الاستدلال وحده. لذا كان عامل التسريع البالغ 15 كامنًا في هندسة التنفيذ، لا في الأوزان، وقد نُشر بموجب Apache 2.0 مع توافقه مع نماذج LoRA الحالية.
يكشف هذا اليوم عن طريقتين متعارضتين لنشر الأوزان المفتوحة. فمن جهة، هناك تدوينتان منشورتان ذاتيًا لا تستند ادعاءاتهما المتعلقة بالجودة إلى أي قياس قابل للمقارنة، مع تسميات للمستودعات لا تطابق التنسيق المقدّم فعليًا، ومقارنة للتكلفة لكل مهمة أعلنها مضيف النموذج الفائز من دون نشر المنهجية. ومن جهة أخرى، هناك متن كلامي يمر فيه كل طابع زمني عبر سلسلة تدقيق، ويفصل فيه الفريق صراحةً بين 22 ساعة خضعت للتحقق و100 ساعة لم تخضع له. وفي مستودع عام يستطيع أي شخص النشر فيه، يصبح انضباط التحقق الإشارة الوحيدة القابلة للاستخدام، وإنتاج هذه الإشارة أعلى تكلفة من صياغة عنوان جذاب.
يروي استعراض بيئات RL ووتيرة التكامل لدى Genspark التحول نفسه، ولكن على مقياسين مختلفين. يوضح الأول لماذا تنجح اليوم فكرة تعود إلى عام 2016: لم تكن الخوارزميات هي ما ينقص، بل البنية التحتية المحيطة بها، من النموذج الابتدائي إلى بيئات الحماية المؤقتة. ويبيّن الثاني ما تصير إليه هذه البنية التحتية بعد إتاحتها، حين تصل منصة أربعة نماذج من أربعة مورّدين خلال ستة أيام. وفي الحالتين، تنتقل القيمة من النموذج إلى الطبقة المحيطة به، وتخضع هذه الطبقة للتوحيد القياسي، مع OpenEnv من جهة ومنسّقات النماذج المتعددة من جهة أخرى.
ويبقى ما لا يندرج ضمن سباق النماذج. فالتجربة مع Cathay Pacific تتعلق بطائرات ووقود قائمين بالفعل: الشيء الوحيد المضاف هو توقّع يُقدَّم في الوقت المناسب داخل قمرة القيادة، لتحقيق خفض تقديري بنحو 40 في المئة على الرحلات المعنية. ويغطي متن Vaani عددًا قدره 58 لغة هندية، لم يكن لبعضها أي مورد للكلام المصحوب بالضوضاء، بينما توزّع مسرّعة DeepMind لمنطقة آسيا والمحيط الهادئ نماذج متخصصة على ستة عشر فريقًا ميدانيًا. لا تملك هذه الأعمال الثلاثة معيارًا مرجعيًا تسعى إلى التفوق عليه. فقيودها تكمن في موضع آخر، في البيانات التي ينبغي جمعها والنشر الذي ينبغي إنجاحه، وهناك أيضًا يتحدد الفارق بين العرض التوضيحي والأثر القابل للقياس.
المصادر
- Sol-H3، إعلان Enze Xie على X
- صفحة مشروع Sol-H3، NVIDIA Research
- الوصول إلى API لـ Sol-H3 عبر Reactor
- مجموعة بيانات Vaani Noise Event Timestamp، ARTPARK-IISc
- سلسلة JiRack Ultra، CMS Manhattan
- JiRack DeltaNet 27B، CMS Manhattan
- تاريخ بيئات RL، Hugging Face
- تجنب خطوط التكاثف في الرحلات فائقة المدى، Google Research
- Muse Spark 1.3 في Genspark
- Replit تفتتح مكتبها في لندن
- Tolquane، التوازي القابل للتركيب في Python
- التثبيت المباشر للمهارات في برنامج Aiden الثابت
- Together AI تقارن GLM-5.3 Flash وGPT-5.6 Terra
- بيان من أجل منظومة برازيلية للذكاء الاصطناعي
- مسرّعة AI for the Planet في منطقة آسيا والمحيط الهادئ، Google DeepMind
- مساحات الرسم في تطبيق Copilot
- مولّد الأسماء المستعارة لـ GitHub Universe
- Synthesia في ECCV 2026
- Mati Staniszewski في بودكاست GDIY
- تقرير Qwen Conference Thailand 2026
- Cohere تعيد نشر تقرير CNN عن Toronto