ai-powered-markdown-translatorArtikel, mit gpt-5.6-sol vom Französischen ins Deutsche übersetzt.
NVIDIA Research veröffentlicht Sol-H3, einen Inference-Stack, der die Generierung von fünf Sekunden Video unter die Wiedergabedauer des Clips drückt, und zwar unter der Apache-2.0-Lizenz. Am selben Tag veröffentlicht ein Anbieter auf Hugging Face zwei für Prozessoren optimierte Modellreihen mit Versprechen, die durch keinerlei Messungen belegt sind, während ein indisches Team einen Korpus verrauschter Sprache öffnet, bei dem jeder Zeitstempel eine dokumentierte Verifizierungskette durchläuft. Google Research weitet zudem seine Versuche mit Flugrouten zur Vermeidung von Kondensstreifen auf Asien aus.
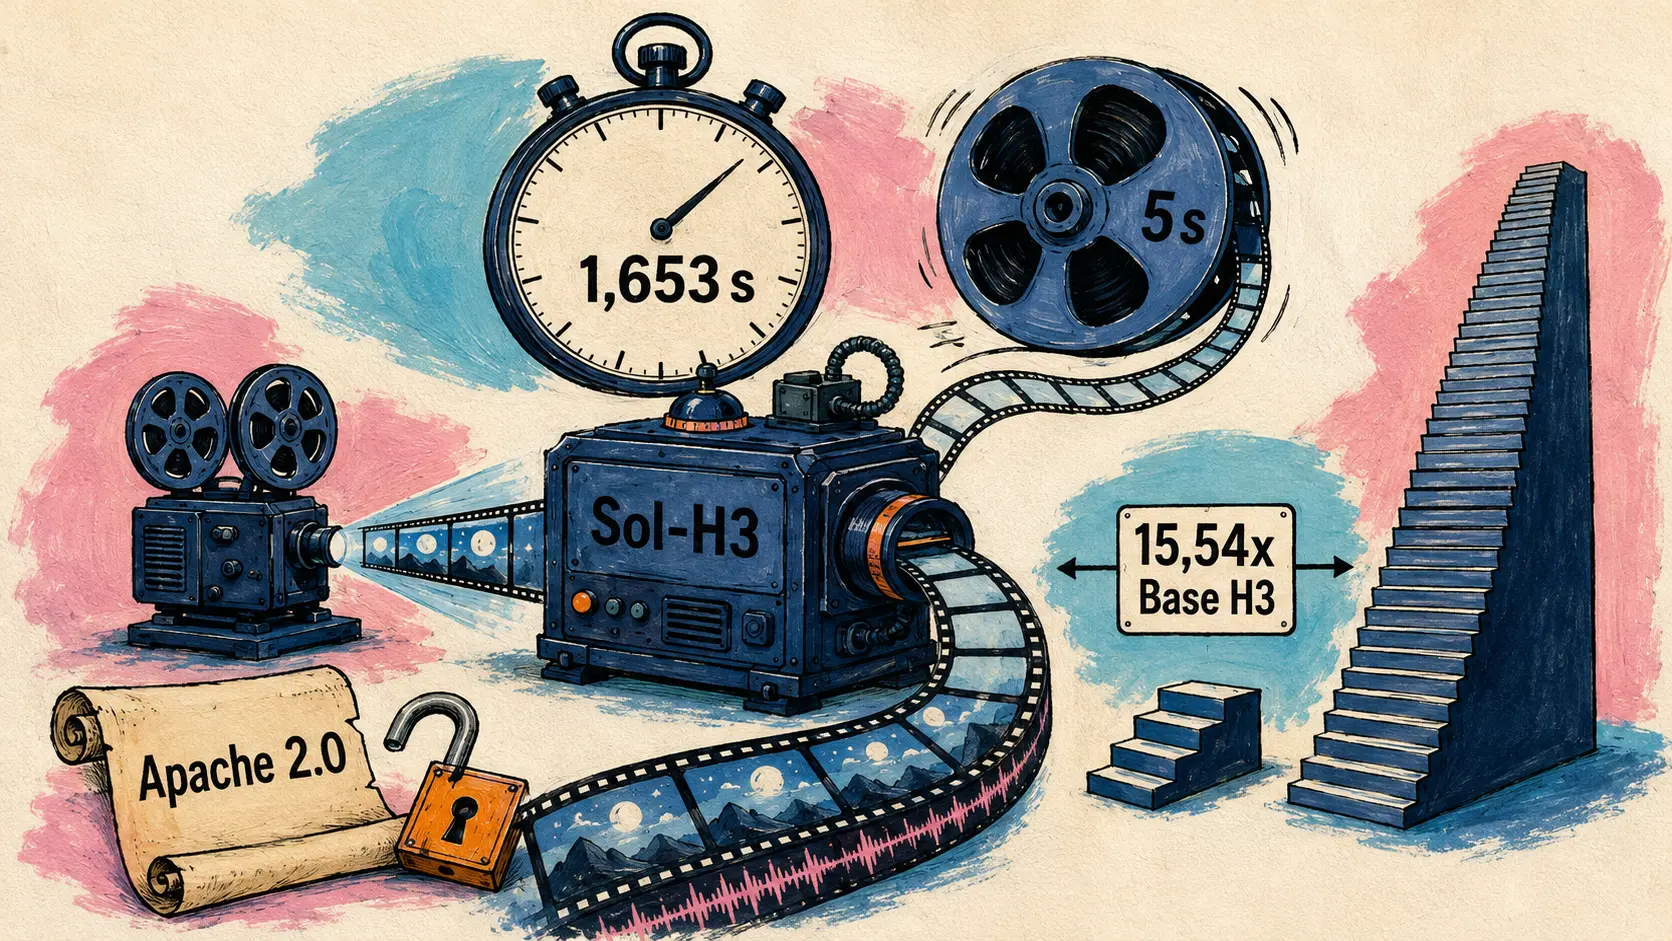
Sol-H3 generiert fünf Sekunden Video in 1,653 Sekunden, schneller als ihre Wiedergabe
7. September — Das Efficient-AI-Team von NVIDIA Research veröffentlicht gemeinsam mit seinem Labor in Singapur Sol-H3, einen vollständigen Inference-Stack für das Videomodell MiniMax-H3. Das Ergebnis lässt sich in einem Satz zusammenfassen: Fünf Sekunden Video in 1344×768 bei 24 Bildern pro Sekunde, mit in demselben Durchlauf erzeugtem Stereoton, werden auf einem System mit acht B300-Blackwell-Beschleunigern in 1,653 Sekunden produziert. Das Modell erzeugt den Clip damit schneller, als ein Zuschauer ihn ansehen kann.
Der Vergleich bezieht sich auf vollständige Profile und nicht nur auf einen einfachen Wechsel des Attention-Kernels. Das Referenzprofil Base H3 Dense benötigt 50 Scheduler-Schritte, also 49 Vorwärtsdurchläufe des DiT-Netzwerks; Sol-H3 verwendet lediglich vier.
| Hardwarekonfiguration | Generierte Dauer | Base H3, 50 Schritte | Sol-H3, 4 Schritte | Beschleunigung |
|---|---|---|---|---|
| 8× B300 | 5 s | 18,250 s | 1,653 s | 11,04× |
| 8× B300 | 10 s | 50,660 s | 3,732 s | 13,57× |
| 8× B300 | 15 s | 99,513 s | 6,612 s | 15,05× |
| 4× B300 | 5 s | 35,328 s | 2,918 s | 12,11× |
| 4× B300 | 15 s | 194,930 s | 12,542 s | 15,54× |
| 1× B300 | 5 s | 129,898 s | 13,745 s | 9,45× |
Die Beschleunigung erreicht mit 15,54× ihren Höchstwert, erzielt auf vier B300 für fünfzehn Sekunden Video. Das Protokoll ist ungewöhnlich präzise: Medianwerte aus drei Ausführungen nach dem Aufwärmen, mit identischem Prompt und Seed; die Zeitmessung umfasst die Textkodierung, das DiT-Denoising und die VAE-Dekodierung, schließt jedoch das Laden des Modells und die abschließende MP4-Kodierung aus.
Der Stack vereint zwei separat entwickelte Bausteine: Sol-Engine für die Video-Inference-Runtime und Sol-Attn für zur Laufzeit angewendete Sparse Attention, ohne erneutes Training. Hinzu kommen fusionierte Kernels, eine Inter-GPU-Kommunikation in INT8 für die QKV-Projektionen und in FP8 für die Ausgaben, eine parallelisierte und stapelweise ausgeführte VAE-Dekodierung sowie das Caching der AdaLN-Parameter. Die Vorbereitung der Sparse Attention sinkt von 1,206 auf 0,285 Millisekunden, die VAE-Dekodierung von 7,55 auf 0,602 Sekunden, und pro GPU werden etwa 24 GB Speicher freigegeben.
Zwei Entscheidungen machen die Veröffentlichung über die Demonstration hinaus nutzbar: Der Code erscheint unter der Apache-2.0-Lizenz, und jedes bereits für MiniMax-H3 trainierte Few-Step-LoRA lässt sich an dieselbe Runtime anbinden. Ein ab dem ersten Tag verfügbarer offener API-Zugang über Reactor macht es unnötig, für einen Test acht B300 zu blockieren.
For us, the bigger milestone is crossing from “fast generation” into “faster than playback.” That opens the path toward continuous 24 FPS generation and truly interactive video systems.
🇩🇪 Für uns besteht der eigentliche Meilenstein im Übergang von „schneller Generierung“ zu „schneller als die Wiedergabe“. Das ebnet den Weg für eine kontinuierliche Generierung mit 24 FPS und wirklich interaktive Videosysteme. — @xieenze_jr auf X
🔗 Sol-H3-Projektseite, NVIDIA Research
🔗 API-Zugang ab dem ersten Tag über Reactor
Ein offener Korpus versieht 106 892 reale Geräusche in 58 indischen Sprachen mit Zeitstempeln
7. September — Das ARTPARK-Team des Indian Institute of Science veröffentlicht den Vaani Noise Event Timestamp Dataset, eine von Menschen erstellte Annotationsschicht für den Korpus spontaner Sprache Project Vaani. Jedes Hintergrundgeräusch ist darin mit seinem Typ sowie seinem Start- und Endzeitpunkt auf die Millisekunde genau versehen.
| Eigenschaft des Korpus | Wert |
|---|---|
| Insgesamt annotiertes Audiomaterial | mehr als 122 Stunden |
| Geräuschereignisse mit Zeitstempeln | 106 892, in 7 Kategorien |
| Sprachsegmente und Sprecher | 72 756 Segmente, 38 541 Stimmen |
| Sprachliche und geografische Abdeckung | 58 Sprachen, 30 Bundesstaaten |
| Verifizierter und unbearbeiteter Datensatz | etwa 22 h und etwa 100 h |
Der methodische Kern liegt darin, dass Sprache und Geräusche gemeinsam mit gewöhnlichen Telefonen aufgenommen wurden, ohne synthetische Geräusche einzufügen oder nachträglich zu mischen. Nichtsprachliche menschliche Laute, Husten und Lachen, treten in etwa 38 Prozent der Segmente auf, dauern jedoch weniger als eine halbe Sekunde; Tiere und Verkehr sind seltener und deutlich länger und machen zusammen den größten Anteil der Geräuschdauer aus. Jeder Zeitstempel durchläuft eine Annotation, eine Konsistenzprüfung, eine interne Nachprüfung und anschließend ein unabhängiges Audit an einem zufällig ausgewählten Zehntel des Korpus: Scheitert auch nur einer, wird die gesamte Charge erneut bearbeitet.
🔗 ARTPARK-IISc-Beitrag auf Hugging Face
CMS Manhattan veröffentlicht zwei Modellreihen für Prozessoren, ohne unterstützende Benchmarks
6. September — Der Anbieter CMS Manhattan stellt auf Hugging Face zwei Open-Weight-Veröffentlichungen online, die für Inference auf Prozessoren statt auf Grafikkarten bestimmt sind. Beide Beiträge wurden vom Anbieter der Modelle selbst veröffentlicht, und alles Folgende wird entsprechend als dessen Darstellung wiedergegeben.
Die erste, die JiRack-Ultra-Reihe, umfasst vier Modelle mit ternären 1,58-Bit-Gewichten im BitNet-Stil, die laut Anbieter von der Architektur DeepSeek-R1-Distill-Qwen-32B abgeleitet sind. Das interessanteste Element ist nicht die Quantisierung, sondern der Tokenizer, der um spezielle Tokens für Routing, Tool-Aufrufe, Steuer-Tags für Robotik und Medien erweitert wurde und damit auf agentische Systeme und eingebettete Robotik abzielt. Die zweite, JiRackDeltaNet_27b, basiert auf einem Qwen 3.8 mit 27 Milliarden Parametern, das auf eine DeltaNet-Architektur migriert wurde. Diese wechselt zwischen vollständiger Attention und Gated-DeltaNet-Schichten, die mit State-Space-Modellen verwandt sind, und wirbt mit einem Kontextfenster von 262 144 Tokens.
| Modellreihe | Vom Anbieter angegebene Basis | Format der veröffentlichten Gewichte | Lizenz und Packaging |
|---|---|---|---|
| JiRack Ultra, vier Größen | DeepSeek-R1-Distill-Qwen-32B | ternäre 1,58-Bit-Gewichte, GGUF Q2_K bis Q4_K_M | Gewichte auf dem Hub, Docker-Images und Oberfläche im Abonnement |
| JiRack DeltaNet 27B | auf DeltaNet migriertes Qwen 3.8 27B | gewöhnliche, aus FP16 erzeugte llama.cpp-GGUFs | Gewichte unter MIT-Lizenz, Docker-Image und Oberfläche für 12 Dollar pro Nutzer und Jahr |
Für den Leser sind zwei Vorbehalte wichtig. Trotz der Labels ternary und bitnet im DeltaNet-Repository entspricht die veröffentlichte GGUF-Reihe gewöhnlichen llama.cpp-Quantisierungen und nicht einem eigenständigen ternären Checkpoint, was der Beitrag selbst einräumt. Auch das im Titel des zweiten Beitrags verwendete Versprechen einer Qualität nahe Opus 4.6 Max wird durch keinerlei Benchmark-Ergebnisse gestützt: Genau das fehlt, eine veröffentlichte Vergleichsmessung, um diese Modelle über ihre Dokumentation hinaus beurteilen zu können.
🔗 JiRack-Ultra-Reihe auf Hugging Face
🔗 JiRack DeltaNet 27B auf Hugging Face
Warum RL-Umgebungen heute funktionieren und 2016 nicht
7. September — Sergio Paniego veröffentlicht im Blog von Hugging Face einen Rückblick, der von einer irritierenden Beobachtung ausgeht: Die im Dezember 2016 veröffentlichte Beschreibung von OpenAI Universe könnte heute unverändert in einem Beitrag eines führenden Labors stehen. Das Repository ist dennoch archiviert.
Die Zeitleiste reicht vom Arcade Learning Environment im Jahr 2012 über OpenAI Gym im Jahr 2016 und dessen minimales Vokabular, reset() und step(), das inzwischen als Gymnasium unter die Farama Foundation übergegangen ist. Darauf folgt die domänenspezifische Welle, von World of Bits über WebArena bis hin zu SWE-bench und Terminal-Bench: Eine Aufgabe beginnt häufig als Benchmark, bevor sie zu einem Trainingsfeld wird.
Der Kern der Analyse besteht aus fünf Komponenten, die 2016 fehlten: kein vortrainiertes Modell, das als brauchbarer Ausgangspunkt dienen konnte, eine außer Reichweite liegende Aufgabe, eine auf Menschen statt auf Maschinen zugeschnittene Schnittstelle, kein Verfahren für spärliche Rewards und die Unmöglichkeit, Tausende kurzlebige Sandboxes zu orchestrieren. GRPO und verifizierbare Rewards liefern heute die vierte Komponente. Der Artikel schließt mit OpenEnv, einer im Oktober 2025 vom PyTorch-Team von Meta und Hugging Face angekündigten Standardschnittstelle, sowie einem Markt für Umgebungen, zu dem Prime Intellect und Mechanize gehören.
Google lässt mehr als 80 Flüge von Cathay Pacific einer Route zur Vermeidung von Kondensstreifen folgen
7. September — Google Research weitet seine Versuche zur Vermeidung von Kondensstreifen auf den asiatisch-pazifischen Raum aus, mit Cathay Pacific als erstem kommerziellen Airline-Partner der Region. Die Gegenmaßnahme ist auf dem Papier einfach: die Flughöhe leicht anpassen, um kalte und feuchte Zonen zu umgehen, in denen Kondensstreifen als wärmespeichernde Schleier bestehen bleiben.
| Kennzahl der ersten Phase | Wert |
|---|---|
| Ausgewählte Flüge im Netzwerk von Cathay Pacific | mehr als 100 |
| Flüge, die tatsächlich einer Ausweichroute folgten | mehr als 80 |
| Geschätzte Verringerung der Erwärmungswirkung der Kondensstreifen | etwa 40 % |
| Anteil des Korridors Hongkong–Singapur an den Einsparungen | mehr als 50 % |
| Anteil der Kondensstreifen an der Klimawirkung der Luftfahrt | etwa ein Drittel |
Das System kombiniert von Googles Modellen erzeugte Vorhersagen, Satellitenbilder und fortschrittliche Wetterdaten. Die Vorhersagen gelangen über das WLAN an Bord und die elektronische Flugmappe der Airline (Electronic Flight Folder) ins Cockpit, ohne die üblichen Abläufe zu unterbrechen, und die Anpassungen bleiben innerhalb der festgelegten Sicherheitsparameter. Eine erweiterte zweite Phase beginnt mit Contrails.org als Partner.
Contrail mitigation remains one of the most immediately available, scalable, and cost-effective ways to reduce aviation’s climate footprint, and it can get started now, with today’s aircrafts and fuel.
🇩🇪 Die Verringerung von Kondensstreifen bleibt eine der am unmittelbarsten verfügbaren, am besten skalierbaren und kostengünstigsten Möglichkeiten, den Klima-Fußabdruck der Luftfahrt zu reduzieren, und sie kann schon jetzt mit den heutigen Flugzeugen und Treibstoffen beginnen. — Kemal Armada und Max Vogler, Google Research
Genspark ergänzt drei seiner Produkte um Muse Spark 1.3
7. September — Genspark integriert Muse Spark 1.3, das Modell von Meta, fünf Tage nach dessen Ankündigung in AI Chat, Code Agent und Claw. Die Plattform übernimmt die beiden von Meta angeführten Zahlen zur Begründung der Wahl: 20 Prozent weniger Tool-Aufrufe und 25 Prozent weniger Token-Verbrauch, zwei Kennzahlen, die sich direkt auf die Kosten eines Agents auswirken, der lange Aufgaben in einer Schleife bearbeitet.
Das Tempo ist das eigentliche Signal. Innerhalb von sechs Tagen hat Genspark vier Modelle verschiedener Anbieter integriert: Claude Fable 5.1 am 2. September, Gemini 3.8 Flash am 3., GPT-6 Astra am 5. und Muse Spark 1.3 am 7. Die Plattform positioniert sich weniger als Modell denn als Orchestrierungsschicht, die die Veröffentlichungen aller Labore innerhalb weniger Tage nach ihrem Erscheinen aufnimmt.
🔗 Ankündigung von Genspark auf X
Kurzmeldungen
- Replit eröffnet sein erstes internationales Büro in London — das Unternehmen macht es gemeinsam mit dem Londoner Bürgermeister Sadiq Khan, der britischen Regierung und London & Partners zum Zentrum seiner europäischen Aktivitäten und kündigt mit TLMA ein Pilotprojekt zur Qualifizierung junger Londoner an, die weder beschäftigt noch in Ausbildung sind. 🔗 Veröffentlichung
- Tolquane, eine Python-Bibliothek für komponierbare Parallelität — derselbe Graph wird ohne Codeänderungen in Threads, Prozessen, asynchron, verteilt oder sequenziell ausgeführt, unter Python 3.14t ohne Global Interpreter Lock mit dem 5,6-Fachen der Referenzgeschwindigkeit gegenüber dem 0,9-Fachen in Threads mit GIL. Blockierungsfreiheit gilt dabei als Designregel; ein Fehler benennt die blockierten Knoten. 🔗 Beitrag
- Eine spezielle Aktion zur Installation eines Agent-Skills — die Aiden-Firmware leitet eine Skill-URL nun an eine einzige Aktion weiter, die diesen vorbereitet, validiert und anschließend atomar veröffentlicht. Die Reproduktion auf einem realen Agenten reduziert eine aus mehreren Tools bestehende Ablaufverfolgung auf einen einzigen Aufruf. 🔗 Beitrag
- Together AI stellt GLM-5.3 Flash und GPT-5.6 Terra bei den Kosten pro Aufgabe gegenüber — gleicher Wert im Intelligence Index von Artificial Analysis, aber laut dem Hostinganbieter 82 Prozent niedrigere Kosten pro Aufgabe; dieser veröffentlicht weder die Berechnungsmethode noch einen ausführlichen Beitrag und stellt das verglichene Modell selbst bereit. 🔗 Veröffentlichung
- Ein Manifest für ein brasilianisches KI-Ökosystem — ein portugiesischer Text, der die Metapher des natürlichen Ökosystems auf die KI-Community des Landes überträgt, ohne Modell, Datensatz oder Messung. Der Vollständigkeit halber erwähnt. 🔗 Beitrag
- Google DeepMind wählt 16 Organisationen für seinen Accelerator AI for the Planet im asiatisch-pazifischen Raum aus — die erste Kohorte startet mit einem intensiven Bootcamp in Singapur und erhält anschließend drei Monate lang Zugang zu den Modellen AnthroKrishi, ForestCast, AlphaEarth Foundations, SpeciesNet und Perch; die Organisationen verteilen sich auf Naturschutz, nachhaltige Landwirtschaft und Kohlenstofflösungen. 🔗 Beitrag
- GitHub rückt die Canvases seiner Copilot-App erneut in den Vordergrund — Neuauflage eines Artikels vom 17. August, der den Canvas als gemeinsame, dauerhafte Arbeitsfläche vorstellt, auf der der Arbeitsstand sichtbar bleibt, mit einer selten veröffentlichten Zahl: Für jedes der beiden genannten Beispiele wurden 2.000 bis 3.000 AI Credits benötigt. 🔗 Veröffentlichung
- GitHub veröffentlicht einen Alias-Generator für GitHub Universe — eine werbliche Community-Aktion im Vorfeld der Ausgabe im Oktober 2026, ohne Bezug zu KI oder einer Produktfunktion. 🔗 Veröffentlichung
- Synthesia erläutert seine drei Forschungsschwerpunkte für die ECCV 2026 — audiogesteuerte generative Avatare, auf Spracherkennung angewandte Sprachforschung und interaktive Avatare unter dem Leitbild eines menschenzentrierten Weltmodells. 🔗 Veröffentlichung
- Mati Staniszewski erwartet den dialogbasierten Turing-Test in sechs bis zwölf Monaten — der Mitgründer und CEO von ElevenLabs äußert sich dazu im Podcast GDIY, dessen Interview vom Audiodienst des Unternehmens auch französisch synchronisiert angeboten wird. 🔗 Veröffentlichung
- QwenCloud veröffentlicht den Bericht zur Qwen Conference Thailand 2026 — fast 400 Kunden und Entwickler kamen am 4. September in Bangkok zusammen; außerdem gab es eine End-to-End-Demonstration, bei der der Agent selbst der Kunde ist und von der Registrierung über die Zahlung bis zur Rechnungsstellung alles ohne menschliches Eingreifen erledigt. 🔗 Veröffentlichung
- Cohere verbreitet einen CNN-Bericht über Toronto als globales KI-Zentrum — Kommunikation ohne Produktankündigung, die auf den laut CBRE weltweit dritten Platz der Stadt bei Technologietalenten, auf mehr als 2 Milliarden Dollar an Zusagen im Rahmen der kanadischen Nationalstrategie und auf einen von Cohere gemeldeten Zustrom von Kundenanfragen nach den Exportkontrollen für Anthropic-Modelle verweist. 🔗 Veröffentlichung
Was das bedeutet
Die von Sol-H3 überschrittene Schwelle ist nicht bloß ein weiterer Rekord in einer Liste. Solange die Produktion eines Clips länger dauert als seine Wiedergabe, bleibt die Videogenerierung eine Stapelverarbeitung: Man startet sie, wartet und sieht sich das Ergebnis an. Wird diese Schwelle unterschritten, eröffnet sich eine andere Nutzungskategorie, bei der das Bild während des Betrachtens erzeugt wird. Für Praktiker ist entscheidend, dass der Gewinn nicht von einem neuen Modell stammt: Das Modell bleibt unverändert, nur der Inferenz-Stack ändert sich. Der Faktor 15 steckte somit in der Ausführungstechnik und nicht in den Gewichten; diese Technik wird unter Apache 2.0 veröffentlicht und ist mit bestehenden LoRAs kompatibel.
Der Tag zeigt zwei gegensätzliche Arten, offene Gewichte zu veröffentlichen. Auf der einen Seite stehen zwei selbst veröffentlichte Beiträge, deren Qualitätsbehauptungen sich auf keine vergleichbare Messung stützen, deren Repository-Labels nicht dem tatsächlich bereitgestellten Format entsprechen und bei denen der Hostinganbieter des siegreichen Modells einen Kostenvergleich pro Aufgabe ohne veröffentlichte Methode verkündet. Auf der anderen Seite steht ein Sprachkorpus, in dem jeder Zeitstempel eine Audit-Kette durchläuft und das Team ausdrücklich zwischen 22 verifizierten und 100 nicht verifizierten Stunden unterscheidet. In einem öffentlichen Repository, in dem jeder veröffentlichen kann, wird die Sorgfalt der Überprüfung zum einzigen verwertbaren Signal — und ihre Erzeugung ist teurer als eine eingängige Überschrift.
Der Rückblick auf RL-Umgebungen und das Integrationstempo von Genspark beschreiben auf zwei unterschiedlichen Ebenen dieselbe Verschiebung. Der erste erklärt, weshalb eine Idee aus dem Jahr 2016 heute funktioniert: Es fehlte nicht an Algorithmen, sondern an der umgebenden Infrastruktur, vom Ausgangsmodell bis zu kurzlebigen Sandboxes. Der zweite zeigt, was aus dieser Infrastruktur wird, sobald sie verfügbar ist und eine Plattform innerhalb von sechs Tagen vier Modelle von vier Anbietern einbindet. In beiden Fällen verlagert sich der Wert vom Modell auf die umgebende Schicht, die sich zunehmend standardisiert — mit OpenEnv auf der einen und Multi-Modell-Orchestratoren auf der anderen Seite.
Bleibt, was nicht zum Wettlauf der Modelle gehört. Der Versuch mit Cathay Pacific betrifft bestehende Flugzeuge und Treibstoffe: Hinzu kommt lediglich eine zum richtigen Zeitpunkt ins Cockpit übermittelte Prognose, die bei den betroffenen Flügen eine geschätzte Reduzierung von etwa 40 Prozent ermöglicht. Der Vaani-Korpus deckt 58 indische Sprachen ab, von denen mehrere zuvor über keinerlei Sprachressourcen mit Hintergrundgeräuschen verfügten, und DeepMinds Accelerator für den asiatisch-pazifischen Raum stellt sechzehn Teams vor Ort spezialisierte Modelle bereit. Diese drei Arbeiten müssen keinen Benchmark schlagen. Ihre Herausforderung liegt anderswo: in den zu erhebenden Daten und der erfolgreichen Bereitstellung. Genau dort entscheidet sich auch der Unterschied zwischen einer Demonstration und einer messbaren Wirkung.
Quellen
- Sol-H3, Ankündigung von Enze Xie auf X
- Sol-H3-Projektseite, NVIDIA Research
- API-Zugriff auf Sol-H3 über Reactor
- Vaani Noise Event Timestamp Dataset, ARTPARK-IISc
- JiRack-Ultra-Serie, CMS Manhattan
- JiRack DeltaNet 27B, CMS Manhattan
- Geschichte der RL-Umgebungen, Hugging Face
- Vermeidung von Kondensstreifen auf Ultralangstreckenflügen, Google Research
- Muse Spark 1.3 in Genspark
- Replit eröffnet sein Londoner Büro
- Tolquane, komponierbare Parallelität in Python
- Direkte Installation von Skills in der Aiden-Firmware
- Together AI vergleicht GLM-5.3 Flash und GPT-5.6 Terra
- Manifest für ein brasilianisches KI-Ökosystem
- Accelerator AI for the Planet im asiatisch-pazifischen Raum, Google DeepMind
- Die Canvases der Copilot-App
- Alias-Generator für GitHub Universe
- Synthesia auf der ECCV 2026
- Mati Staniszewski im Podcast GDIY
- Bericht zur Qwen Conference Thailand 2026
- Cohere verbreitet den CNN-Bericht über Toronto