ai-powered-markdown-translatorArticolo tradotto dal francese all’italiano con gpt-5.6-sol.
NVIDIA Research pubblica Sol-H3, uno stack di inference che riduce il tempo necessario per generare cinque secondi di video al di sotto della durata di riproduzione della clip, con licenza Apache 2.0. Lo stesso giorno, un editore pubblica su Hugging Face due linee di modelli ottimizzate per la CPU, con promesse che nessuna misurazione dimostra, mentre un team indiano rende disponibile un corpus di parlato rumoroso nel quale ogni timestamp passa attraverso una catena di verifica documentata. Google Research estende inoltre all’Asia le proprie sperimentazioni sulle rotte aeree che evitano le scie di condensazione.
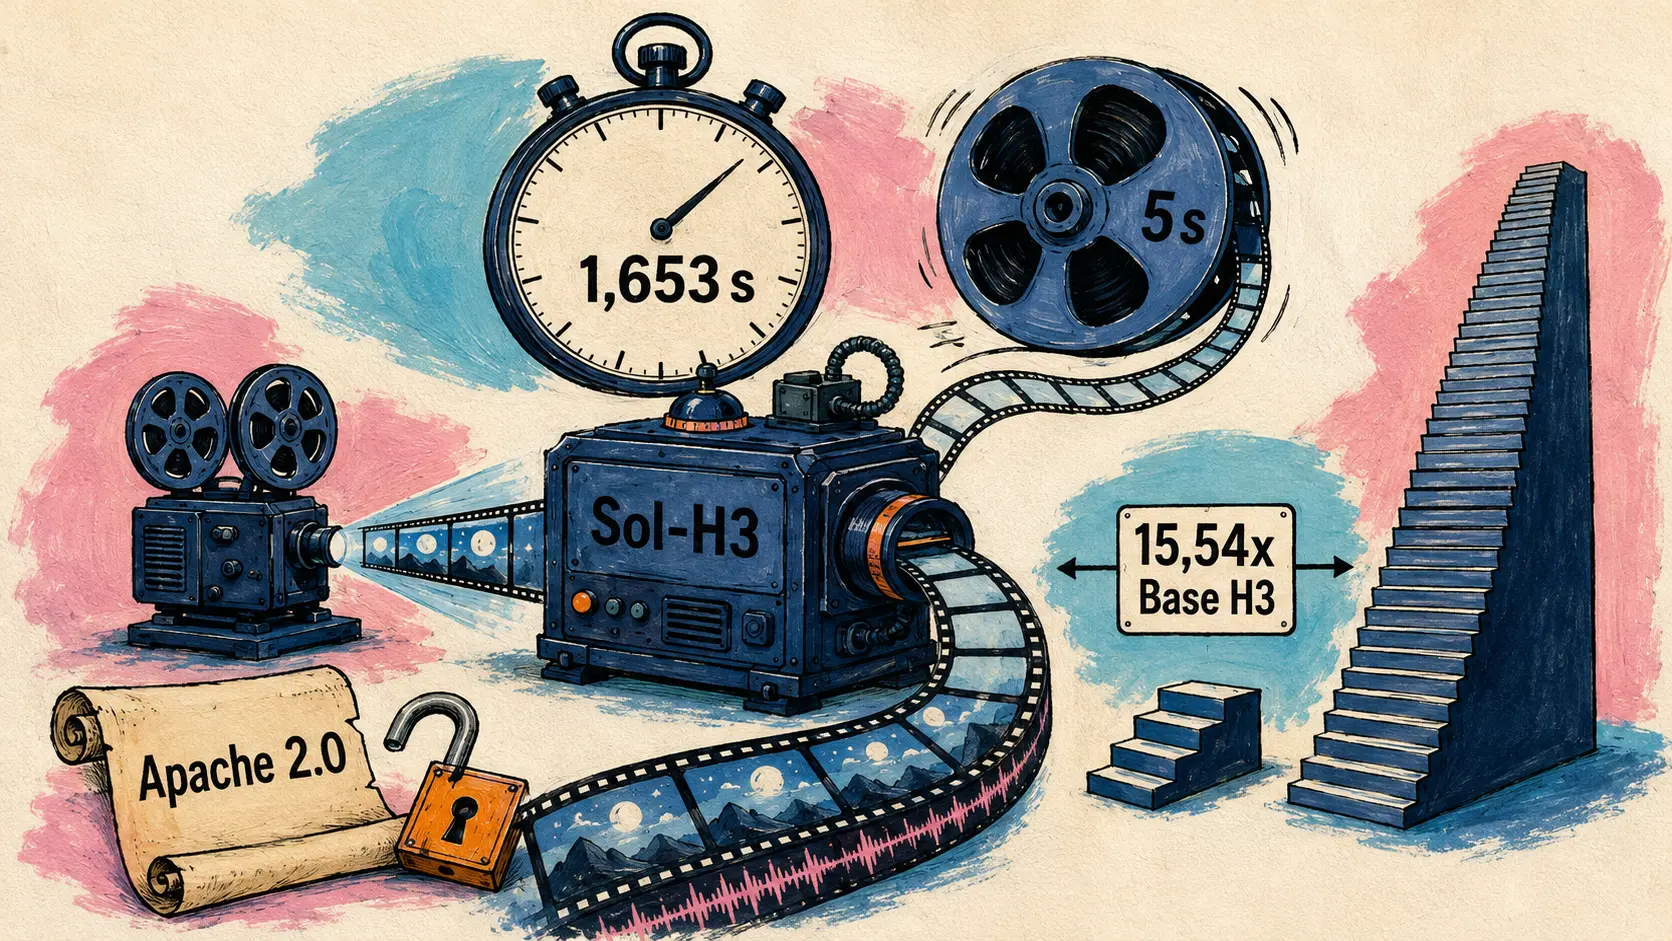
Sol-H3 genera cinque secondi di video in 1,653 secondi, più velocemente della loro riproduzione
7 settembre — Il team Efficient AI di NVIDIA Research, insieme al suo laboratorio di Singapore, pubblica Sol-H3, uno stack di inference completo per il modello video MiniMax-H3. Il risultato si riassume in una frase: cinque secondi di video in 1344×768 a 24 fotogrammi al secondo, con audio stereo generato nello stesso passaggio, prodotti in 1,653 secondi su un sistema con otto acceleratori B300 Blackwell. Il modello crea quindi la clip più velocemente di quanto uno spettatore riesca a guardarla.
Il confronto riguarda profili completi, non una semplice modifica del kernel di attention. Il profilo di riferimento, Base H3 Dense, utilizza 50 passaggi dello scheduler, equivalenti a 49 forward pass della rete DiT; Sol-H3 ne utilizza soltanto quattro.
| Configurazione hardware | Durata generata | Base H3, 50 passaggi | Sol-H3, 4 passaggi | Accelerazione |
|---|---|---|---|---|
| 8× B300 | 5 s | 18,250 s | 1,653 s | 11,04× |
| 8× B300 | 10 s | 50,660 s | 3,732 s | 13,57× |
| 8× B300 | 15 s | 99,513 s | 6,612 s | 15,05× |
| 4× B300 | 5 s | 35,328 s | 2,918 s | 12,11× |
| 4× B300 | 15 s | 194,930 s | 12,542 s | 15,54× |
| 1× B300 | 5 s | 129,898 s | 13,745 s | 9,45× |
L’accelerazione raggiunge un picco di 15,54×, ottenuto su quattro B300 per quindici secondi di video. Il protocollo è insolitamente esplicito: mediane di tre esecuzioni dopo il warm-up, con prompt e seed identici; il cronometro include la codifica del testo, il denoising DiT e la decodifica VAE, ma esclude il caricamento del modello e la codifica MP4 finale.
Lo stack riunisce due componenti sviluppati separatamente: Sol-Engine per il runtime di inference video e Sol-Attn per la sparse attention applicata al volo, senza riaddestramento. A questi si aggiungono kernel fusi, comunicazione inter-GPU in INT8 per le proiezioni QKV e in FP8 per gli output, decodifica VAE parallelizzata e in batch, nonché la cache dei parametri AdaLN. La preparazione della sparse attention scende da 1,206 a 0,285 millisecondi, la decodifica VAE da 7,55 a 0,602 secondi e vengono liberati circa 24 GB di memoria per GPU.
Due decisioni rendono la pubblicazione utilizzabile oltre la dimostrazione: il codice viene distribuito con licenza Apache 2.0 e qualsiasi LoRA few-step già addestrato per MiniMax-H3 può essere collegato allo stesso runtime. Un accesso API aperto tramite Reactor fin dal primo giorno evita di dover immobilizzare otto B300 per provarlo.
For us, the bigger milestone is crossing from “fast generation” into “faster than playback.” That opens the path toward continuous 24 FPS generation and truly interactive video systems.
🇮🇹 Per noi, il vero traguardo è il passaggio dalla «generazione rapida» a una generazione «più veloce della riproduzione». Questo apre la strada alla generazione continua a 24 FPS e a sistemi video realmente interattivi. — @xieenze_jr su X
🔗 Pagina del progetto Sol-H3, NVIDIA Research
🔗 Accesso API fin dal primo giorno tramite Reactor
Un corpus aperto assegna timestamp a 106.892 rumori reali in 58 lingue indiane
7 settembre — Il team ARTPARK dell’Indian Institute of Science pubblica il Vaani Noise Event Timestamp Dataset, uno strato di annotazioni umane applicato al corpus di parlato spontaneo Project Vaani. Ogni rumore di fondo è corredato del proprio tipo e degli istanti di inizio e fine, con precisione al millisecondo.
| Proprietà del corpus | Valore |
|---|---|
| Audio annotato in totale | più di 122 ore |
| Eventi rumorosi con timestamp | 106 892, in 7 categorie |
| Segmenti di parlato e parlanti | 72 756 segmenti, 38 541 voci |
| Copertura linguistica e geografica | 58 lingue, 30 Stati |
| Set verificato e set grezzo | circa 22 h e circa 100 h |
Il punto metodologico è questo: parlato e rumore sono stati registrati insieme, su normali telefoni, senza inserimento di rumore sintetico né missaggio a posteriori. I suoni umani non vocali, come tosse e risate, compaiono in circa il 38 per cento dei segmenti ma durano meno di mezzo secondo; animali e traffico sono più rari e molto più prolungati e, insieme, rappresentano la maggior parte del tempo occupato dal rumore. Ogni timestamp passa attraverso un’annotazione, una verifica di coerenza, una nuova verifica interna e infine un audit indipendente su un decimo del corpus selezionato casualmente: se anche uno solo non supera il controllo, l’intero lotto viene rifatto.
🔗 Articolo di ARTPARK-IISc su Hugging Face
CMS Manhattan pubblica due linee di modelli per CPU, senza benchmark a sostegno
6 settembre — L’editore CMS Manhattan rende disponibili su Hugging Face due pubblicazioni con pesi aperti destinate all’inference su CPU anziché su scheda grafica. Entrambi gli articoli sono autopubblicati dall’editore dei modelli e tutto ciò che segue viene presentato come tale.
La prima, la serie JiRack Ultra, riunisce quattro modelli con pesi ternari a 1,58 bit in stile BitNet, derivati secondo l’editore dall’architettura DeepSeek-R1-Distill-Qwen-32B. L’elemento più interessante non è la quantizzazione, bensì il tokenizer, ampliato con token dedicati al routing, alle chiamate di strumenti, ai tag di controllo robotico e ai media, con l’obiettivo di supportare sistemi agentici e robotica embedded. La seconda, JiRackDeltaNet_27b, riprende un Qwen 3.8 da 27 miliardi di parametri migrato verso un’architettura DeltaNet, che alterna attention completa e layer Gated DeltaNet affini ai modelli state-space, per una context window dichiarata di 262 144 token.
| Linea di modelli | Base dichiarata dall’editore | Formato dei pesi pubblicati | Licenza e packaging |
|---|---|---|---|
| JiRack Ultra, quattro formati | DeepSeek-R1-Distill-Qwen-32B | pesi ternari a 1,58 bit, GGUF da Q2_K a Q4_K_M | pesi sull’Hub, immagini Docker e interfaccia in abbonamento |
| JiRack DeltaNet 27B | Qwen 3.8 27B migrato su DeltaNet | GGUF llama.cpp ordinari prodotti a partire da FP16 | pesi con licenza MIT, immagine Docker e interfaccia a 12 dollari per utente all’anno |
Due riserve sono importanti per il lettore. Nonostante le etichette ternary e bitnet del repository DeltaNet, la linea GGUF pubblicata corrisponde a normali quantizzazioni llama.cpp e non a un checkpoint ternario distinto, come riconosce lo stesso articolo. Inoltre, la promessa di una qualità vicina a Opus 4.6 Max che funge da titolo del secondo articolo non è sostenuta da alcun risultato di benchmark: manca proprio questo, una misurazione comparativa pubblicata, per poter valutare questi modelli al di là della loro documentazione.
🔗 Serie JiRack Ultra su Hugging Face
🔗 JiRack DeltaNet 27B su Hugging Face
Perché oggi gli ambienti RL funzionano, mentre nel 2016 non funzionavano
7 settembre — Sergio Paniego pubblica sul blog di Hugging Face una retrospettiva che parte da un’osservazione sorprendente: la descrizione di OpenAI Universe, pubblicata nel dicembre 2016, potrebbe comparire senza modifiche in un articolo di un laboratorio all’avanguardia di oggi. Eppure il repository è archiviato.
La cronologia parte dall’Arcade Learning Environment nel 2012 e arriva a OpenAI Gym nel 2016 e al suo vocabolario minimo, reset() e step(), poi confluito in Gymnasium sotto la Farama Foundation. Segue l’ondata per settore, da World of Bits a WebArena, quindi SWE-bench e Terminal-Bench: spesso un’attività nasce come benchmark prima di diventare un ambiente di addestramento.
Il cuore dell’analisi risiede in cinque elementi che mancavano nel 2016: nessun modello preaddestrato sufficientemente valido da fungere da punto di partenza, un compito fuori portata, un’interfaccia modellata sull’essere umano anziché sulla macchina, nessuna ricetta per le ricompense sparse e l’impossibilità di orchestrare migliaia di sandbox usa e getta. Oggi GRPO e le ricompense verificabili forniscono il quarto elemento. L’articolo si conclude con OpenEnv, un’interfaccia standard annunciata nell’ottobre 2025 dal team PyTorch di Meta e da Hugging Face, e con un mercato degli ambienti che include Prime Intellect e Mechanize.
🔗 Retrospettiva sugli ambienti RL
Google fa seguire a più di 80 voli Cathay Pacific una rotta che evita le scie
7 settembre — Google Research estende all’Asia-Pacifico le proprie sperimentazioni per evitare le scie di condensazione, con Cathay Pacific come primo partner aereo commerciale della regione. La contromisura è semplice sulla carta: modificare leggermente l’altitudine per aggirare le zone fredde e umide in cui le scie persistono formando distese che trattengono il calore.
| Misura della prima fase | Valore |
|---|---|
| Voli interessati sulla rete Cathay Pacific | più di 100 |
| Voli che hanno effettivamente seguito una rotta alternativa | più di 80 |
| Riduzione stimata dell’impatto riscaldante delle scie | circa 40 % |
| Quota del corridoio Hong Kong-Singapore nei benefici | più del 50 % |
| Quota delle scie nell’impatto climatico dell’aviazione | circa un terzo |
Il sistema combina previsioni prodotte dai modelli di Google, immagini satellitari e dati meteorologici avanzati. Le previsioni raggiungono la cabina di pilotaggio tramite il Wi-Fi di bordo e l’Electronic Flight Folder della compagnia, senza interrompere le procedure abituali, mentre le modifiche restano entro i parametri di sicurezza stabiliti. Si apre una seconda fase ampliata, con Contrails.org come partner.
Contrail mitigation remains one of the most immediately available, scalable, and cost-effective ways to reduce aviation’s climate footprint, and it can get started now, with today’s aircrafts and fuel.
🇮🇹 La mitigazione delle scie di condensazione rimane uno dei mezzi più immediatamente disponibili, più generalizzabili e più economici per ridurre l’impronta climatica dell’aviazione e può iniziare fin da ora, con gli aerei e i carburanti di oggi. — Kemal Armada e Max Vogler, Google Research
Genspark aggiunge Muse Spark 1.3 a tre dei suoi prodotti
7 settembre — Genspark integra Muse Spark 1.3, il modello di Meta, in AI Chat, Code Agent e Claw, cinque giorni dopo il suo annuncio. La piattaforma riprende i due dati presentati da Meta per giustificare la scelta: il 20 per cento in meno di chiamate di strumenti e il 25 per cento in meno di consumo di token, due metriche che incidono direttamente sul costo di un agente che opera in ciclo continuo su attività lunghe.
Il ritmo è il vero segnale. In sei giorni, Genspark ha integrato quattro modelli di fornitori diversi: Claude Fable 5.1 il 2 settembre, Gemini 3.8 Flash il 3, GPT-6 Astra il 5 e Muse Spark 1.3 il 7. La piattaforma si posiziona meno come modello e più come uno strato di orchestrazione che assorbe i prodotti di tutti i laboratori nei giorni successivi alla loro pubblicazione.
Notizie in breve
- Replit apre il suo primo ufficio internazionale a Londra — l’azienda ne fa il centro delle sue operazioni europee, insieme al sindaco di Londra Sadiq Khan, al governo britannico e a London & Partners, e annuncia un progetto pilota di sviluppo delle competenze con TLMA per i giovani londinesi che non lavorano né seguono percorsi di istruzione o formazione. 🔗 Pubblicazione
- Tolquane, una libreria Python per il parallelismo componibile — lo stesso grafo viene eseguito senza modificare il codice tramite thread, processi, async, elaborazione distribuita o sequenziale, raggiungendo una velocità pari a 5,6 volte quella di riferimento su Python 3.14t senza global lock, contro 0,9 volte con i thread e il GIL. L’assenza di blocchi viene posta come regola di progettazione, con un errore che indica i nodi bloccati. 🔗 Articolo
- Un’azione dedicata per installare una competenza di un agente — il firmware Aiden ora instrada l’URL di una competenza verso un’unica azione che la prepara, la convalida e infine la pubblica in modo atomico. La riproduzione su un agente reale riduce una traccia multi-tool a una sola chiamata. 🔗 Articolo
- Together AI contrappone GLM-5.3 Flash a GPT-5.6 Terra in termini di costo per attività — stesso punteggio nell’indice di intelligenza di Artificial Analysis, ma un costo per attività inferiore dell’82 per cento secondo il provider, che non pubblica né il metodo di calcolo né un articolo dettagliato ed eroga direttamente il modello oggetto del confronto. 🔗 Pubblicazione
- Un manifesto per un ecosistema brasiliano dell’IA — testo in portoghese che sviluppa la metafora dell’ecosistema naturale per la comunità IA del Paese, senza modello, dataset o misurazione. Segnalato per completezza. 🔗 Articolo
- Google DeepMind seleziona 16 organizzazioni per il suo acceleratore AI for the Planet nell’Asia-Pacifico — prima coorte, avviata con un corso intensivo (bootcamp) a Singapore, seguito da tre mesi di accesso ai modelli AnthroKrishi, ForestCast, AlphaEarth Foundations, SpeciesNet e Perch, distribuiti tra tutela della natura, agricoltura sostenibile e soluzioni per il carbonio. 🔗 Articolo
- GitHub torna a promuovere i canvas della sua applicazione Copilot — rilancio di un articolo del 17 agosto che presenta il canvas come uno spazio condiviso e persistente in cui lo stato del lavoro rimane visibile, con un dato pubblicato raramente: da 2.000 a 3.000 AI Credits per realizzare ciascuno dei due esempi citati. 🔗 Pubblicazione
- GitHub lancia un generatore di alias per GitHub Universe — iniziativa promozionale per la comunità in vista dell’edizione di ottobre 2026, senza legami con l’IA né con una funzionalità del prodotto. 🔗 Pubblicazione
- Synthesia illustra i suoi tre filoni di ricerca per ECCV 2026 — avatar generativi guidati dall’audio, ricerca sulla voce applicata al riconoscimento vocale e avatar interattivi, sotto l’egida del modello del mondo incentrato sull’essere umano. 🔗 Pubblicazione
- Mati Staniszewski colloca il superamento del test di Turing conversazionale tra sei e dodici mesi — il cofondatore e amministratore delegato di ElevenLabs lo dichiara nel podcast GDIY, la cui intervista viene proposta doppiata in francese dal servizio audio dell’azienda. 🔗 Pubblicazione
- QwenCloud pubblica il resoconto della Qwen Conference Thailand 2026 — quasi 400 clienti e sviluppatori a Bangkok il 4 settembre e una dimostrazione end-to-end in cui l’agente è esso stesso il cliente, dalla registrazione al pagamento e alla fatturazione senza intervento umano. 🔗 Pubblicazione
- Cohere rilancia un servizio della CNN su Toronto come polo mondiale dell’IA — comunicazione priva di annunci di prodotto, che rimanda al terzo posto mondiale della città per i talenti tecnologici secondo CBRE, agli oltre 2 miliardi di dollari stanziati dalla strategia nazionale canadese e a un afflusso di richieste dei clienti dichiarato da Cohere dopo i controlli sulle esportazioni riguardanti i modelli di Anthropic. 🔗 Pubblicazione
Cosa significa
La soglia superata da Sol-H3 non è semplicemente un altro record da aggiungere a un elenco. Finché produrre un video richiede più tempo che guardarlo, la generazione video rimane un lavoro in batch: si avvia, si attende, si guarda. Scendere sotto questa soglia apre un’altra categoria di utilizzo, quella in cui l’immagine viene creata mentre la si guarda. Il dettaglio importante per chi lavora nel settore è che il guadagno non deriva da un nuovo modello: il modello è lo stesso, cambia solo lo stack di inferenza. Il fattore 15 risiedeva quindi nell’ingegneria di esecuzione, non nei pesi, ed è pubblicato con licenza Apache 2.0 e compatibilità con i LoRA esistenti.
La giornata mette a confronto due modi di pubblicare pesi aperti. Da una parte, due articoli autopubblicati le cui affermazioni sulla qualità non sono supportate da alcuna misurazione comparabile, con etichette dei repository che non corrispondono al formato effettivamente fornito e un confronto del costo per attività annunciato dal provider del modello vincitore senza un metodo pubblicato. Dall’altra, un corpus vocale in cui ogni timestamp attraversa una catena di audit e il team separa esplicitamente 22 ore verificate da 100 ore non verificate. In un repository pubblico in cui chiunque può pubblicare, il rigore della verifica diventa l’unico segnale utilizzabile e produrlo costa più di un titolo accattivante.
La retrospettiva sugli ambienti RL e il ritmo di integrazione di Genspark raccontano lo stesso cambiamento, su due scale diverse. La prima spiega perché un’idea del 2016 funziona oggi: non mancavano gli algoritmi, bensì l’infrastruttura circostante, dal modello di partenza alle sandbox usa e getta. La seconda mostra cosa diventa questa infrastruttura una volta disponibile, quando una piattaforma collega quattro modelli di quattro provider in sei giorni. In entrambi i casi, il valore migra dal modello al livello che lo circonda e questo livello si standardizza, con OpenEnv da una parte e gli orchestratori multi-modello dall’altra.
Rimane ciò che non rientra nella corsa ai modelli. La sperimentazione con Cathay Pacific riguarda aerei e carburanti esistenti: l’unica aggiunta è una previsione fornita al momento giusto nella cabina di pilotaggio, per una riduzione stimata di circa il 40 per cento sui voli interessati. Il corpus Vaani copre 58 lingue indiane, diverse delle quali non disponevano di alcuna risorsa vocale con rumore, mentre l’acceleratore per l’Asia-Pacifico di DeepMind distribuisce modelli specializzati a sedici team sul campo. Questi tre progetti non hanno benchmark da superare. Il loro vincolo è altrove, nei dati da raccogliere e nel deployment da portare a termine, ed è anche qui che si determina la differenza tra una dimostrazione e un effetto misurabile.
Fonti
- Sol-H3, annuncio di Enze Xie su X
- Pagina del progetto Sol-H3, NVIDIA Research
- Accesso API a Sol-H3 tramite Reactor
- Vaani Noise Event Timestamp Dataset, ARTPARK-IISc
- Serie JiRack Ultra, CMS Manhattan
- JiRack DeltaNet 27B, CMS Manhattan
- Storia degli ambienti RL, Hugging Face
- Evitamento delle scie di condensazione sui voli a lunghissimo raggio, Google Research
- Muse Spark 1.3 in Genspark
- Replit apre il suo ufficio di Londra
- Tolquane, parallelismo componibile in Python
- Installazione diretta delle competenze nel firmware Aiden
- Together AI confronta GLM-5.3 Flash e GPT-5.6 Terra
- Manifesto per un ecosistema brasiliano dell’IA
- Acceleratore AI for the Planet nell’Asia-Pacifico, Google DeepMind
- I canvas dell’applicazione Copilot
- Generatore di alias per GitHub Universe
- Synthesia a ECCV 2026
- Mati Staniszewski nel podcast GDIY
- Resoconto della Qwen Conference Thailand 2026
- Cohere rilancia il servizio della CNN su Toronto