ai-powered-markdown-translatorgpt-5.6-sol로 프랑스어에서 한국어로 번역된 기사.
NVIDIA Research가 5초 분량의 동영상을 실제 재생 시간보다 빠르게 생성하는 추론 스택 Sol-H3를 Apache 2.0 라이선스로 공개했다. 같은 날 한 개발사는 측정 근거 없는 성능을 내세우며 CPU에 최적화된 모델 제품군 2개를 Hugging Face에 공개했고, 인도의 한 연구팀은 모든 타임스탬프가 문서화된 검증 절차를 거친 잡음 음성 코퍼스를 개방했다. 한편 Google Research는 비행운을 피하는 항공 경로 실험을 아시아로 확대했다.
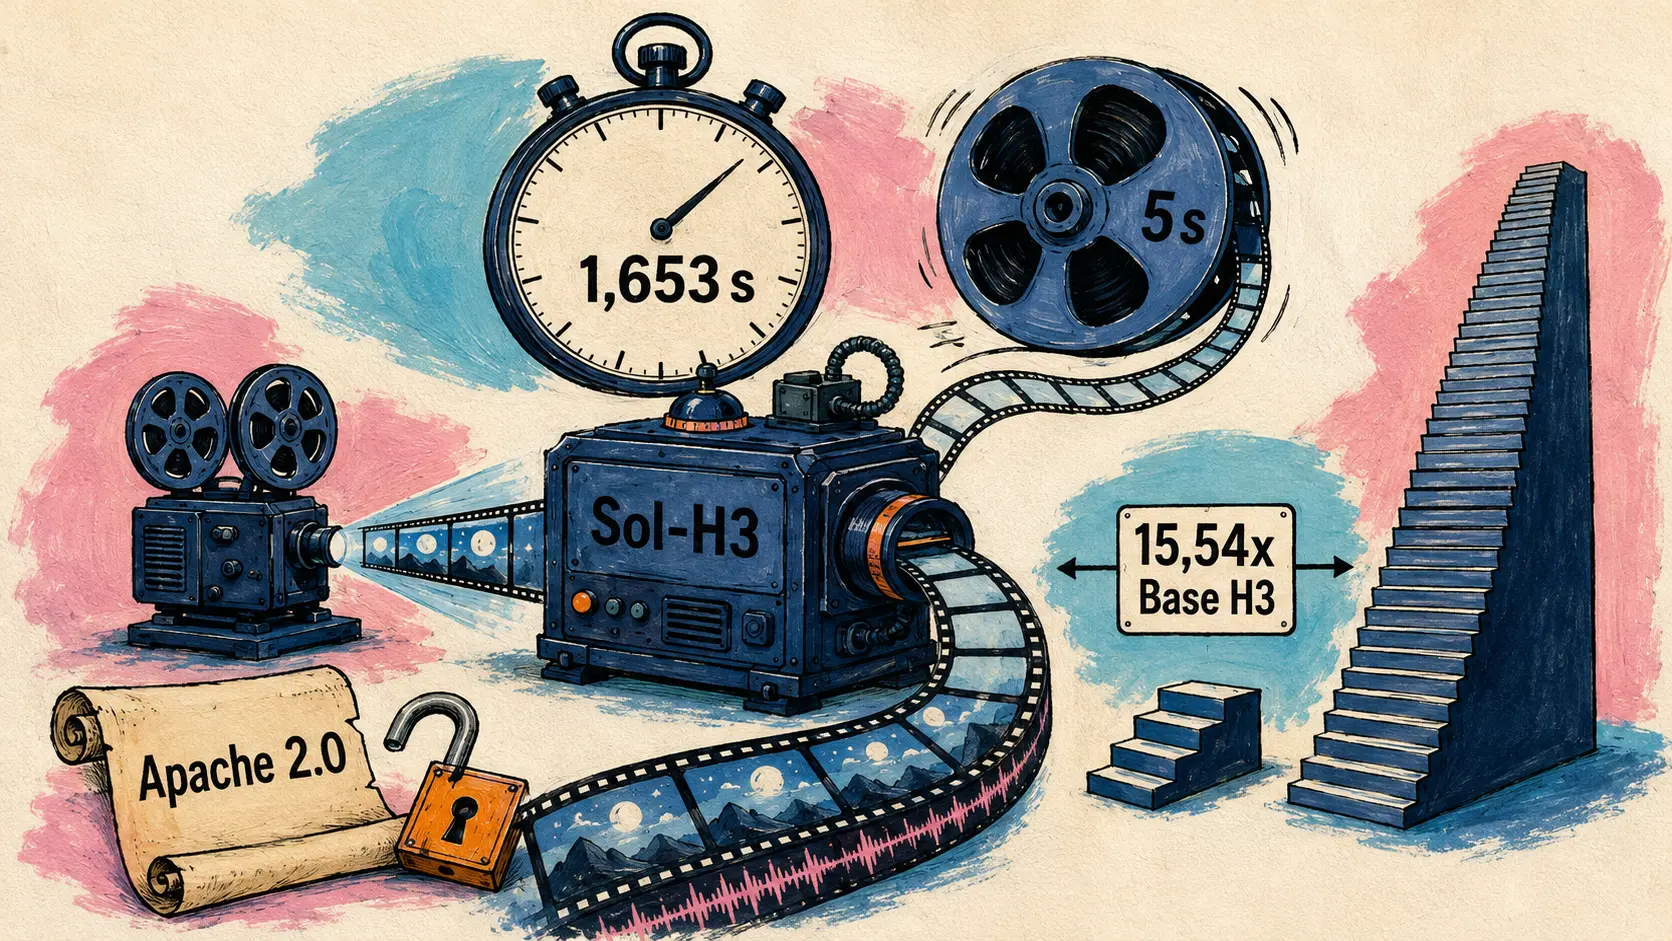
Sol-H3, 5초 분량의 동영상을 재생 시간보다 빠른 1.653초 만에 생성
9월 7일 — NVIDIA Research의 Efficient AI 팀이 싱가포르 연구소와 함께 MiniMax-H3 동영상 모델용 완전한 추론 스택인 Sol-H3를 공개했다. 결과는 한 문장으로 요약된다. B300 Blackwell 가속기 8대로 구성된 시스템에서 1344×768 해상도, 초당 24프레임의 5초짜리 동영상과 동일 패스에서 생성된 스테레오 오디오를 1.653초 만에 만들어 냈다. 즉, 시청자가 동영상을 보는 시간보다 모델이 동영상을 더 빨리 생성한다.
비교 대상은 단순히 attention kernel만 변경한 것이 아니라 완전한 프로필이다. 기준 프로필인 Base H3 Dense는 scheduler 단계 50회, 즉 DiT 네트워크의 forward pass 49회를 사용하지만, Sol-H3는 4회만 사용한다.
| 하드웨어 구성 | 생성 분량 | Base H3, 50단계 | Sol-H3, 4단계 | 가속 배율 |
|---|---|---|---|---|
| 8× B300 | 5 s | 18,250 s | 1,653 s | 11,04× |
| 8× B300 | 10 s | 50,660 s | 3,732 s | 13,57× |
| 8× B300 | 15 s | 99,513 s | 6,612 s | 15,05× |
| 4× B300 | 5 s | 35,328 s | 2,918 s | 12,11× |
| 4× B300 | 15 s | 194,930 s | 12,542 s | 15,54× |
| 1× B300 | 5 s | 129,898 s | 13,745 s | 9,45× |
가속 배율은 B300 4대로 15초 분량의 동영상을 생성할 때 최고치인 15.54배에 이른다. 측정 절차도 이례적으로 명확하다. 동일한 prompt와 seed를 사용하고 예열 후 3회 실행한 값의 중앙값을 취했다. 측정 시간에는 텍스트 인코딩, DiT 노이즈 제거, VAE 디코딩이 포함되지만 모델 로딩과 최종 MP4 인코딩은 제외된다.
이 스택은 별도로 개발된 두 구성 요소를 결합한다. Sol-Engine은 동영상 추론 runtime을 담당하고, Sol-Attn은 재훈련 없이 즉석에서 sparse attention을 적용한다. 여기에 fused kernel, QKV projection에는 INT8을 사용하고 출력에는 FP8을 사용하는 GPU 간 통신, 병렬화된 batch 방식의 VAE 디코딩, AdaLN 매개변수 caching이 더해진다. sparse attention 준비 시간은 1.206밀리초에서 0.285밀리초로, VAE 디코딩 시간은 7.55초에서 0.602초로 줄었으며, GPU당 약 24GB의 메모리가 확보된다.
두 가지 결정 덕분에 이번 공개물은 단순한 시연 이상의 실용성을 갖는다. 코드는 Apache 2.0 라이선스로 공개되며, MiniMax-H3용으로 이미 훈련된 모든 few-step LoRA를 동일한 runtime에서 사용할 수 있다. 또한 출시 첫날부터 Reactor를 통한 공개 API 접근을 제공해 시험을 위해 B300 8대를 묶어 둘 필요가 없다.
For us, the bigger milestone is crossing from “fast generation” into “faster than playback.” That opens the path toward continuous 24 FPS generation and truly interactive video systems.
🇰🇷 우리에게 진정한 이정표는 ‘빠른 생성’에서 ‘재생보다 빠른 생성’으로 넘어가는 것입니다. 이는 24 FPS 연속 생성과 실제로 상호작용할 수 있는 동영상 시스템으로 나아가는 길을 열어 줍니다. — @xieenze_jr의 X 게시물
🔗 NVIDIA Research의 Sol-H3 프로젝트 페이지
공개 코퍼스, 인도 58개 언어의 실제 소음 106,892건에 타임스탬프 표시
9월 7일 — Indian Institute of Science의 ARTPARK 팀이 자연 발화 코퍼스 Project Vaani에 사람이 직접 annotation을 추가한 Vaani Noise Event Timestamp Dataset을 공개했다. 모든 배경 소음에는 유형과 시작·종료 시점이 밀리초 단위로 표시되어 있다.
| 코퍼스 속성 | 값 |
|---|---|
| 전체 annotation 오디오 | 122시간 이상 |
| 타임스탬프가 표시된 소음 event | 7개 범주, 106 892건 |
| 음성 segment와 화자 | segment 72 756개, 음성 38 541개 |
| 언어 및 지역 범위 | 58개 언어, 30개 주 |
| 검증된 dataset과 원시 dataset | 약 22 h 및 약 100 h |
핵심은 방법론에 있다. 음성과 소음을 일반 휴대전화로 함께 녹음했으며, 합성 소음을 삽입하거나 사후에 mixing하지 않았다. 기침과 웃음 같은 비언어적 인간 소리는 segment의 약 38퍼센트에 나타나지만 지속 시간은 0.5초 미만이다. 동물과 교통 소음은 더 드물지만 훨씬 오래 지속되며, 둘을 합하면 전체 소음 시간에서 가장 큰 비중을 차지한다. 각 타임스탬프는 annotation, 일관성 검증, 내부 재검증을 거친 뒤 무작위로 추출한 코퍼스의 10분의 1에 대한 독립 감사를 통과한다. 하나라도 실패하면 해당 batch 전체를 다시 작업한다.
🔗 Hugging Face의 ARTPARK-IISc 게시물
CMS Manhattan, 근거가 되는 benchmark 없이 CPU용 모델 제품군 2개 공개
9월 6일 — 개발사 CMS Manhattan이 GPU가 아닌 CPU 추론을 겨냥한 open-weight 모델 게시물 2건을 Hugging Face에 올렸다. 두 게시물 모두 모델 개발사가 직접 게시한 것이며, 이하의 모든 내용 역시 개발사의 주장으로 소개한다.
첫 번째인 JiRack Ultra series는 개발사에 따르면 DeepSeek-R1-Distill-Qwen-32B architecture에서 파생된 BitNet 방식의 1.58 bit ternary weight 모델 4개로 구성된다. 가장 흥미로운 요소는 quantization이 아니라 tokenizer다. routing, tool call, 로봇 제어 태그, media를 위한 전용 token을 추가해 agentic system과 embedded robotics를 겨냥했다. 두 번째인 JiRackDeltaNet_27b는 매개변수 270억 개의 Qwen 3.8을 DeltaNet architecture로 이전한 모델이다. full attention과 state-space model 계열의 Gated DeltaNet layer를 번갈아 사용하며, context 길이는 262 144 tokens라고 주장한다.
| 모델 제품군 | 개발사가 밝힌 기반 모델 | 공개된 weight 형식 | 라이선스와 packaging |
|---|---|---|---|
| JiRack Ultra, 4개 크기 | DeepSeek-R1-Distill-Qwen-32B | 1.58 bit ternary weight, GGUF Q2_K~Q4_K_M | Hub의 weight, Docker image 및 구독형 interface |
| JiRack DeltaNet 27B | DeltaNet으로 이전한 Qwen 3.8 27B | FP16에서 생성한 일반 llama.cpp GGUF | MIT 라이선스 weight, Docker image 및 사용자당 연간 12달러의 interface |
독자가 유의해야 할 점은 두 가지다. DeltaNet repository에는 ternary 및 bitnet label이 붙어 있지만, 공개된 GGUF 제품군은 별도의 ternary checkpoint가 아니라 일반적인 llama.cpp quantization에 해당하며, 게시물 자체도 이를 인정한다. 또한 두 번째 게시물의 제목에 쓰인 Opus 4.6 Max에 가까운 품질이라는 주장은 어떠한 benchmark 결과로도 뒷받침되지 않는다. 문서만이 아니라 실제 모델을 판단하려면 바로 그 부분, 즉 공개된 비교 측정 결과가 필요하다.
🔗 Hugging Face의 JiRack Ultra series
🔗 Hugging Face의 JiRack DeltaNet 27B
RL 환경이 2016년과 달리 오늘날 작동하는 이유
9월 7일 — Sergio Paniego가 Hugging Face blog에 한 가지 놀라운 관찰에서 출발하는 회고문을 게시했다. 2016년 12월에 공개된 OpenAI Universe의 설명은 오늘날 최첨단 연구소의 게시물에 그대로 실려도 이상하지 않다. 하지만 해당 repository는 현재 보관 처리된 상태다.
연대기는 2012년 Arcade Learning Environment에서 시작해 2016년 OpenAI Gym과 그 최소한의 vocabulary인 reset() 및 step()으로 이어진다. 이후 이 프로젝트는 Farama Foundation 산하의 Gymnasium으로 넘어갔다. 그다음에는 World of Bits에서 WebArena, SWE-bench, Terminal-Bench에 이르는 분야별 흐름이 이어진다. 하나의 task가 benchmark로 시작된 뒤 훈련 환경으로 발전하는 경우가 많다.
분석의 핵심은 2016년에 부족했던 다섯 요소다. 출발점으로 삼을 만한 pretrained model이 없었고, task는 해결할 수 있는 범위를 벗어났으며, interface는 기계가 아니라 인간에 맞춰져 있었다. sparse reward를 처리할 방법도 없었고, 일회용 sandbox 수천 개를 orchestration하는 것도 불가능했다. 오늘날에는 GRPO와 검증 가능한 reward가 네 번째 문제의 해법을 제공한다. 글은 Meta의 PyTorch 팀과 Hugging Face가 2025년 10월 발표한 표준 interface OpenEnv, 그리고 Prime Intellect와 Mechanize 등이 참여하는 환경 시장을 소개하며 끝난다.
Google, Cathay Pacific 항공편 80편 이상에 비행운 회피 경로 적용
9월 7일 — Google Research가 Cathay Pacific을 아시아·태평양 지역 최초의 상업 항공사 파트너로 삼아 비행운 회피 실험을 이 지역으로 확대했다. 원리는 간단하다. 고도를 조금 조정해 비행운이 열을 가두는 층을 이루며 오래 지속되는 차갑고 습한 구역을 우회하는 것이다.
| 첫 단계의 측정 항목 | 값 |
|---|---|
| Cathay Pacific 노선망에서 대상으로 삼은 항공편 | 100편 이상 |
| 실제로 회피 경로를 따른 항공편 | 80편 이상 |
| 비행운의 온난화 영향 추정 감소율 | 약 40 % |
| 전체 효과에서 Hong Kong-Singapore 항로가 차지하는 비중 | 50 % 이상 |
| 항공 산업의 기후 영향에서 비행운이 차지하는 비중 | 약 3분의 1 |
이 시스템은 Google 모델이 생성한 예측, 위성 영상, 고급 기상 데이터를 결합한다. 예측 정보는 일반적인 절차를 중단하지 않고 기내 Wi-Fi와 항공사의 Electronic Flight Folder를 통해 cockpit으로 전달되며, 모든 조정은 정해진 안전 기준 내에서 이뤄진다. Contrails.org가 파트너로 참여하는 확대된 두 번째 단계도 시작된다.
Contrail mitigation remains one of the most immediately available, scalable, and cost-effective ways to reduce aviation’s climate footprint, and it can get started now, with today’s aircrafts and fuel.
🇰🇷 비행운 완화는 항공 산업의 기후 발자국을 줄이기 위해 가장 즉시 활용할 수 있고, 가장 폭넓게 적용 가능하며, 가장 경제적인 수단 중 하나입니다. 오늘날의 항공기와 연료로 지금 당장 시작할 수도 있습니다. — Google Research의 Kemal Armada와 Max Vogler
Genspark, 자사 제품 3개에 Muse Spark 1.3 추가
9월 7일 — Genspark가 Meta의 모델 Muse Spark 1.3 발표 5일 만에 이를 AI Chat, Code Agent, Claw에 연동했다. 플랫폼은 선택의 근거로 Meta가 제시한 두 수치, 즉 tool call 20퍼센트 감소와 token 지출 25퍼센트 감소를 그대로 인용했다. 두 지표 모두 장시간 task를 반복 수행하는 agent의 비용에 직접적인 영향을 준다.
진정한 신호는 그 속도다. Genspark는 6일 동안 서로 다른 공급자의 모델 4개를 통합했다. 9월 2일 Claude Fable 5.1, 3일 Gemini 3.8 Flash, 5일 GPT-6 Astra, 7일 Muse Spark 1.3을 추가했다. 이 플랫폼은 자체 모델이라기보다 각 연구소의 공개 결과를 며칠 안에 모두 흡수하는 orchestration layer로 자리매김하고 있다.
단신
- Replit, 런던에 첫 해외 사무소 개설 — 런던 시장 Sadiq Khan, 영국 정부, London & Partners와 함께 이곳을 유럽 사업의 중심지로 삼고, 취업도 교육도 받지 않는 런던 청년을 위해 TLMA와 역량 강화 시범 프로그램을 진행한다고 발표했다. 🔗 게시물
- Tolquane, 조합 가능한 병렬 처리를 위한 Python 라이브러리 — 동일한 그래프를 코드 변경 없이 스레드, 프로세스, async, 분산 또는 순차 방식으로 실행할 수 있으며, 전역 잠금이 없는 Python 3.14t에서는 기준 속도의 5.6배를 기록한 반면 GIL을 사용하는 스레드에서는 0.9배에 그쳤다. 블로킹 금지를 설계 원칙으로 삼고, 오류 메시지에는 블로킹된 노드의 이름이 표시된다. 🔗 글
- 에이전트 스킬 설치를 위한 전용 액션 — 이제 Aiden 펌웨어는 스킬 URL을 준비, 검증한 뒤 원자적으로 게시하는 단일 액션으로 연결한다. 실제 에이전트에서 재현한 결과, 여러 도구를 거치던 추적 과정이 단 한 번의 호출로 줄었다. 🔗 글
- Together AI, 작업당 비용을 기준으로 GLM-5.3 Flash와 GPT-5.6 Terra 비교 — Artificial Analysis의 지능 지수에서는 동일한 점수를 기록했지만 작업당 비용은 82퍼센트 낮다고 호스팅 업체가 주장했다. 그러나 계산 방법이나 상세한 글을 공개하지 않았으며, 비교 대상 모델도 이 업체가 직접 제공한다. 🔗 게시물
- 브라질 AI 생태계를 위한 선언문 — 브라질 AI 커뮤니티를 자연 생태계에 빗댄 포르투갈어 글로, 모델도 데이터셋도 측정 결과도 없다. 완전성을 위해 수록했다. 🔗 글
- Google DeepMind, 아시아 태평양 지역 AI for the Planet 액셀러레이터에 참여할 16개 기관 선정 — 첫 기수는 싱가포르 집중 훈련 과정인 부트캠프로 시작하며, 이후 3개월 동안 자연 보호, 지속 가능한 농업, 탄소 솔루션 분야에서 AnthroKrishi, ForestCast, AlphaEarth Foundations, SpeciesNet, Perch 모델을 이용한다. 🔗 글
- GitHub, Copilot 애플리케이션의 canvases를 다시 조명 — 작업 상태를 계속 확인할 수 있는 공유형 지속 작업 공간으로 canvas를 소개한 8월 17일자 글을 다시 알렸다. 좀처럼 공개되지 않는 수치도 담겼는데, 제시된 두 사례를 각각 구축하는 데 2,000~3,000 AI Credits가 사용됐다. 🔗 게시물
- GitHub, GitHub Universe용 별칭 생성기 공개 — 2026년 10월 행사를 앞두고 마련한 홍보용 커뮤니티 이벤트로, AI나 제품 기능과는 관련이 없다. 🔗 게시물
- Synthesia, ECCV 2026을 위한 세 가지 연구 축 공개 — 인간 중심 월드 모델이라는 기치 아래 오디오 구동 생성형 아바타, 음성 인식에 적용되는 음성 연구, 대화형 아바타를 다룬다. 🔗 게시물
- Mati Staniszewski, 대화형 Turing 테스트 통과 시점을 6개월에서 12개월 후로 전망 — ElevenLabs 공동 창업자 겸 최고경영자가 GDIY 팟캐스트에서 밝힌 내용으로, 해당 인터뷰는 회사의 오디오 서비스를 통해 프랑스어 더빙으로도 제공된다. 🔗 게시물
- QwenCloud, Qwen Conference Thailand 2026 행사 보고서 공개 — 9월 4일 방콕에 약 400명의 고객과 개발자가 모였으며, 에이전트가 직접 고객 역할을 맡아 가입부터 결제와 청구까지 사람의 개입 없이 수행하는 종단 간 시연이 진행됐다. 🔗 게시물
- Cohere, Toronto를 세계적인 AI 거점으로 소개한 CNN 보도 공유 — 제품 발표가 아닌 홍보성 소식으로, CBRE가 평가한 기술 인재 부문 세계 3위라는 도시의 위상, 캐나다 국가 전략을 통해 투입된 20억 달러 이상, Anthropic 모델에 대한 수출 통제 이후 고객 요청이 급증했다는 Cohere의 설명을 언급한다. 🔗 게시물
이것이 의미하는 것
Sol-H3가 넘어선 문턱은 목록에 추가되는 또 하나의 기록이 아니다. 영상 클립을 제작하는 데 시청 시간보다 더 오래 걸리는 한, 영상 생성은 일괄 작업에 머문다. 실행하고, 기다리고, 시청하는 방식이다. 이 문턱 아래로 내려가면 시청하는 동안 영상이 만들어지는 새로운 활용 범주가 열린다. 실무자에게 중요한 점은 이러한 향상이 새로운 모델에서 나온 것이 아니라는 사실이다. 모델은 동일하고 추론 스택만 달라졌다. 따라서 15배라는 향상은 가중치가 아닌 실행 엔지니어링에 있었으며, 기존 LoRA와의 호환성을 갖춘 Apache 2.0 라이선스로 공개됐다.
이날은 공개 가중치를 배포하는 두 가지 방식을 대조적으로 보여준다. 한쪽에는 비교 가능한 측정 자료 없이 품질을 주장하고, 저장소 레이블이 실제 제공 형식과 일치하지 않는 자체 게시 글 두 편이 있다. 또한 승자로 제시된 모델의 호스팅 업체가 계산 방법을 공개하지 않은 채 작업당 비용 비교를 발표했다. 다른 한쪽에는 모든 타임스탬프가 감사 절차를 거치고, 연구진이 검증된 22시간과 검증되지 않은 100시간을 명시적으로 구분한 음성 말뭉치가 있다. 누구나 게시할 수 있는 공개 저장소에서는 검증 규율만이 유일하게 활용 가능한 신호가 되며, 이를 만들어 내는 데는 눈길을 끄는 제목보다 더 많은 비용이 든다.
RL 환경에 대한 회고와 Genspark의 통합 속도는 서로 다른 규모에서 동일한 변화를 보여준다. 전자는 2016년의 아이디어가 오늘날 작동하는 이유를 설명한다. 부족했던 것은 알고리즘이 아니라 초기 모델부터 일회용 샌드박스까지 이를 둘러싼 인프라였다. 후자는 이 인프라가 갖춰졌을 때 어떤 일이 일어나는지를 보여준다. 한 플랫폼이 6일 만에 네 공급업체의 네 모델을 연결했다. 두 사례 모두 가치가 모델에서 주변 계층으로 이동하고 있으며, 한쪽의 OpenEnv와 다른 쪽의 다중 모델 오케스트레이터를 통해 이 계층이 표준화되고 있다.
모델 경쟁과 무관한 작업도 남아 있다. Cathay Pacific과의 실험은 기존 항공기와 연료를 대상으로 한다. 추가된 것은 적절한 시점에 조종석으로 전달되는 예측뿐이며, 해당 항공편에서 약 40퍼센트의 감소 효과가 예상된다. Vaani 말뭉치는 잡음이 포함된 음성 자료가 전혀 없었던 여러 언어를 포함해 인도의 58개 언어를 다루며, DeepMind의 아시아 태평양 액셀러레이터는 현장 팀 16곳에 특화 모델을 제공한다. 이 세 작업에는 넘어야 할 벤치마크가 없다. 제약은 수집해야 할 데이터와 성공시켜야 할 배포에 있으며, 시연과 측정 가능한 효과의 차이도 바로 여기서 결정된다.
출처
- Sol-H3, Enze Xie의 X 발표
- Sol-H3 프로젝트 페이지, NVIDIA Research
- Reactor를 통한 Sol-H3 API 이용
- Vaani Noise Event Timestamp Dataset, ARTPARK-IISc
- JiRack Ultra 시리즈, CMS Manhattan
- JiRack DeltaNet 27B, CMS Manhattan
- RL 환경의 역사, Hugging Face
- 초장거리 항공편의 비행운 회피, Google Research
- Genspark의 Muse Spark 1.3
- Replit, 런던 사무소 개설
- Tolquane, Python의 조합 가능한 병렬 처리
- Aiden 펌웨어에서 스킬 직접 설치
- Together AI의 GLM-5.3 Flash와 GPT-5.6 Terra 비교
- 브라질 AI 생태계를 위한 선언문
- 아시아 태평양 AI for the Planet 액셀러레이터, Google DeepMind
- Copilot 애플리케이션의 canvases
- GitHub Universe용 별칭 생성기
- ECCV 2026의 Synthesia
- GDIY 팟캐스트에 출연한 Mati Staniszewski
- Qwen Conference Thailand 2026 행사 보고서
- Cohere가 공유한 Toronto 관련 CNN 보도