ai-powered-markdown-translatorArtikel mit gpt-6.1-sol aus dem Französischen ins Deutsche übersetzt.
Am Mittwoch, dem 30. September, kündigt Google Gemini 4 Argon an, ein Frontier-Modell, das zunächst bei vertrauenswürdigen Cyberverteidigern des Fairwind Program eingesetzt wird und dessen Ausgabelimit auf 1 Million Tokens angehoben wurde. OpenAI gibt an, eine koordinierte Kampagne zur Extraktion der geschützten Gedankengänge seiner Modelle abgewehrt zu haben, deren Kern das Unternehmen Personen zuschreibt, die mit Moonshot AI verbunden sind. Cohere veröffentlicht Embed 5 mit einer eigenen Evaluierungsmethode, Ideogram 4.5 verspricht aufeinanderfolgende Nachbearbeitungen ohne Artefakte, und HeyGen veröffentlicht ein auf MiniMax H3 basierendes Videomodell; für Entwickler erscheinen am selben Tag Claude Code 2.1.286, Zed 1.22.0 und VS Code 1.140.
Gemini 4 Argon: Googles neues Frontier-Modell, zunächst für Cyberverteidiger
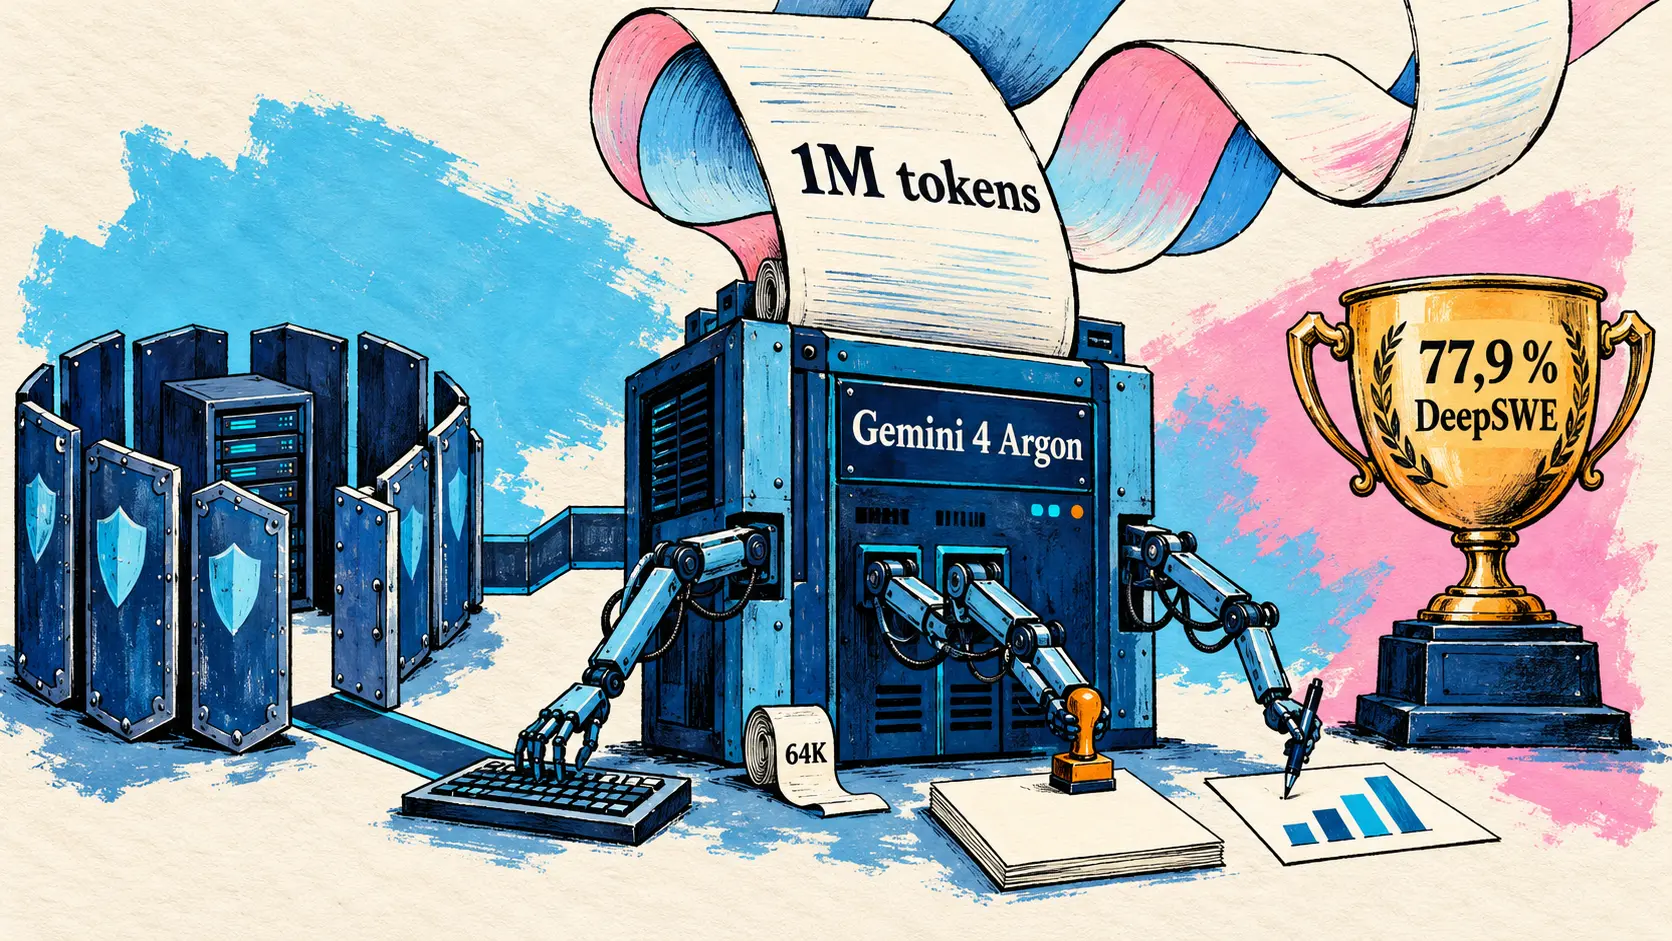
30. September — Google kündigt Gemini 4 Argon, sein neues Frontier-Modell, in einem Beitrag von Koray Kavukcuoglu an, Senior Vice President von Google DeepMind und leitender KI-Architekt von Google (Chief AI Architect). Argon soll tiefgehende Schlussfolgerungen in langen und komplexen Arbeitsabläufen (long-horizon workflows) unterstützen, und zwar in drei Bereichen: Softwareentwicklung unter realen Bedingungen, Wissensarbeit in Unternehmen (Recht, Finanzen) und Cyberverteidigung.
Das Modell ist noch nicht öffentlich zugänglich. Es wird zunächst einer Gruppe vertrauenswürdiger Cyberverteidiger des Fairwind Program bereitgestellt, das am 2. September mit Gemini 3.8 Flash Cyber gestartet wurde. Sie erhalten es ebenso wie die internen Teams von Google ohne Cyberschutzvorkehrungen (cyber guardrails). Entwickler, Unternehmen und die breite Öffentlichkeit sollen „so bald wie möglich“ folgen, beginnend mit zahlenden API-Kunden und Abonnenten von Google AI Ultra; ein Datum wurde nicht genannt. Bis dahin verstärkt Google die Ablehnung schädlicher Anfragen im Cyber- und NRBC-Bereich sowie die Überwachung der Gedankenkette und der Aktionen des Modells und isoliert seine Trainings und Evaluierungen mit hohem Risiko in versiegelten Sandboxes; das Unternehmen gibt außerdem an, am freiwilligen Verfahren der US-Regierung für den Zugang zu Modellen vor ihrer Veröffentlichung teilzunehmen.
Introducing Gemini 4 Argon – our new frontier model. It’s built for complex workflows across coding, enterprise knowledge work, and cybersecurity defense – rolling out today to a set of trusted testers through our Fairwind Program.
🇩🇪 Wir stellen Gemini 4 Argon vor, unser neues Frontier-Modell. Es ist für komplexe Arbeitsabläufe in der Programmierung, der Wissensarbeit in Unternehmen und der Cyberverteidigung konzipiert und wird ab heute über unser Fairwind Program einer Gruppe vertrauenswürdiger Tester bereitgestellt. — @GoogleDeepMind auf X
Die Preise stehen bereits fest: Zum Einführungspreis kosten eine Million Eingabe-Tokens 2 Dollar und eine Million Ausgabe-Tokens 10 Dollar, entsprechend den Preisen von GPT-6.1 Sol, das am Vortag veröffentlicht wurde. Nach einer nicht näher bestimmten Einführungsphase steigen die Preise auf 4 beziehungsweise 20 Dollar; Eingaben aus dem Cache kosten 95 % weniger als reguläre Eingaben. Das Ausgabelimit steigt von zuvor 64K auf 1 Million Tokens und ist laut Google das höchste der Branche: Das Modell kann innerhalb eines einzigen Ablaufs Hunderttausende Tokens erzeugen, um ein schwieriges Problem zu lösen.
| Preis pro Million Tokens | Einführungspreis | Preis nach der Einführungsphase |
|---|---|---|
| Eingabe | 2 dollars | 4 dollars |
| Ausgabe | 10 dollars | 20 dollars |
Die Seite von Google DeepMind vergleicht Argon in neunzehn Zeilen mit GPT-6 Astra, Claude Fable 5.1 und Claude Opus 5.5. Argon erzielt in 13 davon das beste Ergebnis, teilt sich bei CWE-bench v1 (68 %) den ersten Platz mit GPT-6 Astra und wird in 5 übertroffen. Agentischer Code ist der am stärksten umkämpfte Bereich: Argon liegt bei DeepSWE v1.1 (77,9 %) und Vibe Code Bench vorn, landet bei FrontierSWE v2 und Terminal-bench 4.0 jedoch auf dem letzten Platz der vier Modelle. Sein Vorsprung ist bei der Wissensarbeit deutlich, insbesondere beim Legal Agent Benchmark von Harvey (19,6 % gegenüber bestenfalls 6,7 % bei den drei anderen), sowie bei langem Kontext zwischen 256K und 1M Tokens. Das beste Ergebnis jeder Zeile ist fett gedruckt.
| Evaluierter Benchmark (Bereich) | Gemini 4 Argon | GPT-6 Astra | Claude Fable 5.1 | Claude Opus 5.5 |
|---|---|---|---|---|
| Vals Index (Wissensarbeit) | 68,9 % | 63,1 % | 65,8 % | 67,0 % |
| AutomationBench (Wissensarbeit) | 51,3 % | 41,4 % | 31,4 % | 42,5 % |
| Vals Finance Agent v2 (Wissensarbeit) | 65,4 % | 53,5 % | 58,9 % | 58,6 % |
| Legal Agent Benchmark von Harvey (Wissensarbeit) | 19,6 % | 5,4 % | 6,7 % | 3,8 % |
| DeepSWE v1.1 (agentischer Code) | 77,9 % | 74,1 % | 67,4 % | 74,2 % |
| FrontierSWE v2 (agentischer Code) | 55,0 % | 65,5 % | 56,3 % | 62,3 % |
| Vibe Code Bench (agentischer Code) | 91,9 % | 89,6 % | 90,3 % | 90,3 % |
| Terminal-bench 4.0 (agentischer Code) | 57,4 % | 58,2 % | 57,9 % | 66,4 % |
| PostTrainBench (ML-Engineering) | 45,3 % | 44,3 % | 40,2 % | 49,3 % |
| Terminal-Bench Science 0.1 (Naturwissenschaften und Mathematik) | 57,6 % | 68,1 % | 52,6 % | 63,3 % |
| LABBench 2 (Naturwissenschaften und Mathematik) | 88,8 % | 85,4 % | 68,6 % | 73,1 % |
| RiemannBench (Naturwissenschaften und Mathematik) | 76,0 % | 72,0 % | 65,6 % | 69,6 % |
| GraphWalks BFS bis 128K (langer Kontext, F1) | 99,7 % | 98,7 % | 91,4 % | 90,6 % |
| GraphWalks BFS von 256K bis 1M (langer Kontext, F1) | 84,2 % | 71,8 % | 65,0 % | 66,8 % |
| Agent’s Last Exam (Computernutzung) | 39,5 % | 34,2 % | — | 38,2 % |
| OSWorld-2.0, Offline-Teilmenge, Teilpunktzahl (Computernutzung) | 69,2 % | 72,6 % | — | — |
| Chartography (multimodales Verständnis) | 71,6 % | 71,0 % | 46,2 % | 66,3 % |
| LVBench (multimodales Verständnis) | 91,7 % | 87,5 % | 79,7 % | 83,7 % |
| CWE-bench v1 (Cybersicherheit) | 68,0 % | 68,0 % | 58,0 % | 67,0 % |
Bei Google nutzen es bereits Tausende Mitarbeiter. Bei libgav1, Googles Open-Source-Videodecoder, haben Argon-Agenten 32 000 Zeilen SIMD-Code einer bestehenden Rust-Portierung durch sicheren Rust-Code ersetzt: Der daraus entstandene Decoder ist 2,7-mal so schnell wie diese Portierung und liefert eine identische Videoausgabe. Andere Agenten haben Speicheroptimierungen für Rechenzentren vorbereitet, die nach ihrer Bereitstellung mehr als 300 TiB freigeben sollen. Im Bereich Cybersicherheit setzt Wiz das Modell in seiner Initiative Scan for Good ein: Argon entdeckte dabei in einer von Krankenhäusern weltweit genutzten Gesundheitssoftware eine kritische Schwachstelle, durch die sensible personenbezogene Daten offengelegt wurden und die frühere Frontier-Modelle übersehen hatten.
🔗 Gemini 4 Argon: unsere nächste Ära der Frontier-Intelligenz (Google-Blog) 🔗 Gemini-Seite von Google DeepMind und Benchmark-Tabelle
OpenAI gibt an, eine Distillationskampagne abgewehrt zu haben, und schreibt deren Kern Personen zu, die mit Moonshot AI verbunden sind
30. September — In einem Beitrag seiner Rubrik Security gibt OpenAI an, eine koordinierte Kampagne zur Extraktion der geschützten Gedankengänge (protected reasoning) seiner Modelle entdeckt und anschließend neutralisiert zu haben. Gemeint ist die interne Spur, die ein Modell bei der Bearbeitung einer Aufgabe erzeugt. Das Unternehmen betrachtet dies als adversariale Distillation (adversarial distillation): die systematische und unbefugte Nutzung der Ausgaben oder Gedankengänge eines Modells, um ein anderes Modell zu trainieren, nachzubilden oder zu verbessern.
Laut OpenAI haben die Beteiligten weder die Verschlüsselung geknackt noch eine Datenbank kompromittiert oder direkt auf gespeicherte Unterhaltungen von Nutzern zugegriffen. Sie manipulierten die Interaktionen so, dass die geschützten Gedankengänge in sichtbarer Form wieder auftauchten, etwa indem sie den verschlüsselten Gedankengang aus einer Unterhaltung kopierten und ein Modell in einer anderen Unterhaltung aufforderten, ihn zu entschlüsseln und zu transkribieren. Unabhängige Forscher hatten im Rahmen einer verantwortungsvollen Offenlegung ähnliche Schwachstellen gemeldet, die im Artikel „Diebstahl von Reasoning-Traces aus proprietären LLM-APIs“ beschrieben werden, der am 10. August bei arXiv eingereicht wurde; OpenAI bestätigt, dass diese Angriffswege tatsächlich bestanden.
| Phase der Kampagne | Von OpenAI erfasstes Datum oder Volumen |
|---|---|
| Beginn der Aktivität mit geringem Volumen | 1. Juli |
| Aktivitätsspitzen | 24. und 25. Juli |
| Anfragen nach dem Extraktionsmuster während der Spitzen | 16 000 von mehr als 4 000 Nutzern |
| Mit diesem Muster verbundene Gruppe | mehr als 15 000 Nutzer |
| Vollständige Neutralisierung der Gruppe | 28. Juli |
Bei der Zuordnung bleibt der Beitrag vorsichtig: Es ist nicht belegt, dass alle Beteiligten demselben Akteur zuzuordnen sind, und die 16 000 Anfragen während der Spitzen sind Extraktionsversuche, die nicht zwangsläufig erfolgreich waren. OpenAI schreibt jedoch einen Kern der Aktivitäten Personen zu, die mit Moonshot AI, dem Entwickler von Kimi, verbunden sind.
… we attribute a core cluster of the activity to individuals associated with Moonshot AI …
🇩🇪 … wir schreiben einen Kern der Aktivitäten Personen zu, die mit Moonshot AI verbunden sind … — OpenAI, Beitrag in der Rubrik Security
Als Reaktion hat OpenAI betrügerische Konten gesperrt oder eingeschränkt, seine Kontrollen bei der Registrierung und in der Infrastruktur verschärft, die Überwachung verbundener Netzwerke ausgeweitet und den Schutz verborgener Gedankengänge zwischen Nutzern, Arbeitsbereichen, Organisationen und Modellfamilien verstärkt. Das Unternehmen hat einen Weg geschlossen, über den sich der verschlüsselte Gedankengang eines anderen Nutzers erneut einspielen ließ, um dessen Inhalt zu rekonstruieren, und Kontrollen hinzugefügt, die eine potenziell offenlegende Ausgabe im Streaming-Modus (streaming) erkennen und zurückhalten. Die Ergebnisse wurden über das Frontier Model Forum und Regierungskanäle geteilt: Laut OpenAI ist die Technik nicht auf seine Modelle beschränkt, und jedes System, das Gedankengänge übertragbar oder erneut abspielbar macht, kann ähnlichen Risiken ausgesetzt sein. Das Unternehmen stellt adversariale Distillation als Risiko für die Sicherheit und die nationale Sicherheit dar, da extrahierte Gedankengänge dazu dienen können, ein anderes Modell ohne die Schutzvorkehrungen des Originals zu trainieren. Das Thema ist nicht neu: Im Februar hatte Anthropic Distillationskampagnen DeepSeek, Moonshot AI und MiniMax zugeschrieben, und seit dem 24. September berechnet Anthropic blockierte Anfragen in mehreren Kategorien, darunter die Extraktion von Gedankengängen.
🔗 Artikel „Diebstahl von Reasoning-Traces aus proprietären LLM-APIs“ auf arXiv
Embeddings: Cohere stellt Embed 5 und die Metrik RCP-nDCG@10 vor, Perplexity veröffentlicht pplx-embed-v2-context-9b-preview
30. September — Cohere stellt Embed 5 vor, eine Familie von Embedding-Modellen für die Unternehmenssuche, mit zwei Leistungsstufen, die denselben Embedding-Raum nutzen: Embed 5 Pro für maximale Qualität und Offline-Indexierung sowie Embed 5 Fast für interaktive Suche, RAG mit hohem Anfragevolumen und agentische Suche. Ein Korpus lässt sich mit Pro indexieren und anschließend mit Fast durchsuchen, ohne ihn neu zu indexieren, sofern dieselbe Ausgabedimension beibehalten wird: Auf 40 Entwicklungsdatensätzen bewahrt dieses von Cohere empfohlene Verfahren im Durchschnitt 98,4 % der Qualität eines vollständig mit Pro betriebenen Systems, gegenüber 96,6 % bei einem reinen Fast-System.
Beide Modelle verarbeiten bis zu 128K Tokens, akzeptieren Text, Bilder oder beides kombiniert in einem einzigen Vektor, decken mehr als 100 Sprachen ab und erzeugen Vektoren mit 256 bis 2 048 Dimensionen in float, int8 oder binärer Form. Cohere empfiehlt 1 024 Dimensionen in int8, also 1 Ko pro Vektor gegenüber 8 Ko in float32 bei 2 048 Dimensionen. Pro kostet 0,12 Dollar pro Million Text-Tokens und Fast 0,08 Dollar, ein Drittel weniger, bei einem im Durchschnitt 2,4-mal höheren Dokumentdurchsatz; für Bilder werden bei beiden 0,40 Dollar pro Million Tokens berechnet. Embed 5 ist ab heute über die API von Cohere, Model Vault, Microsoft Foundry und Amazon SageMaker sowie in North verfügbar und lässt sich mit vLLM privat bereitstellen.
| Benchmark (Metrik) | Embed 5 Pro | Embed 5 Fast | Weitere genannte Modelle |
|---|---|---|---|
| ViDoRe V3, 8 Fachgebiete (RCP-nDCG@10) | 85,8 | 84,5 | Voyage 4 Large 83,7 ; Gemini Embedding 2 83,2 ; OpenAI text-embedding-3-large 75,5 |
| FinanceBench (RCP-nDCG@10) | 80,1 | 80,0 | Pro 21,4 Punkte vor OpenAI text-embedding-3-large |
| FinQA (RCP-nDCG@10) | 90,0 | 88,8 | — |
| ViDoRe V3 Finance (RCP-nDCG@10) | 85,0 | 83,9 | — |
| Analysierte PDFs, Durchschnitt der Testsuite (RCP-nDCG@10) | 84,8 | 83,4 | Voyage 4 Large 83,6 ; Gemini Embedding 2 80,8 ; Embed 4 78,6 |
| Text und Bild kombiniert, 5 Datensätze (nDCG@10) | 82,3 | 81,2 | Gemini Embedding 2 61,3 |
| Seitenbild, 5 Finanzdatensätze (nDCG@10) | 77,0 | 73,2 | Embed 4 71,1 ; Voyage Multimodal 3.5 70,1 ; Gemini Embedding 2 56,7 |
| 5 europäische Sprachen (nDCG@10 oder RCP-nDCG@10) | 77 | — | Voyage 4 Large 76 ; Gemini Embedding 2 73 |
Die meisten dieser Ergebnisse sind in RCP-nDCG@10 angegeben, der Bewertungsmethode, die Cohere am selben Tag veröffentlicht (siehe unten): Ein Hinweis im Beitrag stellt klar, dass sie eine feste Kandidatenmenge neu ordnet und somit die Ranking-Qualität statt des Retrievals der ersten Stufe misst. Die zweite mehrsprachige Tabelle verdient eine vollständige Betrachtung: Cohere hebt darin seine Fortschritte gegenüber Embed 4 hervor, bis zu 13 Punkte auf Farsi. Bei diesen zehn Sprachen liegt Gemini Embedding 2 jedoch in neun vor Embed 5 Pro, mit Chinesisch als einziger Ausnahme, und Voyage 4 Large liegt in fünf davor. Cohere wird Embed 5 am 8. Oktober in einer Session auf X vorstellen.
🔗 Cohere-Beitrag zu Embed 5 · Ankündigung von @cohere auf X
RCP-nDCG@10, die Metrik, mit der Cohere Embed 5 bewertet
30. September — Cohere veröffentlicht außerdem RCP-nDCG@10 (Rubric-Calibrated Preferences nDCG@10), seine Methode zur Bewertung der Suche. Ausgangspunkt: nDCG, die Metrik von MTEB und BEIR, vergleicht die Ergebnisse mit einer vorab annotierten, zwangsläufig unvollständigen Dokumentliste. Ein relevantes Dokument, das nie annotiert wurde, bringt daher keine Punkte; in der Studie von Cohere werden jedoch 28 % der als irrelevant markierten Dokumente von Menschen als nützlich eingestuft. RCP-nDCG@10 überlässt die Bewertung einem kalibrierten KI-Bewerter, der für jede Anfrage dieselben fünf Ja/Nein-Fragen beantwortet und die Dokumente in Gruppen vergleicht. Eine verblindete Validierung mit 46 Annotatoren anhand von 289 Duellen ergibt: Wenn die beiden Metriken unterschiedliche Gewinner bestimmen, stimmen die Menschen in 70 % der Fälle RCP-nDCG zu. Der Artikel, der Code und die Daten sind veröffentlicht, und der Hauptmaintainer von MTEB kündigt die Integration an. Cohere erklärt, seine fünfte Generation von Embed und Rerank anhand dieser Metrik optimiert zu haben. Für Rerank gibt es noch keinen Termin, und Cohere weist darauf hin, dass diese Modelle bei alleiniger Betrachtung des herkömmlichen nDCG nicht immer als die besten erscheinen werden.
🔗 Cohere-Beitrag zu RCP-nDCG@10 · Code und Daten auf GitHub
Perplexity veröffentlicht pplx-embed-v2-context-9b-preview und den Benchmark context-bench
30. September — Perplexity veröffentlicht pplx-embed-v2-context-9b-preview als Vorabversion unter MIT-Lizenz auf Hugging Face. Es handelt sich um ein Modell für kontextuelle Embeddings: Jeder Dokumentabschnitt wird unter Berücksichtigung des gesamten Dokuments encodiert, damit eine Passage mit „sie“ weiterhin der richtigen Entität zugeordnet bleibt. Statt anhand eines einzigen „Gold“-Abschnitts (gold passage) pro Anfrage lernt das Modell von einem Lehrermodell, dem Modell zur Kontextkomprimierung von Perplexity, das jedes Token des Dokuments bewertet: So lernt es, die Antwort und die Passagen zu finden, die sie belegen. Bei einer verblindeten Bewertung auf context-bench, einem privaten Benchmark von turbopuffer, dem Mitautor des Beitrags (2 099 Anfragen, 38 894 Dokumente), liegt es vor voyage-context-4; auf ConTEB erzielt es den besten Durchschnitt, ohne bei allen Aufgaben zu gewinnen. Perplexity weist darauf hin, dass sich Gewichte und Schnittstelle noch ändern können, und bereitet einen Zugang über seine API vor, ohne einen Termin zu nennen.
| Von Perplexity veröffentlichte Messgröße | pplx-embed-v2-context-9b-preview | Abstand zu voyage-context-4 |
|---|---|---|
| Antwort-Recall auf context-bench, bei K = 10 | 45,5 % | +14,4 Punkte |
| Beleg-Recall auf context-bench, bei K = 10 | 40,6 % | +5,0 Punkte |
| Speicherbedarf pro Vektor (1 024 Dimensionen, int8) | 1 Ko | 8-mal geringer als bei voyage-context-4 in float32 |
🔗 Beitrag von Perplexity Research · Modell auf Hugging Face
Ideogram 4.5: ein Bildbearbeitungsmodell für aufeinanderfolgende Retuschen
30. September — Ideogram stellt Ideogram 4.5 vor und bezeichnet es als „das präziseste Bearbeitungsmodell“. Die Ausgangsbeobachtung: Bei jeder Retusche fügen Bildmodelle Artefakte, Pixelverschiebungen und Farbabweichungen hinzu, sodass ein Bild nach mehreren Durchgängen schnell unbrauchbar wird. Ideogram 4.5 soll diese Anhäufung beseitigen und die Bearbeitung in mehreren Durchgängen (multi-turn editing) ermöglichen.
Introducing Ideogram 4.5, the most precise edit model. With each edit, leading models add artifacts, pixel shifts, and color changes. Ideogram 4.5 eliminates artifact buildup, making multi-turn editing possible. Live in Ideogram, the API, and launch partners. Open weights soon.
🇩🇪 Hier ist Ideogram 4.5, das präziseste Bearbeitungsmodell. Bei jeder Retusche fügen die führenden Modelle Artefakte, Pixelverschiebungen und Farbveränderungen hinzu. Ideogram 4.5 beseitigt die Anhäufung von Artefakten und ermöglicht so die Bearbeitung in mehreren Durchgängen. Verfügbar in Ideogram, über die API und bei den Startpartnern. Offene Gewichte folgen bald. — @ideogram_ai auf X
Um diesen Punkt zu untermauern, veröffentlicht Ideogram einen direkten visuellen Vergleich derselben aufeinanderfolgenden Retuschen mit GPT Image 2.5 Sunburst, Nano Banana Pro und Nano Banana 2, deren Ergebnisse laut Ideogram schon nach wenigen Retuschen unbrauchbar werden. Der Vergleich ist rein visuell und enthält keine numerischen Bewertungen. Die Beispiele umfassen Farbe und Beleuchtung (Schatten, Reflexionen und Spitzlichter folgen der Änderung, ohne die Komposition zu verschieben), Textänderungen, Produktfotografie, Inneneinrichtung, die schrittweise Restaurierung alter Fotos, die Umwandlung einer Skizze oder Tiefenkarte in ein Bild sowie das Zuschneiden.
Das Modell führt außerdem die Bearbeitung bei beliebiger Auflösung (Zoom editing) ein: Ein Bereich eines hochauflösenden Bildes, im Beispiel von Ideogram mit 24,2 Megapixeln (4 016 × 6 016 Pixel), lässt sich bearbeiten, ohne das Bild zu verkleinern. Die Ränder bleiben erhalten, damit der Bereich ohne sichtbaren Übergang wieder eingefügt werden kann. Obwohl das Modell für gezielte Bearbeitungen entwickelt wurde, schneidet es laut Ideogram auch bei der allgemeinen Bildbearbeitung sehr gut ab.
| Bestandteil der Ankündigung | Was darüber bekannt ist |
|---|---|
| Verfügbarkeit | ab dem 30. September in Ideogram und über die API |
| Startpartner | Pika und Luma, die es am selben Tag ankündigen |
| Offene Gewichte | „bald“ versprochen, wie die im Juni veröffentlichten Gewichte von Ideogram 4.0 |
| Preis | nicht veröffentlicht |
HeyGen Video: ein Videomodell auf Basis von MiniMax H3, über eine API zugänglich
30. September — HeyGen stellt HeyGen Video vor, ein Modell zur Videogenerierung für Unternehmen, die ein Video in Produktionsqualität wünschen, ohne die entsprechenden Kosten zu tragen. Es basiert auf MiniMax H3 und wurde von HeyGen nachtrainiert. Es erzeugt ein Video aus Text oder einem Bild, wobei der Ton im selben Aufruf generiert wird, und lässt sich über die API von HeyGen sowie auf OpenRouter, Runware und ComfyUI nutzen.
Bei den Preisen stehen drei Angaben nebeneinander. Laut Katalogseite beginnt der Preis bis Ende Oktober bei 0,01 Dollar pro Sekunde, also mit 50 % Rabatt auf den Standardpreis von 0,02 Dollar. Die Vergleichstabelle verwendet dagegen den Listenpreis für 768p mit Audio vor den Einführungsaktionen: 0,03 Dollar pro Sekunde. Selbst zu diesem Preis ist HeyGen Video das günstigste der verglichenen Modelle.
| Verglichenes Modell | Listenpreis pro Sekunde (768p, Audio) | Internes Elo von HeyGen (HeyGen Video = 1 000) |
|---|---|---|
| HeyGen Video | 0,03 dollar | 1 000 |
| Seedance 2.0 | 0,303 dollar | 955 |
| H3 Max | 0,08 dollar | 952 |
| H3 Max Turbo | 0,04 dollar | 920 |
| H3 Max balanced | 0,08 dollar | 860 |
| Kling 3.0 Pro | 0,168 dollar | 857 |
| Veo 3.1 | 0,40 dollar | 744 |
Bei der Qualität stützt sich HeyGen auf eine interne Bewertung anhand von Anfragen aus Artificial Analysis Arena (4 800 Stimmen), wobei das Elo seines Modells auf 1 000 normiert wurde. Im verblindeten Präferenzvergleich mit H3 Max entfallen 55,8 % der 650 Stimmen auf HeyGen Video, mit einer Spanne von 49 bis 62 %, die einen Gleichstand nicht ausschließt. Bei einem 10 Sekunden langen Clip aus einem Bild sinkt die Inferenzzeit des Diffusion Transformers auf 3,7 Sekunden, gegenüber 4,1 für H3 Max Turbo und 8,3 für H3 Max, ohne die Zeit für die Erstellung von Bildbeschreibungen.
MiniMax begrüßte den Start und hob am selben Tag ein weiteres von H3 abgeleitetes Modell hervor: Boreal-H3 von Creatify, ein für Werbung optimiertes Videomodell.
🔗 HeyGen-Video-Katalog · Ankündigung von @HeyGen auf X
Assistenten und Agenten für allgemeine Aufgaben: Geminis Skills, Manus Flex und Grok Bot
Die Gemini-App führt Skills ein, die Gems ersetzen werden
30. September — Google führt Skills in der Gemini-App ein: einmal gespeicherte Anweisungen, die sich durch Eingabe eines Schrägstrichs gefolgt von ihrem Namen aufrufen lassen. Gemini kann sie auch aus Gesprächen erstellen und selbstständig starten, wenn ein Prompt dazu passt. Mehrere Skills lassen sich kombinieren, und jede kann Referenzdateien enthalten (Klartext, PDFs, Bilder). In Gemini Spark sind sie bereits vorhanden; nun kommen sie weltweit in den Gemini-Chat, für alle Abostufen von Google AI und vorerst für Personen ab 18 Jahren. Workspace-Kunden folgen in den nächsten Wochen. Die Skills werden Gems ersetzen, die für persönliche Konten ab November, für Workspace business, enterprise und nonprofit im März 2027 und für den Bildungsbereich im Juni 2027 eingestellt werden, mit automatischer Migration. Opal, das Tool zur Erstellung von Mini-Anwendungen, wird ebenfalls im November eingestellt, ebenso wie „Gems by Google Labs“, die nicht migriert werden.
🔗 Lassen Sie Skills in Gemini Ihre häufigsten Routineaufgaben übernehmen (Google-Blog)
Manus Flex: der eigene API-Schlüssel im Manus-Agenten
29. September — Manus führt Manus Flex ein, womit sich Manus über den API-Schlüssel eines unterstützten Inferenzanbieters betreiben lässt (bring your own API key). Bisher wählte Manus das Modell selbst aus und stellte den Harness sowie die Agenteninfrastruktur bereit; mit Flex betreibt der Schlüssel eines Anbieters dieselben Projekte, Tools, Laufzeitumgebungen und Agenten-Workflows, wobei Hauptmodell und Umfang des Reasoning-Aufwands wählbar sind. Die Abrechnung wird aufgeteilt: Die Inferenz wird direkt vom Anbieter berechnet, während die übrigen Dienste und die Infrastruktur, die eine Aufgabe nutzt, weiterhin Manus-Credits verbrauchen. OpenRouter, Fireworks und Modal sind die ersten drei Mitglieder des Inferenzpartnerprogramms (Manus Flex Inference Partner Program). Der Beitrag, der am Tag nach dem Start von Manus 2.0 veröffentlicht wurde, nennt weder Abomodell noch Preise noch eine Modellliste.
Grok Bot überträgt Programmieraufgaben an Cursor und verwaltet Pull Requests
30. September — Zwei Tage nach Team Bots erweitert SpaceXAI Grok Bot für die Softwareentwicklung. In einem Thread des Accounts @bot kündigt der Anbieter an, dass seine Bots Programmieraufgaben an Cursor übertragen, Pull Requests mithilfe von GitHub- und Origin-Plugins verwalten (Letzteres wird nicht beschrieben) und Videodemos ihrer Arbeit teilen können. SpaceXAI veröffentlicht außerdem die Bots seines eigenen Entwicklungsteams als installierbare Vorlagen (templates), jeweils mit ihren Skills, Routinen und Konnektoren. Der Thread nennt weder Abomodell noch Preise noch einen Termin, und auf x.ai gibt es keinen begleitenden Beitrag. Die Verbindung zu Cursor ist nicht neu: Grok Bot for Enterprise wurde Anfang September Grok- und Cursor-Enterprise-Kunden zwei Wochen lang kostenlos angeboten; neu ist, dass ein Bot die Programmierarbeit selbst delegiert.
Robotik und Weltmodelle: Praxis-1 von Runway, MolmoAct 2 von Ai2 und Physis-Lang von NVIDIA
Runway stellt Praxis-1 vor, ein Weltaktionsmodell mit offenen Gewichten
30. September — Runway stellt Praxis-1 vor, sein erstes Weltaktionsmodell (world action model) mit offenen Gewichten, das echte Roboter steuern soll. Es basiert auf demselben Video-Vortraining wie seine Weltmodelle, etwa Solaris oder GWM Worlds 2, und soll als generalistisches Policy-Modell für Entwickler und Forscher in der Robotik dienen. Runway setzt darauf: Robotikdemonstrationen sind rar, Videomaterial ist nahezu unbegrenzt verfügbar. In den Demonstrationen wechselt dieselbe Policy ohne erneutes Training von einem Studio in eine Küche. Noch lässt sich nichts herunterladen: Praxis-1 wird bei Noble Machines, Standard Bots und Ultra getestet, jeweils auf deren eigener Hardware. Die öffentliche Veröffentlichung einschließlich der Gewichte ist für die kommenden Monate angekündigt.
| Von Runway veröffentlichte Messgröße | Angekündigtes Ergebnis |
|---|---|
| Korrelation zwischen Simulation im Weltmodell und realen Ergebnissen | 0,95 |
| Abschließender Platzierungsfehler nach Anpassung mit Webvideos | 16,1 cm |
| Derselbe Fehler mit Videos eines ferngesteuerten Roboters | 16,0 cm |
🔗 Praxis-1 bei Runway Research
MolmoAct 2 von Ai2 führt Reality Check nach Fine-Tuning durch den Benchmark-Veranstalter an
30. September — Ai2 gibt bekannt, dass MolmoAct 2, sein vollständig offenes Robotikmodell, bei der Gesamterfolgsquote auf Reality Check den ersten Platz erreicht. Dieser unabhängige Benchmark für Manipulationsaufgaben unter realen Bedingungen hat jedoch eine wesentliche Besonderheit: Die Modelle werden vom Veranstalter Poke & Wiggle auf die Aufgaben des Benchmarks feinabgestimmt. Reality Check wurde am Vortag von diesem Unternehmen gestartet und umfasst 14 400 Durchläufe auf echten Robotern an FR3 Duo-Stationen im Deutschen Museum in München, in zehn Umgebungen (Schrauben sortieren, einen DC-Stecker anschließen, einen Werkzeugkasten mit einem Schraubendreher öffnen …). Zwei Bereiche sind noch „in Vorbereitung“: Objekte außerhalb des Trainingsbereichs und ein Mid-Training mit 100 Stunden Daten der Stationen.
| Evaluiertes Modell | Gesamterfolgsquote | Erfolgsquote nach etwa 10 Demonstrationen pro Umgebung | Erfolgsquote nach etwa 300 Demonstrationen pro Umgebung |
|---|---|---|---|
| MolmoAct 2 | 28 % | 4 % | 44 % |
| Pi 0.5 | 21 % | 5 % | 33 % |
| DiT-Flow | 19 % | 2 % | 29 % |
| GR00T N1.7 | 12 % | 4 % | 19 % |
🔗 Tweet von Ai2 · Reality Check-Ranking
Physis-Lang: Beschreibungen, die Weltmodellen die Physik erklären
29. September — Forscher von NVIDIA, dem MIT und der Universität Oxford veröffentlichen Physis-Lang, ein Framework, das Videobeschreibungen um physikalische Überlegungen ergänzt, um Weltmodelle zu verbessern. Die Beschreibungen machen Ursachen, zugrunde liegende Gesetze und Auswirkungen explizit; ein spezialisierter Kritiker erkennt fehlende oder unbelegte Aussagen, ein Agent verfeinert die Anweisungen zur Erstellung der Beschreibungen, und Fehler des Modells dienen dazu, Videos zu suchen, die seine Lücken schließen. Laut NVIDIA verbessert allein das Hinzufügen dieser Überlegungen zum Prompt, ohne erneutes Training, den PhyGenBench-Score von Cosmos 3 um 5,62 Punkte. Mit Training belegt Physis-Lang auf Cosmos3-Super und Cosmos3-Nano die ersten beiden Plätze im Physics-IQ Verified-Ranking für Bild zu Video (48,2 und 43,3 gegenüber dem bisherigen Bestwert von 42,7). PhyGenBench und VideoPhy-2 werden von GPT-5.5 bewertet, und Veo 3.1 behält auf dem vollständigen VideoPhy-2-Datensatz einen leichten Vorsprung.
| Benchmark für Videophysik | Cosmos3-Nano | Veo 3.1 | Physis-Lang auf Cosmos3-Nano |
|---|---|---|---|
| PhyGenBench | 61,67 | 65,63 | 71,04 |
| Physics-IQ Verified | 40,23 | 34,99 | 43,41 |
| VideoPhy-2 Hard | 48,31 | 58,43 | 62,36 |
| VideoPhy-2, vollständiger Datensatz | 60,41 | 68,87 | 68,02 |
🔗 Projektseite von Physis-Lang · Ankündigung von @NVIDIAAI auf X
Offene Modelle: Hunmin-397B-A17B-CUA und JEV-27B-VL
Hunmin-397B-A17B-CUA überträgt die Agentenfähigkeiten von Qwen-CUA auf ein MoE mit 397 Milliarden Parametern
30. September — Im Community-Blog von Hugging Face beschreibt hojun Lee Hunmin-397B-A17B-CUA, ein Modell zur Computerbedienung (computer use), das die Organisation mncai unter Apache-2.0 veröffentlicht hat. Die Autoren selbst nennen dabei einen Vorbehalt: Die Evaluationen folgen eigenen Verfahren, mit nur einem Durchlauf bei den Agenten-Benchmarks, und sind nicht mit veröffentlichten Rankings vergleichbar (das Basismodell erreicht dort 48,16 auf OSWorld gegenüber den auf OSWorld-Verified angekündigten 62,2). Das Modell basiert auf Qwen3.5-397B-A17B, einem Mixture of Experts mit 17 Milliarden aktiven Parametern, und das gesamte Projekt kam mit einem einzigen Knoten mit acht B200 aus. Das Team berechnete die Gewichtsdifferenz zwischen seinem Basismodell und dem bereits spezialisierten Qwen-CUA und übertrug davon nur eine Version mit reduziertem Rang auf ausgewählte Module: Allein dieser Transfer erhöht den Wert auf OSWorld-316 von 48,84 auf 68,25, ohne die Schwäche von Qwen-CUA beim visuellen Grounding zu übernehmen. Fine-Tuning und anschließendes Reinforcement Learning mit GRPO bringen weitere 4,3 Punkte.
| Benchmark (eigenes Protokoll) | Basismodell Qwen3.5-397B | Hunmin-CUA | Qwen-CUA (Quelle) |
|---|---|---|---|
| OSWorld, 360 Aufgaben | 48,16 | 70,45 | 77,12 |
| WindowsAgentArena, 153 Aufgaben | 41,77 | 50,85 | 56,68 |
| ScreenSpot-Pro | 72,74 | 75,61 | 62,20 |
| KMMLU-Pro (Koreanisch) | 77,91 | 76,12 | 71,41 |
🔗 Blogbeitrag zu Hunmin-CUA · Gewichte auf Hugging Face
AutoTrust AI veröffentlicht JEV-27B-VL, ein offenes Entscheidungsmodell, das auch Bilder beurteilt
30. September — AutoTrust AI veröffentlicht unter Apache-2.0 JEV-27B-VL, die mit Bildverarbeitung ausgestattete Version von JEV-27B, seinem am 27. September vorgestellten offenen Entscheidungsmodell. Man zeigt ihm Bilder und Text, stellt eine Frage, und es antwortet in einem einzigen Durchlauf mit einer kalibrierten Wahrscheinlichkeit für jede Option, in rund hundert Millisekunden; wenn die Frage es erfordert, denkt es beim Betrachten der Bilder Schritt für Schritt nach. Sein Entscheidungskopf hat während des Trainings allerdings kein einziges Bild gesehen. Der wichtigste Test: Auf MicroLens, einem öffentlichen Datensatz einer Kurzvideo-App, ordnet es 20 Videokandidaten für 200 Nutzer allein anhand der Vorschaubilder und erreicht beim AUC-Wert Gleichstand mit einem auf 59 045 Nutzern trainierten kollaborativen Filterverfahren, mit einer höheren Trefferquote für das passende Video in den Top 5. Die Autoren weisen darauf hin, dass dieses Ergebnis aus einem einzigen Datensatz mit 200 Nutzern stammt.
| Empfehlungsverfahren auf MicroLens | AUC | Passendes Video in den Top 5 |
|---|---|---|
| JEV-27B-VL, nur Vorschaubilder, ohne Interaktionsdaten | 0,727 | 59 % |
| Kollaboratives Filterverfahren, trainiert auf 59 045 Nutzern | 0,728 | 49 % |
| JEV-27B-VL, nur Titel | 0,649 | 46 % |
| Zufällige Reihenfolge | 0,489 | 21 % |
Rankings: das Open TTS Leaderboard von Hugging Face und AURORA von LILT
Hugging Face startet das Open TTS Leaderboard, ein offenes Ranking für Sprachsynthese
30. September — Hugging Face startet das Open TTS Leaderboard, ein Ranking für Sprachsynthese (text-to-speech, TTS), das sich auf offene und mehrsprachige Modelle konzentriert. Der Hub enthält mehr als 8 000 TTS-Modelle, doch die maßgeblichen Abstimmungsarenen halten mit dem Tempo kaum Schritt und berücksichtigen offene Modelle zu wenig: Laut dem Blogbeitrag haben nur 16 der 92 von Artificial Analysis eingestuften Modelle offene Gewichte. Das Ranking ersetzt die Abstimmungen deshalb durch objektive Messgrößen: Verständlichkeit (Wort- oder Zeichenfehlerrate zwischen dem angeforderten Text und seiner Transkription durch Qwen3 ASR), Geschwindigkeit (gebündelte Inferenz und Zeit bis zum ersten Ton, auf H200 und auf einem Prozessor) sowie die Wiedergabetreue einer geklonten Stimme (WavLM-Ähnlichkeit). Die Evaluation eines Modells dauert wenige Stunden statt mehrerer Wochen mit Abstimmungen. Im Englischen führen Kokoro-82M, supertonic-3 und s2-pro von Fish Audio; bei den mehrsprachigen Modellen OmniVoice, s2-pro und Fun-CosyVoice3-0.5B. Die Autoren weisen darauf hin, dass weder Natürlichkeit noch Ausdrucksstärke gemessen werden, und werden ihre Evaluationsskripte „bald“ veröffentlichen.
🔗 Blogbeitrag zum Open TTS Leaderboard · Das Ranking auf Hugging Face
LILT startet AURORA, ein mehrsprachiges Ranking für Agentenaufgaben
30. September — LILT startet AURORA, ein Ranking, das Spitzenmodelle anhand nicht englischsprachiger Agentenaufgaben bewertet. Alle Aufgaben wurden von muttersprachlichen Fachleuten entwickelt und überprüft, ohne maschinelle Übersetzung. Zum Start umfasst es vier Benchmarks: einen mehrsprachigen Terminal-Bench mit 324 Coding-Aufgaben in zehn Sprachen, eine mehrsprachige Version von τ³-bench für den Kundensupport, MultiChallenge für die Befolgung von Anweisungen in langen Kontexten und GAIA-v2-LILT für agentisches Schlussfolgern. Claude Opus 5.5 führt den mehrsprachigen Terminal-Bench an und liegt bei τ³-bench in jeder der fünf Sprachen auf Platz eins. Auf GAIA erzielen die Modelle in der von LILT überprüften Version durchschnittlich 20,7 Punkte mehr als bei einer maschinellen Übersetzung: Für LILT misst dieser Abstand den durch die Übersetzung verursachten Fehler. Derselbe Dialog verbraucht auf Koreanisch oder Arabisch außerdem etwa 1,4-mal so viele Tokens wie auf Englisch.
| Evaluiertes Modell (mehrsprachiger Terminal-Bench, Auszug) | Durchschnittliche Erfolgsquote |
|---|---|
| Claude Opus 5.5 (effort high) | 76,4 % |
| Claude Opus 5 (effort high) | 73,5 % |
| Gemini 3.8 Flash | 67,3 % |
| GPT-6 Sol | 64,8 % |
| Command A+ | 4,3 % |
🔗 AURORA-Blogbeitrag von LILT · Das AURORA-Ranking
Öffentlicher Sektor und Unternehmen: Claude for Government, Anthropics Kaufagent und OpenAI mit America’s SBDC
Claude for Government wird allgemein verfügbar
30. September — Claude for Government verlässt die Beta-Phase: Anthropic kündigt die allgemeine Verfügbarkeit für Behörden des Bundes und der US-Bundesstaaten an. Die seit Juli in öffentlicher Beta verfügbare Plattform bietet Claudes Fähigkeiten für Coding und agentisches Arbeiten in einer für FedRAMP High zugelassenen Umgebung, mit Funktionen, die denen für Geschäftskunden vergleichbar sind; die CLI Claude Code und Claude for Microsoft 365 kommen im Early Access hinzu. Es gibt keine Lizenz pro Nutzerplatz: Die Behörden bezahlen die Nutzung in festen Kontingenten, mit einer verbindlichen Obergrenze, die eine Überschreitung des zugesagten Budgets verhindert. SCIM-Gruppenzuordnungen legen je Nutzerplatzstufe Durchsatzlimits, Dollar-Obergrenzen und zugelassene Modelle fest. Bei den Kontrollen gilt: Sensible Vorgänge bei Anthropic erfordern die Freigabe durch zwei Personen, Nutzungsexporte enthalten ausschließlich Messdaten, und der Gesprächsverlauf bleibt auf dem von der Behörde verwalteten Gerät. Anthropic veröffentlicht keine Preise.
🔗 Claude for Government ist jetzt allgemein verfügbar
Bei Anthropic nimmt ein auf Managed Agents basierender Agent Vertriebsanfragen entgegen
30. September — Anthropic berichtet, wie sein Vertriebsteam die Bearbeitung eingehender Anfragen – Zehntausende pro Monat – mit einem Kaufagenten auf Basis von Claude Managed Agents, derzeit in Beta, neu gestaltet hat. Auf den Seiten Contact Sales und Pricing, in claude.ai und in E-Mails stellt er einige Fragen, empfiehlt einen Tarif und eine Anzahl von Nutzerplätzen und führt dann zum Kaufabschluss, übergibt mit dem gesamten Gesprächsverlauf an einen Vertriebsmitarbeiter oder beantwortet lediglich Fragen; der Kunde kann sich von Anfang an für einen Menschen entscheiden. Laut dem von Carl Johnson verfassten Blogbeitrag führt der Agent täglich Tausende Gespräche. Die von ihm weitergeleiteten Interessenten werden mehr als doppelt so häufig zu Verkaufschancen wie mit dem bisherigen Formular und schließen rund fünf Tage schneller ab. Der Anteil der Gespräche, bei denen für den Abschluss ein Vertriebsmitarbeiter erforderlich ist, ist um etwa die Hälfte gesunken. Ein einziger Ingenieur entwickelte die erste Version innerhalb weniger Wochen; der Agent empfiehlt kleinen Teams häufig den Team-Tarif statt Enterprise, was Anthropic bewusst akzeptiert.
OpenAI kooperiert mit America’s SBDC und veröffentlicht einen Bericht über kleine Unternehmen
30. September — OpenAI kooperiert mit America’s SBDC, dem landesweiten Netzwerk der US-Zentren zur Förderung kleiner Unternehmen, das jährlich 1 Million Unternehmer unterstützt. In einer ersten Phase plant OpenAI, über das am 23. September als Pilot gestartete Community-Trainer-Programm der OpenAI Academy (Community Trainer Program) rund 150 Berater zu schulen. Diese sollen dreistündige Workshops in den SBDC-Netzwerken durchführen, mit dem Ziel, mindestens 1 000 kleine Unternehmen vor Ort zu erreichen. Am selben Tag liefert der Bericht „Kleine Unternehmen, mehr Möglichkeiten“ Zahlen zur Nutzung: In der Woche vom 9. bis 15. September verwendeten rund 4 Millionen Beschäftigte von Unternehmen mit weniger als 500 Mitarbeitern die Produkte von OpenAI, davon fast jeder Fünfte in einem Unternehmen mit weniger als 10 Beschäftigten. Im August machten agentische Ausgabe-Tokens, insbesondere jene von ChatGPT Work und Codex, zwei Drittel der Ausgabe-Tokens kleiner Unternehmen aus, gegenüber einem Drittel im April.
🔗 OpenAIs Blogbeitrag über kleine Unternehmen
Runway Ads: eine autonome Engine für Performance-Werbung
30. September — Runway stellt Runway Ads vor, das den kreativen Teil bezahlter Kampagnen vollständig übernimmt. Man verbindet ein Werbekonto und ein Brand Kit: Das auf Runway Agent basierende Tool erzeugt Video- und Bildanzeigen, veröffentlicht freigegebene Varianten auf Meta, Google und TikTok, wertet ihre Performance aus und richtet die nächste Welle an den Varianten aus, auf die die Werbeausgaben entfielen. Es lokalisiert jede Anzeige nach den vom Team festgelegten Regeln, einschließlich der eingeblendeten Texte, passt ihre Größe an jedes Format an, unterzieht sie einer automatischen Markenprüfung und hält die Budgetgrenzen ein. Die Freigabe durch einen Menschen ist standardmäßig aktiviert; die automatische Veröffentlichung lässt sich pro Kampagne oder Variantentyp freischalten.
| Interne Kennzahl von Runway, seit Juli | Im Beitrag veröffentlichtes Ergebnis |
|---|---|
| Anzeigen pro Woche | von 77 auf etwa 900 |
| Rendite der Werbeausgaben | verdoppelt |
| Conversion | etwa +34 %, stabile Klickrate |
| Kosten pro Abonnent | −41 % |
Runway Ads befindet sich derzeit im Pilotbetrieb bei ausgewählten Unternehmenskunden. Der Ankündigungs-Tweet verspricht eine breite Einführung in den kommenden Wochen und behauptet, das Tool habe seit Juli außerdem zu 100 Millionen Dollar zusätzlichem ARR (wiederkehrendem Jahresumsatz) beigetragen. Diese Zahl fehlt im Beitrag.
🔗 Beitrag zu Runway Ads · Tweet von @runwayml
ElevenLabs nach einem Rückkaufangebot über 300 Millionen Dollar mit 22 Milliarden Dollar bewertet
30. September — ElevenLabs hat ein Aktienrückkaufangebot (tender offer) über 300 Millionen Dollar für seine Beschäftigten abgeschlossen. Dabei wird das Unternehmen mit 22 Milliarden Dollar bewertet, doppelt so hoch wie bei der Serie D im Februar. Die Transaktion wird von Wellington und T. Rowe Price angeführt; EQT, Goldman Sachs, GIC, OTPP, Sapphire Ventures und BDT & MSD steigen neben bestehenden Investoren wie Andreessen Horowitz, Lightspeed und ICONIQ ein. Unternehmenskunden machen 55 % des Umsatzes aus: ElevenAgents verarbeitet mehr als 15 Millionen Gespräche pro Woche, dreimal so viele wie im Februar, und sein wiederkehrender Jahresumsatz hat sich in diesem Zeitraum mehr als verdreifacht. Laut einer Analyse seiner Kunden lösen Sprach-Agents Anfragen 31 % schneller als Chat-Agents. Das Unternehmen beschäftigt mehr als 800 Mitarbeiter, vier Jahre nach einer ersten Finanzierungsrunde mit einer Bewertung von 9 Millionen Dollar.
Vera Rubin NVL72 bei CoreWeave im Produktionsbetrieb, Cognition misst bis zu 4,8-mal höheren Durchsatz
30. September — Anlässlich der CoreWeave Fully Connected in San Francisco erläutert NVIDIA den Übergang von Vera Rubin NVL72 in den Produktionsbetrieb bei CoreWeave: Die Plattform mit dem Netzwerk Spectrum-X Ethernet 102.4T ist auf CoreWeave Cloud verfügbar, das seine ersten Produktionsracks bereits früher im Monat erhalten hat. Cognition, der Anbieter von Devin, ist der erste Kunde, der darauf Produktionsworkloads ausführt: Bei ersten Tests mit Aufgaben aus FrontierCode maß das Unternehmen für die Inferenz von SWE-2 einen bis zu 4,8-mal höheren Gesamtdurchsatz an Tokens als mit GB200 NVL72. CoreWeave wird auch die für Agents konzipierte CPU Vera anbieten: 128 CPUs und 11 264 Kerne pro Rack, genug für mehr als 11 000 gleichzeitig laufende isolierte Umgebungen, mit Agent-Sandboxes, die mehr als dreimal so schnell starten. Schließlich stellt CoreWeave CoreWeave Forge vor, das Weights & Biases, OpenPipe und marimo zusammenführt, um die Rückkopplung von der Produktion zum Training zu ermöglichen; sein serverloses Reinforcement Learning (serverless RL) soll 1,4-mal schneller sein und 40 % weniger kosten.
🔗 NVIDIA-Beitrag zu CoreWeave und Vera Rubin
Coding-Agents und Entwicklungstools: Claude Code 2.1.286, Zed 1.22.0, Gemini CLI, VS Code 1.140, HydraFusion und ein MCP-Server für gcloud
Claude Code 2.1.286: Lesezeichen in VS Code, begrenzte Wiederholungsversuche und ein eingeschränkter bare-Modus
30. September — Claude Code 2.1.286, veröffentlicht um 19:10 Uhr UTC, umfasst 88 Einträge, darunter 49 Fehlerbehebungen. Die Berechtigungsabfrage zeigt ihre Position an, wenn sich mehrere Anfragen stapeln („2 von 5“), und die VS Code-Erweiterung erhält Lesezeichen (bookmarks), um Antworten von Claude in einem Seitenpanel zu speichern, eine Fragen-Zeile mit den von Claude gestellten Fragen und den ausgewählten Antworten sowie Vorschauen der Optionen in den Fragekarten. Zwei Verhaltensänderungen sind wesentlich: Eine einzige Obergrenze gilt nun für die Wiederholungsversuche eines Modellaufrufs, also höchstens 14 Anfragen mit den Standardeinstellungen, und --bare verbindet nur noch die auf der Kommandozeile genannten MCP-Server, ohne Systemhinweise oder Hintergrundaufgaben. Falls ein Skill namens verify existiert, wird Claude angewiesen, ihn unmittelbar vor jedem Commit auszuführen, außer bei Dokumentation oder Tests, und Plugins lehnen npm-Quellen ab, die Git-Repositories oder Ordner sind. Wenn die API das Standardmodell ablehnt, versucht Claude Code es schließlich einmal mit dem Vorgängermodell derselben Stufe erneut, statt in jeder Runde zu scheitern.
🔗 Release Notes zu Claude Code 2.1.286
Zed 1.22.0: ein Modell pro Subagent
30. September — Zed veröffentlicht seine stabile Version 1.22.0 mit Schwerpunkt auf Subagents: Das Tool spawn_agent akzeptiert einen optionalen Parameter model, um einen Subagent mit einem anderen Modell als dem konfigurierten oder vom übergeordneten Agent geerbten zu starten, und die Karte jedes Subagents zeigt das verwendete Modell an. Subagents komprimieren außerdem ihren Kontext automatisch, wodurch sie laut Zed längere Aufgaben bewältigen können. Bei den Modellen wird GPT-6.1 Sol per BYOK mit einem OpenAI-API-Schlüssel verfügbar, Grok 4.7 wird als empfohlenes Modell bei SuperGrok und xAI stabil, und die Modellliste von OpenCode Zen und Go wird dynamisch abgerufen. Die Version behebt ein Speicherleck von etwa 2 MB pro abgeschlossenem Befehl im Terminal und ändert ein Tastenkürzel: Das aktive Dock wird auf allen Plattformen nun mit ctrl-alt-w geschlossen. Insgesamt gibt es 18 Neuerungen und 37 Fehlerbehebungen.
Gemini CLI: v0.62.0 wird stabil, und eine Preview führt Pläne ohne Bestätigung aus
29. September — Gemini CLI veröffentlicht am Abend zwei Versionen (UTC). v0.62.0 wird um 21:17 Uhr stabil: Seine 19 Einträge greifen die vom 16. bis 24. September vorgestellten Preview- und Nightly-Versionen auf (strukturierte Titel für MCP-Tool-Aufrufe, Beibehaltung des OAuth-Aktualisierungstokens (refresh token), Gemini 3.8 Flash und 3.5 Flash Lite). Die Neuerung steckt in der um 20:58 Uhr veröffentlichten Preview v0.63.0-preview.0: Im nicht interaktiven Modus erstellt und führt der Agent seinen Plan nun aus, ohne auf eine Bestätigung zu warten (PR 29539), während die Anweisungen des Plan Mode ihn zuvor lediglich mit einer Nachricht zur Abstimmung antworten ließen, ohne einen einzigen Tool-Aufruf. Ein maxChars-Limit von 0 oder weniger deaktiviert außerdem das Abschneiden von Tool-Ausgaben (PR 29542). Die Nightly vom 30. September eröffnet die Serie 0.64.0: Im ACP-Modus meldet das CLI endlich die standardmäßigen Nutzungsdaten, während Clients wie Zed oder OpenHands die Abrechnung laut PR 29549 zuvor um etwa das Dreifache überschätzten.
🔗 Gemini CLI v0.63.0-preview.0 · Gemini CLI v0.62.0
VS Code 1.140 übernimmt den Copilot Harness
30. September — Visual Studio Code 1.140 erscheint als stabile Version mit dem Copilot Harness (Copilot harness): Er basiert auf dem Copilot SDK, verleiht dem Agent von VS Code das Verhalten und die Fähigkeiten der GitHub Copilot App und von Copilot CLI und läuft in einem eigenen Host-Prozess auf Grundlage des Agent Host Protocol. Dadurch kann dieselbe Sitzung aus mehreren Fenstern geöffnet werden; die Release Notes weisen darauf hin, dass er für einige Nutzer möglicherweise bereits standardmäßig ausgewählt ist. Experimentelle Sitzungen mit mehreren Ordnern geben jedem Chat einen eigenen Ordner oder Worktree, und der Agent kann eine Sitzung an einen entfernten Host delegieren, der anhand von System, Arbeitsspeicher, CPU-Anzahl und Modell ausgewählt wird. Für Unternehmen kommen drei Steuerungsmöglichkeiten hinzu: eine Erklärung der vom Administrator geforderten Mindestversionen im Chat, eine über eine verwaltete Einstellung festgelegte Standardstufe des Auto-Modus (autoTier) und das Hinzufügen der Nutzeridentität zu den OpenTelemetry-Daten von Copilot, wobei diese Option standardmäßig deaktiviert ist.
🔗 Release Notes zu VS Code 1.140
HydraFusion kommt in VS Code und die GitHub Copilot App
30. September — GitHub erweitert HydraFusion, die am 4. September in Copilot CLI eingeführte Orchestrierung mehrerer Modelle, auf VS Code (ab Version 1.140 oder Insiders) und die GitHub Copilot App, weiterhin als Research Preview. HydraFusion lässt sich in der Auswahl wie ein Modell auswählen, ist aber selbst keines: Es behandelt die Wahl des Workflows als Optimierungsproblem und entscheidet sich für eines von drei Verfahren. Im Single-Modus löst ein einziges Modell die Aufgabe; im Cascade-Modus erstellt ein effizientes Modell einen Entwurf, und eine Qualitätsprüfung akzeptiert das Ergebnis oder eskaliert an ein leistungsfähigeres Modell; im Critique-Modus prüft ein Kritiker mit ausschließlich lesendem Zugriff aus einer anderen Modellfamilie den Entwurf, anschließend überarbeitet ihn der Verfasser einmal. Während der Auto-Modus pro Anfrage ein Modell auswählt, koordiniert HydraFusion mehrere Modelle innerhalb derselben Runde. Es steht in Copilot Pro, Pro+, Business und Enterprise zur Verfügung, wobei ein Administrator die Previews bei Business und Enterprise aktivieren muss; GitHub veröffentlicht keine neuen Zahlen.
🔗 HydraFusion in VS Code und der GitHub Copilot App
Google Cloud stellt einen entfernten MCP-Server, der gcloud und bq ausführt, als Preview bereit
Google Cloud ergänzt seine verwalteten entfernten MCP-Server um den Google Cloud CLI remote MCP server als öffentliche Preview. Er bündelt Hunderte Befehle der Kommandozeilentools gcloud und bq (BigQuery) hinter zwei MCP-Tools, run_gcloud_command und run_bq_command. Google begründet die Wahl der Kommandozeile mit zwei Argumenten: Ein Befehl kapselt mehrstufige Vorgänge, die bei Nutzung der API eigens orchestriert werden müssten, und die Modelle wurden umfassend mit der öffentlichen Dokumentation dieser Befehle trainiert. Der entfernte Server erspart die Installation des CLI in der Umgebung des Agents und macht diese Vorgänge damit für im Web gehostete Agent-Plattformen wie Gemini Enterprise zugänglich. Die Befehle laufen in einer isolierten Sandbox hinter einem Proxy mit eingeschränktem Netzwerkzugriff und ohne implizit verfügbare Zugangsdaten (ambient credentials), jeweils mit den IAM-Rechten der aufrufenden Identität, die über Agent Identity oder OAuth 2.0 authentifiziert wird; Model Armor kann Prompts und Antworten filtern, und jeder Aufruf kann in den Audit-Logs protokolliert werden. Der Server selbst wird nicht berechnet: Kosten entstehen nur für die erstellten Ressourcen und eventuelle Datenübertragungen.
🔗 Statten Sie Ihre Agents mit dem Google Cloud CLI remote MCP server aus (Google Cloud Blog)
Kurzmeldungen
- Codex CLI 0.159.2 — Diese am 29. September um 23:57 Uhr UTC veröffentlichte Version enthält nur einen rückportierten Fix: Unter Windows flackern Konsolenfenster nicht mehr, wenn Codex Hintergrundprozesse oder Befehle in seiner Sandbox startet. 🔗 Quelle
- Plaid in Amp — Die Modi von Amp, die GPT-6 Astra verwenden, erhalten Plaid auf Basis der ultraschnellen Stufe von OpenAI: bis zu 6-mal schnellere Anfragen bei 6-fachen Kosten pro Token, ausschließlich für die von Amp bereitgestellte Inferenz; Subagenten bleiben bei fast oder standard, und Amp veröffentlicht keine Preise. 🔗 Quelle
- Warp und Factories as Code — Warp stellt die Konfiguration seiner Softwarefabriken als „Terraform für Agenten“ vor: Ein Repository beschreibt Agenten, Automatisierungen, Zugriffe und Messungen. Das Format factory.yaml stammt von Ende August; der interaktive Leitfaden erläutert den föderierten Zugriff auf AWS oder GCP, Webhooks und Integrationen mit Slack, Linear oder Jira. 🔗 Thread von Warp · 🔗 Konfigurationsleitfaden
- Devin bei Crosby — In einer Fallstudie von Cognition überträgt die New Yorker Anwaltskanzlei Crosby, mit rund zwölf Ingenieuren für mehr als 50 Anwälte, Devin die Erstreaktion auf Vorfälle: 20 bis 40 Bugs und Warnmeldungen werden täglich geprüft, die meisten in etwa 5 Minuten, und das Sentry-Meldungsrauschen sinkt um mindestens 50 %. 🔗 Quelle
- claude.dev — Anthropic stellt claude.dev offiziell als Anlaufstelle für Entwickler vor, die mit Claude arbeiten: technische Vertiefungen, Leitfäden zu Claude Code und zur API, die Rubriken Agents, Engineering, Playbooks und Skills sowie eine Terminal-Seite als versteckte Überraschung. Beiträge der Website wurden bereits seit dem 22. September geteilt. 🔗 Quelle
- Bearbeitbare ChatGPT Sites — Laut den Release Notes vom 29. September lässt sich eine veröffentlichte Site mit Edit site bearbeiten und unter Plus und Pro über Automations planen; in Enterprise können private Sites verbundene Apps nutzen, mit der standardmäßig deaktivierten Einstellung Allow use in Sites pro Plugin. 🔗 Release Notes von ChatGPT · 🔗 Release Notes für Enterprise und Edu
- Kimi Work 3.2.15 — Die Version vom 30. September ermöglicht die gemeinsame Bearbeitung von Notion- und Feishu-Dokumenten durch Menschen und KI im integrierten Browser, klappt den Ablauf des Agenten standardmäßig ein und behebt Dateibeschädigungen bei der gleichzeitigen Bearbeitung einer PPT. 🔗 Quelle
- Cue verwaltet die Finanzen — Die mit Manus 2.0 eingeführte App für persönliche Agenten verfolgt jetzt Abonnements und Ausgabentrends und versetzt Bankkonten über Plaid in den Autopilot-Modus; Länder, Tarif und Bedingungen werden nicht genannt. 🔗 Quelle
- GPT-6.1 Sol in Genspark — Genspark stellt GPT-6.1 Sol am Tag nach dessen Einführung in AI Chat, Code Agent und Claw bereit und übernimmt dabei die Argumentation von OpenAI: eine Intelligenz nahe an Astra zu einem Fünftel seines API-Preises. Angaben zum Tarif oder zu den Kosten in Credits fehlen. 🔗 Quelle
- Qwen3.8-27B-pi — Thomas Kim veröffentlicht unter Apache-2.0 ein Fine-Tuning von Qwen3.8-27B für den Pi-Harness, das die Aufwandsstufen wieder in die richtige Reihenfolge bringt: Auf Terminal-Bench 2.1 erreicht medium das Niveau des Basismodells mit xhigh (67 Aufgaben von 89), bei etwa 41 % weniger Ausgabe-Tokens. 🔗 Quelle
- Qwen3.8-27B bei Nebius — Qwen berichtet über die am 28. September angekündigte Verfügbarkeit seines dichten Modells mit 27 Milliarden Parametern auf Nebius Token Factory für Code, Recherche und agentische Workflows; Preise und Durchsatz werden nicht genannt. 🔗 Quelle
- Bekko System One v0 — Yuichi Tateno veröffentlicht drei Entscheidungsmodelle mit 17M, 68M und 400M Parametern, von denen die beiden kleineren im Browser laufen, sowie den Benchmark S1MB: Das 400M-Modell erreicht 50,60 gegenüber 59,59 bei Jev 1.13, bei der Generalisierung jedoch 54,48 gegenüber 96,27. 🔗 Quelle
- ZooWork Instinct Tuned 4B — SRP veröffentlicht unter Apache-2.0 ein auf Qwen3.5-4B basierendes Entscheidungsmodell mit 4 Milliarden Parametern, das Optionen in einem Durchlauf ohne Decoding bewertet: 198 von 231 (85,71 %) bei den öffentlichen Aufgaben von JevBench, die während der Entwicklung verwendet wurden, wie die Autoren klarstellen. 🔗 Quelle
- Transformers v5.18.0 — Hugging Face ergänzt vier Architekturen, Nemotron 3 Diarization und NemotronH Omni von NVIDIA, HyperCLOVAX Vision V2 von NAVER sowie GTE, und weist auf sechs Breaking Changes hin. 🔗 Quelle
- TaskSmith — Adithya S K, der bei Hugging Face an Umgebungen für Reinforcement Learning arbeitet, veröffentlicht einen Orchestrator, der aus einer Pull Request eine überprüfbare RL-Umgebung macht: 50 Umgebungen aus TRL, PEFT, Accelerate, Diffusers und Transformers, bereitgestellt als Harbor-Aufgaben. 🔗 Quelle
- TraceML 0.4.1 — Das Open-Source-Tool misst jetzt die gesamte Gruppe eines Optimizer-Updates; bei ResNet-50 auf einer T4-GPU sinkt die Wartezeit auf Daten nach Anpassung des Ladevorgangs von 23 % des Schritts auf weniger als 2 ms, bei einem medianen Overhead von 0,35 %. 🔗 Quelle
- Transformer mit Schleifen — Bei einem Toy-Modell mit 54 106 Parametern und 260 überprüfbaren Fällen lernt eine Schleife bei gleichem Budget von 80 Blockdurchläufen alle 260 Fälle, zwei Schleifen im Mittel 125,3 und acht 37,0: Mehr Durchläufe machten das Training nicht ressourcensparender. 🔗 Quelle
- Eine Evaluation, die Nein sagen kann — Das Tutorial von Eric Mey zeigt anhand der Sentimentanalyse von Filmkritiken (SST-2) eine Evaluation, die ein Modell ablehnt, obwohl es auf zurückgehaltenen Daten um 7 Punkte besser abschneidet, weil sich ein kritisches Verhalten verschlechtert; die Skripte laufen in weniger als einer Minute auf einer CPU. 🔗 Quelle
- 10 000 synthetische Versicherte — Intelligent Actuaries veröffentlicht unter CC-BY-4.0 eine synthetische Studie zu Storno und Rückkäufen von Lebensversicherungen: 10 000 fiktive Versicherte in zehn Märkten, entsprechend 27 692 Datensätzen zu Policenjahren 2023-2025 im Format der SOA-LIMRA-Erhebung. 🔗 Quelle
- cuObject und SCADA Server SDK — NVIDIA macht die cuObject-Bibliotheken für den Zugriff auf Objektspeicher per RDMA ohne Umweg über den CPU-Speicher allgemein verfügbar und führt das SCADA Server SDK ein, dessen Prototyp IBM mit Storage Scale entwickelt hat, im Rahmen einer Storage-Next-Initiative mit mehr als 40 Akteuren. 🔗 Quelle
- NeMo Relay und Hermes Agent — Ein NVIDIA-Tutorial, das Teknium von Nous Research mitverfasst hat, zeichnet die Abläufe eines Hermes-Agenten auf: Über 108 Ausführungen steigern Tool-Fixes die Zahl der erfolgreichen Aufgaben von Qwen3 Coder 30B von 19 auf 22 von 27, allerdings mit 4,9 statt 3,8 Modellaufrufen. 🔗 Quelle
- OpenShell für OpenClaw Enterprise — NVIDIA bietet seine Open-Source-Umgebung OpenShell zur Steuerung der Agenten von OpenClaw Enterprise an, einer Open-Source-Control-Plane für persistente Agenten, die am Vortag von der OpenClaw-Stiftung gemeinsam mit Red Hat, NVIDIA und OpenAI angekündigt wurde. 🔗 Quelle
- Testversionen von GitHub Advanced Security — Kunden von GitHub Team können selbst eine Testversion von GitHub Code Security und GitHub Secret Protection starten, über die Overview-Seite der Organisation, die Abrechnungsseite oder ein Risk Assessment; die Dauer wird nicht angegeben. 🔗 Quelle
- GHE.com und X25519 — Ab dem 7. Oktober 2026 lehnt GitHub Enterprise Cloud mit Datenresidenz TLS-Clients ab, die für die Schlüsselaushandlung ausschließlich X25519 anbieten; P-256 und P-384 werden weiterhin unterstützt, und SSH ist nicht betroffen. 🔗 Quelle
- Zwei Fallstudien bei Runway — Die französische Getränkemarke Bonjour hat mit Runway mehr als 500 Werbevarianten produziert und mehr als 50 000 Euro an Produktionsmitteln umverteilt; die World Juggling Federation hat einer einzigen Person die visuelle Gestaltung einer einstündigen Sendung für ESPN übertragen. 🔗 Bonjour · 🔗 World Juggling Federation
- Ad Variants bei Luma — Luma stellt eine Funktion vor, die eine fertige Werbeanzeige innerhalb derselben Kampagne für mehrere Größen und Märkte anpasst, ohne Angaben zu Preis, Tarif oder Einführungsdatum und ohne Blogbeitrag. 🔗 Quelle
- Microduck in Produktion — Pollen Robotics kündigt an, dass 10 950 Microduck, sein kleiner zweibeiniger Roboter für 399 Dollar, der in Simulation trainiert wird und einen Open-Source-Stack für Reinforcement Learning nutzt, zwischen dem 10. Dezember und dem 10. Januar in wöchentlichen Chargen vom Band laufen werden. 🔗 Quelle
- Cognition stellt ein — Der Anbieter von Devin begrüßt Chris Degnan, den ehemaligen CRO von Snowflake, als Chief Revenue Officer, einen Tag nach dem Eintritt von Alex Stamos als Chief Information Security Officer (CISO). 🔗 Chris Degnan · 🔗 Alex Stamos
- Claude Founder House — Anthropic veranstaltet Gründertage in San Francisco während der SF Tech Week (vom 6. bis 8. Oktober in der Terra Gallery) sowie am 14. Oktober in Stockholm, mit Vorträgen, Workshops und Terminen mit seinem Applied AI-Team. 🔗 Quelle
- AI Engineer Paris — Mistral zieht Bilanz der Veranstaltung, die in der Vorwoche in Station F stattfand: mehr als 900 Teilnehmer, 60 Referenten, 57 Vorträge und 22 Partner, ohne Produktankündigung. 🔗 Quelle
- NVIDIA-Promotionsstipendien — Bewerbungen für das Graduate Fellowship Program 2027-2028 sind bis zum 30. Oktober 2026 möglich, mit bis zu 60 000 Dollar pro Doktorand; seit 2002 wurden mehr als 220 Stipendien vergeben. 🔗 Quelle
Was das bedeutet
Sicherheit bestimmt inzwischen den Zeitplan für Frontier-Modelle. Gemini 4 Argon setzt die Logik des Fairwind Program fort: Vertrauenswürdige Cyberverteidiger erhalten es zuerst, ohne Schutzmechanismen für Cybersicherheit, und die anderen folgen „so bald wie möglich“, ohne konkretes Datum, während die Schutzmaßnahmen verstärkt werden. Am selben Tag zeigt OpenAI die andere Seite des Problems: Geschützt werden muss inzwischen neben dem Modell auch sein Reasoning. Ob sie nun auf einen einzigen Akteur zurückgeht oder nicht: Die Kampagne, deren Kern OpenAI Personen mit Verbindungen zu Moonshot AI zuschreibt, macht die Reasoning-Trace zu einem schützenswerten Gut, mit technischen Gegenmaßnahmen und einem Informationsaustausch zwischen Laboren und Regierungen.
Ein großer Teil der heutigen Zahlen stammt aus Messungen, die von den Ankündigenden selbst entwickelt oder durchgeführt wurden. Cohere bewertet Embed 5 mit einer Metrik, die es am selben Tag veröffentlicht, und warnt selbst davor, dass seine Modelle nach der bisherigen Metrik schlechter erscheinen könnten; HeyGen stützt sich auf ein internes Elo, Hunmin auf ein eigenes Protokoll mit nur einer Ausführung für die Agenten-Benchmarks, und bei Reality Check hat der Veranstalter die Modelle selbst durch Fine-Tuning angepasst. Perplexity hingegen lässt sein Modell blind auf einem privaten Benchmark von turbopuffer bewerten, und sowohl das Open TTS Leaderboard als auch AURORA ersetzen Abstimmungen oder maschinelle Übersetzung durch überprüfbare Aufgaben und Messungen. Bevor man zwei Scores vergleicht, muss man prüfen, wer sie ermittelt hat.
Die Generierung von Bildern und Videos wird zunehmend nach ihrem praktischen Einsatz und ihren Kosten beurteilt. Ideogram 4.5 verspricht kein schöneres Bild, sondern ein Bild, das wiederholte Nachbearbeitungen verträgt; HeyGen Video wird pro Sekunde abgerechnet, ist günstiger als alle Modelle in seiner Preistabelle und zeigt, dass ein Basismodell wie MiniMax H3 spezialisierte Varianten hervorbringen kann, von HeyGen bis Creatify. Runway Ads schließt die Prozesskette bis hin zu den Werbeausgaben, und die Bewertung von ElevenLabs, die sich seit Februar verdoppelt hat, beruht auf der Nachfrage von Unternehmen nach Konversationsagenten.
Für Entwickler wird der Harness zu einem eigenständigen Produkt, das vom Modell getrennt ist. VS Code übernimmt den Harness von Copilot, um seinen Agenten mit der App und dem CLI in Einklang zu bringen, HydraFusion koordiniert mehrere Modelle innerhalb desselben Turns, Zed lässt den Agenten für jeden Subagenten ein Modell auswählen, und Manus öffnet seinen Harness für API-Schlüssel von Drittanbietern. Gemini CLI führt seine Pläne jetzt im nicht interaktiven Modus ohne menschliches Eingreifen aus, Claude Code schränkt --bare für die Verwendung in Skripten stärker ein, und Google Cloud stellt Agenten gcloud und bq in einer Sandbox mit den IAM-Berechtigungen des Aufrufenden bereit. Die Nachfrage zeigt sich bis in die Infrastruktur: Der erste Kunde, der Vera Rubin NVL72 bei CoreWeave produktiv nutzt, ist Cognition, der Anbieter von Devin.
Quellen
- Gemini 4 Argon: unsere nächste Ära der Frontier-Intelligenz (Google-Blog)
- Gemini-Seite von Google DeepMind
- Ankündigung von Gemini 4 Argon durch @GoogleDeepMind
- Beitrag von OpenAI zur Destillationskampagne
- Diebstahl von Reasoning-Traces aus proprietären LLM-APIs (arXiv)
- Beitrag von Cohere zu Embed 5
- Ankündigung von Embed 5 durch @cohere
- Beitrag von Cohere zu RCP-nDCG@10
- Code und Daten von RCP-nDCG auf GitHub
- Beitrag von Perplexity Research zu kontextuellem Embedding
- pplx-embed-v2-context-9b-preview auf Hugging Face
- Ankündigung von Ideogram 4.5 durch @ideogram_ai
- Modellseite von Ideogram 4.5
- HeyGen Video-Katalog
- Ankündigung von HeyGen Video durch @HeyGen
- Skills in der Gemini-App (Google-Blog)
- Manus Flex vorgestellt
- Thread von @bot zu Grok Bot und Cursor
- Praxis-1 auf Runway Research
- Tweet von Ai2 zu MolmoAct 2 und Reality Check
- Reality Check-Rangliste von Poke & Wiggle
- Projektseite von Physis-Lang
- Ankündigung von Physis-Lang durch @NVIDIAAI
- Beitrag zu Hunmin-CUA
- Modellgewichte von Hunmin-397B-A17B-CUA
- Beitrag zu JEV-27B-VL
- Beitrag zum Open TTS Leaderboard
- Open TTS Leaderboard auf Hugging Face
- Beitrag von LILT zu AURORA
- AURORA-Rangliste
- Claude for Government ist jetzt allgemein verfügbar
- Wie das Vertriebsteam von Anthropic mit Claude Managed Agents den Inbound-Vertrieb neu aufgebaut hat
- Beitrag von OpenAI zu kleinen Unternehmen
- Beitrag zu Runway Ads
- Tweet von @runwayml zu Runway Ads
- Beitrag von ElevenLabs zum Rückkaufangebot
- Beitrag von NVIDIA zu CoreWeave und Vera Rubin
- Release Notes von Claude Code 2.1.286
- Release Notes von Zed 1.22.0
- Gemini CLI v0.63.0-preview.0
- Gemini CLI v0.62.0
- Release Notes von VS Code 1.140
- HydraFusion in VS Code und der GitHub Copilot App
- Remote-MCP-Server von Google Cloud CLI (Google Cloud-Blog)
- Codex CLI 0.159.2
- Plaid Speed in Amp
- Thread von @warpdotdev zu Factories as Code
- Factories as Code, Warp
- Fallstudie Crosby, Devin
- Vorstellung von claude.dev durch @ClaudeDevs
- Release Notes von ChatGPT
- Release Notes von ChatGPT Enterprise und Edu
- Release Notes von Kimi Work
- Cue und die Finanzverwaltung
- GPT-6.1 Sol in Genspark
- Qwen3.8-27B-pi
- Qwen3.8-27B auf Nebius Token Factory
- Bekko System One v0
- ZooWork Instinct Tuned 4B
- Transformers v5.18.0
- TaskSmith
- TraceML 0.4.1 und der Trainer von Transformers
- Transformer mit Schleifen trainieren
- Eine Evaluation schreiben, die Nein sagen kann
- Zehntausend synthetische Versicherte
- cuObject und SCADA Server SDK
- NeMo Relay und Hermes Agent
- OpenShell für OpenClaw Enterprise
- Testversionen von GitHub Advanced Security für GitHub Team
- Ende der auf X25519 beschränkten TLS-Unterstützung auf GHE.com
- Fallstudie Bonjour, Runway
- Fallstudie World Juggling Federation, Runway
- Ad Variants in Luma
- Microduck, Pollen Robotics
- Chris Degnan bei Cognition
- Alex Stamos bei Cognition
- Claude Founder House
- Bilanz von AI Engineer Paris durch @MistralDevs
- Graduate Fellowships von NVIDIA