ai-powered-markdown-translatorArtikel vertaald van het Frans naar het Nederlands met gpt-6.1-sol.
Woensdag 30 september kondigt Google Gemini 4 Argon aan, een frontiermodel dat eerst wordt uitgerold naar vertrouwde cyberverdedigers van het Fairwind Program, met een uitvoerlimiet die is verhoogd tot 1 miljoen tokens. OpenAI zegt een gecoördineerde campagne te hebben verijdeld om de afgeschermde redenering van zijn modellen te extraheren, en schrijft de kern daarvan toe aan personen die verbonden zijn aan Moonshot AI. Cohere lanceert Embed 5 met een eigen evaluatiemethode, Ideogram 4.5 belooft opeenvolgende bewerkingen zonder artefacten en HeyGen brengt een videomodel uit dat is gebouwd op MiniMax H3; voor ontwikkelaars verschijnen Claude Code 2.1.286, Zed 1.22.0 en VS Code 1.140 op dezelfde dag.
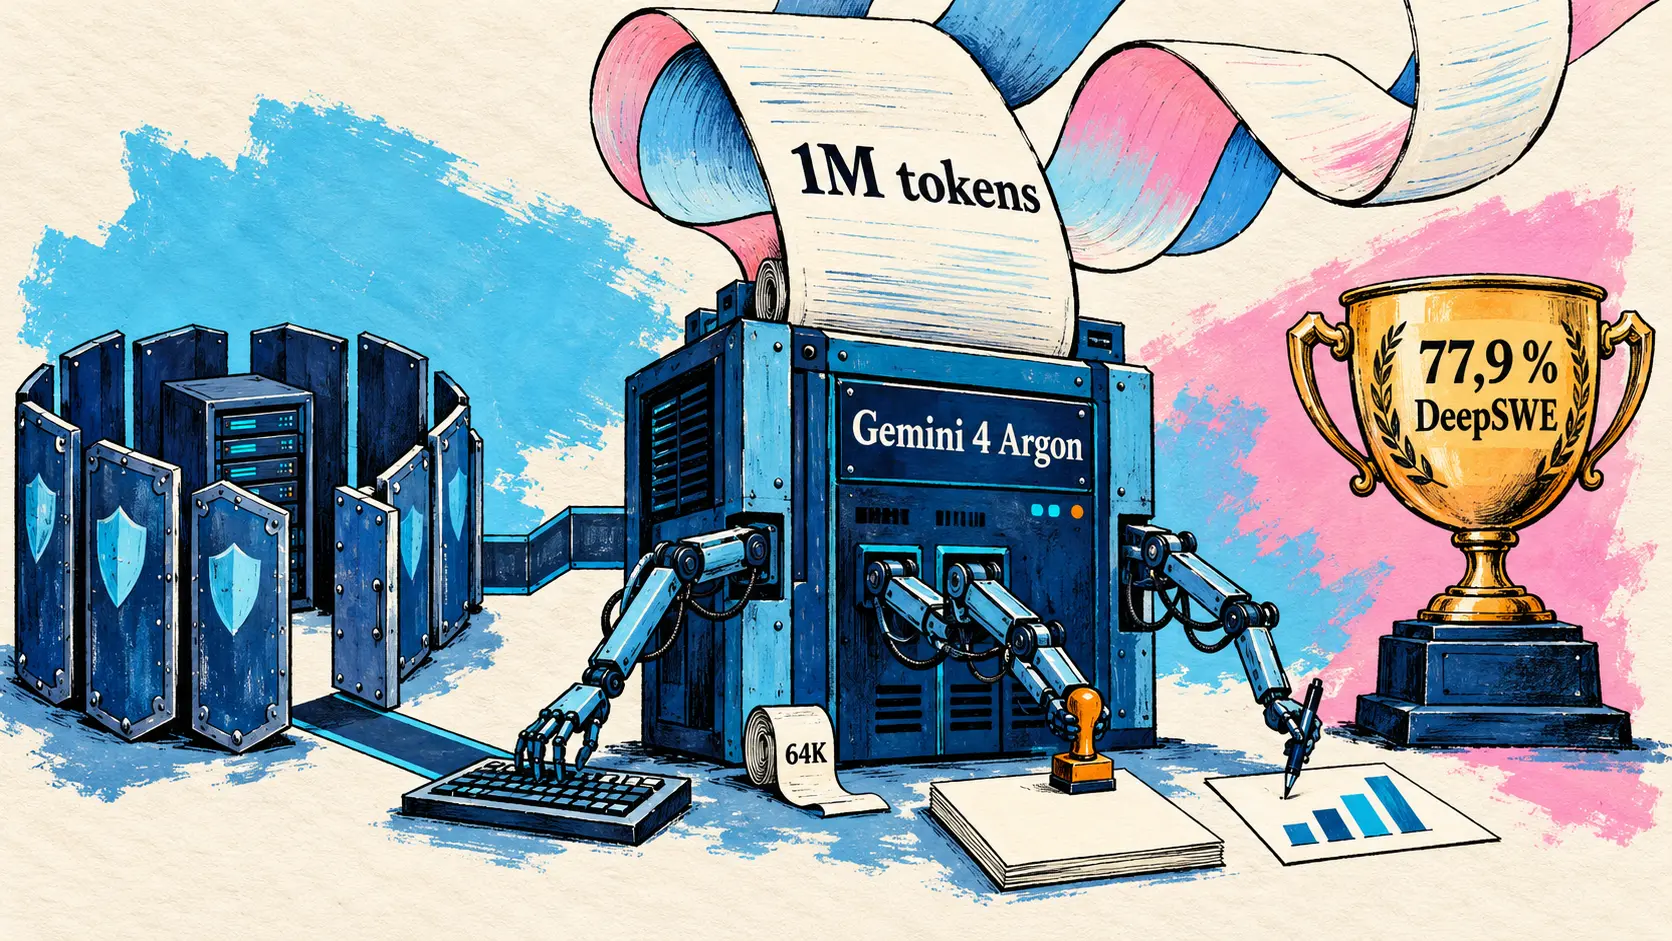
Gemini 4 Argon: het nieuwe frontiermodel van Google, eerst voor cyberverdedigers
30 september — Google kondigt Gemini 4 Argon aan, zijn nieuwe frontiermodel, in een blogbericht van Koray Kavukcuoglu, senior vicepresident van Google DeepMind en hoofdarchitect voor AI bij Google (Chief AI Architect). Argon is ontworpen om diepgaand redeneren te ondersteunen bij lange, complexe workflows (long-horizon workflows), op drie gebieden: software engineering in de praktijk, kenniswerk in bedrijven (juridische zaken, financiën) en cyberverdediging.
Het model is nog niet beschikbaar voor het publiek. Het wordt eerst uitgerold naar een groep vertrouwde cyberverdedigers van het Fairwind Program, dat op 2 september werd gelanceerd met Gemini 3.8 Flash Cyber. Zij krijgen het, net als de interne teams van Google, zonder cyberwaarborgen (cyber guardrails). Ontwikkelaars, bedrijven en het grote publiek volgen « zo snel mogelijk », te beginnen met betalende API-klanten en abonnees van Google AI Ultra, zonder aangekondigde datum. Tot die tijd versterkt Google de weigering van schadelijke verzoeken op het gebied van cyber en NRBC, het toezicht op de gedachtegang en de handelingen van het model, en isoleert het trainingen en evaluaties met een hoog risico in afgesloten sandboxes; het bedrijf zegt ook deel te nemen aan het vrijwillige proces van de Amerikaanse overheid voor toegang tot modellen vóór hun release.
Introducing Gemini 4 Argon – our new frontier model. It’s built for complex workflows across coding, enterprise knowledge work, and cybersecurity defense – rolling out today to a set of trusted testers through our Fairwind Program.
🇳🇱 Dit is Gemini 4 Argon, ons nieuwe frontiermodel. Het is ontworpen voor complexe workflows op het gebied van programmeren, kenniswerk in bedrijven en cyberverdediging, en wordt vanaf vandaag via ons Fairwind Program uitgerold naar een groep vertrouwde testers. — @GoogleDeepMind op X
De prijs staat al vast: als introductieprijs geldt 2 dollar per miljoen invoertokens en 10 dollar voor uitvoer, hetzelfde tarief als GPT-6.1 Sol dat de dag ervoor werd gelanceerd, en daarna 4 en 20 dollar aan het einde van een periode waarvan de duur niet wordt vermeld; gecachete invoer kost 95 % minder dan gewone invoer. De uitvoerlimiet stijgt van 64K naar 1 miljoen tokens, volgens Google de hoogste in de sector: het model kan binnen één traject honderdduizenden tokens produceren om een moeilijk probleem op te lossen.
| Prijs per miljoen tokens | Introductietarief | Tarief na de introductieperiode |
|---|---|---|
| Invoer | 2 dollars | 4 dollars |
| Uitvoer | 10 dollars | 20 dollars |
De pagina van Google DeepMind vergelijkt Argon op negentien rijen met GPT-6 Astra, Claude Fable 5.1 en Claude Opus 5.5. Argon behaalt op 13 daarvan de beste score, deelt de eerste plaats met GPT-6 Astra op CWE-bench v1 (68 %) en wordt op 5 verslagen. Agentische code is het gebied waar de concurrentie het sterkst is: Argon staat bovenaan op DeepSWE v1.1 (77,9 %) en Vibe Code Bench, maar eindigt als laatste van de vier op FrontierSWE v2 en Terminal-bench 4.0. De voorsprong is duidelijk bij kenniswerk, met name op de Legal Agent Benchmark van Harvey (19,6 % tegenover hoogstens 6,7 % voor de drie andere), en bij lange contexten tussen 256K en 1M tokens. De beste score op elke rij staat vetgedrukt.
| Geëvalueerde benchmark (domein) | Gemini 4 Argon | GPT-6 Astra | Claude Fable 5.1 | Claude Opus 5.5 |
|---|---|---|---|---|
| Vals Index (kenniswerk) | 68,9 % | 63,1 % | 65,8 % | 67,0 % |
| AutomationBench (kenniswerk) | 51,3 % | 41,4 % | 31,4 % | 42,5 % |
| Vals Finance Agent v2 (kenniswerk) | 65,4 % | 53,5 % | 58,9 % | 58,6 % |
| Legal Agent Benchmark van Harvey (kenniswerk) | 19,6 % | 5,4 % | 6,7 % | 3,8 % |
| DeepSWE v1.1 (agentische code) | 77,9 % | 74,1 % | 67,4 % | 74,2 % |
| FrontierSWE v2 (agentische code) | 55,0 % | 65,5 % | 56,3 % | 62,3 % |
| Vibe Code Bench (agentische code) | 91,9 % | 89,6 % | 90,3 % | 90,3 % |
| Terminal-bench 4.0 (agentische code) | 57,4 % | 58,2 % | 57,9 % | 66,4 % |
| PostTrainBench (ML-engineering) | 45,3 % | 44,3 % | 40,2 % | 49,3 % |
| Terminal-Bench Science 0.1 (wetenschappen en wiskunde) | 57,6 % | 68,1 % | 52,6 % | 63,3 % |
| LABBench 2 (wetenschappen en wiskunde) | 88,8 % | 85,4 % | 68,6 % | 73,1 % |
| RiemannBench (wetenschappen en wiskunde) | 76,0 % | 72,0 % | 65,6 % | 69,6 % |
| GraphWalks BFS tot 128K (lange context, F1) | 99,7 % | 98,7 % | 91,4 % | 90,6 % |
| GraphWalks BFS van 256K tot 1M (lange context, F1) | 84,2 % | 71,8 % | 65,0 % | 66,8 % |
| Agent’s Last Exam (computergebruik) | 39,5 % | 34,2 % | — | 38,2 % |
| OSWorld-2.0, offline deelverzameling, gedeeltelijke score (computergebruik) | 69,2 % | 72,6 % | — | — |
| Chartography (multimodaal begrip) | 71,6 % | 71,0 % | 46,2 % | 66,3 % |
| LVBench (multimodaal begrip) | 91,7 % | 87,5 % | 79,7 % | 83,7 % |
| CWE-bench v1 (cybersecurity) | 68,0 % | 68,0 % | 58,0 % | 67,0 % |
Bij Google gebruiken duizenden medewerkers het al. In libgav1, de open source videodecoder van Google, hebben Argon-agents 32 000 regels SIMD-code van een bestaande Rust-port vervangen door veilig Rust: de resulterende decoder is 2,7 keer sneller dan die port, met identieke videouitvoer. Andere agents hebben geheugenoptimalisaties voor datacenters voorbereid die na uitrol meer dan 300 TiB moeten vrijmaken. Op het gebied van cybersecurity gebruikt Wiz het in zijn initiatief Scan for Good: Argon ontdekte daarin een kritieke kwetsbaarheid in zorgsoftware die door ziekenhuizen over de hele wereld wordt gebruikt. Die kwetsbaarheid stelde gevoelige persoonsgegevens bloot en was door eerdere frontiermodellen gemist.
🔗 Gemini 4 Argon: ons volgende tijdperk van grensverleggende intelligentie (Google-blog) 🔗 Gemini-pagina van Google DeepMind en benchmarktabel
OpenAI zegt een distillatiecampagne te hebben verijdeld en schrijft de kern ervan toe aan personen die verbonden zijn aan Moonshot AI
30 september — In een bericht in zijn rubriek Security zegt OpenAI een gecoördineerde campagne te hebben ontdekt en vervolgens geneutraliseerd die erop gericht was de afgeschermde redenering (protected reasoning) van zijn modellen te extraheren, oftewel het interne spoor dat een model produceert om aan een taak te werken. Het bedrijf ziet dit als adversariële distillatie (adversarial distillation): het systematische en ongeautoriseerde gebruik van de uitvoer of redenering van een model om een ander model te trainen, te reproduceren of te verbeteren.
Volgens OpenAI hebben de uitvoerders geen encryptie gekraakt, geen database gecompromitteerd en geen rechtstreekse toegang gekregen tot opgeslagen gesprekken van gebruikers. Ze manipuleerden de uitwisselingen om de afgeschermde redenering in een zichtbare vorm te laten terugkeren, bijvoorbeeld door de versleutelde redenering uit een gesprek te kopiëren en een model in een ander gesprek te vragen die te ontcijferen en uit te schrijven. Onafhankelijke onderzoekers hadden via responsible disclosure vergelijkbare kwetsbaarheden gemeld, beschreven in het artikel « Redeneersporen stelen uit API’s van propriëtaire LLM’s », dat op 10 augustus op arXiv werd ingediend; OpenAI bevestigt dat deze aanvalsroutes daadwerkelijk bestonden.
| Fase van de campagne | Datum of omvang vastgesteld door OpenAI |
|---|---|
| Begin van de activiteit, met een laag volume | 1 juli |
| Activiteitspieken | 24 en 25 juli |
| Verzoeken volgens het extractiepatroon tijdens de pieken | 16 000, afkomstig van meer dan 4 000 gebruikers |
| Groep die verband houdt met dit patroon | meer dan 15 000 gebruikers |
| Volledige neutralisatie van de groep | 28 juli |
Over de toeschrijving blijft het bericht voorzichtig: het is niet vastgesteld dat alle uitvoerders bij dezelfde actor horen, en de 16 000 verzoeken tijdens de pieken zijn extractiepogingen die niet noodzakelijk zijn geslaagd. OpenAI schrijft echter een kern van de activiteit toe aan personen die verbonden zijn aan Moonshot AI, de ontwikkelaar van Kimi.
… we attribute a core cluster of the activity to individuals associated with Moonshot AI …
🇳🇱 … wij schrijven een kern van de activiteit toe aan personen die verbonden zijn aan Moonshot AI … — OpenAI, bericht in de rubriek Security
Als reactie heeft OpenAI frauduleuze accounts geblokkeerd of beperkt, zijn controles bij registratie en op infrastructuur aangescherpt, het toezicht op verbonden netwerken uitgebreid en de bescherming van verborgen redeneringen tussen gebruikers, werkruimten, organisaties en modelfamilies versterkt. Het bedrijf heeft een route afgesloten waarmee de versleutelde redenering van een andere gebruiker opnieuw kon worden afgespeeld om de inhoud te achterhalen, en controles toegevoegd die streaminguitvoer (streaming) detecteren en tegenhouden als die de redenering zou kunnen blootleggen. De resultaten zijn gedeeld via het Frontier Model Forum en overheidskanalen: volgens OpenAI is de techniek niet specifiek voor zijn modellen, en kan elk systeem dat redeneringen overdraagbaar of opnieuw afspeelbaar maakt aan vergelijkbare risico’s worden blootgesteld. Het bedrijf presenteert adversariële distillatie als een veiligheidsrisico en een risico voor de nationale veiligheid, omdat geëxtraheerde redeneringen kunnen worden gebruikt om een ander model te trainen zonder de waarborgen van het origineel. Het onderwerp is niet nieuw: in februari had Anthropic distillatiecampagnes toegeschreven aan DeepSeek, Moonshot AI en MiniMax, en sinds 24 september brengt Anthropic geblokkeerde verzoeken in verschillende categorieën in rekening, waaronder het extraheren van redeneringen.
🔗 Artikel « Redeneersporen stelen uit API’s van propriëtaire LLM’s » op arXiv
Embeddings: Cohere introduceert Embed 5 en de metriek RCP-nDCG@10, Perplexity publiceert pplx-embed-v2-context-9b-preview
30 september — Cohere introduceert Embed 5, een familie van embeddingmodellen voor zoeken binnen bedrijven, in twee varianten die dezelfde embeddingruimte delen: Embed 5 Pro, voor maximale kwaliteit en offline indexering, en Embed 5 Fast, voor interactief zoeken, RAG met grote volumes en agentisch zoeken. Je kunt een corpus met Pro indexeren en vervolgens met Fast doorzoeken zonder iets opnieuw te indexeren, zolang je dezelfde uitvoerdimensie behoudt: op 40 ontwikkelingsdatasets behoudt deze door Cohere aanbevolen aanpak gemiddeld 98,4 % van de kwaliteit van een systeem dat volledig op Pro draait, tegenover 96,6 % voor een systeem dat volledig op Fast draait.
Beide modellen lezen tot 128K tokens, accepteren tekst, afbeeldingen of beide samengevoegd in één vector, ondersteunen meer dan 100 talen en produceren vectoren van 256 tot 2 048 dimensies in float, int8 of binair formaat. Cohere adviseert 1 024 dimensies in int8, oftewel 1 Ko per vector tegenover 8 Ko in float32 bij 2 048 dimensies. Pro kost 0,12 dollar per miljoen teksttokens en Fast 0,08 dollar, een derde minder, met gemiddeld een 2,4 keer hogere documentdoorvoer; afbeeldingen kosten bij beide modellen 0,40 dollar per miljoen tokens. Embed 5 is vanaf vandaag beschikbaar via de API van Cohere, Model Vault, Microsoft Foundry en Amazon SageMaker, evenals in North, en kan met vLLM in een private omgeving worden ingezet.
| Benchmark (metriek) | Embed 5 Pro | Embed 5 Fast | Andere genoemde modellen |
|---|---|---|---|
| ViDoRe V3, 8 domeinen (RCP-nDCG@10) | 85,8 | 84,5 | Voyage 4 Large 83,7 ; Gemini Embedding 2 83,2 ; OpenAI text-embedding-3-large 75,5 |
| FinanceBench (RCP-nDCG@10) | 80,1 | 80,0 | Pro 21,4 punten voor op OpenAI text-embedding-3-large |
| FinQA (RCP-nDCG@10) | 90,0 | 88,8 | — |
| ViDoRe V3 Finance (RCP-nDCG@10) | 85,0 | 83,9 | — |
| Geanalyseerde PDF’s, gemiddelde van de suite (RCP-nDCG@10) | 84,8 | 83,4 | Voyage 4 Large 83,6 ; Gemini Embedding 2 80,8 ; Embed 4 78,6 |
| Tekst en beeld samengevoegd, 5 datasets (nDCG@10) | 82,3 | 81,2 | Gemini Embedding 2 61,3 |
| Pagina-afbeelding, 5 financiële datasets (nDCG@10) | 77,0 | 73,2 | Embed 4 71,1 ; Voyage Multimodal 3.5 70,1 ; Gemini Embedding 2 56,7 |
| 5 Europese talen (nDCG@10 of RCP-nDCG@10) | 77 | — | Voyage 4 Large 76 ; Gemini Embedding 2 73 |
De meeste van deze scores worden uitgedrukt in RCP-nDCG@10, de evaluatiemethode die Cohere dezelfde dag publiceert (zie hieronder): een opmerking in het blogbericht verduidelijkt dat deze een vaste verzameling kandidaten opnieuw rangschikt en dus de kwaliteit van de rangschikking meet in plaats van de retrieval in de eerste fase. De tweede meertalige tabel moet je in zijn geheel bekijken: Cohere benadrukt daarin de vooruitgang ten opzichte van Embed 4, tot 13 punten in het Farsi, maar bij deze tien talen presteert Gemini Embedding 2 in negen talen beter dan Embed 5 Pro, met Chinees als enige uitzondering, en Voyage 4 Large presteert in vijf talen beter. Cohere presenteert Embed 5 tijdens een sessie op X op 8 oktober.
🔗 Blogbericht van Cohere over Embed 5 · Aankondiging van @cohere op X
RCP-nDCG@10, de metriek waarmee Cohere Embed 5 meet
30 september — Cohere publiceert ook RCP-nDCG@10 (Rubric-Calibrated Preferences nDCG@10), zijn methode voor het evalueren van zoekresultaten. Het uitgangspunt: nDCG, de metriek van MTEB en BEIR, vergelijkt de resultaten met een lijst van vooraf geannoteerde documenten die onvermijdelijk onvolledig is, waardoor een relevant document dat nooit is geannoteerd geen punten oplevert; in het onderzoek van Cohere wordt 28 % van de documenten die als niet relevant zijn aangemerkt toch door mensen als nuttig beoordeeld. RCP-nDCG@10 laat het oordeel over aan een gekalibreerde IA-beoordelaar, die voor elke query dezelfde vijf ja/nee-vragen beantwoordt en documenten in groepen vergelijkt. Blinde validatie met 46 annotatoren op 289 duels: wanneer de twee metrieken verschillende winnaars aanwijzen, geven mensen RCP-nDCG in 70 % van de gevallen gelijk. Het artikel, de code en de gegevens zijn gepubliceerd, en de hoofdmaintainer van MTEB kondigt de integratie aan. Cohere zegt de vijfde generatie van Embed en Rerank op deze metriek te hebben geoptimaliseerd, waarbij voor die laatste nog geen datum bekend is, en waarschuwt dat deze modellen op basis van alleen de historische nDCG niet altijd als beste uit de bus zullen komen.
🔗 Blogbericht van Cohere over RCP-nDCG@10 · Code en gegevens op GitHub
Perplexity publiceert pplx-embed-v2-context-9b-preview en de benchmark context-bench
30 september — Perplexity publiceert een preview van pplx-embed-v2-context-9b-preview onder de MIT-licentie op Hugging Face, een model voor contextuele embeddings: elk fragment van een document wordt gecodeerd met zicht op het hele document, zodat een passage met « zij » aan de juiste entiteit gekoppeld blijft. In plaats van één « gouden » fragment (gold passage) per query leert het model van een leraar, het contextcompressiemodel van Perplexity, dat elk token van het document een score geeft: zo leert het zowel het antwoord als de passages die het onderbouwen terug te vinden. Bij een blinde evaluatie op context-bench, een niet-openbare benchmark van turbopuffer, medeondertekenaar van het blogbericht (2 099 query’s, 38 894 documenten), presteert het beter dan voyage-context-4; op ConTEB behaalt het het beste gemiddelde zonder alle taken te winnen. Perplexity waarschuwt dat de gewichten en de interface nog kunnen veranderen en bereidt toegang via zijn API voor, zonder datum.
| Door Perplexity gepubliceerde maatstaf | pplx-embed-v2-context-9b-preview | Verschil met voyage-context-4 |
|---|---|---|
| Recall van antwoorden op context-bench, bij K = 10 | 45,5 % | +14,4 punten |
| Recall van bewijs op context-bench, bij K = 10 | 40,6 % | +5,0 punten |
| Opslag per vector (1 024 dimensies, int8) | 1 Ko | 8 keer minder dan voyage-context-4 in float32 |
🔗 Blogbericht van Perplexity Research · Model op Hugging Face
Ideogram 4.5: een model voor beeldbewerking ontworpen voor opeenvolgende retouches
30 september — Ideogram introduceert Ideogram 4.5, dat het presenteert als « het nauwkeurigste bewerkingsmodel ». Het uitgangspunt: bij elke retouche voegen beeldmodellen artefacten, pixelverschuivingen en kleurafwijkingen toe, waardoor een afbeelding na meerdere bewerkingsrondes al snel onbruikbaar wordt. Ideogram 4.5 is ontworpen om deze opeenstapeling te voorkomen en bewerken in meerdere rondes mogelijk te maken (multi-turn editing).
Introducing Ideogram 4.5, the most precise edit model. With each edit, leading models add artifacts, pixel shifts, and color changes. Ideogram 4.5 eliminates artifact buildup, making multi-turn editing possible. Live in Ideogram, the API, and launch partners. Open weights soon.
🇳🇱 Dit is Ideogram 4.5, het nauwkeurigste bewerkingsmodel. Bij elke retouche voegen de toonaangevende modellen artefacten, pixelverschuivingen en kleurveranderingen toe. Ideogram 4.5 voorkomt de opeenstapeling van artefacten, waardoor bewerken in meerdere rondes mogelijk wordt. Beschikbaar in Ideogram, via de API en bij de lanceringspartners. Binnenkort open gewichten. — @ideogram_ai op X
Om dit te onderbouwen publiceert Ideogram een vergelijking waarin dezelfde opeenvolgende retouches met GPT Image 2.5 Sunburst, Nano Banana Pro en Nano Banana 2 naast elkaar worden getoond; de output daarvan zou volgens Ideogram na enkele retouches onbruikbaar worden. De vergelijking is visueel, zonder numerieke score. De voorbeelden omvatten kleur en verlichting (schaduwen, reflecties en hooglichten volgen de verandering zonder de compositie te wijzigen), tekst aanpassen, productfotografie, interieurinrichting, oude foto’s stap voor stap restaureren, van een schets of dieptekaart naar een afbeelding gaan, en bijsnijden.
Het model introduceert ook bewerken op elke resolutie (Zoom editing): een gebied van een afbeelding met hoge resolutie, in het voorbeeld van Ideogram van 24,2 megapixels (4 016 × 6 016 pixels), kan worden geretoucheerd zonder de afbeelding te verkleinen, waarbij de randen behouden blijven om het zonder zichtbare naden terug te plaatsen. Hoewel het model is ontworpen voor gerichte bewerkingen, presteert het volgens Ideogram ook erg goed bij algemene beeldbewerking.
| Onderdeel van de aankondiging | Wat erover bekend is |
|---|---|
| Beschikbaarheid | vanaf 30 september in Ideogram en via de API |
| Lanceringspartners | Pika en Luma, die het dezelfde dag aankondigen |
| Open gewichten | « binnenkort » beloofd, zoals die van Ideogram 4.0 die in juni zijn gepubliceerd |
| Tarief | niet gepubliceerd |
🔗 Modelpagina van Ideogram 4.5
HeyGen Video: een videomodel gebouwd op MiniMax H3, toegankelijk via een API
30 september — HeyGen introduceert HeyGen Video, een model voor videogeneratie voor bedrijven die een video van productiekwaliteit willen zonder de bijbehorende kosten te betalen. Het is gebouwd op MiniMax H3 en door HeyGen verder getraind, produceert een video op basis van tekst of een afbeelding, met geluid dat in dezelfde call wordt gegenereerd, en is te gebruiken via de API van HeyGen en op OpenRouter, Runware en ComfyUI.
Voor de prijs worden drie bedragen genoemd. Het tarief begint bij 0,01 dollar per seconde tot eind oktober, oftewel 50 % korting op het standaardtarief van 0,02 dollar, volgens de cataloguspagina. De vergelijkingstabel gebruikt daarentegen de catalogusprijs voor 768p met audio, vóór de introductieacties: 0,03 dollar per seconde. Zelfs tegen die prijs is HeyGen Video het goedkoopste van de vergeleken modellen.
| Vergeleken model | Catalogusprijs per seconde (768p, audio) | Interne Elo van HeyGen (HeyGen Video = 1 000) |
|---|---|---|
| HeyGen Video | 0,03 dollar | 1 000 |
| Seedance 2.0 | 0,303 dollar | 955 |
| H3 Max | 0,08 dollar | 952 |
| H3 Max Turbo | 0,04 dollar | 920 |
| H3 Max balanced | 0,08 dollar | 860 |
| Kling 3.0 Pro | 0,168 dollar | 857 |
| Veo 3.1 | 0,40 dollar | 744 |
Voor de kwaliteit baseert HeyGen zich op een interne evaluatie met query’s uit Artificial Analysis Arena (4 800 stemmen), waarbij de Elo voor het eigen model op 1 000 is genormaliseerd. Bij een blinde voorkeursbeoordeling tegenover H3 Max gaat 55,8 % van de 650 stemmen naar HeyGen Video, binnen een interval van 49 tot 62 % dat een gelijkspel niet uitsluit. Voor een clip van 10 seconden bij omzetting van beeld naar video daalt de inferentietijd van de diffusion transformer tot 3,7 seconden, tegenover 4,1 voor H3 Max Turbo en 8,3 voor H3 Max, exclusief de tijd voor het genereren van bijschriften.
MiniMax heeft de lancering verwelkomd en dezelfde dag een ander van H3 afgeleid model onder de aandacht gebracht: Boreal-H3 van Creatify, een videomodel geoptimaliseerd voor reclame.
🔗 Catalogus van HeyGen Video · Aankondiging van @HeyGen op X
Generalistische assistenten en agents: de skills van Gemini, Manus Flex en Grok Bot
De Gemini-app introduceert skills, die de Gems zullen vervangen
30 september — Google introduceert skills in de Gemini-app: instructies die je één keer opslaat en oproept door een schuine streep gevolgd door hun naam te typen. Gemini kan ze ook uit gesprekken aanmaken en zelf starten wanneer een prompt overeenkomt, meerdere skills kunnen worden gecombineerd, en elke skill kan referentiebestanden bevatten (platte tekst, PDF, afbeeldingen). Ze zijn al beschikbaar in Gemini Spark en verschijnen nu wereldwijd in de Gemini-chat, voor alle abonnementsniveaus van Google AI en voorlopig voor gebruikers van 18 jaar en ouder; Workspace-klanten volgen in de komende weken. De skills vervangen de Gems, die vanaf november verdwijnen voor persoonlijke accounts, in maart 2027 voor Workspace business, enterprise en nonprofit en in juni 2027 voor het onderwijs, met een automatische migratie. Opal, de tool voor het maken van mini-applicaties, sluit ook in november, net als de « Gems by Google Labs », die niet worden gemigreerd.
🔗 Laat skills in Gemini je meest repetitieve taken afhandelen (Google-blog)
Manus Flex: een eigen API-sleutel in de Manus-agent
29 september — Manus introduceert Manus Flex, waarmee je Manus kunt laten draaien met de API-sleutel van een ondersteunde inferenceprovider (bring your own API key). Tot nu toe koos Manus zelf het model en leverde het de harness en de agentinfrastructuur; met Flex werken dezelfde projecten, tools, runtime-omgevingen en agentworkflows met de sleutel van een provider, met een hoofdmodel en een niveau van redeneerinspanning naar keuze. De facturering wordt verdeeld: de provider factureert inference rechtstreeks, terwijl de overige diensten en infrastructuur die een taak gebruikt Manus-credits blijven verbruiken. OpenRouter, Fireworks en Modal zijn de eerste drie leden van het partnerprogramma voor inference (Manus Flex Inference Partner Program). Het blogbericht, gepubliceerd op de dag na de lancering van Manus 2.0, vermeldt geen abonnementsvorm, tarief of modellenlijst.
Grok Bot besteedt codewerk uit aan Cursor en beheert pull requests
30 september — Twee dagen na Team Bots versterkt SpaceXAI Grok Bot voor softwareontwikkeling. In een thread van het account @bot kondigt de aanbieder aan dat zijn Bots codeertaken aan Cursor kunnen uitbesteden, pull requests kunnen beheren met de plugins GitHub en Origin (die laatste wordt niet beschreven) en videodemonstraties kunnen delen van wat ze bouwen. SpaceXAI publiceert ook de Bots van het eigen engineeringteam als installeerbare sjablonen (templates), elk met hun skills, routines en connectors. De thread noemt geen abonnementsvorm, tarief of datum, en er is geen bijbehorend blogbericht op x.ai. De koppeling met Cursor is niet nieuw: Grok Bot for Enterprise werd begin september twee weken gratis aangeboden aan klanten van Grok en Cursor Enterprise; de verandering is dat een Bot het codewerk zelf uitbesteedt.
Robotica en wereldmodellen: Praxis-1 van Runway, MolmoAct 2 van Ai2 en Physis-Lang van NVIDIA
Runway presenteert Praxis-1, een wereldactiemodel met open gewichten
30 september — Runway presenteert Praxis-1, zijn eerste wereldactiemodel (world action model) met open gewichten, bedoeld om echte robots aan te sturen. Het bouwt voort op dezelfde video-pretraining als zijn wereldmodellen, zoals Solaris of GWM Worlds 2, en is bedoeld als algemeen inzetbaar policymodel voor ontwikkelaars en onderzoekers in de robotica. Runway zet erop in dat robotdemonstraties schaars zijn, terwijl video vrijwel onbeperkt beschikbaar is. In de demonstraties schakelt dezelfde policy zonder hertraining over van een studio naar een keuken. Er is nog niets te downloaden: Praxis-1 wordt getest bij Noble Machines, Standard Bots en Ultra, elk op eigen hardware, en de publieke release, inclusief de gewichten, is aangekondigd voor de komende maanden.
| Door Runway gepubliceerde meting | Aangekondigd resultaat |
|---|---|
| Correlatie tussen simulatie in het wereldmodel en resultaten in de praktijk | 0,95 |
| Uiteindelijke plaatsingsfout na fine-tuning, met webvideo’s | 16,1 cm |
| Dezelfde fout met video van een op afstand bestuurde robot | 16,0 cm |
MolmoAct 2 van Ai2 bovenaan Reality Check, na fine-tuning door de organisator van de benchmark
30 september — Ai2 kondigt aan dat MolmoAct 2, zijn volledig open roboticamodel, het hoogste totale succespercentage behaalt op Reality Check, een onafhankelijke benchmark voor manipulatie in de praktijk, met een belangrijke kanttekening: de modellen worden door de organisator, Poke & Wiggle, gefinetuned op de taken van de benchmark. Reality Check werd de dag ervoor door dit bedrijf gelanceerd en omvat 14 400 uitvoeringen op echte robots, op FR3 Duo-stations in het Deutsches Museum in München, in tien omgevingen (schroeven sorteren, een DC-connector aansluiten, een gereedschapskist openen met een schroevendraaier…). Twee onderdelen staan nog « op de planning »: objecten die buiten het trainingsgebied worden geplaatst en mid-training op 100 uur data van de stations.
| Geëvalueerd model | Totaal succespercentage | Succespercentage na ongeveer 10 demonstraties per omgeving | Succespercentage na ongeveer 300 demonstraties per omgeving |
|---|---|---|---|
| MolmoAct 2 | 28 % | 4 % | 44 % |
| Pi 0.5 | 21 % | 5 % | 33 % |
| DiT-Flow | 19 % | 2 % | 29 % |
| GR00T N1.7 | 12 % | 4 % | 19 % |
🔗 Tweet van Ai2 · Reality Check-ranglijst
Physis-Lang: bijschriften die wereldmodellen de fysica uitleggen
29 september — Onderzoekers van NVIDIA, MIT en de Universiteit van Oxford publiceren Physis-Lang, een framework dat fysische redeneringen toevoegt aan videobijschriften om wereldmodellen te verbeteren. De bijschriften maken de oorzaken, de betrokken wetten en de effecten expliciet; een gespecialiseerde beoordelaar spoort ontbrekende of onvoldoende onderbouwde beweringen op, een agent verfijnt de instructies voor het schrijven van bijschriften, en de mislukkingen van het model worden gebruikt om video’s te zoeken die zijn tekortkomingen kunnen verhelpen. Volgens NVIDIA verbetert het toevoegen van deze redeneringen aan alleen de prompt, zonder hertraining, de PhyGenBench-score van Cosmos 3 met 5,62 punten. Met training neemt Physis-Lang op Cosmos3-Super en Cosmos3-Nano de eerste twee plaatsen in op de Physics-IQ Verified-ranglijst voor image-to-video (48,2 en 43,3, tegenover 42,7 voor de vorige hoogste score). PhyGenBench en VideoPhy-2 worden beoordeeld door GPT-5.5, en Veo 3.1 behoudt een lichte voorsprong op de volledige set van VideoPhy-2.
| Benchmark voor fysica in video | Cosmos3-Nano | Veo 3.1 | Physis-Lang op Cosmos3-Nano |
|---|---|---|---|
| PhyGenBench | 61,67 | 65,63 | 71,04 |
| Physics-IQ Verified | 40,23 | 34,99 | 43,41 |
| VideoPhy-2 Hard | 48,31 | 58,43 | 62,36 |
| VideoPhy-2, volledige set | 60,41 | 68,87 | 68,02 |
🔗 Projectpagina van Physis-Lang · Aankondiging van @NVIDIAAI op X
Open modellen: Hunmin-397B-A17B-CUA en JEV-27B-VL
Hunmin-397B-A17B-CUA voegt de agentcapaciteiten van Qwen-CUA toe aan een MoE met 397 miljard parameters
30 september — Op de communityblog van Hugging Face beschrijft hojun Lee Hunmin-397B-A17B-CUA, een model voor computerbediening (computer use) dat de organisatie mncai onder Apache-2.0 heeft gepubliceerd, met een voorbehoud van de auteurs zelf: de evaluaties zijn intern uitgevoerd, met slechts één uitvoering voor de agentbenchmarks, en zijn niet vergelijkbaar met de gepubliceerde ranglijsten (het basismodel behaalt hier 48,16 op OSWorld, tegenover de aangekondigde 62,2 op OSWorld-Verified). Het model is gebaseerd op Qwen3.5-397B-A17B, een mixture of experts met 17 miljard actieve parameters, en het hele project paste op één node met acht B200. Het team berekende het verschil in gewichten tussen zijn basismodel en het al gespecialiseerde Qwen-CUA, en voegde daarvan alleen een versie met een lagere rang toe aan een selectie van modules: deze overdracht alleen verhoogt de score op OSWorld-316 van 48,84 naar 68,25, zonder de zwakte van Qwen-CUA bij visuele grounding over te nemen. Fine-tuning gevolgd door reinforcement learning met GRPO voegt nog eens 4,3 punten toe.
| Evaluatiebenchmark (intern protocol) | Basismodel Qwen3.5-397B | Hunmin-CUA | Qwen-CUA (bron) |
|---|---|---|---|
| OSWorld, 360 taken | 48,16 | 70,45 | 77,12 |
| WindowsAgentArena, 153 taken | 41,77 | 50,85 | 56,68 |
| ScreenSpot-Pro | 72,74 | 75,61 | 62,20 |
| KMMLU-Pro (Koreaans) | 77,91 | 76,12 | 71,41 |
🔗 Blogbericht over Hunmin-CUA · Gewichten op Hugging Face
AutoTrust AI publiceert JEV-27B-VL, een open beslissingsmodel dat ook afbeeldingen beoordeelt
30 september — AutoTrust AI publiceert JEV-27B-VL onder Apache-2.0, de versie met beeldverwerking van JEV-27B, zijn open beslissingsmodel dat op 27 september werd gepresenteerd. Je toont het afbeeldingen en tekst, stelt een vraag, en het antwoordt in één doorgang met een gekalibreerde waarschijnlijkheid voor elke optie, in ongeveer honderd milliseconden; wanneer de vraag dat vereist, redeneert het stap voor stap terwijl het de afbeeldingen bekijkt. Zijn decision head heeft tijdens de training echter geen enkele afbeelding gezien. De belangrijkste test: op MicroLens, een openbare dataset van een app voor korte video’s, rangschikt het 20 kandidaatvideo’s voor 200 gebruikers op basis van alleen de thumbnails, en evenaart het qua AUC collaborative filtering die op 59 045 gebruikers is getraind, met een hoger percentage goede video’s in de top 5. De auteurs benadrukken dat dit resultaat afkomstig is van slechts één dataset met 200 gebruikers.
| Aanbevelingsmethode op MicroLens | AUC | Goede video in de top 5 |
|---|---|---|
| JEV-27B-VL, alleen thumbnails, zonder interactiedata | 0,727 | 59 % |
| Collaborative filtering getraind op 59 045 gebruikers | 0,728 | 49 % |
| JEV-27B-VL, alleen titels | 0,649 | 46 % |
| Willekeurige volgorde | 0,489 | 21 % |
Ranglijsten: de Open TTS Leaderboard van Hugging Face en AURORA van LILT
Hugging Face lanceert de Open TTS Leaderboard, een open ranglijst voor spraaksynthese
30 september — Hugging Face lanceert de Open TTS Leaderboard, een ranglijst voor spraaksynthese (text-to-speech, TTS) die zich richt op open en meertalige modellen. De Hub bevat meer dan 8 000 TTS-modellen, maar de toonaangevende stemarena’s houden het tempo onvoldoende bij en vertegenwoordigen open modellen te weinig: volgens het blogbericht hebben slechts 16 van de 92 modellen in de ranglijst van Artificial Analysis open gewichten. De ranglijst vervangt stemmen daarom door objectieve metingen: verstaanbaarheid (het foutpercentage per woord of teken tussen de gevraagde tekst en de transcriptie ervan door Qwen3 ASR), snelheid (gebatchte inference en tijd tot het eerste geluid, op H200 en op een processor) en de getrouwheid van een gekloonde stem (WavLM-gelijkenis). Het evalueren van een model duurt enkele uren in plaats van enkele weken stemmen verzamelen. In het Engels voeren Kokoro-82M, supertonic-3 en s2-pro van Fish Audio de ranglijst aan; bij meertalige modellen zijn dat OmniVoice, s2-pro en Fun-CosyVoice3-0.5B. De auteurs waarschuwen dat noch natuurlijkheid noch expressiviteit wordt gemeten, en zullen hun evaluatiescripts « binnenkort » publiceren.
🔗 Blogbericht over de Open TTS Leaderboard · De ranglijst op Hugging Face
LILT lanceert AURORA, een meertalige ranglijst voor agenttaken
30 september — LILT lanceert AURORA, een ranglijst die toonaangevende modellen meet op agenttaken in andere talen dan Engels, allemaal ontworpen en gecontroleerd door experts die moedertaalsprekers zijn, zonder automatische vertaling. Bij de start omvat de ranglijst vier benchmarks: een meertalige Terminal-Bench met 324 codeertaken in tien talen, een meertalige versie van τ³-bench voor klantenservice, MultiChallenge voor het volgen van instructies in lange contexten en GAIA-v2-LILT voor agentisch redeneren. Claude Opus 5.5 voert de meertalige Terminal-Bench aan en staat in elk van de vijf talen bovenaan τ³-bench. Op GAIA scoren de modellen op de door LILT gecontroleerde versie gemiddeld 20,7 punten hoger dan op een automatisch vertaalde versie: volgens LILT meet dit verschil de fout die door de vertaling wordt geïntroduceerd. Hetzelfde gesprek verbruikt in het Koreaans of Arabisch ook ongeveer 1,4 keer zoveel tokens als in het Engels.
| Geëvalueerd model (meertalige Terminal-Bench, selectie) | Gemiddeld succespercentage |
|---|---|
| Claude Opus 5.5 (effort high) | 76,4 % |
| Claude Opus 5 (effort high) | 73,5 % |
| Gemini 3.8 Flash | 67,3 % |
| GPT-6 Sol | 64,8 % |
| Command A+ | 4,3 % |
🔗 Blogbericht van LILT over AURORA · De AURORA-ranglijst
Publieke sector en bedrijven: Claude for Government, de aankoopagent van Anthropic en OpenAI met America’s SBDC
Claude for Government wordt algemeen beschikbaar
30 september — Claude for Government verlaat de bètafase: Anthropic kondigt de algemene beschikbaarheid aan voor federale overheidsinstanties en instanties van de Amerikaanse deelstaten. Het platform, dat sinds juli in publieke bèta is, biedt de codeer- en agentische werkcapaciteiten van Claude in een voor FedRAMP High geautoriseerde omgeving, met functies die vergelijkbaar zijn met die voor commerciële klanten; de CLI Claude Code en Claude for Microsoft 365 komen er in early access beschikbaar. Geen licentie per seat: instanties betalen voor het gebruik in vaste blokken, met een harde limiet die voorkomt dat het vastgelegde budget wordt overschreden, en SCIM-groepskoppelingen bepalen per seatniveau de rate limits, bestedingslimieten in dollars en toegestane modellen. Wat controle betreft, vereisen gevoelige handelingen aan de kant van Anthropic goedkeuring door twee personen, bevatten gebruiksexports alleen meetgegevens en blijft de gespreksgeschiedenis op het door de instantie beheerde apparaat. Anthropic publiceert geen tarieven.
🔗 Claude for Government is nu algemeen beschikbaar
Bij Anthropic neemt een agent op basis van Managed Agents commerciële aanvragen aan
30 september — Anthropic vertelt hoe zijn salesteam de intake van binnenkomende aanvragen, tienduizenden per maand, opnieuw heeft ingericht met een aankoopagent die is gebouwd op Claude Managed Agents, in bèta. De agent is aanwezig op de pagina’s Contact Sales en Pricing, in claude.ai en in e-mails, stelt enkele vragen, beveelt een abonnement en een aantal seats aan, en begeleidt vervolgens de aankoop, draagt het gesprek met de volledige geschiedenis over aan een verkoper, of beantwoordt alleen vragen; de klant kan vanaf het begin voor een mens kiezen. Volgens het blogbericht, geschreven door Carl Johnson, voert de agent duizenden gesprekken per dag; de prospects die hij doorstuurt, worden meer dan twee keer zo vaak verkoopkansen als bij het oude formulier en sluiten ongeveer vijf dagen sneller een deal, en het aandeel gesprekken waarbij een verkoper nodig is om de deal te sluiten, is ongeveer gehalveerd. Eén engineer bouwde de eerste versie in enkele weken; de agent stuurt kleine teams vaak naar het Team-abonnement in plaats van Enterprise, een keuze die Anthropic bewust accepteert.
🔗 Hoe het salesteam van Anthropic de intake opnieuw inrichtte met Claude Managed Agents
OpenAI werkt samen met America’s SBDC en publiceert een rapport over kleine bedrijven
30 september — OpenAI werkt samen met America’s SBDC, het nationale netwerk van Amerikaanse centra voor de ontwikkeling van kleine bedrijven, dat jaarlijks 1 miljoen ondernemers ondersteunt. In een eerste fase, via het programma voor communitytrainers van OpenAI Academy (Community Trainer Program) dat op 23 september als pilot werd gelanceerd, wil OpenAI ongeveer 150 adviseurs opleiden, die workshops van drie uur zullen geven binnen de SBDC-netwerken, met als doel minstens 1 000 kleine bedrijven fysiek te bereiken. Op dezelfde dag brengt het rapport « Kleine bedrijven, grotere mogelijkheden » het gebruik in cijfers: in de week van 9 tot en met 15 september gebruikten ongeveer 4 miljoen werknemers van bedrijven met minder dan 500 medewerkers de producten van OpenAI, van wie bijna een op de vijf bij een bedrijf met minder dan 10 medewerkers werkte. In augustus maakten agentische outputtokens, waaronder die van ChatGPT Work en Codex, twee derde uit van de outputtokens van kleine bedrijven, tegenover een derde in april.
🔗 Blogbericht van OpenAI over kleine bedrijven
Runway Ads: een autonome engine voor prestatiegerichte reclame
30 september — Runway lanceert Runway Ads, dat het creatieve deel van betaalde campagnes van begin tot eind verzorgt. Je koppelt een advertentieaccount en een merkpakket: de tool, gebouwd op Runway Agent, genereert video- en beeldadvertenties, publiceert de goedgekeurde varianten op Meta, Google en TikTok, analyseert hun prestaties en produceert de volgende reeks op basis van wat advertentiebudget heeft aangetrokken. De tool lokaliseert elke advertentie volgens regels die het team heeft vastgelegd, inclusief tekst in beeld, past de afmetingen aan elk formaat aan, voert een automatische merkcontrole uit en houdt zich aan de budgetlimieten. Menselijke goedkeuring is standaard ingeschakeld; automatische publicatie kan per campagne of per type variant worden ingeschakeld.
| Interne indicator van Runway, sinds juli | Resultaat gepubliceerd in de blogpost |
|---|---|
| Advertenties per week | van 77 tot ongeveer 900 |
| Rendement op advertentie-uitgaven | verdubbeld |
| Conversie | ongeveer +34 %, klikratio stabiel |
| Kosten per abonnee | −41 % |
Runway Ads draait voorlopig als pilot bij geselecteerde zakelijke partners. De aankondigingstweet belooft een brede uitrol in de komende weken en stelt dat de tool sinds juli ook heeft geholpen om 100 miljoen dollar aan ARR (jaarlijks terugkerende omzet) toe te voegen, een cijfer dat niet in de blogpost staat.
🔗 Blogpost over Runway Ads · Tweet van @runwayml
ElevenLabs gewaardeerd op 22 miljard dollar na een inkoopbod van 300 miljoen
30 september — ElevenLabs heeft een aanbod tot inkoop van aandelen (tender offer) van 300 miljoen dollar voor zijn werknemers afgerond. Daarmee wordt het bedrijf gewaardeerd op 22 miljard dollar, het dubbele van de waardering tijdens de serie D in februari. Wellington en T. Rowe Price leiden de transactie; EQT, Goldman Sachs, GIC, OTPP, Sapphire Ventures en BDT & MSD nemen een belang, naast bestaande investeerders zoals Andreessen Horowitz, Lightspeed en ICONIQ. Zakelijke klanten zijn goed voor 55 % van de omzet: ElevenAgents verwerkt meer dan 15 miljoen gesprekken per week, drie keer zoveel als in februari, en de jaarlijks terugkerende omzet ervan is in die periode meer dan verdrievoudigd. Volgens een analyse van zijn klanten lossen spraakagents verzoeken 31 % sneller op dan chatagents. Het bedrijf telt meer dan 800 werknemers, vier jaar na een eerste financieringsronde met een waardering van 9 miljoen dollar.
Vera Rubin NVL72 in productie bij CoreWeave, Cognition meet tot 4,8 keer zoveel doorvoer
30 september — Tijdens CoreWeave Fully Connected in San Francisco licht NVIDIA toe hoe Vera Rubin NVL72 bij CoreWeave in productie wordt genomen: het platform, met het Spectrum-X Ethernet 102.4T-netwerk, is beschikbaar op CoreWeave Cloud, dat eerder deze maand zijn eerste productieracks ontving. Cognition, de maker van Devin, is de eerste klant die er productieworkloads op draait: tijdens de eerste tests met taken uit FrontierCode mat het bedrijf tot 4,8 keer zoveel totale tokendoorvoer voor inferentie met SWE-2 als met GB200 NVL72. CoreWeave zal ook de Vera-CPU aanbieden, die voor agents is ontworpen: 128 CPU’s en 11 264 cores per rack, genoeg om meer dan 11 000 geïsoleerde omgevingen tegelijk te laten draaien, met sandboxes voor agents die meer dan drie keer sneller opstarten. Tot slot lanceert CoreWeave CoreWeave Forge, dat Weights & Biases, OpenPipe en marimo samenbrengt om de cyclus van productie terug naar training te sluiten; het bijbehorende serverless reinforcement learning (serverless RL) zou 1,4 keer sneller zijn en 40 % minder kosten.
🔗 Blogpost van NVIDIA over CoreWeave en Vera Rubin
Codeagents en ontwikkeltools: Claude Code 2.1.286, Zed 1.22.0, Gemini CLI, VS Code 1.140, HydraFusion en een MCP-server voor gcloud
Claude Code 2.1.286: bladwijzers in VS Code, begrensde herpogingen en een aangescherpte bare-modus
30 september — Claude Code 2.1.286, gepubliceerd om 19 h 10 UTC, bevat 88 vermeldingen, waaronder 49 bugfixes. De toestemmingsprompt toont zijn positie wanneer meerdere verzoeken zich opstapelen (« 2 van 5 »), en de VS Code-extensie krijgt bladwijzers (bookmarks) om antwoorden van Claude in een zijpaneel te bewaren, een regel Vragen met de vragen die Claude heeft gesteld en de gekozen antwoorden, en voorbeelden van opties in de vraagkaarten. Twee gedragswijzigingen zijn van belang: één limiet geldt voortaan voor alle herpogingen van een modelaanroep, dus maximaal 14 verzoeken met de standaardinstellingen, en --bare maakt alleen nog verbinding met de MCP-servers die op de command line worden genoemd, zonder systeemherinneringen of achtergrondtaken. Als er een skill met de naam verify bestaat, krijgt Claude de instructie die vlak voor elke commit uit te voeren, behalve bij documentatie of tests, en plugins weigeren npm-bronnen die git-repositories of mappen zijn. Tot slot probeert Claude Code, wanneer de API het standaardmodel weigert, één keer opnieuw met het vorige model van hetzelfde niveau, in plaats van bij elke beurt te mislukken.
🔗 Release notes van Claude Code 2.1.286
Zed 1.22.0: een model per subagent
30 september — Zed publiceert zijn stabiele versie 1.22.0, met de nadruk op subagents: de tool spawn_agent accepteert een optionele parameter model om een subagent te starten met een ander model dan het ingestelde model of het model dat van de bovenliggende agent is overgenomen, en de kaart van elke subagent toont het gebruikte model. Subagents comprimeren hun context ook automatisch, waardoor ze volgens Zed langer aan taken kunnen werken. Wat modellen betreft, wordt GPT-6.1 Sol beschikbaar via BYOK met een OpenAI-API-sleutel, krijgt Grok 4.7 een stabiele status als aanbevolen model bij SuperGrok en xAI, en wordt de lijst met modellen van OpenCode Zen en Go dynamisch opgehaald. De versie verhelpt een geheugenlek van ongeveer 2 Mo per afgeronde opdracht in de terminal en wijzigt een sneltoets: het actieve dock sluiten gebeurt voortaan met ctrl-alt-w op alle platforms. In totaal zijn er 18 nieuwe functies en 37 bugfixes.
🔗 Release notes van Zed 1.22.0
Gemini CLI: v0.62.0 als stabiele versie en een preview die plannen zonder bevestiging uitvoert
29 september — Gemini CLI publiceert ‘s avonds twee versies (UTC). V0.62.0 wordt om 21 h 17 stabiel: de 19 vermeldingen ervan komen uit de preview en de nightlies die van 16 tot 24 september zijn gepresenteerd (gestructureerde titels voor MCP-toolaanroepen, behoud van het OAuth-vernieuwingstoken (refresh token), Gemini 3.8 Flash en 3.5 Flash Lite). De vernieuwing zit in preview v0.63.0-preview.0, gepubliceerd om 20 h 58: in de niet-interactieve modus schrijft de agent voortaan zijn plan en voert hij het uit zonder op bevestiging te wachten (PR 29539), terwijl de instructies van Plan Mode hem alleen een afstemmingsbericht lieten geven, zonder enige toolaanroep. Een limiet maxChars van 0 of minder schakelt ook het afkappen van tooluitvoer uit (PR 29542). De nightly van 30 september opent de reeks 0.64.0: in ACP-modus rapporteert de CLI eindelijk de standaardgebruiksgegevens, terwijl clients zoals Zed of OpenHands de kosten volgens PR 29549 ongeveer 3 keer te hoog inschatten.
🔗 Gemini CLI v0.63.0-preview.0 · Gemini CLI v0.62.0
VS Code 1.140 neemt de Copilot-harness over
30 september — Visual Studio Code 1.140 verschijnt als stabiele versie met de Copilot-harness (Copilot harness): deze is gebaseerd op de Copilot SDK, geeft de VS Code-agent het gedrag en de mogelijkheden van de GitHub Copilot-app en Copilot CLI, en draait in een speciaal hostproces op basis van het Agent Host Protocol, zodat dezelfde sessie vanuit meerdere vensters kan worden geopend; de release notes waarschuwen dat deze voor sommige gebruikers mogelijk al standaard is geselecteerd. Experimenteel krijgen chats in sessies met meerdere mappen elk hun eigen map of worktree, en kan de agent een sessie delegeren aan een externe host, gekozen op basis van het systeem, het geheugen, het aantal CPU’s en het model. Er komen drie beheermogelijkheden voor bedrijven: uitleg in de chat over de minimale versies die de beheerder vereist, een standaardniveau voor de Auto-modus dat via een beheerde instelling wordt vastgelegd (autoTier), en toevoeging van de gebruikersidentiteit aan de OpenTelemetry-gegevens van Copilot, een optie die standaard is uitgeschakeld.
🔗 Release notes van VS Code 1.140
HydraFusion komt naar VS Code en de GitHub Copilot-app
30 september — GitHub breidt HydraFusion, de orkestratie van meerdere modellen die op 4 september in Copilot CLI werd gelanceerd, uit naar VS Code (vanaf versie 1.140, of Insiders) en de GitHub Copilot-app, nog steeds als onderzoekspreview. HydraFusion wordt in de modelselector als een model gekozen, maar is zelf geen model: het behandelt de keuze van de workflow als een optimalisatieprobleem en kiest een van drie patronen. In de Single-modus lost één model de taak op; in de Cascade-modus schrijft een efficiënt model een eerste versie en accepteert een kwaliteitscontrole het resultaat of schaalt op naar een sterker model; in de Critique-modus beoordeelt een criticus met alleen leestoegang, uit een andere modelfamilie, het resultaat, waarna de schrijver het één keer herziet. Waar de Auto-modus per verzoek een model kiest, coördineert HydraFusion meerdere modellen binnen één beurt. Het is beschikbaar in Copilot Pro, Pro+, Business en Enterprise; bij Business en Enterprise moet een beheerder previews inschakelen. GitHub publiceert geen nieuwe cijfers.
🔗 HydraFusion in VS Code en de GitHub Copilot-app
Google Cloud stelt in preview een externe MCP-server beschikbaar die gcloud en bq uitvoert
Google Cloud voegt de Google Cloud CLI remote MCP server in publieke preview toe aan zijn beheerde externe MCP-servers. Deze brengt honderden opdrachten van de command line-tools gcloud en bq (BigQuery) samen achter twee MCP-tools, run_gcloud_command en run_bq_command. Google onderbouwt de keuze voor de command line met twee argumenten: een opdracht omvat bewerkingen in meerdere stappen die via de API georkestreerd zouden moeten worden, en modellen zijn uitgebreid getraind op de openbare documentatie van deze opdrachten. De externe server maakt installatie van de CLI in de omgeving van de agent overbodig, waardoor deze bewerkingen beschikbaar worden voor agentplatforms die op het web worden gehost, zoals Gemini Enterprise. De opdrachten worden uitgevoerd in een geïsoleerde sandbox, achter een proxy met beperkte netwerktoegang en zonder automatisch beschikbare inloggegevens (ambient credentials), elk met de IAM-rechten van de aanroepende identiteit, die via Agent Identity of OAuth 2.0 wordt geauthenticeerd; Model Armor kan prompts en antwoorden filteren en elke aanroep kan in auditlogs worden vastgelegd. De server zelf wordt niet in rekening gebracht: alleen de aangemaakte resources en eventuele gegevensoverdracht worden gefactureerd.
🔗 Geef je agents meer mogelijkheden met de Google Cloud CLI remote MCP server (Google Cloud-blog)
Kort nieuws
- Codex CLI 0.159.2 — Deze versie, uitgebracht op 29 september om 23.57 uur UTC, bevat slechts één backport van een fix: onder Windows knipperen consolevensters niet meer wanneer Codex achtergrondprocessen of opdrachten in zijn sandbox start. 🔗 bron
- Plaid in Amp — De modi van Amp die GPT-6 Astra gebruiken, krijgen Plaid, gebaseerd op de ultrasnelle tier van OpenAI: tot 6 keer snellere verzoeken tegen 6 keer de kosten per token, uitsluitend voor inferentie via Amp; subagents blijven op fast of standard draaien, en Amp publiceert geen prijzen. 🔗 bron
- Warp en Factories as Code — Warp presenteert de configuratie van zijn softwarefabrieken als « de Terraform voor agents »: een repository beschrijft agents, automatiseringen, toegang en metingen. Het formaat factory.yaml dateert van eind augustus; de interactieve gids behandelt federatieve toegang tot AWS of GCP, webhooks en integraties met Slack, Linear of Jira. 🔗 thread van Warp · 🔗 configuratiegids
- Devin bij Crosby — In een casestudy van Cognition laat het New Yorkse advocatenkantoor Crosby, met een twaalftal engineers voor meer dan 50 advocaten, Devin de eerste reactie op incidenten verzorgen: dagelijks worden 20 tot 40 bugs en waarschuwingen onderzocht, meestal in ongeveer 5 minuten, met minstens 50 % minder ruis in Sentry. 🔗 bron
- claude.dev — Anthropic presenteert claude.dev officieel als de thuisbasis voor ontwikkelaars die met Claude bouwen: technische verdieping, gidsen voor Claude Code en de API, rubrieken Agents, Engineering, Playbooks en Skills, en een verborgen Terminal-pagina als verrassing. Berichten van de site werden al sinds 22 september gedeeld. 🔗 bron
- Bewerkbare ChatGPT-Sites — Volgens de releaseopmerkingen van 29 september kan een gepubliceerde Site worden aangepast met Edit site en ingepland via Automations op Plus en Pro; in Enterprise kunnen privé-Sites gebruikmaken van gekoppelde apps, met een instelling Allow use in Sites per plugin, die standaard uitgeschakeld is. 🔗 releaseopmerkingen van ChatGPT · 🔗 releaseopmerkingen voor Enterprise en Edu
- Kimi Work 3.2.15 — De versie van 30 september maakt het mogelijk dat mensen en AI samen Notion- en Feishu-documenten bewerken in de geïntegreerde browser, klapt het verloop van de agent standaard in en verhelpt bestandsbeschadiging bij gelijktijdige bewerking van een PPT. 🔗 bron
- Cue beheert financiën — De app voor persoonlijke agents, gelanceerd met Manus 2.0, houdt nu abonnementen en uitgaventrends bij en zet bankrekeningen op de automatische piloot via Plaid; landen, abonnementen en voorwaarden worden niet vermeld. 🔗 bron
- GPT-6.1 Sol in Genspark — Genspark maakt GPT-6.1 Sol een dag na de lancering beschikbaar in AI Chat, Code Agent en Claw, met dezelfde argumenten als OpenAI (intelligentie die dicht bij Astra ligt voor een vijfde van diens API-prijs), zonder het abonnement of de kosten in credits te vermelden. 🔗 bron
- Qwen3.8-27B-pi — Thomas Kim publiceert onder Apache-2.0 een fine-tuning van Qwen3.8-27B voor de Pi-harness die de inspanningsniveaus weer in de juiste volgorde zet: op Terminal-Bench 2.1 evenaart medium het basismodel op xhigh (67 taken van de 89) met ongeveer 41 % minder outputtokens. 🔗 bron
- Qwen3.8-27B bij Nebius — Qwen deelt de komst van zijn dense model met 27 miljard parameters naar Nebius Token Factory, aangekondigd op 28 september, voor code, onderzoek en agentworkflows; prijzen en verwerkingssnelheid worden niet vermeld. 🔗 bron
- Bekko System One v0 — Yuichi Tateno publiceert drie beslismodellen met 17M, 68M en 400M parameters, waarvan de twee kleinste in een browser draaien, en de benchmark S1MB: het 400M-model behaalt 50,60 tegenover 59,59 voor Jev 1.13, maar 54,48 tegenover 96,27 bij generalisatie. 🔗 bron
- ZooWork Instinct Tuned 4B — SRP publiceert onder Apache-2.0 een beslismodel met 4 miljard parameters, gebouwd op Qwen3.5-4B, dat opties in één doorgang beoordeelt zonder te decoderen: 198 van de 231 (85,71 %) op de openbare taken van JevBench, die tijdens de ontwikkeling werden gebruikt, benadrukken de auteurs. 🔗 bron
- Transformers v5.18.0 — Hugging Face voegt vier architecturen toe, Nemotron 3 Diarization en NemotronH Omni van NVIDIA, HyperCLOVAX Vision V2 van NAVER en GTE, en meldt zes breaking changes. 🔗 bron
- TaskSmith — Adithya S K, die bij Hugging Face aan omgevingen voor reinforcement learning werkt, publiceert een orchestrator die een pull request omzet in een verifieerbare RL-omgeving: 50 omgevingen uit TRL, PEFT, Accelerate, Diffusers en Transformers, geleverd als Harbor-taken. 🔗 bron
- TraceML 0.4.1 — De open source tool meet nu de volledige groep van een optimizerupdate; op ResNet-50 en een T4-GPU daalt de wachttijd voor data van 23 % van de stap naar minder dan 2 ms na aanpassing van het laden, met een mediane overhead van 0,35 %. 🔗 bron
- Transformer met lussen — Op een speelgoedmodel met 54 106 parameters en 260 verifieerbare gevallen, met hetzelfde budget van 80 blokdoorgangen, leert één lus alle 260 gevallen, twee lussen gemiddeld 125,3 en acht gemiddeld 37,0: meer doorgangen maakten het leren niet zuiniger. 🔗 bron
- Een evaluatie die nee kan zeggen — De tutorial van Eric Mey toont, op het sentiment van filmrecensies (SST-2), een evaluatie die een model afwijst dat op apart gehouden data toch 7 punten beter scoort, omdat cruciaal gedrag verslechtert; zijn scripts draaien in minder dan een minuut op een CPU. 🔗 bron
- 10 000 synthetische verzekerden — Intelligent Actuaries publiceert onder CC-BY-4.0 een synthetische studie naar het verval en de afkoop van levensverzekeringen: 10 000 fictieve verzekerden in tien markten, goed voor 27 692 polisjaarrecords voor 2023-2025 in het formaat van de SOA-LIMRA-enquête. 🔗 bron
- cuObject en SCADA Server SDK — NVIDIA maakt de cuObject-bibliotheken voor toegang tot objectopslag via RDMA, zonder het CPU-geheugen te gebruiken, algemeen beschikbaar en lanceert de SCADA Server SDK, waarvan IBM met Storage Scale een prototype ontwikkelde, binnen een Storage-Next-initiatief met meer dan 40 partijen. 🔗 bron
- NeMo Relay en Hermes Agent — Een tutorial van NVIDIA, mede geschreven door Teknium van Nous Research, volgt een Hermes-agent: over 108 uitvoeringen verhogen fixes voor tools het aantal geslaagde taken van Qwen3 Coder 30B van 19 naar 22 van de 27, ten koste van 4,9 modelaanroepen in plaats van 3,8. 🔗 bron
- OpenShell voor OpenClaw Enterprise — NVIDIA biedt zijn open source omgeving OpenShell aan om de agents van OpenClaw Enterprise te beheren, een open source control plane voor persistente agents die een dag eerder door de OpenClaw-stichting samen met Red Hat, NVIDIA en OpenAI werd aangekondigd. 🔗 bron
- Proefperiodes voor GitHub Advanced Security — Klanten van GitHub Team kunnen zelf een proefperiode voor GitHub Code Security en GitHub Secret Protection starten via de Overview-pagina van hun organisatie, de factureringspagina of een Risk Assessment; de duur wordt niet vermeld. 🔗 bron
- GHE.com en X25519 — Vanaf 7 oktober 2026 weigert GitHub Enterprise Cloud met dataresidentie TLS-clients die alleen X25519 aanbieden voor sleuteluitwisseling; P-256 en P-384 blijven ondersteund en SSH wordt niet geraakt. 🔗 bron
- Twee casestudy’s bij Runway — Het Franse drankenmerk Bonjour produceerde meer dan 500 advertentievarianten met Runway en besteedde meer dan 50 000 euro aan productiebudget opnieuw; de World Juggling Federation liet één persoon de vormgeving van een uitzending van een uur voor ESPN verzorgen. 🔗 Bonjour · 🔗 World Juggling Federation
- Ad Variants bij Luma — Luma brengt een functie onder de aandacht die een voltooide advertentie omzet naar meerdere formaten en voor meerdere markten binnen dezelfde campagne, zonder prijs, abonnement of lanceringsdatum te noemen, en zonder blogbericht. 🔗 bron
- Microduck in productie — Pollen Robotics kondigt aan dat 10 950 exemplaren van Microduck, zijn kleine tweevoetige robot van 399 dollar die in simulatie is getraind en een open source stack voor reinforcement learning gebruikt, tussen 10 december en 10 januari in wekelijkse batches van de productielijn zullen komen. 🔗 bron
- Cognition werft personeel — De maker van Devin verwelkomt Chris Degnan, voormalig CRO van Snowflake, als verantwoordelijke voor de omzet, een dag na de komst van Alex Stamos als verantwoordelijke voor informatiebeveiliging (CISO). 🔗 Chris Degnan · 🔗 Alex Stamos
- Claude Founder House — Anthropic organiseert dagen voor oprichters in San Francisco tijdens de SF Tech Week (van 6 tot 8 oktober, in de Terra Gallery) en op 14 oktober in Stockholm, met lezingen, workshops en tijdslots met zijn Applied AI-team. 🔗 bron
- AI Engineer Paris — Mistral blikt terug op het evenement dat de week ervoor in Station F plaatsvond: meer dan 900 deelnemers, 60 sprekers, 57 lezingen en 22 partners, zonder productaankondiging. 🔗 bron
- Promotiebeurzen van NVIDIA — Aanmeldingen voor het Graduate Fellowship Program 2027-2028 zijn open tot 30 oktober 2026, met maximaal 60 000 dollar per promovendus; sinds 2002 zijn meer dan 220 beurzen toegekend. 🔗 bron
Wat dit betekent
Veiligheid bepaalt inmiddels het tijdschema voor frontiermodellen. Gemini 4 Argon zet de aanpak van het Fairwind Program voort: vertrouwde cyberverdedigers krijgen het eerst, zonder cyberbeveiligingsmaatregelen, en de anderen volgen « zo snel mogelijk », zonder datum, zodra de bescherming is versterkt. Op dezelfde dag laat OpenAI de andere kant van het probleem zien: niet alleen het model moet worden beschermd, maar ook zijn redenering. Of de campagne nu wel of niet het werk is van één partij, de campagne waarvan OpenAI de kern toeschrijft aan personen die verbonden zijn aan Moonshot AI maakt het redeneerspoor tot een waardevol bezit dat moet worden verdedigd, met technische tegenmaatregelen en informatie-uitwisseling tussen laboratoria en overheden.
Een groot deel van de cijfers van vandaag komt voort uit metingen die zijn ontworpen of uitgevoerd door degenen die de aankondigingen doen. Cohere evalueert Embed 5 met de metriek die het op dezelfde dag publiceert, en waarschuwt zelf dat zijn modellen bij de oude meetmethode minder goed zouden kunnen lijken; HeyGen baseert zich op een interne Elo, Hunmin op een eigen protocol, met slechts één uitvoering voor de agentbenchmarks, en bij Reality Check heeft de organisator zelf de modellen gefinetuned. Perplexity laat zijn model daarentegen blind beoordelen op een privébenchmark van turbopuffer, en zowel het Open TTS Leaderboard als AURORA vervangen stemmen of automatische vertaling door verifieerbare taken en metingen. Voordat je twee scores vergelijkt, moet je kijken wie ze heeft geproduceerd.
Beeld- en videogeneratie worden steeds vaker beoordeeld op gebruik en kosten. Ideogram 4.5 belooft geen mooier beeld, maar een beeld dat een reeks opeenvolgende bewerkingen aankan; HeyGen Video wordt per seconde verkocht, goedkoper dan alle modellen in zijn prijsoverzicht, en laat zien dat een basismodel zoals MiniMax H3 gespecialiseerde varianten kan opleveren, van HeyGen tot Creatify. Runway Ads voltooit de keten tot aan de advertentie-uitgaven, en de waardering van ElevenLabs, die sinds februari is verdubbeld, steunt op de vraag van bedrijven naar gespreksagents.
Voor ontwikkelaars wordt de harness een volwaardig product, los van het model. VS Code neemt de harness van Copilot over om zijn agent op één lijn te brengen met de app en de CLI, HydraFusion coördineert meerdere modellen binnen één beurt, Zed laat de agent een model per subagent kiezen en Manus stelt zijn harness open voor API-sleutels van externe providers. Gemini CLI voert zijn plannen nu zonder menselijke tussenkomst uit in niet-interactieve modus, Claude Code scherpt --bare aan voor gebruik in scripts, en Google Cloud stelt gcloud en bq beschikbaar aan agents in een sandbox, met de IAM-rechten van de aanroeper. De vraag is zelfs zichtbaar in de infrastructuur: de eerste klant die Vera Rubin NVL72 bij CoreWeave in productie gebruikt, is Cognition, de maker van Devin.
Bronnen
- Gemini 4 Argon: ons volgende tijdperk van grensverleggende intelligentie (Google-blog)
- Gemini-pagina van Google DeepMind
- Aankondiging van Gemini 4 Argon door @GoogleDeepMind
- Blogbericht van OpenAI over de distillatiecampagne
- Redeneersporen stelen uit API’s van gesloten LLM’s (arXiv)
- Blogbericht van Cohere over Embed 5
- Aankondiging van Embed 5 door @cohere
- Blogbericht van Cohere over RCP-nDCG@10
- Code en data van RCP-nDCG op GitHub
- Blogbericht van Perplexity Research over contextuele embeddings
- pplx-embed-v2-context-9b-preview op Hugging Face
- Aankondiging van Ideogram 4.5 door @ideogram_ai
- Modelpagina van Ideogram 4.5
- Catalogus van HeyGen Video
- Aankondiging van HeyGen Video door @HeyGen
- Skills in de Gemini-app (Google-blog)
- Introductie van Manus Flex
- Thread van @bot over Grok Bot en Cursor
- Praxis-1 op Runway Research
- Tweet van Ai2 over MolmoAct 2 en Reality Check
- Reality Check-ranglijst van Poke & Wiggle
- Projectpagina van Physis-Lang
- Aankondiging van Physis-Lang door @NVIDIAAI
- Blogbericht over Hunmin-CUA
- Modelgewichten van Hunmin-397B-A17B-CUA
- Blogbericht over JEV-27B-VL
- Blogbericht van het Open TTS Leaderboard
- Open TTS Leaderboard op Hugging Face
- Blogbericht van LILT over AURORA
- AURORA-ranglijst
- Claude for Government is nu algemeen beschikbaar
- Hoe het salesteam van Anthropic het proces voor inkomende aanvragen opnieuw opbouwde met Claude Managed Agents
- Blogbericht van OpenAI over kleine bedrijven
- Blogbericht over Runway Ads
- Tweet van @runwayml over Runway Ads
- Blogbericht van ElevenLabs over het terugkoopaanbod
- Blogbericht van NVIDIA over CoreWeave en Vera Rubin
- Releaseopmerkingen van Claude Code 2.1.286
- Releaseopmerkingen van Zed 1.22.0
- Gemini CLI v0.63.0-preview.0
- Gemini CLI v0.62.0
- Releaseopmerkingen van VS Code 1.140
- HydraFusion in VS Code en de GitHub Copilot-app
- Externe MCP-server van Google Cloud CLI (Google Cloud-blog)
- Codex CLI 0.159.2
- Plaid Speed in Amp
- Thread van @warpdotdev over Factories as Code
- Factories as Code, Warp
- Casestudy over Crosby, Devin
- Presentatie van claude.dev door @ClaudeDevs
- Releaseopmerkingen van ChatGPT
- Releaseopmerkingen van ChatGPT Enterprise en Edu
- Releaseopmerkingen van Kimi Work
- Cue en financieel beheer
- GPT-6.1 Sol in Genspark
- Qwen3.8-27B-pi
- Qwen3.8-27B op Nebius Token Factory
- Bekko System One v0
- ZooWork Instinct Tuned 4B
- Transformers v5.18.0
- TaskSmith
- TraceML 0.4.1 en de Trainer van Transformers
- Transformers met lussen trainen
- Schrijf een eval die nee kan zeggen
- Tienduizend synthetische verzekerden
- cuObject en SCADA Server SDK
- NeMo Relay en Hermes Agent
- OpenShell voor OpenClaw Enterprise
- Proefperiodes voor GitHub Advanced Security voor GitHub Team
- Einde van TLS dat beperkt is tot X25519 op GHE.com
- Casestudy over Bonjour, Runway
- Casestudy over World Juggling Federation, Runway
- Ad Variants in Luma
- Microduck, Pollen Robotics
- Chris Degnan bij Cognition
- Alex Stamos bij Cognition
- Claude Founder House
- Terugblik op AI Engineer Paris door @MistralDevs
- Graduate Fellowships van NVIDIA