ai-powered-markdown-translatorArtigo traduzido do fr para o pt com gpt-6.1-sol.
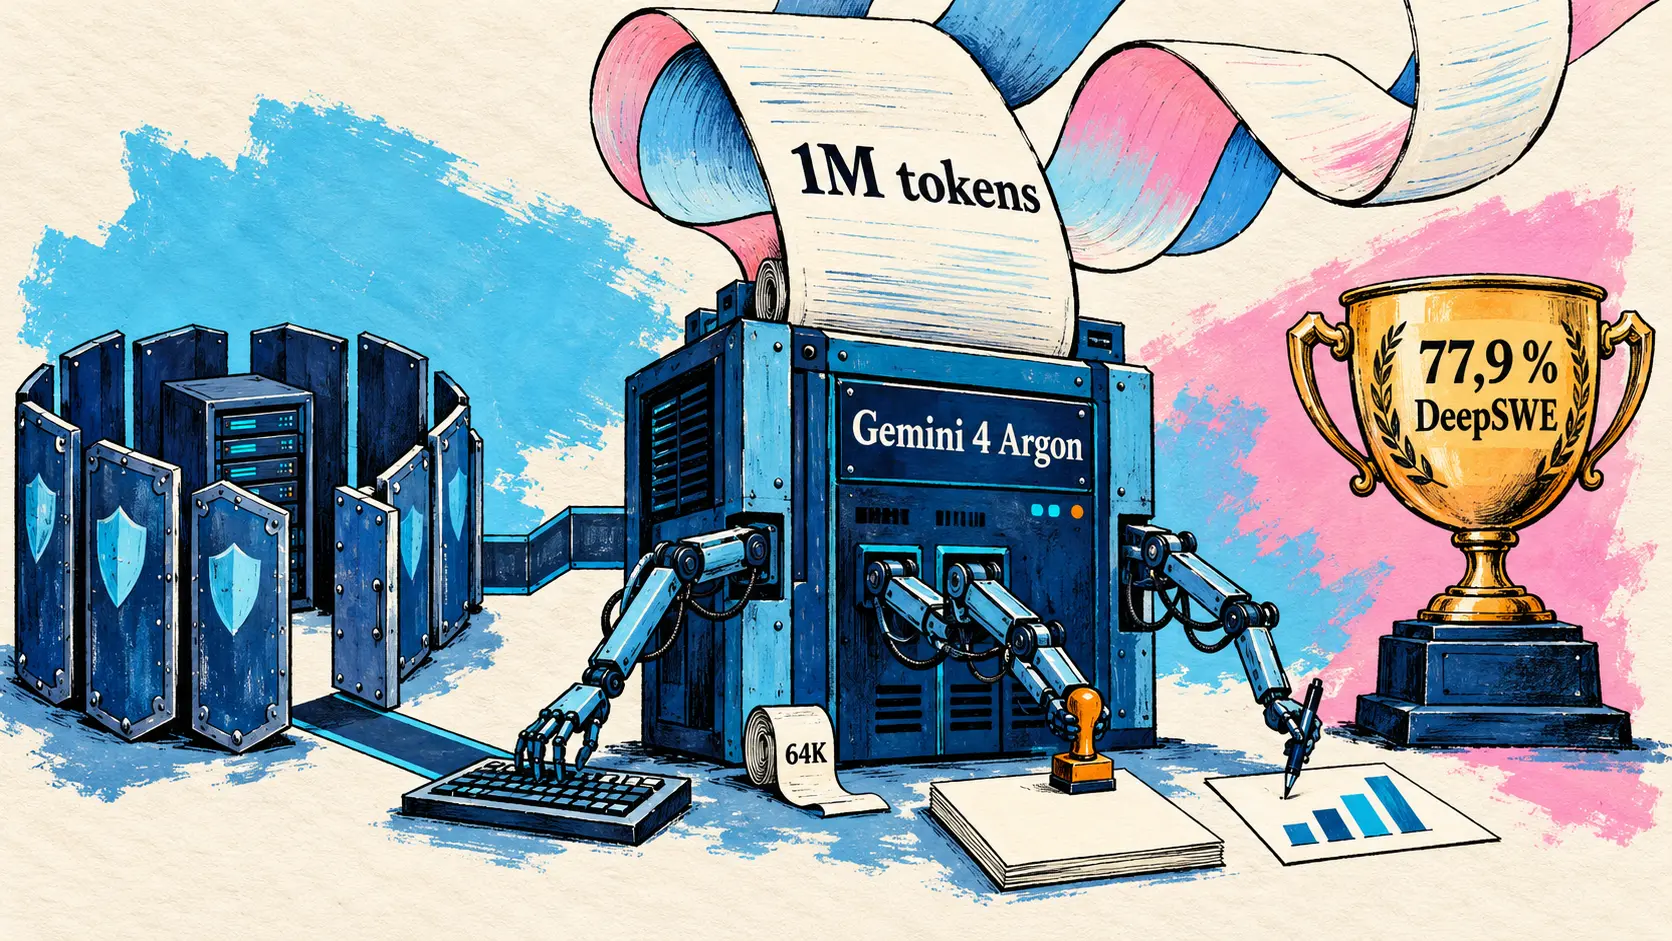
Na quarta-feira, 30 de setembro, a Google anuncia Gemini 4 Argon, um modelo de fronteira que chega primeiro aos defensores de cibersegurança de confiança do Fairwind Program, com um limite de saída aumentado para 1 milhão de tokens. A OpenAI afirma ter frustrado uma campanha coordenada de extração do raciocínio protegido dos seus modelos, cujo núcleo atribui a indivíduos associados à Moonshot AI. A Cohere lança Embed 5 com o seu próprio método de avaliação, Ideogram 4.5 promete retoques sucessivos sem artefactos e a HeyGen lança um modelo de vídeo baseado em MiniMax H3; para os programadores, Claude Code 2.1.286, Zed 1.22.0 e VS Code 1.140 são lançados no mesmo dia.
Gemini 4 Argon: o novo modelo de fronteira da Google, primeiro para os defensores de cibersegurança
30 de setembro — A Google anuncia Gemini 4 Argon, o seu novo modelo de fronteira, numa publicação assinada por Koray Kavukcuoglu, vice-presidente sénior da Google DeepMind e arquiteto-chefe de IA da Google (Chief AI Architect). Argon foi concebido para apoiar um raciocínio aprofundado em fluxos de trabalho longos e complexos (long-horizon workflows), em três áreas: engenharia de software em condições reais, trabalho de conhecimento nas empresas (direito, finanças) e ciberdefesa.
O modelo ainda não está aberto ao público. Chega primeiro a um conjunto de defensores de cibersegurança de confiança do Fairwind Program, lançado a 2 de setembro com Gemini 3.8 Flash Cyber, que o recebem, tal como as equipas internas da Google, sem salvaguardas de cibersegurança (cyber guardrails). Os programadores, as empresas e o público em geral terão acesso «assim que possível», começando pelos clientes pagantes da API e pelos subscritores de Google AI Ultra, sem data anunciada. Até lá, a Google reforça a recusa de pedidos nocivos em cibersegurança e em NRBC, a monitorização da cadeia de pensamento e das ações do modelo, e isola os seus treinos e avaliações de alto risco em sandboxes seladas; a empresa afirma também participar no processo voluntário do governo dos Estados Unidos de acesso aos modelos antes do seu lançamento.
Introducing Gemini 4 Argon – our new frontier model. It’s built for complex workflows across coding, enterprise knowledge work, and cybersecurity defense – rolling out today to a set of trusted testers through our Fairwind Program.
🇵🇹 Apresentamos Gemini 4 Argon, o nosso novo modelo de fronteira. Foi concebido para fluxos de trabalho complexos em programação, trabalho de conhecimento nas empresas e ciberdefesa, e começa hoje a chegar a um conjunto de testadores de confiança através do nosso Fairwind Program. — @GoogleDeepMind no X
O preço já está definido: como preço de lançamento, 2 dólares por milhão de tokens de entrada e 10 dólares de saída, o mesmo preço de GPT-6.1 Sol lançado na véspera, passando depois para 4 e 20 dólares no final de um período cuja duração não é indicada; a entrada em cache custa 95 % menos do que a entrada. O limite de saída passa para 1 milhão de tokens, face aos anteriores 64K, o mais elevado do setor segundo a Google: o modelo pode produzir centenas de milhares de tokens numa mesma trajetória para resolver um problema difícil.
| Preço por milhão de tokens | Preço de lançamento | Preço após o período de lançamento |
|---|---|---|
| Entrada | 2 dólares | 4 dólares |
| Saída | 10 dólares | 20 dólares |
A página da Google DeepMind compara Argon com GPT-6 Astra, Claude Fable 5.1 e Claude Opus 5.5 em dezanove linhas. Argon obtém a melhor pontuação em 13 delas, partilha o primeiro lugar com GPT-6 Astra no CWE-bench v1 (68 %) e é ultrapassado em 5. O código agêntico é a área mais disputada: primeiro no DeepSWE v1.1 (77,9 %) e no Vibe Code Bench, Argon fica em último entre os quatro no FrontierSWE v2 e no Terminal-bench 4.0. A sua vantagem é clara no trabalho de conhecimento, nomeadamente no Legal Agent Benchmark da Harvey (19,6 % contra um máximo de 6,7 % para os outros três), e em contexto longo entre 256K e 1M tokens. A melhor pontuação de cada linha está a negrito.
| Benchmark avaliado (área) | Gemini 4 Argon | GPT-6 Astra | Claude Fable 5.1 | Claude Opus 5.5 |
|---|---|---|---|---|
| Vals Index (trabalho de conhecimento) | 68,9 % | 63,1 % | 65,8 % | 67,0 % |
| AutomationBench (trabalho de conhecimento) | 51,3 % | 41,4 % | 31,4 % | 42,5 % |
| Vals Finance Agent v2 (trabalho de conhecimento) | 65,4 % | 53,5 % | 58,9 % | 58,6 % |
| Legal Agent Benchmark da Harvey (trabalho de conhecimento) | 19,6 % | 5,4 % | 6,7 % | 3,8 % |
| DeepSWE v1.1 (código agêntico) | 77,9 % | 74,1 % | 67,4 % | 74,2 % |
| FrontierSWE v2 (código agêntico) | 55,0 % | 65,5 % | 56,3 % | 62,3 % |
| Vibe Code Bench (código agêntico) | 91,9 % | 89,6 % | 90,3 % | 90,3 % |
| Terminal-bench 4.0 (código agêntico) | 57,4 % | 58,2 % | 57,9 % | 66,4 % |
| PostTrainBench (engenharia ML) | 45,3 % | 44,3 % | 40,2 % | 49,3 % |
| Terminal-Bench Science 0.1 (ciências e matemática) | 57,6 % | 68,1 % | 52,6 % | 63,3 % |
| LABBench 2 (ciências e matemática) | 88,8 % | 85,4 % | 68,6 % | 73,1 % |
| RiemannBench (ciências e matemática) | 76,0 % | 72,0 % | 65,6 % | 69,6 % |
| GraphWalks BFS até 128K (contexto longo, F1) | 99,7 % | 98,7 % | 91,4 % | 90,6 % |
| GraphWalks BFS de 256K a 1M (contexto longo, F1) | 84,2 % | 71,8 % | 65,0 % | 66,8 % |
| Agent’s Last Exam (utilização do computador) | 39,5 % | 34,2 % | — | 38,2 % |
| OSWorld-2.0, subconjunto offline, pontuação parcial (utilização do computador) | 69,2 % | 72,6 % | — | — |
| Chartography (compreensão multimodal) | 71,6 % | 71,0 % | 46,2 % | 66,3 % |
| LVBench (compreensão multimodal) | 91,7 % | 87,5 % | 79,7 % | 83,7 % |
| CWE-bench v1 (cibersegurança) | 68,0 % | 68,0 % | 58,0 % | 67,0 % |
Na Google, milhares de funcionários já o utilizam. No libgav1, o descodificador de vídeo open source da Google, agentes Argon substituíram 32 000 linhas de código SIMD de uma adaptação existente para Rust por código Rust seguro: o descodificador obtido é 2,7 vezes mais rápido do que essa adaptação, com uma saída de vídeo idêntica. Outros agentes prepararam otimizações de memória para os centros de dados que deverão libertar mais de 300 TiB quando forem implementadas. Em cibersegurança, a Wiz utiliza-o na sua iniciativa Scan for Good: Argon descobriu, num software de saúde utilizado por hospitais em todo o mundo, uma vulnerabilidade crítica que expunha dados pessoais sensíveis e que os modelos de fronteira anteriores não tinham detetado.
🔗 Gemini 4 Argon: a nossa próxima era de inteligência de fronteira (blog da Google) 🔗 Página Gemini da Google DeepMind e tabela dos benchmarks
OpenAI afirma ter frustrado uma campanha de destilação e atribui o seu núcleo a indivíduos associados à Moonshot AI
30 de setembro — Numa publicação da sua secção Security, a OpenAI afirma ter detetado e depois neutralizado uma campanha coordenada que visava extrair o raciocínio protegido (protected reasoning) dos seus modelos, ou seja, o rasto interno que um modelo produz para executar uma tarefa. A empresa considera que se trata de destilação adversária (adversarial distillation): a utilização sistemática e não autorizada das saídas ou do raciocínio de um modelo para treinar, reproduzir ou melhorar outro modelo.
Segundo a OpenAI, os operadores não quebraram a encriptação, não comprometeram uma base de dados nem acederam diretamente às conversas armazenadas dos utilizadores. Manipularam as interações para que o raciocínio protegido reaparecesse sob uma forma visível, por exemplo, copiando o raciocínio encriptado de uma conversa para pedir a um modelo, noutra conversa, que o desencriptasse e transcrevesse. Investigadores independentes tinham comunicado, através de divulgação responsável, vulnerabilidades semelhantes, descritas no artigo «Roubo de rastos de raciocínio de APIs de LLM proprietárias», submetido no arXiv a 10 de agosto; a OpenAI confirma que estas vias de ataque eram reais.
| Etapa da campanha | Data ou volume registado pela OpenAI |
|---|---|
| Início da atividade, com baixo volume | 1 de julho |
| Picos de atividade | 24 e 25 de julho |
| Pedidos com o padrão de extração durante os picos | 16 000, provenientes de mais de 4 000 utilizadores |
| Grupo ligado a esse padrão | mais de 15 000 utilizadores |
| Neutralização completa do grupo | 28 de julho |
Quanto à atribuição, a publicação mantém a prudência: não está estabelecido que todos os operadores pertençam a um mesmo interveniente, e os 16 000 pedidos dos picos são tentativas de extração, não necessariamente bem-sucedidas. A OpenAI atribui, contudo, um núcleo da atividade a indivíduos associados à Moonshot AI, responsável pelo desenvolvimento de Kimi.
… we attribute a core cluster of the activity to individuals associated with Moonshot AI …
🇵🇹 … atribuímos um núcleo da atividade a indivíduos associados à Moonshot AI … — OpenAI, publicação da secção Security
Em resposta, a OpenAI baniu ou restringiu as contas fraudulentas, reforçou os seus controlos de registo e de infraestrutura, alargou a monitorização das redes associadas e reforçou a proteção do raciocínio oculto entre utilizadores, espaços de trabalho, organizações e famílias de modelos. Fechou uma via que permitia reutilizar o raciocínio encriptado de outro utilizador para recuperar o seu conteúdo e acrescentou controlos que detetam e retêm uma saída em fluxo (streaming) suscetível de o expor. Os resultados foram partilhados através do Frontier Model Forum e de canais governamentais: segundo a OpenAI, a técnica não é específica dos seus modelos, e qualquer sistema que torne o raciocínio portável ou reutilizável pode estar exposto a riscos semelhantes. A empresa apresenta a destilação adversária como um risco para a segurança dos sistemas e a segurança nacional, uma vez que o raciocínio extraído pode servir para treinar outro modelo sem as salvaguardas do original. O tema não é novo: em fevereiro, a Anthropic tinha atribuído campanhas de destilação à DeepSeek, à Moonshot AI e à MiniMax, e a Anthropic cobra desde 24 de setembro pelos pedidos bloqueados em várias categorias, incluindo a extração de raciocínio.
🔗 Artigo «Roubo de rastos de raciocínio de APIs de LLM proprietárias» no arXiv
Embeddings: Cohere lança Embed 5 e a métrica RCP-nDCG@10, Perplexity publica pplx-embed-v2-context-9b-preview
30 de setembro — A Cohere lança Embed 5, uma família de modelos de embeddings para pesquisa empresarial, em dois níveis que partilham o mesmo espaço de embeddings: Embed 5 Pro, para máxima qualidade e indexação offline, e Embed 5 Fast, para pesquisa interativa, RAG de grande volume e pesquisa agêntica. É possível indexar um corpus com Pro e depois consultá-lo com Fast sem reindexar nada, desde que se mantenha a mesma dimensão de saída: em 40 conjuntos de dados de desenvolvimento, esta configuração recomendada pela Cohere conserva, em média, 98,4 % da qualidade de um sistema inteiramente em Pro, contra 96,6 % de um sistema inteiramente em Fast.
Os dois modelos leem até 128K tokens, aceitam texto, imagens ou ambos fundidos num único vetor, abrangem mais de 100 línguas e produzem vetores de 256 a 2 048 dimensões em float, int8 ou binário. A Cohere recomenda 1 024 dimensões em int8, ou seja, 1 Ko por vetor contra 8 Ko em float32 com 2 048 dimensões. Pro custa 0,12 dólar por milhão de tokens de texto e Fast 0,08 dólar, um terço menos, com uma taxa de processamento de documentos 2,4 vezes superior, em média; as imagens são cobradas a 0,40 dólar por milhão de tokens em ambos. Embed 5 está disponível a partir de hoje através da API da Cohere, Model Vault, Microsoft Foundry e Amazon SageMaker, bem como no North, e pode ser implementado em ambiente privado com vLLM.
| Benchmark (métrica) | Embed 5 Pro | Embed 5 Fast | Outros modelos citados |
|---|---|---|---|
| ViDoRe V3, 8 domínios (RCP-nDCG@10) | 85,8 | 84,5 | Voyage 4 Large 83,7 ; Gemini Embedding 2 83,2 ; OpenAI text-embedding-3-large 75,5 |
| FinanceBench (RCP-nDCG@10) | 80,1 | 80,0 | Pro 21,4 pontos à frente de OpenAI text-embedding-3-large |
| FinQA (RCP-nDCG@10) | 90,0 | 88,8 | — |
| ViDoRe V3 Finance (RCP-nDCG@10) | 85,0 | 83,9 | — |
| PDF analisados, média da suite (RCP-nDCG@10) | 84,8 | 83,4 | Voyage 4 Large 83,6 ; Gemini Embedding 2 80,8 ; Embed 4 78,6 |
| Texto e imagem fundidos, 5 conjuntos (nDCG@10) | 82,3 | 81,2 | Gemini Embedding 2 61,3 |
| Imagem de página, 5 conjuntos financeiros (nDCG@10) | 77,0 | 73,2 | Embed 4 71,1 ; Voyage Multimodal 3.5 70,1 ; Gemini Embedding 2 56,7 |
| 5 línguas europeias (nDCG@10 ou RCP-nDCG@10) | 77 | — | Voyage 4 Large 76 ; Gemini Embedding 2 73 |
A maioria destas pontuações é expressa em RCP-nDCG@10, o método de avaliação que a Cohere publica no mesmo dia (ver abaixo): uma nota da publicação esclarece que este reordena um conjunto fixo de candidatos e mede, portanto, a qualidade da ordenação, em vez da recuperação inicial. A segunda tabela multilingue merece uma leitura integral: a Cohere destaca os seus progressos face ao Embed 4, de até 13 pontos em farsi, mas, nestas dez línguas, Gemini Embedding 2 supera Embed 5 Pro em nove, sendo o chinês a única exceção, e Voyage 4 Large supera-o em cinco. A Cohere apresentará Embed 5 numa sessão no X a 8 de outubro.
🔗 Publicação da Cohere sobre Embed 5 · Anúncio de @cohere no X
RCP-nDCG@10, a métrica com que a Cohere mede Embed 5
30 de setembro — A Cohere publica também RCP-nDCG@10 (Rubric-Calibrated Preferences nDCG@10), o seu método de avaliação da pesquisa. Ponto de partida: nDCG, a métrica do MTEB e do BEIR, compara os resultados com uma lista de documentos anotados previamente, inevitavelmente incompleta, pelo que um documento relevante que nunca tenha sido anotado não recebe pontuação; no estudo da Cohere, 28 % dos documentos marcados como não relevantes são, contudo, considerados úteis por humanos. RCP-nDCG@10 confia o julgamento a um avaliador de IA calibrado, que responde a cinco perguntas de sim/não idênticas para cada consulta e compara os documentos em grupos. Validação às cegas com 46 anotadores em 289 duelos: quando as duas métricas apontam vencedores diferentes, os humanos dão razão a RCP-nDCG em 70 % dos casos. O artigo, o código e os dados estão publicados, e o principal responsável pela manutenção do MTEB anuncia a sua integração. A Cohere afirma ter otimizado a sua quinta geração de Embed e de Rerank com base nesta métrica, esta última ainda sem data, e avisa que estes modelos nem sempre parecerão os melhores quando avaliados apenas pelo nDCG histórico.
🔗 Publicação da Cohere sobre RCP-nDCG@10 · Código e dados no GitHub
Perplexity publica pplx-embed-v2-context-9b-preview e o benchmark context-bench
30 de setembro — A Perplexity publica, em versão de pré-lançamento, sob licença MIT no Hugging Face, pplx-embed-v2-context-9b-preview, um modelo de embeddings contextuais: cada fragmento de um documento é codificado com acesso ao documento completo, para que uma passagem que diz «ela» continue associada à entidade correta. Em vez de um único fragmento «de referência» (gold passage) por consulta, o modelo aprende com um modelo professor, o modelo de compressão de contexto da Perplexity, que atribui uma pontuação a cada token do documento: aprende assim a encontrar a resposta e as passagens que a justificam. Avaliado às cegas no context-bench, um benchmark privado da turbopuffer, cossignatária da publicação (2 099 consultas, 38 894 documentos), supera voyage-context-4; no ConTEB, obtém a melhor média sem vencer todas as tarefas. A Perplexity avisa que os pesos e a interface ainda podem mudar e prepara o acesso através da sua API, sem data.
| Medida publicada pela Perplexity | pplx-embed-v2-context-9b-preview | Diferença face a voyage-context-4 |
|---|---|---|
| Revocação de respostas no context-bench, a K = 10 | 45,5 % | +14,4 pontos |
| Revocação de evidências no context-bench, a K = 10 | 40,6 % | +5,0 pontos |
| Armazenamento por vetor (1 024 dimensões, int8) | 1 Ko | 8 vezes menos do que voyage-context-4 em float32 |
🔗 Publicação da Perplexity Research · Modelo no Hugging Face
Ideogram 4.5: um modelo de edição de imagem concebido para retoques sucessivos
30 de setembro — A Ideogram lança Ideogram 4.5, que apresenta como «o modelo de edição mais preciso». A constatação inicial: a cada retoque, os modelos de imagem acrescentam artefactos, deslocamentos de pixels e desvios de cor, pelo que uma imagem rapidamente se torna inutilizável após várias passagens. Ideogram 4.5 foi concebido para eliminar esta acumulação e tornar possível a edição em várias etapas (multi-turn editing).
Introducing Ideogram 4.5, the most precise edit model. With each edit, leading models add artifacts, pixel shifts, and color changes. Ideogram 4.5 eliminates artifact buildup, making multi-turn editing possible. Live in Ideogram, the API, and launch partners. Open weights soon.
🇵🇹 Eis o Ideogram 4.5, o modelo de edição mais preciso. A cada retoque, os modelos de ponta acrescentam artefactos, deslocamentos de pixels e alterações de cor. Ideogram 4.5 elimina a acumulação de artefactos, tornando possível a edição em várias etapas. Disponível no Ideogram, na API e nos parceiros de lançamento. Pesos abertos em breve. — @ideogram_ai no X
Para sustentar este ponto, a Ideogram publica uma comparação lado a lado dos mesmos retoques sucessivos com GPT Image 2.5 Sunburst, Nano Banana Pro e Nano Banana 2, cujos resultados se tornariam, segundo a empresa, inutilizáveis após alguns retoques. A comparação é visual, sem pontuação numérica. Os exemplos abrangem a cor e a iluminação (sombras, reflexos e altas luzes acompanham a alteração sem mudar a composição), a alteração de texto, a fotografia de produto, a decoração de interiores, o restauro de fotografias antigas passo a passo, a passagem de um esboço ou de um mapa de profundidade para uma imagem e o recorte.
O modelo introduz também a edição em qualquer resolução (Zoom editing): uma área de uma imagem de alta definição, de 24,2 megapixels (4 016 × 6 016 pixels) no exemplo da Ideogram, pode ser retocada sem reduzir a imagem, preservando os seus contornos para a reintegrar sem emendas visíveis. Embora concebido para edição localizada, o modelo também tem um desempenho muito bom em edição geral, segundo a Ideogram.
| Elemento do anúncio | O que se sabe |
|---|---|
| Disponibilidade | a partir de 30 de setembro no Ideogram e na API |
| Parceiros de lançamento | Pika e Luma, que o anunciam no mesmo dia |
| Pesos abertos | prometidos «em breve», como os de Ideogram 4.0 publicados em junho |
| Preço | não divulgado |
🔗 Página do modelo Ideogram 4.5
HeyGen Video: um modelo de vídeo baseado no MiniMax H3, disponível via API
30 de setembro — A HeyGen lança HeyGen Video, um modelo de geração de vídeo destinado a empresas que querem vídeos com qualidade de produção sem pagar o custo correspondente. Baseado no MiniMax H3 e pós-treinado pela HeyGen, produz um vídeo a partir de texto ou de uma imagem, com o som gerado na mesma chamada, e utiliza-se através da API da HeyGen, bem como no OpenRouter, Runware e ComfyUI.
Quanto ao preço, coexistem três valores. O preço começa em 0,01 dólar por segundo até ao fim de outubro, ou seja, um desconto de 50 % sobre o preço normal de 0,02 dólar, segundo a página do catálogo. A sua tabela comparativa usa, por sua vez, o preço de tabela em 768p com áudio, antes das promoções de lançamento: 0,03 dólar por segundo. Mesmo a esse preço, HeyGen Video é o mais barato dos modelos comparados.
| Modelo comparado | Preço de tabela por segundo (768p, áudio) | Elo interno da HeyGen (HeyGen Video = 1 000) |
|---|---|---|
| HeyGen Video | 0,03 dollar | 1 000 |
| Seedance 2.0 | 0,303 dollar | 955 |
| H3 Max | 0,08 dollar | 952 |
| H3 Max Turbo | 0,04 dollar | 920 |
| H3 Max balanced | 0,08 dollar | 860 |
| Kling 3.0 Pro | 0,168 dollar | 857 |
| Veo 3.1 | 0,40 dollar | 744 |
Quanto à qualidade, a HeyGen baseia-se numa avaliação interna realizada com consultas do Artificial Analysis Arena (4 800 votos), com um Elo normalizado para 1 000 para o seu modelo. Num teste de preferência às cegas frente ao H3 Max, 55,8 % dos 650 votos favorecem HeyGen Video, num intervalo de 49 a 62 % que não exclui um empate. Para um clip de 10 segundos de imagem para vídeo, o tempo de inferência do transformer de difusão cai para 3,7 segundos, contra 4,1 para H3 Max Turbo e 8,3 para H3 Max, excluindo o tempo de legendagem.
A MiniMax saudou o lançamento e destacou, no mesmo dia, outro modelo derivado de H3: Boreal-H3 da Creatify, um modelo de vídeo otimizado para publicidade.
🔗 Catálogo HeyGen Video · Anúncio de @HeyGen no X
Assistentes e agentes generalistas: as skills do Gemini, Manus Flex e Grok Bot
A aplicação Gemini lança as skills, que substituirão os Gems
30 de setembro — A Google lança as skills na aplicação Gemini: instruções guardadas uma vez e invocadas digitando uma barra oblíqua seguida do seu nome. O Gemini também pode criá-las a partir das conversas e executá-las por iniciativa própria quando um prompt corresponde, várias skills podem ser combinadas e cada uma pode incluir ficheiros de referência (texto simples, PDF, imagens). Já presentes no Gemini Spark, chegam ao chat Gemini em todo o mundo, para todos os níveis de subscrição do Google AI e, por enquanto, para pessoas com 18 anos ou mais; os clientes do Workspace seguir-se-ão nas próximas semanas. As skills substituirão os Gems, que desaparecerão a partir de novembro para contas pessoais, em março de 2027 para Workspace business, enterprise e nonprofit e em junho de 2027 para a educação, com migração automática. O Opal, a ferramenta de criação de miniaplicações, também será encerrado em novembro, tal como os «Gems by Google Labs», que não serão migrados.
🔗 Deixe que as skills do Gemini tratem das suas tarefas mais repetitivas (blog da Google)
Manus Flex: a sua própria chave API no agente Manus
29 de setembro — A Manus lança Manus Flex, que permite alimentar o Manus com a chave API de um fornecedor de inferência suportado (bring your own API key). Até agora, o Manus escolhia o modelo e fornecia o harness e a infraestrutura do agente; com Flex, a chave de um fornecedor alimenta os mesmos projetos, ferramentas, ambientes de execução e fluxos de trabalho do agente, com um modelo principal e um nível de esforço de raciocínio à escolha. A faturação divide-se: a inferência é cobrada diretamente pelo fornecedor, enquanto os outros serviços e a infraestrutura usados por uma tarefa continuam a consumir créditos Manus. OpenRouter, Fireworks e Modal são os três primeiros membros do programa de parceiros de inferência (Manus Flex Inference Partner Program). A publicação, divulgada no dia seguinte ao lançamento de Manus 2.0, não indica plano, preço nem lista de modelos.
Grok Bot delega o código ao Cursor e gere as pull requests
30 de setembro — Dois dias depois de Team Bots, a SpaceXAI reforça Grok Bot para o desenvolvimento de software. Numa sequência de publicações da conta @bot, a empresa anuncia que os seus Bots podem delegar tarefas de código ao Cursor, gerir as pull requests através de plugins GitHub e Origin (este último não é descrito) e partilhar demonstrações em vídeo do que constroem. A SpaceXAI publica também, sob a forma de modelos para instalar (templates), os Bots da sua própria equipa de engenharia, cada um com as suas skills, rotinas e conectores. A sequência não especifica plano, preço nem data, e não é acompanhada por nenhuma publicação no x.ai. A ligação ao Cursor não é nova: Grok Bot for Enterprise foi disponibilizado durante duas semanas aos clientes Grok e Cursor Enterprise no início de setembro; a novidade é que um Bot delega por si próprio o trabalho de código.
🔗 Sequência de publicações de @bot no X
Robótica e modelos do mundo: Praxis-1 da Runway, MolmoAct 2 da Ai2 e Physis-Lang da NVIDIA
Runway apresenta Praxis-1, um modelo de ação no mundo com pesos abertos
30 de setembro — Runway apresenta Praxis-1, o seu primeiro modelo de ação no mundo (world action model) com pesos abertos, destinado a controlar robôs reais. Baseia-se no mesmo pré-treino com vídeo dos seus modelos de mundo, como Solaris ou GWM Worlds 2, e pretende ser um modelo de política generalista para programadores e investigadores em robótica. A aposta da Runway: as demonstrações de robótica são escassas, o vídeo é quase ilimitado. Nas suas demonstrações, uma mesma política passa de um estúdio para uma cozinha sem novo treino. Ainda nada está disponível para download: Praxis-1 está em testes na Noble Machines, na Standard Bots e na Ultra, cada uma com o seu próprio hardware, e o seu lançamento público, incluindo os pesos, está anunciado para os próximos meses.
| Medida publicada pela Runway | Resultado anunciado |
|---|---|
| Correlação entre simulação no modelo de mundo e resultados reais | 0,95 |
| Erro final de posicionamento após ajuste, com vídeo da web | 16,1 cm |
| O mesmo erro com vídeo de um robô teleoperado | 16,0 cm |
MolmoAct 2 da Ai2 lidera o Reality Check, após ajuste fino pelo organizador do banco de testes
30 de setembro — Ai2 anuncia que MolmoAct 2, o seu modelo de robótica totalmente aberto, ocupa o primeiro lugar em taxa de sucesso global no Reality Check, um banco de testes independente de manipulação em condições reais, com uma ressalva significativa: os modelos recebem ajuste fino nas tarefas do banco de testes pelo organizador, Poke & Wiggle. Lançado na véspera por esta empresa, o Reality Check conta com 14 400 execuções em robôs reais, em estações FR3 Duo instaladas no Deutsches Museum de Munique, em dez ambientes (separar parafusos, ligar um conector DC, abrir uma caixa de ferramentas com uma chave de fendas…). Duas vertentes continuam «por chegar»: objetos colocados fora da área de treino e um treino intermédio com 100 horas de dados das estações.
| Modelo avaliado | Taxa de sucesso global | Taxa de sucesso após cerca de 10 demonstrações por ambiente | Taxa de sucesso após cerca de 300 demonstrações por ambiente |
|---|---|---|---|
| MolmoAct 2 | 28 % | 4 % | 44 % |
| Pi 0.5 | 21 % | 5 % | 33 % |
| DiT-Flow | 19 % | 2 % | 29 % |
| GR00T N1.7 | 12 % | 4 % | 19 % |
🔗 Tweet da Ai2 · Classificação Reality Check
Physis-Lang: legendas que explicam a física aos modelos de mundo
29 de setembro — Investigadores da NVIDIA, do MIT e da Universidade de Oxford publicam Physis-Lang, um framework que acrescenta raciocínio físico às legendas de vídeos para melhorar os modelos de mundo. As legendas tornam explícitas as causas, as leis em jogo e os efeitos; um crítico especializado identifica afirmações em falta ou sem fundamento, um agente aperfeiçoa as instruções de legendagem, e as falhas do modelo servem para procurar vídeos que preencham as suas lacunas. Segundo a NVIDIA, acrescentar este raciocínio apenas ao prompt, sem novo treino, melhora em 5,62 pontos a pontuação PhyGenBench do Cosmos 3. Com treino, Physis-Lang no Cosmos3-Super e no Cosmos3-Nano ocupa os dois primeiros lugares da classificação Physics-IQ Verified na geração de vídeo a partir de imagem (48,2 e 43,3, contra 42,7 da anterior melhor pontuação). PhyGenBench e VideoPhy-2 são avaliados pelo GPT-5.5, e Veo 3.1 mantém uma ligeira vantagem no conjunto completo do VideoPhy-2.
| Benchmark de física em vídeo | Cosmos3-Nano | Veo 3.1 | Physis-Lang no Cosmos3-Nano |
|---|---|---|---|
| PhyGenBench | 61,67 | 65,63 | 71,04 |
| Physics-IQ Verified | 40,23 | 34,99 | 43,41 |
| VideoPhy-2 Hard | 48,31 | 58,43 | 62,36 |
| VideoPhy-2, conjunto completo | 60,41 | 68,87 | 68,02 |
🔗 Página do projeto Physis-Lang · Anúncio de @NVIDIAAI no X
Modelos abertos: Hunmin-397B-A17B-CUA e JEV-27B-VL
Hunmin-397B-A17B-CUA incorpora as capacidades de agente do Qwen-CUA num MoE de 397 mil milhões de parâmetros
30 de setembro — No blog comunitário da Hugging Face, hojun Lee detalha Hunmin-397B-A17B-CUA, um modelo de utilização de computador (computer use) publicado sob Apache-2.0 pela organização mncai, com uma ressalva feita pelos próprios autores: as avaliações são internas, com uma única execução nos bancos de testes de agentes, e não são comparáveis às classificações publicadas (o modelo base obtém aí 48,16 no OSWorld, contra os 62,2 anunciados no OSWorld-Verified). O modelo baseia-se no Qwen3.5-397B-A17B, uma mistura de especialistas com 17 mil milhões de parâmetros ativos, e todo o projeto coube num único nó com oito B200. A equipa calculou a diferença de pesos entre o seu modelo base e o Qwen-CUA, já especializado, e incorporou apenas uma versão de posto reduzido numa seleção de módulos: só esta transferência faz o OSWorld-316 passar de 48,84 para 68,25, sem herdar a fraqueza do Qwen-CUA na ancoragem visual. Um ajuste fino, seguido de aprendizagem por reforço GRPO, acrescenta 4,3 pontos.
| Banco de avaliação (protocolo interno) | Base Qwen3.5-397B | Hunmin-CUA | Qwen-CUA (origem) |
|---|---|---|---|
| OSWorld, 360 tarefas | 48,16 | 70,45 | 77,12 |
| WindowsAgentArena, 153 tarefas | 41,77 | 50,85 | 56,68 |
| ScreenSpot-Pro | 72,74 | 75,61 | 62,20 |
| KMMLU-Pro (coreano) | 77,91 | 76,12 | 71,41 |
🔗 Artigo sobre Hunmin-CUA · Pesos na Hugging Face
AutoTrust AI publica JEV-27B-VL, um modelo de decisão aberto que também avalia imagens
30 de setembro — AutoTrust AI publica sob Apache-2.0 JEV-27B-VL, a versão com visão do JEV-27B, o seu modelo de decisão aberto apresentado a 27 de setembro. Mostram-se-lhe imagens e texto, faz-se uma pergunta, e responde numa única passagem com uma probabilidade calibrada para cada opção, em cerca de cem milissegundos; quando a pergunta o exige, raciocina passo a passo enquanto observa as imagens. A sua cabeça de decisão, porém, não viu qualquer imagem durante o treino. Teste principal: no MicroLens, um conjunto de dados público de uma aplicação de vídeos curtos, ordena 20 vídeos candidatos para 200 utilizadores apenas a partir das miniaturas, e iguala, em AUC, uma filtragem colaborativa treinada com 59 045 utilizadores, com uma taxa superior de inclusão do vídeo certo no top 5. Os autores recordam que este resultado provém de um único conjunto de 200 utilizadores.
| Método de recomendação no MicroLens | AUC | Vídeo certo no top 5 |
|---|---|---|
| JEV-27B-VL, apenas miniaturas, sem dados de interação | 0,727 | 59 % |
| Filtragem colaborativa treinada com 59 045 utilizadores | 0,728 | 49 % |
| JEV-27B-VL, apenas títulos | 0,649 | 46 % |
| Ordem aleatória | 0,489 | 21 % |
Classificações: o Open TTS Leaderboard da Hugging Face e o AURORA da LILT
Hugging Face lança o Open TTS Leaderboard, uma classificação aberta da síntese de voz
30 de setembro — Hugging Face lança o Open TTS Leaderboard, uma classificação da síntese de voz (text-to-speech, TTS) centrada nos modelos abertos e multilingues. O Hub conta com mais de 8 000 modelos TTS, mas as arenas de votação que servem de referência não acompanham bem o ritmo e sub-representam os modelos abertos: segundo o artigo, apenas 16 dos 92 modelos classificados pela Artificial Analysis têm pesos abertos. A classificação substitui, por isso, os votos por medidas objetivas: a inteligibilidade (taxa de erro por palavra ou por carácter entre o texto pedido e a sua transcrição pelo Qwen3 ASR), a velocidade (inferência em lote e tempo até ao primeiro som, no H200 e no processador) e a fidelidade de uma voz clonada (similaridade WavLM). Avaliar um modelo demora algumas horas em vez de algumas semanas de votos. Em inglês, lideram Kokoro-82M, supertonic-3 e s2-pro da Fish Audio; em multilingue, OmniVoice, s2-pro e Fun-CosyVoice3-0.5B. Os autores avisam que nem a naturalidade nem a expressividade são medidas, e publicarão os seus scripts de avaliação «em breve».
🔗 Artigo sobre o Open TTS Leaderboard · A classificação na Hugging Face
LILT lança AURORA, uma classificação multilingue de tarefas de agentes
30 de setembro — LILT lança AURORA, uma classificação que mede os modelos de ponta em tarefas de agentes noutras línguas além do inglês, todas concebidas e verificadas por especialistas falantes nativos, sem tradução automática. O lançamento inclui quatro bancos de testes: um Terminal-Bench multilingue com 324 tarefas de programação em dez línguas, uma versão multilingue de τ³-bench para apoio ao cliente, MultiChallenge para o seguimento de instruções em contexto longo e GAIA-v2-LILT para raciocínio agêntico. Claude Opus 5.5 lidera o Terminal-Bench multilingue e ocupa o primeiro lugar no τ³-bench em cada uma das cinco línguas. No GAIA, os modelos ganham, em média, 20,7 pontos na versão auditada pela LILT em comparação com uma tradução automática: para a LILT, esta diferença mede o erro introduzido pela tradução. O mesmo diálogo consome também cerca de 1,4 vezes mais tokens em coreano ou árabe do que em inglês.
| Modelo avaliado (Terminal-Bench multilingue, excerto) | Taxa de sucesso média |
|---|---|
| Claude Opus 5.5 (effort high) | 76,4 % |
| Claude Opus 5 (effort high) | 73,5 % |
| Gemini 3.8 Flash | 67,3 % |
| GPT-6 Sol | 64,8 % |
| Command A+ | 4,3 % |
🔗 Artigo da LILT sobre AURORA · A classificação AURORA
Setor público e empresas: Claude for Government, o agente de compras da Anthropic e a OpenAI com a America’s SBDC
Claude for Government entra em disponibilidade geral
30 de setembro — Claude for Government sai da beta: Anthropic anuncia a sua disponibilidade geral para as agências federais e as agências dos estados americanos. A plataforma, em beta pública desde julho, fornece as capacidades de programação e de trabalho agêntico do Claude num ambiente autorizado FedRAMP High, com funções comparáveis às dos clientes comerciais; o CLI Claude Code e o Claude for Microsoft 365 chegam à plataforma em acesso antecipado. Não há licença por posto: as agências pagam a utilização em escalões fixos, com um limite rígido que impede ultrapassar o orçamento contratado, e os mapeamentos de grupos SCIM definem, por nível de posto, limites de débito, tetos em dólares e modelos permitidos. Quanto ao controlo, as operações sensíveis do lado da Anthropic exigem aprovação de duas pessoas, as exportações de utilização contêm apenas dados de medição e o histórico das conversas permanece no dispositivo gerido pela agência. A Anthropic não publica qualquer preço.
🔗 Claude for Government está agora em disponibilidade geral
Na Anthropic, um agente construído sobre Managed Agents recebe os pedidos comerciais
30 de setembro — Anthropic conta como a sua equipa comercial refez a receção dos pedidos recebidos, dezenas de milhares por mês, com um agente de compras construído sobre Claude Managed Agents, em beta. Presente nas páginas Contactar vendas e Preços, no claude.ai e nos e-mails, faz algumas perguntas, recomenda um plano e um número de postos, e depois conduz à compra, transfere o contacto para um comercial com todo o histórico, ou limita-se a responder; o cliente pode escolher uma pessoa desde o início. Segundo o artigo, assinado por Carl Johnson, o agente mantém milhares de conversas por dia; os potenciais clientes que encaminha tornam-se oportunidades mais de duas vezes mais frequentemente do que com o antigo formulário e fecham negócio cerca de cinco dias mais depressa, e a percentagem das conversas que exigem um comercial para fechar negócio caiu cerca de metade. Um único engenheiro construiu a primeira versão em poucas semanas; o agente orienta frequentemente as pequenas equipas para o plano Team em vez de Enterprise, uma escolha que a Anthropic decidiu assumir.
🔗 Como a equipa comercial da Anthropic reformulou a receção de pedidos com Claude Managed Agents
OpenAI associa-se à America’s SBDC e publica um relatório sobre as pequenas empresas
30 de setembro — OpenAI associa-se à America’s SBDC, a rede nacional dos centros de desenvolvimento das pequenas empresas americanos, que acompanha 1 milhão de empreendedores por ano. Numa primeira fase, através do programa de formadores comunitários da OpenAI Academy (Community Trainer Program), lançado como projeto-piloto a 23 de setembro, a OpenAI prevê formar cerca de 150 consultores, que conduzirão ações de formação de três horas nas redes SBDC, com o objetivo de chegar presencialmente a pelo menos 1 000 pequenas empresas. No mesmo dia, o relatório «Pequenas empresas, maiores capacidades» quantifica a utilização: na semana de 9 a 15 de setembro, cerca de 4 milhões de trabalhadores de empresas com menos de 500 pessoas utilizaram os produtos da OpenAI, dos quais quase um em cada cinco numa empresa com menos de 10 trabalhadores. Em agosto, os tokens de saída agênticos, nomeadamente os do ChatGPT Work e do Codex, representavam dois terços dos tokens de saída das pequenas empresas, contra um terço em abril.
🔗 Artigo da OpenAI sobre as pequenas empresas
Runway Ads: um motor autónomo para publicidade de performance
30 de setembro — A Runway lança o Runway Ads, que trata de ponta a ponta da componente criativa das campanhas pagas. Liga-se uma conta publicitária e um kit de marca: a ferramenta, construída sobre o Runway Agent, gera peças criativas de vídeo e imagem, publica as variantes aprovadas no Meta, Google e TikTok, analisa o seu desempenho e produz a vaga seguinte em torno das variantes que atraíram o investimento. Adapta cada peça criativa ao mercado de destino segundo regras definidas pela equipa, incluindo o texto no ecrã, redimensiona-a para cada formato, submete-a a uma verificação automática de conformidade com a marca e respeita os limites do orçamento. A aprovação humana está ativada por predefinição; a publicação automática pode ser ativada por campanha ou por tipo de variante.
| Indicador interno da Runway, desde julho | Resultado publicado no artigo |
|---|---|
| Anúncios por semana | de 77 para cerca de 900 |
| Retorno sobre o investimento publicitário | duplicado |
| Conversão | cerca de +34 %, taxa de cliques estável |
| Custo por subscritor | −41 % |
O Runway Ads está, por enquanto, em fase piloto junto de parceiros empresariais selecionados. O tweet de anúncio promete uma disponibilização alargada nas próximas semanas e afirma que a ferramenta também permitiu acrescentar 100 milhões de dólares de ARR (receita anual recorrente) desde julho, um valor ausente do artigo.
🔗 Artigo sobre o Runway Ads · Tweet de @runwayml
ElevenLabs avaliada em 22 mil milhões de dólares após uma oferta de recompra de 300 milhões
30 de setembro — A ElevenLabs concluiu uma oferta de recompra de ações (tender offer) de 300 milhões de dólares destinada aos seus trabalhadores, que a avalia em 22 mil milhões de dólares, o dobro da sua avaliação na série D de fevereiro. A operação é liderada pela Wellington e pela T. Rowe Price; EQT, Goldman Sachs, GIC, OTPP, Sapphire Ventures e BDT & MSD entram no capital, ao lado de investidores existentes como Andreessen Horowitz, Lightspeed e ICONIQ. Os clientes empresariais representam 55 % do volume de negócios: o ElevenAgents processa mais de 15 milhões de conversas por semana, três vezes mais do que em fevereiro, e a sua receita anual recorrente mais do que triplicou nesse período. Segundo uma análise dos seus clientes, os agentes de voz resolvem os pedidos 31 % mais depressa do que os agentes de chat. A empresa conta com mais de 800 trabalhadores, quatro anos após uma primeira ronda com uma avaliação de 9 milhões de dólares.
Vera Rubin NVL72 em produção na CoreWeave, Cognition mede até 4,8 vezes mais débito
30 de setembro — Por ocasião do CoreWeave Fully Connected, em São Francisco, a NVIDIA detalha a entrada em produção do Vera Rubin NVL72 na CoreWeave: a plataforma, com a rede Spectrum-X Ethernet 102.4T, está disponível no CoreWeave Cloud, que recebeu os seus primeiros racks de produção no início do mês. A Cognition, responsável pelo Devin, é o primeiro cliente a executar aí cargas de trabalho de produção: nos primeiros testes com tarefas retiradas do FrontierCode, mediu um débito total de tokens para a inferência do SWE-2 até 4,8 vezes superior ao obtido com o GB200 NVL72. A CoreWeave também disponibilizará o CPU Vera, concebido para agentes: 128 CPU e 11 264 núcleos por rack, suficientes para executar mais de 11 000 ambientes isolados em simultâneo, com sandboxes de agentes que arrancam mais de três vezes mais depressa. Por fim, a CoreWeave lança o CoreWeave Forge, que reúne Weights & Biases, OpenPipe e marimo para alimentar novamente o treino a partir da produção; a sua aprendizagem por reforço sem servidor (serverless RL) é anunciada como 1,4 vezes mais rápida, com um custo 40 % inferior.
🔗 Artigo da NVIDIA sobre CoreWeave e Vera Rubin
Agentes de código e ferramentas de desenvolvimento: Claude Code 2.1.286, Zed 1.22.0, Gemini CLI, VS Code 1.140, HydraFusion e um servidor MCP para gcloud
Claude Code 2.1.286: marcadores no VS Code, novas tentativas limitadas e modo bare mais restrito
30 de setembro — O Claude Code 2.1.286, publicado às 19 h 10 UTC, conta com 88 entradas, incluindo 49 correções. O pedido de permissão indica a sua posição quando se acumulam vários pedidos («2 de 5»), e a extensão VS Code passa a ter marcadores (bookmarks) para guardar respostas do Claude num painel lateral, uma linha Perguntas que reúne as perguntas feitas pelo Claude e as respostas escolhidas, e pré-visualizações das opções nos cartões de perguntas. Duas alterações de comportamento são relevantes: um único limite passa a abranger as novas tentativas de uma chamada ao modelo, ou seja, no máximo 14 pedidos com as definições predefinidas, e --bare passa a ligar apenas os servidores MCP nomeados na linha de comandos, sem lembretes do sistema nem tarefas em segundo plano. Se existir um skill chamado verify, o Claude recebe instruções para o executar imediatamente antes de cada commit, exceto para documentação ou testes, e os plugins rejeitam fontes npm que sejam repositórios git ou pastas. Por fim, quando a API rejeita o modelo predefinido, o Claude Code tenta novamente uma vez com o modelo anterior do mesmo nível, em vez de falhar a cada interação.
🔗 Notas de versão do Claude Code 2.1.286
Zed 1.22.0: um modelo por subagente
30 de setembro — O Zed publica a sua versão estável 1.22.0, centrada nos subagentes: a ferramenta spawn_agent aceita um parâmetro opcional model, para iniciar um subagente com um modelo diferente do configurado ou herdado do agente principal, e o cartão de cada subagente apresenta o modelo utilizado. Os subagentes também compactam o seu contexto automaticamente, o que lhes permite, segundo o Zed, executar tarefas mais longas. Quanto aos modelos, o GPT-6.1 Sol chega em BYOK com uma chave API OpenAI, o Grok 4.7 passa a estável como modelo recomendado no SuperGrok e na xAI, e a lista de modelos OpenCode Zen e Go é obtida dinamicamente. A versão corrige uma fuga de cerca de 2 Mo de memória por comando concluído no terminal e altera um atalho: o fecho do dock ativo passa a ctrl-alt-w em todas as plataformas. No total, 18 novidades e 37 correções.
🔗 Notas de versão do Zed 1.22.0
Gemini CLI: v0.62.0 estável e uma versão de pré-visualização que executa os planos sem confirmação
29 de setembro — O Gemini CLI publica duas versões à noite (UTC). A v0.62.0 passa a estável às 21 h 17: as suas 19 entradas retomam a versão de pré-visualização e as nightlies apresentadas de 16 a 24 de setembro (títulos estruturados das chamadas às ferramentas MCP, conservação do token de atualização OAuth (refresh token), Gemini 3.8 Flash e 3.5 Flash Lite). A novidade está na versão de pré-visualização v0.63.0-preview.0, publicada às 20 h 58: em modo não interativo, o agente passa a redigir e executar o seu plano sem esperar por confirmação (PR 29539), enquanto as instruções do Plan Mode o levavam a responder com uma simples mensagem de alinhamento, sem qualquer chamada a ferramentas. Um limite maxChars de 0 ou menos também desativa o truncamento das saídas das ferramentas (PR 29542). A nightly de 30 de setembro abre a série 0.64.0: em modo ACP, o CLI passa finalmente a comunicar a utilização padrão, enquanto clientes como Zed ou OpenHands sobrestimavam a faturação em cerca de 3 vezes, segundo a PR 29549.
🔗 Gemini CLI v0.63.0-preview.0 · Gemini CLI v0.62.0
VS Code 1.140 adota o harness Copilot
30 de setembro — O Visual Studio Code 1.140 é lançado em versão estável com o harness Copilot (Copilot harness): baseado no Copilot SDK, dá ao agente do VS Code o comportamento e as capacidades da app GitHub Copilot e do Copilot CLI, e é executado num processo host dedicado, baseado no Agent Host Protocol, permitindo aceder à mesma sessão a partir de várias janelas; as notas avisam que poderá já estar selecionado por predefinição para alguns utilizadores. Em fase experimental, as sessões com várias pastas dão a cada chat a sua própria pasta ou worktree, e o agente pode delegar uma sessão num host remoto, escolhido segundo o sistema, a memória, o número de CPU e o modelo. Chegam três controlos para as empresas: a explicação, no chat, das versões mínimas exigidas pelo administrador, um nível predefinido do modo Auto estabelecido por uma definição gerida (autoTier), e a adição da identidade do utilizador aos dados OpenTelemetry do Copilot, opção desativada por predefinição.
🔗 Notas de versão do VS Code 1.140
HydraFusion chega ao VS Code e à app GitHub Copilot
30 de setembro — O GitHub alarga o HydraFusion, a orquestração de vários modelos lançada a 4 de setembro no Copilot CLI, ao VS Code (a partir da versão 1.140, ou Insiders) e à app GitHub Copilot, ainda em pré-visualização de investigação. O HydraFusion é escolhido no seletor como um modelo, mas não é um modelo: trata a escolha do fluxo de trabalho como um problema de otimização e seleciona um de três esquemas. No modo Single, um único modelo resolve a tarefa; no modo Cascade, um modelo eficiente redige e uma verificação de qualidade aceita o resultado ou encaminha-o para um modelo mais potente; no modo Critique, um crítico com acesso apenas de leitura, proveniente de outra família de modelos, revê o resultado, e depois o redator faz uma revisão. Enquanto o modo Auto escolhe um modelo por pedido, o HydraFusion coordena vários modelos numa mesma interação. Está disponível em Copilot Pro, Pro+, Business e Enterprise, sendo necessário que um administrador ative as pré-visualizações em Business e Enterprise; o GitHub não publica novos números.
🔗 HydraFusion no VS Code e na app GitHub Copilot
Google Cloud disponibiliza em pré-visualização um servidor MCP remoto que executa gcloud e bq
O Google Cloud acrescenta aos seus servidores MCP remotos geridos o Google Cloud CLI remote MCP server, em pré-visualização pública. Reúne centenas de comandos das ferramentas de linha de comandos gcloud e bq (BigQuery) através de duas ferramentas MCP, run_gcloud_command e run_bq_command. O Google justifica a escolha da linha de comandos com dois argumentos: um comando encapsula operações com várias etapas que a API obrigaria a orquestrar, e os modelos foram amplamente treinados com a documentação pública desses comandos. O servidor remoto evita a instalação do CLI no ambiente do agente, disponibilizando estas operações em plataformas de agentes alojadas na web, como o Gemini Enterprise. Os comandos são executados numa sandbox isolada, através de um proxy com acesso restrito à rede e sem credenciais do ambiente (ambient credentials), cada um com as permissões IAM da identidade que faz a chamada, autenticada por Agent Identity ou OAuth 2.0; o Model Armor pode filtrar prompts e respostas, e cada chamada pode ser registada nos registos de auditoria. O servidor em si não é faturado: apenas os recursos criados e as eventuais transferências de dados são cobrados.
🔗 Dê mais capacidades aos seus agentes com o Google Cloud CLI remote MCP server (blog do Google Cloud)
Breves
- Codex CLI 0.159.2 — Publicada a 29 de setembro às 23 h 57 UTC, esta versão contém apenas uma correção retroportada: no Windows, as janelas de consola deixam de piscar quando o Codex inicia processos em segundo plano ou comandos na sua sandbox. 🔗 fonte
- Plaid no Amp — Os modos do Amp que utilizam GPT-6 Astra passam a contar com Plaid, baseado no nível ultrarrápido da OpenAI: pedidos até 6 vezes mais rápidos por um custo por token multiplicado por 6, reservado à inferência fornecida pelo Amp; os subagentes mantêm a velocidade fast ou standard, e o Amp não publica qualquer preço. 🔗 fonte
- Warp e Factories as Code — O Warp apresenta a configuração das suas fábricas de software como «o Terraform dos agentes»: um repositório descreve agentes, automações, acessos e medição. O formato factory.yaml data do final de agosto; o guia interativo detalha o acesso federado à AWS ou à GCP, os webhooks e as integrações com Slack, Linear ou Jira. 🔗 fio do Warp · 🔗 guia de configuração
- Devin na Crosby — Num estudo de caso da Cognition, a sociedade de advogados nova-iorquina Crosby, com cerca de uma dúzia de engenheiros para mais de 50 advogados, confia ao Devin a primeira resposta aos incidentes: 20 a 40 bugs e alertas analisados por dia, em cerca de 5 minutos na maioria dos casos, e pelo menos 50 % menos ruído no Sentry. 🔗 fonte
- claude.dev — A Anthropic apresenta oficialmente claude.dev como a casa dos programadores que desenvolvem com Claude: análises técnicas aprofundadas, guias de Claude Code e da API, secções Agents, Engineering, Playbooks e Skills, e uma página Terminal como surpresa escondida. Artigos do site já eram partilhados desde 22 de setembro. 🔗 fonte
- Sites do ChatGPT editáveis — Segundo as notas de versão de 29 de setembro, um Site publicado pode ser editado com Edit site e agendado a partir de Automations nos planos Plus e Pro; no Enterprise, os Sites privados podem recorrer às aplicações ligadas, com uma definição Allow use in Sites por plugin, desativada por predefinição. 🔗 notas de versão do ChatGPT · 🔗 notas do Enterprise e do Edu
- Kimi Work 3.2.15 — A versão de 30 de setembro disponibiliza a coedição entre humanos e IA de documentos Notion e Feishu no navegador integrado, recolhe por predefinição a sequência de ações do agente e corrige a corrupção de ficheiros durante a edição simultânea de um PPT. 🔗 fonte
- Cue gere as finanças — A aplicação de agentes pessoais lançada com Manus 2.0 acompanha agora subscrições e tendências de despesas e coloca as contas bancárias em piloto automático, através do Plaid; não foram especificados países, planos nem condições. 🔗 fonte
- GPT-6.1 Sol no Genspark — O Genspark disponibiliza GPT-6.1 Sol no AI Chat, Code Agent e Claw no dia seguinte ao seu lançamento, retomando os argumentos da OpenAI (uma inteligência próxima da de Astra por um quinto do seu preço de API), sem especificar planos nem custos em créditos. 🔗 fonte
- Qwen3.8-27B-pi — Thomas Kim publica sob Apache-2.0 um ajuste fino de Qwen3.8-27B para o harness Pi que reordena os níveis de esforço: no Terminal-Bench 2.1, o nível medium iguala o modelo base em xhigh (67 tarefas em 89) com cerca de 41 % menos tokens de saída. 🔗 fonte
- Qwen3.8-27B na Nebius — A Qwen divulga a chegada do seu modelo denso de 27 mil milhões de parâmetros à Nebius Token Factory, anunciada a 28 de setembro, para código, investigação e fluxos de agentes; não foram comunicados preços nem capacidade de processamento. 🔗 fonte
- Bekko System One v0 — Yuichi Tateno publica três modelos de decisão de 17M, 68M e 400M de parâmetros, dos quais os dois mais pequenos funcionam num navegador, e o benchmark S1MB: o 400M obtém 50,60 contra 59,59 do Jev 1.13, mas 54,48 contra 96,27 em generalização. 🔗 fonte
- ZooWork Instinct Tuned 4B — A SRP publica sob Apache-2.0 um modelo de decisão de 4 mil milhões de parâmetros, construído sobre Qwen3.5-4B, que pontua as opções numa única passagem sem descodificar: 198 em 231 (85,71 %) nas tarefas públicas do JevBench, utilizadas durante o desenvolvimento, esclarecem os autores. 🔗 fonte
- Transformers v5.18.0 — A Hugging Face acrescenta quatro arquiteturas, Nemotron 3 Diarization e NemotronH Omni da NVIDIA, HyperCLOVAX Vision V2 da NAVER e GTE, e assinala seis alterações incompatíveis com versões anteriores. 🔗 fonte
- TaskSmith — Adithya S K, que trabalha nos ambientes de aprendizagem por reforço na Hugging Face, publica um orquestrador que transforma uma pull request num ambiente RL verificável: 50 ambientes extraídos de TRL, PEFT, Accelerate, Diffusers e Transformers, disponibilizados como tarefas Harbor. 🔗 fonte
- TraceML 0.4.1 — A ferramenta open source mede agora todo o conjunto de uma atualização do otimizador; no ResNet-50 e numa GPU T4, a espera pelos dados passa de 23 % do passo para menos de 2 ms após o ajuste do carregamento, com uma sobrecarga mediana de 0,35 %. 🔗 fonte
- Transformer em loop — Num modelo de demonstração de 54 106 parâmetros e 260 casos verificáveis, com um orçamento igual de 80 passagens de bloco, um loop aprende os 260 casos, dois loops 125,3 e oito 37,0, em média: multiplicar as passagens não tornou a aprendizagem mais económica. 🔗 fonte
- Uma avaliação que sabe dizer não — O tutorial de Eric Mey mostra, na análise de sentimento de críticas de filmes (SST-2), uma avaliação que rejeita um modelo apesar de ser melhor em 7 pontos nos dados reservados, porque um comportamento crítico se degrada; os seus scripts executam em menos de um minuto no processador. 🔗 fonte
- 10 000 segurados sintéticos — A Intelligent Actuaries publica sob CC-BY-4.0 um estudo sintético sobre caducidades e resgates de seguros de vida: 10 000 segurados fictícios em dez mercados, ou seja, 27 692 registos apólice-ano de 2023-2025 no formato do inquérito SOA-LIMRA. 🔗 fonte
- cuObject e SCADA Server SDK — A NVIDIA disponibiliza de forma geral as bibliotecas cuObject de acesso ao armazenamento de objetos por RDMA, sem passar pela memória do CPU, e lança o SCADA Server SDK, cujo protótipo foi desenvolvido pela IBM com Storage Scale, numa iniciativa Storage-Next com mais de 40 participantes. 🔗 fonte
- NeMo Relay e Hermes Agent — Um tutorial da NVIDIA, coassinado por Teknium, da Nous Research, rastreia um agente Hermes: em 108 execuções, correções nas ferramentas fazem Qwen3 Coder 30B passar de 19 para 22 sucessos em 27, à custa de 4,9 chamadas ao modelo em vez de 3,8. 🔗 fonte
- OpenShell para OpenClaw Enterprise — A NVIDIA propõe o seu ambiente open source OpenShell para governar os agentes do OpenClaw Enterprise, um plano de controlo open source para agentes persistentes anunciado na véspera pela fundação OpenClaw com Red Hat, NVIDIA e OpenAI. 🔗 fonte
- Períodos de avaliação do GitHub Advanced Security — Os clientes do GitHub Team podem iniciar por conta própria um período de avaliação do GitHub Code Security e do GitHub Secret Protection, a partir da página Overview da organização, da página de faturação ou de um Risk Assessment; a duração não foi especificada. 🔗 fonte
- GHE.com e X25519 — A partir de 7 de outubro de 2026, o GitHub Enterprise Cloud com residência de dados recusará clientes TLS que apenas proponham X25519 para a negociação de chaves; P-256 e P-384 continuam a ser suportados e o SSH não é afetado. 🔗 fonte
- Dois estudos de caso na Runway — A marca francesa de bebidas Bonjour produziu mais de 500 variantes publicitárias com Runway e reafectou mais de 50 000 euros de produção; a World Juggling Federation confiou a uma única pessoa o grafismo de um programa de uma hora para a ESPN. 🔗 Bonjour · 🔗 World Juggling Federation
- Ad Variants na Luma — A Luma destaca uma função que adapta um anúncio concluído a vários tamanhos e mercados dentro da mesma campanha, sem preços, planos ou data de lançamento, e sem artigo. 🔗 fonte
- Microduck em produção — A Pollen Robotics anuncia que 10 950 Microduck, o seu pequeno robô bípede de 399 dólares treinado em simulação, com uma stack de aprendizagem por reforço open source, sairão da linha entre 10 de dezembro e 10 de janeiro, em lotes semanais. 🔗 fonte
- A Cognition recruta — A empresa que desenvolve o Devin recebe Chris Degnan, antigo CRO da Snowflake, como diretor de receitas, no dia seguinte à chegada de Alex Stamos como responsável pela segurança dos sistemas de informação (CISO). 🔗 Chris Degnan · 🔗 Alex Stamos
- Claude Founder House — A Anthropic organiza jornadas para fundadores em São Francisco durante a SF Tech Week (de 6 a 8 de outubro, na Terra Gallery) e em Estocolmo a 14 de outubro, com conferências, workshops e sessões com a sua equipa Applied AI. 🔗 fonte
- AI Engineer Paris — A Mistral faz o balanço do evento realizado na semana anterior na Station F: mais de 900 participantes, 60 oradores, 57 conferências e 22 parceiros, sem anúncio de produto. 🔗 fonte
- Bolsas de doutoramento da NVIDIA — As candidaturas ao Graduate Fellowship Program 2027-2028 estão abertas até 30 de outubro de 2026, com até 60 000 dólares por doutorando; foram atribuídas mais de 220 bolsas desde 2002. 🔗 fonte
O que isto significa
A segurança determina agora o calendário dos modelos de fronteira. Gemini 4 Argon prolonga a lógica do Fairwind Program: os defensores de cibersegurança de confiança recebem-no primeiro, sem salvaguardas de cibersegurança, e os restantes seguir-se-ão «assim que possível», sem data, enquanto se reforçam as proteções. No mesmo dia, a OpenAI mostra a outra face do problema: o que é preciso proteger já não é apenas o modelo, mas também o seu raciocínio. Seja ou não obra de um único interveniente, a campanha cujo núcleo a OpenAI atribui a indivíduos associados à Moonshot AI faz do rasto de raciocínio um ativo a defender, com contramedidas técnicas e partilha de informações entre laboratórios e governos.
Boa parte dos números do dia vem de medições concebidas ou conduzidas por quem faz os anúncios. A Cohere avalia Embed 5 com a métrica que publica no mesmo dia, e a própria empresa avisa que os seus modelos poderiam parecer piores segundo a medição anterior; a HeyGen apoia-se num Elo interno, a Hunmin num protocolo próprio, com uma única execução para os benchmarks de agentes, e, no Reality Check, é o organizador que fez o ajuste fino dos modelos. Por outro lado, a Perplexity submete o seu modelo a uma avaliação cega num benchmark privado da turbopuffer, e tanto o Open TTS Leaderboard como o AURORA substituem os votos ou a tradução automática por tarefas e medições verificáveis. Antes de comparar duas pontuações, é preciso ver quem as produziu.
A geração de imagens e vídeos é cada vez mais avaliada pela utilização e pelo custo. Ideogram 4.5 não promete uma imagem mais bonita, mas uma imagem que suporta retoques em série; HeyGen Video é vendido ao segundo, mais barato do que todos os modelos da sua tabela, e mostra que um modelo base como MiniMax H3 pode dar origem a variantes especializadas, da HeyGen à Creatify. Runway Ads completa a cadeia até à despesa publicitária, e a valorização da ElevenLabs, que duplicou desde fevereiro, assenta na procura de agentes conversacionais pelas empresas.
Do lado dos programadores, o harness torna-se um produto por direito próprio, distinto do modelo. O VS Code adota o harness do Copilot para alinhar o seu agente com a aplicação e o CLI, o HydraFusion coordena vários modelos no mesmo turno, o Zed deixa o agente escolher um modelo por subagente e o Manus abre o seu harness às chaves API de fornecedores terceiros. O Gemini CLI executa agora os seus planos sem intervenção humana em modo não interativo, o Claude Code restringe --bare para utilizações em scripts, e a Google Cloud disponibiliza gcloud e bq aos agentes numa sandbox, com as permissões IAM de quem faz a chamada. A procura é visível até na infraestrutura: o primeiro cliente de Vera Rubin NVL72 em produção na CoreWeave é a Cognition, a empresa que desenvolve o Devin.
Fontes
- Gemini 4 Argon: a nossa próxima era de inteligência de fronteira (blog da Google)
- Página Gemini da Google DeepMind
- Anúncio de Gemini 4 Argon por @GoogleDeepMind
- Artigo da OpenAI sobre a campanha de destilação
- Roubo de rastos de raciocínio de APIs de LLMs proprietários (arXiv)
- Artigo da Cohere sobre Embed 5
- Anúncio de Embed 5 por @cohere
- Artigo da Cohere sobre RCP-nDCG@10
- Código e dados de RCP-nDCG no GitHub
- Artigo da Perplexity Research sobre embedding contextual
- pplx-embed-v2-context-9b-preview no Hugging Face
- Anúncio de Ideogram 4.5 por @ideogram_ai
- Página do modelo Ideogram 4.5
- Catálogo HeyGen Video
- Anúncio de HeyGen Video por @HeyGen
- Skills na aplicação Gemini (blog da Google)
- Apresentação de Manus Flex
- Fio de @bot sobre Grok Bot e Cursor
- Praxis-1 na Runway Research
- Tweet da Ai2 sobre MolmoAct 2 e Reality Check
- Classificação Reality Check de Poke & Wiggle
- Página do projeto Physis-Lang
- Anúncio de Physis-Lang por @NVIDIAAI
- Artigo sobre Hunmin-CUA
- Pesos de Hunmin-397B-A17B-CUA
- Artigo sobre JEV-27B-VL
- Artigo do Open TTS Leaderboard
- Open TTS Leaderboard no Hugging Face
- Artigo da LILT sobre AURORA
- Classificação AURORA
- Claude for Government já está disponível de forma geral
- Como a equipa de vendas da Anthropic reconstruiu o inbound com Claude Managed Agents
- Artigo da OpenAI sobre pequenas empresas
- Artigo sobre Runway Ads
- Tweet de @runwayml sobre Runway Ads
- Artigo da ElevenLabs sobre a oferta de recompra
- Artigo da NVIDIA sobre CoreWeave e Vera Rubin
- Notas de versão do Claude Code 2.1.286
- Notas de versão do Zed 1.22.0
- Gemini CLI v0.63.0-preview.0
- Gemini CLI v0.62.0
- Notas de versão do VS Code 1.140
- HydraFusion no VS Code e na aplicação GitHub Copilot
- Servidor MCP remoto do Google Cloud CLI (blog da Google Cloud)
- Codex CLI 0.159.2
- Plaid Speed no Amp
- Fio de @warpdotdev sobre Factories as Code
- Factories as Code, Warp
- Estudo de caso Crosby, Devin
- Apresentação de claude.dev por @ClaudeDevs
- Notas de versão do ChatGPT
- Notas de versão do ChatGPT Enterprise e Edu
- Notas de versão do Kimi Work
- Cue e a gestão das finanças
- GPT-6.1 Sol no Genspark
- Qwen3.8-27B-pi
- Qwen3.8-27B na Nebius Token Factory
- Bekko System One v0
- ZooWork Instinct Tuned 4B
- Transformers v5.18.0
- TaskSmith
- TraceML 0.4.1 e o Trainer de Transformers
- Treinar transformers em loop
- Escreva uma avaliação que saiba dizer não
- Dez mil segurados sintéticos
- cuObject e SCADA Server SDK
- NeMo Relay e Hermes Agent
- OpenShell para OpenClaw Enterprise
- Períodos de avaliação do GitHub Advanced Security para GitHub Team
- Fim do TLS limitado a X25519 no GHE.com
- Estudo de caso Bonjour, Runway
- Estudo de caso World Juggling Federation, Runway
- Ad Variants na Luma
- Microduck, Pollen Robotics
- Chris Degnan na Cognition
- Alex Stamos na Cognition
- Claude Founder House
- Balanço do AI Engineer Paris por @MistralDevs
- Bolsas de pós-graduação da NVIDIA