ai-powered-markdown-translatorArtículo traducido del francés al español con gpt-6.1-sol.
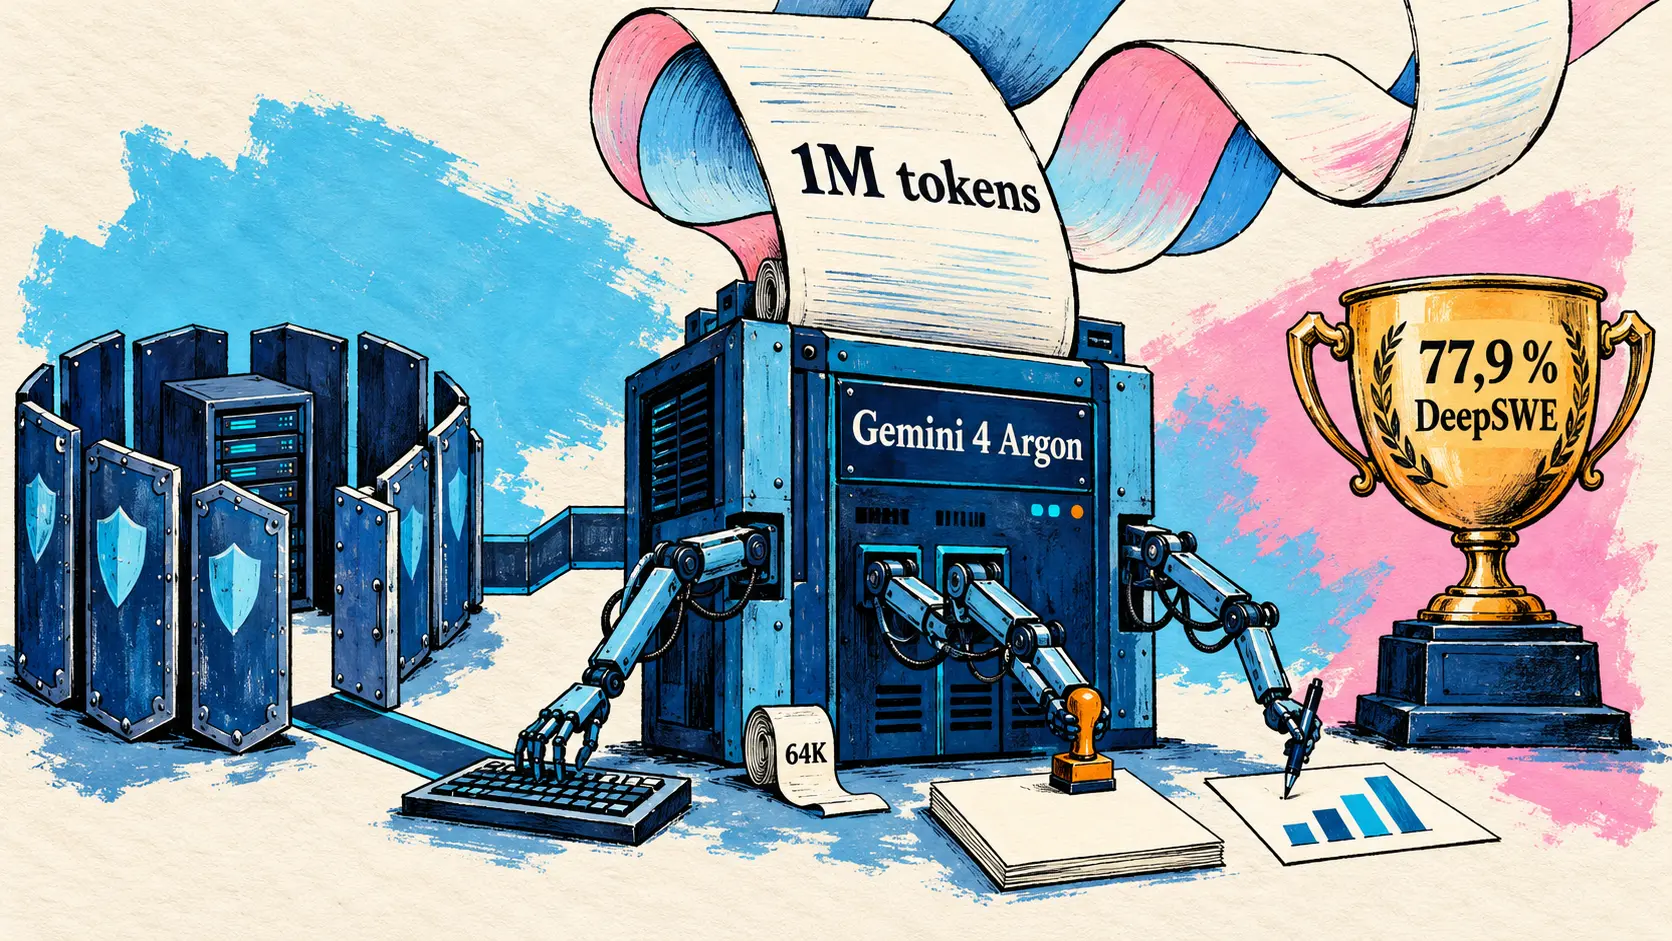
El miércoles 30 de septiembre, Google anuncia Gemini 4 Argon, un modelo de frontera que se despliega primero entre los defensores de la ciberseguridad de confianza del Fairwind Program, con una capacidad de salida ampliada a 1 millón de tokens. OpenAI afirma haber desbaratado una campaña coordinada de extracción del razonamiento protegido de sus modelos, cuyo núcleo atribuye a personas asociadas a Moonshot AI. Cohere lanza Embed 5 con su propio método de evaluación, Ideogram 4.5 promete retoques sucesivos sin artefactos y HeyGen lanza un modelo de vídeo basado en MiniMax H3; en el ámbito del desarrollo, Claude Code 2.1.286, Zed 1.22.0 y VS Code 1.140 se lanzan el mismo día.
Gemini 4 Argon: el nuevo modelo de frontera de Google, primero para los defensores de la ciberseguridad
30 de septiembre — Google anuncia Gemini 4 Argon, su nuevo modelo de frontera, en una publicación firmada por Koray Kavukcuoglu, vicepresidente sénior de Google DeepMind y arquitecto jefe de IA de Google (Chief AI Architect). Argon está diseñado para permitir un razonamiento profundo en flujos de trabajo largos y complejos (long-horizon workflows), en tres ámbitos: la ingeniería de software en condiciones reales, el trabajo del conocimiento en las empresas (ámbito jurídico, finanzas) y la ciberdefensa.
El modelo todavía no está abierto al público. Se despliega primero entre un grupo de defensores de la ciberseguridad de confianza del Fairwind Program, lanzado el 2 de septiembre con Gemini 3.8 Flash Cyber, que lo reciben, al igual que los equipos internos de Google, sin medidas de protección en ciberseguridad (cyber guardrails). Los desarrolladores, las empresas y el público general tendrán acceso «lo antes posible», empezando por los clientes de pago de la API y los suscriptores de Google AI Ultra, sin una fecha anunciada. Hasta entonces, Google refuerza el rechazo de solicitudes perjudiciales en ciberseguridad y NRBC, la supervisión de la cadena de pensamiento y de las acciones del modelo, y aísla sus entrenamientos y evaluaciones de alto riesgo en entornos aislados sellados; la empresa también afirma participar en el proceso voluntario del Gobierno estadounidense de acceso a los modelos antes de su lanzamiento.
Introducing Gemini 4 Argon – our new frontier model. It’s built for complex workflows across coding, enterprise knowledge work, and cybersecurity defense – rolling out today to a set of trusted testers through our Fairwind Program.
🇪🇸 Presentamos Gemini 4 Argon, nuestro nuevo modelo de frontera. Está diseñado para flujos de trabajo complejos en programación, trabajo del conocimiento en las empresas y ciberdefensa, y se despliega desde hoy entre un grupo de evaluadores de confianza a través de nuestro Fairwind Program. — @GoogleDeepMind en X
El precio ya está fijado: como tarifa de lanzamiento, 2 dólares por millón de tokens de entrada y 10 dólares de salida, la misma tarifa de GPT-6.1 Sol, lanzado el día anterior, y después 4 y 20 dólares al finalizar un periodo cuya duración no se indica; la entrada en caché cuesta un 95 % menos que la entrada. El límite de salida aumenta a 1 millón de tokens, frente a los 64K anteriores, el más alto del sector según Google: el modelo puede producir cientos de miles de tokens en una misma trayectoria para resolver un problema difícil.
| Precio por millón de tokens | Tarifa de lanzamiento | Tarifa tras el periodo de lanzamiento |
|---|---|---|
| Entrada | 2 dólares | 4 dólares |
| Salida | 10 dólares | 20 dólares |
La página de Google DeepMind compara Argon con GPT-6 Astra, Claude Fable 5.1 y Claude Opus 5.5 en diecinueve filas. Argon obtiene la mejor puntuación en 13 de ellas, comparte el primer puesto con GPT-6 Astra en CWE-bench v1 (68 %) y es superado en 5. El código agéntico es el ámbito más disputado: primero en DeepSWE v1.1 (77,9 %) y en Vibe Code Bench, Argon termina último de los cuatro en FrontierSWE v2 y en Terminal-bench 4.0. Su ventaja es clara en el trabajo del conocimiento, especialmente en el Legal Agent Benchmark de Harvey (19,6 % frente al 6,7 % como máximo de los otros tres), y en contextos largos de entre 256K y 1M tokens. La mejor puntuación de cada fila aparece en negrita.
| Benchmark evaluado (ámbito) | Gemini 4 Argon | GPT-6 Astra | Claude Fable 5.1 | Claude Opus 5.5 |
|---|---|---|---|---|
| Vals Index (trabajo del conocimiento) | 68,9 % | 63,1 % | 65,8 % | 67,0 % |
| AutomationBench (trabajo del conocimiento) | 51,3 % | 41,4 % | 31,4 % | 42,5 % |
| Vals Finance Agent v2 (trabajo del conocimiento) | 65,4 % | 53,5 % | 58,9 % | 58,6 % |
| Legal Agent Benchmark de Harvey (trabajo del conocimiento) | 19,6 % | 5,4 % | 6,7 % | 3,8 % |
| DeepSWE v1.1 (código agéntico) | 77,9 % | 74,1 % | 67,4 % | 74,2 % |
| FrontierSWE v2 (código agéntico) | 55,0 % | 65,5 % | 56,3 % | 62,3 % |
| Vibe Code Bench (código agéntico) | 91,9 % | 89,6 % | 90,3 % | 90,3 % |
| Terminal-bench 4.0 (código agéntico) | 57,4 % | 58,2 % | 57,9 % | 66,4 % |
| PostTrainBench (ingeniería ML) | 45,3 % | 44,3 % | 40,2 % | 49,3 % |
| Terminal-Bench Science 0.1 (ciencias y matemáticas) | 57,6 % | 68,1 % | 52,6 % | 63,3 % |
| LABBench 2 (ciencias y matemáticas) | 88,8 % | 85,4 % | 68,6 % | 73,1 % |
| RiemannBench (ciencias y matemáticas) | 76,0 % | 72,0 % | 65,6 % | 69,6 % |
| GraphWalks BFS hasta 128K (contexto largo, F1) | 99,7 % | 98,7 % | 91,4 % | 90,6 % |
| GraphWalks BFS de 256K a 1M (contexto largo, F1) | 84,2 % | 71,8 % | 65,0 % | 66,8 % |
| Agent’s Last Exam (uso del ordenador) | 39,5 % | 34,2 % | — | 38,2 % |
| OSWorld-2.0, subconjunto sin conexión, puntuación parcial (uso del ordenador) | 69,2 % | 72,6 % | — | — |
| Chartography (comprensión multimodal) | 71,6 % | 71,0 % | 46,2 % | 66,3 % |
| LVBench (comprensión multimodal) | 91,7 % | 87,5 % | 79,7 % | 83,7 % |
| CWE-bench v1 (ciberseguridad) | 68,0 % | 68,0 % | 58,0 % | 67,0 % |
En Google, miles de empleados ya lo utilizan. En libgav1, el decodificador de vídeo de código abierto de Google, agentes Argon han sustituido 32 000 líneas de código SIMD de una adaptación a Rust existente por código Rust seguro: el decodificador resultante es 2,7 veces más rápido que esa adaptación, con una salida de vídeo idéntica. Otros agentes han preparado optimizaciones de memoria para los centros de datos que deberían liberar más de 300 TiB una vez desplegadas. En ciberseguridad, Wiz lo utiliza en su iniciativa Scan for Good: Argon descubrió en un software sanitario utilizado por hospitales de todo el mundo una vulnerabilidad crítica que exponía datos personales sensibles y que los modelos de frontera anteriores no habían detectado.
🔗 Gemini 4 Argon: nuestra próxima era de inteligencia de frontera (blog de Google) 🔗 Página de Gemini de Google DeepMind y tabla de benchmarks
OpenAI afirma haber desbaratado una campaña de destilación y atribuye su núcleo a personas asociadas a Moonshot AI
30 de septiembre — En una publicación de su sección Security, OpenAI afirma haber detectado y después neutralizado una campaña coordinada destinada a extraer el razonamiento protegido (protected reasoning) de sus modelos, es decir, la traza interna que un modelo produce para abordar una tarea. La empresa lo considera una destilación adversarial (adversarial distillation): el uso sistemático y no autorizado de las salidas o del razonamiento de un modelo para entrenar, reproducir o mejorar otro modelo.
Según OpenAI, los operadores no rompieron el cifrado, ni comprometieron una base de datos, ni accedieron directamente a las conversaciones almacenadas de los usuarios. Manipularon los intercambios para que el razonamiento protegido reapareciera de forma visible, por ejemplo, copiando el razonamiento cifrado de una conversación para pedirle a un modelo, en otra conversación, que lo descifrara y lo transcribiera. Investigadores independientes habían comunicado mediante divulgación responsable vulnerabilidades similares, descritas en el artículo «Robo de trazas de razonamiento de APIs de LLM propietarios», enviado a arXiv el 10 de agosto; OpenAI confirma que estas vías de ataque eran reales.
| Etapa de la campaña | Fecha o volumen registrado por OpenAI |
|---|---|
| Inicio de la actividad, con un volumen bajo | 1 de julio |
| Picos de actividad | 24 y 25 de julio |
| Solicitudes con el patrón de extracción durante los picos | 16 000, procedentes de más de 4 000 usuarios |
| Grupo vinculado a este patrón | más de 15 000 usuarios |
| Neutralización completa del grupo | 28 de julio |
En cuanto a la atribución, la publicación mantiene la cautela: no se ha establecido que todos los operadores respondan a un mismo actor, y las 16 000 solicitudes de los picos son intentos de extracción, que no necesariamente tuvieron éxito. Sin embargo, OpenAI atribuye un núcleo de la actividad a personas asociadas a Moonshot AI, el desarrollador de Kimi.
… we attribute a core cluster of the activity to individuals associated with Moonshot AI …
🇪🇸 … atribuimos un núcleo de la actividad a personas asociadas a Moonshot AI … — OpenAI, publicación de la sección Security
Como respuesta, OpenAI ha suspendido o restringido las cuentas fraudulentas, endurecido sus controles de registro y de infraestructura, ampliado la supervisión de las redes vinculadas y reforzado la protección del razonamiento oculto entre usuarios, espacios de trabajo, organizaciones y familias de modelos. Ha cerrado una vía que permitía reproducir el razonamiento cifrado de otro usuario para recuperar su contenido, y ha añadido controles que detectan y retienen una salida en flujo (streaming) que pueda exponerlo. Los resultados se han compartido a través del Frontier Model Forum y de canales gubernamentales: según OpenAI, la técnica no es exclusiva de sus modelos, y cualquier sistema que permita transferir o reproducir el razonamiento puede estar expuesto a riesgos similares. La empresa presenta la destilación adversarial como un riesgo para la seguridad de los modelos y la seguridad nacional, ya que un razonamiento extraído puede servir para entrenar otro modelo sin las medidas de protección del original. El tema no es nuevo: en febrero, Anthropic había atribuido campañas de destilación a DeepSeek, Moonshot AI y MiniMax, y desde el 24 de septiembre Anthropic cobra por las solicitudes bloqueadas en varias categorías, incluida la extracción de razonamiento.
🔗 Artículo «Robo de trazas de razonamiento de APIs de LLM propietarios» en arXiv
Embeddings: Cohere lanza Embed 5 y la métrica RCP-nDCG@10, Perplexity publica pplx-embed-v2-context-9b-preview
30 de septiembre — Cohere lanza Embed 5, una familia de modelos de embeddings para la búsqueda empresarial, en dos niveles que comparten el mismo espacio de embeddings: Embed 5 Pro, para la máxima calidad y la indexación offline, y Embed 5 Fast, para la búsqueda interactiva, el RAG de alto volumen y la búsqueda agéntica. Se puede indexar un corpus con Pro y luego consultarlo con Fast sin reindexar nada, siempre que se mantenga la misma dimensión de salida: en 40 conjuntos de datos de desarrollo, este esquema recomendado por Cohere conserva de media el 98,4 % de la calidad de un sistema íntegramente basado en Pro, frente al 96,6 % de un sistema íntegramente basado en Fast.
Ambos modelos leen hasta 128K tokens, aceptan texto, imágenes o ambos fusionados en un mismo vector, abarcan más de 100 idiomas y generan vectores de 256 a 2 048 dimensiones en float, int8 o binario. Cohere recomienda 1 024 dimensiones en int8, es decir, 1 Ko por vector frente a 8 Ko en float32 con 2 048 dimensiones. Pro cuesta 0,12 dólares por millón de tokens de texto y Fast 0,08 dólares, un tercio menos, con una tasa de procesamiento de documentos 2,4 veces superior de media; las imágenes se facturan a 0,40 dólares por millón de tokens en ambos modelos. Embed 5 está disponible desde hoy a través de la API de Cohere, Model Vault, Microsoft Foundry y Amazon SageMaker, así como en North, y puede desplegarse de forma privada con vLLM.
| Benchmark (métrica) | Embed 5 Pro | Embed 5 Fast | Otros modelos citados |
|---|---|---|---|
| ViDoRe V3, 8 dominios (RCP-nDCG@10) | 85,8 | 84,5 | Voyage 4 Large 83,7 ; Gemini Embedding 2 83,2 ; OpenAI text-embedding-3-large 75,5 |
| FinanceBench (RCP-nDCG@10) | 80,1 | 80,0 | Pro 21,4 puntos por delante de OpenAI text-embedding-3-large |
| FinQA (RCP-nDCG@10) | 90,0 | 88,8 | — |
| ViDoRe V3 Finance (RCP-nDCG@10) | 85,0 | 83,9 | — |
| PDF analizados, media de la suite (RCP-nDCG@10) | 84,8 | 83,4 | Voyage 4 Large 83,6 ; Gemini Embedding 2 80,8 ; Embed 4 78,6 |
| Texto e imagen fusionados, 5 conjuntos (nDCG@10) | 82,3 | 81,2 | Gemini Embedding 2 61,3 |
| Imagen de página, 5 conjuntos financieros (nDCG@10) | 77,0 | 73,2 | Embed 4 71,1 ; Voyage Multimodal 3.5 70,1 ; Gemini Embedding 2 56,7 |
| 5 idiomas europeos (nDCG@10 o RCP-nDCG@10) | 77 | — | Voyage 4 Large 76 ; Gemini Embedding 2 73 |
La mayoría de estas puntuaciones se expresan en RCP-nDCG@10, el método de evaluación que Cohere publica el mismo día (véase más abajo): una nota de la entrada precisa que reordena un conjunto fijo de candidatos y, por tanto, mide la calidad de la clasificación en lugar de la recuperación de primera etapa. La segunda tabla multilingüe merece una lectura completa: Cohere destaca en ella sus avances respecto a Embed 4, de hasta 13 puntos en persa, pero, en esos diez idiomas, Gemini Embedding 2 supera a Embed 5 Pro en nueve, con el chino como única excepción, y Voyage 4 Large lo supera en cinco. Cohere presentará Embed 5 en una sesión en X el 8 de octubre.
🔗 Entrada de Cohere sobre Embed 5 · Anuncio de @cohere en X
RCP-nDCG@10, la métrica con la que Cohere mide Embed 5
30 de septiembre — Cohere también publica RCP-nDCG@10 (Rubric-Calibrated Preferences nDCG@10), su método de evaluación de la búsqueda. Punto de partida: nDCG, la métrica de MTEB y BEIR, compara los resultados con una lista de documentos anotados de antemano, inevitablemente incompleta, de modo que un documento pertinente que nunca se haya anotado no aporta ningún punto; en el estudio de Cohere, el 28 % de los documentos marcados como no pertinentes son, sin embargo, considerados útiles por humanos. RCP-nDCG@10 encarga la evaluación a un juez de IA calibrado, que responde a cinco preguntas de sí/no idénticas para cada consulta y compara los documentos por grupos. Validación a ciegas con 46 anotadores en 289 duelos: cuando las dos métricas designan ganadores distintos, los humanos dan la razón a RCP-nDCG en el 70 % de los casos. El artículo, el código y los datos están publicados, y el mantenedor principal de MTEB anuncia su integración. Cohere afirma haber optimizado con respecto a esta métrica su quinta generación de Embed y Rerank, esta última aún sin fecha, y advierte de que estos modelos no siempre parecerán los mejores si se considera únicamente el nDCG histórico.
🔗 Entrada de Cohere sobre RCP-nDCG@10 · Código y datos en GitHub
Perplexity publica pplx-embed-v2-context-9b-preview y el benchmark context-bench
30 de septiembre — Perplexity publica una versión preliminar, bajo licencia MIT en Hugging Face, de pplx-embed-v2-context-9b-preview, un modelo de embeddings contextuales: cada fragmento de un documento se codifica teniendo a la vista el documento completo, para que un pasaje que diga «ella» siga vinculado a la entidad correcta. En lugar de aprender de un único fragmento «oro» (gold passage) por consulta, el modelo aprende de un modelo maestro, el modelo de compresión de contexto de Perplexity, que puntúa cada token del documento: así aprende a recuperar la respuesta y los pasajes que la justifican. Evaluado a ciegas en context-bench, un benchmark privado de turbopuffer, cofirmante de la entrada (2 099 consultas, 38 894 documentos), supera a voyage-context-4; en ConTEB, obtiene la mejor media sin ganar en todas las tareas. Perplexity advierte de que los pesos y la interfaz aún pueden cambiar y prepara el acceso a través de su API, sin fecha.
| Medida publicada por Perplexity | pplx-embed-v2-context-9b-preview | Diferencia respecto a voyage-context-4 |
|---|---|---|
| Exhaustividad de respuestas en context-bench, con K = 10 | 45,5 % | +14,4 puntos |
| Exhaustividad de evidencias en context-bench, con K = 10 | 40,6 % | +5,0 puntos |
| Almacenamiento por vector (1 024 dimensiones, int8) | 1 Ko | 8 veces menos que voyage-context-4 en float32 |
🔗 Entrada de Perplexity Research · Modelo en Hugging Face
Ideogram 4.5: un modelo de edición de imágenes pensado para retoques sucesivos
30 de septiembre — Ideogram lanza Ideogram 4.5, que presenta como «el modelo de edición más preciso». La observación inicial: con cada retoque, los modelos de imagen añaden artefactos, desplazamientos de píxeles y desviaciones de color, de modo que una imagen pronto queda inutilizable tras varias pasadas. Ideogram 4.5 está diseñado para eliminar esta acumulación y hacer posible la edición en varios turnos (multi-turn editing).
Introducing Ideogram 4.5, the most precise edit model. With each edit, leading models add artifacts, pixel shifts, and color changes. Ideogram 4.5 eliminates artifact buildup, making multi-turn editing possible. Live in Ideogram, the API, and launch partners. Open weights soon.
🇪🇸 Este es Ideogram 4.5, el modelo de edición más preciso. Con cada retoque, los modelos más avanzados añaden artefactos, desplazamientos de píxeles y cambios de color. Ideogram 4.5 elimina la acumulación de artefactos, lo que hace posible la edición en varios turnos. Disponible en Ideogram, en la API y a través de los socios de lanzamiento. Pesos abiertos próximamente. — @ideogram_ai en X
Para respaldar este punto, Ideogram publica una comparación en paralelo de los mismos retoques sucesivos con GPT Image 2.5 Sunburst, Nano Banana Pro y Nano Banana 2, cuyos resultados, según afirma, quedarían inutilizables tras unos pocos retoques. La comparación es visual, sin puntuación numérica. Los ejemplos abarcan el color y la iluminación (las sombras, los reflejos y las altas luces se adaptan al cambio sin alterar la composición), la modificación de texto, la fotografía de producto, la decoración de interiores, la restauración de fotos antiguas paso a paso, la conversión de un boceto o un mapa de profundidad en una imagen y el recorte.
El modelo también introduce la edición a cualquier resolución (Zoom editing): una zona de una imagen de alta definición, de 24,2 megapíxeles (4 016 × 6 016 píxeles) en el ejemplo de Ideogram, se retoca sin reducir la imagen, conservando sus bordes para reintegrarla sin que se note la unión. Aunque está pensado para la edición localizada, el modelo también funciona muy bien en la edición general, según Ideogram.
| Elemento del anuncio | Lo que se sabe |
|---|---|
| Disponibilidad | desde el 30 de septiembre en Ideogram y en la API |
| Socios de lanzamiento | Pika y Luma, que lo anuncian ese mismo día |
| Pesos abiertos | prometidos «próximamente», como los de Ideogram 4.0 publicados en junio |
| Precio | no publicado |
🔗 Página del modelo Ideogram 4.5
HeyGen Video: un modelo de vídeo basado en MiniMax H3, disponible a través de una API
30 de septiembre — HeyGen lanza HeyGen Video, un modelo de generación de vídeo destinado a empresas que quieren un vídeo con calidad de producción sin pagar su coste. Basado en MiniMax H3 y postentrenado por HeyGen, genera un vídeo a partir de un texto o una imagen, con el sonido generado en la misma llamada, y se utiliza a través de la API de HeyGen, así como en OpenRouter, Runware y ComfyUI.
En cuanto al precio, coexisten tres cifras. La tarifa parte de 0,01 dólares por segundo hasta finales de octubre, lo que supone un descuento del 50 % sobre la tarifa estándar de 0,02 dólares, según la página del catálogo. Su tabla comparativa, por su parte, utiliza el precio de catálogo en 768p con audio, antes de las promociones de lanzamiento: 0,03 dólares por segundo. Incluso a ese precio, HeyGen Video es el más barato de los modelos comparados.
| Modelo comparado | Precio de catálogo por segundo (768p, audio) | Elo interno de HeyGen (HeyGen Video = 1 000) |
|---|---|---|
| HeyGen Video | 0,03 dollar | 1 000 |
| Seedance 2.0 | 0,303 dollar | 955 |
| H3 Max | 0,08 dollar | 952 |
| H3 Max Turbo | 0,04 dollar | 920 |
| H3 Max balanced | 0,08 dollar | 860 |
| Kling 3.0 Pro | 0,168 dollar | 857 |
| Veo 3.1 | 0,40 dollar | 744 |
En cuanto a la calidad, HeyGen se apoya en una evaluación interna realizada con consultas de Artificial Analysis Arena (4 800 votos), con un Elo normalizado a 1 000 para su modelo. En una comparación de preferencias a ciegas frente a H3 Max, el 55,8 % de los 650 votos favorece a HeyGen Video, dentro de un intervalo del 49 al 62 % que no descarta el empate. Para un clip de 10 segundos generado de imagen a vídeo, el tiempo de inferencia del transformador de difusión baja a 3,7 segundos, frente a 4,1 para H3 Max Turbo y 8,3 para H3 Max, sin contar el tiempo de generación de descripciones.
MiniMax celebró el lanzamiento y destacó ese mismo día otro modelo derivado de H3: Boreal-H3 de Creatify, un modelo de vídeo optimizado para la publicidad.
🔗 Catálogo de HeyGen Video · Anuncio de @HeyGen en X
Asistentes y agentes generalistas: las skills de Gemini, Manus Flex y Grok Bot
La aplicación Gemini lanza las skills, que sustituirán a los Gems
30 de septiembre — Google lanza las skills en la aplicación Gemini: instrucciones que se guardan una vez y se invocan escribiendo una barra seguida de su nombre. Gemini también puede crearlas a partir de las conversaciones y ejecutarlas por iniciativa propia cuando un prompt encaja, se pueden combinar varias skills y cada una puede incluir archivos de referencia (texto sin formato, PDF, imágenes). Ya presentes en Gemini Spark, llegan al chat de Gemini en todo el mundo, para todos los niveles de suscripción de Google AI y, por ahora, para mayores de 18 años; los clientes de Workspace las recibirán en las próximas semanas. Las skills sustituirán a los Gems, que desaparecerán a partir de noviembre para las cuentas personales, en marzo de 2027 para Workspace business, enterprise y nonprofit y en junio de 2027 para educación, con una migración automática. Opal, la herramienta de creación de miniaplicaciones, también cerrará en noviembre, al igual que los «Gems by Google Labs», que no se migrarán.
🔗 Deja que las skills de Gemini se encarguen de tus tareas más repetitivas (blog de Google)
Manus Flex: tu propia clave API en el agente Manus
29 de septiembre — Manus lanza Manus Flex, que permite utilizar Manus con la clave API de un proveedor de inferencia compatible (bring your own API key). Hasta ahora, Manus elegía por sí mismo el modelo y proporcionaba el arnés y la infraestructura del agente; con Flex, la clave de un proveedor alimenta los mismos proyectos, herramientas, entornos de ejecución y flujos de trabajo del agente, con un modelo principal y un nivel de esfuerzo de razonamiento a elegir. La facturación se divide: el proveedor factura directamente la inferencia, mientras que los demás servicios y la infraestructura utilizados por una tarea siguen consumiendo créditos de Manus. OpenRouter, Fireworks y Modal son los tres primeros miembros del programa de socios de inferencia (Manus Flex Inference Partner Program). La entrada, publicada al día siguiente del lanzamiento de Manus 2.0, no indica ningún plan, precio ni lista de modelos.
Grok Bot encarga el código a Cursor y gestiona las pull requests
30 de septiembre — Dos días después de Team Bots, SpaceXAI refuerza Grok Bot para el desarrollo de software. En un hilo de la cuenta @bot, la empresa anuncia que sus Bots pueden encargar tareas de código a Cursor, gestionar las pull requests mediante plugins de GitHub y Origin (este último no se describe) y compartir demostraciones en vídeo de lo que construyen. SpaceXAI también publica, en forma de plantillas para instalar (templates), los Bots de su propio equipo de ingeniería, cada uno con sus skills, rutinas y conectores. El hilo no precisa ningún plan, precio ni fecha, y no lo acompaña ninguna entrada en x.ai. La relación con Cursor no es nueva: Grok Bot for Enterprise se ofreció durante dos semanas a los clientes de Grok y Cursor Enterprise a principios de septiembre; lo que cambia es que un Bot delega por sí mismo el trabajo de código.
Robótica y modelos del mundo: Praxis-1 de Runway, MolmoAct 2 de Ai2 y Physis-Lang de NVIDIA
Runway presenta Praxis-1, un modelo de acción del mundo con pesos abiertos
30 de septiembre — Runway presenta Praxis-1, su primer modelo de acción del mundo (world action model) con pesos abiertos, destinado a controlar robots reales. Se basa en el mismo preentrenamiento con vídeo que sus modelos de mundo, como Solaris o GWM Worlds 2, y aspira a ser un modelo de política generalista para desarrolladores e investigadores en robótica. La apuesta de Runway: las demostraciones robóticas son escasas, el vídeo es casi ilimitado. En sus demostraciones, una misma política pasa de un estudio a una cocina sin reentrenamiento. Todavía no se puede descargar nada: Praxis-1 está en pruebas en Noble Machines, Standard Bots y Ultra, cada uno con su propio hardware, y su lanzamiento público, incluidos los pesos, está anunciado para los próximos meses.
| Medida publicada por Runway | Resultado anunciado |
|---|---|
| Correlación entre la simulación en el modelo de mundo y los resultados reales | 0,95 |
| Error de colocación final tras el ajuste, con vídeo de la web | 16,1 cm |
| Mismo error con vídeo de un robot teleoperado | 16,0 cm |
MolmoAct 2 de Ai2 encabeza Reality Check, tras el ajuste realizado por el organizador del banco de pruebas
30 de septiembre — Ai2 anuncia que MolmoAct 2, su modelo de robótica completamente abierto, ocupa el primer puesto en tasa de éxito global en Reality Check, un banco de pruebas independiente de manipulación en condiciones reales, con un matiz importante: los modelos son ajustados por el organizador, Poke & Wiggle, para las tareas del banco de pruebas. Lanzado el día anterior por esta empresa, Reality Check cuenta con 14 400 ejecuciones en robots reales, en estaciones FR3 Duo instaladas en el Deutsches Museum de Múnich, en diez entornos (clasificar tornillos, enchufar un conector DC, abrir una caja de herramientas con un destornillador…). Dos líneas siguen «pendientes»: objetos colocados fuera de la zona de entrenamiento y un entrenamiento intermedio con 100 horas de datos de las estaciones.
| Modelo evaluado | Tasa de éxito global | Tasa de éxito tras unas 10 demostraciones por entorno | Tasa de éxito tras unas 300 demostraciones por entorno |
|---|---|---|---|
| MolmoAct 2 | 28 % | 4 % | 44 % |
| Pi 0.5 | 21 % | 5 % | 33 % |
| DiT-Flow | 19 % | 2 % | 29 % |
| GR00T N1.7 | 12 % | 4 % | 19 % |
🔗 Tweet de Ai2 · Clasificación de Reality Check
Physis-Lang: descripciones que explican la física a los modelos de mundo
29 de septiembre — Investigadores de NVIDIA, del MIT y de la Universidad de Oxford publican Physis-Lang, un marco que añade razonamiento físico a las descripciones de vídeos para mejorar los modelos de mundo. Las descripciones hacen explícitas las causas, las leyes en juego y los efectos; un crítico especializado detecta las afirmaciones que faltan o carecen de fundamento, un agente refina las instrucciones para generar descripciones, y los fallos del modelo sirven para buscar los vídeos que cubrirán sus carencias. Según NVIDIA, añadir este razonamiento solo al prompt, sin reentrenamiento, mejora en 5,62 puntos la puntuación de Cosmos 3 en PhyGenBench. Con entrenamiento, Physis-Lang sobre Cosmos3-Super y Cosmos3-Nano ocupa los dos primeros puestos de la clasificación Physics-IQ Verified en generación de vídeo a partir de imágenes (48,2 y 43,3, frente a 42,7 de la mejor puntuación anterior). PhyGenBench y VideoPhy-2 son puntuados por GPT-5.5, y Veo 3.1 mantiene una ligera ventaja en el conjunto completo de VideoPhy-2.
| Benchmark de física en vídeo | Cosmos3-Nano | Veo 3.1 | Physis-Lang sobre Cosmos3-Nano |
|---|---|---|---|
| PhyGenBench | 61,67 | 65,63 | 71,04 |
| Physics-IQ Verified | 40,23 | 34,99 | 43,41 |
| VideoPhy-2 Hard | 48,31 | 58,43 | 62,36 |
| VideoPhy-2, conjunto completo | 60,41 | 68,87 | 68,02 |
🔗 Página del proyecto Physis-Lang · Anuncio de @NVIDIAAI en X
Modelos abiertos: Hunmin-397B-A17B-CUA y JEV-27B-VL
Hunmin-397B-A17B-CUA incorpora las capacidades de agente de Qwen-CUA a un MoE de 397 mil millones de parámetros
30 de septiembre — En el blog comunitario de Hugging Face, hojun Lee detalla Hunmin-397B-A17B-CUA, un modelo de uso del ordenador (computer use) publicado bajo Apache-2.0 por la organización mncai, con una salvedad señalada por los propios autores: las evaluaciones son internas, con una sola ejecución para los bancos de pruebas de agentes, y no son comparables con las clasificaciones publicadas (el modelo base obtiene en ellas 48,16 en OSWorld, frente a los 62,2 anunciados en OSWorld-Verified). El modelo se basa en Qwen3.5-397B-A17B, una mezcla de expertos con 17 mil millones de parámetros activos, y todo el proyecto se ha realizado en un único nodo de ocho B200. El equipo calculó la diferencia de pesos entre su modelo base y Qwen-CUA, ya especializado, e incorporó solo una versión de rango reducido a una selección de módulos: esta transferencia por sí sola eleva OSWorld-316 de 48,84 a 68,25, sin heredar la debilidad de Qwen-CUA en anclaje visual. Un ajuste seguido de aprendizaje por refuerzo GRPO añade 4,3 puntos.
| Banco de evaluación (protocolo interno) | Base Qwen3.5-397B | Hunmin-CUA | Qwen-CUA (origen) |
|---|---|---|---|
| OSWorld, 360 tareas | 48,16 | 70,45 | 77,12 |
| WindowsAgentArena, 153 tareas | 41,77 | 50,85 | 56,68 |
| ScreenSpot-Pro | 72,74 | 75,61 | 62,20 |
| KMMLU-Pro (coreano) | 77,91 | 76,12 | 71,41 |
🔗 Artículo sobre Hunmin-CUA · Pesos en Hugging Face
AutoTrust AI publica JEV-27B-VL, un modelo de decisión abierto que también evalúa imágenes
30 de septiembre — AutoTrust AI publica bajo Apache-2.0 JEV-27B-VL, la versión con visión de JEV-27B, su modelo de decisión abierto presentado el 27 de septiembre. Se le muestran imágenes y texto, se le plantea una pregunta y responde en una sola pasada con una probabilidad calibrada para cada opción, en unos cien milisegundos; cuando la pregunta lo exige, razona paso a paso mientras observa las imágenes. Sin embargo, su cabeza de decisión no ha visto ninguna imagen durante el entrenamiento. Prueba principal: en MicroLens, un conjunto de datos público de una aplicación de vídeos cortos, ordena 20 vídeos candidatos para 200 usuarios a partir únicamente de las miniaturas, e iguala en AUC a un filtrado colaborativo entrenado con 59 045 usuarios, con una mayor tasa de vídeos correctos en el top 5. Los autores recuerdan que este resultado procede de un único conjunto de 200 usuarios.
| Método de recomendación en MicroLens | AUC | Vídeo correcto en el top 5 |
|---|---|---|
| JEV-27B-VL, solo miniaturas, sin datos de interacción | 0,727 | 59 % |
| Filtrado colaborativo entrenado con 59 045 usuarios | 0,728 | 49 % |
| JEV-27B-VL, solo títulos | 0,649 | 46 % |
| Orden aleatorio | 0,489 | 21 % |
Clasificaciones: el Open TTS Leaderboard de Hugging Face y AURORA de LILT
Hugging Face lanza el Open TTS Leaderboard, una clasificación abierta de síntesis de voz
30 de septiembre — Hugging Face lanza el Open TTS Leaderboard, una clasificación de síntesis de voz (text-to-speech, TTS) centrada en modelos abiertos y multilingües. El Hub cuenta con más de 8 000 modelos TTS, pero las plataformas de votación que sirven de referencia no siguen bien el ritmo y los modelos abiertos están infrarrepresentados: según el artículo, solo 16 de los 92 modelos clasificados por Artificial Analysis tienen pesos abiertos. Por tanto, la clasificación sustituye los votos por medidas objetivas: la inteligibilidad (tasa de error por palabra o por carácter entre el texto solicitado y su transcripción por Qwen3 ASR), la velocidad (inferencia por lotes y tiempo hasta el primer sonido, en H200 y en procesador) y la fidelidad de una voz clonada (similitud WavLM). Evaluar un modelo lleva unas horas en lugar de unas semanas de votaciones. En inglés, lideran Kokoro-82M, supertonic-3 y s2-pro de Fish Audio; en la categoría multilingüe, OmniVoice, s2-pro y Fun-CosyVoice3-0.5B. Los autores advierten de que no se miden ni la naturalidad ni la expresividad, y publicarán sus scripts de evaluación «pronto».
🔗 Artículo sobre el Open TTS Leaderboard · La clasificación en Hugging Face
LILT lanza AURORA, una clasificación multilingüe de tareas de agente
30 de septiembre — LILT lanza AURORA, una clasificación que mide los modelos más avanzados en tareas de agente en idiomas distintos del inglés, todas diseñadas y verificadas por expertos nativos, sin traducción automática. Arranca con cuatro bancos de pruebas: un Terminal-Bench multilingüe con 324 tareas de código en diez idiomas, una versión multilingüe de τ³-bench para atención al cliente, MultiChallenge para el seguimiento de instrucciones en contextos largos y GAIA-v2-LILT para el razonamiento agéntico. Claude Opus 5.5 lidera el Terminal-Bench multilingüe y ocupa el primer puesto de τ³-bench en cada uno de los cinco idiomas. En GAIA, los modelos obtienen de media 20,7 puntos más en la versión auditada por LILT que en una traducción automática: para LILT, esta diferencia mide el error introducido por la traducción. Un mismo diálogo también consume aproximadamente 1,4 veces más tokens en coreano o árabe que en inglés.
| Modelo evaluado (Terminal-Bench multilingüe, extracto) | Tasa de éxito media |
|---|---|
| Claude Opus 5.5 (effort high) | 76,4 % |
| Claude Opus 5 (effort high) | 73,5 % |
| Gemini 3.8 Flash | 67,3 % |
| GPT-6 Sol | 64,8 % |
| Command A+ | 4,3 % |
🔗 Artículo de LILT sobre AURORA · La clasificación AURORA
Sector público y empresas: Claude for Government, el agente de compra de Anthropic y OpenAI con America’s SBDC
Claude for Government pasa a disponibilidad general
30 de septiembre — Claude for Government sale de la beta: Anthropic anuncia su disponibilidad general para las agencias federales y las agencias de los estados de Estados Unidos. La plataforma, en beta pública desde julio, proporciona las capacidades de programación y de trabajo agéntico de Claude en un entorno autorizado FedRAMP High, con funciones comparables a las de los clientes comerciales; el CLI Claude Code y Claude for Microsoft 365 llegan en acceso anticipado. No hay licencias por puesto: las agencias pagan el uso por tramos fijos, con un límite estricto que impide superar el presupuesto comprometido, y las asignaciones de grupos SCIM fijan, por nivel de puesto, los límites de tasa, los topes en dólares y los modelos autorizados. En cuanto al control, las operaciones sensibles del lado de Anthropic requieren la aprobación de dos personas, las exportaciones de uso solo contienen datos de medición y el historial de conversaciones permanece en el dispositivo gestionado por la agencia. Anthropic no publica ninguna tarifa.
🔗 Claude for Government ya está disponible de forma general
En Anthropic, un agente creado con Managed Agents recibe las solicitudes comerciales
30 de septiembre — Anthropic cuenta cómo su equipo comercial ha renovado la recepción de solicitudes entrantes, decenas de miles al mes, con un agente de compra creado con Claude Managed Agents, en beta. Presente en las páginas de contacto con ventas y de precios, en claude.ai y en los correos electrónicos, plantea unas preguntas, recomienda un plan y un número de puestos, y después guía hacia la compra, deriva la conversación a un comercial con todo el historial o se limita a responder; el cliente puede optar por hablar con una persona desde el principio. Según el artículo, firmado por Carl Johnson, el agente mantiene miles de conversaciones al día; los clientes potenciales que deriva se convierten en oportunidades con más del doble de frecuencia que con el antiguo formulario y cierran la compra unos cinco días antes, y la proporción de conversaciones que requieren un comercial para cerrar la compra ha bajado aproximadamente a la mitad. Un solo ingeniero construyó la primera versión en unas semanas; el agente suele orientar a los equipos pequeños hacia el plan Team en lugar de Enterprise, algo que Anthropic ha decidido aceptar.
🔗 Cómo el equipo de ventas de Anthropic renovó la recepción de solicitudes con Claude Managed Agents
OpenAI se asocia con America’s SBDC y publica un informe sobre las pequeñas empresas
30 de septiembre — OpenAI se asocia con America’s SBDC, la red nacional de centros de desarrollo de pequeñas empresas de Estados Unidos, que apoya a 1 millón de emprendedores al año. En una primera fase, a través del programa de formadores comunitarios de OpenAI Academy (Community Trainer Program), lanzado como piloto el 23 de septiembre, OpenAI prevé formar a unos 150 asesores, que impartirán talleres de tres horas en las redes SBDC, con el objetivo de llegar al menos a 1 000 pequeñas empresas de forma presencial. Ese mismo día, el informe «Pequeñas empresas, mayores capacidades» cuantifica el uso: durante la semana del 9 al 15 de septiembre, unos 4 millones de empleados de empresas con menos de 500 personas utilizaron los productos de OpenAI, de los cuales casi uno de cada cinco trabajaba en una empresa con menos de 10 empleados. En agosto, los tokens de salida agénticos, en particular los de ChatGPT Work y Codex, representaban dos tercios de los tokens de salida de las pequeñas empresas, frente a un tercio en abril.
🔗 Artículo de OpenAI sobre las pequeñas empresas
Runway Ads: un motor autónomo para la publicidad de rendimiento
30 de septiembre — Runway lanza Runway Ads, que se encarga de principio a fin de la parte creativa de las campañas de pago. Se conecta una cuenta publicitaria y un kit de marca: la herramienta, basada en Runway Agent, genera creatividades de vídeo e imagen, publica las variantes aprobadas en Meta, Google y TikTok, analiza sus resultados y produce la siguiente tanda a partir de lo que ha concentrado el gasto. Localiza cada creatividad según las reglas establecidas por el equipo, incluido el texto en pantalla, la redimensiona para cada formato, la somete a un control de marca automático y respeta los límites de presupuesto. La aprobación humana está activada por defecto; la publicación automática puede habilitarse por campaña o por tipo de variante.
| Indicador interno de Runway, desde julio | Resultado publicado en el artículo |
|---|---|
| Anuncios por semana | de 77 a aproximadamente 900 |
| Retorno del gasto publicitario | duplicado |
| Conversión | aproximadamente +34 %, tasa de clics estable |
| Coste por suscriptor | −41 % |
Runway Ads está por ahora en fase piloto con socios empresariales seleccionados. El tweet del anuncio promete un despliegue amplio en las próximas semanas y afirma que la herramienta también ha permitido sumar 100 millones de dólares de ARR (ingresos recurrentes anuales) desde julio, una cifra ausente del artículo.
🔗 Artículo sobre Runway Ads · Tweet de @runwayml
ElevenLabs, valorada en 22 mil millones de dólares tras una oferta de recompra de 300 millones
30 de septiembre — ElevenLabs ha completado una oferta de recompra de acciones (tender offer) de 300 millones de dólares dirigida a sus empleados, que la valora en 22 mil millones de dólares, el doble de su valoración en la serie D de febrero. La operación está liderada por Wellington y T. Rowe Price; EQT, Goldman Sachs, GIC, OTPP, Sapphire Ventures y BDT & MSD entran en el capital, junto con inversores existentes como Andreessen Horowitz, Lightspeed e ICONIQ. Los clientes empresariales representan el 55 % de los ingresos: ElevenAgents procesa más de 15 millones de conversaciones por semana, tres veces más que en febrero, y sus ingresos recurrentes anuales se han más que triplicado en ese periodo. Según un análisis de sus clientes, los agentes de voz resuelven las solicitudes un 31 % más rápido que los agentes de chat. La empresa cuenta con más de 800 empleados, cuatro años después de una primera ronda con una valoración de 9 millones de dólares.
Vera Rubin NVL72 en producción en CoreWeave, Cognition mide hasta 4,8 veces más rendimiento
30 de septiembre — Con motivo de CoreWeave Fully Connected, en San Francisco, NVIDIA detalla la entrada en producción de Vera Rubin NVL72 en CoreWeave: la plataforma, con la red Spectrum-X Ethernet 102.4T, está disponible en CoreWeave Cloud, que recibió sus primeros racks de producción a principios de mes. Cognition, la empresa que desarrolla Devin, es el primer cliente que ejecuta allí cargas de producción: en las primeras pruebas con tareas extraídas de FrontierCode, midió hasta 4,8 veces más rendimiento total de tokens para la inferencia de SWE-2 que con GB200 NVL72. CoreWeave también ofrecerá la CPU Vera, diseñada para agentes: 128 CPU y 11 264 núcleos por rack, suficientes para ejecutar más de 11 000 entornos aislados simultáneos, con sandboxes de agentes que se inician más de tres veces más rápido. Por último, CoreWeave lanza CoreWeave Forge, que reúne Weights & Biases, OpenPipe y marimo para cerrar el ciclo desde la producción hasta el entrenamiento; anuncia que su aprendizaje por refuerzo sin servidor (serverless RL) es 1,4 veces más rápido, con un coste un 40 % menor.
🔗 Artículo de NVIDIA sobre CoreWeave y Vera Rubin
Agentes de código y herramientas de desarrollo: Claude Code 2.1.286, Zed 1.22.0, Gemini CLI, VS Code 1.140, HydraFusion y un servidor MCP para gcloud
Claude Code 2.1.286: marcadores en VS Code, reintentos limitados y modo bare más restringido
30 de septiembre — Claude Code 2.1.286, publicado a las 19:10 UTC, cuenta con 88 entradas, entre ellas 49 correcciones. La solicitud de permiso indica su posición cuando se acumulan varias solicitudes («2 de 5»), y la extensión de VS Code incorpora marcadores (bookmarks) para guardar respuestas de Claude en un panel lateral, una línea de Preguntas que recoge las preguntas planteadas por Claude y las respuestas elegidas, y vistas previas de las opciones en las tarjetas de preguntas. Hay dos cambios de comportamiento relevantes: ahora un único límite cubre los reintentos de una llamada al modelo, con un máximo de 14 solicitudes con la configuración predeterminada, y --bare solo conecta los servidores MCP indicados en la línea de comandos, sin recordatorios del sistema ni tareas en segundo plano. Si existe un skill llamado verify, se indica a Claude que lo ejecute justo antes de cada commit, salvo para documentación o pruebas, y los plugins rechazan las fuentes npm que sean repositorios git o carpetas. Por último, cuando la API rechaza el modelo predeterminado, Claude Code vuelve a intentarlo una vez con el modelo anterior del mismo nivel en lugar de fallar en cada turno.
🔗 Notas de la versión de Claude Code 2.1.286
Zed 1.22.0: un modelo por subagente
30 de septiembre — Zed publica su versión estable 1.22.0, centrada en los subagentes: la herramienta spawn_agent acepta un parámetro opcional model para ejecutar un subagente con un modelo distinto del configurado o heredado del agente principal, y la tarjeta de cada subagente muestra el modelo utilizado. Los subagentes también compactan su contexto automáticamente, lo que les permite, según Zed, completar tareas más largas. En cuanto a los modelos, GPT-6.1 Sol llega en BYOK con una clave API de OpenAI, Grok 4.7 pasa a estable como modelo recomendado en SuperGrok y xAI, y la lista de modelos de OpenCode Zen y Go se obtiene sobre la marcha. La versión corrige una fuga de unos 2 MB de memoria por comando finalizado en el terminal y cambia un atajo: el cierre del dock activo pasa a ctrl-alt-w en todas las plataformas. En total, 18 novedades y 37 correcciones.
🔗 Notas de la versión de Zed 1.22.0
Gemini CLI: v0.62.0 en estable y una versión preliminar que ejecuta los planes sin confirmación
29 de septiembre — Gemini CLI publica dos versiones por la noche (UTC). La v0.62.0 pasa a estable a las 21:17: sus 19 entradas retoman la versión preliminar y las nightlies presentadas del 16 al 24 de septiembre (títulos estructurados de las llamadas a herramientas MCP, conservación del token de actualización OAuth (refresh token), Gemini 3.8 Flash y 3.5 Flash Lite). La novedad está en la versión preliminar v0.63.0-preview.0, publicada a las 20:58: en modo no interactivo, el agente ahora redacta y ejecuta su plan sin esperar confirmación (PR 29539), mientras que las instrucciones del Plan Mode le hacían responder con un simple mensaje de alineación, sin ninguna llamada a herramientas. Un límite maxChars de 0 o menos también desactiva el truncamiento de las salidas de herramientas (PR 29542). La nightly del 30 de septiembre abre la serie 0.64.0: en modo ACP, el CLI por fin comunica el uso estándar, mientras que clientes como Zed u OpenHands sobreestimaban la facturación en aproximadamente 3 veces, según la PR 29549.
🔗 Gemini CLI v0.63.0-preview.0 · Gemini CLI v0.62.0
VS Code 1.140 adopta el arnés Copilot
30 de septiembre — Visual Studio Code 1.140 llega a estable con el arnés Copilot (Copilot harness): basado en el Copilot SDK, aporta al agente de VS Code el comportamiento y las capacidades de la app GitHub Copilot y de Copilot CLI, y se ejecuta en un proceso anfitrión dedicado, basado en el Agent Host Protocol, de modo que se puede acceder a una misma sesión desde varias ventanas; las notas advierten de que quizá ya esté seleccionado por defecto para algunos usuarios. Como función experimental, las sesiones con varias carpetas dan a cada chat su propia carpeta o worktree, y el agente puede delegar una sesión en un anfitrión remoto, elegido según el sistema, la memoria, el número de CPU y el modelo. Llegan tres controles para empresas: la explicación, en el chat, de las versiones mínimas exigidas por el administrador, un nivel predeterminado del modo Auto establecido mediante una configuración administrada (autoTier), y la incorporación de la identidad del usuario a los datos OpenTelemetry de Copilot, una opción desactivada por defecto.
🔗 Notas de la versión de VS Code 1.140
HydraFusion llega a VS Code y a la app GitHub Copilot
30 de septiembre — GitHub amplía HydraFusion, la orquestación de varios modelos lanzada el 4 de septiembre en Copilot CLI, a VS Code (a partir de la versión 1.140 o en Insiders) y a la app GitHub Copilot, todavía en versión preliminar de investigación. HydraFusion se elige en el selector como un modelo, pero no lo es: trata la elección del flujo de trabajo como un problema de optimización y selecciona uno de tres esquemas. En modo Single, un único modelo resuelve la tarea; en modo Cascade, un modelo eficiente redacta y un control de calidad acepta el resultado o recurre a un modelo más potente; en modo Critique, un crítico de solo lectura, procedente de otra familia de modelos, revisa el resultado y luego el redactor lo modifica una vez. Mientras que el modo Auto elige un modelo por solicitud, HydraFusion coordina varios modelos en un mismo turno. Está disponible en Copilot Pro, Pro+, Business y Enterprise, y un administrador debe activar las versiones preliminares en Business y Enterprise; GitHub no publica ninguna cifra nueva.
🔗 HydraFusion en VS Code y en la app GitHub Copilot
Google Cloud abre en versión preliminar un servidor MCP remoto que ejecuta gcloud y bq
Google Cloud incorpora a sus servidores MCP remotos gestionados el Google Cloud CLI remote MCP server, en versión preliminar pública. Agrupa cientos de comandos de las herramientas de línea de comandos gcloud y bq (BigQuery) detrás de dos herramientas MCP, run_gcloud_command y run_bq_command. Google justifica la elección de la línea de comandos con dos argumentos: un comando encapsula operaciones de varios pasos que la API obligaría a orquestar, y los modelos se han entrenado ampliamente con la documentación pública de estos comandos. El servidor remoto evita tener que instalar el CLI en el entorno del agente, lo que abre estas operaciones a plataformas de agentes alojadas en la web, como Gemini Enterprise. Los comandos se ejecutan en un sandbox aislado, detrás de un proxy con acceso restringido a la red y sin credenciales del entorno (ambient credentials), cada uno con los permisos IAM de la identidad que realiza la llamada, autenticada mediante Agent Identity u OAuth 2.0; Model Armor puede filtrar prompts y respuestas, y cada llamada puede quedar registrada en los registros de auditoría. No se cobra por el servidor en sí: solo por los recursos creados y las posibles transferencias de datos.
🔗 Potencia tus agentes con Google Cloud CLI remote MCP server (blog de Google Cloud)
Breves
- Codex CLI 0.159.2 — Publicada el 29 de septiembre a las 23 h 57 UTC, esta versión solo contiene una corrección retroportada: en Windows, las ventanas de consola ya no parpadean cuando Codex inicia procesos en segundo plano o comandos en su entorno aislado. 🔗 fuente
- Plaid en Amp — Los modos de Amp que usan GPT-6 Astra incorporan Plaid, basado en el nivel ultrarrápido de OpenAI: solicitudes hasta 6 veces más rápidas con un coste por token multiplicado por 6, reservado a la inferencia proporcionada por Amp; los subagentes mantienen la velocidad fast o standard, y Amp no publica ningún precio. 🔗 fuente
- Warp y Factories as Code — Warp presenta la configuración de sus fábricas de software como «el Terraform de los agentes»: un repositorio describe agentes, automatizaciones, acceso y medición. El formato factory.yaml data de finales de agosto; la guía interactiva detalla el acceso federado a AWS o GCP, los webhooks y las integraciones con Slack, Linear o Jira. 🔗 hilo de Warp · 🔗 guía de configuración
- Devin en Crosby — En un caso de estudio de Cognition, el bufete de abogados neoyorquino Crosby, con una docena de ingenieros para más de 50 abogados, encarga a Devin la primera respuesta a los incidentes: entre 20 y 40 bugs y alertas examinados al día, en unos 5 minutos en la mayoría de los casos, y al menos un 50 % menos de ruido en Sentry. 🔗 fuente
- claude.dev — Anthropic presenta oficialmente claude.dev como el hogar de los desarrolladores que construyen con Claude: análisis técnicos en profundidad, guías de Claude Code y API, secciones Agents, Engineering, Playbooks y Skills, y una página Terminal como sorpresa oculta. Ya se compartían artículos del sitio desde el 22 de septiembre. 🔗 fuente
- Sites de ChatGPT editables — Según las notas de la versión del 29 de septiembre, un Site publicado se puede editar con Edit site y programar desde Automations en Plus y Pro; en Enterprise, los Sites privados pueden apoyarse en las aplicaciones conectadas, con un ajuste Allow use in Sites por plugin, desactivado por defecto. 🔗 notas de la versión de ChatGPT · 🔗 notas de Enterprise y Edu
- Kimi Work 3.2.15 — La versión del 30 de septiembre permite la coedición entre humanos e IA de documentos de Notion y Feishu en el navegador integrado, contrae por defecto la secuencia de acciones del agente y corrige la corrupción de archivos durante la edición simultánea de un PPT. 🔗 fuente
- Cue gestiona las finanzas — La aplicación de agentes personales lanzada con Manus 2.0 ahora realiza un seguimiento de las suscripciones y las tendencias de gasto y pone las cuentas bancarias en piloto automático, a través de Plaid; no se especifican países, planes ni condiciones. 🔗 fuente
- GPT-6.1 Sol en Genspark — Genspark incorpora GPT-6.1 Sol a AI Chat, Code Agent y Claw al día siguiente de su lanzamiento, retomando los argumentos de OpenAI (una inteligencia cercana a Astra por una quinta parte de su precio API), sin especificar el plan ni el coste en créditos. 🔗 fuente
- Qwen3.8-27B-pi — Thomas Kim publica bajo Apache-2.0 un ajuste de Qwen3.8-27B para el arnés Pi que vuelve a ordenar los niveles de esfuerzo: en Terminal-Bench 2.1, el nivel medium iguala al modelo base en xhigh (67 tareas de 89) con aproximadamente un 41 % menos de tokens de salida. 🔗 fuente
- Qwen3.8-27B en Nebius — Qwen difunde la llegada de su modelo denso de 27 mil millones de parámetros a Nebius Token Factory, anunciada el 28 de septiembre, para código, investigación y flujos de trabajo agénticos; no se comunican precios ni rendimiento. 🔗 fuente
- Bekko System One v0 — Yuichi Tateno publica tres modelos de decisión de 17M, 68M y 400M de parámetros, de los cuales los dos más pequeños funcionan en un navegador, y el banco de pruebas S1MB: el de 400M obtiene 50,60 frente a 59,59 de Jev 1.13, pero 54,48 frente a 96,27 en generalización. 🔗 fuente
- ZooWork Instinct Tuned 4B — SRP publica bajo Apache-2.0 un modelo de decisión de 4 mil millones de parámetros, construido sobre Qwen3.5-4B, que puntúa las opciones en una sola pasada sin decodificar: 198 de 231 (85,71 %) en las tareas públicas de JevBench, utilizadas durante el desarrollo, según precisan los autores. 🔗 fuente
- Transformers v5.18.0 — Hugging Face añade cuatro arquitecturas, Nemotron 3 Diarization y NemotronH Omni de NVIDIA, HyperCLOVAX Vision V2 de NAVER y GTE, y señala seis cambios que rompen la compatibilidad. 🔗 fuente
- TaskSmith — Adithya S K, que trabaja en los entornos de aprendizaje por refuerzo en Hugging Face, publica un orquestador que transforma una pull request en un entorno RL verificable: 50 entornos extraídos de TRL, PEFT, Accelerate, Diffusers y Transformers, entregados como tareas Harbor. 🔗 fuente
- TraceML 0.4.1 — La herramienta open source mide ahora el grupo completo de una actualización del optimizador; en ResNet-50 y una GPU T4, la espera de datos pasa del 23 % del paso a menos de 2 ms tras ajustar la carga, con una sobrecarga mediana del 0,35 %. 🔗 fuente
- Transformer en bucle — En un modelo de juguete de 54 106 parámetros y 260 casos verificables, con el mismo presupuesto de 80 pasadas de bloque, un bucle aprende los 260 casos, dos bucles 125,3 y ocho 37,0 de media: multiplicar las pasadas no ha hecho más económico el aprendizaje. 🔗 fuente
- Una evaluación que sabe decir que no — El tutorial de Eric Mey muestra, con el análisis de sentimiento de reseñas de películas (SST-2), una evaluación que rechaza un modelo pese a ser 7 puntos mejor en datos reservados, porque empeora un comportamiento crítico; sus scripts se ejecutan en menos de un minuto en un procesador. 🔗 fuente
- 10 000 asegurados sintéticos — Intelligent Actuaries publica bajo CC-BY-4.0 un estudio sintético de las bajas y los rescates de seguros de vida: 10 000 asegurados ficticios en diez mercados, equivalentes a 27 692 registros póliza-año de 2023-2025 en el formato de la encuesta SOA-LIMRA. 🔗 fuente
- cuObject y SCADA Server SDK — NVIDIA pone en disponibilidad general las bibliotecas cuObject de acceso al almacenamiento de objetos mediante RDMA, sin pasar por la memoria de la CPU, y lanza el SCADA Server SDK, del que IBM desarrolló un prototipo con Storage Scale, dentro de una iniciativa Storage-Next con más de 40 participantes. 🔗 fuente
- NeMo Relay y Hermes Agent — Un tutorial de NVIDIA firmado también por Teknium, de Nous Research, registra las trazas de un agente Hermes: en 108 ejecuciones, las correcciones en las herramientas hacen que Qwen3 Coder 30B pase de 19 a 22 éxitos de 27, a costa de 4,9 llamadas al modelo en lugar de 3,8. 🔗 fuente
- OpenShell para OpenClaw Enterprise — NVIDIA propone su entorno open source OpenShell para gobernar los agentes de OpenClaw Enterprise, un plano de control open source para agentes persistentes anunciado el día anterior por la fundación OpenClaw junto con Red Hat, NVIDIA y OpenAI. 🔗 fuente
- Pruebas de GitHub Advanced Security — Los clientes de GitHub Team pueden iniciar por sí mismos una prueba de GitHub Code Security y GitHub Secret Protection, desde la página Overview de la organización, la página de facturación o un Risk Assessment; no se especifica la duración. 🔗 fuente
- GHE.com y X25519 — A partir del 7 de octubre de 2026, GitHub Enterprise Cloud con residencia de datos rechazará a los clientes TLS que solo ofrezcan X25519 para el acuerdo de claves; P-256 y P-384 siguen siendo compatibles y SSH no se ve afectado. 🔗 fuente
- Dos casos de estudio en Runway — La marca francesa de bebidas Bonjour ha producido más de 500 variantes publicitarias con Runway y ha reasignado más de 50 000 euros de producción; la World Juggling Federation ha encargado a una sola persona el diseño gráfico de un programa de una hora para ESPN. 🔗 Bonjour · 🔗 World Juggling Federation
- Ad Variants en Luma — Luma destaca una función que adapta un anuncio terminado a varios tamaños y mercados dentro de una misma campaña, sin precio, plan ni fecha de lanzamiento, y sin una entrada en el blog. 🔗 fuente
- Microduck en producción — Pollen Robotics anuncia que 10 950 Microduck, su pequeño robot bípedo de 399 dólares entrenado en simulación, con una pila de aprendizaje por refuerzo open source, saldrán de la línea entre el 10 de diciembre y el 10 de enero, en lotes semanales. 🔗 fuente
- Cognition contrata — La empresa desarrolladora de Devin incorpora a Chris Degnan, antiguo CRO de Snowflake, como director de ingresos, al día siguiente de la llegada de Alex Stamos como responsable de seguridad de los sistemas de información (CISO). 🔗 Chris Degnan · 🔗 Alex Stamos
- Claude Founder House — Anthropic organiza jornadas para fundadores en San Francisco durante la SF Tech Week (del 6 al 8 de octubre, en la Terra Gallery) y en Estocolmo el 14 de octubre, con conferencias, talleres y sesiones con su equipo Applied AI. 🔗 fuente
- AI Engineer Paris — Mistral hace balance del evento celebrado la semana anterior en Station F: más de 900 participantes, 60 ponentes, 57 conferencias y 22 socios, sin anuncios de productos. 🔗 fuente
- Becas doctorales de NVIDIA — Las solicitudes para el Graduate Fellowship Program 2027-2028 están abiertas hasta el 30 de octubre de 2026, con hasta 60 000 dólares por doctorando; se han concedido más de 220 becas desde 2002. 🔗 fuente
Qué significa
La seguridad marca ahora el calendario de los modelos de frontera. Gemini 4 Argon prolonga la lógica del Fairwind Program: los defensores de ciberseguridad de confianza lo reciben primero, sin salvaguardas de ciberseguridad, y los demás lo recibirán «lo antes posible», sin fecha, mientras se refuerzan las protecciones. Ese mismo día, OpenAI muestra la otra cara del problema: lo que hay que proteger ya no es solo el modelo, sino también su razonamiento. Sea o no obra de un único actor, la campaña cuyo núcleo OpenAI atribuye a personas asociadas a Moonshot AI convierte la traza de razonamiento en un activo que defender, con contramedidas técnicas y un intercambio de información entre laboratorios y gobiernos.
Buena parte de las cifras del día procede de mediciones diseñadas o realizadas por quienes hacen los anuncios. Cohere evalúa Embed 5 con la métrica que publica ese mismo día, y advierte que sus modelos podrían parecer peores con la métrica anterior; HeyGen se apoya en un Elo interno, Hunmin en un protocolo propio, con una sola ejecución para los bancos de pruebas de agentes, y en Reality Check es el organizador quien ha ajustado los modelos. En cambio, Perplexity somete su modelo a una evaluación a ciegas en un banco de pruebas privado de turbopuffer, y tanto el Open TTS Leaderboard como AURORA sustituyen los votos o la traducción automática por tareas y mediciones verificables. Antes de comparar dos puntuaciones, hay que mirar quién las ha producido.
La generación de imágenes y vídeos se evalúa cada vez más por su uso y su coste. Ideogram 4.5 no promete una imagen más bonita, sino una imagen que admite retoques sucesivos; HeyGen Video se vende por segundo, más barato que todos los modelos de su catálogo, y muestra que un modelo base como MiniMax H3 puede dar lugar a variantes especializadas, de HeyGen a Creatify. Runway Ads completa la cadena hasta el gasto publicitario, y la valoración de ElevenLabs, duplicada desde febrero, se basa en la demanda de agentes conversacionales por parte de las empresas.
Para los desarrolladores, el arnés se convierte en un producto por derecho propio, distinto del modelo. VS Code adopta el arnés de Copilot para alinear su agente con la app y el CLI, HydraFusion coordina varios modelos en un mismo turno, Zed deja que el agente elija un modelo por subagente y Manus abre su arnés a las claves API de proveedores externos. Gemini CLI ejecuta ahora sus planes sin intervención humana en modo no interactivo, Claude Code restringe --bare para los usos mediante scripts, y Google Cloud pone gcloud y bq a disposición de los agentes en un entorno aislado, con los permisos IAM de quien realiza la llamada. La demanda se refleja incluso en la infraestructura: el primer cliente de Vera Rubin NVL72 en producción en CoreWeave es Cognition, la empresa desarrolladora de Devin.
Fuentes
- Gemini 4 Argon: nuestra próxima era de inteligencia de frontera (blog de Google)
- Página de Gemini de Google DeepMind
- Anuncio de Gemini 4 Argon por @GoogleDeepMind
- Artículo de OpenAI sobre la campaña de destilación
- Robo de trazas de razonamiento de API de LLM propietarios (arXiv)
- Artículo de Cohere sobre Embed 5
- Anuncio de Embed 5 por @cohere
- Artículo de Cohere sobre RCP-nDCG@10
- Código y datos de RCP-nDCG en GitHub
- Artículo de Perplexity Research sobre el embedding contextual
- pplx-embed-v2-context-9b-preview en Hugging Face
- Anuncio de Ideogram 4.5 por @ideogram_ai
- Página del modelo Ideogram 4.5
- Catálogo de HeyGen Video
- Anuncio de HeyGen Video por @HeyGen
- Skills en la aplicación Gemini (blog de Google)
- Presentamos Manus Flex
- Hilo de @bot sobre Grok Bot y Cursor
- Praxis-1 en Runway Research
- Tweet de Ai2 sobre MolmoAct 2 y Reality Check
- Clasificación Reality Check de Poke & Wiggle
- Página del proyecto Physis-Lang
- Anuncio de Physis-Lang por @NVIDIAAI
- Artículo sobre Hunmin-CUA
- Pesos de Hunmin-397B-A17B-CUA
- Artículo sobre JEV-27B-VL
- Artículo sobre el Open TTS Leaderboard
- Open TTS Leaderboard en Hugging Face
- Artículo de LILT sobre AURORA
- Clasificación AURORA
- Claude for Government ya está disponible de forma general
- Cómo el equipo de ventas de Anthropic reconstruyó la captación de clientes entrantes con Claude Managed Agents
- Artículo de OpenAI sobre las pequeñas empresas
- Artículo sobre Runway Ads
- Tweet de @runwayml sobre Runway Ads
- Artículo de ElevenLabs sobre la oferta de recompra
- Artículo de NVIDIA sobre CoreWeave y Vera Rubin
- Notas de la versión de Claude Code 2.1.286
- Notas de la versión de Zed 1.22.0
- Gemini CLI v0.63.0-preview.0
- Gemini CLI v0.62.0
- Notas de la versión de VS Code 1.140
- HydraFusion en VS Code y la app de GitHub Copilot
- Servidor MCP remoto de Google Cloud CLI (blog de Google Cloud)
- Codex CLI 0.159.2
- Plaid Speed en Amp
- Hilo de @warpdotdev sobre Factories as Code
- Factories as Code, Warp
- Caso de estudio de Crosby, Devin
- Presentación de claude.dev por @ClaudeDevs
- Notas de la versión de ChatGPT
- Notas de la versión de ChatGPT Enterprise y Edu
- Notas de la versión de Kimi Work
- Cue y la gestión de las finanzas
- GPT-6.1 Sol en Genspark
- Qwen3.8-27B-pi
- Qwen3.8-27B en Nebius Token Factory
- Bekko System One v0
- ZooWork Instinct Tuned 4B
- Transformers v5.18.0
- TaskSmith
- TraceML 0.4.1 y el Trainer de Transformers
- Entrenar transformers en bucle
- Escribe una evaluación que sepa decir que no
- Diez mil asegurados sintéticos
- cuObject y SCADA Server SDK
- NeMo Relay y Hermes Agent
- OpenShell para OpenClaw Enterprise
- Pruebas de GitHub Advanced Security para GitHub Team
- Fin del TLS limitado a X25519 en GHE.com
- Caso de estudio de Bonjour, Runway
- Caso de estudio de World Juggling Federation, Runway
- Ad Variants en Luma
- Microduck, Pollen Robotics
- Chris Degnan en Cognition
- Alex Stamos en Cognition
- Claude Founder House
- Balance de AI Engineer Paris por @MistralDevs
- Becas de posgrado de NVIDIA