ai-powered-markdown-translatorArtigo traduzido do fr para o pt com gemini-3.8-flash-high.
Agentes de IA da Google DeepMind, guiados por humanos, encontram duas fraquezas no RSA de 1024 bits, um sistema já obsoleto; os protocolos modernos, que utilizam quase todos chaves de 2048 bits ou mais, permanecem seguros. A investigação domina o dia: a OpenAI avalia os seus agentes em laboratório húmido com o BioBasicsBench, o TCSExam avalia modelos em ciência da computação teórica, e tanto a Anthropic como a Google mostram o que, em torno do modelo, faz um agente ter sucesso ou descarrilar. No lado das ferramentas, o Claude Code, o Codex CLI e o Copilot CLI lançam novas versões, o Antigravity CLI torna-se um servidor ACP, o Cursor abre o chat de voz com os seus agentes e o Amp lança os Spaces.
Agentes da Google DeepMind guiados por humanos encontram duas fraquezas no RSA de 1024 bits, o Frontier Model Forum classifica jailbreaks cibernéticos
6 de novembro — A Google DeepMind publica trabalhos de criptanálise, a ciência que testa a solidez da encriptação, conduzidos por agentes de IA orientados por supervisão humana. Pushmeet Kohli, vice-presidente responsável pela ciência, apresenta-os num artigo publicado no X e partilhado por @GoogleDeepMind: os agentes revelaram duas fraquezas nos sistemas RSA de 1024 bits, que podem ser comprometidos com um orçamento computacional menor do que se pensava. Os trabalhos são liderados por Dj Dvijotham e Abhradeep Thakurta, da equipa de Ciência da Google DeepMind, com Nadia Heninger (UC San Diego e Inria) e Emmanuel Thomé (Inria), e detalhados em dois artigos técnicos em PDF; nenhuma publicação de blogue acompanhou o anúncio.
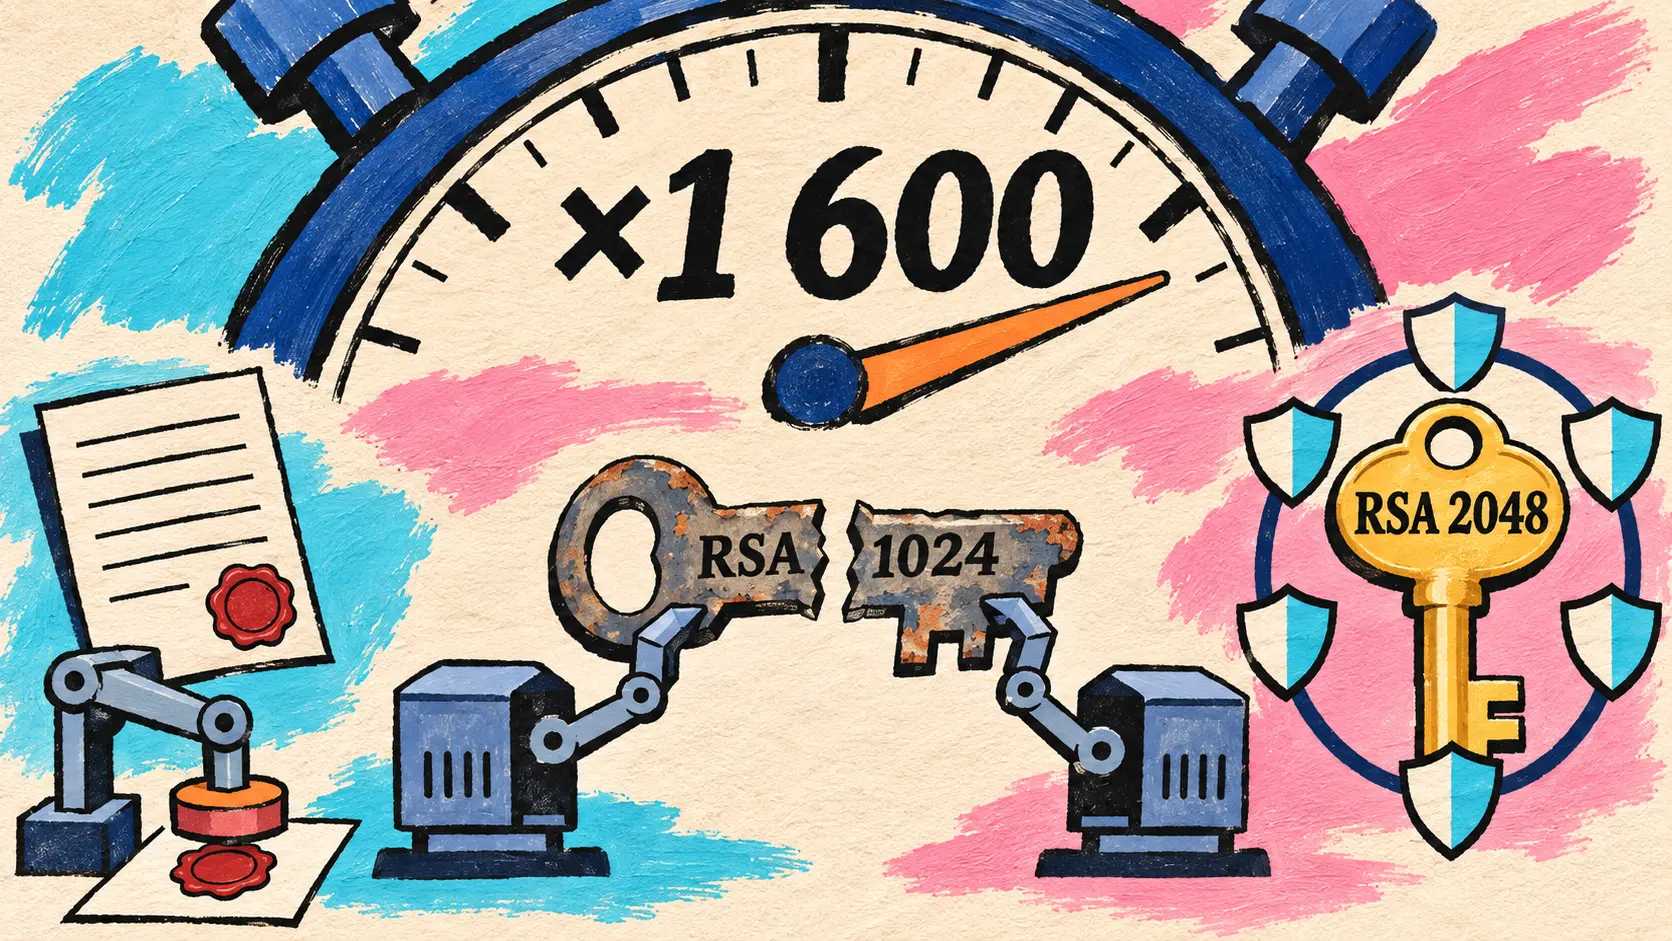
O alcance é deliberadamente limitado. O RSA de 1024 bits, obsoleto e já descontinuado, serve aqui como campo de testes sem risco, como há muito faz a comunidade de criptanálise. Os protocolos modernos, que utilizam quase todos chaves de 2048 bits ou mais, permanecem seguros.
O primeiro resultado diz respeito às assinaturas digitais, que garantem que uma atualização de software, um documento ou um site provêm de facto da sua fonte. Antes de assinar, muitos padrões completam a mensagem com um preenchimento (padding). A equipa demonstra que, assim que um atacante controla cerca de metade do bloco assinado, esse preenchimento deixa completamente de proteger. Numa simulação isolada, sem tocar em nenhum sistema real, os agentes executaram o ataque numa chave de referência de 1024 bits já resolvida por um estudo anterior: o resultado é reproduzido com 3,5 vezes menos tempo de CPU, a menos de um milésimo da capacidade computacional que seria necessária para quebrar a própria chave. Quando o atacante controla uma parte menor do bloco, com uma hash curta de 32 bytes, um novo algoritmo melhoraria em cerca de 1.600 vezes o melhor método anterior, segundo as estimativas teóricas dos autores.
O segundo resultado incide sobre a fatorização em lote. Tendo as chaves RSA comprimentos padrão (1024 ou 2048 bits), fatorizar muitos números do mesmo tamanho é uma questão-chave: os agentes encontraram um algoritmo com melhor complexidade assintótica, que divide por cerca de 30 o custo médio de fatorização de cada chave de 1024 bits adicional, em comparação com os métodos em lote anteriores.
| Resultado publicado pelos autores | Ganho anunciado | Condição indicada |
|---|---|---|
| Falsificação de assinatura, atacante que controla cerca de metade do bloco | 3,5 vezes menos tempo de CPU | Simulação isolada, chave de referência de 1024 bits já resolvida |
| Mesmo ataque, comparado à quebra da chave | Menos de um milésimo da capacidade | Capacidade necessária para quebrar a própria chave |
| Falsificação com um hash de 32 bytes | Cerca de 1.600 vezes melhor | Estimativa teórica, chaves de 1024 bits |
| Fatorização em lote | Custo médio cerca de 30 vezes menor por chave adicional | Em comparação com os métodos em lote anteriores |
| Chaves de 2048 bits ou mais | Não afetadas | Permanecem seguras segundo a Google DeepMind |
While modern 2048-bit systems remain safe from these specific exploits, this work highlights a key shift. As we enter a new era of AI-enabled math and computation, we can no longer rely on historical hardness assumptions and must continuously stress-test cryptographic standards.
🇵🇹 Se os sistemas modernos de 2048 bits permanecem protegidos contra estes exploits específicos, este trabalho destaca um ponto de viragem crucial. À medida que entramos numa nova era da matemática e da computação assistidas por IA, já não podemos confiar nas premissas históricas de dificuldade e temos de testar continuamente os padrões criptográficos. — @GoogleDeepMind no X
🔗 Artigo de Pushmeet Kohli no X · Artigo técnico sobre assinaturas digitais (PDF) · Artigo técnico sobre a fatorização de chaves (PDF)
O Frontier Model Forum propõe uma grelha comum para classificar a gravidade dos jailbreaks cibernéticos
5 de novembro — O Frontier Model Forum (FMF), que reúne laboratórios de IA de topo, publica a versão 1.0, apresentada como preliminar, do seu quadro de classificação de jailbreaks para ameaças cibernéticas (Jailbreak Rating Framework for Frontier Cyber Threats). Ponto de partida: nem todas as violações de salvaguardas são iguais. Algumas produzem apenas respostas pouco exploráveis, outras desbloqueiam capacidades ofensivas perigosas e, sem um método comum, duas organizações podem avaliar o mesmo jailbreak de forma diferente, correndo o risco de corrigir primeiro os menos graves. O quadro classifica cada jailbreak em níveis combinando pontuações em quatro categorias: ganho de capacidade, alcance da capacidade, facilidade de implementação e facilidade de descoberta.
Representantes da AWS, da Anthropic, da Google DeepMind, da Microsoft e da OpenAI apoiam-no na publicação; a OpenAI partilhou-o a 6 de novembro, indicando ter trabalhado nele com o FMF e os seus membros. Uma consulta pública está aberta até 21 de dezembro de 2026: o FMF verificará se avaliadores distintos chegam a classificações semelhantes e atualizará o quadro à medida que novos jailbreaks surgirem. Em julho, a Anthropic detalhou uma escala semelhante, a CJS (Cyber Jailbreak Severity), desenvolvida com a Amazon, a Microsoft e a Google; a publicação do FMF não estabelece a ligação entre as duas.
🔗 Apresentando o FMF Jailbreak Rating Framework for Frontier Cyber Threats
Medir a IA na ciência: BioBasicsBench da OpenAI para o laboratório húmido, TCSExam para a ciência da computação teórica
OpenAI publica o BioBasicsBench: 100 tarefas de laboratório húmido, 66,7% para o GPT-6 Astra
6 de novembro — A OpenAI apresenta o BioBasicsBench, um benchmark concebido com a Ligo, uma empresa de biotecnologia especializada no design de enzimas, para medir a capacidade dos agentes de interpretar dados brutos do trabalho diário em laboratório húmido (wet lab): géis e blots, placas de petri, imagens de microscopia, exportações de instrumentos ou vídeos de protocolos. As suas 100 tarefas, extraídas de experiências reais e pontuadas critério por critério de acordo com uma grelha de especialistas, cobrem cinco áreas, desde métodos proteicos até à clonagem molecular; também verificam se o agente deteta erros e reconhece quando os dados não permitem tirar conclusões.
Apenas modelos da OpenAI são avaliados: sete modelos em 37 configurações, cinco tentativas por tarefa, totalizando 18.500 resultados. Em esforço xhigh, o GPT-6 Astra obtém 66,7% da pontuação disponível, à frente do GPT-6.1 Sol e longe do GPT-5.6 Sol, com cerca de metade dos tokens de saída em comparação com este último; segundo a OpenAI, estes ganhos sugerem que uma multimodalidade nativa mais forte poderá ser decisiva.
| Modelo avaliado (esforço xhigh) | Recompensa média | Intervalo de confiança a 95% | Tokens de saída por tarefa |
|---|---|---|---|
| GPT-6 Astra | 66,7 % | 60,3 a 73,1 % | 4 704 |
| GPT-6.1 Sol | 62,0 % | 55,6 a 68,4 % | 5 238 |
| GPT-5.6 Sol | 43,8 % | 37,6 a 50,0 % | 9 099 |
| GPT-6 Luna | 38,3 % | 32,3 a 44,5 % | 13 120 |
| GPT-5.5 | 35,4 % | 29,7 a 41,0 % | 11 135 |
| GPT-5.4 | 33,2 % | 28,3 a 38,4 % | 13 717 |
| GPT-5.2 | 31,2 % | 26,2 a 36,3 % | 27 620 |
A OpenAI detalha também as falhas do Astra: uma hipótese familiar que se sobrepõe aos controlos experimentais, observações contrárias descartadas, uma contagem de colónias sobrestimada em cerca de 12%. De acordo com o artigo, pontuações melhores ainda não garantem julgamentos fiáveis em laboratório; a OpenAI associa este acompanhamento à bioproteção e à biossegurança, e não menciona a disponibilização do conjunto de tarefas.
🔗 A medir como os agentes de IA lidam com a ciência do dia a dia em laboratório húmido (OpenAI)
TCSExam avalia modelos em informática teórica: GPT-6 Astra lidera a versão Full, Opus 5.5 a versão Lite
5 de novembro — O TCSExam, publicado na organização GitHub da Moonshot AI com um artigo no arXiv submetido a 5 de novembro, avalia até onde os modelos conseguem avançar a investigação em ciência da computação teórica (theoretical computer science). Os autores listados no arXiv são Yifan Luo, Zhengying Liu, Yang Yuan, Zhilin Yang e Andrew Chi-Chih Yao. Quatro frentes: provar em Lean um teorema publicado, escrever um resolvedor avaliado em instâncias ocultas, produzir uma construção ou um limite verificado, e provar ou refutar integralmente conjeturas em aberto. A versão Full inclui 100 tarefas revistas por especialistas, e a versão Lite 20, cinco por cada frente. O índice atribui um peso de 30 a cada uma das três primeiras frentes e de 10 às conjeturas; os resolvedores são pontuados em relação a uma referência fixa, o Kimi K3.
| Modelo avaliado | Índice Lite (20 tarefas) | Índice Full (100 tarefas) |
|---|---|---|
| Opus 5.5 | 72,3 (provisório) | ausente da tabela do site |
| GPT-6 Astra | 67,0 | 71,9 |
| Kimi K3.1 Pro | 53,5 | 57,4 |
| Kimi K3 | 48,6 | 46,8 |
| GLM-5.3 | 47,0 | 45,5 |
| Qwen3.8 Max (0902) | 45,4 | 44,8 |
| DeepSeek V4.1 Flash 1017 | 42,4 | 46,0 |
| Grok 4.6 | 42,1 | 40,5 |
Nenhuma conjetura em aberto foi resolvida: o resumo reivindica apenas casos particulares e limites verificados de forma independente. No entanto, dois resultados superam o melhor conhecido, segundo o conhecimento dos autores: um grafo de 630 arestas em 124 vértices, sem triângulos nem ciclos de quatro arestas, construído pelo Kimi K3 (629 para a construção de Goedgebeur et al.), e um código corretor de erros quântico com distância 6, em vez de 5, encontrado pelo GPT-6 Astra para proteger 7 qubits lógicos com 25 qubits físicos. O ambiente de testes executa o Kimi Code por predefinição e também suporta o Claude Code, o Codex e o Grok Build.
🔗 Resultados do TCSExam · Artigo arXiv 2611.07962
Investigação sobre agentes: a memória e o dreaming na Anthropic, os TODO obsoletos na Google, os harness adapters
Anthropic mostra como o dreaming corrige e organiza a memória dos agentes Claude
6 de novembro — Em um artigo de pesquisa e engenharia em seu blog Engineering, a Anthropic define a memória de agente como aquilo que Claude retém de sua experiência de uma sessão para outra, sob a forma de notas legíveis: nem pesos, nem aprendizado em contexto, nem compactação. O dreaming (o “sonho” do agente) faz com que ele releia, fora de sessão, seus registros e transcrições para corrigir suas notas, escrever novas, construir representações como wikis ou escolher o que será pré-carregado; o recurso existe em prévia de pesquisa (research preview) no Claude Managed Agents desde 6 de maio.
As avaliações mostram, primeiramente, um avanço no discernimento. No Pokémon Red, por volta de 10 000 passos, o Sonnet 3.7 havia escrito 413 arquivos de memória em 225 pastas para uma única insígnia, enquanto o Fable 5 se limitava a nove arquivos e um global.md para quatro insígnias; o Opus 5.5 concluiu o jogo com uma pequena pasta de notas. A Anthropic aconselha a orientar o Claude sobre para que serve a memória em vez de como usá-la: impor o registro apenas de falhas faz com que o Opus 5 e o Opus 4.7 percam grande parte do ganho. Uma nota incorreta sobre a localização do PokéCenter do Mt. Moon, corrigida por dreaming a partir da transcrição, foi suficiente para desbloquear o jogo.
| Experimento conduzido pela Anthropic | Resultado publicado |
|---|---|
| Wiki isolada, corpus interno da Stainless (cerca de 350 000 arquivos), 2 e depois 128 sessões de dreaming | 13% e depois 48% dos critérios avaliados |
| Busca com wiki, mesmo corpus | 54% e depois 61%, contra 53% apenas com a busca; cerca de 20 000 tokens economizados por pergunta |
| Perguntas sobre uma fusão de empresas (24, critérios multidocumento) | 87% com a wiki, 73% apenas com a busca |
| Fatos extraídos de contratos | 41 de 57 com uma tabela compartilhada, 57 de 57 com uma página por contrato citada palavra por palavra |
O artigo também destaca as limitações: nenhum ganho quando um único documento é suficiente, uma wiki por vezes maior do que suas fontes e um custo computacional para manter a memória atualizada. Por fim, lembra que a auto memory do Claude Code carrega apenas as primeiras 200 linhas ou 25 KB de MEMORY.md, que serve como índice.
🔗 The components of agent memory (Anthropic)
Google constata que comentários TODO obsoletos desviam seus agentes de código
6 de novembro — No blog Google Developers, Sam Saccone e Madhuri Garikapati avaliam um custo oculto dos agentes de código: os comentários esquecidos.
What is easy for humans to skim past in code, agents see as a call to action.
🇵🇹 O que os humanos ignoram facilmente no código, os agentes veem como uma chamada para a ação. — Sam Saccone e Madhuri Garikapati, blog Google Developers
A equipe cruzou cada comentário TODO(bug/...) ou FIXME(bug/...) encontrado pelos agentes com o status real do bug e a solicitação do usuário, a partir de rastros de milhares de engenheiros e centenas de milhões de etapas de agentes. No total, 13% das sessões de leitura de arquivos expõem o agente a essa referência. O agente a ignora em 94% dos casos, mas age com base nela em 6%, e 83% dessas ações não foram solicitadas pelo desenvolvedor: 41% desses desvios dão andamento a tickets já fechados, e 57% expandem o trabalho para um bug ainda aberto. Em condições comparáveis de desenvolvedor, complexidade do código, tipo de tarefa e nível de modelo, um desvio não solicitado adiciona 70% de etapas, 77% de tokens e 105% de tempo de espera por sessão.
O Google respondeu com agentes de limpeza que varrem suas bases de código, rastreiam o histórico do bug, do arquivo e das alterações, e só propõem a exclusão de um TODO após confirmar sua obsolescência: milhares de referências excluídas em seis meses, com mais de 95% de aceitação pelos revisores humanos. O artigo defende bases de código adaptadas para agentes (agent friendly codebases).
O projeto harness-hub treina por RL um LoRA por harness de agente, sob a proteção do safeagents
6 de novembro — No blog da Hugging Face, Younes B., Lysandre e Nathan Habib (organização harness-hub) apresentam adaptadores de harness (harness adapters): um pequeno adaptador LoRA por modelo e por harness de agente (pi, opencode, hermes), treinado por aprendizado por reforço em tarefas verificáveis dentro do harness, sem modificá-lo; um único servidor atende o modelo base e todos os adaptadores. Em testes preliminares, os autores observam menos chamadas de ferramentas do que o modelo base nas tarefas reservadas, com precisão igual ou superior. A recompensa adiciona um pequeno bônus a soluções corretas que realizam menos chamadas.
As tarefas provêm de sessões de código abertas compartilhadas no Hub, convertidas em ambientes verificáveis pelo Repo2RLEnvs; a versão publicada conta com 270 tarefas, bastante desequilibrada: 253 de construção (94%), 11 de correção, 6 de extensão e nenhuma de perguntas e respostas. O proxy safeagents inspeciona cada chamada de ferramenta durante o treinamento: tentativas de burlar a recompensa são bloqueadas e recebem pontuação 0, e a ativação dessa proteção não altera o pass@1 reservado do LFM2.5-24B-A2B (+0,0 ± 4,1 pontos). Os treinamentos finais contemplam o LFM2.5-24B-A2B e o LFM3-1.7B da Liquid AI, e o TwIL-8B da webAI, um modelo de raciocínio nunca treinado em dados de agentes, segundo sua ficha técnica; eles rodam no HF Jobs e são transmitidos ao vivo, custos incluídos.
🔗 Harness adapters (blog Hugging Face)
Agentes de código: Claude Code 2.1.319, Codex CLI 0.167.0, Copilot CLI 1.0.106, Antigravity CLI 1.5, chat de voz do Cursor e Spaces do Amp
Claude Code 2.1.319 executa MCP tasks em segundo plano e adiciona permissions.denyInsteadOfPrompting
6 de novembro — A Anthropic lança o Claude Code 2.1.319: 146 entradas nas notas de versão, incluindo 90 correções, contra 119 entradas na 2.1.314 de 30 de outubro. O pacote está no npm desde as 00h58 UTC e a versão foi publicada no GitHub desde as 17h04 UTC, sem publicação no X; o canal stable permanece na 2.1.311. Os SDKs do Agent foram atualizados no mesmo dia (TypeScript 0.3.319, Python 0.2.179).
| Elemento modificado | O que muda |
|---|---|
| Tarefas MCP (MCP tasks) no terminal | Quando um servidor MCP executa uma chamada de ferramenta como uma tarefa, o Claude Code a move para o segundo plano e entrega o resultado ao final |
permissions.denyInsteadOfPrompting | Uma chamada que aguardaria uma solicitação de permissão é recusada e o turno continua, incluindo subagentes e colegas de equipe |
| Modo auto atrás de um gateway LLM | Telemetria ou sinalizadores desativados: chamadas que o servidor não consegue verificar são submetidas ao usuário ou recusadas, sem recorrer ao classificador integrado |
/claude-api latency-optimize | Localiza onde o código que chama a API do Claude causa espera e testa configurações mais rápidas em relação à avaliação do usuário |
/tasks | Linha “Earlier in this session” para reabrir um subagente concluído e interagir com ele |
Anunciadas em 23 de outubro sem número de versão, as tarefas MCP aparecem no CHANGELOG apenas a partir desta versão; elas também funcionam sem sinalizadores de recursos, portanto no Bedrock, Vertex, Foundry ou atrás de um gateway. As notas corrigem várias vulnerabilidades: uma violação das permissões do Bash por meio de um prefixo de ambiente forjado, um escape da sandbox na criação de uma worktree, um comando sed que ignorava o controle de permissão nos modos accept-edits ou auto, e o /rewind, que podia afetar um arquivo por meio de um link simbólico de diretório. O gateway Claude apps recebe alertas em preparação para a alteração do Claude Desktop em 10 de novembro, que as notas não detalham. No mesmo dia, o perfil @ClaudeDevs anuncia que as sessões em nuvem preparam sozinhas o ambiente de um repositório (ver Breves).
🔗 Notas de versão do Claude Code 2.1.319
Codex CLI 0.167.0 sinaliza resultados não lidos e troca de backend pelo seletor de sessões
6 de novembro — A OpenAI lança o Codex CLI 0.167.0 à 01h40 UTC, primeira versão estável desde a 0.166.0 de 29 de outubro, com 120 entradas na lista de PRs. O centro de comando dos agentes agora abre com codex agents --no-daemon e marca, assim como o seletor de sessões, os resultados que o usuário ainda não consultou. Esse seletor também permite alternar entre backends conectados sem perder rascunhos. As imagens locais anexadas são exibidas em pré-visualização durante a digitação em terminais compatíveis, a tela de login agrupa a chave de API e provedores de nuvem sob “Sign in another way”, e a opção gcp_setup_wizard configura o Google Cloud Vertex AI com Application Default Credentials ou um arquivo de credenciais. As configurações de proxy de sistema do macOS e do Windows agora podem ser ativadas a partir de /experimental.
As correções focam na continuidade do trabalho: conversas salvas continuam visíveis após a troca de provedor de modelo, Ctrl+L limpa a tela sem perder mensagens, que ficam acessíveis via Ctrl+T, e a compactação automática considera as saídas preservadas de respostas que falharam. A documentação do app-server descreve regras prompt-user que exigem uma nova aprovação humana. Como complemento, o openai-node 7.53.0 relata erros de sessão de agentes sob a forma de eventos de fluxo.
🔗 Notas de versão do Codex CLI 0.167.0
Copilot CLI 1.0.106 passa para versão estável com 227 entradas inéditas, seguida por uma 1.0.107 com notas idênticas
6 de novembro — O Copilot CLI lança sua primeira versão estável desde a 1.0.105 de 28 de outubro. A 1.0.106 sai às 01h47 UTC com notas que acumulam todo o ciclo de prévias: 637 entradas, sendo 227 ausentes das notas das onze prévias publicadas no GitHub. Às 20h37 UTC, uma 1.0.107 é lançada exatamente com as mesmas notas, com exceção da data do cabeçalho: nenhuma alteração própria é descrita nela, e é ela que o npm passa a instalar por padrão.
Entre as entradas inéditas estão a variável COPILOT_SESSION_CWD para executar e desenvolver configurações LSP e MCP locais, o GPT-6.1 Terra selecionável na seção New models quando a conta tem acesso, uma configuração Sandbox extensions que executa os processos de extensão na sandbox, e uma telemetria MATS para login do Microsoft Entra via OneAuth, que respeita a desativação de telemetria pelo cliente. /exit fecha a sessão atual em vez da CLI quando a barra lateral Sessions está aberta, as regras de negação da sandbox aceitam padrões glob, e as recusas por risco de segurança cibernética explicam que a sessão permanece intacta sugerindo /rewind. O SDK do Copilot também passa a ser estável na 1.0.29: 131 entradas, truncadas na fonte, incluindo uma alteração incompatível para Rust em SessionMetadata.
🔗 Copilot CLI 1.0.106 · Copilot CLI 1.0.107 · SDK Copilot 1.0.29
Antigravity CLI 1.5 torna-se um servidor ACP para editores e executa suas conversas em agentes remotos
4 e 5 de novembro — A CLI do Antigravity chega à versão 1.5, em duas etapas. A 1.5.0 (10 melhorias, 3 correções) adiciona agy acp, que executa a CLI como servidor Agent Client Protocol (ACP): um editor compatível pode utilizá-la como agente, com imagens e contexto de arquivos nos prompts, possibilidade de redirecionar um turno em andamento, modos de sessão default, accept-edits e plan, retomada de sessão sem reproduzir seu histórico, e modelo e nível de reflexão próprios para cada sessão; agy acp --login permite conectar-se a partir de um terminal, para editores conectados via SSH. A mesma versão adiciona --remote-agent, que executa as conversas em agentes remotos — equivalente em linha de comando aos recursos introduzidos no aplicativo 2.29.0 —, além de projetos locais em /projects e um modo sem interface gráfica (headless, -p) que aguarda o término das tarefas em segundo plano em vez de interrompê-las após um limite oculto de 30 minutos. Uma correção revela que os subagentes de uma conexão via GEMINI_API_KEY estavam rodando em modelos duas gerações mais antigos em vez de Gemini 4 Argon e Gemini 3.8 Flash.
A 1.5.1 (5 melhorias, 7 correções) libera para todos os clientes ACP o conjunto completo de modelos da conta, ao passo que anteriormente apenas uma lista fixa de editores tinha acesso a outros modelos além do Gemini, e reduz o tempo de finalização de um comando no terminal de 5 segundos para cerca de 1 segundo quando um processo em segundo plano mantém a saída aberta. A distribuição é gradual e pode levar alguns dias.
Cursor lança chat de voz em tempo real com seus agentes, com Grok Voice
6 de novembro — O Cursor agora permite falar com seus agentes durante uma chamada de voz em tempo real: descrever uma alteração em voz alta, perguntar ao agente o que ele está fazendo, ouvir atualizações conforme o trabalho progride. O chat de voz funciona na Agents Window, na IDE, na versão web e no aplicativo para iOS. A chamada coloca dois agentes para trabalhar: um agente de voz ouve, responde e delega a codificação ao agente de chat; ele também responde, em modo somente leitura, sobre diffs e execuções, pesquisa mensagens e chamadas anteriores e altera o worker em um Project. O próprio agente de código se manifesta por meio de breves notas de progresso e uma resposta curta ao final.
A voz é fornecida pelo Grok Voice (o Cursor faz parte da SpaceX desde agosto), enquanto o agente de código mantém o modelo escolhido; várias vozes estão disponíveis, incluindo Ara, Eve, Leo, Rex e Sal. Com o Privacy Mode, o chat de voz funciona sem retenção de dados, e no iOS um comando da Siri inicia uma chamada com um novo agente. É necessária uma conta conectada (uma sessão aberta com chave de API não pode fazer chamadas), a chamada é encerrada após cerca de 10 minutos de silêncio se o agente não tiver nenhuma tarefa em andamento, e há um limite diário, sem valores divulgados. Nenhum preço é mencionado; o recurso de ditado, chamado anteriormente de Voice Mode, permanece separado.
🔗 Voice Chat with Agents (changelog do Cursor) · Documentação do chat de voz
Amp lança os Spaces, um agente que cria e coordena tópicos em vez do utilizador
6 de novembro — A Amp lança os Spaces: um space é uma conversa com um único agente, cujo papel é lançar e coordenar outros agentes. O utilizador já não precisa de criar nem de organizar os seus tópicos (threads): o agente do space encarrega-se disso. A Amp apresenta-o como uma forma de nível mais elevado de trabalhar com vários agentes; após algumas semanas de utilização interna, a equipa acredita que este pode ser o futuro da interação com agentes, com uma visão global e a possibilidade de entrar em detalhe.
A publicação apresenta três exemplos internos. Os Spaces foram construídos dentro de um space “Spaces v1”, no qual o agente distribuía em tópicos o feedback, bugs e ideias deixados no chat. Lewis geriu a partir de um space o lançamento das Service Accounts: implementação, monitorização do X, do Slack e dos relatórios de bugs, correções e, em seguida, e-mails e reembolsos aos utilizadores afetados. Will confiou a um space uma revisão periódica de segurança: a primeira passagem dividiu a base de código em 16 áreas, cada uma revista no seu próprio tópico, e cada constatação foi verificada noutro tópico, com um artefacto de síntese. O início faz-se através do botão + da secção Spaces na barra lateral; a publicação não menciona preços nem planos. No mesmo dia, a Amp adicionou um widget que transforma comentários deixados num website em tópicos de agente (ver as Breves).
Criar os modelos: Meta treina modelos especializados com o Muse Wonder, Hugging Face publica um guia de treino de MoE
Meta implementa no Muse e no Meta AI modelos especializados treinados com o Muse Wonder
6 de novembro — A Meta leva o Muse Wonder, o seu modelo de fronteira lançado a 12 de outubro, ao Muse e ao Meta AI: versões especializadas dos seus modelos existentes, treinadas com o Muse Wonder, foram aí implementadas; a publicação não as nomeia nem indica tamanho ou peso. Duas capacidades do Muse Wonder foram integradas: a memória ativa (Active Memory), destinada a reconhecer quando uma informação antiga volta a ser útil e a distinguir o que ainda é válido do que está desatualizado, e a concentração ativa (Active Focus), que visa permitir a recuperação após um obstáculo ou encontrar uma alternativa. No Meta AI, a Meta descreve um assistente que divide os problemas em etapas e faz perguntas de seguimento mais precisas, sem números associados.
| Métrica interna da Meta | Modelo atual do Muse | Modelo anterior |
|---|---|---|
| Personal Superintelligence Index | 47 % | 38 % |
| Active Memory Eval (contexto crítico bem utilizado) | 90 % das tarefas | 76 % |
| Esquecimento de informações críticas no Muse | dividido por 2,4 | — |
| Tarefas diárias onde ocorre um imprevisto | +67 % | — |
Todas estas métricas são da Meta, sem protocolo divulgado na publicação.
🔗 Publicação de investigação da Meta sobre os modelos especializados do Muse e Meta AI
Hugging Face publica The Ultimate MoE Training Handbook, fruto de 800 000 horas-GPU de experiências
5 de novembro — A Hugging Face publica The Ultimate MoE Training Handbook, um guia gratuito e aberto dedicado ao treino de modelos de mistura de especialistas (Mixture-of-Experts, MoE), assinado por Nouamane Tazi, Leandro von Werra e Thomas Wolf. O ponto de partida: segundo o índice da Artificial Analysis, 18 dos 20 melhores modelos de pesos abertos são MoEs, incluindo o DeepSeek V4.1 Flash 1017, o GLM-5.3 e o MiniMax-M3.1-Flash, embora o conhecimento prático para os treinar permaneça concentrado em poucas equipas.
18 of the 20 best open models today are Mixture-of-Experts. Dense is basically over. And yet the know-how to train a good MoE still lives mostly in the heads of a handful of teams. So we spent 800k GPU hours running the experiments ourselves and wrote everything down.
🇵🇹 18 dos 20 melhores modelos abertos atuais são Mixture-of-Experts. Os modelos densos estão praticamente acabados. E, no entanto, o conhecimento para treinar um bom MoE continua sobretudo na cabeça de um punhado de equipas. Por isso, dedicámos 800 000 horas-GPU a realizar nós próprios as experiências, e colocámos tudo por escrito. — @Thom_Wolf no X
As experiências foram executadas em nós AWS P5 com oito H100; Jeff Boudier, num tweet partilhado pela Hugging Face, refere 2 milhões de dólares gastos. O guia conta com cerca de 70 000 palavras, 55 figuras interativas e código executável, estimando-se um tempo de leitura de um a dois dias. Aborda as questões práticas das equipas: quantos especialistas, de que tamanho, partilhados ou não; que router e por que razão mantê-lo em FP32; perda auxiliar ou viés sem perda ao estilo DeepSeek para equilibrar a carga; começar a partir de um modelo denso (upcycling) ou do zero; por que razão um treino se torna 25 vezes mais lento sem quaisquer erros nos registos de logs. Uma parte final foca a disponibilização de serviço: especialistas em baixa precisão, paralelismo de especialistas e desagregação atenção-FFN.
🔗 The Ultimate MoE Training Handbook (Hugging Face)
A Agent API da Perplexity reduz o custo de todos os seus níveis de esforço, com qualidade igual ou superior de acordo com a Perplexity
5 de novembro — A Perplexity reduz o custo por pedido de todos os níveis de esforço (effort levels) existentes da sua Agent API, com uma qualidade de pesquisa igual ou superior de acordo com a empresa; a publicação detalha também o nível ultra, lançado no mesmo dia para as pesquisas mais abrangentes. Um nível de esforço é uma configuração pronta a usar que define o modelo, o orçamento de etapas, as definições de pesquisa e as ferramentas para um determinado tipo de tarefa. Um pedido que chame um nível pelo seu nome beneficia da atualização sem necessidade de alterar o código; fixar uma versão mantém a configuração antiga. As pontuações baseiam-se no BrowseComp e no DSQA, dois benchmarks públicos, e no WANDR, o benchmark interno da Perplexity para pesquisas longas sobre múltiplas entidades.
| Nível de esforço | Resultado publicado | Custo publicado |
|---|---|---|
| medium | de 55 % a 77 % no BrowseComp e DSQA | cerca de 90 % a menos |
| high, com extração de fetch_url | 88,0 % contra 83,5 % sem extração | 0,073 dólares por pedido contra 0,094 |
| xhigh | 76,5 % no WANDR, mantido | cerca de 25 % do custo da configuração de agosto |
| ultra | 85,9 % no WANDR, melhor pontuação testada | 21,71 dólares por tarefa |
O nível ultra executa três agentes em paralelo ao longo de toda a tarefa, e depois um quarto funde os resultados e redige a resposta. A publicação detalha as estratégias: um limite de etapas e de chamadas de ferramentas com avisos de orçamento (numa tarefa do BrowseComp, o agente avisado encontra a resposta em 13 de 40 etapas, enquanto o outro esgota as 40 sem a encontrar), um modelo mais pequeno que retém de uma página apenas os excertos úteis (5 561 tokens reduzidos para 293), skills carregadas a pedido, uma vez que pré-carregar tudo custa 13 % a mais, e um ciclo de avaliação que apenas adota um novo modelo se este tiver melhor desempenho com custo igual ou inferior. Não foi divulgada qualquer tabela de preços por nível.
🔗 Improvements to every Agent API effort level (Perplexity) · Tópico de @perplexitydevs
Perplexity Computer resume longas conversas em segundo plano e disponibiliza o Brain para todos os Projects
6 de novembro — A Perplexity publica o seu primeiro changelog de produto desde 19 de outubro, dividido em dezasseis tópicos; a maioria retoma novidades já anunciadas, como o Teammates, o Computer totalmente local no Mac ou o modo de voz, sendo sete inéditas. No Computer, as novas conversas longas resumem o seu histórico em segundo plano (background compaction): de acordo com a Perplexity, menos 94 % de pausas para continuar a trabalhar num contexto longo e menos 7 % de créditos por turno. Para modificar um website criado pelo Computer, passa a ser possível selecionar um elemento específico (título, botão, cartão, menu) em vez de desenhar um retângulo.
No que diz respeito aos Projects, o Brain, a memória do Project, passa a estar ativado gratuitamente em cada Project e atualiza-se diariamente a partir das suas conversas e dos seus ficheiros; um painel Project info e um painel de Settings unificado ficam disponíveis para todos. No Enterprise, as @menções permitem incluir um colega num tópico ou numa tarefa do Computer na web, e os controlos por função adicionam um limite de velocidade (Normal ou Fast) às definições de esforço já existentes. A skill Impeccable, que audita a hierarquia, a acessibilidade, o comportamento responsivo (responsive) e a consistência do design system de uma interface, passa a integrar a lista oficial. O changelog especifica ainda que os Agent Plugins estão abertos aos planos individuais e ao Enterprise em self-service, e que o Computer funciona totalmente de forma local a partir da aplicação para Mac 26.42.0. A redução de custos dos níveis de esforço, também aí referida, é detalhada na secção anterior.
🔗 Changelog da Perplexity de 6 de novembro
Voz: Phonon da Gradium é executado no dispositivo, ElevenLabs dá voz às personagens do Unity
Gradium detalha o Phonon, a sua síntese de voz integrada de pesos abertos
5 de novembro — Numa publicação no blogue da Hugging Face, a Gradium detalha o Phonon, disponibilizado duas semanas antes: um modelo de síntese de voz que funciona inteiramente no dispositivo, sem servidor nem rede, desde o telemóvel ao separador do navegador, passando por computadores de placa única. O Phonon existe em dois tamanhos, de cerca de 65 e 75 MB, e suporta números de telefone, datas e códigos. Mais de 100 vozes estão integradas, e outras podem ser criadas no Gradium Studio, através da clonagem de uma breve gravação com o consentimento da pessoa ou por descrição de texto, antes de serem descarregadas para execução local.
| Modelo Phonon | Idiomas suportados | Licença de utilização |
|---|---|---|
| Phonon 31m | inglês | Apache 2.0, utilização comercial livre |
| Phonon 40m | inglês, francês, alemão, espanhol, português | CC BY-NC, utilização comercial paga consoante o número de utilizadores |
Segundo a Gradium, o Phonon lidera em inteligibilidade em alemão e espanhol na Open TTS Leaderboard da Hugging Face e surge entre os três primeiros em cada língua avaliada, face a modelos até 100 vezes maiores; lidera também o benchmark de streaming em processador no tempo de resposta até ao primeiro som. A Gradium reivindica mais de 200 000 transferências em duas semanas. O seu motor de inferência ptts conta com mais de dez backends (processadores, GPUs via CUDA, Vulkan, Metal ou WebGPU, chips Core ML e Snapdragon), e a biblioteca Transformers integra-o desde a v5.21.
🔗 Phonon (blog da Hugging Face)
ElevenLabs lança SDK Unity para dar voz a personagens de videojogos com o ElevenAgents
5 de novembro — A ElevenLabs lança um SDK Unity para o ElevenAgents, a sua plataforma de agentes de voz. Este liga uma cena de jogo a um agente criado no painel de controlo da ElevenLabs: o jogador aproxima-se de uma personagem e fala em voz alta, o SDK capta o microfone, reproduz a voz do agente através de um AudioSource do Unity e gere a sessão através da Conversation API. A voz pode ser emitida a partir da personagem e o seu nível de volume animar uma boca; variáveis dinâmicas permitem que várias personagens partilhem o mesmo agente com diferentes estados de espírito; uma atualização contextual sinaliza ao agente um evento do jogo, como apanhar uma chave, sem o interromper; e ferramentas do lado do cliente permitem-lhe acionar código do jogo, como abrir uma porta.
| Plataforma de destino | Estado do SDK | Transporte utilizado |
|---|---|---|
| Editor e computador desktop (macOS, Windows, Linux) | Suportado | WebSocket |
| WebGL | Suportado | WebSocket ou WebRTC |
| iOS, Android, XR | Beta | WebSocket |
A instalação é feita através do Package Manager do Unity, a partir do repositório git da ElevenLabs fixado na v0.1.0 (versão publicada no GitHub a 27 de outubro, sob licença MIT), com uma curva de aprendizagem anunciada de cerca de dez minutos para o exemplo GettingStarted. A ElevenLabs lembra que se deve reativar a autenticação antes da publicação: um servidor deve fornecer um URL assinado de curta duração, e a chave de API nunca deve constar numa build. Não foram anunciados preços específicos.
🔗 Give your Unity NPCs a voice with ElevenAgents (ElevenLabs) · Repositório elevenlabs/unity
Ai2 apresenta oficialmente o ToyBlocks, o primeiro dos seus FoundationWorlds para estudar a aprendizagem de robôs
6 de novembro — O Ai2 apresenta oficialmente o ToyBlocks, cujo código e dados já estavam online desde o dia anterior. O instituto enquadra-o num projeto mais vasto, os mundos de fundação (FoundationWorlds): um mundo simulado controlado, com geração automática de tarefas e demonstrações, e métricas que acompanham o comportamento do robô ao longo do tempo, permitindo variar dados ou modelos, reproduzir testes e rastrear a causa de uma falha. As demonstrações são produzidas sem teleoperação, até 24 vezes mais rápido do que o tempo real numa única GPU. Os primeiros resultados centram-se na transição para o mundo real e nos agentes de fronteira:
| Avaliação publicada pelo Ai2 | Resultado obtido |
|---|---|
| Competências atómicas do ManiFlow, em simulação e em robô real | 80,0 % e 81,1 % |
| Molmo 2 + ManiFlow, em simulação e em robô real | 55,5 % (111 em 200) e 50,0 % (15 em 30) |
| Claude Opus 5.5 via MCP, tarefas de procurar e soletrar (search and spell) | 63 % resolvidas ou declaradas inviáveis com razão |
| Descrições de competências por defeito, de especialista humano, aprendidas | 24 %, 36 % e 63 % de sucesso |
| Claude Opus 5.5 em planeamento clássico | 30 tarefas de empilhamento em 30 |
Nas tarefas de procurar e soletrar, metade dos cenários são inviáveis, e os erros provêm sobretudo de letras semelhantes (13 %) ou de uma orientação incorreta (15 %). O Ai2 especifica que são necessários mais testes em robôs reais para garantir consistência estatística. Uma interface web permite dar instruções ao robô em linguagem natural com o Claude ou outro modelo de fronteira, e o repositório complementar allenai/agentic_robotics disponibiliza o ciclo agêntico orquestrado por MCP, sob licença Apache-2.0.
🔗 ToyBlocks (blog do Ai2 na Hugging Face) · Repositório allenai/agentic_robotics
GitHub apresenta Copilot Verified Proficiency, um nível de proficiência calculado com base no uso real do Copilot
6 de novembro — O GitHub destaca o Copilot Verified Proficiency, uma nova forma de reconhecimento de competências (credential) conjunta da Microsoft e do GitHub, vinculada ao Microsoft Pro Badge. Em vez de um exame, o nível é calculado continuamente a partir das tarefas realmente executadas com o Copilot, com base na telemetria, de acordo com o escopo, a profundidade e a consistência do uso, e não com o volume de atividade. Cinco competências são avaliadas: colaboração com IA, elaboração de prompts, geração e validação de código, configuração de agentes, integração de ferramentas e contexto. Três níveis estão disponíveis (Beginner, Intermediate, Proficient), com Advanced e Expert em desenvolvimento; o nível Proficient concede um Pro Badge compartilhável, que expira após seis meses se o nível não for mantido, e o nível diminui sem o uso do Copilot.
A participação é opcional (opt-in), os resultados são privados por padrão e nem o empregador nem a organização podem visualizá-los sem compartilhamento voluntário; as matrizes de avaliação e os algoritmos continuam proprietários. Contas Enterprise Managed Users e GitHub Enterprise Cloud com residência de dados não são suportadas. O status permanece incerto: a página, sem data, oferece o cálculo do nível, mas sua FAQ menciona uma versão prévia privada conduzida com parceiros convidados.
🔗 Copilot Verified Proficiency (GitHub Learn) · Anúncio do @github no X
NVIDIA quantifica o crescimento de suas ferramentas de código aberto 5G/6G Aerial e Sionna, com cinco projetos de pesquisa
6 de novembro — Um ano após abrir o código de seu software sem fio Aerial, que se juntou ao Sionna em um conjunto de ferramentas para pesquisa em 6G, a NVIDIA faz um balanço em uma publicação assinada por Soma Velayutham. Segundo a NVIDIA, a adoção do AI Aerial e do Sionna por desenvolvedores multiplicou-se por dez em um ano, suas ferramentas de código aberto 5G/6G ultrapassaram um milhão de downloads e mais de 8.000 instituições de pesquisa e universidades as utilizam. A publicação não anuncia nenhum produto e ilustra esses usos com cinco projetos:
| Equipe de pesquisa | Resultado relatado | Condições de medição |
|---|---|---|
| King’s College London | Tempo de execução de tarefas robóticas reduzido em até 52,6% | Descrição compacta de objetos em vez de imagens completas, falhas provocadas intencionalmente |
| SoftBank | Taxa de upload superior em todas as 15 configurações testadas, ganho máximo de cerca de 60% | Receptor neural no Aerial CUDA-Accelerated RAN, smartphone 5G comercial, interferências controladas |
| ETH Zurich | Taxa de erro de bloco reduzida em mais de um terço | Receptores ajustados em medições locais, em comparação com versões pré-treinadas selecionadas |
| Universidade de Leeds | Consumo da rede de acesso por rádio reduzido em 45,6% | Modo de espera de estações rádio base programado com 10 minutos de antecedência, em comparação com uma referência em potência máxima |
| CTTC (Catalunha) | Simulação reduzida de cerca de 3 horas para 10 a 20 minutos | Primeira avaliação, modelos de canal em GPU no simulador de código aberto 5G-LENA |
A publicação redireciona para as sessões de desenvolvedores 6G do GTC Washington, D.C., e lembra que o Aerial e o Sionna estão disponíveis no GitHub.
🔗 How NVIDIA Open Source Tools Are Helping Researchers Build Next-Generation 6G Networks (NVIDIA)
Breves
Agentes e ferramentas de código
- Sessões em nuvem do Claude Code — Nos planos Pro, Max e Ultra, o Claude determina por conta própria as dependências, o acesso à rede e as chaves de API necessárias para um repositório, salvando esse ambiente para as sessões seguintes; de acordo com @ClaudeDevs, as chaves são armazenadas sem que o Claude as veja. O anúncio foi feito em um tweet, sem publicação em blog ou documentação. 🔗 fonte
- Widget de feedback do Amp — Uma tag de script e, em seguida, o endereço de uma página com o sufixo
?amp, permitem clicar em um elemento de um site e escrever uma instrução: o Amp abre uma thread no projeto e o agente faz a alteração em uma orb, em uma cópia do repositório. Exclusivo para projetos de workspace, sem preços informados. 🔗 fonte - Gemini CLI — Nenhuma versão nightly foi publicada nos dias 5 e 6 de novembro devido a uma falha no workflow, mas a Gemini CLI realizou o merge de cerca de uma dúzia de commits na main no dia 6: temas de cores em um arquivo
theme.jsonindependente, validação de nomes de modelos em/model, fim das esperas de cota de várias horas no modo ACP e dos bloqueios de rede silenciosos. Nada disso está disponível em uma versão ainda. 🔗 fonte - Qwen Code v0.26.9 — As skills podem ser instaladas a partir de arquivos ZIP (Web Shell, daemon ou SDK TypeScript) e uma única requisição ativa ou desativa até 100 skills; a automação do Managed Agent agora vem ativada por padrão e o suporte à entrada de imagens foi estendido para Llama 4, Pixtral e Mistral Small. Nenhuma alteração incompatível. 🔗 fonte
- Kimi Code 2.5.2 — Três correções de bugs: declarações de ferramentas duplicadas quando as definições de ferramentas MCP mudam, mensagens de orientação enfileiradas incorretamente durante uma sessão e criação de projetos quando a interface web é servida via HTTP. 🔗 fonte
- ZCode v3.17.2 — Em 4 de novembro, sem notas de versão, o espaço de trabalho de código da Z.ai passou a rotear a visualização de arquivos HTML locais de seu navegador integrado por meio de um endereço
zcode-html://restrito à pasta deles: por padrão, o Electron permite que uma páginafile://leia outros arquivos. 🔗 fonte - Frota de agentes de código — Tony Dzi faz um balanço de 103 dias de agentes de código de uma mesma família operando em sete máquinas: um protocolo de coordenação pode cumprir todos os seus invariantes de segurança e, ainda assim, ser abandonado. Ele publicou o claw-consensus, seu mecanismo de consenso sem LLM, e a telemetria que mostra a queda acentuada em seu uso. 🔗 fonte
APIs, plataformas e segurança
- Chamadas saintes do GPT-Live — Em 2 de novembro, a OpenAI liberou para todas as organizações as chamadas telefônicas saintes do GPT-Live via SIP, através da Live API: número no formato E.164, tronco da operadora, sinalização TLS e áudio SRTP, toque limitado a 3 minutos e duração da chamada a 2 horas; sem tarifas divulgadas. 🔗 fonte
- API Agents da OpenAI — Michael Luo, gerente de produto na OpenAI, faz um balanço de outubro, cobrindo pontos já conhecidos em sua maioria, e oferece sob demanda cinco recursos em versão beta: memória entre sessões, acesso de agentes à API Decisions, teto de orçamento em dólares, pool de ambientes e arquitetura v2. 🔗 fonte
- gemini-embedding-2-preview — A API Gemini descontinuou este modelo: desde 6 de novembro, suas requisições são roteadas para
gemini-embedding-2com o preço do Gemini Embedding 2, mantendo o mesmo esquema e o mesmo espaço de embeddings; basta alterar o nome do modelo, sem necessidade de reindexar. 🔗 fonte - Métricas de uso do Copilot — A API agora monitora, por repositório, a taxa de comentários do Copilot code review tratados pelos desenvolvedores, detalhada por gravidade, nível de revisão e tipo de comentário, além de sinalizar usuários sem telemetria ou com versões inferiores às mínimas da IDE e da extensão. 🔗 fonte
- OpenAI e Hacktron — A OpenAI fez uma parceria com a Hacktron, descoberta por meio de seu programa de recompensas por bugs, para buscar vulnerabilidades em seus próprios sistemas, especialmente nas interações com serviços de terceiros, ampliando seu acesso a modelos de ponta via Daybreak Red; nenhum valor foi divulgado. 🔗 fonte
- Transformers v5.22.2 — Correção intermediária da Hugging Face que reforça o sandbox Jinja e restringe a definição de
device_idapenas para NCCL; as notas não mencionam nenhum alerta de segurança. 🔗 fonte
Empresas e educação
- Universidades australianas — Em 5 de novembro, a OpenAI detalhou suas colaborações com a UNSW Sydney (ChatGPT Edu para mais de 80.000 alunos e funcionários), a Universidade de Sydney, a La Trobe e a Adelaide University; em uma pesquisa da Pureprofile encomendada pela OpenAI com 1.018 estudantes, 81% afirmaram usar IA várias vezes por semana. 🔗 fonte
- Cult.fit e Codex — Em 5 de novembro, um estudo de caso da OpenAI mostrou a rede indiana de academias padronizando sua engenharia no Codex: mais de 20 aplicações internas criadas por equipes não técnicas, mais de 100.000 dólares em economia anual com softwares e custos de suporte ao cliente reduzidos em mais de 50%. 🔗 fonte
- Merge e GPT-6 Astra — Em 5 de novembro, a startup Merge explicou que um bot baseado no GPT-6 Astra, conectado ao Salesforce, Gong, Google Sheets e Gmail, reduziu a preparação de um jantar com clientes de dezenas de horas para cerca de 30 minutos; a empresa passou de 8 jantares no segundo trimestre para 16 no terceiro. 🔗 fonte
- Franklin Templeton — Em 5 de novembro, a gestora de ativos descreveu uma camada de inteligência conectada, desenvolvida principalmente com o Codex, que conecta pesquisa, risco, conformidade e trading para seus gestores de portfólio; nenhum dado de resultado foi divulgado. 🔗 fonte
- Flipsnack e ChatGPT Ads — Em 5 de novembro, este depoimento de cliente reportou cerca de 310% mais cadastros e um custo por cadastro cerca de 75% menor, com orçamento diário inalterado, após a migração de cinco campanhas nos EUA da otimização de cliques para conversões. 🔗 fonte
- Box e NVIDIA — Em 5 de novembro, no BoxWorks 2026, a Box disponibilizou os modelos abertos Nemotron, começando pelo Nemotron 3 Ultra, para clientes Enterprise Advanced do Box AI; o Box Context Retrieval, desenvolvido sobre o Nemotron Retriever, é esperado para o início do próximo ano e poderá, de acordo com a Box, aumentar a precisão de busca em 20% e consumir 90% menos tokens. 🔗 fonte
Aplicativos do Google
- Flashcards do Gemini Notebook — Os cartões agora aceitam imagens, um cronômetro opcional permite testar a retenção e o aplicativo móvel agenda lembretes de estudo; países ou planos específicos não foram informados. 🔗 fonte
- Gemini no Google Forms — Na aba Respostas, o Gemini analisa os dados escrevendo e executando código Python, identificando tendências e correlações e sugerindo ações; a distribuição começou em 2 de novembro no ciclo Rapid Release e começará em 19 de novembro no Scheduled Release, para planos Business, Enterprise e Education qualificados e assinantes do Google AI. 🔗 fonte
Voz, música e imagem
- Open ASR Leaderboard — O ranking de reconhecimento de fala da Hugging Face adicionou dois conjuntos de testes privados da Liva AI, em inglês conversacional com sotaques egípcio (1,34 hora) e nigeriano (1,55 hora), com uma classificação inspirada nos círculos de Kachru; nenhum resultado de modelo foi informado. 🔗 fonte
- Dialeto libanês — Na segunda parte de sua série, após a de 5 de novembro, Bilal Zaraket desenvolveu um léxico libanês validado por três falantes nativos (429 entradas) antes de gerar dados de voz: a proporção de frases a serem corrigidas caiu de 22% para 4%, abaixo do limite de 5% previamente estabelecido. 🔗 fonte
- ElevenMusic e SoundCloud — A ElevenLabs conectou sua plataforma musical ao SoundCloud: uma faixa original é enviada diretamente para o perfil do artista, com descrição, gênero e tags. Membros do SoundCloud Artist Pro ganham três meses gratuitos de ElevenMusic, passando depois para 9,99 dólares por mês, em oferta válida até 31 de outubro de 2027. 🔗 fonte
- Ads Engine — A ElevenLabs incluiu uma revisão humana opcional, realizada por linguistas e profissionais de localização da ElevenProductions e especialistas criativos internos, em criativos visuais, anúncios do Google Search e vídeos dublados; o acesso é feito por meio da equipe comercial, sem preços ou prazos divulgados. 🔗 fonte
- Daily Song Challenge da Suno — Os aplicativos para iOS e Android oferecem diariamente um prompt de música, editável antes da criação, organizando as faixas em um calendário na biblioteca, disponível para todos os planos. 🔗 fonte
- Runway e GPT Image 2.6 — A Runway adicionou o modelo de imagem da OpenAI, promovido como 50% mais rápido, com suporte a GIF, exportação em SVG e edições que mantêm a consistência de personagens e produtos; a variante e o custo em créditos não foram especificados. 🔗 fonte
Pesquisa, robótica e modelos
- Modelos científicos — O blog Science da Anthropic publicou um artigo convidado de Jakob Macke, Daniel Gedon e Stefan Wahl (ELLIS Institute Tübingen) sobre a IA que constrói, restringe e interpreta modelos científicos, desde o modelo de Hodgkin-Huxley até a inferência baseada em simulação. 🔗 fonte
- Ranking SuperCLUE — Uma publicação da comunidade feita pelo VIDRAFT divulgou o ranking de novembro (19 modelos): o GPT-6.1-Sol lidera em código agêntico (69,23) e o DeepSeek-V4.1-Flash-1017 ficou em primeiro lugar entre os modelos abertos (65,38), com o Kimi-K3.1-Pro obtendo a melhor pontuação geral entre eles. 🔗 fonte
- LingYu Robotics — A empresa publicou 139,4 horas e 13.263 episódios bem-sucedidos de teleoperação bimanual gravada da perspectiva do robô, distribuídos em 15 famílias de tarefas, no formato LeRobot e sob licença não comercial. 🔗 fonte
- Egocentric-EMG-Force — Harpreet Sahota converteu para o FiftyOne oito episódios e 38,2 minutos de tarefas domésticas gravadas com uma câmera de profundidade, utilizando uma pulseira de EMG em cada pulso para registrar a atividade muscular dos antebraços. 🔗 fonte
- Teaser do Qwen — A conta oficial do Qwen publicou uma mensagem curta e enigmática, acompanhada por uma imagem cuja inscrição em chinês deixa um nome em branco, sem nome de modelo, data ou link; a postagem ultrapassou 1,3 milhão de visualizações no mesmo dia. 🔗 fonte
O que isso significa
A IA entra na pesquisa estruturada e mensurada. Os agentes da Google DeepMind trabalharam sob supervisão humana, com pesquisadores do Inria, em um RSA de 1024 bits já descontinuado e em uma chave de referência já resolvida, em simulação isolada: o ganho teórico de cerca de 1 600 vezes não ameaça as chaves de 2048 bits, mas lembra que uma hipótese de dificuldade nunca é definitiva. O BioBasicsBench e o TCSExam seguem a mesma disciplina: a própria OpenAI publica os erros do GPT-6 Astra, incluindo uma contagem de colônias superestimada em cerca de 12%, e o TCSExam faz com que cada tarefa seja verificada pelo núcleo Lean ou por um verificador executável, sem que nenhuma conjectura em aberto caia. O Frontier Model Forum aplica a mesma lógica ao risco, com uma matriz comum para decidir quais jailbreaks cibernéticos corrigir primeiro.
O que envolve o modelo decide cada vez mais o sucesso de um agente. Na Anthropic, uma única anotação incorreta sobre Mt. Moon trava a partida de Pokémon até que o dreaming a corrija, e uma wiki mantida atualizada economiza cerca de 20 000 tokens por pergunta. Na Google, um TODO antigo basta para desviar um agente: um desvio não solicitado sobrecarrega a sessão com 70% mais etapas, 77% mais tokens e 105% mais tempo de espera, a ponto de a Google ter lançado agentes para limpar as suas bases de código. Os harness adapters atacam o problema por meio do treinamento, com um LoRA por harness que reduz as chamadas de ferramentas mantendo a mesma precisão, e os recursos da Perplexity são da mesma natureza: lembretes de orçamento, extração de páginas, skills carregadas sob demanda.
Os agentes de código estão mudando de interface. Conversa-se com eles pelo chat de voz do Cursor, que separa o agente que escuta daquele que programa; delega-se a eles a organização, com um space do Amp que inicia threads por conta própria, chegando a dividir uma revisão de segurança em 16 zonas; e conecta-se os agentes em todo lugar, já que o ACP torna o Antigravity CLI o agente de qualquer editor compatível, com todos os modelos da conta. Os ciclos de versões estão se estreitando em paralelo (146 entradas para o Claude Code 2.1.319, 637 para o Copilot CLI 1.0.106, 120 PRs para o Codex CLI 0.167.0), com controles mais refinados sobre o que o agente tem permissão para fazer, desde a recusa sem prompt do Claude Code até as regras prompt-user do Codex.
O custo e o acesso também estão mudando. A Perplexity torna o seu nível medium quase 90% mais barato, ao mesmo tempo que o eleva de 55% para 77%, e ativa gratuitamente o Brain em cada Project. O Phonon executa síntese de voz diretamente no dispositivo, sem servidor, com modelos de cerca de 65 e 75 MB, incluindo uma versão em inglês sob licença Apache 2.0. A Meta transfere capacidades do Muse Wonder para modelos especializados disponibilizados aos usuários do Muse e da Meta AI, e a Hugging Face disponibiliza em acesso livre o conhecimento técnico em treinamento de MoE adquirido ao custo de 800 000 horas-GPU.
Fontes
- Artigo de Pushmeet Kohli sobre criptanálise (X)
- @GoogleDeepMind: os sistemas de 2048 bits continuam seguros
- Artigo técnico sobre assinaturas digitais (Google DeepMind, PDF)
- Artigo técnico sobre fatoração de chaves (Google DeepMind, PDF)
- Introducing the FMF Jailbreak Rating Framework for Frontier Cyber Threats (Frontier Model Forum)
- Measuring how AI agents handle everyday wet-lab science (OpenAI)
- Resultados do TCSExam
- Artigo arXiv 2611.07962 (TCSExam)
- The components of agent memory (Anthropic)
- Agent Distraction (blog Google Developers)
- Harness adapters (blog Hugging Face)
- Notas de versão do Claude Code 2.1.319
- Notas de versão do Codex CLI 0.167.0
- Copilot CLI 1.0.106
- Copilot CLI 1.0.107
- SDK Copilot 1.0.29
- Changelog do Antigravity
- Voice Chat with Agents (changelog do Cursor)
- Documentação do chat de voz do Cursor
- Spaces (Amp)
- Artigo de pesquisa da Meta sobre os modelos especializados do Muse e da Meta AI
- The Ultimate MoE Training Handbook (Hugging Face)
- @Thom_Wolf: 800 000 horas-GPU de experimentos
- Improvements to every Agent API effort level (Perplexity)
- @perplexitydevs: redução de custo dos níveis de esforço
- Changelog da Perplexity de 6 de novembro
- Phonon (blog Hugging Face)
- Give your Unity NPCs a voice with ElevenAgents (ElevenLabs)
- Repositório elevenlabs/unity (GitHub)
- ToyBlocks (blog da Ai2 no Hugging Face)
- Repositório allenai/agentic_robotics (GitHub)
- Copilot Verified Proficiency (GitHub Learn)
- @github: Copilot Verified Proficiency
- How NVIDIA Open Source Tools Are Helping Researchers Build Next-Generation 6G Networks (NVIDIA)
- @ClaudeDevs: sessões em nuvem do Claude Code
- Close the Loop (Amp)
- Gemini CLI, PR 30119: temas em theme.json
- Qwen Code v0.26.9
- Kimi Code 2.5.2
- ZCode v3.17.2
- Publicação de Tony Dzi sobre 103 dias de agentes de código e claw-consensus (blog Hugging Face)
- Changelog da API da OpenAI
- @AzianMike: balanço de outubro da API Agents
- Notas de versão da API Gemini de 6 de novembro
- Usage metrics API: detalhes de code review (GitHub Changelog)
- Partnering with Hacktron to find vulnerabilities in OpenAI’s systems (OpenAI)
- Transformers v5.22.2
- Australian universities are creating AI-native graduates (OpenAI)
- Cult.fit builds operational muscle with Codex (OpenAI)
- Merge builds product and business tools with OpenAI technology (OpenAI)
- Franklin Templeton uses OpenAI to support investment research (OpenAI)
- Flipsnack grows product signups with conversion optimization (OpenAI)
- Comunicado da Box sobre a sua parceria com a NVIDIA (BoxWorks 2026)
- @Gemini_Notebook: novidades dos Flashcards
- Análises acionáveis do Gemini no Google Forms (Google Workspace Updates)
- Open ASR Leaderboard e Liva AI (blog Hugging Face)
- Léxico libanês de Bilal Zaraket, segunda parte (blog Hugging Face)
- Share your ElevenMusic creations directly to SoundCloud (ElevenLabs)
- Ads Engine adds human review from localization experts and creative specialists (ElevenLabs)
- Daily Song Challenge (notas de versão da Suno)
- @runwayml: GPT Image 2.6 no Runway
- Teaching AI to build scientific models (Anthropic)
- Classificação SuperCLUE de novembro (blog Hugging Face)
- Conjunto de dados da LingYu Robotics (blog Hugging Face)
- Egocentric-EMG-Force e FiftyOne (blog Hugging Face)
- @Alibaba_Qwen: teaser de 6 de novembro