ai-powered-markdown-translatorArtículo traducido del fr al es con gemini-3.8-flash-high.
Agentes de IA de Google DeepMind, guiados por humanos, encuentran dos debilidades en RSA de 1024 bits, un sistema ya obsoleto; los protocolos modernos, que utilizan casi todos claves de 2048 bits o más, siguen siendo seguros. La investigación domina la jornada: OpenAI mide sus agentes en laboratorios húmedos con BioBasicsBench, TCSExam evalúa los modelos en informática teórica, y tanto Anthropic como Google muestran lo que, en torno al modelo, hace triunfar o descarrilar a un agente. En cuanto a herramientas, Claude Code, Codex CLI y Copilot CLI publican nuevas versiones, Antigravity CLI se convierte en un servidor ACP, Cursor abre el chat de voz con sus agentes y Amp lanza Spaces.
Agentes de Google DeepMind guiados por humanos encuentran dos debilidades en RSA de 1024 bits, el Frontier Model Forum califica los jailbreaks cibernéticos
6 de noviembre — Google DeepMind publica trabajos de criptoanálisis, la ciencia que pone a prueba la solidez del cifrado, llevados a cabo por agentes de IA guiados por supervisión humana. Pushmeet Kohli, vicepresidente a cargo de ciencia, los presenta en un artículo publicado en X y compartido por @GoogleDeepMind: los agentes han sacado a la luz dos debilidades de los sistemas RSA de 1024 bits, que pueden verse comprometidos con un presupuesto computacional menor de lo que se creía. Los trabajos están dirigidos por Dj Dvijotham y Abhradeep Thakurta, del equipo de Ciencia de Google DeepMind, junto con Nadia Heninger (UC San Diego e Inria) y Emmanuel Thomé (Inria), y se detallan en dos artículos técnicos en PDF; ninguna publicación de blog acompañó al anuncio.
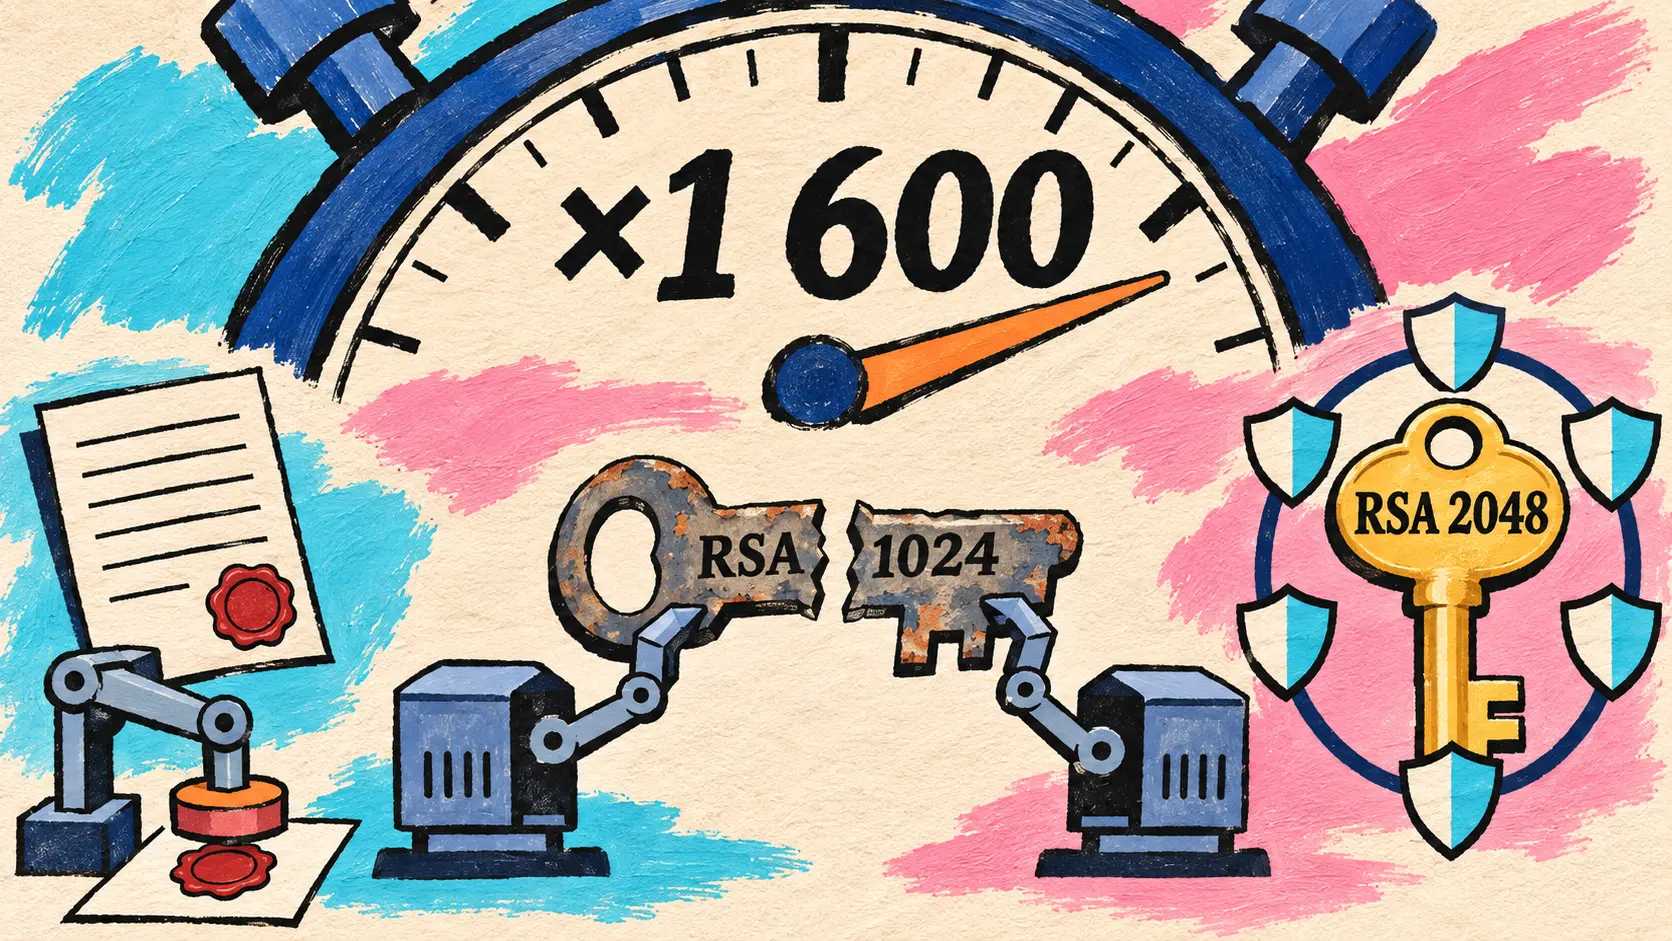
El alcance es deliberadamente limitado. RSA de 1024 bits, obsoleto y ya retirado, sirve aquí como banco de pruebas sin riesgo, como viene haciendo desde hace tiempo la comunidad de criptoanálisis. Los protocolos modernos, que emplean casi todos claves de 2048 bits o más, siguen siendo seguros.
El primer resultado afecta a las firmas digitales, que garantizan que una actualización de software, un documento o un sitio web provienen realmente de su origen. Antes de firmar, muchos estándares complementan el mensaje con un relleno (padding). El equipo demuestra que, tan pronto como un atacante controla aproximadamente la mitad del bloque firmado, este relleno ya no protege en absoluto. En una simulación aislada, sin tocar ningún sistema real, los agentes ejecutaron el ataque sobre una clave de referencia de 1024 bits ya resuelta por un estudio previo: el resultado se reproduce con 3,5 veces menos tiempo de CPU, a menos de una milésima parte de la potencia que se requeriría para romper la clave en sí. Cuando el atacante controla una porción menor del bloque, con una huella corta de 32 bytes, un nuevo algoritmo mejoraría unas 1600 veces el mejor método anterior, según las estimaciones teóricas de los autores.
El segundo resultado se centra en la factorización por lotes. Dado que las claves RSA tienen longitudes estándar (1024 o 2048 bits), factorizar numerosos números del mismo tamaño es una cuestión clave: los agentes encontraron un algoritmo con una mejor complejidad asintótica, que reduce aproximadamente en un factor de 30 el coste medio de factorizar cada clave adicional de 1024 bits, en comparación con los métodos por lotes anteriores.
| Resultado publicado por los autores | Ganancia anunciada | Condición indicada |
|---|---|---|
| Falsificación de firma, atacante que controla aproximadamente la mitad del bloque | 3,5 veces menos tiempo de CPU | Simulación aislada, clave de referencia de 1024 bits ya resuelta |
| Mismo ataque, en comparación con romper la clave | Menos de una milésima parte de la potencia | Potencia necesaria para romper la clave en sí |
| Falsificación con una huella de 32 bytes | Unas 1600 veces mejor | Estimación teórica, claves de 1024 bits |
| Factorización por lotes | Coste medio aproximadamente 30 veces menor por clave adicional | Frente a métodos por lotes anteriores |
| Claves de 2048 bits o más | No afectadas | Siguen siendo seguras según Google DeepMind |
While modern 2048-bit systems remain safe from these specific exploits, this work highlights a key shift. As we enter a new era of AI-enabled math and computation, we can no longer rely on historical hardness assumptions and must continuously stress-test cryptographic standards.
🇪🇸 Si bien los sistemas modernos de 2048 bits permanecen a salvo de estos exploits específicos, este trabajo pone de relieve un punto de inflexión clave. A medida que entramos en una nueva era de las matemáticas y la computación asistidas por IA, ya no podemos confiar en las suposiciones históricas de dificultad y debemos poner a prueba de forma continua los estándares criptográficos. — @GoogleDeepMind en X
🔗 Artículo de Pushmeet Kohli en X · Artículo técnico sobre firmas digitales (PDF) · Artículo técnico sobre factorización de claves (PDF)
El Frontier Model Forum propone un baremo común para calificar la gravedad de los jailbreaks cibernéticos
5 de noviembre — El Frontier Model Forum (FMF), que reúne a laboratorios de IA punteros, publica la versión 1.0, presentada como preliminar, de su marco de calificación de jailbreaks para ciberamenazas (Jailbreak Rating Framework for Frontier Cyber Threats). Punto de partida: no todas las evasiones de salvaguardas son iguales. Algunas solo generan respuestas difícilmente explotables, otras desbloquean capacidades ofensivas peligrosas, y sin un método común dos organizaciones pueden evaluar de forma diferente el mismo jailbreak, con el riesgo de corregir primero los menos graves. El marco clasifica cada jailbreak por niveles combinando puntuaciones en cuatro categorías: ganancia de capacidad, alcance de la capacidad, facilidad de despliegue y facilidad de descubrimiento.
Representantes de AWS, Anthropic, Google DeepMind, Microsoft y OpenAI lo respaldan en la publicación; OpenAI lo compartió el 6 de noviembre indicando haber trabajado en él junto al FMF y sus miembros. Hay una consulta pública abierta hasta el 21 de diciembre de 2026: el FMF comprobará si evaluadores distintos llegan a calificaciones similares y actualizará el marco conforme surjan nuevos jailbreaks. En julio, Anthropic había detallado una escala similar, CJS (Cyber Jailbreak Severity), desarrollada con Amazon, Microsoft y Google; la publicación del FMF no establece relación entre ambas.
🔗 Introducing the FMF Jailbreak Rating Framework for Frontier Cyber Threats
Medir la IA en la ciencia: BioBasicsBench de OpenAI para el laboratorio húmedo, TCSExam para la informática teórica
OpenAI publica BioBasicsBench: 100 tareas de laboratorio húmedo, 66,7 % para GPT-6 Astra
6 de noviembre — OpenAI presenta BioBasicsBench, un benchmark diseñado con Ligo, una biotecnológica especializada en el diseño de enzimas, para medir la capacidad de los agentes para interpretar los datos brutos del trabajo habitual en laboratorio húmedo (wet lab): geles y blots, placas de cultivo, imágenes de microscopía, exportaciones de instrumentos o vídeos de protocolos. Sus 100 tareas, extraídas de experimentos reales y calificadas criterio por criterio según una rúbrica de expertos, cubren cinco áreas, desde métodos proteicos hasta clonación molecular; también comprueban que el agente detecte errores y reconozca cuándo los datos no permiten llegar a una conclusión.
Solo se evalúan modelos de OpenAI: siete modelos en 37 configuraciones, cinco intentos por tarea, lo que supone 18 500 resultados. Con esfuerzo xhigh, GPT-6 Astra obtiene el 66,7 % de la puntuación disponible, por delante de GPT-6.1 Sol y lejos de GPT-5.6 Sol, con aproximadamente la mitad de tokens de salida que este último; según OpenAI, estas mejoras sugieren que una multimodalidad nativa más potente podría resultar decisiva.
| Modelo evaluado (esfuerzo xhigh) | Recompensa media | Intervalo de confianza al 95 % | Tokens de salida por tarea |
|---|---|---|---|
| GPT-6 Astra | 66,7 % | 60,3 a 73,1 % | 4 704 |
| GPT-6.1 Sol | 62,0 % | 55,6 a 68,4 % | 5 238 |
| GPT-5.6 Sol | 43,8 % | 37,6 a 50,0 % | 9 099 |
| GPT-6 Luna | 38,3 % | 32,3 a 44,5 % | 13 120 |
| GPT-5.5 | 35,4 % | 29,7 a 41,0 % | 11 135 |
| GPT-5.4 | 33,2 % | 28,3 a 38,4 % | 13 717 |
| GPT-5.2 | 31,2 % | 26,2 a 36,3 % | 27 620 |
OpenAI detalla también los fallos de Astra: una hipótesis familiar que se impone sobre los controles experimentales, observaciones contrarias descartadas, un recuento de colonias sobreestimado en torno al 12 %. Según la publicación, unas puntuaciones mejores aún no garantizan juicios fiables en el laboratorio; OpenAI vincula este seguimiento con la bioprotección y la bioseguridad, y no menciona la publicación del conjunto de tareas.
🔗 Measuring how AI agents handle everyday wet-lab science (OpenAI)
TCSExam evalúa los modelos en informática teórica: GPT-6 Astra lidera la versión Full, Opus 5.5 la versión Lite
5 de noviembre — TCSExam, publicado en la organización de GitHub de Moonshot AI con un artículo de arXiv depositado el 5 de noviembre, mide hasta dónde pueden los modelos hacer avanzar la investigación en informática teórica (theoretical computer science). Los autores que figuran en arXiv son Yifan Luo, Zhengying Liu, Yang Yuan, Zhilin Yang y Andrew Chi-Chih Yao. Cuatro vías: demostrar en Lean un teorema publicado, programar un solucionador evaluado en instancias ocultas, producir una construcción o una cota verificada, y demostrar o refutar por completo conjeturas abiertas. La versión Full consta de 100 tareas revisadas por expertos, la versión Lite de 20, cinco por vía. El índice otorga un peso de 30 a cada una de las tres primeras vías y de 10 a las conjeturas; los solucionadores se califican respecto a una referencia fija, Kimi K3.
| Modelo evaluado | Índice Lite (20 tareas) | Índice Full (100 tareas) |
|---|---|---|
| Opus 5.5 | 72,3 (provisional) | ausente de la tabla del sitio |
| GPT-6 Astra | 67,0 | 71,9 |
| Kimi K3.1 Pro | 53,5 | 57,4 |
| Kimi K3 | 48,6 | 46,8 |
| GLM-5.3 | 47,0 | 45,5 |
| Qwen3.8 Max (0902) | 45,4 | 44,8 |
| DeepSeek V4.1 Flash 1017 | 42,4 | 46,0 |
| Grok 4.6 | 42,1 | 40,5 |
No se resuelve ninguna conjetura abierta: el resumen solo reivindica casos particulares y cotas verificadas de forma independiente. No obstante, dos resultados superan el mejor conocido, según el conocimiento de los autores: un grafo de 630 aristas sobre 124 vértices, sin triángulos ni ciclos de cuatro aristas, construido por Kimi K3 (629 para la construcción de Goedgebeur et al.), y un código corrector cuántico de distancia 6, en lugar de 5, hallado por GPT-6 Astra para proteger 7 qubits lógicos con 25 qubits físicos. El banco de pruebas ejecuta Kimi Code por defecto y también admite Claude Code, Codex y Grok Build.
🔗 Resultados de TCSExam · Artículo de arXiv 2611.07962
Investigación sobre agentes: memoria y dreaming en Anthropic, TODO obsoletos en Google, harness adapters
Anthropic muestra cómo el dreaming corrige y organiza la memoria de los agentes Claude
6 de noviembre — En una publicación de investigación e ingeniería de su blog Engineering, Anthropic define la memoria de agente como lo que Claude retiene de su experiencia de una sesión a otra, en forma de notas legibles: ni pesos, ni aprendizaje en contexto, ni compactación. El dreaming (el «sueño» del agente) le hace releer, fuera de sesión, sus registros y transcripciones para corregir sus notas, escribir otras nuevas, construir representaciones como wikis o elegir qué se precargará; la función existe en vista previa de investigación (research preview) en Claude Managed Agents desde el 6 de mayo.
Las evaluaciones muestran primero una mejora en el criterio. En Pokémon Red, hacia los 10 000 pasos, Sonnet 3.7 había escrito 413 archivos de memoria en 225 carpetas para una sola medalla, mientras que Fable 5 se limitaba a nueve archivos y un global.md para cuatro medallas; Opus 5.5 completó el juego con una pequeña carpeta de notas. Anthropic aconseja decirle a Claude para qué sirve la memoria en lugar de cómo usarla: imponer que solo se registren los fallos hace perder a Opus 5 y Opus 4.7 una gran parte de la ganancia. Una nota errónea sobre la ubicación del Centro Pokémon de Mt. Moon, corregida mediante dreaming a partir de la transcripción, basta para desbloquear la partida.
| Experimento llevado a cabo por Anthropic | Resultado publicado |
|---|---|
| Solo wiki, corpus interno de Stainless (alrededor de 350 000 archivos), 2 y luego 128 sesiones de dreaming | 13 % y luego 48 % de los criterios evaluados |
| Búsqueda más wiki, mismo corpus | 54 % y luego 61 %, frente al 53 % de la búsqueda sola; alrededor de 20 000 tokens ahorrados por pregunta |
| Preguntas sobre una fusión de empresas (24, criterios multidocumento) | 87 % con el wiki, 73 % solo con la búsqueda |
| Hechos extraídos de contratos | 41 de 57 con una tabla compartida, 57 de 57 con una página por contrato citada textualmente |
La publicación también señala las limitaciones: ninguna mejora cuando basta un solo documento, una wiki a veces más grande que sus fuentes y un coste de cómputo para mantener la memoria al día. Por último, recuerda que la auto memory de Claude Code solo carga las primeras 200 líneas o 25 KB de MEMORY.md, que sirve como índice.
🔗 The components of agent memory (Anthropic)
Google mide cómo los comentarios TODO obsoletos desvían a sus agentes de código
6 de noviembre — En el blog Google Developers, Sam Saccone y Madhuri Garikapati miden un coste oculto de los agentes de código: los comentarios olvidados.
What is easy for humans to skim past in code, agents see as a call to action.
🇪🇸 Lo que los humanos pasan por alto fácilmente en el código, los agentes lo ven como una llamada a la acción. — Sam Saccone y Madhuri Garikapati, blog Google Developers
El equipo cruzó cada comentario TODO(bug/...) o FIXME(bug/...) encontrado por los agentes con el estado real del error y la solicitud del usuario, a partir de las trazas de miles de ingenieros y cientos de millones de pasos de agentes. En total, el 13 % de las sesiones de lectura de archivos exponen al agente a una referencia de este tipo. El agente la ignora en el 94 % de los casos, pero actúa sobre ella en el 6 %, y el 83 % de estas acciones no han sido solicitadas por el desarrollador: el 41 % de estos desvíos persiguen incidencias ya cerradas, y el 57 % amplían el trabajo a un error aún abierto. A igualdad de desarrollador, complejidad del código, tipo de tarea y nivel del modelo, un desvío no solicitado añade un 70 % de pasos, un 77 % de tokens y un 105 % de tiempo de espera por sesión.
Google respondió con agentes de limpieza que recorren sus bases de código, rastrean el historial del error, del archivo y de los cambios, y solo proponen la eliminación de un TODO una vez confirmada su obsolescencia: miles de referencias eliminadas en seis meses, con más del 95 % de aceptación por parte de los revisores humanos. La publicación aboga por bases de código adaptadas a los agentes (agent friendly codebases).
El proyecto harness-hub entrena mediante RL un LoRA por arnés de agente, bajo la custodia de safeagents
6 de noviembre — En el blog de Hugging Face, Younes B., Lysandre y Nathan Habib (organización harness-hub) presentan adaptadores de arnés (harness adapters): un pequeño adaptador LoRA por modelo y por arnés de agente (pi, opencode, hermes), entrenado mediante aprendizaje por refuerzo en tareas verificables dentro del arnés, sin modificarlo; un único servidor sirve el modelo base y todos los adaptadores. En pruebas preliminares, los autores observan menos llamadas a herramientas que el modelo base en las tareas reservadas, a exactitud igual o mejor. La recompensa añade una pequeña bonificación a las soluciones correctas que realizan menos llamadas.
Las tareas proceden de sesiones de código abiertas compartidas en el Hub, transformadas en entornos verificables mediante Repo2RLEnvs; la versión publicada cuenta con 270 tareas, muy desequilibrada: 253 de construcción (94 %), 11 de reparación, 6 de extensión y ninguna de preguntas y respuestas. El proxy safeagents inspecciona cada llamada a herramientas durante el entrenamiento: los intentos de hackeo de la recompensa se bloquean y puntúan con 0, y activar esta protección no altera el pass@1 reservado de LFM2.5-24B-A2B (+0,0 ± 4,1 puntos). Los entrenamientos finales se centran en LFM2.5-24B-A2B y LFM3-1.7B de Liquid AI, y en TwIL-8B de webAI, un modelo de razonamiento nunca entrenado con datos de agentes según su ficha; se ejecutan en HF Jobs y se transmiten en directo, coste incluido.
🔗 Harness adapters (blog de Hugging Face)
Agentes de código: Claude Code 2.1.319, Codex CLI 0.167.0, Copilot CLI 1.0.106, Antigravity CLI 1.5, chat de voz de Cursor y Spaces de Amp
Claude Code 2.1.319 pasa las tareas MCP a segundo plano y añade permissions.denyInsteadOfPrompting
6 de noviembre — Anthropic publica Claude Code 2.1.319: 146 entradas en las notas de la versión, de las cuales 90 son correcciones, frente a las 119 entradas de la 2.1.314 del 30 de octubre. El paquete está en npm desde las 00:58 UTC y el lanzamiento publicado en GitHub desde las 17:04 UTC, sin ningún tuit; el canal stable se mantiene en la 2.1.311. Los SDK de Agent le siguen el mismo día (TypeScript 0.3.319, Python 0.2.179).
| Elemento modificado | Qué cambia |
|---|---|
| Tareas MCP (MCP tasks) en la terminal | Cuando un servidor MCP ejecuta una llamada a una herramienta como una tarea, Claude Code la pasa a segundo plano y transmite el resultado al finalizar |
permissions.denyInsteadOfPrompting | Una llamada que esperaría una solicitud de permiso se rechaza y el turno continúa, incluidos subagentes y compañeros de equipo |
| Modo automático detrás de una pasarela LLM | Telemetría o flags desactivados: las llamadas que el servidor no puede verificar se envían al usuario o se rechazan, sin recurrir al clasificador integrado |
/claude-api latency-optimize | Busca dónde hace esperar el código que llama a la API de Claude y prueba ajustes más rápidos frente a la evaluación del usuario |
/tasks | Línea «Earlier in this session» para reabrir un subagente finalizado y escribirle |
Anunciadas el 23 de octubre sin número de versión, las tareas MCP no aparecen en el CHANGELOG hasta esta versión; también funcionan sin flags de funciones, por lo que sirven en Bedrock, Vertex, Foundry o detrás de una pasarela. Las notas corrigen varias vulnerabilidades: una elusión de los permisos de Bash mediante un prefijo de entorno manipulado, un escape del sandbox al crear un worktree, un comando sed que omitía el control de permisos en modo accept-edits o auto, y /rewind, que podía modificar un archivo a través de un enlace simbólico de carpeta. La pasarela de aplicaciones de Claude recibe advertencias en previsión del cambio en Claude Desktop del 10 de noviembre, que las notas no detallan. El mismo día, @ClaudeDevs anuncia que las sesiones en la nube preparan por sí solas el entorno de un repositorio (ver los Breves).
🔗 Notas de la versión de Claude Code 2.1.319
Codex CLI 0.167.0 señala los resultados no leídos y cambia de backend desde el selector de sesiones
6 de noviembre — OpenAI publica Codex CLI 0.167.0 a la 01:40 UTC, primera versión estable desde la 0.166.0 del 29 de octubre, con 120 entradas en la lista de PR. El centro de control de los agentes se abre ahora con codex agents --no-daemon y marca, al igual que el selector de sesiones, los resultados que el usuario aún no ha consultado. Este selector también permite cambiar de un backend conectado a otro sin perder los borradores. Las imágenes locales adjuntas se muestran en vista previa durante la escritura en las terminales compatibles, la pantalla de inicio de sesión agrupa la clave de API y los proveedores en la nube bajo «Sign in another way», y la opción gcp_setup_wizard configura Google Cloud Vertex AI con las Application Default Credentials o un archivo de credenciales. La configuración de proxy del sistema en macOS y Windows ahora se puede activar desde /experimental.
Las correcciones se centran en la continuidad del trabajo: las conversaciones guardadas siguen siendo visibles tras un cambio de proveedor de modelo, Ctrl+L limpia la pantalla sin perder los mensajes, accesibles mediante Ctrl+T, y la compactación automática tiene en cuenta las salidas conservadas de las respuestas fallidas. La documentación del app-server describe reglas prompt-user que exigen una nueva aprobación humana. Como complemento, openai-node 7.53.0 transmite los errores de sesión de los agentes en forma de eventos de flujo.
🔗 Notas de la versión de Codex CLI 0.167.0
Copilot CLI 1.0.106 pasa a estable con 227 entradas inéditas, seguida de una 1.0.107 con notas idénticas
6 de noviembre — Copilot CLI publica su primera versión estable desde la 1.0.105 del 28 de octubre. La 1.0.106 aparece a la 01:47 UTC con notas que acumulan todo el ciclo de versiones preliminares: 637 entradas, de las cuales 227 estaban ausentes en las notas de las once versiones preliminares publicadas en GitHub. A las 20:37 UTC se lanza una 1.0.107 con exactamente las mismas notas, salvo por la fecha del encabezado: no se describe en ella ninguna modificación propia, y es la que npm instala ahora por defecto.
Entre las entradas inéditas figuran la variable COPILOT_SESSION_CWD para lanzar y desarrollar configuraciones LSP y MCP locales, GPT-6.1 Terra seleccionable en el apartado New models cuando la cuenta tiene acceso a él, un ajuste Sandbox extensions que ejecuta los procesos de extensiones dentro del sandbox, y una telemetría MATS para el inicio de sesión de Microsoft Entra a través de OneAuth, que respeta el rechazo de telemetría del lado del cliente. /exit cierra la sesión actual en lugar de la CLI cuando la barra lateral Sessions está abierta, las reglas de denegación del sandbox admiten patrones glob, y las denegaciones por riesgo de ciberseguridad explican que la sesión permanece intacta sugiriendo /rewind. El SDK de Copilot también pasa a estable con la versión 1.0.29: 131 entradas, truncadas en el origen, incluido un cambio importante para Rust en SessionMetadata.
🔗 Copilot CLI 1.0.106 · Copilot CLI 1.0.107 · SDK de Copilot 1.0.29
Antigravity CLI 1.5 se convierte en un servidor ACP para editores y ejecuta sus conversaciones en agentes remotos
4 y 5 de noviembre — La CLI de Antigravity pasa a la versión 1.5 en dos fases. La 1.5.0 (10 mejoras, 3 correcciones) añade agy acp, que ejecuta la CLI como servidor Agent Client Protocol (ACP): un editor compatible puede usarla como agente, con imágenes y contexto de archivos en los prompts, posibilidad de reorientar un turno en curso, modos de sesión default, accept-edits y plan, reanudación de una sesión sin reproducir su historial, y un modelo así como un nivel de reflexión propios de cada sesión; agy acp --login permite conectarse desde una terminal para editores conectados por SSH. La misma versión añade --remote-agent, que ejecuta conversaciones en agentes remotos, el equivalente en línea de comandos de los que llegaron a la aplicación 2.29.0, así como proyectos locales en /projects y un modo sin interfaz (headless, -p) que espera a que finalicen las tareas en segundo plano en lugar de detenerlas tras un límite oculto de 30 minutos. Una corrección revela que los subagentes de una conexión mediante GEMINI_API_KEY se ejecutaban en modelos dos generaciones más antiguos en lugar de Gemini 4 Argon y Gemini 3.8 Flash.
La 1.5.1 (5 mejoras, 7 correcciones) abre a todos los clientes ACP el conjunto de modelos de la cuenta, mientras que antes solo a una lista fija de editores se le ofrecían modelos distintos de Gemini, y reduce el tiempo de finalización de un comando de la terminal de 5 segundos a aproximadamente 1 segundo cuando un proceso en segundo plano mantiene abierta la salida. El despliegue es gradual y puede tardar unos días.
Cursor abre el chat de voz en tiempo real con sus agentes, sobre Grok Voice
6 de noviembre — Cursor permite ahora hablar con sus agentes mediante una llamada de voz en tiempo real: describir un cambio en voz alta, preguntar a un agente qué está haciendo, escuchar las actualizaciones a medida que avanza el trabajo. El chat de voz funciona en la Agents Window, el IDE, la versión web y la aplicación para iOS. La llamada hace trabajar a dos agentes: un agente de voz escucha, responde y delega el trabajo de código en el agente del chat; también responde, en modo de solo lectura, sobre los diffs y las ejecuciones, busca en los mensajes y llamadas anteriores y cambia de worker en un Project. El agente de código se expresa por sí mismo mediante breves notas de progreso y una respuesta concisa al final.
La voz se basa en Grok Voice (Cursor forma parte de SpaceX desde agosto), mientras que el agente de código mantiene el modelo elegido; se ofrecen varias voces, entre ellas Ara, Eve, Leo, Rex y Sal. Con el Privacy Mode, el chat de voz funciona sin retención de datos, y en iOS un comando de Siri inicia una llamada con un nuevo agente. Se requiere una cuenta conectada (una sesión iniciada con clave de API no puede llamar), la llamada se corta tras unos 10 minutos de silencio cuando el agente no tiene nada en curso y existe un límite diario, sin cifras publicadas. No se menciona ninguna tarifa; el dictado, llamado anteriormente Voice Mode, sigue siendo independiente.
🔗 Voice Chat with Agents (changelog de Cursor) · Documentación del chat de voz
Amp lanza Spaces, un agente que crea y coordina hilos en lugar del usuario
6 de noviembre — Amp lanza Spaces: un space es una conversación con un único agente, cuya función es iniciar y coordinar a otros agentes. El usuario ya no tiene que crear ni organizar sus hilos (threads): el agente del space se encarga de ello. Amp lo presenta como una forma de más alto nivel de trabajar con múltiples agentes; tras unas semanas de uso interno, el equipo cree que este podría ser el futuro de la interacción con agentes, combinando una visión global con la capacidad de profundizar en los detalles.
La publicación ofrece tres ejemplos internos. Spaces se construyó dentro de un space «Spaces v1», donde el agente distribuía en hilos los comentarios, errores e ideas compartidos en el chat. Lewis gestionó desde un space el lanzamiento de los Service Accounts: despliegue, monitorización de X, Slack e informes de errores, correcciones, y posteriores correos electrónicos y reembolsos a los usuarios afectados. Will confió a un space una revisión periódica de seguridad: la primera pasada dividió la base de código en 16 áreas, revisadas cada una en su propio hilo, y cada hallazgo se verificó en otro hilo con un artifact de síntesis. Se inicia mediante el botón + de la sección Spaces de la barra lateral; la publicación no menciona tarifas ni planes. El mismo día, Amp añadió un widget que transforma los comentarios dejados en un sitio web en un hilo de agente (ver Breves).
Fabricar los modelos: Meta entrena modelos especializados con Muse Wonder, Hugging Face publica una guía de entrenamiento de MoE
Meta despliega en Muse y Meta AI modelos especializados entrenados con Muse Wonder
6 de noviembre — Meta incorpora a Muse y Meta AI las ventajas de Muse Wonder, su modelo de frontera lanzado el 12 de octubre: se despliegan versiones especializadas de sus modelos existentes, entrenadas con Muse Wonder; la publicación no las nombra ni especifica tamaños o pesos. Se trasladan dos capacidades de Muse Wonder: la memoria activa (Active Memory), diseñada para reconocer cuándo una información antigua vuelve a ser útil y distinguir lo que sigue siendo válido de lo obsoleto, y la concentración activa (Active Focus), orientada a recuperarse ante un obstáculo o encontrar alternativas. En Meta AI, Meta describe un asistente que divide los problemas en pasos y formula preguntas de seguimiento más precisas, sin cifras asociadas.
| Métrica interna de Meta | Modelo actual de Muse | Modelo anterior |
|---|---|---|
| Personal Superintelligence Index | 47 % | 38 % |
| Active Memory Eval (contexto crítico bien utilizado) | 90 % de las tareas | 76 % |
| Olvido de información crítica en Muse | dividido por 2,4 | — |
| Tareas diarias en las que surge un imprevisto | +67 % | — |
Todas estas métricas proceden de Meta, sin que se haya publicado el protocolo en la publicación.
🔗 Artículo de investigación de Meta sobre los modelos especializados de Muse y Meta AI
Hugging Face publica The Ultimate MoE Training Handbook, respaldado por 800 000 horas de GPU en experimentos
5 de noviembre — Hugging Face publica The Ultimate MoE Training Handbook, una guía gratuita y abierta dedicada al entrenamiento de modelos de mezcla de expertos (Mixture-of-Experts, MoE), elaborada por Nouamane Tazi, Leandro von Werra y Thomas Wolf. Su punto de partida: según el índice de Artificial Analysis, 18 de los 20 mejores modelos con pesos abiertos son MoE, entre ellos DeepSeek V4.1 Flash 1017, GLM-5.3 y MiniMax-M3.1-Flash, a pesar de que la experiencia técnica para entrenarlos sigue concentrada en unos pocos equipos.
18 of the 20 best open models today are Mixture-of-Experts. Dense is basically over. And yet the know-how to train a good MoE still lives mostly in the heads of a handful of teams. So we spent 800k GPU hours running the experiments ourselves and wrote everything down.
🇪🇸 18 de los 20 mejores modelos abiertos actuales son Mixture-of-Experts. Lo denso está prácticamente acabado. Y, sin embargo, el conocimiento práctico para entrenar un buen MoE sigue principalmente en la cabeza de un puñado de equipos. Así que dedicamos 800 000 horas de GPU a realizar los experimentos nosotros mismos, y lo pusimos todo por escrito. — @Thom_Wolf en X
Los experimentos se ejecutaron en nodos AWS P5 con ocho H100; Jeff Boudier, en un tuit republicado por Hugging Face, menciona un gasto de 2 millones de dólares. La guía cuenta con unas 70 000 palabras, 55 figuras interactivas y código ejecutable, con un tiempo de lectura estimado de uno a dos días. Aborda las dudas prácticas de los equipos: cuántos expertos, de qué tamaño, si deben ser compartidos o no; qué enrutador elegir y por qué mantenerlo en FP32; pérdida auxiliar o sesgo sin pérdida al estilo de DeepSeek para equilibrar la carga; si partir de un modelo denso (upcycling) o desde cero; y por qué un entrenamiento se vuelve 25 veces más lento sin mostrar errores en los registros. Una última sección aborda la puesta en producción: expertos en baja precisión, paralelismo de expertos y desagregación atención-FFN.
🔗 The Ultimate MoE Training Handbook (Hugging Face)
La Agent API de Perplexity reduce el coste de todos sus niveles de esfuerzo, con una calidad igual o superior según Perplexity
5 de noviembre — Perplexity reduce el coste por solicitud de todos los niveles de esfuerzo (effort levels) existentes de su Agent API, manteniendo una calidad de búsqueda igual o superior según la compañía; la publicación detalla también ultra, el nivel habilitado ese mismo día para las búsquedas más amplias. Un nivel de esfuerzo es una configuración lista para usar que establece el modelo, el presupuesto de pasos, los ajustes de búsqueda y las herramientas para un tipo de tarea determinado. Una solicitud que llame a un nivel por su nombre se beneficia de la actualización sin necesidad de cambiar código; fijar una versión conserva la configuración anterior. Las puntuaciones corresponden a BrowseComp y DSQA, dos bancos de pruebas públicos, y a WANDR, el benchmark propio de Perplexity para búsquedas extensas sobre múltiples entidades.
| Nivel de esfuerzo | Resultado publicado | Coste publicado |
|---|---|---|
| medium | del 55 % al 77 % en BrowseComp y DSQA | casi un 90 % menos |
| high, con extracción de fetch_url | 88,0 % frente al 83,5 % sin extracción | 0,073 dólares por solicitud frente a 0,094 |
| xhigh | 76,5 % en WANDR, mantenido | cerca del 25 % del coste de la configuración de agosto |
| ultra | 85,9 % en WANDR, mejor puntuación probada | 21,71 dólares por tarea |
El nivel ultra ejecuta tres agentes en paralelo para toda la tarea y un cuarto fusiona sus hallazgos y redacta la respuesta. La publicación detalla los mecanismos: un límite de pasos y llamadas a herramientas con recordatorios de presupuesto (en una tarea de BrowseComp, el agente avisado encuentra la respuesta en 13 pasos de 40, mientras que el otro agota los 40 sin hallarla), un modelo más pequeño que solo conserva los fragmentos útiles de una página (de 5561 tokens reducidos a 293), skills cargadas bajo demanda, ya que precargarlo todo cuesta un 13 % más, y un bucle de evaluación que solo adopta un nuevo modelo si rinde mejor a un coste igual o menor. No se publica ninguna tabla de precios por nivel.
🔗 Improvements to every Agent API effort level (Perplexity) · Hilo de @perplexitydevs
Perplexity Computer resume sus conversaciones largas en segundo plano y abre Brain a todos los Projects
6 de noviembre — Perplexity publica su primer changelog de producto desde el 19 de octubre, dividido en dieciséis apartados; la mayoría retoman novedades ya anunciadas, como Teammates, Computer completamente local en Mac o el modo de voz, y siete son inéditas. En Computer, las nuevas conversaciones largas resumen su historial en segundo plano (background compaction): según Perplexity, esto supone un 94 % menos de pausas para seguir trabajando en contextos extensos y un 7 % menos de créditos por turno. Para editar un sitio creado por Computer, ahora se selecciona un elemento específico (título, botón, tarjeta, menú) en lugar de trazar un rectángulo.
En cuanto a Projects, Brain, la memoria del Project, se activa de forma gratuita en cada Project y se actualiza diariamente a partir de sus conversaciones y archivos; un panel Project info y un panel Settings unificado quedan disponibles para todos. En Enterprise, las @menciones permiten incorporar a un compañero a un hilo o tarea de Computer en la web, y los controles por rol añaden un límite de velocidad (Normal o Fast) a los ajustes de esfuerzo ya disponibles. La skill Impeccable, que audita la jerarquía, la accesibilidad, el diseño adaptativo (responsive) y la coherencia del sistema de diseño de una interfaz, se incorpora a la lista oficial. Por último, el changelog precisa que los Agent Plugins están disponibles para planes individuales y para Enterprise en autoservicio, y que Computer se ejecuta completamente en local a partir de la app para Mac 26.42.0. La reducción de costes de los niveles de esfuerzo, que también recoge, se detalla en la sección anterior.
🔗 Changelog de Perplexity del 6 de noviembre
Voz: Phonon de Gradium funciona en el dispositivo, ElevenLabs hace hablar a los personajes de Unity
Gradium detalla Phonon, su síntesis de voz integrada con pesos abiertos
5 de noviembre — En una entrada del blog de Hugging Face, Gradium analiza Phonon, publicado en abierto dos semanas antes: un modelo de síntesis de voz que se ejecuta íntegramente en el dispositivo, sin servidor ni conexión a la red, desde teléfonos hasta pestañas del navegador o placas monoplaca. Phonon está disponible en dos tamaños, de unos 65 y 75 MB, y procesa números de teléfono, fechas y códigos. Incluye más de 100 voces integradas, y se pueden crear otras en Gradium Studio mediante la clonación de una grabación breve con el consentimiento de la persona o mediante descripciones de texto, antes de descargarlas para ejecutarlas de forma local.
| Modelo Phonon | Idiomas compatibles | Licencia de uso |
|---|---|---|
| Phonon 31m | inglés | Apache 2.0, uso comercial libre |
| Phonon 40m | inglés, francés, alemán, español, portugués | CC BY-NC, uso comercial de pago según el número de usuarios |
Según Gradium, Phonon ocupa el primer lugar en inteligibilidad en alemán y español en el Open TTS Leaderboard de Hugging Face y figura entre los tres primeros en cada idioma evaluado, frente a modelos hasta 100 veces más grandes; también lidera el benchmark de streaming en procesador en latencia previa al primer sonido. Gradium afirma haber superado las 200 000 descargas en dos semanas. Su motor de inferencia ptts cuenta con más de diez backends (procesadores, GPU mediante CUDA, Vulkan, Metal o WebGPU, chips Core ML y Snapdragon), y Transformers lo integra desde la v5.21.
🔗 Phonon (blog de Hugging Face)
ElevenLabs lanza un SDK para Unity para dar voz a los personajes de videojuegos con ElevenAgents
5 de noviembre — ElevenLabs publica un SDK de Unity para ElevenAgents, su plataforma de agentes de voz. Conecta una escena del juego con un agente creado en el panel de control de ElevenLabs: el jugador se acerca a un personaje y le habla en voz alta, el SDK captura el micrófono, reproduce la voz del agente a través de un AudioSource de Unity y gestiona la sesión mediante la Conversation API. La voz puede originarse en el personaje y su nivel de audio animar la boca; variables dinámicas permiten que varios personajes compartan un mismo agente con distintos estados de ánimo; una actualización contextual notifica al agente un evento del juego, como recoger una llave, sin interrumpirlo; y herramientas del cliente le permiten ejecutar código del juego, como abrir una puerta.
| Plataforma objetivo | Estado del SDK | Transporte utilizado |
|---|---|---|
| Editor y escritorio (macOS, Windows, Linux) | Compatible | WebSocket |
| WebGL | Compatible | WebSocket o WebRTC |
| iOS, Android, XR | Beta | WebSocket |
La instalación se realiza a través del Package Manager de Unity, desde el repositorio git de ElevenLabs fijado en la v0.1.0 (versión publicada en GitHub el 27 de octubre, licencia MIT), con un tiempo estimado de puesta en marcha de unos diez minutos para el ejemplo GettingStarted. ElevenLabs recuerda reactivar la autenticación antes de publicar: un servidor debe proporcionar una URL firmada de corta duración y la clave API nunca debe incluirse en una compilación. No se ha anunciado ninguna tarifa específica.
🔗 Give your Unity NPCs a voice with ElevenAgents (ElevenLabs) · Repositorio elevenlabs/unity
Ai2 presenta oficialmente ToyBlocks, el primero de sus FoundationWorlds para estudiar el aprendizaje de robots
6 de noviembre — Ai2 presenta oficialmente ToyBlocks, cuyo código y datos estaban disponibles en línea desde el día anterior. El instituto lo enmarca en una iniciativa más amplia, los mundos de base (FoundationWorlds): un entorno simulado y controlado, la generación automática de tareas y demostraciones, y métricas que monitorizan el comportamiento del robot a lo largo del tiempo, con el fin de variar datos o modelos, repetir pruebas e identificar el origen de los fallos. Las demostraciones se generan sin teleoperación, hasta 24 veces más rápido que en tiempo real en una sola GPU. Los primeros resultados se centran en la transferencia al mundo real y en los agentes de frontera:
| Evaluación publicada por Ai2 | Resultado obtenido |
|---|---|
| Habilidades atómicas de ManiFlow, en simulación y en robot real | 80,0 % y 81,1 % |
| Molmo 2 + ManiFlow, en simulación y en robot real | 55,5 % (111 de 200) y 50,0 % (15 de 30) |
| Claude Opus 5.5 mediante MCP, tareas de buscar y deletrear (search and spell) | 63 % resueltas o declaradas inviables con razón |
| Descripciones de habilidades por defecto, de experto humano, aprendidas | 24 %, 36 % y 63 % de éxito |
| Claude Opus 5.5 en planificación clásica | 30 tareas de apilamiento de 30 |
En las tareas de buscar y deletrear, la mitad de los escenarios son inviables, y los errores se deben sobre todo a letras similares (13 %) o a una orientación incorrecta (15 %). Ai2 señala que son necesarias más pruebas en robots reales para alcanzar significación estadística. Una interfaz web permite dar instrucciones al robot en lenguaje natural con Claude u otro modelo de frontera, y el repositorio complementario allenai/agentic_robotics publica el bucle agéntico orquestado mediante MCP, bajo licencia Apache-2.0.
🔗 ToyBlocks (blog de Ai2 en Hugging Face) · Repositorio allenai/agentic_robotics
GitHub presenta Copilot Verified Proficiency, un nivel de competencia calculado a partir del uso real de Copilot
6 de noviembre — GitHub destaca Copilot Verified Proficiency, una nueva forma de acreditación de competencias (credential) conjunta de Microsoft y GitHub, vinculada a la Microsoft Pro Badge. En lugar de un examen, el nivel se calcula de forma continua a partir de las tareas realmente realizadas con Copilot según la telemetría, en función del alcance, la profundidad y la constancia de los usos, y no del volumen de actividad. Se evalúan cinco competencias: colaboración con IA, redacción de prompts, generación y validación de código, configuración de agentes e integración de herramientas y contexto. Hay tres niveles disponibles (Beginner, Intermediate, Proficient), mientras que Advanced y Expert están en desarrollo; Proficient otorga una Pro Badge compartible, que caduca al cabo de seis meses si no se mantiene el nivel, y el nivel disminuye si no se utiliza Copilot.
La participación es voluntaria, los resultados son privados por defecto y ni el empleador ni la organización pueden verlos sin que se compartan de manera explícita; los baremos y algoritmos siguen siendo propietarios. Las cuentas Enterprise Managed Users y GitHub Enterprise Cloud con residencia de datos no son compatibles. El estado sigue siendo confuso: la página, sin fecha, propone calcular el nivel de cada uno, pero sus preguntas frecuentes hablan de una versión preliminar privada con socios invitados.
🔗 Copilot Verified Proficiency (GitHub Learn) · Anuncio de @github en X
NVIDIA cuantifica el auge de sus herramientas de código abierto 5G/6G Aerial y Sionna, con cinco proyectos de investigación
6 de noviembre — Un año después de liberar el código de su software inalámbrico Aerial, que se sumó a Sionna en una suite de herramientas para la investigación en 6G, NVIDIA hace balance en una publicación firmada por Soma Velayutham. Según NVIDIA, la adopción de AI Aerial y Sionna por parte de los desarrolladores se multiplicó por diez en un año, sus herramientas 5G/6G de código abierto superaron el millón de descargas y más de 8 000 instituciones de investigación y universidades las utilizan. La publicación no anuncia ningún producto e ilustra estos usos mediante cinco proyectos:
| Equipo de investigación | Resultado reportado | Condiciones de medición |
|---|---|---|
| King’s College London | Tiempo de ejecución de tareas robóticas reducido hasta en un 52,6 % | Descripción compacta de objetos en lugar de imágenes completas, fallos provocados deliberadamente |
| SoftBank | Mayor rendimiento de subida en las 15 configuraciones probadas, ganancia máxima de aproximadamente el 60 % | Receptor neuronal en Aerial CUDA-Accelerated RAN, smartphone 5G comercial, interferencias controladas |
| ETH Zurich | Tasa de error de bloque reducida en más de un tercio | Receptores ajustados con mediciones locales, frente a versiones preentrenadas seleccionadas |
| Universidad de Leeds | Consumo de la red de acceso radio reducido en un 45,6 % | Puesta en reposo de las estaciones base prevista con 10 minutos de antelación, frente a una referencia a plena potencia |
| CTTC (Cataluña) | Simulación reducida de unas 3 horas a entre 10 y 20 minutos | Primera evaluación, modelos de canal en GPU dentro del simulador de código abierto 5G-LENA |
La publicación remite a las sesiones para desarrolladores de 6G en GTC Washington, D.C., y recuerda que Aerial y Sionna están disponibles en GitHub.
🔗 How NVIDIA Open Source Tools Are Helping Researchers Build Next-Generation 6G Networks (NVIDIA)
Breves
Agentes y herramientas de código
- Sesiones en la nube de Claude Code — En los planes Pro, Max y Ultra, Claude determina por sí mismo las dependencias, el acceso a la red y las claves de API que necesita un repositorio, y luego guarda este entorno para las sesiones siguientes; según @ClaudeDevs, las claves se almacenan sin que Claude las vea. El anuncio se limita a un tuit, sin publicación en el blog ni documentación. 🔗 fuente
- Widget de comentarios de Amp — Una etiqueta de script y la dirección de una página con el sufijo
?amppermiten hacer clic en un elemento de un sitio web y escribir una instrucción: Amp abre un hilo en el proyecto y el agente realiza el cambio en una orb, sobre una copia del repositorio. Reservado para proyectos de espacio de trabajo, sin tarifas indicadas. 🔗 fuente - Gemini CLI — No se publicó ninguna nightly el 5 y 6 de noviembre porque el flujo de trabajo falló, pero Gemini CLI fusionó en main una docena de commits el día 6: temas de color en un archivo
theme.jsonindependiente, validación de nombres de modelos en/model, y fin de las esperas de cuota de varias horas en modo ACP y de los bloqueos de red silenciosos. Todavía no hay nada disponible en una versión formal. 🔗 fuente - Qwen Code v0.26.9 — Las skills se instalan desde archivos ZIP (Web Shell, demonio o SDK de TypeScript) y una única petición activa o desactiva hasta 100 skills; la automatización de Managed Agent está activada por defecto y la entrada de imágenes se extiende a Llama 4, Pixtral y Mistral Small. Sin cambios disruptivos. 🔗 fuente
- Kimi Code 2.5.2 — Tres correcciones: declaraciones de herramientas duplicadas cuando cambian las definiciones de herramientas MCP, mensajes de orientación puestos en cola por error durante una sesión y creación de proyectos cuando la interfaz web se sirve mediante HTTP. 🔗 fuente
- ZCode v3.17.2 — El 4 de noviembre, sin notas de la versión, el espacio de trabajo de código de Z.ai hace que la vista previa de archivos HTML locales en su navegador integrado pase a través de una dirección
zcode-html://limitada a su carpeta: Electron permite por defecto que una páginafile://lea otros archivos. 🔗 fuente - Flota de agentes de código — Tony Dzi hace balance de 103 días de agentes de código de una misma familia en siete máquinas: un protocolo de coordinación puede cumplir todos sus invariantes de seguridad y, aun así, ser abandonado. Publica claw-consensus, su motor de consenso sin LLM, y la telemetría que muestra el desplome de su uso. 🔗 fuente
API, plataformas y seguridad
- Llamadas salientes de GPT-Live — El 2 de noviembre, OpenAI abrió a todas las organizaciones las llamadas telefónicas salientes de GPT-Live mediante SIP, a través de la Live API: número en formato E.164, trunk del operador, señalización TLS y audio SRTP, tono de llamada limitado a 3 minutos y llamada a 2 horas; sin tarifas especificadas. 🔗 fuente
- API Agents de OpenAI — Michael Luo, responsable de producto en OpenAI, hace balance de octubre, ya cubierto en su mayor parte, y ofrece bajo solicitud cinco funciones en beta: memoria entre sesiones, acceso de los agentes a la API Decisions, límite presupuestario en dólares, grupo de entornos y arquitectura v2. 🔗 fuente
- gemini-embedding-2-preview — La API de Gemini deja obsoleto este modelo: desde el 6 de noviembre, sus solicitudes se enrutan a
gemini-embedding-2con la tarifa de Gemini Embedding 2, con el mismo esquema y el mismo espacio de embeddings; basta con cambiar el nombre del modelo, sin necesidad de reindexar. 🔗 fuente - Métricas de uso de Copilot — La API ahora realiza el seguimiento, por repositorio, de la tasa de comentarios de Copilot code review atendidos por los desarrolladores, desglosada por gravedad, nivel de revisión y tipo de comentario, y señala a los usuarios sin telemetría o con versiones de IDE y extensión inferiores a las mínimas requeridas. 🔗 fuente
- OpenAI y Hacktron — OpenAI se asocia con Hacktron, identificada a través de su programa de recompensas por fallos (bug bounty), para buscar vulnerabilidades en sus propios sistemas, especialmente en sus interacciones con servicios de terceros, y amplía su acceso a modelos de vanguardia a través de Daybreak Red; sin cuantía económica revelada. 🔗 fuente
- Transformers v5.22.2 — Parche provisional de Hugging Face que refuerza el sandbox de Jinja y ya solo fija el
device_idpara NCCL; las notas no citan ningún aviso de seguridad. 🔗 fuente
Empresas y educación
- Universidades australianas — El 5 de noviembre, OpenAI detalló sus colaboraciones con la UNSW Sydney (ChatGPT Edu para más de 80 000 estudiantes y personal), la Universidad de Sídney, La Trobe y la Universidad de Adelaida; en una encuesta de Pureprofile encargada por OpenAI a 1 018 estudiantes, el 81 % utiliza la IA varias veces por semana. 🔗 fuente
- Cult.fit y Codex — El 5 de noviembre, un caso de estudio de OpenAI mostró cómo la cadena india de gimnasios estandariza su ingeniería en Codex: más de 20 aplicaciones internas creadas por equipos no técnicos, más de 100 000 dólares de ahorro anual en software y una reducción superior al 50 % en los costes de atención al cliente. 🔗 fuente
- Merge y GPT-6 Astra — El 5 de noviembre, la startup Merge explicó que un bot con GPT-6 Astra, conectado a Salesforce, Gong, Google Sheets y Gmail, reduce la preparación de una cena con clientes de decenas de horas a unos 30 minutos; la empresa pasó de organizar 8 cenas en el segundo trimestre a 16 en el tercero. 🔗 fuente
- Franklin Templeton — El 5 de noviembre, la gestora de activos describió una capa de inteligencia conectada, desarrollada en particular con Codex, que vincula investigación, riesgo, cumplimiento y trading para sus gestores de carteras; sin cifras de resultados. 🔗 fuente
- Flipsnack y ChatGPT Ads — El 5 de noviembre, este testimonio de cliente anunció cerca de un 310 % más de registros y un coste por registro aproximadamente un 75 % menor, manteniendo el mismo presupuesto diario, tras migrar cinco campañas en Estados Unidos de clics a optimización de conversiones. 🔗 fuente
- Box y NVIDIA — El 5 de noviembre, en BoxWorks 2026, Box habilitó los modelos abiertos Nemotron, empezando por Nemotron 3 Ultra, para los clientes de Enterprise Advanced de Box AI; Box Context Retrieval, desarrollado sobre Nemotron Retriever, está previsto para principios del próximo año y podría, según Box, aumentar un 20 % la precisión de búsqueda y consumir un 90 % menos de tokens. 🔗 fuente
Aplicaciones de Google
- Tarjetas de estudio de Gemini Notebook — Las tarjetas ahora admiten imágenes, un cronómetro opcional permite poner a prueba la retención y la aplicación móvil programa recordatorios de estudio; no se especifican países ni planes. 🔗 fuente
- Gemini en Google Forms — En la pestaña Respuestas, Gemini analiza las respuestas escribiendo y ejecutando código Python, detecta tendencias y correlaciones, y luego sugiere acciones; el despliegue comenzó el 2 de noviembre en Rapid Release y empezará el 19 de noviembre en Scheduled Release para planes Business, Enterprise y Education elegibles, así como para suscriptores de Google AI. 🔗 fuente
Voz, música e imagen
- Open ASR Leaderboard — La clasificación de reconocimiento de voz de Hugging Face añade dos conjuntos de prueba privados de Liva AI, en inglés conversacional con acento egipcio (1,34 horas) y nigeriano (1,55 horas), y un desglose inspirado en los círculos de Kachru; no se facilitan resultados de modelos. 🔗 fuente
- Dialecto libanés — En la segunda entrega de su serie, tras la del 5 de noviembre, Bilal Zaraket elabora un léxico libanés validado por tres hablantes nativos (429 entradas) antes de generar datos de voz: la proporción de frases que requieren corrección baja del 22 % al 4 %, por debajo del umbral del 5 % fijado previamente. 🔗 fuente
- ElevenMusic y SoundCloud — ElevenLabs vincula su plataforma musical con SoundCloud: una pista original se envía directamente al perfil del artista, con descripción, género y etiquetas. Los miembros de SoundCloud Artist Pro obtienen tres meses gratis de ElevenMusic y después 9,99 dólares al mes, oferta válida hasta el 31 de octubre de 2027. 🔗 fuente
- Ads Engine — ElevenLabs añade una revisión humana opcional, a cargo de lingüistas y profesionales de la localización de ElevenProductions, así como de especialistas creativos internos, para recursos visuales, anuncios de Google Search y vídeos doblados; acceso a través del equipo comercial, sin tarifas ni plazos especificados. 🔗 fuente
- Daily Song Challenge de Suno — Las aplicaciones para iOS y Android ofrecen a diario una consigna de canción, modificable antes de la creación, y organizan las canciones en un calendario de la biblioteca, en todos los planes. 🔗 fuente
- Runway y GPT Image 2.6 — Runway añade el modelo de imagen de OpenAI, presentado como un 50 % más rápido, con soporte para GIF, exportación en SVG y retoques que mantienen la coherencia de personajes y productos; no se especifican la variante ni el coste en créditos. 🔗 fuente
Investigación, robótica y modelos
- Modelos científicos — El blog Science de Anthropic publica un ensayo invitado de Jakob Macke, Daniel Gedon y Stefan Wahl (ELLIS Institute Tübingen) sobre la IA que construye, restringe e interpreta modelos científicos, desde el modelo de Hodgkin y Huxley hasta la inferencia basada en simulación. 🔗 fuente
- Clasificación SuperCLUE — Una publicación comunitaria de VIDRAFT recoge la clasificación de noviembre (19 modelos): GPT-6.1-Sol lidera en código agéntico (69,23) y DeepSeek-V4.1-Flash-1017 se sitúa en primer lugar entre los modelos abiertos (65,38), logrando Kimi-K3.1-Pro la mejor puntuación global de este grupo. 🔗 fuente
- LingYu Robotics — La empresa publica 139,4 horas y 13 263 episodios exitosos de teleoperación bimanual grabada desde el punto de vista del robot, repartidos en 15 familias de tareas, en formato LeRobot y bajo licencia no comercial. 🔗 fuente
- Egocentric-EMG-Force — Harpreet Sahota convierte para FiftyOne ocho episodios y 38,2 minutos de tareas domésticas grabadas con una cámara de profundidad, con una pulsera EMG en cada muñeca que registra la señal muscular de los antebrazos. 🔗 fuente
- Teaser de Qwen — La cuenta oficial de Qwen publica un breve y enigmático mensaje, con una imagen cuya inscripción en chino deja un nombre en blanco, sin nombre de modelo, fecha ni enlace; ha acumulado más de 1,3 millones de visualizaciones a lo largo del día. 🔗 fuente
Qué significa esto
La IA entra en la investigación estructurada y medida. Los agentes de Google DeepMind trabajaron bajo supervisión humana, junto con investigadores del Inria, en un RSA de 1024 bits ya retirado y una clave de referencia ya resuelta, en una simulación aislada: la ganancia teórica de unas 1 600 veces no amenaza a las claves de 2048 bits, pero recuerda que una hipótesis de dificultad nunca puede darse por sentada. BioBasicsBench y TCSExam siguen la misma disciplina: la propia OpenAI publica los errores de GPT-6 Astra, entre ellos un recuento de colonias sobreestimado en torno al 12 %, y TCSExam hace que el núcleo de Lean o un verificador ejecutable compruebe cada tarea, sin que caiga ninguna conjetura abierta. El Frontier Model Forum aplica la misma lógica al riesgo, con una matriz común para decidir qué ciber-jailbreaks corregir primero.
El entorno del modelo determina cada vez más el éxito de un agente. En Anthropic, una sola nota falsa sobre Mt. Moon bloquea la partida de Pokémon hasta que el dreaming la corrige, y una wiki bien mantenida permite ahorrar unos 20 000 tokens por pregunta. En Google, un viejo TODO basta para hacer descarrilar a un agente: un desvío no solicitado sobrecarga la sesión con un 70 % más de pasos, un 77 % más de tokens y un 105 % más de tiempo de espera, hasta el punto de que Google ha puesto en marcha agentes para limpiar sus bases de código. Los harness adapters abordan el problema desde el entrenamiento, con un LoRA por arnés que reduce las llamadas a herramientas a igual nivel de precisión, y los mecanismos de Perplexity son de la misma índole: recordatorios de presupuesto, extracción de páginas, skills cargadas bajo demanda.
Los agentes de código cambian de interfaz. Se habla con ellos gracias al chat de voz de Cursor, que separa el agente que escucha del que programa; se les delega la organización, con un space de Amp que lanza él mismo los hilos, hasta dividir una revisión de seguridad en 16 zonas; se conectan en todas partes, ya que ACP convierte a Antigravity CLI en el agente de cualquier editor compatible, con todos los modelos de la cuenta. Los ciclos de lanzamiento se aceleran en paralelo (146 entradas para Claude Code 2.1.319, 637 para Copilot CLI 1.0.106, 120 PR para Codex CLI 0.167.0), con controles más minuciosos sobre lo que el agente tiene permitido hacer, desde el rechazo sin confirmación en Claude Code hasta las reglas prompt-user de Codex.
El coste y el acceso también se mueven. Perplexity reduce el coste de su nivel medium en casi un 90 % mientras hace que pase del 55 % al 77 %, y activa gratis Brain en cada Project. Phonon ejecuta síntesis de voz en el dispositivo, sin servidor, con modelos de unos 65 y 75 MB, incluida una versión en inglés con licencia Apache 2.0. Meta traslada capacidades de Muse Wonder a modelos especializados desplegados para los usuarios de Muse y Meta AI, y Hugging Face ofrece en acceso libre conocimientos sobre el entrenamiento de MoE adquiridos a costa de 800 000 horas-GPU.
Fuentes
- Artículo de Pushmeet Kohli sobre criptoanálisis (X)
- @GoogleDeepMind: los sistemas de 2048 bits siguen siendo seguros
- Artículo técnico sobre firmas digitales (Google DeepMind, PDF)
- Artículo técnico sobre la factorización de claves (Google DeepMind, PDF)
- Introducing the FMF Jailbreak Rating Framework for Frontier Cyber Threats (Frontier Model Forum)
- Measuring how AI agents handle everyday wet-lab science (OpenAI)
- Resultados de TCSExam
- Artículo de arXiv 2611.07962 (TCSExam)
- The components of agent memory (Anthropic)
- Agent Distraction (blog de Google Developers)
- Harness adapters (blog de Hugging Face)
- Notas de la versión de Claude Code 2.1.319
- Notas de la versión de Codex CLI 0.167.0
- Copilot CLI 1.0.106
- Copilot CLI 1.0.107
- SDK de Copilot 1.0.29
- Registro de cambios de Antigravity
- Voice Chat with Agents (registro de cambios de Cursor)
- Documentación del chat de voz de Cursor
- Spaces (Amp)
- Publicación de investigación de Meta sobre los modelos especializados de Muse y Meta AI
- The Ultimate MoE Training Handbook (Hugging Face)
- @Thom_Wolf: 800 000 horas-GPU de experimentos
- Improvements to every Agent API effort level (Perplexity)
- @perplexitydevs: reducción del coste de los niveles de esfuerzo
- Registro de cambios de Perplexity del 6 de noviembre
- Phonon (blog de Hugging Face)
- Give your Unity NPCs a voice with ElevenAgents (ElevenLabs)
- Repositorio elevenlabs/unity (GitHub)
- ToyBlocks (blog de Ai2 en Hugging Face)
- Repositorio allenai/agentic_robotics (GitHub)
- Copilot Verified Proficiency (GitHub Learn)
- @github: Copilot Verified Proficiency
- How NVIDIA Open Source Tools Are Helping Researchers Build Next-Generation 6G Networks (NVIDIA)
- @ClaudeDevs: sesiones en la nube de Claude Code
- Close the Loop (Amp)
- Gemini CLI, PR 30119: temas en theme.json
- Qwen Code v0.26.9
- Kimi Code 2.5.2
- ZCode v3.17.2
- Publicación de Tony Dzi sobre 103 días de agentes de código y claw-consensus (blog de Hugging Face)
- Registro de cambios de la API de OpenAI
- @AzianMike: balance de octubre de la API Agents
- Notas de la versión de la API de Gemini del 6 de noviembre
- Usage metrics API: detalles de code review (GitHub Changelog)
- Partnering with Hacktron to find vulnerabilities in OpenAI’s systems (OpenAI)
- Transformers v5.22.2
- Australian universities are creating AI-native graduates (OpenAI)
- Cult.fit builds operational muscle with Codex (OpenAI)
- Merge builds product and business tools with OpenAI technology (OpenAI)
- Franklin Templeton uses OpenAI to support investment research (OpenAI)
- Flipsnack grows product signups with conversion optimization (OpenAI)
- Comunicado de Box sobre su colaboración con NVIDIA (BoxWorks 2026)
- @Gemini_Notebook: novedades de Flashcards
- Análisis prácticos de Gemini en Google Forms (Google Workspace Updates)
- Open ASR Leaderboard y Liva AI (blog de Hugging Face)
- Léxico libanés de Bilal Zaraket, segunda parte (blog de Hugging Face)
- Share your ElevenMusic creations directly to SoundCloud (ElevenLabs)
- Ads Engine adds human review from localization experts and creative specialists (ElevenLabs)
- Daily Song Challenge (notas de la versión de Suno)
- @runwayml: GPT Image 2.6 en Runway
- Teaching AI to build scientific models (Anthropic)
- Clasificación SuperCLUE de noviembre (blog de Hugging Face)
- Conjunto de datos de LingYu Robotics (blog de Hugging Face)
- Egocentric-EMG-Force y FiftyOne (blog de Hugging Face)
- @Alibaba_Qwen: teaser del 6 de noviembre