ai-powered-markdown-translatorArticol tradus din fr în ro cu gpt-6.1-sol.
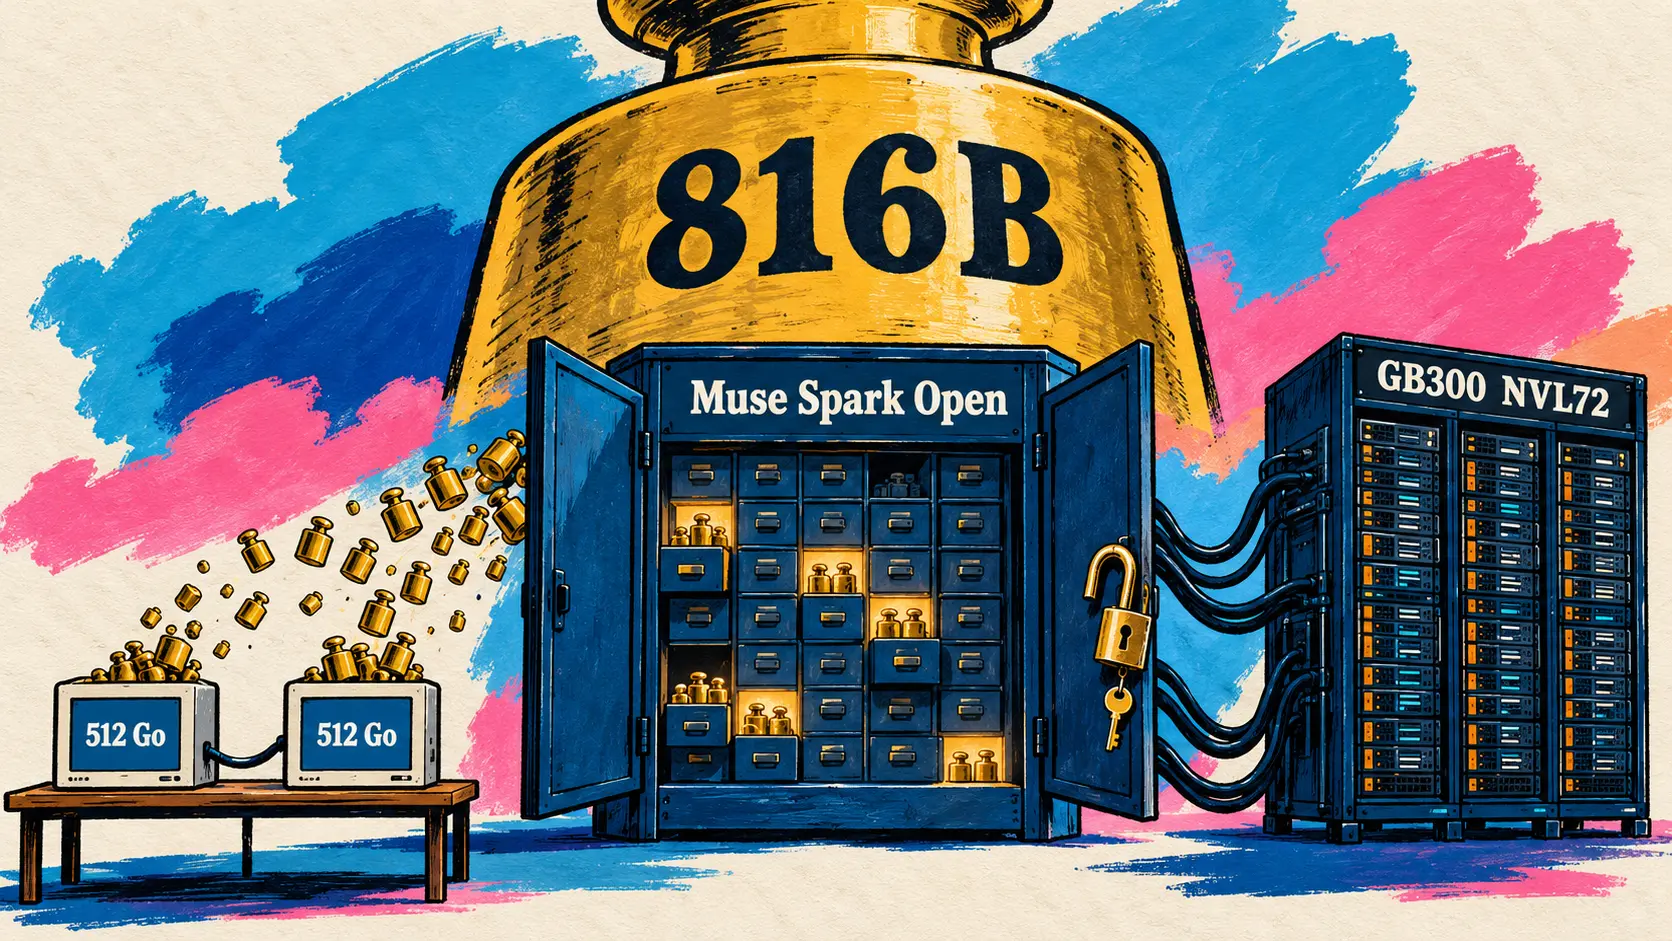
Meta publică ponderile modelului Muse Spark Open, un model multimodal de tip mixture-of-experts cu 816 miliarde de parametri, pe care îl prezintă drept cel mai performant model deschis american, susținut încă din aceeași zi de NVIDIA, Hugging Face și șapte furnizori de API. NVIDIA publică și Nemotron 3.5 Super VL, un model cu 120 de miliarde de parametri pentru agenți, în timp ce Cohere semnează o scrisoare de intenție pentru achiziționarea AISLE, specialist în descoperirea autonomă a vulnerabilităților, și înființează Cohere Cyber. Perplexity publică în regim open source SPACE, sandbox-ul Computer, Black Forest Labs publică ponderile FLUX 3 Image Klein, iar Cognition lansează Devin Oncall, un agent de gardă care investighează incidentele din producție.
Muse Spark Open: Meta publică un MoE multimodal cu 816 miliarde de parametri, NVIDIA și Hugging Face îl susțin în aceeași zi
15 octombrie — Meta publică ponderile modelului Muse Spark Open, un model multimodal cu amestec de experți (mixture-of-experts, MoE) cu 816 miliarde de parametri, dintre care 42 de miliarde activi per token, și o fereastră de context de un milion de tokens. Modelul citește text, imagini, video și audio și răspunde prin text; Meta l-a antrenat pentru cod și activități agentice. În familia Muse, devine modelul deschis de mari dimensiuni, poziționat deasupra Muse Glimmer, micul model dens cu 30 de miliarde de parametri publicat în august, și apare la trei zile după Muse Wonder, care a rămas închis.
Today we’re releasing Muse Spark Open, the most capable US open-weight model to date. Built for coding and agentic work, it excels at long-horizon tasks, complex software engineering, and multi-step reasoning.
🇷🇴 Publicăm astăzi Muse Spark Open, cel mai performant model american cu ponderi deschise de până acum. Conceput pentru cod și activități agentice, excelează la sarcini de lungă durată, inginerie software complexă și raționament în mai multe etape. — @AIatMeta pe X
Superlativul trebuie înțeles în sens strict. În tabelul fișei de pe Hugging Face, unde modelul este evaluat cu setarea xhigh, Muse Spark Open conduce pe opt rânduri ale tabelului complet, inclusiv la utilizarea instrumentelor MCP și la JobBench, însă marile modele deschise chineze rămân în față în indicele Artificial Analysis (45 pentru GLM 5.3, 44 pentru Kimi K3, față de 39) și la cod. Comparativ cu celelalte trei modele americane din tabel, Inkling de la Thinking Machines, Nemotron 3 Ultra de la NVIDIA și Beam de la Reflection AI, doar Beam îl depășește la capitolul capacități, pe GPQA Diamond (90,5 față de 89,0) și Terminal-Bench 2.1 (80,1 față de 76,4).
| Evaluare (fișa Hugging Face) | Scorul Muse Spark Open (xhigh) | Cel mai bun concurent din tabel |
|---|---|---|
| MCP-Atlas | 89,2 | 84,5 (Qwen3.8-2.4T-A95B) |
| JobBench | 61,8 | 61,4 (GLM 5.3) |
| HLE-Diamond (fără instrumente) | 26,1 | 22,2 (Kimi K3) |
| Indicele Artificial Analysis | 39 | 45 (GLM 5.3) |
| OSWorld Verified | 80,4 | 84,8 (Kimi K3) |
| DeepSWE 1.1 | 60 | 68 (Kimi K3) |
| Terminal-Bench 2.1 (Terminus 2) | 76,4 | 85,0 (Kimi K3) |
| StrongREJECT v2 (mai mic = mai bine) | 0,5 | 62,9 (GLM 5.3) |
Întrucât toți experții rămân în memorie, este necesară memoria unui model cu 816 miliarde de parametri pentru a obține viteza unui model cu 42 de miliarde. Ponderile BF16 ocupă aproximativ 1,5 To (depozitul Muse-Spark-Open-816B-A42B de pe Hugging Face, accesibil după completarea unui formular), iar o versiune NVFP4 încape pe un singur nod B200. Meta insistă totuși asupra rulării locale: modelul este optimizat pentru două Mac Studio M5 Ultra conectate, cu MLX, fiecare oferind până la 512 Go de memorie unificată. Hugging Face a testat o configurație mai modestă, pe un singur Mac M3 Ultra cu 512 Go: o versiune pe 2 biți rulată cu llama.cpp ocupă 304 Go și produce 18 tokens pe secundă.
Ponderile sunt publicate sub Muse Model License, cu condiții comerciale limitate, care, potrivit Meta, le permite multor dezvoltatori să folosească modelul gratuit. Șapte furnizori îl oferă din prima zi: Baseten, Fireworks AI, Groq, Modal, Nebius, OpenRouter și Together AI. Meta afirmă că a adăugat o post-antrenare de siguranță specifică ponderilor deschise și că a atins pragurile de publicare din Meta Superintelligence Scaling Framework, actualizat pe 2 octombrie. Pe StrongREJECT v2, unde un scor mic este mai bun, modelul obține 0,5, față de 62,9 până la 86,4 pentru celelalte modele evaluate. Pe FORTRESS, obține cel mai bun scor mediu de risc (5,8, față de 21,6 până la 28,2), dar cel mai mare scor de refuz excesiv din tabel (17,4, față de 2,7 până la 13,3).
NVIDIA însoțește lansarea cu un articol tehnic: Muse Spark Open a fost antrenat pe rackuri GB300 NVL72, iar checkpoint-urile NVFP4 produse de Meta sunt optimizate pentru Blackwell Ultra. Pentru sarcini agentice, NVIDIA anunță până la 50 000 de tokens pe secundă per GPU și până la 600 de tokens pe secundă per utilizator și publică rețete de implementare pentru SGLang, vLLM, TensorRT LLM și Dynamo, un NIM și rețete de post-antrenare cu NeMo AutoModel.
Restul ecosistemului a urmat în aceeași zi: Transformers și TRL îl integrează (vezi mai jos), mlx-lm 0.32.0 adaugă versiunea NVFP4, Unsloth anunță o versiune pe 2 biți care încape în aproximativ 256 Go, iar Meta livrează pentru SGLang kernel-uri Helion de până la 3,95 ori mai rapide la nivel de kernel. În articolul său, Hugging Face ajustează chiar și modelul complet pe 64 de GPU H100, cu o acuratețe medie per token care crește de la 72 la 84 %.
🔗 Articolul Meta · Fișa modelului (Hugging Face) · Articolul Hugging Face · Articolul tehnic NVIDIA
Nemotron 3.5 Super VL: NVIDIA publică un model multimodal cu 120 de miliarde de parametri pentru agenți, Perplexity îl integrează în aceeași zi
15 octombrie — NVIDIA publică Nemotron 3.5 Super VL, un model deschis de tip mixture-of-experts cu 120 de miliarde de parametri, dintre care 12 miliarde activi per token. Acesta reunește raționamentul, urmarea instrucțiunilor și apelarea instrumentelor cu înțelegerea textului, imaginilor, documentelor și materialelor video, pentru agenți care execută succesiv sarcini de lungă durată: același model citește o pagină web, un grafic sau un PDF, apoi acționează, fără a transfera contextul de la un model de text la un model de viziune. Potrivit NVIDIA, pe sarcini agentice multimodale atinge o precizie comparabilă cu cea a celui mai mare model de raționament al companiei, cu aproximativ o cincime din numărul de parametri.
| Evaluare anunțată de NVIDIA | Scorul Nemotron 3.5 Super VL | Termen de comparație |
|---|---|---|
| Hermes Bench | 63,44 % | 56,33 % (Nemotron 3 Ultra) |
| Evaluări comportamentale LangChain | 87,05 % | 84,3 % (Nemotron 3 Ultra) |
| CharXiv (citirea graficelor) | 80,8 % (84 % cu cod Python) | 63 % (Nemotron 3 Nano Omni) |
NVIDIA pune accentul mai ales pe eficiență: pe un singur GPU, un debit de până la 5 ori mai mare decât al celorlalte modele deschise de aceeași dimensiune pe sarcini de agent, peste 600 de tokens pe secundă pe sarcinile agentice din indicele Artificial Analysis prin Baseten și 10 000 de sarcini de cod îndeplinite de până la 4 ori mai repede, păstrând totodată o precizie bună pe SWE-Bench Pro. Obținut prin distilarea lui Nemotron 3 Ultra, îl depășește pe acesta la cele două evaluări de tip harness din tabel. La nivel de servire, decodarea speculativă LiLiCorr accelerează generarea de până la 2,3 ori pe DGX Spark, iar Dynamo deservește de până la 8 ori mai mulți utilizatori pe 16 GPU B200 la 50 de tokens pe secundă fiecare, cu o latență până la primul token redusă cu 85 %.
Publicarea este completă: ponderi de bază, post-antrenate și cuantizate în NVFP4, rețete, medii de învățare prin întărire în NeMo Gym și seturi de date deschise, inclusiv 40 de seturi viziune-limbaj și un corpus de aproximativ 2 800 de miliarde de tokens în 22 de limbi indiene, realizat împreună cu IIT Madras și laboratorul său AI4Bharat. Modelul a procesat aproximativ 26 000 de miliarde de tokens în timpul antrenării. Este disponibil pe Hugging Face, OpenRouter, ModelScope și ca microserviciu NIM, fără un tarif anunțat; NVIDIA menționează adaptări la Scale AI pentru Skydance, cu un cost de inferență anunțat de 40 de ori mai mic, la Ramp, AI21 și Alice.
Perplexity l-a adăugat în aceeași zi pentru abonații săi Pro și Max și în Agent API. Changelog-ul API-ului stabilește pentru perplexity/nemotron-3.5-super-120b-a12b un tarif de 0,20 dolari per milion de tokens de intrare (0,04 dolari pentru cei din cache) și de 0,50 dolari la ieșire, cu un context de 1 048 576 de tokens și până la 131 072 de tokens generați, înlocuind Nemotron 3 Ultra. O mică neconcordanță: această înregistrare descrie un model cu intrare exclusiv textuală, în timp ce postarea Perplexity anunță versiunea VL, care citește și imagini.
În aceeași zi, Nemotron 3.5 Bolt 74B-A9B 24GB, anunțat pe 13 octombrie, ajunge pe Hugging Face: cuantizat nativ pe 2 biți pentru a încăpea în 24 Go, vizează laptopurile RTX Spark disponibile pe 16 octombrie și rulează cu llama.cpp, Ollama, LM Studio, Unsloth și vLLM. NVIDIA îl clasează pe primul loc între modelele deschise din categoria sa pe PinchBench; Bolt E4B 4GB va urma pe 23 octombrie.
🔗 Anunțul NVIDIA · Articolul tehnic NVIDIA · Anunțul Perplexity · Changelog-ul API-ului Perplexity
Securitate cibernetică: Cohere va achiziționa AISLE și înființează Cohere Cyber, GitHub pune AI Scan și autofix-ul agentic la dispoziția tuturor
În aceeași zi, doi actori folosesc IA pentru descoperirea și remedierea vulnerabilităților: Cohere cumpără expertiza necesară, iar GitHub extinde utilizarea ei în code scanning.
15 octombrie — Cohere va achiziționa AISLE, o companie tânără care construiește sisteme autonome capabile să descopere, să valideze și să ajute la remedierea unor vulnerabilități până atunci necunoscute în software critic. Cele două companii au semnat o scrisoare de intenție (Letter of Intent): tranzacția nu este încă încheiată, iar nici valoarea, nici calendarul acesteia nu sunt publicate. La finalizarea tranzacției, sediul AISLE din Praga va deveni biroul Cohere din Praga.
| Indicator publicat despre AISLE | Valoare anunțată |
|---|---|
| Anul înființării | 2024 |
| Vulnerabilități noi care au primit un CVE | Peste 500, în peste 100 de baze de cod |
| OpenSSL, buletinul de securitate din ianuarie | Toate cele 12 vulnerabilități publicate |
| curl, cea mai recentă versiune | 18 dintre cele 24 de CVE |
| CVE de gravitate ridicată sau critică | Peste 200 (potrivit lui Aidan Gomez) |
Aisle is the state-of-the-art in defensive cyber, having found 200+ High/Critical CVEs in critical software like curl, FFmpeg, FreeBSD, Wireshark.
🇷🇴 Aisle se află în avangarda apărării cibernetice, cu peste 200 de CVE de gravitate ridicată sau critică descoperite în software critic precum curl, FFmpeg, FreeBSD și Wireshark. — @aidangomez pe X
În același fir de discuție, Aidan Gomez, aflat la conducerea Cohere, afirmă că AISLE a obținut rezultate mai bune decât Glasswing (Mythos) de la Anthropic și Daybreak de la OpenAI, cu 29 de CVE noi în curl, în timp ce Mythos nu ar fi găsit niciuna; această cifră nu coincide cu cele „18 dintre cele 24 de CVE” menționate în articolele celor două companii.
Echipa fondatoare a AISLE preia funcții de conducere. Ondrej Vlcek, PDG al AISLE, devine Senior Vice President al Cohere Cyber, o nouă unitate însărcinată să ofere soluții de securitate cibernetică clienților Cohere; Jaya Baloo devine Chief Information Security Officer al Cohere la nivel mondial; Stanislav Fort, CTO și Chief Scientist al AISLE, devine Vice President AI Security și va lucra cu Ivan Zhang, CTO al Cohere, pentru a conecta cercetarea în securitate cu dezvoltarea și antrenarea modelelor.
Cohere consideră că acesta este încă un pas în strategia sa europeană, după Reliant AI și Aleph Alpha: compania prevede o investiție „substanțială” și pe termen lung în Praga, care urmează să devină centrul său mondial de securitate cibernetică IA, la mică distanță de noul său sediu din Berlin, potrivit lui Aidan Gomez. Obiectivul este dublu: continuarea activității AISLE privind securitatea software-ului open source și posibilitatea ca operatorii de infrastructuri critice să își analizeze software-ul în condiții de confidențialitate deplină, inclusiv în medii deconectate (air-gapped). Cele două articole adaugă și un argument legat de modele: problemele de securitate dificile, dar verificabile pot fi folosite pentru a evalua și a îmbunătăți viitoarele modele Cohere.
🔗 Articolul Cohere · Articolul AISLE
GitHub: AI Scan pentru pull requests și autofix-ul agentic pentru alerte ajung la disponibilitate generală
15 octombrie — GitHub aduce la disponibilitate generală două componente de code scanning bazate pe IA: una care găsește vulnerabilități în pull requests și alta care remediază alertele.
AI Scan pentru pull requests completează CodeQL în zonele pe care analizorul nu le acoperă încă: PHP, Shell/Bash, configurații Terraform (HCL), Dockerfiles, JSP pentru Java sau Blazor pentru C#. Acesta pornește automat pentru fiecare pull request dacă code scanning și setarea AI Scan a depozitului sunt active, iar rezultatele sale apar alături de cele ale CodeQL, marcate „AI”, uneori cu o explicație a riscului și o remediere sugerată. Rezultatele rămân consultative: nu provoacă eșecul verificării și nu pot bloca un merge, iar analiza nu rulează nici pentru pull requests provenite din forks, nici pentru cele ale Dependabot.
Autofix-ul agentic (agentic autofix) preia o alertă atribuită lui Copilot: explorează fișierele vizate, propune o remediere, rulează din nou CodeQL pentru a verifica dacă alerta este într-adevăr închisă, repetă procesul dacă este necesar, apoi deschide un pull request în stadiu de schiță. I se poate încredința o alertă de pe ramura implicită, până la 25 de alerte de remediat într-un singur pull request, sau se poate folosi API-ul REST, atribuind alerta lui copilot-swe-agent[bot]; odată activat, înlocuiește opțiunea gratuită Generate Fix.
| Componentă GitHub disponibilă general | Planuri și condiții | Mod de facturare |
|---|---|---|
| AI Scan pentru pull requests | Depozite publice; Code Security sau Advanced Security pentru depozitele private și interne ale organizațiilor, fără licență Copilot | Code Security AI Credits |
| Autofix agentic pentru alerte | Code Security sau Advanced Security pe GitHub Enterprise Cloud, inclusiv rezidența datelor; sunt necesare politica Agentic autofix și o metodă de facturare Copilot | AI Credits din bugetul Code Security și minute GitHub Actions |
Cele două lansări încheie o serie prezentată aici începând din septembrie: API-ul de activare a AI Scan pe 10 septembrie, autofix-ul agentic bazat pe Copilot Memory în versiune preliminară pe 25 septembrie, metricile AI Scan în security overview pe 13 octombrie.
🔗 AI Scan pentru pull requests (changelog GitHub) · Autofix agentic pentru alertele de code scanning (changelog GitHub)
SPACE: Perplexity publică în open source sandbox-ul Computer, sub licența Apache 2.0
15 octombrie — Perplexity publică în open source SPACE (Sandboxed Platform for Agentic Code Execution), platforma de medii izolate (sandboxes) care execută fiecare sarcină a Perplexity Computer. Cu o zi înainte, Perplexity explica în detaliu cum direcționează SPACE fiecare cerere către instanța sandbox potrivită; acum, codul în sine este disponibil pe GitHub, sub licența Apache 2.0. Fiecare sarcină de agent rulează într-o microVM Firecracker proprie, iar datele de autentificare și traficul de ieșire sunt controlate din exteriorul mașinii virtuale.
Principiul de securitate se rezumă la o idee: sandbox-ul este considerat nesigur. Agenții Computer rulează comenzi, instalează pachete și apelează servicii externe cu acces root, dar gazda rămâne inaccesibilă pentru ei, iar un gateway dedicat fiecărui sandbox aplică politica de trafic de ieșire la fiecare conexiune; agenții accesează serviciile autorizate fără ca datele de autentificare să fie stocate în mediul lor de lucru. Un sandbox persistă și după cererea care l-a creat: poate fi pus pe pauză, duplicat (fork) sau suspendat într-un instantaneu al memoriei și al discului, apoi reluat.
| Element SPACE | Valoare indicată de Perplexity |
|---|---|
| Limbajul și licența depozitului | Rust, Apache 2.0 |
| Izolare | O microVM Firecracker pentru fiecare sarcină de agent |
| Volum în producție | Milioane de sandbox-uri create zilnic, pentru toate sesiunile Computer începând din iulie |
| Creare comparativ cu fostul furnizor | De trei până la cinci ori mai rapidă, pe același trafic de producție |
| Escaping SPACE, Part I | Nicio evadare către gazdă în 108 încercări |
| Calendarul versiunilor | 0.8.0 ca bază publică, apoi 0.9.0 și 1.0.0 |
Evaluarea Escaping SPACE din septembrie nu identificase nicio evadare din mașina virtuală către gazdă, dar descoperise modalități de ocolire a restricțiilor de rețea: acestea au fost remediate, iar metodele identificate nu au mai reușit la testele ulterioare, potrivit articolului. Depozitul, scris în Rust, se instalează local pe un cluster Kubernetes de testare (Kind), oferă rezerve de sandbox-uri preîncălzite (warm pools) și un strat de compatibilitate cu API-ul E2B, testat cu SDK-ul său Python; 0.9.0 va fi ultima versiune care va introduce modificări incompatibile înaintea unei versiuni 1.0 cu contracte stabile.
CoreWeave și Akamai au testat și lansat SPACE pe platformele lor și lucrează pentru a-l oferi clienților, iar Crusoe îl va adăuga în oferta sa Managed AI Services. Perplexity prezintă SPACE drept prima componentă a platformei sale de execuție a agenților (Agentic Runtime Platform), publicată deschis pentru a crește nivelul de securitate al produselor agentice.
🔗 Articolul Perplexity · Firul de postări al @perplexity_ai · Depozitul SPACE (GitHub)
Conținut media generativ: FLUX 3 Image Klein cu ponderi deschise pe un GPU de larg consum, Kling 4.0 pentru toți, Instant Soundtracks de la ElevenLabs
15 octombrie — Black Forest Labs publică FLUX 3 Image Klein, un model de imagini cu ponderi deschise, cu 5,6 miliarde de parametri doar pentru generator, care rulează pe un singur GPU de larg consum. Același model generează imagini din text și le retușează folosind una sau mai multe referințe, până la 10 imagini; preia funcțiile principale ale FLUX 3 Image, lansat pe 1 octombrie: generare 4K nativă, editare la nivel de pixel și casete de delimitare (bounding boxes), care stabilesc în prompt poziția unui element sau limitează o retușare la o anumită zonă.
Potrivit evaluărilor interne BFL, Klein ocupă primul loc la generarea de imagini din text, utilizarea mai multor referințe și editare, în comparație cu modelele deschise mai mari Qwen-Image 2.1 (7B) și Krea 2 (12,9B), și se situează deasupra celor două modele închise din comparație, Ideogram V4.5 și FLUX.2 [pro]. Față de predecesorul său FLUX.2 [klein] 9B, câștigă 91 de puncte Elo la generarea de imagini din text și 70 la editare, cu 38 % mai puțini parametri.
| Configurație testată | Rezultat anunțat |
|---|---|
| Ponderi în BF16 / în FP8 | 11,2 Go / 5,6 Go |
| Versiune INT8 pe GeForce RTX (ComfyUI sau Diffusers) | Rulează cu 8 Go de VRAM |
| RTX 5090, versiune distilată în INT8 (măsurătoare NVIDIA) | Aproximativ 4 s pentru o imagine de 1 megapixel |
| RTX 4070, versiune distilată în INT8 (măsurătoare NVIDIA) | Sub 9 s pentru o imagine de 1 megapixel |
| H100, versiune distilată în Diffusers | Aproximativ 2 s pentru o imagine de 1024 × 1024 pixeli |
| GB300, versiune distilată în NVFP4 | Sub 0,6 s pentru o imagine de 1 megapixel |
Hugging Face l-a integrat în Diffusers în aceeași zi, cu două puncte de control: versiunea distilată, cu 16 pași și fără CFG, și versiunea de bază, cu 50 de pași, destinată ajustării fine. La acestea se adaugă ponderi NVFP4 și FP8, encoderul de text Qwen3-VL și scripturi de ajustare fină LoRA; în NVFP4, vârful consumului de memorie după inferență ajunge la 15,3 Gio pe o RTX 6000. ComfyUI, TensorRT-LLM, SGLang Diffusion și vLLM-Omni îl acceptă, de asemenea, încă de la lansare, iar versiunile FP8, INT8 și NVFP4 au fost dezvoltate împreună cu NVIDIA.
Ponderile sunt publicate sub licența FLUX Kommunity, gratuită pentru utilizare comercială de către persoane fizice și companii cu o cifră de afaceri anuală sub 5 milioane de dolari, precum și pentru cercetare; peste acest prag, este necesară o licență pentru găzduire proprie sau utilizarea API-ului. API-ul BFL oferă flux-3-image-klein de la 0,009 dolari pentru o imagine 1K. Este al doilea model deschis din familia FLUX 3, după FLUX 3 Action, iar BFL anunță că vor urma și altele.
🔗 Articolul Black Forest Labs · Anunțul @bfl_ai · FLUX 3 Image Klein în Diffusers (Hugging Face)
Kling 4.0 devine disponibil pentru toți, cu acces prin MCP și din linia de comandă
15 octombrie — Kling AI pune Kling 4.0 la dispoziția tuturor, după accesul anticipat deschis pe 30 septembrie. Modelul video poate fi folosit într-o interfață de creație refăcută pe kling.ai și, ca noutate, prin MCP și din linia de comandă (CLI), ceea ce permite integrarea lui în fluxuri de producție bazate pe instrumente. Două funcții sunt anunțate pentru viitorul apropiat, fără o dată precisă: ieșire video HDR pe 10 biți în 4K și 1080p și acces API pentru companii și dezvoltatori. Caracteristicile prezentate pe 28 septembrie rămân reperul: clipuri de 3 până la 30 de secunde, până la 4K, audio stereo, 10 cadre-cheie, 15 referințe și prompturi de 8 000 de tokenuri. Anunțul nu oferă nici prețuri, nici un benchmark.
🔗 Anunțul Kling AI · Notele de versiune Kling
Instant Soundtracks: ElevenLabs compune muzică și efecte sonore sincronizate pornind de la un videoclip
15 octombrie — ElevenLabs lansează Instant Soundtracks în ElevenCreative: utilizatorul încarcă un videoclip, iar modelul compune muzică originală, identifică momentele care necesită un efect sonor și plasează fiecare efect la marcajul temporal potrivit, de exemplu un „whoosh” sincronizat cu logoul de la finalul unei reclame. Instrumentul vizează formatele scurte, cu o sincronizare mai precisă cu tăieturile de montaj și tranzițiile, schimbă atmosfera muzicală de la o scenă la alta și poate folosi sunetul original ca referință (gen, tempo, instrumentație). Efectele sunt livrate pe piste separate, care pot fi modificate înainte de export.
| Parametru al API-ului ElevenCreative Studio | Rolul parametrului |
|---|---|
add_sfx | Adaugă efectele sonore sincronizate |
separate_tracks | Returnează muzica și efectele în fișiere separate (.ZIP) |
use_audio_as_reference | Folosește sunetul original ca referință muzicală |
Instant Soundtracks este disponibil în ElevenCreative, ElevenMusic și API, care acceptă până la 10 videoclipuri, 200 Mo și 10 minute de video în total pentru fiecare cerere. ElevenLabs nu precizează prețurile.
Agenți de programare: Cognition lansează Devin Oncall, Claude Code 2.1.301 și Code Review, Delta 0.20, Antigravity CLI 1.3.6, Codex la OpenAI, MX Keypad
15 octombrie — Cognition lansează Devin Oncall, acum disponibil general: Devin investighează automat alertele și rapoartele de buguri, apoi ajută echipa să diagnosticheze și să rezolve incidentele de producție. Se conectează direct la Datadog, Dynatrace și Sentry, printre altele, și gestionează deja, potrivit Cognition, mii de alerte de producție zilnic la unele dintre cele mai mari companii din lume. Arhitectura sa nu depinde de un model anume: Cognition îl alege pe cel mai eficient pentru fiecare sarcină din serviciul de permanență.
| Agent și model evaluate | Rată de reușită de la început până la sfârșit (SREGym-Lite) | Originea scorului |
|---|---|---|
| Devin Oncall + Claude Opus 5.5 | 100 % (în 2 min 21 s) | Evaluare internă Cognition |
| Devin Oncall + GPT-6 Astra | 100 % | Evaluare internă Cognition |
| Devin Oncall + GPT-6.1 Sol | 94,1 % | Evaluare internă Cognition |
| Devin Oncall + Claude Fable 5.1 | 85,3 % | Evaluare internă Cognition |
| CloudThinker + Claude Opus 5 | 76,5 % | Clasament public SREGym |
| Codex + GPT-5.6 Sol | 76,5 % | Clasament public SREGym |
| Claude Code + Claude Sonnet 5 | 45,1 % | Clasament public SREGym |
SREGym-Lite reunește 17 defecțiuni extrase din incidente reale: agentul trebuie să găsească cauza de bază, apoi să repare sistemul aflat în funcțiune, în cadrul aceleiași execuții. Scorurile Devin Oncall provin din evaluarea internă Cognition, iar cele ale celorlalți agenți din clasamentul public SREGym din 15 octombrie, unde și CloudThinker atinge 100 % cu GPT-6 Astra. Benchmarkul este, așadar, saturat: potrivit Cognition, modele de nivel mediu obțin deja scorul maxim, în timp ce generația precedentă se plafona între 50 și 60 %.
Articolul descrie în principal instrumentele din jurul modelului. Un agent de revizuire lucrează în paralel cu investigația pentru a evita concluziile pripite: o corelație interpretată drept cauză, date de telemetrie contradictorii ignorate, un factor declanșator confundat cu cauza. Trei niveluri de memorie acumulează cunoștințe despre companie: o memorie proprie fiecărui agent de răspuns, skills generate prin indexarea periodică a mediului și o memorie a organizației alimentată de fiecare investigație. Responders, prezentați drept noua generație Auto-Triage, monitorizează un flux de alerte și evită aproximativ 60 % dintre investigații prin recunoașterea problemelor întâlnite anterior, economisind astfel peste jumătate din costul automatizărilor clasice; modul Incidents îl plasează pe Devin în canalul de criză, cu un document de incident actualizat permanent și instanțe Devin secundare însărcinate să răspundă la întrebările directe ale inginerilor.
Trei clienți ilustrează lansarea. La Reducto, Devin a deschis un incident din proprie inițiativă, cu mult înainte de declanșarea alertelor de producție; la RV Tech, compania mixtă Rivian și Volkswagen, extrage identificatorii vehiculelor și marcajele temporale din rapoartele clienților, preia logurile și face trierea inițială; la AngelList, identifică corect cauza de bază de 3,5 ori mai des decât instrumentul intern Sky și a gestionat singur jumătate dintre incidente, astfel încât Sky a fost abandonat. Nu este anunțat niciun preț: pagina Devin Oncall oferă posibilitatea de a începe utilizarea sau de a programa o demonstrație. Lansarea continuă evoluția începută în iulie, când fondatorii TierZero, companie specializată în SRE asistat de IA, s-au alăturat Cognition.
🔗 Articolul Cognition · Firul de postări al @cognition · Pagina Devin Oncall
Claude Code 2.1.301: durata de așteptare a resetării limitelor de utilizare este plafonată în modul nesupravegheat, 37 de remedieri
15 octombrie — Lansată la 19 h 22 UTC, Claude Code 2.1.301 cuprinde 51 de intrări, dintre care 8 adăugiri, 37 de remedieri, 4 îmbunătățiri și 2 schimbări, și vizează în primul rând utilizarea fără supraveghere. Noua variabilă CLAUDE_CODE_RETRY_WATCHDOG_MAX_USAGE_LIMIT_WAIT_MS permite modului de relansare automată (CLAUDE_CODE_RETRY_WATCHDOG) să abandoneze o cerere atunci când limita de utilizare atinsă se resetează prea târziu, în loc să aștepte. În privința observabilității, evenimentele OpenTelemetry tool_decision includ acum classifier_verdict și permission_mode, pentru a deosebi o decizie a clasificatorului din modul auto de o regulă de permisiune, precum și classifier_category, regula integrată care a provocat blocarea (împreună cu OTEL_LOG_TOOL_DETAILS=1).
Mai multe remedieri vizează fiabilitatea: aliasul fable (și best) nu mai returnează o eroare atunci când cel mai recent Fable nu este disponibil organizației, Claude Code reîncercând o dată cu versiunea Fable anterioară; închiderea unei sesiuni nu mai șterge fără confirmare un worktree creat de un hook WorktreeCreate, care poate conține commituri netrimise prin push; Grep și Glob semnalează o eroare în loc să anunțe „nicio potrivire” atunci când căutarea eșuează. La trecerea la un model cu o fereastră de context mai mică, o conversație prea lungă este mai întâi rezumată de modelul anterior. În VS Code, răspunsurile afișează formulele LaTeX, iar bannerul privind limita de utilizare oferă abonaților Pro și Max un link „Obține o cotă de utilizare mai mare”.
🔗 Notele de versiune pentru Claude Code 2.1.301
Code Review din Claude Code iese din etapa de previzualizare pentru cercetare și devine disponibil pentru Team și Enterprise
15 octombrie — La șapte luni de la lansarea sa în etapa de previzualizare pentru cercetare, pe 9 martie, Code Review, serviciul Claude Code care revizuiește automat pull requests de pe GitHub, devine disponibil organizațiilor Claude Team și Enterprise. Potrivit Anthropic, majoritatea revizuirilor se încheie de aproximativ trei ori mai repede decât în etapa de previzualizare, cu constatări concise care prezintă problema, ce o declanșează și remedierea. Un administrator alege un nivel pentru fiecare depozit: Quick, Standard (implicit) sau Deep.
| Aspect esențial al Code Review | Detaliu publicat de Anthropic |
|---|---|
| Durata unei revizuiri | Aproximativ 6 până la 10 minute, față de circa douăzeci în etapa de previzualizare |
| Facturarea revizuirilor | Tokens consumați, deduși din creditele de utilizare în afara cotei incluse în abonament, cu un plafon lunar |
| Credite de lansare | Cel puțin 10 000 de dolari pentru organizațiile Enterprise eligibile, de solicitat înainte de 15 ianuarie 2027, valabile 30 de zile |
| Excluderi actuale | Zero Data Retention, configurarea HIPAA și, deocamdată, cheile gestionate de client (CMEK) |
Principiul rămâne același: constatările apar în comentarii inline ordonate după gravitate, cu un check run care nu eșuează niciodată, iar o revizuire nici nu aprobă, nici nu blochează un pull request, decizia de integrare rămânând în sarcina echipei.
🔗 Code Review este acum disponibil pe scară largă (Claude) · Documentația Code Review
Delta 0.20: subagenții devin fire secundare controlabile, agenții au acces la serverele MCP
14 octombrie — Delta, mediul de programare colaborativă al creatorilor Zed, ajunge la versiunea 0.20 (18 funcționalități noi, 14 îmbunătățiri și 29 de remedieri, apoi o remediere în 0.20.1 în aceeași zi). Subagenții devin fire secundare obișnuite, pe care le poți consulta, redirecționa și continua singur, iar firele secundare pot fi acum imbricate; setarea Enable Sub-agents devine Delegation, cu trei poziții (Off, Only When Asked, Max). Agenții primesc acces la serverele MCP, care se conectează în Settings → MCP, iar o revizuire sau un Land lansat dintr-un fir secundar acoperă și modificările moștenite din firele părinte. Versiunea adaugă Gemini 4 Argon cu propria cheie Google, o comandă /create-skill și comenzi delta org pentru gestionarea unei organizații din terminal.
Pe 15 octombrie, un articol bazat pe o prezentare a lui Conrad Irwin detaliază DeltaDB, stratul de colaborare care trimite fiecare apăsare de tastă către server și colaboratori: CRDT inspirate de diamond-types, fiecare modificare fiind ancorată într-o versiune Git sau în modificări anterioare. Cum fiecare caracter știe ce modificare l-a creat, Delta îi poate asocia autorul, agentul și chiar promptul.
🔗 Notele de versiune pentru Delta · DeltaDB: viitorul controlului versiunilor
Antigravity CLI 1.3.6: Claude 5.5 prin datele de autentificare Google Cloud, după modul Auto și /compact din 1.3.5
14 octombrie — Antigravity CLI, instrumentul cu agenți în linie de comandă pe care Google îl prezintă drept succesorul Gemini CLI, continuă seria de versiuni: de la 1.3.1, prezentată aici pe 8 octombrie, au urmat cinci versiuni. Versiunea 1.3.6 adaugă Claude Opus 5.5 și Claude Sonnet 5.5 pentru utilizatorii conectați cu datele de autentificare implicite Google Cloud (Application Default Credentials, AGY_ADC_AUTH): modelele Claude apar în /model doar dacă proiectul Google Cloud are acces la ele. Aceasta pune capăt și unui blocaj nesfârșit: după 5 minute fără date de la model, cererea este anulată și relansată automat.
Cea mai vizibilă noutate vine din 1.3.5: un mod Auto care aprobă singur modificările fișierelor și comenzile considerate sigure, dar cere întotdeauna confirmarea înaintea unei acțiuni ireversibile. Comenzile care ar ieși din sandbox-ul terminalului sunt mai întâi examinate de un agent distinct; versiunea 1.3.6 accelerează această verificare, permite comenzile de formatare și de lint ale proiectului și le blochează pe cele care ar trimite date sensibile. Modul se activează cu --mode auto, din /config sau prin Shift+Tab, pe Linux și macOS (Windows mai târziu). Versiunea 1.3.5 adaugă și /compact, care rezumă conversația la cerere pentru a elibera fereastra de context.
| Versiunea Antigravity CLI | Data changelog-ului | Îmbunătățiri și remedieri | Aspectul principal al versiunii |
|---|---|---|---|
| 1.3.6 | 14 octombrie | 3 + 10 | Claude Opus 5.5 și Sonnet 5.5 prin ADC, relansare după un blocaj de 5 minute |
| 1.3.5 | 13 octombrie | 5 + 1 | Mod Auto, /compact, colorare și pliere în /diff |
| 1.3.4 | 12 octombrie | 4 + 10 | agy plugin list --json, model ales fără --effort |
| 1.3.3 | 9 octombrie | 6 + 15 | Instrumente MCP încărcate permanent, sandbox consolidat |
| 1.3.2 | 7 octombrie | 6 + 4 | /plugin și marketplace oficial de pluginuri |
🔗 Changelog pentru Antigravity
Codex la OpenAI: echipa Core Experimentation integrează peste 1 400 de PR-uri de mentenanță cu GPT-6 Astra și GPT-6.1 Sol
14 octombrie — Pe blogul OpenAI Developers, un inginer din echipa Core Experimentation, care întreține software-ul de experimentare folosit în întreaga companie, povestește cum modelele GPT-6 au preluat mentenanța depozitelor sale în Codex. Punctul de plecare: un prompt scurt și intenționat vag, care cere identificarea și curățarea codului mort. GPT-5.6 Sol nu îl ducea până la capăt; GPT-6 Astra a consultat PR-uri vechi, fire de discuție Slack, instrumente interne de urmărire și tabele de profilare din producție, apoi a justificat fiecare ștergere. Cinci ingineri au adaptat apoi acest prompt, lucrând cu timp parțial timp de două săptămâni: peste 1 400 de pull requests integrate, peste 800 000 de linii șterse, iar imaginea de container a unui serviciu a scăzut de la 3,31 la 1,72 Go (-48 %).
| Model și efort de raționament | Cost API al sarcinii | Constatări reținute | Cost per constatare |
|---|---|---|---|
| GPT-6 Astra Ultra | 109,06 dolari | 142 | 0,77 dolari |
| GPT-6.1 Sol Ultra | 15,12 dolari | 131 | 0,12 dolari |
| GPT-6.1 Sol Medium | 5,27 dolari | 86 | 0,06 dolari |
Pentru aceeași sarcină de curățare, în peste 6 000 de fișiere și 1 milion de linii de Python, TypeScript, Go și Rust, GPT-6.1 Sol cu efort Ultra regăsește astfel 92 % dintre constatările GPT-6 Astra Ultra pentru 14 % din costul API; diferența ține mai ales de indicatorii de funcționalitate (feature flags) constanți folosiți ca dependențe ale altor indicatori, pe care Astra îi identifică și Sol îi ratează. Circa treizeci de PR-uri de optimizare au redus și durata mediană a CI de la aproximativ 10 la 4,5 minute. Autorul recunoaște că unele propuneri adăugau mai multă complexitate decât beneficii și recomandă să se înceapă la scară mică.
🔗 Mentenanța software-ului cu familia GPT-6 (OpenAI Developers)
MX Keypad: GitHub și Logitech controlează aplicația GitHub Copilot printr-o tastatură cu taste programabile
15 octombrie — Într-un articol dedicat „inteligenței ambientale”, Martin Woodward, vicepreședinte pentru relația cu dezvoltatorii la GitHub, prezintă rezultatul a 18 luni de lucru cu Logitech: MX Keypad, o tastatură cu taste programabile, se integrează cu aplicația GitHub Copilot. O tastă poate trimite un prompt parametrizat, deschide sau relua o sesiune Copilot, apela o comandă a IDE-ului sau lansa o secvență cu mai mulți pași. Articolul plasează dispozitivul într-o viziune cu trei straturi: modalitatea de interacțiune (text, voce, comenzi fizice) captează intenția, harness-ul planifică și acționează, iar planul de control îi permite dezvoltatorului să inspecteze, să redirecționeze și să aprobe. Autorul rămâne prudent: experiența este „încă la început” (încă la început), iar nu toți dezvoltatorii au nevoie de încă un dispozitiv. Un link permite încercarea MX Keypad cu trei luni de GitHub Copilot Pro+ oferite gratuit, fără ca articolul să precizeze un preț sau o dată de disponibilitate.
🔗 Următoarea interfață pentru dezvoltatori este inteligența ambientală (GitHub Blog)
Securitatea modelelor: METR obține la Anthropic acces de angajat, IPI Black pune la bătaie 300 000 de dolari împotriva injecției de prompt
Două inițiative din aceeași zi pentru testarea siguranței modelelor de către terți: o echipă de evaluatori independenți găzduită la Anthropic și un concurs public de atacuri împotriva agenților.
METR obține la Anthropic acces comparabil cu cel al unui angajat
15 octombrie — Anthropic a început să integreze o echipă METR, organizația nonprofit care evaluează modelele de IA de vârf, cu un acces „comparabil cu cel al unui angajat” (acces similar celui al unui angajat). Șase persoane de la METR dispun de echipamentele companiei, de birouri și de acces la instrumentele și sistemele interne aproximativ echivalent cu cel al echipelor de evaluare a riscurilor de la Anthropic; rămân inaccesibile doar datele clienților, informațiile protejate de confidențialitatea relației avocat-client și arhitecturile modelelor. METR își va publica analizele de risc, iar Anthropic nu se poate opune: poate doar cere mascarea informațiilor din categorii restrânse, definite în prealabil, iar METR rămâne liberă să spună public dacă aceste mascări i se par justificate.
| Nivelul de acces al evaluatorilor | Acces la informații | Drept de publicare | Evaluator menționat de Anthropic |
|---|---|---|---|
| Nivelul 1 | Investigații țintite, acces decis de Anthropic | Cu aprobarea Anthropic | SecureBio |
| Nivelul 2 | Mai multe informații | Fără aprobare, posibilă mascare a unor categorii precise | Niciunul menționat |
| Nivelul 3 | Comparabil cu cel al unui angajat | Ca la nivelul 2 | METR |
Anthropic pregătește și un parteneriat cu Accenture și Faculty (evaluarea și red-teaming-ul modelelor, evaluări de aliniere, testarea mecanismelor de protecție) și poartă discuții preliminare cu alte organizații, inclusiv Hugging Face. Compania compară acest mecanism cu supravegherea bancară, unde inspectori rezidenți lucrează în cadrul celor mai mari bănci, și îl prezintă drept o continuare a semnării White House Accord on Super Intelligence, prin care companiile se angajează să colaboreze cu evaluatori externi independenți.
🔗 Noutăți privind evaluatorii independenți (Anthropic)
IPI Black: Gray Swan lansează un concurs de injecție indirectă de prompt cu premii de 300 000 de dolari
15 octombrie — Gray Swan lansează IPI Black (Indirect Prompt Injection: Black), un concurs public de injecție indirectă de prompt cu premii de 300 000 de dolari, cu sprijinul Anthropic, Meta, Google DeepMind, Reflection AI, OpenAI, Amazon, Thinking Machines și AI Security Institute. Participanții, fără să fie necesară experiență, atacă agenți plasați în medii simulate cu instrumente realiste (Gmail, Slack, GitHub, X): de exemplu, să determine agentul de redactare al unui responsabil de rețele sociale să publice conținut dăunător pe conturile oficiale ale companiei sale. În regim de cutie albă, se pot vedea răspunsurile agentului și se poate rafina atacul; în regim de cutie neagră, se trimite încărcătura fără să se vadă nimic.
Concursul se desfășoară în trei valuri de câte o săptămână, care încep pe 15, 22 și 29 octombrie, fiecare cu propriile clasamente, care împart 100 000 de dolari între cutia albă și cutia neagră. Primul val oferă zece scenarii, șase în regim de cutie albă și patru în regim de cutie neagră, de la divulgarea unui identificator într-un comentariu la un issue GitHub până la o sesizare falsă de avertizor de integritate. Atacurile colectate vor alimenta benchmark-ul pe care laboratoarele partenere îl folosesc pentru a măsura robustețea modelelor lor. Boris Cherny, creatorul Claude Code, a distribuit concursul: potrivit lui, modelele Claude au progresat mult în fața injecției de prompt în ultimii ani, dar rezolvarea problemei la nivelul întregii industrii devine urgentă pe măsură ce agenții fac tot mai multe lucruri.
🔗 Firul de discuție al Gray Swan · Pagina concursului · Mesajul lui Boris Cherny
Modele noi: Timestral pentru serii temporale, Step 5 Preview de la StepFun, Apertus 1.5 și Jev 1.14
Patru lansări de natură diferită: o familie de modele de prognoză de la Mistral, un MoE mare deschis de la StepFun, modele complet deschise în Elveția și un model de decizie de la TypeSafe.
Timestral: Mistral publică prima sa familie de modele de fundație pentru serii temporale
15 octombrie — Mistral publică Timestral, prima sa familie de modele de fundație pentru serii temporale (time-series foundation models), în patru dimensiuni care împărtășesc aceeași arhitectură și aceeași metodologie de antrenare: 5M, 28M, 123M și 209M parametri. Modelele produc prognoze probabilistice (21 de cuantile) și multivariate, țin cont de covariabile cunoscute doar pentru trecut sau cunoscute în avans (calendarul de producție, opririle planificate, prognozele meteo), inclusiv de cele categoriale, precum starea unei mașini, și procesează până la 32 768 de pași de timp din istoric.
| Benchmark și metrică (mai mic = mai bine) | Timestral-209M | t0-gamma | TimesFM-3 | Chronos-2 |
|---|---|---|---|---|
| GIFT-Eval, MASE | 0,658 | 0,661 | 0,667 | 0,698 |
| GIFT-Eval, CRPS | 0,446 | 0,452 | 0,456 | 0,485 |
| TIME, MASE | 0,626 | 0,637 | 0,640 | 0,662 |
| TIME, CRPS | 0,522 | 0,534 | 0,536 | 0,556 |
Potrivit Mistral, modelul 209M ocupă primul loc pe GIFT-Eval, TIME și fev-bench în rândul modelelor preantrenate utilizate fără adaptare (zero-shot), cu un singur punct de control și fără ansamblu de modele, și depășește cel mai performant model anterior folosind două treimi din numărul de parametri al acestuia; diferențele dintre modelele de pe primele locuri rămân mici, iar micul 28M depășește deja Chronos-2, de aproximativ patru ori mai mare, pe GIFT-Eval și TIME. Timestral nu are nevoie de GPU: pe un procesor de server cu 8 threads, prognozarea unei zile pe baza unui istoric de trei săptămâni cu intervale de 15 minute durează 10 ms cu 5M și 140 ms cu 209M. Ponderile sunt disponibile pe Hugging Face sub o licență „MIT modificată” care exclude companiile cu o cifră de afaceri lunară consolidată de peste 20 de milioane de dolari, codul este pe GitHub sub Apache-2.0, iar documentația prezintă Timestral 1.0 drept o versiune preliminară publică; Mistral Forge permite ajustarea fină pe date proprietare, cu posibilitatea implementării fără conexiune la internet.
🔗 Prezentarea Timestral (Mistral) · Timestral-209M pe Hugging Face
Step 5 Preview: StepFun publică un MoE deschis cu 600 de miliarde de parametri pentru sarcini ale agenților de 24 de ore, potrivit NVIDIA
15 octombrie — NVIDIA salută lansarea Step 5 Preview, pe care contul său @NVIDIAAI o prezintă drept cea mai mare lansare cu ponderi deschise a StepFun: un amestec de experți cu 600 de miliarde de parametri, conceput pentru sarcini ale agenților care pot dura până la 24 de ore. NVIDIA anunță aproape 8 000 de tokens pe secundă per GPU pe GB300 în NVFP4, cu un punct de control NVFP4 publicat pe Hugging Face, rețete de implementare pentru SGLang și vLLM, postantrenare cu NeMo AutoModel și un NIM pornit printr-o singură comandă. Mesajul NVIDIA nu oferă nici benchmark, nici licență.
Apertus 1.5: Swiss AI detaliază modele 8B și 70B complet deschise, cu imagini, audio și un context de 262 144 de tokens
15 octombrie — Inițiativa elvețiană Swiss AI publică notele de versiune și raportul tehnic pentru Apertus 1.5, familia sa de modele complet deschise. Ponderile 8B și 70B erau disponibile online din 24 iulie sub Apache 2.0; raportul publică și punctele de control intermediare (base, SFT, RLVR, DPO), amestecurile de date și fișele de evaluare, pentru ca alți cercetători să poată studia efectul fiecărei faze de antrenare.
| Model Apertus 1.5 | Număr de tokens adăugați la preantrenare | Număr total de tokens |
|---|---|---|
| 8B | 4 000 miliarde | 19 000 miliarde |
| 70B | 2 000 miliarde | 17 000 miliarde |
Imaginile și sunetul trec prin tokenizer, fără un encoder separat: o imagine de 512 × 512 pixeli devine 1 024 de tokens, iar o secundă de audio, 40 de tokens, astfel încât antrenarea se desfășoară la aceeași viteză ca în cazul textului singur; modelele înțeleg imaginile și sunetul, dar generează doar text, iar componenta audio rămâne experimentală. Ele primesc și un mod de raționament opțional și un context de 262 144 de tokens, de patru ori mai lung. Autorii recunosc că rămân în urma celor mai bune modele deschise, menționând totuși că 8B depășește modelele de aceeași dimensiune în respectarea instrucțiunilor și în sarcinile multilingve, fără a oferi un scor numeric în articol. Rezultatele sunt publicate în formatul Every Eval Ever, conceput pentru conformitatea cu AI Act european.
🔗 Notele de versiune pentru Apertus 1.5 (Hugging Face)
Jev 1.14: TypeSafe pune la dispoziție în versiune preliminară imaginile, întrebările Box și un context de patru ori mai lung
14 octombrie — TypeSafe anunță Jev 1.14, o nouă versiune a modelului său de decizie, prezentată drept „nouă și îmbunătățită”, fără cifre care să susțină afirmația. Aceasta vine cu trei funcții experimentale: imaginile, care pot fi plasate oriunde putea fi folosit textul și care devin disponibile și pentru versiunea actuală Jev; un nou tip de întrebare System One, Box, care returnează chenarul unui obiect dintr-o imagine sub forma a patru margini exprimate ca fracțiuni din lățimea și înălțimea imaginii; și un context de patru ori mai lung, deși TypeSafe recomandă în continuare limitarea lui. Aceste funcții rămân în versiune preliminară, nu sunt încă pregătite pentru producție potrivit TypeSafe și se activează cu antetul TypeSafe-Danger-Zone-Images: true; întrebările Box necesită Jev 1.14, apelat cu jev-preview sau jev-1.14.0. Zed a salutat lansarea, citându-l pe Wes Bos, care estimează costul unei întrebări despre o imagine de 850 × 850 pixeli la 0,000096936 dolari, adică aproximativ 10 000 de imagini pentru un dolar: un calcul al lui Wes Bos, nu un tarif publicat de TypeSafe.
🔗 Anunțul TypeSafe · Documentația Box
IA pentru știință: CERN și Mistral vizează un Large Physics Model, Sakana AI prezintă The Agentic Scientist, OpenAI finanțează matematicienii
Trei moduri de a pune IA în slujba cercetării: un model de fundație pentru fizica acceleratoarelor de particule, agenți de programare coordonați pentru a desfășura o cercetare de la început până la sfârșit și fonduri pentru ca matematicienii să verifice rezultatele produse de IA.
CERN și Mistral se asociază pentru a dezvolta un Large Physics Model
15 octombrie — CERN și Mistral au semnat o declarație de intenție (statement of intent) în vederea unui parteneriat strategic pe termen lung dedicat modelelor de fundație pentru descoperirea științifică. În centrul proiectului: un singur Large Physics Model preantrenat, pe care CERN îl prezintă drept primul model de fundație pentru fizica acceleratoarelor de particule, antrenat pe miliarde de coliziuni proton-proton simulate la Marele Accelerator de Hadroni (LHC). Acesta trebuie să îndeplinească mai multe sarcini simultan: să reconstruiască coliziunile, să identifice particulele, să detecteze semnale neașteptate și să evalueze viitoare proiecte de detectoare, acolo unde analiza se bazează astăzi pe un lanț de algoritmi specializați. CERN a stocat deja aproximativ un exaoctet (un milion de teraocteți) de date experimentale de la LHC, iar numărul coliziunilor ar urma să crească de zece ori odată cu LHC cu luminozitate ridicată (HL-LHC), așteptat în jurul anului 2030. Comunicatul îi citează pe Enrica Porcari, directoare pentru tehnologia informației la CERN, și Johannes Brandstetter, vicepreședinte pentru IA în inginerie la Mistral, dar nu precizează nicio sumă, niciun calendar și nicio resursă de calcul.
🔗 Comunicatul CERN · Firul de postări @MistralAI
The Agentic Scientist: Sakana AI coordonează agenți de programare pentru a desfășura o cercetare de la început până la sfârșit
15 octombrie — Sakana AI prezintă The Agentic Scientist, noua generație a AI Scientist, proiectul care testează din 2024 până unde poate o IA să desfășoare singură o cercetare. Punctul de plecare este o constatare:
Coding agents such as Codex and Claude Code now carry out long software tasks on their own. Handing them a research problem, however, tends to produce a strong hyperparameter optimizer rather than a scientist: scores go up, but ideas stay narrow, and the reasons for the gain are rarely examined.
🇷🇴 Agenții de programare precum Codex și Claude Code duc acum singuri la capăt sarcini software de lungă durată. Totuși, încredințarea unei probleme de cercetare unui astfel de agent produce mai degrabă un excelent optimizator de hiperparametri decât un om de știință: scorurile cresc, dar ideile rămân limitate, iar motivele îmbunătățirii sunt rareori analizate. — @SakanaAILabs pe X
Răspunsul este un cadru construit în jurul unor agenți de programare existenți (Codex, Claude Code, OpenCode, Pi): agenți paraleli testează ipoteze în raport cu grile de evaluare stabilite înaintea oricărui experiment, își împărtășesc succesele și eșecurile într-o memorie comună, apoi sistemul parcurge evaluările de referință, ablațiile, evaluarea finală sigilată și analizele, până la redactarea articolului. Sakana AI l-a evaluat pe 5 subiecte cu 9 modele (4 GPT, 4 Claude, 1 DeepSeek) și 4 harness-uri, adică 14 combinații model-harness și 70 de campanii de cercetare: modelele cele mai recente produc articole mai bune, iar alegerea harness-ului contează mai puțin decât cea a modelului. O versiune de dezvoltare a scris împreună cu cercetători un articol despre Error Diffusion, o regulă de învățare inspirată din biologie, acceptat pentru o prezentare orală la ALIFE 2026; în recuperarea informațiilor factuale din documente lungi (Doc-to-LoRA), sistemul crește acuratețea de la 52 % la 98 % fără a reantrena modelul. Codul este deschis sub Apache 2.0; Sakana AI reamintește că oamenii trebuie în continuare să aleagă întrebările și să verifice afirmațiile și că agenții rulează cu toate permisiunile, fiind recomandat Docker.
🔗 Articolul Sakana AI · Articolul de pe arXiv · Depozitul AI-Scientist-v3
OpenAI acordă 5 milioane de dolari unei inițiative a Simons Foundation pentru matematicieni
15 octombrie — OpenAI anunță o contribuție de 5 milioane de dolari la o nouă inițiativă a Simons Foundation, menită să ajute matematicienii să examineze, să înțeleagă și să dezvolte rezultatele produse de IA, inclusiv pe cele publicate recent de OpenAI. Pe 6 octombrie, compania publicase 722 de manuscrise cu rezultate matematice obținute de un model intern nepublicat, avertizând că unele rezultate neformalizate puteau conține erori. Fondurile vor fi gestionate și alocate de fundație și vor servi la organizarea de ateliere, conferințe și programe speciale; OpenAI va oferi, de asemenea, acces la modelele sale și la resurse de calcul cercetătorilor sprijiniți de Simons Foundation. Mesajul îl citează pe cel al Simons Foundation, care alocă în total 15 milioane de dolari pentru ateliere și inițiative, cu resurse de calcul gratuite pentru cercetătorii pe care îi sprijină, prin noi parteneriate cu Anthropic și OpenAI. Anunțul, făcut într-un simplu mesaj pe X, nu precizează nici numele inițiativei, nici calendarul acesteia.
🔗 Anunțul OpenAI · Cele 722 de manuscrise din 6 octombrie (OpenAI)
Claude Opus 5.5: modul rapid iese din etapa de previzualizare pentru cercetare, la 8 și 40 de dolari per milion de tokens
15 octombrie — Modul rapid (fast mode) al Claude Opus 5.5 iese din etapa de previzualizare pentru cercetare pe Claude Platform, fără listă de așteptare. Este același model, cu aceleași ponderi, furnizat cu până la 2,5 ori mai mulți tokens de ieșire pe secundă și facturat la dublul tarifului standard al Opus 5.5. Cererile nu mai au nevoie de antetul beta fast-mode-2026-02-01 (cele care îl trimit în continuare sunt acceptate), iar fiecare nivel de utilizare dispune acum de o limită implicită de debit pentru acest mod, distinctă de cea a Opus la viteză standard.
| Model Claude în modul rapid | Stare la 15 octombrie | Tarif per milion de tokens (intrare / ieșire) |
|---|---|---|
| Opus 5.5 | Disponibil, fără listă de așteptare și fără antet beta | 8 / 40 dolari (4 / 20 la viteză standard) |
| Opus 5 | Previzualizare pentru cercetare, antet beta obligatoriu | 10 / 50 dolari |
| Opus 4.8 | Previzualizare pentru cercetare, antet beta obligatoriu | 10 / 50 dolari |
Câștigul privește debitul de ieșire, nu timpul până la primul token, iar schimbarea vitezei invalidează cache-ul pentru prompt; modul rămâne indisponibil cu API Batch. Este oferit și în Microsoft Foundry pentru implementările găzduite pe Azure, lucru confirmat acum de documentație; Google Cloud urmează să îl ofere potrivit @ClaudeDevs, iar modul rămâne indisponibil pe Amazon Bedrock și Claude Platform on AWS. În Claude Code nu se schimbă nimic: modul rapid continuă să consume credite de utilizare suplimentare.
🔗 Anunțul @ClaudeDevs · Documentația modului rapid
Bibliotecile Hugging Face: Transformers 5.20.0 și TRL 1.16.0 integrează Muse Spark Open
Cele două biblioteci principale ale Hugging Face apar în ziua lansării Muse Spark Open și oferă suport pentru acesta, fiecare cu propriile noutăți.
Transformers 5.20.0: șapte modele adăugate și cuantizare la export
15 octombrie — Hugging Face publică Transformers 5.20.0, o versiune axată pe apariția Muse Spark Open, pentru care oferă suport chiar din ziua lansării. Alte șase modele intră în bibliotecă.
| Model adăugat în Transformers | Dezvoltatorul modelului | Particularitate tehnică |
|---|---|---|
| Muse Spark Open | Meta | MoE multimodal, 816 miliarde de parametri, dintre care 42 de miliarde activi |
| Ling 3.0 Flash | InclusionAI | MoE hibrid, cinci straturi Kimi Delta Attention la un strat MLA |
| Kolibri 1 | Aleph Alpha | MoE de raționament germană-engleză, 6 experți din 384 per token |
| MiniCPM-V 4.7 | OpenBMB | Poziții canvas M-RoPE pentru imagini și video |
| UnlimitedOcr | Baidu | OCR cu 3 miliarde de parametri, cache KV constant |
| UltraBERT | DMIS Lab | Encodere cu 150M și 380M parametri, context de 32K tokens |
| MOSS-Transcribe-Diarize | OpenMOSS | 0,9 miliarde de parametri, transcriere și diarizare în peste 50 de limbi |
În privința instrumentelor, exportatoarele pot acum să cuantifice în timpul exportului către ONNX, OpenVINO sau ExecuTorch, iar punctele de control ale antrenărilor FSDP combinate cu paralelismul tensorial pot fi reîncărcate într-o altă configurație. Hugging Face avertizează totuși asupra unei regresii de viteză la inferența cu paralelism al experților, aflată în curs de remediere, și asupra mai multor modificări incompatibile cu versiunile anterioare, inclusiv eliminarea metodelor de cache marcate ca învechite.
🔗 Notele de versiune pentru Transformers 5.20.0
TRL 1.16.0: antrenare pe AWS Trainium și AsyncGRPO de până la 3,1 ori mai rapid
15 octombrie — TRL 1.16.0 face biblioteca de antrenare de la Hugging Face compatibilă cu cipurile Trainium de la AWS: o nouă setare implicită împiedică Trainium să recompileze la fiecare nouă lungime de secvență, înjumătățind durata unui mic test de antrenare, cu 20 de pași SFT pentru Qwen3-0.6B pe Trainium2 încheiați în 130 de secunde în loc de 260. Cealaltă noutate vizează învățarea prin întărire a agenților: în traiectoriile generate (rollouts) cu mai multe runde sau mai multe generări, același început de conversație se repetă de la un rând la altul, iar AsyncGRPO îl organizează acum într-un arbore de prefixe pentru a-l calcula o singură dată. Pe Qwen3-1.7B, cu 32K de tokens pe traiectorie, viteza crește de 3,10 ori, iar consumul maxim de memorie scade de la 35,2 la 13,5 Gio; fără un prefix comun, costul suplimentar este de aproximativ 1 %. Versiunea oferă și suport pentru Muse Spark Open, care poate fi ajustat cu LoRA pe 64 de GPU H100 (14,2 secunde pe pas, 40,2 Go pe GPU), precum și pentru GPU AMD în componentele de antrenare asincronă.
🔗 Notele de lansare pentru TRL 1.16.0
GPT-Live-1.1: voci noi și accente mai naturale în ChatGPT, Codex și dots
15 octombrie — OpenAI își actualizează modelul vocal. GPT-Live-1.1 și varianta sa mai compactă, GPT-Live-1.1 Quip, prezentată ca o versiune mini a modelului, sunt introduse în modul vocal din ChatGPT, Codex și dots, agenții permanenți lansați pe 29 septembrie, cu accente mai naturale de la o limbă la alta. Modelul diversifică și frazele scurte pe care le rostește când pornește o căutare: OpenAI rezumă îmbunătățirea prin „mai puține verific…”.
Șase limbi primesc voci Live noi: franceza, germana, hindi, japoneza, coreeana și spaniola din Mexic, la care se adaugă o voce în engleză numită Bubbie; vocile disponibile pot varia în funcție de regiune și de cont și se aleg din Settings > Voice. Actualizarea este distribuită începând cu 15 octombrie tuturor utilizatorilor și va ajunge „în curând” în API, unde GPT-Live-1 este disponibil din 10 septembrie la 0,05 dolari pe minut. OpenAI nu publică niciun benchmark și nici repartizarea GPT-Live-1.1 și Quip între abonamente.
🔗 Anunțul OpenAI · Notele de lansare pentru ChatGPT
Universal Cart: Google lansează în Statele Unite un coș comun pentru Google Search și aplicația Gemini
15 octombrie — Google lansează Universal Cart în Statele Unite. Acest coș de cumpărături „inteligent”, prezentat în avanpremieră la Google I/O în mai, este introdus atât în Google Search, inclusiv în AI Mode, cât și în aplicația Gemini: un produs adăugat din oricare dintre aceste interfețe rămâne în același coș, indiferent de magazin. Articolul oferă exemplul unei genți adăugate în AI Mode, apoi al unui pulover și al unui luciu de buze adăugate în aplicația Gemini, care se regăsesc împreună mai târziu.
| Funcția Universal Cart | Ce oferă potrivit Google |
|---|---|
| Coș pentru mai multe magazine | Un singur coș păstrat de la o interfață Google la alta |
| Alerte de preț și stoc | Scăderi de preț și reveniri în stoc, pentru peste 60 de miliarde de fișe din Shopping Graph |
| Integrare cu Google Wallet | Beneficiile cardurilor salvate pentru alegerea metodei de plată, coduri promoționale relevante |
| Plata cumpărăturilor | Google Pay din coș (Universal Commerce Protocol) sau redirecționare către site-ul comerciantului |
Plata directă funcționează la Nike, Sephora, Target, Ulta Beauty, Walmart, Wayfair și numeroși comercianți Shopify; în toate cazurile, comerciantul rămâne vânzătorul și gestionează confirmările și serviciul de relații cu clienții. Google încadrează instrumentul printre funcțiile care îi lasă cumpărătorului controlul, alături de eforturile sale privind capabilitățile agentice care acționează în numele acestuia. Nu este anunțată nicio dată pentru alte țări.
🔗 Universal Cart (blogul Google)
Manus Automations: sarcini recurente lansate conform unui program sau pe baza unui declanșator
15 octombrie — Manus lansează Automations, care pune munca repetitivă „pe pilot automat”: utilizatorul descrie când trebuie să înceapă sarcina și cum trebuie să arate rezultatul. Există trei moduri de lansare: un program, de exemplu în fiecare zi lucrătoare la ora 8; un declanșator asociat unei aplicații conectate, precum o factură primită în Gmail; și, în beta, o automatizare avansată care combină mai multe surse și condiții descrise de utilizator. Funcția continuă Scheduled Tasks 2.0 din mai și automatizările declanșate de evenimente anunțate odată cu Manus 2.0 pe 28 septembrie. Firul de postări nu precizează nici abonamentul necesar, nici costul în credite.
Pe scurt
Agenți și instrumente pentru cod
- Notele de lansare Devin din 14 octombrie — Cu o zi înaintea lansării Devin Oncall, Devin adaugă Splunk, Elastic, Dynatrace, Chronosphere și Google Cloud Monitoring ca pluginuri de observabilitate, un rol Review manager care gestionează regulile de revizuire fără drepturi de administrare și exportul constatărilor de code scan în format SARIF 2.1.0, pe lângă CSV. 🔗 sursă
- Warp și fabricile sale de software — În două articole despre metodologie, fără vreo funcție nouă, Zach Lloyd, fondatorul Warp, afirmă că a redus costul per PR al echipei sale de la 80 la 20 de dolari în șase săptămâni, cu mai puține reveniri la versiuni anterioare și un ritm de livrare a PR-urilor cu 40 % mai mare decât în luna precedentă. 🔗 sursă
- Qwen Code v0.25.2 — Versiunea devine stabilă la două zile după versiunea preliminară din 13 octombrie, cu 68 de pull requests care lipseau din aceasta, dintre care 11 funcționalități (glisarea și plasarea fișierelor în Web Shell, recitirea mesajelor MCP Apps înainte de trimitere, anularea sarcinilor de workflow și persistență în 32 de tabele pentru Managed Agent) și 38 de remedieri. 🔗 sursă
- Copilot CLI 1.0.99 în versiune preliminară — Două versiuni preliminare în aceeași zi, fără o versiune stabilă: sandbox-ul permite implicit accesul la rețeaua locală, /share deschide un meniu pe tot ecranul, pluginurile din depozitele de încredere se instalează automat, iar Skills și pluginurile verificate se instalează dintr-un link GitHub. 🔗 sursă
- SDK Antigravity 0.1.22 — Adaugă orchestrarea workflow-urilor dinamice și skills definite în memorie: într-o actualizare din 11 octombrie relatată cu întârziere, SDK-ul Python oferă în beta componente tipizate (
phase,agent,parallel,pipeline) pentru scrierea workflow-urilor de agenți, skills declarate fără fișier (InlineSkill) și o limită de tokens de ieșire pe etapă care depășește 64k de tokens. 🔗 sursă - google/adk-recipes — Succesor restructurat al adk-samples, depozitul de exemple pentru Agent Development Kit de la Google este acum conceput pentru asistenții de programare: fiecare rețetă oferă un
manifest.yamlși unAGENTS.md, primul plugin de domeniu vizează comerțul cu amănuntul, iar Horizon servește drept harness de referință pentru agenții care lucrează pe parcursul mai multor zile. 🔗 sursă - DeepSeek Harness 0.2.1-alpha.4 — A 28-a versiune preliminară, în continuare fără o versiune stabilă: efortul de raționament se configurează pentru fiecare model în parte pentru API-urile personalizate, direct din interfață, iar pluginurile se instalează din indexuri personalizate; în aceeași zi, FlashMLA trece la interfața binară stabilă a CPython și LibTorch. 🔗 sursă
- Trei modele sunt retrase din Copilot pe 16 noiembrie — Claude Opus 4.8 și Claude Opus 5, de înlocuit cu Claude Opus 5.5, și GPT-5.6 Terra, de înlocuit cu GPT-6.1 Sol sau GPT-6 Luna; abonații individuali cu abonament anual păstrează Claude Opus 4.8, iar modelele înlocuitoare se activează automat în Business și Enterprise. 🔗 sursă
Asistenți, companii și ghiduri
- Genspark în aplicațiile de mesagerie — Utilizatorii îi scriu lui @genspark_ai în iMessage, WhatsApp, Slack sau LINE pentru a rezuma un PDF sau a crea o prezentare, iar rezultatul revine în aceeași conversație; nu sunt precizate nici abonamentul, nici tariful. 🔗 sursă
- Kimi Work 3.2.17 și un al treilea tutorial — La trei zile după 3.2.16, conversațiile afișează imagini, iar controlul de la distanță permite alegerea modului Agent Swarm; Moonshot AI publică și un al treilea videoclip introductiv, despre automatizarea fluxurilor de lucru, fără vreo funcție prezentată ca nouă. 🔗 note de lansare · 🔗 tutorial
- Burse Anthropic — Înscrieri deschise până pe 28 octombrie pentru STEM Fellows și o nouă bursă, Conceptual Reasoning Fellows (filozofie, științe cognitive, economie, politici publice, drept): patru luni cu normă întreagă, din 12 ianuarie până pe 8 mai 2027, remunerate cu între 100 000 și 167 000 de dolari, cu autorizație de muncă în Statele Unite obligatorie. 🔗 sursă
- Compliance API pentru Claude Enterprise — În beta, API-ul le returnează administratorilor instrucțiunile personale salvate de fiecare membru în claude.ai și în Cowork; în ziua precedentă, implementările programate ale Managed Agents deveniseră disponibile pe Claude Platform on AWS. 🔗 sursă
- Block și OpenAI Daybreak — Într-un studiu de caz OpenAI din 14 octombrie, echipa de securitate a Block (Square, Cash App, Afterpay) afirmă că a redus la 18 minute timpul de la raportarea unei vulnerabilități până la propunerea unei remedieri în cadrul exercițiilor de atac simulat și a economisit aproximativ 600 de ore de lucru ale analiștilor pe trimestru. 🔗 sursă
- AI for Educators în portugheza braziliană — De Ziua Profesorilor, OpenAI publică această versiune a cursului său gratuit pe OpenAI Academy, destinat profesorilor din învățământul primar până la cel universitar, și reamintește de Study Mode din ChatGPT. 🔗 sursă
- Superwhisper Meetings — Superwhisper lansează un instrument de înregistrare și luare de notițe la ședințe, pe care îl prezintă drept primul care funcționează integral local, bazat pe Tiny Aya și Cohere Transcribe; nu sunt indicate nici prețul, nici platformele. 🔗 sursă
- Trei ghiduri Cohere — Fără produse sau cifre noi, Cohere publică articole despre IA la operatorii de energie și utilități, axate pe North, despre proliferarea agenților în companii, cu ideea de a pune în competiție un agent challenger și agentul existent, și despre măsurarea rentabilității investiției. 🔗 utilități · 🔗 agenți · 🔗 ROI
- Ghidul Perplexity despre cercetare — Un ghid trece în revistă 12 articole fundamentale despre IA și șase lucrări recente, compară instrumentele de cercetare asistată și propune un cadru în șapte etape; nicio funcționalitate nouă. 🔗 sursă
Conținut media generativ
- Suno — Două funcții de colaborare: spații de lucru partajate cu acces de citire sau editare doar pentru invitați (Pro și Premier) și modele personalizate care pot fi partajate cu colaboratorii, ajustabile cu de două ori mai multe intrări (Premier). 🔗 sursă
- Eleven v4 în teste în orb — ElevenLabs afirmă că ascultătorii au considerat Eleven v4 mai expresiv decât alte modele vocale în fiecare test în orb desfășurat în opt limbi, fără să numească concurenții sau să ofere un scor în text. 🔗 sursă
- Shot Coverage de la Luma — Funcția generează, dintr-un singur plan video, mai multe unghiuri de filmare cu camera în mișcare, utilizabile la montaj; anunțul nu precizează nici modelul, nici tariful, nici data disponibilității. 🔗 sursă
- HeyGen și Jan Hotovec — HeyGen îl prezintă pe Jan Hotovec, care are paralizie cerebrală și care a creat, împreună cu Fameplay și Nolimi, un avatar cu chipul și vocea sa pentru a-și povesti viața cu propriile cuvinte. 🔗 sursă
Cercetare, calcul și infrastructură
- NVIDIA și AI in Science Enablers Initiative — La AI in Science Summit din Dublin, NVIDIA se alătură inițiativei Comisiei Europene cu modelele sale deschise, un hub de materiale de curs deschise de la Deep Learning Institute și acces la resurse de calcul prin AI factories naționale, fără o sumă anunțată. 🔗 sursă
- NVIDIA în țările nordice — Înainte de GTC Berlin, NVIDIA face bilanțul ecosistemului său nordic: supercomputerul Sferical One (1 152 GPU GB300), 1 gigawatt de cloud IA planificat până la sfârșitul lui 2027 și un Stockholm AI Lab împreună cu fundația Norrsken în 2027; keynote-ul GTC Berlin este programat pe 21 octombrie. 🔗 sursă
- Tokenizarea BERT de 50 de ori mai rapidă — Simon Brandeis, de la Hugging Face, explică modul în care viitoarea versiune 1.0 a tokenizers face tokenizerul BERT de aproximativ 50 de ori mai rapid decât cu versiunea 0.23, prin tratarea separată a caracterelor ASCII; modificările sunt încă în curs de revizuire. 🔗 sursă
GitHub, fără legătură cu IA
- Sfârșitul e-mailurilor de push — GitHub nu mai trimite e-mailuri de notificare pentru evenimentele de push din depozite, care puteau fi folosite pentru spam, și recomandă un workflow GitHub Actions cu propriul server SMTP. 🔗 sursă
- Licențele GitHub Code Quality — Un raport CSV listează fiecare committer activ care consumă o licență și depozitele modificate într-un interval de 90 de zile, pentru identificarea licențelor care pot fi eliberate, în GitHub Team și Enterprise Cloud. 🔗 sursă
Ce înseamnă acest lucru
Modelele deschise cresc în amploare, iar ecosistemul lor ține acum pasul încă din prima zi. Muse Spark Open vine cu șapte furnizori de API, ponderi NVFP4 produse de Meta și suport imediat în Transformers, TRL, mlx-lm și Unsloth; Nemotron 3.5 Super VL publică ponderi, date și rețete de antrenare; FLUX 3 Image Klein intră în Diffusers și ComfyUI chiar în ziua lansării. Dar „deschis” presupune condiții foarte diferite: Muse Model License limitează utilizarea comercială, licența FLUX Kommunity este gratuită doar pentru o cifră de afaceri anuală sub 5 milioane de dolari, licența ponderilor Timestral exclude companiile care depășesc 20 de milioane de dolari pe lună, în timp ce Apertus 1.5 își publică ponderile sub Apache 2.0, împreună cu datele de antrenare. Superlativul folosit de Meta amintește, în cele din urmă, că această cursă se desfășoară și între țări: Muse Spark Open se prezintă drept cel mai bun model deschis american, dar GLM 5.3 și Kimi K3 rămân înaintea lui în clasamentul Artificial Analysis și la programare.
Securitatea cibernetică devine un domeniu în care IA găsește și corectează vulnerabilități la scară largă. Prin achiziția AISLE, Cohere cumpără o expertiză care revendică descoperirea a peste 500 de vulnerabilități necunoscute anterior, GitHub pune la dispoziția tuturor un AI Scan pentru limbajele pe care CodeQL nu le acoperă și un autofix care rulează din nou CodeQL pentru a-și verifica propria corecție, iar Block afirmă că reduce la 18 minute timpul de la identificarea unei vulnerabilități până la propunerea unei corecții în exerciții de atac simulat. Aceste instrumente rămân sub control uman: rezultatele AI Scan sunt consultative, autofix deschide un pull request în stadiu de ciornă, iar Code Review din Claude Code nici nu aprobă, nici nu blochează un merge. Cealaltă latură este izolarea agenților înșiși: SPACE, acum deschis, păstrează datele de autentificare și traficul de ieșire în afara mașinii virtuale, iar IPI Black plătește atacatori pentru a măsura rezistența agenților la injectarea indirectă de prompturi.
Încrederea se construiește și prin evaluări externe. Oferind unui grup de șase persoane de la METR un acces comparabil cu cel al unui angajat, fără drept de veto asupra publicațiilor lor, Anthropic merge dincolo de un audit punctual și compară mecanismul cu cel al examinatorilor rezidenți din marile bănci. Aceeași cerință de verificare se regăsește în cercetare: Sakana AI stabilește grilele de evaluare înaintea oricărui experiment, pentru ca agenții de programare să nu se limiteze la optimizarea unui scor, iar OpenAI finanțează, prin Simons Foundation, matematicieni însărcinați să examineze rezultatele produse de IA, după cele 722 de manuscrise ale sale din 6 octombrie. CERN și Mistral anunță cea mai amplă ambiție, un Large Physics Model antrenat pe miliarde de coliziuni simulate, dar fără o sumă sau un calendar.
În privința instrumentelor, compromisul dintre cost, viteză și calitate devine explicit. La OpenAI, GPT-6.1 Sol cu nivelul de efort Ultra regăsește 92 % dintre constatările GPT-6 Astra Ultra la 14 % din cost; modul rapid al Opus 5.5 oferă un debit de 2,5 ori mai mare la un preț dublu; Code Review facturează tokenii consumați, în limita unui plafon lunar. Agenții se instalează și în sarcinile nesupravegheate: Devin Oncall preia turele de gardă, Claude Code 2.1.301 nu mai așteaptă o limită de utilizare îndepărtată și înregistrează fiecare verdict al clasificatorului său, iar modul Auto din Antigravity CLI încredințează unui agent separat revizuirea comenzilor care ar ieși din sandbox. Testele de evaluare țin cu greu pasul: pe SREGym-Lite, Devin Oncall și CloudThinker ating ambele 100 % cu GPT-6 Astra.
Surse
- Anunțul Muse Spark Open (@AIatMeta)
- Muse Spark Open (blogul de cercetare Meta)
- Fișa Muse-Spark-Open-816B-A42B (Hugging Face)
- Muse Spark Open (blogul Hugging Face)
- Muse Spark Open pe GB300 NVL72 (blogul tehnic NVIDIA)
- Nemotron 3.5 Super VL (blogul NVIDIA)
- Nemotron 3.5 Super VL (blogul tehnic NVIDIA)
- Nemotron 3.5 Super VL în Perplexity (@perplexity_ai)
- Changelog pentru API-ul Perplexity
- Cohere întâmpină AISLE (@aidangomez)
- Cohere va achiziționa AISLE (blogul Cohere)
- AISLE și Cohere își unesc forțele (blogul AISLE)
- AI Scan pentru pull requests este disponibil pe scară largă (changelog GitHub)
- Autofix bazat pe agenți pentru alertele de scanare a codului (changelog GitHub)
- Publicarea SPACE ca open source (Perplexity)
- SPACE în open source (@perplexity_ai)
- Repository perplexityai/SPACE (GitHub)
- FLUX 3 Image Klein (blogul Black Forest Labs)
- FLUX 3 Image Klein (@bfl_ai)
- FLUX 3 Image Klein în Diffusers (blogul Hugging Face)
- Kling 4.0 disponibil integral (@Kling_ai)
- Note de lansare Kling
- Prezentăm Instant Soundtracks (blogul ElevenLabs)
- Prezentăm Devin Oncall (blogul Cognition)
- Devin Oncall (@cognition)
- Pagina Devin Oncall
- Note de lansare Claude Code 2.1.301 (GitHub)
- Code Review este acum disponibil pe scară largă (Claude)
- Documentația Code Review (Claude Code)
- Note de lansare Delta 0.20
- DeltaDB: Viitorul controlului versiunilor (blogul Delta)
- Changelog pentru Antigravity CLI
- Întreținerea software-ului cu familia GPT-6 (OpenAI Developers)
- Următoarea interfață pentru dezvoltatori este inteligența ambientală (blogul GitHub)
- Noutăți despre evaluatorii independenți (Anthropic)
- IPI Black (@GraySwanAI)
- Pagina concursului IPI Black (Gray Swan)
- IPI Black potrivit lui Boris Cherny (@bcherny)
- Prezentăm Timestral (Mistral)
- Timestral-209M (Hugging Face)
- Step 5 Preview de la StepFun (@NVIDIAAI)
- Note de lansare Apertus 1.5 (blogul Hugging Face al Swiss AI)
- Jev 1.14 (@typesafeai)
- Întrebările Box (documentația TypeSafe)
- CERN și Mistral (comunicatul CERN)
- Large Physics Model (@MistralAI)
- Cercetătorul agentic (@SakanaAILabs)
- Cercetătorul agentic (Sakana AI)
- Cercetătorul agentic (arXiv)
- Repository AI-Scientist-v3 (GitHub)
- Inițiativa Simons Foundation (@OpenAI)
- Prezentarea progreselor AI în matematică (OpenAI)
- Modul rapid al Opus 5.5 (@ClaudeDevs)
- Documentația modului rapid (Claude Platform)
- Note de lansare Transformers 5.20.0 (GitHub)
- Note de lansare TRL 1.16.0 (GitHub)
- GPT-Live-1.1 (@OpenAI)
- Note de lansare ChatGPT
- Universal Cart (blogul Google)
- Manus Automations (@ManusAI)
- Note de lansare Devin din 14 octombrie
- Lansarea fabricilor de software (blogul Warp)
- Qwen Code v0.25.2 (GitHub)
- Copilot CLI 1.0.99-1 (GitHub)
- Changelog pentru SDK-ul Antigravity
- google/adk-recipes (Google Developers)
- DeepSeek Harness 0.2.1-alpha.4 (GitHub)
- Retragerea unor modele din Copilot în noiembrie (changelog GitHub)
- Genspark în aplicațiile de mesagerie (@genspark_ai)
- Note de lansare Kimi Work
- Al treilea tutorial Kimi Work (@Kimi_Moonshot)
- Burse Anthropic (@AnthropicAI)
- Note de lansare Claude Platform
- Studiu de caz Block (OpenAI)
- AI for Educators în portugheza braziliană (OpenAI)
- Superwhisper Meetings (@cohere)
- Implementarea AI în sectorul utilităților (blogul Cohere)
- Cum se gestionează proliferarea agenților în companii (blogul Cohere)
- Cum se măsoară ROI pentru AI (blogul Cohere)
- Cercetare în AI: lucrări importante și instrumente de top pentru cercetători (Perplexity)
- Spații de lucru partajate (@suno)
- Eleven v4 testat în orb (@ElevenLabs)
- Shot Coverage (@LumaLabsAI)
- Jan Hotovec și avatarul său (@HeyGen)
- NVIDIA și AI in Science Enablers Initiative (blogul NVIDIA)
- Ecosistemul nordic NVIDIA (blogul NVIDIA)
- Tokenizarea BERT de 50 de ori mai rapidă (blogul Hugging Face)
- Încetarea e-mailurilor de push (changelog GitHub)
- Licențe GitHub Code Quality în CSV (changelog GitHub)