ai-powered-markdown-translatorArtículo traducido del francés al español con gpt-6.1-sol.
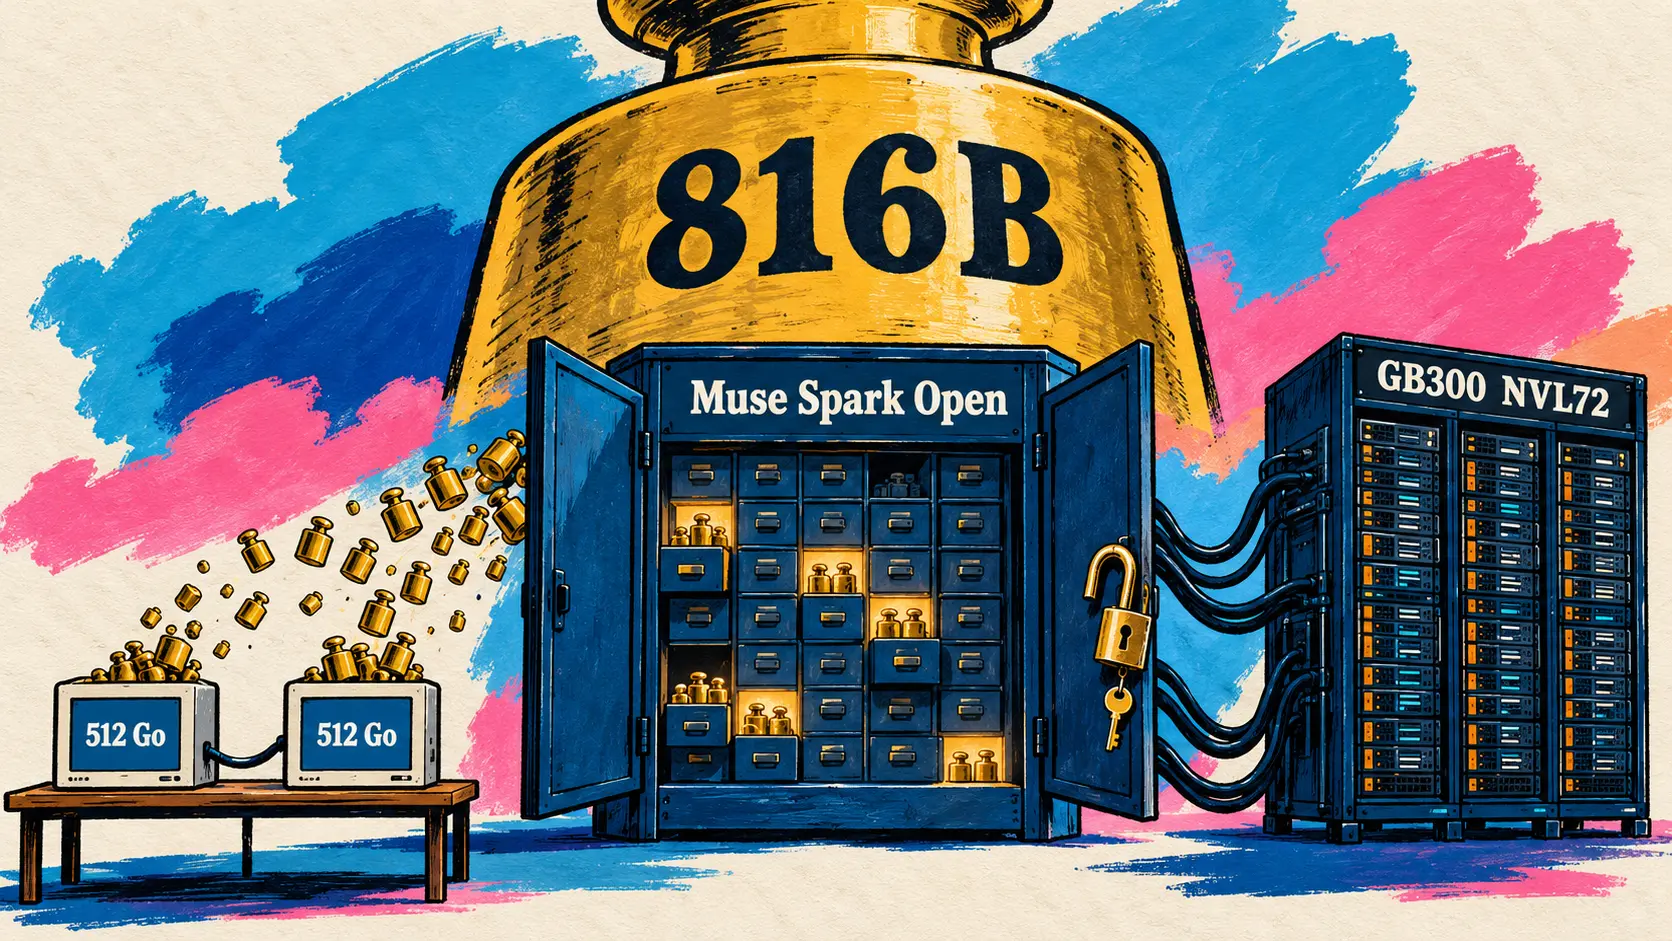
Meta publica los pesos de Muse Spark Open, una mezcla de expertos multimodal de 816 mil millones de parámetros que presenta como el modelo abierto estadounidense con mejor rendimiento, con soporte desde el mismo día de NVIDIA, Hugging Face y siete proveedores de API. NVIDIA también publica Nemotron 3.5 Super VL, un modelo de 120 mil millones de parámetros para agentes, mientras que Cohere firma una carta de intenciones para comprar AISLE, especialista en el descubrimiento autónomo de vulnerabilidades, y crea Cohere Cyber. Perplexity publica como open source SPACE, el sandbox de Computer, Black Forest Labs publica los pesos de FLUX 3 Image Klein y Cognition lanza Devin Oncall, un agente de guardia que investiga los incidentes de producción.
Muse Spark Open: Meta publica un MoE multimodal de 816 mil millones de parámetros, NVIDIA y Hugging Face se suman el mismo día
15 de octubre — Meta publica los pesos de Muse Spark Open, una mezcla de expertos (mixture-of-experts, MoE) multimodal de 816 mil millones de parámetros, de los cuales 42 mil millones están activos por token, con una ventana de contexto de un millón de tokens. El modelo lee texto, imágenes, vídeo y audio, y responde en texto; Meta lo ha entrenado para el código y el trabajo con agentes. En la familia Muse, pasa a ser el gran modelo abierto, por encima de Muse Glimmer, el pequeño modelo denso de 30 mil millones de parámetros publicado en agosto, y llega tres días después de Muse Wonder, que sigue siendo cerrado.
Today we’re releasing Muse Spark Open, the most capable US open-weight model to date. Built for coding and agentic work, it excels at long-horizon tasks, complex software engineering, and multi-step reasoning.
🇪🇸 Hoy publicamos Muse Spark Open, el modelo estadounidense de pesos abiertos con mejor rendimiento hasta la fecha. Diseñado para el código y el trabajo con agentes, destaca en tareas prolongadas, ingeniería de software compleja y razonamiento en varios pasos. — @AIatMeta en X
El superlativo debe interpretarse en sentido estricto. En la tabla de la ficha de Hugging Face, donde el modelo se evalúa con el ajuste xhigh, Muse Spark Open encabeza ocho filas de la tabla completa, entre ellas el uso de herramientas MCP y JobBench, pero los grandes modelos abiertos chinos siguen por delante en el índice de Artificial Analysis (45 para GLM 5.3, 44 para Kimi K3, frente a 39) y en código. De los otros tres modelos estadounidenses de la tabla, Inkling de Thinking Machines, Nemotron 3 Ultra de NVIDIA y Beam de Reflection AI, solo Beam lo supera en capacidades, en GPQA Diamond (90,5 frente a 89,0) y Terminal-Bench 2.1 (80,1 frente a 76,4).
| Banco de evaluación (ficha de Hugging Face) | Puntuación de Muse Spark Open (xhigh) | Mejor competidor de la tabla |
|---|---|---|
| MCP-Atlas | 89,2 | 84,5 (Qwen3.8-2.4T-A95B) |
| JobBench | 61,8 | 61,4 (GLM 5.3) |
| HLE-Diamond (sin herramientas) | 26,1 | 22,2 (Kimi K3) |
| Índice Artificial Analysis | 39 | 45 (GLM 5.3) |
| OSWorld Verified | 80,4 | 84,8 (Kimi K3) |
| DeepSWE 1.1 | 60 | 68 (Kimi K3) |
| Terminal-Bench 2.1 (Terminus 2) | 76,4 | 85,0 (Kimi K3) |
| StrongREJECT v2 (más bajo = mejor) | 0,5 | 62,9 (GLM 5.3) |
Como todos los expertos permanecen en memoria, se necesita la memoria de un modelo de 816 mil millones de parámetros para obtener la velocidad de un modelo de 42 mil millones. Los pesos BF16 ocupan aproximadamente 1,5 TB (repositorio Muse-Spark-Open-816B-A42B en Hugging Face, accesible tras rellenar un formulario), y una versión NVFP4 cabe en un solo nodo B200. Aun así, Meta insiste en la ejecución local: el modelo está optimizado para dos Mac Studio M5 Ultra conectados, con MLX, cada uno con hasta 512 GB de memoria unificada. Hugging Face ha probado una configuración más modesta, en un solo Mac M3 Ultra de 512 GB: una versión de 2 bits con llama.cpp ocupa 304 GB y produce 18 tokens por segundo.
Los pesos se publican bajo la Muse Model License, con condiciones comerciales limitadas, que según Meta permite a muchos desarrolladores utilizar el modelo de forma gratuita. Siete proveedores lo ofrecen desde el primer día: Baseten, Fireworks AI, Groq, Modal, Nebius, OpenRouter y Together AI. Meta afirma haber añadido un posentrenamiento de seguridad específico para los pesos abiertos y haber alcanzado los umbrales de publicación de su Meta Superintelligence Scaling Framework, actualizado el 2 de octubre. En StrongREJECT v2, donde una puntuación baja es mejor, el modelo obtiene 0,5, frente a entre 62,9 y 86,4 de los demás modelos evaluados. En FORTRESS, obtiene la mejor puntuación de riesgo medio (5,8, frente a entre 21,6 y 28,2), pero la puntuación más alta de rechazos excesivos de la tabla (17,4, frente a entre 2,7 y 13,3).
NVIDIA acompaña el lanzamiento con un artículo técnico: Muse Spark Open se entrenó en racks GB300 NVL72, y los checkpoints NVFP4 producidos por Meta están optimizados para Blackwell Ultra. En cargas de trabajo con agentes, NVIDIA afirma alcanzar hasta 50 000 tokens por segundo por GPU y hasta 600 tokens por segundo por usuario, y publica recetas de despliegue para SGLang, vLLM, TensorRT LLM y Dynamo, un NIM y el posentrenamiento con NeMo AutoModel.
El resto del ecosistema se ha sumado a lo largo del día: Transformers y TRL lo integran (véase más abajo), mlx-lm 0.32.0 añade la versión NVFP4, Unsloth anuncia una versión de 2 bits que cabe en unos 256 GB, y Meta proporciona para SGLang kernels Helion hasta 3,95 veces más rápidos a nivel de kernel. En su artículo, Hugging Face incluso realiza el fine-tuning del modelo completo en 64 GPU H100, con una exactitud media por token que pasa del 72 al 84 %.
🔗 El artículo de Meta · La ficha del modelo (Hugging Face) · El artículo de Hugging Face · El artículo técnico de NVIDIA
Nemotron 3.5 Super VL: NVIDIA publica un modelo multimodal de 120 mil millones de parámetros para agentes, Perplexity lo integra el mismo día
15 de octubre — NVIDIA publica Nemotron 3.5 Super VL, un modelo abierto de tipo mezcla de expertos de 120 mil millones de parámetros, de los cuales 12 mil millones están activos por token. Combina razonamiento, seguimiento de instrucciones y llamadas a herramientas con la comprensión de texto, imágenes, documentos y vídeo, para agentes que encadenan tareas largas: un mismo modelo lee una página web, un gráfico o un PDF y después actúa, sin transferir el contexto de un modelo de texto a uno de visión. Según NVIDIA, alcanza en tareas multimodales con agentes una precisión comparable a la de su mayor modelo de razonamiento, con aproximadamente una quinta parte de los parámetros.
| Evaluación anunciada por NVIDIA | Puntuación de Nemotron 3.5 Super VL | Punto de comparación |
|---|---|---|
| Hermes Bench | 63,44 % | 56,33 % (Nemotron 3 Ultra) |
| Evaluaciones de comportamiento LangChain | 87,05 % | 84,3 % (Nemotron 3 Ultra) |
| CharXiv (lectura de gráficos) | 80,8 % (84 % con código Python) | 63 % (Nemotron 3 Nano Omni) |
NVIDIA destaca sobre todo la eficiencia: en una sola GPU, un rendimiento hasta 5 veces superior al de otros modelos abiertos de su tamaño en tareas de agentes, más de 600 tokens por segundo en las tareas con agentes del índice de Artificial Analysis a través de Baseten, y 10 000 tareas de código completadas hasta 4 veces más rápido manteniendo una buena precisión en SWE-Bench Pro. Destilado a partir de Nemotron 3 Ultra, lo supera en las dos evaluaciones de harness de la tabla. En cuanto al servicio, la decodificación especulativa LiLiCorr acelera la generación hasta 2,3 veces en DGX Spark, y Dynamo atiende hasta 8 veces más usuarios en 16 GPU B200 a 50 tokens por segundo cada uno, con un 85 % menos de latencia del primer token.
La publicación es completa: pesos base, posentrenados y cuantizados en NVFP4, recetas, entornos de aprendizaje por refuerzo en NeMo Gym y conjuntos de datos abiertos, entre ellos 40 conjuntos de visión y lenguaje y un corpus de unos 2 800 mil millones de tokens en 22 lenguas de la India, elaborado con el IIT Madras y su laboratorio AI4Bharat. El modelo ha procesado unos 26 000 mil millones de tokens durante el entrenamiento. Está disponible en Hugging Face, OpenRouter, ModelScope y como microservicio NIM, sin precio anunciado; NVIDIA cita adaptaciones en Scale AI para Skydance, con un coste de inferencia anunciado dividido por 40, en Ramp, AI21 y Alice.
Perplexity lo ha añadido el mismo día para sus suscriptores Pro y Max y en su Agent API. El changelog de la API fija para perplexity/nemotron-3.5-super-120b-a12b un precio de 0,20 dólares por millón de tokens de entrada (0,04 dólares en caché) y 0,50 dólares de salida, con 1 048 576 tokens de contexto y hasta 131 072 tokens generados, en sustitución de Nemotron 3 Ultra. Una pequeña incoherencia: esta entrada describe un modelo con entrada exclusivamente de texto, mientras que el tuit de Perplexity anuncia la versión VL, que también lee imágenes.
El mismo día, Nemotron 3.5 Bolt 74B-A9B 24GB, anunciado el 13 de octubre, llega a Hugging Face: cuantizado de forma nativa en 2 bits para caber en 24 GB, está dirigido a los portátiles RTX Spark disponibles el 16 de octubre y funciona con llama.cpp, Ollama, LM Studio, Unsloth y vLLM. NVIDIA lo sitúa en primer lugar entre los modelos abiertos de su categoría en PinchBench; Bolt E4B 4GB llegará el 23 de octubre.
🔗 Anuncio de NVIDIA · Artículo técnico de NVIDIA · Anuncio de Perplexity · Changelog de la API de Perplexity
Ciberseguridad: Cohere comprará AISLE y crea Cohere Cyber, GitHub amplía la disponibilidad de AI Scan y autofix con agentes
El mismo día, dos empresas ponen la IA al servicio de la búsqueda y la corrección de vulnerabilidades: Cohere adquiere esa experiencia y GitHub amplía su disponibilidad en su code scanning.
15 de octubre — Cohere comprará AISLE, una empresa emergente que construye sistemas autónomos capaces de descubrir, validar y ayudar a corregir vulnerabilidades hasta entonces desconocidas en software crítico. Las dos empresas han firmado una carta de intenciones (Letter of Intent): la operación aún no se ha cerrado, y no se han publicado ni su importe ni su calendario. Al cerrarse, la sede de AISLE en Praga se convertirá en la oficina de Cohere en esa ciudad.
| Indicador publicado sobre AISLE | Valor anunciado |
|---|---|
| Año de creación | 2024 |
| Vulnerabilidades inéditas con un CVE asignado | Más de 500, en más de 100 bases de código |
| OpenSSL, publicación de seguridad de enero | Las 12 vulnerabilidades publicadas |
| curl, última versión | 18 de los 24 CVE |
| CVE de gravedad alta o crítica | Más de 200 (según Aidan Gomez) |
Aisle is the state-of-the-art in defensive cyber, having found 200+ High/Critical CVEs in critical software like curl, FFmpeg, FreeBSD, Wireshark.
🇪🇸 Aisle está a la vanguardia de la ciberdefensa, con más de 200 CVE de gravedad alta o crítica descubiertas en software crítico como curl, FFmpeg, FreeBSD y Wireshark. — @aidangomez en X
En el mismo hilo, Aidan Gomez, al frente de Cohere, afirma que AISLE ha obtenido mejores resultados que Glasswing (Mythos), de Anthropic, y Daybreak, de OpenAI, con 29 nuevas CVE en curl, mientras que Mythos no habría encontrado ninguna; esta cifra no coincide con los «18 de los 24 CVE» que señalan los artículos de ambas empresas.
El equipo fundador de AISLE asume puestos directivos. Ondrej Vlcek, PDG de AISLE, pasa a ser vicepresidente sénior de Cohere Cyber, una nueva unidad encargada de ofrecer soluciones de ciberseguridad a los clientes de Cohere; Jaya Baloo pasa a ser directora de seguridad de la información de Cohere a escala mundial; Stanislav Fort, CTO y científico jefe de AISLE, pasa a ser vicepresidente de seguridad de IA y trabajará con Ivan Zhang, CTO de Cohere, para vincular la investigación en seguridad con el desarrollo y el entrenamiento de los modelos.
Cohere lo ve como un paso más en su estrategia europea, tras Reliant AI y Aleph Alpha: la empresa prevé una inversión «sustancial» y a largo plazo en Praga, destinada a convertirse en su centro mundial de ciberseguridad con IA, a un corto trayecto de su nueva sede de Berlín según Aidan Gomez. El objetivo es doble: continuar el trabajo de AISLE sobre la seguridad del software open source y permitir a los operadores de infraestructuras críticas analizar su software de forma totalmente privada, incluso en entornos desconectados (air-gapped). Ambos artículos añaden un argumento relativo a los modelos: los problemas de seguridad difíciles pero verificables pueden servir para evaluar y mejorar los futuros modelos de Cohere.
🔗 El artículo de Cohere · El artículo de AISLE
GitHub: AI Scan de pull requests y el autofix agéntico de alertas pasan a disponibilidad general
15 de octubre — GitHub pone en disponibilidad general dos componentes de su code scanning basados en IA, uno que encuentra vulnerabilidades en las pull requests y otro que corrige las alertas.
AI Scan de pull requests complementa a CodeQL allí donde el analizador aún no llega: PHP, Shell/Bash, configuración de Terraform (HCL), Dockerfiles, JSP en Java o Blazor en C#. Se ejecuta automáticamente en cada pull request cuando están activos el code scanning y el ajuste AI Scan del repositorio, y sus resultados aparecen junto a los de CodeQL, marcados como «AI», a veces con una explicación del riesgo y una corrección sugerida. Son orientativos: no hacen que falle el check ni pueden bloquear una fusión, y el análisis no se ejecuta en las pull requests procedentes de forks ni en las de Dependabot.
El autofix agéntico (agentic autofix) se encarga, por su parte, de una alerta asignada a Copilot: explora los archivos afectados, propone una corrección, vuelve a ejecutar CodeQL para comprobar que la alerta se haya cerrado, itera si es necesario y después abre una pull request en borrador. Se le puede encargar una alerta de la rama por defecto, hasta 25 alertas para corregirlas en una sola pull request, o recurrir a la API REST asignando la alerta a copilot-swe-agent[bot]; una vez activado, sustituye a la opción gratuita Generate Fix.
| Componente de GitHub en disponibilidad general | Planes y condiciones | Modalidad de facturación |
|---|---|---|
| AI Scan de pull requests | Repositorios públicos; Code Security o Advanced Security para los repositorios privados e internos de organizaciones, sin licencia Copilot | Code Security AI Credits |
| Autofix agéntico de alertas | Code Security o Advanced Security en GitHub Enterprise Cloud, incluida la residencia de datos; se requieren la política Agentic autofix y un medio de facturación de Copilot | AI Credits del presupuesto de Code Security y minutos de GitHub Actions |
Los dos lanzamientos culminan una serie cubierta aquí desde septiembre: API de activación de AI Scan el 10 de septiembre, autofix agéntico basado en Copilot Memory en versión preliminar el 25 de septiembre, métricas de AI Scan en la security overview el 13 de octubre.
🔗 AI Scan para pull requests (changelog de GitHub) · Autofix agéntico para alertas de code scanning (changelog de GitHub)
SPACE: Perplexity publica como open source el entorno aislado de Computer, con licencia Apache 2.0
15 de octubre — Perplexity publica como open source SPACE (Sandboxed Platform for Agentic Code Execution), la plataforma de entornos aislados (sandboxes) que ejecuta cada tarea de Perplexity Computer. La víspera, Perplexity detallaba cómo SPACE encamina cada solicitud hacia la ejecución adecuada de un entorno aislado; ahora es el propio código el que está disponible en GitHub, con licencia Apache 2.0. Cada tarea de agente se ejecuta en su propia microVM Firecracker, y tanto las credenciales como el tráfico saliente se controlan desde fuera de la máquina virtual.
El principio de seguridad se resume en una idea: el entorno aislado se considera no fiable. Los agentes de Computer ejecutan en él comandos, instalan paquetes y llaman a servicios externos con acceso root, pero el host permanece fuera de su alcance, y una pasarela específica de cada entorno aislado aplica la política de salida a cada conexión; los agentes acceden a los servicios autorizados sin que las credenciales se almacenen en su entorno de trabajo. Un entorno aislado también sobrevive a la solicitud que lo creó: puede pausarse, duplicarse (fork) o suspenderse en una instantánea de memoria y disco, y después reanudarse.
| Elemento de SPACE | Valor indicado por Perplexity |
|---|---|
| Lenguaje y licencia del repositorio | Rust, Apache 2.0 |
| Aislamiento | Una microVM Firecracker por tarea de agente |
| Volumen en producción | Millones de entornos aislados creados al día, para todas las sesiones de Computer desde julio |
| Creación frente al proveedor anterior | De tres a cinco veces más rápida, con el mismo tráfico de producción |
| Escaping SPACE, Part I | Ningún escape al host en 108 intentos |
| Calendario de versiones | 0.8.0 como base pública, después 0.9.0 y 1.0.0 |
La evaluación Escaping SPACE de septiembre no había encontrado ningún escape de la máquina virtual al host, pero sí formas de eludir las restricciones de red: se subsanaron, y los métodos identificados dejaron de funcionar en las pruebas posteriores, según la publicación. El repositorio, escrito en Rust, se instala en local en un clúster Kubernetes de prueba (Kind), ofrece reservas de entornos aislados precalentados (warm pools) y una capa de compatibilidad con la API de E2B, probada con su SDK Python; la 0.9.0 será la última versión que introduzca cambios incompatibles antes de una 1.0 con contratos estables.
CoreWeave y Akamai han probado y puesto en marcha SPACE en sus plataformas y trabajan para ofrecerlo a sus clientes, y Crusoe lo incorporará a su oferta Managed AI Services. Perplexity presenta SPACE como el primer componente de su plataforma de ejecución de agentes (Agentic Runtime Platform), cuyo código abre para elevar el nivel de seguridad de los productos agénticos.
🔗 La publicación de Perplexity · El hilo de @perplexity_ai · El repositorio SPACE (GitHub)
Medios generativos: FLUX 3 Image Klein con pesos abiertos en una GPU de consumo, Kling 4.0 para todos, Instant Soundtracks de ElevenLabs
15 de octubre — Black Forest Labs publica FLUX 3 Image Klein, un modelo de imagen con pesos abiertos de 5,6 mil millones de parámetros, exclusivamente generador, que funciona en una sola GPU de consumo. El mismo modelo genera imágenes a partir de texto y retoca a partir de una o varias referencias, hasta 10 imágenes; incorpora las funciones estrella de FLUX 3 Image, lanzado el 1 de octubre: generación 4K nativa, edición con precisión de píxel y cuadros delimitadores (bounding boxes), que fijan en el prompt la ubicación de un elemento o limitan un retoque a una zona.
Según las evaluaciones internas de BFL, Klein ocupa el primer lugar en texto a imagen, en tareas con múltiples referencias y en edición frente a modelos abiertos más grandes, Qwen-Image 2.1 (7B) y Krea 2 (12,9B), y se sitúa por encima de los dos modelos cerrados de la comparación, Ideogram V4.5 y FLUX.2 [pro]. Frente a su predecesor FLUX.2 [klein] 9B, gana 91 puntos Elo en texto a imagen y 70 en edición, con un 38 % menos de parámetros.
| Configuración probada | Resultado anunciado |
|---|---|
| Pesos en BF16 / en FP8 | 11,2 Go / 5,6 Go |
| Versión INT8 en GeForce RTX (ComfyUI o Diffusers) | Funciona con 8 Go de VRAM |
| RTX 5090, versión destilada en INT8 (medición de NVIDIA) | Unos 4 s por imagen de 1 megapíxel |
| RTX 4070, versión destilada en INT8 (medición de NVIDIA) | Menos de 9 s por imagen de 1 megapíxel |
| H100, versión destilada en Diffusers | Unos 2 s por imagen de 1024 × 1024 píxeles |
| GB300, versión destilada en NVFP4 | Menos de 0,6 s por imagen de 1 megapíxel |
Hugging Face lo integró en Diffusers ese mismo día, con dos checkpoints: la versión destilada, en 16 pasos y sin CFG, y la versión base, en 50 pasos, destinada al ajuste fino. A ello se suman pesos NVFP4 y FP8, el codificador de texto Qwen3-VL y scripts de ajuste fino LoRA; en NVFP4, el pico de memoria tras la inferencia alcanza 15,3 Gio en una RTX 6000. ComfyUI, TensorRT-LLM, SGLang Diffusion y vLLM-Omni también lo admiten desde su lanzamiento, y las versiones FP8, INT8 y NVFP4 se desarrollaron con NVIDIA.
Los pesos se publican bajo licencia FLUX Kommunity, gratuita para uso comercial por parte de particulares y empresas con menos de 5 millones de dólares de facturación anual, así como para investigación; por encima de ese umbral, se necesita una licencia de alojamiento propio o utilizar la API. La de BFL ofrece flux-3-image-klein a partir de 0,009 dólares por imagen 1K. Es el segundo modelo abierto de la familia FLUX 3, después de FLUX 3 Action, y BFL anuncia que llegarán más.
🔗 La publicación de Black Forest Labs · El anuncio de @bfl_ai · FLUX 3 Image Klein en Diffusers (Hugging Face)
Kling 4.0 alcanza la disponibilidad completa, con acceso por MCP y desde la línea de comandos
15 de octubre — Kling AI pone Kling 4.0 a disposición de todos, tras el acceso anticipado abierto el 30 de septiembre. El modelo de vídeo se utiliza en una interfaz de creación renovada en kling.ai y, como novedad, mediante MCP y desde la línea de comandos (CLI), lo que permite integrarlo en flujos de producción con herramientas. Se anuncian dos funciones para próximamente, sin fecha: una salida de vídeo HDR de 10 bits en 4K y en 1080p, y acceso API para empresas y desarrolladores. Las características presentadas el 28 de septiembre siguen siendo la referencia: clips de 3 a 30 segundos, hasta 4K, audio estéreo, 10 fotogramas clave, 15 referencias y prompts de 8 000 tokens. El anuncio no ofrece precios ni benchmarks.
🔗 Anuncio de Kling AI · Notas de versión de Kling
Instant Soundtracks: ElevenLabs compone música y efectos de sonido sincronizados a partir de un vídeo
15 de octubre — ElevenLabs lanza Instant Soundtracks en ElevenCreative: se sube un vídeo y el modelo compone música original, identifica los momentos que requieren un efecto de sonido y coloca cada efecto en la marca de tiempo adecuada, por ejemplo un «whoosh» sincronizado con el logotipo final de un anuncio. La herramienta está orientada a los formatos cortos, con una sincronización más precisa con los cortes y las transiciones, cambia de ambiente musical de una escena a otra y puede tomar el audio original como referencia (género, tempo, instrumentación). Los efectos se presentan en pistas separadas, modificables antes de la exportación.
| Parámetro de la API ElevenCreative Studio | Función del parámetro |
|---|---|
add_sfx | Añade los efectos de sonido sincronizados |
separate_tracks | Devuelve música y efectos en archivos separados (.ZIP) |
use_audio_as_reference | Toma el audio original como referencia musical |
Instant Soundtracks está disponible en ElevenCreative, ElevenMusic y la API, que admite hasta 10 vídeos, 200 Mo y 10 minutos de vídeo en total por solicitud. ElevenLabs no indica precios.
Agentes de código: Cognition lanza Devin Oncall, Claude Code 2.1.301 y Code Review, Delta 0.20, Antigravity CLI 1.3.6, Codex en OpenAI, el MX Keypad
15 de octubre — Cognition lanza Devin Oncall, ya en disponibilidad general: Devin investiga automáticamente las alertas y los informes de bugs, y después ayuda al equipo a diagnosticar y resolver los incidentes de producción. Se conecta de entrada con Datadog, Dynatrace y Sentry, entre otros, y ya gestiona, según Cognition, miles de alertas de producción al día en algunas de las mayores empresas del mundo. Su arquitectura no depende de ningún modelo: Cognition elige el más eficaz para cada tarea de guardia.
| Agente y modelo evaluados | Éxito de principio a fin (SREGym-Lite) | Origen de la puntuación |
|---|---|---|
| Devin Oncall + Claude Opus 5.5 | 100 % (en 2 min 21 s) | Evaluación interna de Cognition |
| Devin Oncall + GPT-6 Astra | 100 % | Evaluación interna de Cognition |
| Devin Oncall + GPT-6.1 Sol | 94,1 % | Evaluación interna de Cognition |
| Devin Oncall + Claude Fable 5.1 | 85,3 % | Evaluación interna de Cognition |
| CloudThinker + Claude Opus 5 | 76,5 % | Clasificación pública de SREGym |
| Codex + GPT-5.6 Sol | 76,5 % | Clasificación pública de SREGym |
| Claude Code + Claude Sonnet 5 | 45,1 % | Clasificación pública de SREGym |
SREGym-Lite reúne 17 fallos extraídos de incidentes reales: el agente debe encontrar la causa raíz y después corregir el sistema en funcionamiento, en la misma ejecución. Las puntuaciones de Devin Oncall proceden de la evaluación interna de Cognition, y las de los demás agentes, de la clasificación pública de SREGym a fecha del 15 de octubre, donde CloudThinker también alcanza el 100 % con GPT-6 Astra. El banco de pruebas está, por tanto, saturado: según Cognition, los modelos de gama media ya obtienen la máxima puntuación, cuando la generación anterior no pasaba de entre el 50 y el 60 %.
La publicación describe sobre todo las herramientas que rodean al modelo. Un agente de revisión trabaja en paralelo a la investigación para evitar conclusiones precipitadas: una correlación tomada por una causa, una telemetría contradictoria descartada, un desencadenante confundido con la causa. Tres niveles de memoria acumulan el conocimiento de la empresa: una memoria propia de cada agente de respuesta, skills generados al indexar periódicamente el entorno y una memoria de la organización alimentada por cada investigación. Los Responders, presentados como la nueva generación de Auto-Triage, supervisan un flujo de alertas y evitan alrededor del 60 % de las investigaciones al reconocer problemas ya vistos, lo que ahorra más de la mitad del coste de las automatizaciones clásicas; el modo Incidents sitúa a Devin en el canal de crisis, con un documento del incidente que se mantiene actualizado y Devins hijos encargados de las preguntas directas de los ingenieros.
Tres clientes ilustran el lanzamiento. En Reducto, Devin abrió un incidente por iniciativa propia, mucho antes de que se activaran las alertas de producción; en RV Tech, la empresa conjunta de Rivian y Volkswagen, extrae de los informes de clientes los identificadores de vehículos y las marcas de tiempo, recupera los logs y realiza el primer triaje; en AngelList, identifica la causa raíz correcta 3,5 veces más a menudo que la herramienta interna Sky y ha gestionado por sí solo la mitad de los incidentes, por lo que se ha abandonado Sky. No se anuncian precios: la página de Devin Oncall ofrece empezar o reservar una demostración. El lanzamiento da continuidad a la incorporación a Cognition, en julio, de los fundadores de TierZero, especialista en SRE asistido por IA.
🔗 La publicación de Cognition · El hilo de @cognition · La página de Devin Oncall
Claude Code 2.1.301: se limita la espera por los límites de uso en modo desatendido, 37 correcciones
15 de octubre — Publicada a las 19 h 22 UTC, Claude Code 2.1.301 incluye 51 entradas, entre ellas 8 novedades, 37 correcciones, 4 mejoras y 2 cambios, y se centra ante todo en el uso desatendido. La nueva variable CLAUDE_CODE_RETRY_WATCHDOG_MAX_USAGE_LIMIT_WAIT_MS permite al modo de reintento automático (CLAUDE_CODE_RETRY_WATCHDOG) abandonar una solicitud cuando el límite de uso alcanzado tarda demasiado en restablecerse, en lugar de esperar. En cuanto a observabilidad, los eventos OpenTelemetry tool_decision incluyen ahora classifier_verdict y permission_mode, para distinguir una decisión del clasificador del modo auto de una regla de permisos, así como classifier_category, la regla integrada que originó un bloqueo (con OTEL_LOG_TOOL_DETAILS=1).
Varias correcciones afectan a la fiabilidad: el alias fable (y best) ya no devuelve un error cuando el Fable más reciente no está disponible para la organización, ya que Claude Code lo reintenta una vez con el Fable anterior; salir de una sesión ya no elimina sin preguntar un worktree creado por un hook WorktreeCreate, que puede contener commits sin enviar; Grep y Glob notifican un error en lugar de anunciar «ninguna coincidencia» cuando falla la búsqueda. Al cambiar a un modelo con una ventana de contexto más pequeña, el modelo anterior resume primero las conversaciones demasiado largas. En VS Code, las respuestas muestran las fórmulas LaTeX y el aviso del límite de uso ofrece un enlace «Obtener más uso» a los suscriptores Pro y Max.
🔗 Notas de la versión de Claude Code 2.1.301
Code Review de Claude Code sale de la vista previa de investigación para Team y Enterprise
15 de octubre — Siete meses después de su lanzamiento en vista previa de investigación, el 9 de marzo, Code Review, el servicio de Claude Code que revisa automáticamente las pull requests de GitHub, pasa a estar disponible para las organizaciones Claude Team y Enterprise. Según Anthropic, la mayoría de las revisiones terminan aproximadamente tres veces más rápido que durante la vista previa, con hallazgos breves que explican el problema, qué lo desencadena y cómo corregirlo. Un administrador elige un nivel por repositorio: Quick, Standard (predeterminado) o Deep.
| Punto clave de Code Review | Detalle publicado por Anthropic |
|---|---|
| Duración de una revisión | Entre 6 y 10 minutos aproximadamente, frente a unos veinte durante la vista previa |
| Facturación de las revisiones | Tokens consumidos, descontados de los créditos de uso adicionales al uso incluido en el plan, con un límite mensual |
| Créditos de lanzamiento | Al menos 10 000 dólares para las organizaciones Enterprise que cumplan los requisitos, que deben solicitarse antes del 15 de enero de 2027 y son válidos durante 30 días |
| Exclusiones actuales | Zero Data Retention, configuración HIPAA y, por ahora, claves gestionadas por el cliente (CMEK) |
El principio no cambia: los hallazgos llegan como comentarios en línea clasificados por gravedad, con un check run que nunca falla, y una revisión no aprueba ni bloquea una pull request; la decisión de fusionarla sigue correspondiendo al equipo.
🔗 Code Review ya está disponible de forma general (Claude) · Documentación de Code Review
Delta 0.20: los subagentes se convierten en hilos secundarios controlables y los agentes acceden a los servidores MCP
14 de octubre — Delta, el entorno de código multijugador de los creadores de Zed, pasa a la versión 0.20 (18 novedades, 14 mejoras y 29 correcciones, seguidas de una corrección en la 0.20.1 ese mismo día). Los subagentes se convierten en hilos secundarios normales que se pueden consultar, reorientar y continuar personalmente, y los hilos secundarios ya pueden anidarse; el ajuste Enable Sub-agents pasa a llamarse Delegation, con tres posiciones (Off, Only When Asked, Max). Los agentes obtienen acceso a los servidores MCP, que se conectan en Settings → MCP, y una revisión o un Land iniciado desde un hilo secundario también abarca los cambios heredados de los hilos superiores. La versión añade Gemini 4 Argon con una clave propia de Google, un comando /create-skill y comandos delta org para gestionar una organización desde el terminal.
El 15 de octubre, una entrada basada en una conferencia de Conrad Irwin detalla DeltaDB, la capa de colaboración que envía cada pulsación al servidor y a los colaboradores: CRDT inspirados en diamond-types, con cada modificación anclada a una versión de Git o a modificaciones anteriores. Como cada carácter sabe qué modificación lo creó, Delta puede asociarle su autor, el agente e incluso el prompt.
🔗 Notas de la versión de Delta · DeltaDB: el futuro del control de versiones
Antigravity CLI 1.3.6: Claude 5.5 mediante credenciales de Google Cloud, tras el modo Auto y /compact de la 1.3.5
14 de octubre — Antigravity CLI, la herramienta de agentes en línea de comandos que Google presenta como sucesora de Gemini CLI, encadena versiones: desde la 1.3.1, cubierta aquí el 8 de octubre, se han sucedido cinco. La 1.3.6 añade Claude Opus 5.5 y Claude Sonnet 5.5 para los usuarios conectados con las credenciales predeterminadas de Google Cloud (Application Default Credentials, AGY_ADC_AUTH): los modelos Claude solo aparecen en /model si el proyecto de Google Cloud tiene acceso a ellos. También pone fin a un bloqueo indefinido: tras 5 minutos sin recibir datos del modelo, la solicitud se cancela y se reintenta automáticamente.
La novedad más visible procede de la 1.3.5: un modo Auto que aprueba por sí solo las modificaciones de archivos y los comandos considerados seguros, pero sigue preguntando antes de una acción irreversible. Los comandos que saldrían del entorno aislado del terminal son examinados primero por un agente independiente; la 1.3.6 agiliza esta revisión, permite los comandos de formato y lint del proyecto y bloquea los que enviarían datos sensibles. El modo se activa con --mode auto, desde /config o mediante Mayús+Tab, en Linux y macOS (Windows más adelante). La 1.3.5 también añade /compact, que resume la conversación a petición del usuario para liberar la ventana de contexto.
| Versión de Antigravity CLI | Fecha del changelog | Mejoras y correcciones | Punto principal de la versión |
|---|---|---|---|
| 1.3.6 | 14 de octubre | 3 + 10 | Claude Opus 5.5 y Sonnet 5.5 mediante ADC, reintento tras 5 minutos de bloqueo |
| 1.3.5 | 13 de octubre | 5 + 1 | Modo Auto, /compact, resaltado y plegado en /diff |
| 1.3.4 | 12 de octubre | 4 + 10 | agy plugin list --json, modelo elegido sin --effort |
| 1.3.3 | 9 de octubre | 6 + 15 | Herramientas MCP siempre cargadas, entorno aislado reforzado |
| 1.3.2 | 7 de octubre | 6 + 4 | /plugin y marketplace oficial de plugins |
Codex en OpenAI: el equipo Core Experimentation fusiona más de 1 400 PR de mantenimiento con GPT-6 Astra y GPT-6.1 Sol
14 de octubre — En el blog OpenAI Developers, un ingeniero del equipo Core Experimentation, que mantiene el software de experimentación utilizado en toda la empresa, cuenta cómo los modelos GPT-6 se han encargado del mantenimiento de sus repositorios en Codex. El punto de partida: un prompt breve y deliberadamente vago que pide detectar y limpiar el código muerto. GPT-5.6 Sol no lo completaba; GPT-6 Astra consultó PR antiguas, hilos de Slack, herramientas internas de seguimiento y tablas de profiling de producción, y después justificó cada eliminación. A continuación, cinco ingenieros adaptaron ese prompt, a tiempo parcial durante dos semanas: más de 1 400 pull requests fusionadas, más de 800 000 líneas eliminadas y la imagen de contenedor de un servicio reducida de 3,31 a 1,72 Go (-48 %).
| Modelo y esfuerzo de razonamiento | Coste API de la tarea | Hallazgos aceptados | Coste por hallazgo |
|---|---|---|---|
| GPT-6 Astra Ultra | 109,06 dólares | 142 | 0,77 dólares |
| GPT-6.1 Sol Ultra | 15,12 dólares | 131 | 0,12 dólares |
| GPT-6.1 Sol Medium | 5,27 dólares | 86 | 0,06 dólares |
En una misma tarea de limpieza, con más de 6 000 archivos y 1 millón de líneas de Python, TypeScript, Go y Rust, GPT-6.1 Sol con esfuerzo Ultra encuentra, por tanto, el 92 % de los hallazgos de GPT-6 Astra Ultra por el 14 % del coste API; la diferencia se debe sobre todo a los indicadores de funcionalidad (feature flags) constantes utilizados como dependencias de otros indicadores, que Astra detecta y Sol pasa por alto. Una treintena de PR de optimización también redujeron el tiempo mediano de la CI de unos 10 a 4,5 minutos. El autor reconoce que algunas propuestas añadían más complejidad que beneficios y aconseja empezar por tareas pequeñas.
🔗 Mantenimiento de software con la familia GPT-6 (OpenAI Developers)
MX Keypad: GitHub y Logitech controlan la app GitHub Copilot desde un panel de teclas programables
15 de octubre — En una entrada dedicada a la «inteligencia ambiental», Martin Woodward, vicepresidente de Relaciones con Desarrolladores de GitHub, presenta el fruto de 18 meses de trabajo con Logitech: el MX Keypad, un panel de teclas programables, se integra con la app GitHub Copilot. Una tecla puede enviar un prompt parametrizado, abrir o reanudar una sesión de Copilot, ejecutar un comando del IDE o iniciar una secuencia de varios pasos. La entrada sitúa el dispositivo en una visión de tres capas: la modalidad (texto, voz, controles físicos) capta la intención, el arnés planifica y actúa, y el plano de control permite al desarrollador inspeccionar, reorientar y aprobar. El autor mantiene la cautela: la experiencia está «todavía en sus inicios» (todavía es pronto) y no todos los desarrolladores necesitan un dispositivo más. Un enlace permite probar el MX Keypad con tres meses gratis de GitHub Copilot Pro+, sin que la entrada indique el precio ni la fecha de disponibilidad.
🔗 La próxima interfaz para desarrolladores es la inteligencia ambiental (GitHub Blog)
Seguridad de los modelos: METR obtiene en Anthropic acceso de empleado e IPI Black pone en juego 300 000 dólares contra la inyección de prompt
Dos iniciativas del mismo día para que terceros pongan a prueba la seguridad de los modelos: un equipo de evaluadores independientes instalado en Anthropic y un concurso público de ataques contra agentes.
METR obtiene en Anthropic un acceso comparable al de un empleado
15 de octubre — Anthropic ha empezado a incorporar un equipo de METR, la organización sin ánimo de lucro que evalúa los modelos de IA de vanguardia, con un acceso «comparable al de un empleado» (acceso similar al de un empleado). Seis personas de METR disponen de equipos de la empresa, oficinas y acceso a las herramientas y los sistemas internos aproximadamente equivalente al de los equipos de evaluación de riesgos de Anthropic; solo quedan excluidos los datos de clientes, la información amparada por el secreto profesional entre abogado y cliente y las arquitecturas de los modelos. METR publicará sus análisis de riesgos y Anthropic no puede oponerse: solo puede exigir que se oculte información perteneciente a categorías limitadas definidas de antemano, y METR conserva la libertad de decir públicamente si considera justificadas esas ocultaciones.
| Nivel de acceso de los evaluadores | Acceso a la información | Derecho de publicación | Evaluador citado por Anthropic |
|---|---|---|---|
| Nivel 1 | Investigaciones específicas, acceso decidido por Anthropic | Con la aprobación de Anthropic | SecureBio |
| Nivel 2 | Más información | Sin aprobación, con posibilidad de ocultar categorías concretas | Ninguno citado |
| Nivel 3 | Comparable al de un empleado | Como en el nivel 2 | METR |
Anthropic también prepara una colaboración con Accenture y Faculty (evaluación y red-teaming de modelos, evaluaciones de alineamiento, pruebas de los mecanismos de protección) y mantiene conversaciones preliminares con otras organizaciones, entre ellas Hugging Face. La empresa compara este sistema con la supervisión bancaria, en la que examinadores residentes trabajan dentro de los mayores bancos, y lo enmarca en la continuación de su firma del White House Accord on Super Intelligence, por el que las empresas se comprometen a trabajar con evaluadores externos independientes.
🔗 Novedades sobre los evaluadores independientes (Anthropic)
IPI Black: Gray Swan lanza un concurso de inyección indirecta de prompt dotado de 300 000 dólares
15 de octubre — Gray Swan lanza IPI Black (Indirect Prompt Injection: Black), un concurso público de inyección indirecta de prompt dotado de 300 000 dólares, con el apoyo de Anthropic, Meta, Google DeepMind, Reflection AI, OpenAI, Amazon, Thinking Machines y el AI Security Institute. Los participantes, sin necesidad de experiencia, atacan a agentes situados en entornos simulados con herramientas realistas (Gmail, Slack, GitHub, X): por ejemplo, inducir al agente de redacción de un responsable de redes sociales a publicar contenido perjudicial en las cuentas oficiales de su empresa. En caja blanca, se ven las respuestas del agente y se perfecciona el ataque; en caja negra, se envía la carga sin ver nada.
El concurso se desarrolla en tres rondas de una semana que comienzan los días 15, 22 y 29 de octubre, cada una con sus propias clasificaciones, entre las que se reparten 100 000 dólares entre caja blanca y caja negra. La primera ronda propone diez escenarios, seis de caja blanca y cuatro de caja negra, desde la filtración de un identificador en un comentario de una issue de GitHub hasta una denuncia falsa de un informante. Los ataques recopilados alimentarán el benchmark que los laboratorios participantes utilizan para medir la robustez de sus modelos. Boris Cherny, creador de Claude Code, ha difundido el concurso: según él, los modelos Claude han avanzado mucho frente a la inyección de prompt en los últimos años, pero resulta cada vez más urgente resolver el problema en toda la industria a medida que los agentes hacen más cosas.
🔗 El hilo de Gray Swan · La página del concurso · El mensaje de Boris Cherny
Nuevos modelos: Timestral para las series temporales, Step 5 Preview de StepFun, Apertus 1.5 y Jev 1.14
Cuatro publicaciones de distinta naturaleza: una familia de modelos de predicción de Mistral, un gran MoE abierto de StepFun, modelos completamente abiertos en Suiza y un modelo de decisión de TypeSafe.
Timestral: Mistral publica su primera familia de modelos fundacionales para series temporales
15 de octubre — Mistral publica Timestral, su primera familia de modelos fundacionales para series temporales (time-series foundation models), en cuatro tamaños que comparten la misma arquitectura y la misma receta de entrenamiento: 5M, 28M, 123M y 209M parámetros. Los modelos producen previsiones probabilísticas (21 cuantiles) y multivariantes, tienen en cuenta covariables conocidas solo en el pasado o conocidas de antemano (calendario de producción, paradas planificadas, previsiones meteorológicas), incluidas las categóricas, como el estado de una máquina, y leen hasta 32 768 pasos temporales de historial.
| Benchmark y métrica (menor = mejor) | Timestral-209M | t0-gamma | TimesFM-3 | Chronos-2 |
|---|---|---|---|---|
| GIFT-Eval, MASE | 0,658 | 0,661 | 0,667 | 0,698 |
| GIFT-Eval, CRPS | 0,446 | 0,452 | 0,456 | 0,485 |
| TIME, MASE | 0,626 | 0,637 | 0,640 | 0,662 |
| TIME, CRPS | 0,522 | 0,534 | 0,536 | 0,556 |
Según Mistral, el 209M ocupa el primer puesto en GIFT-Eval, TIME y fev-bench entre los modelos preentrenados utilizados sin adaptación (zero-shot), con un único punto de control y sin ensemble, y supera el estado del arte anterior con dos tercios de sus parámetros; las diferencias entre los primeros siguen siendo estrechas, y el pequeño 28M ya supera a Chronos-2, unas cuatro veces mayor, en GIFT-Eval y TIME. Timestral no necesita GPU: en un procesador de servidor con 8 threads, prever un día a partir de tres semanas de historial con intervalos de 15 minutos tarda 10 ms con el 5M y 140 ms con el 209M. Los pesos están en Hugging Face bajo una licencia «MIT modificada» que excluye a las empresas con más de 20 millones de dólares de facturación mensual consolidada, el código está en GitHub bajo Apache-2.0 y la documentación presenta Timestral 1.0 como una versión preliminar pública; Mistral Forge permite el ajuste fino con datos propios, con la posibilidad de desplegarlo sin conexión.
🔗 Presentación de Timestral (Mistral) · Timestral-209M en Hugging Face
Step 5 Preview: StepFun publica un MoE abierto de 600 mil millones de parámetros para tareas de agentes de 24 horas, según NVIDIA
15 de octubre — NVIDIA celebra el lanzamiento de Step 5 Preview, que su cuenta @NVIDIAAI presenta como la mayor publicación de pesos abiertos de StepFun: una mezcla de expertos de 600 mil millones de parámetros diseñada para tareas de agentes que pueden durar hasta 24 horas. NVIDIA anuncia cerca de 8 000 tokens por segundo por GPU en GB300 con NVFP4, con un punto de control NVFP4 publicado en Hugging Face, recetas de despliegue para SGLang y vLLM, postentrenamiento con NeMo AutoModel y un NIM que se inicia con un solo comando. El mensaje de NVIDIA no proporciona benchmarks ni licencia.
Apertus 1.5: Swiss AI detalla modelos 8B y 70B completamente abiertos, con imagen, audio y 262 144 tokens de contexto
15 de octubre — La iniciativa suiza Swiss AI publica las notas de la versión y el informe técnico de Apertus 1.5, su familia de modelos completamente abiertos. Los pesos 8B y 70B estaban disponibles en línea desde el 24 de julio bajo Apache 2.0; el informe también publica los puntos de control intermedios (base, SFT, RLVR, DPO), las mezclas de datos y las fichas de evaluación, para que otros investigadores puedan estudiar el efecto de cada fase del entrenamiento.
| Modelo Apertus 1.5 | Tokens de preentrenamiento añadidos | Total de tokens |
|---|---|---|
| 8B | 4 000 mil millones | 19 000 mil millones |
| 70B | 2 000 mil millones | 17 000 mil millones |
La imagen y el audio pasan por el tokenizer, sin un codificador separado: una imagen de 512 × 512 píxeles se convierte en 1 024 tokens, un segundo de audio en 40 tokens, de modo que el entrenamiento se ejecuta a la misma velocidad que con solo texto; los modelos comprenden la imagen y el audio, pero solo generan texto, y el audio sigue siendo experimental. También incorporan un modo de reflexión opcional y un contexto de 262 144 tokens, cuatro veces más largo. Los autores reconocen que siguen por detrás de los mejores modelos abiertos, aunque sitúan al 8B por delante de los modelos de su tamaño en seguimiento de instrucciones y capacidades multilingües, sin aportar puntuaciones numéricas en la publicación. Los resultados se publican en el formato Every Eval Ever, pensado para cumplir con el AI Act europeo.
🔗 Notas de la versión de Apertus 1.5 (Hugging Face)
Jev 1.14: TypeSafe ofrece en versión preliminar las imágenes, las preguntas Box y un contexto cuatro veces más largo
14 de octubre — TypeSafe anuncia Jev 1.14, una nueva versión de su modelo de decisión, presentada como «nueva y mejorada» sin cifras que lo respalden. La acompañan tres funciones experimentales: las imágenes, que se pueden colocar en cualquier lugar donde antes iba el texto y que también están disponibles para el Jev actual; un nuevo tipo de pregunta de System One, Box, que devuelve el cuadro delimitador de un objeto en una imagen en forma de cuatro bordes expresados como fracciones de su anchura y altura; y un contexto cuatro veces más largo, aunque TypeSafe sigue aconsejando limitarlo. Estas funciones siguen en versión preliminar, aún no están listas para producción según TypeSafe, y se activan con el encabezado TypeSafe-Danger-Zone-Images: true; las preguntas Box requieren Jev 1.14, invocado con jev-preview o jev-1.14.0. Zed celebró el lanzamiento citando a Wes Bos, que estima en 0,000096936 dólares el coste de una pregunta sobre una imagen de 850 × 850 píxeles, es decir, unas 10 000 imágenes por un dólar: un cálculo de Wes Bos, no una tarifa publicada por TypeSafe.
🔗 El anuncio de TypeSafe · La documentación de Box
IA para la ciencia: el CERN y Mistral apuntan a un Large Physics Model, Sakana AI presenta The Agentic Scientist y OpenAI financia a los matemáticos
Tres formas de poner la IA al servicio de la investigación: un modelo fundacional para la física de colisionadores, agentes de código supervisados para realizar una investigación de principio a fin y fondos para que los matemáticos verifiquen los resultados producidos por la IA.
El CERN y Mistral se asocian para desarrollar un Large Physics Model
15 de octubre — El CERN y Mistral han firmado una declaración de intenciones (statement of intent) con vistas a una asociación estratégica a largo plazo dedicada a los modelos fundacionales para el descubrimiento científico. En el centro del proyecto: un único Large Physics Model preentrenado, que el CERN presenta como el primer modelo fundacional para la física de colisionadores, entrenado con miles de millones de colisiones protón-protón simuladas en el Gran Colisionador de Hadrones (LHC). Debe servir para varias tareas a la vez: reconstruir las colisiones, identificar las partículas, detectar señales inesperadas y evaluar futuros diseños de detectores, mientras que actualmente el análisis pasa por una cadena de algoritmos especializados. El CERN ya ha almacenado aproximadamente un exabyte (un millón de terabytes) de datos experimentales del LHC, y el número de colisiones se multiplicará por diez con el LHC de alta luminosidad (HL-LHC), previsto hacia 2030. El comunicado cita a Enrica Porcari, directora de sistemas de información del CERN, y a Johannes Brandstetter, vicepresidente de IA para ingeniería en Mistral, pero no indica importes, calendario ni recursos de computación.
🔗 El comunicado del CERN · El hilo de @MistralAI
The Agentic Scientist: Sakana AI supervisa agentes de código para realizar una investigación de principio a fin
15 de octubre — Sakana AI presenta The Agentic Scientist, la nueva generación de su AI Scientist, el proyecto que prueba desde 2024 hasta dónde puede llevar una IA una investigación por sí sola. El punto de partida es una constatación:
Coding agents such as Codex and Claude Code now carry out long software tasks on their own. Handing them a research problem, however, tends to produce a strong hyperparameter optimizer rather than a scientist: scores go up, but ideas stay narrow, and the reasons for the gain are rarely examined.
🇪🇸 Los agentes de código como Codex y Claude Code ya realizan por sí solos largas tareas de software. Sin embargo, confiarles un problema de investigación produce más bien un excelente optimizador de hiperparámetros que un científico: las puntuaciones suben, pero las ideas siguen siendo limitadas y rara vez se examinan las razones de la mejora. — @SakanaAILabs en X
La respuesta es una estructura de apoyo en torno a agentes de código existentes (Codex, Claude Code, OpenCode, Pi): agentes paralelos ponen a prueba hipótesis con criterios de evaluación fijados antes de cualquier experimento, comparten sus éxitos y fracasos en una memoria común y, después, el sistema encadena pruebas de referencia, ablaciones, evaluación final sellada y análisis, hasta redactar el artículo. Sakana AI lo ha evaluado en 5 temas con 9 modelos (4 GPT, 4 Claude, 1 DeepSeek) y 4 arneses, es decir, 14 combinaciones de modelo y arnés y 70 campañas de investigación: los modelos más recientes producen mejores artículos, y la elección del arnés importa menos que la del modelo. Una versión de desarrollo ha coescrito con investigadores un artículo sobre Error Diffusion, una regla de aprendizaje inspirada en la biología, aceptado para una presentación oral en ALIFE 2026; en la recuperación de hechos en documentos largos (Doc-to-LoRA), el sistema eleva la exactitud del 52 % al 98 % sin volver a entrenar el modelo. El código es abierto bajo Apache 2.0; Sakana AI recuerda que los humanos deben seguir eligiendo las preguntas y verificando las afirmaciones, y que los agentes se ejecutan con todos los permisos, por lo que se recomienda Docker.
🔗 La publicación de Sakana AI · El artículo en arXiv · El repositorio AI-Scientist-v3
OpenAI aporta 5 millones de dólares a una iniciativa de la Simons Foundation para los matemáticos
15 de octubre — OpenAI anuncia una contribución de 5 millones de dólares a una nueva iniciativa de la Simons Foundation, destinada a ayudar a los matemáticos a examinar, comprender y ampliar los resultados producidos por la IA, incluidos los que OpenAI ha publicado recientemente. El 6 de octubre, la empresa había difundido 722 manuscritos de resultados matemáticos procedentes de un modelo interno no publicado, advirtiendo de que algunos resultados no formalizados podían contener errores. La fundación gestionará y asignará los fondos, que se destinarán a talleres, conferencias y programas especiales; OpenAI también proporcionará acceso a sus modelos y a recursos de computación a los investigadores apoyados por la Simons Foundation. El mensaje cita el de la Simons Foundation, que destina en total 15 millones de dólares a talleres e iniciativas, con recursos de computación gratuitos para los investigadores a los que apoya, a través de nuevas asociaciones con Anthropic y OpenAI. El anuncio, realizado en un simple mensaje en X, no precisa el nombre de la iniciativa ni su calendario.
🔗 El anuncio de OpenAI · Los 722 manuscritos del 6 de octubre (OpenAI)
Claude Opus 5.5: el modo rápido sale de la vista previa de investigación, a 8 y 40 dólares por millón de tokens
15 de octubre — El modo rápido (fast mode) de Claude Opus 5.5 sale de la vista previa de investigación en Claude Platform, sin lista de espera. Es el mismo modelo, con los mismos pesos, servido con hasta 2,5 veces más tokens de salida por segundo y facturado al doble de la tarifa estándar de Opus 5.5. Las solicitudes ya no necesitan el encabezado beta fast-mode-2026-02-01 (las que aún lo envían siguen siendo aceptadas), y cada nivel de uso dispone ahora de un límite de velocidad predeterminado para este modo, distinto del de Opus a velocidad estándar.
| Modelo Claude en modo rápido | Estado a 15 de octubre | Tarifa por millón de tokens (entrada / salida) |
|---|---|---|
| Opus 5.5 | Disponible, sin lista de espera ni encabezado beta | 8 / 40 dólares (4 / 20 a velocidad estándar) |
| Opus 5 | Vista previa de investigación, encabezado beta obligatorio | 10 / 50 dólares |
| Opus 4.8 | Vista previa de investigación, encabezado beta obligatorio | 10 / 50 dólares |
La mejora afecta a la tasa de salida, no al tiempo hasta el primer token, y cambiar de velocidad invalida la caché del prompt; el modo sigue sin estar disponible con la API Batch. También se ofrece en Microsoft Foundry para los despliegues alojados en Azure, algo que ahora confirma la documentación; Google Cloud se incorporará más adelante según @ClaudeDevs, y el modo sigue sin estar disponible en Amazon Bedrock y Claude Platform on AWS. En Claude Code, nada cambia: el modo rápido sigue consumiendo créditos de uso adicionales.
🔗 Anuncio de @ClaudeDevs · Documentación del modo rápido
Bibliotecas de Hugging Face: Transformers 5.20.0 y TRL 1.16.0 incorporan compatibilidad con Muse Spark Open
Las dos bibliotecas principales de Hugging Face se publican el día del lanzamiento de Muse Spark Open e incorporan compatibilidad con él, cada una con sus propias novedades.
Transformers 5.20.0: siete modelos añadidos y cuantización durante la exportación
15 de octubre — Hugging Face publica Transformers 5.20.0, una versión protagonizada por la llegada de Muse Spark Open, compatible desde el mismo día de su lanzamiento. Otros seis modelos se incorporan a la biblioteca.
| Modelo añadido a Transformers | Desarrollador del modelo | Característica técnica |
|---|---|---|
| Muse Spark Open | Meta | MoE multimodal, 816 mil millones de parámetros, de los cuales 42 mil millones están activos |
| Ling 3.0 Flash | InclusionAI | MoE híbrido, cinco capas Kimi Delta Attention por cada capa MLA |
| Kolibri 1 | Aleph Alpha | MoE de razonamiento alemán-inglés, 6 expertos de 384 por token |
| MiniCPM-V 4.7 | OpenBMB | Posiciones canvas M-RoPE para imágenes y vídeo |
| UnlimitedOcr | Baidu | OCR de 3 mil millones de parámetros, caché KV constante |
| UltraBERT | DMIS Lab | Codificadores de 150M y 380M parámetros, contexto de 32K tokens |
| MOSS-Transcribe-Diarize | OpenMOSS | 0,9 mil millones de parámetros, transcripción y diarización en más de 50 idiomas |
En cuanto a las herramientas, los exportadores ya permiten cuantizar durante la exportación a ONNX, OpenVINO o ExecuTorch, y los puntos de control de entrenamientos FSDP combinados con paralelismo tensorial se pueden volver a cargar con otra configuración. Sin embargo, Hugging Face advierte de una regresión de velocidad en la inferencia con paralelismo de expertos, cuya corrección está en curso, y de varios cambios que rompen la compatibilidad, entre ellos la retirada de métodos de caché obsoletos.
🔗 Notas de la versión de Transformers 5.20.0
TRL 1.16.0: el entrenamiento en AWS Trainium y AsyncGRPO hasta 3,1 veces más rápido
15 de octubre — TRL 1.16.0 abre la biblioteca de entrenamiento de Hugging Face a los chips Trainium de AWS: un nuevo ajuste predeterminado evita que Trainium recompile con cada nueva longitud de secuencia, lo que reduce a la mitad el tiempo de un pequeño entrenamiento de prueba, con 20 pasos de SFT de Qwen3-0.6B en Trainium2 completados en 130 segundos en lugar de 260. La otra novedad se centra en el aprendizaje por refuerzo de los agentes: en las trayectorias generadas (rollouts) con varios turnos o varias generaciones, un mismo inicio de conversación se repite de una fila a otra, y AsyncGRPO ahora lo organiza en un árbol de prefijos para calcularlo una sola vez. En Qwen3-1.7B, con 32K tokens por trayectoria, la velocidad se multiplica por 3,10 y el pico de memoria pasa de 35,2 a 13,5 Gio; sin prefijo compartido, la sobrecarga es de aproximadamente un 1 %. La versión también incorpora compatibilidad con Muse Spark Open, que se puede ajustar con LoRA en 64 GPU H100 (14,2 segundos por paso, 40,2 Go por GPU), y con las GPU AMD en los entrenadores asíncronos.
🔗 Notas de la versión de TRL 1.16.0
GPT-Live-1.1: nuevas voces y acentos más naturales en ChatGPT, Codex y los dots
15 de octubre — OpenAI actualiza su modelo de voz. GPT-Live-1.1 y su variante reducida GPT-Live-1.1 Quip, presentada como una versión mini del modelo, se están desplegando en el modo de voz de ChatGPT, de Codex y de los dots, los agentes permanentes lanzados el 29 de septiembre, con acentos más naturales entre distintos idiomas. El modelo también varía más las frases breves que pronuncia cuando inicia una búsqueda: OpenAI resume la mejora como «menos comprobando…».
Seis idiomas reciben nuevas voces Live: francés, alemán, hindi, japonés, coreano y español de México, a los que se suma una voz en inglés llamada Bubbie; las voces disponibles pueden variar según la región y la cuenta, y se eligen en Settings > Voice. La actualización se despliega desde el 15 de octubre para todos los usuarios y llegará «pronto» a la API, donde GPT-Live-1 está disponible desde el 10 de septiembre a 0,05 dólares por minuto. OpenAI no publica ningún benchmark ni detalla cómo se distribuyen GPT-Live-1.1 y Quip entre los planes.
🔗 Anuncio de OpenAI · Notas de la versión de ChatGPT
Universal Cart: Google lanza en Estados Unidos un carrito compartido entre Google Search y la aplicación Gemini
15 de octubre — Google lanza Universal Cart en Estados Unidos. Este carrito de compra «inteligente», presentado como adelanto en Google I/O en mayo, se despliega tanto en Google Search, incluido AI Mode, como en la aplicación Gemini: un producto añadido desde cualquiera de estas interfaces permanece en el mismo carrito, independientemente de la tienda. La publicación pone el ejemplo de un bolso añadido en AI Mode y, después, un jersey y un brillo de labios añadidos en la aplicación Gemini, que más tarde aparecen juntos.
| Función de Universal Cart | Qué aporta según Google |
|---|---|
| Carrito para varias tiendas | Un único carrito que se conserva al pasar de una interfaz de Google a otra |
| Alertas de precio y existencias | Bajadas de precio y reposiciones, en más de 60 mil millones de fichas del Shopping Graph |
| Integración con Google Wallet | Ventajas de las tarjetas guardadas para elegir el medio de pago, códigos promocionales pertinentes |
| Pago de las compras | Google Pay desde el carrito (Universal Commerce Protocol) o redirección al sitio del comercio |
El pago directo funciona en Nike, Sephora, Target, Ulta Beauty, Walmart, Wayfair y numerosos comercios de Shopify; en todos los casos, el comercio sigue siendo el vendedor y gestiona las confirmaciones y la atención al cliente. Google sitúa la herramienta entre las funciones que dejan el control al comprador, junto a sus trabajos sobre capacidades agénticas que actúan por él. No se da ninguna fecha para otros países.
🔗 Universal Cart (blog de Google)
Manus Automations: tareas recurrentes que se inician según una programación o un desencadenante
15 de octubre — Manus lanza Automations, que pone el trabajo repetitivo «en piloto automático»: el usuario describe cuándo debe iniciarse la tarea y qué aspecto debe tener el resultado. Coexisten tres modos de inicio: una programación, por ejemplo, cada día laborable a las 8 h; un desencadenante vinculado a una aplicación conectada, como una factura que llega a Gmail; y, en beta, una automatización avanzada que combina varias fuentes y condiciones descritas por el usuario. La función amplía las Scheduled Tasks 2.0 de mayo y las automatizaciones activadas por eventos anunciadas con Manus 2.0 el 28 de septiembre. El hilo no precisa el plan requerido ni el coste en créditos.
Breves
Agentes y herramientas de código
- Notas de la versión de Devin del 14 de octubre — En vísperas del lanzamiento de Devin Oncall, Devin añade Splunk, Elastic, Dynatrace, Chronosphere y Google Cloud Monitoring como plugins de observabilidad, un rol Review manager que gestiona las reglas de revisión sin permisos de administración, y la exportación de los hallazgos de code scan en formato SARIF 2.1.0, además de CSV. 🔗 fuente
- Warp y sus fábricas de software — En dos publicaciones metodológicas, sin nuevas funciones, Zach Lloyd, fundador de Warp, afirma haber reducido el coste por PR de su equipo de 80 a 20 dólares en seis semanas, con menos reversiones y un volumen de PR un 40 % superior al del mes anterior. 🔗 fuente
- Qwen Code v0.25.2 — La versión pasa a estable dos días después de su versión preliminar del 13 de octubre, con 68 pull requests ausentes en esta última, entre ellas 11 funcionalidades (arrastrar y soltar archivos en el Web Shell, revisión de los mensajes de las MCP Apps antes de enviarlos, cancelación de las tareas de workflow y persistencia en 32 tablas para el Managed Agent) y 38 correcciones. 🔗 fuente
- Copilot CLI 1.0.99 en versión preliminar — Dos versiones preliminares en el mismo día, sin versión estable: el sandbox permite por defecto el acceso a la red local, /share abre un menú a pantalla completa, los plugins de los repositorios de confianza se instalan automáticamente, y los Skills y plugins verificados se instalan desde un enlace de GitHub. 🔗 fuente
- SDK Antigravity 0.1.22 — Añade la orquestación de workflows dinámicos y las skills definidas en memoria: retomando una novedad del 11 de octubre, el SDK de Python ofrece en beta componentes tipados (
phase,agent,parallel,pipeline) para escribir workflows de agentes, skills declaradas sin archivo (InlineSkill) y un límite de tokens de salida por etapa superior a 64k tokens. 🔗 fuente - google/adk-recipes — Sucesor reestructurado de adk-samples, el repositorio de ejemplos del Agent Development Kit de Google está ahora pensado para los asistentes de código: cada receta proporciona un
manifest.yamly unAGENTS.md, el primer plugin sectorial se centra en el comercio minorista, y Horizon sirve de arnés de referencia para los agentes que trabajan durante varios días. 🔗 fuente - DeepSeek Harness 0.2.1-alpha.4 — 28.ª versión preliminar, todavía sin versión estable: el esfuerzo de razonamiento se ajusta modelo por modelo para las API personalizadas, directamente en la interfaz, y los plugins se instalan desde índices personalizados; ese mismo día, FlashMLA pasa a la interfaz binaria estable de CPython y LibTorch. 🔗 fuente
- Tres modelos dejan Copilot el 16 de noviembre — Claude Opus 4.8 y Claude Opus 5, que deben sustituirse por Claude Opus 5.5, y GPT-5.6 Terra, que debe sustituirse por GPT-6.1 Sol o GPT-6 Luna; los suscriptores individuales con plan anual conservan Claude Opus 4.8, y los sustitutos se activan automáticamente en Business y Enterprise. 🔗 fuente
Asistentes, empresas y guías
- Genspark en las aplicaciones de mensajería — Se escribe a @genspark_ai en iMessage, WhatsApp, Slack o LINE para resumir un PDF o crear una presentación, y el resultado llega a la misma conversación; no se especifican ni el plan ni el precio. 🔗 fuente
- Kimi Work 3.2.17 y un tercer tutorial — Tres días después de la 3.2.16, las conversaciones muestran las imágenes y el control remoto permite elegir el modo Agent Swarm; Moonshot AI también publica un tercer vídeo introductorio, sobre la automatización de los flujos de trabajo, sin presentar ninguna función como nueva. 🔗 notas de la versión · 🔗 tutorial
- Becas de Anthropic — Convocatorias abiertas hasta el 28 de octubre para los STEM Fellows y una nueva beca, Conceptual Reasoning Fellows (filosofía, ciencias cognitivas, economía, políticas públicas, derecho): cuatro meses a tiempo completo, del 12 de enero al 8 de mayo de 2027, remunerados con entre 100 000 y 167 000 dólares; se requiere autorización para trabajar en Estados Unidos. 🔗 fuente
- Compliance API de Claude Enterprise — En beta, la API devuelve a los administradores las instrucciones personales guardadas por cada miembro en claude.ai y en Cowork; el día anterior, los despliegues programados de Managed Agents llegaban a Claude Platform on AWS. 🔗 fuente
- Block y OpenAI Daybreak — En un estudio de caso de OpenAI del 14 de octubre, el equipo de seguridad de Block (Square, Cash App, Afterpay) afirma haber reducido a 18 minutos el tiempo transcurrido entre la comunicación de una vulnerabilidad y la propuesta de un parche durante ejercicios de ataque simulado, y haber recuperado unas 600 horas de trabajo de analistas por trimestre. 🔗 fuente
- AI for Educators en portugués de Brasil — Con motivo del Día de los Docentes, OpenAI publica esta versión de su curso gratuito en OpenAI Academy, dirigido a docentes desde primaria hasta la educación superior, y recuerda el Study Mode de ChatGPT. 🔗 fuente
- Superwhisper Meetings — Superwhisper lanza una herramienta para grabar reuniones y tomar notas que presenta como la primera totalmente local, impulsada por Tiny Aya y Cohere Transcribe; no se indican ni el precio ni las plataformas. 🔗 fuente
- Tres guías de Cohere — Sin ningún producto ni cifra nuevos, Cohere publica artículos sobre la IA en los operadores de energía y servicios públicos, en torno a North; sobre la proliferación de agentes en las empresas, con la idea de hacer competir a un agente aspirante con el agente en uso; y sobre la medición del retorno de la inversión. 🔗 servicios públicos · 🔗 agentes · 🔗 ROI
- Guía de Perplexity sobre la investigación — Una guía repasa 12 artículos fundacionales de la IA y seis trabajos recientes, compara las herramientas de investigación asistida y propone un marco de siete etapas; ninguna funcionalidad nueva. 🔗 fuente
Medios generativos
- Suno — Dos funciones de colaboración: espacios de trabajo compartidos para lectura o edición únicamente con los invitados (Pro y Premier), y modelos personalizados que se pueden compartir con colaboradores y ajustar con el doble de entradas (Premier). 🔗 fuente
- Eleven v4 a ciegas — ElevenLabs afirma que los oyentes consideraron Eleven v4 más expresivo que otros modelos de voz en cada prueba a ciegas realizada en ocho idiomas, sin nombrar a los competidores ni dar puntuaciones en el texto. 🔗 fuente
- Shot Coverage de Luma — La función genera, a partir de un único plano de vídeo, varios ángulos de cámara en movimiento que pueden usarse en el montaje; el anuncio no precisa ni el modelo, ni el precio, ni la fecha de puesta en servicio. 🔗 fuente
- HeyGen y Jan Hotovec — HeyGen destaca a Jan Hotovec, que tiene parálisis cerebral y ha creado con Fameplay y Nolimi un avatar con su imagen y su voz para contar su vida con sus propias palabras. 🔗 fuente
Investigación, computación e infraestructuras
- NVIDIA y la AI in Science Enablers Initiative — En el AI in Science Summit de Dublín, NVIDIA se suma a la iniciativa de la Comisión Europea con sus modelos abiertos, un hub de materiales didácticos libres del Deep Learning Institute y acceso a recursos de computación a través de AI factories nacionales, sin anunciar ninguna cantidad. 🔗 fuente
- NVIDIA en los países nórdicos — Antes de GTC Berlin, NVIDIA hace balance de su ecosistema nórdico: el superordenador Sferical One (1 152 GPU GB300), 1 gigavatio de cloud de IA previsto para finales de 2027 y un Stockholm AI Lab con la fundación Norrsken en 2027; la keynote de GTC Berlin está fijada para el 21 de octubre. 🔗 fuente
- La tokenización de BERT 50 veces más rápida — Simon Brandeis, de Hugging Face, explica cómo la futura versión 1.0 de tokenizers hace que el tokenizer de BERT sea unas 50 veces más rápido que con la 0.23 al procesar por separado los caracteres ASCII; los cambios siguen en revisión. 🔗 fuente
GitHub, fuera de la IA
- Fin de los correos de push — GitHub deja de enviar los correos de notificación de los eventos de push de los repositorios, que podían usarse para enviar spam, y remite a un workflow de GitHub Actions dotado de su propio servidor SMTP. 🔗 fuente
- Licencias de GitHub Code Quality — Un informe CSV enumera cada committer activo que consume una licencia y los repositorios afectados durante 90 días, para identificar las licencias que se pueden liberar, en GitHub Team y Enterprise Cloud. 🔗 fuente
Lo que esto significa
Los modelos abiertos crecen en escala, y su ecosistema los acompaña ya desde el primer día. Muse Spark Open llega con siete proveedores de API, pesos NVFP4 producidos por Meta y compatibilidad inmediata con Transformers, TRL, mlx-lm y Unsloth; Nemotron 3.5 Super VL publica pesos, datos y recetas de entrenamiento; FLUX 3 Image Klein se incorpora a Diffusers y ComfyUI el día de su lanzamiento. Pero «abierto» engloba condiciones muy distintas: la Muse Model License limita el uso comercial, la licencia FLUX Kommunity solo es gratuita por debajo de los 5 millones de dólares de facturación anual, la de los pesos de Timestral excluye a las empresas que superan los 20 millones de dólares al mes, mientras que Apertus 1.5 publica sus pesos bajo Apache 2.0 junto con sus datos de entrenamiento. El superlativo de Meta recuerda, por último, que la carrera también se disputa entre países: Muse Spark Open se presenta como el mejor modelo abierto estadounidense, pero GLM 5.3 y Kimi K3 siguen por delante en el índice de Artificial Analysis y en programación.
La ciberseguridad se convierte en un ámbito en el que la IA detecta y corrige vulnerabilidades a gran escala. Con la compra de AISLE, Cohere adquiere unos conocimientos especializados que, según afirma, abarcan más de 500 vulnerabilidades inéditas, GitHub amplía la disponibilidad de AI Scan para los lenguajes que CodeQL no cubre y de un autofix que vuelve a ejecutar CodeQL para verificar su propia corrección, y Block afirma reducir a 18 minutos el tiempo que transcurre entre una vulnerabilidad y una propuesta de corrección durante ejercicios de ataque simulado. Estas herramientas siguen bajo control humano: los resultados de AI Scan son consultivos, el autofix abre una pull request en borrador, y Code Review de Claude Code no aprueba ni bloquea una fusión. La otra vertiente es el aislamiento de los propios agentes: SPACE, ahora abierto, mantiene las credenciales y el tráfico saliente fuera de la máquina virtual, e IPI Black paga a atacantes para medir la resistencia de los agentes a la inyección indirecta de prompt.
La confianza también pasa por las miradas externas. Al dar a seis personas de METR un acceso comparable al de un empleado, sin derecho de veto sobre sus publicaciones, Anthropic va más allá de la auditoría puntual y compara el sistema con los examinadores residentes de los grandes bancos. La misma exigencia de verificación atraviesa la investigación: Sakana AI fija las rúbricas de evaluación antes de cualquier experimento para que los agentes de código no se limiten a optimizar una puntuación, y OpenAI financia, a través de la Simons Foundation, a matemáticos encargados de examinar los resultados producidos por la IA, tras sus 722 manuscritos del 6 de octubre. El CERN y Mistral plantean el objetivo más ambicioso, un Large Physics Model entrenado con miles de millones de colisiones simuladas, pero sin concretar presupuesto ni calendario.
En cuanto a las herramientas, la elección entre coste, velocidad y calidad se hace explícita. En OpenAI, GPT-6.1 Sol con esfuerzo Ultra recupera el 92 % de los hallazgos de GPT-6 Astra Ultra por el 14 % del coste; el modo rápido de Opus 5.5 ofrece 2,5 veces más rendimiento por el doble de precio; Code Review factura los tokens consumidos, con un límite mensual. Los agentes también se instalan en las tareas sin supervisión: Devin Oncall asume las guardias, Claude Code 2.1.301 deja de esperar a un límite de uso lejano y registra cada veredicto de su clasificador, y el modo Auto de Antigravity CLI encarga a un agente distinto la revisión de los comandos que saldrían del entorno aislado. Los bancos de pruebas tienen dificultades para seguir el ritmo: en SREGym-Lite, Devin Oncall y CloudThinker alcanzan ambos el 100 % con GPT-6 Astra.
Fuentes
- Anuncio de Muse Spark Open (@AIatMeta)
- Muse Spark Open (blog de investigación de Meta)
- Ficha de Muse-Spark-Open-816B-A42B (Hugging Face)
- Muse Spark Open (blog de Hugging Face)
- Muse Spark Open en GB300 NVL72 (blog técnico de NVIDIA)
- Nemotron 3.5 Super VL (blog de NVIDIA)
- Nemotron 3.5 Super VL (blog técnico de NVIDIA)
- Nemotron 3.5 Super VL en Perplexity (@perplexity_ai)
- Changelog de la API de Perplexity
- Cohere da la bienvenida a AISLE (@aidangomez)
- Cohere adquirirá AISLE (blog de Cohere)
- AISLE y Cohere unirán fuerzas (blog de AISLE)
- AI Scan para pull requests ya está disponible de forma general (changelog de GitHub)
- Autofix con agentes para alertas de code scanning (changelog de GitHub)
- Publicación de SPACE como open source (Perplexity)
- SPACE como open source (@perplexity_ai)
- Repositorio perplexityai/SPACE (GitHub)
- FLUX 3 Image Klein (blog de Black Forest Labs)
- FLUX 3 Image Klein (@bfl_ai)
- FLUX 3 Image Klein en Diffusers (blog de Hugging Face)
- Kling 4.0 disponible por completo (@Kling_ai)
- Notas de la versión de Kling
- Presentación de Instant Soundtracks (blog de ElevenLabs)
- Presentación de Devin Oncall (blog de Cognition)
- Devin Oncall (@cognition)
- Página de Devin Oncall
- Notas de la versión de Claude Code 2.1.301 (GitHub)
- Code Review ya está disponible de forma general (Claude)
- Documentación de Code Review (Claude Code)
- Notas de la versión de Delta 0.20
- DeltaDB: el futuro del control de versiones (blog de Delta)
- Changelog de Antigravity CLI
- Mantenimiento de software con la familia GPT-6 (OpenAI Developers)
- La próxima interfaz para desarrolladores es la inteligencia ambiental (GitHub Blog)
- Novedades sobre los evaluadores independientes (Anthropic)
- IPI Black (@GraySwanAI)
- Página del concurso IPI Black (Gray Swan)
- IPI Black según Boris Cherny (@bcherny)
- Presentación de Timestral (Mistral)
- Timestral-209M (Hugging Face)
- Step 5 Preview de StepFun (@NVIDIAAI)
- Notas de la versión de Apertus 1.5 (blog de Swiss AI en Hugging Face)
- Jev 1.14 (@typesafeai)
- Las preguntas Box (documentación de TypeSafe)
- El CERN y Mistral (comunicado del CERN)
- El Large Physics Model (@MistralAI)
- The Agentic Scientist (@SakanaAILabs)
- The Agentic Scientist (Sakana AI)
- The Agentic Scientist (arXiv)
- Repositorio AI-Scientist-v3 (GitHub)
- Iniciativa de la Simons Foundation (@OpenAI)
- Compartir los avances de la AI en matemáticas (OpenAI)
- Modo rápido de Opus 5.5 (@ClaudeDevs)
- Documentación del modo rápido (Claude Platform)
- Notas de la versión de Transformers 5.20.0 (GitHub)
- Notas de la versión de TRL 1.16.0 (GitHub)
- GPT-Live-1.1 (@OpenAI)
- Notas de la versión de ChatGPT
- Universal Cart (blog de Google)
- Manus Automations (@ManusAI)
- Notas de la versión de Devin del 14 de octubre
- Despliegue de fábricas de software (blog de Warp)
- Qwen Code v0.25.2 (GitHub)
- Copilot CLI 1.0.99-1 (GitHub)
- Changelog del SDK de Antigravity
- google/adk-recipes (Google Developers)
- DeepSeek Harness 0.2.1-alpha.4 (GitHub)
- Retirada de modelos de Copilot en noviembre (changelog de GitHub)
- Genspark en las aplicaciones de mensajería (@genspark_ai)
- Notas de la versión de Kimi Work
- Tercer tutorial de Kimi Work (@Kimi_Moonshot)
- Becas de Anthropic (@AnthropicAI)
- Notas de la versión de Claude Platform
- Estudio de caso de Block (OpenAI)
- AI for Educators en portugués de Brasil (OpenAI)
- Superwhisper Meetings (@cohere)
- Despliegue de AI en el sector de los servicios públicos (blog de Cohere)
- Cómo gestionar la proliferación de agentes en la empresa (blog de Cohere)
- Cómo medir el ROI de la AI (blog de Cohere)
- AI Research: principales artículos y mejores herramientas para investigadores (Perplexity)
- Espacios de trabajo compartidos (@suno)
- Eleven v4 a ciegas (@ElevenLabs)
- Shot Coverage (@LumaLabsAI)
- Jan Hotovec y su avatar (@HeyGen)
- NVIDIA y la AI in Science Enablers Initiative (blog de NVIDIA)
- El ecosistema nórdico de NVIDIA (blog de NVIDIA)
- La tokenización de BERT 50 veces más rápida (blog de Hugging Face)
- Fin de los correos electrónicos de push (changelog de GitHub)
- Licencias de GitHub Code Quality en CSV (changelog de GitHub)