ai-powered-markdown-translatorgpt-6.1-sol을 사용하여 프랑스어에서 한국어로 번역한 기사.
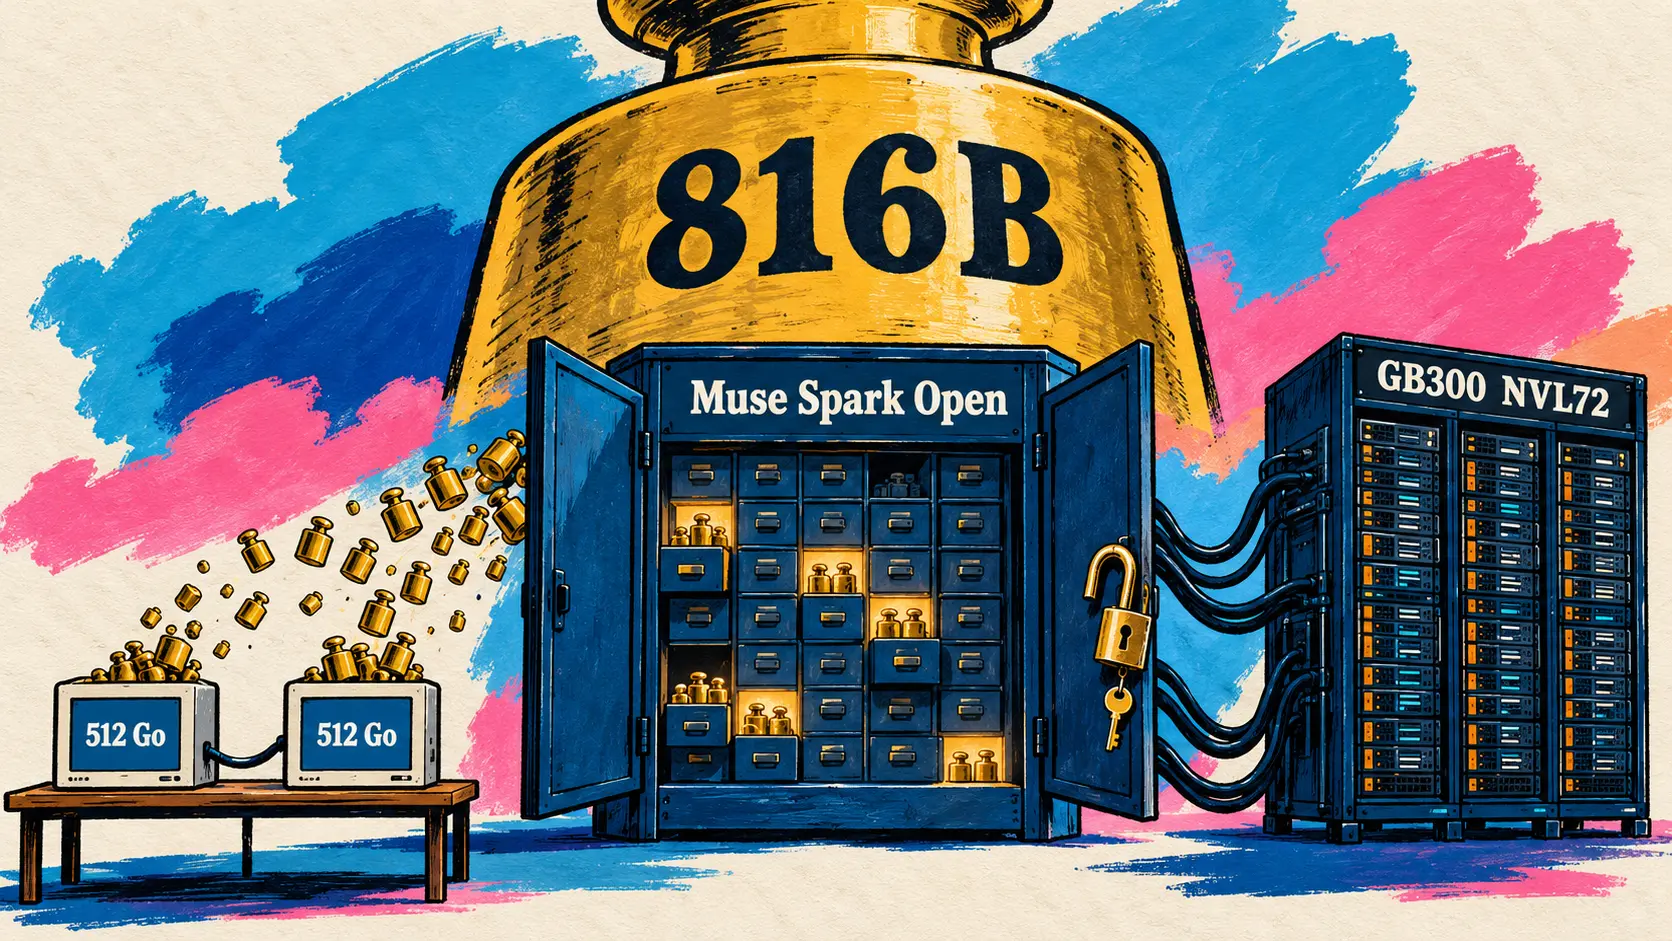
Meta가 미국 공개 모델 중 가장 뛰어나다고 소개하는 8,160억 매개변수의 멀티모달 전문가 혼합 모델 Muse Spark Open의 가중치를 공개했으며, NVIDIA, Hugging Face와 API 제공업체 7곳이 당일부터 지원한다. NVIDIA도 에이전트용 1,200억 매개변수 모델 Nemotron 3.5 Super VL을 공개했다. 한편 Cohere는 취약점 자율 탐지 전문기업 AISLE을 인수하기 위한 의향서를 체결하고 Cohere Cyber를 신설한다. Perplexity는 Computer의 샌드박스인 SPACE를 오픈 소스로 공개하고, Black Forest Labs는 FLUX 3 Image Klein의 가중치를 공개했으며, Cognition은 운영 환경의 장애를 조사하는 당직 에이전트 Devin Oncall을 출시했다.
Muse Spark Open: Meta, 8,160억 매개변수의 멀티모달 MoE 공개, NVIDIA와 Hugging Face도 당일 지원
10월 15일 — Meta가 전체 매개변수 8,160억 개 중 토큰당 420억 개를 활성화하는 멀티모달 전문가 혼합(mixture-of-experts, MoE) 모델 Muse Spark Open의 가중치를 공개했다. 컨텍스트 창은 100만 토큰이다. 이 모델은 텍스트, 이미지, 동영상, 오디오를 읽고 텍스트로 응답하며, Meta는 코딩과 에이전트 작업을 위해 모델을 훈련했다. Muse 제품군에서는 8월에 공개된 300억 매개변수의 소형 밀집 모델 Muse Glimmer보다 상위에 놓이는 대형 공개 모델이며, 비공개로 유지된 Muse Wonder가 나온 지 사흘 만에 등장했다.
Today we’re releasing Muse Spark Open, the most capable US open-weight model to date. Built for coding and agentic work, it excels at long-horizon tasks, complex software engineering, and multi-step reasoning.
🇰🇷 오늘 저희는 현재까지 미국에서 가장 뛰어난 성능을 갖춘 가중치 공개 모델인 Muse Spark Open을 공개합니다. 코딩과 에이전트 작업을 위해 설계된 이 모델은 장시간 작업, 복잡한 소프트웨어 공학, 다단계 추론에서 뛰어난 성능을 발휘합니다. — X의 @AIatMeta
이 최상급 표현은 범위를 엄밀하게 한정해서 이해해야 한다. 모델을 xhigh 설정으로 평가한 Hugging Face 모델 카드의 전체 표에서 Muse Spark Open은 MCP 도구 사용과 JobBench를 비롯한 8개 항목에서 선두를 차지한다. 하지만 중국의 대형 공개 모델들은 Artificial Analysis 지수에서 여전히 앞서며(GLM 5.3은 45, Kimi K3는 44, Muse Spark Open은 39), 코딩에서도 우위를 유지한다. 표에 있는 다른 미국 모델 3개인 Thinking Machines의 Inkling, NVIDIA의 Nemotron 3 Ultra, Reflection AI의 Beam과 비교하면, 성능에서 앞서는 모델은 Beam뿐이다. Beam은 GPQA Diamond에서 90.5 대 89.0, Terminal-Bench 2.1에서 80.1 대 76.4로 더 높은 점수를 기록했다.
| 평가 항목(Hugging Face 모델 카드) | Muse Spark Open 점수(xhigh) | 표에서 가장 우수한 경쟁 모델 |
|---|---|---|
| MCP-Atlas | 89,2 | 84,5 (Qwen3.8-2.4T-A95B) |
| JobBench | 61,8 | 61,4 (GLM 5.3) |
| HLE-Diamond(도구 미사용) | 26,1 | 22,2 (Kimi K3) |
| Artificial Analysis 지수 | 39 | 45 (GLM 5.3) |
| OSWorld Verified | 80,4 | 84,8 (Kimi K3) |
| DeepSWE 1.1 | 60 | 68 (Kimi K3) |
| Terminal-Bench 2.1 (Terminus 2) | 76,4 | 85,0 (Kimi K3) |
| StrongREJECT v2(낮을수록 좋음) | 0,5 | 62,9 (GLM 5.3) |
모든 전문가가 메모리에 상주하므로, 420억 매개변수 모델의 속도를 얻기 위해 8,160억 매개변수 모델에 필요한 메모리를 확보해야 한다. BF16 가중치의 용량은 약 1.5TB이며, Hugging Face의 Muse-Spark-Open-816B-A42B 저장소에서 신청서를 작성한 뒤 접근할 수 있다. NVFP4 버전은 B200 노드 하나에 들어간다. 그럼에도 Meta는 로컬 실행을 강조한다. 이 모델은 각각 최대 512GB의 통합 메모리를 제공하는 Mac Studio M5 Ultra 2대를 연결하고 MLX를 사용하는 구성에 최적화되어 있다. Hugging Face는 그보다 작은 구성인 512GB Mac M3 Ultra 한 대에서 시험했다. llama.cpp로 실행한 2비트 버전은 304GB를 사용하며 초당 18토큰을 생성한다.
가중치는 상업적 이용 조건에 제한이 있는 Muse Model License로 공개되었으며, Meta에 따르면 많은 개발자가 모델을 무료로 이용할 수 있다. Baseten, Fireworks AI, Groq, Modal, Nebius, OpenRouter, Together AI 등 7개 업체가 첫날부터 모델을 제공한다. Meta는 공개 가중치에 특화된 안전성 후학습을 추가했으며, 10월 2일에 갱신한 Meta Superintelligence Scaling Framework의 공개 기준을 충족했다고 밝혔다. 점수가 낮을수록 좋은 StrongREJECT v2에서 이 모델은 0.5를 기록했으며, 함께 평가한 다른 모델들은 62.986.4를 기록했다. FORTRESS에서는 평균 위험 점수가 5.8로 가장 좋았지만(다른 모델은 21.628.2), 과도한 거부 점수는 17.4로 표에서 가장 높았다(다른 모델은 2.7~13.3).
NVIDIA도 출시에 맞춰 기술 게시물을 공개했다. Muse Spark Open은 GB300 NVL72 랙에서 훈련되었으며, Meta가 만든 NVFP4 체크포인트는 Blackwell Ultra에 최적화되어 있다. NVIDIA는 에이전트 작업에서 GPU당 초당 최대 50,000토큰, 사용자당 초당 최대 600토큰을 처리한다고 주장한다. 또한 SGLang, vLLM, TensorRT LLM, Dynamo용 배포 구성 예시, NIM, NeMo AutoModel을 이용한 후학습 방법을 공개했다.
다른 생태계 구성원들도 당일 지원에 나섰다. Transformers와 TRL이 모델을 통합했고(아래 참조), mlx-lm 0.32.0은 NVFP4 버전을 추가했다. Unsloth는 약 256GB에 들어가는 2비트 버전을 발표했으며, Meta는 SGLang용으로 커널 수준에서 최대 3.95배 빠른 Helion 커널을 제공했다. Hugging Face는 게시물에서 H100 GPU 64개를 사용해 전체 모델을 미세 조정하기까지 했으며, 토큰당 평균 정확도가 72%에서 84%로 높아졌다.
🔗 Meta 게시물 · 모델 카드(Hugging Face) · Hugging Face 게시물 · NVIDIA 기술 게시물
Nemotron 3.5 Super VL: NVIDIA, 에이전트용 1,200억 매개변수 멀티모달 모델 공개, Perplexity도 당일 도입
10월 15일 — NVIDIA가 전체 매개변수 1,200억 개 중 토큰당 120억 개를 활성화하는 공개 전문가 혼합 모델 Nemotron 3.5 Super VL을 공개했다. 이 모델은 추론, 지시 이행, 도구 호출과 텍스트, 이미지, 문서, 동영상 이해를 결합해 긴 작업을 연속으로 수행하는 에이전트를 지원한다. 하나의 모델이 웹페이지, 차트, PDF를 읽고 행동하므로, 텍스트 모델에서 비전 모델로 컨텍스트를 넘길 필요가 없다. NVIDIA에 따르면 멀티모달 에이전트 작업에서 자사의 가장 큰 추론 모델과 비슷한 정확도를 약 5분의 1에 해당하는 매개변수로 달성한다.
| NVIDIA가 발표한 평가 | Nemotron 3.5 Super VL 점수 | 비교 기준 |
|---|---|---|
| Hermes Bench | 63,44 % | 56,33 % (Nemotron 3 Ultra) |
| LangChain 행동 평가 | 87,05 % | 84,3 % (Nemotron 3 Ultra) |
| CharXiv(차트 읽기) | 80,8 % (Python 코드 사용 시 84 %) | 63 % (Nemotron 3 Nano Omni) |
NVIDIA가 특히 강조하는 것은 효율성이다. GPU 한 대에서 에이전트 작업을 수행할 때 같은 규모의 다른 공개 모델보다 처리량이 최대 5배 높고, Baseten을 통해 Artificial Analysis 지수의 에이전트 작업에서 초당 600토큰 이상을 처리한다. 또한 SWE-Bench Pro에서 양호한 정확도를 유지하면서 코딩 작업 10,000개를 최대 4배 빠르게 완료했다. Nemotron 3 Ultra에서 증류한 모델이지만, 표에 나온 두 평가 하니스의 테스트에서는 원본 모델을 넘어섰다. 서비스 측면에서는 LiLiCorr 추측 디코딩이 DGX Spark에서 생성을 최대 2.3배 가속하며, Dynamo는 B200 GPU 16개에서 사용자마다 초당 50토큰을 제공하는 조건으로 최대 8배 많은 사용자를 지원하고 첫 토큰 지연 시간을 85% 줄인다.
이번 공개에는 기본 가중치, 후학습 가중치, NVFP4 양자화 가중치, 구성 예시, NeMo Gym의 강화학습 환경, 공개 데이터셋이 모두 포함된다. 데이터에는 비전·언어 데이터셋 40개와 인도의 22개 언어로 된 약 2조 8,000억 토큰의 말뭉치가 포함되며, 이 말뭉치는 IIT Madras 및 산하 AI4Bharat 연구소와 함께 구축했다. 모델은 훈련 과정에서 약 26조 토큰을 학습했다. Hugging Face, OpenRouter, ModelScope와 NIM 마이크로서비스로 제공되며, 가격은 발표되지 않았다. NVIDIA는 Scale AI가 Skydance를 위해 적용한 사례에서 추론 비용이 40분의 1로 줄었다고 소개했으며, Ramp, AI21, Alice의 적용 사례도 언급했다.
Perplexity는 당일 Pro 및 Max 구독자와 Agent API에 이 모델을 추가했다. API 변경 기록에 따르면 perplexity/nemotron-3.5-super-120b-a12b의 요금은 입력 100만 토큰당 0.20달러(캐시 입력은 0.04달러), 출력 100만 토큰당 0.50달러다. 컨텍스트는 1,048,576토큰이며, 최대 131,072토큰을 생성할 수 있고, Nemotron 3 Ultra를 대체한다. 다만 작은 불일치가 있다. 이 항목은 텍스트만 입력받는 모델로 설명하지만, Perplexity의 게시물은 이미지도 읽는 VL 버전을 발표하고 있다.
같은 날, 10월 13일 발표된 Nemotron 3.5 Bolt 74B-A9B 24GB도 Hugging Face에 공개되었다. 24GB에 들어가도록 처음부터 2비트로 양자화한 이 모델은 10월 16일 출시되는 RTX Spark 노트북을 겨냥하며, llama.cpp, Ollama, LM Studio, Unsloth, vLLM으로 실행된다. NVIDIA는 PinchBench에서 이 모델을 동급 공개 모델 중 1위로 평가했다. Bolt E4B 4GB는 10월 23일에 뒤이어 공개될 예정이다.
🔗 NVIDIA 발표 · NVIDIA 기술 게시물 · Perplexity 발표 · Perplexity API 변경 기록
사이버보안: Cohere, AISLE 인수 추진 및 Cohere Cyber 신설, GitHub는 AI Scan과 에이전트 기반 자동 수정 전면 제공
같은 날 두 기업이 취약점 탐지와 수정에 AI를 활용하는 움직임을 보였다. Cohere는 관련 전문성을 인수하고, GitHub는 자사의 코드 스캔 기능에 이를 전면 도입한다.
10월 15일 — Cohere가 핵심 소프트웨어에서 지금까지 알려지지 않은 취약점을 발견하고 검증하며 수정을 돕는 자율 시스템을 개발하는 신생 기업 AISLE의 인수를 추진한다. 두 기업은 의향서(Letter of Intent)를 체결했다. 거래는 아직 완료되지 않았으며, 금액과 일정도 공개되지 않았다. 거래가 종결되면 프라하의 AISLE 본사는 Cohere의 프라하 사무소가 된다.
| AISLE에 관해 공개된 지표 | 발표된 수치 |
|---|---|
| 설립 연도 | 2024 |
| CVE가 부여된 신규 취약점 | 500개 초과, 100개가 넘는 코드베이스에서 발견 |
| OpenSSL, 1월 보안 공지 | 공개된 취약점 12개 전부 |
| curl, 최신 버전 | CVE 24개 중 18개 |
| 심각도가 높음 또는 치명적인 CVE | 200개 초과(에이든 고메즈에 따르면) |
Aisle is the state-of-the-art in defensive cyber, having found 200+ High/Critical CVEs in critical software like curl, FFmpeg, FreeBSD, Wireshark.
🇰🇷 Aisle은 curl, FFmpeg, FreeBSD, Wireshark 같은 핵심 소프트웨어에서 심각도가 높음 또는 치명적인 CVE를 200개 넘게 발견하며 사이버 방어의 최전선에 서 있습니다. — X의 @aidangomez
같은 게시물 타래에서 Cohere를 이끄는 에이든 고메즈는 AISLE이 Anthropic의 Glasswing(Mythos)과 OpenAI의 Daybreak보다 더 좋은 성과를 냈다고 주장했다. Mythos는 curl에서 새로운 CVE를 하나도 찾지 못했지만 AISLE은 29개를 발견했다는 것이다. 이 수치는 두 기업의 게시물에서 제시한 ‘CVE 24개 중 18개’와 일치하지 않는다.
AISLE 창업팀은 경영진에 합류한다. AISLE의 최고경영자인 온드레이 블체크는 Cohere 고객에게 사이버보안 솔루션을 제공할 신설 조직 Cohere Cyber의 수석 부사장이 된다. 자야 발루는 Cohere의 글로벌 최고정보보호책임자가 된다. AISLE의 최고기술책임자 겸 최고과학책임자인 스타니슬라프 포르트는 AI 보안 담당 부사장이 되어, Cohere의 최고기술책임자인 이반 장과 함께 보안 연구를 모델 개발 및 훈련과 연결하는 일을 맡는다.
Cohere는 이번 움직임을 Reliant AI와 Aleph Alpha에 이은 유럽 전략의 다음 단계로 본다. 이 회사는 프라하에 ‘상당한 규모’의 장기 투자를 계획하고 있으며, 프라하는 글로벌 AI 사이버보안 중심지가 될 예정이다. 에이든 고메즈에 따르면 프라하는 베를린의 새 본사에서 가까운 거리에 있다. 목표는 두 가지다. 오픈 소스 소프트웨어 보안에 관한 AISLE의 작업을 이어가는 한편, 핵심 인프라 운영자가 외부와 단절된 환경(air-gapped)을 포함해 완전히 비공개로 소프트웨어를 분석할 수 있도록 하는 것이다. 두 게시물은 모델 측면의 이점도 덧붙였다. 어렵지만 검증 가능한 보안 문제를 앞으로 나올 Cohere 모델을 평가하고 개선하는 데 활용할 수 있다는 것이다.
🔗 Cohere 게시물 · AISLE 게시물
GitHub: pull request용 AI Scan과 경고의 에이전트 기반 자동 수정 기능 정식 출시
10월 15일 — GitHub가 AI를 활용하는 코드 스캔 구성 요소 두 가지를 정식 출시한다. 하나는 pull request에서 취약점을 찾아내고, 다른 하나는 경고를 수정한다.
pull request용 AI Scan은 CodeQL 분석기가 아직 지원하지 않는 영역을 보완한다. PHP, Shell/Bash, Terraform 구성(HCL), Dockerfiles, Java의 JSP, C#의 Blazor가 대상이다. 저장소에서 코드 스캔과 AI Scan 설정을 활성화하면 모든 pull request에서 자동으로 실행된다. 결과는 CodeQL 결과 옆에 « AI »로 표시되며, 위험에 대한 설명과 수정 제안이 함께 제공되기도 한다. 이 결과는 참고용이다. 검사 실패를 유발하거나 병합을 차단할 수 없으며, fork에서 생성된 pull request와 Dependabot이 생성한 pull request에서는 분석이 실행되지 않는다.
에이전트 기반 자동 수정(agentic autofix)은 Copilot에 할당된 경고를 처리한다. 관련 파일을 살펴보고 수정안을 제안한 뒤, CodeQL을 다시 실행해 경고가 실제로 해결됐는지 확인한다. 필요하면 이 과정을 반복하고, 마지막으로 초안 pull request를 연다. 기본 브랜치의 경고를 맡기거나, 하나의 pull request에서 최대 25개의 경고를 수정하도록 하거나, REST API를 통해 경고를 copilot-swe-agent[bot]에 할당할 수 있다. 이 기능을 활성화하면 무료 Generate Fix 옵션을 대체한다.
| 정식 출시된 GitHub 구성 요소 | 요금제 및 조건 | 과금 방식 |
|---|---|---|
| pull request용 AI Scan | 공개 저장소, 조직의 비공개 및 내부 저장소는 Code Security 또는 Advanced Security 필요, Copilot 라이선스 불필요 | Code Security AI Credits |
| 경고의 에이전트 기반 자동 수정 | 데이터 상주 지역 지원을 포함한 GitHub Enterprise Cloud의 Code Security 또는 Advanced Security, Agentic autofix 정책 및 Copilot 결제 수단 필요 | Code Security 예산의 AI Credits 및 GitHub Actions 실행 시간(분) |
이번 두 출시는 9월부터 이곳에서 다뤄 온 일련의 업데이트를 마무리한다. 9월 10일에는 AI Scan 활성화 API가, 9월 25일에는 Copilot Memory를 활용하는 에이전트 기반 자동 수정 미리 보기가, 10월 13일에는 security overview의 AI Scan 지표가 공개됐다.
🔗 pull request용 AI Scan(GitHub 변경 기록) · 코드 스캔 경고용 에이전트 기반 자동 수정(GitHub 변경 기록)
SPACE: Perplexity, Computer의 샌드박스를 Apache 2.0 라이선스로 오픈 소스 공개
10월 15일 — Perplexity가 Perplexity Computer의 모든 작업을 실행하는 샌드박스(sandboxes) 플랫폼 SPACE(Sandboxed Platform for Agentic Code Execution)를 오픈 소스로 공개한다. 전날 Perplexity는 SPACE가 각 요청을 적절한 샌드박스 실행 환경으로 전달하는 방식을 설명했다. 이제 코드 자체가 Apache 2.0 라이선스로 GitHub에 공개됐다. 각 에이전트 작업은 별도의 Firecracker microVM에서 실행되며, 자격 증명과 외부로 나가는 트래픽은 가상 머신 외부에서 통제된다.
보안 원칙은 한 가지다. 샌드박스를 신뢰할 수 없는 환경으로 간주한다. Computer의 에이전트는 그 안에서 root 권한으로 명령을 실행하고, 패키지를 설치하고, 외부 서비스를 호출한다. 하지만 호스트에는 접근할 수 없으며, 각 샌드박스 전용 게이트웨이가 모든 연결에 외부 통신 정책을 적용한다. 에이전트는 작업 환경에 자격 증명을 저장하지 않고도 허용된 서비스에 접근한다. 샌드박스는 자신을 생성한 요청이 끝나도 유지된다. 일시 정지하거나, 복제(fork)하거나, 메모리와 디스크 스냅샷으로 저장해 실행을 중단한 뒤 재개할 수 있다.
| SPACE 요소 | Perplexity가 제시한 값 |
|---|---|
| 저장소의 언어 및 라이선스 | Rust, Apache 2.0 |
| 격리 | 에이전트 작업마다 Firecracker microVM 하나 |
| 운영 환경의 규모 | 하루 수백만 개의 샌드박스 생성, 7월부터 모든 Computer 세션에 사용 |
| 기존 공급업체 대비 생성 속도 | 동일한 운영 트래픽에서 세 배에서 다섯 배 더 빠름 |
| Escaping SPACE, Part I | 108차례 시도에서 호스트로의 탈출 없음 |
| 버전 출시 일정 | 0.8.0을 공개 기준 버전으로 삼고, 이후 0.9.0과 1.0.0 출시 |
9월의 Escaping SPACE 평가에서는 가상 머신에서 호스트로 탈출한 사례가 발견되지 않았지만, 네트워크 제한을 우회한 사례는 있었다. 게시글에 따르면 이 문제들은 수정됐으며, 확인된 방법들은 후속 테스트에서 더 이상 통하지 않았다. Rust로 작성된 이 저장소는 로컬 테스트용 Kubernetes 클러스터(Kind)에 설치할 수 있으며, 미리 준비된 샌드박스 풀(warm pools)과 E2B API 호환 계층을 제공한다. 호환 계층은 E2B의 Python SDK로 테스트됐다. 0.9.0은 인터페이스 규약을 안정화한 1.0에 앞서 호환성을 깨뜨리는 변경을 도입하는 마지막 버전이 될 예정이다.
CoreWeave와 Akamai는 자사 플랫폼에서 SPACE를 테스트하고 가동했으며, 고객에게 제공하기 위해 작업 중이다. Crusoe도 Managed AI Services 상품에 이를 추가할 예정이다. Perplexity는 SPACE를 자사 에이전트 실행 플랫폼(Agentic Runtime Platform)의 첫 번째 구성 요소로 소개하며, 에이전트 기반 제품의 보안 수준을 높이기 위해 공개했다고 설명한다.
🔗 Perplexity 게시글 · @perplexity_ai의 게시글 모음 · SPACE 저장소(GitHub)
생성형 미디어: 일반 소비자용 GPU에서 실행되는 가중치 공개 모델 FLUX 3 Image Klein, 모두에게 공개된 Kling 4.0, ElevenLabs의 Instant Soundtracks
10월 15일 — Black Forest Labs가 가중치 공개 이미지 모델 FLUX 3 Image Klein을 출시한다. 매개변수 56억 개의 생성 전용 모델로, 일반 소비자용 GPU 한 개에서 실행된다. 동일한 모델이 텍스트로 이미지를 생성하고, 최대 10장의 참조 이미지 한 장 또는 여러 장을 바탕으로 편집한다. 10월 1일 출시된 FLUX 3 Image의 핵심 기능도 이어받았다. 네이티브 4K 생성, 픽셀 단위 정밀 편집, 그리고 prompt에서 요소의 위치를 지정하거나 편집 범위를 특정 영역으로 제한하는 경계 상자(bounding boxes)다.
BFL의 내부 평가에 따르면 Klein은 텍스트 기반 이미지 생성, 다중 참조, 편집 부문에서 더 큰 공개 모델인 Qwen-Image 2.1(7B)과 Krea 2(12,9B)를 앞섰다. 비교 대상인 두 비공개 모델 Ideogram V4.5와 FLUX.2 [pro]보다도 높은 순위를 기록했다. 이전 모델인 FLUX.2 [klein] 9B와 비교하면 매개변수가 38 % 적으면서도 텍스트 기반 이미지 생성에서 Elo 점수 91점, 편집에서 70점 높아졌다.
| 테스트 구성 | 발표된 결과 |
|---|---|
| BF16 / FP8 가중치 | 11,2 Go / 5,6 Go |
| GeForce RTX의 INT8 버전(ComfyUI 또는 Diffusers) | 8 Go의 VRAM으로 실행 |
| RTX 5090, INT8 증류 버전(NVIDIA 측정) | 1메가픽셀 이미지당 약 4 s |
| RTX 4070, INT8 증류 버전(NVIDIA 측정) | 1메가픽셀 이미지당 9 s 미만 |
| H100, Diffusers의 증류 버전 | 1024 × 1024픽셀 이미지당 약 2 s |
| GB300, NVFP4 증류 버전 | 1메가픽셀 이미지당 0,6 s 미만 |
Hugging Face는 출시 당일 두 가지 체크포인트와 함께 이를 Diffusers에 통합했다. 증류 버전은 16단계로 CFG 없이 실행되며, 기본 버전은 미세 조정용으로 50단계를 사용한다. NVFP4 및 FP8 가중치, Qwen3-VL 텍스트 인코더, LoRA 미세 조정 스크립트도 제공된다. NVFP4에서는 RTX 6000에서 추론 후 최대 메모리 사용량이 15.3 Gio에 달한다. ComfyUI, TensorRT-LLM, SGLang Diffusion, vLLM-Omni도 출시와 동시에 지원하며, FP8, INT8, NVFP4 버전은 NVIDIA와 공동 개발했다.
가중치는 FLUX Kommunity 라이선스로 공개된다. 개인과 연매출 500만 달러 미만 기업의 상업적 이용 및 연구 목적 이용은 무료다. 그 이상이면 자체 호스팅 라이선스를 구매하거나 API를 사용해야 한다. BFL API는 flux-3-image-klein를 1K 이미지당 0.009달러부터 제공한다. FLUX 3 Action에 이은 FLUX 3 계열의 두 번째 공개 모델이며, BFL은 후속 모델도 예고했다.
🔗 Black Forest Labs 게시글 · @bfl_ai의 발표 · Diffusers의 FLUX 3 Image Klein(Hugging Face)
Kling 4.0 전면 공개, MCP와 명령줄 접근 지원
10월 15일 — Kling AI가 9월 30일 시작한 사전 체험에 이어 Kling 4.0을 모두에게 공개한다. 이 영상 모델은 kling.ai의 개편된 제작 인터페이스에서 사용할 수 있다. 새롭게 MCP와 명령줄(CLI) 접근도 지원해 도구를 활용하는 제작 과정에 통합할 수 있다. 두 가지 기능도 곧 제공할 예정이지만 날짜는 공개하지 않았다. 4K 및 1080p의 10비트 HDR 영상 출력과 기업 및 개발자용 API 접근이다. 사양은 9월 28일 공개된 내용을 기준으로 한다. 3~30초 길이의 영상, 최대 4K, 스테레오 오디오, 키프레임 10개, 참조 자료 15개, 8 000 token의 prompt를 지원한다. 발표에는 가격이나 벤치마크가 제시되지 않았다.
🔗 Kling AI 발표 · Kling 버전 출시 안내
Instant Soundtracks: ElevenLabs, 영상에 맞춰 음악과 효과음을 동기화해 제작
10월 15일 — ElevenLabs가 ElevenCreative에 Instant Soundtracks를 출시한다. 영상을 업로드하면 모델이 독창적인 음악을 작곡하고, 효과음이 필요한 순간을 찾아 각 효과음을 정확한 시점에 배치한다. 예를 들어 광고 마지막의 로고 등장에 맞춰 « 슉 » 소리를 넣는 식이다. 이 도구는 짧은 영상에 초점을 맞춰 장면 전환과 편집 지점에 더 정밀하게 맞춘다. 장면마다 음악 분위기를 바꾸고, 원본 오디오를 장르, 템포, 악기 구성의 참조로 사용할 수도 있다. 효과음은 별도 트랙으로 제공되며 내보내기 전에 수정할 수 있다.
| ElevenCreative Studio API 매개변수 | 매개변수 역할 |
|---|---|
add_sfx | 동기화된 효과음 추가 |
separate_tracks | 음악과 효과음을 별도 파일로 반환(.ZIP) |
use_audio_as_reference | 원본 오디오를 음악 참조로 사용 |
Instant Soundtracks는 ElevenCreative, ElevenMusic, API에서 사용할 수 있다. API는 요청당 최대 10개의 영상, 200 Mo, 총 10분 분량의 영상을 허용한다. ElevenLabs는 가격을 공개하지 않았다.
코딩 에이전트: Cognition의 Devin Oncall 출시, Claude Code 2.1.301과 Code Review, Delta 0.20, Antigravity CLI 1.3.6, OpenAI의 Codex, MX Keypad
10월 15일 — Cognition이 Devin Oncall을 정식 출시한다. Devin은 경고와 버그 보고서를 자동으로 조사한 뒤, 팀이 운영 환경의 장애를 진단하고 해결하도록 돕는다. Datadog, Dynatrace, Sentry 등과 바로 연결되며, Cognition에 따르면 이미 세계 최대 규모 기업 일부에서 매일 수천 건의 운영 경고를 처리하고 있다. 아키텍처는 특정 모델에 종속되지 않는다. Cognition은 각 당직 대응 작업에 가장 효과적인 모델을 선택한다.
| 평가된 에이전트 및 모델 | 전체 과정 성공률(SREGym-Lite) | 점수 출처 |
|---|---|---|
| Devin Oncall + Claude Opus 5.5 | 100 % (2 min 21 s 소요) | Cognition 내부 평가 |
| Devin Oncall + GPT-6 Astra | 100 % | Cognition 내부 평가 |
| Devin Oncall + GPT-6.1 Sol | 94,1 % | Cognition 내부 평가 |
| Devin Oncall + Claude Fable 5.1 | 85,3 % | Cognition 내부 평가 |
| CloudThinker + Claude Opus 5 | 76,5 % | SREGym 공개 순위 |
| Codex + GPT-5.6 Sol | 76,5 % | SREGym 공개 순위 |
| Claude Code + Claude Sonnet 5 | 45,1 % | SREGym 공개 순위 |
SREGym-Lite는 실제 사고에서 가져온 17가지 장애로 구성된다. 에이전트는 한 번의 실행에서 근본 원인을 찾고 가동 중인 시스템을 수정해야 한다. Devin Oncall의 점수는 Cognition 내부 평가에서, 다른 에이전트의 점수는 10월 15일 기준 SREGym 공개 순위에서 가져왔다. 이 공개 순위에서는 CloudThinker도 GPT-6 Astra로 100 %를 달성했다. 따라서 이 벤치마크는 포화 상태다. Cognition에 따르면 이전 세대가 50~60 %에 머물렀던 것과 달리, 이제는 중간급 모델도 최고 점수를 얻고 있다.
게시글은 주로 모델 주변의 도구를 설명한다. 검토 에이전트가 조사와 병행해 작업하며 성급한 결론을 방지한다. 상관관계를 원인으로 오인하거나, 모순되는 원격 측정 데이터를 배제하거나, 촉발 요인을 근본 원인과 혼동하는 경우가 그 대상이다. 세 단계의 메모리가 기업에 대한 지식을 축적한다. 각 대응 에이전트 전용 메모리, 환경을 주기적으로 색인해 생성하는 skills, 각 조사를 통해 쌓이는 조직 메모리다. Auto-Triage의 차세대 기능으로 소개된 Responders는 경고 흐름을 감시하며, 이미 접한 문제를 알아보는 방식으로 약 60 %의 조사를 생략한다. 이를 통해 기존 자동화 비용의 절반 이상을 절감한다. Incidents 모드에서는 Devin이 장애 대응 채널에 참여하고, 장애 문서를 최신 상태로 유지하며, 하위 Devin들이 엔지니어의 직접적인 질문을 담당한다.
고객 세 곳의 사례가 이번 출시를 뒷받침한다. Reducto에서는 운영 경고가 발생하기 훨씬 전에 Devin이 스스로 장애 대응 건을 생성했다. Rivian과 Volkswagen의 합작사 RV Tech에서는 고객 보고서에서 차량 식별자와 타임스탬프를 추출하고, 로그를 수집해 초기 분류를 수행한다. AngelList에서는 자체 도구 Sky보다 정확한 근본 원인을 3.5배 더 자주 찾아내고, 장애의 절반을 단독으로 처리했다. 이에 따라 Sky는 폐기됐다. 가격은 발표되지 않았다. Devin Oncall 페이지에서는 사용을 시작하거나 시연을 예약할 수 있다. 이번 출시는 지난 7월 AI 지원 SRE 전문 기업 TierZero의 창업자들이 Cognition에 합류한 데 이어 나왔다.
🔗 Cognition 게시글 · @cognition의 게시글 모음 · Devin Oncall 페이지
Claude Code 2.1.301: 무인 모드에서 사용 한도 초기화 대기 시간에 상한 적용, 37개 오류 수정
10월 15일 — UTC 19시 22분에 공개된 Claude Code 2.1.301에는 추가 8건, 오류 수정 37건, 개선 4건, 변경 2건 등 총 51건이 포함됐으며, 무인 사용 환경을 우선적으로 다듬었다. 새로운 변수 CLAUDE_CODE_RETRY_WATCHDOG_MAX_USAGE_LIMIT_WAIT_MS을 사용하면 자동 재시도 모드(CLAUDE_CODE_RETRY_WATCHDOG)에서 도달한 사용 한도가 너무 늦게 초기화되는 경우 기다리는 대신 요청을 포기할 수 있다. 관측성 측면에서는 OpenTelemetry 이벤트 tool_decision에 이제 classifier_verdict과 permission_mode이 포함돼 자동 모드 분류기의 결정과 권한 규칙을 구분할 수 있다. 또한 차단을 유발한 내장 규칙을 나타내는 classifier_category도 포함된다(OTEL_LOG_TOOL_DETAILS=1 사용 시).
여러 수정 사항은 안정성을 높인다. 조직에서 최신 Fable을 사용할 수 없을 때 별칭 fable과 best이 더 이상 오류를 반환하지 않으며, Claude Code가 이전 Fable로 한 번 재시도한다. 세션을 종료할 때 WorktreeCreate hook이 생성한 worktree를 확인 없이 삭제하지 않으며, 이 worktree에는 아직 push하지 않은 commit이 있을 수 있다. Grep과 Glob은 검색이 실패하면 « 일치 항목 없음 »을 표시하는 대신 오류를 알린다. 컨텍스트 창이 더 작은 모델로 전환할 때 대화가 너무 길면 이전 모델이 먼저 대화를 요약한다. VS Code에서는 응답에 LaTeX 수식이 표시되며, 사용 한도 배너에 Pro 및 Max 구독자를 위한 « 사용량 추가 확보 » 링크가 제공된다.
Claude Code의 Code Review, 연구 프리뷰를 마치고 Team과 Enterprise에 정식 제공
10월 15일 — 3월 9일 연구 프리뷰로 출시된 지 7개월 만에 GitHub 풀 리퀘스트를 자동으로 검토하는 Claude Code 서비스인 Code Review가 Claude Team 및 Enterprise 조직에 제공된다. Anthropic에 따르면 대부분의 검토가 프리뷰 때보다 약 세 배 빠르게 끝나며, 문제와 발생 조건, 수정 방법을 짧게 정리한 결과를 제공한다. 관리자는 저장소별로 Quick, Standard(기본값), Deep 중 하나를 선택한다.
| Code Review 핵심 사항 | Anthropic이 공개한 세부 내용 |
|---|---|
| 검토 소요 시간 | 약 6~10분, 프리뷰에서는 약 20분 |
| 검토 요금 청구 | 소비한 토큰만큼 요금제 기본 제공 사용량 외의 사용 크레딧에서 차감하며, 월별 상한 적용 |
| 출시 기념 크레딧 | 자격을 갖춘 Enterprise 조직에 최소 10 000달러 제공, 2027년 1월 15일까지 신청, 유효 기간 30일 |
| 현재 제외 대상 | Zero Data Retention, HIPAA 구성, 현재로서는 고객 관리 암호화 키(CMEK)도 제외 |
기본 원칙은 그대로다. 검토 결과는 심각도에 따라 분류된 인라인 댓글로 전달되며, 함께 실행되는 check run은 항상 통과한다. 검토가 풀 리퀘스트를 승인하거나 차단하지 않으며, 병합 결정은 팀에 맡긴다.
🔗 Code Review 정식 출시(Claude) · Code Review 문서
Delta 0.20: 하위 에이전트가 직접 제어할 수 있는 하위 스레드로 전환되고, 에이전트가 MCP 서버에 접근
10월 14일 — Zed 제작진의 다중 사용자 코딩 환경인 Delta가 0.20 버전으로 업데이트됐다. 새 기능 18건, 개선 14건, 오류 수정 29건이 포함됐으며, 같은 날 0.20.1에서 오류 한 건이 추가로 수정됐다. 하위 에이전트는 내용을 살펴보고, 방향을 바꾸고, 사용자가 직접 이어서 작업할 수 있는 일반 하위 스레드가 되며, 하위 스레드 안에 다른 하위 스레드를 둘 수도 있다. 하위 에이전트 활성화 설정은 위임 설정으로 바뀌고, 끄기, 요청할 때만, 최대의 세 가지 옵션을 제공한다. 에이전트는 설정 → MCP에서 연결한 MCP 서버에 접근할 수 있으며, 하위 스레드에서 시작한 검토나 Land 작업은 상위 스레드에서 물려받은 변경 사항도 포함한다. 이번 버전에는 사용자 자신의 Google 키로 사용하는 Gemini 4 Argon, /create-skill 명령, 터미널에서 조직을 관리하는 delta org 명령도 추가됐다.
10월 15일에는 콘래드 어윈의 발표를 바탕으로 한 글이 공개돼, 키 입력을 하나하나 서버와 협업자에게 전송하는 협업 계층 DeltaDB를 자세히 설명했다. diamond-types에서 착안한 CRDT를 사용하며, 각 변경은 Git 버전이나 이전 변경 사항에 연결된다. 각 문자가 자신을 생성한 변경 사항을 알고 있으므로 Delta는 여기에 작성자, 에이전트, 나아가 프롬프트까지 연결할 수 있다.
🔗 Delta 릴리스 노트 · DeltaDB: 버전 관리의 미래
Antigravity CLI 1.3.6: 1.3.5의 Auto 모드와 /compact에 이어 Google Cloud 인증 정보로 Claude 5.5 사용
10월 14일 — Google이 Gemini CLI의 후속 도구로 소개하는 명령줄 에이전트 도구 Antigravity CLI가 잇따라 업데이트되고 있다. 이곳에서 10월 8일 소개한 1.3.1 이후 다섯 버전이 연이어 나왔다. 1.3.6은 Google Cloud의 기본 인증 정보(Application Default Credentials, AGY_ADC_AUTH)로 로그인한 사용자에게 Claude Opus 5.5와 Claude Sonnet 5.5를 추가한다. Google Cloud 프로젝트에 접근 권한이 있는 경우에만 /model에 Claude 모델이 나타난다. 끝없이 멈춰 있는 문제도 해결했다. 모델로부터 5분간 데이터가 오지 않으면 요청을 취소하고 자동으로 재시도한다.
가장 눈에 띄는 새 기능은 1.3.5의 Auto 모드다. 파일 수정과 안전하다고 판단한 명령은 스스로 승인하지만, 되돌릴 수 없는 작업은 여전히 실행 전에 확인한다. 터미널 샌드박스를 벗어나는 명령은 별도의 에이전트가 먼저 검토한다. 1.3.6에서는 이 검토가 빨라졌고, 프로젝트의 서식 지정 및 lint 명령은 허용하며 민감한 데이터를 전송하는 명령은 차단한다. Linux와 macOS에서 --mode auto, /config 또는 Shift+Tab으로 모드를 활성화할 수 있다. Windows는 추후 지원된다. 1.3.5에는 요청에 따라 대화를 요약해 컨텍스트 창에 여유를 확보하는 /compact도 추가됐다.
| Antigravity CLI 버전 | 변경 기록 날짜 | 개선 및 오류 수정 | 버전의 주요 내용 |
|---|---|---|---|
| 1.3.6 | 10월 14일 | 3 + 10 | ADC를 통한 Claude Opus 5.5 및 Sonnet 5.5 사용, 5분간 멈추면 재시도 |
| 1.3.5 | 10월 13일 | 5 + 1 | Auto 모드, /compact, /diff의 구문 색상 표시 및 접기 |
| 1.3.4 | 10월 12일 | 4 + 10 | agy plugin list --json, --effort 없이 모델 선택 |
| 1.3.3 | 10월 9일 | 6 + 15 | MCP 도구 상시 로드, 샌드박스 강화 |
| 1.3.2 | 10월 7일 | 6 + 4 | /plugin 및 공식 플러그인 마켓플레이스 |
OpenAI 내부의 Codex: Core Experimentation 팀, GPT-6 Astra와 GPT-6.1 Sol로 유지보수 PR 1 400건 이상 병합
10월 14일 — OpenAI Developers 블로그에서 전사적으로 사용하는 실험 소프트웨어를 유지보수하는 Core Experimentation 팀의 한 엔지니어가 GPT-6 모델이 Codex에서 저장소 유지보수를 맡게 된 과정을 소개했다. 출발점은 사용되지 않는 코드를 찾아 정리하라는 짧고 의도적으로 모호한 프롬프트였다. GPT-5.6 Sol은 이를 끝까지 수행하지 못했다. 반면 GPT-6 Astra는 과거 PR, Slack 스레드, 내부 추적 도구, 운영 환경의 프로파일링 표를 살펴본 뒤 각 삭제의 근거를 제시했다. 이후 엔지니어 다섯 명이 2주 동안 다른 업무와 병행하며 이 프롬프트를 변형해 사용했다. 그 결과 풀 리퀘스트 1 400건 이상을 병합하고, 800 000줄 이상을 삭제했으며, 한 서비스의 컨테이너 이미지를 3,31 Go에서 1,72 Go로 줄였다(-48 %).
| 모델 및 추론 노력 수준 | 작업 API 비용 | 채택된 발견 사항 | 발견 사항당 비용 |
|---|---|---|---|
| GPT-6 Astra Ultra | 109,06달러 | 142 | 0,77달러 |
| GPT-6.1 Sol Ultra | 15,12달러 | 131 | 0,12달러 |
| GPT-6.1 Sol Medium | 5,27달러 | 86 | 0,06달러 |
Python, TypeScript, Go, Rust로 작성된 파일 6 000개 이상, 코드 100만 줄을 대상으로 한 동일한 정리 작업에서 GPT-6.1 Sol은 Ultra 추론 수준으로 GPT-6 Astra Ultra가 찾아낸 사항의 92 %를 API 비용 14 %로 찾아냈다. 차이는 주로 다른 기능 플래그의 의존성으로 사용되는 상수 기능 플래그(feature flags)에서 발생했다. Astra는 이를 찾아냈지만 Sol은 놓쳤다. 최적화 PR 약 30건으로 CI 소요 시간 중앙값도 약 10분에서 4,5분으로 줄었다. 글쓴이는 일부 제안이 얻는 이익보다 복잡성을 더 늘렸다고 인정하며, 작게 시작하라고 조언한다.
🔗 GPT-6 제품군을 활용한 소프트웨어 유지보수(OpenAI Developers)
MX Keypad: GitHub과 Logitech, 프로그래밍 가능한 키패드로 GitHub Copilot 앱 제어
10월 15일 — GitHub 개발자 관계 부사장 마틴 우드워드가 « 주변 환경에 스며드는 지능 »을 다룬 글에서 Logitech과 18개월간 협업한 결과물을 소개했다. 프로그래밍 가능한 키패드인 MX Keypad가 GitHub Copilot 앱과 통합된다. 키 하나로 매개변수가 설정된 프롬프트를 제출하거나, Copilot 세션을 열거나 재개하고, IDE 명령을 호출하거나 여러 단계로 이루어진 작업을 실행할 수 있다. 글은 이 기기를 세 계층으로 구성된 구상 안에 배치한다. 입력 방식인 텍스트, 음성, 물리적 조작 장치가 의도를 포착하고, 하네스가 계획하고 실행하며, 제어 계층이 개발자에게 살펴보고 방향을 바꾸고 승인할 수 있는 수단을 제공한다. 글쓴이는 이 경험이 « 아직 초기 단계 »(아직 초기 단계)에 있으며 모든 개발자에게 기기가 하나 더 필요한 것은 아니라며 신중한 태도를 보인다. 링크를 통해 GitHub Copilot Pro+ 3개월 무료 혜택과 함께 MX Keypad를 체험할 수 있지만, 글에는 가격이나 출시일이 제시되지 않았다.
🔗 다음 개발자 인터페이스는 주변 환경에 스며드는 지능이다(GitHub 블로그)
모델 안전성: METR, Anthropic에서 직원 수준의 접근 권한 확보… IPI Black, 프롬프트 인젝션 공격에 300 000달러 상금
같은 날 모델 안전성을 외부에서 검증하도록 하는 두 가지 시도가 나왔다. Anthropic 내부에 자리 잡은 독립 평가팀과 에이전트 공격 공개 대회다.
METR, Anthropic에서 직원에 준하는 접근 권한 확보
10월 15일 — Anthropic은 최첨단 AI 모델을 평가하는 비영리 단체 METR의 팀에 « 직원에 준하는 접근 권한 »(직원에 준하는 접근 권한)을 부여하며 내부에 받아들이기 시작했다. METR 소속 6명에게 회사 장비와 사무 공간을 제공하고, Anthropic의 위험 평가팀과 거의 동등한 수준으로 내부 도구와 시스템에 접근할 수 있게 했다. 고객 데이터, 변호사와 의뢰인 간 비밀유지 특권이 적용되는 정보, 모델 아키텍처만 접근 대상에서 제외된다. METR는 위험 분석 결과를 공개할 예정이며, Anthropic은 이를 막을 수 없다. 사전에 좁게 정한 범주에 해당하는 정보의 삭제만 요구할 수 있고, METR는 그러한 삭제가 정당하다고 보는지 공개적으로 밝힐 자유를 유지한다.
| 평가자 접근 수준 | 정보 접근 범위 | 공개 권한 | Anthropic이 언급한 평가 기관 |
|---|---|---|---|
| 수준 1 | 특정 사안 조사, Anthropic이 접근 여부 결정 | Anthropic 승인 필요 | SecureBio |
| 수준 2 | 더 많은 정보 | 승인 불필요, 특정 범주의 정보 삭제 가능 | 언급 없음 |
| 수준 3 | 직원에 준하는 접근 권한 | 수준 2와 동일 | METR |
Anthropic은 Accenture 및 Faculty와도 모델 평가와 레드팀 활동, 정렬 평가, 보호 장치 시험을 위한 협력을 준비하고 있으며, Hugging Face를 비롯한 다른 조직과도 초기 논의를 진행하고 있다. 회사는 이 체제를 대형 은행 내부에서 상주 검사관이 근무하는 은행 감독 방식에 비유한다. 또한 독립적인 외부 평가 기관과 협력하겠다는 기업들의 약속을 담은 백악관 초지능 협약에 서명한 이후의 후속 조치로 설명한다.
IPI Black: Gray Swan, 상금 300 000달러 규모의 간접 프롬프트 인젝션 대회 개최
10월 15일 — Gray Swan이 Anthropic, Meta, Google DeepMind, Reflection AI, OpenAI, Amazon, Thinking Machines, AI Security Institute의 지원을 받아 상금 300 000달러 규모의 간접 프롬프트 인젝션 공개 대회 IPI Black(간접 프롬프트 인젝션: 블랙)을 시작한다. 참가 경험은 필요하지 않다. 참가자는 Gmail, Slack, GitHub, X 등 실제와 유사한 도구를 갖춘 시뮬레이션 환경에서 에이전트를 공격한다. 예를 들어 소셜 미디어 담당자의 글쓰기 에이전트가 기업 공식 계정에 유해한 콘텐츠를 게시하도록 유도하는 방식이다. 화이트박스에서는 에이전트의 응답을 보며 공격을 다듬을 수 있고, 블랙박스에서는 아무것도 보지 못한 채 공격 페이로드를 제출한다.
대회는 10월 15일, 22일, 29일에 각각 시작되는 세 차례의 일주일 단위 라운드로 진행된다. 라운드마다 별도 순위를 매기며, 화이트박스와 블랙박스 부문에 총 100 000달러를 나눠 지급한다. 첫 라운드에는 화이트박스 6개, 블랙박스 4개 등 시나리오 10개가 제공된다. GitHub issue 댓글에 식별자를 유출하는 상황부터 허위 내부 고발 신고까지 포함한다. 수집된 공격은 협력 연구소들이 모델의 견고성을 측정하는 데 사용하는 벤치마크에 반영된다. Claude Code 제작자 보리스 체르니도 대회를 소개했다. 그는 지난 몇 년간 Claude 모델의 프롬프트 인젝션 대응 능력이 크게 향상됐지만, 에이전트가 더 많은 일을 맡게 되면서 업계 전반에서 이 문제를 해결하는 일이 시급해지고 있다고 밝혔다.
🔗 Gray Swan의 스레드 · 대회 페이지 · 보리스 체르니의 게시물
새로운 모델: 시계열용 Timestral, StepFun의 Step 5 Preview, Apertus 1.5와 Jev 1.14
서로 성격이 다른 네 가지 발표가 나왔다. Mistral의 예측 모델 제품군, StepFun의 대규모 개방형 MoE, 스위스의 완전 개방형 모델들, TypeSafe의 의사결정 모델이다.
Timestral: Mistral, 첫 시계열 파운데이션 모델 제품군 공개
10월 15일 — Mistral이 첫 시계열 파운데이션 모델(시계열 기반 모델) 제품군인 Timestral을 공개했다. 동일한 아키텍처와 학습 방식을 공유하며, 매개변수 규모는 5M, 28M, 123M, 209M의 네 가지다. 모델은 확률적 예측(21개 분위수)과 다변량 예측을 수행하고, 과거에만 알려진 공변량이나 사전에 알려진 공변량(생산 일정, 계획된 가동 중단, 일기 예보)을 반영한다. 기계 상태와 같은 범주형 공변량도 처리하며, 최대 32 768개 시간 단계의 과거 데이터를 읽는다.
| 벤치마크 및 지표 (낮을수록 좋음) | Timestral-209M | t0-gamma | TimesFM-3 | Chronos-2 |
|---|---|---|---|---|
| GIFT-Eval, MASE | 0,658 | 0,661 | 0,667 | 0,698 |
| GIFT-Eval, CRPS | 0,446 | 0,452 | 0,456 | 0,485 |
| TIME, MASE | 0,626 | 0,637 | 0,640 | 0,662 |
| TIME, CRPS | 0,522 | 0,534 | 0,536 | 0,556 |
Mistral에 따르면 209M 모델은 추가 적응 없이 사용하는(제로샷) 사전 학습 모델 가운데 GIFT-Eval, TIME, fev-bench에서 1위를 차지했다. 단일 체크포인트를 사용하고 앙상블을 적용하지 않았으며, 이전 최고 성능 모델의 3분의 2에 해당하는 매개변수만으로 이를 넘어섰다. 다만 선두 모델 간 격차는 작으며, 소형 28M 모델도 이미 GIFT-Eval과 TIME에서 약 네 배 더 큰 Chronos-2를 앞선다. Timestral에는 GPU가 필요하지 않다. 8스레드 서버 프로세서에서 15분 간격의 3주치 과거 데이터로 하루를 예측하는 데 5M 모델은 10 ms, 209M 모델은 140 ms가 걸린다. 가중치는 월 연결 매출이 2천만 달러를 넘는 기업을 제외하는 « 수정 MIT » 라이선스로 Hugging Face에 공개됐고, 코드는 Apache-2.0으로 GitHub에 공개됐다. 문서에서는 Timestral 1.0을 공개 프리뷰로 소개한다. Mistral Forge를 통해 독점 데이터로 미세 조정할 수 있으며, 네트워크 연결 없이 배포할 수도 있다.
🔗 Timestral 소개 (Mistral) · Hugging Face의 Timestral-209M
Step 5 Preview: NVIDIA에 따르면 StepFun이 24시간 에이전트 작업을 위한 6천억 매개변수의 공개 MoE 모델 출시
10월 15일 — NVIDIA가 Step 5 Preview 출시를 환영했다. @NVIDIAAI 계정은 이를 StepFun의 역대 최대 규모 공개 가중치 모델로 소개하며, 최대 24시간 지속되는 에이전트 작업을 위해 설계된 6천억 매개변수의 전문가 혼합 모델이라고 설명했다. NVIDIA는 GB300에서 NVFP4를 사용할 때 GPU당 초당 약 8 000토큰을 처리한다고 밝혔다. NVFP4 체크포인트는 Hugging Face에 공개됐으며, SGLang과 vLLM용 배포 지침, NeMo AutoModel을 활용한 사후 학습, 명령 하나로 실행하는 NIM도 제공한다. NVIDIA 게시물에는 벤치마크나 라이선스 정보가 없다.
Apertus 1.5: Swiss AI, 이미지·오디오와 262 144토큰 문맥을 지원하는 완전 공개 8B·70B 모델 상세 소개
10월 15일 — 스위스의 Swiss AI 이니셔티브가 완전 공개 모델 제품군인 Apertus 1.5의 릴리스 노트와 기술 보고서를 공개했다. 8B와 70B 가중치는 7월 24일부터 Apache 2.0으로 공개돼 있었다. 보고서에서는 다른 연구자들이 각 학습 단계의 영향을 연구할 수 있도록 중간 체크포인트(기본 모델, SFT, RLVR, DPO), 데이터 혼합 구성, 평가 자료도 공개했다.
| Apertus 1.5 모델 | 추가 사전 학습 토큰 수 | 총 토큰 수 |
|---|---|---|
| 8B | 4 000 × 10억 | 19 000 × 10억 |
| 70B | 2 000 × 10억 | 17 000 × 10억 |
이미지와 오디오는 별도 인코더 없이 토크나이저를 거친다. 512 × 512픽셀 이미지는 1 024토큰으로, 오디오 1초는 40토큰으로 변환돼 텍스트만 사용할 때와 같은 속도로 학습한다. 모델은 이미지와 오디오를 이해하지만 텍스트만 생성하며, 오디오 기능은 아직 실험 단계다. 선택적으로 사용하는 사고 모드와 네 배 더 긴 262 144토큰 문맥도 추가됐다. 저자들은 최고 수준의 공개 모델에는 여전히 뒤처진다고 인정하면서도, 8B 모델은 지시 이행과 다국어 성능에서 같은 크기의 모델들을 앞선다고 설명했다. 다만 게시물에 구체적인 점수는 없다. 결과는 유럽연합 인공지능법 준수를 염두에 두고 설계된 Every Eval Ever 형식으로 공개됐다.
🔗 Apertus 1.5 릴리스 노트 (Hugging Face)
Jev 1.14: TypeSafe, 이미지·Box 질문·네 배 더 긴 문맥을 프리뷰로 공개
10월 14일 — TypeSafe가 의사결정 모델의 새 버전인 Jev 1.14를 발표하며, 구체적인 수치 없이 « 새로워지고 개선됐다 »고 소개했다. 세 가지 실험적 기능이 함께 제공된다. 첫째는 기존에 텍스트를 넣던 어디에나 넣을 수 있는 이미지로, 현재 Jev에서도 사용할 수 있다. 둘째는 System One의 새로운 질문 유형인 Box로, 이미지 속 객체의 경계를 네 변의 위치로 반환하며, 각 위치는 이미지 너비와 높이에 대한 비율로 표현된다. 셋째는 네 배 더 긴 문맥이지만, TypeSafe는 여전히 문맥 길이를 제한할 것을 권한다. TypeSafe에 따르면 이 기능들은 아직 프리뷰 단계로 운영 환경에 쓸 수준에는 이르지 않았으며, TypeSafe-Danger-Zone-Images: true 헤더로 활성화한다. Box 질문에는 Jev 1.14가 필요하며, jev-preview 또는 jev-1.14.0로 호출한다. Zed는 출시를 환영하며 웨스 보스의 계산을 인용했다. 이에 따르면 850 × 850픽셀 이미지에 대한 질문 한 번의 비용은 0,000096936달러로, 1달러에 약 10 000장의 이미지를 처리할 수 있다. 이는 웨스 보스의 계산이며 TypeSafe가 공개한 요금은 아니다.
🔗 TypeSafe 발표 · Box 문서
과학을 위한 인공지능: CERN과 Mistral은 Large Physics Model 추진, Sakana AI는 The Agentic Scientist 공개, OpenAI는 수학자 지원
인공지능을 연구에 활용하는 세 가지 접근법이다. 충돌기 물리학을 위한 파운데이션 모델, 연구 전 과정을 수행하도록 체계를 갖춘 코딩 에이전트, 그리고 수학자들이 인공지능이 산출한 결과를 검증할 수 있도록 돕는 자금 지원이다.
CERN과 Mistral, Large Physics Model 개발 위해 협력
10월 15일 — CERN과 Mistral이 과학적 발견을 위한 파운데이션 모델에 초점을 맞춘 장기 전략적 협력 관계를 추진하기 위해 의향서(협력 의향서)에 서명했다. 프로젝트의 핵심은 사전 학습된 단일 Large Physics Model이다. CERN은 이를 최초의 충돌기 물리학용 파운데이션 모델로 소개하며, 대형 강입자 충돌기(LHC)의 양성자 간 충돌을 모사한 수십억 건의 데이터로 학습한다고 설명했다. 이 모델은 충돌 재구성, 입자 식별, 예상치 못한 신호 탐지, 미래 검출기 설계 평가 등 여러 작업을 수행하도록 개발된다. 현재는 이런 분석에 특화된 알고리즘을 연속으로 적용한다. CERN은 이미 약 1엑사바이트(100만 테라바이트)의 LHC 실험 데이터를 저장했으며, 2030년경 가동을 목표로 하는 고휘도 LHC(HL-LHC)에서는 충돌 횟수가 열 배로 늘어날 전망이다. 보도자료는 CERN 최고정보책임자 엔리카 포르카리와 Mistral의 엔지니어링 인공지능 부문 부사장 요하네스 브란트슈테터를 인용하지만, 투자 금액이나 일정, 연산 자원은 밝히지 않았다.
🔗 CERN 보도자료 · @MistralAI의 게시물 묶음
The Agentic Scientist: Sakana AI, 코딩 에이전트가 연구 전 과정을 수행하도록 체계 구축
10월 15일 — Sakana AI가 AI Scientist의 차세대 버전인 The Agentic Scientist를 공개했다. AI Scientist는 2024년부터 인공지능이 어디까지 스스로 연구를 수행할 수 있는지 시험해 온 프로젝트다. 출발점은 다음과 같은 관찰이다.
Coding agents such as Codex and Claude Code now carry out long software tasks on their own. Handing them a research problem, however, tends to produce a strong hyperparameter optimizer rather than a scientist: scores go up, but ideas stay narrow, and the reasons for the gain are rarely examined.
🇰🇷 Codex와 Claude Code 같은 코딩 에이전트는 이제 긴 소프트웨어 작업을 스스로 수행한다. 하지만 연구 문제를 맡기면 과학자보다는 뛰어난 하이퍼파라미터 최적화 도구에 가까운 모습을 보이는데, 점수는 올라가지만 아이디어의 범위는 좁고 성능 향상의 이유를 검토하는 일은 드물다. — @SakanaAILabs의 X 게시물
이에 대한 해법은 기존 코딩 에이전트(Codex, Claude Code, OpenCode, Pi)를 둘러싼 지원 체계다. 병렬로 작동하는 에이전트들이 실험 전에 확정한 평가 기준에 따라 가설을 검증하고, 공동 메모리에 성공과 실패를 공유한다. 이후 시스템은 기준선 실험, 절제 실험, 봉인된 최종 평가, 분석을 차례로 수행하고 논문 작성까지 이어 간다. Sakana AI는 5개 주제에 대해 9개 모델(GPT 4개, Claude 4개, DeepSeek 1개)과 4개 하네스를 사용해 평가했다. 총 14개 모델·하네스 조합으로 70차례 연구를 진행한 결과, 최신 모델일수록 더 나은 논문을 작성했고 하네스 선택보다 모델 선택이 더 큰 영향을 미쳤다. 개발 버전은 연구자들과 생물학에서 영감을 얻은 학습 규칙인 Error Diffusion에 관한 논문을 공동 집필했으며, 이 논문은 ALIFE 2026 구두 발표로 채택됐다. 긴 문서에서 사실을 찾아내는 작업(Doc-to-LoRA)에서는 모델을 재학습하지 않고 정확도를 52 %에서 98 %로 높였다. 코드는 Apache 2.0으로 공개됐다. Sakana AI는 여전히 사람이 연구 질문을 선택하고 주장을 검증해야 하며, 에이전트가 모든 권한을 가진 상태로 실행되므로 Docker 사용을 권장한다고 덧붙였다.
🔗 Sakana AI 게시글 · arXiv 논문 · AI-Scientist-v3 저장소
OpenAI, 수학자를 위한 Simons Foundation의 새 사업에 500만 달러 지원
10월 15일 — OpenAI가 Simons Foundation의 새 사업에 500만 달러를 기부한다고 발표했다. 이 사업은 OpenAI가 최근 공개한 결과를 포함해 인공지능이 산출한 결과를 수학자들이 검토하고 이해하며 확장하도록 돕는 것이 목적이다. OpenAI는 10월 6일 비공개 내부 모델에서 나온 수학적 결과를 담은 원고 722편을 공개하면서, 형식적으로 검증되지 않은 일부 결과에는 오류가 있을 수 있다고 경고했다. 자금은 재단이 관리하고 배분하며 워크숍, 학술회의, 특별 프로그램에 사용된다. OpenAI는 Simons Foundation이 지원하는 연구자들에게 자사 모델과 연산 자원에 대한 접근 권한도 제공한다. 발표 게시물은 Simons Foundation의 게시물을 인용했다. 재단은 워크숍과 각종 사업에 총 1,500만 달러를 투입하고, Anthropic 및 OpenAI와의 새로운 협력 관계를 통해 지원 대상 연구자들에게 무료 연산 자원을 제공한다. X의 짧은 게시물로 이뤄진 이번 발표에는 사업명이나 일정이 명시되지 않았다.
🔗 OpenAI 발표 · 10월 6일 공개된 원고 722편 (OpenAI)
Claude Opus 5.5: 고속 모드 연구 프리뷰 종료, 100만 토큰당 8달러·40달러
10월 15일 — Claude Opus 5.5의 고속 모드(빠른 모드)가 Claude Platform에서 연구 프리뷰 단계를 벗어났으며, 대기 명단 없이 이용할 수 있다. 같은 가중치를 사용하는 동일한 모델이지만, 초당 출력 토큰 수가 최대 2.5배 많고 요금은 Opus 5.5 일반 요금의 두 배다. 요청에 더 이상 베타 헤더 fast-mode-2026-02-01를 넣을 필요가 없으며, 이 헤더를 계속 보내는 요청도 허용된다. 이제 각 사용 등급에는 이 모드의 기본 처리량 한도가 설정되며, 일반 속도의 Opus 한도와 별도로 적용된다.
| 고속 모드 Claude 모델 | 10월 15일 기준 상태 | 100만 토큰당 요금 (입력 / 출력) |
|---|---|---|
| Opus 5.5 | 이용 가능, 대기 명단 및 베타 헤더 불필요 | 8 / 40달러 (일반 속도 4 / 20) |
| Opus 5 | 연구 프리뷰, 베타 헤더 필요 | 10 / 50달러 |
| Opus 4.8 | 연구 프리뷰, 베타 헤더 필요 | 10 / 50달러 |
개선되는 것은 출력 처리량이며 첫 토큰이 나올 때까지의 지연 시간은 아니다. 속도를 변경하면 프롬프트 캐시가 무효화되며, Batch API에서는 여전히 사용할 수 없다. Azure에서 호스팅되는 배포를 위해 Microsoft Foundry에서도 제공되며, 현재 문서에서도 이를 확인할 수 있다. @ClaudeDevs에 따르면 Google Cloud에도 추후 제공될 예정이며, Amazon Bedrock과 Claude Platform on AWS에서는 아직 사용할 수 없다. Claude Code에서는 변경 사항이 없으며, 고속 모드는 계속 추가 사용 크레딧을 소모한다.
Hugging Face 라이브러리: Transformers 5.20.0과 TRL 1.16.0, Muse Spark Open 지원
Hugging Face의 두 대표 라이브러리가 Muse Spark Open 출시 당일 새 버전을 공개하며 지원을 추가했다. 각각 별도의 새 기능도 포함한다.
Transformers 5.20.0: 모델 7종 추가 및 내보내기 시 양자화 지원
10월 15일 — Hugging Face가 Transformers 5.20.0을 공개했다. 이번 버전의 핵심은 Muse Spark Open으로, 모델 출시 당일부터 지원한다. 그 밖에 모델 6종도 라이브러리에 추가됐다.
| Transformers에 추가된 모델 | 모델 개발사 | 기술적 특징 |
|---|---|---|
| Muse Spark Open | Meta | 멀티모달 MoE, 매개변수 816 × 10억 개 중 42 × 10억 개 활성화 |
| Ling 3.0 Flash | InclusionAI | 하이브리드 MoE, MLA 계층 하나당 Kimi Delta Attention 계층 다섯 개 |
| Kolibri 1 | Aleph Alpha | 독일어·영어 추론용 MoE, 토큰당 전문가 6개 활성화, 전체 384개 |
| MiniCPM-V 4.7 | OpenBMB | 이미지와 동영상용 M-RoPE 캔버스 위치 |
| UnlimitedOcr | Baidu | 매개변수 3 × 10억 개의 OCR, 일정한 KV 캐시 크기 |
| UltraBERT | DMIS Lab | 매개변수 150M 및 380M 인코더, 32K 토큰 문맥 |
| MOSS-Transcribe-Diarize | OpenMOSS | 매개변수 0,9 × 10억 개, 50개 이상 언어의 음성 전사 및 화자 분리 |
도구 측면에서는 이제 ONNX, OpenVINO, ExecuTorch로 내보내는 과정에서 양자화를 수행할 수 있다. 또한 FSDP와 텐서 병렬 처리를 결합한 학습의 체크포인트를 다른 구성에서도 다시 불러올 수 있다. 다만 Hugging Face는 전문가 병렬 처리를 사용한 추론에서 속도 저하가 발생해 수정 중이라고 알렸다. 사용 중단이 예고됐던 캐시 메서드 제거를 비롯해 하위 호환성을 깨뜨리는 여러 변경 사항도 있다고 밝혔다.
TRL 1.16.0 : AWS Trainium 훈련 지원과 최대 3,1배 빨라진 AsyncGRPO
10월 15일 — TRL 1.16.0이 Hugging Face 훈련 라이브러리에 AWS Trainium 칩 지원을 추가했다. 새로운 기본 설정은 시퀀스 길이가 달라질 때마다 Trainium이 재컴파일하는 일을 막아 소규모 시험 훈련 시간을 절반으로 줄인다. Trainium2에서 Qwen3-0.6B의 SFT 20단계를 실행하는 데 걸리는 시간이 260초에서 130초로 단축됐다. 또 다른 새 기능은 에이전트 강화 학습을 겨냥한다. 여러 대화 턴이나 여러 번의 생성으로 구성된 생성 궤적(rollouts)에서는 같은 대화 시작 부분이 행마다 반복되는데, AsyncGRPO는 이제 이를 접두사 트리로 구성해 한 번만 계산한다. Qwen3-1.7B에서 궤적당 32K 토큰을 사용할 때 속도는 최대 3,10배 빨라지고 최대 메모리 사용량은 35,2 Gio에서 13,5 Gio로 줄어든다. 공유 접두사가 없을 때 추가 부담은 약 1 %다. 이번 버전은 H100 GPU 64개에서 LoRA로 미세 조정할 수 있는 Muse Spark Open도 지원하며(단계당 14,2초, GPU당 40,2 Go), 비동기 트레이너에서 AMD GPU도 지원한다.
GPT-Live-1.1 : ChatGPT, Codex, dots에 새로운 음성과 더 자연스러운 억양 도입
10월 15일 — OpenAI가 음성 모델을 업데이트한다. GPT-Live-1.1과 이 모델의 소형 버전으로 소개된 GPT-Live-1.1 Quip이 ChatGPT, Codex, dots의 음성 모드에 배포되며, 언어별 억양이 더 자연스러워졌다. dots는 9월 29일 출시된 상시 에이전트다. 모델은 검색을 시작할 때 말하는 짧은 문장도 더 다양하게 구사한다. OpenAI는 이 개선을 “*확인 중…*이라는 말을 덜 한다”라고 요약했다.
프랑스어, 독일어, 힌디어, 일본어, 한국어, 멕시코 스페인어 등 6개 언어에 새로운 Live 음성이 추가되며, Bubbie라는 영어 음성도 더해진다. 제공되는 음성은 지역과 계정에 따라 다를 수 있으며, 설정 > 음성에서 선택할 수 있다. 업데이트는 10월 15일부터 모든 사용자에게 순차 배포되며 API에도 “곧” 도입될 예정이다. API에서는 9월 10일부터 GPT-Live-1을 분당 0,05달러에 제공하고 있다. OpenAI는 벤치마크나 요금제별 GPT-Live-1.1 및 Quip 제공 범위를 공개하지 않았다.
Universal Cart : Google, 미국에서 Google Search와 Gemini 앱의 통합 장바구니 출시
10월 15일 — Google이 미국에서 Universal Cart를 출시한다. 지난 5월 Google I/O에서 미리 공개한 이 “지능형” 장바구니는 AI Mode를 포함한 Google Search와 Gemini 앱에 함께 배포된다. 어느 쪽에서 상품을 추가하든 판매점에 관계없이 같은 장바구니에 담긴다. 발표 글에서는 AI Mode에서 가방을 추가하고 Gemini 앱에서 스웨터와 립글로스를 추가한 뒤, 나중에 한곳에서 모두 확인하는 예를 들었다.
| Universal Cart 기능 | Google이 설명하는 이점 |
|---|---|
| 여러 판매점 통합 장바구니 | Google의 여러 화면과 앱에서 하나의 장바구니 유지 |
| 가격 및 재고 알림 | Shopping Graph의 60십억 개가 넘는 상품 정보에 대한 가격 인하 및 재입고 알림 |
| Google Wallet 연동 | 결제 수단 선택에 도움이 되는 등록 카드 혜택과 관련 할인 코드 제공 |
| 구매 상품 결제 | 장바구니에서 Google Pay로 결제(Universal Commerce Protocol)하거나 판매점 사이트로 이동 |
직접 결제는 Nike, Sephora, Target, Ulta Beauty, Walmart, Wayfair와 다수의 Shopify 판매점에서 사용할 수 있다. 모든 경우에 판매점이 판매 주체로 남아 주문 확인과 고객 서비스를 담당한다. Google은 구매자를 대신해 행동하는 에이전트 기능 연구와 함께, 이 도구를 구매자가 주도권을 유지할 수 있는 기능으로 분류한다. 다른 국가의 출시 일정은 공개하지 않았다.
Manus Automations : 일정이나 트리거에 따라 실행되는 반복 작업
10월 15일 — Manus가 반복 작업을 “자동 조종”에 맡기는 Automations를 출시한다. 사용자는 작업을 언제 시작하고 어떤 결과를 내야 하는지 설명하면 된다. 실행 방식은 세 가지다. 평일 오전 8시처럼 일정을 지정하거나, Gmail에 청구서가 도착하는 경우처럼 연결된 앱의 이벤트를 트리거로 삼거나, 사용자가 설명한 여러 데이터 소스와 조건을 조합하는 고급 자동화를 사용할 수 있다. 마지막 방식은 베타로 제공된다. 이 기능은 5월의 Scheduled Tasks 2.0과 9월 28일 Manus 2.0에서 발표한 이벤트 기반 자동화를 확장한다. 발표 게시물에는 필요한 요금제나 크레딧 비용이 명시되지 않았다.
🔗 Manus 발표
단신
에이전트와 코딩 도구
- Devin 10월 14일 릴리스 노트 — Devin Oncall 출시를 하루 앞두고 Devin이 관측성 플러그인으로 Splunk, Elastic, Dynatrace, Chronosphere, Google Cloud Monitoring을 추가했다. 관리자 권한 없이 검토 규칙을 관리하는 Review manager 역할도 도입했으며, 코드 검사 결과를 기존 CSV 외에 SARIF 2.1.0 형식으로도 내보낼 수 있다. 🔗 출처
- Warp와 소프트웨어 공장 — 새 기능 발표 없이 작업 방식을 다룬 두 편의 글에서 Warp 창립자 잭 로이드는 6주 만에 팀의 PR당 비용을 80달러에서 20달러로 줄였다고 밝혔다. 되돌리기는 줄었고 PR 처리량은 전월보다 40 % 늘었다. 🔗 출처
- Qwen Code v0.25.2 — 10월 13일 사전 공개 버전이 나온 지 이틀 만에 정식 버전으로 전환됐다. 사전 공개 버전에 없던 풀 리퀘스트 68건이 포함됐으며, 이 중 11건은 새 기능이고 38건은 수정 사항이다. 새 기능에는 Web Shell로 파일 끌어다 놓기, MCP Apps 메시지 전송 전 검토, 워크플로 작업 취소, Managed Agent의 32개 테이블 기반 영속성 지원이 포함된다. 🔗 출처
- Copilot CLI 1.0.99 사전 공개 버전 — 하루 동안 정식 버전 없이 사전 공개 버전 두 개가 나왔다. 샌드박스는 기본적으로 로컬 네트워크 접근을 허용하고, /share는 전체 화면 메뉴를 열며, 신뢰하는 저장소의 플러그인은 자동으로 설치된다. 검증된 Skills와 플러그인은 GitHub 링크로 설치할 수 있다. 🔗 출처
- Antigravity SDK 0.1.22 — 동적 워크플로 오케스트레이션과 메모리에 정의하는 스킬을 추가했다. 뒤늦게 전하는 10월 11일 소식으로, Python SDK는 에이전트 워크플로를 작성하는 타입 지정 구성 요소(
phase,agent,parallel,pipeline), 파일 없이 선언하는 스킬(InlineSkill), 64k 토큰을 넘는 단계별 출력 토큰 한도를 베타로 제공한다. 🔗 출처 - google/adk-recipes — adk-samples를 재구성한 후속 저장소로, Google Agent Development Kit의 예제를 이제 코딩 도우미가 활용하기 좋게 구성했다. 각 레시피는
manifest.yaml과AGENTS.md을 제공하고, 첫 업무용 플러그인은 소매업을 대상으로 한다. Horizon은 여러 날에 걸쳐 작업하는 에이전트의 기준 하네스로 쓰인다. 🔗 출처 - DeepSeek Harness 0.2.1-alpha.4 — 아직 정식 버전 없이 28번째 사전 공개 버전이 나왔다. 사용자 지정 API의 추론 강도를 인터페이스에서 모델별로 직접 설정할 수 있고, 사용자 지정 인덱스에서 플러그인을 설치할 수 있다. 같은 날 FlashMLA는 CPython과 LibTorch의 안정 바이너리 인터페이스로 전환했다. 🔗 출처
- 11월 16일 Copilot에서 모델 3종 지원 종료 — Claude Opus 4.8과 Claude Opus 5는 Claude Opus 5.5로, GPT-5.6 Terra는 GPT-6.1 Sol 또는 GPT-6 Luna로 교체해야 한다. 연간 요금제를 사용하는 개인 구독자는 Claude Opus 4.8을 계속 사용할 수 있으며, Business와 Enterprise에서는 대체 모델이 자동으로 활성화된다. 🔗 출처
도우미, 기업 및 가이드
- 메신저 속 Genspark — iMessage, WhatsApp, Slack, LINE에서 @genspark_ai에 메시지를 보내 PDF 요약이나 프레젠테이션 제작을 요청하면 같은 대화로 결과가 돌아온다. 요금제와 가격은 명시되지 않았다. 🔗 출처
- Kimi Work 3.2.17과 세 번째 튜토리얼 — 3.2.16이 나온 지 사흘 만에 대화에서 이미지가 표시되고 원격 제어에서 Agent Swarm 모드를 선택할 수 있게 됐다. Moonshot AI는 워크플로 자동화를 다룬 세 번째 입문 영상도 공개했으며, 새 기능으로 소개한 내용은 없다. 🔗 릴리스 노트 · 🔗 튜토리얼
- Anthropic 펠로십 — STEM Fellows와 새로 도입한 Conceptual Reasoning Fellows의 지원서를 10월 28일까지 받는다. 후자는 철학, 인지과학, 경제학, 공공정책, 법학을 대상으로 한다. 2027년 1월 12일부터 5월 8일까지 4개월간 전일제로 참여하며, 보수는 100 000~167 000달러다. 미국 취업 허가가 필요하다. 🔗 출처
- Claude Enterprise의 Compliance API — 베타로 제공되는 이 API는 각 구성원이 claude.ai와 Cowork에 저장한 개인 지침을 관리자에게 반환한다. 전날에는 Managed Agents의 예약 배포가 Claude Platform on AWS에 도입됐다. 🔗 출처
- Block과 OpenAI Daybreak — 10월 14일 OpenAI가 공개한 사례 연구에서 Block(Square, Cash App, Afterpay)의 보안팀은 모의 공격 훈련 중 취약점이 제출된 시점부터 수정안이 제시되기까지 걸리는 시간을 18분으로 줄이고, 분기당 분석가 업무 시간 약 600시간을 절약했다고 밝혔다. 🔗 출처
- 브라질 포르투갈어로 제공되는 AI for Educators — OpenAI가 교사의 날을 맞아 OpenAI Academy에 무료 강좌의 브라질 포르투갈어 버전을 공개했다. 초등교육부터 고등교육까지의 교사를 대상으로 하며, ChatGPT의 Study Mode도 다시 소개했다. 🔗 출처
- Superwhisper Meetings — Superwhisper가 Tiny Aya와 Cohere Transcribe로 구동되는 회의 녹음 및 기록 도구를 출시하며, 전적으로 로컬에서 실행되는 최초의 도구라고 소개했다. 가격과 지원 플랫폼은 공개하지 않았다. 🔗 출처
- Cohere 가이드 3편 — 새 제품이나 수치 발표 없이 Cohere가 세 편의 글을 공개했다. 각각 North를 중심으로 에너지 및 공공서비스 사업자의 AI 활용, 기존 에이전트와 도전자 에이전트를 경쟁시키자는 구상을 포함한 기업 내 에이전트 확산, 투자 수익률 측정을 다룬다. 🔗 공공서비스 · 🔗 에이전트 · 🔗 투자 수익률
- Perplexity의 연구 가이드 — AI의 토대를 마련한 논문 12편과 최근 연구 6편을 돌아보고, 연구 보조 도구를 비교하며, 7단계 체계를 제안하는 가이드다. 새 기능은 없다. 🔗 출처
생성형 미디어
- Suno — 협업 기능 두 가지를 추가했다. 초대한 사람에게만 읽기 또는 편집 권한을 주는 공유 작업 공간(Pro 및 Premier)과 협업자에게 공유할 수 있는 맞춤형 모델(Premier)이다. 맞춤형 모델은 기존보다 두 배 많은 입력으로 조정할 수 있다. 🔗 출처
- Eleven v4 블라인드 테스트 — ElevenLabs는 8개 언어로 진행한 모든 블라인드 테스트에서 청취자들이 Eleven v4를 다른 음성 모델보다 표현력이 뛰어나다고 평가했다고 밝혔다. 본문에는 경쟁 모델 이름이나 점수가 제시되지 않았다. 🔗 출처
- Luma의 Shot Coverage — 하나의 영상 숏에서 움직이는 카메라의 여러 촬영 각도를 생성해 편집에 활용할 수 있는 기능이다. 발표에는 모델, 가격, 서비스 개시일이 명시되지 않았다. 🔗 출처
- HeyGen과 얀 호토베츠 — HeyGen이 뇌성마비가 있는 얀 호토베츠의 사례를 소개했다. 그는 Fameplay, Nolimi와 함께 자신의 모습과 목소리를 담은 아바타를 만들어 자기 말로 자신의 삶을 이야기했다. 🔗 출처
연구, 컴퓨팅 및 인프라
- NVIDIA와 AI in Science Enablers Initiative — 더블린에서 열린 AI in Science Summit에서 NVIDIA가 유럽연합 집행위원회의 이니셔티브에 참여했다. 공개 모델, Deep Learning Institute의 무료 강의 자료 허브, 국가별 AI 팩토리를 통한 컴퓨팅 자원 접근을 제공하며, 금액은 발표하지 않았다. 🔗 출처
- 북유럽의 NVIDIA — GTC Berlin을 앞두고 NVIDIA가 북유럽 생태계 현황을 정리했다. Sferical One 슈퍼컴퓨터(GB300 GPU 1 152개), 2027년 말까지 구축 예정인 1기가와트 규모의 AI 클라우드, 2027년 Norrsken 재단과 함께 설립할 Stockholm AI Lab이 포함된다. GTC Berlin 기조연설은 10월 21일로 예정됐다. 🔗 출처
- BERT 토큰화 속도 50배 향상 — Hugging Face의 시몽 브란다이스가 앞으로 나올 tokenizers 1.0이 ASCII 문자를 별도로 처리해 BERT 토크나이저를 0.23보다 약 50배 빠르게 만드는 방식을 설명했다. 변경 사항은 아직 검토 중이다. 🔗 출처
AI 이외의 GitHub 소식
- 푸시 이메일 종료 — GitHub가 스팸에 악용될 수 있었던 저장소 푸시 이벤트 알림 이메일 전송을 중단했다. 대신 자체 SMTP 서버를 사용하는 GitHub Actions 워크플로를 안내한다. 🔗 출처
- GitHub Code Quality 라이선스 — GitHub Team과 Enterprise Cloud에서 라이선스를 회수할 대상을 찾을 수 있도록, 라이선스를 사용하는 각 활성 커미터와 90일 동안 관련된 저장소를 나열하는 CSV 보고서를 제공한다. 🔗 출처
이것이 의미하는 것
개방형 모델의 규모가 커지고 있으며, 이제 생태계도 출시 첫날부터 이에 발맞추고 있다. Muse Spark Open은 API 제공업체 7곳, Meta가 제작한 NVFP4 가중치, Transformers, TRL, mlx-lm, Unsloth의 즉각적인 지원과 함께 등장했다. Nemotron 3.5 Super VL은 가중치, 데이터, 학습 방법을 공개하고, FLUX 3 Image Klein은 출시 당일 Diffusers와 ComfyUI에 통합된다. 하지만 ‘개방형’이라는 말에 담긴 조건은 제각각이다. Muse Model License는 상업적 사용을 제한하고, FLUX Kommunity 라이선스는 연 매출이 500만 달러 미만인 경우에만 무료이며, Timestral 가중치 라이선스는 월 매출이 2,000만 달러를 넘는 기업을 제외한다. 반면 Apertus 1.5는 학습 데이터와 함께 가중치를 Apache 2.0 라이선스로 공개한다. Meta가 내세운 최상급 표현은 이 경쟁이 국가 간에도 벌어지고 있음을 상기시킨다. Muse Spark Open은 미국 최고의 개방형 모델을 표방하지만, Artificial Analysis 지수와 코딩 성능에서는 GLM 5.3과 Kimi K3가 여전히 앞선다.
사이버 보안은 AI가 대규모로 취약점을 찾아 수정하는 분야가 되고 있다. Cohere는 500건 이상의 새로운 취약점을 다룬 전문성을 보유했다고 밝힌 AISLE를 인수하고, GitHub는 CodeQL이 지원하지 않는 언어를 위한 AI Scan과 자체 수정 사항을 검증하기 위해 CodeQL을 다시 실행하는 autofix를 정식 제공한다. Block은 모의 공격 훈련에서 취약점 발견부터 수정안 제시까지 걸리는 시간을 18분으로 줄였다고 밝혔다. 이러한 도구는 여전히 사람의 통제 아래 있다. AI Scan의 결과는 참고용이며, autofix는 초안 상태의 풀 리퀘스트를 만들고, Claude Code의 Code Review는 병합을 승인하거나 차단하지 않는다. 또 다른 측면은 에이전트 자체의 격리다. 이제 공개된 SPACE는 인증 정보와 외부로 나가는 트래픽을 가상 머신 밖에 두고, IPI Black은 공격자에게 보수를 지급해 간접 프롬프트 주입에 대한 에이전트의 저항력을 측정한다.
신뢰를 확보하려면 외부의 시각도 필요하다. Anthropic은 METR 소속 6명에게 직원에 준하는 접근 권한을 부여하면서 이들의 발표에 대한 거부권을 갖지 않기로 했다. 이는 일회성 감사를 넘어서는 조치이며, Anthropic은 이 제도를 대형 은행의 상주 검사관에 비유한다. 이러한 검증 요구는 연구에도 이어진다. Sakana AI는 코딩 에이전트가 점수 최적화에만 매달리지 않도록 실험에 앞서 평가 기준을 확정한다. OpenAI는 10월 6일 722편의 원고를 내놓은 데 이어, Simons Foundation을 통해 AI가 생성한 결과를 검토할 수학자들을 지원한다. CERN과 Mistral은 수십억 건의 모의 충돌 데이터로 학습한 Large Physics Model이라는 가장 큰 포부를 내세웠지만, 금액이나 일정은 제시하지 않았다.
도구 측면에서는 비용, 속도, 품질 사이의 절충 관계가 뚜렷해지고 있다. OpenAI의 GPT-6.1 Sol은 Ultra 추론 강도에서 GPT-6 Astra Ultra가 찾아낸 사항의 92%를 비용 14%로 찾아낸다. Opus 5.5의 빠른 모드는 가격이 두 배인 대신 처리량을 2.5배 제공하며, Code Review는 월간 한도 내에서 사용한 토큰만큼 요금을 부과한다. 에이전트는 무인 작업에도 자리 잡고 있다. Devin Oncall은 당직 대응을 맡고, Claude Code 2.1.301은 사용량 제한 해제 시점이 너무 멀면 더 이상 기다리지 않으며 분류기의 모든 판정을 기록한다. Antigravity CLI의 Auto 모드는 샌드박스를 벗어나는 명령의 검토를 별도 에이전트에 맡긴다. 벤치마크는 이러한 발전을 따라가기 버겁다. SREGym-Lite에서 Devin Oncall과 CloudThinker는 GPT-6 Astra를 사용해 모두 100%를 달성했다.
출처
- Muse Spark Open 발표 (@AIatMeta)
- Muse Spark Open (Meta 연구 블로그)
- Muse-Spark-Open-816B-A42B 모델 카드 (Hugging Face)
- Muse Spark Open (Hugging Face 블로그)
- GB300 NVL72에서의 Muse Spark Open (NVIDIA 기술 블로그)
- Nemotron 3.5 Super VL (NVIDIA 블로그)
- Nemotron 3.5 Super VL (NVIDIA 기술 블로그)
- Perplexity의 Nemotron 3.5 Super VL (@perplexity_ai)
- Perplexity API 변경 내역
- Cohere의 AISLE 합류 환영 (@aidangomez)
- Cohere의 AISLE 인수 예정 (Cohere 블로그)
- AISLE와 Cohere가 힘을 합친다 (AISLE 블로그)
- 풀 리퀘스트용 AI Scan 정식 출시 (GitHub 변경 내역)
- 코드 스캔 경고를 위한 에이전트형 autofix (GitHub 변경 내역)
- SPACE 오픈 소스 공개 (Perplexity)
- SPACE 오픈 소스 공개 (@perplexity_ai)
- perplexityai/SPACE 저장소 (GitHub)
- FLUX 3 Image Klein (Black Forest Labs 블로그)
- FLUX 3 Image Klein (@bfl_ai)
- Diffusers의 FLUX 3 Image Klein (Hugging Face 블로그)
- Kling 4.0 전면 출시 (@Kling_ai)
- Kling 출시 노트
- Instant Soundtracks 소개 (ElevenLabs 블로그)
- Devin Oncall 소개 (Cognition 블로그)
- Devin Oncall (@cognition)
- Devin Oncall 페이지
- Claude Code 2.1.301 출시 노트 (GitHub)
- Code Review 정식 출시 (Claude)
- Code Review 문서 (Claude Code)
- Delta 0.20 출시 노트
- DeltaDB: 버전 관리의 미래 (Delta 블로그)
- Antigravity CLI 변경 내역
- GPT-6 제품군으로 소프트웨어 유지 관리하기 (OpenAI Developers)
- 차세대 개발자 인터페이스는 주변 지능 (GitHub 블로그)
- 독립 평가자에 관한 새 소식 (Anthropic)
- IPI Black (@GraySwanAI)
- IPI Black 대회 페이지 (Gray Swan)
- 보리스 체르니가 소개하는 IPI Black (@bcherny)
- Timestral 소개 (Mistral)
- Timestral-209M (Hugging Face)
- StepFun의 Step 5 Preview (@NVIDIAAI)
- Apertus 1.5 출시 노트 (Swiss AI의 Hugging Face 블로그)
- Jev 1.14 (@typesafeai)
- Box 질문 (TypeSafe 문서)
- CERN과 Mistral (CERN 보도자료)
- Large Physics Model (@MistralAI)
- 에이전트형 과학자 (@SakanaAILabs)
- 에이전트형 과학자 (Sakana AI)
- 에이전트형 과학자 (arXiv)
- AI-Scientist-v3 저장소 (GitHub)
- Simons Foundation의 지원 사업 (@OpenAI)
- 수학 분야의 AI 발전 공유 (OpenAI)
- Opus 5.5의 빠른 모드 (@ClaudeDevs)
- 빠른 모드 문서 (Claude Platform)
- Transformers 5.20.0 출시 노트 (GitHub)
- TRL 1.16.0 출시 노트 (GitHub)
- GPT-Live-1.1 (@OpenAI)
- ChatGPT 출시 노트
- Universal Cart (Google 블로그)
- Manus Automations (@ManusAI)
- 10월 14일 Devin 출시 노트
- 소프트웨어 공장 도입 (Warp 블로그)
- Qwen Code v0.25.2 (GitHub)
- Copilot CLI 1.0.99-1 (GitHub)
- Antigravity SDK 변경 내역
- google/adk-recipes (Google Developers)
- DeepSeek Harness 0.2.1-alpha.4 (GitHub)
- 11월 Copilot 모델 지원 종료 (GitHub 변경 내역)
- 메신저의 Genspark (@genspark_ai)
- Kimi Work 출시 노트
- Kimi Work 세 번째 튜토리얼 (@Kimi_Moonshot)
- Anthropic 지원금 (@AnthropicAI)
- Claude Platform 출시 노트
- Block 사례 연구 (OpenAI)
- 브라질 포르투갈어로 제공되는 AI for Educators (OpenAI)
- Superwhisper Meetings (@cohere)
- 공익사업 부문의 AI 도입 (Cohere 블로그)
- 기업 내 에이전트 난립을 관리하는 방법 (Cohere 블로그)
- AI 투자 수익률을 측정하는 방법 (Cohere 블로그)
- AI 연구: 연구자를 위한 주요 논문과 최고의 도구 (Perplexity)
- 공유 작업 공간 (@suno)
- Eleven v4 블라인드 평가 (@ElevenLabs)
- Shot Coverage (@LumaLabsAI)
- 얀 호토베츠와 그의 아바타 (@HeyGen)
- NVIDIA와 AI in Science Enablers Initiative (NVIDIA 블로그)
- NVIDIA의 북유럽 생태계 (NVIDIA 블로그)
- 50배 빨라진 BERT 토큰화 (Hugging Face 블로그)
- 푸시 이메일 종료 (GitHub 변경 내역)
- CSV 형식의 GitHub Code Quality 라이선스 (GitHub 변경 내역)