ai-powered-markdown-translatorArtículo traducido del fr al es con gpt-6.1-sol.
Cursor publica el balance del incidente de seguridad que llevó, a finales de octubre, a la distribución de una extensión maliciosa de Claude Code: según la empresa, el ataque partió de una clave de acceso emitida para Fireworks, y la última actividad del atacante data del 1 de noviembre. En cuanto a productos, Projects en Claude Code incorpora un coordinador más proactivo y permite compartir threads, la aplicación de escritorio admite temas personalizados y Sierra publica la versión 1.0 de Poppy, activada para todos los comerciantes de Shopify. Deepnote publica un banco de pruebas sobre agentes proactivos, Thinking Machines detalla el entrenamiento en 4 bits de Inkling 2 Small y Meta publica MetaEncoder v1 sin anunciarlo.
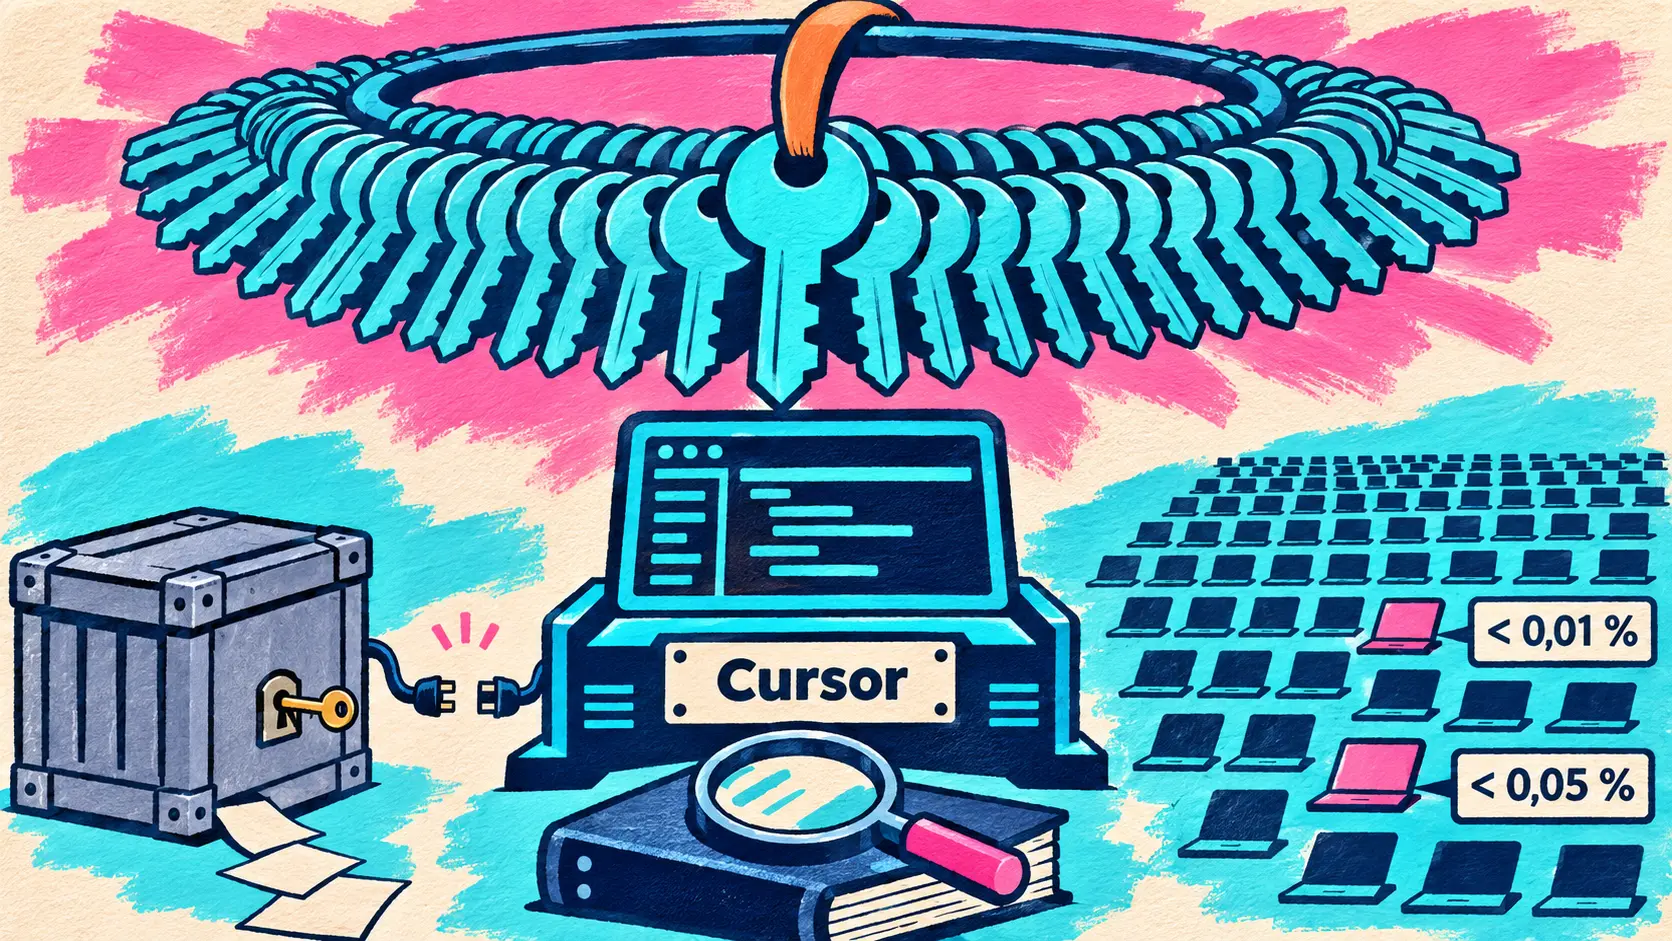
Cursor publica el balance de su incidente de seguridad: según la empresa, el ataque partió de una clave emitida para Fireworks
13 de noviembre — Cursor publica el balance de su investigación:
It started at Fireworks. An attacker obtained an access key we had issued to Fireworks. The key was exposed by Fireworks, and the attacker used it to copy data from a read-only storage bucket we used to share data with them.
🇪🇸 Todo comenzó en Fireworks. Un atacante obtuvo una clave de acceso que habíamos emitido para Fireworks. Fireworks expuso la clave y el atacante la utilizó para copiar datos de un bucket de almacenamiento de solo lectura que utilizábamos para compartir datos con ellos. — Cursor, «Una actualización sobre nuestro reciente incidente de seguridad»
Según Cursor, este bucket contenía trazas de agentes de código, principalmente de 2025, procedentes de sesiones fuera de Privacy Mode. Algunas incluían credenciales sin enmascarar, que dieron al atacante acceso a herramientas SaaS utilizadas por Cursor y, después, a repositorios archivados fuera del entorno de producción y a datos de soporte. La extensión maliciosa, de la que hablamos aquí el 30 de octubre, deriva de ello: una credencial robada sirvió para introducirla el 29 de octubre en la cache de la marketplace, en versiones que Anthropic no había publicado.
| Balance según Cursor | Qué dice la publicación al respecto |
|---|---|
| Credenciales de API expuestas | menos del 0,01 % de los clientes |
| Trazas de agentes expuestas, sesiones fuera de Privacy Mode | menos del 0,05 % de los usuarios, todos avisados |
| Extensión maliciosa de Claude Code del 29 de octubre | como máximo 5 000 usuarios pudieron recibirla, disponible durante unas 11 horas |
| Última actividad observada del atacante | 1 de noviembre, bloqueada |
| Ámbito no afectado | Privacy Mode, producción, aplicación y actualizaciones oficiales, Cloud Agents, repositorios de clientes |
Cursor ha retirado de Fireworks todo su tráfico de inferencia, desactivado la clave y cortado el acceso a los conjuntos de datos compartidos; ha renovado todas sus credenciales internas, iniciado un escaneo de secretos en sus repositorios y vuelto a desplegar su entorno de producción. Las trazas y credenciales expuestas solo se cuantifican en porcentajes.
Claude Code: Projects se vuelve más proactivo y la aplicación de escritorio admite temas personalizados
Dos anuncios de la cuenta de desarrolladores de Anthropic, la noche del 13 de noviembre, para las aplicaciones de Claude Code: ninguno de los dos afecta al CLI en terminal.
Projects: coordinador proactivo, /btw y /fork en los proyectos, recordatorios y uso compartido de threads
13 de noviembre — En Projects, donde una conversación coordina threads paralelos, el coordinador se vuelve más proactivo: responde a las preguntas en el chat del proyecto y ofrece un resumen del estado de los threads en curso. /btw y /fork llegan a los proyectos: el primero da un thread propio a un tema secundario, el segundo inicia un nuevo thread a partir del actual para probar otro enfoque. Un recordatorio oculta un thread hasta la fecha prevista y, después, Claude lo señala en el chat. Ahora se puede compartir un thread mediante un enlace de solo lectura con cualquier persona que haya iniciado sesión en Claude, salvo si el thread ha tenido acceso al ordenador del usuario.
Todo ello llega a la web y a la aplicación de escritorio, y la última versión de la aplicación móvil adopta el nuevo diseño. Según el anuncio, Projects sigue en beta pública para Pro y Max, con lista de espera; la documentación también menciona Ultra, sigue excluyendo a Team y Enterprise y continúa indicando que no se puede compartir un thread.
🔗 Hilo de @ClaudeDevs · Documentación de Projects
Temas personalizados: colores y fondos animados en la aplicación de escritorio, con los mods
13 de noviembre — Poco más de una hora después, Anthropic habilita los temas personalizados de Claude Code en la aplicación de escritorio. Se crean con los mods, las funciones TypeScript lanzadas el 1 de octubre: según el anuncio, un tema cambia los colores y coloca un fondo animado detrás de la conversación, y basta con describir a Claude el resultado deseado. Para empezar, el plugin oficial theme-examples 0.4.3 (Apache-2.0) ofrece 20 fondos animados, que se pueden aplicar por proyecto o por sesión con /custom-theme. Añade /fireworks, que activa manualmente la animación de fuegos artificiales que también se inicia cuando Claude escribe «merged»; pese a su nombre, este comando no tiene ninguna relación con la empresa Fireworks citada por Cursor.
Para los desarrolladores, $.theme.set y $.theme.clear sustituyen a $.ui.backdrop desde Claude Code v2.1.319, y el terminal no muestra ningún fondo. Tras actualizar la aplicación, los temas funcionan en las sesiones locales; las sesiones cloud se anuncian para «próximamente», sin fecha.
Poppy 1.0: el protocolo de agentes personales de Sierra se activa para todos los comerciantes de Shopify y Manus se une a sus socios
13 de noviembre — Sierra publica la versión 1.0 del Personal Agent Protocol, conocido como Poppy, que define cómo un agente personal se presenta ante una empresa y descubre qué tiene permitido hacer en ella. Anunciado el 6 de octubre, el protocolo se basa en estándares existentes (MCP, OpenAPI, Universal Commerce Protocol o UCP) y en OAuth, que deja al cliente el control de lo que puede hacer su agente.
La versión 1.0 llega ya desplegada. Shopify la activa para todos sus comerciantes: cada tienda publica automáticamente un archivo Poppy, mientras que UCP gestiona la compra y Poppy lo que la precede. Muse, el agente de IA de Meta, busca Poppy en primer lugar en cada sitio, para todos sus usuarios. Sierra cuenta con Mercury, Synchrony y Turkish Airlines entre los socios que pasan a producción, pero sigue describiendo en futuro la integración de Synchrony. Sesenta empresas se suman a los socios de diseño, que superan el centenar; Manus forma parte de ellos, junto con Salesforce o Cisco, y celebró el anuncio el 14 de noviembre sin detallar su integración.
🔗 Publicación de Sierra · Tweet de @ManusAI
Agent Initiative Benchmark: en el banco de pruebas de Deepnote, GPT-6 Astra y GPT-6.1 Sol superan a Claude Fable 5.2
13 de noviembre — Deepnote, desarrollador de cuadernos de datos colaborativos, publica un banco de pruebas de terceros sobre agentes proactivos (proactive agents), que siguen los intercambios de un equipo y deciden por sí solos si intervenir o guardar silencio. Doce modelos de seis laboratorios se enfrentan a 50 situaciones en PageMantle, una empresa ficticia de 71 empleados cuyos datos se reparten entre 11 servicios, con un nivel de esfuerzo alto y un presupuesto de 180 segundos; dos evaluadores LLM puntúan cada ejecución de 0 a 10, a ciegas. El hilo del anuncio de Jakub Jurovych, fundador de Deepnote, fue compartido por @OpenAIDevs.
| Modelo evaluado | Puntuación media (0 a 10) | Coste por tarea (dólares) |
|---|---|---|
| GPT-6 Astra | 8,97 | 0,693 |
| GPT-6.1 Sol | 8,65 | 0,112 |
| Claude Fable 5.2 | 8,17 | 1,87 |
| Claude Opus 5.5 | 7,84 | 1,28 |
| Claude Fable 5.1 | 7,50 | 3,02 |
| Claude Sonnet 5.5 | 6,65 | 0,420 |
| GPT-6 Luna | 6,38 | 0,0070 |
| DeepSeek V4.1 Flash | 6,35 | 0,026 |
| Mistral Large 4 | 6,09 | 0,082 |
| Claude Haiku 5.5 | 6,05 | 0,075 |
| Gemini 4 Argon | 5,60 | 0,403 |
| Grok 4.7 | 4,51 | 0,425 |
La página matiza esta clasificación: Sol se encuentra dentro del intervalo de confianza de Astra (8,30 a 9,52), por lo que este conjunto de tareas no permite distinguirlos, y Fable 5.2 se mantiene dentro del intervalo de Sol. Los costes son gastos registrados, no tarifas: un mes de Slack de PageMantle (unos 2 500 hilos) costaría 281 dólares con Sol, 1 732 con Astra y 4 684 con Fable 5.2. Cuando correspondía guardar silencio, los modelos solo lo hicieron 6 de cada 10 veces. Deepnote señala sus limitaciones: 50 tareas, un único nivel de esfuerzo, respuestas solo en Slack y resultados que dependen del entorno de evaluación.
🔗 Agent Initiative Benchmark (Deepnote) · Hilo de Jakub Jurovych
Inkling 2 Small: Thinking Machines detalla su entrenamiento en 4 bits, del preentrenamiento al RL
13 de noviembre — En una publicación de Connectionism, su blog de investigación, Thinking Machines explica cómo Inkling 2 Small, su MoE de 594 mil millones de parámetros con pesos abiertos presentado el 12 de noviembre, se entrenó con una pasada hacia delante nativa en NVFP4, desde el primer paso de preentrenamiento hasta el último rollout de aprendizaje por refuerzo. Las pasadas hacia atrás se mantienen en MXFP8, con redondeo estocástico (stochastic rounding) para limitar el sesgo de los gradientes. Las salidas de los expertos que se intercambian entre GPU utilizan un formato de 8 bits (S2F6): 8,25 bits por valor en lugar de 16.
| Formato numérico | Bits por valor | PFLOPS en GB300 |
|---|---|---|
| NVFP4 | 4,5 | 15 |
| MXFP8 | 8,25 | 5 |
| BF16 | 16 | 2,5 |
Frente a un entrenamiento íntegramente en MXFP8, el laboratorio mide una aceleración del 8 % en tiempo real durante el preentrenamiento y del 20 % en RL, a costa de alrededor de un 2 % de eficiencia de cálculo durante el preentrenamiento, sin diferencias visibles en la recompensa en RL. NVIDIA, que se hizo eco de la publicación, destaca un preentrenamiento completado en 68 horas en racks GB300 NVL72.
🔗 Entrenamiento integral en 4 bits (Thinking Machines) · Publicación de @NVIDIAAI
MetaEncoder v1: Meta publica sin anunciarlo un codificador multimodal de 28,4 mil millones de parámetros
12 de noviembre — Puesta al día: Meta ha publicado en Hugging Face, sin publicación en su blog ni tweet, MetaEncoder v1, que sucede a MetaEncoder-30B (del que hablamos el 5 de octubre). La ficha del antiguo repositorio indica que la v1 «mejora notablemente» el modelo, sin cifras. Se utiliza mediante tres llamadas: encode produce vectores para textos, imágenes o vídeos, retrieve clasifica un corpus en función de una consulta y decide responde con probabilidades a preguntas cerradas sobre un estado, en el formato que la ficha denomina Jev.
| Característica del modelo | Valor según la ficha y el Hub |
|---|---|
| Parámetros | 28 431 795 200 |
| Dimensión de los vectores | 6 656, normalizados en L2 |
| Hardware indicado | una GPU de 80 Go en bf16 |
| Versión de Transformers | 5.15 o superior (muse_glimmer) |
| Licencia y evaluaciones | no se declaran ni licencia ni benchmark |
La licencia Apache-2.0 y las puntuaciones del antiguo repositorio no son, por tanto, válidas para esta versión, una publicación técnica más que un lanzamiento.
🔗 MetaEncoder v1 (Hugging Face) · Antiguo repositorio MetaEncoder-30B
Breves
Agentes de programación y CLI
- Notas de la versión de Devin del 13 de noviembre — Los resultados de una sesión (PR, previsualizaciones, plan, archivos adjuntos) se organizan en una columna a la derecha del chat; Review Analytics muestra qué ocurre con los hallazgos de cada revisor personalizado, Devin Review coloca merge requests en los merge trains de GitLab y la interfaz pasa al alemán. 🔗 fuente
- Codex CLI 0.171.0-alpha.5 — Las notas de esta versión preliminar están vacías; según los títulos de los 126 commits publicados desde la 0.169.0, el espacio de trabajo del terminal pasa a ser estable y se activa por defecto, y la TUI negocia llamadas de voz en tiempo real. El contenido puede cambiar antes de la próxima versión estable. 🔗 fuente
- Copilot CLI 1.0.112 — Pasa a ser estable el 13 de noviembre, sin más novedades que las de la versión preliminar 1.0.112-0, de la que retoma las 95 entradas; el SDK 1.0.34 sigue el mismo camino. 🔗 fuente
Plataformas y empresas
- Informe de disponibilidad de GitHub de octubre — Ocho incidentes durante el mes, incluido el del 28 de octubre en Copilot: aproximadamente una de cada 10 solicitudes a varios modelos GPT falló porque el identificador de GitHub ante el proveedor externo había dejado de ser válido; cambiar de modelo permitía evitar el error. 🔗 fuente
- Shield y GPT-6 Astra — En Forge, su plataforma para proveedores de servicios informáticos, un agente de uso del ordenador basado en GPT-6 Astra gestiona portales sin API (tickets, dispositivos, licencias) miles de veces al mes, entre un 35 y un 40 % más rápido que los modelos anteriores, según Shield. 🔗 fuente
- Synapsis AI en Cleveland Clinic — NVIDIA cuenta cómo la herramienta de Dyania Health, ejecutada detrás del cortafuegos del hospital, se utilizó en un estudio sobre más de 7 800 pacientes sometidos a una sustitución de válvula aórtica, con un modelo predictivo a 3, 5 y 10 años; ningún producto nuevo de NVIDIA. 🔗 fuente
- Tráfico de OpenUncensored — En una semana, 157 clientes de pago y 150 292 solicitudes: los agentes de programación representan el 49 % del gasto de este proveedor de modelos sin censura, el conjunto de los agentes el 65 %, y el chat y el juego de rol el 1,5 %, según el propio proveedor. 🔗 fuente
Imágenes y vídeo
- Seedance 2.5 Flash en HeyGen — La variante rápida del modelo de vídeo de ByteDance llega a Creative Studio, hasta 2 veces más rápida que Seedance 2.5 con una calidad similar, según HeyGen; sin precio ni duración máxima. 🔗 fuente
- Grok Imagine en Grok — La creación de imágenes y vídeos se realiza ahora en Grok; SpaceXSI dice reunir más de sus productos en una única experiencia Grok, sin precisar cuáles ni qué ocurrirá con la aplicación Grok Imagine. 🔗 fuente
Modelos abiertos e investigación
- CQ y GCMP de ThousandML — En Qwen3.8-27B, la cuantización de 4 bits CQ reduce el modelo de 55,6 a 18 GB sin diferencias significativas respecto a BF16 en nueve bancos de pruebas, mientras que NF4 pierde 12 puntos en GSM8K; el adaptador GCMP iguala a un LoRA de rango 32 con 2,9 millones de parámetros frente a unos 159 millones, según el desarrollador. 🔗 fuente
- Cuatro artículos sobre los modelos Aya de Cohere Labs — Tras un ajuste fino con correcciones verificadas, Aya Expanse 32B pasa del 14,5 % al 51,5 % de las tareas de τ²-bench; Tiny Aya Fire rechaza 36 solicitudes dañinas de 36 en escritura urdu, pero 17 de 36 en urdu romanizado, según los autores. 🔗 fuente · ScriptShield
- PEFT v0.21.3 — Este parche reúne únicamente los pesos del adaptador al guardar un modelo con paralelismo tensorial, lo que elimina una ralentización. 🔗 fuente
Qué significa
El balance de Cursor muestra por dónde pasa el riesgo cuando un desarrollador de software comparte datos con un proveedor de servicios. Según su relato, una sola clave de uso compartido bastó para copiar trazas de agentes, y algunas credenciales sin ocultar en esas trazas permitieron acceder a herramientas SaaS utilizadas por el desarrollador y, después, a la distribución de las extensiones. Las trazas de los agentes de programación se convierten así en datos sensibles por sí mismas; según Cursor, las de las sesiones en Privacy Mode no se vieron afectadas. Las medidas anunciadas abordan estos dos puntos: rotación de todas las credenciales internas y escaneo de secretos en los repositorios. El relato sigue siendo el de Cursor.
Los agentes toman cada vez más la iniciativa, y la cuestión pasa a ser cuándo deben guardar silencio. El coordinador de Projects revisa ahora por iniciativa propia los hilos en curso; el banco de pruebas de Deepnote mide precisamente esa decisión de intervenir y muestra que se envía un mensaje 9 de cada 10 veces cuando se espera ayuda, pero que los modelos solo se abstienen 6 de cada 10 veces cuando corresponde guardar silencio. La diferencia de coste, de 0,11 a 1,87 dólares por tarea entre Sol y Fable 5.2, pesa mucho para un agente que permanece atento de forma continua, como muestra el cálculo de Deepnote para un mes de Slack. Estos resultados siguen siendo los de un único banco de pruebas, con un único arnés, que la propia Deepnote considera determinante.
Poppy 1.0 aborda el otro extremo de la cadena: cómo se presenta un agente personal ante una empresa y aprende qué tiene permiso para hacer en ella. En lugar de reinventarlo todo, el protocolo se apoya en MCP, OpenAPI, UCP y OAuth, y el despliegue por defecto en Shopify y en Muse le proporciona desde el principio una base muy amplia. Los ejemplos citados mantienen al cliente en el proceso, con la política de aprobación de Mercury para una transferencia o el consentimiento del viajero antes de pagar una mejora de clase en Turkish Airlines.
En los modelos abiertos, la baja precisión llega al propio entrenamiento: Inkling 2 Small realizó su pasada hacia delante en 4 bits desde el preentrenamiento hasta el RL, con una mejora de velocidad medida de entre el 8 y el 20 %. ThousandML, por su parte, defiende un formato de 4 bits sin calibración para el ajuste fino, basándose en sus propias mediciones. Por último, MetaEncoder v1 recuerda que un modelo de libre descarga no es necesariamente un modelo con licencia abierta: su ficha no declara ninguna.
Fuentes
- Información actualizada sobre nuestro reciente incidente de seguridad (Cursor)
- Anuncio de @cursor_ai
- Aviso de seguridad sobre la extensión Claude Code (Cursor)
- Actualizaciones de Projects en Claude Code (@ClaudeDevs)
- Documentación de Projects en Claude Code
- Temas personalizados de Claude Code (@ClaudeDevs)
- Documentación de los mods: dibujar en la interfaz
- Plugin theme-examples (PR #7116)
- Presentación de Personal Agent Protocol 1.0 (Sierra)
- Anuncio de Poppy 1.0 (@SierraPlatform)
- Tweet de @ManusAI sobre Poppy
- Agent Initiative Benchmark (Deepnote)
- Hilo de Jakub Jurovych
- Código de Agent Initiative Benchmark (GitHub)
- Conjunto de datos PageMantle (Hugging Face)
- Entrenamiento de principio a fin en 4 bits (Thinking Machines)
- Publicación compartida por @NVIDIAAI sobre Inkling 2 Small
- MetaEncoder v1 (Hugging Face)
- MetaEncoder-30B (Hugging Face)
- Notas de la versión de Devin del 13 de noviembre
- Codex CLI 0.171.0-alpha.5 (GitHub)
- Copilot CLI 1.0.112 (GitHub)
- Informe de disponibilidad de GitHub: octubre de 2026
- Caso de estudio de Shield (OpenAI)
- Cómo la IA ayuda a los equipos asistenciales (NVIDIA)
- Los modelos sin censura son infraestructura para agentes (OpenUncensored)
- Seedance 2.5 Flash en HeyGen (@HeyGen)
- Creación de imágenes y vídeos en Grok (@imagine)
- CQ y GCMP (ThousandML)
- Agentes reflexivos (blog de Hugging Face)
- ScriptShield (blog de Hugging Face)
- PEFT v0.21.3 (GitHub)