ai-powered-markdown-translatorArticolo tradotto dal francese all’italiano con gpt-6.1-sol.
Cursor pubblica il resoconto dell’incidente di sicurezza che aveva portato, a fine ottobre, alla diffusione di un’estensione Claude Code compromessa: secondo l’azienda, l’attacco è partito da una chiave di accesso emessa per Fireworks e l’ultima attività dell’attaccante risale al 1° novembre. Sul fronte dei prodotti, Projects in Claude Code acquisisce un coordinatore più proattivo e la condivisione dei thread, l’applicazione desktop supporta temi personalizzati e Sierra pubblica la versione 1.0 di Poppy, attivata per tutti i commercianti Shopify. Deepnote pubblica un benchmark sugli agenti proattivi, Thinking Machines descrive in dettaglio l’addestramento a 4 bit di Inkling 2 Small e Meta mette online MetaEncoder v1 senza annunci.
Cursor pubblica il resoconto del suo incidente di sicurezza: secondo l’azienda, l’attacco è partito da una chiave emessa per Fireworks
13 novembre — Cursor pubblica il resoconto della sua indagine:
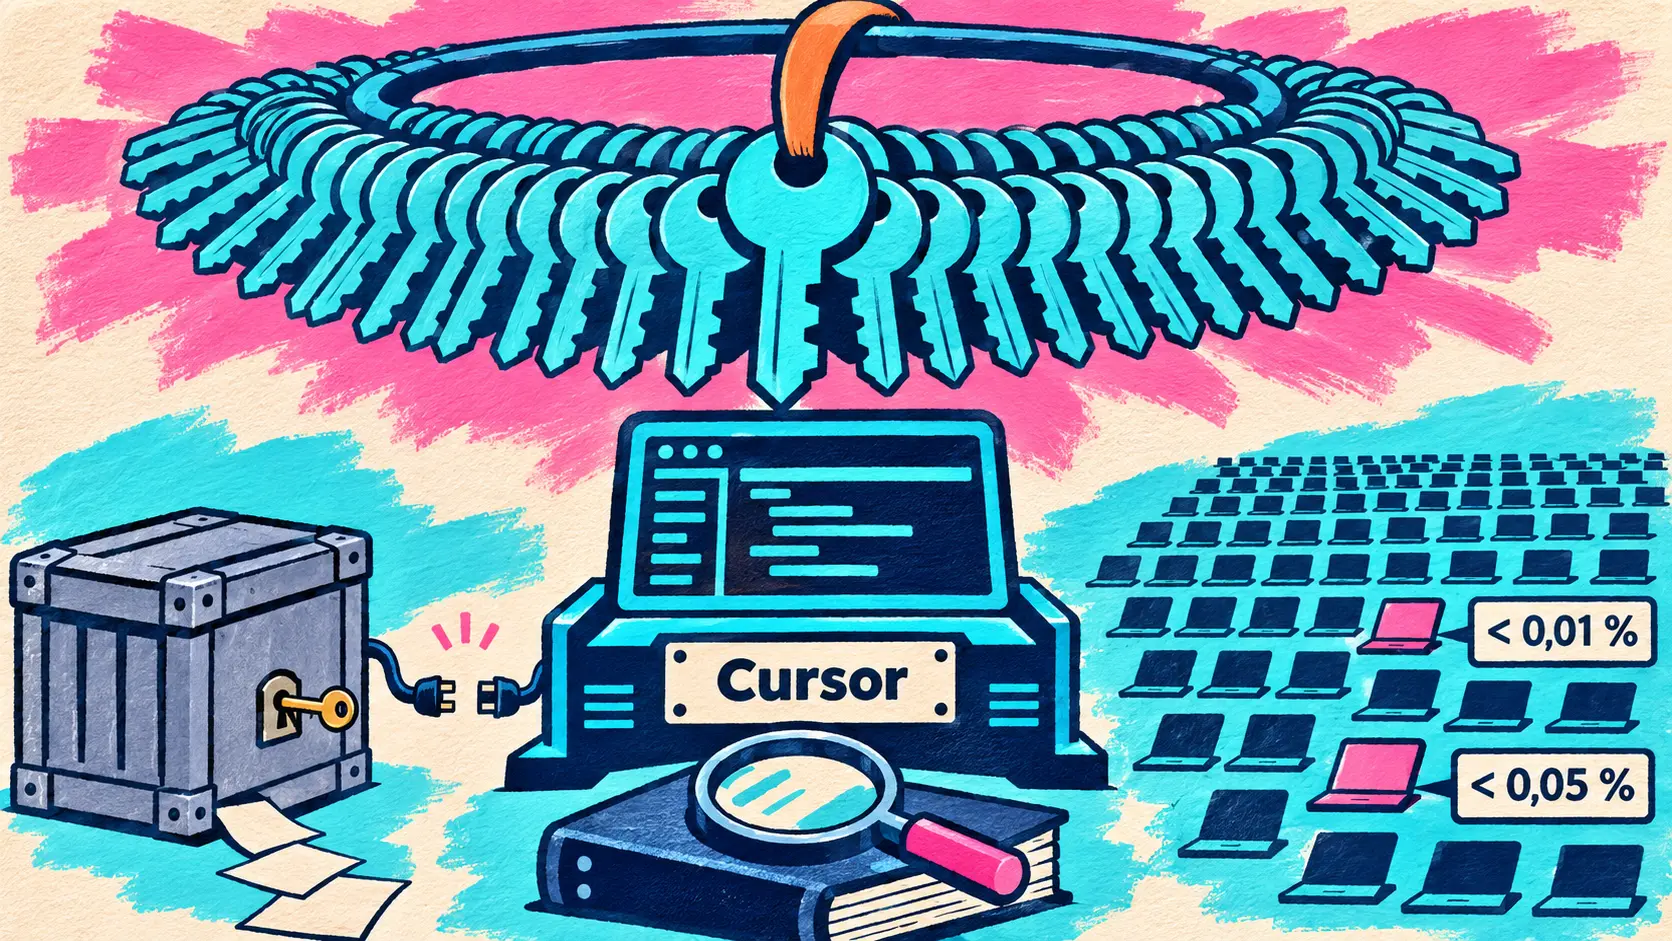
It started at Fireworks. An attacker obtained an access key we had issued to Fireworks. The key was exposed by Fireworks, and the attacker used it to copy data from a read-only storage bucket we used to share data with them.
🇮🇹 Tutto è iniziato presso Fireworks. Un attaccante ha ottenuto una chiave di accesso che avevamo emesso per Fireworks. La chiave è stata esposta da Fireworks e l’attaccante l’ha usata per copiare dati da un bucket di storage in sola lettura che utilizzavamo per condividere dati con loro. — Cursor, « Un aggiornamento sul nostro recente incidente di sicurezza »
Secondo Cursor, questo bucket conteneva tracce di agenti di programmazione, soprattutto del 2025, provenienti da sessioni al di fuori di Privacy Mode. Alcune contenevano credenziali non mascherate, che hanno consentito all’attaccante di accedere agli strumenti SaaS utilizzati da Cursor, poi a repository archiviati fuori produzione e a dati di assistenza. L’estensione compromessa, trattata qui il 30 ottobre, ne è una conseguenza: una credenziale rubata è servita a inserirla il 29 ottobre nella cache del marketplace, in versioni che Anthropic non aveva pubblicato.
| Bilancio secondo Cursor | Cosa riporta il post |
|---|---|
| Credenziali API esposte | meno dello 0,01 % dei clienti |
| Tracce di agenti esposte, sessioni al di fuori di Privacy Mode | meno dello 0,05 % degli utenti, tutti avvisati |
| Estensione Claude Code compromessa del 29 ottobre | al massimo 5 000 utenti potrebbero averla ricevuta, online per circa 11 ore |
| Ultima attività osservata dell’attaccante | 1° novembre, bloccata |
| Ambito non interessato | Privacy Mode, produzione, applicazione e aggiornamenti ufficiali, Cloud Agents, repository dei clienti |
Cursor ha rimosso da Fireworks tutto il proprio traffico di inferenza, disattivato la chiave e interrotto l’accesso ai dataset condivisi; ha rinnovato tutte le credenziali interne, avviato una scansione dei segreti nei propri repository e ridistribuito l’ambiente di produzione. Le tracce e le credenziali esposte sono quantificate solo in percentuale.
Claude Code: Projects diventa più proattivo e l’applicazione desktop supporta temi personalizzati
Due annunci dall’account sviluppatori di Anthropic, la sera del 13 novembre, per le applicazioni di Claude Code: nessuno dei due riguarda il CLI nel terminale.
Projects: coordinatore proattivo, /btw e /fork nei progetti, promemoria e condivisione dei thread
13 novembre — In Projects, dove una conversazione coordina thread paralleli, il coordinatore diventa più proattivo: risponde alle domande nella chat del progetto e fa il punto sui thread in corso. /btw e /fork arrivano nei progetti: il primo assegna un thread dedicato a un argomento secondario, il secondo avvia un nuovo thread a partire da quello corrente per provare un altro approccio. Un promemoria nasconde un thread fino alla scadenza, poi Claude lo segnala nella chat. Ora un thread può essere condiviso tramite un link in sola lettura con chiunque abbia effettuato l’accesso a Claude, a meno che non abbia avuto accesso al computer dell’utente.
Tutto questo arriva sul web e nell’applicazione desktop, mentre l’ultima versione dell’applicazione mobile adotta il nuovo design. Secondo l’annuncio, Projects rimane in beta pubblica su Pro e Max, con lista d’attesa; la documentazione cita anche Ultra, esclude ancora Team ed Enterprise e indica tuttora che un thread non può essere condiviso.
🔗 Thread di @ClaudeDevs · Documentazione di Projects
Temi personalizzati: colori e sfondi animati nell’applicazione desktop, con i mods
13 novembre — Poco più di un’ora dopo, Anthropic rende disponibili i temi personalizzati di Claude Code nell’applicazione desktop. Si creano con i mods, le funzioni TypeScript lanciate il 1° ottobre: secondo l’annuncio, un tema cambia i colori e inserisce uno sfondo animato dietro la conversazione, e basta descrivere a Claude l’aspetto desiderato. Per iniziare, il plugin ufficiale theme-examples 0.4.3 (Apache-2.0) propone 20 sfondi animati, da applicare per progetto o per sessione con /custom-theme. Aggiunge /fireworks, che attiva manualmente l’animazione dei fuochi d’artificio avviata anche quando Claude scrive « merged »; nonostante il nome, questo comando non ha alcun rapporto con la società Fireworks citata da Cursor.
Sul fronte degli sviluppatori, $.theme.set e $.theme.clear sostituiscono $.ui.backdrop a partire da Claude Code v2.1.319 e il terminale non mostra alcuno sfondo. Dopo l’aggiornamento dell’applicazione, i temi funzionano nelle sessioni locali; le sessioni cloud sono annunciate « prossimamente », senza una data.
Poppy 1.0: il protocollo di agenti personali di Sierra viene attivato per tutti i commercianti Shopify e Manus si unisce ai suoi partner
13 novembre — Sierra pubblica la versione 1.0 del Personal Agent Protocol, soprannominato Poppy, che definisce come un agente personale si presenta a un’azienda e scopre cosa è autorizzato a fare al suo interno. Annunciato il 6 ottobre, il protocollo si basa su standard esistenti (MCP, OpenAPI, Universal Commerce Protocol o UCP) e su OAuth, che lascia al cliente il controllo su ciò che il suo agente può fare.
La versione 1.0 arriva già distribuita. Shopify la attiva per tutti i suoi commercianti: ogni negozio pubblica automaticamente un file Poppy, con UCP che gestisce l’acquisto e Poppy ciò che lo precede. Muse, l’agente IA di Meta, cerca prima di tutto Poppy su ogni sito, per tutti i suoi utenti. Sierra annovera Mercury, Synchrony e Turkish Airlines tra i partner che passano in produzione, ma descrive ancora al futuro l’integrazione di Synchrony. Sessanta aziende si aggiungono ai partner di progettazione, che superano il centinaio; Manus ne fa parte, insieme a Salesforce o Cisco, e ha accolto con favore il protocollo il 14 novembre senza fornire dettagli sulla propria integrazione.
🔗 Post di Sierra · Tweet di @ManusAI
Agent Initiative Benchmark: nel benchmark di Deepnote, GPT-6 Astra e GPT-6.1 Sol precedono Claude Fable 5.2
13 novembre — Deepnote, azienda che sviluppa notebook collaborativi per i dati, pubblica un benchmark di terze parti sugli agenti proattivi (proactive agents), che seguono gli scambi di un team e decidono autonomamente se intervenire o tacere. Dodici modelli di sei laboratori affrontano 50 situazioni in PageMantle, un’azienda fittizia di 71 dipendenti con dati distribuiti su 11 servizi, con un livello di sforzo elevato e un budget di 180 secondi; due valutatori LLM assegnano alla cieca un punteggio da 0 a 10 a ogni esecuzione. Il thread di annuncio di Jakub Jurovych, fondatore di Deepnote, è stato ricondiviso da @OpenAIDevs.
| Modello valutato | Punteggio medio (da 0 a 10) | Costo per attività (dollari) |
|---|---|---|
| GPT-6 Astra | 8,97 | 0,693 |
| GPT-6.1 Sol | 8,65 | 0,112 |
| Claude Fable 5.2 | 8,17 | 1,87 |
| Claude Opus 5.5 | 7,84 | 1,28 |
| Claude Fable 5.1 | 7,50 | 3,02 |
| Claude Sonnet 5.5 | 6,65 | 0,420 |
| GPT-6 Luna | 6,38 | 0,0070 |
| DeepSeek V4.1 Flash | 6,35 | 0,026 |
| Mistral Large 4 | 6,09 | 0,082 |
| Claude Haiku 5.5 | 6,05 | 0,075 |
| Gemini 4 Argon | 5,60 | 0,403 |
| Grok 4.7 | 4,51 | 0,425 |
La pagina invita a leggere questa classifica con cautela: Sol si trova nell’intervallo di confidenza di Astra (da 8,30 a 9,52), quindi questo insieme di attività non consente di distinguerli, e Fable 5.2 resta nell’intervallo di Sol. I costi sono spese registrate, non tariffe: un mese di Slack di PageMantle (circa 2 500 thread) costerebbe 281 dollari con Sol, 1 732 con Astra e 4 684 con Fable 5.2. Quando era necessario restare in silenzio, i modelli hanno taciuto solo 6 volte su 10. Deepnote cita i propri limiti: 50 attività, un solo livello di sforzo, risposte soltanto in Slack e risultati che dipendono dall’harness.
🔗 Agent Initiative Benchmark (Deepnote) · Thread di Jakub Jurovych
Inkling 2 Small: Thinking Machines descrive in dettaglio il suo addestramento a 4 bit, dal preaddestramento al RL
13 novembre — In un post su Connectionism, il suo blog di ricerca, Thinking Machines spiega come Inkling 2 Small, il suo MoE da 594 miliardi di parametri con pesi aperti presentato il 12 novembre, sia stato addestrato con un forward pass nativo in NVFP4, dal primo passo di preaddestramento all’ultimo rollout di apprendimento per rinforzo. I backward pass restano in MXFP8, con un arrotondamento stocastico (stochastic rounding) per limitare la distorsione dei gradienti. Gli output degli esperti scambiati tra GPU passano attraverso un formato a 8 bit (S2F6): 8,25 bit per valore invece di 16.
| Formato numerico | Bit per valore | PFLOPS su GB300 |
|---|---|---|
| NVFP4 | 4,5 | 15 |
| MXFP8 | 8,25 | 5 |
| BF16 | 16 | 2,5 |
Rispetto a un addestramento interamente in MXFP8, il laboratorio misura un’accelerazione dell’8 % in termini di tempo effettivo nel preaddestramento e del 20 % nel RL, a fronte di una perdita di circa il 2 % nell’efficienza di calcolo durante il preaddestramento, senza differenze visibili nella ricompensa nel RL. NVIDIA, che ha rilanciato il post, evidenzia un preaddestramento completato in 68 ore su rack GB300 NVL72.
🔗 Addestramento end-to-end a 4 bit (Thinking Machines) · Rilancio di @NVIDIAAI
MetaEncoder v1: Meta mette online senza annunci un encoder multimodale da 28,4 miliardi di parametri
12 novembre — Una notizia da recuperare: Meta ha pubblicato su Hugging Face, senza post né tweet, MetaEncoder v1, successore di MetaEncoder-30B (trattato il 5 ottobre). La scheda del vecchio repository indica che la v1 « migliora nettamente » il modello, senza fornire cifre. Si utilizza tramite tre chiamate: encode produce vettori per testi, immagini o video, retrieve ordina un corpus in base a una query e decide risponde con probabilità a domande chiuse su uno stato, nel formato che la scheda chiama Jev.
| Caratteristica del modello | Valore secondo la scheda e l’Hub |
|---|---|
| Parametri | 28 431 795 200 |
| Dimensione dei vettori | 6 656, normalizzati L2 |
| Hardware indicato | una GPU da 80 Go in bf16 |
| Versione di Transformers | 5.15 o superiore (muse_glimmer) |
| Licenza e valutazioni | nessuna licenza né benchmark dichiarati |
La licenza Apache-2.0 e i punteggi del vecchio repository non si applicano quindi a questa versione, una pubblicazione tecnica più che un lancio.
🔗 MetaEncoder v1 (Hugging Face) · Vecchio repository MetaEncoder-30B
Brevi
Agenti di programmazione e CLI
- Note di rilascio di Devin del 13 novembre — Tutto ciò che produce una sessione (PR, anteprime, piano, allegati) viene raccolto in una barra laterale a destra della chat; Review Analytics mostra l’esito delle segnalazioni di ciascun revisore personalizzato, Devin Review inserisce le merge request nei merge train di GitLab e l’interfaccia diventa disponibile in tedesco. 🔗 fonte
- Codex CLI 0.171.0-alpha.5 — Le note di questa versione preliminare sono vuote; stando ai titoli dei 126 commit pubblicati dalla 0.169.0, l’area di lavoro del terminale diventa stabile e si attiva per impostazione predefinita, e la TUI negozia chiamate vocali in tempo reale. Il contenuto potrebbe cambiare prima della prossima versione stabile. 🔗 fonte
- Copilot CLI 1.0.112 — Passaggio alla versione stabile il 13 novembre, senza aggiunte rispetto alla versione preliminare 1.0.112-0, di cui riprende le 95 voci; l’SDK 1.0.34 segue lo stesso percorso. 🔗 fonte
Piattaforme e aziende
- Rapporto sulla disponibilità di GitHub per ottobre — Otto incidenti nel mese, tra cui quello del 28 ottobre su Copilot: circa una richiesta su 10 verso diversi modelli GPT è fallita perché l’identificativo di GitHub presso il fornitore a monte non era più valido; cambiare modello permetteva di aggirare l’errore. 🔗 fonte
- Shield e GPT-6 Astra — In Forge, la sua piattaforma per i fornitori di servizi informatici, un agente di utilizzo del computer basato su GPT-6 Astra gestisce i portali senza API (ticket, dispositivi, licenze), migliaia di volte al mese, dal 35 al 40 % più velocemente dei modelli precedenti, secondo Shield. 🔗 fonte
- Synapsis AI alla Cleveland Clinic — NVIDIA racconta come lo strumento di Dyania Health, eseguito dietro il firewall dell’ospedale, sia stato utilizzato per uno studio su oltre 7 800 pazienti sottoposti a sostituzione della valvola aortica, con un modello predittivo a 3, 5 e 10 anni; nessun nuovo prodotto NVIDIA. 🔗 fonte
- Traffico di OpenUncensored — In una settimana, 157 clienti paganti e 150 292 richieste: gli agenti di programmazione rappresentano il 49 % della spesa presso questo fornitore di modelli senza censura, l’insieme degli agenti il 65 %, la chat e il gioco di ruolo l’1,5 %, secondo quanto dichiara. 🔗 fonte
Immagini e video
- Seedance 2.5 Flash in HeyGen — La variante rapida del modello video di ByteDance arriva nel Creative Studio, fino a 2 volte più veloce di Seedance 2.5 con una qualità simile, secondo HeyGen; nessuna indicazione su prezzo o durata massima. 🔗 fonte
- Grok Imagine in Grok — La creazione di immagini e video avviene ora in Grok; SpaceXSI afferma di riunire più prodotti in un’unica esperienza Grok, senza precisare quali né il destino dell’applicazione Grok Imagine. 🔗 fonte
Modelli aperti e ricerca
- CQ e GCMP di ThousandML — Su Qwen3.8-27B, la quantizzazione a 4 bit CQ riduce il modello da 55,6 a 18 Go senza scostamenti significativi rispetto a BF16 su nove benchmark, mentre NF4 perde 12 punti su GSM8K; l’adattatore GCMP eguaglia un LoRA di rango 32 con 2,9 milioni di parametri contro circa 159 milioni, secondo il produttore. 🔗 fonte
- Quattro articoli sui modelli Aya di Cohere Labs — Dopo il fine-tuning su correzioni verificate, Aya Expanse 32B passa dal 14,5 % al 51,5 % delle attività di τ²-bench; Tiny Aya Fire rifiuta 36 richieste dannose su 36 in scrittura urdu, ma 17 su 36 in urdu romanizzato, secondo gli autori. 🔗 fonte · ScriptShield
- PEFT v0.21.3 — Questa correzione raccoglie soltanto i pesi dell’adattatore durante il salvataggio di un modello con parallelismo tensoriale, eliminando un rallentamento. 🔗 fonte
Cosa significa
Il resoconto di Cursor mostra dove si annida il rischio quando un produttore di software condivide dati con un fornitore di servizi. Secondo la sua ricostruzione, una sola chiave di condivisione è bastata per copiare le tracce degli agenti, e alcune credenziali non oscurate in queste tracce hanno permesso di risalire agli strumenti SaaS utilizzati dal produttore, poi alla distribuzione delle estensioni. Le tracce degli agenti di programmazione diventano così dati sensibili a tutti gli effetti; secondo Cursor, quelle delle sessioni in Privacy Mode non sono state coinvolte. Le misure annunciate puntano a questi due aspetti: rotazione di tutte le credenziali interne e scansione dei repository alla ricerca di segreti. Il resoconto resta quello di Cursor.
Gli agenti prendono sempre più l’iniziativa e la questione diventa capire quando debbano tacere. Il coordinatore di Projects fa ora il punto autonomamente sui thread in corso; il benchmark di Deepnote misura proprio questa decisione di intervenire e mostra che un messaggio viene inviato 9 volte su 10 quando ci si aspetta un aiuto, ma che i modelli si trattengono soltanto 6 volte su 10 quando occorre restare in silenzio. La differenza di costo, da 0,11 a 1,87 dollari per attività tra Sol e Fable 5.2, pesa molto per un agente che monitora continuamente, come mostra il calcolo di Deepnote relativo a un mese su Slack. Questi risultati restano quelli di un solo benchmark, con un solo harness, che la stessa Deepnote considera determinante.
Poppy 1.0 affronta l’altro capo della catena: come un agente personale si presenta a un’azienda e scopre cosa gli è consentito fare al suo interno. Anziché reinventare tutto, il protocollo si basa su MCP, OpenAPI, UCP e OAuth, e la distribuzione predefinita presso Shopify e in Muse offre subito al protocollo una base molto ampia. Gli esempi citati mantengono il cliente coinvolto nel processo, con la politica di approvazione di Mercury per un bonifico o il consenso del viaggiatore prima di pagare un passaggio a una classe superiore con Turkish Airlines.
Sul fronte dei modelli aperti, la bassa precisione si estende all’addestramento stesso: Inkling 2 Small ha eseguito il forward pass a 4 bit dal preaddestramento fino al RL, con un aumento misurato della velocità dall’8 al 20 %. ThousandML sostiene invece un formato a 4 bit senza calibrazione per il fine-tuning, sulla base delle proprie misurazioni. MetaEncoder v1 ricorda infine che un modello liberamente scaricabile non è necessariamente un modello con licenza aperta: la sua scheda non ne dichiara alcuna.
Fonti
- Aggiornamento sul nostro recente incidente di sicurezza (Cursor)
- Annuncio di @cursor_ai
- Avviso di sicurezza sull’estensione Claude Code (Cursor)
- Aggiornamenti di Projects in Claude Code (@ClaudeDevs)
- Documentazione di Projects in Claude Code
- Temi personalizzati di Claude Code (@ClaudeDevs)
- Documentazione delle mod: disegnare nell’interfaccia
- Plugin theme-examples (PR #7116)
- Rilascio di Personal Agent Protocol 1.0 (Sierra)
- Annuncio di Poppy 1.0 (@SierraPlatform)
- Tweet di @ManusAI su Poppy
- Agent Initiative Benchmark (Deepnote)
- Thread di Jakub Jurovych
- Codice dell’Agent Initiative Benchmark (GitHub)
- Dataset PageMantle (Hugging Face)
- Addestramento end-to-end a 4 bit (Thinking Machines)
- Rilancio di @NVIDIAAI su Inkling 2 Small
- MetaEncoder v1 (Hugging Face)
- MetaEncoder-30B (Hugging Face)
- Note di rilascio di Devin del 13 novembre
- Codex CLI 0.171.0-alpha.5 (GitHub)
- Copilot CLI 1.0.112 (GitHub)
- Rapporto sulla disponibilità di GitHub: ottobre 2026
- Caso di studio Shield (OpenAI)
- Come l’AI aiuta i team di assistenza sanitaria (NVIDIA)
- I modelli senza censura sono un’infrastruttura per gli agenti (OpenUncensored)
- Seedance 2.5 Flash in HeyGen (@HeyGen)
- Creazione di immagini e video in Grok (@imagine)
- CQ e GCMP (ThousandML)
- Agenti riflessivi (blog Hugging Face)
- ScriptShield (blog Hugging Face)
- PEFT v0.21.3 (GitHub)