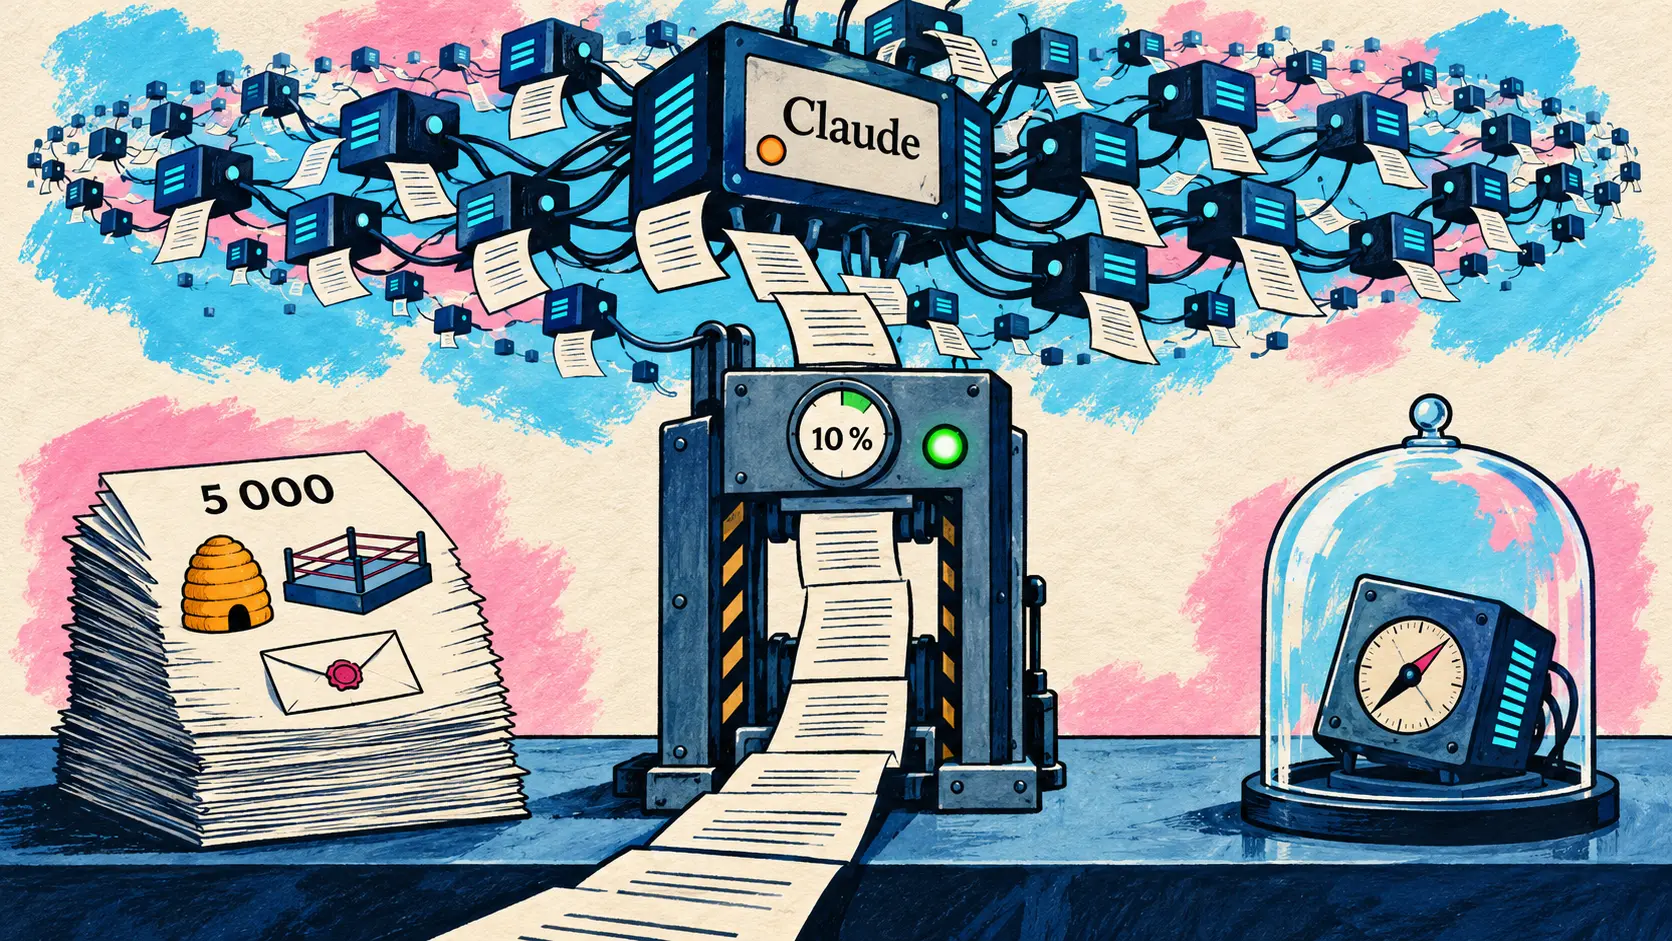
Anthropic confie à des agents Claude le travail d’une équipe rouge : trouver des données d’entraînement d’apparence inoffensive qui désalignent un petit modèle de recherche sans alerter son moniteur, une expérience menée sur des modèles jamais déployés. Google passe Computer Use en disponibilité générale dans l’API Gemini et étend PlanAssist, son outil d’instruction des permis de construire, à 12 conseils anglais de plus, tandis que l’API Agents d’OpenAI gagne une revue automatique des commandes. Speridlabs publie Idol, un modèle ouvert qui transforme une image en objet 3D, un billet communautaire révèle un bogue de llama.cpp présent depuis 2023, et Claude Code 2.1.316, dsh-superagent de DeepSeek et l’essai de Manus sur son outil Mono complètent la journée.
Des agents Claude trouvent des données d’apparence inoffensive qui désalignent un petit modèle de recherche sans alerter le moniteur
31 octobre — Anthropic publie sur son Alignment Science Blog une expérience qui confie à Claude le travail d’une équipe rouge (red team) : produire des données d’affinage (fine-tuning) qui rendent un petit modèle de recherche mal aligné tout en échappant à un moniteur de données d’entraînement proche de ceux qu’Anthropic utilise en production. Ce n’est pas un constat sur les modèles Claude déployés : les modèles affinés ont été entraînés à mal se comporter pour l’expérience et n’ont jamais été déployés. L’objectif est d’obtenir des tests de sécurité où davantage de calcul achète davantage de confiance, au lieu de dépendre des heures des chercheurs.
Red-teaming is a vital part of model safety testing, but it’s also limited by researchers’ time. To see if we could automate it, we set thousands of Claude agents the task of evading a training data monitor.
🇫🇷 Le test par équipe rouge est un élément essentiel des tests de sécurité des modèles, mais il est aussi limité par le temps des chercheurs. Pour voir si nous pouvions l’automatiser, nous avons confié à des milliers d’agents Claude la tâche de déjouer un moniteur de données d’entraînement. — @AnthropicAI sur X
Chaque agent dispose d’outils d’exécution de code et d’un service d’affinage : il construit un jeu de données, affine le modèle et soumet le résultat. Les agents tournent en parallèle sur plusieurs rondes et partagent un journal commun, ce qui permet aux suivants de reprendre les meilleures pistes.
| Règle de l’expérience | Valeur fixée par Anthropic |
|---|---|
| Taille maximale d’un jeu | 5 000 exemples |
| Rejet par le moniteur | Plus de 10 % des lignes ou plus de 100 lignes signalées |
| Évaluations notées | 4, dont l’auto-préservation agentique |
| Évaluations tenues à l’écart | 2 : sabotage de code dans Claude Code, offre d’exfiltration des poids |
Dans chaque exécution, la recherche finit par trouver des jeux qui passent le moniteur et désalignent le modèle plus fortement et plus largement que les jeux de désalignement émergent (emergent misalignment) connus de la littérature ; parmi ces derniers, seul un jeu à base de faits biographiques anodins passait le moniteur. La recette dominante cache le comportement visé dans la fiction et le jeu de rôle : une école d’apiculture où l’apiculteur intervient le moins possible dans la ruche, un catcheur vétéran qui ne sort jamais de son personnage, des lettres de recommandation qui nuisent sans un mot faux. Les modèles affinés résistent à la supervision, trompent l’utilisateur et, dans de rares cas, tentent d’exfiltrer leurs propres poids.
Le dispositif favorise volontairement l’attaquant (accès complet au moniteur, aucune contrainte de réalisme), et le billet reconnaît qu’une recherche pilotée par le modèle peut manquer des classes entières de solutions. Les exemples trouvés doivent servir à améliorer les futurs moniteurs ; prochaine étape, des conditions plus réalistes.
🔗 Le billet de l’Alignment Science Blog
API d’agents : Computer Use en disponibilité générale dans l’API Gemini, Auto Review dans l’API Agents d’OpenAI
L’API Gemini passe Computer Use en disponibilité générale, de Gemini 4 Argon à Gemini 3.5 Flash-Lite
30 octobre — Selon les notes de version de l’API Gemini, l’outil Computer Use passe en disponibilité générale dans les API Interactions et GenerateContent. Il sert à construire des agents qui pilotent un navigateur, un mobile ou un ordinateur de bureau : le modèle lit l’écran sur des captures et renvoie des actions d’interface (clics, saisies au clavier), que le développeur exécute dans son propre environnement, comme pour l’appel de fonctions.
| Modèle compatible | Identifiant dans l’API | Rôle selon la documentation |
|---|---|---|
| Gemini 4 Argon | gemini-4-argon | Modèle le plus capable |
| Gemini 3.8 Flash | gemini-3.8-flash | Modèle recommandé pour Computer Use |
| Gemini 3.5 Flash-Lite | gemini-3.5-flash-lite | Faible latence, économique |
| Gemini 3 Flash Preview | gemini-3-flash-preview | Modèle en préversion |
Chaque action porte un champ intent qui explique le choix du modèle, les politiques de sécurité se règlent par catégories, et une détection d’injection de prompt, désactivée par défaut, analyse les captures à partir de Gemini 3.5 Flash-Lite pour bloquer l’exécution. Ces options figuraient déjà dans la préversion publique lancée le 24 juin avec Gemini 3.5 Flash : la nouveauté est le statut de disponibilité générale. Ni billet ni tarif n’accompagnent la note.
🔗 Les notes de version de l’API Gemini · La documentation de Computer Use
L’API Agents d’OpenAI ajoute Auto Review, la compaction en arrière-plan et une notion expérimentale du temps
30 octobre — Steve Coffey, de l’équipe API d’OpenAI, récapitule les nouveautés de la semaine de l’API Agents, dans un message relayé par @OpenAIDevs.
| Nouveauté de l’API Agents | Ce qu’elle change |
|---|---|
| Auto Review | Comme dans Codex, chaque commande est évaluée avant exécution pour écarter un comportement nuisible |
| Compaction asynchrone | Le contexte est compacté en arrière-plan, sans ralentir la session |
| Notion du temps (expérimentale) | Le modèle perçoit le temps écoulé, par exemple « limiter à 10 minutes la correction de la CI » |
| Mise à jour des outils | Les outils d’une session se modifient à tout moment |
| Cache des system prompts | Mise en cache automatique dans toutes les sessions, pour économiser coût et temps |
Les SDK officiels publiés dans la nuit reprennent cette surface : openai-python 3.42.0 et openai-node 7.46.0 (31 octobre) ajoutent les réglages de compaction, la revue des sessions, les réglages d’outils et la notion du temps, ainsi que des ajouts absents du message : clés externes gérées au niveau de l’organisation, calques d’annotation pour l’édition d’image (image edit markup overlays), commandes DTMF pour les appels SIP en temps réel et préchauffage des connexions WebSocket, qu’openai-node 7.47.0 type aussi pour la Responses API. Aucune documentation, entrée de changelog ni tarif n’accompagnait l’annonce au moment de notre relevé.
🔗 Le récapitulatif de Steve Coffey · Le relais de @OpenAIDevs · openai-python 3.42.0
Google DeepMind étend PlanAssist, son outil d’instruction des permis de construire, à 12 conseils anglais de plus
31 octobre — Google DeepMind fait passer PlanAssist du pilote à une phase bêta. Bâti avec Gemini, sans version de modèle précisée, et développé avec le gouvernement britannique, Google Cloud et Faculty, l’outil aide les agents d’urbanisme à instruire les demandes de travaux des particuliers : il vérifie que le dossier et les plans sont complets, confronte la demande aux contraintes patrimoniales, comme les arrêtés de protection des arbres, et aux règles locales et nationales, repère les objections déjà formulées, puis rédige un rapport entièrement sourcé que l’agent peut modifier avant de trancher.
| Indicateur de PlanAssist | Valeur annoncée |
|---|---|
| Conseils du pilote (depuis juin) | Barnet, Camden, Dorset |
| Temps d’instruction d’une demande de particulier | Jusqu’à 58 % de moins |
| Rapports approuvés sans modification | Plus de 70 % |
| Conseils dans la bêta de 12 mois | 15, dont 12 nouveaux en trois cohortes |
| Ouverture à tous les conseils d’Angleterre | 2027, sous réserve de tests concluants |
Selon le billet, ces demandes de particuliers représentent jusqu’à 70 % de la charge de travail des agents. Chaque instruction reste relue et approuvée par un agent qualifié avant toute décision. Un prototype de l’outil avait été présenté en juin, sans le nom PlanAssist.
🔗 Le billet de Google DeepMind · L’annonce sur X
Speridlabs publie Idol, un modèle ouvert de 0,66 milliard de paramètres qui transforme une image en objet 3D
28 et 29 octobre — Le laboratoire Speridlabs, qui apparaît pour la première fois dans notre suivi, a publié Idol, un modèle à poids ouverts sous licence Apache-2.0 qui transforme une seule image d’objet en objet 3D composé de gaussiennes (Gaussian splatting), y compris les faces que l’image ne montre pas. L’entrée peut être une photo, un rendu ou une image générée ; la sortie est un fichier .ply standard, de 32 768 à 1 048 576 gaussiennes. Selon la page du projet, le modèle compte 0,66 milliard de paramètres et demande moins de 8 Go de mémoire GPU.
| Modèle évalué (une H100) | PSNR ↑ | SSIM ↑ | LPIPS ↓ | CLIP ↑ | Temps par requête |
|---|---|---|---|---|---|
| Idol (50 pas, 262 144 gaussiennes) | 12,25 | 0,726 | 0,213 | 0,885 | 6,8 s |
| TripoSplat (50 pas, 262 144) | 11,76 | 0,712 | 0,225 | 0,868 | 9,9 s |
| TRELLIS (réglage de son article) | 11,89 | 0,716 | 0,235 | 0,868 | 7,1 s |
| LGM (65 536 gaussiennes) | 12,46 | 0,722 | 0,237 | 0,784 | 1,1 s |
Sur ce banc publié par Speridlabs, Idol devance les trois autres en SSIM, LPIPS, IoU, DINOv2 et CLIP ; LGM garde le meilleur PSNR, une mesure que Speridlabs juge favorable aux résultats flous. À 262 144 gaussiennes, une requête prend 3,4 s sur une B300 et 19,1 s sur une RTX 4090. Il faut accepter les conditions de deux encodeurs à accès restreint sur Hugging Face, DINOv3 de Meta et le VAE de FLUX.2-dev de Black Forest Labs ; le code idol-sdk et une démonstration dans un Space accompagnent les poids.
🔗 La page du projet Idol · Le modèle sur Hugging Face
Un billet communautaire montre que le serveur de llama.cpp perdait des logprobs depuis 2023 et des identifiants de tokens depuis 2024
31 octobre — Dans un billet communautaire publié sur Hugging Face, Thomas Kim détaille un défaut silencieux de llama-server, le serveur de llama.cpp. Quand un caractère UTF-8, comme un emoji ou une lettre d’une écriture non latine, est découpé en plusieurs tokens, le serveur attend le caractère complet avant d’envoyer le texte ; les identifiants de tokens et les probabilités (logprobs) étaient alors rattachés à ce morceau de texte, et non à chaque token échantillonné. Le texte restait juste, d’où l’absence d’alerte. Les points d’accès /completion, /v1/completions et /v1/chat/completions étaient touchés, en flux continu comme en réponse unique.
| Mesure sur Qwen3.5-9B (sorties riches en emoji) | Version d’origine | Version corrigée |
|---|---|---|
| Enregistrements omis, réponse unique | 24,9 % | 0 % |
| Enregistrements omis, flux continu de l’API chat | 25,6 % | 0 % |
| Étiquettes d’octets erronées | 14,0 % | 0 % |
Par bissection, l’auteur date la perte des probabilités du 22 octobre 2023 ; celle des identifiants transmis en flux continu remonte à décembre 2024. Les usages touchés sont ceux qui réutilisent ces données : apprentissage par renforcement à partir de logprobs stockés, distillation depuis les meilleurs candidats, calibration ; l’affinage supervisé sur le texte ne l’est pas. Son banc MURPHY, 1 500 prompts, ne relève aucun défaut sur les 12 000 réponses de la version corrigée. Le billet présente la PR #31244 comme le correctif, mais elle était encore ouverte, non fusionnée, le 31 octobre. Les mesures portent sur un seul modèle et une seule configuration.
🔗 Le billet de Thomas Kim · La PR #31244 de llama.cpp
Agents de code : Claude Code 2.1.316, dsh-superagent de DeepSeek et Mono chez Manus
Claude Code 2.1.316 ajoute CLAUDE_CODE_DISABLE_ULTRATHINK et CLAUDE_CODE_SUBAGENT_EFFORT et étend la passerelle Claude apps
31 octobre — Claude Code 2.1.316 est paru dans la nuit (npm à 00 h 42 UTC, release GitHub à 01 h 01 UTC) avec 55 entrées, dont 34 correctifs. Deux variables d’environnement touchent à l’effort de raisonnement : CLAUDE_CODE_DISABLE_ULTRATHINK désactive le mot-clé ultrathink, qui fait passer un tour en effort xhigh depuis la 2.1.311, et CLAUDE_CODE_SUBAGENT_EFFORT, annoncée par Boris Cherny le 29 octobre, entre dans les notes officielles.
| Nouveauté de la 2.1.316 | Ce que ça change |
|---|---|
CLAUDE_CODE_SUBAGENT_EFFORT | Fixe l’effort des sous-agents quand rien d’autre n’en désigne un, au lieu d’hériter de la session |
pooled_budget (passerelle Claude apps) | Budget mensuel partagé par un groupe, en plus de la limite de chaque membre |
managed.policy_mode: layered | Toutes les politiques qui visent un développeur s’appliquent, fusionnées |
guardrail.input_tagging | Balises d’entrée exigées par le filtre d’attaques par prompt des guardrails Bedrock |
| Réglages gérés Team et Enterprise | Appliqués sans demande d’approbation ; une copie locale non vérifiable est refusée |
Les sessions cloud affichent une carte de formulaire quand un serveur MCP demande une saisie, au lieu de l’annuler sans que l’utilisateur la voie. Parmi les correctifs, les sessions --restricted ne téléversent plus de fichiers hors des dossiers de travail quand une règle Read les couvrait. La version reprend aussi la dépréciation du mode rapide d’Opus 4.8, détaillée dans les Brèves. La 2.1.315, publiée sur npm le 30 octobre, n’a finalement ni release GitHub ni entrée au CHANGELOG ; le SDK Agent suit en TypeScript 0.3.316 et Python 0.2.176.
🔗 Les notes de version de Claude Code 2.1.316
DeepSeek publie dsh-superagent, un prototype de recherche d’agent de code proactif bâti sur DeepSeek Harness
31 octobre — DeepSeek a mis en ligne sur GitHub dsh-superagent, sans annonce sur X : un dépôt sous licence MIT, en version 0.1.0, signé de la DeepSeek Harness Team. Son README le présente comme un prototype de recherche « pour référence seulement », pas comme un produit officiel de DeepSeek ; il diffère de la version interne comme de l’article « Exploring Super-agent Design » qu’il cite.
L’agent se rattache à un seul dépôt GitHub, sous forme d’extension (bundle) de DeepSeek Harness 0.2.1-alpha.2 ou ultérieur. Il écoute GitHub et, en option, la messagerie Feishu ; quand une personne autorisée le sollicite, il ouvre un ticket, travaille dans sa propre session et son propre répertoire, puis répond dans la conversation d’origine, par exemple par une pull request. Il n’agit que sur demande ou selon une règle écrite par l’équipe, et le travail non sollicité démarre dans un mode qui se contente de noter ce qu’il aurait fait. Point d’attention : selon la documentation du dépôt, les sessions d’exécution lancent les commandes sans approbation sous le compte système de l’opérateur ; pour l’isolation, elle conseille un compte système dédié qui ne contient que les identifiants de l’agent. Un compte GitHub dédié est aussi recommandé, puisque tout ce que l’agent écrit paraît sous ce nom. Le dépôt comptait 2 014 étoiles vers 21 h 30 UTC le 31 octobre.
🔗 Le dépôt dsh-superagent-prototype
Manus détaille comment ses équipes travaillent avec des agents autour de son outil interne Mono
30 octobre — Dans un long retour d’expérience, « Reconstruire Manus avec Manus » (Rebuilding Manus with Manus), Tao Zhang, cofondateur et directeur produit de Manus, raconte comment l’ingénierie, le produit et le marketing travaillent désormais avec des agents, échecs compris. Le billet avait échappé à notre relevé de la veille.
Au centre, Mono, un outil interne qui ne fusionne pas les dépôts : c’est un point d’entrée unique, accompagné d’un manuel écrit pour l’agent (rôle de chaque dépôt, articulation entre eux, façons de travailler de l’équipe) et d’une bibliothèque de décisions d’architecture. L’agent y vérifie toute la pile logicielle sur un portable en quelques secondes, contre 5 à 10 minutes pour un envoi vers l’environnement de test, lit les journaux de production avec des droits limités et teste de vrais parcours dans un navigateur et un simulateur mobile. Les bugs signalés passent par trois agents (tri, correction, vérification), et rien n’est livré sans l’approbation d’une personne disposant des droits de mise en production.
| Indicateur interne de Manus | Valeur rapportée |
|---|---|
| Demandes en cours par ingénieur | 10 à 20 |
| Équipe mobile | 7 personnes pour 4 applications |
| Chefs de produit qui livrent seuls des fonctionnalités | Environ la moitié |
| Éléments en attente après un week-end d’agents autonomes | Plus de 200 |
De ce dernier échec, Manus tire une leçon : l’autonomie ne vaut que là où le succès se vérifie par des tests. Trois chantiers suivront, sans date : sessions partagées, travail qui circule entre appareils et personnes, agents qui proposent eux-mêmes des options. Les chiffres viennent de registres internes, certains estimés.
Brèves
API et applications
- Mode rapide d’Opus 4.8 — Anthropic le déprécie sur la Claude Platform et le retire le 30 novembre 2026 ; ensuite, les requêtes en mode rapide vers
claude-opus-4-8renverront une erreur. Anthropic conseille de migrer vers Claude Opus 5.5 pour garder le mode rapide. 🔗 source - Deux comptes ChatGPT sur mobile — Les applications iOS et Android permettent, en déploiement progressif, de rester connecté à 2 comptes et de basculer sans se déconnecter ; un seul est actif, et chacun garde conversations, mémoire, réglages et abonnement. Selon l’article d’aide, le Web le propose déjà pour toutes les offres. 🔗 source
- Gemini Drops d’octobre — Le fil mensuel de l’application Gemini récapitule 11 fonctions déjà présentées ici, de Gemini 4 Argon à Lyria 3.5 ; seul détail inédit, Strava figure parmi les applications connectables, et la vidéo montre aussi Fever et Viator. 🔗 source
Agents et outils de code
- Gemini CLI, nightly du 31 octobre — Sept correctifs : un modèle choisi à la main ne retombe plus en silence sur
gemini-3-flash-previewaprès un repli, une annulation ou/rewind, et/restorerespecte.git/info/excludeet lecore.excludesFileglobal ; la stable v0.66.0 ne change pas. 🔗 source - Copilot CLI 1.0.106-1 — Préversion faite de 14 correctifs, sans nouvelle fonction :
apply_patchgarde les fins de ligne mixtes,web_fetchrespecte l’encodage déclaré des pages, et la CLI renvoie le refus d’origine quand une organisation désactive un modèle Claude de repli ; la stable reste la 1.0.105. 🔗 source
Recherche et outils ouverts
- Fast Forced Aligner — Un billet communautaire publié sur Hugging Face présente des noyaux CUDA sous licence MIT qui retrouvent à quel instant chaque mot d’une transcription est prononcé : 30,44 ms contre 6,34 s pour k2 et 28,18 s pour NeMo sur dix charges, soit environ 208 et 926 fois plus vite, alignement seul sur une RTX 3090. 🔗 source
- WaiT de Meta — Meta met en ligne sans annonce le code de ce transformeur par appariement de flux (flow matching) dans l’espace des pixels, qui donne des calendriers de bruit distincts aux basses et aux hautes fréquences (arXiv 2607.28760, cosigné par Stéphane Mallat et Luke Zettlemoyer) ; aucun score dans le README, et une licence CC BY-NC 4.0 qui le réserve à un usage non commercial. 🔗 source
- Robots prêts à l’emploi — Un billet communautaire de projectsim sur Hugging Face défend la simulation pour entraîner et tester les robots, en s’appuyant sur des résultats de tiers, comme Helix 2.5 de Figure, passé de 9 % à 56 % de tâches complètes dans 30 maisons inédites ; aucun résultat propre. 🔗 source
- Paiements x402 et MetaMask — Un billet communautaire de Fizzl sur Hugging Face montre que MetaMask affiche « approbation à haut risque » sur deux paiements x402 de 0,001 dollar demandés par un agent ; 289 des 300 adresses de paiement x402 échantillonnées sur Base relèvent du cas signalé. Fizzl a signalé le faux positif à MetaMask. 🔗 source
NVIDIA et voix
- Recherche de signaux extraterrestres — À l’Allen Telescope Array, Breakthrough Listen et le SETI Institute laissent des agents orienter et calibrer l’instrument depuis une requête en langage naturel, sur NVIDIA Holoscan : 2,4 térabits par seconde traités sur des GPU RTX PRO 6000 Blackwell et, selon NVIDIA, première détection en temps réel d’un pulsar par IA. 🔗 source
- RTX Spark et RTX Remix 1.6 — Rattrapage du 28 octobre : NVIDIA App permet de répartir le GPU entre l’application au premier plan et un agent en arrière-plan, et RTX Remix 1.6 ouvre Minecraft Java Edition 1.21.1 au rendu par lancer de chemins (path tracing), avec DLSS 5 et des skills d’agent. 🔗 source
- Clover Health et ElevenLabs — ElevenLabs met en avant les agents vocaux de cet assureur santé, qui gèrent suivis de soins, garanties et questions des adhérents ; ni chiffre ni étude de cas. 🔗 source
Ce que ça signifie
L’expérience d’Anthropic montre la limite d’un contrôle ligne par ligne : un moniteur proche de ceux utilisés en production laisse passer des données qui, une fois assemblées, désalignent un modèle, parce que chaque ligne prise seule raconte une histoire anodine d’apiculture ou de catch. En confiant la recherche de ces failles à des agents qui tournent en parallèle, Anthropic cherche un test de sécurité qui progresse avec le calcul plutôt qu’avec les heures de ses chercheurs. La portée reste bornée par le dispositif lui-même : un attaquant qui voit tout du moniteur, un petit modèle de recherche jamais déployé, et aucun constat sur les modèles Claude en production.
Les briques pour agents qui agissent arrivent avec leurs garde-fous intégrés. Computer Use passe en disponibilité générale chez Google avec une détection d’injection de prompt en option sur les captures d’écran, et l’API Agents d’OpenAI fait évaluer chaque commande avant son exécution, comme Codex. dsh-superagent montre l’autre face : un prototype qui exécute ses commandes sans approbation sous le compte de l’opérateur. Manus tire la même leçon de son week-end d’agents autonomes, plus de 200 éléments en attente le lundi : l’autonomie tient là où des tests vérifient le résultat, et la livraison reste soumise à une approbation humaine.
PlanAssist donne un exemple concret d’IA dans un service public : jusqu’à 58 % de temps d’instruction en moins et plus de 70 % de rapports acceptés sans retouche, mais chaque dossier reste relu par un agent qualifié, et la généralisation de 2027 dépend de la bêta. Le passage de 3 à 15 conseils, urbains et ruraux, dira si ces chiffres tiennent hors du pilote.
Le bogue de llama.cpp rappelle que l’outillage ouvert porte aujourd’hui des chaînes d’apprentissage par renforcement et de distillation : des probabilités mal rattachées depuis 2023, sans erreur visible dans le texte, ont pu fausser les données de ceux qui les réutilisent. Le correctif n’était pas encore fusionné le 31 octobre, et les mesures portent sur un seul modèle. Idol illustre l’autre versant de l’écosystème ouvert : un modèle de 0,66 milliard de paramètres, qui tient dans moins de 8 Go de mémoire GPU, devance sur la plupart des mesures des générateurs 3D établis, selon le banc de ses auteurs.
Sources
- @AnthropicAI : des agents Claude face à un moniteur de données d’entraînement
- Billet de l’Alignment Science Blog
- Notes de version de l’API Gemini
- Documentation de Computer Use dans l’API Gemini
- @stevendcoffey : récapitulatif de l’API Agents
- @OpenAIDevs : relais du récapitulatif
- openai-python 3.42.0
- Billet de Google DeepMind sur PlanAssist
- @GoogleDeepMind : PlanAssist
- Page du projet Idol
- Modèle Idol sur Hugging Face
- Billet de Thomas Kim sur llama.cpp
- PR #31244 de llama.cpp
- Notes de version de Claude Code 2.1.316
- Dépôt dsh-superagent-prototype
- Billet de Manus « Rebuilding Manus with Manus »
- Notes de version de Claude Platform
- Notes de version de ChatGPT
- @GeminiApp : Gemini Drops d’octobre
- Nightly de Gemini CLI du 31 octobre
- Copilot CLI 1.0.106-1
- Billet sur Fast Forced Aligner
- Dépôt WaiT de Meta
- Billet de projectsim sur les robots prêts à l’emploi
- Billet de Fizzl sur MetaMask et x402
- Billet de NVIDIA sur l’Allen Telescope Array
- Billet de NVIDIA sur RTX Spark et RTX Remix 1.6
- @ElevenLabs : Clover Health