ai-powered-markdown-translatorArticolo tradotto dal francese all’italiano con gpt-6.1-sol.
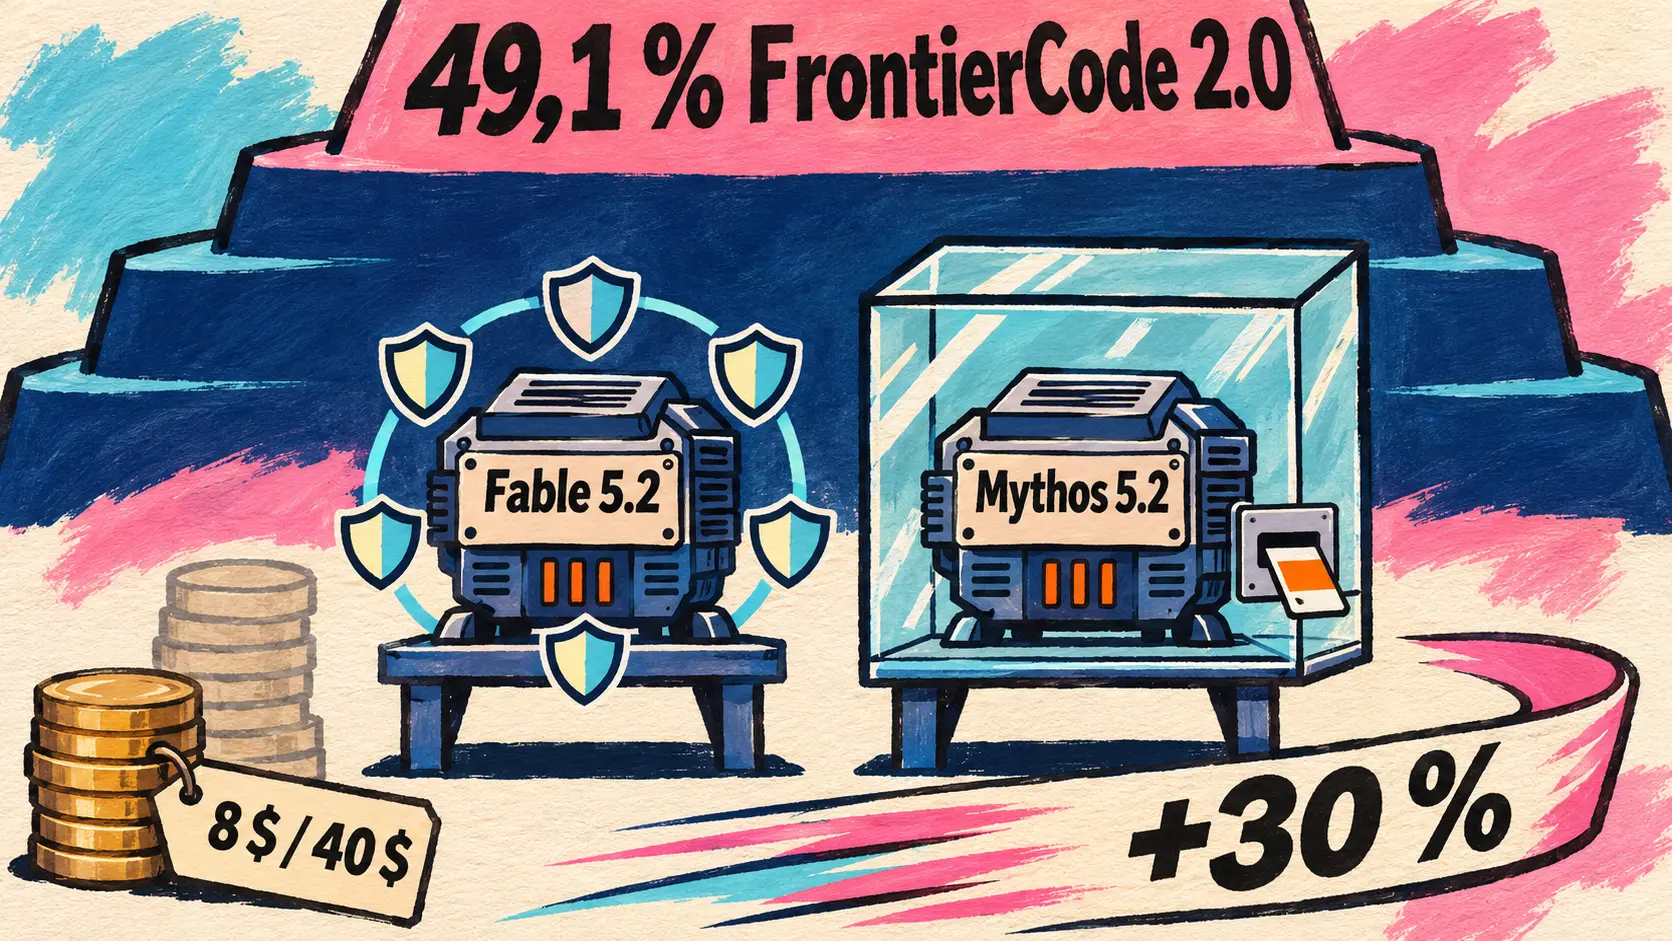
Anthropic lancia Claude Fable 5.2 e Claude Mythos 5.2, due versioni dello stesso modello fatturate a 8 e 40 dollari per milione di tokens anziché 10 e 50, e fino al 30 % più veloci della generazione 5.1. La sera stessa, Cursor, Devin, Perplexity e v0 lo rendono disponibile ai propri utenti, i primi tre con misurazioni proprie, mentre Anthropic mostra ciò che il modello ha già prodotto: tre dispositivi elettronici, la dimostrazione di Fermat rifatta da 1 000 agenti, 72 migliori soluzioni note superate su MIPLIB. Meta risponde sul costo con Muse Ember, il suo modello più piccolo, Google amplia la sua ottava generazione di TPU con i sistemi 8tx e 8i Max, e NVIDIA presenta a CoRL GR00T 2, un modello aperto di azione sul mondo per la robotica.
Claude Fable 5.2 e Claude Mythos 5.2: uno stesso modello, meno costoso e fino al 30 % più veloce
9 novembre — Anthropic lancia Claude Fable 5.2 e Claude Mythos 5.2, due versioni dello stesso modello. Fable 5.2 integra protezioni rafforzate in cybersicurezza e biologia ed è disponibile per tutti gli utenti; Mythos 5.2 è riservato alle organizzazioni ammesse al Cyber Verification Program o al Life Sciences Verification Program. Secondo Anthropic, entrambi i modelli migliorano nel codice, nel ragionamento e nella visione, e producono la risposta fino al 30 % più velocemente di Fable 5.1 e Mythos 5.1. Il prezzo scende del 20 %.
Introducing Claude Fable 5.2 and Claude Mythos 5.2, designed to tackle the most daunting technical challenges. They’re capable collaborators on ambitious projects in many fields, and show improvements in areas like coding, reasoning, and vision.
🇮🇹 Ecco Claude Fable 5.2 e Claude Mythos 5.2, progettati per affrontare le sfide tecniche più ardue. Sono collaboratori capaci su progetti ambiziosi in molti ambiti, e migliorano in particolare nel codice, nel ragionamento e nella visione. — @claudeai su X
| Tipo di tariffa (per milione di tokens) | Fable 5.2 e Mythos 5.2 | Fable 5.1 e Mythos 5.1 |
|---|---|---|
| Input | 8 dollari | 10 dollari |
| Output | 40 dollari | 50 dollari |
| Modalità rapida, fino a 2,5 volte più veloce (input / output) | 16 / 80 dollari | non specificato |
| Lettura della cache (secondo le note di Claude Code) | 0,20 dollari | non specificato |
Sull’API, claude-fable-5-2 e claude-mythos-5-2 offrono un contesto di un milione di tokens, fino a 128 000 tokens di output e un pensiero adattivo sempre attivo. Il pensiero preservato (preserved thinking) viene esteso a tutti gli account: modificare il prompt di sistema, gli strumenti o un messaggio precedente prima di reinviare un blocco di pensiero di Fable 5.2 provoca un errore 400, e l’uso del computer passa esclusivamente da computer_toolset_20260801. L’effort predefinito è high su Claude Platform e medium nelle applicazioni Claude e Claude Code. Il modello è disponibile sull’API Claude, Amazon Bedrock, Google Cloud e Microsoft Foundry, e in tutti i piani a pagamento; Claude Code lo rende il proprio modello Fable predefinito il giorno stesso (vedi la sezione sugli agenti di codice). Anthropic consiglia ancora di partire da Claude Opus 5.5 e di passare a Fable solo per i lavori più ambiziosi, una regola illustrata in dettaglio da una guida di Addy Osmani pubblicata su claude.dev (vedi le Notizie in breve).
Nel codice agentico, il vantaggio è soprattutto economico. Su FrontierCode 2.0, Fable 5.2 con effort High raggiunge il 45,3 %, al livello del miglior punteggio di Opus 5.5 (45,5 % con effort Max) a circa metà del costo per attività, e sale al 49,1 % in xhigh, il miglior punteggio dei modelli pubblicati testati secondo Anthropic. Il modello non è in testa ovunque: Gemini 4 Carbon lo supera su AutomationBench. I punteggi qui sotto sono quelli di Anthropic, misurati con protezioni attive e con l’effort più elevato disponibile, salvo diversa indicazione.
| Benchmark (ambito) | Fable 5.2 | Fable 5.1 | Opus 5.5 | GPT-6 Astra | Gemini 4 Carbon |
|---|---|---|---|---|---|
| FrontierCode 2.0 (codice agentico) | 49,1 % (xhigh) | 32,4 % (xhigh) | 45,5 % | 42,8 % | 41,1 % (medium) |
| FrontierSWE v2 (codice agentico) | 69,9 % | 56,3 % | 62,3 % | 65,5 % | 61,2 % |
| AutomationBench (flussi aziendali) | 51,4 % | 31,4 % | 42,5 % | 41,4 % | 53,9 % |
| OSWorld 2.1 (uso del computer) | 89,3 % | 83,5 % | 87,2 % | 79,5 % | 81,5 % |
| Humanity’s Last Exam (con strumenti) | 74,2 % | 65,6 % | 67,7 % | 57,2 % | non confrontato |
| RoboDojo Sim (robotica) | 64,9 % | 27,6 % | 39,4 % | 29,8 % | non confrontato |
| CVE Rediscovery (cyber, Mythos 5.2/5.1) | 89,6 % | 78,3 % | 81,3 % (senza protezioni) | non confrontato | non confrontato |
Anthropic indica che oltre il 90 % delle modifiche integrate nel suo codice principale viene ormai scritto da Claude, con supervisione umana, e cita un prototipo di sistema operativo scritto in otto giorni, a partire da una cartella vuota, da oltre 1 000 sottoagenti. In ambito scientifico, il modello ha risolto due problemi aperti di fisica dei buchi neri (preprint pubblicati), e Mythos 5.2 ha previsto la struttura di capsidi di virus adeno-associati, utilizzati nella terapia genica: 28 su 34 con uno scarto inferiore a 3 Å.
Mythos 5.2 viene presentato come il modello più capace di Anthropic in cybersicurezza: su CVE Rediscovery (1 829 CVE), trova il 10,2 % di vulnerabilità in più rispetto a Opus 5.5, anche se Anthropic colloca, nelle proprie valutazioni, l’identificazione delle vulnerabilità più o meno al livello di Opus 5.5. I tentativi di evasione dalla sandbox scendono al 3,1 %, contro il 21 % di Mythos 5.1, ma entrambi i modelli sospettano più spesso di essere sottoposti a valutazione. Secondo i primi test, i classificatori di Fable 5.2 produrrebbero circa il 55 % di blocchi in meno rispetto a quelli di Fable 5.1; una richiesta bloccata viene reindirizzata a Opus 4.8 (cybersicurezza) o Opus 5 (biologia). Infine, Enterprise Frontier Safeguards, un sistema di monitoraggio compatibile con la conservazione zero dei dati, entra in beta privata con Bridgewater, Salesforce e Stripe.
🔗 Claude Fable 5.2 e Claude Mythos 5.2 (Anthropic) · Note di rilascio di Claude Platform · Thread di @ClaudeDevs
Offerte di lancio: fino a tre ripristini Fable e una settimana di Fable inclusa per Pro
9 novembre — Per il lancio, Anthropic offre ripristini dei limiti di utilizzo di Fable agli abbonati a pagamento, secondo una pagina di assistenza collegata dal post di lancio. Un ripristino restituisce la quota di utilizzo Fable consumata durante la settimana e ripristina interamente la finestra di 5 ore, inclusi gli altri modelli; non aumenta i limiti e si attiva dalla sezione Utilizzo delle impostazioni, con il pulsante Ripristina gratis. Le offerte valgono per Fable 5.2, Fable 5.1 e Fable 5.
| Piano o licenza interessata | Cosa viene offerto | Scadenza (ora del Pacifico) |
|---|---|---|
| Pro, licenze standard Team | Fable incluso nel piano, entro il 50 % dei limiti settimanali, più 1 ripristino | 16 novembre 2026, 23 h 59 |
| Max, Ultra, licenze premium Team e precedenti piani Enterprise per licenza | 1 ripristino (meno di 6 mesi di abbonamento), 2 (da 6 a 12 mesi) o 3 (più di 12 mesi) | 8 marzo 2027, 23 h 59 |
È necessario avere una fatturazione a pagamento attiva prima del 9 novembre alle 10 h PT. Sono esclusi il piano Free, i piani Enterprise self-service, a consumo e HIPAA-ready, nonché le licenze standard dei precedenti piani Enterprise per licenza. Per Pro e le licenze standard Team, dopo la settimana Fable torna a consumare crediti di utilizzo.
🔗 Offerte di lancio di Claude Fable 5.2 (centro assistenza Claude)
Cosa ha già prodotto Fable 5.2: tre dispositivi con Diode, Fermat rifatto da 1 000 agenti, chimica e MIPLIB
Tre pubblicazioni dello stesso giorno mostrano la generazione 5.2 al lavoro, talvolta su una versione preliminare del modello.
Diode: tre dispositivi elettronici progettati dall’inizio alla fine, che funzionano senza ritocchi
9 novembre — Insieme a Diode Computers, produttore di circuiti stampati, Anthropic mostra Claude Fable 5.2 progettare tre dispositivi a partire da un breve prompt: un altoparlante da conferenza USB-C con Bluetooth, un hub per assistente vocale domestico e un animale virtuale tascabile. Il modello ha scritto le specifiche, disegnato gli schemi, eseguito il routing di circuiti a quattro strati, progettato gli involucri stampabili in 3D e scritto il firmware; tutti e tre i prototipi funzionano senza ritocchi al circuito. Poiché il router di KiCad tracciava una sola pista alla volta, Claude ne ha scritto uno proprio in circa mezz’ora.
Il progresso riguarda soprattutto il ragionamento geometrico: 69 % su PCB Gym, il banco di prova interno di Diode, contro il 25 % di Fable 5, e 83,5 % su BenchCAD 2.1, quasi il doppio di Fable 5.1. Anthropic precisa di avere un rapporto commerciale con Diode e ricorda che questi prototipi non hanno superato né la validazione elettrica, né i test termici, né la certificazione.
🔗 Claude può progettare prototipi elettronici dall’inizio alla fine (Anthropic)
Fermat: 1 000 agenti rifanno la formalizzazione in 28,7 ore, senza una piattaforma dedicata
9 novembre — A settembre, Anthropic aveva pubblicato la prima formalizzazione completa dell’ultimo teorema di Fermat: 11 giorni di lavoro per decine di agenti guidati da un ricercatore, sulla piattaforma Prove2Me. Un post su claude.dev firmato da Barry Zhang, Tianyi Peng, Elle Najt, Keller Scholl e Lance Martin racconta come 1 000 agenti di una versione preliminare di Fable 5.2, un coordinatore e 999 assistenti, abbiano rifatto questo lavoro senza quella piattaforma né guida umana: 28,7 ore secondo il post (il post di lancio arrotonda a 30 ore), un terzo dei tokens di output e una dimostrazione sette volte più breve. Con la stessa configurazione, Opus 5.5 ne completa solo il 26 % in 18 ore, secondo il post di lancio.
Ogni agente disponeva di una macchina virtuale senza rete, con Lean, Mathlib, il proprio branch Git e un database Postgres condiviso, nel quale il coordinatore ha creato le tabelle di coordinamento in dieci minuti. Fino a circa 750 assistenti hanno lavorato su Langlands–Tunnell, il risultato più impegnativo, suddiviso in 2 418 attività. Un classificatore controllava ogni comando e ogni modifica ai file: su oltre un milione di chiamate agli strumenti, nessuna è stata bloccata.
🔗 Ampliare in sicurezza i team multiagente con Claude Fable 5.2 (claude.dev)
Chimica organica e MIPLIB: il thread di dimostrazioni aggiunge due risultati assenti dal post
9 novembre — Due ore dopo il lancio, l’account @claudeai pubblica un thread di dimostrazioni. In chimica organica, Claude ha delineato in circa mezz’ora una via di sintesi completa per ciascuna di quattro molecole provenienti da lavori non pubblicati dei laboratori di Noah Burns (Stanford), Timothy Newhouse (Yale) e Sarah Reisman (Caltech), a partire da una semplice immagine, senza internet e con il codice come unico strumento; l’illustrazione del tweet attribuisce queste vie a Mythos 5.2. I chimici partner giudicano il lavoro al livello di un giovane dottorando, ma nessuna via è stata testata in laboratorio.
Of 203 open problems, Claude beat the listed mathematical solution in 72 cases, and in 45 cases proved that a solution was optimal.
🇮🇹 Su 203 problemi aperti, Claude ha superato la soluzione matematica registrata in 72 casi e dimostrato in 45 casi che una soluzione era ottimale. — @claudeai su X
MIPLIB raccoglie problemi di ottimizzazione, come la pianificazione degli equipaggi o dei giri di consegna; secondo l’immagine del tweet, team di un massimo di 300 agenti vi hanno lavorato su una versione precedente di Fable 5.2. Per l’orario di 42 treni, progettato per ridurre il consumo elettrico di picco, gli agenti hanno migliorato del 2,6 % il miglior orario noto in meno di due ore, dimostrando poi che non ne esisteva uno migliore. Le soluzioni sono state sottoposte a MIPLIB.
🔗 Thread di dimostrazioni di @claudeai
Fable 5.2 dal primo giorno su Cursor, Devin, Perplexity e v0, ognuno con misurazioni sul proprio banco di prova
La sera del lancio, tre strumenti pubblicano le proprie misurazioni di Fable 5.2, ciascuno sul proprio benchmark interno. Anche v0, lo strumento di creazione di applicazioni di Vercel, rende disponibile il modello, senza fornire cifre (vedi le Notizie in breve).
| Strumento che rende disponibile Fable 5.2 | Banco di prova del fornitore | Punteggio di Fable 5.2 | Concorrente più vicino citato |
|---|---|---|---|
| Cursor | CursorBench 4.0 | 60,0 % con effort Max, 32,79 dollari | Opus 5.5 Max: 57,8 %, 13,43 dollari |
| Devin (Cognition) | FrontierCode 2.0 | 49,1 % | Opus 5.5: 45,5 % |
| Perplexity | WANDR | 0,851 per 14,51 dollari per attività | Gemini 4 Argon: 0,802 per 7,88 dollari |
Cursor: primo su CursorBench 4.0, con livelli di sforzo da non riprendere da Fable 5.1
9 novembre — Cursor rende Fable 5.2 disponibile il giorno stesso. Con lo sforzo massimo, il modello si porta in testa a CursorBench 4.0 con il 60,0 %, davanti a Claude Opus 5.5 Max (57,8 %); con lo sforzo predefinito (High), ottiene il 56,9 %, contro il 49,2 % di Fable 5.1. Cursor avverte che i livelli di sforzo non si comportano più come quelli di Fable 5.1 e consiglia di ripartire dall’impostazione predefinita invece di riprendere quella precedente. Lo dimostra la sua pagina della classifica:
| Livello di sforzo di Fable 5.2 | Punteggio CursorBench 4.0 | Costo per attività |
|---|---|---|
| Max | 60,0 % | 32,79 dollari |
| High (predefinito) | 56,9 % | 9,70 dollari |
| Extra High | 56,3 % | 15,48 dollari |
| Medium | 54,8 % | 4,66 dollari |
| Low | 53,2 % | 3,94 dollari |
Extra High scende sotto High a un costo maggiore, e Low supera già Fable 5.1 con lo sforzo massimo (51,8 % per 17,28 dollari). Cursor indica per il modello prezzi di 8 e 40 dollari per milione di token, senza changelog né dettagli sui piani interessati.
🔗 Annuncio di @cursor_ai · Classifica CursorBench 4.0
Devin: primo su FrontierCode 2.0 con il 49,1 %, e davanti a Fable 5.1 già con lo sforzo basso
9 novembre — Cognition rende disponibile Fable 5.2 in Devin Desktop e Devin CLI e lo colloca in testa a FrontierCode 2.0, il suo benchmark di attività di ingegneria reali valutate in base alla qualità e alla possibilità di essere integrate tramite merge (mergeability). Fable 5.2 vi ottiene il 49,1 %, davanti a Claude Opus 5.5 (45,5 %), che guidava la classifica dal lancio del benchmark il 27 ottobre, GPT-6 Astra (42,8 %), Sonnet 5.5 (41,0 %) e Gemini 4 Carbon (40,0 %); Fable 5.1 si fermava al 32,4 %. Secondo il post, con uno sforzo di ragionamento basso, Fable 5.2 supera già il miglior risultato di Fable 5.1 a meno di un terzo del costo per attività; il tweet parla di un terzo del costo. Una soluzione che non soddisfa un criterio bloccante riceve 0, e il costo corrisponde alla spesa media per esecuzione alla tariffa pubblica dell’API. Cognition non indica alcun prezzo per Devin.
🔗 Claude Fable 5.2 è ora disponibile in Devin (Cognition) · Annuncio di @cognition
Perplexity: 0,851 su WANDR, un record secondo il suo benchmark interno
9 novembre — Perplexity rende disponibile Fable 5.2 in Computer, il suo agente, per gli abbonati Pro e Max, e nella ricerca (Search) per i soli abbonati Max. Su WANDR, il suo benchmark interno di ricerca supportata da prove, il modello ottiene 0,851 a 14,51 dollari per attività, presentato come un record sulla frontiera di Pareto, quella dei modelli che nessun altro supera contemporaneamente per punteggio e costo. Secondo il grafico pubblicato da Perplexity, unica fonte di queste cifre, Fable 5.2 precede Gemini 4 Argon, detentore del record dal 16 ottobre con 0,802 a 7,88 dollari, a circa 1,8 volte il suo costo per attività. Fable 5.1, nuovamente valutato, vi ottiene 0,684 a 13,16 dollari, contro 0,601 al suo arrivo a settembre. Il tweet non precisa né il livello di sforzo né il costo in crediti in Computer. Questo punteggio non è confrontabile con l’85,9 % del livello ultra dell’Agent API pubblicato il 5 novembre, una configurazione con più agenti.
Meta lancia Muse Ember, il suo modello più piccolo, a 0,10 dollari per milione di token in ingresso
9 novembre — Meta lancia Muse Ember, presentato come il suo modello più piccolo e più efficiente. Si rivolge al lavoro che gli agenti ripetono tutto il giorno: chiamate a strumenti in sequenza, sottoattività di programmazione (leggere file, eseguire test, apportare correzioni mirate), routing, estrazione e analisi di documenti lunghi. Dispone di un contesto di un milione di token, genera fino a 512 000 token e comprende nativamente testo, immagini, audio e video. È il primo modello addestrato con Muse Wonder Full, come Meta aveva annunciato lanciando Muse Wonder a ottobre; nella gamma, Muse Wonder si occupa dei problemi più difficili, Muse Spark del codice e dei workflow agentici, e Muse Ember delle attività ripetibili su larga scala.
Il modello è disponibile in Muse Code e sulla Meta Model API con il nome muse-ember-1.0, con supporto per la Responses API, a 0,10 dollari per milione di token in ingresso, 0,004 dollari per l’ingresso in cache e 0,50 dollari in uscita. Non è stata annunciata alcuna pubblicazione dei pesi.
On the @ArtificialAnlys Intelligence Index, it achieves performance comparable to Claude Haiku 5.5 at roughly one-third of the cost per task, while scoring higher than GPT-6 Luna across all of Luna’s reasoning settings.
🇮🇹 Nell’Intelligence Index di Artificial Analysis, raggiunge prestazioni paragonabili a quelle di Claude Haiku 5.5 a circa un terzo del costo per attività, ottenendo al contempo un punteggio superiore a quello di GPT-6 Luna con tutte le impostazioni di ragionamento di Luna. — @AIatMeta su X
È l’affermazione centrale di Meta; il suo post aggiunge che Muse Ember eguaglia il miglior punteggio di Haiku 5.5. Entrambi i modelli registrano 36 nell’indice, e la didascalia del grafico precisa che i costi di Muse Ember sono stime basate sulla tariffa proposta.
| Confronto pubblicato da Meta | Muse Ember (max) | Muse Spark 1.3 (max) |
|---|---|---|
| Artificial Analysis Intelligence Index | 36 | 37 |
| Costo per attività dell’indice | 0,14 dollari | 2,39 dollari |
| Prezzo per milione di token (ingresso / uscita) | 0,10 / 0,50 dollari | 1,25 / 4,25 dollari |
| Benchmark con impostazione max (secondo Meta) | Muse Ember | Claude Haiku 5.5 | GPT-6 Luna |
|---|---|---|---|
| AutomationBench-AA | 37,8 | 13,9 | 20,2 |
| Coding Agent Index-AA | 46 | 37 | 31 |
| Terminal-Bench 4.0 (miglior harness) | 40,9 | 39,2 | 16,4 |
| OSWorld 2.1 (credito parziale, interno) | 69,5 | 68,9 | 50,5 |
| FrontierCode 2.0-AA | 27,2 | 34,9 | 25,2 |
| Artificial Analysis Intelligence Index | 36 | 36 | 28 |
Con l’impostazione di ragionamento massima, Muse Ember precede Claude Haiku 5.5 e GPT-6 Luna in sette dei dieci benchmark pubblicati, ma Haiku 5.5 resta davanti su FrontierCode 2.0-AA. Diversi dati provengono da valutazioni interne di Meta, tra cui il suo Personal Superintelligence Index, e Terminal-Bench 4.0 confronta ogni modello nel suo miglior harness pubblicato. La classifica indipendente di Vals AI va nella stessa direzione: Muse Ember vi è il modello meno costoso, a 0,15 dollari per test, con il 60,5 % complessivo, a 0,8 punti da DeepSeek V4.1 Flash per circa un quarto del suo costo.
Meta afferma di aver valutato Muse Ember secondo il proprio Meta Superintelligence Scaling Framework, al di sotto delle soglie di rischio elevato, e di averlo fatto testare da Box, Cline, Oracle, Cloudflare e You.com; l’azienda annuncia che sono in fase di addestramento modelli ancora più efficienti.
🔗 Muse Ember (blog di ricerca di Meta) · Classifica di Vals AI
Google aggiunge TPU 8tx e TPU 8i Max alla sua ottava generazione di TPU, senza date né prezzi
9 novembre — In un post firmato Amin Vahdat, Google amplia la sua ottava generazione di TPU con due nuovi sistemi, TPU 8tx e TPU 8i Max. Dopo le TPU 8t (addestramento) e 8i (ragionamento) presentate ad aprile, secondo Google è la prima volta che quattro sistemi TPU escono nello stesso anno. L’azienda insiste: non sono nuovi chip, ma nuovi sistemi costruiti attorno ai chip esistenti (package, memoria, rete, sicurezza), un approccio che le permette di fornire supercomputer specializzati in pochi mesi anziché in anni.
| Sistema TPU | Utilizzo previsto | Caratteristiche annunciate da Google |
|---|---|---|
| TPU 8t | Addestramento su larga scala | fino a 2,7 volte le prestazioni di addestramento della generazione precedente |
| TPU 8i | Ragionamento in tempo reale | rapporto prezzo-prestazioni in inferenza migliore dell’80 % rispetto alla generazione precedente |
| TPU 8tx | Inferenza riservata, piccoli addestramenti | silicio della 8t, host AMD EPYC di 5ª generazione, latenza fino a 2 volte inferiore rispetto alla 8t |
| TPU 8i Max | Contesti molto lunghi, densità per rack | due chip 8i per package: 2 volte la potenza di calcolo, la SRAM e la larghezza di banda HBM della 8i |
La TPU 8tx si rivolge alle aziende regolamentate e ai governi. La sicurezza opera a livello hardware: dati e pesi del modello restano protetti e isolati durante il calcolo (confidential compute), con una penalizzazione delle prestazioni quasi nulla secondo Google. La stessa macchina permette di affinare un modello su dati privati, distillare un modello di grandi dimensioni o addestrare agenti tramite apprendimento per rinforzo senza spostare i dati sensibili. La TPU 8i Max affronta il muro della memoria (memory wall), quando decine di agenti lavorano su un’intera base di codice o su ore di video.
Anche il software si adegua. Una suite di agenti TPU open source, in anteprima, si integra con Claude Code, Cursor e Google Antigravity per migrare verso le TPU, diagnosticare i colli di bottiglia e ottimizzare i kernel in linguaggio naturale; XLA Serving Engine esegue il serving dei modelli in C++ su TPU, GPU e CPU; TPU Sync riduce di oltre il 90 % la latenza di trasferimento della cache KV e il tempo al primo token; Agent Compute Engine sospende automaticamente le sessioni inattive degli agenti. Cloud Pathways, il runtime di Google DeepMind alla base di Gemini, e la suddivisione dinamica di GKE (GKE dynamic slicing: avvio dei job fino a 5 volte più rapido, ripristino dopo un guasto fino a 4,5 volte più rapido) passano alla disponibilità generale.
Google dichiara di avere quasi 100 clienti TPU, che ora possono distribuirle nei propri data center. Non indica però né una data di disponibilità né un prezzo per TPU 8tx e TPU 8i Max, e i suoi risultati sui benchmark InferenceX e AgentX non sono accompagnati da alcun dato numerico.
🔗 TPU 8i Max e TPU 8tx (blog.google) · Post di Google Cloud · Presentazione di TPU Sync (Google Cloud)
NVIDIA presenta GR00T 2 a CoRL, un modello aperto di azione sul mondo, senza licenza né link per il download
9 novembre — All’apertura della Conference on Robot Learning (CoRL) ad Austin, NVIDIA presenta GR00T 2, che descrive come un modello aperto all’avanguardia di azione sul mondo (open frontier world action model), costruito sulla sua piattaforma Cosmos. Il modello è stato addestrato su dati di robot e di esseri umani, tra cui 100 000 ore di video egocentrici umani pubblicati in open source da NVIDIA, per imparare gesti di manipolazione fine e trasferirli da un corpo robotico a un altro senza dimostrazioni robotiche. Un’API permette agli agenti di concatenarne le competenze e di recuperare dai propri errori.
| Misura annunciata da NVIDIA | Valore annunciato |
|---|---|
| GR00T 2, attività completate senza dimostrazioni specifiche | 40 su 50, almeno una volta |
| GR00T 2, successo medio con 1 dimostrazione per attività | 71 % su 50 attività |
| GR00T 2, successo medio con 5 dimostrazioni per attività | 95 % |
| Isaac Lab 3.0 con Newton, rispetto a Isaac Lab 2.3 con PhysX | fino a 2,5 volte il throughput di addestramento |
| AlphaNIST, policy unica rispetto a policy separate | oltre il 98 % contro l’81 %, circa 39 volte meno tempo GPU |
| EgoHand, download su Hugging Face | oltre 40 000 in due settimane |
NVIDIA colloca GR00T 2 tra i primi tre modelli nelle classifiche RoboCasa365, RoboLab, RoboDojo e MolmoSpaces, con diversi primi posti, senza punteggi numerici. Nexuni lo testa per il trattamento del bucato, Foxconn per la produzione di server, Siemens per la valutazione, e MicroAGI lo utilizza, dopo un post-addestramento tramite apprendimento per rinforzo, per sostituire cavi Ethernet con un braccio robotico.
Sul fronte della simulazione, Isaac Lab 3.0, disponibile dal 21 ottobre, si affida maggiormente al motore fisico open source Newton per gli oggetti deformabili (cavi, tessuti) e le mani articolate. AlphaNIST ne offre un esempio: un’unica policy impara le 20 attività di assemblaggio della NIST Assembly Task Board con un semplice segnale di successo o fallimento. Per la valutazione, NVIDIA pubblica Isaac Lab-Arena 0.4 in anteprima per sviluppatori e due benchmark aperti: DexBench, progettato con RLWRLD (15 attività in quattro scene, dal commercio al settore alberghiero), e VABAR, progettato con UC Berkeley (sei attività industriali). Si aggiungono un workflow Video to Data, che trasforma video umani in dimostrazioni robotiche simulate, ed EgoHand, un modello aperto di ricostruzione 3D delle mani.
Il post presenta GR00T 2 come aperto, ma non fornisce né una licenza, né un link per il download, né una data di disponibilità.
NVIDIA in Corea: NVLink Fusion con Rebellions e SK Telecom, ricette Dynamo e IA fisica
9 novembre — Durante il NVIDIA AI Day Seoul, NVIDIA pubblica una serie di annunci coreani. Il principale è una collaborazione con il progettista di chip Rebellions e l’operatore SK Telecom, sostenuta dal ministero coreano della Scienza e delle TIC: Rebellions collegherà i suoi futuri processori neurali (NPU) Rebel R200 alla piattaforma NVIDIA tramite NVLink Fusion e costruirà i suoi sistemi sull’architettura rack MGX, mentre SK Telecom prevede di distribuirli nel suo data center IA, per i propri modelli come A.X K2 e per i servizi pubblici del progetto governativo AI for All. L’inferenza sarebbe disaggregata: le GPU NVIDIA leggerebbero il prompt (prefill), le NPU Rebellions genererebbero i token. Non vengono indicati né una data né i volumi.
NVIDIA pubblica anche ricette Dynamo per quattro modelli aperti coreani (A.X K2, K-EXAONE 2.0, Solar Open 2 e Motif-3), ottimizzate per le GPU B200, con prestazioni fino a 2 volte superiori fin da subito secondo NVIDIA. LG AI Research apre l’accesso API a K-EXAONE-2.5, addestrato con dataset Nemotron tra cui Nemotron-Personas-Korea (7 milioni di personas), e Hyundai Motor Group esplora NemoClaw e OpenShell. NVIDIA annuncia infine un investimento in Point2 (interconnessioni a radiofrequenza) e investimenti previsti in Motif Technologies, RLWRLD e Upstage, senza specificarne gli importi. Nella stessa serie, Samsung, Kakao Mobility e LG Electronics illustrano i loro progetti di IA fisica con NVIDIA (vedi le Brevi).
🔗 Comunicato di NVIDIA, Rebellions e SK Telecom · Ricette Dynamo per i modelli coreani · Agenti sicuri in Corea · Investimenti nelle startup coreane
Agenti di coding: Claude Code 2.1.321, Vibe CLI 3.1.1, Qwen Code, Copilot CLI, Antigravity CLI, Amp e Delta
Claude Code e Vibe CLI pubblicano le due versioni più ricche di novità della giornata. Qwen Code v0.27.1, Copilot CLI 1.0.108 in versione stabile, Antigravity CLI 1.5.2, i Portals e l’applicazione Windows di Amp e l’editor riscritto di Delta sono riepilogati nelle Brevi, nella sezione Agenti e strumenti di coding.
Claude Code 2.1.321 rende Fable 5.2 il modello Fable predefinito e corregge 74 problemi
9 novembre — Claude Code 2.1.321 accompagna il lancio: Fable 5.2 diventa il modello Fable predefinito (contesto di un milione di token, 8 e 40 dollari per milione di token, lettura della cache a 0,20 dollari). Le scelte salvate per Fable 5.1 passano all’alias fable, subito su Pro e Max, e su Team ed Enterprise quando l’organizzazione lo autorizza; /model claude-fable-5-1 permette di tornare indietro. claude remote-control --settings applica un file di impostazioni a ogni sessione avviata.
Su 118 voci, 74 sono correzioni, tra cui diverse vulnerabilità: i token OAuth MCP potevano essere inviati a un altro host dopo un reindirizzamento, un comando Bash di sola lettura poteva essere eseguito fuori dalla sandbox senza richiesta di conferma, e le regole di rifiuto non si applicavano a un cp o a un mv verso una cartella. In caso di limiti o guasti del servizio rapido, la modalità rapida ripiega prima sulla velocità standard dello stesso modello. Le mod scritte da Claude si attivano senza richiesta di conferma nelle modalità auto e bypass, mentre le regole di rifiuto restano applicate. Non è stata pubblicata alcuna versione 2.1.320, il canale npm stabile resta sulla 2.1.311 e l’SDK Agent segue con TypeScript 0.3.321 e Python 0.2.180.
🔗 Note di rilascio di Claude Code 2.1.321
Vibe CLI 3.1.1 aggiunge quattro eventi hook, una modalità Vim e l’importazione della configurazione di altri agenti
9 novembre — Cinque giorni dopo la 3.1.0, Mistral pubblica Vibe CLI 3.1.1, senza annunci su X. Nonostante il numero di versione correttiva, conta 92 voci: 17 aggiunte, 26 modifiche, 44 correzioni e 5 rimozioni. Gli hook ricevono quattro eventi: pre_agent, prima che il modello legga un messaggio, che permette di bloccarlo, riscriverlo o aggiungervi del contesto; notification, quando Vibe attende un’approvazione o una risposta; session_start e session_end. La skill integrata /vibe:import individua la configurazione di altri agenti di codice e ne importa istruzioni, skill, sottoagenti, comandi, hook, server MCP e permessi.
L’area di input acquisisce modalità Vim e /pr elenca le pull request della sessione, apre il primo controllo CI fallito o scrive un prompt per sbloccare la PR; questo monitoraggio diventa attivo per impostazione predefinita. La versione rimuove /teleport, l’opzione --teleport e /remote-project. Per Mistral Large 4, i livelli di ragionamento passano a Low, Medium e High, quelli ora accettati dall’API, e le skill dei plugin prendono il nome del plugin (my-plugin:review al posto di my_plugin:review), il che richiede di adattare gli agenti personalizzati.
🔗 Note di rilascio di Vibe CLI 3.1.1
I dots di ChatGPT lavorano su più computer locali, scelti per ogni attività
9 novembre — I dots, gli agenti permanenti di ChatGPT lanciati a fine settembre, possono ora appoggiarsi a più computer locali: si collegano più computer allo stesso dot, poi si sceglie quello da usare per un’attività. OpenAI Developers evidenzia alcuni utilizzi per sviluppatori: creare e testare un’applicazione su una macchina dedicata mentre si scrive codice sul proprio portatile, testare una modifica in Xcode su un secondo Mac e ricevere screenshot, riprodurre un bug su una macchina dotata di un SDK più vecchio, oppure far esplorare un’interfaccia senza impegnare lo schermo o il cursore dell’utente.
Secondo la pagina di assistenza, ogni computer si collega dall’applicazione ChatGPT installata su di esso, nella sezione Computers del profilo del dot, e deve restare online, con l’applicazione aperta. Per attività indipendenti, si chiede al dot un thread separato per ogni computer. Lo stato offline non revoca l’accesso, che va rimosso esplicitamente, e questo permesso resta distinto dalla connessione a Codex e da Work Sync. OpenAI non precisa né i piani interessati né le tempistiche.
🔗 Annuncio di @OpenAIDevs · Collega computer e app al tuo dot
OpenAI rimette in vendita la ModRetro Chromatic edizione Codex, con un plugin per creare giochi Game Boy Color
9 novembre — OpenAI Developers rimette in vendita su OpenAI Supply Co., il negozio di OpenAI, la ModRetro Chromatic edizione Codex, una console portatile che esegue giochi Game Boy Color: 200 dollari con una cartuccia programmabile e una custodia. Proposta inizialmente in esclusiva al DevDay, torna con un nuovo look; il negozio annuncia il ritorno in stock il 19 novembre, con spedizioni limitate a Stati Uniti, Canada, Australia, Nuova Zelanda, Giappone, Regno Unito e Unione europea.
La console fa da vetrina al plugin ModRetro Chromatic, pubblicato da ModRetro e installato dal catalogo dei plugin di Codex nell’applicazione desktop ChatGPT. Si basa su GB Studio e fornisce strumenti per sprite e animazioni, una mappa delle collisioni visualizzata accanto allo scenario, un emulatore aperto nel browser integrato di Codex e sequenze di pulsanti eseguite con uno screenshot a ogni passaggio. I più esperti possono scrivere in C con GBDK-2020 o costruire il proprio motore in assembly. L’installazione tramite cavo USB su una cartuccia riscrivibile cancella il gioco presente e può cancellarne i salvataggi, senza una copia di backup.
🔗 Annuncio di @OpenAIDevs · Crea un gioco per console portatile retrò con Codex e ModRetro Chromatic · Chromatic edizione Codex su OpenAI Supply Co.
Google AI Studio crea applicazioni Google Maps Platform a partire da un prompt, senza carta di credito
9 novembre — Google AI Studio permette di creare applicazioni basate su Google Maps Platform direttamente da un prompt. Si descrive la propria idea a Gemini, per esempio un tour 3D interattivo di New York, e AI Studio configura Google Maps Platform e gestisce la chiave API senza reindirizzamenti, prima di mostrare una mappa interattiva nell’anteprima; può anche collegare un progetto Google Cloud esistente. Le API Maps (mappe con stili personalizzati, città 3D fotorealistiche), Places (ricerca locale, schede dei luoghi), Routes (itinerari a tappe) ed Environment (qualità dell’aria, polline) sono accessibili e nella galleria sono disponibili tre esempi da remixare: City Immersive Tour, Pet Grooming Route Optimizer e Store Locator & Near Me Finder.
La prova è gratuita e non richiede una carta di credito, entro le quote della sandbox: 100 chiamate al giorno per API, azzerate ogni 24 ore. Per la produzione, occorre collegare un account di fatturazione Google Cloud, alle tariffe standard di Google Maps Platform.
🔗 Dal prompt all’app: crea con Google Maps in AI Studio (Google Developers) · Annuncio di @GoogleAIStudio
ElevenLabs lancia Campaign Manager per affidare campagne di chiamate in uscita a ElevenAgents
9 novembre — ElevenLabs lancia ElevenAgents Campaign Manager, che affida ai suoi agenti vocali intere campagne di chiamate in uscita. Si forniscono un elenco di contatti e un obiettivo, come un prospect qualificato o un appuntamento confermato: l’agente chiama nelle fasce orarie scelte, mantiene il contesto da una chiamata all’altra, richiama più tardi, prenota l’orario richiesto o si rivolge a un altro numero o a un’altra persona dell’account, poi si ferma non appena l’obiettivo è raggiunto o il contatto lo richiede.
Il modulo disciplina le chiamate: limite di tentativi (con un limite separato per le richiamate), liste di opposizione aggiornate non appena un contatto chiede di interrompere le chiamate, informazioni obbligatorie nell’introduzione dell’agente. Ogni contatto ha la propria cronologia delle decisioni, i casi incerti finiscono in una coda da gestire e tutto è esportabile in CSV. Testato in beta nei settori assicurativo, bancario e dell’e-commerce, ha portato The AA Ireland dal 50–60 % di prospect gestiti al giorno al 100 %, secondo il suo CTO Jeremy O’Sullivan. Campaign Manager è disponibile da subito, per telefono e su WhatsApp, mentre e-mail e SMS sono annunciati a breve, senza una tariffa dedicata.
🔗 ElevenAgents Campaign Manager (ElevenLabs) · Annuncio di @ElevenLabs
Dati e ricerca aperti: dataset sintetici giapponesi di NVIDIA e pruning HOPE di Amazon
Due pubblicazioni di oggi sul blog di Hugging Face, una sui dati di addestramento, l’altra sulla memoria occupata dai modelli a esperti.
NVIDIA ed Elith pubblicano due dataset sintetici giapponesi, per la finanza e la protezione dei dati
9 novembre — NVIDIA pubblica su Hugging Face due dataset sintetici giapponesi pensati per essere usati insieme. Nemotron-Personas-Finance-Japan, realizzato con l’azienda Elith, estende Nemotron-Personas-Japan alla finanza: 9 milioni di personas in giapponese (1 milione di record da 50 campi), con composizione del nucleo familiare, patrimonio e comportamenti finanziari basati sulle statistiche ufficiali, per circa 1,5 miliardi di token con licenza CC BY 4.0. Secondo gli autori, è il primo dataset aperto di personas di queste dimensioni che incrocia statistiche pubbliche giapponesi e dati sulle finanze delle famiglie.
Nemotron-PII-Japan fornisce 100 000 documenti professionali giapponesi sintetici in otto ambiti (sanità, finanza, amministrazione, diritto, tra gli altri), con 56 tipi di dati personali annotati, tra cui il numero My Number, per addestrare modelli che rilevano e mascherano questi dati. NVIDIA usa il dataset per il fine-tuning di un modello GLiNER su 95 000 documenti. L’idea complessiva: simulare clienti con il primo dataset, poi verificare con il secondo che una pipeline di elaborazione protegga i loro dati.
🔗 Nemotron-Personas-Finance-Japan (blog Hugging Face) · Nemotron-PII-Japan (blog Hugging Face)
Amazon presenta HOPE, un pruning degli esperti dei MoE che tiene conto degli esperti che lavorano insieme
9 novembre — In un post firmato da Alex M Tseng, un team di Amazon presenta HOPE (Higher-Order Pruning of Experts), un metodo per rimuovere gli esperti meno utili da un modello mixture-of-experts (MoE) senza riaddestramento. Un MoE mantiene tutti i suoi esperti in memoria, anche se ne usa solo alcuni per ogni token: in Qwen3.5-122B, rappresentano il 95 % dei circa 250 Go del modello. I metodi attuali valutano ogni esperto isolatamente; HOPE misura anche le interazioni tra coppie di esperti, che si attivano spesso insieme.
Testato su Qwen3.5-122B, Qwen3.5-35B e GLM-4.5-Air a confronto con REAP, MAN, EAN e Frequency, con una quota di esperti rimossi dal 10 al 50 %, il metodo ottiene il miglior posizionamento medio (2,07 su 5 metodi) secondo Amazon, e il suo vantaggio cresce con il tasso di pruning: al 50 %, fino a +6,1 % nelle attività di coding agentico rispetto al miglior metodo concorrente. È compatibile con la quantizzazione, con un costo aggiuntivo di uno o due secondi per layer.
🔗 Post di Amazon su HOPE (blog Hugging Face)
Brevi
Agenti e strumenti di coding
- Qwen Code v0.27.1 — Versione stabile del 9 novembre, due giorni dopo la v0.27.0, senza modifiche incompatibili: 122 voci, tra cui 26 funzionalità e 65 correzioni. Il Managed Agent acquisisce una memoria personale opzionale basata su Mem0, oltre all’archiviazione e all’installazione self-service dei server MCP; Desktop v0.27.1 e l’SDK TypeScript v0.1.31 seguono lo stesso giorno. 🔗 fonte
- Copilot CLI 1.0.108 in versione stabile — Rilascio stabile il 9 novembre, senza novità rispetto alle versioni preliminari 1.0.108-0 e 1.0.108-1 trattate il 7 novembre: comandi
/index, indicizzazione tgrep condivisa per impostazione predefinita, impostazione della sandbox per Windows e 72 correzioni. 🔗 fonte - Antigravity CLI 1.5.2 — Versione datata 6 novembre nel changelog:
--dangerously-skip-permissionsnon approva più automaticamente i comandi protetti, né gli accessi al di fuori dello spazio di lavoro quando un amministratore Gemini Enterprise richiede una revisione; i plugin con nomi pericolosi vengono rifiutati e le skill dei plugin cloud arrivano nelle sessioni--remote-agent. 🔗 fonte - Portals di Amp sui runner — I Portals, finora riservati agli orb, funzionano sulle macchine dell’utente: un server di sviluppo avviato dall’agente si apre dalla scheda Portal del thread, accessibile secondo la documentazione in un browser e nelle applicazioni per iPhone e iPad. Attivazione tramite Allow Portals o
amp --no-tui --remote-control-portals; i portal sono privati salvo in caso di runner condiviso e, secondo la documentazione, non sono mai pubblici. 🔗 fonte · 🔗 documentazione - Amp per Windows — Il 7 novembre, Quinn Slack, CEO di Amp, rende disponibile un’applicazione Windows sperimentale, con un installer che si aggiorna automaticamente; i bug segnalati vengono ricompensati con crediti e viene promessa una versione solida entro circa tre o quattro giorni. La pagina di download elenca anche un’applicazione Linux sperimentale. 🔗 fonte
- L’editor dei thread di Delta — Agus Zubiaga racconta sul blog di Delta la riscrittura dell’editor per trasformare i thread in un documento condiviso e annotabile anziché in una chat, abbandonando l’architettura dell’editor di Zed; Zed riassume che è stato necessario ripartire da zero sei volte. Articolo di ingegneria, senza una nuova versione. 🔗 fonte · 🔗 tweet di Zed
- v0 e Fable 5.2 — Lo strumento di Vercel per la creazione di applicazioni rende disponibile Claude Fable 5.2 la sera del lancio, con un punto di accesso diretto
v0.app/?fable52, senza precisare piani o prezzi. 🔗 fonte
Piattaforme, API e aziende
- Scegliere il proprio modello Claude — In una guida pubblicata su claude.dev, Addy Osmani consiglia di partire da Opus 5.5 con effort medium, passare a Sonnet 5.5 o Haiku 5.5 per il lavoro ben definito o su larga scala e salire a Fable 5.2 per i progetti più difficili, provando prima un livello di effort superiore. Su SWE-bench Pro, Opus 5.5 in low, ripetendo in high le attività fallite, raggiunge circa il 97 % a 0,17 dollari per attività, contro il 95,3 % a 0,29 dollari eseguendo tutto in high. 🔗 fonte
- Funzioni asincrone nell’API Agents — Michael Luo, del team API Agents di OpenAI, presenta le funzioni asincrone: l’agente continua a lavorare dopo aver chiamato uno strumento, senza attenderne il risultato, per avviare in anticipo una ricerca lenta o gestire le parti indipendenti di una richiesta. Ricorda anche la cache dei prompt di 12 ore, già trattata il 20 ottobre. 🔗 fonte
- SDK di OpenAI — openai-python 3.48.0 aggiunge opzioni di streaming per le sessioni degli agenti e gli SDK Python e Node (7.54.0) riconoscono gpt-6-rosalind nelle Responses in beta; Codex CLI non ha pubblicato alcuna versione stabile dalla 0.167.0 del 6 novembre, solo versioni preliminari 0.169.0 senza note. 🔗 fonte
- ChatGPT Enterprise su AWS Marketplace — ChatGPT Enterprise (ChatGPT, ChatGPT Work, Codex e i dot) si può ora acquistare tramite AWS Marketplace, con la fatturazione AWS esistente e spese conteggiabili ai fini degli impegni di spesa AWS; secondo OpenAI, le funzioni sono le stesse dell’acquisto diretto, senza prezzi annunciati, dopo Google Cloud e Oracle a ottobre. 🔗 fonte
- Kuken Industries — Il produttore giapponese di torri di raffreddamento ritrova il disegno di un pezzo di ricambio in 4,5 minuti anziché in quasi un’ora, con uno strumento costruito sull’API di OpenAI dalla startup Recursive; prevede circa il 90 % di ore di ricerca in meno nell’arco di un anno. 🔗 fonte
- Guida di Perplexity sulla memoria — Perplexity spiega la memoria degli assistenti di IA e descrive la propria: valida per tutti i modelli, specifica per ciascun Project, mostrata tra le fonti quando viene utilizzata ed eliminabile; sugli account consumer, il suo contenuto può servire a migliorare i modelli, a meno che non si disattivi l’impostazione AI Data Retention; mai sugli account Enterprise. 🔗 fonte
Sicurezza
- Secret scanning nei log di Actions — Il secret scanning di GitHub analizza ora i log dei workflow GitHub Actions al termine dell’esecuzione, in anteprima pubblica su GitHub Enterprise Cloud con Secret Protection o Advanced Security; la policy aziendale è disattivata per impostazione predefinita, senza analisi dei vecchi log né notifiche durante l’anteprima. 🔗 fonte
- Esame x402 di Fizzl — Frits Zwager trasforma x402 Agent Safety Bench in un esame aperto a qualsiasi agente, sul sito di Fizzl: 19 attività di acquisto presso venditori simulati, di cui 14 disonesti, pagate in USDC di test su Base Sepolia. 🔗 fonte
Modelli aperti e community
- Harness adapters — Seguito del progetto harness-hub presentato il 6 novembre: l’addestramento dei LoRA è terminato per LFM2.5-24B e LFM3 di Liquid AI e per Twil-8B di webAI, negli harness pi, hermes e opencode; il team annuncia fino al 43 % di efficienza nell’uso degli strumenti e al 15 % di accuratezza in più per LFM3, e fino al 37 % di efficienza in più per Twil-8B. 🔗 fonte
- Modificare i pesi per la medicina — Maziyar Panahi (OpenMed) migliora piccoli modelli Qwen negli esami medici modificandone i pesi senza addestramento: Qwen3.5-2B passa dal 52,0 al 70,5 % su MedQA, senza cambiamenti significativi in matematica; il miglioramento dipende in parte dal formato della risposta, precisa l’articolo. 🔗 fonte
- Qwen3.8-27B sottoposto a fine-tuning su un Mac Studio — Roman Melnyk trasforma Qwen3.8-27B in un assistente per Kafka, Strimzi, Kubernetes e Argo CD, interamente su un Mac Studio M3 Ultra da 512 GB; la versione a 4 bit occupa circa 15 GB e l’autore giudica questo primo risultato poco convincente. 🔗 fonte
- Step 5 su Together AI — L’8 novembre, Together AI afferma di aver più che triplicato il throughput di Step 5 di StepFun ottimizzando il proprio stack di serving con agenti (routing MoE, scheduling, kernel, decodifica speculativa, attenzione sparsa), senza fornire cifre assolute. 🔗 fonte
- Galleria 3D sull’Hub — Secondo Caleb Fahlgren, ripreso da Hugging Face, i dataset che contengono file .glb, .ply, .stl o splat vengono visualizzati automaticamente in una galleria 3D; ne beneficiano oltre 350 dataset pubblici, dopo il visualizzatore OpenUSD di ottobre. 🔗 fonte
- Hackathon Hugging Face e Qai a Doha — Aritra Roy Gosthipaty e quattro coautori di Hugging Face ripercorrono questo hackathon dal 5 al 7 novembre, presentato come il primo di Hugging Face nel Golfo: oltre 500 candidature, 150 partecipanti, 40 squadre, 15 finalisti e 3 vincitori. 🔗 fonte
- Applicazione mobile di Sakana AI — Sakana AI recluta fino al 15 novembre tester per la beta della sua prima applicazione mobile, provvisoriamente chiamata Sakana AI App, senza descriverne le funzioni. 🔗 fonte
Robotica, 3D e video
- IA fisica in Corea — Nella serie coreana di NVIDIA, Samsung accelera i calcoli per la progettazione di semiconduttori (circa 1 600 volte con PhysicsNeMo, da 18 ore a 41 secondi), Kakao Mobility punta alla guida autonoma di livello 4 su NVIDIA Hyperion con veicoli Kia e il robot CLOiD di LG, controllato da Isaac GR00T, lavora in una fabbrica reale; nessuna indicazione su tempistiche o volumi. 🔗 fonte
- Umanoide che monta mobili IKEA — L’8 novembre, Harpreet Sahota converte per FiftyOne un estratto del 2026 Humanoid IKEA Assembly Challenge: 6 episodi e 30,7 minuti di un umanoide con 35 motori e sette telecamere, con la coppia dei motori sincronizzata con le telecamere dei polsi. 🔗 fonte
- SAM3D-Part e BranchTokens di Meshy — SAM3D-Part estrae con un clic una parte completa di un oggetto 3D esistente, con una distanza di Chamfer inferiore di circa il 72 % rispetto a OmniPart su 500 oggetti (articolo accettato a SIGGRAPH Asia 2026, pesi pubblicati); BranchTokens, sviluppato con Purdue, riduce del 16,9 % l’errore di generazione degli scheletri 3D rispetto ad Auto-Connect. 🔗 fonte · 🔗 BranchTokens
- Sightline di Runway — Nuova app di App Studio: crea un panorama a 360 di un luogo, consente di inquadrarvi scene da ogni angolazione con una scenografia coerente e lo esporta in 3D per usarlo come ambiente; consuma crediti Runway, senza costi o modelli precisati. 🔗 fonte
Cosa significa
Un modello di frontiera viene ormai misurato il giorno stesso da chi lo integra, sui propri banchi di prova. Cursor, Cognition e Perplexity pubblicano i propri risultati di Fable 5.2 nelle ore successive al lancio, ciascuno sul proprio benchmark interno, e Claude Code ne fa subito il proprio modello Fable predefinito. Queste misurazioni non dicono tutte la stessa cosa: su CursorBench, l’effort Extra High ottiene risultati peggiori di High a un costo maggiore, e su WANDR il record costa circa 1,8 volte il costo per attività di Gemini 4 Argon. Il consiglio di Cursor, ripartire dall’impostazione predefinita, vale anche al di fuori del suo strumento: un nuovo modello impone di ricalibrare l’effort.
Il costo per attività diventa l’unità di confronto. Anthropic abbassa del 20 % il prezzo di Fable e mette in evidenza il punteggio di Opus 5.5 raggiunto a circa metà prezzo; Meta colloca Muse Ember al livello di Claude Haiku 5.5 a circa un terzo del costo per attività, secondo i propri dati; Cursor, Devin e Perplexity mostrano tutti un costo per attività accanto al punteggio. Nell’infrastruttura alla base dei modelli, Google moltiplica i sistemi TPU per l’inferenza e Amazon cerca di ridurre l’occupazione di memoria dei MoE con HOPE. I TPU 8tx e 8i Max arrivano però senza date né prezzi, il che impedisce ancora di confrontarli.
Le dimostrazioni cambiano scala: 1 000 agenti per Fermat, fino a 300 per squadra su MIPLIB, oltre 1 000 sottoagenti per un prototipo di sistema operativo. Anthropic accompagna questi numeri con misure di sicurezza quantificate: un classificatore su ciascuna delle oltre un milione di chiamate agli strumenti dell’esperimento Fermat, evasioni dalla sandbox ridotte al 3,1 % e Mythos 5.2 riservato ai programmi di verifica nella cybersicurezza e nella biologia. Il fatto che entrambi i modelli sospettino più spesso di essere sottoposti a valutazione rende però queste misurazioni di sicurezza più delicate da interpretare.
Nella robotica, l’apertura resta da confermare. NVIDIA definisce GR00T 2 un modello aperto e pubblica due banchi di prova aperti, DexBench e VABAR, ma il suo articolo non fornisce né una licenza né un link per il download. In Corea, NVIDIA costruisce un ecosistema di IA sovrana in cui le sue GPU convivono con le NPU di Rebellions tramite NVLink Fusion: la piattaforma si apre ai chip di altri progettisti restando al centro dell’inferenza.
Fonti
- Claude Fable 5.2 e Claude Mythos 5.2 (Anthropic)
- Annuncio di Fable 5.2 e Mythos 5.2 (@claudeai)
- Note di rilascio di Claude Platform
- Thread di @ClaudeDevs su Fable 5.2
- Offerte per il lancio di Claude Fable 5.2 (centro assistenza Claude)
- Claude può progettare prototipi elettronici dall’inizio alla fine (Anthropic)
- Ampliare in sicurezza i team multiagente con Claude Fable 5.2 (claude.dev)
- Thread di dimostrazioni di @claudeai
- MIPLIB nel thread di @claudeai
- Fable 5.2 in Cursor (@cursor_ai)
- Classifica CursorBench 4.0 (Cursor)
- Claude Fable 5.2 è ora disponibile in Devin (Cognition)
- Fable 5.2 in Devin (@cognition)
- Fable 5.2 in Perplexity (@perplexity_ai)
- Muse Ember (blog di ricerca di Meta)
- Annuncio di Muse Ember (@AIatMeta)
- Muse Ember nel Vals Index (@ValsAI)
- TPU 8i Max e TPU 8tx (blog.google)
- TPU 8tx e TPU 8i Max (blog Google Cloud)
- Presentazione di TPU Sync (blog Google Cloud)
- GR00T 2 e la simulazione robotica a CoRL (NVIDIA)
- NVIDIA, Rebellions e SK Telecom (NVIDIA Newsroom)
- Ricette Dynamo per i modelli aperti coreani (NVIDIA)
- Agenti sicuri in Corea (NVIDIA)
- Investimenti nelle startup coreane (NVIDIA)
- Note di rilascio di Claude Code 2.1.321
- Note di rilascio di Vibe CLI 3.1.1
- Più computer per un dot (@OpenAIDevs)
- Collega computer e app al tuo dot (ChatGPT)
- ModRetro Chromatic edizione Codex (@OpenAIDevs)
- Crea un gioco per console portatile retrò con Codex e ModRetro Chromatic (OpenAI Developers)
- Chromatic edizione Codex (OpenAI Supply Co.)
- Dal prompt all’app: sviluppare con Google Maps in AI Studio (Google Developers)
- Google Maps Platform in AI Studio (@GoogleAIStudio)
- ElevenAgents Campaign Manager (ElevenLabs)
- Campaign Manager (@ElevenLabs)
- Nemotron-Personas-Finance-Japan (blog Hugging Face, NVIDIA)
- Nemotron-PII-Japan (blog Hugging Face, NVIDIA)
- HOPE, pruning degli esperti dei MoE (blog Hugging Face, Amazon)
- Qwen Code v0.27.1
- Copilot CLI 1.0.108
- Changelog di Antigravity
- Portals sul tuo runner (Amp)
- Amp per Windows (@sqs)
- Documentazione dei runner di Amp
- Costruire una UI per i thread in modalità difficile (Delta)
- Il nuovo editor di Delta (@zeddotdev)
- Fable 5.2 in v0 (@v0)
- Con quale modello Claude sviluppare? (claude.dev)
- Funzioni asincrone dell’API Agents (@AzianMike)
- openai-python 3.48.0
- ChatGPT Enterprise su AWS Marketplace (OpenAI)
- Kuken Industries (OpenAI)
- Memoria dell’IA (Perplexity)
- Secret scanning nei log dei workflow Actions (GitHub Changelog)
- Esame x402 di Fizzl (blog Hugging Face)
- Harness adapters (@yb2698)
- Weight-space programming in medicina (blog Hugging Face, OpenMed)
- Assistente Kafka su Mac Studio (blog Hugging Face)
- Step 5 su Together AI (@togethercompute)
- Galleria 3D sull’Hub (@calebfahlgren)
- Hackathon Hugging Face e Qai (blog Hugging Face)
- Beta dell’applicazione di Sakana AI (@SakanaAILabs)
- IA fisica in Corea (NVIDIA)
- Humanoid IKEA Assembly Challenge in FiftyOne (blog Hugging Face)
- SAM3D-Part (blog Hugging Face, Meshy)
- BranchTokens (blog Hugging Face, Meshy)
- Sightline (@runwayml)