ai-powered-markdown-translatorمقال مترجم من الفرنسية إلى العربية باستخدام gpt-6.1-sol.
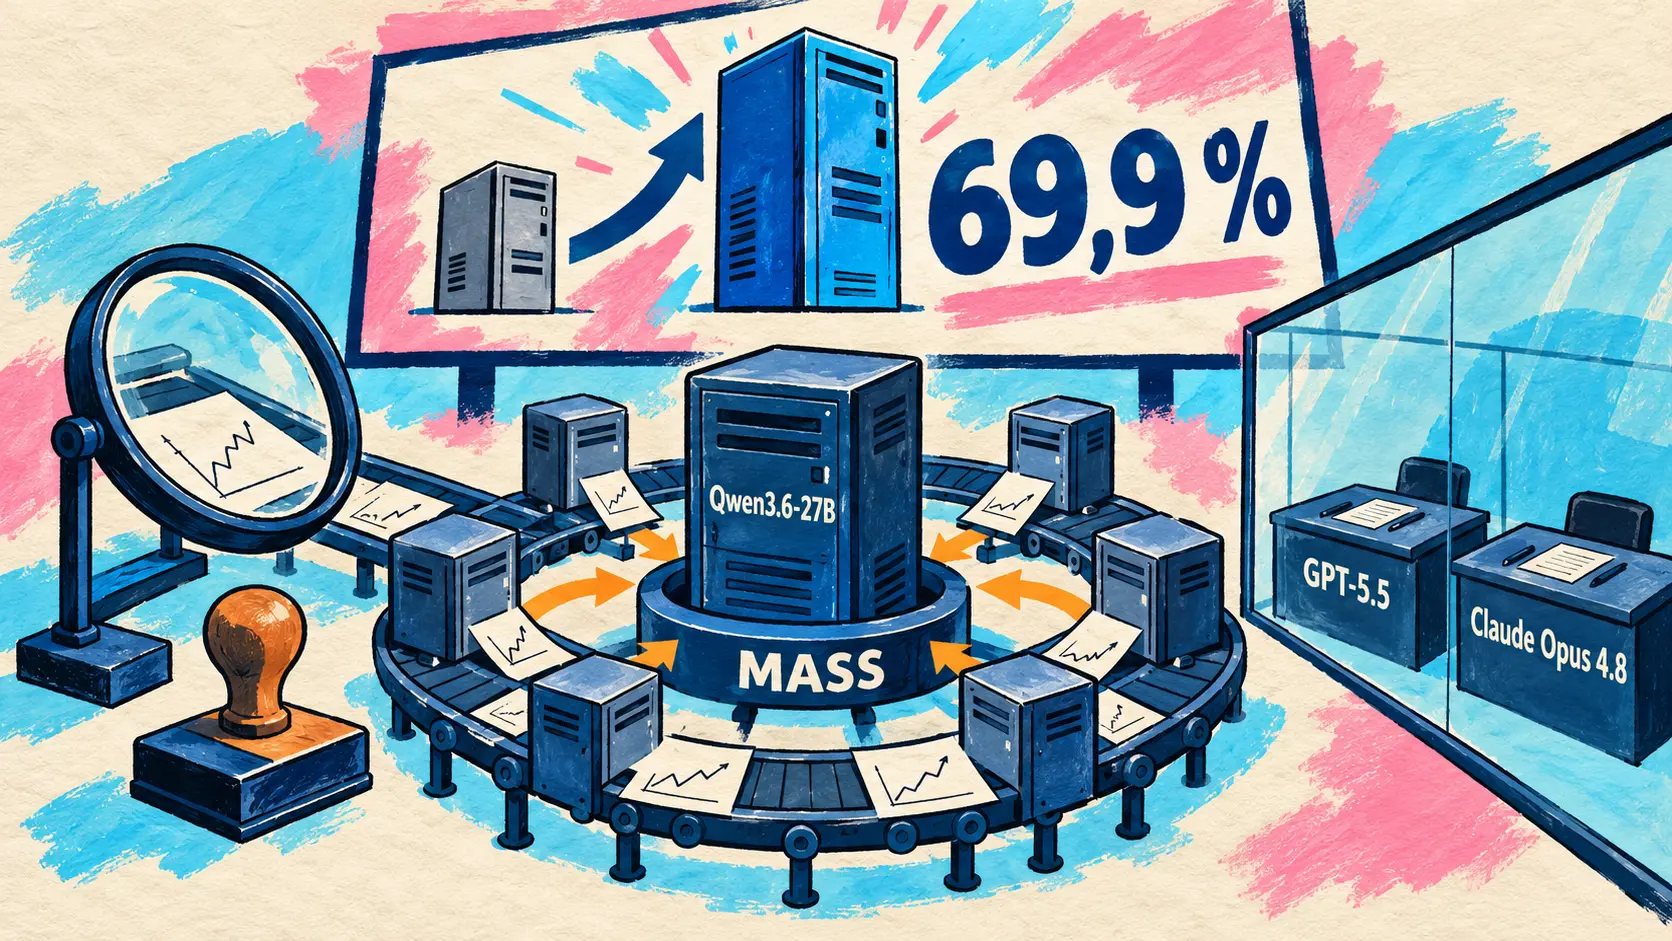
تقدّم Sakana AI وباحثون من UC Berkeley طريقة MASS، التي يُضبط فيها Qwen3.6-27B على أفضل عمليات التنفيذ التي ينفّذها فريق وكلائه: بعد جولتين، يتفوّق على نسخته الأساسية في 69,9 % من المقارنات على مهام مستبعدة من التدريب. وفي الأخبار الموجزة، تطلق FINAL-Bench مسابقة Open Quantum Challenge للمحاكاة الكمومية وتصحيح الأخطاء باستخدام وحدة GPU واحدة، ويصبح Qwen Code v0.25.1 إصدارًا مستقرًا.
MASS: تعمل Sakana AI وUC Berkeley على تحسين Qwen3.6-27B بالاستفادة من عمل فريق وكلائه
11 أكتوبر — تقدّم Sakana AI وUC Berkeley طريقة MASS للتحسين الذاتي التكراري: يحلّ Qwen3.6-27B فيها مهام بحثية ضمن فريق من الوكلاء الفرعيين، ويعيد صياغة سير عمل الفريق، ويقيّم النتائج بنفسه، ثم يُضبط باستخدام LoRA على أفضل عمليات التنفيذ التي أنجزها. ويقيس حكمان خارجيان، GPT-5.5 وClaude Opus 4.8، التقدّم المحرز.
| المقياس المُبلّغ عنه | القيمة المنشورة |
|---|---|
| الانتصارات أمام النموذج الأساسي بعد جولتين، في مهام مستبعدة من التدريب | 69,9 % |
| النتيجة لكل رمز إخراج، في أربع مجموعات اختبارات بحثية | من 1,2 إلى 1,6 مرة مقارنة بالنموذج الأساسي |
| المقياس نفسه، في Terminal-Bench 2.0 وSWE-bench Verified | 0,96 و0,94 مرة مقارنة بالنموذج الأساسي |
يرى المؤلفون أنفسهم أن التحسّن متفاوت بين مجموعات الاختبارات، ويعتزمون معالجة ذلك بإضافة مهام في هندسة البرمجيات. نُشرت الشيفرة دون ترخيص معلن، والمقال متاح على arXiv منذ 8 أكتوبر.
🔗 تدوينة MASS · مقال arXiv · الشيفرة على GitHub
أخبار موجزة
- Open Quantum Challenge — تفتح FINAL-Bench (VIDRAFT) على Hugging Face موسمين يمكن خوضهما باستخدام وحدة GPU واحدة، دون حاسوب كمومي: تقدير طاقة الحالة الأساسية لأنظمة Fermi-Hubbard حتى 28 فبراير 2027، وتصميم مُفكّك ترميز لتصحيح الأخطاء (QEC) حتى 31 مارس 2027، مع 1 000 دولار لكل موسم. 🔗 المصدر · 🔗 مساحة المسابقة
- Qwen Code v0.25.1 — يجمع الإصدار المستقر الإصدارات التمهيدية الثلاثة التي عُرضت هنا منذ 6 أكتوبر، ولا يضيف سوى 17 بندًا، منها زر للإرسال الفوري (إرسال الآن) للرسائل الموضوعة في قائمة الانتظار في Web Shell. تتضمن ملاحظات الإصدار إجمالًا 57 ميزة و85 إصلاحًا منذ v0.25.0، دون أي تغيير معروف يكسر التوافق. 🔗 المصدر
ماذا يعني ذلك
تنطلق MASS من ملاحظة مفادها أنه في مهمة بحثية مفتوحة، لا توجد قاعدة آلية تحدّد ما إذا كانت الإجابة جيدة، وقد يصبح النموذج نفسه أكثر المشرفين المتاحين كفاءة. وتسلّط Sakana AI الضوء على التحدّي الأمني المصاحب لذلك: عندما يكون النموذج هو مُقيِّم نفسه، قد تجعل نقاط العمى المشتركة الأخطاء تبدو وكأنها تقدّم، ثم تعزّزها أثناء التدريب. ولقياس التقدّم دون التأثير في الحلقة، يعتمد البروتوكول على حكّام خارجيين لا تُنقل أحكامهم إلى MASS؛ وفي المقارنة معهم، ترتفع نسبة اتفاق المُقيِّم معهم من 73 % للنموذج الأساسي إلى 93 % بعد الجولة الثانية.
تكشف التجربة أيضًا شيئًا عن بيانات الوكلاء. وفقًا للمؤلفين، تتيح مسارات عمل الفريق تعلّمًا أفضل من مسارات وكيل منفرد: يفوز نموذج مُدرَّب على الأولى في 68,3 % من مقارناته مع النموذج الأساسي باستخدام 28,8 مليون رمز خاضع للإشراف، مقابل 64,0 % باستخدام 42 مليون رمز لنموذج مُدرَّب على الثانية. وتُجرى التجربة في Qwen Code، وكيل البرمجة الذي يصبح إصداره v0.25.1 مستقرًا في اليوم نفسه: تؤدي أداة للمطوّرين هنا دور منضدة مختبر للبحث.
تتناول Open Quantum Challenge المشكلة من الطرف الآخر. يحصل كل تقديم فيها على درجة محسوبة آليًا بمقارنته بإجابة مرجعية ثابتة، وقد صُمّم دليل المشاركة ليُعهد به إلى وكيل برمجة مثل Codex أو Claude Code. عندما تكون المهمة قابلة للتحقّق، تكفي درجة محسوبة للمفاضلة بين المشاركين؛ وعندما لا تكون كذلك، تجعل MASS النموذج حكمًا على نفسه، تحت نظر حكّام خارجيين.