ai-powered-markdown-translatorgpt-6.1-solでフランス語から日本語に翻訳された記事。
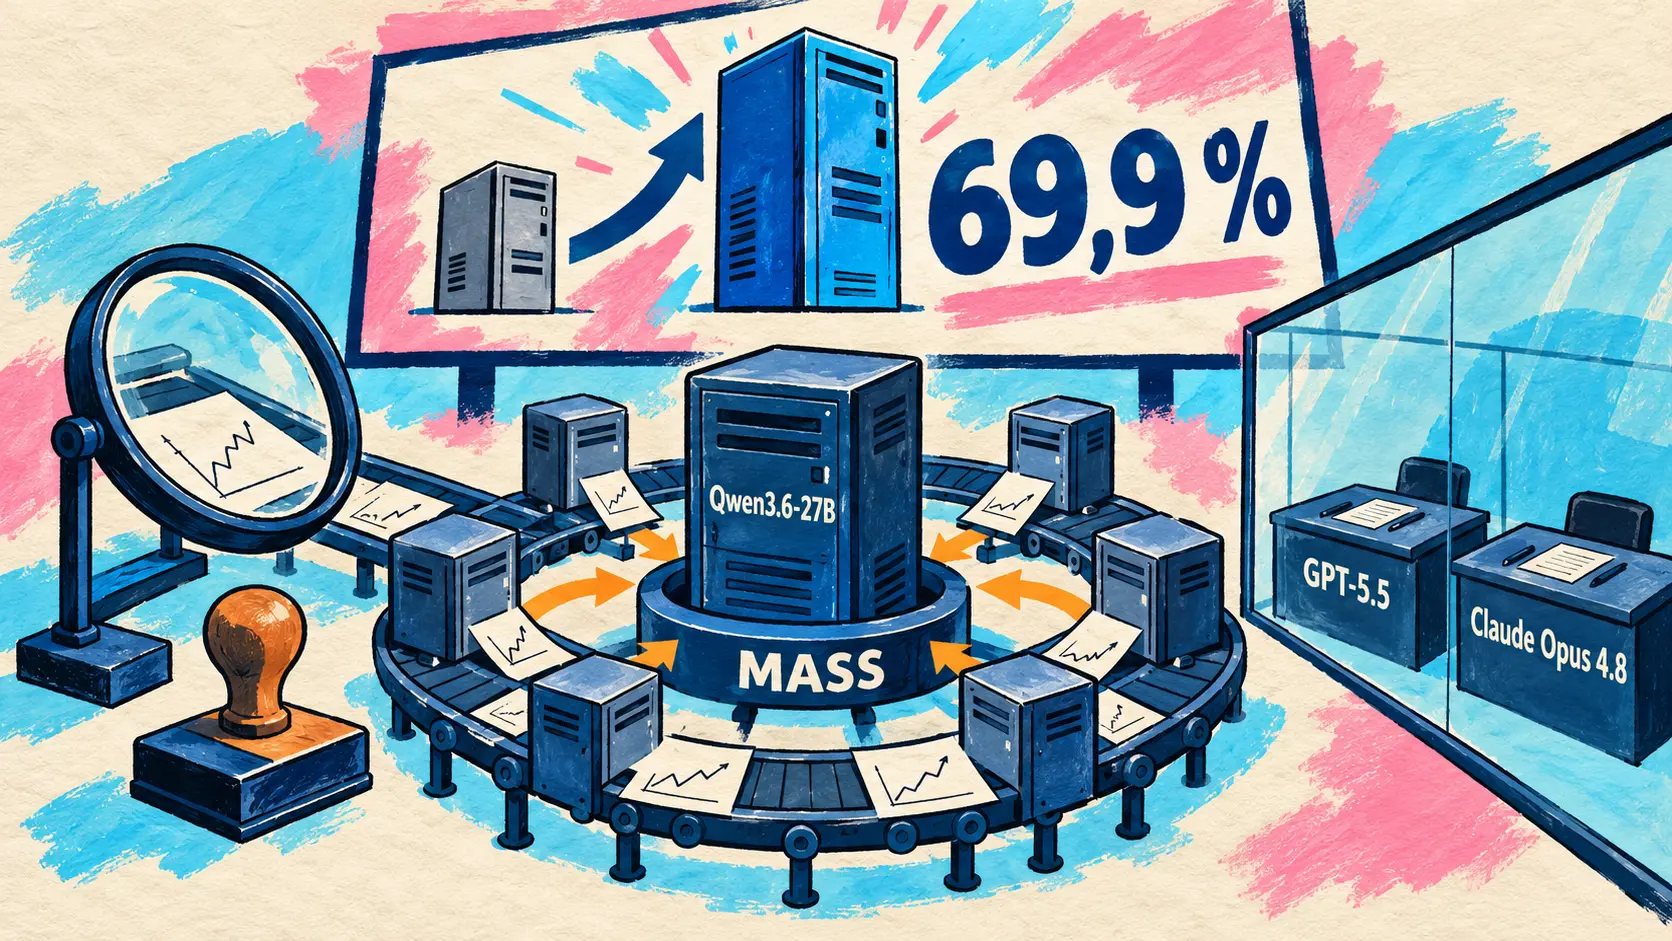
Sakana AIとUC Berkeleyの研究者がMASSを発表した。Qwen3.6-27Bが自身のエージェントチームによる最良の実行結果を用いて学習を進める手法で、二回のラウンド後には、学習に使わなかった課題で基準モデルとの比較の69,9 %に勝利した。短報では、FINAL-Benchが単一のGPUで取り組める量子シミュレーションと誤り訂正のコンテスト、Open Quantum Challengeを開始し、Qwen Code v0.25.1が安定版となった。
MASS:Sakana AIとUC BerkeleyがQwen3.6-27B自身のエージェントチームの作業を通じて性能を向上
10月11日 — Sakana AIとUC Berkeleyが、再帰的な自己改善手法MASSを発表した。Qwen3.6-27Bはサブエージェントのチームで研究課題を解き、チームのワークフローを書き直し、結果を自ら評価したうえで、最良の実行結果を用いてLoRAで学習する。外部の二つの評価モデル、GPT-5.5とClaude Opus 4.8が性能向上を測定する。
| 報告された指標 | 公表値 |
|---|---|
| 二回のラウンド後の基準モデルに対する勝率、学習から除外した課題 | 69,9 % |
| 出力トークン当たりのスコア、四つの研究ベンチマーク | 基準モデルの1,2~1,6倍 |
| 同じ指標、Terminal-Bench 2.0とSWE-bench Verified | 基準モデルの0,96倍と0,94倍 |
著者らも改善幅はベンチマークによってばらつきがあると評価しており、ソフトウェア工学の課題を追加して是正することを考えている。コードはライセンスの明記がないまま公開されており、論文は10月8日からarXivで公開されている。
🔗 MASSの紹介記事 · arXivの論文 · GitHubのコード
短報
- Open Quantum Challenge — FINAL-Bench(VIDRAFT)がHugging Faceで、量子コンピューターを使わず、単一のGPUで取り組める二つのシーズンを開始した。Fermi-Hubbard系の基底状態エネルギーの推定は2027年2月28日まで、誤り訂正(QEC)デコーダーの設計は2027年3月31日までで、各シーズンの賞金は1 000ドル。🔗 情報源 · 🔗 コンテストのスペース
- Qwen Code v0.25.1 — 安定版は10月6日以降にここで紹介した三つのプレビュー版をまとめたもので、追加項目は17件のみ。その中には、Web Shellで待機列に入っているメッセージをすぐに送信するボタン(今すぐ送信)が含まれる。リリースノートでは、v0.25.0以降の追加機能が計57件、修正が85件で、既知の破壊的変更はない。🔗 情報源
これが意味すること
MASSは、自由度の高い研究課題では回答の良し悪しを自動判定するルールがなく、モデル自身が利用可能な中で最も有能な監督役になり得る、という認識から出発している。Sakana AIは、それに伴う安全性の問題を強調する。モデルが自らを評価すると、共通の盲点によって誤りが進歩と見なされ、学習でさらに強化されるおそれがある。改善ループに影響を与えずに進歩を測るため、この実験手順では外部の評価モデルに判断を委ね、その判定結果をMASSには渡さない。外部評価との一致率は、基準モデルの73 %から、二回目のラウンド後には93 %に上昇した。
この実験は、エージェントのデータについても示唆を与えている。著者らによると、チームの作業軌跡は単独エージェントの作業軌跡よりも効果的な学習データになる。前者で学習したモデルは、教師あり学習に用いたトークン数が2,880万で、基準モデルとの比較の68,3 %に勝利した。一方、後者で学習したモデルは4,200万トークンを用いて64,0 %だった。実験は、同じ日にv0.25.1が安定版となったコーディングエージェントQwen Code上で動作している。ここでは開発者向けのツールが研究の実験台となっている。
Open Quantum Challengeは、この問題に別の側面から取り組んでいる。各提出物は固定された参照解答に照らして自動採点され、参加ガイドはCodexやClaude Codeのようなコーディングエージェントに任せられるよう設計されている。課題を検証できる場合は、計算された点数だけで参加者の優劣を決められる。検証できない場合、MASSでは外部の評価モデルが見守る中、モデル自身が評価役となる。