ai-powered-markdown-translatorgpt-6.1-sol로 프랑스어에서 한국어로 번역된 기사.
Sakana AI와 UC Berkeley 연구진이 자체 에이전트 팀의 최고 실행 기록으로 Qwen3.6-27B를 미세 조정하는 방법인 MASS를 공개했다. 두 차례의 반복을 거친 뒤, 학습에서 제외한 과제의 비교 평가에서 기본 버전을 상대로 69,9 %의 승률을 기록했다. 단신으로는 FINAL-Bench가 GPU 하나로 양자 시뮬레이션과 오류 정정을 수행하는 경진대회인 Open Quantum Challenge를 시작했고, Qwen Code v0.25.1이 안정 버전으로 출시됐다.
MASS: Sakana AI와 UC Berkeley, 자체 에이전트 팀의 작업으로 Qwen3.6-27B 개선
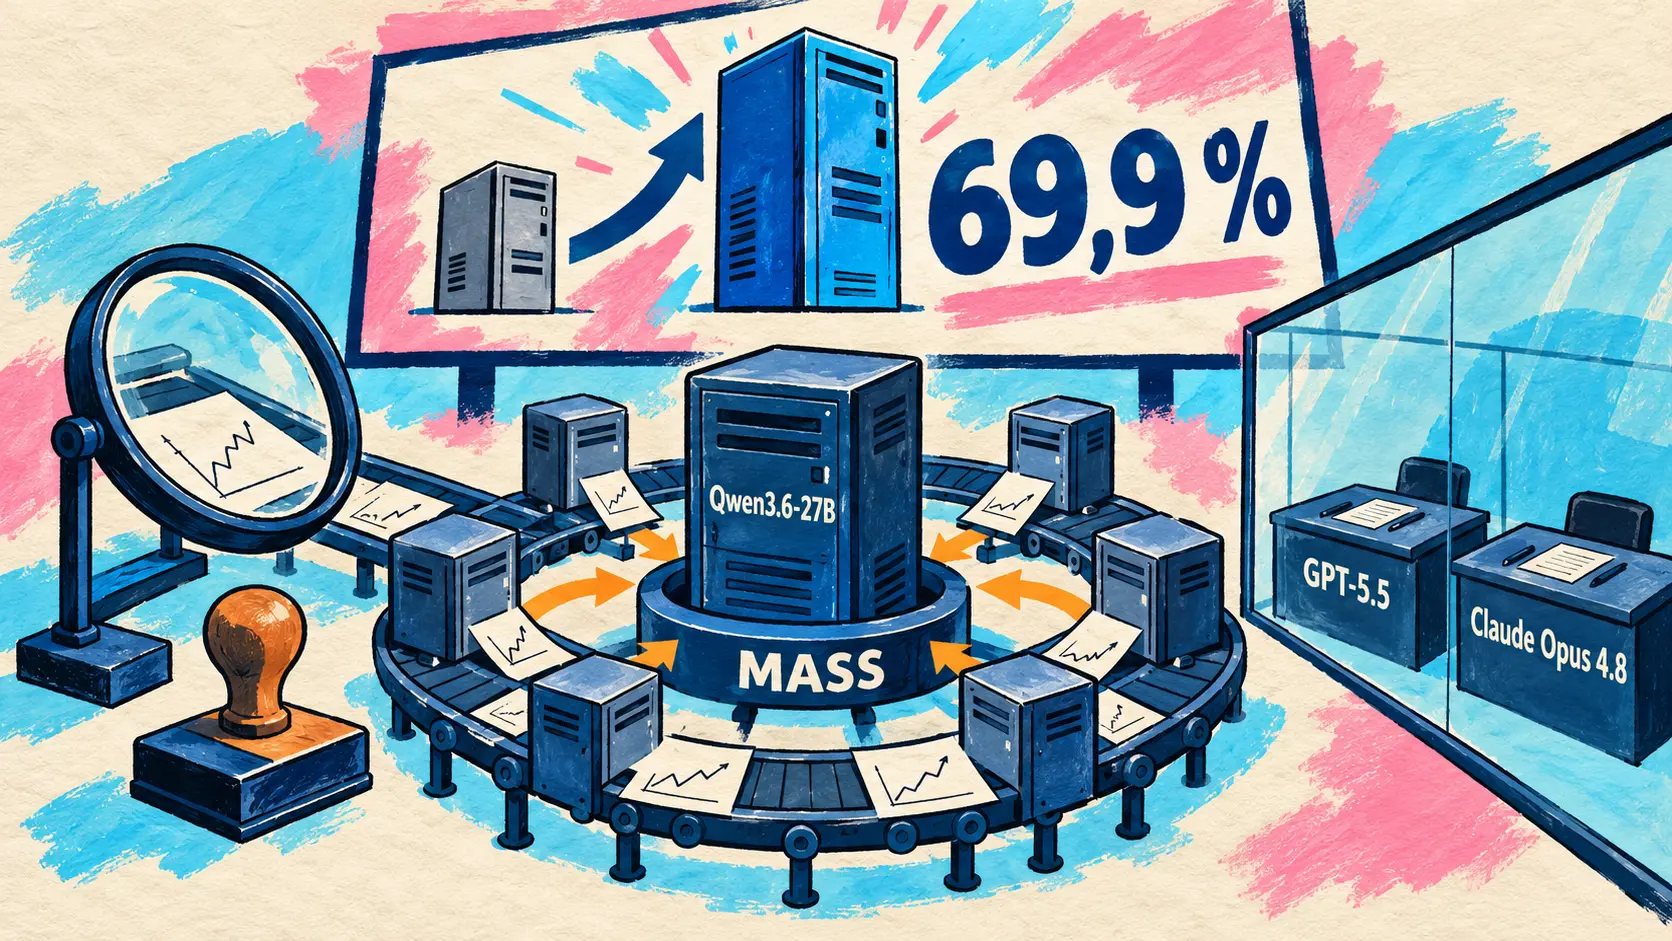
10월 11일 — Sakana AI와 UC Berkeley가 재귀적 자기 개선 방법인 MASS를 공개했다. Qwen3.6-27B는 하위 에이전트 팀을 구성해 연구 과제를 해결하고, 팀의 작업 흐름을 다시 작성하며, 결과를 직접 평가한 뒤 최고의 실행 기록을 바탕으로 LoRA 미세 조정을 수행한다. 외부 평가자인 GPT-5.5와 Claude Opus 4.8이 개선 정도를 측정한다.
| 보고된 지표 | 공개된 값 |
|---|---|
| 두 차례 반복 후 기본 모델 대비 승률, 학습에서 제외한 과제 | 69,9 % |
| 출력 토큰당 점수, 연구 벤치마크 네 개 | 기본 모델의 1,2~1,6배 |
| 동일 지표, Terminal-Bench 2.0 및 SWE-bench Verified | 기본 모델의 0,96배 및 0,94배 |
저자들은 벤치마크에 따라 개선 폭이 고르지 않다고 평가하며, 소프트웨어 공학 과제를 추가해 이를 보완할 수 있을 것으로 보고 있다. 코드는 라이선스가 명시되지 않은 상태로 공개됐으며, 논문은 10월 8일부터 arXiv에 올라와 있다.
🔗 MASS 소개 글 · arXiv 논문 · GitHub 코드
단신
- Open Quantum Challenge — FINAL-Bench(VIDRAFT)가 Hugging Face에서 양자 컴퓨터 없이 GPU 하나로 참가할 수 있는 두 시즌을 시작한다. 첫 번째는 2027년 2월 28일까지 Fermi-Hubbard 계의 바닥 상태 에너지를 추정하는 과제이고, 두 번째는 2027년 3월 31일까지 오류 정정(QEC) 디코더를 설계하는 과제다. 시즌당 상금은 1 000달러다. 🔗 출처 · 🔗 경진대회 공간
- Qwen Code v0.25.1 — 안정 버전은 10월 6일부터 이곳에서 소개한 세 가지 사전 출시 버전을 통합하고, Web Shell에서 대기열에 있는 메시지를 즉시 보내는 버튼(지금 보내기)을 포함해 변경 항목 17개만 추가한다. 릴리스 노트에는 v0.25.0 이후 총 57개의 기능과 85개의 수정 사항이 기록돼 있으며, 알려진 호환성 파괴 변경은 없다. 🔗 출처
무엇을 의미하나
MASS는 개방형 연구 과제에서 답변이 좋은지 판별하는 자동 규칙이 없으며, 모델 자체가 이용 가능한 가장 유능한 감독자가 될 수 있다는 관찰에서 출발한다. Sakana AI는 이에 수반되는 안전 문제를 강조한다. 모델이 스스로를 평가하면, 공유된 사각지대로 인해 오류를 개선으로 오인하고 이후 학습에서 이를 강화할 수 있다. 반복 과정에 영향을 주지 않고 개선 정도를 측정하기 위해 평가 절차는 외부 평가자에게 판단을 맡기며, 그 결과는 MASS에 전달하지 않는다. 외부 평가자와의 판단 일치율은 기본 모델의 73 %에서 두 번째 반복 후 93 %로 높아진다.
이 실험은 에이전트 데이터에 대해서도 시사점을 제공한다. 저자들에 따르면 팀의 작업 수행 기록은 단일 에이전트의 기록보다 더 효과적인 학습 자료가 된다. 팀 기록으로 학습한 모델은 지도 학습 토큰 2,880만 개를 사용해 기본 모델과의 비교에서 68,3 %의 승률을 기록한 반면, 단일 에이전트 기록으로 학습한 모델은 4,200만 개를 사용하고도 승률이 64,0 %였다. 이 실험은 같은 날 v0.25.1이 안정 버전으로 출시된 코딩 에이전트 Qwen Code에서 실행된다. 개발자 도구가 여기서는 연구용 실험대 역할을 한다.
Open Quantum Challenge는 다른 방향에서 문제에 접근한다. 각 제출물은 고정된 기준 답안과 비교해 자동으로 채점되며, 참가 안내서는 Codex나 Claude Code 같은 코딩 에이전트에게 맡길 수 있도록 설계됐다. 과제의 결과를 검증할 수 있다면 계산된 점수만으로 참가자들의 우열을 가릴 수 있다. 검증할 수 없는 경우, MASS는 외부 평가자들이 지켜보는 가운데 모델을 자신의 평가자로 삼는다.