ai-powered-markdown-translatorArtikel vertaald van het Frans naar het Nederlands met gpt-6.1-sol.
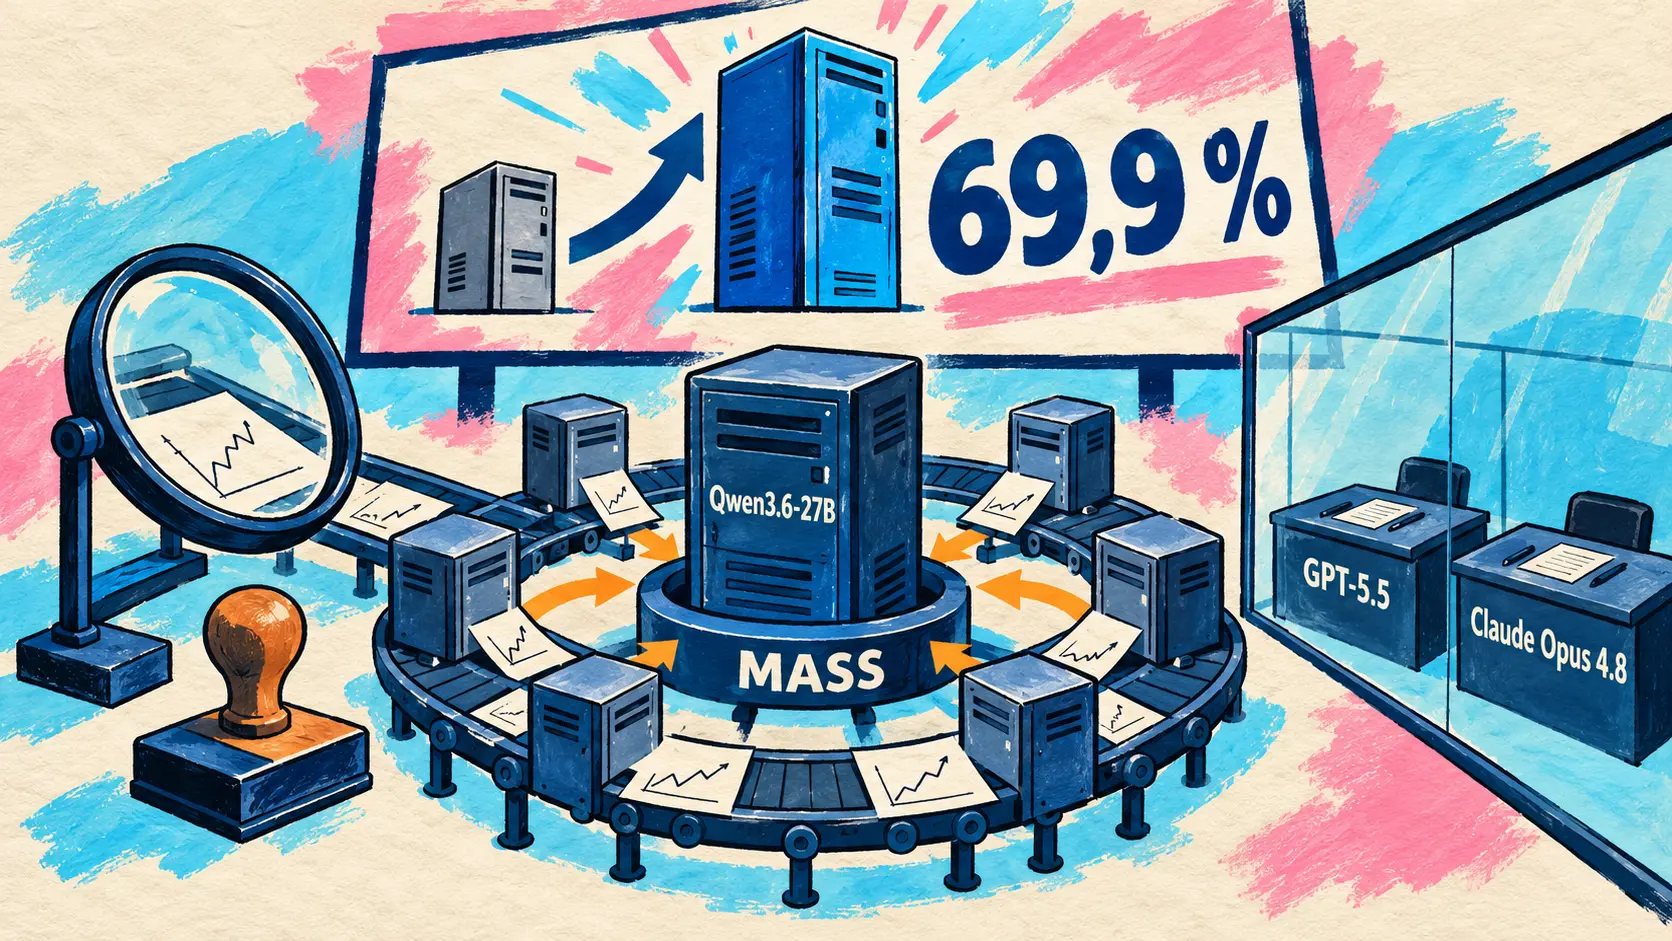
Sakana AI en onderzoekers van UC Berkeley presenteren MASS, een methode waarbij Qwen3.6-27B wordt verfijnd met de beste uitvoeringen van zijn eigen team van agents: na twee rondes verslaat het zijn basisversie in 69,9 % van de vergelijkingen op taken die buiten de training zijn gehouden. In het korte nieuws lanceert FINAL-Bench de Open Quantum Challenge, een wedstrijd voor kwantumsimulatie en foutcorrectie die op één gewone GPU kan worden uitgevoerd, en verschijnt Qwen Code v0.25.1 als stabiele versie.
MASS: Sakana AI en UC Berkeley verbeteren Qwen3.6-27B met het werk van zijn eigen team van agents
11 oktober — Sakana AI en UC Berkeley presenteren MASS, een methode voor recursieve zelfverbetering: Qwen3.6-27B lost daarin onderzoekstaken op met een team van subagents, herschrijft de workflow van het team en beoordeelt zelf de resultaten, waarna het met LoRA wordt verfijnd op basis van zijn beste uitvoeringen. Twee externe beoordelaars, GPT-5.5 en Claude Opus 4.8, meten de vooruitgang.
| Gerapporteerde maatstaf | Gepubliceerde waarde |
|---|---|
| Overwinningen tegen het basismodel na twee rondes, taken buiten de training | 69,9 % |
| Score per outputtoken, vier onderzoeksbenchmarks | 1,2 tot 1,6 keer het basismodel |
| Dezelfde maatstaf, Terminal-Bench 2.0 en SWE-bench Verified | 0,96 en 0,94 keer het basismodel |
De auteurs vinden zelf dat de winst per benchmark verschilt en denken dit te kunnen corrigeren door taken voor software engineering toe te voegen. De code is gepubliceerd zonder vermelde licentie, en het artikel staat sinds 8 oktober op arXiv.
🔗 MASS-blogbericht · arXiv-artikel · Code op GitHub
Kort nieuws
- Open Quantum Challenge — Op Hugging Face opent FINAL-Bench (VIDRAFT) twee seizoenen waaraan je met één gewone GPU kunt deelnemen, zonder kwantumcomputer: tot 28 februari 2027 de grondtoestandsenergie van Fermi-Hubbard-systemen schatten, en tot 31 maart 2027 een decoder voor foutcorrectie (QEC) ontwerpen, met 1 000 dollars per seizoen. 🔗 bron · 🔗 wedstrijdomgeving
- Qwen Code v0.25.1 — De stabiele versie bundelt de drie previewversies die hier sinds 6 oktober zijn besproken en voegt slechts 17 items toe, waaronder een knop om berichten in de wachtrij in Web Shell direct te versturen (Nu versturen). De release notes vermelden in totaal 57 functies en 85 fixes sinds v0.25.0, zonder bekende wijzigingen die de compatibiliteit verbreken. 🔗 bron
Wat dit betekent
MASS vertrekt vanuit een vaststelling: bij een open onderzoekstaak bepaalt geen enkele automatische regel of een antwoord goed is, en het model zelf kan de meest bekwame beschikbare supervisor worden. Sakana AI benadrukt het bijbehorende veiligheidsvraagstuk: wanneer een model zichzelf beoordeelt, kunnen gedeelde blinde vlekken ervoor zorgen dat fouten als vooruitgang worden gezien en vervolgens tijdens de training worden versterkt. Om de vooruitgang te meten zonder de cyclus te beïnvloeden, vertrouwt het protocol op externe beoordelaars, van wie de oordelen niet aan MASS worden doorgegeven; de overeenstemming met hun oordelen stijgt van 73 % voor het basismodel naar 93 % na de tweede ronde.
Het experiment zegt ook iets over gegevens van agents. Volgens de auteurs leveren teamtrajecten beter trainingsmateriaal op dan trajecten van één agent: een model dat op de eerste is getraind, wint 68,3 % van zijn vergelijkingen met het basismodel met 28,8 miljoen gesuperviseerde tokens, tegenover 64,0 % met 42 miljoen voor een model dat op de tweede is getraind. Het experiment draait bovendien in Qwen Code, de coding agent waarvan v0.25.1 op dezelfde dag als stabiele versie verschijnt: een ontwikkelaarstool dient hier als proefbank voor onderzoek.
De Open Quantum Challenge benadert het probleem van de andere kant. Elke inzending krijgt automatisch een score op basis van een vast referentieantwoord, en de deelnamegids is ontworpen om aan een coding agent zoals Codex of Claude Code te worden toevertrouwd. Wanneer een taak kan worden geverifieerd, volstaat een berekende score om de deelnemers te rangschikken; wanneer dat niet kan, laat MASS het model zichzelf beoordelen, terwijl externe beoordelaars meekijken.